
25 寒假学习笔记
学习总结
传这个对大家真的有帮助吗,其实本来不想申请全站推荐的,但是后来想了想,也许会帮到一些人吧。
作者当时水平不高,写出来的东西可能有一些瑕疵,也可能有小错误,请谅解并指正,我会改进的。
第一讲:线段树建模
权值线段树
引入
首先,我们在写线段树相关的问题的时候,我们常常对于区间进行处理,比如线段树的下标就代表区间的下标,但是实际上有的时候我们不需要这些东西,我们需要的是其他的东西,我们的线段树的下标和线段也可以代表值域。也就是值域线段树。
例题1 动态数列I
对于这样的题目,我们发现实际上最后的值域很小,我们就可以采用权值线段树去处理,基础的维护的信息就是这个区间的数出现的次数,那么对于这简单的动态维护值的问题,我们就可以用权值线段树来处理。当然也可以用平衡树,不过权值线段树的实现更为简约。
线段树 & 离散化
例题2 P3740 [HAOI2014] 贴海报
对于这个题来说,算是一个颜色覆盖的问题,我们需要去对于 \([L, R]\) 的部分进行覆盖操作(对于这样的覆盖类题目也可以用颜色均摊 $\mathtt{ODT} $ 解决),每次都这样覆盖,那么我们是否只需要直接进行延迟标记,然后最终查询呢?我们发现最终的区间长度有 \(10 ^ 9\) 的大小,显然是超出我们的处理,但是我们发现海报最多只有 \(n = 10 ^ 5\) 个,我们可以考虑离散化。
那么问题来了,是否只需要开 \(2n\) 个点呢?
看起来很显然的问题,我们只有 \(n\) 个海报,每个海报都有两个端点,但是答案是否定的。
我们考虑这样的例子:\([1, 5], [8, 10]\),这样的两个区间在整个区间 \([1, 10]\) 中,会被映射为 \([1, 2], [3, 4]\),也就是说在原本并不相邻的两个区间,被我们这样的映射之后,却变为相邻的了,中间的 \([6, 7]\) 莫名消失了。为了解决这样的问题,我们可以采用插入间隙的方式,也就是说把每个海报左端点的左边 \(1\) 位的点加入,把每个海报右端点的右边 \(1\) 位的点也加入。这样就可以完美的解决上面的问题。回到最初的问题,也就是需要插入 \(4n\) 个点。
插入示例如下:
uniq.insert(l[i]);
uniq.insert(r[i]);
uniq.insert(l[i] - 1);
uniq.insert(r[i] + 1);
动态开点线段树
引入
我们在写线段树的时候,一般来说都是直接拿 \(\mathtt{u << 1}\) 当作左子树的编号, \(\mathtt{u << 1 | 1}\) 当作右子树的编号,这样一看,我们每次的线段树空间都要开大 \(4\) 倍,可是有的子树在处理的时候完全用不到,于是我们思考一下是否能够在用到某个子树的时候再把这个点给开出来,于是就有了动态开点线段树。
例题3 [Non] 动态数列II
这个题面和 例题 \(1\) 其实没有什么本质上的区别,但是现在的值达到了 \(2 ^ {30}\) 大小,如果我们直接强制的去建树,那么我们的空间直接就 MLE 了,于是我们采用动态的开点方式,具体怎么操作呢?简单来说就是不建树了,直接爱咋地咋地吧,如果在 update 的时候发现没有要修改的区间内有一个子树需要使用,但是实际上并没有这个节点,我们就直接给这个节点建出来。
示例大概长这样:
if(pos <= mid){
    if(!a[rt].l) a[rt].l = ++ tot;
    update(a[rt].l, l, mid, pos, x);
}
else{
    if(!a[rt].r) a[rt].r = ++ tot;
    update(a[rt].r, mid + 1, r, pos, x);
}
课后习题
习题1 [Non] 区间平方和
此题为线段树板子,练习正常的线段树所用,注意平方和的计算方式
习题2 CF482B - Interesting Array
一道好题,我们对于区间的与值为 \(x\),只需要先把这个区间的值全部或上 \(x\)即可。
习题3 CF877E - Danil and a Part-time Job
对于子树进行操作,转树为序列,用线段树维护简单即可。
第二讲:树上DP进阶
树上背包
引入
首先我们想想之前做过的题目,比如 P1064 [NOIP 2006 提高组] 金明的预算方案,这道题目所考察的内容是有依赖的背包,我们需要去分类讨论,但是这个题目中的依赖关系太少了,如果更一般呢?如果给出类似于森林的依赖,那又该如何解决呢?
例题1 P2014 [CTSC1997] 选课
这个题目很经典,树上背包的模板题目,我们想想对于背包的定义,一般来说要有容量,和花费之类的,对于此题,我们定义 \(f[u][j]\) 表示在第 \(u\) 颗子树内选了 \(j\) 门课,能达到最大的价值,那么我们 \(u\) 的转移只和 \(v\) 有关,则有转移方程:
这个复杂度是 \(\mathcal{O}(nm^2)\) 的,但是真的有必要吗?这个时候就出现一个重要的技巧,上下界优化。
对于我们枚举 \(j\) 的时候,能枚举到的大小只有 \(sz[u]\),然后对于 \(k\) 来说,我们若是在 \(u\) 内选择 \(j\) 个,则显然的一点是,我们的 \(k\) 的下界应是 \(j - (sz[u] - sz[v])\),这样至少能凑够,上界与 \(j\) 类似。最终的效果就是:
for (int j = min(m, siz[u]); j >= 0; --j) {
    for (int k = max(1, j - siz[u] + siz[v]); k <= min(j - 1, siz[v]); ++k) {
        f[u][j] = max(f[u][j], f[u][j - k] + f[v][k]);
    }
}
通过这样的简单上下界优化,复杂度在 \(\mathcal{O}(nm)\),证明在博客中证明过了,不再赘述。
例题2 P2015 二叉苹果树
此题与选课类似,唯一区别是这个是处理边的。几乎一样。
树上差分
差分方式
目前主流的差分方式只有 \(2\) 种,然后一种是把一颗树的 \(\mathtt{dfs}\) 序跑出来,对于这个序列操作,类似上面第一讲的第三道习题,转换为序列的话就想咋整咋整了。第二种是利用 \(\mathtt{LCA}\) 进行差分,对于 \(u\) 和 \(v\) 差分,只需要关注 \(u\),\(v\),\(LCA(u, v)\) 即可,注意自下而上的统计的逻辑进行差分就好。
例题3 P3258 [JLOI2014] 松鼠的新家
给路径上的点 \(+ 1\),然后最后统计每个点的点权值,很简单,差分示例如下:
diff[u] ++;
diff[v] ++;
diff[l] --;
diff[f[l][0]] --;
例题4 [Non] 树上乘法
嘿,这一看就是树上差分,在两端乘法,然后父节点...欸?不对啊,乘法?
如果是乘法的话,我们无法去做,因为会溢出,那么我们有什么办法吗?有的?我们能不能把乘法改成加法?可以。\(\mathtt{乘法 \to 加法}\) 即 \(\mathtt{\times \to log}\),对嘛,对数运算不就好了。
课后习题
习题1 P1273 有线电视网
这个题的话要求最大的叶子节点的数量,要求所选的叶子节点的点权之和大于等于边权和,显然直接做树上背包即可,注意边权的问题。
习题2 P3128 [USACO15DEC] Max Flow P
树上差分板子题。
习题3 P1272 重建道路
要求分离点,不再是选点了,可以正难则反,也可以直接正着做。
习题4 P2680 [NOIP 2015 提高组] 运输计划
一道很有质量的题目,考虑小 \(\text{trick}\),我们无法快速确定这个边,但是我们可以确定所有边权 \(> k\) 的这些东西,于是我们可以二分答案,注意 \(\mathtt{check}\) 的写法即可。
第三讲:不带权图进阶
二分图
引入

这是一个二分图,简单来说,对于这个图就只有两部分,那么如何判断二分图呢?
二分图染色
简单的方式来说就是直接 \(\mathtt{DFS}\) 染色,下一个点染与当前点不一样的颜色,只要能够不冲突的染完,那么这个东西就是二分图,正确性显然。
当什么时候是无法构成二分图的?显然是有奇环的时候,这时一定会有一组相邻的点颜色冲突。
类似下面这种情况:

二分图染色代码示例:
bool dfs(int u, int color){
    ans[u] = color;
    for(int i = 0;i < g[u].size();i ++){
        int v = g[u][i];
        if(!ans[v]){
            if(!dfs(v, 3 - color)){
                return false;
            }
        }
        else if(ans[v] == color){
            return false;
        }
    }
    return true;
}
例题1 P1525 [NOIP 2010 提高组] 关押罪犯
这道题目是很经典的并查集题目了,但是我们今天试试不用并查集完成这道题。
我们考虑二分,二分最大的怨气值 \(x\),也就是说,我们对于怨气值 \(\le x\) 的组合已经无所谓了,那就随便吧,剩下的 \(> x\) 的不分到同一个监狱即可,那就直接二分图染色判断就好。
2 - SAT
引入
2-SAT(2-Satisfiability)问题是指:给定 \(n\) 个布尔变量 \(x_1, x_2, \dots, x_n\),以及 \(m\) 个限制条件,每个条件都形如“\(x_i\) 为真或 \(x_j\) 为假”这种二元关系,问是否存在一组赋值使得所有条件同时满足。
例题1 P4782 【模板】2-SAT
对于任何一个逻辑条件 \((a \lor b)\),它等价于两个蕴含关系:
- \(\neg a \implies b\) (如果 \(a\) 为假,则 \(b\) 必为真)
- \(\neg b \implies a\) (如果 \(b\) 为假,则 \(a\) 必为真)
我们将每个变量 \(x_i\) 拆成两个点:\(2i\) 表示 \(x_i\) 为真,\(2i+1\) 表示 \(x_i\) 为假。根据上述逻辑连有向边,表示“推导关系”。
那就是说,我们要在拆开的这些条件上进行二分图染色,那么就有这样的 \(\mathtt{2 - SAT}\) 代码:
bool dfs(int u){
    if(selected[u ^ 1]){
        return false;
    }
    if(selected[u]){
        return true;
    }
    selected[u] = true;
    S[c ++] = u;
    for(int i = 0;i < g[u].size();i ++){
        int v = g[u][i];
        if(!dfs(v)){
            return false;
        }
    }
    return true;
}

bool Two_SAT(){
    for(int i = 0;i < 2 * n;i += 2){
        if(!selected[i] && !selected[i + 1]){
            c = 0;
            if(!dfs(i)){
                while(c > 0){
                    selected[S[-- c]] = false;
                }
                if(!dfs(i + 1)){
                    return false;
                }
            }
        }
    }
    return true;
}
这种方式就是很朴素的基于二分图染色的逻辑的代码,但是这个代码的时间复杂度是 \(\mathcal{O}(nm)\) 的,已经可以通过大部分的简单的 \(\mathtt{2 - SAT}\) 题目了,但是也有更加快速的做法。
想想刚刚的二分图染色的过程,如果我们直接缩点,只需要让 \(x\) 和 \(\neg x\) 不在一个 \(\mathtt{SCC}\) 里面即可,那么我们如何给出可行解呢?只需要看 \(SCC[u]\) 和 \(SCC[\neg u]\) 的拓扑序,拓扑序靠后的为真。
缩点方式代码如下:
void targin(int u){
	low[u] = dfn[u] = ++ tim;
	stk.push(u);
	ins[u] = true;
	for(int &v : g[u]){
		if(!dfn[v]){
			targin(v);
			low[u] = min(low[u], low[v]);
		}
		else if(ins[v]){
			low[u] = min(low[u], dfn[v]);
		}
	}
	if(low[u] == dfn[u]){
		++ cnt;
		int v;
		do{
			v = stk.top();
			stk.pop();
			ins[v] = false;
			scc[v] = cnt;
		}while(v != u);
	}
}

for(int i = 1;i <= n;i ++){
    if(scc[i] == scc[i + n]){
        cout << "IMPOSSIBLE\n";
        return 0;
    }
    ans.push_back((scc[i] > scc[i + n]));
}
这样一来,我们的时间复杂度就只有 \(\mathcal{O}(n + m)\) 了。
例题2 P4171 [JSOI2010] 满汉全席
每种菜的两种做法,分别用 \(u \times 2\) 和 \(u \times 2 + 1\) 表示,在建图的时候分类讨论一下即可:
最大团
引入
相关概念:
- 顶点相邻:两个顶点之间有直接的边相连(没有中间顶点)
- 团:图中的一个非空顶点子集,满足「这个子集里的任意两个不同顶点之间都互相相邻」
注意:单个顶点本身也是一个团,两个相邻的顶点也构成一个团。
例题3 [Non] 最大团问题
最大团的定义:
- 它首先是一个「团」(满足子集内顶点两两相邻);
- 它是所有团中顶点个数最多的那个(或那些)(无法再向这个子集里加入任何其他顶点,使得加入后的子集仍然是一个团)。
我们直接采用启发式 \(\mathtt{A *}\) 的方式搜索答案,倒序枚举顶点,在回溯的过程中记录答案的,若不符合我们的估价函数,那么直接返回 \(\mathtt{False}\) 即可。
示例代码:
bool dfs(int pos, int num) {
    for(int i = pos + 1;i <= n;i ++){
        if(cnt[i] + num <= ans){
            return false;
        }
        int j;
        for(j = 0;j < num;j ++){
            if(!G[i][vis[j]]){
                break;
            }
        }
        if(j == num){
            vis[num] = i;
            if(dfs(i, num + 1)){
                return true;
            }
        }
    }
    if(num > ans){
        for(int i = 0;i < num;i ++){
            ansId[i] = vis[i];
        }
        ans = num;
        return true;
    }
    return false;
}
void maxClique() {
    ans = -1;
    for (int i = n; i > 0; --i) {
        vis[0] = i;
        dfs(i, 1);
        cnt[i] = ans;
    }
}
课后习题
习题1 P1330 封锁阳光大学
很显然的一道图染色问题,我们对于每个联通块染色,选择少的一个颜色即可。
习题2 [Non] 选举
将题目的约束条件搞清楚,然后套上 \(\mathtt{2 - SAT}\) 即可。
习题3 P5782 [POI 2001] 和平委员会
依旧需要转换这个代表之间的关系,但是要注意这个题目的建图,比较恶心。
第四讲:二分图
二分图最大匹配
引入
在一个二分图中,如果存在它的一个子图,这个子图中的任意两条边都没有公共顶点,我们把这样的子图叫做二分
图的一个匹配。而如何在二分图中选择一个边数最大的匹配就叫做图的最大匹配问题。

例题1 P3386 【模板】二分图最大匹配
这个题目是二分图最大匹配的模板题目,我们对于二分图匹配的问题,可以采用匈牙利算法,所谓匈牙利算法,就是不断 \(\mathtt{DFS}\) 去找增广路径的过程,对一条增广路进行异或操作,可以让这条增广路的长度 \(+ 1\)。这样做的时间复杂度是 \(\mathcal{O}(nm)\) 的。
示例代码:
bool dfs(int u){
    for(int i = 0;i < g[u].size();i ++){
        int v = g[u][i];
        if(!vst[v]){
            vst[v] = true;
            if(rmatch[v] == -1 || dfs(rmatch[v])){
                rmatch[v] = u;
                return true;
            }
        }
    }
    return false;
}
int hungary(int n){
    int cnt = 0;
    memset(rmatch, -1, sizeof(rmatch));
    for(int i = 1;i <= n;i ++){
        memset(vst, 0, sizeof(vst));
        cnt += dfs(i);
    }
    return cnt;
}
图 / 二分图 相关概念及定理
1. 点覆盖 & 点独立集
点覆盖集 \(V'\) :一个顶点子集 \(V' \subseteq V\),使得图中的每一条边\(e \in E\),至少有一个端点属于 \(V‘\)。
点独立集 \(I\):一个顶点子集 \(I \subseteq V\),使得 \(I\) 中任意两个顶点之间都没有边相连。
定理:点覆盖集和点独立集互为补集,即 最小点覆盖数 + 最大点独立集 = 总顶点数
2. 匹配(边独立集) & 边覆盖集
匹配(边独立集) \(M\):\(M \subseteq E\),使得 \(M\) 中的任意两条边都没有公共端点。
边覆盖集 \(F\):\(F \subseteq E\),使得任意一个顶点 \(v \in V\) 都是 \(F\) 中至少一条边的端点(无孤立点)
定理:对于一个没有孤立点的图,最大匹配数 + 最小边覆盖数 = 总顶点数
3. König 定理
König 定理 只适用于二分图
对于二分图来说,最大匹配数等于最小点覆盖的顶点数。
由此,我们可以推出来一些其他的内容:
- 最大点独立集:\(总顶点数 - 最大匹配数\)
- 最小边覆盖:\(总顶点数 - 最大匹配数\)
- \(\mathtt{DAG} 最小路径覆盖\):\(总顶点数 - 最大匹配数\)
以上内容较为显然,就不做证明。接下来举一些例子来应用。
König 定理 应用
例子1:拆散情侣
给你若干对情侣的关系,求,选出的集合,使得最终的集合没有情侣。
裸的 最大点独立集。
例子2:机器调度
如果有两台机器,每台都有多种模式,给 \(k\) 对任务,每个任务需要在 \(A\) 的 \(x\) 模式下,在 \(B\) 的 \(y\) 模式下,要求机器尽可能少的切换模式。
尽可能少的切换模式,也就是说我们在左右都要选尽可能少的点,就是求 最小点覆盖。
例子3:棋盘覆盖
给定 \(n \times n\) 的棋盘,放上 \(1 \times 2\) 的卡片(可以横放或者竖放),某些格子被标记,求最小多少卡片可以覆盖这些标记的格子。

对于这类问题,我们可以试着将格子交替染色,建图的时候,如果该点为被标记,就看看附近有没有被标记的点,有就连上。然后问题就转换为最小边覆盖。
例子4:矩形合并
给定若干个矩形,如果矩形 \(A\) 的长和宽都小于另一个矩形 \(B\),那么可以合并 \(A + B = A\),计算这些矩形能1合并为最少几个矩形。
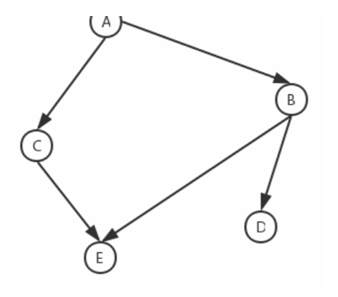
此题要求的是 DAG 上的最小覆盖,直接做就好。
集的构造
知道了如何求数量之后,若是要求方案,那么又该怎么办呢?
最大边独立集
对于最大边独立集,就是最大匹配,直接匈牙利。
最小边覆盖
当存在孤立点的时候,最小边覆盖不存在,若不是的话,我们就选择最大匹配的所有边,剩下的没匹配的点任选一条边即可
最小点覆盖集
先在左边的集合 \(X\) 中找到未匹配的点出发,通过增广路径标记点:
- 沿着未匹配边走到 \(Y\)
- 沿着匹配边走回 \(X\)
- 交替操作,直到无法进行
标记结果:
- 标记在 \(X\) 中的点存储在 \(lvis\) 中
- 标记在 \(Y\) 中的点存储在 \(rvis\) 中
构造结果:
- \(X\) 集合中未被标记的点
- \(Y\) 集合中被标记的点
void dfs2(int u) {
    lvis[u] = true;
    for (int i = 0; i < g[u].size(); i++) {
        int v = g[u][i];
        if (!rvis[v]) {
            rvis[v] = true;
            if (rmatch[v] != -1) {
                dfs2(rmatch[v]);
            }
        }
    }
}

void find_mincover(int n, int m) {
    cout << hungary(n) << endl;
    memset(lvis, 0, sizeof(lvis));
    memset(rvis, 0, sizeof(rvis));
    for (int i = 1; i <= n; i++) {
        if (lmatch[i] == -1) {
            dfs2(i);
        }
    }
    for (int i = 1; i <= n; i++) {
        if (!lvis[i]) {
            cout << " r" << i;
        }
    }
    for (int i = 1; i <= m; i++) {
        if (rvis[i]) {
            cout << " c" << i;
        }
    }
    cout << endl;
}
最大点独立集
与最小点覆盖互补,只需要求出最小点覆盖,补集就是最大点独立集。
DAG 最小路径覆盖
只需要求出最大匹配,然后把匹配之后的匹配边用一个 \(\mathtt{Path}\) 数组存下来,然后再构造,我们对于一个点 \(i\) 如果其不是任何一个点的后继,那么这个点必为起点,我们顺着这个点往下找。
for(int i = 1; i <= n; i++){
    if(rmatch[i] == -1){
        cout << i;
        for(int u = path[i]; u != 0; u = path[u]){
            cout << "->" << u;
        }
        cout << endl;
    }
}
例题2 P1129 [ZJOI2007] 矩阵游戏
这个题目的话,注意一下二分图的左右两边分别是什么,然后最终看是否存在完整的匹配。
二分图最大权匹配(KM 算法)
我们给二分图的每一个顶点都设置一个顶标,左侧为 \(X_i\),右侧为 \(Y_i\),那么对于任何一条 \(w_{i, j}\) 的边来说,都满足 \(X_i + Y_j \ge w_{i, j}\),相等子图是 \(G\) 的生成子图,包含所有顶点,但只包含满足 \(X_i + Y_j = w_{i, j}\) 的所有边,我们有如下定理:
如果相等子图 \(G'\) 存在完美匹配,则该匹配是原图 \(G\) 的一个最大权匹配。
这是因为任取 \(G\) 的一个完美匹配 \(M\),由于
\(w_{i, j} \le X_i + Y_j\),所以 \(M\) 的权值和不超过顶标和,而相等子图的完美匹配权值和等于顶标和,因此 \(M\) 的权值和不会超过相等子图的完美匹配权值和。
\(\mathtt{KM}\) 算法就是不停的调整左右的顶标,直到其相等子图中存在一个完美匹配。
bool find(int i, int n){
   lvis[i] = true;
   for(int j = 1;j <= n;j ++){
       if(lx[i] + ly[j] == w[i][j] && !rvis[j]){
           rvis[j] = true;
           if(!rmatch[j] || find(rmatch[j], n)){
               rmatch[j] = i;
               return true;
           }
       }
       else{
           slack[j] = min(slack[j], lx[i] + ly[j] - w[i][j]);
       }
   }
   return false;
}

void update(int n){
   int dt = INF;
   for(int i = 1;i <= n;i ++){
       if(!rvis[i]) dt = min(dt, slack[i]);
   }
   for(int i = 1;i <= n;i ++){
       if(lvis[i]) lx[i] -= dt;
       if(rvis[i]) ly[i] += dt;
       else slack[i] -= dt;
   }
}

int KM(int n){
   for(int i = 1;i <= n;i ++){
       rmatch[i] = lx[i] = ly[i] = 0;
       for(int j = 1;j <= n;j ++){
           lx[i] = max(lx[i], w[i][j]);
       }
   }
   for(int i = 1;i <= n;i ++){
       memset(slack, 0x3f, sizeof(slack));
       while(true){
           for(int j = 1;j <= n;j ++){
               lvis[j] = rvis[j] = false;
           }
           if(find(i, n)) break;
           else{
               update(n);
           }
       }
   }
   int res = 0;
   for(int i = 1;i <= n;i ++){
       res += (lx[i] + ly[i]);
   }
   return res;
}
课后习题
习题1 P2055 [ZJOI2009] 假期的宿舍
此题只需要看题目中这些人的关系,把边建好直接最大匹配。
习题2 P2319 [HNOI2006] 超级英雄
在匹配中记录答案,找不到增广路就直接 break
习题3 [Non] 棋盘上的马
我们发现妈每次跳的地方的行列和都与原来不同,于是按行列和的奇偶性去建图,把不能跳的地方也建上边。最终求的就是最大点独立集。
第五讲:分块算法
朴素分块
对于分块,一句话总结:大块维护,小块朴素。
不明白的看下面这个用分块实现的区间加和区间查询:
#include <bits/stdc++.h>
using namespace std;
const int N = 1e5 + 5;
const int S = 316 + 5;
typedef long long ll;
ll a[N], sum[S], add[S];
int n, m, B;

int get(int x){
    return (x + B - 1) / B;
}

int main() {
    cin >> n >> m;
    B = sqrt(n);
    for (int i = 1; i <= n; i++) {
        cin >> a[i];
        sum[get(i)] += a[i];
    }
    while (m--) {
        int op, l, r, x;
        cin >> op >> l >> r;
        int idl = get(l), idr = get(r);
        if (op == 1) {
            cin >> x;
            if(idl == idr){
                for(int i = l;i <= r;i ++){
                    a[i] += x;
                }
                sum[idl] += (r - l + 1) * x;
            }
            else{
                for(int i = idl + 1;i <= idr - 1;i ++){
                    add[i] += x;
                }
                for(int i = l;i <= idl * B;i ++){
                    a[i] += x;
                }
                sum[idl] += (idl * B - l + 1) * x;
                for(int i = (idr - 1) * B + 1;i <= r;i ++){
                    a[i] += x;
                }
                sum[idr] += (r - (idr - 1) * B) * x;
            }
        } else if (op == 2) {
            ll ans = 0;
            if(idl == idr){
                for(int i = l;i <= r;i ++){
                    ans += a[i] + add[idl];
                }
            }
            else{
                for(int i = idl + 1;i <= idr - 1;i ++){
                    ans += sum[i] + add[i] * B;
                }
                for(int i = l;i <= idl * B;i ++){
                    ans += a[i] + add[idl];
                }
                for(int i = (idr - 1) * B + 1;i <= r;i ++){
                    ans += a[i] + add[idr];
                }
            }
            cout << ans << endl;
        }
    }
    return 0;
}
分出块,对整块维护,跨越的部分就朴素做,复杂度就是 \(n \sqrt n\) 的。
莫队算法
引入
对于刚刚的序列询问,我们发现 \([l, r]\) 的答案能 \(\mathcal{O}(1)\) 的转移到 \([l - 1, r], [l + 1, r], [l, r - 1], [l, r + 1]\),那么我们是否可以对询问进行分块处理呢?
例题1 莫队模板
给定长为 \(n\),\(m\) 次询问,每次查询 \([l, r]\) 中不相同的数的个数。
这个题直接朴素分块太麻烦了,我们采用莫队算法,对询问离线后排序,按顺序处理每一个询问,暴力的从上一个答案转移。
排序的方式按照二元组 \((\lfloor \frac{l}{\sqrt r} \rfloor, r)\) 从小到大排序。
复杂度分析:
设序列长度为 \(n\),询问个数为 \(m\),且 \(n,m\) 同阶,即 \(O(n)=O(m)\)。可以发现从 \((l_1,r_1)\) 转移到 \((l_2,r_2)\) 的代价为 \(|l_1-l_2|+|r_1-r_2|\)。
对于询问序列中的每一个块(第一关键字相同),整个块内纵坐标最多变化 \(n\) 长度(纵坐标单调不减),共有 \(\frac{m}{\sqrt{n}}=O(\sqrt{n})\) 块,这一部分代价为 \(O(n\sqrt{n})\)。
对于每个询问,横坐标最多变化 \(\sqrt{n}\),共有 \(m\) 个询问,这一部分代价为 \(m\sqrt{n}=O(n\sqrt{n})\)。
因此总体复杂度为 \(O(n\sqrt{n})\)。
cnt[i]:表示数值i在当前区间内的出现次数。tans:表示当前区间内不相同数的数量。
当区间变化导致数值 x 的出现次数 cnt[x] 改变时,若 cnt[x] 从 1 变为 0:说明数值 x 完全离开了当前区间,因此不同数的数量 tans 减 1。若 cnt[x] 从 0 变为 1:说明数值 x 首次进入当前区间,因此不同数的数量 tans 加 1。
代码示例:
struct Q {
    int l, r, id;
    bool operator < (const Q &t) const{
        if(l / B == t.l / B) return r < t.r;
        return l / B < t.l / B;
    }
} q[N];

void update(int x, int f){
    cnt[x] += f;
    if(cnt[x] == 0 && f == -1) tans--;
    if(cnt[x] == 1 && f == 1) tans ++;
}

for (int i = 1; i <= m; i++) {
    cin >> q[i].l >> q[i].r;
    q[i].id = i;
}
sort(q + 1, q + m + 1);
int l = 1, r = 0;
for(int i = 1;i <= m;i ++){
    while(l < q[i].l) update(a[l ++], -1);
    while(l > q[i].l) update(a[-- l], 1);
    while(r < q[i].r) update(a[++ r], 1);
    while(r > q[i].r) update(a[r --], -1);
    ans[q[i].id] = tans;
}
块状链表
引入
我们思考这样的问题,数组在访问元素的时候是 \(\mathcal{O}(1)\) 的,但是在插入元素的时候却是 \(\mathcal{O}(n)\) 的,链表刚好反过来,那么有没有能把这俩东西结合起来的数据结构呢?
例题1 块状链表模板
初始给定一个字符串 \(s\),\(|s| \le 10^6\)。
有 \(m(m \le 2000)\) 次操作。
1:\(I \ c \ p\)
2:\(Q \ p\)
操作 1 表示在当前串的位置 \(p\) 前面插入一个字符 \(c\)。若 \(p\) 大于当前串长,则将字符添加到串的末尾。
操作 2 表示询问当前串的第 \(p\) 个字符。输入保证当前串的第 \(p\) 个字符存在。所有字符均为小写字母。
解法
用块状链表维护,插入和查询为块状链表的基本操作。
我们将串分块,共分为 \(S = 1000\) 个块,由于只有 \(2000\) 次操作,因此我们可以将块的大小设为 \(B = 3000\)。于是复杂度为 \(O(m(B + S))\)。同时也避免了块的分裂及合并,降低了代码的实现难度。
对每块维护一个变量 \(sz\),表示块内的字符个数。
初始将串分到块中,每块不超过 \(1000\) 个字符。
查找位置,从前往后访问块,利用 \(sz\),可以在 \(O(S)\) 的复杂度内定位到所在块,并且可以求得在块内的位置。
查询操作则可以直接用查找的方法,求得答案。
对于插入操作,先查找位置,然后直接暴力地在块内将字符挪动即可(复杂度 \(O(B)\))。
示例代码:
#include <cstdio>
#include <cstring>
const int B = 3005, S = 1005;
char str[S * B];
int n;
struct Block{
    int sz;
    char d[B];
    void ins(int pos, char c) {
        for (int i = ++sz; i > pos; i--) d[i] = d[i - 1];
        d[pos] = c;
    }
} b[S];

void init() {
    int len = strlen(str);
    n = (len + 999) / 1000;
    for (int i = 0; i < len; i++) {
        int id = i / 1000 + 1;
        b[id].d[++b[id].sz] = str[i];
    }
}

int main() {
    if (scanf("%s", str) == EOF) return 0;
    init();
    int m; scanf("%d", &m);
    while (m--) {
        char op[2], c[2];
        int p, id = 1;
        scanf("%s%d", op, &p);
        while (id < n && p > b[id].sz) p -= b[id].sz, id++;
        if (op[0] == 'I') {
            scanf("%s", c);
            b[id].ins(p, c[0]);
        } else {
            printf("%c\n", b[id].d[p]);
        }
    }
    return 0;
}
分块打表
例题2
求同时满足下列要求的数字 \(x\) 的个数:
\(x \in [A, B], A, B \le 3 \times 10 ^ 8\)
\(x\) 是质数
存在正整数 \(P, Q\) 满足 \(x = Q^2 + P^2\)。
预处理 \(f[i]\) 表示 \(1 \sim i\) 中满足要求的数字的个数,也就是将 \([A, B]\) 转化为前缀和相减。在打表时,我们可以设定每个块的大小为 \(10^5\),打 \(3 \times 10^3\) 个数据。这样每次暴力计算的规模实际上只有 \(10^5\),直接使用 \(O(n\sqrt{n})\) 的暴力算法即可在 1 秒内处理出来。
int A, B;
int f[MAXN] = {0,4784,8978,12981,16901,.......8118011,8120631,8123161,8125719};
int solve(int n) {
    ans = f[n / base];
    for(int i = n / base * base + 1; i <= n; i++)
        check(i);
    return ans;
}
int main() {
    for(int i = 1; i <= 18000; i++) sqr[i] = i * i;
    cin >> A >> B;
    cout << solve(B) - solve(A - 1);
    return 0;
}
课后习题
习题1 P3203 [HNOI2010] 弹飞绵羊
这个题虽然是经典的 \(\mathtt{LCT}\) 题目,但是也算是经典的分块题目,注意跳跃的性质。
习题2 P4462 [CQOI2018] 异或序列
不难想到异或的性质也可以扩展,然后,将区间异或转为前缀异或,用 \(s[r]\) 和 \(s[l - 1]\) 来算。
习题3 P1494 [国家集训队] 小 Z 的袜子
莫队板子,注意对分子和分母的维护。
习题4 COGS 4292.折枝的函数
我们可以以 \(10 ^ 6\) 为块的大小,分出 \(1000\) 个块,分块打表。
第六讲:平衡树与 pbds
排序二叉树
-
对于一个结点,若它的左子树不为空,那么它的左子树中所有结点的权值都小于这个结点的权值。
-
对于一个结点,若它的右子树不为空,那么它的右子树中所有结点的权值都大于这个结点的权值。
也就是说,排序二叉树的中序遍历就是它所有结点的权值排序后的结果。
下图就是一棵排序二叉树。
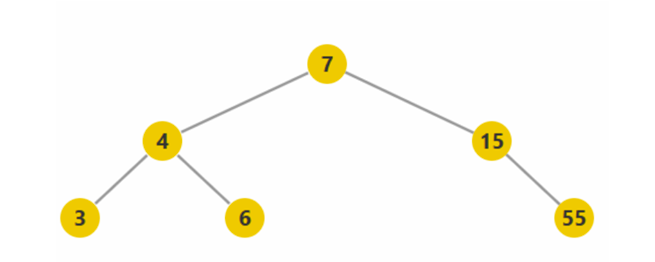
代码示例:
struct Node {
    int ch[2];
    int fa, val, size;
} t[N];
int root, tot;
int newNode(int val, int f) {
    t[++tot].val = val;
    t[tot].size = 1;
    t[tot].fa = f;
    return tot;
}
void pushup(int x) {
    if (!x) return;
    t[x].size = t[t[x].ch[0]].size + t[t[x].ch[1]].size + 1;
}
int search(int x, int val) {
    if (!x || t[x].val == val) return x;
    return search(t[x].ch[val > t[x].val], val);
}
int kth(int x, int k) {
    int lsize = t[t[x].ch[0]].size;
    if (k <= lsize) return kth(t[x].ch[0], k);
    if (k == lsize + 1) return x;
    return kth(t[x].ch[1], k - (lsize + 1));
}
void insert(int &x, int val, int f) {
    if (!x) {
        x = newNode(val, f);
        return;
    }
    t[x].size++;
    if (val <= t[x].val) insert(t[x].ch[0], val, x);
    else insert(t[x].ch[1], val, x);
}
void del(int x) {
    if (!x) return;
    int cur = x;
    if (!t[x].ch[0] || !t[x].ch[1]) {
        int son = t[x].ch[0] + t[x].ch[1];
        int f = t[x].fa;
        if (son) t[son].fa = f;
        if (!f) root = son;
        else t[f].ch[x == t[f].ch[1]] = son;
        cur = f;
    } else {
        int y = kth(t[x].ch[1], 1);
        t[x].val = t[y].val;
        int son = t[y].ch[1];
        int f = t[y].fa;
        if (son) t[son].fa = f;
        t[f].ch[y == t[f].ch[1]] = son;
        cur = f;
    }
    while (cur) {
        pushup(cur);
        cur = t[cur].fa;
    }
}
Treap
引入
我们知道,排序二叉树的复杂度是\(O(n \log n)\)的,除非我们遇到了极端数据。
例如,我们通过特定的插入顺序,把二叉搜索树变成一整条链,这时候我们每次操作的复杂度就很不幸变成了\(O(n)\)的。
介绍 Treap
一句话总结:\(\mathtt{Treap = Tree + Heap}\)
我们同时维护一棵树,既满足二叉搜索树,又满足堆的性质的东西。
也就是说,我们的这颗树,既要在本身的点值方面满足二叉搜索树,我们再随机给每一个节点分配一个点权,即权值,在权值方面要大于等于自己的两个孩子。
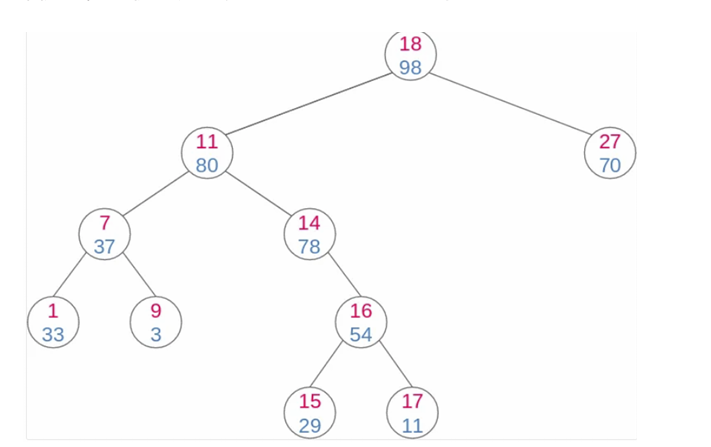
那么,我们在操作的时候,如何保证这个树的结构呢?那么我们可以引入一个重要的操作:旋转
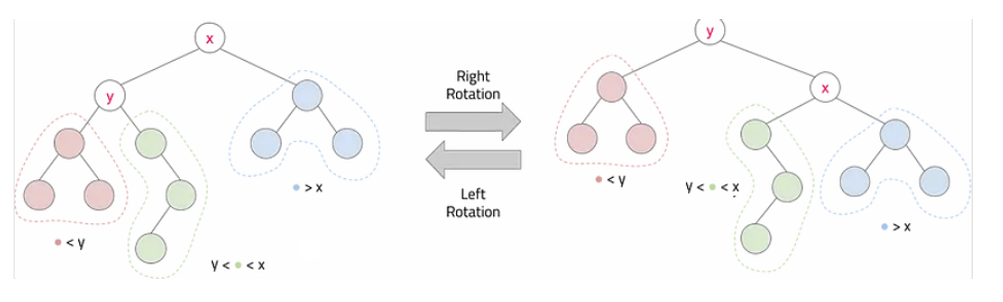
自己看这个图片感性理解一下,我们发现,这样就可以在满足堆的性质下,不破坏二叉搜索树性质的前提下,通过左旋或者右旋实现维护。
那么插入呢?
我们可以先按照二叉搜索树的插入,先把点插进树里,如何随机分配一个权值,再不断的旋转,直到合法。
那删除呢?
简单的一种处理手段是把节点旋转到叶子,然后删掉即可。
Treap 的其他常见操作
求前驱/后继
以前驱为例,后继是相似的求法。
我们首先访问根。如果根的数值比 \(x\) 小,那么就访问根的右子树,并递归下去。如果根的数值比 \(x\) 大或相等,那么就访问根的左子树,并递归下去。如果我们发现我们访问到了空结点,那么我们就返回一个无解。一旦我们在某个结点向右子树递归并且发现右子树是无解的,那么就返回这个结点本身。否则我们就返回当前得到的解。
注意:如果我们访问到了某个结点的左子树并得到无解,那么说明在整个子树内是无解的。
我们最终访问的点数仅与深度有关,所以复杂度是\(O(\log n)\)的。
求第k小
我们需要在 \(\mathtt{Treap}\) 的结点中维护它的子树大小,并且需要在旋转的时候正确维护子树大小。我们首先访问根。
- 如果根的左子树的大小\(=k-1\),那么我们可以直接返回根的值。
- 如果根的左子树的大小\(<k-1\),那么我们就递归到右子树,求右子树的第\(k-size_l-1\)小即可。(\(size_l\)表示左子树的大小)
- 如果根的左子树的大小\(>k-1\),那么就直接递归到左子树。
最多访问的点数也仅与深度有关,所以复杂度是\(O(\log n)\)的。
求第 \(k\) 大与第 \(k\) 小是相似的,甚至你可以直接将第 \(k\) 大改为第 \(n-k+1\) 小来求。
求 rank(比x小的数有几个)
我们需要在 \(\mathtt{Treap}\) 的结点中维护它的子树大小,并且需要在旋转的时候正确维护子树大小。我们首先访问根。
如果根的值比 \(x\) 小,那么根和左子树都比x小,所以返回 \(1+size_l\) 再加上右子树递归下去得到的值。(\(size_l\)表示左子树的大小)
如果根比 \(x\) 大或者相等,那么直接递归左子树就行。
其他操作思路
- 求第 \(1~k\) 小的和
我们需要在 \(\mathtt{Treap}\) 的结点中维护它的子树大小和子树和,并且在旋转的时候正确维护它们。与求第 \(k\) 大的情况相似。 - 修改单点的数值
先删除这个点,再插入回来。可以考虑重复利用这个指针。 - 查询一个数是否存在
与求rank相似。
Splay
引入
由于 \(\mathtt{Treap}\) 是随机化算法,难免会有些令人不安心,而且其对于实现复杂的区间问题有时候力不从心,所以就出现了 \(\mathtt{Splay}\)。
Splay 介绍
\(\mathtt{Treap}\) 的旋转是为了保持堆的性质,而 \(\mathtt{Splay}\) 的旋转是为了让树不会退化以至于复杂度过高。一般而言,我们会在对某个结点进行操作后把它旋转到根结点。
复杂度证明过于复杂,不赘述。
我们既然知道了 \(\mathtt{Splay}\) 也是旋转,我们想把一个新插入的节点旋转到根,我们注意到,如果是正常的只按照二叉搜索树的性质进行单旋,那么这样会退化。
对于这样的问题,我们采用双旋的方式(下图为同向旋转):
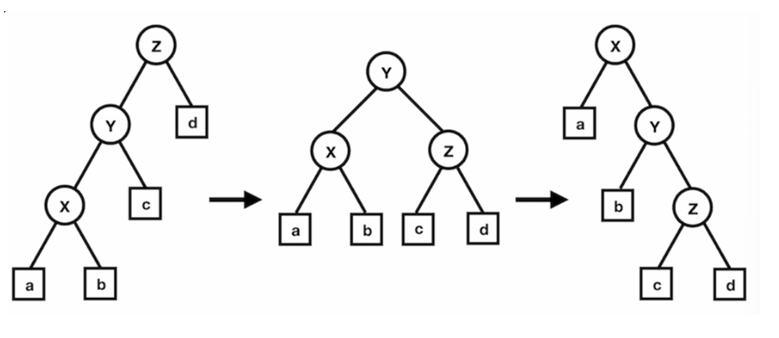
情况一:单旋 (Zig)
条件:\(y\) 就是根节点(或者 \(y\) 的父亲就是 \(goal\))。
做法:直接 rotate(x)。
效果:\(x\) 变成了根。
情况二:同向双旋 (Zig-Zig)
\(x, y, z\) 在同一条线上(比如 \(x\) 是 \(y\) 的左儿子,\(y\) 也是 \(z\) 的左儿子)。
先旋父亲 \(y\),再旋自己 \(x\)。
为什么要先旋父亲? 这是为了把原本很深的一条链“折叠”起来。
如果先旋 \(x\) 再旋 \(x\),这棵树还是那么深;但先旋 \(y\),整棵树的高度会瞬间减半。
情况三:异向双旋 (Zig-Zag)
\(x, y, z\) 呈“之”字形(比如 \(x\) 是 \(y\) 的右儿子,\(y\) 是 \(z\) 的左儿子)。
连续旋转两次自己 \(x\)。\(x\) 直接顶替了 \(z\) 的位置。
pbds
1.平衡树 RB - Tree
#include <bits/stdc++.h>
#include <ext/pb_ds/assoc_container.hpp>
#include <ext/pb_ds/tree_policy.hpp>
using namespace __gnu_pbds;
using namespace std;

// 定义一个基于红黑树的有序统计集合
template<class T>
using ordered_set = tree<
    T,
    null_type,
    less<T>,
    rb_tree_tag,
    tree_order_statistics_node_update
>;
order_of_key(x):返回 \(x\) 的排名(小于 \(x\) 的元素个数)。
find_by_order(k):返回排名为 \(k\) 的迭代器(从 \(0\) 开始计数)。
2.Rope
#include <ext/rope>
using namespace __gnu_cxx;
crope rp; // crope 即 rope<char>
push_back(x):末尾插入。
insert(pos, str):在 pos 处插入字符串或另一个 rope。
erase(pos, n):删除从 pos 开始的 \(n\) 个字符。
substr(pos, n):提取子串。
它支持 \(O(1)\) 持久化。
rope *new_rp = new rope(old_rp)
可以在常数时间内完成复制。
3.优先队列
#include <iostream>
#include <ext/pb_ds/priority_queue.hpp>

int main(){
    __gnu_pbds::priority_queue<int> pq;
    pq.push(10);
    pq.push(2);
    pq.push(7);
    std::cout << "堆顶:" << pq.top() << std::endl;
    pq.pop();
    std::cout << "pop后堆顶:" << pq.top() << std::endl;
    std::cout << "元素个数:" << pq.size() << std::endl;
    __gnu_pbds::priority_queue<int> pq2;
    pq2.push(20);
    pq.join(pq2);
    pq.clear();
    return 0;
}
join(q) 支持 \(\mathcal{O}(1)\) 的合并堆操作。
课后习题
习题1 P3369 【模板】普通平衡树
平衡树板子,可以自己实现一下 \(\mathtt{Treap}\) 和 \(\mathtt{Splay}\)。
习题2 [Non] 字符串问题
\(\mathtt{Rope}\) 大法好。
第七讲:数学概率与期望
概率
虽然我们都知道概率是 \(0\) 到 \(1\) 之间的一个数,但在解题时,更推荐大家从集合的角度去理解。
设样本空间为 \(\Omega\)(所有可能发生的结果的集合)。对于 \(\Omega\) 中的每一个随机事件 \(A\),概率 \(P(A)\) 本质上就是一种衡量 \(A\) 在 \(\Omega\) 中“分量”大小的函数。
它必须满足三条公理(柯尔莫哥洛夫公理):
- 非负性:\(P(A) \geq 0\)。
- 规范性:\(P(\Omega) = 1\)(整个宇宙发生的概率是 1)。
- 可加性:对于互斥事件(不可能同时发生),概率可以直接相加:\(\sum P(A_i) = P(\bigcup A_i)\)。
古典概率模型
这是最朴素的情况:每个基本结果发生的概率相等。
比如掷骰子,\(\Omega = \{ 1, 2, 3, 4, 5, 6\}\),大小为 \(6\)。设事件 \(A\) 为“点数大于 \(4\)”,则 \(A = \{ 5, 6\}\),大小为 \(2\)。
条件概率与独立性
条件概率
条件概率 \(P(A|B)\) 的直观理解是:已知 \(B\) 发生了,那么 \(\Omega\) 就缩水成了 \(B\)。此时 \(A\) 发生的概率,就是在 \(B\) 这个新世界里,属于 \(A\) 的那部分占比。
公式:
- \(P(AB)\) 是 \(A\) 和 \(B\) 的交集(在原世界的大小)。
- 除以 \(P(B)\) 就是为了把分母归一化,把 \(B\) 当作新的 \(1\)。
例子:掷两颗骰子,已知和为 \(7\)(事件 \(B\),共 \(6\) 种情况:\(1+6, 2+5\)...),求其中一颗是 \(1\)(事件 \(A\))的概率。
- 满足 \(B\) 的有 \(6\) 种。
- 同时满足 \(A\) 和 \(B\) 的只有 \((1, 6)\) 和 \((6, 1)\) 这 \(2\) 种。
- 所以 \(P(A|B) = 2/6 = 1/3\)。
独立性
独立性是概率题中最大的坑点,也是最大的简化工具。
已知 \(B\) 发生,并不会改变 \(A\) 发生的概率,即 \(P(A|B) = P(A)\)。
\(A, B \text{ 独立} \iff P(AB) = P(A)P(B)\)。
千万不要凭直觉滥用 \(P(AB) = P(A)P(B)\)。只有当你确定两件事物理上互不干扰(比如掷两个不同的骰子,或者题目明确说明独立)时才能用。如果两件事有因果关系或制约关系,必须用条件概率公式。
例题1 [Non] 踩地雷I
这个题目,我们只需要定义每一个格子的概率,然后做概率 DP,但是我们发现范围很大,但是我们的转移式可以用矩阵快速幂优化。
全概率与贝叶斯
全概率公式
当我们很难直接求 \(P(B)\) 时,可以把样本空间切成若干个互不重叠的“碎片” \(A_i\)(比如按第一步的操作分类)。
贝叶斯公式
贝叶斯公式是全概率公式的逆过程。通常我们容易算出“因 \(\to\) 果”的正向概率 \(P(\text{果}|\text{因})\),但有时题目会给你结果,问你起因的概率 \(P(\text{因}|\text{果})\)。
典型案例:某病发病率 \(0.1\%\)。检测准确率 \(90\%\)(有病测出阳性 \(90\%\),没病测出阴性 \(90\%\))。
问题:你检测呈阳性(事件 \(T\)),你真的有病(事件 \(D\))的概率是多少?计算:
\[P(D|T) = \frac{P(T|D)P(D)}{P(T)} = \frac{0.9 \times 0.001}{0.9 \times 0.001 + 0.1 \times 0.999} \approx 0.0089 \]结论:即使阳性,你也只有不到 \(1\%\) 的概率真有病,这就是先验概率(发病率极低)的强大影响力。
数学期望
期望的线性性质
它的强大之处在于:不需要 \(X\) 和 \(Y\) 独立 无论关系多么抽象,只要问的是“和的期望”,就可以拆成“期望的和”。
在 OI 中,常设 \(X_i\) 为指示变量(满足条件为 \(1\),否则为 \(0\)):
期望的可乘性
仅当 \(X, Y\) 独立时,\(E[XY] = E[X]E[Y]\)。
例题
问题:有 \(n\) 种卡片,每次买一包得到其中一张(概率均等),集齐 \(n\) 种卡片的期望次数?
手里有 \(k\) 种卡片时,买到一张新卡片的概率是 \(p = \frac{n-k}{n}\)。这是一个几何分布,期望尝试次数就是 \(1/p\)。
期望 DP 与高斯消元
期望 DP
期望 DP 通常是在 DAG(有向无环图)或者是树上进行的,可以倒推或正推。但如果图里有环,状态之间会互相依赖:
对于每一个节点 \(u\),我们都能列出这样一个线性方程。如果有 \(N\) 个点,我们就得到了一个包含 \(N\) 个变量、\(N\) 个方程的线性方程组。
高斯消元
先在每一列里找一个不为零的数作为“标杆”换到对角线上,如果找不到就说明方程组没法解。
接着像玩“消消乐”一样,用这一行去乘以一个比例再减掉其他所有行,把这一列除了对角线以外的数字全部抹成零,一列一列处理完后,左边的系数矩阵就只剩下对角线有数了,最后把右边的常数项除以对角线上的系数,就直接得到了每一个未知数的答案。
注意高斯消元的复杂度是 \(\mathcal{O}(n ^ 3)\)
示例代码:
bool Jorhn(){
	for(int i = 1;i <= n;i ++){
		for(int k = i;k <= n;k ++){
			if(fabs(a[k][i]) > eps){
				swap(a[k], a[i]);
				break;
			}
		}
		if(fabs(a[i][i]) < eps) return false;
		for(int k = 1;k <= n;k ++){
			if(k == i) continue;
			for(int j = n + 1;j >= i;j --){
				a[k][j] -= a[k][i] / a[i][i] * a[i][j];
			}
		}
	}
	for(int i = 1;i <= n;i ++){
		a[i][n + 1] /= a[i][i];
	}
	return true;
}
课后习题
习题1 [Non] 踩地雷II
我们发现正着做很麻烦,考虑倒退进行期望 DP。
习题2 P4035 [JSOI2008] 球形空间产生器
我们把这个题所表达是式子写出来,然后把这个式子进行消元,达到一个线性方程组,直接高斯消元即可。
习题3 P1297 [国家集训队] 单选错位
这个题比较妙,总题数的期望等于每道题目做对的概率之和。自己独立思考。
习题4 CF148D Bag of mice
这个题比较板,概率 DP 即可。
习题5 P1850 [NOIP 2016 提高组] 换教室
很好的概率题目,融合了很多算法,需要仔细分类讨论,好题!
第八讲 数位动态规划
数位动态规划介绍及常见技巧
数位和统计
当我们计算 \([1000, 4321]\) 中的数位和,我们将共分解为
对于前面三个区间,我们可以在常数时间内计算数位和。我们可以进一步将最后一个区间分解为
以此类推,我们每次用常数时间解决前面的区间,并且将最后一个区间不断划分,我们可以得到如下的区间划分:
我们可以看到,我们每一轮操作都按从左到右的顺序固定了一个数位,用常数时间计算出严格小于已固定数位的数的数位和,并且将问题规模缩小 \(1\)。由于 \(4321\) 只包含四个数位,我们只需要这样操作 \(4\) 轮就能计算出答案。
数位动态规划问题
数位动态规划是一种常见的动态规划模型。数位动态规划的题型往往为:给定一个区间 \([L, R]\),计算在这个区间中满足条件 \(P\) 的正整数的权值和。
如果我们将刚才的问题进行简单的推广,可以发现其实就是一道数位动态规划问题:在 \(L\) 到 \(R\) 之间,计算所有整数的 \(k\) 进制表示下各数位之和。这里,条件对于所有正整数都成立(即无条件),一个正整数的权值为它在 \(k\) 进制下的各数位之和。
常用技巧
首先,我们可以观察到一个结论:由于我们计算的是区间中满足条件的数的权值和,我们可以将区间问题转化为前缀问题。
假设我们给定的区间为 \([L, R]\),我们可以分别计算出在区间 \([0, L - 1]\) 和区间 \([0, R]\) 上满足条件的整数权值和,用 \(S_1\) 和 \(S_2\) 表示
那么在 \([L, R]\) 上满足条件的整数权值和即为 \(S_2 - S_1\)。
事实上,我们在之前的算法学习中,已经多次使用到了将区间问题转化为前缀问题的思想,例如树状数组等。
这种转化的好处是将两个限制 \(\ge L\) 和 \(\le R\) 转化为了一个限制 \(\le R\)。这样,我们可以专注于讨论小于某一个上界的整数的一些性质。
通过上述简化,我们求解小于 \(n\) 且满足条件 \(P\) 的正整数的权值和。
对于一个小于 \(n\) 的数,它从高到低必定出现某一位,使得这一位上的数字小于 \(n\) 对应位置上的数字,并且这一位之前的数字都和 \(n\) 中对应的位置相等,这一位之后的数字的选取没有限制。事实上,一开始题目的区间划分就用到了这个思想。
有了这个分析,我们定义 \(f[i][st][op]\) 为目前考虑数字从高到低第 i 位,当前前缀(即枚举到前 i−1 位)的“状态”为 \(st\),且当前考虑的数字与 \(n\) 的“大小关系”为 op∈{0,1}。
其中,“状态”指从第一位到第 \(i−1\) 位对于计算第 \(i\) 位所需要的信息。数位动态规划中常见的“状态”有前缀的数字和,前缀数字的最大公约数(GCD),前缀数字取模后的值,等等。
\(op=1\) 表示当前数字等于\(n\),那么当前能取到的最高位不能超过 \(n\) 对应的位置;而 \(op=0\) 则表示当前数字已经小于 \(n\),那么当前能取到的最高位没有限制。
我们的状态设计为 \(f[i][st][op]\) 为目前考虑数字从高到低第 \(i\) 位,当前前缀(即枚举到前 \(i-1\) 位)的“状态”为 \(st\),且当前考虑的数字与 \(n\) 的“大小关系”为 \(op \in \{0, 1\}\)。
有了这个状态设计,我们可以写出数位动态规划通用的状态转移方程:
这里 \(k\) 是枚举下一位的值,\(max\) 是当前位能取到的最高位。如果 \(op = 1\),那么 \(max\) 即为 \(n\) 对应位置上的数;否则 \(max\) 为当前进制下的最大数位。\(P(st, k)\) 表示当前位 \(k\) 和前 \(i-1\) 位的状态 \(st\) 是否满足条件 \(P\)。
示例代码:
// n[i] 倒序储存(低位到高位)
int dp(int i, int st, int op) {
    if (i == -1) {
        return __BASE__;  // __BASE__ 为边界条件的答案
    }
    if (f[i][st][op] != -1) {
        return f[i][st][op];  // 记忆化
    }
    int max = op ? n[i] : 9;
    int ans = 0;
    for (int k = 0; k <= max; k++) {
        if (!P(st, k)) continue;  // 判断 st 和 k 是否满足条件 P
        ans += dp(i - 1, __NEW_ST__,
                  op & (k == max));  // __NEW_ST__ 为包含第 k 位的新状态
    }
    f[i][st][op] = ans;
    return ans;
}
例题1 P2602 [ZJOI2010] 数字计数
沿用刚刚的思路,用 \(f[pos][sum][lim][zero]\) 表示状态,记忆化直接转移,最后利用前缀和计算出答案。
例题2 P13085 [SCOI2009] windy 数(加强版)
这个题目来说的话,就是正常的数位 DP,但是需要注意其不含前导零,而且相差 \(\ge 2\) 的条件需要满足。
数位 DP 求解回文数
例题3 B3883 [信息与未来 2015] 求回文数(加强版)
对于位数小于 len 的数字,直接利用回文数的构造公式计算。对于 \(i\) 位的回文数,只需确定前 \(\lceil \frac{i}{2} \rceil\) 位,其中首位不能为 0,故共有
个回文数。
也就是说这一部分是不需要我们做的,直接用公式算即可,那么对于位数dengyu len 的呢?
我们采用数位 DP 的方式,我们设 \(f[pos][lim]\) 表示在第 pos 个位置,是否有限制的答案。
那么我们想一想,我们只需要枚举到 \(\lceil n \rceil\) 的位置,那么,既然是回文的后面只需要填上就行了,我们只需要判断直接的这种填法是否合法即可。
数位 DP 的另一种看待方式
我们在这里考虑 \(0\) 到 \(2^4 - 1 = 15\) 之间的所有二进制数:
如果我们将这些二进制数用类似字典树的方式构造出一棵 \(01\) 字典树,我们将得到如下一棵高度为 \(4\) 的满二叉树。
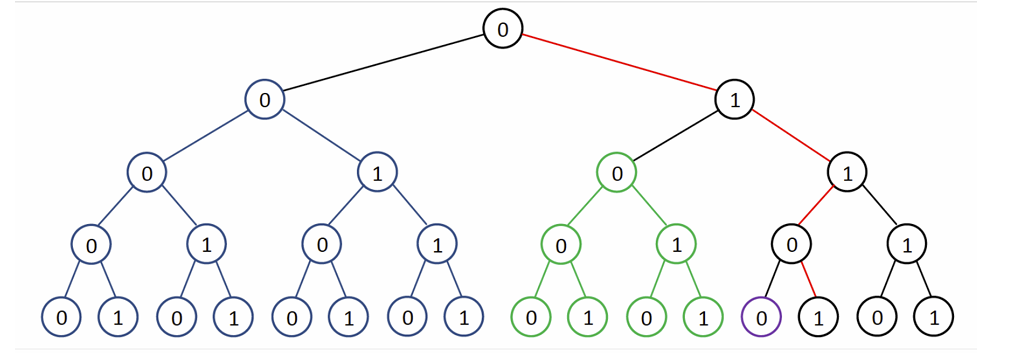
这棵高度为 \(4\) 的满二叉树可以表示所有 \(4\) 位的二进制数 \((0 \dots 2^4 - 1)\),每个叶子节点代表一个数。
考虑之前我们学到的一个小技巧:将 \([A, B]\) 区间拆分成两个前缀区间 \([0, B]\) 和 \([0, A - 1]\)。因此,我们来考虑小于 \(n\) 的所有二进制数在这棵树上是如何表示的。我们统计小于 \(13\) 的数,由于我们是按照字典树的方式构造这棵二叉树的,并且 \(13 = 1101_2\),图中红色的路径代表数字 \(13\)。
通过简单的观察我们可以发现,小于 \(13\) 的数被分成了三棵满二叉树,根节点分别为 \(0\),\(10\) 和 \(1100\),在上图中分别用蓝色、绿色和紫色标注。因此假如我们需要统计小于 \(13\) 的树中满足某些条件的数字个数,我们只需要分别统计这三棵满二叉树即可。
通过进一步我们观察可以发现,这三棵满二叉树的根节点代表的前缀都是以 \(0\) 结尾的。这意味着这三棵满二叉树是由红色路径“右转”时“左转”得到的。那么我们可以在假想的二叉树中从根节点走到 \(n\) 所在的叶子结点,每次在路径右转时统计左子树的信息,累加即可。
事实上,这三棵满二叉树恰好把小于 \(13\) 的二进制树划分成了三个区间
这和我们最开始的区间划分的思想不谋而合。
通常情况下,我们不实际构造出这棵二叉树,而更多的是把二叉树作为一种思考的过程,来辅助设计递推表达式和状态转移方程。对于其他进制的问题,我们可以把满二叉树变成满 \(k\) 叉树进行求解,思想和二进制是一样的。
例题4
求给定区间 \([X,Y]\) 中满足下列条件的整数个数:这个数恰好等于 \(K\) 个互不相等的 \(B\) 的整数次幂之和。
首先我们观察得到一个重要转化:所求的数为互不相等的幂之和,即其 \(B\) 进制表示中各位上的数字只能是 \(0\) 和 \(1\)。我们首先考虑二进制;我们考虑统计小于 \(n\) 的二进制数中含 \(k\) 个 \(1\) 的数字个数。这里我们使用了常见技巧:将区间拆分为两个前缀区间之差。
我们画出假想的二叉树。这里,我们使用刚才讲解时同样的图:一棵高度为 \(4\) 的满二叉树。
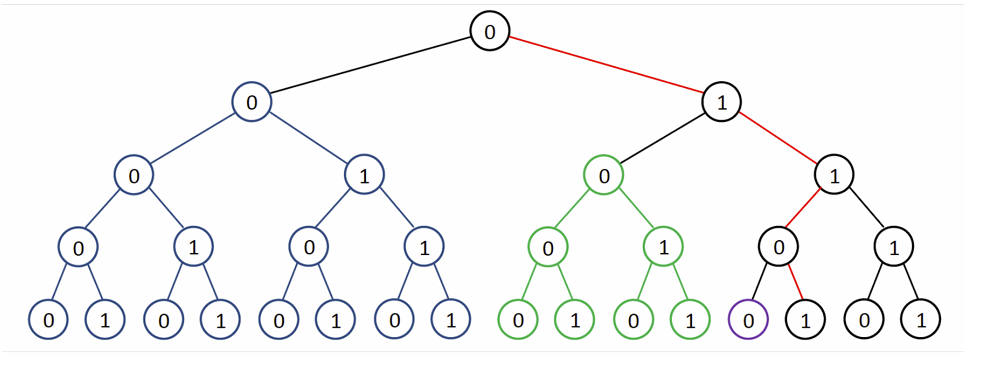
如果我们统计小于 \(13\) 的树中含 \(3\) 个 \(1\) 的数字个数,我们只需要统计三棵满二叉树。需要注意,我们需要减去红色路径上已经经过的 \(1\) 的个数。因此,我们统计蓝色满二叉树中含 \(3\) 个 \(1\) 的数字个数、绿色满二叉树中含 \(2\) 个 \(1\) 的数字个数,以及紫色满二叉树中含 \(1\) 个 \(1\) 的数字个数。
我们需要统计 \(n = 13\) 本身。因此,一个常见的技巧是将 \(n\) 加上一,统计小于 \(n + 1\) 的树中含 \(k\) 个 \(1\) 的数字个数。
注意到高度相同的树的统计结果相同。因此,我们将问题化简为了:统计一棵高度为 \(i\) 的完全二叉树中二进制表示中恰好含有 \(j\) 个 \(1\) 的数字个数。
我们可以用递推求解。令 \(f[i, j]\) 表示高度为 \(i\) 的完全二叉树中二进制表示中恰好含有 \(j\) 个 \(1\) 的数字个数。那么我们分别统计左子树和右子树中二进制表示中恰好含有 \(j\) 和 \(j - 1\) 个 \(1\) 的数字个数,因为左子树根节点为 \(0\),而右子树的根节点为 \(1\)。同时注意到左右子树的高度较原树减一。于是我们得到
如果我们单纯从数位“逐位确定”的角度进行思考,对于询问 \(n\),我们找到一个等于 \(1\) 的数位,将它赋为 \(0\),那么它右边的数位可以任选。我们需要统计其中恰好有 \(K - \ell\) 个 \(1\) 的数字个数,其中 \(\ell\) 表示左边的 \(1\) 的个数。那么我们可以用组合数公式进行求解。
我们发现我们之前用树来帮助我们思考的时候推导出的 \(f[i, j]\) 也是组合数,这说明了两种方法本质上是一样的。
示例代码:
int solve(int x, int k){
    int ans = 0, cnt = 0;
    for(int i = 31;i > 0;i --){
        if(x & (1 << i)){
            x ^= 1 << i;
            cnt ++;
            if(cnt > k){
                break;
            }
        }
        if((1 << (i - 1)) <= x){
            ans += f[i - 1][k - cnt];
        }
    }
    if(cnt + x == k){
        ans ++;
    }
    return ans;
}

int change(int x, int b) {
    int ans = 0;
    int a[32], p = 0;
    while (x) {
        a[p++] = x % b;
        x /= b;
    }
    int i;
    for (i = p - 1; i >= 0; i--) {
        if (a[i] == 1) {
            ans |= 1 << i;
        } else if (a[i] > 1) {
            break;
        }
    }
    if (i >= 0) {
        ans |= (1 << (i + 1)) - 1;
    }
    return ans;
}
课后习题
习题1 P6218 [USACO06NOV] Round Numbers S
这个题目可以说是数位 DP 的板子了,自己来验证一下自己会不会。
习题2 UVA1640 统计问题 The Counting Problem
这个题就纯统计数位,只需要把 \(0 \sim 9\) 每一种都去统计一次即可。
习题3 P4999 烦人的数学作业
这次不统计数位和了,只统计和,那么只需要改一下记录答案的方式即可。
习题4 P4317 花神的数论题
在二进制下做这个题,然后保证选来的合法即可,注意累计答案是相乘。
第九讲:动态规划的数据结构优化
序列动态规划引入
序列动态规划一般指问题背景为序列的题目,在这种题目中一般转移数组只有一维的状态,并常用 \(f[i]\) 来表示前 \(i\) 个数字所组成的答案。如果我们想要计算出 \(f[i]\) 的值就需要找到一些满足一定条件的 \(j\),用 \(f[j] + x\) 来更新 \(f[i]\) 的值,
我们看一个简单的例子:
给你三个长度为 \(n\) 的数组:\(a\), \(l\), \(r\)。并且定义转移方程:\(f[0] = 0, f[i] = a[i] + f[l[i]] + f[l[i] + 1] + \dots + f[r[i] - 1] + f[r[i]], i > 0\)。并且保证 \(1 \le l[i] \le r[i] < i\)。
让你快速计算 \(f\) 数组,同学们可以想一想该如何计算。
最朴素的方式就是我们通过双重 for 循环来处理:
C++
for (int i = 1; i <= n; ++ i) {
    f[i] = a[i];
    for (int j = l[i]; j <= r[i]; ++ j) {
        f[i] += f[j];
    }
}
虽然这份代码可以完成题目中的要求,但是它的复杂度过高,我们可以有更快的算法做到相同的事情。
注意代码的 \(3\) 到 \(5\) 行,这段代码实际上就是在求解 \(f\) 数组中 \([l[i], r[i]]\) 这个区间内所有元素的和,如果我们提前维护 \(f\) 数组的前缀和 \(sum\),就可以直接通过前缀项相减方式来得到这个区间内所有的元素和,并且时间复杂度仅为 \(O(1)\),比之前的 \(O(n)\) 要快很多。
也就是说我们可以将上面的代码改写为:
for (int i = 1; i <= n; ++ i) {
    f[i] = a[i] + sum[r[i]] - sum[l[i] - 1];
    sum[i] = sum[i - 1] + f[i];
}
这样总体复杂度就降到了 \(O(n)\),我们付出的不过是多一个数组带来的内存开销。
最长上升子序列优化
例题1
给定一个长度为 \(n\) 的整数序列 \(a_1, a_2, \dots, a_n\),以及一个整数 \(d\)。
你需要从该序列中挑选出一个子序列(不一定连续),使得该子序列中相邻两个元素的绝对值之差不超过 \(d\)。
我们首先不能用 \(\mathcal{O}(n ^ 2)\) 的暴力 DP,我们可以尝试用线段树来维护数值在 \([a[i]-d, a[i]+d]\) 范围内的最大 DP 值,每次转移的时候直接在线段树上查询即可,这样的复杂度直接由 \(\mathcal{O}(n) \to \mathcal{O}(\log n)\)。
LCS 最长公共子序列优化
引入
LCS(最长公共子序列)问题我们在动态规划里面已经接触过了。
假设两个字符串的长度分别为 \(n_1\) 和 \(n_2\),用 \(dp[i, j]\) 表示 \(s_1[0 \dots i]\) 和 \(s_2[0 \dots j]\) 的最长公共子序列。
转移方程如下
可见这是一个 2D/0D 的动态规划问题。
优化
我们考虑一种特殊情况下的 \(LCS\),给出 \(1 \dots n\) 的两个排列 \(P_1\) 和 \(P_2\),求 \(P_1\) 和 \(P_2\) 的 \(LCS\)。
考虑刚才的转移,我们发现,只有 \(P_1[i] = P_2[j]\) 的时候才会使得长度加 \(1\),我们考虑转移变成如下
由于是排列,对于一个 \(i\),能发生转移的 \(j\) 必然是固定的,我们用 \(pair[i]\) 表示 \(P_1[i] = P_2[pair[i]]\)。
我们按照 \(i\) 从小到大扫描 \(P_1\),对于前面求出的 \(dp\) 值的匹配对 \([i', pair[i']]\),必然满足 \(i' < i\),所以我们只需要求出 \(pair[i'] < pair[i]\) 中的匹配对的最大值。而这正好可以用线段树或树状数组来维护。
什么意思呢?
假设有两个 \(1 \dots 5\) 的排列:
第一步:给 \(P_1\) 的每个数字“发编号”
既然是排列,每个数字都是唯一的。我们把 \(P_1\) 当成参照标准,记录每个数字在 \(P_1\) 里的位置索引:
数字 \(3\) 在第 \(1\) 位
数字 \(2\) 在第 \(2\) 位
数字 \(1\) 在第 \(3\) 位
数字 \(4\) 在第 \(4\) 位
数字 \(5\) 在第 \(5\) 位
我们可以用一个数组 \(pos\) 存下来:\(pos[3]=1, \ pos[2]=2, \ pos[1]=3, \ pos[4]=4, \ pos[5]=5\)。
第二步:把 \(P_2\) 里的数字“翻译”成位置
现在我们观察 \(P_2 = \{1, 2, 3, 4, 5\}\)。我们将 \(P_2\) 里的每一个数字,替换为它在 \(P_1\) 中出现的位置:
第一个数是 \(1\),它在 \(P_1\) 里是第 3 位。
第二个数是 \(2\),它在 \(P_1\) 里是第 2 位。
第三个数是 \(3\),它在 \(P_1\) 里是第 1 位。
第四个数是 \(4\),它在 \(P_1\) 里是第 4 位。
第五个数是 \(5\),它在 \(P_1\) 里是第 5 位。
于是,\(P_2\) 就被“翻译”成了一个新序列:$$S = {3, 2, 1, 4, 5}$$
如果你在序列 \(S\) 中选出的数字是递增的(例如选了 \(\{1, 4, 5\}\)),那么:
在 \(P_2\) 中:因为我们是按顺序从左往右扫描 \(S\) 提取数字的,这些数字在 \(P_2\) 原本的相对位置一定是递增的。
在 \(P_1\) 中:因为 \(S\) 中的数值代表的是 \(P_1\) 的下标。如果选出的数值递增(例如 \(1 < 4 < 5\)),意味着这些数字在 \(P_1\) 中的原始位置也是递增的。
既然这些数字在 \(P_1\) 和 \(P_2\) 中的位置都是递增的,它们就构成了一个公共子序列。因此,求 \(S\) 的 LIS(最长递增子序列) 等价于求 \(P_1\) 和 \(P_2\) 的 LCS(最长公共子序列)。
示例代码:
int lowbit(int x) {
    return x & (-x);
}
void update(int x, int v) {
    for (int i = x; i <= n; i += lowbit(i)) {
        C[i] = max(C[i], v);
    }
}
int getmax(int x) {
    int res = 0;
    for (int i = x; i > 0; i -= lowbit(i)) {
        res = max(res, C[i]);
    }
    return res;
}
for(int i = 1;i <= n;i ++){
    cin >> p1[i];
}
for(int i = 1;i <= n;i ++){
    cin >> p2[i];
    pos[p2[i]] = i;
}
for(int i = 1;i <= n;i ++){
    dp[i] = getmax(pos[p1[i]] - 1) + 1;
    update(pos[p1[i]], dp[i]);
}
int ans = 0;
for(int i = 1;i <= n;i ++){
    ans = max(ans, dp[i]);
}
cout << ans;
LIS 最长上升子序列优化
引入
一个序列的 子序列 指的是从这个序列中取出若干元素,他们的相对位置不变时组成的序列。
如果一个子序列满足每个元素都大于等于它之前的元素,则称其为 上升子序列,或 不降子序列,若全取大于,则称为 严格上升子序列。
比如序列 \(1, 3, 2, 3, 4, 5\) 中:\(1, 3, 3, 5\) 是它的上升(不降)子序列;\(1, 3, 4\) 是它的严格上升子序列;\(1, 3, 2\) 是它的子序列,但不是上升子序列;\(1, 4, 3\) 不是它的子序列。
在一个序列的所有上升子序列中,元素个数最多的称为它的 最长上升子序列,最长上升子序列的个数 \(\ge 1\)。
一般最长上升子序列指的是严格上升子序列。
优化
在序列 \(\{a_i\}\) 中,设 \(f_i\) 表示以 \(a_i\) 为结尾的最长上升子序列的长度。
以 \(a_i\) 为结尾的上升子序列有两种:序列中只含 \(a_i\),或者满足 \(j < i, a_j < a_i\) 的上升子序列末尾加上 \(a_i\) 得到的新序列。
那么容易得到如下状态转移方程:
时间复杂度为 \(O(n^2)\)。
在很多情况下,我们发现 \(O(n^2)\) 的时间复杂度并不能满足要求,于是我们希望有更快的方法来求最长上升子序列。
回想之前的方法,可以发现,在寻找满足条件的最优的 \(j\) 时耗费了大量时间,每一步都要花费 \(O(n)\) 的时间查找,效率并不高。
观察 \(f\) 和 \(a\) 数组,可以知道,所有的 \(f_i = x\) 中,\(a_i\) 组成的序列一定是单调不增的。
可以用反证法证明:假设有 \(f_i = f_j\) 且 \(a_j < a_i, j < i\),那么 \(f_j\) 可以转移到 \(f_i\),即 \(f_i > f_j\),与条件矛盾。
所以我们可以记录 \(g_x\) 表示 \(f_i = x\) 中最后一个 \(i\) 所对应的 \(a_i\),也就是最小的 \(a_i\),显然 \(\{g_x\}\) 是单调递增的。
转移时,我们可以在 \(g\) 数组中进行二分查找,找到比 \(a_i\) 小的最大的 \(g_j\),然后用 \(j + 1\) 更新 \(f_i\),并用 \(f_i\) 更新 \(g_{j+1}\)。
时间复杂度为 \(O(n \log n)\)。
示例代码:
for (int i = 1; i <= n; i++) cin >> a[i];
memset(g, 0x3f, sizeof(g));
g[0] = 0;
ans = 0;
for(int i = 1;i <= n;i ++){
    f[i] = lower_bound(g + 1, g + ans + 1, a[i]) - g;
    g[f[i]] = a[i];
    ans = max(ans, f[i]);
}
cout << ans;
单调队列优化 DP
引入
单调队列就是可以处理滑动窗口的问题的工具,使得快速算出一个窗口内的最值。
例题
问题是:有 \(N\) 只奶牛排成一排,每只奶牛有一个效率值 \(E_i\)。我们需要选择一些奶牛让它们工作,但不能有超过 \(K\) 只连续的奶牛一起工作,否则它们会罢工。我们的目标是最大化选中奶牛的总效率。
如果要满足“不能有超过 \(K\) 只连续”,等价于“在任何 \(K+1\) 只连续的奶牛中,至少要有一只不干活”。
为了求最大效率,我们先求最小损失。
设 \(dp[i]\) 表示:强制第 \(i\) 只奶牛不干活时,前 \(i\) 只奶牛损失的最小效率总和。
既然第 \(i\) 只不干活,那么为了满足条件,在它之前的 \(K+1\) 个位置里(即 \([i-K-1, i-1]\)),必须也至少有一个人不干活。
解释:我们要从前面找一个已经处于“不干活”状态的 \(j\),且 \(i\) 和 \(j\) 之间的距离不能超过 \(K\)(否则中间干活的人就超过 \(K\) 个了)。
朴素转移:每次算 \(dp[i]\) 都要扫一遍前面的 \(K\) 个数,复杂度 \(O(NK)\)。
单调队列优化:观察方程,我们其实是在求一个滑动窗口 \([i-K-1, i-1]\) 内的最小值。
我们可以维护一个单调递增的队列。
每次移动 \(i\) 时,把过期的 \(j\) 弹出,把新的 \(dp\) 值塞进去。
这样每次获取 \(\min\) 只需 \(O(1)\),总复杂度降为 \(O(N)\)。
示例代码:
q.push_back(0);
for(int i = 1;i <= n;i ++){
    while(!q.empty() && q.front() + k < i) q.pop_front();
    f[i] = f[q.front()] + e[i];
    while(!q.empty() && f[q.back()] > f[i]){
        q.pop_back();
    }
    q.push_back(i);
}
long long dec = 1LL << 60;
for(int i = 0;i < k;i ++){
    dec = min(dec, f[n - i]);
}
cout << sum - dec;
单调队列优化多重背包
引入
多重背包问题是一个经典动态规划问题:
有 \(N\) 种物品和容量为 \(V\) 的背包,若第 \(i\) 种物品,体积为 \(v_i\),价值为 \(w_i\),共有 \(c_i\) 件,怎样装才能使背包内的物品总价值最大?
有一个常见的动态转移方程如下:
其中 \(f_{i,j}\) 表示前 \(i\) 种物品消耗了 \(j\) 的体积所得的最大总价值。
直接进行转移的时间复杂度是 \(O(NV \sum c_i)\)。
优化
当我们计算 \(j\) 时,它只和 \(j - w, j - 2w \dots\) 这些同余的项有关。
我们将背包容量 \(j\) 按照对物品重量 \(w\) 的余数 \(r\) 分成 \(w\) 组。
例如 \(w=3\),容量可分为:
组 0: \(0, 3, 6, 9 \dots\)
组 1: \(1, 4, 7, 10 \dots\)
组 2: \(2, 5, 8, 11 \dots\)
在每一组内,转移方程可以改写。设 \(j = q \cdot w + r\),则:
注意, 这里的 \(\max\) 部分,其实就是在维护一个长度为 \(c+1\) 的滑动窗口的最值。
这样一来,这一部分的时间复杂度就降到了 \(\mathcal{O}(V)\)。
示例代码:
for(int i = 1;i <= n;i ++){
    for(int b = 0;b < v[i];b ++){
        deque<pair<long long, int>> q;
        for(int x = 0;b + x * v[i] <= m; x ++){
            long long tmp = f[i - 1][b + x * v[i]] - x * w[i];
            while(!q.empty() && q.back().first <= tmp) q.pop_back();
            while(!q.empty() && q.front().second < x - c[i]) q.pop_front();
            q.push_back({tmp, x});
            f[i][b + x * v[i]] = q.front().first + x * w[i];
        }

    }
}
字典树优化 DP
例题2
给出一个由 \(n\) 个不同单词组成的字典 \(S\) 和一个长字符串 \(T\)。把这个字符串分解成未若干个单词的连接(单词可以重复使用),有多少种不同的方法?比如,有 \(4\) 个单词,"a","b","cd","ab"。则 "abcd" 有两种分解方法:"a" + "b" + "cd" 和 "ab" + "cd"。
保证单词个数 \(n \le 500\)。每个单词由不超过 \(100\) 个小写字母组成。
这个问题很容易用动态规划来解决。我们用 \(dp[i]\) 表示 \(T\) 前面 \(i\) 个长度的方案数。
对于所有的 \(j (j < i)\),如果 \(T_{j \dots i}\) 是一个单词,就有转移
这样的代码写出来大概是这样
for (int i = 1; i <= n; ++i) {
    for (int j = 1; j <= i; ++j) {
        if (isword(j, i)) {
            // 如果是单词
            dp[i] += dp[j - 1];
        }
    }
}
isword 如果是用暴力比对的方式,时间复杂度会很高。我们考虑把字典 \(S\) 建立成一棵字典树,这样每次能够快速的判断一个单词是否出现。
我们考虑枚举串 \(T\) 的起点为 \(i\),然后令串 \(T\) 从 \(i\) 开始在字典树上查询。这样,当我们沿着字典树走到一个单词结点的时候,就相当于找到了一个转移。由于每个单词最长只有 \(100\),所以最长只会走到字典树中深度为 \(100\) 的位置。
示例代码:
void find(int st) {
    int p = 0;
    for (int i = st; T[i]; ++i) {
        if (ch[p][T[i] - 'a'] == -1) {
            return;
        }
        p = ch[p][T[i] - 'a'];
        if (cnt[p]) {
            // 如果是一个单词
            dp[i] += dp[st - 1];
        }
    }
}
第十讲:动态规划的决策优化
四边形不等式
四边形不等式
若 \(w[i, j]\) 满足
则称 \(w\) 满足四边形不等式。
之所以称为四边形不等式,可以用如下图来形象化理解。四边形 \(ABCD\) 中,对角线 \(AC\) 端点的权值之和不大于对角线 \(BD\) 端点的权值之和。
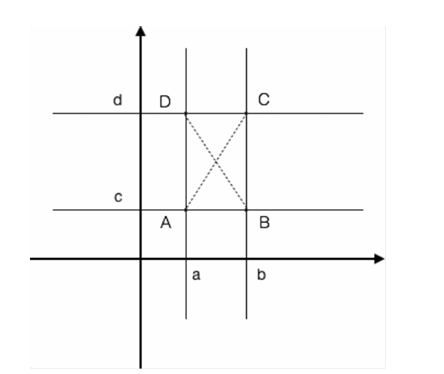
为了判断 \(w[i, j]\) 是否满足四边形不等式。有几个简单的方法。
证明 \(w[i, j] + w[i + 1, j + 1] \le w[i + 1, j] + w[i, j + 1]\)。
固定一个 \(j\) 算出 \(w[i, j + 1] - w[i, j]\) 关于 \(i\) 的表达式,如果是关于 \(i\) 递减的,那么 \(w[i, j]\) 满足四边形不等式。同样也可以固定 \(i\)。
区间包含的单调性
若 \(w[i, j]\) 满足 \(w[a, d] \ge w[b, c] (a \le b \le c \le d)\),则称 \(w\) 关于区间包含关系单调。
可以看作长区间的值大于等于它包含的短区间的值。
四边形不等式证明
定理一
在之前的动态转移方程中,如果 \(w\) 满足四边形不等式和区间包含关系单调,则 \(f\) 也满足四边形不等式。
证明:
不妨设 \(a < b < c < d\)。下证 \(f(a, d) + f(b, c) \geq f(a, c) + f(b, d)\)。考虑依 \(d - a\) 归纳,当 \(a = b\) 或 \(c = d\) 时,所求即一等式。对于一般的情形,根据 \(d' = \text{opt}(a, d)\) 的位置分类讨论。
第一种情况: \(c \leq d'\) 或 \(d' < b\)
即 \([b, c]\) 包含于 \([a, d']\) 或 \([d' + 1, d]\) 之中。
不妨假设 \(c \leq d'\),另一种情形同理,此时有:
这里,第一个不等式来自于归纳假设 \(f(a, c) + f(b, d') \leq f(a, d') + f(b, c)\),第二个不等式来自于区间包含单调性 \(w(b, d) \leq w(a, d)\),第三个不等式来自于最优性条件 \(f(b, d) \leq f(b, d') + f(d' + 1, d) + w(b, d)\)。
第二种情况: \(b \leq d' < c\)
即 \(d'\) 位于 \([b, c]\) 之中。此时,考虑 \(c' = \text{opt}(b, c)\) 的位置。
不妨假设 \(c' \leq d'\),即 \([b, c']\) 包含于 \([a, d']\) 之中。另一种情形同理,此时有
定理二
\(dp\) 满足四边形不等式的情况下,若 \(dp[i, j]\) 的最优决策位置 \(k = s[i, j]\),则 \(s[i, j - 1] \leq s[i, j] \leq s[i + 1, j]\)。
证明:
记 \(F[k, i, j] = dp[i, k] + dp[k + 1, j] + w[i, j]\),
记 \(x = s[i, j - 1], i \leq y \leq x\),
那么需要证明 \(F[x, i, j] \leq F[y, i, j]\)。
由于 \(F[x, i, j - 1] \leq F[y, i, j - 1]\)
故证明 \(0 \leq F[y, i, j - 1] - F[x, i, j - 1] \leq F[y, i, j] - F[x, i, j]\) 即可,
可以发现右边相当于
由于 \(dp\) 满足四边形不等式,故上式成立。
同理可以证明 \(x = s[i + 1, j], y \in (x, j)\) 的情况。
应用
有了这个结论以后,状态转移方程等价于
由于动态规划的阶段是 \(l = j - i\),所以在求 \(dp[i, j]\) 的时候,\(s[i, j - 1]\) 和 \(s[i + 1, j]\) 必然已经求出了。通过这样缩小决策变量的枚举范围,从而进行优化。时间复杂度降低到 \(\mathcal{O}(n^2)\)。
可以证明,上面的转移的时间复杂度是 \(\mathcal{O}(n^2)\) 的。
例题1 COGS 4263. 石子合并II
对于石子合并,我们显然发现,合并的过程和代价函数都是符合四边形不等式的,那么对于这样类似有凸性的函数,我们发现对于最小值应该是在一部分小区间取得,由于 \(s[i][j - 1] \le s[i][j](k) \le s[i][j + 1]\),所以每次转移的时候记录决策点,下次直接用就行。
代码示例:
for(int l = 2;l <= n;l ++){
    for(int i = 1;i + l - 1 <= n;i ++){
        int j = i + l - 1;
        for(int k = K[i][j - 1];k <= K[i + 1][j];k ++){
            int t = dp[i][k - 1] + dp[k][j] + sum[j] - sum[i - 1];
            if(dp[i][j] > t){
                dp[i][j] = t;
                K[i][j] = k;
            }
        }
    }
}
例题2 P3195 [HNOI2008] 玩具装箱
我们可以想到这样的状态转移方程:
在这里,我们让 \(w(i, j) = (i - j + \sum_{k=j}^i C_k - L)^2\),经过分析可以发现,\(w(i, j)\) 满足四边形不等式和区间包含的单调性。
我们记录 \(opt_i\) 为使得 \(dp_j + w(j, i)\) 取得最小值的 \(j\),由四边形不等式我们可以知道,\(opt_i\) 是单调不下降的。
但是这样还是 \(\mathcal{O}(n ^ 2)\) 的。
所以我们得换个角度考虑问题。
在还没有进行任何状态转移的时候,\(opt_i = 0\)。此时我们计算 \(dp_1\) 的值,很明显 \(opt_1 = 0\),于是我们令 \(dp_1 = dp_0 + w(0, 1)\)。
这样 \(dp_1\) 求出来了,接下来我们就可以去看对于 \(2 \leq i \leq n\),有哪些满足
由于 \(opt\) 是一个单调不下降的序列,所以我们只需要找到最小的 \(i\) 满足刚才这个条件就可以。我们可以使用二分法去找到这个 \(i\)。找到这个 \(i\) 之后,去更新 \(opt\) 数组。
实际上把任意的 \(dp_j\) 求出来之后,我们都同样可以用二分法去找到一个最小的 \(i\),只不过满足的条件变成了这样:
方法有很多,比如你可以用线段树。这样在线段树上你需要进行两种操作:
- 区间修改成一个值。
- 单点查询。
示例代码:
LL W(int l, int r) {
    LL x = L - ((sum[r] - sum[l]) + (LL)(r - l - 1));
    return x * x;
}
bool check(int mid, int nn) {
    int u = query(1, 1, n, mid);
    return(dp[nn] + W(nn, mid)) <= (dp[u] + W(u, mid));
}
int main() {
    cin >> n >> L;
    for (int i = 1; i <= n; i++) {
        cin >> c[i];
        sum[i] = sum[i - 1] + c[i];
    }
    memset(dp, 0x3f, sizeof(dp));
    memset(cover, -1, sizeof(cover));
    dp[0] = 0;
    for(int i = 1;i <= n;i ++){
        int u = query(1, 1, n, i);
        dp[i] = dp[u] + W(u, i);
        int l = i + 1, r = n;
        while(l < r){
            int mid = (l + r) >> 1;
            if(check(mid, i)){
                r = mid;
            }
            else{
                l = mid + 1;
            }
        }
        if(!check(l, i)) l ++;
        if(l > n) continue;
        update(1, 1, n, l, n, i);
    }
    cout << dp[n];
    return 0;
}
斜率优化 DP
令 \(A_i = \text{sum}_i + i\),\(B_j = \text{sum}_j + j + L + 1\)。
展开转移方程,原始方程为:
将平方项展开:
变形为直线方程
为了找到最优的 \(j\),我们将只含 \(j\) 的项作为 \(y\) 和 \(x\),包含 \(i, j\) 乘积的项作为 \(kx\),包含 \(dp[i]\) 的项作为截距 \(b\):
对照 \(y = kx + b\),我们得到:
- \(y\) 坐标:\(Y(j) = dp[j] + B_j^2\)
- \(x\) 坐标:\(X(j) = B_j\)
- 斜率 \(k\):\(k_i = 2 A_i\)
- 截距 \(b\):\(b_i = dp[i] - A_i^2\)
对于一个固定的 \(i\),斜率 \(k_i = 2A_i\) 是常数。我们要最小化 \(dp[i]\),等价于最小化截距 \(b_i\)。
在坐标系中,这相当于拿一条斜率为 \(2A_i\) 的直线,从下往上平移,直到碰到由点 \(P_j(X_j, Y_j)\) 构成的集合。第一个碰到的点就是最优决策点。
接下来,只需要用单调队列维护斜率即可。
示例代码:
double X(int x) { return B[x]; }
double Y(int x) { return dp[x] + B[x] * B[x]; }
double slope(int a, int b){
    return ((Y(a) - Y(b)) / (X(a) - X(b)));
}
q.push_back(0);
for(int i = 1;i <= n;i ++){
    while(q.size() > 1 && slope(q[0], q[1]) < 2 * A[i]) q.pop_front();
    int j = q[0];
    dp[i] = dp[j] + ((A[i] - B[j])) * (A[i] - B[j]);
    while(q.size() > 1 && slope(i, q[q.size() - 2]) < slope(q[q.size() - 2], q[q.size() - 1])){
        q.pop_back();
    }
    q.push_back(i);
}
cout << (long long)dp[n];
例题2
有 \(n\) 台超电磁炮排列成一行,第 \(i\) 台超电磁炮的功率为 \(w_i\)。众所周知,超电磁炮之间存在电磁干扰。它们之间的干扰程度为 \(\sum_{i=1}^n \sum_{j=i+1}^n w_i \cdot w_j\)。
现在有 \(m\) 个电磁屏蔽装置,一个电磁屏蔽装置可以放置到两个相邻的超电磁炮中间,这样就可以阻止装置左边和右边的超电磁炮之间发生项目干扰。通过 \(m\) 个电磁屏蔽装置可以把超电磁炮个隔离成 \(m + 1\) 个干扰组。
输出最小干扰程度。
一个组内的干扰程度为 \(\sum_{i=1}^{n} \sum_{j=i+1}^{n} w_i \cdot w_j\)。为了实现 \(O(1)\) 计算任意区间 \([x, y]\) 的干扰,进行了如下推导:
令 \(a_i = \sum_{j=1}^i w_j\)。令 \(b_i = \sum_{j=1}^i (w_j \times a_j)\)。
区间代价 \(W(x, y)\),经过代数变形,区间 \([x, y]\) 的干扰程度为:
令 \(f_{i, j}\) 表示前 \(j\) 台电磁炮在拥有 \(i\) 个屏蔽装置(即分成 \(i+1\) 组)时的最小干扰程度。
状态转移方程为:
为了将方程转化为直线形式,我们展开转移方程中与 \(k\) 相关的项:
固定当前的组数 \(i\) 和位置 \(j\),我们将仅与决策点 \(k\) 相关的项移到等号左边:
对照直线方程 \(y = kx + b\):
- 纵坐标 \(y\):\(Y(k) = f_{i-1, k} + b_k\)
- 横坐标 \(x\):\(X(k) = a_k\)
- 斜率 \(k\):\(K = a_j\)
- 截距 \(b\):\(B = f_{i, j} - a_j^2 + b_j\)
第十一讲:数据结构与搜索优化
笛卡尔树
笛卡尔树是一种特殊的二叉树,它结合了二叉搜索树和堆的性质。具体来说,给定一个数组,我们可以构造一棵笛卡尔树,使其满足:
- 中序遍历(即左根右的遍历顺序)得到的序列正好是原数组(这相当于按数组下标构成一棵二叉搜索树)。
- 堆序性质:树中节点的值满足堆的性质(通常取最小值为堆顶,即小根堆),也就是说每个节点的值不大于其子节点的值。
简单理解:笛卡尔树以数组元素的顺序关系作为树的形状约束(按下标构成BST),以大小关系作为堆约束(最小值作为根)。这意味着数组中的最小元素将成为整棵笛卡尔树的根;数组被这个最小值分成左右两部分,递归在左右区间重复上述过程,建立左子树和右子树。这样构造出来的二叉树就是笛卡尔树。
从数学直觉看,笛卡尔树相当于将一个数组“堆化”。如果我们给每个元素赋予两个关键字:一个是它的下标(索引),一个是它的值。那么按下标看,它们应形成一棵二叉搜索树;按值看,它们应形成一棵堆。这两个条件唯一地确定了一棵笛卡尔树。这种树常用用来解决范围查询问题,例如RMQ(区间最小值查询),因为在笛卡尔树中两个下标之间的最小值节点正好是它们在树中的最近公共祖先节点。
性质:对于一个包含 \(n\) 个元素的数组,笛卡尔树是唯一的(假设不考虑相等元素的情况)。笛卡尔树的高度与数组的排列有关,最坏情况下可能退化为链(例如数组单调时)。但我们可以在线性时间内构建笛卡尔树,并且很好地应用于一些算法优化。
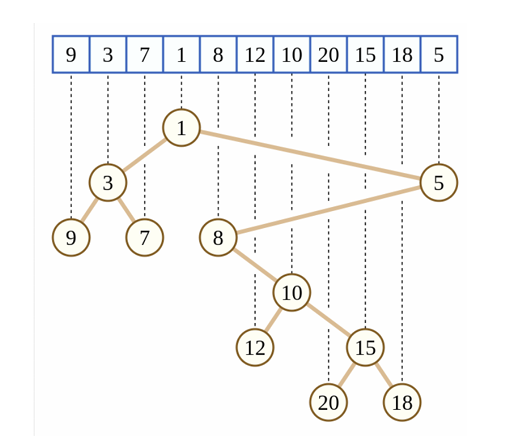
实际上我们的笛卡尔树跟 \(\mathtt{Treap}\) 很像,都是维护的二元的关系。
我们发现在笛卡尔树上,我们每次只需要维护一条右链,也就是一个递增的链,我们只需要用单调栈来维护这条链即可。
代码示例:
s.push(1);
for(int i = 2;i <= n;i ++){
    int last = s.top();
    while(!s.empty() && a[s.top()] > a[i]){
        last = s.top();
        s.pop();
    }
    if(s.empty()) l[i] = last;
    else{
        l[i] = r[s.top()];
        r[s.top()] = i;
    }
    s.push(i);
    rd[l[i]] ++;
    rd[r[i]] ++;
}
例题1 B4273 [蓝桥杯青少年组省赛 2023] 最大的矩形纸片
这个题目是笛卡尔树的经典应用,我们注意到一个矩形能往左右延伸的部分即为自己的子节点,那么只需要记录自己的子树大小即可,最终每一块矩形的最大并应当是 \(h[i] \times sz[i]\)。
珂朵莉树
珂朵莉树(Chtholly Tree),又称老司机树(Old Driver Tree,编写 ODT),是一种巧妙的数据结构,最早出现在 Codeforces 896C 问题中。它的核心思想是:将序列中相邻且数值相同的一段区间合并为一个节点,用一个平衡二叉搜索树(如 C++ 的 set)来维护这些区间节点,从而支持在序列上进行高效的区间操作。
换句话说,珂朵莉树并不像传统的树状数组或线段树那样有固定的结构,而是利用 STL 容器的红黑树特性,将序列划分成若干不相交的区间块,每个区间块里的所有值相同。对序列的区间操作(如赋值、加值等)会触发这些区间块的分裂或合并。由于平衡二叉树操作是对数时间的,且在随机数据情况下,分裂和合并的均摊复杂度很优(一般接近 \(\mathcal{O}(\log n)\)),因此珂朵莉树可以在一定概率范围内高效地维护序列区间。
关键想法: 为了维护区间,有两个重要操作需要实现:
- split(位置 pos):将 pos 所在的区间一分为二,使得 pos 成为一个新的区间的起点。这用于在操作边界处把一个区间断开。
- merge(相邻区间):当相邻区间的值相同时,就将它们合并为一个更大的区间。这用于在赋值操作后合并相同值的段。
通过 split,我们可以精确地定位一个操作影响的区间范围;通过 merge,我们保证相同值的区间不会被不必要地分割太细。
数学直觉: 珂朵莉树有点像以“值”为颜色,对数轴上的区间进行着色,并用集合保存那些“同色段”。每次如果要把一段区间重新染色(赋值操作)或增加某个值(加值操作),只需考虑这段区间涉及到的少数几个已有段,将它们在操作范围处切断,然后调整颜色(值)即可。这样操作的代价与当前段的数量成正比,如果数据比较随机,通常会保持在较低水平(远小于 \(N\))。
需要注意的是,珂朵莉树并不是严格意义上的平衡树结构,更像是一种 策略 + STL 封装的数据结构。它依赖于数据的随机性以获得较优的性能,在最坏情况下性能可能退化(例如每次操作都稍微修改数值导致无法合并,段的数量接近 \(N\))。但在竞赛和实际应用中,这种情况较少见或可以通过随机化避免。
假设有一个初始数组:\(A = [1, 1, 1, 2, 2, 3, 3, 3]\),我们用珂朵莉树来维护它,并进行一些区间操作:
初始时,各区间块为:\([1, 3]\) 值 \(= 1\)、\([4, 5]\) 值 \(= 2\)、\([6, 8]\) 值 \(= 3\)(用闭区间表示)。
操作 1:区间 \([2, 5]\) 所有数加上 1。
- 我们首先用 split 将区间在 2 和 5 处分割:原来的 \([1, 3]\) 在 2 处分为 \([1, 1]\) 值 \(= 1\) 和 \([2, 3]\) 值 \(= 1\);\([4, 5]\) 完全在操作区间内,无需分割。
- 这样精确锁定受影响的区间块为 \([2, 3]\)(值 1)和 \([4, 5]\)(值 2)。
- 对这些块每个元素加 1:于是 \([2, 3]\) 值变为 2、\([4, 5]\) 值变为 3。
- 更新后我们检查相邻区间是否可合并:现在区间 \([2, 3]\) 值 \(= 2\) 和 \([4, 5]\) 值 \(= 3\) 不同无法合并。
- 更新后的分段:\([1, 1]\) 值 \(= 1\)、\([2, 3]\) 值 \(= 2\)、\([4, 5]\) 值 \(= 3\)、\([6, 8]\) 值 \(= 3\)。
- 注意最后两个段 \([4, 5]\) 和 \([6, 8]\) 值都为 3,虽然值相同但不相邻(中间不连续),不能合并。
操作 2:区间 \([3, 7]\) 改成值 4(覆盖赋值操作)。
- 首先在 3 和 7 处分割现有段:目前段有 \([2, 3]\)、\([4, 5]\)、\([6, 8]\) 等,会被 split 成 \([2, 2]\) 值 \(= 2\)、\([3, 3]\) 值 \(= 2\)、\([4, 5]\) 原本整个在区间内无须切,\([6, 7]\) 值 \(= 3\) 和 \([8, 8]\) 值 \(= 3\)。
- 然后将 \([3, 3]\)、\([4, 5]\)、\([6, 7]\) 这些覆盖范围内的段的值直接改为 4。
- 这些段修改后变成 \([3, 3]\) 值 \(= 4\)、\([4, 5]\) 值 \(= 4\)、\([6, 7]\) 值 \(= 4\)。
- 最后合并相邻同值段:这三个段其实现在可以合并成一个 \([3, 7]\) 值 \(= 4\) 的段。
- 合并时也要注意与左右相邻段:左边 \([2, 2]\) 值 \(= 2\),不同值不合并;右边 \([8, 8]\) 值 \(= 3\),不同值不合并。
- 更新后的分段:\([1, 1]\) 值 \(= 1\)、\([2, 2]\) 值 \(= 2\)、\([3, 7]\) 值 \(= 4\)、\([8, 8]\) 值 \(= 3\)。
通过上述操作,我们看到每次区间操作实际修改的只是涉及的少数几个段,并进行有限分裂和合并。 相比直接对数组每个元素修改,效率提高明显。
代码示例:
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const ll MOD = 1000000007;
const ll N = 100005;
struct Node {
    mutable ll l, r, v;
    bool operator<(const Node &a) const {
        return l < a.l;
    }
};
ll n, m, vmax, a[N];
set<Node> s;
auto split(int pos) {
    auto it = s.lower_bound({pos, 0, 0});
    if(it != s.end() && it -> l == pos){
        return it;
    }
    it --;
    if(it -> r < pos) return s.end();
    ll l = it -> l, r = it -> r, v = it -> v;
    s.erase(it);
    s.insert({l, pos - 1, v});
    return s.insert({pos, r, v}).first;
}
void add(ll l, ll r, ll x) {
    auto itr = split(r + 1), itl = split(l);
    for(auto it = itl;it != itr;it ++){
        it -> v += x;
    }
}
void assign(ll l, ll r, ll x) {
    auto itr = split(r + 1), itl = split(l);
    s.erase(itl, itr);
    s.insert({l, r, x});
}
struct Rank {
    ll num, cnt;
    bool operator<(const Rank &a) const {
        return num < a.num;
    }
};
ll rnk(ll l, ll r, ll x) {
    auto itr = split(r + 1), itl = split(l);
    vector<Rank> v;
    for(auto i = itl;i != itr;i ++){
        v.push_back({i -> v, i -> r - i -> l + 1});
    }
    sort(v.begin(), v.end());
    int i;
    for(i = 0;i < v.size();++ i){
        if(v[i].cnt < x) x -= v[i].cnt;
        else break;
    }
    return v[i].num;
}
int main() {
    int op, l, r, x;
    cin >> n >> m;
    for (int i = 1; i <= n; i++) {
        cin >> a[i];
        s.insert({i, i, a[i]});
    }
    while (m--) {
        cin >> op >> l >> r >> x;
        if (op == 1) add(l, r, x);
        else if (op == 2) assign(l, r, x);
        else cout << rnk(l, r, x) << ' ';
    }
    return 0;
}
应用场景
珂朵莉树适用于需要大量区间修改且数据分布较随机的情形,常见的应用包括:
区间赋值/加值及查询:如维护一个序列,有操作将某区间全部改为某值,或在某区间每个元素上加一个值,或查询某区间的统计信息(如第 k 小、区间和等)。 传统线段树处理赋值需要 lazy 标记或拆分,而珂朵莉树直接用合并+分裂维护区间,灵活性更高。 在 Codeforces 896C 问题中,就需要支持上述三种操作。
随机场景模拟:一些仿真的场景下,若修改往往发生在随机位置,ODT 能够高效运行。 例如维护一个充电桩网络,连续区间充电功率相同,当某段需要调节功率时,只影响毗邻的区段。
基于值分段的优化:当我们只关心序列中段的变化,而不是每个点的变化时,ODT 提供了一种处理视角。 例如“颜色分段”问题:有一长串元素初始都有颜色 0,随后有若干操作把某些区间染成某种颜色,问最后形成了多少段连续同色区间。 这可以直接用 ODT 模拟:每次染色操作等同于 assignRange,最终 ODT 中段的个数就是答案。
需要强调,珂朵莉树在最坏情况下性能可能退化为 \(\mathcal{O}(n)\) 每次(比如每次交替改变不同的小区间颜色,使得区间无法合并,段数线性增长)。 但是在随机数据下的平均而言,随机修改下段的数量通常增长缓慢。 对于竞赛和实际应用,珂朵莉树实现相对简单且性能优秀,被誉为“优雅的暴力”。
启发式搜索
启发式搜索是一类利用启发信息 (heuristic) 指导搜索过程的算法,旨在更快地找到解或更优地探索状态空间。最经典的启发式搜索算法是 \(\mathtt{A*}\) (A-star) 算法。\(\mathtt{A*}\) 在图或网格中寻找最短路径时非常高效,它在普通宽度优先搜索(BFS)或 Dijkstra算法的基础上,引入了一个启发式估价函数 \(h(n)\),用于预估从节点 \(n\) 到目标的“代价”。启发式函数提供了一种“方向感”,使得搜索更倾向于朝着目标前进。
\(\mathtt{A*}\) 算法通常按照评价函数 \(f(n) = g(n) + h(n)\) 排序选取下一个拓展的节点:
其中 \(g(n)\) 是起点到当前节点 \(n\) 的实际代价(已知路径长度);
\(h(n)\) 是从节点 \(n\) 到目标的估计代价(启发式猜测)。
通过选取 \(f(n)\) 最小的节点扩展,\(\mathtt{A*}\) 可以兼顾已经花费的代价和潜在剩余代价,避免走明显绕远的路,又确保不会遗漏最优解。如果启发函数 \(h(n)\) 是低估实际代价的(称为“一致”和“乐观”的启发,如欧几里得距离、曼哈顿距离等通常满足),\(\mathtt{A*}\) 能够保证找到全局最优路径,即它和Dijkstra一样找到最短路,但通常效率更高(扩展更少的节点)。
数学直觉: \(\mathtt{A*}\) 实质上在进行一种剪枝的最短路搜索。Dijkstra算法会探索到所有可能的距离,而 \(\mathtt{A*}\) 引入函数 \(h(n)\) 作为“乐观估计”,比如平面中用直线距离作为启发,则决不会比真实最短路径长。这样,\(\mathtt{A*}\) 可以证明,当你选取一个节点扩展时,如果这个节点已经有 \(f(n)\) 比其他所有路径估计都小,那么这个节点最终一定在最优路径上。通过这个论证 \(\mathtt{A*}\) 剪除了许多不必要扩展的节点。此外,如果 \(h(n)\) 完全精准(等于实际最短余距),\(\mathtt{A*}\) 将直奔最优路径,只扩展必要节点。如果 \(h(n) = 0\) 对所有节点(没有启发信息),则 \(\mathtt{A*}\) 退化为Dijkstra搜索。
除了 \(\mathtt{A*}\),启发式搜索的范围很广,包括贪心最佳优先搜索(只考虑 \(h(n)\),可能找不到最优解但速度快)、模拟退火、遗传算法等,这些都利用某种启发来指导搜索。不过在竞赛算法中,最常用、算法框架清晰的还是 \(\mathtt{A*}\)。
应用场景
启发式搜索,特别是 \(\mathtt{A*}\),在诸多领域有应用:
- 路径规划:如游戏中的 NPC 寻路、地图应用中的最短路径查询,\(\mathtt{A*}\) 是实际标准方案,因为地图很大而启发可以很好指导方向。
- 八数码/十五数码这类拼图问题:状态空间巨大,BFS 无法穷举所有状态,而 \(\mathtt{A*}\) 通过启发函数(如错位数、曼哈顿距离)能在可行时间内找到解。如果状态再大一些,可能需要 IDA* 等优化。
- 组合游戏求解:如华容道、魔方的还原,在特定设定下可用 \(\mathtt{A*}\) 或其变种(如启发式\(\mathtt{IDA*}\))找到比较短的解。
- 人工智能:\(\mathtt{A*}\) 是很多 AI 问题求解的基础,如机器人导航、路径搜索等。它也是业界常用算法,充分体现启发式的威力。
- 竞赛题:部分题目状态空间大(如棋盘压缩状态),可考虑用 \(\mathtt{A*}\) 代替 BFS 剪枝。不过比赛中要小心启发函数需保证安全(不大于实际值)以找到最优解,否则需要接受次优解或者换策略。
- 贪心搜索:有些问题可以设计启发式进行搜索近似最优,例如旅行商问题 (TSP) 可以用启发式贪心构建初始解,但这类一般不保证全局最优。
总而言之,启发式搜索的精髓在于利用领域知识减少无效搜索。好的启发可以极大提升效率,但也要注意保持启发的一致性和正确性以确保结果质量。在可以接受近似的场合,也有更“大胆”的启发式算法能更快得到可行方案。
课后习题
习题1 P5854 【模板】笛卡尔树
模板题。
习题2 P1377 [TJOI2011] 树的序
好题,注意到题目给出的二元关系,我们可以尝试用同样有二元关系的笛卡尔树求解。
习题3 P2324 [SCOI2005] 骑士精神
启发式搜索,注意估价函数,有小细节。
本文来自一名高中生,作者:To_Carpe_Diem

 浙公网安备 33010602011771号