
[Python3] Python 基础教程
1 概述
1.1 简介
- Python 是一种解释型、面向对象、动态数据类型的高级程序设计语言。
- Python 由 Guido van Rossum 于 1989 年底发明,第一个公开发行版发行于
1991年。 - 像 Perl 语言一样, Python 源代码同样遵循 GPL(GNU General Public License) 协议。
Python 是一个高层次的结合了解释性、编译性、互动性和面向对象的脚本语言。

Python 的设计具有很强的可读性,相比其他语言经常使用英文关键字,其他语言的一些标点符号,它具有比其他语言更有特色语法结构。

Python 是一种解释型语言: 这意味着开发过程中没有了编译这个环节。类似于PHP和Perl语言。

Python 是交互式语言: 这意味着,您可以在一个 Python 提示符 >>> 后直接执行代码。

Python 是面向对象语言: 这意味着Python支持面向对象的风格或代码封装在对象的编程技术。

Python 是初学者的语言:Python 对初级程序员而言,是一种伟大的语言,它支持广泛的应用程序开发,从简单的文字处理到 WWW 浏览器再到游戏。
- Python 2 与 Python 3
- 官方宣布,2020 年 1 月 1 日, 停止 Python 2 的更新。Python 2.7 被确定为最后一个 Python 2.x 版本。
- Python 的 3.0 版本,常被称为
Python 3000,或简称Py3k。相对于 Python 的早期版本,这是一个较大的升级。为了不带入过多的累赘,Python 3.0 在设计的时候没有考虑向下兼容。
1.2 第1个Python程序
#!/usr/bin/python3

print("Hello, World!")
-
Python 常用文件扩展名为
.py。 -
你可以将以上代码保存在
hello.py文件中,并使用python命令执行该脚本文件。
$ python3 hello.py
Hello, World!
1.3 Python的安装/运维
1.3.0 安装 Python
安装方式1(源码编译方式)
- 源码编译式安装(python + pip)
- step1 安装 前置依赖
# 安装 python 的前置依赖 : make
apt-get update
#apt-get -y install vim
apt-get -y install make gcc build-essential

# 安装 pip 的前置依赖: zlib
apt-get -y install zlib1g zlib1g-dev
# yum install zlib*
- step2 编译安装 python
# 安装 python
PYTHON_VERSION=3.12.10
#curl -o /tmp/python.tgz https://www.python.org/ftp/python/3.12.10/Python-3.12.10.tgz
curl -o /opt/python.tgz https://mirrors.aliyun.com/python-release/source/Python-$PYTHON_VERSION.tgz

tar -zxvf /opt/python.tgz -C /opt/

#### 修改 Setup 文件,以确保后续安装 pip 时,不会因所依赖的 zlib 模块异常而报错 (此步骤,即 取消注释掉如下配置行) | 参考文献: 问题解决zipimport.ZipImportError: can‘t decompress data; zlib not availabl - CSDN - https://blog.csdn.net/loovelj/article/details/90274059
#vim /opt/Python-$PYTHON_VERSION/Modules/Setup
echo 'zlib zlibmodule.c -I$(prefix)/include -L$(exec_prefix)/lib -lz' >> /opt/Python-$PYTHON_VERSION/Modules/Setup
echo -e "\n" >> /opt/Python-$PYTHON_VERSION/Modules/Setup

cd /opt/Python-$PYTHON_VERSION
./configure
make && make install
- step3 查验安装信息
# python3 -V
Python 3.12.10

# whereis python3
python3: /usr/local/bin/python3
- step4 手动安装 pip
- step5 添加快捷指令 for python / pip
alias python="python3"
alias pip="pip3"
安装方式2(CENTOS)
yum -y install python3

python3 --version
安装方式3(Ubuntu)
# apt -y install python3

# python3 --version
Python 3.9.2

# whereis python3
python3: /usr/bin/python3 /usr/bin/python3.9 /usr/lib/python3 /usr/lib/python3.9 /etc/python3 /etc/python3.9 /usr/local/lib/python3.9 /usr/share/python3

# alias python=python3
- 推荐文献
安装方式4(基于Ubuntu 24 的 Docker 环境)
此节解决在基于 Ubuntu 24 作为基础镜像 的 Docker 环境中 Python 环境的安装方式(仅供参考)
- Dockerfile
# OS: Ubuntu 24.04
FROM swr.cn-north-4.myhuaweicloud.com/xxx/eclipse-temurin:17-noble

COPY ./target/*.jar /app.jar
COPY ./target/classes/xxx/ /xxx/

# install : python + pip (前置操作: 更新 apt 源)
RUN sed -i 's#http[s]*://[^/]*#http://mirrors.aliyun.com#g' /etc/apt/sources.list \
  && apt-get update \
  && apt-get -y install vim \
  && apt-get -y install --no-install-recommends python3 python3-pip python3-venv \
  && python3 -m venv $HOME/.venv \
  && . $HOME/.venv/bin/activate \ # 注:Linux 中 高版本 Python (3.5以上),必须在虚拟环境下方可正常安装所需依赖包
  && pip install -i https://mirrors.aliyun.com/pypi/simple/ can cantools
#   && echo "alias python=python3" >> ~/.bashrc \ # Java程序的子进程调用中试验:未此行命令未生效;但开发者独自登录 docker 容器内,有生效
#   && echo '. $HOME/.venv/bin/activate' >> ~/.bashrc \ # Java程序的子进程调用中试验:未此行命令未生效;但开发者独自登录 docker 容器内,有生效
#   && echo 'export PYTHON=$HOME/.venv/bin/python' >> /etc/profile \ # Java程序的子进程调用中试验:未此行命令未生效;但开发者独自登录 docker 容器内,有生效

#  && echo '. /etc/profile' > $HOME/app.sh \ # Java程序的子进程调用中试验:未测通,有衍生问题未解决掉
#  && echo 'java ${JAVA_OPTS:-} -jar app.jar > /dev/null 2>&1 &' >> $HOME/app.sh \  # Java程序的子进程调用中试验:未测通,有衍生问题未解决掉
#  && echo 'java ${JAVA_OPTS:-} -jar app.jar' >> $HOME/app.sh \  # Java程序的子进程调用中试验:未测通,有衍生问题未解决掉
#  && chmod +x $HOME/app.sh \  # Java程序的子进程调用中试验:未测通,有衍生问题未解决掉
#  && chown 777 $HOME/app.sh  # Java程序的子进程调用中试验:未测通,有衍生问题未解决掉


EXPOSE 8080

# ENTRYPOINT exec sh $HOME/app.sh # Java程序的子进程调用中试验:未测通,有衍生问题未解决掉
ENTRYPOINT exec java ${JAVA_OPTS:-} -DPYTHON=$HOME/.venv/bin/python -jar app.jar # 通过 Java 获取 JVM 参数( System.getProperty("PYTHON") ) 方式获取 【 Python 可执行文件的绝对路径】的值
- Demo : Java 程序中调用 Python
@Slf4j
public class XxxxGenerator implements IGenerator<XxxxSequenceDto> {
    //python jvm 变量 (`-DPYTHON=$HOME/.venv/bin/python`)
    public static String PYTHON_VM_PARAM = "PYTHON";//System.getProperty(PYTHON_VM_PARAM)
    //python 环境变量名称 //eg: "export PYTHON=$HOME/.venv/bin/python" , pythonEnv="$HOME/.venv/bin/python"
    public static String PYTHON_ENV_PARAM = "PYTHON";//;System.getenv(PYTHON_ENV_PARAM);
    private static String PYTHON_COMMAND ;
    //默认的 python 命令
    private static String PYTHON_COMMAND_DEFAULT = "python";

	//...

    static {
        PYTHON_COMMAND = loadPythonCommand();
        log.info("PYTHON_COMMAND:{}, PYTHON_VM:{}, PYTHON_ENV:{}", PYTHON_COMMAND, System.getProperty(PYTHON_VM_PARAM), System.getenv(PYTHON_ENV_PARAM) );

		//...
    }

    /**
     * 加载 python 命令的可执行程序的路径
     * @note
     *   Linux 中,尤其是 高版本 Python(3.x) ,为避免 Java 通过 `Runtime.getRuntime().exec(args)` 方式 调用 Python 命令时,报找不到 可执行程序(`Python` 命令)\
     *   ————建议: java 程序中使用的 `python` 命令的可执行程序路径,使用【绝对路径】
     * @return
     */
    private static String loadPythonCommand(){
        String pythonVm = System.getProperty(PYTHON_VM_PARAM);
        String pythonEnv = System.getenv(PYTHON_ENV_PARAM);
        String pythonCommand = pythonVm != null?pythonVm : pythonEnv;
        pythonCommand = pythonCommand != null?pythonCommand : PYTHON_COMMAND_DEFAULT;
        return pythonCommand;
    }


    /**
     * CAN ASC LOG 转 BLF
     * @param ascLogFilePath
     * @param blfFilePath
     */
    protected void convertToBlf(File ascLogFilePath, File blfFilePath){
        //CanAsclogBlfConverterScriptPath = "/D:/Workspace/CodeRepositories/xxx-platform/xxx-sdk/xxx-sdk-java/target/classes/bin/can-asclog-blf-converter.py"
        //String CanAsclogBlfConverterScriptPath = CanAscLogGenerator.class.getClassLoader().getResource("bin/can-asclog-blf-converter.py").getPath();

        String canAscLogBlfConverterScriptPath = XxxxGenerator.scriptFilePath;//python 业务脚本的文件路径, eg: "D:\tmp\xxx-sdk\can-asclog-blf-converter.py"

        //String [] args = new String [] {"python", "..\\bin\\can-asclog-blf-converter.py", "-i", ascLogFilePath, "-o", blfFilePath};// ascLogFilePath="/tmp/xxx-sdk/can-1.asc" , blfFilePath="/tmp/xxx-sdk/can-1.blf"
        String [] args = new String [] { PYTHON_COMMAND, canAscLogBlfConverterScriptPath, "-i", ascLogFilePath.getPath(), "-o", blfFilePath.getPath()};
        log.info("args: {} {} {} {} {} {}", args);
        Process process = null;
        Long startTime = System.currentTimeMillis();
        try {
            process = Runtime.getRuntime().exec(args);
            Long endTime = System.currentTimeMillis();
            log.info("Success to convert can asc log file to blf file!ascLogFile:{}, blfFile:{}, timeConsuming:{}ms, pid:{}", ascLogFilePath, blfFilePath, endTime - startTime, process.pid());
        } catch (IOException exception) {
            log.error("Fail to convert can asc log file to blf file!ascLogFile:{}, blfFile:{}, exception:", ascLogFilePath, blfFilePath,  exception);
            throw new RuntimeException(exception);
        }

        //读取 python 脚本的标准输出
        // ---- input stream ----
        List<String> processOutputs = new ArrayList<>();
        try(
            InputStream processInputStream = process.getInputStream();
            BufferedReader processReader = new BufferedReader( new InputStreamReader( processInputStream ));
        ) {
            Long readProcessStartTime = System.currentTimeMillis();
            String processLine = null;
            while( (processLine = processReader.readLine()) != null ) {
                processOutputs.add( processLine );
            }
            process.waitFor();
            Long readProcessEndTime = System.currentTimeMillis();
            log.info("Success to read the can asc log to blf file's process standard output!timeConsuming:{}ms", readProcessEndTime - readProcessStartTime );
            log.info("processOutputs(System.out):{}", JSON.toJSONString( processOutputs ));
        } catch (IOException exception) {
            log.error("Fail to get input stream!IOException:", exception);
            throw new RuntimeException(exception);
        } catch (InterruptedException exception) {
            log.error("Fail to wait for the process!InterruptedException:{}", exception);
            throw new RuntimeException(exception);
        }

        // ---- error stream ----
        List<String> processErrors = new ArrayList<>();
        try(
            InputStream processInputStream = process.getErrorStream();
            BufferedReader processReader = new BufferedReader( new InputStreamReader( processInputStream ));
        ) {
            Long readProcessStartTime = System.currentTimeMillis();
            String processLine = null;
            while( (processLine = processReader.readLine()) != null ) {
                processErrors.add( processLine );
            }
            process.waitFor();
            Long readProcessEndTime = System.currentTimeMillis();
            log.error("Success to read the can asc log to blf file's process standard output!timeConsuming:{}ms", readProcessEndTime - readProcessStartTime );
            log.error("processOutputs(System.err):{}", JSON.toJSONString( processOutputs ));
        } catch (IOException exception) {
            log.error("Fail to get input stream!IOException:", exception);
            throw new RuntimeException(exception);
        } catch (InterruptedException exception) {
            log.error("Fail to wait for the process!InterruptedException:{}", exception);
            throw new RuntimeException(exception);
        }
        if( processErrors.size() > 0 ) {
            throw new RuntimeException( "convert to blf failed!\nerrors:" + JSON.toJSONString(processErrors) );
        }
    }
}
- 【特别注意】
- Linux 中,尤其是 高版本 Python(3.x) ,为避免 Java 通过
Runtime.getRuntime().exec(args)方式 调用 Python 命令时,报找不到 可执行程序(Python命令)强烈建议: java 程序中使用的
python命令的可执行程序路径,使用【绝对路径】
- 推荐文献
1.3.1 查看安装位置
- Windows CMD (不支持 Power Shell)
C:\Users\xxx> where python
C:\Users\xxx\AppData\Local\Programs\Python\Python310\python.exe
C:\Users\xxx\AppData\Local\Microsoft\WindowsApps\python.exe

- Linux
root@xxxbackend-service-xxx-xxx:/# which python3
/usr/bin/python3

root@xxxbackend-service-xxx-xxx:/# whereis python3
python3: /usr/bin/python3 /usr/lib/python3 /etc/python3 /usr/share/python3
1.3.2 查看版本
- 方式1 命令行
python --version
python3 --version

或

python -V
python3 -V
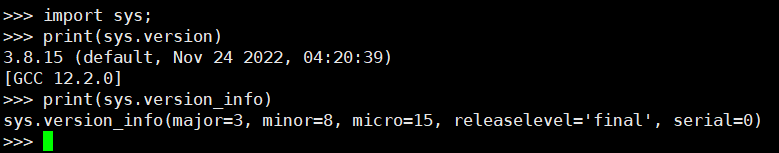
- 方式2 利用
sys模块
import sys
print(sys.version);
# 或  print(sys.version_info)
- 方式3 利用
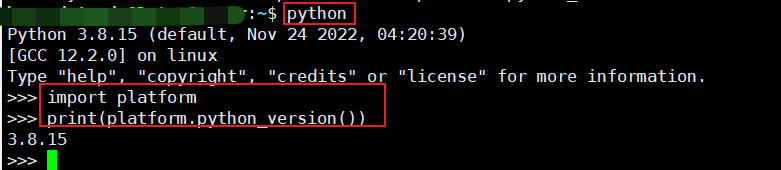
platform模块
import platform
print(platform.python_version())
1.3.3 退出 command 模式
>>> exit();
xx@yyyy:~$
1.3.4 Python 安装包源
- 官方安装包源
curl -o /tmp/python.tgz https://www.python.org/ftp/python/3.12.10/Python-3.12.10.tgz
- 第三方安装包源(阿里云)
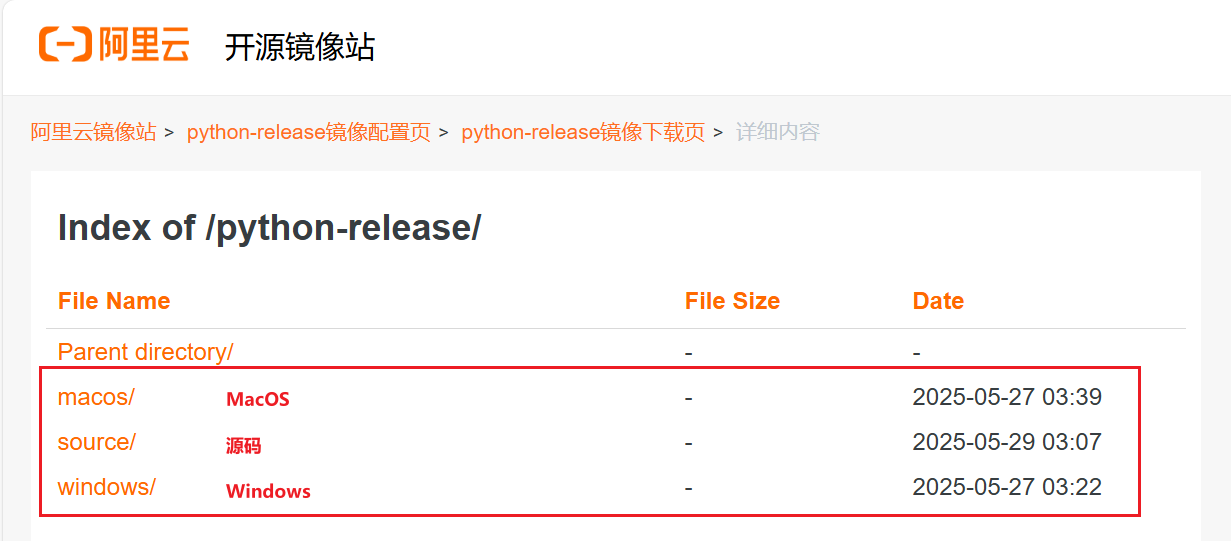
PYTHON_VERSION=3.12.10
curl -o /opt/python.tgz https://mirrors.aliyun.com/python-release/source/Python-$PYTHON_VERSION.tgz
1.4 Python的发展历程
- Python 是由 Guido van Rossum 在八十年代末和九十年代初,在荷兰国家数学和计算机科学研究所设计出来的。
- Python 本身也是由诸多其他语言发展而来的,这包括 ABC、Modula-3、C、C++、Algol-68、SmallTalk、Unix shell 和其他的脚本语言等等。
- 像 Perl 语言一样,Python 源代码同样遵循 GPL(GNU General Public License)协议。
- 现在 Python 是由一个核心开发团队在维护,Guido van Rossum 仍然占据着至关重要的作用,指导其进展。
- Python 2.0 于 2000 年 10 月 16 日发布,增加了实现完整的垃圾回收,并且支持 Unicode。
- Python 2.7 被确定为最后一个 Python 2.x 版本,它除了支持 Python 2.x 语法外,还支持部分 Python 3.1 语法。
- Python 3.0 于 2008 年 12 月 3 日发布,此版不完全兼容之前的 Python 源代码。不过,很多新特性后来也被移植到旧的Python 2.6/2.7版本。
- Python 3.0 版本,常被称为 Python 3000,或简称 Py3k。相对于 Python 的早期版本,这是一个较大的升级。
1.5 Python的语言特点
- 易于学习:Python有相对较少的关键字,结构简单,和一个明确定义的语法,学习起来更加简单。
- 易于阅读:Python代码定义的更清晰。
- 易于维护:Python的成功在于它的源代码是相当容易维护的。
- 一个广泛的标准库:Python的最大的优势之一是丰富的库,跨平台的,在UNIX,Windows和Macintosh兼容很好。
- 互动模式:互动模式的支持,您可以从终端输入执行代码并获得结果的语言,互动的测试和调试代码片断。
- 可移植:基于其开放源代码的特性,Python已经被移植(也就是使其工作)到许多平台。
- 可扩展:如果你需要一段运行很快的关键代码,或者是想要编写一些不愿开放的算法,你可以使用C或C++完成那部分程序,然后从你的Python程序中调用。
- 数据库:Python提供所有主要的商业数据库的接口。
- GUI编程:Python支持GUI可以创建和移植到许多系统调用。
- 可嵌入: 你可以将Python嵌入到C/C++程序,让你的程序的用户获得"脚本化"的能力。
1.6 开发环境与工具
Python Command : 原始工具
python
VSCode : 支持Python插件/编程的IDE 【主流】
- url
- 定位
VSCode是一款由微软开发的跨平台免费源代码编辑器,支持语法高亮、代码自动补全、调试工具等功能。
它通过插件市场提供丰富的扩展功能,适合中小型项目开发者、Web开发者、数据科学家等使用
PyCharm : 专业的 Python 集成软件开发环境(IDE) 【主流】
- Reference Document
- 定位
PyCharm是一款由JetBrains开发的专业Python IDE,分为免费社区版和付费专业版。
它提供智能代码编辑、调试、版本控制等功能,特别适合大型项目开发、数据科学和Web开发。
社区版适合个人学习和小型项目,专业版则包含更多高级功能,适合企业级应用
Jupter Lab / Jupter NoteBook 【主流】
- 定位
Jupyter Notebook适合数据科学家和机器学习开发者,提供了一个交互式计算平台,支持多种编程语言。
它便于数据分析和科学计算,支持通过邮件、GitHub等方式共享笔记,并集成了大数据工具如Apache Spark
JupyterLab: 用于交互式数据科学和可视化的集成开发环境(IDE)。
- https://jupyter.org
- 支持语言: Jupyter 支持超过 40 种编程语言,包括 Python、R、Julia 和 Scala。
Jupyter是它要服务的三种编程语言(Julia,Python、R)的缩写。
Julia是一个面向科学计算的高性能动态高级程序设计语言。Python是一门编程语言,具有丰富强大的库。Python 也被称为胶水语言,因为它能够把用其他语言制作的各种模块(尤其是C/C++)很轻松地连在一起。R是用于统计分析、绘图的语言和操作环境。
- 共享笔记本 : 可以通过电子邮件、Dropbox、GitHub 和Jupyter Notebook Viewer与他人共享笔记本。
- 交互式输出 : 您的代码可以产生丰富的交互式输出:HTML、图像、视频、LaTeX 和自定义 MIME 类型。
- 大数据集成 : 利用 Python、R 和 Scala 中的大数据工具(例如 Apache Spark)。使用 pandas、scikit-learn、ggplot2 和 TensorFlow 探索相同的数据。
Jupter NoteBookJupyter Notebook是基于网页的用于交互计算的应用程序。其可被应用于全过程计算:开发、文档编写、运行代码和展示结果。
Jupyter Notebook 是用于创建和共享计算文档的原始 Web 应用程序。它提供简单、精简、以文档为中心的体验。
在没有Jupyter Notebook之前,在IT领域工作的程序员是这样工作的:
    首先,在普通的 Python shell 或者在IDE(集成开发环境)如Pycharm中写代码,
	然后,在word中写文档来说明他的项目。

这个过程很繁琐,通常是写完代码,再写文档的时候还要重头回顾一遍代码。
最麻烦的地方在于,有些数据分析的中间结果,还要重新跑代码,然后把结果弄到文档里给客户看。

有了Jupyter Notebook之后,程序员的世界突然美好了许多,因为Jupyter Notebook可以直接在代码旁写出叙述性文档,而不是另外编写单独的文档。
也就是,它可以能将代码、文档等这一切集中到一处,让用户一目了然。
JupyterLab: 下一代笔记本界面。是最新的基于 Web 的交互式开发环境,适用于笔记本、代码和数据。
其灵活的界面允许用户配置和安排数据科学、科学计算、计算新闻和机器学习中的工作流程。
模块化设计允许扩展以扩展和丰富功能。
- 推荐文献
Jupyter 的安装方法有3种:
- 1、命令行安装 Jupyter Notebook :
pip install jupyter- 2、VSCode 安装 Jupyter Notebook :
Python插件 +Jupyter插件- 3、Anaconda 安装 Jupyter Notebook
版本环境管理 : Conda
包管理 : pip
2 Python3 基础语法
基础语法
编码
- 默认情况下,
Python 3源码文件以UTF-8编码,所有字符串都是unicode字符串。
当然你也可以为源码文件指定不同的编码:
# -*- coding: cp-1252 -*-
或
#!/usr/bin/env python3.8
# -*- coding: utf-8 -*-
上述定义允许在源文件中使用
Windows-1252字符集中的字符编码,对应适合语言为保加利亚语、白俄罗斯语、马其顿语、俄语、塞尔维亚语。
标识符
- 第1个字符必须是字母表中字母或下划线
_。 - 标识符的其他的部分由字母、数字和下划线组成。
- 标识符对大小写敏感。
在
Python 3中,可以用中文作为变量名,非 ASCII 标识符也是允许的了。
python保留字
- 保留字即关键字,我们不能把它们用作任何标识符名称。
Python的标准库提供了一个keyword模块,可以输出当前版本的所有关键字:
>>> import keyword
>>> keyword.kwlist
['False', 'None', 'True', 'and', 'as', 'assert', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'nonlocal', 'not', 'or', 'pass', 'raise', 'return', 'try', 'while', 'with', 'yield']
注释
- 单行注释 : 以
#开头
示例
#!/usr/bin/python3

# 第一个注释
print ("Hello, Python!") # 第二个注释
out
Hello, Python!
- 多行注释 : 可以用多个
#号,还有'''和"""
#!/usr/bin/python3

# 第一个注释
# 第二个注释

'''
第三注释
第四注释
'''

"""
第五注释
第六注释
"""
print ("Hello, Python!")
out
Hello, Python!
行与缩进
-
python最具特色的就是使用缩进来表示代码块,不需要使用大括号{}。 -
缩进的空格数是可变的,但是同一个代码块的语句必须包含相同的缩进空格数。
示例
if True:
    print ("True")
else:
    print ("False")
以下代码最后一行语句缩进数的空格数不一致,会导致运行错误:
if True:
    print ("Answer")
    print ("True")
else:
    print ("Answer")
  print ("False")    # 缩进不一致,会导致运行错误
out
 File "test.py", line 6
    print ("False")    # 缩进不一致,会导致运行错误
                                      ^
IndentationError: unindent does not match any outer indentation level
缩进错误: 取消缩进不匹配任何外部缩进级别
多行语句
Python通常是一行写完一条语句,但如果语句很长,我们可以使用反斜杠\来实现多行语句。
例如:
total = item_one + \
        item_two + \
        item_three
- 在
[],{}, 或()中的多行语句,不需要使用反斜杠\。
例如:
total = ['item_one', 'item_two', 'item_three',
        'item_four', 'item_five']
变量:无类型、无需声明、使用前必须赋值、赋值后方才被创建 | 变量赋值
- Python 中的变量不需要声明。每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建。
- 在 Python 中,变量就是变量,它没有类型,我们所说的"类型"是变量所指的内存中对象的类型。
- 等号(
=)用来给变量赋值。 - 等号(
=)运算符左边是一个变量名,等号(=)运算符右边是存储在变量中的值。
例如:
#!/usr/bin/python3

counter = 100          # 整型变量
miles   = 1000.0       # 浮点型变量
name    = "test"       # 字符串

print (counter)
print (miles)
print (name)
out
100
1000.0
test
- 多个变量赋值
- Python允许你同时为多个变量赋值。例如:
a = b = c = 1
以上实例,创建一个整型对象,值为 1,从后向前赋值,三个变量被赋予相同的数值。
您也可以为多个对象指定多个变量。例如:
a, b, c = 1, 2, "test"
以上实例,两个整型对象 1 和 2 的分配给变量 a 和 b,字符串对象 "test" 分配给变量 c。
标准数据类型
-
Python3 中常见的数据类型有:
-
Number(数字)
-
String(字符串)
-
bool(布尔类型)
-
List(列表)
-
Tuple(元组)
-
Set(集合)
-
Dictionary(字典)
-
Python3 的六个标准数据类型中:
- 不可变数据(3 个):Number(数字)、String(字符串)、Tuple(元组);
- 可变数据(3 个):List(列表)、Dictionary(字典)、Set(集合)。
string、tuple和list都属于sequence(序列)。
空行
-
函数之间或类的方法之间用空行分隔,表示一段新的代码的开始。
-
类和函数入口之间也用一行空行分隔,以突出函数入口的开始。
-
空行与代码缩进不同:
- 空行并不是
Python语法的一部分。- 书写时不插入空行,Python 解释器运行也不会出错。
- 但是空行的作用在于分隔两段不同功能或含义的代码,便于日后代码的维护或重构。
记住:空行也是程序代码的一部分。
等待用户输入
执行下面的程序在按回车键后就会等待用户输入:
#!/usr/bin/python3

input("\n\n按下 enter 键后退出。\n")
以上代码中 ,\n\n 在结果输出前会输出两个新的空行。一旦用户按下 enter 键时,程序将退出。
同一行显示多条语句
Python可以在同一行中使用多条语句,语句之间使用分号;分割
demo
#!/usr/bin/python3

import sys; x = 'test'; sys.stdout.write(x + '\n')
使用脚本执行以上代码,输出结果为:
test
使用交互式命令行执行,输出结果为:
>>> import sys; x = 'test'; sys.stdout.write(x + '\n')
test
5
此处的 5 表示字符数,test 有 4 个字符,\n 表示一个字符,加起来 5 个字符。
多个语句构成代码组
-
缩进相同的一组语句构成一个代码块,我们称之代码组。
-
像if、while、def和class这样的复合语句,首行以关键字开始,以冒号(
:)结束,该行之后的一行或多行代码构成代码组。 -
我们将首行及后面的代码组称为一个子句(clause)。
if expression :
   suite
elif expression :
   suite
else :
   suite
print 输出
print默认输出是换行的,如果要实现不换行需要在变量末尾加上 end="":
#!/usr/bin/python3

x="a"
y="b"
# 换行输出
print( x )
print( y )

print('---------')
# 不换行输出
print( x, end=" " )
print( y, end=" " )
print()
out
a
b
---------
a b
f-string格式输出
f-string格式输出
在Python编程过程中,字符串格式化是一个常见的任务。无论是在输出数据、生成报告还是调试信息时,使用合适的字符串格式化方法显得尤为重要。
Python为此提供了多种字符串格式化的方法,其中最受欢迎的当属f格式输出(f-strings)。
f格式输出是Python 3.6引入的一种字符串格式化方法。
它以"f"或"F"开头,并允许在字符串中嵌入表达式。
通过使用大括号{}将变量或表达式包裹起来,你可以直接在字符串中引用它们。
yy = None;
if yy is None :
  xx=45; print(f"hello, xx :{xx}")
out :
hello, 45
f格式输出与其他字符串格式化方法相比,具有以下几个显著优势:
- 可读性高:通过直观的语法,变量和表达式的插入显得非常自然,使得代码的可读性大大提升。
- 效率高:f格式输出在性能上通常优于 %-formatting 和 str.format() 方法,尤其是在需要重复格式化的情况下。
- 支持复杂表达式:你不仅可以插入变量,还可以在大括号内进行复杂的表达式计算和调用函数。
- 样例:支持复杂表达式的示例
x = 5
y = 10
result = f"The sum of {x} and {y} is {x + y}."
print(result)  # 输出: The sum of 5 and 10 is 15.
- 样例:格式化数字
pi = 3.14159265358979
formatted_pi = f"Pi is approximately {pi:.2f}."
print(formatted_pi)  # 输出: Pi is approximately 3.14.
- 样例:列表与字典
# 列表
fruits = ["apple", "banana", "cherry"]
output = f"My favorite fruit is {fruits[1]}."
print(output)  # 输出: My favorite fruit is banana.

# 字段
person = {"name": "Bob", "age": 25}
output = f"{person['name']} is {person['age']} years old."
print(output)  # 输出: Bob is 25 years old.
import 与 from...import
import/from...import
- 在 python 用
import或者from...import来导入相应的模块。
- 将整个模块(
somemodule)导入,格式为:import somemodule
- 从某个模块中导入某个函数,格式为:
from somemodule import somefunction
- 从某个模块中导入多个函数,格式为:
from somemodule import firstfunc, secondfunc, thirdfunc
- 将某个模块中的全部函数导入,格式为:
from somemodule import *
- 导入 sys 模块
import sys
print('================Python import mode==========================')
print ('命令行参数为:')
for i in sys.argv:
    print (i)
print ('\n python 路径为',sys.path)
- 导入 sys 模块的 argv,path 成员
from sys import argv,path  #  导入特定的成员

print('================python from import===================================')
print('path:',path) # 因为已经导入path成员,所以此处引用时不需要加sys.path
命令行参数
- 很多程序可以执行一些操作来查看一些基本信息,Python可以使用
-h参数查看各参数帮助信息:
$ python -h
usage: python [option] ... [-c cmd | -m mod | file | -] [arg] ...
Options and arguments (and corresponding environment variables):
-c cmd : program passed in as string (terminates option list)
-d     : debug output from parser (also PYTHONDEBUG=x)
-E     : ignore environment variables (such as PYTHONPATH)
-h     : print this help message and exit

[ etc. ]
传递参数方式 x5
1 位置传参
# 位置传递实例:
def fun1(a,b,c):
  return a+b+c

print(fun1(1,2,3))
out
6
2 关键字传参
根据每个参数的名字写入函数参数
 # 关键字传递
 def fun2(a,b,c):
  return a+b+c

print(fun2(1,c=3,b=2))
out
6
3 参数默认值传参
给函数的输入参数设定一个默认值,如果该参数最终没有输入,则使用默认参数出入函数.
# 默认值传递
 def fun3(a,b=2,c=3):
  return a+b+c

print(fun3(a = 1))
out
6
4 包裹传参
在定义函数时,我们有时候并不知道调用的时候会传递多少个参数。这时候,包裹(packing)【位置参数】或者【关键字参数】来进行参数传递会非常有用。
def fun4(*name):
  print(type(name))
  print(name)

fun4([1,2,3])
fun4((1,2,3))
fun4(1,2,3)
在fun4的参数表中,所有的参数被name收集,根据位置合并成一个元组(tuple),这就是包裹位置传递。
<class ‘tuple’>
([1, 2, 3],)
<class ‘tuple’>
((1, 2, 3),)
<class ‘tuple’>
(1, 2, 3)
5 解包裹传递
def func1(a,b=1,*c,**d):
  print(a,b,c,d)


l = [3,4]
dic = {'@':2,'#':3}

func1(1,2,l,dic)
print("---------**------------")
func1(1,2,*l,**dic)
func1(1,2,3,4,**dic)
out
1 2 ([3, 4], {‘@’: 2, ‘#’: 3}) {}
---------**------------
1 2 (3, 4) {‘@’: 2, ‘#’: 3}
1 2 (3, 4) {‘@’: 2, ‘#’: 3}
X 参考文献
拷贝模式:浅拷贝 & 深拷贝
深拷贝和浅拷贝
- 浅拷贝:不拷贝子对象的内容,只是拷贝子对象的引用。
- 深拷贝:会连子对象的内存也全部拷贝一份,对子对象的修改不会影响源对象。
Python 对象赋值的深拷贝与浅拷贝
- 在 Python 中,对象赋值实际上是对象的引用。
当创建一个对象,然后把它赋值给另一个变量的时候,Python 并没有拷贝这个对象,而只是拷贝了这个对象的引用,我们称之为浅拷贝。
在 Python 中,为了使当进行赋值操作时,两个变量互补影响,可以使用copy模块中的deepcopy方法,称之为深拷贝。
Python 函数的参数传递: Python 函数的参数传递都是“引用传递”,不是“值传递”
- 【函数的参数传递】,本质上就是:从实参到形参的【赋值操作】。
Python 中“一切皆对象”,所有的赋值操作都是“引用的赋值”。
所以,Python 中参数的传递都是“引用传递”,不是“值传递”。
- 具体操作时分为两类:
- 对“可变对象”进行“写操作”,直接作用于原对象本身。
- 对“不可变对象”进行“写操作”,会产生一个新的“对象空间”,并用新的值填充这块空间。(起到其他语言的“值传递”效果,但不是“值传递”)
- 可变对象有:
字典、列表、集合、自定义的对象等
- 不可变对象有:
数字、字符串、元组、function 等
- 为了更深入的了解参数传递的底层原理,我们需要讲解一下“浅拷贝和深拷贝”。
我们可以使用内置函数:
copy(浅拷贝)、deepcopy(深拷贝)。
传递可变对象的引用
- 传递参数是可变对象,实际传递的还是对象的引用。在函数体中不创建新的对象拷贝,而是可以直接修改所传递的对象。(这个和
C语言中传递指针一样)
例如:列表、字典、自定义的其他可变对象等。
- 示例
``python
b = [10,20]
def f2(m):
print("m:",id(m)) #b 和 m 是同一个对象
m.append(30) #由于 m 是可变对象,不创建对象拷贝,直接修改这个对象b:
f2(b)
print("b:",id(b))
print(b)
> 执行结果:
```log
m: 45765960
b: 45765960
[10, 20, 30]
传递不可变对象的引用
- 传递参数是不可变对象,实际传递的还是对象的引用。在”赋值操作”时,由于不可变对象无法修改,系统会新创建一个对象。
不会修改原传入参数,在对传入的不可变对象进行修改操作时,会新建一个新的对象。
例如:int、float、字符串、元组、布尔值
- 示例
a = 100

def f1(n):
	print("n:",id(n)) # 传递进来的是 a 对象的地址
	n = n+200         # 由于 a 是不可变对象,因此创建新的对象 n
	print("n:",id(n)) # n 已经变成了新的对象
	print(n)

f1(a)
print("a:",id(a))
执行结果:
n: 1663816464
n: 46608592
300
a: 1663816464
显然,通过 id 值我们可以看到 n 和 a 一开始是同一个对象。给 n 赋值后,n 是新的对象。
传递【不可变对象】包含的【子对象是可变对象】的情况
- 示例
# 不可变对象
a = 100

def f1(n):
    print("n:",id(n)) #传递进来的是 a 对象的地址
    n = n+200 #由于 a 是不可变对象,因此创建新的对象 n
    print("n:",id(n))
    #n 已经变成了新的对象
    # print(n)

f1(a)
print("a:",id(a))
out
a: 41611632
m: 41611632
(10, 20, [888, 6])
m: 41611632
(10, 20, [888, 6])
- 示例
# 浅拷贝和深拷贝
import copy

def testCopy():
    '''测试浅拷贝'''
    a = [10, 20, [5, 6]]
    b = copy.copy(a)
    print("a", a)
    print("b", b)
    b.append(30)
    b[2].append(7)
    print("浅拷贝......")
    print("a", a)
    print("b", b)

def testDeepCopy():
    '''测试深拷贝'''
    a = [10, 20, [5, 6]]
    # 深拷贝
    b = copy.deepcopy(a)
    print("a", a)
    print("b", b)
    b.append(30)
    b[2].append(7)
    print("深拷贝......")
    print("a", a)
    print("b", b)

testCopy()

print("*************")

testDeepCopy()
out
a [10, 20, [5, 6]]
b [10, 20, [5, 6]]

浅拷贝…
a [10, 20, [5, 6, 7]]
b [10, 20, [5, 6, 7], 30]
“*************”
a [10, 20, [5, 6]]
b [10, 20, [5, 6]]

深拷贝…
a [10, 20, [5, 6]]
b [10, 20, [5, 6, 7], 30]
List对象的append()函数
- 当
list类型的对象进行append操作时,实际上追加的是该对象的引用。
对象的id()函数
- id() 函数:返回对象的唯一标识,可以类比成该对象在内存中的地址。
>>> alist = []
>>> num = [2]
>>> alist.append( num )
>>> id( num ) == id( alist[0] )
True
如上例所示,当
num发生变化时(前提是id(num)不发生变化),alist的内容随之会发生变化。往往会带来意想不到的后果,想避免这种情况,可以采用深拷贝解决:
alist.append( copy.deepcopy( num ) )
numpy 模块的深拷贝与浅拷贝
Y 参考文献
Y FAQ for Python
Q: Python工程中,如何安装自己写的模块?
- 要在 Python 中安装自己写的模块,有几种方法,具体取决于你的需求和模块的复杂度
方式1: setup.py + pip install + 本地模块
- 使用 pip 安装本地模块
如果你想要用 pip 安装自己的模块,可以将模块打包成标准格式。假设你的模块结构如下:
my_module/
├── my_module/
│   ├── __init__.py
│   └── my_script.py
├── setup.py
└── README.md
setup.py 是打包的关键文件,内容如下
from setuptools import setup, find_packages

setup(
    name="my_module",            # 模块名
    version="0.1",               # 版本号
    packages=find_packages(),    # 自动查找子包
    install_requires=[],         # 依赖库
    description="My custom module",
    author="Your Name",
    author_email="your.email@example.com"
)
步骤:
- 在模块的根目录下(即 setup.py 所在的目录),打开终端。
- 运行以下命令:
pip install .这会将 my_module 安装到 Python 环境中,使其可以在任何地方导入。
- 使用 pip 本地链接安装
如果你在开发中不断修改模块,想要在更改后自动生效,可以使用 pip 的开发模式进行安装:
pip install -e .
此时安装的是模块的符号链接版本,修改源代码后无需重新安装。
重新安装的方式: (样例,如: 自定义的模块 autosar)
pip uninstall autosar
pip install .
- 手动复制文件
如果只是一个简单的
.py文件,可以直接将其放入 Python 项目的目录中,或者复制到 Python 的site-packages目录下。
- 使用 PYTHONPATH
可以将模块所在的路径添加到 PYTHONPATH 环境变量中。例如:
export PYTHONPATH=$PYTHONPATH:/path/to/your/module
这样可以直接在代码中导入模块。
方式2: project.toml + pip install + 本地模块
- 推荐文献/参考
Intro
最近打算构建一些开源工具套件,想着能不能把 ruff, darglint, mypy 这些 lint 工具全部 all in one 整合一下,化简配置流程,因此详细看了一下这些框架是怎么做 pyproject.toml 配置的。
在 Python 项目开发的历史长河中,我们经历了从 setup.py 到 requirements.txt,再到 setup.cfg 的变迁。
所以你可以看到到 python 会有各种各样的配置文件,属实有点头疼,各种工具链也到处配置,真的不让人省心...
而现在,pyproject.toml 的出现标志着 Python 项目管理进入了一个新的时代,本文会详细解读一下这个现代 Python 项目管理的核心配置文件。
为什么需要 pyproject.toml?
在传统的 Python 项目中,我们往往需要维护多个配置文件:
setup.py用于项目打包requirements.txt管理依赖setup.cfg存放项目元数据- 各种工具的配置文件(
.pylintrc、pytest.ini等)
这种分散的配置方式带来了几个问题:
- 配置分散,难以统一管理
- 不同文件格式增加学习成本
- 工具配置可能存在冲突
- 项目结构不够清晰
pyproject.toml 的出现就是为了解决这些问题。它提供了一个集中的、标准化的配置方式,让项目管理变得更加简单和清晰。
pyproject.toml 的标准之路
PEP 518:奠定基础
2016 年,PEP 518 提案定义了 pyproject.toml 文件的基本结构和构建系统规范。这个提案主要解决了 Python 项目构建时的依赖问题,让构建过程变得更加可靠。
Link: https://peps.python.org/pep-0518/
PEP 621:统一项目元数据
2020 年,PEP 621 进一步规范化了项目元数据的格式,使得不同的构建后端都能以统一的方式处理项目信息。
Link: https://peps.python.org/pep-0621/
pyproject.toml 的核心结构
1. 构建系统配置
[build-system]
requires = ["setuptools>=42", "wheel"]
build-backend = "setuptools.build_meta"
这部分定义了构建项目所需的工具和后端。
2. 项目元数据
[project]
name = "your-awesome-project"
version = "0.1.0"
description = "一个很棒的项目"
authors = [
    {name = "作者名", email = "author@example.com"}
]
dependencies = [
    "requests>=2.24.0",
    "pandas>=1.0.0"
]
这里包含了项目的基本信息和依赖要求。
3. 开发依赖和可选功能
[project.optional-dependencies]
dev = ["pytest", "black", "mypy"]
docs = ["sphinx", "sphinx-rtd-theme"]
你可以定义不同场景下需要的额外依赖。
4. 工具配置
[tool.black]
line-length = 88
target-version = ['py37']

[tool.isort]
profile = "black"

[tool.pytest.ini_options]
minversion = "6.0"
addopts = "-ra -q"
各种开发工具的配置都可以统一在这里管理。
现代化工具支持
现代 Python 项目管理工具都对 pyproject.toml 提供了很好的支持:
自定义配置信息
如果你有一些自己的配置信息,自己读取 pyproject.toml 也很简单,就像读取 json,yaml 一样,下面是一个示例代码:
import tomli  # For Python < 3.11
# For Python 3.11+, you can use: import tomllib

def read_pyproject_toml(file_path="pyproject.toml"):
    """
    读取并解析 pyproject.toml 文件

    Args:
        file_path (str): pyproject.toml 文件的路径

    Returns:
        dict: 解析后的 TOML 内容
    """
    try:
        with open(file_path, mode="rb") as fp:
            # 使用 rb (二进制读取模式) 来避免编码问题
            toml_dict = tomli.load(fp)
            return toml_dict
    except FileNotFoundError:
        print(f"错误: 找不到文件 '{file_path}'")
        return None
    except Exception as e:
        print(f"解析 TOML 文件时出错: {str(e)}")
        return None

def print_project_info(toml_dict):
    """
    打印项目主要信息

    Args:
        toml_dict (dict): 解析后的 TOML 字典
    """
    if not toml_dict:
        return

    # 打印项目基本信息
    if "project" in toml_dict:
        project = toml_dict["project"]
        print("项目信息:")
        print(f"名称: {project.get('name', '未指定')}")
        print(f"版本: {project.get('version', '未指定')}")
        print(f"描述: {project.get('description', '未指定')}")
        print(f"作者: {project.get('authors', ['未指定'])}")

        # 打印依赖信息
        if "dependencies" in project:
            print("\n依赖项:")
            for dep in project["dependencies"]:
                print(f"- {dep}")

    # 打印构建系统信息
    if "build-system" in toml_dict:
        build_system = toml_dict["build-system"]
        print("\n构建系统:")
        print(f"构建后端: {build_system.get('build-backend', '未指定')}")
        print(f"依赖项: {build_system.get('requires', [])}")

def main():
    # 读取并解析 TOML 文件
    toml_dict = read_pyproject_toml()

    if toml_dict:
        # 打印完整的解析结果
        print("完整的 TOML 内容:")
        print(toml_dict)
        print("\n" + "="*50 + "\n")

        # 打印格式化的项目信息
        print_project_info(toml_dict)

if __name__ == "__main__":
    main()
需要注意的是:
- Python < 3.11 需要安装
tomli:pip install tomli - Python 3.11+ 可以直接使用内置的
tomllib
至此,大致就可以理解各种工具链是如何配置的自己的参数了,当然如何更好地配置,还是要看官方文档(虽然有些文档真的写的很烂,如 darglint)。
Y 推荐文献
- Python
- 菜鸟教程
X 参考文献
QPython OH: Qpython是一个轻量级的、成熟的python编程工具。它配有终端和简单的代码编辑器。它支持安装第三方库。目前,它支持Python 3.6.6,这还不算太老。Aid Learning: 一款很酷的高端移动编程工具,可以直接在app Store中下载和安装。- 现代 Python 项目管理:pyproject.toml 完全指南 - Zhihu

本文链接: https://www.cnblogs.com/johnnyzen
关于博文:评论和私信会在第一时间回复,或直接私信我。
版权声明:本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!
日常交流:大数据与软件开发-QQ交流群: 774386015 【入群二维码】参见左下角。您的支持、鼓励是博主技术写作的重要动力!

 浙公网安备 33010602011771号