
双向搜索
如果问题不但具有“初态”,还具有明确的“终态”,并且从初态开始搜索与从终态开始逆向搜索产生的搜索范围能覆盖整个问题的状态空间,在这种情况下,可以采用双向搜索——从初态和终态出发各搜索一半状态,使得两边的搜索深度减半,在中间交会、组合成最终的答案。
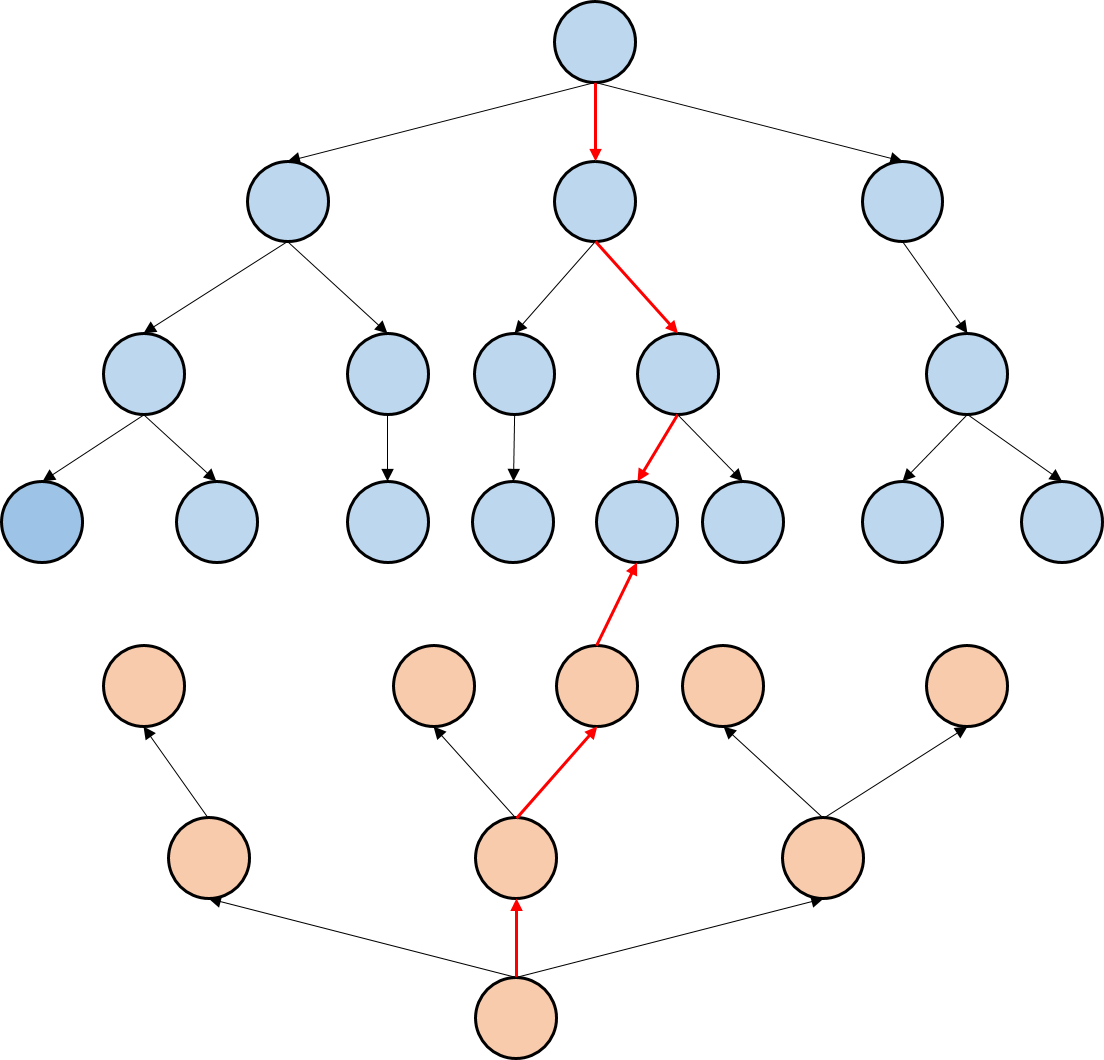
双向 DFS
双向 DFS(或称折半搜索、Meet-in-the-middle)是算法竞赛中用于优化指数级时间复杂度的经典技巧。
当搜索树的深度较大时,常规 DFS 的复杂度为 \(O(2^n)\) 或 \(O(3^n)\)。如果直接搜索,\(n\) 只能承受 \(20 \sim 30\) 左右。双向 DFS 的核心逻辑在于将长度为 \(n\) 的问题拆分为前后两个独立或半独立的部分:
- 前半部分(前 \(n/2\) 项):使用 DFS 搜索出所有可能的状态,并将结果存入哈希表或数组中。
- 后半部分(后 \(n/2\) 项):使用 DFS 搜索状态,并在搜索的同时与前半部分保存的结果进行匹配/查找。
例题:P4799 [CEOI 2015] 世界冰球锦标赛 (Day2)
Bobek 打算去观赏世界冰球锦标赛,现有 \(n \ (1 \le n \le 40)\) 场比赛,每场比赛门票的价格分别为 \(p_1, p_2, \dots, p_n \ (p_i \le 10^{16})\),Bobek 手中共有预算 \(m \ (1 \le m \le 10^{18})\)。请计算在总花费不超过预算 \(m\) 的前提下,有多少种不同的观赛方案。两种方案不同当且仅当存在至少一场比赛在其中一种方案中被观看,而在另一种方案中未被观看(允许一张票都不买的方案)。
每场比赛只有“看”与“不看”两种状态,本质是一个 0/1 背包计数问题。若直接采用简单的 DFS 对 \(n\) 场比赛进行状态枚举,其时间复杂度为 \(O(2^n)\)。当 \(n=40\) 时,\(2^{40} \approx 1.099 \times 10^{12}\),在标准 \(1\) 秒的时限下,直接搜索必然超时。
由于预算 \(m\) 高达 \(10^{18}\),无法使用状态为金额的 DP,但 \(n = 40\) 的数据规模非常适合双向搜索。
将 \(n\) 场比赛均分为两部分,前一半包含 \(\lfloor n/2 \rfloor\) 场比赛,后一半包含 \(n - \lfloor n/2 \rfloor\) 场比赛。当 \(n=40\) 时,两边最多各 \(20\) 场比赛。使用 DFS 穷举前一半比赛的所有选择组合,将所有不超过 \(m\) 的合法总花费存入数组,状态总数最多为 \(2^{20} \approx 10^6\)。使用 DFS 穷举后一半比赛的所有选择组合,将所有不超过 \(m\) 的合法总花费存入数组,状态总数同样最多为 \(2^{20} \approx 10^6\)。对第一个数组进行升序排序,遍历第二个数组中的每一个元素 \(x\)(即后半段的一种观赛花费),前半段允许的最大花费为 \(r = m - x\),在第一个有序数组中使用二分查找小于等于 \(r\) 的元素个数,累加至最终答案。
前半段 DFS 耗时 \(O(2^{n/2})\),对第一个数组排序耗时 \(O(2^{n/2} \times \log(2^{n/2})) = O(n \times 2^{n/2})\),后半段遍历并对第一个数组进行二分查找耗时 \(O(2^{n/2} \times \log(2^{n/2})) = O(n \times 2^{n/2})\),总体时间复杂度为 \(O(n \times 2^{n/2})\)。
参考代码
#include <cstdio>
#include <vector>
#include <algorithm>
using namespace std;
using ll = long long;
ll m, p[45];
vector<ll> v1, v2;
/**
 * DFS 搜索函数
 * @param l 当前处理的起始下标
 * @param r 当前处理的结束下标
 * @param sum 当前累计的票价和
 * @param v 存储结果的数组
 */
void dfs(int l, int r, ll sum, vector<ll> &v) {
    if (l > r) {
        v.push_back(sum);
        return;
    }
    // 不选第 l 场
    dfs(l + 1, r, sum, v);
    // 选第 l 场
    if (sum + p[l] <= m) {
        dfs(l + 1, r, sum + p[l], v);
    }
}
int main()
{
    int n;
    scanf("%d%lld", &n, &m);
    for (int i = 1; i <= n; i++) {
        scanf("%lld", &p[i]);
    }
    // 将 n 分为两部分进行双向搜索
    int mid = n / 2;
    // 第一阶段:搜索前一半 [1, mid]
    dfs(1, mid, 0, v1);
    // 对第一阶段的结果排序,以便后续二分查找
    sort(v1.begin(), v1.end());
    // 第二阶段:搜索后一半 [mid + 1, n]
    dfs(mid + 1, n, 0, v2);
    ll ans = 0;
    // 第三阶段:结合第一阶段结果进行二分统计
    for (ll x : v2) {
        ll r = m - x;
        // 查找 v1 中小于等于 r 的元素个数
        // upper_bound 返回第一个大于 r 的迭代器,减去 begin() 即为 <= r 的元素个数
        ans += upper_bound(v1.begin(), v1.end(), r) - v1.begin();
    }
    printf("%lld\n", ans);
    return 0;
}
例题:P5691 [NOI2001] 方程的解数
已知一个 \(n \ (1 \le n \le 6)\) 元高次方程 \(\sum\limits_{i=1}^n k_i x_i^{p_i} = 0\),其中 \(x_i \in [1,m] \ (1 \le m \le 150)\),\(k_i, p_i \ (p_i \lt 2^{31})\) 均为整数,求该方程的整数解 \((x_1, x_2, \dots, x_n)\) 的个数。保证 \(\sum\limits_{i=1}^n |k_i m^{p_i}| \lt 2^{31}\),答案不超过 \(2^{31}-1\)。
若直接枚举,共有 \(m^n\) 种取值组合,最坏情况下 \(150^6 \approx 1.1 \times 10^{13}\)。但 \(n \le 6\) 非常小,可以把未知数分成两半,先枚举一半得到其部分和,再枚举另一半去配对,即经典的折半搜索。
参考代码
#include <iostream>
#include <vector>
#include <algorithm>
using namespace std;
const int N = 10;
const int M = 155;
int n, m, half, ans;
int k[N], p[N];
int v[N][M];
vector<int> s;
int qpow(int x, int y) {
    int res = 1;
    while (y > 0) {
        if (y & 1) res *= x;
        x *= x;
        y >>= 1;
    }
    return res;
}
void dfs1(int i, int sum) {
    if (i == half + 1) {
        s.push_back(sum);
        return;
    }
    for (int x = 1; x <= m; x++) {
        dfs1(i + 1, sum + v[i][x]);
    }
}
void dfs2(int i, int sum) {
    if (i == n + 1) {
        ans += upper_bound(s.begin(), s.end(), -sum) - lower_bound(s.begin(), s.end(), -sum);
        return;
    }
    for (int x = 1; x <= m; x++) {
        dfs2(i + 1, sum + v[i][x]);
    }
}
int main()
{
    cin >> n >> m;
    for (int i = 1; i <= n; i++) {
        cin >> k[i] >> p[i];
    }
    for (int i = 1; i <= n; i++) {
        for (int j = 1; j <= m; j++) {
            v[i][j] = k[i] * qpow(j, p[i]);
        }
    }
    half = n / 2;
    dfs1(1, 0);
    sort(s.begin(), s.end());
    dfs2(half + 1, 0);
    cout << ans << "\n";
    return 0;
}
2025 CSP-S1 阅读程序 T3
#include <algorithm>
#include <cstdio>
#include <cstring>
#include <vector>
#define ll long long
int n, m;
std::vector<int> k, p;
inline int mpow(int x, int k) {
    int ans = 1;
    for (; k; k = k >> 1, x = x * x) {
        if (k & 1)
            ans = ans * x;
    }
    return ans;
}
std::vector<int> ans1, ans2;
int cnt1, cnt2;
inline void dfs(std::vector<int>& ans, int& cnt, int l, int r, int v) {
    if (l > r) {
        ++cnt;
        ans.push_back(v);
        return;
    }
    for (int i = 1; i <= m; ++i) {
        dfs(ans, cnt, l + 1, r, v + k[l] * mpow(i, p[l]));
    }
    return;
}
std::vector<int> cntans1;
int main() {
    scanf("%d%d", &n, &m);
    k.resize(n + 1);
    p.resize(n + 1);
    for (int i = 1; i <= n; ++i) {
        scanf("%d%d", &k[i], &p[i]);
    }
    dfs(ans1, cnt1, 1, n >> 1, 0);
    dfs(ans2, cnt2, (n >> 1) + 1, n, 0);
    std::sort(ans1.begin(), ans1.end());
    int newcnt1 = 1;
    cntans1.push_back(1);
    for (int i = 1; i < cnt1; ++i) {
        if (ans1[i] == ans1[newcnt1 - 1]) {
            ++cntans1[newcnt1 - 1];
        } else {
            ans1[newcnt1++] = ans1[i];
            cntans1.push_back(1);
        }
    }
    cnt1 = newcnt1;
    std::sort(ans2.begin(), ans2.end());
    int las = 0;
    ll ans = 0;
    for (int i = cnt2 - 1; i >= 0; --i) {
        for (; las < cnt1 && ans1[las] + ans2[i] < 0; ++las)
            ;
        if (las < cnt1 && ans1[las] + ans2[i] == 0)
            ans += cntans1[las];
    }
    printf("%lld\n", ans);
    return 0;
}
(1)删除第 51 行的 std::sort(ans2.begin(), ans2.end()); 后,代码输出的结果不会受到影响。(正确/错误)
(2)假设计算过程中不发生溢出,函数 mpow(x, k) 的功能是求出 \(x^k\) 的取值。(正确/错误)
(3)代码中第 39 行到第 50 行的目的是为了将 ans1 数组进行“去重”操作。(正确/错误)
(4)当输入为 3 15 1 2 -1 2 1 2 时,输出结果为?
(5)记程序结束前 p 数组元素的最大值为 \(P\),则该代码的时间复杂度是?
(6)本题所求出的是?
程序解析
这段代码实现了一个经典的折半搜索算法,用于求解形如 \(\sum\limits_{i=1}^n k_i x_i^{p_i} = 0\) 的方程的解的个数,其中每个未知数 \(x_i\) 的取值范围是 \(1\) 到 \(m\)。
代码的主要逻辑分为:
- 将 \(n\) 个变量分成两半,\(1\) 到 \(\lfloor n/2 \rfloor\),以及 \(\lfloor n/2 \rfloor + 1\) 到 \(n\)。
- 使用
dfs分别枚举这两部分变量所有可能的取值组合,并计算各自的代数和,分别存入ans1和ans2。 - 对
ans1进行排序和去重,并记录每个值出现的频次cntans1。 - 对
ans2进行排序,然后使用双指针(类似滑动窗口的方式)在ans1和ans2中寻找满足ans1[las] + ans2[i] == 0的组合,统计总方案数。
答案
(1)错误
原代码在第 52 到第 59 行使用了一种双指针(滑动窗口)算法,用于在 ans1 和 ans2 中寻找和为 \(0\) 的元素组合。具体的匹配逻辑如下:
- 遍历方向与单调性:外层循环变量
i从cnt2 - 1递减到0,由于在第 51 行对ans2进行了升序排序,逆序遍历就意味着取出的ans2[i]是单调递减的。 - 指针单向移动:要寻找满足
ans1[las] + ans2[i] == 0的解,即ans1[las] == -ans2[i]。因为-ans2[i]是单调递增的,且ans1已经在第 39 行被升序排序,这就保证了匹配位置las也是单调递增的。因此,内层循环中的指针las只需要一直向前走,无需回退。
如果删除了第 51 行对 ans2 的排序操作,会产生以下后果:
ans2数组将保持dfs深度优先搜索时生成的原始顺序,由于系数 \(k_i\) 和指数运算的存在,这个顺序是杂乱无章、上下波动的。- 在外层循环逆序遍历这个无序的
ans2时,取出的ans2[i]会忽大忽小,这也意味着它所需要的匹配值-ans2[i]同样会忽大忽小。 - 然而,内层的
las指针在代码中被设计为只能递增,当遍历到一个较大的ans2[i],导致las指针大幅度向后移动后;如果接下来遇到一个较小的ans2[i](需要较小的ans1[las]来匹配),由于las无法回退,程序将直接错过这个匹配组合。
最终,这会导致统计出的方案总数 ans 产生漏算,输出结果小于正确答案。
(2)正确
函数 mpow(x, k) 实现的是经典的快速幂算法,可以通过拆解其内部循环来验证其功能:
- 初始化:变量
ans初始赋值为 \(1\)。 - 二进制拆分:循环通过
k = k >> 1依次处理指数k的每一个二进制位,直到k变为 \(0\)。 - 底数倍增:在每一次循环中,
x = x * x会将当前的底数平方。随着循环的进行,x的值依次为输入值 \(x\) 的 \(1\) 次方、\(2\) 次方、\(4\) 次方、\(8\) 次方……刚好对应二进制位上的权重。 - 累乘结果:
k & 1用于判断当前指数k的最低二进制位是否为 \(1\),如果是,则说明最后的结果中包含当前的这一项权重,因此执行ans = ans * x将其累乘到最终结果中。
例如,当计算 \(x^{11}\) 时,指数 \(11\) 的二进制表示为 \((1011)_2\)。算法会将其拆分为 \(x^8 \cdot x^2 \cdot x^1\),并在对应的二进制位为 \(1\) 时将这些部分乘入 ans。
因此,在不发生整型溢出的前提下,该函数确切地计算并返回了 \(x^k\) 的值。
(3)正确
代码第 39 行至第 50 行的执行逻辑可以拆解如下:
- 排序聚集:第 39 行的
std::sort(ans1.begin(), ans1.end());首先将ans1数组进行升序排序,这一步的核心作用是将所有相同的值(重复项)聚集到相邻的位置,为后续处理打下基础。 - 双指针压缩:从第 40 行开始,代码使用类似双指针的逻辑。
i是读指针(遍历原始数组),newcnt1是写指针(指向去重后数组的下一个写入位置)。 - 重复项判定与频次统计:在第 42 行的循环中,如果当前遍历到的元素
ans1[i]与刚刚写入的最新独立元素ans1[newcnt1 - 1]相同(第 43 行),代码不会将其写入新位置,而是将对应的计数器cntans1加一(第 44 行)。 - 新元素写入:如果遇到不同的元素,说明找到了一个新的独立值,此时代码会将其写入
ans1数组的newcnt1位置(第 46 行),并为这个新值在cntans1中初始化频次为 \(1\)(第 47 行)。 - 更新长度:最后,第 50 行将原长度
cnt1更新为去重后的独立元素总数newcnt1。
这段代码实现了一个标准的“就地去重并统计频次”的操作,其对 ans1 数组本身的结构性改变就是去除了重复元素。
(4)8
根据输入的参数,程序的执行过程实质上是在限定范围内求解勾股数的组合数量。
- 解析输入参数
输入的变量个数 \(n = 3\),取值上限 \(m = 15\)。
接下来的 3 行数据分别定义了方程中每一项的系数 \(k_i\) 和指数 \(p_i\):
第一项:\(k_1 = 1, p_1 = 2\)
第二项:\(k_2 = -1, p_2 = 2\)
第三项:\(k_3 = 1, p_3 = 2\)
代入代码中dfs的累加逻辑,程序要寻找的是满足方程 \(x_1^2 - x_2^2 + x_3^2 = 0\)(即 \(x_1^2 + x_3^2 = x_2^2\))的解的个数,其中 \(x_1, x_2, x_3\) 的取值范围均在 \([1, 15]\) 之间。 - 拆半搜索过程
左半部分搜索ans1:遍历并计算了第一项 \(x_1^2\) 的所有可能取值。
右半部分搜索ans2:嵌套遍历并计算了后两项 \(-x_2^2 + x_3^2\) 的所有可能取值组合。
后续的双指针匹配逻辑用于寻找ans1 + ans2 == 0的情况,等价于统计该范围内所有成立的勾股数等式。 - 计算满足条件的解
在 \([1, 15]\) 的范围内,满足 \(A^2 + B^2 = C^2\) 的基础勾股数及其在范围内的倍数包括: - 基于 3-4-5:
\(3^2 + 4^2 = 5^2\)(对应 \(x_1=3, x_3=4, x_2=5\) 或 \(x_1=4, x_3=3, x_2=5\),共 2 组)
\(6^2 + 8^2 = 10^2\)(对应 \(x_1=6, x_3=8\) 或 \(x_1=8, x_3=6\),共 2 组)
\(9^2 + 12^2 = 15^2\)(对应 \(x_1=9, x_3=12\) 或 \(x_1=12, x_3=9\),共 2 组) - 基于 5-12-13:
\(5^2 + 12^2 = 13^2\)(对应 \(x_1=5, x_3=12\) 或 \(x_1=12, x_3=5\),共 2 组)
(5)\(O(m^{\lceil \frac{n}{2} \rceil} (n \log m + \log P))\)
具体拆解分析如下:
- 折半搜索的时间开销
程序将 \(n\) 个变量分为两半进行搜索。左半部分的递归深度为 \(\lfloor \frac{n}{2} \rfloor\),右半部分的递归深度为 \(\lceil \frac{n}{2} \rceil\)。在每一层,程序都有 \(m\) 个分支(遍历 \(1\) 到 \(m\))。
因此,生成的搜索树节点总数最大为 \(O(m^{\lceil \frac{n}{2} \rceil})\)。在每次状态转移时,程序都会调用mpow(i, p[l])。由于 \(p\) 数组的最大值为 \(P\),快速幂的单次时间复杂度为 \(O(\log P)\)。
所以,搜索阶段的总时间复杂度为 \(O(m^{\lceil \frac{n}{2} \rceil} \log P)\)。 - 排序数组的时间开销
ans1数组的长度最大为 \(m^{\lfloor \frac{n}{2} \rfloor}\),ans2数组的长度最大为 \(m^{\lceil \frac{n}{2} \rceil}\)。
以规模较大的ans2为例,对其进行快速排序的时间复杂度为 \(O(N \log N)\),其中 \(N = m^{\lceil \frac{n}{2} \rceil}\)。
代入得:\(O(m^{\lceil \frac{n}{2} \rceil} \log(m^{\lceil \frac{n}{2} \rceil})) = O(m^{\lceil \frac{n}{2} \rceil} \cdot \lceil \frac{n}{2} \rceil \log m)\),可化简为 \(O(m^{\lceil \frac{n}{2} \rceil} \cdot n \log m)\)。 - 双指针匹配的时间开销
ans1的去重操作,以及最后对ans1和ans2进行的双指针遍历,均是线性扫描。
双指针循环执行的次数受限于两个数组的长度之和,时间复杂度为 \(O(m^{\lfloor \frac{n}{2} \rfloor} + m^{\lceil \frac{n}{2} \rceil})\),即 \(O(m^{\lceil \frac{n}{2} \rceil})\),这一项在渐进复杂度中被排序的时间开销所覆盖。
综合以上三部分,核心耗时由搜索运算和排序运算构成,合并提取公因式后即得到最终的时间复杂度 \(O(m^{\lceil \frac{n}{2} \rceil} (n \log m + \log P))\)。
(6)本题求解的是多元高次方程 \(\sum\limits_{i=1}^n k_i x_i^{p_i} = 0\) 在正整数范围 \([1, m]\) 内的解的个数。
习题:P10484 送礼物
解题思路
可以利用双向搜索的思想,把礼物分成两半。
首先,搜索出从前一半礼物中选出若干个,可能达到的 \(0 \sim W\) 之间的所有重量值,存放在一个数组中,并对数组进行排序、去重。
然后,进行第二次搜索,尝试从后一半礼物中选出一些。对于每个可能达到的重量值 \(w\),在第一部分得到的数组中二分查找 \(\le W-w\) 的数值中最大的一个,用二者的和更新答案。
这个算法的时间复杂度就只有 \(O(2^{N/2} \log 2^{N/2}) = O(N \cdot 2^{N/2})\) 了,还可以加入一些优化,进一步提高算法的效率,比如把礼物按照重量降序排序后再分半、搜索。
参考代码
#include <cstdio>
#include <algorithm>
#include <functional>
#include <vector>
using namespace std;
int g[50], mid, n, maxw, ans;
vector<int> w;
// 第一阶段 DFS:搜索前 mid 个物品的所有可能重量组合
void dfs1(int u, int sum) {
    if (u == mid) {
        w.push_back(sum);
        return;
    }
    // 不选当前物品
    dfs1(u + 1, sum);
    // 选当前物品(需判断是否超过 maxw)
    if (sum <= maxw - g[u]) {
        dfs1(u + 1, sum + g[u]);
    }
}
// 第二阶段 DFS:搜索剩余物品,并结合第一阶段结果更新最大值
void dfs2(int u, int sum) {
    if (u == n) {
        // 二分查找第一个使得 w[i] + sum <= maxw 的最大 w[i]
        int t = maxw - sum;
        auto it = upper_bound(w.begin(), w.end(), t);
        if (it != w.begin()) {
            it--;
            ans = max(ans, sum + *it);
        }
        return;
    }
    // 不选
    dfs2(u + 1, sum);
    // 选
    if (sum <= maxw - g[u]) {
        dfs2(u + 1, sum + g[u]);
    }
}
int main()
{
    scanf("%d%d", &maxw, &n);
    for (int i = 0; i < n; i++) scanf("%d", &g[i]);
    // 优化:从大到小排序,优化搜索效率
    sort(g, g + n, greater<int>());
    mid = n / 2;
    // 执行第一阶段
    dfs1(0, 0);
    // 对结果排序并去重,方便二分查找
    sort(w.begin(), w.end());
    w.erase(unique(w.begin(), w.end()), w.end());
    ans = 0;
    // 执行第二阶段
    dfs2(mid, 0);
    printf("%d\n", ans);
    return 0;
}
双向 BFS
从起始状态、目标状态分别开始,两边轮流进行,每次各扩展一整层。当两边各自有一个状态在记录数组中发生重复时,就说明这两个搜索过程相遇了,可以合并得出起点到终点的最少步数。
例题:P1032 [NOIP 2002 提高组] 字串变换
给定一个起点字符串 \(A\) 和一个目标字符串 \(B\),以及最多 \(6\) 条字符串变换规则,每次变换可以将字符串中出现的子串 \(A_i\) 替换为对应的 \(B_i\),所有字符串(包含初始串、目标串及规则串)的长度上限为 \(20\)。求在 \(10\) 步(包含 \(10\) 步)以内将字符串 \(A\) 变换为字符串 \(B\) 所需的最少变换步数,若无法在 \(10\) 步以内完成变换,则输出
NO ANSWER!。
在字符串变换过程中,一个字符串内部可能存在多个符合规则的子串,且存在多条可选规则,这意味着搜索树的分支因子较多。如果采用普通的单向 BFS,在最坏情况下,搜索树的状态节点数量会随着步数呈现指数级爆发增长。
本题的起点和终点都是确定的,且限制最大深度为 \(10\),这种场景非常适合采用双向 BFS。正向搜索从起点 \(A\) 出发,按照变换规则 \(A_i \to B_i\) 向下扩展。反向搜索从目标串 \(B\) 出发,按照逆向规则 \(B_i \to A_i\) 向上扩展。当正向搜索与反向搜索探索到同一个中间字符串 \(S\) 时,两侧消耗的步数之和即为正向推导到终点的最短总步数。双向 BFS 将搜索树的深度从单向的 \(10\) 层缩减到了两侧各 \(5\) 层,极大地减少了冗余状态的搜索。
在双向 BFS 主循环中,为了保持两侧搜索树的平衡,可以每次选择队列节点数较小的一侧扩展一层。

参考代码
#include <iostream>
#include <string>
#include <queue>
#include <map>
using namespace std;
// 存储变换规则,ra 为原串,rb 为目标串
string ra[7], rb[7];
int n; // 规则计数
/**
 * 扩展一层搜索空间
 * @param q 当前搜索方向的队列
 * @param m1 当前方向的访问标记及步数统计
 * @param m2 另一个搜索方向的访问记录
 * @param a 变换规则的原串数组
 * @param b 变换规则的目标串数组
 * @return 如果找到相遇点,返回总步数;否则返回 -1
 */
int expand(queue<string>& q, map<string, int>& m1, map<string, int>& m2, string a[], string b[]) {
    int sz = q.size();
    int min_ans = 20;
    // 每次处理当前层级的所有状态
    while (sz--) {
        string t = q.front();
        q.pop();
        for (int i = 0; i < n; i++) {
            // 在当前字串中寻找可匹配规则的子串位置
            int pos = t.find(a[i]);
            while (pos != -1) {
                string s = t;
                // 执行字串替换变换
                s.replace(pos, a[i].length(), b[i]);
                // 如果变换后的字串在另一个搜索方向已经出现过,说明路径对接成功
                if (m2.count(s) && m1[t] + 1 + m2[s] <= 10) {
                    if (m1[t] + 1 + m2[s] < min_ans) {
                        min_ans = m1[t] + 1 + m2[s];
                    }
                }
                // 如果该字串未在当前方向访问过,则记录步数并入队
                if (!m1.count(s)) {
                    m1[s] = m1[t] + 1;
                    q.push(s);
                }
                // 继续寻找该规则在同一字串中的下一个匹配位置
                pos = t.find(a[i], pos + 1);
            }
        }
    }
    if (min_ans <= 10) return min_ans;
    return -1;
}
int main()
{
    string a, b;
    // 读入起点串和目标串
    cin >> a >> b;
    n = 0;
    // 循环读入变换规则
    while (cin >> ra[n] >> rb[n]) n++;
    // 特判:起点和终点相同
    if (a == b) {
        cout << "0\n";
        return 0;
    }
    // q1, m1: 从起点向终点搜;q2, m2: 从终点向起点搜
    queue<string> q1, q2;
    map<string, int> m1, m2;
    q1.push(a); m1[a] = 0;
    q2.push(b); m2[b] = 0;
    // 双向 BFS 主循环
    while (!q1.empty() && !q2.empty()) {
        if (m1[q1.front()] + m2[q2.front()] > 10) break;
        int res;
        // 优先扩展当前队列规模较小的一侧,平衡两侧搜索树
        if (q1.size() <= q2.size()) {
            res = expand(q1, m1, m2, ra, rb);
        } else {
            res = expand(q2, m2, m1, rb, ra);
        }
        if (res != -1 && res <= 10) {
            printf("%d\n", res);
            return 0;
        }
    }
    // 无法在 10 步内完成变换
    cout << "NO ANSWER!\n";
    return 0;
}
习题:P10487 Nightmare II
解题思路
使用双向 BFS 算法,建立两个队列,分别从男孩的初始位置、女孩的初始位置开始进行 BFS,两边轮流进行。
在每一轮中,男孩这边 BFS 三层(可以移动三步),女孩这边 BFS 一层(可以移动一步),使用数组记录每个位置对于男孩和女孩的可达性。
当然,在 BFS 的每次扩展时,注意实时计算状态与鬼之间的曼哈顿距离,及时排除不合法的状态。
在 BFS 的过程中,第一次出现某个位置既能被男孩到达,也能被女孩到达时,当前轮数就是两人的最短会合时间。
参考代码
#include <cstdio>
#include <queue>
#include <cmath>
using namespace std;
const int N = 805;
const int dr[] = {-1, 1, 0, 0};
const int dc[] = {0, 0, -1, 1};
struct Node {
    int r, c;
};
int n, m;
char g[N][N];
bool vis[2][N][N]; // 0: Boy (M), 1: Girl (G)
Node gh[2];
bool safe(int r, int c, int t) {
    if (r < 0 || r >= n || c < 0 || c >= m || g[r][c] == 'X') return false;
    for (int i = 0; i < 2; i++) {
        if (abs(r - gh[i].r) + abs(c - gh[i].c) <= 2 * t) return false;
    }
    return true;
}
bool expand(queue<Node>& q, int step, int t, int self, int other) {
    for (int s = 0; s < step; s++) {
        int sz = q.size();
        while (sz--) {
            Node cur = q.front();
            q.pop();
            // 如果当前点已经被鬼魂覆盖,该路径废弃
            if (!safe(cur.r, cur.c, t)) continue;
            for (int i = 0; i < 4; i++) {
                int nr = cur.r + dr[i];
                int nc = cur.c + dc[i];
                if (safe(nr, nc, t) && !vis[self][nr][nc]) {
                    if (vis[other][nr][nc]) return true; // 相遇
                    vis[self][nr][nc] = true;
                    q.push({nr, nc});
                }
            }
        }
    }
    return false;
}
void solve() {
    scanf("%d%d", &n, &m);
    queue<Node> qm, qg;
    int cnt = 0;
    for (int i = 0; i < n; i++) {
        scanf("%s", g[i]);
        for (int j = 0; j < m; j++) {
            vis[0][i][j] = vis[1][i][j] = false;
            if (g[i][j] == 'M') {
                qm.push({i, j});
                vis[0][i][j] = true;
            } else if (g[i][j] == 'G') {
                qg.push({i, j});
                vis[1][i][j] = true;
            } else if (g[i][j] == 'Z') {
                gh[cnt++] = {i, j};
            }
        }
    }
    int t = 0;
    while (!qm.empty() && !qg.empty()) {
        t++;
        // 扩展男孩 3 步,女孩 1 步
        if (expand(qm, 3, t, 0, 1) || expand(qg, 1, t, 1, 0)) {
            printf("%d\n", t);
            return;
        }
    }
    printf("-1\n");
}
int main()
{
    int t; scanf("%d", &t);
    while (t--) {
        solve();
    }
    return 0;
}
习题:P2324 [SCOI2005] 骑士精神
解题思路
由于目标状态固定且步数限制较小,使用 双向 BFS 可以显著降低搜索空间。
从目标状态开始,进行 BFS 搜索 8 步,并将搜索到的所有状态及其步数存储下来。对于每组输入的初始状态,从初始状态开始正向搜索最多 7 步。在正向搜索过程中,如果某个状态已经存在于反向搜索的记录中,则两个步数和为答案。
由于棋盘只有 25 个格子,且每个格子状态简单,可以将棋盘掩码与空位置坐标组合成一个整数来表示唯一状态,节省空间并提高存取效率。用 25 位二进制数表示骑士颜色(每一位 0/1),用 5 位表示空位索引(0 到 24)。
参考代码
#include <cstdio>
#include <queue>
#include <unordered_map>
using namespace std;
// 骑士(马)的 8 个移动方向
const int dx[] = {-2, -2, -1, -1, 1, 1, 2, 2};
const int dy[] = {-1, 1, -2, 2, -2, 2, -1, 1};
// 存储从目标状态出发搜索到的状态及其步数
// key: 压缩后的状态 (mask + 空位坐标), value: 步数
unordered_map<int, int> dis;
/**
 * 将目标棋盘状态压缩为一个整数
 * 状态表示:(棋盘位掩码 << 5) | 空格索引
 * 12 个黑色骑士为 1,12 个白色骑士为 0,'*' 为空位
 */
int calc() {
    int t[5][5] = {
        {1, 1, 1, 1, 1},
        {0, 1, 1, 1, 1},
        {0, 0, 0, 1, 1}, // 目标状态中心是空位
        {0, 0, 0, 0, 1},
        {0, 0, 0, 0, 0}
    };
    int mask = 0;
    for (int i = 0; i < 5; i++)
        for (int j = 0; j < 5; j++)
            if (t[i][j] == 1) mask |= (1 << (i * 5 + j));
    return (mask << 5) | 12; // 空位在索引 12 (坐标 2,2)
}
// 预处理:从目标状态开始反向 BFS 搜索 8 步
void precompute() {
    int start = calc();
    queue<int> q;
    q.push(start);
    dis[start] = 0;
    while (!q.empty()) {
        int cur = q.front();
        int d = dis[cur];
        q.pop();
        if (d >= 8) continue; // 限制反向搜索深度为 8
        int mask = cur >> 5, pos = cur & 31;
        int x = pos / 5, y = pos % 5;
        for (int i = 0; i < 8; i++) {
            int nx = x + dx[i], ny = y + dy[i];
            if (nx >= 0 && nx < 5 && ny >= 0 && ny < 5) {
                int npos = nx * 5 + ny, nmask = mask;
                // 交换空格和骑士的位置,生成新 mask
                if ((mask >> npos) & 1) {
                    nmask |= (1 << pos);
                    nmask ^= (1 << npos);
                }
                int nxt = (nmask << 5) | npos;
                if (dis.find(nxt) == dis.end()) {
                    dis[nxt] = d + 1;
                    q.push(nxt);
                }
            }
        }
    }
}
// 处理单组测试数据:从初始状态正向搜索 7 步
int solve() {
    int mask = 0, pos = -1;
    char s[6];
    for (int i = 0; i < 5; i++) {
        scanf("%s", s);
        for (int j = 0; j < 5; j++) {
            if (s[j] == '*') pos = i * 5 + j;
            else if (s[j] == '1') mask |= (1 << (i * 5 + j));
        }
    }
    int start = (mask << 5) | pos;
    // 如果初始状态就在预处理的 8 步范围内
    if (dis.count(start)) return dis[start];
    unordered_map<int, int> vis;
    queue<int> q;
    q.push(start);
    vis[start] = 0;
    while (!q.empty()) {
        int cur = q.front();
        int d = vis[cur];
        q.pop();
        if (d >= 7) continue; // 限制正向搜索深度为 7
        int mask = cur >> 5, pos = cur & 31;
        int x = pos / 5, y = pos % 5;
        for (int i = 0; i < 8; i++) {
            int nx = x + dx[i], ny = y + dy[i];
            if (nx >= 0 && nx < 5 && ny >= 0 && ny < 5) {
                int npos = nx * 5 + ny, nmask = mask;
                if ((mask >> npos) & 1) {
                    nmask |= (1 << pos);
                    nmask ^= (1 << npos);
                }
                int nxt = (nmask << 5) | npos;
                if (vis.find(nxt) == vis.end()) {
                    // 检查是否与反向搜索的结果相遇
                    if (dis.count(nxt)) return d + 1 + dis[nxt];
                    q.push(nxt); vis[nxt] = d + 1;
                }
            }
        }
    }
    return -1;
}
int main()
{
    precompute();
    int t; scanf("%d", &t);
    while (t--) printf("%d\n", solve());
    return 0;
}
习题:P5507 机关
12 个旋钮,每个旋钮有 4 个状态。旋转一个旋钮会带动另一个旋钮,目标是求出将所有旋钮调至状态 1 的最少步数及操作序列。
解题思路
由于每个旋钮只有 4 个状态,可以用 2 个二进制位来存储一个旋钮的状态。12 个旋钮总共需要 24 位二进制,可以用一个 int 来存储。
初始状态和目标状态都是已知的,可以使用双向 BFS。
参考代码
#include <cstdio>
#include <queue>
#include <vector>
#include <algorithm>
using namespace std;
// 12个旋钮,每个旋钮4个状态,共 4^12 = 2^24 种状态
const int S = 1 << 24;
int start, r[12][4], d[S], prem[S], pres[S];
// 获取第 i 个旋钮的当前状态 (0-3)
int get(int s, int i) {
    return (s >> (i * 2)) & 3;
}
// 修改第 i 个旋钮的状态为 v
int put(int s, int i, int v) {
    return (s & ~(3 << (i * 2))) | (v << (i * 2));
}
// 正向旋转:旋转旋钮 i,并根据当前状态带动另一个旋钮 t 旋转
int rotate1(int s, int i) {
    int v = get(s, i);
    int t = r[i][v];
    int nv = (v + 1) & 3;
    s = put(s, i, nv);
    int tv = (get(s, t) + 1) & 3;
    s = put(s, t, tv);
    return s;
}
// 逆向旋转:已知旋转后的状态 s,推测旋转旋钮 i 前的状态
int rotate2(int s, int i) {
    int v = (get(s, i) + 3) & 3; // 逆向推导 i 旋转前的状态
    int t = r[i][v];
    int pv = (get(s, t) + 3) & 3; // 逆向推导被带动旋钮 t 旋转前的状态
    s = put(s, i, v);
    s = put(s, t, pv);
    return s;
}
// 输出路径:结合正向和反向搜索的结果
void output(int u, int v, int i) {
    vector<int> res;
    // 从正向相遇点回溯到起点
    int t = u;
    while (t != start) {
        res.push_back(prem[t] + 1);
        t = pres[t];
    }
    reverse(res.begin(), res.end());
    // 加入相遇时的那一步操作
    res.push_back(i + 1);
    // 从反向相遇点回溯到终点(0)
    t = v;
    while (t != 0) {
        res.push_back(prem[t] + 1);
        t = pres[t];
    }
    int step = res.size();
    printf("%d\n", step);
    for (int mv : res) {
        printf("%d ", mv);
    }
}
int main()
{
    start = 0;
    for (int i = 0; i < 12; i++) {
        int s;
        scanf("%d", &s);
        start |= ((s - 1) << (i * 2));
        for (int j = 0; j < 4; j++) {
            scanf("%d", &r[i][j]);
            r[i][j]--; // 旋钮编号转为 0-11
        }
    }
    if (start == 0) {
        printf("0\n");
        return 0;
    }
    queue<int> q1, q2;
    q1.push(start);
    d[start] = 1; // 正数为正向搜索标识
    q2.push(0);
    d[0] = -1; // 负数为反向搜索标识
    while (!q1.empty() && !q2.empty()) {
        // 扩展正向搜索
        int sz = q1.size();
        while (sz--) {
            int u = q1.front(); q1.pop();
            for (int i = 0; i < 12; i++) {
                int v = rotate1(u, i);
                if (d[v] < 0) { // 与反向搜索相遇
                    output(u, v, i);
                    return 0;
                }
                if (d[v] == 0) {
                    d[v] = d[u] + 1;
                    pres[v] = u;
                    prem[v] = i;
                    q1.push(v);
                }
            }
        }
        // 扩展反向搜索
        sz = q2.size();
        while (sz--) {
            int v = q2.front(); q2.pop();
            for (int i = 0; i < 12; i++) {
                int u = rotate2(v, i);
                if (d[u] > 0) { // 与正向搜索相遇
                    output(u, v, i);
                    return 0;
                }
                if (d[u] == 0) {
                    d[u] = d[v] - 1;
                    pres[u] = v;
                    prem[u] = i;
                    q2.push(u);
                }
            }
        }
    }
    return 0;
}

 浙公网安备 33010602011771号