
树的DFS序
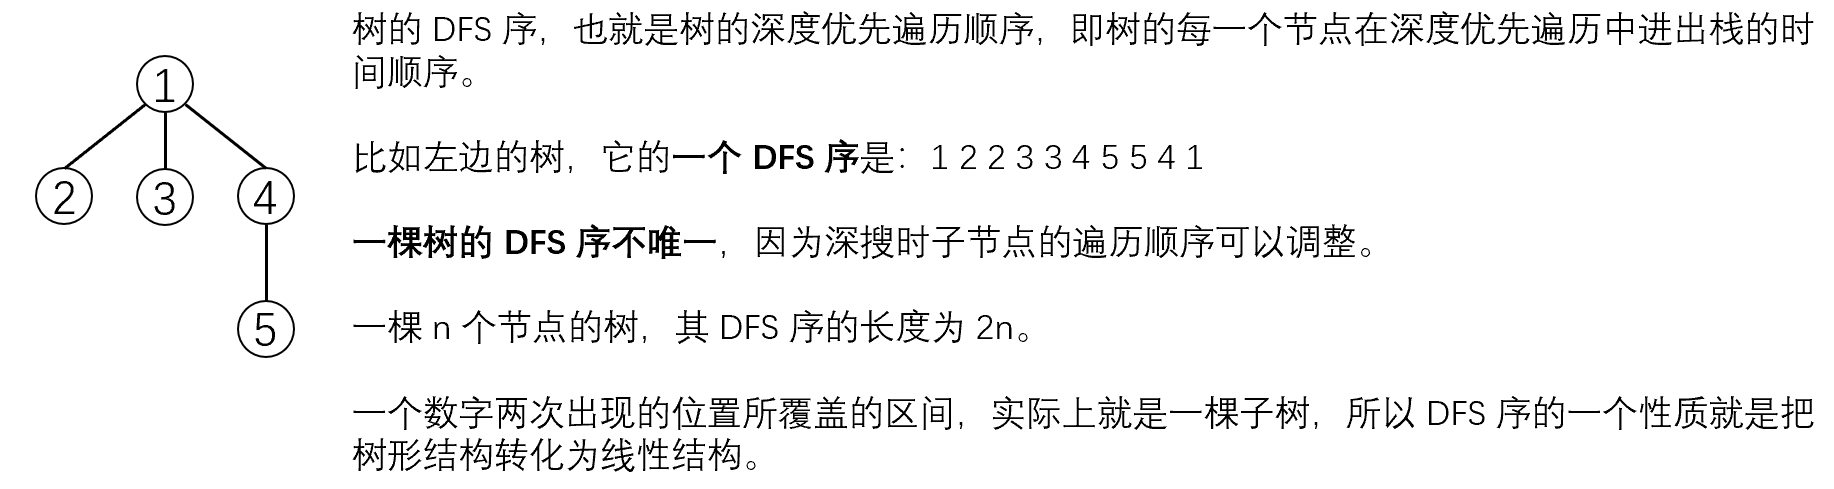
例题:P9305 「DTOI-5」校门外的枯树
定义 \(S_i\) 为按照 DFS 顺序访问节点时,到达节点 \(i\) 时累计的边权前缀和(注意这里的 DFS 顺序需要严格按照题目给定的“从左往右”遍历子节点的顺序),设 \(s_i\) 为从根节点到节点 \(i\) 的路径上的边权和。
当选择路径 \(u \to v\) 作为分割路径时:
- 左半部分的边权和 \(L\):由于 DFS 是先遍历左子树,再遍历右子树。对于路径上的任意节点,其左侧所有的分支(即已经遍历过的部分)的边权和实际上被包含在 \(S_v - S_u\) 中。但 \(S_v - S_u\) 同时也包含了路径 \(u \to v\) 本身的边权,因此,分割后的左半部分边权和 \(L = (S_v - S_u) - (s_v - s_u)\)。
- 右半部分的边权和 \(R\):右半部分包含了路径右侧的所有分支,这些分支将在访问完 \(v\) 之后被遍历,直到 \(u\) 的子树遍历结束。设 \(l_u\) 为 \(u\) 子树中 DFS 序最大的叶子节点(这可以预处理),那么 \(S_{l_u}\) 就代表了遍历完 \(u\) 的整个子树后的累计边权和。因此,右半部分边权和 \(R = S_{l_u} - S_v\)。
对于每个节点 \(u\),需要在其子树的所有叶子节点 \(v\) 中,找到一个 \(v\),使得 \(|L-R|\) 最小。
注意到随着 DFS 序的增加,选取的叶子节点 \(v\) 在子树中从左向右移动,\(L\) 会逐渐增加(左边的分支变多),\(R\) 会逐渐减少(右边的分支变少),这意味着 \(L-R\) 是关于叶子节点 DFS 序单调递增的。
因此,可以利用二分查找。
参考代码
#include <cstdio>
#include <vector>
#include <algorithm>
#include <cmath>

using std::min;
using std::abs;
using std::vector;

const int N = 1e5 + 5;
const int INF = 1e9 + 5;

// 定义边的结构体,包含目标顶点 v 和权重 m
struct Edge {
    int v, m;
};

// 邻接表存储图
vector<Edge> g[N];

// dfn_sum[v]: 按照DFS顺序遍历时,到达节点 v 时累计的边权总和
// sum[v]: 从根节点到节点 v 的路径边权和
// leaf[i]: 存储第 i 个叶子节点的编号
// leaf_cnt: 叶子节点的计数器
// bg[u]: 以 u 为根的子树中,包含的叶子节点在 leaf 数组中的起始下标
// ed[u]: 以 u 为根的子树中,包含的叶子节点在 leaf 数组中的结束下标
// tot: DFS 过程中的全局累加器,用于计算 dfn_sum
int dfn_sum[N], sum[N], leaf[N], leaf_cnt, bg[N], ed[N], tot;

// 深度优先搜索,用于预处理各项数据
void dfs(int u) {
    for (Edge e : g[u]) {
        int v = e.v, m = e.m;
        // tot 是按照 DFS 访问顺序累加的边权和
        // 这里的逻辑是:进入子树前加边权
        tot += m;
        dfn_sum[v] = tot;
        // sum[v] 是从根到 v 的路径权值和
        sum[v] = sum[u] + m;

        dfs(v);

        // 更新 u 子树的叶子区间
        // 如果 u 还没有记录起始叶子(即访问第一个子节点时),则继承该子节点的起始叶子
        if (bg[u] == 0) bg[u] = bg[v];
        // 每次访问完一个子节点,都更新 u 的结束叶子为当前子节点的结束叶子
        ed[u] = ed[v];
    }
    // 如果 u 是叶子节点(没有子节点)
    if (g[u].size() == 0) {
        leaf_cnt++;
        leaf[leaf_cnt] = u;
        // 叶子节点的叶子区间就是它自己
        bg[u] = ed[u] = leaf_cnt;
    }
}

// 初始化函数,清空上一组数据
void init(int n) {
    for (int i = 1; i <= n; i++) {
        g[i].clear();
        bg[i] = 0;
    }
    tot = 0;
    leaf_cnt = 0;
}

// 计算不平衡度的核心函数
// 参数 u: 当前子树的根节点
// 参数 v: u 子树中的某个叶子节点,代表选择的分割路径终点
// 返回值: 路径 (u -> v) 将 u 子树分割为左右两部分后的 (左权值和 - 右权值和)
int imbalance(int u, int v) {
    int l = dfn_sum[v] - dfn_sum[u] - (sum[v] - sum[u]);
    int r = dfn_sum[leaf[ed[u]]] - dfn_sum[v];
    return l - r;
}

// 计算节点 u 的子树的最小不平衡度
// 利用二分查找在有序的叶子节点序列中寻找最优解
int calc(int u) {
    int l = bg[u], r = ed[u];
    // 叶子节点的 imbalance 值随 DFS 序单调递增(因为左边部分越来越多,右边越来越少)
    // 要找 imbalance 最接近 0 的点
    while (l <= r) {
        int mid = (l + r) / 2;
        // 如果 imbalance < 0,说明左边轻右边重,需要往右找(增加左边,减少右边)
        if (imbalance(u, leaf[mid]) < 0) {
            l = mid + 1;
        } else {
            // 否则往左找
            r = mid - 1;
        }
    }

    int res = INF;
    // 检查二分结束位置附近的两个点,取绝对值最小的
    if (l <= ed[u]) res = min(res, abs(imbalance(u, leaf[l])));
    if (r >= bg[u]) res = min(res, abs(imbalance(u, leaf[r])));
    return res;
}

void solve(int k) {
    int n;
    scanf("%d", &n);
    init(n);
    for (int i = 1; i <= n; i++) {
        int x;
        scanf("%d", &x);
        for (int j = 1; j <= x; j++) {
            int v, m;
            scanf("%d%d", &v, &m);
            g[i].push_back({v, m});
        }
    }

    // 根节点从 1 开始 DFS
    dfs(1);

    if (k == 1) {
        // k=1 时只计算整棵树的不平衡度
        printf("%d\n", calc(1));
    } else {
        // k=2 时计算每个节点子树的不平衡度
        for (int i = 1; i <= n; i++)
            printf("%d ", calc(i));
        printf("\n");
    }
}

int main() {
    int t, k;
    scanf("%d%d", &t, &k);
    for (int i = 1; i <= t; i++) {
        solve(k);
    }
    return 0;
}
例题:P3459 [POI2007] MEG-Megalopolis
给定一棵 \(n\) 个节点的树,根节点为 \(1\),开始每条边边权为 \(1\)。有 \(m+n-1\) 次操作,每次修改操作使得某条边边权为 \(0\),每次查询操作询问 \(1\) 到某个点的边权和。
数据范围:\(n \le 250000\)。
如果从 DFS 序列的角度考虑,将每个节点在 DFS 中的第一个出现位置看作 +1,第二个位置看作 -1,则每次查询相当于查询序列的前缀和,而修改操作相当于对该条边的子节点在 DFS 序列中两次出现的位置做单点更新。
参考代码
#include <cstdio>
#include <vector>
using std::vector;
const int N = 250005;
vector<int> tree[N];
int n, in[N], out[N], idx, bit[N * 2];
char op[5];
int lowbit(int x) {
    return x & -x;
}
void update(int x, int d) {
    while (x <= 2 * n) {
        bit[x] += d; x += lowbit(x);
    }
}
int query(int x) {
    int res = 0;
    while (x > 0) {
        res += bit[x];
        x -= lowbit(x);
    }
    return res;
}
void dfs(int u, int fa) {
    idx++; in[u] = idx;
    update(idx, 1);
    for (int v : tree[u]) {
        if (v == fa) continue;
        dfs(v, u);
    }
    idx++; out[u] = idx;
    update(idx, -1);
}
int main()
{
    scanf("%d", &n);
    for (int i = 1; i < n; i++) {
        int a, b; scanf("%d%d", &a, &b);
        tree[a].push_back(b); tree[b].push_back(a);
    }
    dfs(1, 0);
    int m; scanf("%d", &m);
    for (int i = 1; i <= n + m - 1; i++) {
        scanf("%s", op);
        if (op[0] == 'A') {
            int x, y; scanf("%d%d", &x, &y);
            int z = in[x] < in[y] ? y : x;
            update(in[z], -1); update(out[z], 1);
        } else {
            int x; scanf("%d", &x);
            printf("%d\n", query(in[x]) - 1);
        }
    }
    return 0;
}
例题:P14363 [CSP-S 2025] 谐音替换
给定 \(n \ (1 \le n \le 2 \times 10^5)\) 个字符串二元组 \((s_{i,1}, s_{i,2})\),第 \(i\) 个二元组的两个字符串长度均相等。有 \(q \ (1 \le q \le 2 \times 10^5)\) 次询问,每次给定两个不同的字符串 \(t_{j,1}, t_{j,2}\),且 \(|t_{j,1}| = |t_{j,2}|\)。需要求出有多少种合法的替换方案,使得 \(t_{j,1}\) 在经过一次替换后变成 \(t_{j,2}\)。一次“替换”定义为:选取 \(t_{j,1}\) 的一个子串 \(y\),若存在 \(s_{i,1} = y\),则将其替换为 \(s_{i,2}\)。两种替换方案不同,当且仅当被替换的子串在 \(t_{j,1}\) 中的位置不同,或使用的二元组编号 \(i\) 不同。所有字符串总长度 \(L\) 满足 \(2 \le L \le 5 \times 10^6\),字符串均仅包含小写英文字母。
对于单次询问 \((t_1, t_2)\),由于只进行一次替换,且替换区间之外的部分不发生改变,这意味着 \(t_1\) 和 \(t_2\) 中不同的部分必须完全包含在替换的子串范围内。通过比对可以找出 \(t_1, t_2\) 第一个不同的字符位置 \(d\) 和最后一个不同的字符位置 \(e\),任何合法的替换所覆盖的区间必须包含区间 \([d,e]\)。由于区间外的字符保持一致,所选用的二元组 \((s_{i,1}, s_{i,2})\) 的不同之处也必定严格对应于 \(t_1[d \dots e]\) 和 \(t_2[d \dots e]\)。如果将每次询问或给定的二元组中不一致的核心差异部分提取出来,只有该差异部分完全相同的 \((s_{i,1}, s_{i,2})\) 和 \((t_1, t_2)\) 才有匹配的可能性。在差异一致的前提下,还需要 \(t_1\) 在差异部分左侧的前缀能和 \(s_{i,1}\) 左侧的前缀匹配,右侧的后缀也能和 \(s_{i,2}\) 的后缀匹配。
对于每一个询问 \((t_1, t_2)\),找到差异区间 \([d,e]\)。枚举所有的二元组,若 \(s_{i,1}\) 的长度能够覆盖 \([d,e]\),则枚举起始匹配位置,利用字符串哈希快速判断 \(t_1, t_2\) 对应的子串是否等于 \(s_{i,1}, s_{i,2}\)。时间复杂度为 \(O(q \cdot L)\),可以通过测试点 \(1 \sim 5\) 和特殊性质 A 即 \(q = 1\) 的测试点。
对于特殊性质 B,每个字符串均仅包含字符 a 和 b,且字符 b 在每个字符串中恰好只出现一次。因为 b 恰好出现一次,这大大简化了匹配条件。
设二元组 \((s_{i,1}, s_{i,2})\) 的长度为 \(l\),其中 b 在 \(s_{i,1}\) 中的位置为 \(x\)(从 \(0\) 开始计数),在 \(s_{i,2}\) 中的位置为 \(y\)。设询问 \(t = (t_{j,1}, t_{j,2})\) 的长度为 \(m\),其中 b 在 \(t_{j,1}\) 中的位置为 \(b_1\),在 \(t_{j,2}\) 中的位置为 \(b_2\)。
在二元组中,a 替换为 a 位置不变,唯一的“改变”就是将 \(s_{i,1}\) 中位于 \(x\) 的 b 替换为了位于 \(y\) 的 b。因此,替换导致 b 的位置变化量(偏移量)为 \(\Delta = x - y\)。同理,询问 \(t_1 \to t_2\) 使得 b 位置发生改变,其所需的偏移量必须为 \(\Delta = b_1 - b_2\)。只有满足 \(x-y=b_1-b_2\) 的二元组 \(s_i\),才有可能匹配询问 \(t\)。
假设 \(s_{i,1}\) 匹配的是 \(t_1\) 中从索引 \(p\) 开始、长度为 \(l\) 的子串,即 \(t_1[p \dots p+l-1] = s_{i,1}\)。由于 \(s_{i,1}\) 中唯一的 b 在相对位置 \(x\),那么它在 \(t_1\) 中对应的绝对位置必须是 \(p+x\)。因为 \(t_1\) 中也只有一个 b 位于 \(b_1\),所以必有 \(p+x = b_1 \implies p = b_1 - x\),匹配起始位置 \(p\) 是被唯一确定的。
子串匹配需要满足起点 \(p \ge 0\) 以及终点 \(p+l-1 \le m-1\),即 \(p+l \le m\)。将 \(p = b_1 - x\) 代入上述两个不等式得到 \(x \le b_1\) 和 \(l-x \le m-b_1\)。
因此,对于某组偏移量相同,即 \(x-y = b_1 - b_2 = \Delta\) 的数据,每个二元组 \(s_i\) 可以抽象为一个二维平面上的点 \((X_i, Y_i)\),其中 \(X_i = x, Y_i = l - x\),每个询问 \(t\) 可以抽象为一个二维偏序查询区间 \((K_1, K_2)\),其中 \(K_1 = b_1, K_2 = m - b_1\)。询问 \(t\) 能够被二元组 \(s_i\) 匹配,当且仅当该店满足二维偏序条件,即求平面上满足 \(x \le b_1\) 且 \(l - x \le m - b_1\) 的点 \((x, l-x)\) 的数量。这个问题可以通过离线处理询问加树状数组实现,从而使得在特殊性质 B 下,总时间复杂度为 \(O(L + (n+q) \log n)\)。
参考代码(70 分)
#include <iostream>
#include <vector>
#include <string>
#include <algorithm>
using namespace std;
using ull = unsigned long long;
const int B = 131;
const int L = (int)5e6 + 5;
int n, q;
ull pw[L];
vector<int> len;
vector<string> s1, s2, t1, t2;
void fastIO() {
	ios::sync_with_stdio(false);
	cin.tie(nullptr);
}
namespace SPB {
	struct Pair {
		int l, x, y;
	};
	struct Query {
		int id, m, b1, b2;
	};
	struct BIT {
		int sz;
		vector<int> c;
		void init(int s) {
			sz = s;
			c.assign(s + 1, 0);
		}
		void add(int i) {
			while (i <= sz) {
				c[i]++;
				i += i & -i;
			}
		}
		int query(int i) {
			int res = 0;
			while (i > 0) {
				res += c[i];
				i -= i & -i;
			}
			return res;
		}
	};
	bool check(const string &s) {
		bool b = false;
		for (char c : s) {
			if (c == 'b') {
				if (b) return false;
				b = true;
			} else if (c != 'a') return false;
		}
		return true;
	}
	void solve() {
		vector<Pair> s(n);
		for (int i = 0; i < n; i++) {
			s[i].l = len[i];
			for (int j = 0; j < len[i]; j++) if (s1[i][j] == 'b') s[i].x = j;
			for (int j = 0; j < len[i]; j++) if (s2[i][j] == 'b') s[i].y = j;
		}
		vector<Query> qry;
		for (int i = 0; i < q; i++) {
			if (t1[i].length() != t2[i].length()) continue;
			Query cur; cur.m = t1[i].length(); cur.id = i;
			for (int j = 0; j < cur.m; j++) if (t1[i][j] == 'b') cur.b1 = j;
			for (int j = 0; j < cur.m; j++) if (t2[i][j] == 'b') cur.b2 = j;
			qry.push_back(cur);
		}
		// 二元组按 (s1的b位置差, s1的b位置) 排序;询问按 (差, t1的b位置) 排序
		sort(s.begin(), s.end(), [](Pair a, Pair b) {
			int da = a.x - a.y, db = b.x - b.y;
			if (da != db) return da < db;
			return a.x < b.x;
		});
		sort(qry.begin(), qry.end(), [](Query a, Query b) {
			int da = a.b1 - a.b2, db = b.b1 - b.b2;
			if (da != db) return da < db;
			return a.b1 < b.b1;
		});
		vector<int> ans(q);
		int qi = 0, si = 0, qn = qry.size();
		while (qi < qn) {
			int delta = qry[qi].b1 - qry[qi].b2;
			int qj = qi;
			while (qj < qn && qry[qj].b1 - qry[qj].b2 == delta) qj++;
			while (si < n && s[si].x - s[si].y < delta) si++;
			if (s[si].x - s[si].y == delta) {
				// 组内对 (l-x) 做离散化 + 树状数组
				int sj = si;
				vector<int> v;
				while (sj < n && s[sj].x - s[sj].y == delta) {
					v.push_back(s[sj].l - s[sj].x);
					sj++;
				}
				sort(v.begin(), v.end());
				v.erase(unique(v.begin(), v.end()), v.end());
				BIT bit; bit.init(v.size());
				int sk = si;
				for (int i = qi; i < qj; i++) {
					while (sk < sj && s[sk].x <= qry[i].b1) { // 满足 x<=b1
						bit.add(lower_bound(v.begin(), v.end(), s[sk].l - s[sk].x) - v.begin() + 1);
						sk++;
					}
					// 统计 l - x <= m - b1
					ans[qry[i].id] = bit.query(upper_bound(v.begin(), v.end(), qry[i].m - qry[i].b1) - v.begin());
				}
			}
			qi = qj;
		}
		for (int i = 0; i < q; i++) cout << ans[i] << "\n";
	}
}
namespace Brute {
	void init() {
		pw[0] = 1;
		for (int i = 0; i < (int)5e6; i++) {
			pw[i + 1] = pw[i] * B;
		}
	}
	ull getHash(const string &s) {
		ull h = 0;
		for (char c : s) {
			h = h * B + (c - 'a' + 1);
		}
		return h;
	}
	void solve() {
		init();
		vector<int> a(n), b(n); // s1的哈希、s2的哈希
		for (int i = 0; i < n; i++) {
			a[i] = getHash(s1[i]);
			b[i] = getHash(s2[i]);
		}
		for (int i = 0; i < q; i++) {
			if (t1[i].length() != t2[i].length()) {
				cout << "0\n"; continue;
			}
			int m = t1[i].length();
			int d = -1, e = -1; // 第一个、最后一个不同的位置
			for (int j = 0; j < m; j++) {
				if (t1[i][j] != t2[i][j]) {
					if (d == -1) d = j;
					e = j;
				}
			}
			int l0 = e - d + 1;
			// t1、t2的前缀哈希
			vector<ull> f(m + 1), g(m + 1);
			for (int j = 0; j < m; j++) {
				f[j + 1] = f[j] * B + (t1[i][j] - 'a' + 1);
				g[j + 1] = g[j] * B + (t2[i][j] - 'a' + 1);
			}
			int ans = 0;
			for (int j = 0; j < n; j++) {
				int l = len[j];
				if (l < l0 || l > m) continue;
				// 区间必须覆盖 [d, e]
				int low = max(0, e - l + 1), high = min(d, m - l);
				for (int p = low; p <= high; p++) {
					int x = f[p + l] - f[p] * pw[l];
					if (x != a[j]) continue; // t1[p~p+l-1]必须等于s1[j]
					int y = g[p + l] - g[p] * pw[l];
					if (y == b[j]) ans++; // t2[p~p+l-1]必须等于s2[j]
				}
			}
			cout << ans << "\n";
		}
	}
}
int main()
{
	fastIO();
	cin >> n >> q;
	len.resize(n);
	s1.resize(n); s2.resize(n);
	bool pb = true;
	for (int i = 0; i < n; i++) {
		cin >> s1[i] >> s2[i];
		len[i] = s1[i].length();
		if (pb && !SPB::check(s1[i])) pb = false;
		if (pb && !SPB::check(s2[i])) pb = false;
	}
	t1.resize(q); t2.resize(q);
	for (int i = 0; i < q; i++) {
		cin >> t1[i] >> t2[i];
		if (pb && !SPB::check(t1[i])) pb = false;
		if (pb && !SPB::check(t2[i])) pb = false;
	}
	if (pb) {
		SPB::solve();
		return 0;
	}
	Brute::solve();
	return 0;
}
对于一般情况,还是找出字符串对中第一个不同的位置 \(d\) 和最后一个不同的位置 \(e\),定义其核心差异串为将 \(t_1[d \dots e]\) 与 \(t_2[d \dots e]\) 按位置交叉拼接的得到的特征串。若 \(t_j\) 能够由 \(s_i\) 替换得到,首要必要条件就是 \(t_j\) 的核心差异串必须与 \(s_i\) 的核心差异串完全相同。因此,可以用哈希表对所有的二元组和询问进行分组。只有同一组内的二元组和询问才有可能匹配,不同组之间互不影响。
在核心差异一致的前提下,二元组 \(s_i\) 的剩余部分必须与 \(t_j\) 剩余的前后部分匹配:\(s\) 在 \(d\) 左侧的部分必须是 \(t\) 在 \(d\) 左侧部分的后缀,\(s\) 在 \(e\) 右侧的部分必须是 \(t\) 在 \(e\) 右侧部分的前缀。为了将问题同一处理,可以反转 \(s\) 和 \(t\) 分别在 \(d\) 左侧的部分,这样后缀关系就转化为了前缀关系,与 \(e\) 右侧部分的关系要求统一。
对于某一个分组,建立左 trie 树 \(T_L\),插入该组内所有二元组的左侧反转串,建立右 trie 树 \(T_R\),插入该组内所有二元组的右侧串。每个二元组 \(s_i\) 会在 \(T_L\) 和 \(T_R\) 中分别落在一个终端节点上,记为 \((u, v)\)。
对于该组的一个询问 \(t_j\),在 \(T_L\) 上查询其左侧反转串,找到最长匹配到的节点 \(p\)。在 \(T_R\) 上查询其右侧串,找到最长匹配到的节点 \(q\)。二元组 \(s_i\) 能匹配询问 \(t_j\),当且仅当 \(s_i\) 在 \(T_L\) 上的节点 \(u\) 是 \(p\) 的祖先(包含 \(u = p\) 的情况),\(s_i\) 在 \(T_R\) 上的节点 \(v\) 是 \(q\) 的祖先(包含 \(v=q\) 的情况)。
对 \(T_L\) 和 \(T_R\) 分别进行 DFS 遍历,记录每个节点进入和离开的时间戳 \(l_u, r_u\)。在树中,节点 \(u\) 是 \(p\) 的祖先 \(\iff\) \(p\) 的入时间戳落入 \(u\) 的 DFS 序区间内,即 \(l_u \le l_p \le r_u\)。于是,“\(u\) 是 \(p\) 的祖先”等价于 \(l_p \in [l_u, r_u]\)。同理,:“\(v\) 是 \(q\) 的祖先”等价于 \(l_q \in [l_v, r_v]\)。
现在,将 \(T_L\) 的 DFS 序作为横轴 \(X\),\(T_R\) 的 DFS 序作为纵轴 \(Y\),构成一个二维平面。每个二元组 \(s_i\) 不再是一个单点,而是在二维平面上形成了一个闭矩形区域 \([l_u, r_u] \times [l_v, r_v]\),任何坐标 \((x,y)\) 落在此矩形内的询问,都能被 \(s_i\) 匹配到。每个询问 \(t_j\) 对应二维平面上的一个坐标点 \((l_p, l_q)\),求有多少种合法的替换方案,就完全等价于求二维平面上的点 \((l_p, l_q)\) 被多少个二元组矩形 \([l_u, r_u] \times [l_v, r_v]\) 所覆盖。而这个问题可以通过二维差分加扫描线的思想,将一个矩形拆分为 4 个扫描线事件,再配合树状数组维护实时的计数信息,总时间复杂度为 \(O(L + (n+q) \log L)\)。
参考代码(100 分)
#include <iostream>
#include <string>
#include <unordered_map>
#include <vector>
#include <algorithm>
using namespace std;
void fastIO() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
}
struct Trie {
    vector<vector<int>> f;
    vector<int> l, r;
    int tim;
    Trie() {
        f.push_back(vector<int>(26));
    }
    int insert(const string &s) {
        int u = 0;
        for (char c : s) {
            int x = c - 'a';
            if (f[u][x] == 0) {
                f[u][x] = f.size();
                f.push_back(vector<int>(26));
            }
            u = f[u][x];
        }
        return u;
    }
    void dfs(int u) {
        l[u] = ++tim;
        for (int i = 0; i < 26; i++) {
            if (f[u][i]) dfs(f[u][i]);
        }
        r[u] = tim;
    }
    void calc() {
        l.resize(f.size());
        r.resize(f.size());
        tim = 0;
        dfs(0);
    }
    int query(const string &s) {
        int u = 0;
        for (char c : s) {
            int x = c - 'a';
            if (f[u][x]) u = f[u][x];
            else return u;
        }
        return u;
    }
};
vector<Trie> sl, sr;
struct Event {
    int x, y, v;
};
struct Query {
    int id, l, r;
};
struct BIT {
    int n;
    vector<int> c;
    void init(int sz) {
        n = sz;
        c.assign(n + 1, 0);
    }
    void add(int i, int d) {
        while (i <= n) { c[i] += d; i += i & -i; }
    }
    int query(int i) {
        int res = 0;
        while (i > 0) { res += c[i]; i -= i & -i; }
        return res;
    }
};
int main()
{
    int n, q; cin >> n >> q;
    unordered_map<string, int> h;
    int id = 0;
    vector<int> bel(n), ed_l(n), ed_r(n);
    for (int i = 0; i < n; i++) {
        string s1, s2; cin >> s1 >> s2;
        int l = s1.length(), d = -1, e = -1;
        for (int j = 0; j < l; j++) {
            if (s1[j] != s2[j]) {
                if (d == -1) d = j;
                e = j;
            }
        }
        string s;
        for (int j = d; j <= e; j++) {
            s += s1[j]; s += s2[j];
        }
        int cur;
        if (h.find(s) == h.end()) {
            cur = id;
            h[s] = id++;
            sl.push_back(Trie());
            sr.push_back(Trie());
        } else {
            cur = h[s];
        }
        s.clear();
        for (int j = d - 1; j >= 0; j--) s += s1[j];
        ed_l[i] = sl[cur].insert(s);
        s.clear();
        for (int j = e + 1; j < l; j++) s += s2[j];
        ed_r[i] = sr[cur].insert(s);
        bel[i] = cur;
    }
    for (int i = 0; i < id; i++) {
        sl[i].calc(); sr[i].calc();
    }
    vector<vector<Event>> evt(id);
    for (int i = 0; i < n; i++) {
        int cur = bel[i];
        int x1 = sl[cur].l[ed_l[i]], y1 = sr[cur].l[ed_r[i]];
        int x2 = sl[cur].r[ed_l[i]], y2 = sr[cur].r[ed_r[i]];
        evt[cur].push_back({x1, y1, 1});
        evt[cur].push_back({x1, y2 + 1, -1});
        evt[cur].push_back({x2 + 1, y1, -1});
        evt[cur].push_back({x2 + 1, y2 + 1, 1});
    }
    for (int i = 0; i < id; i++) {
        sort(evt[i].begin(), evt[i].end(), [](Event a, Event b) {
            if (a.x != b.x) return a.x < b.x;
            return a.y < b.y;
        });
    }
    vector<int> ans(q);
    vector<vector<Query>> qry(id);
    for (int i = 0; i < q; i++) {
        string t1, t2;
        cin >> t1 >> t2;
        if (t1.length() != t2.length()) continue;
        int l = t1.length(), d = -1, e = -1;
        for (int j = 0; j < l; j++) {
            if (t1[j] != t2[j]) {
                if (d == -1) d = j;
                e = j;
            }
        }
        string s;
        for (int j = d; j <= e; j++) {
            s += t1[j]; s += t2[j];
        }
        if (h.find(s) == h.end()) continue;
        int cur = h[s];
        s.clear();
        for (int j = d - 1; j >= 0; j--) s += t1[j];
        int ql = sl[cur].query(s);
        s.clear();
        for (int j = e + 1; j < l; j++) s += t2[j];
        int qr = sr[cur].query(s);
        qry[cur].push_back({i, sl[cur].l[ql], sr[cur].l[qr]});
    }
    for (int i = 0; i < id; i++) {
        sort(qry[i].begin(), qry[i].end(), [](Query a, Query b) {
            if (a.l != b.l) return a.l < b.l;
            return a.r < b.r;
        });
    }
    for (int i = 0; i < id; i++) {
        if (qry[i].size() > 0) {
            BIT bit; bit.init(sr[i].tim);
            int si = 0, sn = evt[i].size();
            for (Query cur : qry[i]) {
                while (si < sn && evt[i][si].x <= cur.l) {
                    bit.add(evt[i][si].y, evt[i][si].v);
                    si++;
                }
                ans[cur.id] = bit.query(cur.r);
            }
        }
    }
    for (int i = 0; i < q; i++) cout << ans[i] << "\n";
    return 0;
}

 浙公网安备 33010602011771号