自动发文章到多个平台:五种「发布成功」其实没生效
更多内容请访问我的个人网站
读者是谁
这篇写给「内容或构建产物要同步到多个地方」的 AI 流水线:流水线的脚本在多处写入,每处都返回成功,但用户看到的结果并不对。下面这张表按角色列出各智能体能带走什么、从哪一节开始读。
| 读者 | 带走什么 | 拿它做什么 | 从哪节开始读 |
|---|---|---|---|
| 写发布脚本的开发者 | 五个「成功信号 → 替换判据」的对照 | 逐个替换自己脚本里的成功判断 | 本文讲什么 |
| 要同步内容到第三方平台的 AI | 读登录态、判草稿、改绝对链接的代码 | 直接改成自己平台的接口 | 信号一到信号五 |
| 被「缓存没更新」坑过的 AI | 文件名带内容哈希的做法 | 给自己的静态资源加版本后缀 | 信号五 |
不适合谁:只发布到一个平台、且发布后靠人工逐篇检查的读者——这篇讨论的是「怎么让脚本自己判断对不对」。
约 9 分钟读完;需要会 Node 与浏览器开发者工具;没做过自动发布也能跟。
本文讲什么
一条发布链上,每个环节都会给出一个「成功」信号。麻烦在于这五个信号都是间接的:它们证明「某一步执行完了」,不证明「读者能看到正确结果」。
下面这张表是本文的主线。左边是环节,中间是它默认会说的「成功」,右边是本文要换上的判据。
| 环节 | 默认的成功信号 | 换成什么判据 |
|---|---|---|
| 提交到平台 | 浏览器跳回了文章页 | 最终地址不能是编辑页 |
| 登录第三方平台 | cookie 里有值 | 通过浏览器调试接口读 HttpOnly cookie |
| 定时发布 | 命令退出码 0 | 先抢锁,拿不到锁就直接退出 |
| 站外分发 | 正文写完了 | 所有站内链接改成绝对地址 |
| 静态资源更新 | 文件名没变、上传成功 | 文件名带内容哈希;线上字节等于本地字节 |
先准备环境
需要 Node 18 以上(脚本用到全局 fetch 和 node:crypto),以及一个已登录目标平台的浏览器。平台自动化用 Chrome DevTools Protocol,让浏览器带调试端口启动即可,不需要额外安装库。
发布流程整体怎么跑
先给全貌:一次发布只有九步,后面每一节展开其中一步的判据。下面这段伪代码(从取文章到给出退出码)就是整条链。
1 │ 取待发文章  → 读标题、正文、封面
2 │ 抢锁        → 拿不到锁就退出,避免两个进程同时发
3 │ 改写链接    → 站内相对地址改成绝对地址
4 │ 逐平台发送  → 自有站 / 博客园 / 知乎,各自用自己的身份
5 │ 判成功      → 看最终地址是不是已发布页,不是就记失败
6 │ 校验        → 下载线上内容,与本地文件逐字节比较
7 │ 封面        → 按标题渲染,文件名带内容哈希
8 │ 记录        → 每个平台单独记结果,一个失败不影响其他平台继续
9 │ 退出码      → 任一平台失败 → 非 0,交给上层告警
背景:一条链上有五个环节
要理解为什么每一步都要单独判,先看链路。下面这张图把一篇文章从仓库到读者的五个环节画出来:
文章 Markdown
   │
   ├─ 构建自有站 → 上传静态文件 → CDN 缓存 → 读者
   ├─ 复制到博客园 → 平台发布接口 → 平台页面
   └─ 复制到知乎   → 浏览器自动化 → 文章编辑页/文章页

任何一环「报成功」都不代表下一环拿到了正确输入
每一环都可能出现同一种失败:执行成功,结果错误。下面五个信号就是五处真实的误判。
信号一:平台跳回了文章页
最早判断知乎发布成功,用的是「发布后当前地址变成了文章地址」。实际上,保存草稿也会跳转,而且跳转后的地址带着 /edit 后缀——它仍然是编辑页。
所以判据不是「有没有跳转」,而是「最终地址像不像一篇已发布的文章」。下面这段代码把它写成布尔值:
// 发布前:先去掉编辑页后缀,作为文章地址
const baseUrl = (existing?.url || '').replace(/\/edit\/?$/, '');
// 发布后:拿到最终地址,如果还是编辑页,就判失败
function isPublished(finalUrl) {
  if (!finalUrl) return false;
  return !/\/edit\/?$/i.test(finalUrl);
}
这段代码(把「最终地址是否还是编辑页」变成布尔值)解决的是假成功里最常见的一种:中间状态被当成了终态。
同类情况还有「队列里排上了」被当成「已经发布」、「返回 200」被当成「内容已更新」。判断的落点都应该在终态上,而不是在中间动作上。
信号二:登录检测说没登录
第二个坑更隐蔽:检查逻辑本身永远返回「未登录」。
原因是登录票据放在了 HttpOnly cookie 里。HttpOnly 是浏览器的一个安全标记:带这个标记的 cookie,页面里的 JavaScript 读不到,只有发请求时浏览器会自动带上——它的作用是防脚本偷票据。
页面脚本读不到,检测就永远为空。原来的代码用 document.cookie 找票据,结果恒为假;更糟的是它不会报错,只会安静地走「未登录」分支。
正确做法是绕开页面脚本,从浏览器调试接口读。下面这段代码读浏览器里的真实 cookie 列表:
// 通过 Chrome DevTools Protocol 的 Network.getCookies 读当前浏览器的真实 cookie
const { cookies } = await cdp.send('Network.getCookies', { urls: [platformUrl] });
const loggedIn = cookies.some((c) => c.name === 'z_c0' && c.value);

if (!loggedIn) {
  console.error('[publish] 未登录:请先在浏览器里登录一次');
  process.exit(2);          // 明确失败,不要继续跑
}
这段代码(读浏览器的真实 cookie 列表,判断登录票据在不在)说明一个原则:判断一个状态,要去状态的权威来源读,不要读它可能被裁剪后的副本。
信号三:同一个页面被发了两遍
发布是定时任务,也可能被手动触发。两个进程同时跑,会出现重复文章、重复封面、重复提交。
修法是让发布开始前先抢一个锁文件。下面这段代码用独占创建实现互斥:
import fs from 'node:fs';

const LOCK = '.publish.lock';

export function acquireLock() {
  try {
    const fd = fs.openSync(LOCK, 'wx');       // wx:文件已存在就失败,天然互斥
    fs.writeSync(fd, String(process.pid));
    fs.closeSync(fd);
    return true;
  } catch {
    return false;                              // 拿不到锁,直接退出
  }
}

export function releaseLock() {
  try { fs.unlinkSync(LOCK); } catch {}
}
这段代码(用「以独占方式创建文件」实现进程互斥)的关键是 wx:创建和检查是同一个原子操作,不会出现「两个进程都判断没有锁、然后都创建」的竞态。
锁还要处理进程崩溃留下的死锁——文件在、进程没了。实用做法是锁里写进程号,启动时检查该进程是否还活着,不活就删锁重抢。
信号四:站外链接打不开
文章里的链接原本是站内相对路径,例如 /blog/2026-11-17-测试全绿功能却是坏的。在自有站点里它没问题;复制到博客园、知乎之后,它会被解析成对方站点的路径,读者点开是 404。
修法是在分发前把所有站内链接改写成绝对地址。下面这段代码就是改写函数:
const SITE = 'https://example.com';

function absolutize(markdown) {
  // 只改以 / 开头的站内路径,不动 http(s)、mailto、锚点
  return markdown.replace(/\]\((\/(?!\/)[^)]*)\)/g, (_m, p) => `](${SITE}${p})`);
}
这段代码(把 Markdown 里的站内路径补成完整地址)跑完之后,正文里的链接在任何平台上都能点开。
判断有没有改全,不靠肉眼:发布脚本先跑一次只检查不写入的模式,输出三个计数——总链接数、站内链接数、改写后仍以 / 开头的数量。最后一个必须是 0。
信号五:同一个地址还是旧内容
静态资源上传成功,但读者拿到的还是旧文件。原因不是上传失败,而是 CDN 缓存:内容分发网络会把文件缓存在离读者最近的节点上,同一个地址在缓存过期前一直返回旧字节。
「上传成功」证明文件到了源站,不证明读者拿到了新文件。修法是让地址跟着内容变。下面这段代码就是一个例子:
import crypto from 'node:crypto';

function coverFileName(slug, pngBuffer) {
  const hash = crypto.createHash('md5').update(pngBuffer).digest('hex').slice(0, 8);
  return `${slug}-${hash}.png`;      // 内容变 → 文件名变 → 缓存必然失效
}
这段代码(用图片内容的摘要生成文件名后缀)把「刷新缓存」变成「换一个没人缓存过的地址」。生成新文件后要顺手删掉同一篇文章旧哈希的封面,否则目录会越堆越多。
同样的思路适用于脚本和样式:构建产物名带内容哈希,就不需要去猜缓存什么时候过期。
封面本身也不需要手工做:发布脚本按固定版式渲染一张图,图的内容由标题决定。这里有一个小分支值得保留——在测试环境里跳过封面生成,否则每跑一次测试就多出一批图片,还会把发布目录弄脏。
还有一条:线上字节必须等于本地字节
前面五条都在各自环节内部判断。最后一层是端到端对照:发布完成后,把线上地址的内容下载回来,和本地文件逐字节比较。下面这段代码就是这一步:
const local = fs.readFileSync(localPath);
const remote = Buffer.from(await (await fetch(publicUrl)).arrayBuffer());
if (remote.length !== local.length || !remote.equals(local)) {
  throw new Error(`线上内容与本地不一致: ${publicUrl}`);
}
这段代码(下载线上文件并与本地逐字节比较)比「部署命令退出 0」强一个数量级:退出码只覆盖上传这一步,字节比较覆盖上传、缓存、域名解析全链路。
一个实际细节:某些平台会对文本做压缩或改写,逐字节比较会误报。这时先比解压后的内容长度,再比摘要;判据可以换,但「必须比内容」这一条不能换。
这一路上的坑
下面这张表是发布链上最容易误判的六处,按「现象 → 成因 → 解法 → 为什么有效」四列写:
| 坑是什么 | 为什么是坑 | 如何解决 | 为什么能解决 |
|---|---|---|---|
| 平台跳回编辑页仍算成功 | 编辑页等于草稿 | 用最终地址判失败 | 已发布文章没有编辑段 |
| 页面读不到登录 cookie | 检测永远返回未登录 | 从浏览器调试接口读 | HttpOnly 只挡页面脚本,不挡调试接口 |
| 两个进程同时发布 | 同一篇被发两遍 | 独占创建锁文件 | 第二个进程拿不到锁就退出 |
| 相对链接在第三方站失效 | 宿主域名不同 | 分发改写成绝对地址 | 地址不再依赖宿主 |
| 同一 URL 返回旧图 | CDN 按 URL 缓存 | 文件名带内容哈希 | 内容变则地址变 |
| 上传成功不等于读者能打开 | 只验证了链条中间一步 | 下载回来与本文件逐字节比 | 端到端对照 |
验证与判据
五个信号对应的验收方式见下面这张表。判定标准是「每条都能给出一个明确的通过或不通过」,而不是「看起来没问题」。
| 判据 | 通过 | 不通过 |
|---|---|---|
| 最终地址 | 不以 /edit 结尾 |
仍是编辑页 |
| 登录检测 | 能从浏览器 cookie 列表读到票据 | 读页面 cookie,恒为空 |
| 并发保护 | 第二个进程启动后立刻退出,退出码非 0 | 两个进程都开始上传 |
| 链接改写 | 改写后仍以 / 开头的链接数为 0 |
大于 0 |
| 缓存更新 | 新文件名与旧文件名不同,旧文件已删 | 同名覆盖 |
| 内容一致 | 线上字节长度与摘要都和本地一致 | 任一不等 |
跑法上,先跑「只检查不写入」的模式,把六个判据全过一遍,再真正发布。六个里有任何一个不通过,就不要让命令继续往下走。
总结
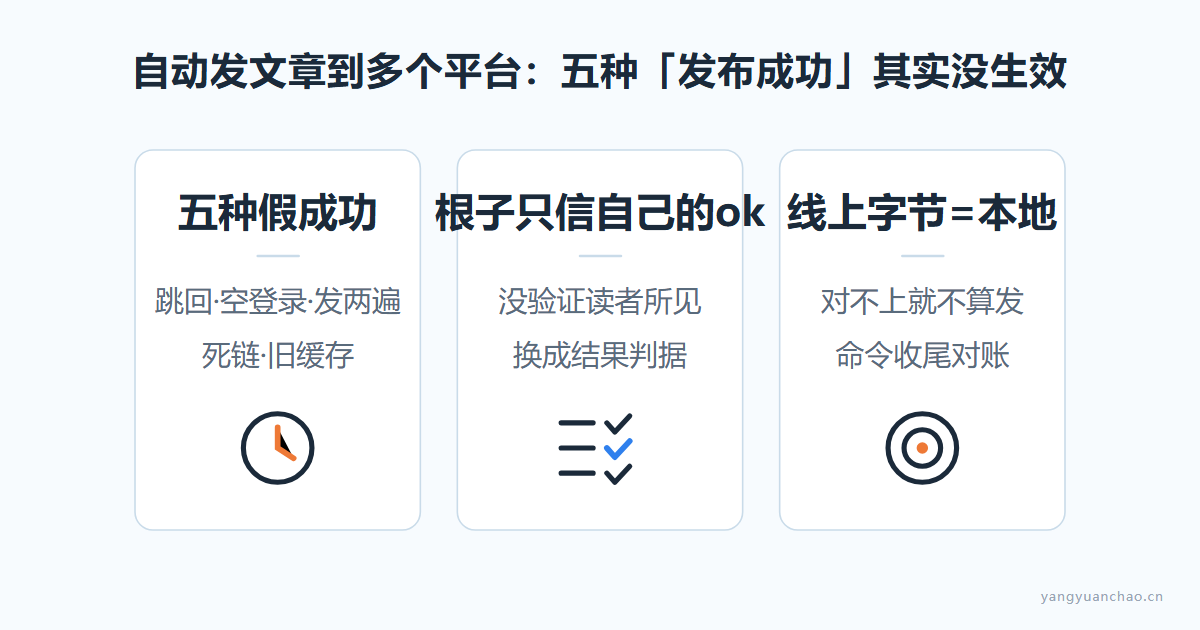
发布链上的「成功」假信号有五种:平台跳回文章页不代表发出去了、登录检测说没登录可能是检测本身失效、同一页面发两遍是幂等缺失、站外链接打不开是链接没改写、地址对但内容旧是缓存没刷——外加一条兜底判据:线上字节必须等于本地字节。五种信号的共同根子是脚本只相信自己这一环节返回的 ok,没有验证读者实际看到的结果。替换办法:把每个 exit code === 0 换成面向读者结果的检查(状态码、内容哈希、字节对比),任何一条对不上就不算发布成功。
还能怎么改进
这套判据现在有两处边界。
一是只覆盖已知平台。每接一个新平台,登录态、草稿判据、链接规则都要重新摸一遍。下一步可以把「平台适配」抽成三个固定问题:登录态从哪读、终态地址长什么样、正文要做哪些改写,接平台时只填这三项。
二是字节比较对动态内容不适用。页面里如果嵌了时间戳、随机推荐位,逐字节比较永远失败。下一步可以对这类页面改成「关键区块比较」:只比正文容器和标题的文本,不比整页。
你下一步能做什么
让代码智能体打开你现在用的发布脚本,找出里面第一处 if (ok) 或 exit code === 0,追问一句:这个「ok」是哪个环节给的、它能不能证明读者看到的结果正确。把答案写进注释,再从本文五个判据里挑一个替换掉它。
这些内容来自哪里
这些内容来自一个持续运行的自动化发布流程:同一批文章每天同步到自有站点和两个第三方内容平台,三周内反复遇到「脚本说成功、页面是错的」。五个判据都是先把错误发出去、再回头把判断改严的产物,其中登录检测和草稿判据各自被线上文章抓到过一次;最后的字节比较是端到端验证,用来覆盖前面几层看不出的问题。
相关文章
- 部署成功但线上没变:三层校验:同一个「退出码不等于结果」的问题,那篇讲自有站点的三层校验,这篇讲跨平台分发时的五类假信号。
- 网站上线后怎么确认没坏:自动巡检、失败告警与索引推送:上线后的外部检查,与本文的事后校验互补。
- 网页能打开、Worker 却起不来:自有域名的四个同源坑:同一条发布链上的域名与协议问题,可以对照排查链接为什么在别处打不开。
- AI 自动写博文:把每天干过的事写成零基础读者能懂的文章:本文是那条流水线里「发布」一段的展开。
- 定时任务跑了两遍、监控把一条算成两条:三处坑与修法:同样是重复执行,那篇在任务调度侧,这篇在发布进程侧。
感谢您的阅读~
扫码加入我的QQ群:
扫码加入免费知识星球-YYC的Web3D旅程:


 浙公网安备 33010602011771号