
attention, Positional encoding, transformer

1 一些概念
- Query, 当前元素
- Key,序列中的其他元素
- Value,求的加权结果和
2 Attention
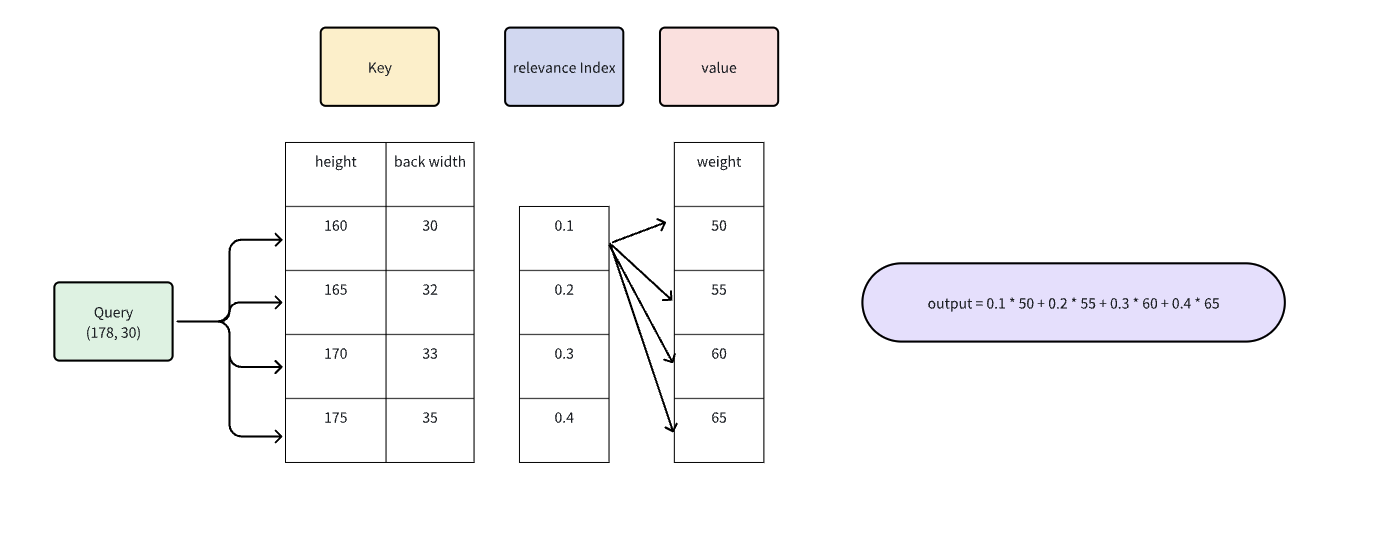
- dk 是k的维度,归一化,防止某一个 QK内积比较大,只关注一个
- QK是内积,
3 Self-Attention
QKV都变成了自身,在这基础之上需要让QKV参与到最终结果优化的过程中,那么需要对QKV加入权重与全连接网络,让权重参与到计算与更新的过程中来。
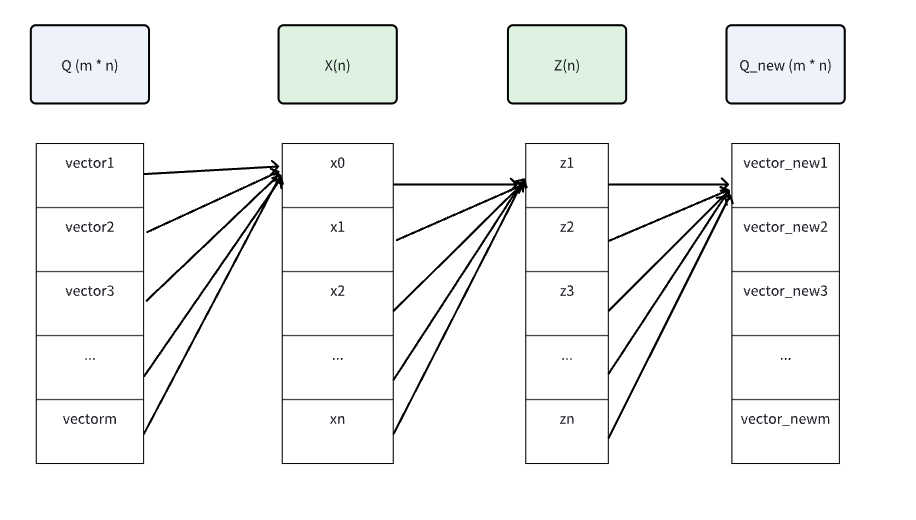
X、Z完成某种线性变换,强化需要强化的,弱化需要弱化的,对K、V进行同样的操作。
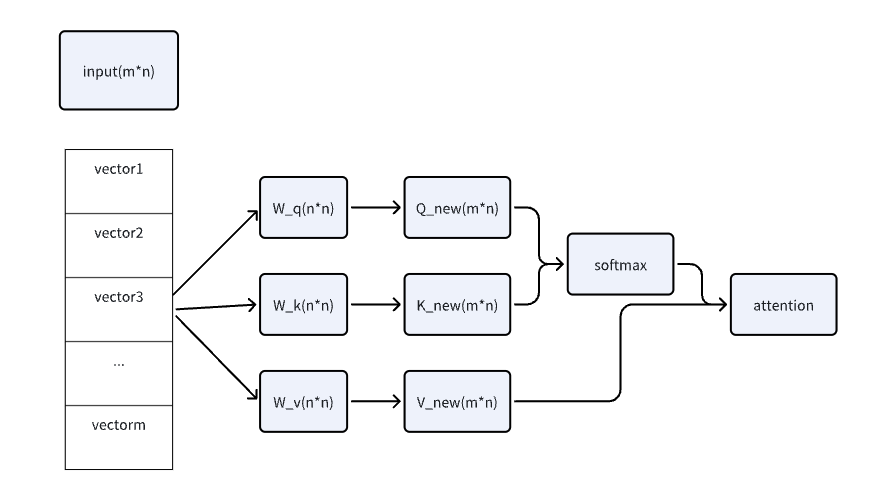
attention 也能进行叠加,相互提取信息
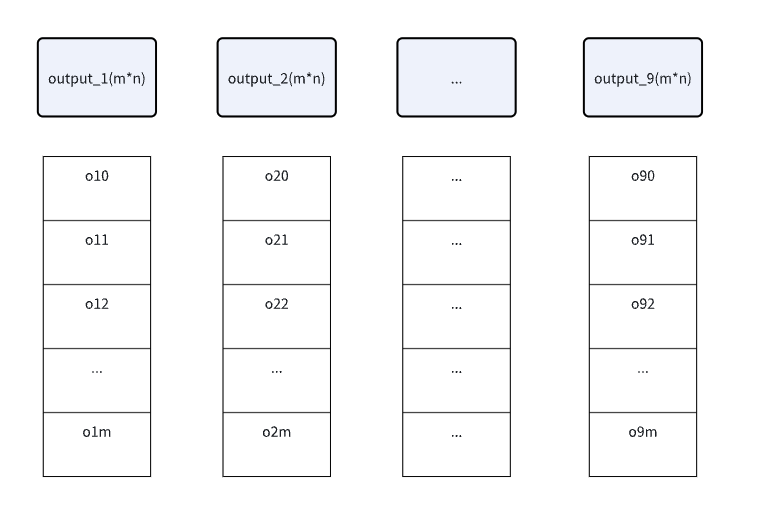
3 multi-headed attention
用尽一切办法聚合任何可能的语意信息. 对于self attention, 线性变换曾的权重不变,每次不同的输入,得到的结果会侧重同样的位置权重。输入序列会被划分为若干个“头”,每个头有自己独立的 query, key, value。最后所有的头 concatenate 在一起。类似于CNN中可以用不同的卷积核提取人脸不同部位的信息,例如嘴巴、鼻子、眼睛,这里的多头也是类似的概念,一套输入多套权重
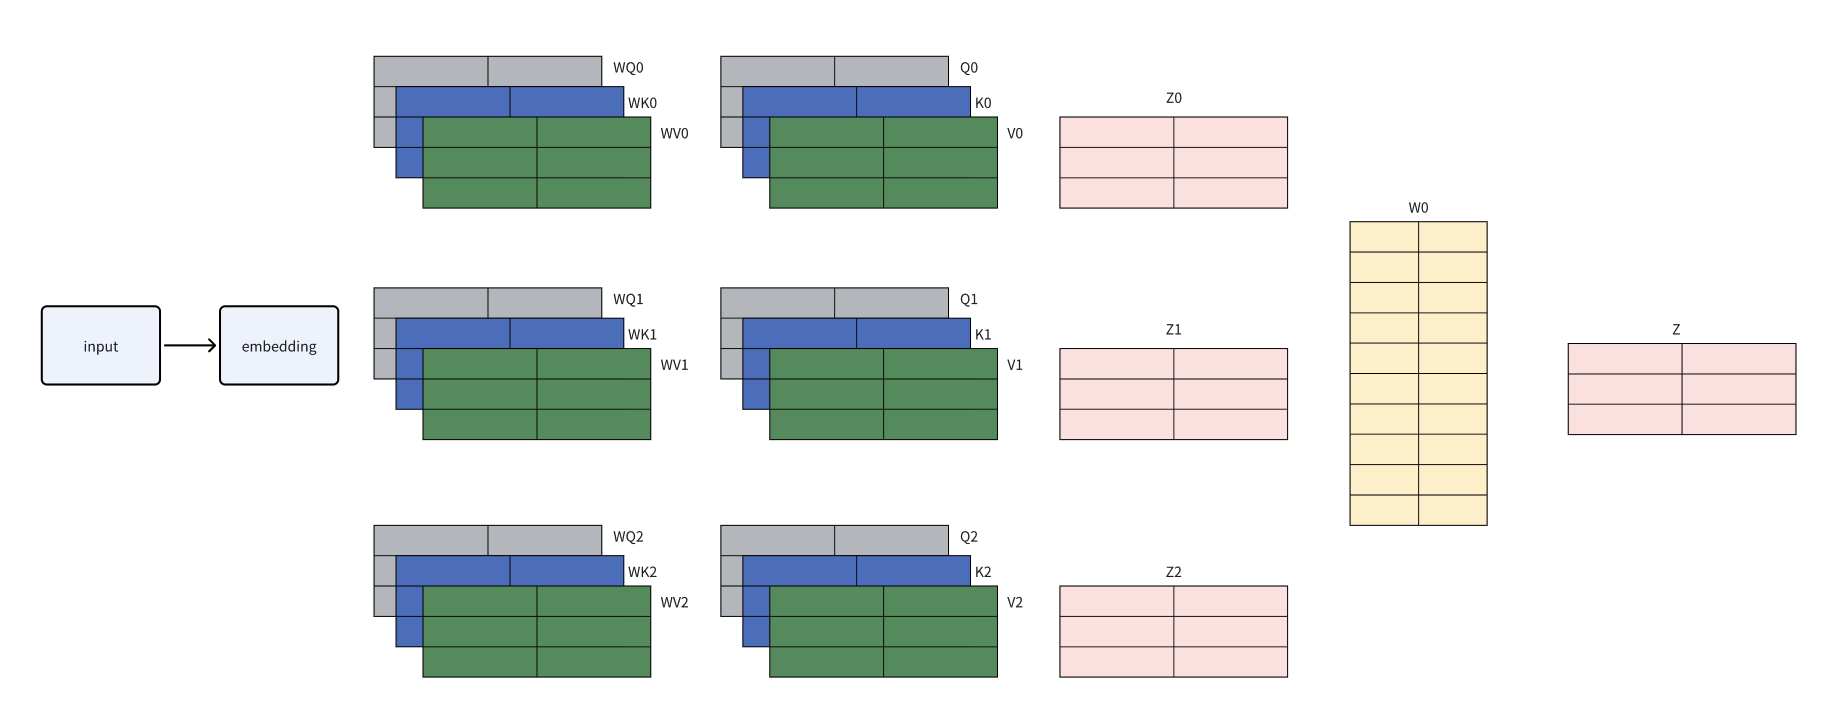
4 Positional encoding
看这个例子,a) 我打你,b) 你打我。
在self-attention中,QKV算的是QK的相关性,但是在上述例子中,主语和宾语的位置含义是不同的,a)中的我和 b)中的我,一个是打人者,一个是被打者,所以需要位置信息。这就是 positional encoding. 也就是不同位置的同一个token,虽然embedding一样,但是应该有不同的意义,所以输入到QKV中的应该是不同的。
原始的输入变成:
EMB(x1) + PE (1)
EMB(x2) + PE (2)
...
原始论文的PE为固定公式
$$PE(pos, 2i) = \sin\left(\frac{pos}{10000^{2i/d}}\right)$$
$$PE(pos, 2i+1) = \cos\left(\frac{pos}{10000^{2i/d}}\right)$$
- pos是位置
- i是 embedding的维度编号
- d 是总维度
输出为一个向量,维度和原始embedding向量一样。
Position 0
↓
[0,1,0,1,0,1...]

Position 1
↓
[0.84,0.54,0.10,0.99...]

Position 2
↓
[0.91,-0.42,0.20,0.98...]
前面的维度变化很快:
现在的大模型不用原始PE了,开始用新的方法, 是一个可学参数。
5 mask multi-headed attention
比如在算pos=2时候,不能用后面的单词信息,所以利用mask=11000000来算, pos=3, mask=11100000. 防止盗用未来的信息。
6 cross-attention
QK用的输入的,V用的输出的。self-attention都是用的输入的。

 浙公网安备 33010602011771号