
摘要:  上一章咱们给数据库装了个“写缓存”,相当于在市中心车库外建了个临时停车场。确实,车流(写操作)不堵门了。但问题是——这停车场是露天的,且只有三个车位。一旦遇上“双十一”式的高频数据洪流(想象一群饿疯了的吃货同时涌向自助餐厅),这方案立刻露出短板:缓存写满的速度比手机掉电还快,数据要么排队等到天荒地老,要么面临丢失风险。显然,临时方案扛不住持久战。接下来咱们关掉美颜,直面痛点,一步步拆解如何为持续的高频写入设计一个既扛得住、又稳得起的系统方案。道路就在前方,咱们开始铺路。 阅读全文
posted @ 2025-12-04 10:42
yihuiComeOn
阅读(1136)
评论(1)
推荐(0)
 上一篇文章讲到我们通过读缓存以减少数据库读操作的压力,却也存在着不足,比如写操作并发量大时,这个方案不会奏效。那该怎么办呢?本篇就来讨论怎么处理写操作并发量大的场景。
 前面已经完成了数据持久层的讲解,接下来将围绕数据库数据频繁读写的问题探讨缓存层的实战,本篇文章,我们就来聊聊缓存界的“头号网红”——读缓存。这玩意儿大家常用到都快用出“包浆”了,所以基础操作就此掠过,着重对比下常见缓存方案的优劣。
 我们在上一章讲到,查询分离的方案存在三大不足,其中一个就是:当主数据量越来越大时,写操作会越来越缓慢。这个问题该如何解决呢?可以考虑分表分库。今天我们会先介绍一下真实的业务场景,而后依次介绍拆分存储时如何进行技术选型、分表分库的实现思路是什么,以及分表分库存在哪些不足。
 "在AI可以自动生成代码的今天,为什么还要读源码?因为理解原理才能让我们从代码的'使用者'变成'创造者'!"最近AI的崛起确实让技术圈发生了翻天覆地的变化,博主之前的源码解析栏目也因此沉寂了一段时间。不过,在经历了更多生产问题复盘和真实架构设计的实战后,我愈发觉得:理解底层原理才是应对技术变革的不变法宝。
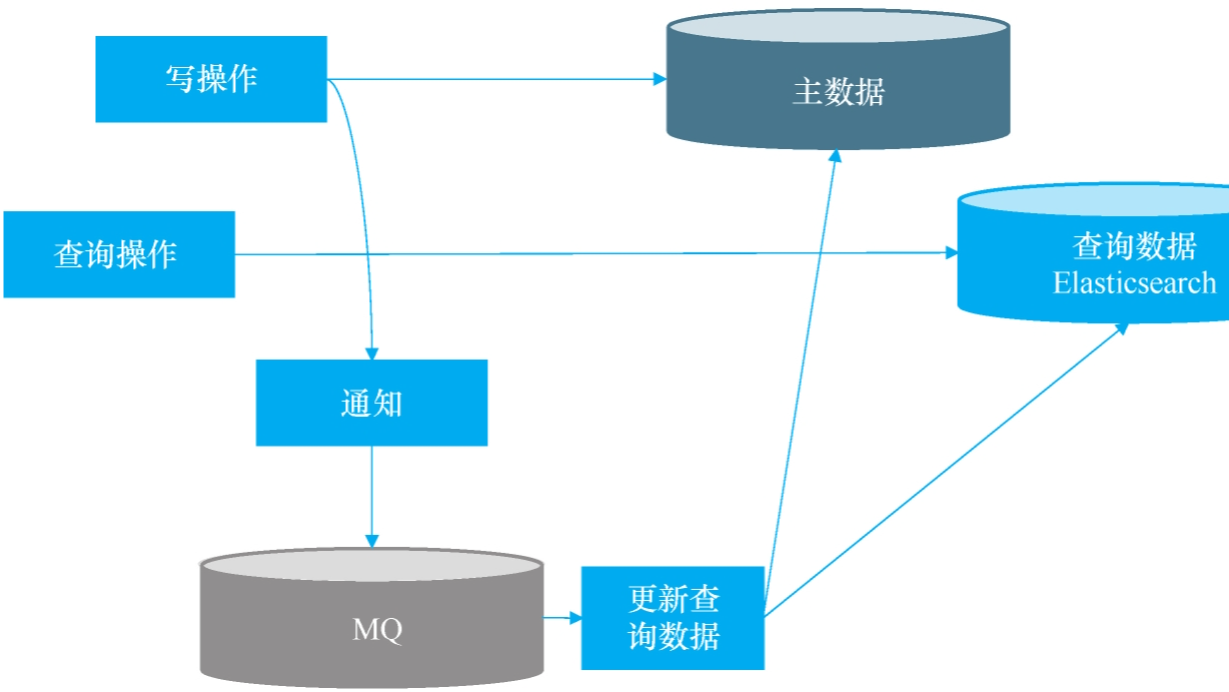 上一章中我们介绍到冷热分离,旨在快速交付。但是他仍存在一些问题,并不是完美的方案,比如限制了业务的操作,必须再特定的业务场景下(冷数据不允许修改、冷数据查询慢、不适合复杂查询)。本章将介绍新的方案,支持千万数据的快速查询。
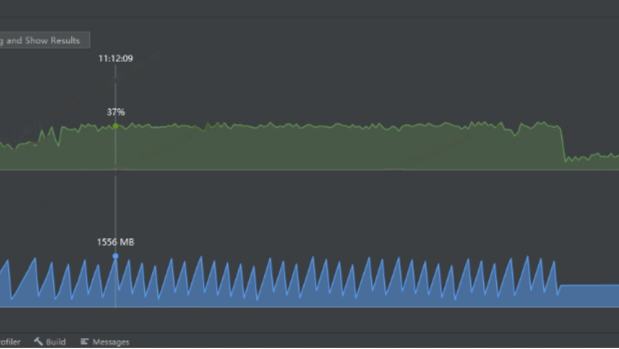 文档导入服务因自研SQL拦截器性能问题崩溃,经排查发现replaceFirst()方法消耗89% CPU时间。源码分析显示该方法每次调用都从头扫描字符串,导致O(n²)复杂度。优化方案改用StringBuilder单次遍历,将时间复杂度降至O(n),实测性能提升210倍,内存占用减少73%。该案例揭示了字符串处理中正则替换的高成本与StringBuilder的优化价值。
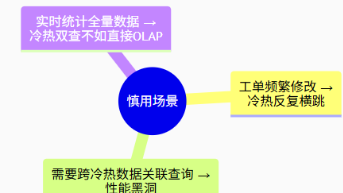 大数据场景下的冷热数据分离实战 本文针对工单系统日均10万增长、数据量超1.5亿导致的性能问题,提出了冷热分离解决方案。核心痛点在于热数据(最近3个月)仅占极少比例却承担九成访问。通过分析数据库分区方案的缺陷,详细阐述了冷热分离实施策略:采用定时扫描触发迁移、批量处理与并发控制相结合、设计精妙的锁机制确保数据一致性,最终实现查询响应从2.1s降至0.2s。对于亿级冷数据,进一步介绍了迁移至HBase的优化方案,包括RowKey设计和存储架构。文章还总结了冷热分离的适用场景与实施原则,为高并发大数据系统
 《当Kafka化身抽水马桶:论组件并发提升与系统可用性的量子纠缠关系》 引言:一场OOM引发的血案 某个月黑风高的夜晚,监控系统突然发出刺耳的警报——我们的数据发现流水线集体扑街。事后复盘发现:Kafka集群、Gateway、Discovery服务默契地同时表演了OOM自杀式艺术行为。这场事故完美演
 客户端“自废武功”背后的深层秘密——CORS跨域是怎么回事? 嘿,对于刚入门的开发新手,你是不是曾经遇到过这样的情况:你正在愉快地开发一个 Web 应用,代码写得热火朝天,前后端配合得天衣无缝,直到某天你开始用 fetch 或者 axios 发送跨域请求,突然间,客户端跳出了一个巨大的“CORS 错
 浙公网安备 33010602011771号