算法/定理学习笔记
Dilworth 定理
任意有限偏序集的最长反链大小等于其最小链覆盖中链的数量。这里将偏序集建图其一定是 DAG。
其中链可交于点/边。
最长反链并不是一条链,是一个互相不可达的集合。
- 证明,对图的大小用归纳法证明。
设最长反链为 \(P\),其所有可达的点(不包括 \(P\))为 \(D(P)\),所有可达它的点(不包括 \(P\))为 \(U(P)\)。
:::info[对于 \(\forall P\),\(|D(P)|\times|U(P)|>0\)]
由归纳法知 \(P\cup D(P)\),\(P\cup U(P)\) 的最长反链大小均为 \(|P|\),且它们对应的最小链覆盖中的链以 \(P\) 分别为链头和链尾(不然无法覆盖),则可以将两个链的集合合并,则得证。
:::
:::info[存在 \(P\),\(|D(P)|\times|U(P)|=0\)]
容易发现其最小链覆盖一定以所有入度为 \(0\) 的点为链头或以所有出度为 \(0\) 的点为链尾。取出一个入度为 \(0\) 的点和一个出度为 \(0\) 的点以及一条包含其二的链,设其为 \(P\),则 \(S-P\) 的最长反链大小一定为 \(m-1\),则其最小链覆盖大小亦为 \(m-1\),加上 \(P\) 之后即为 \(m\)。得证。
:::
推论:任意有限偏序集的最长链大小等于其最小反链覆盖中链的数量。证明可类比上文。
网络流
一种基于反悔贪心的算法。
主要分为最大流,最小割,费用流,上下界等几个部分。
以下有几个模型,可以见 Alex_Wei 的文章:
- 割点模型:选取一个点集,使 \(S,T\) 不连通,求最小代价:首先用经典套路,拆点,用一个结论:在最小割中若 \(s \xrightarrow{\inf} t\),则不可能 \(s \isin S\),\(t \isin T\),则对于原图的边,连边 $s_{out}\xrightarrow{\inf} t_{in} $,而代价刻画为 $s_{in}\xrightarrow{w_s} s_{out} $。
- 集合划分模型:将 \(S\) 与所有点连边,权值为 \(t_i\),代表 \(i \isin T\) 的代价,将所有点与 \(T\) 连边,权值为 \(s_i\)。
- 推论 \(\rightarrow\) 文理选科模型:将 \(S\) 与虚点 \(u\) 连边,边权为 \(a_i\),将 \(u\) 与集合 \(P\) 中点连边,权值均为 \(\inf\),代表若 \(P\) 中点有 \(\isin T\) 的,则代价加 \(a_i\),反之亦然。
- 切糕模型:可以通过上述最小割模型自行推出,主要是用 \(\inf\) 边权的边限制一定是选一个前缀。
- 子图选取模型:依旧是用 \(\inf\) 边权的边限制,较易。
- 区间选择:较智慧:每一个点向后连边,容量为 \(-a_i\),代表要被加 \(a_i\) 次,\(s\) 向 \(1\) 连边,\(n\) 向 \(t\) 连边,权值均为 \(0\),代表最大流是否能让边负权边被抵消,因为边权不能为负,所以全部加上一个 \(\inf\) 即可。
有些网络流其中存在负数,以集合划分模型为例,讲一下处理方法:
若 \(a_i\) 为负,则连边 \(S \xrightarrow{-a_i} i\),而最后直接减掉 \(-a_i\) 即可。
有些网络流是求最大而非最小,以集合划分模型为例,讲一下处理方法:
可以先将所有的 \(a_i,b_i\) 做和,然后原来权为 \(a_i\) 的和权为 \(b_i\) 交换,跑最小割用和减去它即可。
若有负的 \(a_i\) 怎么办?不用将其算入和内,当然最后也不需要减掉。
没学的:模拟费用流,有负环的费用流
圆方树&仙人掌
圆方树:一般指广义,用于处理点双连通性的算法。
性质如下:
- 两点之间所有路径都经过的点集合为圆方树上两点唯一路径上的原点。
仙人掌为一条边最多只存在于一个简单环的无向图。
仿照广义,建狭义圆方树,将一个环内离根最近的点 \(u\) 与方点连边,边权为 \(0\),其余点连方点,边权为此点到 \(u\) 的距离。
则 \(dis(x,y)\) 为:
- 若 \(lca(x,y) > n\) 则找到两个点的 \(lca\) 子节点,距离为 \(dis(x,u)+dis(u,v)+dis(y,v)\)。
- 否则直接相加。
另外,dfs 生成树也是处理仙人掌的利器。
二分图
二分图是一种特殊的无向图,当且仅当其中没有奇环。
二分图最大匹配是在二分图中找出最多的一组边满足其两两不相交于点,有匈牙利算法以及网络流可以解决,前者通过寻找增广路来求解。
一些定理:
- 二分图最小点覆盖大小等于最大匹配
:::info[如何构造?]
-
首先我们选出未匹配的左部点,然后分别对其做一次寻找增广路的操作,将所经过的点都 mark 上。
-
则最小点覆盖为左部点未被 mark 的并上右部点被 mark 的。
-
若一条边左右均未被选,则左部点被 mark,右部点未被 mark,若此边不在匹配内,则矛盾,若在匹配内,则其一定是通过另一条匹配边被标记的,则左部点有两条匹配边,故矛盾,则其为点覆盖。
-
下面通过匹配点有一半选了来证明定理,一条匹配边两头要么被均匹配,要么均不被匹配,证明同上,则有且仅有一个被选,一条非匹配边若左部点未被匹配,则根据定义,其一定被 mark,则其未选,若右部点未被匹配,则其一定没被 mark,否则就真的寻找到了一条增广路,与匹配最大矛盾。
:::
- 二分图最大独立集大小等于点数减掉最大匹配
:::info[如何构造?]
构造是易的,你会发现最大匹配一定是将除了匹配外的点变为一个独立集,否则还会有匹配存在。
那么你在每对匹配中找一点并上其余所有点即可。
:::
一个转换:如果能将图分为 \(A\),\(B\) 两个部分,使 \(A\) 和 \(B\) 均为团,则最大团即为补图的最大独立集。
一般地:任何一组独立集取补后就得到一组点覆盖,独立集与点覆盖是一一对应的(适用于所有无向图)。
- 二分图最小边覆盖大小等于点数减掉最大匹配
:::info[如何构造?]
还是易的。
选出所有匹配边,再对于所有未匹配点单独选一条和它相连的边,就得到了一组等于最大独立集的边覆盖
:::
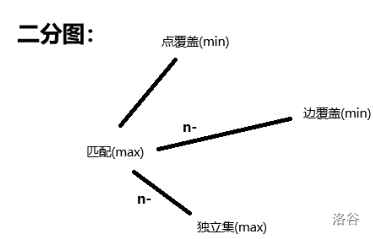
总的来看,关系就如下图所示:
- 怎么做 DAG 最小链覆盖问题?
首先最小路径覆盖是易的,将每个点拆成 \(x_{in}\) 和 \(x_{out}\) 然后连边跑最大匹配即可,而扩展为最小链覆盖只需在这之前先将所有 \(x\) 可达 \(y\) 的点对连边 \(x \rightarrow y\) 然后跑小路径覆盖即可。这样可以确保你在选完这个点后仍可以通过新加的边取到。
另一种理解方式是:最小链覆盖可以看作一个数列 \(s\) 满足 \(s_i\) 可达 \(s_{i+1}\),然后选取最小数量的不可相交数列作为覆盖,也可以看作一个数列 \(s\) 满足 \(s_i \rightarrow s_{i+1}\),选取最小数量的可相交数列作为覆盖,前者则相当于补全 DAG 跑最小路径覆盖。
没学的:Hall 定理,KM 算法
Kruskal 重构树
为最小生成树的加强版,具体建树方法类似于格雷码,拥有以下一些良好性质:
- 两点 \(u,v\) 所有路径中边权 \(\max\) 的最小值为两点 \(\rm LCA\) 的权值。
- 若限制 \(\ge w\) 的边不能走,一点 \(u\) 能到达的所有点的集合为子树 \(x\),其中 \(x\) 为 \(u\) 的最浅祖先,满足 \(w_x < w\)。
李超线段树
用于维护一类线段/直线在 \(x\) 取某值时的 \(\min/\max\)。
基本原理:通过用每个区间的中点最优线段来限制每次查询的线段个数为 \(\log n\) 个。
对于新插入的一条线段,遍历线段树的区间,若原区间上的线段在取中点时的值小于新加入的线段,则二者交换。由于可以排除左右端点大于原线段而中间不大于的情况,所以每次只需往一边递归,当然,若三处地方都大于/小于原线段,则可直接停止。
常用于斜率优化,支持单线段插入和单点查询。
FHQ Treap
一种码量很小的平衡树,且扩展性好。
FHQ 的核心在于 \(\rm split,\rm merge\) 两个函数,分别是用于以 \(w=k\) 分为两棵树,和将 \(b_{\min} \ge a_{\max}\) 的两棵树按顺序合并,复杂度均期望 \(\mathcal{O}(\log n)\)。
WQS 二分
有一类问题,给定一个整数 \(m\),求函数 \(f(m)\) 的值,但是你无法快速得到它,可能求它需要从 \(1\) 递推到 \(m\),每次复杂度很高,无法通过。
这时候若此函数满足凸性,我们就能使用 WQS 二分来求解,并且这个函数还需要支持快速查询 \(\max\{f(x)-kx\}\) 或 \(\min\{f(x)-kx\}\),当函数为下凸时支持查询 \(\min\),为上凸时支持 \(\max\),下文以 \(\min\) 举例。
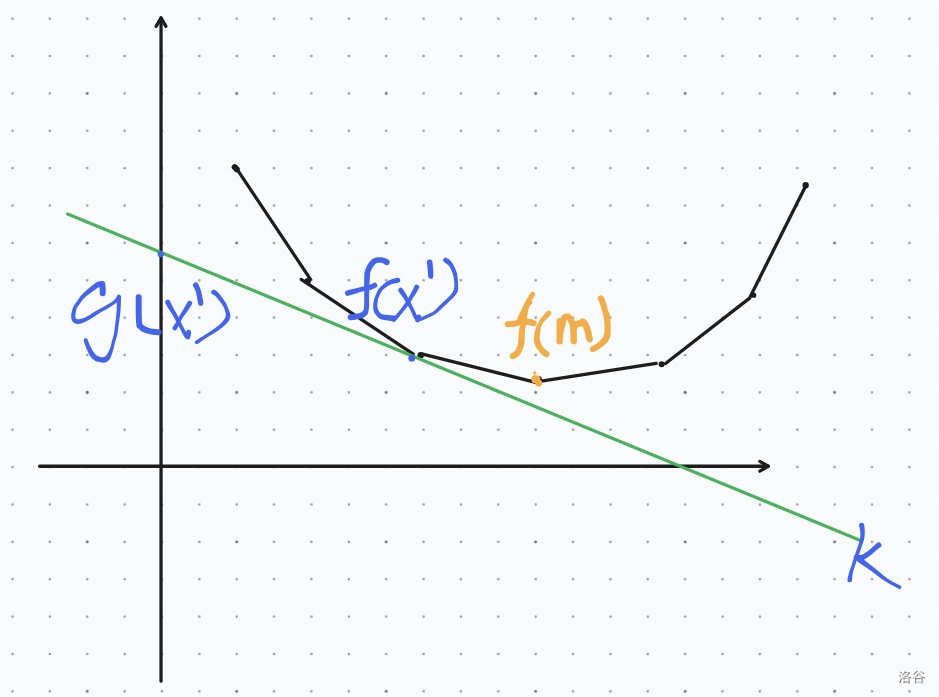
如图,我们画出函数 \(f(x)\) 的图像,黄色点为要求的 \(f(m)\),我们二分斜率 \(k\),然后用斜率为 \(k\) 的斜线去切那个图像,则若我们可以求得截距 \(g\),设 \(g\) 取最小值时 \(x=x'\),则有 \(g(x')=f(x')-x'k\),求时就可以顺带求一下 \(x'\),则我们可以根据 \(x'\) 与 \(m\) 的大小关系进一步二分斜率,最后将二分出的斜率带进去算一遍得到 \(g\) 然后加上 \(x'k\) 即为答案。
WQS 二分常用于优化 dp,在一类恰好取 \(m\) 个数,或恰好划分为 \(m\) 段的 dp 题中,WQS 二分可以直接省去 \(m\) 那一位,使得复杂度由 \(m\) 变为 \(\log m\)。
没学的:WQS 二分模拟费用流,LARSCH 算法
动态 DP
一种在树上支持单点修改的动态算法。
拿模板举例,此题是动态求树上最大权独立集,先想静态,则设 \(dp_{u,0/1}\) 为考虑 \(u\) 的子树,\(u\) 这个点取/不取的最大代价,有转移如下:
发现单点修改时只会影响从此点到根的 dp 值,其他不变,考虑依靠这个性质在上面做手脚。
考虑重链剖分,具体地,我们将一个点 \(u\) 的转移分为两部分,先处理所有的轻儿子,在与重儿子合并,根据方程,我们设 \(g_{u,0}\) 为所有轻儿子的 \(\max(dp_{v,0},dp_{v,1})\) 之和,设 \(g_{u,1}\) 为 \(a_u+\sum dp_{v,0}\),则我们可以写出转移为 \(dp_{u,0}=\max(dp_{son_u,0},dp_{son_u,1})+g_{u,0}\),\(dp_{u,1}=dp_{son_u,0}+g_{u,1}\)。
则可以根据一条重链的 \(g\) 来求出其链头的 \(dp\) 值,而我们只需修改一些点的 \(g\) 值即可。
考虑重剖时我们在线段树上维护一个关于 \(g\) 的矩阵,而使用 \(\max+\) 的广义矩阵乘法进行维护,注意其不满足交换律,所以合并时应该 \(\rm dfn\) 序大的在左。
合并时往上条链,跳到一个链头就计算出其 \(dp\) 值来计算其父亲节点,即下一个链的链尾的 \(g\) 值。
复杂度 \(\mathcal{O}(n \log^2 n)\)。
没学的:基于全局平衡二叉树和 LCT 实现的动态 DP
CRT 与 exCRT
这两个算法都是求解如下问题的:
给定 \(n\) 组非负整数 \(a_i, b_i\) ,求解关于 \(x\) 的方程组的最小非负整数解。
先看简化版的 CRT,它的基本思想是将一个方程组化为 \(n\) 个互不相关的方程组,入下:
以及:
先求解第一个方程组,先求解 \(x\equiv 1\pmod{m_1}\) 的问题,此外还要求 \(x \mid \prod\limits_{i=2}^{n} m_i\),设 \(f_1=\prod\limits_{i=2}^{n} m_i\),可以发现一个解为 \(kf_1\equiv 1\pmod{m_1}\),这是一个逆元问题,由于互素,可以用 exgcd 解出,则 \(x={f_1}^{-1}f_1\),考虑加上 \(r_i\),则 \(x={f_1}^{-1}f_1r_1\)。
考虑将所有解综合起来,具体地,最终的 \(x\) 存在一个解为 \(\sum {f_i}^{-1}f_ir_1\),这样一定是对的因为这个解对于所有的模数都余 \(r_i\),最后取个模即为最小解。
考虑去掉互素的性质,则用 exCRT,其基本思想为将两个同余方程化为一个。
考虑 \(x \equiv r_1\pmod{m_1}\) 和 \(x \equiv r_2\pmod{m_2}\),套路的设 \(k,b\) 有 \(x=k_1m_1 +b_1=k_2m_2+b_2\),则移项有 \(k_1m_1+k_2m_2=r_2-r_1\),发现其形如一个二元一次不定方程,考虑 exgcd。
具体地,设其一个解为 \((x_1,y_1)\),则有通解 \(x'=x_1+k\frac{m_2}{g}\),则原式可化为 \(x=x'm_1+b_1=(x_1+k\frac{m_2}{g})m_1+b_1\),整理得 \(x=x_1m_1+b_1+k\times {\rm lcm}(m1,m2)\),即 \(x\equiv x_1m_1+b_1\pmod{{\rm lcm}(m_1,m_2)}\)。
至此,问题得到解决,无解当且仅当其中一步出现 \(g\nmid r_2-r_1\) 的情况,时间复杂度 \(\mathcal{O}(n \log V)\)。
高斯消元法
解一个 \(n\) 元一次方程组。
首先将系数写成一个 \(n \times (n+1)\) 的矩阵,然后再其中不断进行初等变换,最后削成只有 \((i,i),(i,n+1)\) 有值的矩阵。
具体变换如下:从 \(1\) 枚举到 \(n\),对于每个 \(i\),找到行 \(i\),用方程 \(i\) 的第 \(i\) 个元素去把其他行的 \(i\) 全部消掉,这样在处理完 \(i\) 后可以确保 \(1\sim i\) 中每一个元都只有一行的系数不为 \(0\),具体实现时把系数 \(i\) 最大的那一行提到第 \(i\) 行用于减少误差。
复杂度 \(\mathcal{O}(n^3)\),在一些有后效性的 dp 中常用其求解。
线性基
处理异或问题的利器。
线性基的构建方式如下:对于每个数,从高位到低位逐一枚举,若这一位没数,直接插入,否则将现在手中的数 \(x\) 异或上这一位的数 \(a_i\),然后继续往下循环 \(x=0\)。
它具有一些良好性质:
- 原序列的任意一数均可以通过线性基内的数异或得到,证明分讨:若此数 \(x\) 未能成功加入线性基,则其最后一定是 \(x=0\) 出来的,则可以从里面找到一些数使得异或和为 \(x\),若此数成功加入线性基,则将最后的 \(x\) 和前面一些数异或起来就行了。
- 线性基中任意选择一些数的异或值所构成的集合,等于原序列中任意选择一些数的异或值所构成的集合。这个证明容易,根据第一条直接证即可。
- 线性基中任意选择一些数的异或值均不为 0。
- 线性基中没有两组不相同的数异或和相同。
- 设线性基大小为 \(m\),则对于任意一个能被异或出来的数,其方案数均为 \(2^{n-m}\),这个你考虑先用线性基中的元素把这个数表示出来,然后随机加入剩下的 \(n-m\) 个数,可以发现你怎么加都可以调整线性基中元素来使得异或和不变,且这种调整是唯一的。
有一些扩展应用如下:
- 求异或和的 \(\max/\min\):求 \(max\) 的话从高位往地位贪心即可,\(\min\) 的话若线性基中元素 \(m=n\),则答案为线性基中最小值,否则为 0。
- 求一个数在所有异或和中的排名,这个的话你需要先明白一个事:就是所有能异或出来的数构成的不可重集中,均可以通过枚举 \(2^m\) 种最高位来得到,而其他没有数的位相应的有一种方案,但你不知道他们是 \(0\) 是 \(1\),但是那些你无法确定是 \(0\) 是 \(1\) 的位一定是你前面有一个更高的位置上的数在这一位有 \(1\),所以说你只需要把所有为 \(1\) 的位拿出来,也就是说这些位并不影响排名,然后总和即为 \(2^{n-m}\times\sum2^{st_i}(q_i=1)\)。
- 求所有异或出来的数构成的不可重集的第 \(k\) 小,考虑刻画上面一个做法的本质,我们构建新的一个线性基,对于每一位所插入的数,枚举其更低位,若其有值,则其异或上那一位所对应的数,第 \(k\) 小即为 \(\oplus x_i(k_i=1)\),由于上面所说那些位置并不影响排名,又经过这样一番处理使得有值的位只有一个地方有值,所以这是对的。
- 线性基合并:较简单,直接暴力插入,复杂度 \(\mathcal{O}(\log^2 V)\)。
- 前缀/删除线性基,在每个位置上维护一个时间戳,贪心取时间戳最小的那一个即可。

 浙公网安备 33010602011771号