
Neural-based Outlier Discovery
离群点检测的目标是揭示数据中的不寻常模式。在预见性维护中的典型场景是识别失效、传感器故障或入侵。这是一个具有挑战性的任务,特别是当数据是高维的时候,因为异常值会被隐藏起来且只在特定的子空间中可见。在本文将讨论基于自动编码器的方法,以发现高维数据中的异常值。
1.Introduction
让我们从一个例子开始。通过观察下图,很容易看出,这些红点在x、y和z等变量的空间里都是离群。
 .
然而,如果我们将数据投射到低维度的子空间中,它们的离群表现就会丢失。我们说这样的离群值是non-trivial的[1]。
 .
同样,在其他维度(如[r,s,t])中,同样的点可能不被视为异常值。

当数据是高维的时候,即每个数据点被一个大的向量描述(比方说100、1000或更多的值),它们也不能在完整的数据空间中被检测到。这是所谓的“维数诅咒”的产物:空间变得稀疏,而邻近的概念变得毫无意义[2],这样,完整的空间离群探测就显示出糟糕的结果。数据点的离群现象只能在子空间中观察到。这是有问题的,因为子空间的数量随着数据集的维数呈指数级增长:我们不能去探索所有的子空间。
2.Auto-encoder
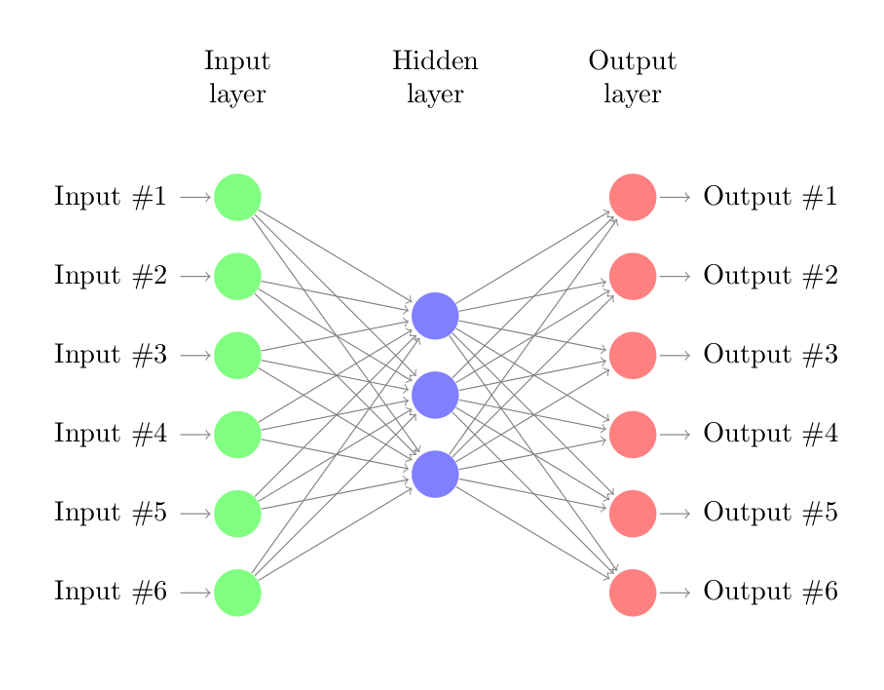
可以使用自动编码器检测离群值。自动编码器,也以前称为复制器网络,是一个无监督的神经网络。它主要学习一对非线性变换:从原始空间到另一个空间(编码器)的映射——可能是更高或更低的维度——以及从这个新空间映射到原来的(译码器)。这种假设是,由于离群值很少见而且与众不同,自动编码器将不会学习正确地映射这些对象,从而导致更高的重构错误。通过观察重构误差,可以推断出一个离群值。
有趣的是,我们不需要数据的标签,也就是说我们不需要标注好了正常点和异常点的样例。神经网络可以从数据点本身直接推断出相对于其他点的异常程度。这就是我们所说的纯无监督环境。这在异常检测中是很方便的,因为异常/异常值的特征通常是事先不知道的。结果表明,该方法工作得很好,如之前的工作[3,4,5]所示。
尽管如此,高维性是对检测的一个主要障碍。由于自动编码器学习映射到可能更低的空间,因此有充分的理由认为它们会扩展到高维问题。不幸的是,在现存的文献中,这种观点被忽视了。另外,典型的基准数据集是低维度的(最大限度为30到40个维度)。
因此,让我们尝试一下。我们使用一个HiCS[1]合成数据集。数据集包含100个维度和1000个实例,其中136个是异常值。这些数据生成的异常值是隐藏的,即它们只在特定的子空间中可见。在上面的示例中,我们实际上查看了这个数据集的子空间[30,31,32],其中包含5个离群值。
让我们用panda的形式打开数据集
from scipy.io import arff
import pandas as pd

data, meta = arff.loadarff("synth_multidim_100_000.arff")
data = pd.DataFrame(data)
我们预先处理并保存标签。注意,我们从原始数据集中删除掉了标签,因为利用他们进行训练就像作弊!
labels = data['class'].astype(int)
labels[labels != 0] = 1
del data['class']
我们把数据标准化到0和1之间:
from sklearn import preprocessing

min_max_scaler = preprocessing.MinMaxScaler()
np_scaled = min_max_scaler.fit_transform(data)
data_n = pd.DataFrame(np_scaled)
data_n = data_n.astype('float32')
现在我们可以开始构建一个简单的自动编码器。在这个示例中,我们将使用Keras。我们用一个隐藏的包含80个神经元的隐藏层来构建一个自动编码器,输入和输出层的大小为100。我们将ReLU作为激活函数在隐藏层中,在输出层中使用Sigmoid。我们选择adadelta作为梯度优化器和binary_cross熵作为损失函数。只要有几行代码,我们就可以开始训练这个网络。
from keras.layers import Input, Dense
from keras.models import Model

encoding_dim = 80
input = Input(shape=(100,))
encoded = Dense(encoding_dim, activation='relu')(input)
decoded = Dense(100, activation='sigmoid')(encoded)
autoencoder = Model(inputs=input, outputs=decoded)

encoder = Model(inputs=input, outputs=encoded)

encoded_input = Input(shape=(encoding_dim,))
decoder_layer = autoencoder.layers[-1]
decoder = Model(inputs=encoded_input, outputs=decoder_layer(encoded_input))

autoencoder.compile(optimizer='adadelta', loss='binary_crossentropy')

autoencoder.fit(data_n.values, data_n.values,
                nb_epoch=2500,
                batch_size=100,
                shuffle=True,
                verbose=0)
我们训练超过2500个次,每批数据量为100。最后,我们得到了数据网络的预测:
encoded = encoder.predict(data_n.values)
decoded = decoder.predict(encoded)
我们计算每个点到它重构之后的欧几里得距离。我们把它作为一个离群点的分数:
import numpy as np

dist = np.zeros(len(data_n.values))
for i, x in enumerate(data_n.values):
    dist[i] = np.linalg.norm(x-decoded[i])
然后,为了评估我们的离群检测器的质量,我们绘制了ROC曲线:
from sklearn.metrics import roc_curve, auc
import matplotlib.pyplot as plt

fpr, tpr, thresholds = roc_curve(labels, dist)
roc_auc = auc(fpr, tpr)

plt.figure(figsize=(10,6))
plt.plot(fpr, tpr, color='red', label='AUC = %0.2f)' % roc_auc)
plt.xlim((0,1))
plt.ylim((0,1))
plt.plot([0, 1], [0, 1], color='navy', linestyle='--')
plt.xlabel('False Positive rate')
plt.ylabel('True Positive rate')
plt.title('ROC Autoencoder 100-80-100 ReLU/Sigmoid synth\_multidim\_100\_000')
plt.legend(loc="lower right")
plt.show()

曲线下的面积0.91实际上非常好。作为比较,最先进的方法,例如HiCS[1],这个数据集上只获得了大约0.8的AUC。
绘制每一个数据点的异常值是很有趣的:

黑点是从标签中推断出来的离群点,。正如我们所看到的,他们通常比非离群点得分更高。如果我们对比学习前后的距离,效果就更明显了。在学习之前,网络权值是随机初始化的。网络还没有学会任何转换,因此它在每个数据点的重构上表现得很差,与它们是否异常值是独立的。

3.Interpretability
离群点是关于数据点异常的有用信息。然而,在实践中,这往往是不够的。一个人不仅要知道哪些点是异常的,还想知道为什么这些点是如此特别,即在哪个子空间中它们是不正常的。
解释可能性的缺乏一直是对神经网络的主要批评。神经网络经常被看作是一个神奇的黑盒子,做着伟大的事情,但不包括任何解释可能性。我想说的是,在异常检测的情况下,这是不正确的。
通过查看重构错误,我们可以找到关于特定数据点在哪些维度上的蛛丝马迹。例如,点350是子空间中的一个异常[30,31,32],我们可以计算它的每维重构误差,并将其作图:
def compute_error_per_dim(point):
    p = np.array(data_n.iloc[point,:]).reshape(1,100)
    encoded = encoder.predict(p)
    decoded = decoder.predict(encoded)
    return np.array(p - decoded)[0]

plt.figure(figsize=(12,7))
plt.plot(compute_error_per_dim(350))
plt.xlim((0,100))
plt.xlabel('Index')
plt.ylabel('Reconstruction error')
plt.title("Reconstruction error in each dimension of point 350")

正如我们所看到的,点350显示了一个在维度[30,31,32]上更高的重构错误,这表明它在这个子空间中是不正确的。
同样的,点50在子空间中[30,31,32]和[68,69]是离群点,显示了一个维度[30,31,32,68,69]上的高重构错误的。

点50在子空间中也有相对较高的重构误差[50,51,52]。这是 false positive,,因为点50在这个子空间中没有显示明显的离群行为。然而,似乎点50位于子空间[50,51,52]相对稀疏的区域(见红点)。

因此,似乎可以通过查看重构错误,或者至少大幅减少搜索空间,来找到每个异常对象的信息。此后,我们绘制了子空间内[30,31,32]各异常值的重构误差。即点50、121、350、572和559。
# 50, 121, 350, 572 and 559 are outliers in subspace [30,31,32]
plt.figure(figsize=(12,7))
plt.xlim((0,100))
plt.plot(range(100), compute_error_per_dim(50), label="50")
plt.plot(range(100), compute_error_per_dim(121), label="121")
plt.plot(range(100), compute_error_per_dim(350), label="350")
plt.plot(range(100), compute_error_per_dim(572), label="572")
plt.plot(range(100), compute_error_per_dim(669), label="669")
plt.legend(loc=1)
plt.xlabel('Index')
plt.ylabel('Reconstruction error')
plt.title("Reconstruction error in each dimension of outliers in [30,31,32]")

在[30,31,32]的高峰段,每一个点似乎都是一致的。
4.What about Deep Learning?
现在,每个人都热衷于深度学习。增加神经网络的大小通常被认为是提高准确性的灵丹妙药。尽管在很多设置中都是正确的,特别是在计算机视觉任务中,但这里并不是这样。
例如,如果有许多参数允许网络对数据进行过度匹配,这样所有的点将几乎完美地重建,从而模糊了正常数据点和异常数据点之间的差异。之前的工作[4]表明单层的检测结果较好。有争议的是,[5]认为增加层来压缩数据的逐渐表示有帮助。显然,这里需要做实验。
5.Conclusion
在本文中,我们介绍了在高维空间中查找离群点的相关问题。我们展示了基于神经网络的方法,例如自动编码器,可以提供很好的结果。
尽管如此,这些结果的质量依赖于选择参数,如隐藏神经元的数量,激活函数梯度优化,数量的训练时期,mini-batches大小,距离函数…目前的大部分工作是基于 trial-and-error,,耗费时间且缺乏普遍性。基于数据,如相关数据结构或预期的比例/特征的异常值,来推导规则解决参数问题可能是有趣的。
本文所展示的结果是基于一个单一的数据集,使用仔细选择的参数得到的。对于具有不同特征的不同数据集,很难推断出相同模型的质量。其他基于神经的方法,如Self-Organizing Maps[6]s或受限的 Restricted Boltzmann Machines[7]也显示了有希望的结果,并且比较起来很有趣。
6.Try it yourself !
作者在github提供了代码 here.
7.Sources
-
Keller F., Müller E. & Böhm K. (2012). HiCS: High contrast subspaces for density-based outlier ranking. International Conference on Data Engineering.
-
Beyer K., Goldstein J., Ramakrishnan R. & Shaft U. (1999). When is “nearest neighbor” meaningful?. International Conference on Database Theory.
-
Hawkins S., He H., Williams G. & Baxter R. (2002). Outlier Detection Using Replicator Neural Networks. Data Warehousing and Knowledge Discovery.
-
Dau H. A., Ciesielski V. & Song A. (2014). Anomaly Detection Using Replicator Neural Networks Trained on Examples of One Class. Simulated Evolution and Learning.
-
An J., Cho S. (2016). Variational Autoencoder based Anomaly Detection using Reconstruction Probability. CoRR.
-
Muñoz A. & Muruzábal J. (1998). Self-organizing maps for outlier detection. Neurocomputing.
-
Fiore U., Palmieri F., Castiglione A. & De Santis A. (2013). Network anomaly detection with the restricted Boltzmann machine. Neurocomputing.

 浙公网安备 33010602011771号