
102:一句顶一万句驯服大模型原理刨析?
01、现场:一句“做个快递后台”引发的返工
去年做跨境物流系统时,业务方丢来一句“做个快递后台”。团队按常规电商思路出了运单列表和状态流转。
评审时对方追问:尾程派送和头程运输的运单是不是同一张表?库存周转率按海外仓还是按在途口径算?
我们答不上来。返工两周,问题不在技术,而在需求里的词没有共同定义。后来把同一句话改成下面这样,歧义立刻少了大半。
“设计尾程派送的运单状态机,区分揽收、出库、在途、妥投、签收异常,并定义幂等事件。”
这不是文字游戏。它把领域、对象、状态集合、异常分支和工程约束一次说清。本文讨论这种差异在工程上能解释到什么程度,以及哪些说法只是类比。
02、拆题:术语、边界、验收与示例各管什么
精准术语解决的是“指哪个东西”。尾程派送、头程运输、库存周转率在跨境物流里有稳定所指,能快速排除无关解释。
边界条件解决的是“到哪里为止”。揽收与出库是否同一节点,签收异常是否回滚到在途,这些必须写死,否则模型只能猜。
验收标准解决的是“怎样算对”。状态机是否覆盖全部迁移、事件是否幂等、字段是否齐全,都要可检查。
少样本示例解决的是“长什么样”。复杂输出格式、边界案例和风格一致性,靠两三个高质量样例往往比形容词更有效。
四者职能不同。术语收敛语义,边界约束行为,验收定义正确,示例示范形态。混为一谈,就会得出“术语一定胜过示例”的错误结论。
03、原理:语义收敛的合理解释与过度推断
一种流行解释是:精准术语在语义向量空间里对应更精确的坐标,Transformer的多头注意力会更快聚焦,推理路径更短。
其中合理的部分在于,术语确实能降低输入的条件熵。模型在给定上下文下预测下一个token,词越具体,候选分布越集中。
但“坐标更精确”“注意力必然聚焦”“路径必然更短”是解释性类比,不是已证实的机制定律。注意力权重高也不等于因果贡献大。
词向量聚类反映的是语料共现结构,不能直接替代任务级因果证据。模型没学过的术语,反而可能被拆成子词,引入噪声。
所以正确态度是:术语能收敛歧义,这是工程上可观察的经验;它为什么收敛,现有工具只能给近似解释。
04、取舍:四种写法的适用条件
模糊白话的优点是沟通成本低,适合探索期和内部脑暴。代价是输出不可测,返工率高,不适合直接进生产链路。
精准术语的优点是歧义小、可验收,适合状态机、字段契约、分类体系这类结构明确的任务。代价是要求团队维护术语表。
少样本示例的优点是能示范复杂格式和边界处理,适合报告生成、代码风格、多轮工具调用。代价是占Token,且样例偏差会被放大。
术语加示例通常最稳,但成本最高。选择依据不是哪个“更强”,而是任务歧义来源:词不清就补术语,形不清就补示例。
05、架构:让术语落到契约与工具上
Prompt里的术语不能孤立存在。它要和服务端契约、RAG事实依据、工具Schema对齐,否则模型理解了词也做不对事。
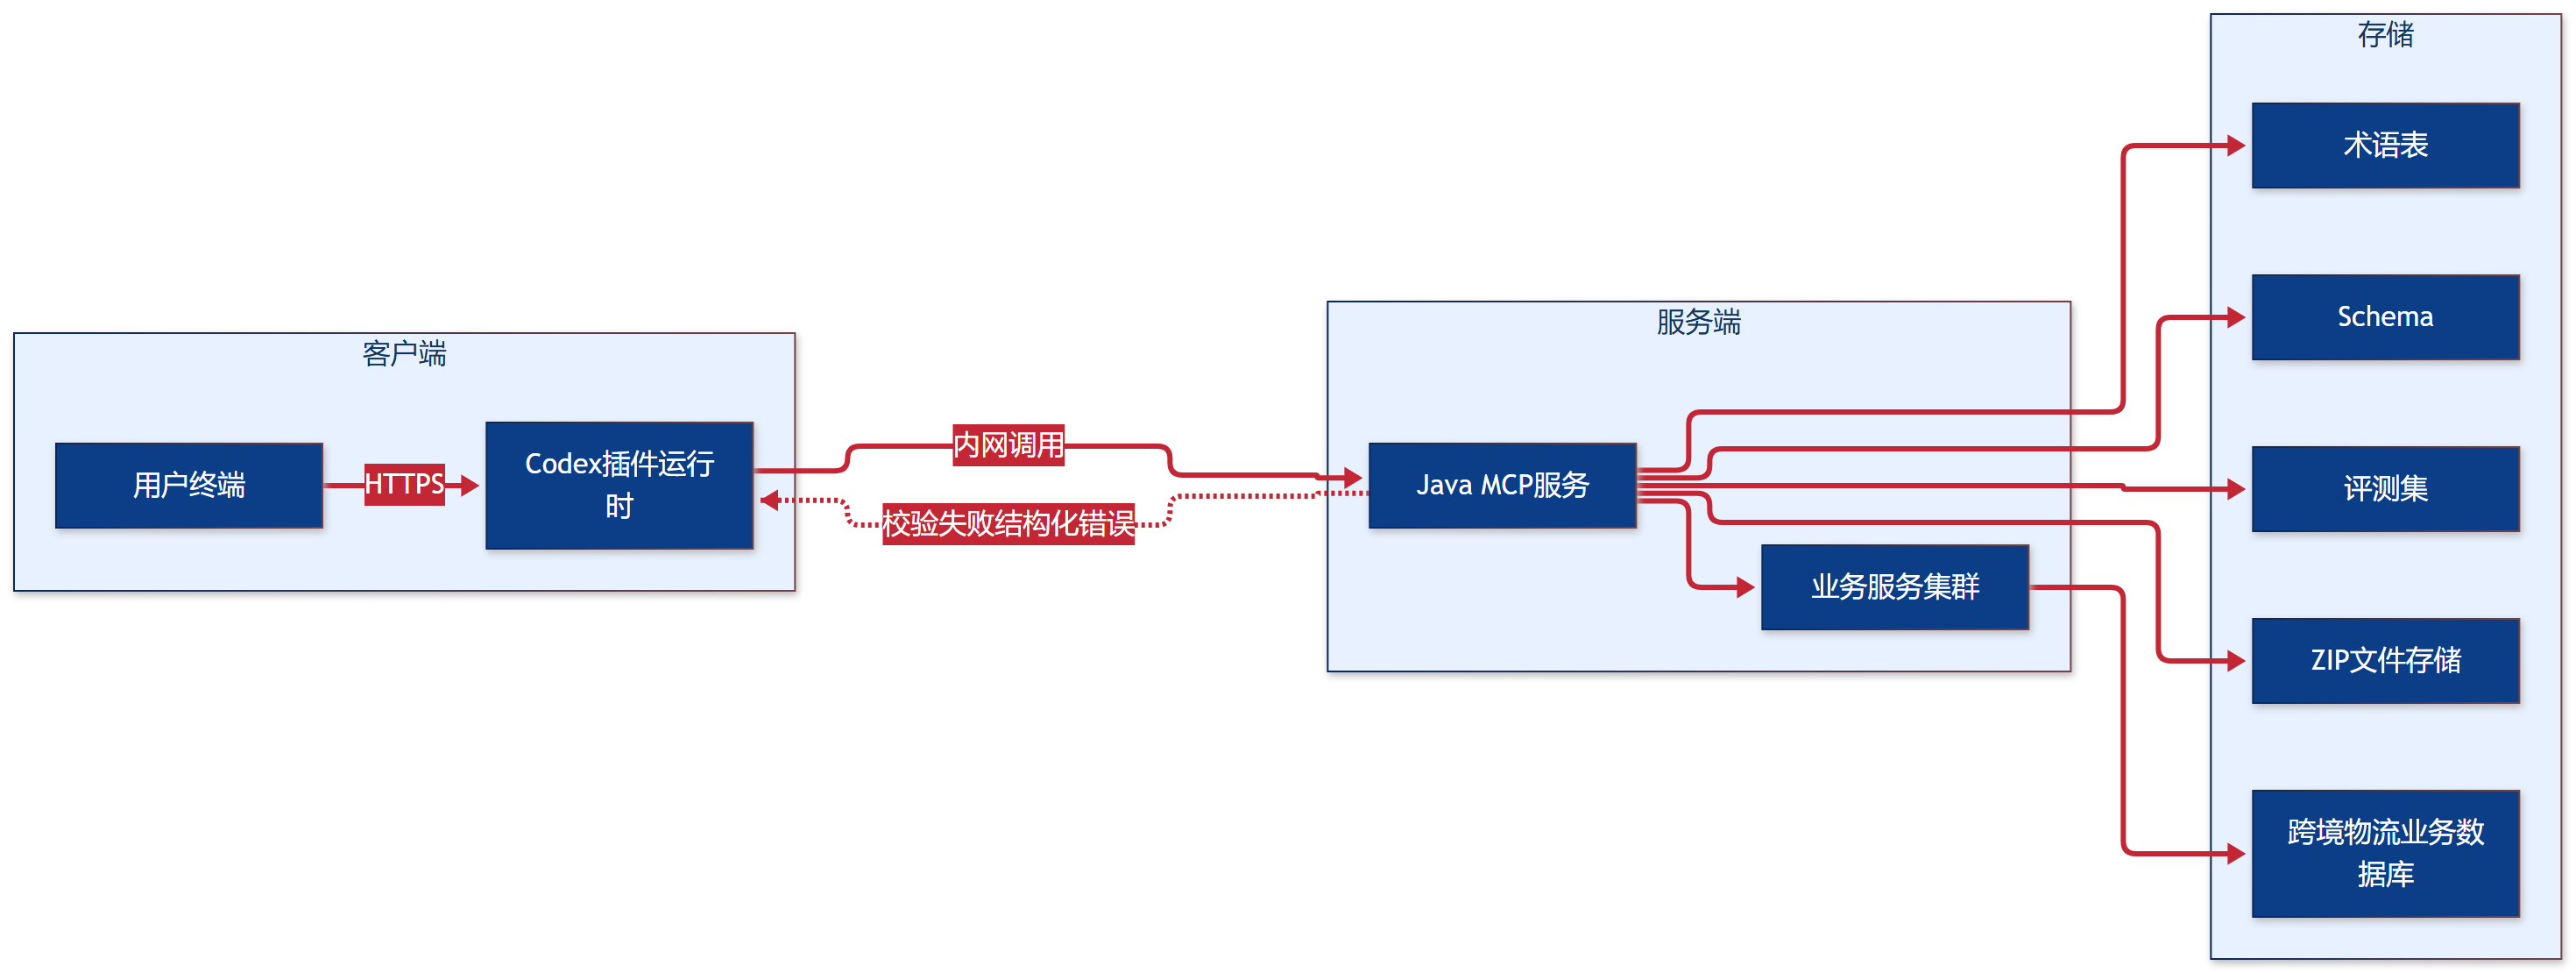
部署上,Codex插件或Agent运行时调用Java MCP服务,MCP服务再访问业务服务与数据存储。术语表、Schema和评测集都应作为受控资源。
工具Schema是硬约束。参数类型、枚举值、必填项写清楚,比在Prompt里反复叮嘱“注意格式”可靠得多。
RAG负责事实。术语定义、状态机文档、历史工单都应可检索,让模型在生成前拿到依据,而不是靠记忆。
06、实战:四组A/B测试与三条工具链路
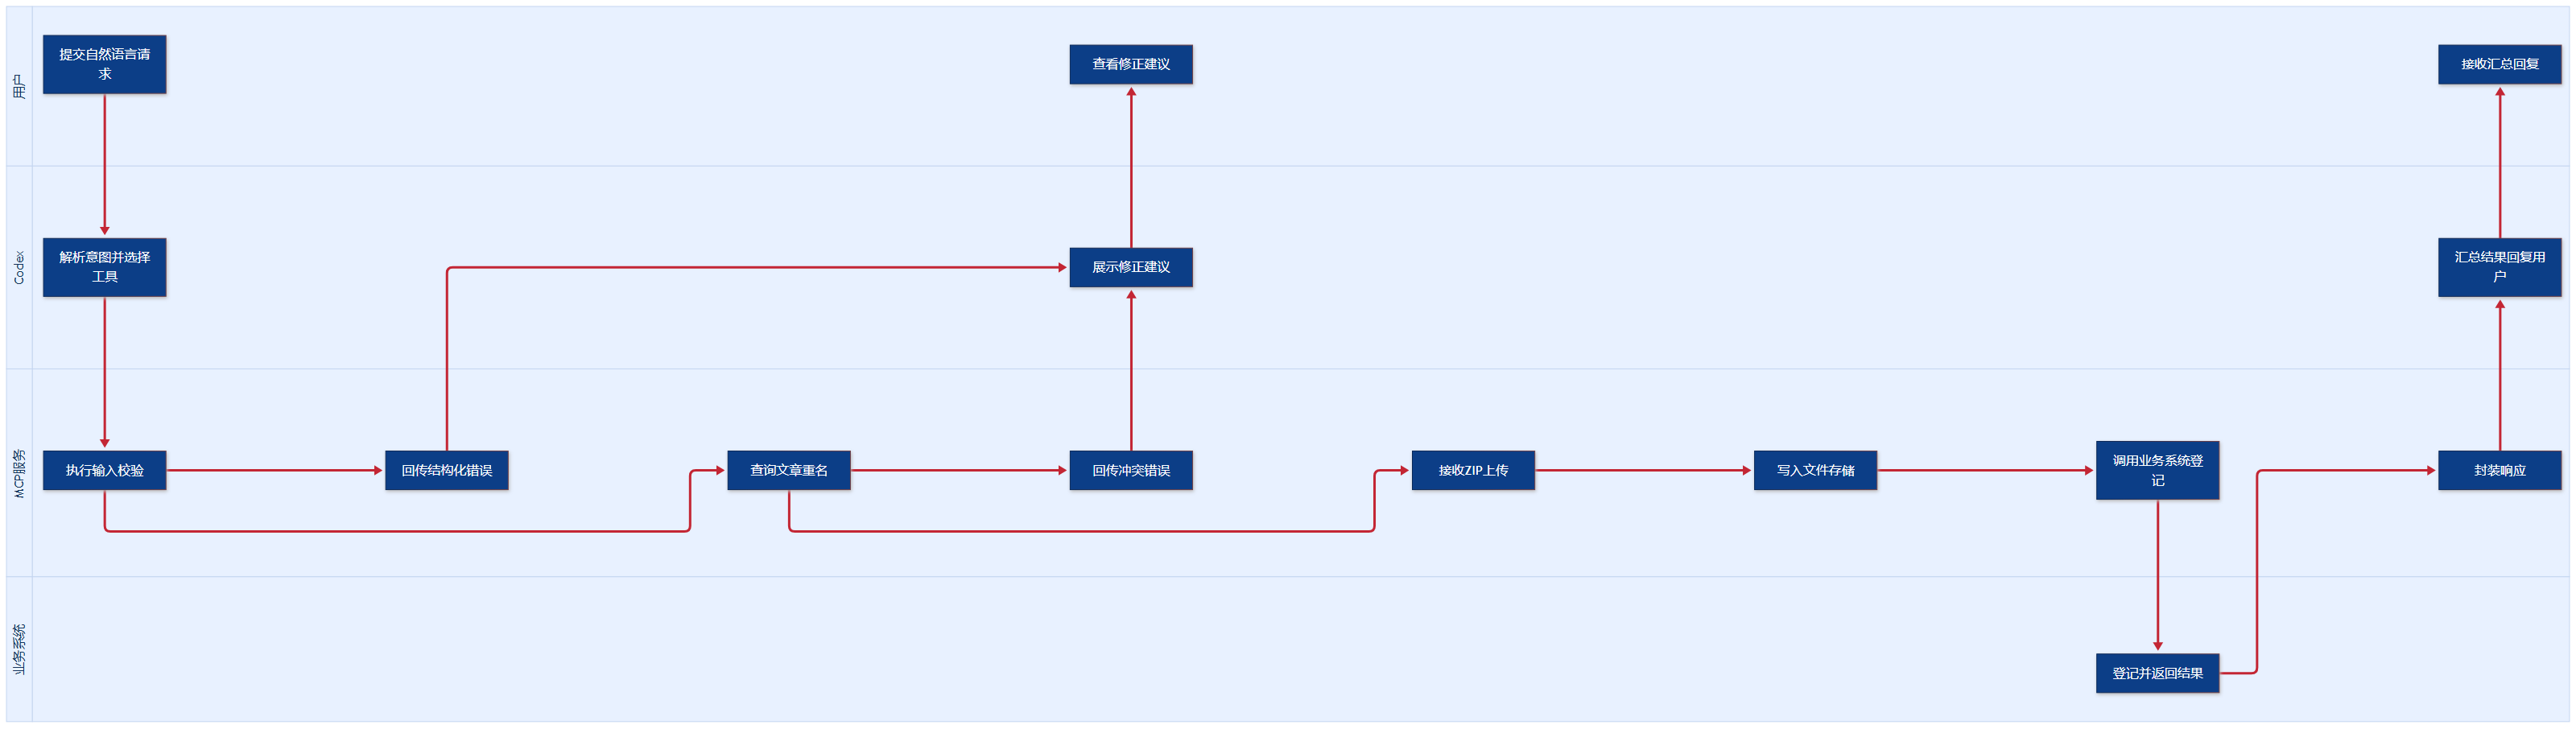
要判断哪种写法更好,必须做对照实验。固定同一模型、温度、任务和预算,只改Prompt写法。
四组分别是:模糊白话、精准术语、少样本示例、精准术语加示例。测试集须含常规样本、稀有名词、歧义输入和分布外样本。
指标看六项:事实准确率、字段完整率、格式符合率、一次交付率、Token消耗、人工返工时长。前四项看质量,后两项看成本。
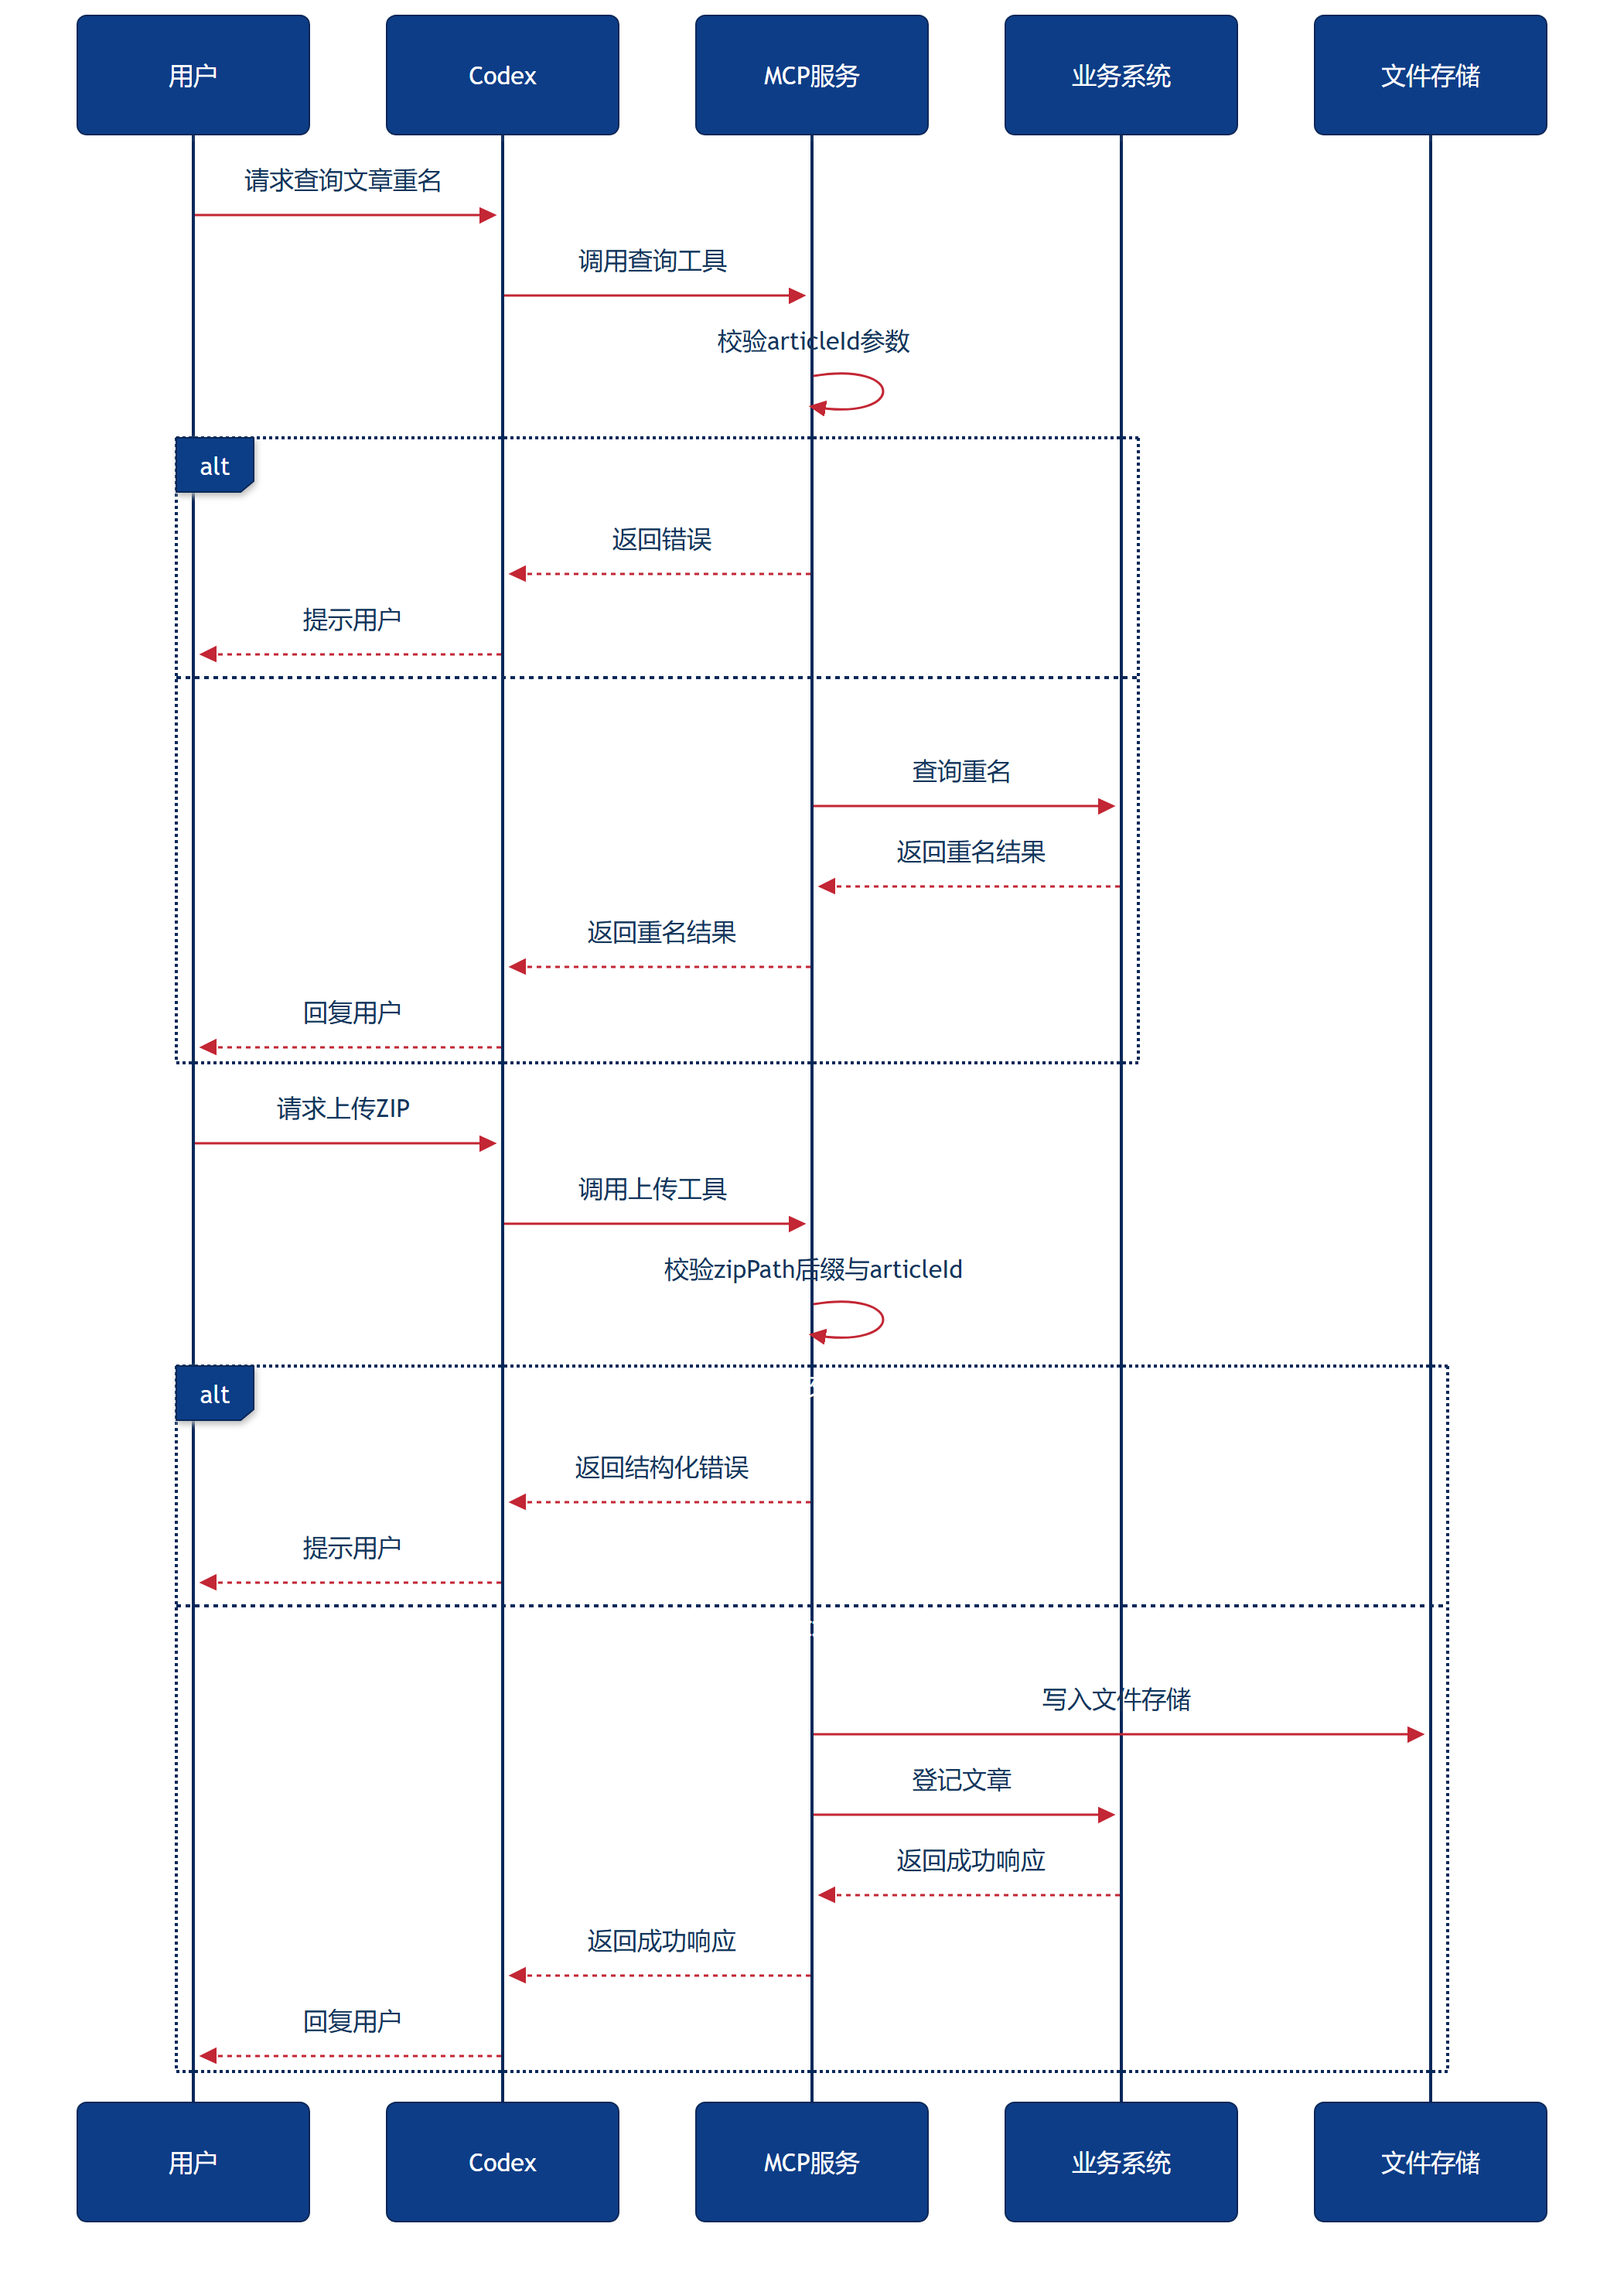
以MCP工具调用为例,查询文章重名和上传ZIP是两条典型路径。前者考验参数是否精确,后者考验错误回传是否可读。
// 用途:MCP工具入参校验的最小片段,约束比Prompt更硬
public record UploadCmd(String articleId, String zipPath) {
    public UploadCmd {
        if (articleId == null || articleId.isBlank())
            throw new IllegalArgumentException("articleId required");
        if (zipPath == null || !zipPath.endsWith(".zip"))
            throw new IllegalArgumentException("zipPath must end with .zip");
    }
}
测试断言应覆盖正常、缺参、非法后缀和重名冲突。工具层报错要结构化,方便Agent回传并自我修正。
07、复盘:三类任务谁占优
客户工单分类:精准术语通常占优。分类体系本身就是术语集合,边界定义清楚后,准确率和一致性都会提升。
RAG召回:术语加示例更稳。术语改善查询改写,示例示范如何组织引用和拒答,两者互补。
接口代码生成:示例权重更高。代码风格、异常处理和命名习惯靠描述很难说清,一两个好样例更直接。
但结论都有条件。术语未被模型学过、中文缩写歧义大、任务本身开放时,精准术语可能放大错误。
术语不是魔法词。缺定义、被误用、与Schema冲突时,它只会让错误更自信。
08、洞见:把提示词当工程资产治理
单靠一句好Prompt不可持续。可复用的做法是四件事一起上:领域术语表、少样本模板库、结构化输出约束、回归评测门禁。
术语表要写定义、反例和适用范围。模板库按任务类型维护,定期淘汰过时样例。结构化输出用Schema校验兜底。
回归评测是底线。每次改Prompt或换模型,都跑同一套测试集,看六项指标是否退化,而不是凭感觉说“好像更好了”。
这套流程的价值不在驯服模型,而在让团队对“什么叫对”有共同语言。术语只是这个共识的入口。
09、小结:精确是工程问题,不是咒语
精准术语能收敛歧义,这在工程上可观察、可测试。但它不是神经机制定律,也不能替代契约、检索和校验。
模糊白话适合探索,精准术语适合结构任务,少样本示例适合形态示范,组合使用要看歧义来源。
真正让系统稳定的,是术语表、Schema、RAG和回归评测共同构成的约束体系。一句顶一万句的前提,是这一万句已经被定义清楚。
延伸阅读:可检索Transformer原始论文中关于自注意力与条件概率的章节,核对机制描述。
延伸阅读:可检索OpenAI官方文档中函数调用与结构化输出的章节,了解Schema约束能力。
延伸阅读:可检索Model Context Protocol官方规范中工具定义与错误处理的章节,核对工具契约。

 浙公网安备 33010602011771号