
101:Hy4Flash便宜20倍,哪些使用场景可以平替?
01、现场:一句“全部切过去”
业务方的诉求很直接:新模型目录价每百万输入Token 0.5元、输出2元、缓存命中输入0.02元,既然便宜,客服和数字员工为什么不能明天就全量切?
这个要求不能简单拒绝,也不能直接答应。价格表只描述Token单价,不描述一次业务交付的成本。
一次退款咨询要经过意图识别、知识检索、工具查单、权限校验、人工确认和审计落库。模型只是链条中的一环。
真正要回答的不是“能不能切”,而是“哪一段负载可以先切,切了以后用什么证据证明没变差”。
02、拆题:便宜的是Token,不是任务
腾讯在2026年11月16日发布Hy4 flash,官方口径是总参数224B,其中64B为Engram参数,单Token激活12B,支持多模态和1M上下文。
预训练引入混合注意力、LatentMoE与Engram,官方称KV缓存约为Hy4的1/6;经自蒸馏与强化学习优化,端到端任务输出长度降低50%。
结合4bit量化等推理优化,官方称解码速度超过150 Token/s。这些是官方披露,属于特定任务集与价格时段,不能外推为所有Agent场景的保证。
更关键的是官方内部WorkIndex评测:覆盖PPT、文档、表格、音视频及视觉理解等8类工作任务,Hy4 flash单任务成本约为Hy4 preview的1/13、Hy4的1/20。
注意,这是“单任务成本”的倍数,不是“每Token价格低20倍”。两者口径不同,混用会误导预算决策。
另有85名WorkBuddy内部用户对27类259个任务盲测,腾讯云ADP文章披露4分制平均2.79分、单任务成本0.26元、端到端耗时中位数6.7分钟,满意度接近Claude Haiku 5.5。
这是内部盲测,不是第三方独立验证。可以当作方向性证据,不能当作对外承诺。
03、原理:激活参数、Engram与KV缓存
MoE(混合专家)模型的总参数很大,但每个Token只走部分专家。Hy4 flash单Token激活12B,意味着单次前向计算量远小于224B全量激活。
Engram参数可以理解为可检索的记忆结构,官方将其纳入总参数并参与训练。它影响的是知识调用方式,不等于把1M上下文变成稳定可用的1M信息检索。
KV缓存约为Hy4的1/6,直接降低长上下文推理的显存占用与带宽压力。吞吐上去了,单位时间能服务更多请求。
但吞吐高不等于任务正确率高。输出长度降低50%,可能意味着更简洁,也可能意味着省略了必要步骤,必须用任务级指标验证。
成本公式应写成:单任务成本 = Token成本 + 工具调用成本 + 重试成本 + 人工复核成本 + 失败赔付成本。
模型便宜只压缩第一项。如果重试和人工复核上升,总成本可能不降反升。
04、取舍:四类负载分层决策
第一类是文档问答与PPT生成。输入长、输出结构化、工具调用少,最适合优先试点。1M上下文在这里有价值,但仍要测长文档检索的召回率。
第二类是多轮客服。它依赖对话状态、租户知识库和工单工具,模型切换会改变追问风格与工具调用频率,应谨慎灰度。
第三类是复杂工具编排。多步API调用对格式遵循和错误恢复要求高,必须逐工具验证成功率,不能只看最终回答像不像。
第四类是高危动作:赔付、支付、额度调整。这类动作不应由模型直接授权,必须保留服务端授权与独立审批,模型只做建议和材料整理。
长程复杂研发任务则应与Hy4等高能力模型对照。便宜模型适合高频、短链路、可复核的任务,不适合用价格倒逼高风险决策。
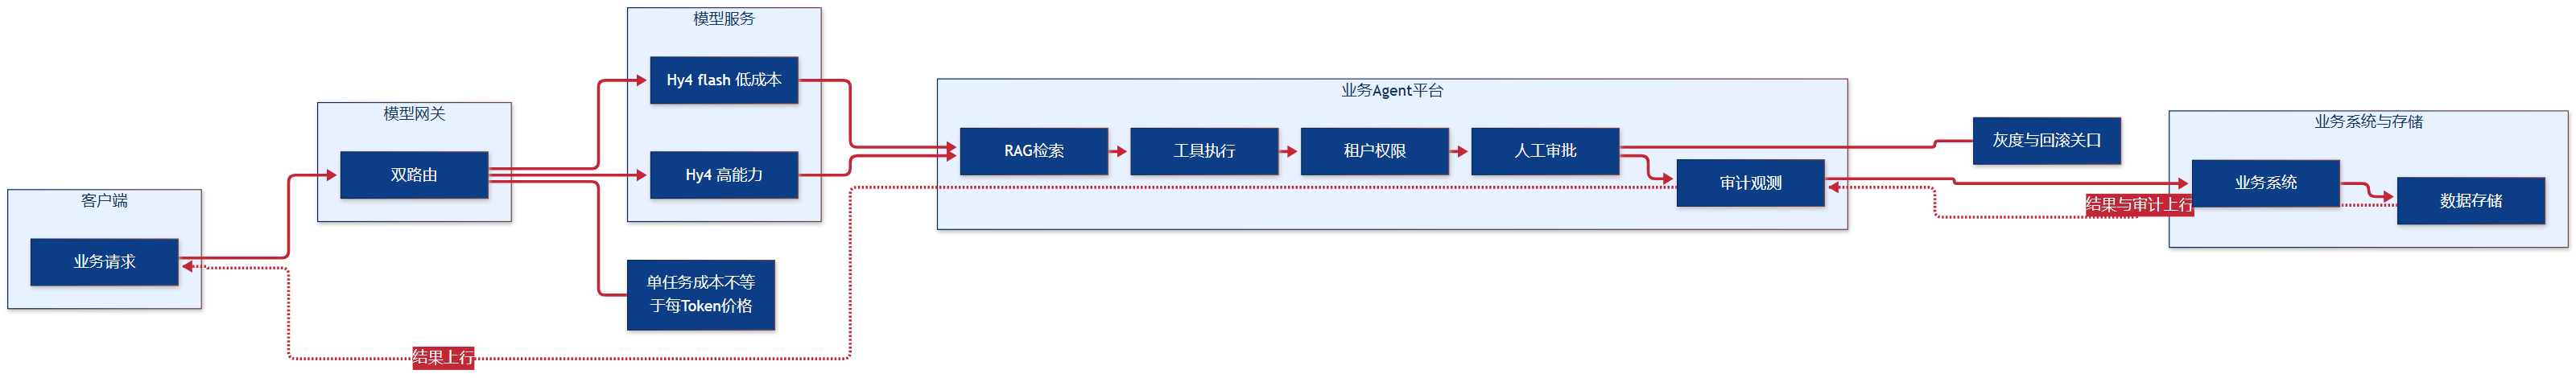
05、架构:网关、路由与治理的位置
模型网关负责统一鉴权、配额、日志和供应商适配。路由层按任务类型、租户等级和实时健康度选择模型,并保留降级路径。
RAG(检索增强生成)负责把企业知识送进上下文。检索质量差时,换更便宜的模型只会更快地给出错误答案。
工具执行层要有入参校验、超时、幂等和结果回传规范。租户权限必须在服务端判定,不能依赖模型自觉。
人工确认用于高风险动作,审计与追踪记录每次模型调用、工具调用和审批结果,便于回溯与计费分摊。
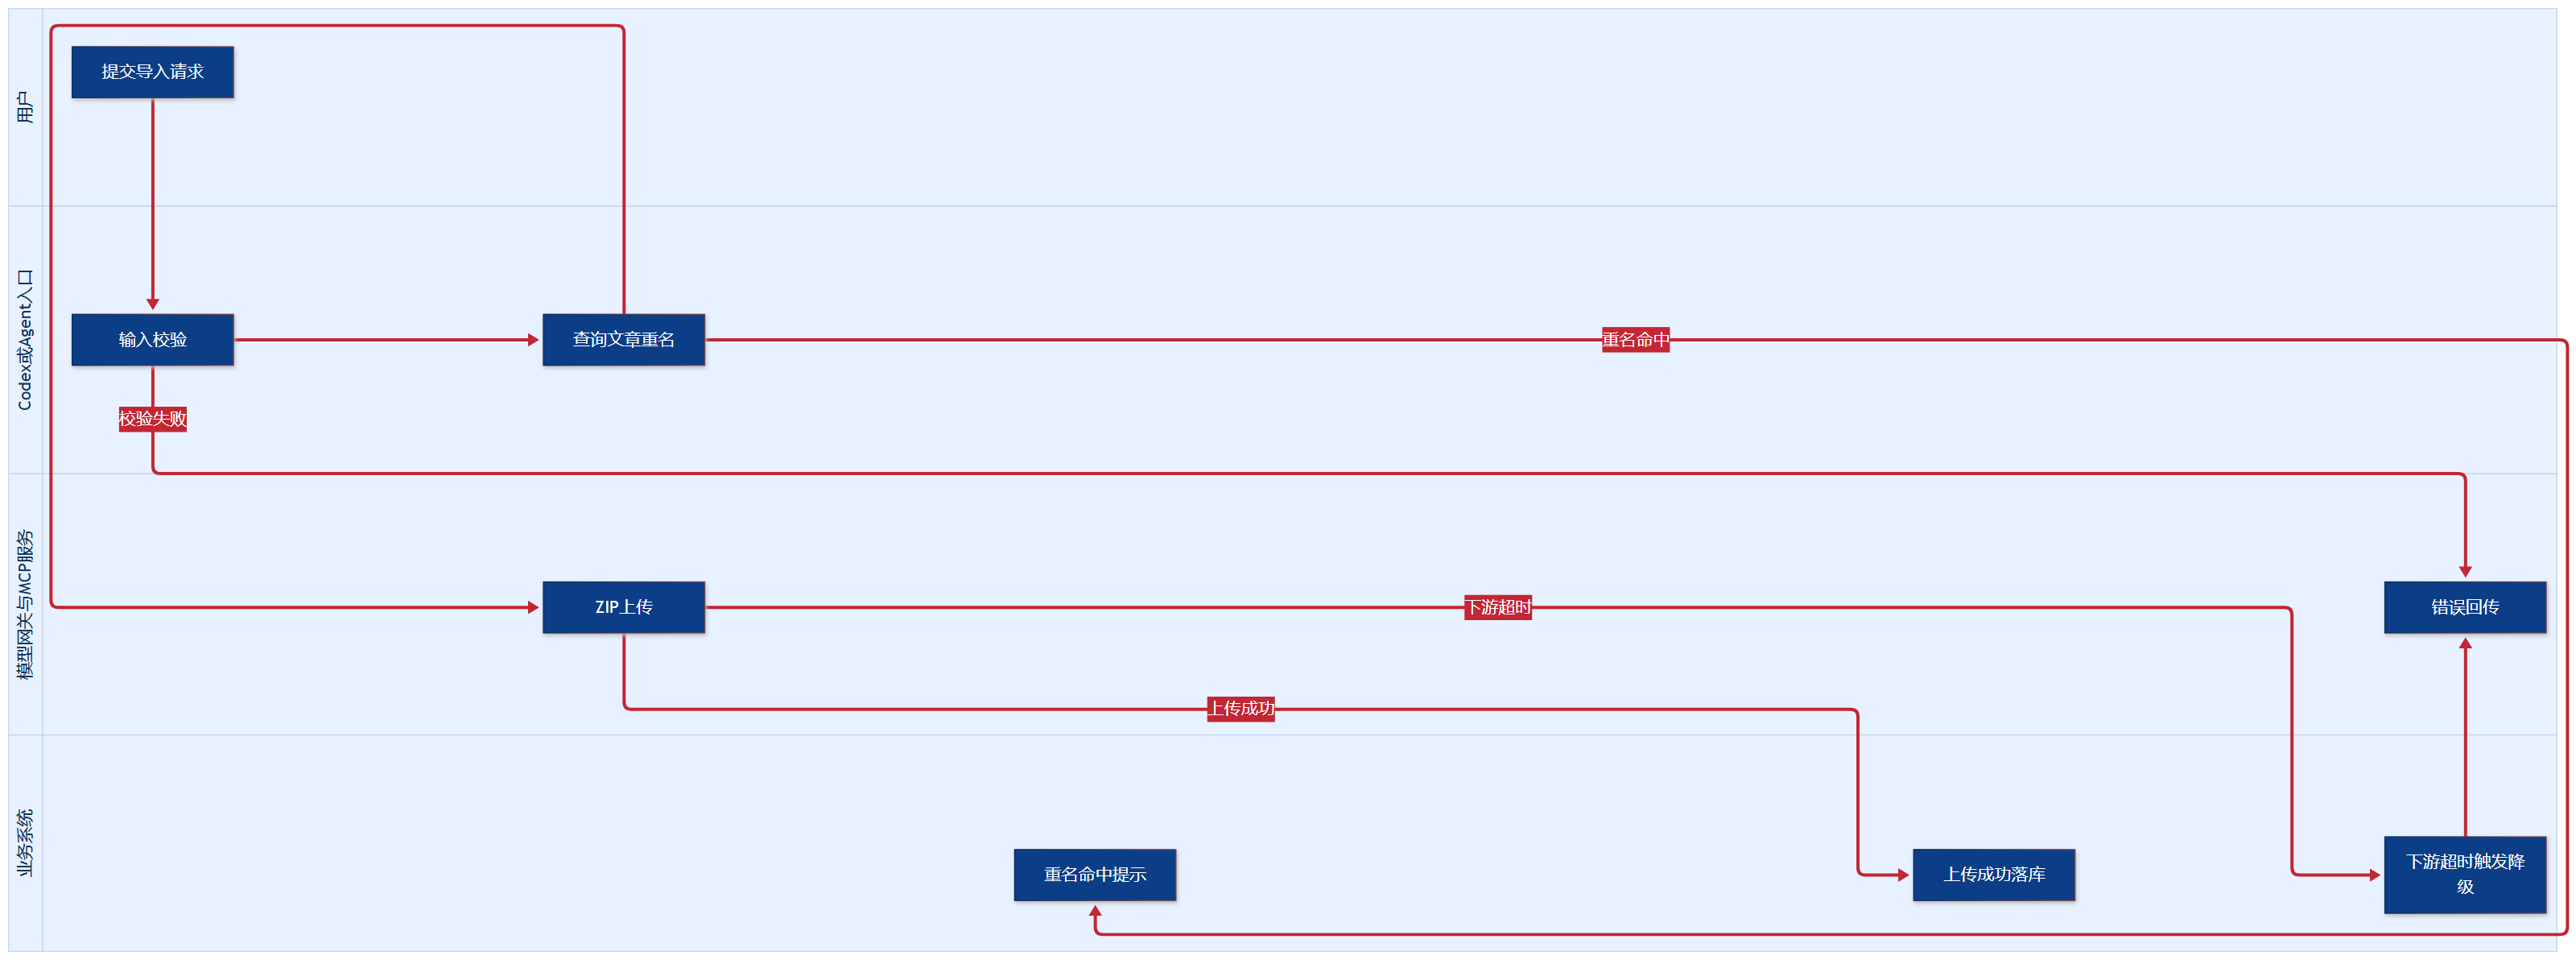
06、实战:影子流量与逐租户灰度
第一阶段跑影子流量。真实请求仍走原模型,同时把同一输入送给Hy4 flash,只记录不生效,对比输出与工具调用差异。
第二阶段按租户灰度。先选内部租户和低风险业务,设置预算上限与熔断阈值,异常时自动回滚到原模型。
第三阶段扩大比例。每扩一档都要复核七类指标,确认没有把成本转移到人工复核和投诉处理上。
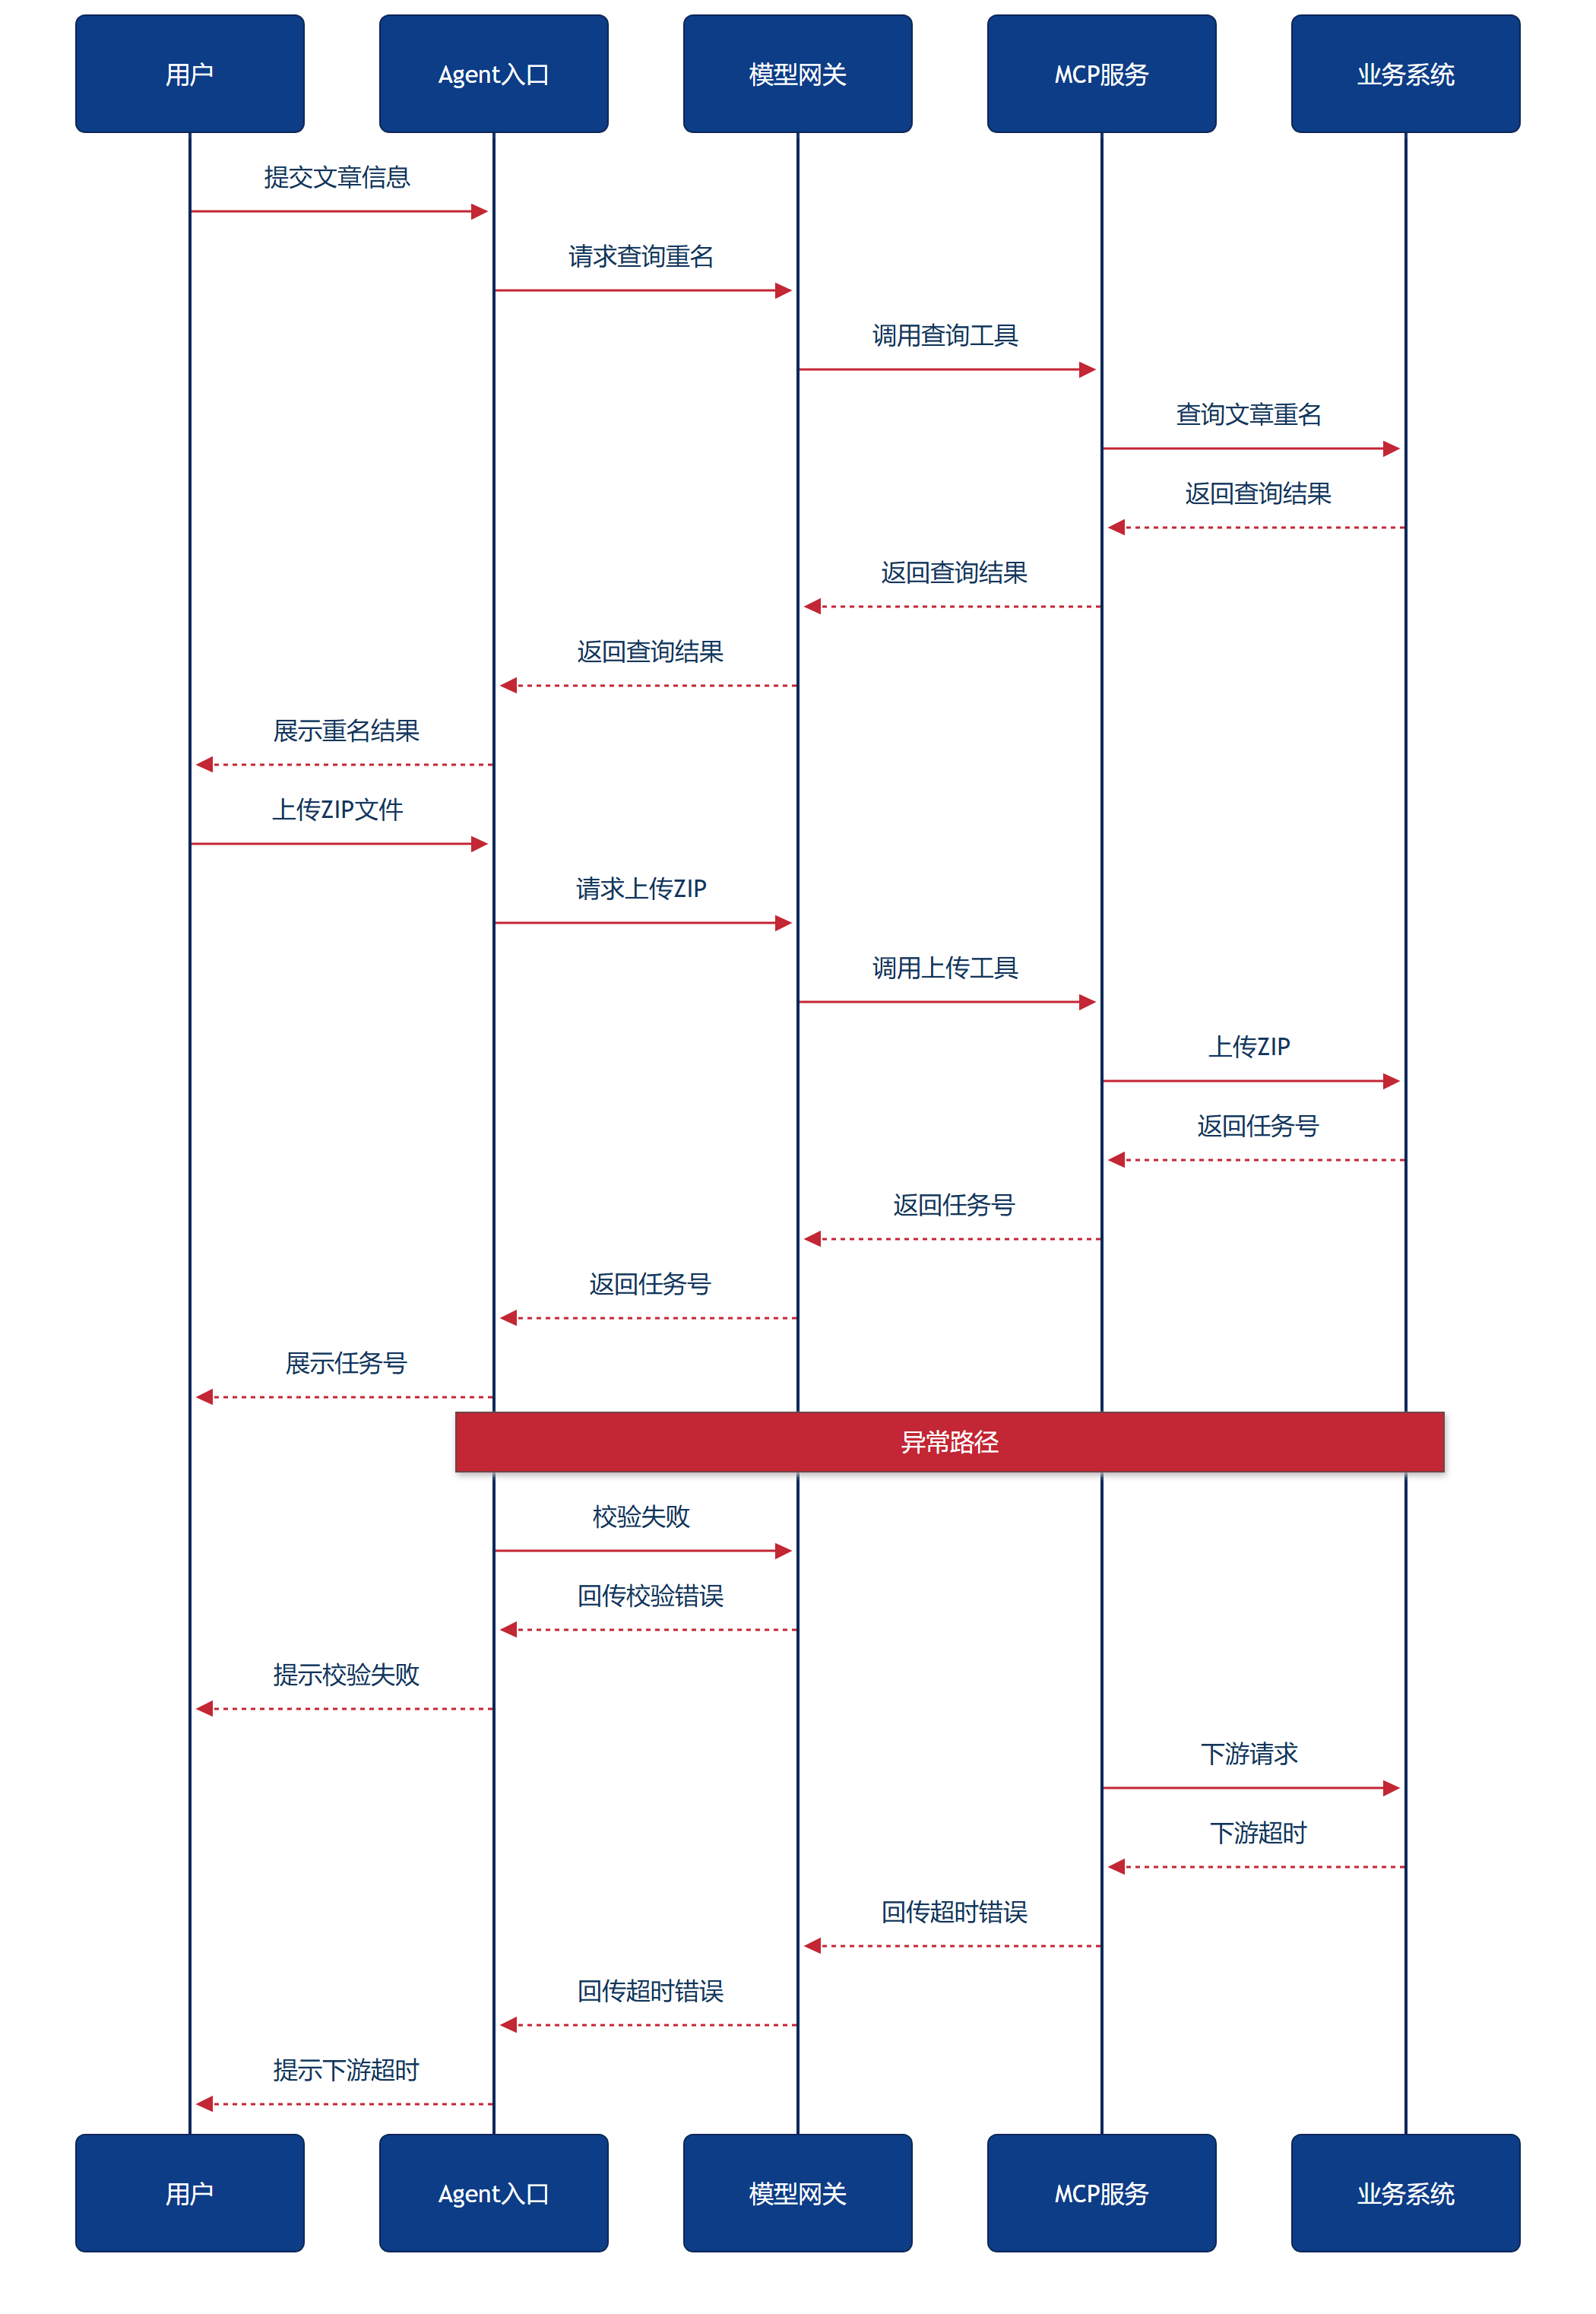
07、复盘:七类指标与统计口径
正确完成率按任务集分层统计,区分文档问答、客服、工具编排,不能混成一个总数。
工具成功率单独统计调用次数与成功次数,失败要区分模型格式错误、权限拒绝和下游超时。
幻觉与越权分开计数。幻觉看事实错误,越权看是否触碰了不该触碰的数据或动作。
时延看P50与P95,不能只看中位数。Token成本与工具总成本分开记账,人工复核成本按分钟折算。
租户SLA按合同口径统计,样本要覆盖不同租户等级。所有对比必须注明模型版本、价格时段和任务集来源。
08、洞见:越便宜越不能省治理
模型价格下降会改变成本结构,但不会自动改变责任结构。银行保险的数字员工一旦说错话,赔付的是机构,不是模型厂商。
全球多租户客服还要面对数据隔离与合规差异。同一套提示词在不同租户下可能触发不同的工具权限,这必须由平台层兜底。
企业知识工作Agent的价值在于把不确定的自然语言变成可审计的动作。调度、权限、评测和治理正是把便宜模型变成可用交付的那部分工程。
Hy4 flash拟开源是计划,不是已开源。限时免费活动截至2026年11月30日,实际配额与计费以产品页面为准,不能当作永久免费。
09、小结:先切低风险高频段
Hy4 flash在官方口径下展现出明显的单任务成本优势,适合文档问答、PPT生成等高频可复核场景优先试点。
多轮客服与复杂工具编排应灰度验证,高危赔付与支付动作继续走独立审批和服务端授权。
决策依据不是每Token价格,而是每个正确交付任务的总成本。把七类指标、影子流量、逐租户灰度和熔断回滚做扎实,便宜才真正变成收益。
延伸阅读可在腾讯官网检索Hy4 flash发布说明,在腾讯云ADP博客检索WorkBuddy盲测与WorkIndex评测章节,核对口径与适用边界。

 浙公网安备 33010602011771号