
AI写代码不缺产能,缺的是可判定的需求:一位产品经理175天独立开发复盘
先别急着让AI写代码:瓶颈在需求可判定性
先看结果。一位自述不懂代码的产品经理,在175天里独立搭起一套系统:Web端、运营后台、后端接口、数据采集、自动写作、自动制作短视频、支付会员。据他在2026年10月的复盘,这套系统能跑起来,靠的不是“让AI多写代码”,而是一套后来被他称为Spec的需求方法。
这个结论有点反直觉。代码产能上来之后,另一件事反而更贵:把“要做成什么样”说到机器能判定。以下内容基于其公开复盘重述,不构成普适结论。
一、传统需求文档,默认读者是人
传统软件流程是一条串行链:需求文档→设计稿→需求评审→技术评审→排期→开发→测试→上线。这条链能成立,有一个没写出来的前提:每一环的读者都是人。人能补全空白,能在不确定时开口问,能用常识拒绝一个荒谬的实现。
把执行者换成AI,前提立刻失效。他记录过几类反复出现的问题:只写正常路径,没写数据为空、停牌、跨日、开关关闭,实现就只处理正常情况,异常要么报错,要么静默返回空;一段话塞五件事,最后交付三件半,没有编号,无法逐条比对;做完说“感觉不对”,改四轮才发现双方对“对”的定义不同;“涨幅按前复权计算”没写哪一种、谁定的、查过没有,更严重的一次,后台面板数据恒为0,因为需求默认“这张表有人写入”,而事实上没有生产者;接口失败时静默还是报错没人写,于是静默失败了三个月。
根因只有一个:这种文体不提供判据。散文能表达意图,回答不了“做到没有”,也回答不了“谁说了算”。需求文档不是写给人看的说明,是写给执行者的合同;合同没有违约判定,就等于没有合同。
二、三份文档,各回答一个不能替代的问题
五份产物里,代码和测试用例不是文档,是结果。真正要设计位置的是另外三份。
需求文档,回答“要什么、怎样算做到”。读者同时是人和AI,两者都必须能判定。它最小的结构是:意图+判据+边界。意图一句话说清这次要改什么;每条验收只有一个通过与否的判定,能给数值就给数值,必须写错误路径;边界至少有一条“不做什么”,以及会出事的那几个状态。
设计文档,回答“怎么做”。交互设计与技术设计合成一份,因为二者常是同一个决定:一个面板能有什么交互,取决于它的数据从哪来。
开发任务文档,回答“按什么顺序做、每步做完怎么验”。它把设计切成可独立验收的单元,带编号与依赖,每条回指需求编号。
还能不能砍?他逐一试过。去掉需求,AI会按设计做出能跑的东西,但没人能判定它是否满足初衷;去掉设计,任务只能按需求条目机械切分,切出的单元没有共享决策,各自选一套方案,最后拼不起来;去掉任务,AI会一次实现整份设计,你只能整体接受或整体打回,无法逐段验收,“哪些做完了”也失去载体。
三份对应三样东西:需求给判据,设计给方案,任务给进度。缺一份,闭环上就有一个环节没有产物,只能靠人的记忆兜住——而人的记忆,正是这套流程要替换掉的东西。
还有一条反直觉的规矩:先写需求,不许先写设计。一旦先想方案,需求就会被方案裹挟——你会只写这个方案能满足的需求,把方案做不到的部分悄悄删掉。
三、强制力不能停在文档里
据他复盘,Kiro的Spec正是这三份:requirements、design、tasks,需求用EARS句式写,任务带编号并回指需求。但它仍有四类缺陷:分类只有功能和缺陷,改一个统计口径、加一条CI检查全被塞进“功能”;改五十行也要走三份文档,流程成本高于收益,人不会反抗,人会绕过;面板上点“完成”很好看,代码到底做没做只有提交历史知道;格式校验靠自觉。
最刺眼的是一个自动校验Spec格式的钩子,连续四次静默失效:匹配规则过度转义、内联脚本被shell吃掉、字段名取错、判据是手写重实现,四次都没报警。修完跑存量,57个红里有24个是脚本自己的缺陷;此前还抽查两类现象就结案为“历史格式问题”,那个结论本身是误判。这训练出了“lint红了不用管”的习惯,比不装护栏更糟。
所以新体系把强制力分成两层。第一层,状态真源移进提交历史:一个任务一个提交,复选框从[ ]改成[x]与代码在同一个提交里;验证命令和实际输出摘要写进commit message;状态行跟着任务提交走,第一个推进任务的提交改成“执行中”,最后一个改成“已完成”。状态的真源变成“复选框+git log”,机器能读,第三方能复核。代价是失去一张好看的进度图。
第二层,机器门槛只查结构。pre-commit上的脚本只查六样:任务行格式、状态只有三种、有任务节、每个顶层任务写了验证、批准后才能推进任务、需求与任务的追溯是否闭合。其余一概不查,因为格式对不等于内容对,能自动判的只有结构,内容判据只能靠人。这里有一条自我约束值得抄下来:给任何兜底记功之前,先构造一个它应该拦住的输入,看它拦不拦;拦不住的检查,不如不装。
四、重建后的流程:分类、调研、定档、加码、冻结
据作者2026年10月的复盘,新体系在2026年9月23日上线,一个月内跑了27套新格式spec、206张施工单,规则本身312行纯markdown。它的六条原则可压成一句话:分类先于流程,成本随风险走,先读后改,验收先于实现,状态只有一个真源,强制力落在机器上。
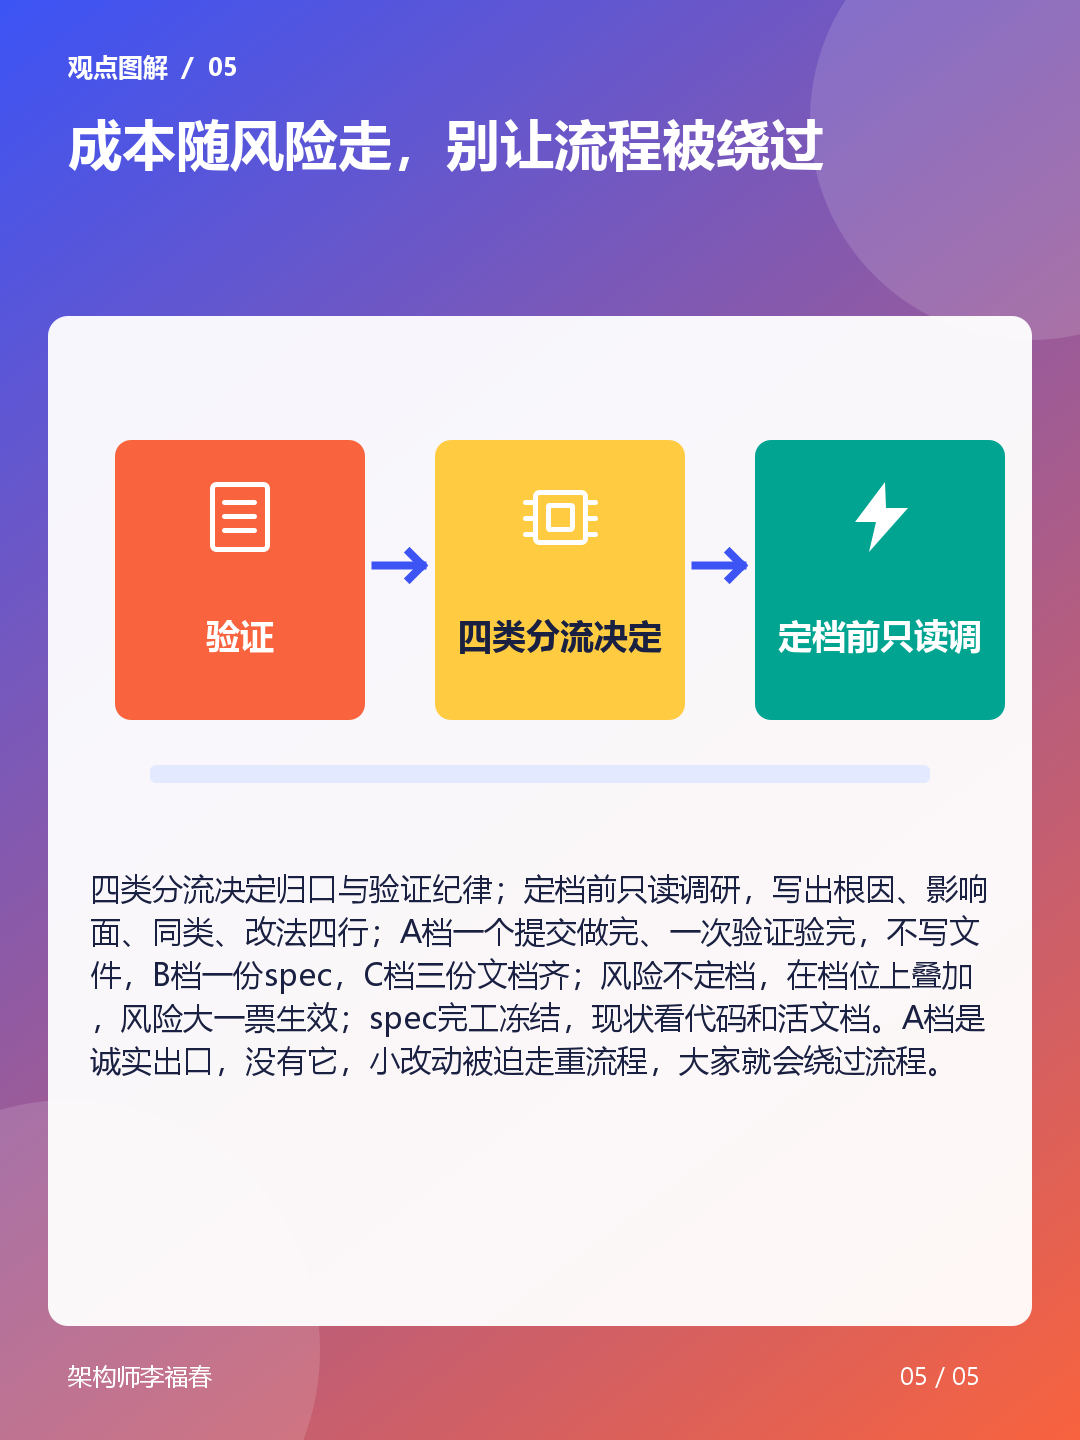
落到操作,是五步。第一步,四类分流。判据依次问三句:改的是研发体系吗?原本的行为是错的吗?用户能看到的行为要变吗?由此分出工程任务、缺陷、改造、新功能;类型还决定验证纪律:缺陷先复现,改造先证明旧行为,新功能验新行为与相邻行为,工程任务验门槛真的拦得住。
第二步,先调研,再定档。定档前必须只读调研,深到能写出四行:根因或目标;影响面,调用方与消费方清单以及怎么列出来的;同类,同一写法还有哪些位置以及怎么枚举;改法,一句话能说清就写一句,说不清就写卡在哪。结论涉及“多少行、什么值、有没有这种数据”的,查生产库。定档若靠拍脑袋,档位就退化成形容词。
第三步,三档。A档是一个提交做得完、一次验证验得完,不写文件,四行写进commit message;B档要分步但一份spec够;C档要多步、多验证,三份文档齐。改动量不参与定档,判的是要不要分步。A档是整套设计里最关键的零件:没有它,小改动被迫走B,然后所有人学会绕过B。
第四步,风险独立加码。风险不定档,在已定的档位上叠加,风险大一票生效。改一个统计口径,代码只有三行,但下游三个面板的口径全变;档位可以是A,但A也必须先报。
第五步,完工冻结,与活文档分离。一份spec完工后正文冻结,后续问题在记录节追加,不回头改正文;要改行为,开新spec。“现在系统是什么样”去看代码和活文档,不看spec。归档按待完成/和已完成/分层,引用时不带状态层路径。如果spec既当历史又当现状,它半年后必然开始撒谎,而读它的人或模型无法分辨哪一句过期了。
五、代价与边界
不讲代价的方法论是广告。这套东西至少有五个成本。
C档的写作成本可能超过写代码:一份完整spec要写需求、设计、任务,再加证据登记与决策登记,改动越复杂,比例越难看。规则本身要维护:312行会漂,规范里已出现“已知误报”“已知漏口”的章节,这不是严谨,是不得不承认的负债。规则越多,越可能只被读一半;作者用分层缓解,§1–§6必做,§7是清单,§8是参考,但分层只降低误读概率,不消除。A档依赖诚实:不写文件意味着没人核对你是否真的做了调研,commit message有格式,但拦不住敷衍。最后,它是为“一个人+多个agent”设计的;换成五个人协作,状态真源、批准流程、归档规则都要重写,不能直接搬。
小结
AI读代码,读不出人当时的设计意图。一个if为什么在那里,可能是三年前的合规要求;一个字段为什么允许为空,可能是上游某次事故的补丁。这些进不了函数名。人可以靠记忆和同事补全,记忆会过期,人会走;AI连记忆都没有,手里只有代码。只让它读代码,它只能按“看起来合理”的方式改,而合理与当初的意图无关。
所以维护一套文档系统,不是文档洁癖,是让AI有一半输入不靠猜。三份文档各回答一个不可替代的问题:要什么、怎么做、做到哪算完。写进文档还不够,不读等于没有,这也是“先读旧spec再动手”被写成调研第一步的原因。
强制力必须落在机器上,这是六个月里最贵的一课。规则写进文档,靠自觉;写进pre-commit,才靠机器。而机器也会骗你,所以每装一道护栏,先构造一个它应该拦住的输入。Spec的底座不是模板,是把人的设计意图外置成AI可读、可查、可追的东西。工具会换,这份外置的意图不能没有。

 浙公网安备 33010602011771号