
SpringBoot性能优化6:HTTP复用与超时预算
背景:从纵腾海外末端派送说起
我在纵腾集团负责海外末端派送系统研发管理时,长期跟数据库性能瓶颈、JVM 和稳定性治理打交道。那段经历让我形成一个习惯:遇到下游抖动,先看调用链上的时间都花在哪,再看重试和超时是否在放大问题。
本文把那段业务背景改造成一个教学项目“远航派送”,不包含生产源码,也不复用生产性能数据。项目里的人物和名称都是教学假设:我是架构师老李,开发小周负责实现,测试小陈负责验证,运营小林提业务诉求。固定运单号是 WB-DEMO-001,租户是 tenant-a。
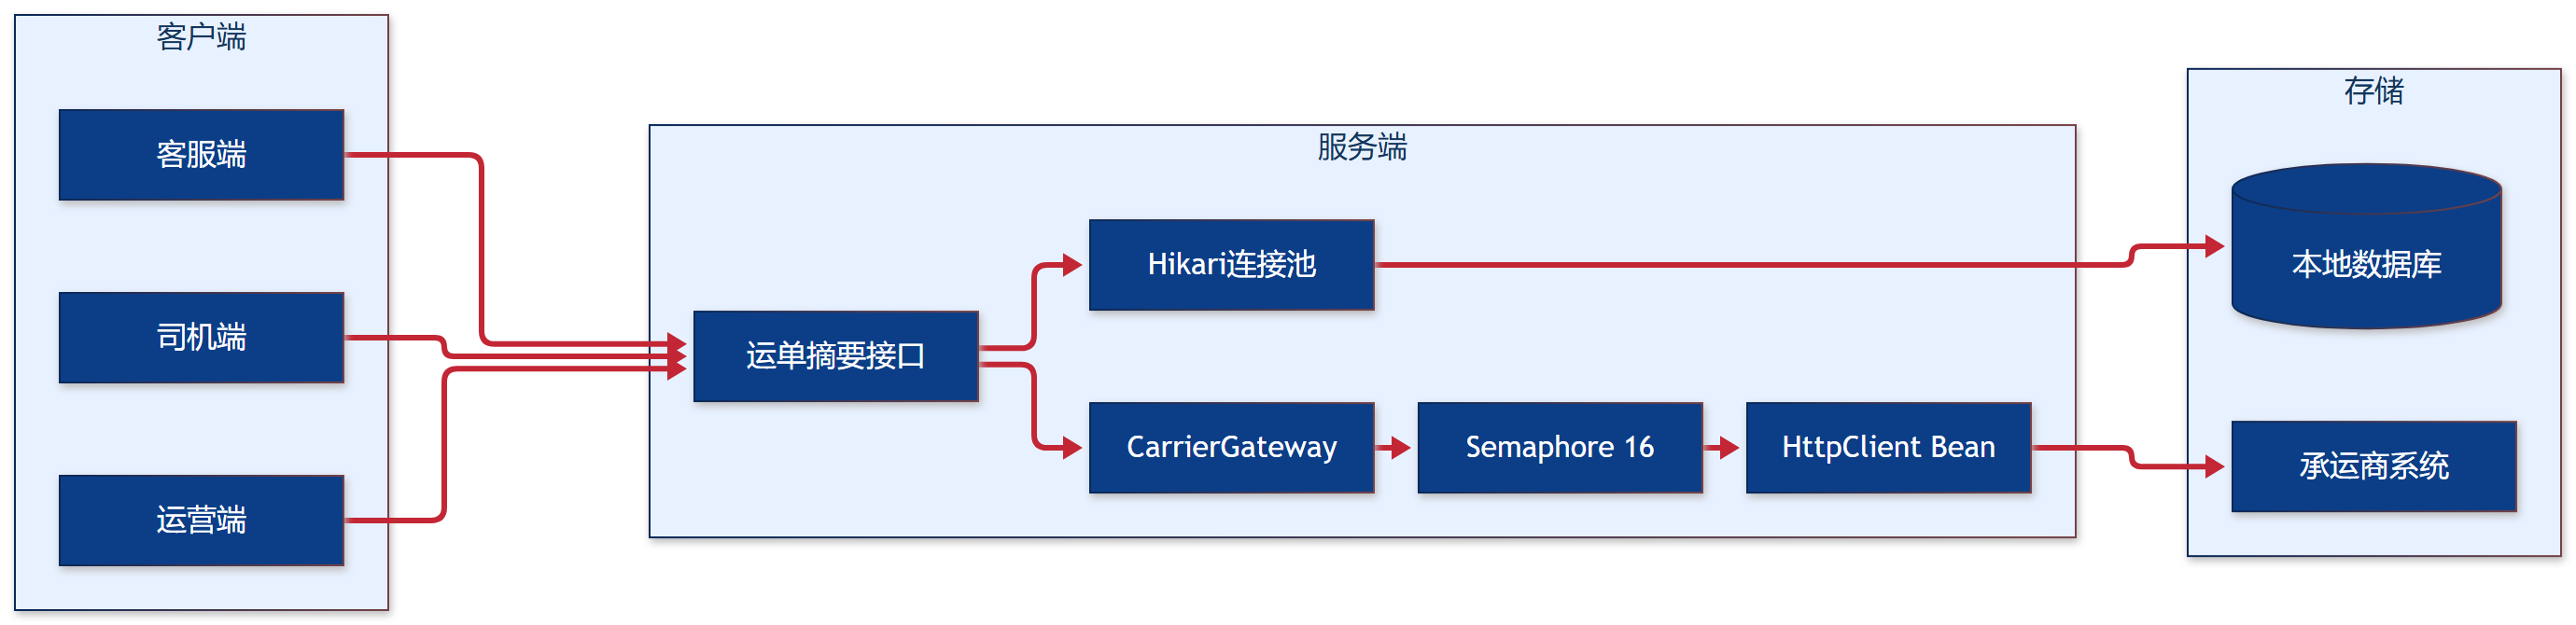
“远航派送”有三个核心角色:司机查询运单,运营查看轨迹,客服追踪异常。司机端关心“我这一车要送哪些单”,运营端关心“包裹现在到哪了”,客服端关心“客户投诉时能不能快速定位”。这三类请求最终都会经过运单摘要接口,而运单摘要接口又需要向承运商系统补充查询一段信息。
教学假设的目标应用资源是 2 vCPU/2GiB,压测机单独部署。数据库里放 10 万条种子运单,其中 20% 是热点数据。压测采用阶梯负载:50、100、200、400 req/s,每轮预热 60 秒,采样 180 秒,重复 3 轮。实验目标是可持续负载下 p95 不超过 300ms、错误率低于 1%。注意,这是实验目标,不是已经实现的结果。
冲突:承运商查询突然变慢
某天下午,小陈在压测环境发现一个现象:当承运商查询耗时从几十毫秒突然升高到几百毫秒时,运单摘要接口的 p95 迅速恶化,大量请求被拖住。小周的第一反应是“加重试”,理由是偶尔失败就再试一次。小林担心客服侧会看到更多超时。
我让小周先别急着加代码,把问题拆开看。运单摘要接口的路径大致是:应用收到请求,查本地数据库拿到运单主信息,再调用承运商 HTTP 接口补充一段信息,最后组装返回。数据库查询在 Hikari 连接池下通常比较稳定,真正波动的是承运商 HTTP 调用。
这里有一个关键问题:当承运商接口变慢时,短超时和盲重试哪个更合适?
定位:先分清两类超时
很多同学把“连接超时”和“请求超时”混为一谈。连接超时是建立 TCP 连接阶段的等待上限,请求超时是发出请求后等待响应的上限。JDK HttpClient 里,前者对应 connectTimeout,后者对应 requestTimeout。如果只设一个很短的“超时”,很可能只限制了连接建立,而响应等待仍然很长。
另一个常见误用是把请求超时当成整条业务链的截止时间。实际上,HTTP 请求超时只覆盖“发出请求到收到响应”这一段,不包括前面的排队、数据库查询和后面的组装。即使 HTTP 请求 400ms 超时了,如果前面已经等了 100ms,整体也可能超过 500ms。
再看重试。盲重试的问题在于:下游已经变慢,重试等于把请求量翻倍。如果下游是因为过载而变慢,重试会让它更慢。对于非幂等操作,自动重试还可能造成重复扣款、重复下单。所以,在没确认下游是否幂等之前,不能盲目加重试。
决策:短超时 + 显式并发限制
本课的教学基线是 Spring Boot 3.5.16 + JDK 21 + Maven 3.9+,Servlet/Tomcat 10.1 依赖由 BOM 管理。H2 用于快速体验,MySQL 8 用于数据库性能实验。这里不声称 3.5 是最新版,也不混用 4.x 参数。
客户端选择上,我让小周用 JDK 自带的 java.net.http.HttpClient,减少教学依赖。Apache HttpClient 的显式连接池适合更细粒度管理,但本课先聚焦“超时”和“并发限制”两个变量。需要说明,本例不声称存在通用的 spring.http.pool.max 配置,连接池参数要按客户端实现分别设置。
方案是:复用同一个 HttpClient Bean,不要每个请求 new 一个客户端。carrier profile 里把连接超时 200ms、请求超时 400ms 显式写入构造。同时用 Semaphore(16) 限制本进程对下游的并发调用数。慢调用返回受控错误,而不是无限排队。
为什么选短超时而不是盲重试?因为下游已经变慢,短超时可以快速失败,让调用方尽早降级或返回受控错误。盲重试会放大下游负载,尤其在过载场景下会形成雪崩。
实践:Java 代码配置
下面是小周按本课方案写的核心配置。先定义一个 carrier profile 下的 HttpClient Bean:
@Configuration
@Profile("carrier")
public class CarrierClientConfig {

    @Bean
    public HttpClient carrierHttpClient() {
        return HttpClient.newBuilder()
                .connectTimeout(Duration.ofMillis(200))
                .requestTimeout(Duration.ofMillis(400))
                .build();
    }
}
这里把连接超时和请求超时都显式写进构造,避免依赖默认值。连接超时 200ms 意味着如果 200ms 内连不上承运商,直接失败。请求超时 400ms 意味着发出请求后 400ms 内没收到响应,也直接失败。
接着是并发限制。用 Semaphore(16) 控制同时进行的下游调用数:
@Component
@Profile("carrier")
public class CarrierGateway {

    private final HttpClient httpClient;
    private final Semaphore semaphore = new Semaphore(16);

    public CarrierGateway(HttpClient carrierHttpClient) {
        this.httpClient = carrierHttpClient;
    }

    public CarrierInfo query(String trackingNo, String tenant) {
        if (!semaphore.tryAcquire()) {
            throw new CarrierOverloadException("carrier permit rejected");
        }
        try {
            HttpRequest request = HttpRequest.newBuilder()
                    .uri(URI.create("http://carrier.example/query?trackingNo=" + trackingNo + "&tenant=" + tenant))
                    .timeout(Duration.ofMillis(400))
                    .GET()
                    .build();
            HttpResponse<String> response = httpClient.send(request, HttpResponse.BodyHandlers.ofString());
            if (response.statusCode() == 200) {
                return parse(response.body());
            }
            throw new CarrierTimeoutException("carrier status " + response.statusCode());
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
            throw new CarrierTimeoutException("carrier interrupted");
        } catch (Exception e) {
            throw new CarrierTimeoutException("carrier timeout or error");
        } finally {
            semaphore.release();
        }
    }
}
tryAcquire 失败时立即返回过载错误,对应后面的 503。这样当 16 个 permit 都被占用时,新请求不会无限等待,而是快速失败。
运单摘要接口里,数据库查询和承运商查询分开计量。数据库查询走 Hikari,承运商查询走上面的 gateway。两者之间没有持有关系:HTTP 调用期间不占用数据库连接,数据库查询期间也不占用 HTTP permit。
验证:小陈的故障实验
小陈在压测环境里加了一个开关 carrier-delay-ms,用来模拟承运商变慢。当 carrier-delay-ms=800 时,承运商接口固定延迟 800ms 才返回。
实验结果符合预期:
- 当
carrier-delay-ms=800时,请求超时 400ms 先生效,运单摘要接口返回受控 504,而不是无限等待。 - 当并发超过 16 时,
tryAcquire失败,返回 503,表示本进程对下游的并发限制生效。 - 数据库连接没有被 HTTP 调用持有。小陈在压测期间观察 Hikari 活跃连接数,没有因为承运商变慢而飙升。
- 依赖耗时和 permit 拒绝量都有记录。每次承运商调用记录耗时,每次
tryAcquire失败记录一次拒绝。
小周按本课方案只修改了单一变量:把原来默认超时、无并发限制的客户端,改成显式 200ms/400ms 超时加 Semaphore(16)。其他代码不动。
复盘:预算与边界
我让小周把路径预算写出来:数据库 50ms + 下游 400ms + 应用 50ms = 500ms。这个预算是教学示例,并不满足 300ms 的 p95 目标。要满足 300ms,必须减少路径工作或快速降级。比如,下游超时降到 200ms,或者对非关键补充信息做缓存,或者在下游变慢时直接返回降级数据。
本课只解决“短超时和盲重试哪个更合适”这个问题。答案是:短超时更合适,盲重试不合适。短超时快速失败,配合显式并发限制,能保护下游也保护自己。盲重试在下游已经变慢时只会放大负载。
常见误用有四个:每个请求 new 客户端;把 read timeout 当总 deadline;使用超时却不取消后台任务;对非幂等操作自动重试。本课的代码避免了前两个,第三个在 JDK HttpClient 里由 requestTimeout 覆盖,第四个通过“不加重试”来规避。
最后,小陈把实验报告输出到 results/06/实验报告.md。如果未通过验收,就回滚本课配置,沿调用链反馈定位。本课所有人物、项目名、运单号和性能数据均为教学假设,不构成生产结论。

 浙公网安备 33010602011771号