
二叉树与树
二叉树
二叉树的基本概念
二叉树(Binary Tree)是算法竞赛中最基础、应用最广泛的非线性数据结构之一。
二叉树是 \(n \ (n \ge 0)\) 个节点的有限集合,它满足以下特点:
- 递归性:当 \(n=0\) 时为空树;当 \(n \gt 0\) 时,由一个根节点(Root)以及两棵互不相交的、分别称为根节点的左子树和右子树的二叉树组成。
- 有序性:二叉树的子树有严格的左右之分,次序绝对不能颠倒。即使某个节点只有一棵子树,也必须明确它是左子树还是右子树。
二叉树的核心术语
设节点 \(u\) 连有一条边指向节点 \(v\):
- 父节点:\(u\) 是 \(v\) 的父节点。
- 子节点:\(v\) 是 \(u\) 的子节点(具体分为左孩子与右孩子)。
- 叶子节点:没有子节点的节点。
- 节点的度(Degree):节点拥有的子树棵树,二叉树中节点的度只能为 \(0,1,2\)。叶结点的度数为 \(0\)。
- 深度(Depth):从根节点到该节点的唯一路径上的边数(或节点数),根节点的深度会定义为 \(0\) 或 \(1\),需视具体题目约定。
- 高度(Height):从该节点到其最远叶节点的最长路径上的边数(或节点数),树的高度即为根节点的高度。
不定项选择题
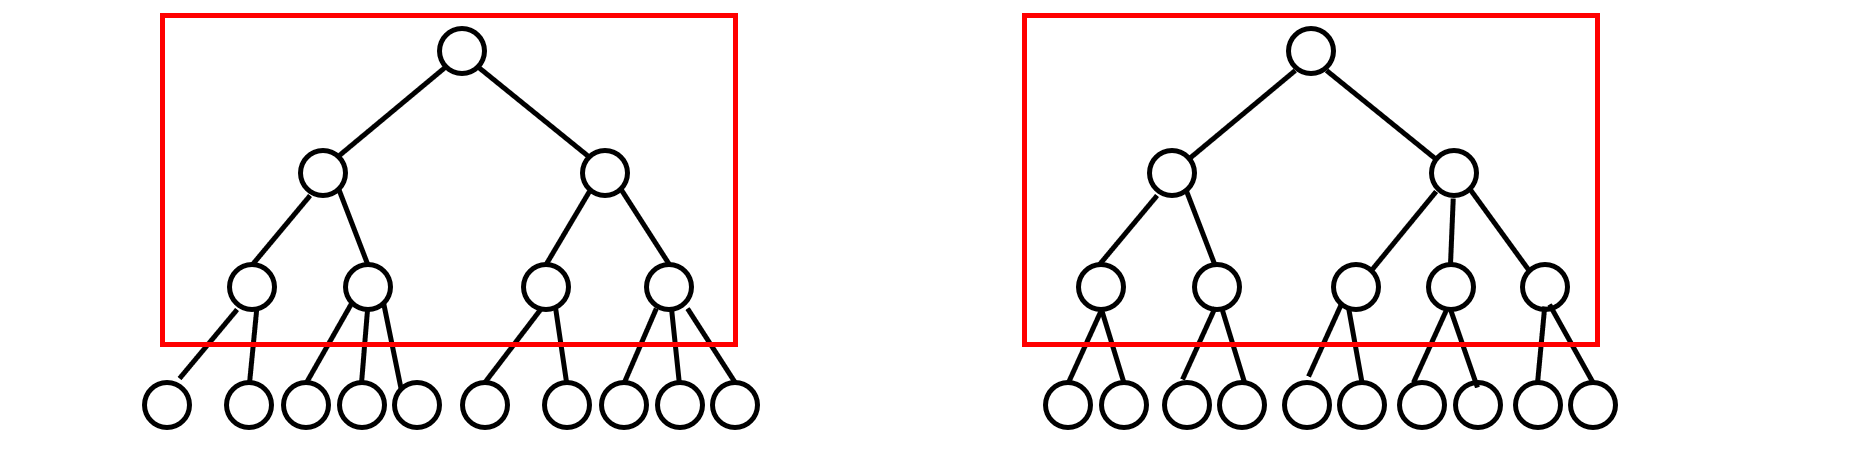
2-3 树是一种特殊的树,它满足两个条件:
- 每个内部节点有两个或三个子节点
- 所有的叶节点到根的路径长度相同
如果一棵 2-3 树有 10 个叶节点,那么它可能有多少个非叶节点?
- A. 5
- B. 6
- C. 7
- D. 8
答案
CD。
特殊形态的二叉树
在算法竞赛中,有几种非常重要的特殊二叉树类型:

- 完美二叉树(Perfect Binary Tree):所有叶子节点都在同一层,且所有非叶节点的度数均为 \(2\)。注意,国内部分教材习惯称其为“满二叉树”,国际标准中称为 Perfect Binary Tree,而 Full Binary Tree 则指所有节点的度数均只为 \(0\) 或 \(2\) 的二叉树。深度为 \(h\)(根节点深度为 1)的完美二叉树,节点总数为 \(2^h-1\)。
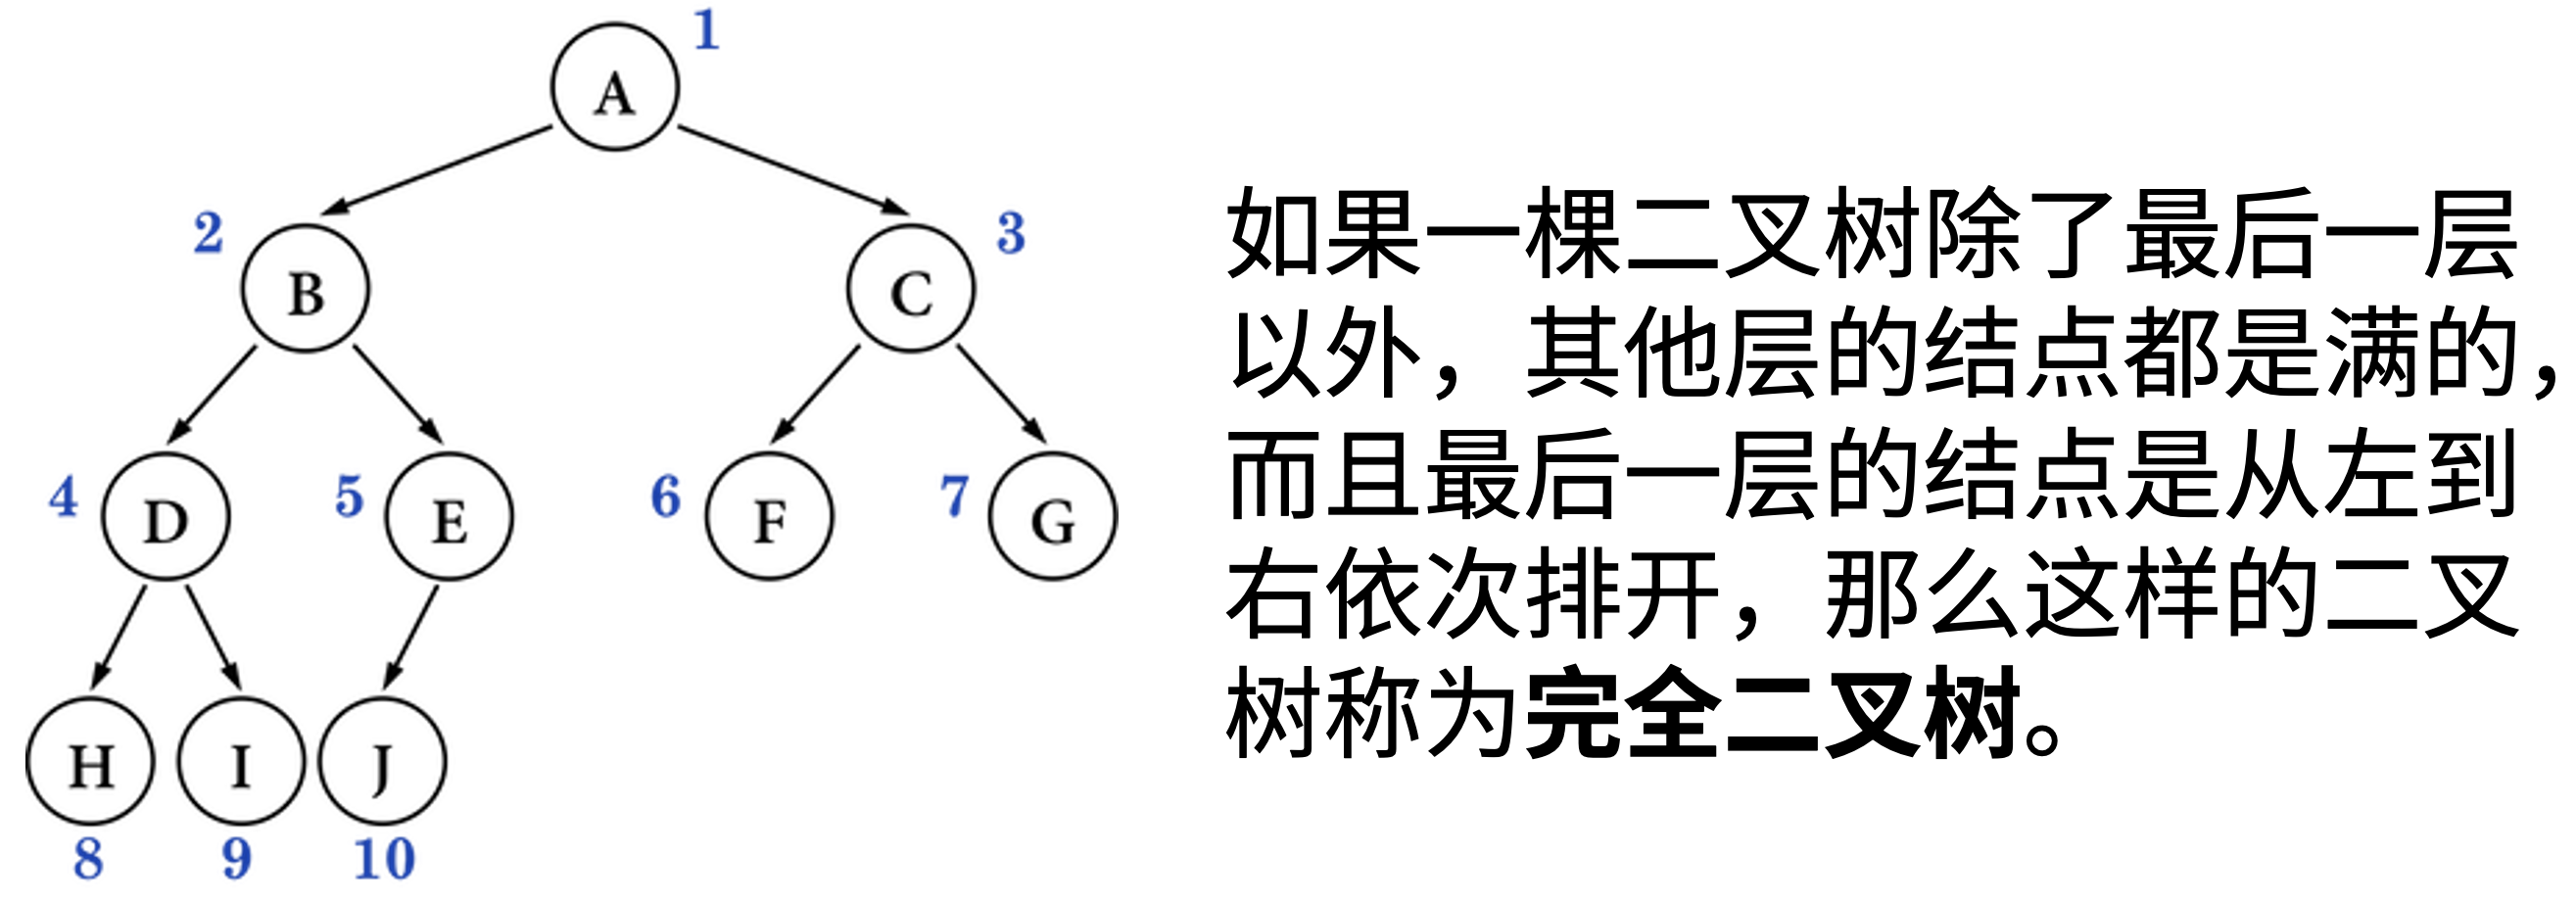
- 完全二叉树(Complete Binary Tree):除最后一层外,其余各层的节点数均达到最大值,最后一层的节点连续集中 在最左边。
- 斜树(Skewed Tree):所有节点都只有左子树(左斜树)或右子树(右斜树)。退化为线性链表,树的高(深)度等于节点数 \(N\)。
例题:P4715 【深基16.例1】淘汰赛
共有 \(2^n \ (n \le 7)\) 个国家参加单败淘汰赛,参赛国家的编号依次为 \(1\) 到 \(2^n\),已知每个国家的能力值(互不相同)。比赛规则如下:
- 相邻的两个国家进行淘汰赛(如 \(1\) 与 \(2\) 比赛、\(3\) 与 \(4\) 比赛、……)。
- 能力值高者直接晋级下一轮,负者淘汰。
- 晋级后的国家按原有相对顺序继续两两对决,直到决出最终冠军。
要求求出本次淘汰赛的亚军(即决赛中输给冠军的那个国家)的编号。
本题的比赛流程是一棵标准的完美二叉树结构:底层有 \(2^n\) 个叶子节点,代表所有参赛队伍。每一轮比赛,队伍数量减半。最终的决赛发生在左半区编号 \(1 \sim 2^{n-1}\) 的胜者与右半区编号 \(2^{n-1}+1 \sim 2^n\) 的胜者之间,决赛中败北的队伍即为亚军。
可以使用队列来逐轮模拟淘汰赛的过程:将所有国家的编号 \(1, 2, \dots, 2^n\) 依序入队。设当前轮剩余队伍数为 \(N\),每轮共有 \(N/2\) 场比赛。每次从队头取出两个队伍编号 \(p_1\) 和 \(p_2\),比较能力值,胜者再次入队,进入下一轮。特别地,当到了最后一轮,失败的那支队伍就是要找的亚军,记录其编号。
参考代码
#include <iostream>
#include <queue>
using namespace std;
const int N = 130;
int a[N];
int main()
{
    int n; cin >> n;
    queue<int> q;
    n = 1 << n; // 2^n 个队伍
    for (int i = 1; i <= n; i++) {
        cin >> a[i];
        q.push(i);
    }
    int ans = 0; // 用于存储亚军的编号
    // 当剩余队伍数大于 1 时继续进行淘汰赛
    while (n > 1) {
        n /= 2; // 当前轮次的比赛场数
        for (int i = 0; i < n; i++) {
            int p1 = q.front(); q.pop();
            int p2 = q.front(); q.pop();
            // 比较两队能力值,胜者入队
            if (a[p1] > a[p2]) {
                q.push(p1);
                // 如果是最后一场比赛(决赛),败者即为亚军
                if (n == 1) ans = p2;
            } else {
                q.push(p2);
                if (n == 1) ans = p1;
            }
        }
    }
    cout << ans << "\n";
    return 0;
}
设总参赛队伍数为 \(M = 2^n\),第一轮比赛场数为 \(M/2\),第二轮比赛场数为 \(M/4\),……,总比赛场数为 \(\frac{M}{2} + \frac{M}{4} + \dots + 1 = M - 1 = 2^n - 1\) 次。每场比赛包含常数级别的队列弹出与入队操作,因此总时间复杂度为 \(O(M)\)。
如果国家个数不是 $2^n$ 个,而是一个任意正整数,这棵树的形态是?
二叉树的数学性质
性质 1:每层节点上限
二叉树第 \(i\) 层(假设根节点在第 \(1\) 层)上最多有 \(2^{i-1}\) 个节点。
性质 2:节点数与度的关系
设二叉树中度数为 \(0\) 的叶子节点数为 \(n_0\),度数为 \(1\) 的节点数为 \(n_1\),度数为 \(2\) 的节点数为 \(n_2\),则必有 \(n_0 = n_2 + 1\)。
推导证明
设总节点数为 \(n\),显然 \(n = n_0 + n_1 + n_2\)。
树中的边数(连线数)等于总节点数减一,即 \(E = n-1\)。度数为 \(2\) 的节点向下产生 \(2\) 条边,度数为 \(1\) 的节点产生 \(1\) 条边,故 \(E = 2n_2 + n_1\)。两者结合则有 \(n_0 + n_1 + n_2 - 1 = 2 n_2 + n_1 \implies n_0 = n_2 + 1\)。
性质 3:完全二叉树的数组下标规律
若将一棵完全二叉树从上到下、从左到右按 \(1 \sim N\) 进行编号(存储在数组 A[1..N] 中),对于编号为 \(i\) 的节点:
- 若 \(i \gt 1\),其父节点编号为 \(\lfloor \frac{i}{2} \rfloor\),即代码中的
i >> 1。 - 其左孩子编号为 \(2i\),即
i << 1。若 \(2i \gt N\),则说明无左孩子。 - 其右孩子编号为 \(2i+1\),即
i << 1 | 1。若 \(2i+1 \gt N\),则说明无右孩子。
如果根节点下标从 $0$ 开始,左/右孩子公式为?
对于编号为 \(i\) 的节点,左孩子编号为 \(2i+1\),右孩子为 \(2i+2\)。

答案
B。前 \(4\) 层都是满的,第 \(5\) 层至少有一个结点,因此至少有 \(1+2+4+8+1=16\) 个结点。
2024 CSP-S1 T11
假设有一棵 \(h\) 层的完全二叉树,该树最多包含多少个节点?
答案
一个具有 \(h\) 层的完全二叉树,要使其节点数达到最多,那么它的所有层都必须被填满。当所有层都被填满时,这棵树就成了一棵完美二叉树。
一棵 \(h\) 层的完美二叉树的节点总数:
- 第 1 层有:\(2^0=1\) 个节点
- 第 2 层有:\(2^1=2\) 个节点
- 第 3 层有:\(2^2=4\) 个节点
- ……
- 第 \(h\) 层:\(2^{h-1}\) 个节点
总节点数就是将每一层的节点数相加,这是一个等比数列求和:\(总数 = 1+2+4+\cdots+2^{h-1}\)。
根据等比数列求和公式 \(S_n = \dfrac{a_1(1-q^n)}{1-q}\),其中 \(a_1 = 1\),\(q=2\),\(n=h\),\(总数 = \dfrac{1 \times (2^h-1)}{(2-1)} = 2^h-1\)。
因此,一棵 \(h\) 层的完全二叉树最多包含 \(2^h-1\) 个节点。
选择题:根节点深度为 \(0\),一棵深度为 \(h\) 的满 \(k(k \gt 1)\) 叉树,即除最后一层无任何子节点外,每一层上的所有节点都有 \(k\) 个子节点的树,共有多少个节点?
- A. \(\dfrac{k^{h+1}-1}{k-1}\)
- B. \(k^{h-1}\)
- C. \(k^h\)
- D. \(\dfrac{k^{h-1}}{k-1}\)
答案
A。
总节点数 \(N = k^0 + k^1 + k^2 + \cdots + k^h\),应用等比数列求和公式可以得到 \(\dfrac{k^{h+1}-1}{k-1}\)。
选择题:令根节点的高度为 1,则一棵含有 2021 个节点的二叉树的高度至少为?
- A. 10
- B. 11
- C. 12
- D. 2021
答案
B。
为了使含有 2021 个节点的二叉树高度最小,这棵树必须尽可能地“紧凑”和“平衡”。这种形态的树是完全二叉树。
一棵高度为 \(h\) 的完美二叉树(最紧凑的情况),其节点总数为 \(2^h-1\)。一棵高度为 \(h\) 的完全二叉树,其节点数 \(n\) 满足以下关系:它至少包含一个高度为 \(h-1\) 的完美二叉树和一个在第 \(h\) 层的节点,至多是一个高度为 \(h\) 的完美二叉树。因此,节点数 \(n\) 的范围是 \(2^{h-1} \le n \le 2^h-1\)。
需要找到满足 \(2^{h-1} \le 2021 \le 2^h-1\) 的最小整数 \(h\)。当 \(h=10\) 时,一个高度为 10 的完全二叉树,节点数范围为 \([2^9, 2^{10}-1]\),即 \([512, 1023]\)。因为 \(2021 \lt 1023\),所以高度为 10 的树不足以容纳 2021 个节点。当 \(h=11\) 时,一个高度为 11 的完全二叉树,节点数范围是 \([2^{10}, 2^{11}-1]\),即 \([1024, 2047]\)。因为 \(1024 \le 2021 \le 2047\),所以 2021 个节点可以构成一棵高度为 11 的完全二叉树。
二叉树的存储
在算法竞赛中,通常使用静态数组开辟空间,利用节点下标充当指针。
struct Node {
    int v;
    int l; // 左孩子的节点编号,0 表示无左孩子
    int r; // 右孩子的节点编号,0 表示无右孩子
};
Node tree[N];
int cnt = 0; // 静态节点分配计数器
// 创建新节点
void create(int val) {
    cnt++;
    tree[cnt].v = val;
    tree[cnt].l = tree[cnt].r = 0;
}
如果不需要在节点存很多附加信息,直接开两个数组 lc[] 和 rc[] 分别记录左右孩子。
int lc[N]; // lc[i] 表示节点 i 的左孩子编号
int rc[N]; // rc[i] 表示节点 i 的右孩子编号
int val[N]; // val[i] 表示节点 i 的权值
二叉树的四种遍历方式
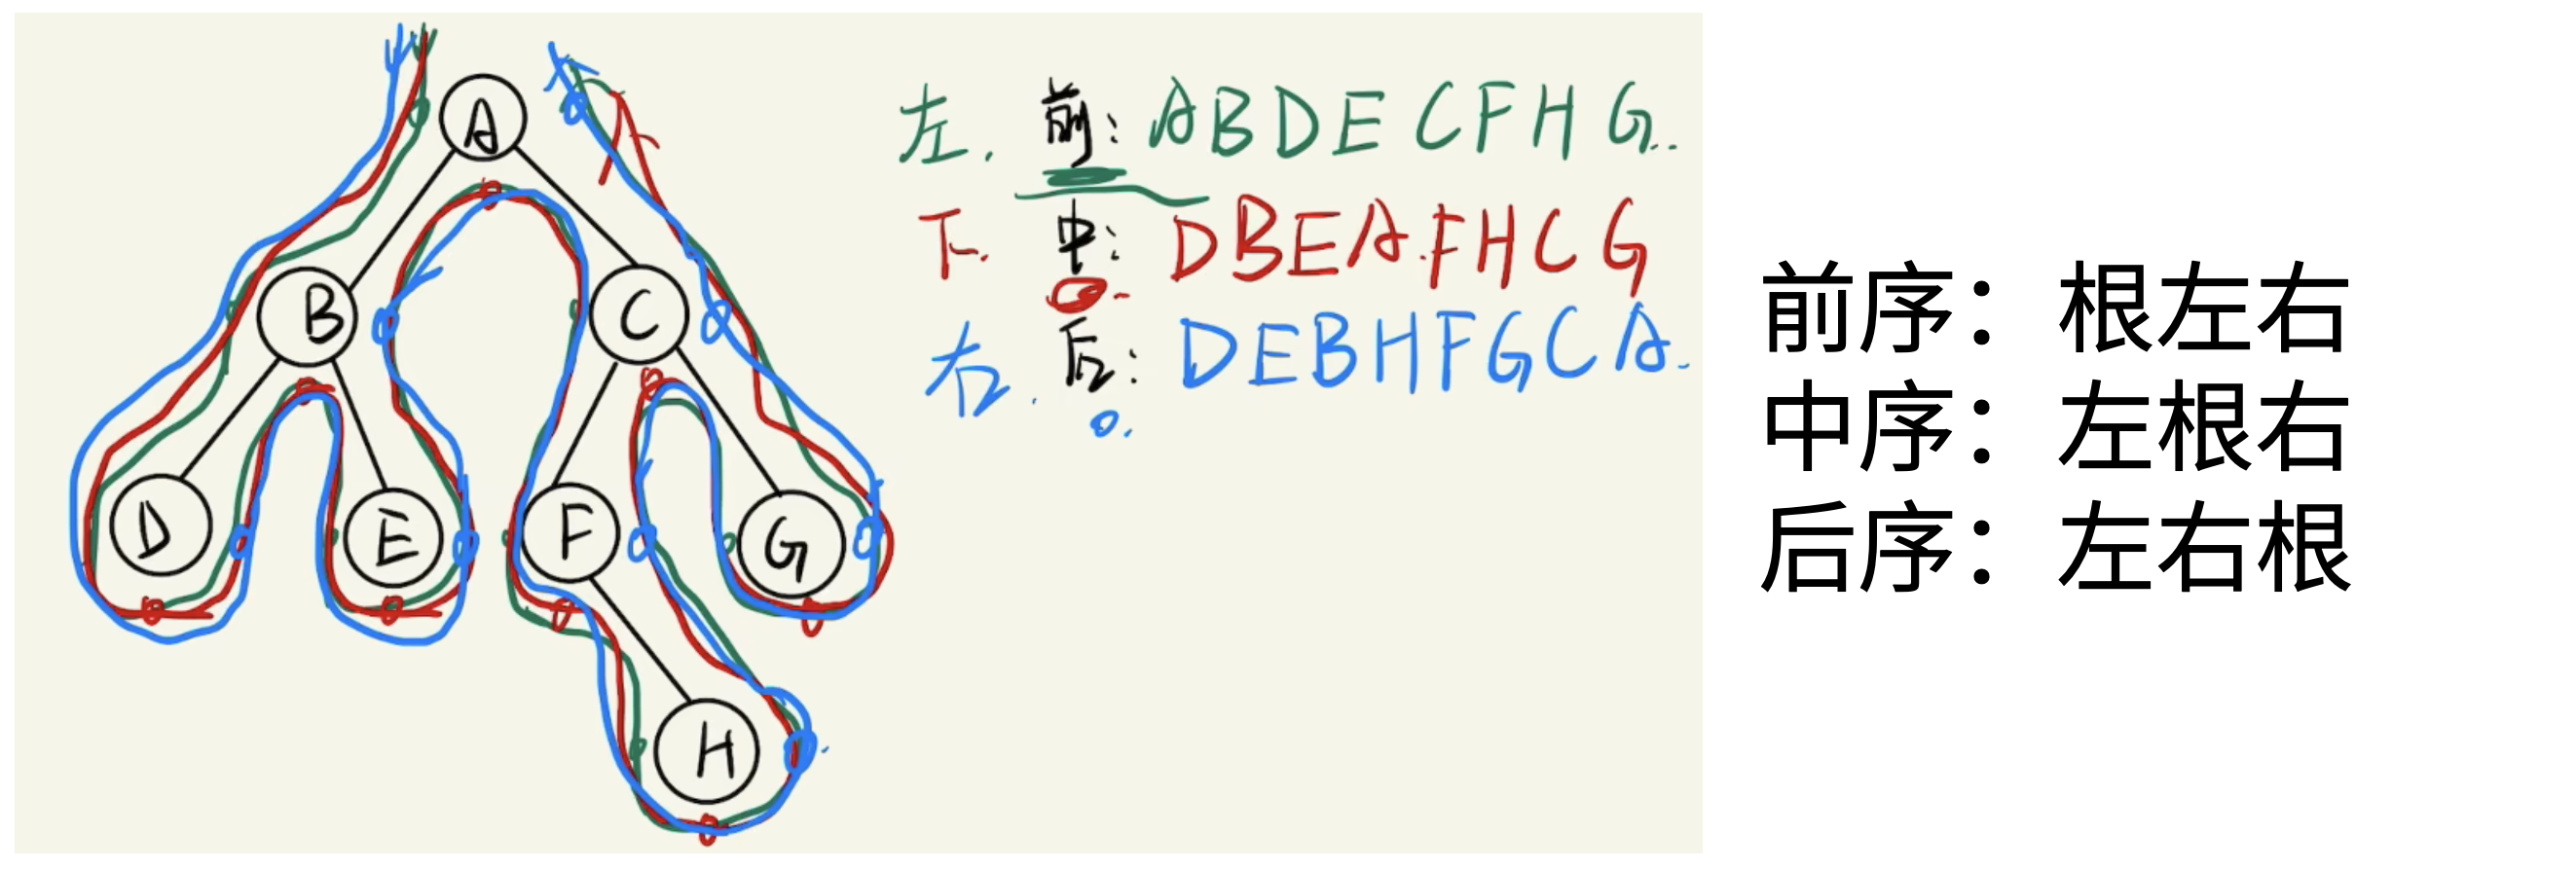
遍历是指按照某种特定次序访问二叉树中的所有节点,且每个节点仅被访问一次。
前序遍历
顺序:根节点 \(\rightarrow\) 左子树 \(\rightarrow\) 右子树。
特点:序列的第一个元素必然是整棵树的根节点。
void preOrder(int u) {
    if (u == 0) return;
    cout << val[u] << " "; // 访问根节点
    preOrder(lc[u]); // 递归访问左子树
    preOrder(rc[u]); // 递归访问右子树
}
选择题:一个深度为 5(根节点深度为 1)的完全 3 叉树,按前序遍历的顺序给节点从 1 开始编号,则第 100 号节点的父节点是第几号?
- A. 95
- B. 96
- C. 97
- D. 98
答案
正确答案是 C。
需要知道一个节点作为根时,它所包含的整个满子树一共有多少个节点。
一个深度为 \(d\) 的满 \(k\) 叉树的节点总数公式为 \((k^d - 1) / (k - 1)\),本题中 \(k=3\)。
- 深度为 1 的子树(单个叶子节点):\((3^1-1)/2=1\) 个节点。
- 深度为 2 的子树:\((3^2-1)/2=4\) 个节点。
- 深度为 3 的子树:\((3^3-1)/2=13\) 个节点。
- 深度为 4 的子树:\((3^4-1)/2=40\) 个节点。
- 深度为 5 的整棵树(如果是满的):\((3^5-1)/2=121\) 个节点。

例题:P1305 新二叉树
给定一棵包含 \(n \ (1 \le n \le 26)\) 个节点的二叉树,每个节点用一个小写英文字母(或字符
*)表示。连续输入 \(n\) 行数据,每行包含当前节点名称及其左、右子节点的名称(若无左/右子节点则用字符*表示)。题目保证第一行读入的节点即为整棵二叉树的根节点,求这棵二叉树的前序遍历序列。
参考代码
#include <iostream>
using namespace std;
const int N = 128;
char lc[N], rc[N];
// 前序遍历:根 -> 左 -> 右
void preorder(char u) {
    if (u == '*') return; // 遇到空节点,终止递归
    cout << u; // 访问并输出当前节点
    preorder(lc[u]); // 递归遍历左子树
    preorder(rc[u]); // 递归遍历右子树
}
int main()
{
    int n; cin >> n;
    char root;
    for (int i = 0; i < n; i++) {
        char node, l, r;
        cin >> node >> l >> r;
        lc[node] = l; rc[node] = r;
        if (i == 0) root = node; // 记录根
    }
    // 从根发起前序遍历
    preorder(root);
    cout << "\n";
    return 0;
}
建树阶段读入 \(n\) 次,耗时 \(O(n)\);在前序遍历过程中,树中的每个节点被访问 \(1\) 次,对于每个节点的输出与递归调用均为 \(O(1)\) 操作,总时间复杂度为 \(O(n)\)。
中序遍历
顺序:左子树 \(\rightarrow\) 根节点 \(\rightarrow\) 右子树。
void inOrder(int u) {
    if (u == 0) return;
    inOrder(lc[u]); // 递归访问左子树
    cout << val[u] << " "; // 访问根节点
    inOrder(rc[u]); // 递归访问右子树
}
二叉搜索树是一种特殊的二叉树,它满足如下性质:对于树中的任意节点 \(x\),若它的左子树不为空,则左子树上所有节点的值均小于 \(x\) 的值;若它的右子树不为空,则右子树上所有节点的值均大于 \(x\) 的值。
核心特点:由于 BST 的“左小右大”性质,对其进行中序遍历(左 \(\rightarrow\) 根 \(\rightarrow\) 右)得到的序列必然是一个严格单调递增的有序序列,这一性质常用于检验一棵树是否为合法 BST 或在 BST 中查找特定元素。
选择题:前序遍历和中序遍历相同的二叉树为且仅为?
- A. 只有 1 个点的二叉树
- B. 根节点没有左子树的二叉树
- C. 非叶子节点只有左子树的二叉树
- D. 非叶子节点只有右子树的二叉树
答案
D。
前序遍历:根节点 → 左子树 → 右子树,中序遍历:左子树 → 根节点 → 右子树。
在前序遍历中,访问的第一个节点永远是当前树(或子树)的根节点。在中序遍历中,访问的第一个节点是当前树(或子树)的最左边的节点。
要使两个遍历序列相同,它们的第一个元素必须相同。这意味着,对于树中的任意一个节点(把它看作一个子树的根),它自身必须是该子树中最左边的节点。这种情况发生的唯一条件是:这个节点没有左子树。如果它有左子树,那么中序遍历就会先访问左子树,导致第一个被访问的节点不是根节点,从而与前序遍历产生差异。
这个“没有左子树”的条件必须对树中的每一个节点都成立。如果树的根节点没有左子树,那么遍历的下一个节点将是右子树的根。对于这个右子树,同样的逻辑也适用:它的根节点(即原始树根的右孩子)也不能有左孩子。这个规律依次传递下去,得出的结论是:整棵树从上到下,没有任何一个节点可以拥有左孩子。
后序遍历
顺序:左子树 \(\rightarrow\) 右子树 \(\rightarrow\) 根节点。
特点:序列的最后一个元素必然是整棵树的根节点,经常用于自底向上的信息统计(如计算树的子树大小、高度等)。
void postOrder(int u) {
    if (u == 0) return;
    postOrder(lc[u]); // 递归访问左子树
    postOrder(rc[u]); // 递归访问右子树
    cout << val[u] << " "; // 访问根节点
}
答案
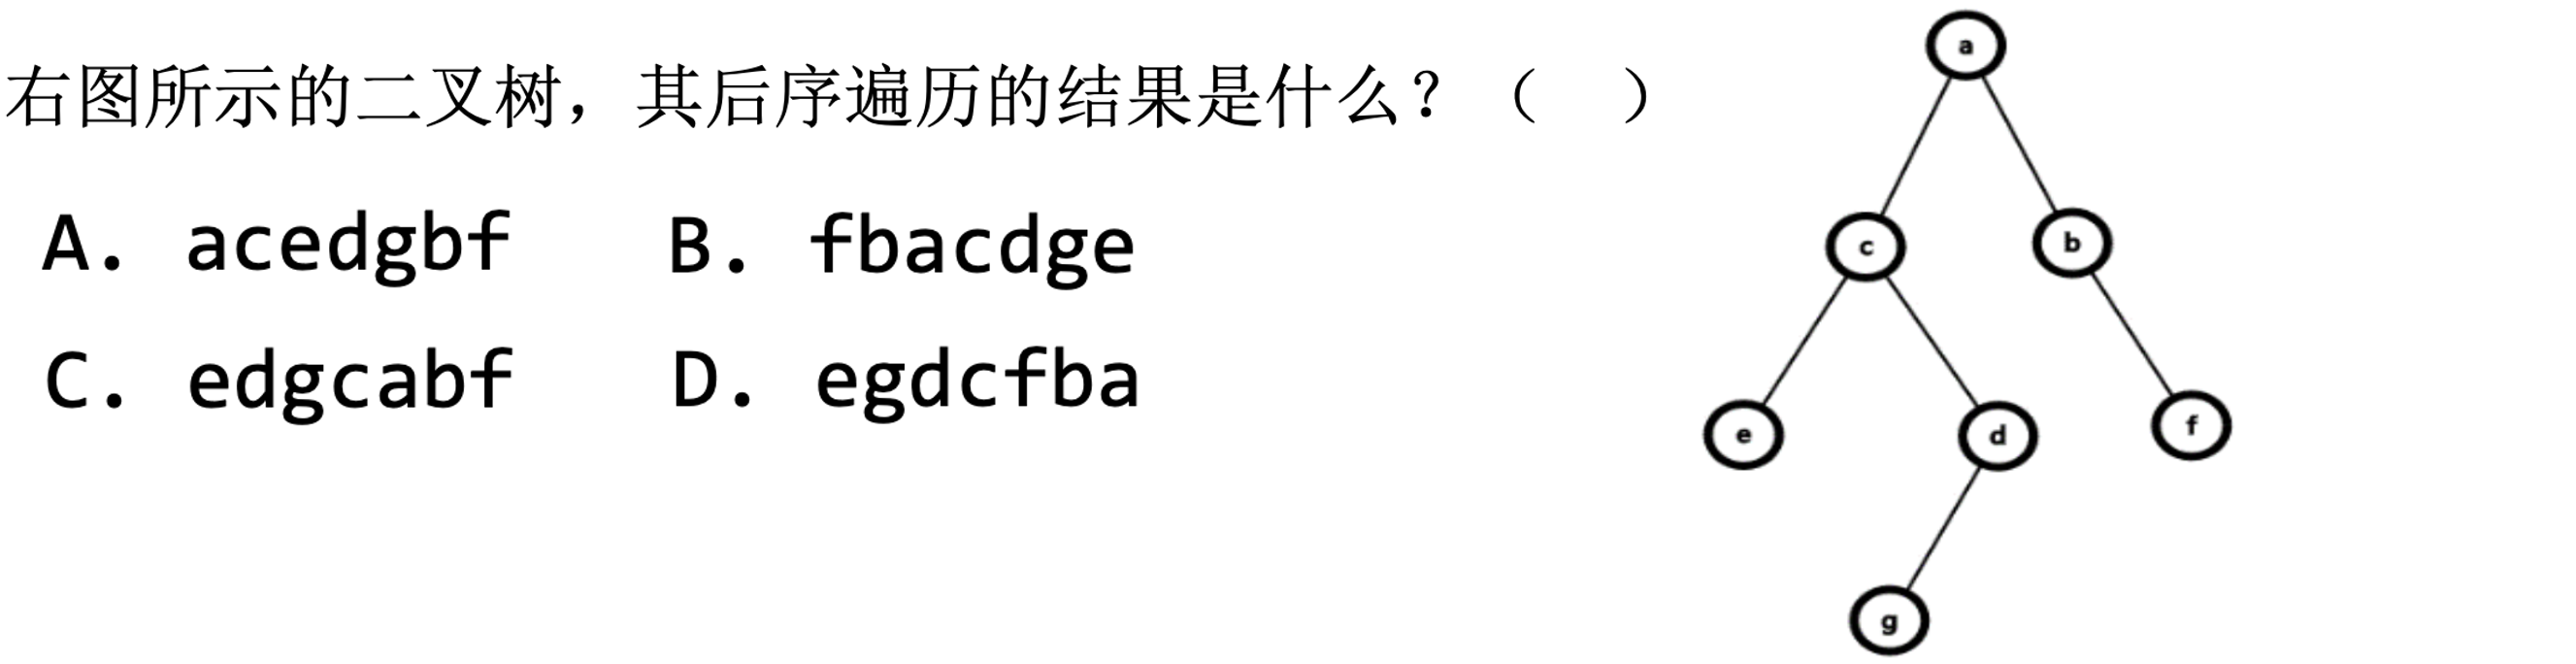
D
例题:P1087 [NOIP 2004 普及组] FBI 树
给定一个长度为 \(2^N \ (0 \le N \le 10)\) 的 01 字符串,按照以下规则递归构造一棵二叉树(称为 FBI 树):
- 节点分类:全 0 串对应的节点类型为 B 节点,全 1 串对应的节点类型为 I 节点,既含 0 又含 1 的串对应的节点类型为 F 节点。
- 递归构造:若当前字符串长度等于 \(1\),则该节点为叶子节点;若当前字符串长度大于 \(1\),则将其划分为等长的左右两个子串,分别作为当前节点的左子树和右子树。
求这棵 FBI 树的后序遍历序列(输出各节点代表的字符)。
如果从叶子节点向上推导,一个父节点的 FBI 类型可以完全由其左子树类型与右子树类型决定:若左子树为 B 且右子树为 B,说明整段子串全是 0,父节点类型为 B。若左子树为 I 且右子树为 I,说明整段子串全是 1,父节点类型为 I。其他任何情况(例如包含 F、或者一左一右分别为 B 与 I),说明子串中既包含 0 也包含 1,父节点类型为 F。
递归边界是当前子串区间只包含一个字符时,根据其 0/1 值决定是 B 还是 I。当区间长度大于 \(1\) 时,取中点将区间分两半,分别递归即可完成合并与输出。
参考代码
#include <iostream>
using namespace std;
const int N = 1030;
char s[N];
// 分治递归求解 FBI 树并输出后序遍历
char dfs(int l, int r) {
    // 递归边界:区间长度为 1(叶子节点)
    if (l == r) {
        return (s[l] == '0' ? 'B' : 'I');
    }
    int mid = l + (r - l) / 2;
    // 递归处理左子树
    char ls = dfs(l, mid);
    cout << ls; // 输出左子树根节点的类型
    // 递归处理右子树
    char rs = dfs(mid + 1, r);
    cout << rs; // 输出右子树根节点的类型
    // 根据左右子树类型推导当前节点的类型
    if (ls == rs) return ls;
    else return 'F';
}
int main()
{
    int n; cin >> n;
    for (int i = 1; i <= (1 << n); i++) {
        cin >> s[i];
    }
    // 调用递归函数处理整棵树,并输出根节点的类型
    cout << dfs(1, 1 << n) << "\n";
    return 0;
}
例题:P5018 [NOIP 2018 普及组] 对称二叉树
给定一棵包含 \(n \ (n \le 10^6)\) 个节点的二叉树,每个节点 \(i\) 包含一个点权 \(v_i \ (v_i \le 1000)\)。定义一棵树为对称二叉树:若将这棵树所有节点的左右子树交换后,得到的新树与原树在对应位置上的结构完全相同,且对应位置上的节点点权也想等。现在要求在原树中找到一棵节点树最多的对称二叉树(这里的子树定义为某个节点 \(T\) 及其所有后代节点构成的二叉树),并输出该子树的节点总数。
首先通过一次后序遍历计算出整棵树中每一个节点 \(i\) 为根的子树大小 \(s_i\),有 \(s_i = s_{l_i} + s_{r_i} + 1\)。
根据题目定义,一棵以节点 \(u\) 为根的二叉树是对称二叉树,当且仅当它的左子树与右子树互为镜像。两棵二叉树 \(X\) 与 \(Y\) 互为镜像的充要条件为:
- \(X\) 与 \(Y\) 均为空节点,此时成立。
- 若 \(X\) 与 \(Y\) 均不为空,则必须同时满足条件:点权相等,子树规模相等,交叉镜像。
只要 \(X\) 或 \(Y\) 中有一个为空而另一个不为空,或者上述任何条件不满足,则 \(X\) 与 \(Y\) 不为镜像。
基于上述镜像性质,可以实现一个递归函数 check(x, y) 用来判断以 \(x\) 和 \(y\) 为根的子树是否互为镜像:
- 边界条件:两边都为空,返回
true;一边为空一边不为空,结构不匹配,返回false。 - 高效剪枝:若点权不想等,直接返回
false;若预先计算好的子树大小不相等,直接返回false。 - 子树交叉递归:递归检查
check(l[x], r[y]) && check(r[x], l[y])。
在加入子树大小判断剪枝后,算法的最坏时间复杂度为 \(O(n \log n)\)。
证明
考虑在遍历所有节点 \(i \in [1,n]\) 调用 check(l[i], r[i]) 的过程中,任何一个节点 \(u\) 被访问的总次数:
- 如果在某次
check过程中,在访问到 \(u\) 时因权值不符或结构不符返回了false,则包含 \(u\) 的该次递归遍历立即终止。因为只有当父节点及其左右子树规模完全相同时才会向下递归,不匹配的情况会在递归树的高层被快速阻断,所有节点作为“失败节点”被访问的总次数不会超过 \(O(n)\)。 - 如果节点 \(u\) 在某次以 \(r_1\) 为根的
check中被完整遍历并成功匹配,说明 \(u\) 属于某个大的对称子树。若 \(u\) 随后又在更高的祖先 \(r_2\) 的check中被再次成功匹配,说明以 \(r_1\) 为根的对称结构被整体包含在以 \(r_2\) 为根的更大对称结构中。根据二叉树的性质,每次包含 \(u\) 的对称子树规模至少翻倍,即 \(s_{r_2} \ge 2 \times s_{r_1} + 1\)。由于整棵树的最大节点数为 \(n\),包含 \(u\) 的对称子树规模最多只能翻倍 \(O(\log n)\) 次。因此,任何一个节点 \(u\) 在所有成功的check检查中被访问的总次数至多为 \(O(\log n)\) 次。
综上所述,所有节点在遍历检查中的总访问次数被严格控制在 \(O(n \log n)\) 级别。
参考代码
#include <iostream>
using namespace std;
const int N = (int)1e6 + 5;
// l, r, v 分别存储每个节点的左孩子、右孩子和权值
// s 存储以该节点为根的子树的节点总数
int v[N], l[N], r[N], s[N];
// 通过后序遍历预处理计算以 u 为根的子树大小
void dfs(int u) {
    if (u == -1) return;
    dfs(l[u]); dfs(r[u]);
    // 当前子树大小 = 左子树大小 + 右子树大小 + 1 (根节点本身)
    s[u] = s[l[u]] + s[r[u]] + 1;
}
// 检查以 x 和 y 为根的两棵子树是否互为镜像
bool check(int x, int y) {
    // 两个都是空节点,结构完全匹配
    if (x == -1 && y == -1) return true;
    // 一个为空一个不为空,结构不对称
    if (x == -1 || y == -1) return false;
    // 剪枝优化:如果权值不同,或者子树节点总数不同,则一定不互为镜像
    if (v[x] != v[y] || s[x] != s[y]) return false;
    // 交叉递归检查:x 的左子树必须与 y 的右子树镜像,x 的右子树必须与 y 的左子树镜像
    return check(l[x], r[y]) && check(r[x], l[y]);
}
int main()
{
    int n; cin >> n;
    for (int i = 1; i <= n; i++) {
        cin >> v[i];
    }
    for (int i = 1; i <= n; i++) {
        cin >> l[i] >> r[i];
    }
    // 从根节点 1 开始,计算所有节点的子树大小
    dfs(1);
    // 任何单个独立节点本身都是大小为 1 的对称二叉树,因此答案初值为 1
    int ans = 1;
    for (int i = 1; i <= n; i++) {
        // 一个子树对称的充要条件是:其左子树与右子树互为镜像
        if (check(l[i], r[i])) {
            // 如果对称,用当前子树的大小更新最大值
            ans = max(ans, s[i]);
        }
    }
    cout << ans << "\n";
    return 0;
}
层序遍历
顺序:按照从上到下、从左到右的顺序逐层访问节点。
实现:借助队列实现广度优先搜索,按层区分输出时,可以通过记录当前层节点数实现。
// 按层遍历并逐层打印
void levelOrder(int root) {
    if (root == 0) return;
    queue<int> q;
    q.push(root);
    while (!q.empty()) {
        int sz = q.size(); // 当前层的节点数量
        while (sz--) {
            int u = q.front();
            q.pop();
            cout << val[u] << " ";
            if (lc[u] != 0) q.push(lc[u]);
            if (rc[u] != 0) q.push(rc[u]);
        }
        cout << "\n"; // 每层换行
    }
}
例题:P4913 【深基16.例3】二叉树深度
给定一棵包含 \(n \ (1 \le n \le 10^6)\) 个节点的二叉树,根节点编号固定为 \(1\)。每个节点给出其左右子节点的编号,若无左/右子节点则用 \(0\) 表示。求这棵二叉树的最大深度,即从根节点到叶子节点最多经过的层数。
DFS 和 BFS 都可以实现,时间复杂度都为 \(O(n)\)。
- DFS:利用二叉树的递归结构,从根节点出发递归向下探索。一个节点的深度等于其左右子树深度的较大值加 \(1\),如果节点为空也就是编号为 \(0\),则深度为 \(0\)。
- BFS:利用队列按层扩展,每次将当前层的所有点弹出并将其左右子节点入队,每完成一层的处理,深度计数器加 \(1\)。
参考代码(DFS)
#include <iostream>
#include <algorithm>
using namespace std;
const int N = (int)1e6 + 5;
int l[N], r[N];
// DFS 递归计算子树深度
int dfs(int u) {
    if (u == 0) return 0; // 空节点深度为 0
    return max(dfs(l[u]), dfs(r[u])) + 1; // 左右子树最大深度 + 1
}
int main()
{
    int n; cin >> n;
    for (int i = 1; i <= n; i++) {
        cin >> l[i] >> r[i];
    }
    // 从根结点 1 发起 DFS
    cout << dfs(1) << "\n";
    return 0;
}
参考代码(BFS)
#include <iostream>
#include <queue>
using namespace std;
const int N = (int)1e6 + 5;
int l[N], r[N];
int main()
{
    int n; cin >> n;
    for (int i = 1; i <= n; i++) {
        cin >> l[i] >> r[i];
    }
    queue<int> q;
    q.push(1);
    int ans = 0;
    // BFS 层序遍历
    while (!q.empty()) {
        ans++;
        int s = q.size();
        while (s--) {
            int u = q.front(); // 当前层的点数
            q.pop();
            if (l[u]) q.push(l[u]); // 存在左孩子
            if (r[u]) q.push(r[u]); // 存在右孩子
        }
    }
    cout << ans << "\n";
    return 0;
}
由遍历序列还原二叉树
已知一棵二叉树,可以确定它的三种遍历序列。反过来,已知两种遍历序列,能否确定二叉树?
已知前序 + 中序
可以唯一确定一棵二叉树。
例题:P1827 [USACO3.4] 美国血统 American Heritage
已知一棵二叉树的中序遍历和前序遍历,求出该二叉树的后序遍历。树中每个节点均用一个大写英文字母表示,且树中节点的字母各不相同,节点总数 \(N \le 26\)。
前序遍历的访问顺序为 [根节点] -> [左子树] -> [右子树],因此,前序序列的第一个元素必定是当前树的根节点。
中序遍历的访问顺序为 [左子树] -> [根节点] -> [右子树],一旦在序列中定位到根节点的位置,根节点左侧的所有元素即属于左子树,右侧的所有元素即属于右子树。
利用上述性质,可以采用分治思想递归地重建这棵二叉树并直接输出后续遍历序列,假设当前正在处理的前序序列的区间是 \([l_{pre}, r_{pre})\),中序的区间是 \([l_{in}, r_{in})\):
- 确定根节点:在前序序列的当前区间首部获取根节点。
- 切分中序序列:在中序序列中找到根节点的位置 \(p\),那么左子树的中序区间为 \([l_{in}, p)\),右子树的中序区间为 \([p+1, r_{in})\),左子树节点个数为 \(s_l = p - l_{in}\)。
- 切分前序序列:左子树的前序区间为 \([l_{pre}+1, l_{pre}+1+s_l)\),右子树的前序区间为 \([l_{pre}+1+s_l, r_{pre})\)。
- 输出后序遍历:根据后序遍历
左 -> 右 -> 根的顺序,优先递归求解左子树,接着递归求解右子树,最后输出当前根节点字符。
参考代码
#include <iostream>
#include <string>
using namespace std;
const int N = 128;
string in, pre;
int pos[N];
// 递归求解后序遍历
// 中序遍历的左边界(左闭右开)、右边界 前序遍历的左边界、右边界
void solve(int inl, int inr, int prel, int prer) {
    // 递归边界:区间为空时直接返回
    if (inl >= inr) return;
    // 前序遍历的第一个字符即为当前子树的根节点
    char root = pre[prel];
    // 查询根节点在中序遍历中的位置
    int p = pos[root];
    // 计算左子树的大小
    int ls = p - inl;
    // 递归处理左子树
    solve(inl, p, prel + 1, prel + 1 + ls);
    // 递归处理右子树
    solve(p + 1, inr, prel + 1 + ls, prer);
    // 后序遍历:在左右子树递归完成后输出根节点
    cout << root;
}
int main()
{
    cin >> in >> pre;
    int n = in.length();
    // 预处理中序遍历中每个字符对应的索引
    for (int i = 0; i < n; i++) {
        pos[in[i]] = i;
    }
    // 递归求解,区间使用 [0, n) 表示
    solve(0, n, 0, n);
    cout << "\n";
    return 0;
}
已知后序 + 中序
可以唯一确定一棵二叉树。
和上一节类似,根据中序和后序遍历序列确定一棵二叉树的步骤:
- 根据后序序列最后一个节点确定根节点
- 根据根节点在中序序列中的位置,分割出左子树和右子树
- 对左子树和右子树分别递归使用相同的方法继续分解
【练习】已知一棵二叉树的中序遍历序列为 CBEDAHGIJF,后序遍历序列为 CEDBHJIGFA,求出其先序遍历序列。
答案
ABCDEFGHIJ
例题:P1030 [NOIP 2001 普及组] 求先序排列
已知一棵二叉树的中序遍历和后序遍历序列(长度不超过 8),求出该二叉树的先序遍历序列,树中每个节点均用一个不同的大写英文字母表示。
参考代码
#include <iostream>
using namespace std;
const int N = 128;
string in, post;
int pos[N];
// 递归求解先序遍历
// 中序遍历的左边界(左闭右开)、右边界 后序遍历的左边界、右边界
void solve(int inl, int inr, int postl, int postr) {
    // 递归边界:区间为空时直接返回
    if (inl >= inr) return;
    // 后序遍历的最后一个字符即为当前子树的根节点
    char root = post[postr - 1];
    // 先序遍历:首先输出当前根节点
    cout << root;
    // 查询根节点在中序遍历中的位置
    int p = pos[root];
    // 计算左子树的大小
    int ls = p - inl;
    // 递归处理左子树
    solve(inl, p, postl, postl + ls);
    // 递归处理右子树(除去根节点 postr - 1)
    solve(p + 1, inr, postl + ls, postr - 1);
}
int main()
{
    cin >> in >> post;
    int n = in.length();
    // 预处理中序遍历中每个字符对应的索引
    for (int i = 0; i < n; i++) {
        pos[in[i]] = i;
    }
    // 递归求解,区间采用左闭右开 [0, n)
    solve(0, n, 0, n);
    cout << "\n";
    return 0;
}
2025 CSP-S1 T8
如果一棵二叉搜索树的后序遍历序列是 \(2,5,4,8,12,10,6\),那么该树的前序遍历是什么?
答案
后序遍历(左-右-根)的最后一个元素必定是整棵树的根节点,因此根节点是 \(6\)。
根据二叉搜索树的性质,左子树的所有节点值必定小于根节点,右子树的所有节点值必定大于根节点。在去掉根节点 \(6\) 剩余的序列 \(2, 5, 4, 8, 12, 10\) 中,小于 \(6\) 的部分 \(2,5,4\) 构成左子树的后序遍历序列,大于 \(6\) 的部分 \(8,12,10\) 构成右子树的后序遍历序列。
左子树 \(2,5,4\) 的最后一个元素 \(4\) 是子树的根节点,小于 \(4\) 的 \(2\) 是左子节点,大于 \(4\) 的 \(5\) 是右子节点。右子树 \(8,12,10\) 的最后一个元素 \(10\) 是子树的根节点,小于 \(10\) 的 \(8\) 是左子节点,大于 \(10\) 的 \(12\) 是右子节点。
还原后的树形结构如下:
      6
    /   \
   4     10
  / \   /  \
 2   5 8    12
按照“根-左-右”的顺序遍历上述二叉树,即可得出结果 \(6, 4, 2, 5, 10, 8, 12\)。
已知前序 + 后序
不能唯一确定一棵二叉树,除非所有非叶节点的度均为 \(2\)。
例如先序遍历序列为 ABC,后序遍历序列为 CBA,可以画出 \(4\) 种不同的结构。
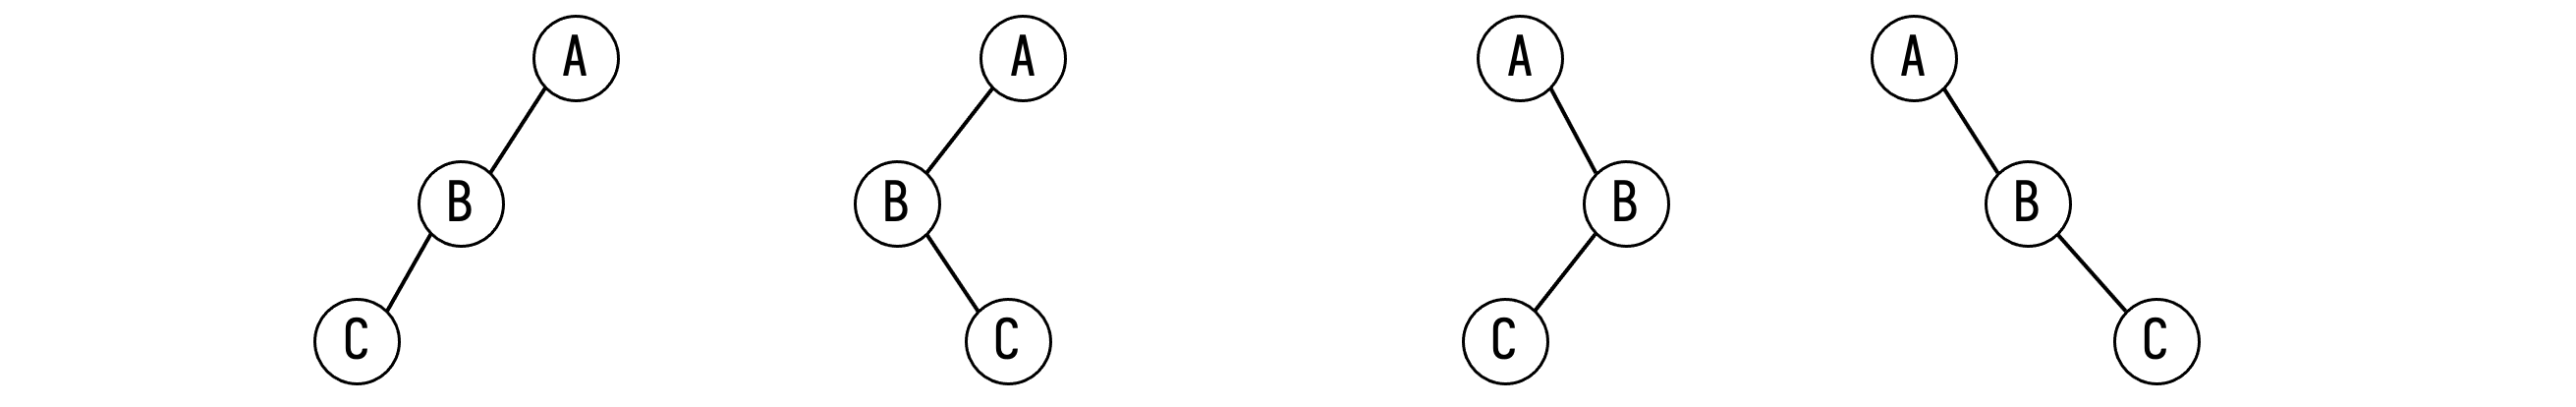
例题:P1229 遍历问题
已知一棵二叉树的前序遍历和后序遍历序列(每个字符为小写字母,且同一个遍历序列中的字母互不相同,即节点数不超过 26),求能够构成符合该前序与后序序列的可能的中序遍历序列的总数,即可能构成的二叉树形态总数。
在二叉树遍历中,前序遍历顺序为 [根节点] -> [左子树] -> [右子树],后序遍历顺序为 [左子树] -> [右子树] -> [根节点]。如果某个节点 \(u\) 同时拥有左子树和右子树,那么在前序和后序遍历中,左右子树的范围是可以通过递归对应切割开的。
然而,如果某个节点 \(u\) 只有一个子节点 \(v\):
- 若 \(v\) 为 \(u\) 的左子节点,前序遍历中 \(u\) 后面会紧跟着 \(v\),即 \(\dots, u, v, \dots\),后序遍历中 \(v\) 后面会紧跟着 \(u\),即 \(\dots, v, u, \dots\)。
- 若 \(v\) 为 \(u\) 的右子节点,前序遍历中 \(u\) 后面会紧跟着 \(v\),即 \(\dots, u, v, \dots\),后序遍历中 \(v\) 后面会紧跟着 \(u\),即 \(\dots, v, u, \dots\)。
可以发现,无论 \(v\) 是左子节点还是右子节点,其对应的前序遍历与后序遍历序列完全一致。
每个这样的“单传”节点(只有一个子节点的节点)都有 \(2\) 种可能性(可以将该子树挂在左边,也可以挂在右边),且各个单传节点的选择是彼此独立的。
因此,若整棵树中共有 \(k\) 个节点满足“只有一个子节点”,则可构成的不同二叉树形态数为 \(2^k\)。
如何快速在给定的前序与后序序列中找出这些只有一个子节点的父子关系 \((u,v)\)?
在前序遍历序列 \(\text{pre}\) 中,父节点 \(u\) 与子节点 \(v\) 必定相邻,存在下标 \(i\) 使得 \(\text{pre}_i = u\) 且 \(\text{pre}_{i+1}=v\)。在后序遍历序列 \(\text{post}\) 中,子节点 \(v\) 的访问必定恰好结束于父节点 \(u\) 之前,存在下标 \(j\) 使得 \(\text{post}_{j} = v\) 且 \(\text{post}_{j+1} = u\)。
因此,只需要寻找满足 \(\text{pre}_{i} = \text{post}_{j+1}\) 且 \(\text{pre}_{i+1} = \text{post}_j\) 的下标对 \((i,j)\)。每找到一组这样的字符组合,就说明有一个节点只有一个子节点,对应最终答案乘以 \(2\)。
参考代码
#include <iostream>
#include <string>
using namespace std;
using ll = long long;
int main()
{
    string pre, post;
    cin >> pre >> post;
    int n = pre.length();
    ll ans = 1;
    // 遍历前序与后序序列,寻找满足条件的父子关系 (u, v)
    for (int i = 0; i < n - 1; i++) {
        for (int j = 0; j < n - 1; j++) {
            // pre[i] 为父节点 u,pre[i + 1] 为单子节点 v
            // post[j] 为单子节点 v,post[j + 1] 为父节点 u
            if (pre[i + 1] == post[j] && pre[i] == post[j + 1]) {
                ans *= 2;
            }
        }
    }
    cout << ans << "\n";
    return 0;
}
双重循环遍历前序和后序字符串,循环次数为 \((n-1) \times (n-1)\),因此总时间复杂度为 \(O(n^2)\)。
从二叉树到多叉树
多叉树和二叉树最大的不同在于,它的每个节点可以有任意数量的子节点。标准库中的 std::vector 是一个动态数组,可以根据需要增长,这使得它成为存储数量不定的子节点的理想工具。
最常用和最高效的方法是邻接表示法。
- 给节点编号:首先,给树上的每个节点一个唯一的整数 ID,例如从 \(0\) 到 \(n-1\) 或者 \(1\) 到 \(n\)。
- 建立邻接表:创建一个
vector的vector,即vector<vector<int>> tree。 - 存储关系:
tree[i]本身是一个vector,里面存储了所有以节点 \(i\) 为父节点的子节点的 ID。
例如,tree[u] = {v1, v2, v3} 就表示节点 u 有三个子节点,分别是 v1,v2 和 v3。
这种方法的优点是:
- 空间高效:只存储存在的边(父子关系),总空间复杂度为 \(O(n)\),其中 \(n\) 是节点数。
- 实现简单:很容易添加一条边(即一个父子关系)。
- 遍历方便:很容易找到一个节点的所有子节点,只需遍历对应的
vector即可。
假设有这样一棵树,节点 1 的子节点是 2, 3, 4,节点 2 的子节点是 5,节点 4 的子节点是 6 和 7。结构如下:
   1
 / | \
2  3  4
|    / \
5   6   7
#include <iostream>
#include <vector>
using namespace std;

// 使用邻接表示法存储树
// tree[u] 是一个 vector,存储了节点 u 的所有子节点
vector<vector<int>> tree;

// 深度优先搜索 (DFS) 遍历树
// u: 当前遍历到的节点
// depth: 当前节点的深度(用于格式化输出)
void dfs(int u, int depth) {
	// 打印当前节点,并根据深度进行缩进
	for (int i = 0; i < depth; i++) {
		cout << " ";
	}
	cout << "node " << u << "\n";
	// 递归地访问所有子节点
	for (int child : tree[u]) {
		dfs(child, depth + 1);
	}
}
int main()
{
	// 假设有 7 个节点,编号从 1 到 7
	int n = 7;
	// 需要 n+1 的大小,因为节点编号从 1 开始
	tree.resize(n + 1);
	// 构建树的结构
	// 添加边来表示父子关系
	// tree[parent].push_back(child);
	// 节点 1 的子节点是 2, 3, 4
	tree[1].push_back(2);
	tree[1].push_back(3);
	tree[1].push_back(4);
	// 节点 2 的子节点是 5
	tree[2].push_back(5);
	// 节点 4 的子节点是 6, 7
	tree[4].push_back(6);
	tree[4].push_back(7);
	// 假设节点 1 是根节点
	int root = 1;
	cout << "Start from the root node " << root << " and perform DFS traveral\n";
	// 从根节点开始遍历
	dfs(root, 0);
	return 0;
}
代码讲解
vector<vector<int>> tree;:这是核心数据结构,tree是一个vector,它的每个元素是另一个vector<int>。tree[i]就代表了节点i的子节点列表。tree.resize(n + 1);:调整tree的大小以容纳所有节点,因为节点的编号从 1 开始,所以需要n+1的空间(索引 0 将被闲置)。tree[parent].push_back(child);:这是添加父子关系的关键,例如tree[1].push_back(2);表示“节点 2 是节点 1 的一个子节点”。dfs(int u, int depth):这是一个标准的深度优先搜索函数,用于演示如何使用建立起来的树结构。- 它首先处理当前节点
u。 - 然后,它通过
for (int child : tree[u])循环遍历u的所有子节点。 - 对每个子节点,它递归调用
dfs,从而深入到树的下一层。
- 它首先处理当前节点
当遇到以下情况时,通常需要在建树时建立双向边:题目只给出 \(n-1\) 条边,每条边用 \(u\) 和 \(v\) 表示两者之间有一条边。此时,由于在输入时无法确定谁是树上深度更深/浅的那个,必须建立双向边。如果只建单向边 \(u \rightarrow v\),万一实际遍历过程中 \(v\) 离根节点更近,由于没有构建 \(v \rightarrow u\) 这条边,使得遍历过程不正确。
处理方式
// 读入 u, v
tree[u].push_back(v);
tree[v].push_back(u); // 关键:建立反向边
遍历时的注意事项:因为建立了双向边,在进行深度优先搜索(DFS)或广度优先搜索(BFS)时,当从节点 \(p\) 走到节点 \(u\),必须防止立即从 \(u\) 又走回 \(p\)。所以,遍历函数通常需要多一个参数来记录父节点。
void dfs(int u, int parent) {
	// ... 对 u 进行操作 ...

	for (int v : tree[u]) {
		if (v == parent) { // 如果邻居是来的地方,就跳过
			continue;
		}
		dfs(v, u); // 递归下去,此时 u 是 v 的父节点
	}
}

// 调用时,根节点的父节点可以设为一个不存在的节点,如 0 或 -1
// dfs(root, 0);
习题:P5908 猫猫和企鹅
参考代码
#include <cstdio>
#include <vector>
using namespace std;
const int N = 100005;
// 使用邻接表来存储树的结构
// tree[i] 是一个动态数组,存储所有与节点i直接相连的节点
vector<vector<int>> tree;
// n: 居住区数量, d: 猫猫愿意走的最大距离, ans: 最终答案(可以拜访的企鹅数量)
int n, d, ans;
/**
 * @brief 深度优先搜索函数
 *
 * @param cur 当前正在访问的节点
 * @param fa  当前节点的父节点(防止向回走)
 * @param dis 当前节点到根节点1的距离
 */
void dfs(int cur, int fa, int dis) {
    // 如果当前节点的距离已经达到了d
    // 那么它的所有子节点的距离都将大于d,无需继续向下探索
	if (dis == d) return;
    // 遍历当前节点的所有邻居
	for (int to : tree[cur]) {
        // 如果邻居节点就是父节点,则跳过,避免走回头路
		if (to == fa) continue;
        // 如果邻居节点不是父节点,说明它是一个可以访问的子节点
        // 猫猫可以拜访住在这个子节点的小企鹅,所以答案加一
		ans++;
        // 递归地访问这个子节点
        // 子节点地父节点是当前节点(cur),距离是当前距离加一(dis + 1)
		dfs(to, cur, dis + 1);
	}
}
int main()
{
    // 读取节点数n和最大距离d
	scanf("%d%d", &n, &d);
    tree.resize(n + 1);
    // 循环n-1次,读取所有的道路信息,构建邻接表
	for (int i = 1; i < n; i++) {
		int u, v; scanf("%d%d", &u, &v);
        // 因为道路输入时不知道哪个节点深度大,所以要在两个节点的邻接表中都添加对方
		tree[u].push_back(v);
		tree[v].push_back(u);
	}
    // 从根节点1开始进行深度优先搜索
    // 初始状态:当前节点为1,父节点为0(一个不存在的节点),到根的距离为0
	dfs(1, 0, 0);
    // 输出最终统计的数量
	printf("%d\n", ans);
	return 0;
}
假设有 5 个节点,边是:(1, 2),(1, 3),(2, 4),(2, 5)。这棵树可以画成很多样子,但它们的结构本质上是一样的。
      1          2          4
     / \        /|\         |
    2   3      4 1 5        2
   / \           |         / \
  4   5          3        1   5
                          |
                          3
// 以上三种画法描述的是同一个结构
如果一棵树不指定根节点,那么所有节点在结构上都是平等的,没有哪个节点天生就是“根”。边 \((u,v)\) 只表示 \(u\) 和 \(v\) 是相邻的,没有 \(u\) 是 \(v\) 的父亲或孩子这种说法,这样的树称为无根树。
既然无根树里所有节点都“平等”,那么该如何下手呢?处理无根树的方法往往是:任选一个点作为根节点,将其“变成”一棵有根树。
这个过程就像把一张平铺的地图上的某个城市“拎起来”,其他城市因为重力自然下垂,形成了层次分明的结构。
当树的边带有属性(例如权重、长度、颜色、费用等)时,之前用的 vector<vector<int>> 就不够了,因为它只能存储“连接到哪个节点”,无法存储“这条连接的属性是什么”。
可以使用结构体扩展数据结构。
- 定义一个
Edge结构体,用来封装一条边的所有信息:它指向哪个节点(to),以及它的各种属性(如weight)。 - 邻接表从
vector<vector<int>>升级为vector<vector<Edge>>。 tree[u]现在是一个存储Edge对象的vector,其中每个Edge对象都描述了从u出发的一条边。
假设要解决一个问题:在一棵带权树上,求根节点到所有其他节点的距离。
#include <iostream>
#include <vector>
using namespace std;
using ll = long long;
// 1. 定义 Edge 结构体
struct Edge {
    int to;     // 这条边指向的节点
    int weight; // 这条边的权重
};
int n;
// 2. 邻接表存储 Edge 结构体
vector<vector<Edge>> tree;
// 用于存储根节点到各点距离的数组
vector<ll> dist;
// DFS 遍历带权树
// u:当前节点
// p:父节点(用于防止走回头路)
// current_dist:从根节点到 u 的距离
void dfs(int u, int p, ll current_dist) {
    dist[u] = current_dist;
    // 3. 遍历邻接表时,取出的元素是 Edge 对象
    for (const Edge& edge : tree[u]) {
        int v = edge.to;
        int w = edge.weight;
        if (v == p) {
            continue;
        }
        // 递归到子节点,并累加上这条边的权重
        dfs(v, u, current_dist + w);
    }
}
int main()
{
    cout << "Please input the number of nodes:";
    cin >> n;
    tree.resize(n + 1);
    dist.resize(n + 1);
    cout << "\nPlease input " << n - 1 << " edges (u v weight)\n";
    for (int i = 0; i < n - 1; i++) {
        int u, v, w;
        cin >> u >> v >> w;
        // 建立双向带权边
        tree[u].push_back({v, w});
        tree[v].push_back({u, w});
    }
    int root = 1; // 假设 1 是根节点
    dfs(root, 0, 0);
    cout << "From the root node " << root << " to other nodes\n";
    for (int i = 1; i <= n; i++) {
        cout << "The distance to node " << i << " is " << dist[i] << "\n";
    }
    return 0;
}
习题:P6111 [USACO18JAN] MooTube S
解题思路
题目要求找到所有与视频 \(v\) 的“相关性”至少为 \(k\) 的其他视频。两个视频的相关性是它们之间路径上所有边相关性的最小值。因此,这等价于从 \(v\) 到其他点的路径上,每一条边的相关性都必须大于等于 \(k\)。
对于一个查询 \((k, v)\),可以想象只保留原树中那些相关性大于等于 \(k\) 的边能走,而暂时忽略所有小于 \(k\) 的边。以 \(v\) 为根节点遍历整棵树时,当某条边相关性不足 \(k\) 时,这条边就相当于无法通行,在这个条件下统计一共经过多少个其他节点即可。
参考代码
#include <cstdio>
#include <vector>
using namespace std;
// 边的结构体,包含目标节点和相关性值
struct Edge {
    int to, r; // to:边的另一个端点,r:相关性
};
// 使用邻接表存储树的结构
vector<vector<Edge>> tree;
/**
 * @brief 深度优先搜索
 *
 * @param u    当前正在访问的视频节点
 * @param p    当前节点的父节点(用于防止DFS走回头路)
 * @param k    本次查询的相关性阈值k
 * @return int 从节点u出发,在只能走相关性>=k的边的情况下, 能访问到的节点总数(包括u自身)
 */
int dfs(int u, int p, int k) {
    // 初始化结果为1,代表计数当前节点u
    int res = 1;
    // 遍历与当前节点u相连的所有边
    for (const Edge& edge : tree[u]) {
        int v = edge.to;
        int r = edge.r; // 这条边的相关性
        // 过滤条件:
        // 1. v == p 不走回头路
        // 2. r < k 不走相关性小于阈值k的边
        if (v == p || r < k) continue;
        // 如果可以通过这条边,则递归地访问子节点v
        // 并将子树返回的节点数累加到结果中
        res += dfs(v, u, k);
    }
    // 返回符合条件的数量
    return res;
}
// 处理单次查询的函数
void solve() {
    int k, v; scanf("%d%d", &k, &v);
    // 减1是因为求的是“其他”相关视频的数量
    printf("%d\n", dfs(v, 0, k) - 1);
}
int main()
{
    int n, q;
    scanf("%d%d", &n, &q); // 读取视频数和查询数
    tree.resize(n + 1); // 调整邻接表大小
    for (int i = 1; i < n; i++) {
        int x, y, z;
        scanf("%d%d%d", &x, &y, &z);
        // 由于是无根树,需要在两个节点的邻接表中都添加这条边
        tree[x].push_back({y, z});
        tree[y].push_back({x, z});
    }
    // 循环处理q次查询
    for (int i = 1; i <= q; i++) {
        solve();
    }
    return 0;
}

 浙公网安备 33010602011771号