
递归与分治
递归
递归:直接或间接(A:这件事找 B;B:这件事找 A)地用到自己。
如何定义正整数?正整数是 \(1,2,3,\cdots\) 这些数。这个定义不是那么的“严密”,换一种方式:
- \(1\) 是正整数
- 如果 \(n\) 是正整数,\(n+1\) 也是正整数
这种定义就是递归式的:在“正整数”还没有定义时,就用到了“正整数”的定义。递归式定义能让定义简洁而严密。
例题:P5739 [深基7.例7] 计算阶乘
解题思路
原来学过循环求解,用一个 for 循环,就可以完成递推了。
参考代码
#include <cstdio>
int main()
{
    int n; scanf("%d", &n);
    int ans = 1;
    for (int i = 1; i <= n; i++) ans *= i;
    printf("%d\n", ans);
    return 0;
}
数学函数也可以递归定义,阶乘函数 \(f(n)=n!\) 可以定义为:
\( \ f(n) = \begin{cases} 1 & \quad n=0 \\ f(n-1) \times n, &\quad n \ge 1\\ \end{cases} \ \)
参考代码
#include <cstdio>
int f(int n) {
    return n == 0 ? 1 : f(n - 1) * n;
}
int main()
{
    int n; scanf("%d", &n);
    printf("%d\n", f(n));
    return 0;
}
要注意:一定要有个递归边界,要不然就无限递归了,另外递归过程中每一层的变量(包括参数)是独立的,互不影响。
例题:P5743 【深基7.习8】猴子吃桃
解题思路
可以循环递推,设 \(f_i\) 表示第 \(i\) 天时还剩多少桃子,则有 \(f_n = 1\),\(f_i = (f_{i+1} + 1) \times 2\),倒序循环即可,答案为 \(f_1\)。
也可以正着递推,设 \(f_i\) 表示在倒数第几天(或者说还剩几天)的时候还剩多少桃子,则有 \(f_1 = 1\),\(f_i = (f_{i-1} + 1) \times 2\),最后答案就是 \(f_n\)。
当然,这两种递推方式也可以写成递归形式,类似于上一题。
参考代码1
#include <cstdio>
int n;
int calc(int x) {
    if (x == n) return 1;
    return 2 * (calc(x + 1) + 1);
}
int main()
{
    scanf("%d", &n);
    printf("%d\n", calc(1));
    return 0;
}
参考代码2
#include <cstdio>
int calc(int x) {
    if (x == 1) return 1;
    return 2 * (calc(x - 1) + 1);
}
int main()
{
    int n;
    scanf("%d", &n);
    printf("%d\n", calc(n));
    return 0;
}
习题:B2142 求 1+2+3+...+N 的值
解题思路
与阶乘类似,\(1+2+ \cdots + n = (1 + 2 + \cdots + (n-1)) + n\),因而若 \(f(n)\) 表示累加函数,则对于 \(n>0\) 时有 \(f(n)=f(n-1)+n\)。
#include <cstdio>
int f(int n) {
    return n == 0 ? 0 : f(n - 1) + n;
}
int main()
{
    int n; scanf("%d", &n);
    printf("%d\n", f(n));
    return 0;
}
选择题:ack 函数在输入参数 m = 2, n = 2 时的返回值为?
unsigned ack(unsigned m, unsigned n) {
    if (m == 0) return n + 1;
    if (n == 0) return ack(m - 1, 1);
    return ack(m - 1, ack(m, n - 1));
}
- A. 5
- B. 7
- C. 9
- D. 13
答案
这是一个经典的递归函数——阿克曼函数。
ack(2, 2) = ack(1, ack(2, 1))
现在,需要计算内层的 ack(2, 1) = ack(1, ack(2, 0))
接下来,计算更内层的 ack(2, 0) = ack(1, 1)
继续计算 ack(1, 1) = ack(0, ack(1, 0))
继续计算 ack(1, 0) = ack(0, 1) = 1 + 1 = 2
开始将结果代回,ack(1, 1) = ack(0, ack(1, 0)) = ack(0, 2) = 2 + 1 = 3
所以有 ack(2, 0) = ack(1, 1) = 3
接下来计算 ack(1, 3) = ack(0, ack(1, 2)),ack(1, 2) = ack(0, ack(1, 1)) = ack(0, 3) = 3 + 1 = 4,所以 ack(1, 3) = ack(0, 4) = 4 + 1 = 5
所以有 ack(2, 1) = ack(1, 3) = 5
最后计算 ack(1, 5) = ack(0, ack(1, 4)),ack(1, 4) 等于 ack(0, ack(1, 3)),已经计算出 ack(1, 3) = 5,所以 ack(1, 4) = ack(0, 5) = 5 + 1 = 6
将 ack(1, 4) = 6 代回,ack(1, 5) 等于 ack(0, 6) = 6 + 1 = 7
B
递归与递推
对于前面的问题,用递归和递推都解决了,那么两者有什么区别?
运行下面两份代码,输入 \(40\),比较运行效率:
#include <cstdio>
int f[45];
int main()
{
	int n; scanf("%d", &n);
	f[1] = 1; f[2] = 1;
	for (int i = 3; i <= n; i++) f[i] = f[i - 1] + f[i - 2];
	printf("%d\n", f[n]);
	return 0;
}
循环递推,时间复杂度 \(O(n)\)。
#include <cstdio>
int f(int x) {
	if (x <= 2) return 1;
	return f(x - 1) + f(x - 2);
}
int main()
{
	int n; scanf("%d", &n);
	printf("%d\n", f(n));
	return 0;
}
递归,时间复杂度 \(O(fib(n))\),同一项会多次计算,每次都递归到 f(1) 或 f(2) 返回。
要提升递归的效率,可以使用记忆化(用数组标记每一项是否已经算出,已经算出就直接返回)的方法,不过一定要确定真的不需要重复计算才行。
#include <cstdio>
int ans[45];
bool vis[45];
int f(int x) {
	if (x <= 2) return 1;
	if (vis[x]) return ans[x];
	vis[x] = true;
	return ans[x] = f(x - 1) + f(x - 2);
}
int main()
{
	int n; scanf("%d", &n);
	printf("%d\n", f(n));
	return 0;
}
时间复杂度 \(O(n)\),每项只算一次,算每项时是 \(O(1)\) 的。
通常建议简单递推式使用循环递推实现。
使用递归往往适用于如下情况:
- 难以找到循环的合适顺序时(递推式中出现的下标可能变大也可能变小)
- 从要求的第 \(n\) 项出发,有用的项很少(比如 \(f_n = f_{n/2} + f_{n/3}\))
选择题:斐波那契数列的定义为:\(F_1 = 1\),\(F_2 = 1\),\(F_n = F_{n-1} + F_{n-2} (n \ge 3)\)。现在用如下程序来计算斐波那契数列的第 \(n\) 项,其时间复杂度为?
F(n):
    if n<=2 return 1
    else return F(n-1) + F(n-2)
- A. \(O(n)\)
- B. \(O(n^2)\)
- C. \(O(2^n)\)
- D. \(O(n \log n)\)
答案
C。
令 \(T(n)\) 表示计算 \(F(n)\) 所需的时间。根据代码 return F(n-1) + F(n-2),为了计算 F(n),程序需要先计算 F(n-1) 和 F(n-2),然后将它们相加。因此,\(T(n)\) 可以表示为 \(T(n) = T(n-1) + T(n-2) + O(1)\),其中 \(O(1)\) 代表加法操作的常数时间。这个递推关系与斐波那契数列本身的定义非常相似。
对于 \(T(n) = T(n-1) + T(n-2)\) 而言,可以进行估算:
- 上限:\(T(n) \lt 2 T(n-1) \lt 4 T(n-2) \lt \cdots \lt 2^n T(0)\),所以 \(T(n)\) 的一个上限是 \(O(2^n)\)。
- 下限:\(T(n) \gt 2 T(n-2) \gt 4 T(n-4) \gt \cdots \gt 2^{n/2} T(0)\),所以 \(T(n)\) 的一个下限是 \(O(2^{n/2})\)。
实际上,这个更紧的界大约是 \(O(1.618^n)\),其中 1.618 是黄金分割数。
在实际编程时,如果使用递推计算或是记忆化的方法,其时间复杂度可以优化到 \(O(n)\)。
例题:P1464 Function
解题思路
使用记忆化的方法就可以避免超时了,有效状态数是 \(20 \times 20 \times 20\) 级别,计算加法的时间复杂度是 \(O(1)\),算下来只需要做 \(8000\) 这个量级的计算量,完全不用担心超时。
不过需要注意当 \(a \le 0\) 或 \(b \le 0\) 或 \(c \le 0\) 或 \(a>20\) 或 \(b>20\) 或 \(c>20\) 时可以不把答案记进数组,避免数组访问越界。
参考代码
#include <cstdio>
using ll = long long;
const int N = 25;
bool vis[N][N][N]; // 记录某状态是否被计算过
ll ans[N][N][N]; // 记录某状态下的计算结果
ll w(ll a, ll b, ll c) {
    if (a <= 0 || b <= 0 || c <= 0) return 1;
    if (a > 20 || b > 20 || c > 20) return w(20, 20, 20);
    if (vis[a][b][c]) return ans[a][b][c]; // 如果曾经计算过可以直接返回存下来的结果
    // 需要展开计算则在计算完成后更新相应状态及计算结果
    if (a < b && b < c) {
        ans[a][b][c] = w(a, b, c-1) + w(a, b-1, c-1) - w(a, b-1, c);
        vis[a][b][c] = true;
        return ans[a][b][c];
    }
    ans[a][b][c] = w(a-1, b, c) + w(a-1, b-1, c) + w(a-1, b, c-1) - w(a-1, b-1, c-1);
    vis[a][b][c] = true;
    return ans[a][b][c];
}
int main()
{
    while (true) {
        ll a, b, c; scanf("%lld%lld%lld", &a, &b, &c);
        if (a == -1 && b == -1 && c == -1) break;
        printf("w(%lld, %lld, %lld) = %lld\n", a, b, c, w(a, b, c));
    }
    return 0;
}
例题:P1028 [NOIP 2001 普及组] 数的计算
解题思路
可以定义一个函数 int f(int n) 表示当最后一个拼上的数是 \(n\) 的时候,最终能生成多少个数列。
在计算时,首先设答案(返回值)是 \(1\)(表示第一种情况),然后循环枚举拼接的数 \(i\)(需满足 \(2i \le x\)),把 f(i) 的结果加进当前返回值,循环结束后返回结果。
为了保证不重复计算,需要加上记忆化。
一共 \(n\) 项要算,算一项的时候有 \(n/2\) 次循环,所以时间复杂度为 \(O(n^2)\)。
参考代码
#include <cstdio>
const int N = 1005;
int f[N];
int solve(int n) {
    if (n == 1) return 1;
    if (f[n] != 0) return f[n];
    int res = 1;
    for (int i = 1; i * 2 <= n; i++) res += solve(i);
    return f[n] = res;
}
int main()
{
    int n; scanf("%d", &n);
    printf("%d\n", solve(n));
    return 0;
}
习题:P1010 [NOIP 1998 普及组] 幂次方
解题思路
任何正整数都可以唯一地表示为二进制形式,即若干个 \(2\) 的幂次之和。可以通过检查 \(n\) 的二进制位,从高位到低位,若第 \(i\) 位为 \(1\),则说明分解式中包含 \(2^i\) 这一项。
题目要求的格式具有明显的递归性质:
- 对于 \(2^i\) 这一项,如果 \(i=0\) 或 \(i=1\),有特定的表示法。
- 如果 \(i \gt 1\),则 \(i\) 需要再次被分解并按照同样的规则输出。
这意味着可以定义一个递归函数 solve(n) 来处理。
参考代码
#include <cstdio>

// 递归函数 solve 用于将整数 n 分解为 2 的幂次表示形式
void solve(int n) {
    bool first = true; // 标记当前层级是否是第一个输出的项,用于控制 '+' 号的打印

    // 从高位向低位遍历二进制位。n 最大为 2*10^4,2^14 = 16384,2^15 = 32768,所以从 14 开始即可。
    for (int i = 14; i >= 0; i--) {
        // 检查第 i 位是否为 1 (即 2^i 是否存在于分解中)
        if ((n >> i) & 1) {
            // 如果不是第一个项,则在前边加一个 '+'
            if (!first) printf("+");
            first = false;

            // 处理不同的指数 i 的情况
            if (i == 0) {
                // 根据约定,2^0 表示为 2(0)
                printf("2(0)");
            } else if (i == 1) {
                // 根据约定,2^1 表示为 2
                printf("2");
            } else {
                // 对于 i > 1 的情况,表示为 2(i的分解形式)
                printf("2(");
                solve(i); // 递归分解指数 i
                printf(")");
            }
        }
    }
}

int main()
{
    int n;
    // 读取输入的正整数
    scanf("%d", &n);
    solve(n);
    return 0;
}
习题:P10458 Fractal
解题思路
度为 \(n\) 的分形边长为 \(3^{n-1}\),其图形可以看作是在一个 \(3 \times 3\) 的大网格中,在左上、右上、中间、左下、右下这 5 个位置分别填充一个度为 \(n-1\) 的图形,其余位置为空白。
这非常适合使用递归来解决,可以定义一个函数 draw(n, x, y),表示在画布的 \((x,y)\) 坐标处开始绘制一个度为 \(n\) 的分形。
参考代码
#include <cstdio>

// 当 n=7 时,边长为 3^6 = 729
const int S = 735;

int p[7];       // 存储 3 的幂次,p[i] = 3^i
char g[S][S];   // 二维字符数组作为画布

// 递归绘图函数
// n: 当前分形的度数
// x, y: 当前分形在画布上的左上角坐标
void draw(int n, int x, int y) {
    // 递归基:度为 1 时,画一个 'X'
    if (n == 1) {
        g[x][y] = 'X';
        return;
    }

    // 计算下一级分形的边长
    // 度为 n 的分形由 5 个 度为 n-1 的分形组成
    // 度为 n-1 的分形边长为 3^(n-2),即 p[n-2]
    int s = p[n - 2];

    // 根据盒子分形的定义,在 3x3 的网格位置中绘制 5 个子分形:
    // 网格布局示意:
    // [B] [ ] [B]
    // [ ] [B] [ ]
    // [B] [ ] [B]

    // 1. 左上角
    draw(n - 1, x, y);
    // 2. 右上角 (列坐标偏移 2*s)
    draw(n - 1, x, y + 2 * s);
    // 3. 中间 (行、列坐标各偏移 s)
    draw(n - 1, x + s, y + s);
    // 4. 左下角 (行坐标偏移 2*s)
    draw(n - 1, x + 2 * s, y);
    // 5. 右下角 (行、列坐标各偏移 2*s)
    draw(n - 1, x + 2 * s, y + 2 * s);
}

int main()
{
    // 预处理 3 的幂次
    p[0] = 1;
    for (int i = 1; i <= 6; i++) p[i] = p[i - 1] * 3;

    while (true) {
        int n;
        scanf("%d", &n);
        if (n == -1) break; // 输入 -1 表示结束

        // 计算当前度数 n 对应的图形总边长 len = 3^(n-1)
        int len = p[n - 1];

        // 初始化画布,全部填充为空格
        for (int i = 0; i < len; i++) {
            for (int j = 0; j < len; j++) {
                g[i][j] = ' ';
            }
        }

        // 从坐标 (0, 0) 开始递归绘制
        draw(n, 0, 0);

        // 输出生成的图形
        for (int i = 0; i < len; i++) {
            for (int j = 0; j < len; j++) {
                printf("%c", g[i][j]);
            }
            printf("\n");
        }
        // 每个测试用例后输出一个分隔行
        printf("-\n");
    }
    return 0;
}
例题:P1928 外星密码
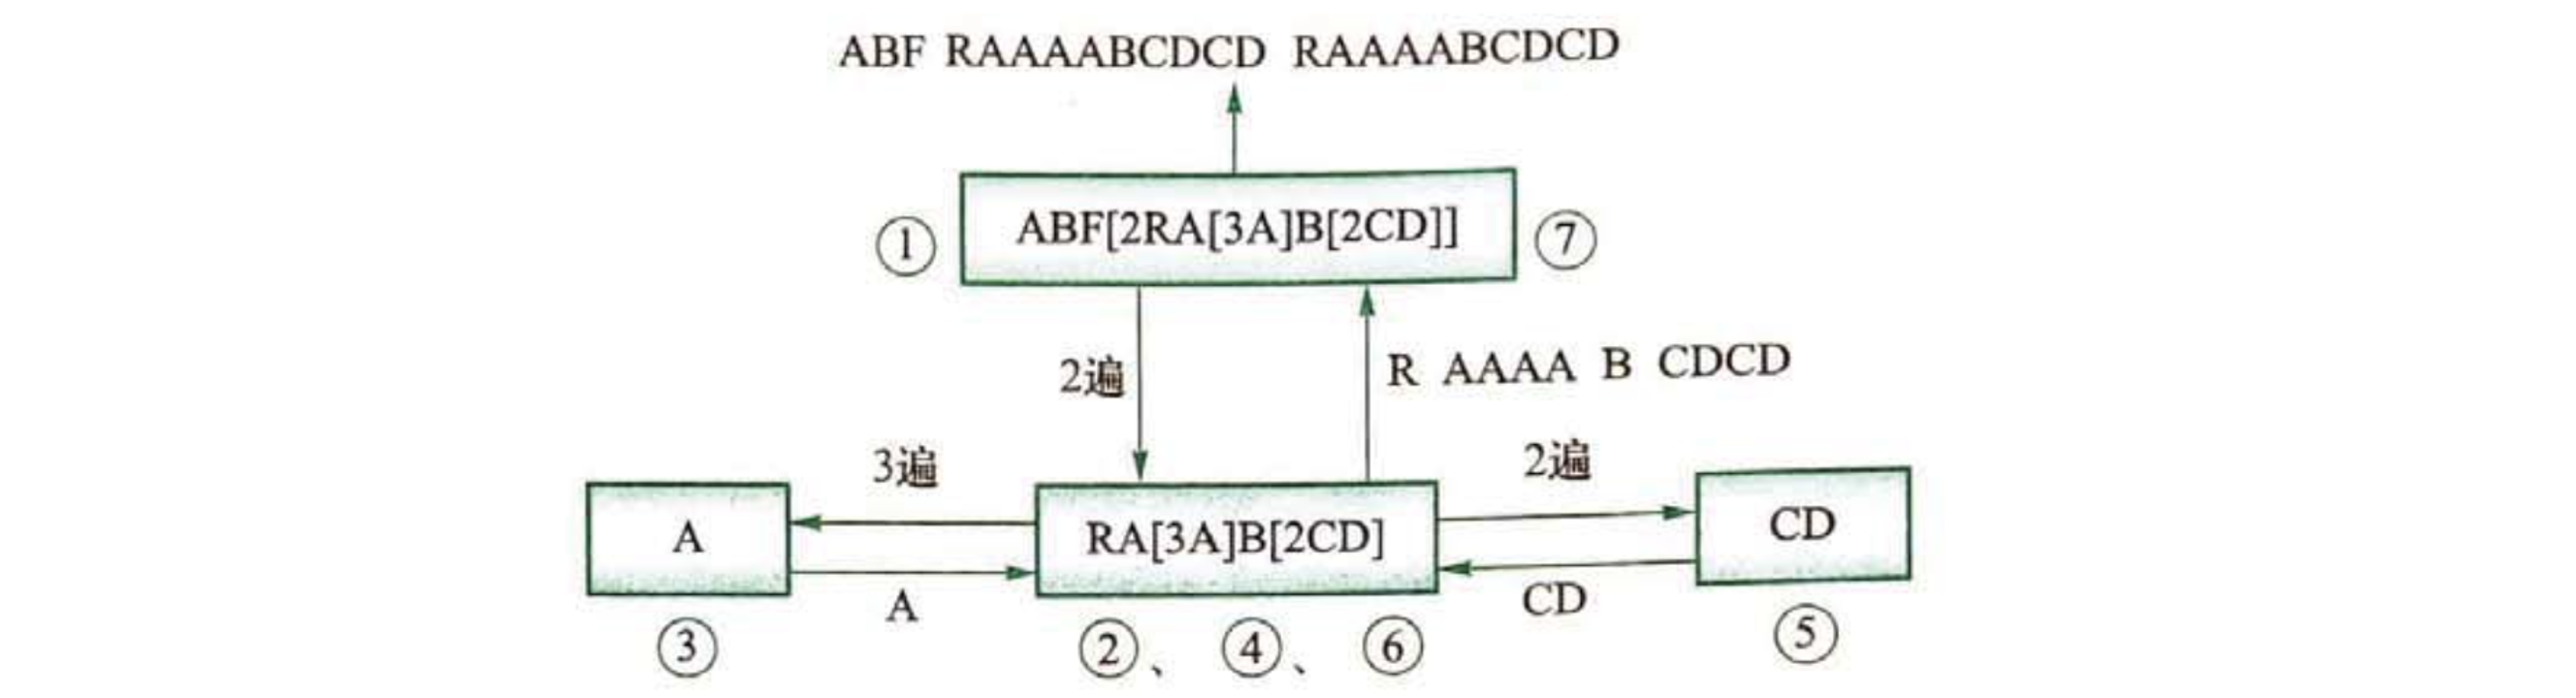
分析:如果只有一层方括号,那么只需要找到方括号,就可以提取出重复次数,然后将重复部分按次数复制若干份拼接起来即可。如果方括号的“重复部分”里还有方括号呢?用同样的方式展开即可。可以发现,这个机制和递归非常吻合,因此本题适合用递归的方式来实现。
参考代码
#include <cstdio>
#include <iostream>
#include <string>
#include <stack>
using namespace std;
const int N = 20005;
int match[N]; // match[i]代表code[i]为左括号时对应的右括号的下标
/**
 * @brief 递归解压缩函数
 * @param code 完整的原始密码字符串
 * @param l 当前要解压的子串的左边界(包含)
 * @param r 当前要解压的子串的右边界(不包含)
 * @return 解压后的字符串
 */
string decompress(string &code, int l, int r) {
    // 解压缩 code[l]~code[r-1]
    int i = l;
    int num = 0; // 用于累积当前层级的重复次数
    string res; // 用于存储当前层级解压出的基本字符串(重复前)
    // 遍历当前需要处理的子串 code[l...r-1]
    while (i < r) {
        if (code[i] == '[') {
            // 遇到左括号,说明有一个嵌套的压缩块
            // 递归调用 decompress 来处理这个内部块
            // 内部块的范围是 [i+1, match[i]-1]
            res += decompress(code, i + 1, match[i]);
            // 处理完内部块后,直接跳到右括号的下一个位置
            i = match[i] + 1;
        } else {
            // 处理非括号的字符
            if (code[i] >= '0' && code[i] <= '9') {
                // 如果是数字,累加到重复次数 num 中
                num = num * 10 + (code[i] - '0');
            } else {
                // 如果是字母,直接追加到结果字符串中
                res += code[i];
            }
            i++; // 继续处理下一个字符
        }
    }
    // 如果整个块内没有数字,则默认重复1次
    if (num == 0) num = 1;
    string ret; // 最终要返回的、重复后的字符串
    // 将解压出的基本字符串 res 重复 num 次
    for (int i = 1; i <= num; i++) ret += res;
    return ret;
}
int main()
{
    string code;
    cin >> code; // 读取完整的密码字符串
    // 预处理:使用栈来匹配所有的括号
    stack<int> s;
    for (int i = 0; i < code.size(); i++) {
        if (code[i] == '[') {
            // 遇到左括号,将其下标入栈
            s.push(i);
        } else if (code[i] == ']') {
            // 遇到右括号,栈顶的元素就是与之匹配的左括号的下标
            match[s.top()] = i;
            s.pop(); // 匹配完成,出栈
        }
    }
    // 调用递归函数,从整个字符串的范围 [0, code.size()) 开始解压
    cout << decompress(code, 0, code.size()) << "\n";
    return 0;
}
如果能将一个大的任务分解成若干规模较小的任务,而且这些任务的形式与结构和原问题一致,就可以考虑使用递归。当问题规模足够小或者达到了边界条件就要停止递归。分解完问题后还要将这些规模小的任务的处理结果合并,最后逐级上报,解决最大规模的问题。
递归与栈的关系
栈是一种“后进先出”的数据结构,而函数调用自身,会形成一个调用链。当递归到达最深层(基本情况)后,会开始逐层返回。这个“逐层返回”的顺序,正好与“逐层调用”的顺序相反。最后调用的函数最先返回,最先调用的函数最后返回。这种行为模式与栈的“后进先出”特性完全吻合。
函数调用栈
当在代码中调用一个函数时,操作系统会为这个函数在内存中创建一个“栈帧”(Stack Frame),这个栈帧被推入一个叫作“函数调用栈”(Call Stack)的特殊栈中。
这个栈帧里存储了关于这次函数调用的所有重要信息,包括:
- 函数的参数(Parameters)
- 函数的局部变量(Local Variables)
- 返回地址(Return Address):即函数执行完毕后,程序应该回到哪里继续执行。
联系与引申
栈溢出(Stack Overflow):如果递归没有正确的“基本情况”来终止,或者递归的深度太深,调用栈会持续增长,直到耗尽所有分配给它的内存空间,从而导致程序崩溃,这就是著名的“栈溢出”错误。
递归转迭代:任何一个递归算法,都可以被转换成一个非递归的、使用循环和显式栈(即自己创建和管理的栈数据结构)的等价算法。在某些情况下,这样做可以避免函数调用的开销,提高效率,或者避免栈溢出。
选择题:在程序运行过程中,如果递归调用的层数过多,可能会由于什么引发错误?
- A. 系统分配的栈空间溢出
- B. 系统分配的队列空间溢出
- C. 系统分配的链表空间溢出
- D. 系统分配的堆空间溢出
答案
A。
每次函数调用(包括递归调用)时,系统都会在内存的栈区域中为该次调用分配一块空间(称为“栈帧”),用于存储函数的参数、局部变量、返回地址等信息。当函数执行完毕返回时,这块空间会被释放。
如果递归调用的层次非常深,就会连续不断地在栈上分配空间,而没有机会释放。由于系统分配给程序的栈空间是有限的,当占用的栈空间超出了这个限制时,就会发生“栈溢出”错误,导致程序异常终止。
2024 CSP-S1 T3
在 C++ 中,以下哪个函数调用会造成栈溢出?
- A.
int foo() { return 0; } - B.
int bar() { int x = 1; return x; } - C.
void baz() { int a[1000]; baz(); } - D.
void qux() { return; }
答案
C。这个函数会导致栈溢出,原因有两个关键点:
- 无限递归:函数
baz()在没有设置任何终止条件的情况下直接调用了自身。 - 栈上分配:每次调用
baz()时,它都会在栈上创建一个包含 1000 个整数的数组a。
每次 baz() 调用自身,一个新的“栈帧”就会被推入调用栈。这个栈帧里包含了数组 a 所需的内存(在大多数系统中大约是 4KB 左右)以及函数的返回地址等信息。由于递归永不停止,调用栈会持续增长,直到耗尽所有分配给它的有限内存空间,最终导致程序因“栈溢出”错误而崩溃。
分治
如果想知道我国的人口数量,就需要进行人口普查。让每一个省份都去统计本省有多少人,然后将各省人口累加起来,就可以获得全国的人口数量。而要想知道某一个省的人口数量,可以让省里的每一个城市统计本市有多少人,然后将各市人口累加起来,就可以获得这个省的人口数量……以此类推,层层细分,最后统计一个村子或者一个小区有多少人,这个任务就足够简单了。把一个复杂的问题细分成若干结构相同但规模更小的子问题,然后将每个子问题的解合并起来,就得到了复杂问题的解,这就是分治策略。
2025 CSP-S1 T11
递归关系式 \(T(n)=2T(n/2)+O(n^2)\) 描述了某个分治算法的时间复杂度。请问该算法的时间复杂度是多少?
答案
为了便于推导,设本层合并开销为 \(f(n) = c \cdot n^2\),其中 \(c\) 为某个正常数,递归关系写为 \(T(n) = 2T(n/2) + c \cdot n^2\)。
- 第 \(0\) 层:规模为 \(n\),本层的处理开销为 \(W_0 = c \cdot n^2\)。
- 第 \(1\) 层:产生 \(2\) 个规模为 \(n/2\) 的子问题,每个子问题的开销为 \(c \cdot (n/2)^2 = \frac{1}{4} c \cdot n^2\),第 \(1\) 层的总开销为 \(W_1 = 2 \times \left(\frac{1}{4} c \cdot n^2\right) = \frac{1}{2} c \cdot n^2\)。
- 第 \(2\) 层:产生 \(4\) 个规模为 \(n/4\) 的子问题,每个子问题的开销为 \(c \cdot (n/4)^2 = \frac{1}{16} c \cdot n^2\),第 \(2\) 层的总开销为 \(W_2 = 4 \times \left(\frac{1}{16} c \cdot n^2\right) = \frac{1}{4} c \cdot n^2\)。
- 第 \(i\) 层(一般规律):共有 \(2^i\) 个子问题,问题规模为 \(n/2^i\),第 \(i\) 层的总开销为 \(W_i = 2^i \times c \cdot \left(\frac{n}{2^i}\right)^2 = \left(\frac{1}{2}\right)^i c \cdot n^2\)。
问题规模从 \(n\) 每次减半,直到缩小到 \(1\) 停止递归。设总深度为 \(k\),则有 \(\frac{n}{2^k} = 1 \implies k = \log_2 n\)。最后一层共有 \(2^k = 2^{\log_2 n} = n\) 个子问题,若每个子问题的常数开销为 \(O(1)\),则最后一层的总开销为 \(W_k = O(n)\)。
算法的总时间开销 \(T(n)\) 等于每一层开销总和 \(T(n) = W_k + \sum\limits_{i=0}^{\log_2 n - 1} W_i = O(n) + c \cdot n^2 \sum\limits_{i=0}^{\log_2 n - 1} \left(\frac{1}{2}\right)^i\),展开求和项,则有 \(T(n) = O(n) + c \cdot n^2 \left( 1 + \frac{1}{2} + \frac{1}{4} + \frac{1}{8} + \cdots + \left(\frac{1}{2}\right)^{\log_2 n - 1} \right)\)。括号内是一个首项为 \(1\)、公比 \(q = \frac{1}{2}\) 的有限等比数列,根据无穷递缩等比数列求和公式,当 \(q \lt 1\) 时,即使项数趋于无穷,其累加和也不会无限增长,而是收敛于一个有限常数 \(\sum\limits_{i=0}^{\infty} \left(\frac{1}{2}\right)^i = \frac{1}{1 - 1/2} = 2\)。这意味着括号内的求和结果恒小于 \(2\),\(T(n) \lt 2c \cdot n^2 + O(n)\)。随着 \(n\) 的增大,\(n^2\) 项增长速度远快于低阶项 \(O(n)\),因此整个算法的时间复杂度由最顶层的 \(O(n^2)\) 主导,即 \(T(n) = O(n^2)\)。
P5461 赦免战俘
#include <cstdio>
const int N = 1050;
int a[N][N];
// 左上角坐标(x,y),边长为len的正方形
void solve(int x, int y, int len) {
	// 先考虑边界条件
	if (len==1) {
		a[x][y]=1;
		return;
	}
	// 拆分问题
	// 左上角全为0(相当于不用处理)
	// 继续用同样的方式处理右上,左下,右下
	solve(x,y+len/2,len/2);
	solve(x+len/2,y,len/2);
	solve(x+len/2,y+len/2,len/2);
}
int main()
{
	int n; scanf("%d",&n);
	// n = (1<<n);
	int len=1;
	for (int i=1;i<=n;i++) len*=2;
	solve(1,1,len);
	for (int i=1;i<=len;i++) {
		for (int j=1;j<=len;j++) {
			printf("%d ",a[i][j]);
		}
		printf("\n");
	}
    return 0;
}
P1228 地毯填补问题
#include <cstdio>
int px, py;
int judge(int xx, int yy, int x, int y, int n) { // 判断残缺的块在哪个分区
    if (xx < x + n / 2) return yy < y + n / 2 ? 1 : 2; // 左上/右上
    return yy < y + n / 2 ? 3 : 4; // 左下/右下
}
void solve(int n, int x, int y, int miss, int xx, int yy) {
    if (n == 1) return;
    n = n / 2;
    if (miss == 1) {
        printf("%d %d %d\n", x + n, y + n, 1);
        solve(n, x, y, judge(xx, yy, x, y, n), xx, yy);
        solve(n, x, y + n, 3, x + n - 1, y + n);
        solve(n, x + n, y, 2, x + n, y + n - 1);
        solve(n, x + n, y + n, 1, x + n, y + n);
    } else if (miss == 2) {
        printf("%d %d %d\n", x + n, y + n - 1, 2);
        solve(n, x, y, 4, x + n - 1, y + n - 1);
        solve(n, x, y + n, judge(xx, yy, x, y + n, n), xx, yy);
        solve(n, x + n, y, 2, x + n, y + n - 1);
        solve(n, x + n, y + n, 1, x + n, y + n);
    } else if (miss == 3) {
        printf("%d %d %d\n", x + n - 1, y + n, 3);
        solve(n, x, y, 4, x + n - 1, y + n - 1);
        solve(n, x, y + n, 3, x + n - 1, y + n);
        solve(n, x + n, y, judge(xx, yy, x + n, y, n), xx, yy);
        solve(n, x + n, y + n, 1, x + n, y + n);
    } else {
        printf("%d %d %d\n", x + n - 1, y + n - 1, 4);
        solve(n, x, y, 4, x + n - 1, y + n - 1);
        solve(n, x, y + n, 3, x + n - 1, y + n);
        solve(n, x + n, y, 2, x + n, y + n - 1);
        solve(n, x + n, y + n, judge(xx, yy, x + n, y + n, n), xx, yy);
    }
}
int main()
{
    int k;
    scanf("%d%d%d", &k, &px, &py);
    int len = 1;
    for (int i = 1; i <= k; i++) len *= 2;
    solve(len, 1, 1, judge(px, py, 1, 1, len), px, py);
    return 0;
}
例题:P1115 最大子段和
要找到整个序列的最大子段和,可以将其一分为二,从中点 \(mid\) 分成左右两个子序列:\(a_{left \dots mid}\) 和 \(a_{mid+1 \dots right}\)。
此时,最大子段和可能存在于三个位置:
- 完全在左半部分:即 \(a_{left \dots mid}\) 内部。
- 完全在右半部分:即 \(a_{mid+1 \dots right}\) 内部。
- 跨越中点:这个子段既包含了左半部分的元素,也包含了右半部分的元素,并且一定跨过 \(mid\) 和 \(mid+1\)。
对于前两种情况,可以递归地求解来得到答案。递归的终止条件是当子序列只有一个元素时,最大子段和就是该元素自身的值。
对于第三种情况,即跨越中点的情况,无法直接通过递归得到。此时需要专门解决:
- 从 \(mid\) 开始向左遍历,找到一个以 \(mid\) 结尾的最大子段和。
- 从 \(mid+1\) 开始向右遍历,找到一个以 \(mid+1\) 开头的最大子段和。
- 将这两个和相加,就得到了跨越中点的最大子段和。
比较上述三种情况得出的三个值,取其中最大者,即为当前问题的最终解。
这个分治算法的递推关系式是 \(T(n) = 2T(n/2) + O(n) = O(n \log n)\)。
参考代码
#include <cstdio>
#include <algorithm>

using namespace std;

const int N = 2e5 + 5;

int a[N];

/**
 * @brief 计算跨越中点的最大子段和
 * @param left 区间左边界
 * @param mid 区间中点
 * @param right 区间右边界
 * @return 返回跨越中点的最大子段和
 * @note 这个函数的线性扫描是整个分治算法时间复杂度为 O(n log n) 的原因
 */
int maxCrossingSum(int left, int mid, int right) {
    int sum = 0;
    // 初始化左半部分的最大和为一个极小值,这里直接用 a[mid] 作为初始值
    int left_sum = a[mid];

    // 从中点 `mid` 开始向左遍历,寻找以 a[mid] 结尾的最大连续和
    for (int i = mid; i >= left; i--) {
        sum += a[i];
        if (sum > left_sum) {
            left_sum = sum;
        }
    }

    // 重置 sum,准备计算右半部分
    sum = 0;
    // 初始化右半部分的最大和
    int right_sum = a[mid + 1];

    // 从 `mid + 1` 开始向右遍历,寻找以 a[mid+1] 开头的最大连续和
    for (int i = mid + 1; i <= right; i++) {
        sum += a[i];
        if (sum > right_sum) {
            right_sum = sum;
        }
    }

    // 跨越中点的最大子段和等于左、右两部分最大和之和
    return left_sum + right_sum;
}

/**
 * @brief 使用分治法递归求解最大子段和
 * @param left 区间左边界
 * @param right 区间右边界
 * @return 返回 a[left...right] 区间的最大子段和
 */
int maxSubArraySum(int left, int right) {
    // 递归的终止条件:如果区间只有一个元素,最大子段和就是它本身
    if (left == right) {
        return a[left];
    }

    // --- 1. 分解 (Divide) ---
    int mid = left + (right - left) / 2;

    // --- 2. 解决 (Conquer) ---
    // 递归求解左半部分的最大子段和
    int left_max = maxSubArraySum(left, mid);
    // 递归求解右半部分的最大子段和
    int right_max = maxSubArraySum(mid + 1, right);
    // 求解跨越中点的最大子段和
    int cross_max = maxCrossingSum(left, mid, right);

    // --- 3. 合并 (Combine) ---
    // 返回三种情况中的最大值
    return std::max({left_max, right_max, cross_max});
}

int main() {
    int n;
    scanf("%d", &n);

    for (int i = 1; i <= n; i++) {
        scanf("%d", &a[i]);
    }

    printf("%d\n", maxSubArraySum(1, n));

    return 0;
}
这个算法可以进一步改进,使其时间复杂度达到 \(O(n)\)。算法思想仍然是“分治”,但通过在“合并”步骤中进行优化,避免了 \(O(n \log n)\) 解法中重复的线性扫描,从而达到了 \(O(n)\) 的效率。
之前的分治法在“合并”步骤需要 \(O(n)\) 时间来计算跨越中点的最大和,为了优化这一点,必须让“合并”操作在 \(O(1)\) 时间内完成。
如何做到呢?诀窍在于递归函数返回更多的信息,而不仅仅是“最大子段和”。
对于任意一个区间 \(a_{left \dots right}\),维护以下四个值:
max_sum:该区间的最大子段和(这是最终的答案)。prefix_sum:包含该区间最左侧元素 \(a_{left}\) 的最大子段和。suffix_sum:包含该区间最右侧元素 \(a_{right}\) 的最大子段和。total_sum:该区间所有元素的总和。
将这四个值封装在一个结构体里。
和之前一样,将区间 \(a_{left \dots right}\) 分为 \(a_{left \dots mid}\) 和 \(a_{mid+1 \dots right}\)。递归地调用函数,获取左右两个子区间的信息包(称之为 l 和 r)。
现在,利用 l 和 r 在 \(O(1)\) 的时间内计算出整个区间 \(a_{left \dots right}\) 的信息包 res。
- 显然,整体的总和是左右两边的总和相加。
res.total_sum = l.total_sum + r.total_sum。 - 整个区间的“最大前缀和”有两种可能,左半部分的“最大前缀和”,或者它跨越了中点,等于左半部分的“总和”加上右半部分的“最大前缀和”。取这两者的较大值:
res.prefix_sum = max(l.prefix_sum, l.total_sum + r.prefix_sum)。 - 与前缀和对称,整个区间的“最大后缀和”也有两种可能,右半部分的“最大后缀和”,或者它跨越了中点,等于右半部分的“总和”加上左半部分的“最大后缀和”。取这两者的较大值:
res.suffix_sum = max(r.suffix_sum, r.total_sum + l.suffix_sum)。 - 整个区间的“最大子段和”有三种可能:左半部分的“最大子段和”,右半部分的“最大子段和”,或者它跨越了中点,这个跨越中点的最大和,恰好等于左半部分的“最大后缀和”与右半部分的“最大前缀和”之和。取这三者的最大值:
res.max_sum = max({l.max_sum, r.max_sum, l.suffix_sum + r.prefix_sum})。
通过这种方式,每次合并都只需要几次简单的加法和比较,是 \(O(1)\) 操作。
递推关系式变为 \(T(n) = 2T(n/2) + O(1) = O(n)\)。
参考代码
#include <cstdio>
#include <algorithm>

using namespace std;

const int N = 2e5 + 5;

int a[N];

// 定义一个结构体来存储区间信息
struct SubArrayInfo {
    int max_sum;    // 区间最大子段和
    int prefix_sum; // 包含左边界的最大子段和
    int suffix_sum; // 包含右边界的最大子段和
    int total_sum;  // 区间总和
};

// 合并两个子区间信息的函数
SubArrayInfo pushUp(const SubArrayInfo& l, const SubArrayInfo& r) {
    SubArrayInfo res;
    // 计算总和
    res.total_sum = l.total_sum + r.total_sum;
    // 计算最大前缀和
    res.prefix_sum = max(l.prefix_sum, l.total_sum + r.prefix_sum);
    // 计算最大后缀和
    res.suffix_sum = max(r.suffix_sum, r.total_sum + l.suffix_sum);
    // 计算最大子段和
    int cross_max = l.suffix_sum + r.prefix_sum;
    res.max_sum = max({l.max_sum, r.max_sum, cross_max});
    return res;
}

// O(n) 分治法求解主函数
SubArrayInfo solve(int left, int right) {
    // 基本情况:区间只有一个元素
    if (left == right) {
        int val = a[left];
        return {val, val, val, val};
    }
    // 1. 分解
    int mid = left + (right - left) / 2;
    // 2. 解决
    SubArrayInfo left_info = solve(left, mid);
    SubArrayInfo right_info = solve(mid + 1, right);
    // 3. 合并
    return pushUp(left_info, right_info);
}

int main() {
    int n;
    scanf("%d", &n);

    for (int i = 1; i <= n; i++) {
        scanf("%d", &a[i]);
    }

    printf("%d\n", solve(1, n).max_sum);

    return 0;
}
阅读程序题
#include <algorithm>
#include <iostream>
using namespace std;

int n, a[1005];

struct Node
{
	int h, j, m, w;

	Node(const int _h, const int _j, const int _m, const int _w) :
		h(_h), j(_j), m(_m), w(_w)
	{ }

	Node operator+(const Node &o) const
	{
		return Node(
			max(h, w + o.h),
			max(max(j, o.j), m + o.h),
			max(m + o.w, o.m),
			w + o.w);
	}
};

Node solve1(int h, int m)
{
	if (h > m)
		return Node(-1, -1, -1, -1);
	if (h == m)
		return Node(max(a[h], 0), max(a[h], 0), max(a[h], 0), a[h]);
	int j = (h + m) >> 1;
	return solve1(h, j) + solve1(j + 1, m);
}

Node solve2(int h, int m)
{
	if (h > m)
		return -1;
	if (h == m)
		return max(a[h], 0);
	int j = (h + m) >> 1;
	int wh = 0, wm = 0;
	int wht = 0, wmt = 0;
	for (int i = j; i >= h; i--) {
		wht += a[i];
		wh = max(wh, wht);
	}
	for (int i = j + 1; i <= m; i++) {
		wmt += a[i];
		wm = max(wm, wmt);
	}
	return max(max(solve2(h, j), solve2(j + 1, m)), wh + wm);
}

int main()
{
	cin >> n;
	for (int i = 1; i <= n; i++) cin >> a[i];
	cout << solve1(1, n).j << endl;
	cout << solve2(1, n) << endl;
	return 0;
}
假设输入的所有数的绝对值都不超过 1000,完成下面的判断题和单选题:
判断题
-
程序总是会正常执行并输出两行两个相等的数。
-
第 28 行与第 38 行分别有可能执行两次及以上。
-
当输入为
5 -10 11 -9 5 -7时,输出的第二行为7。
单选题
solve1(1, n)的时间复杂度为?
- A. \(O(\log n)\)
- B. \(O(n)\)
- C. \(O(n \log n)\)
- D. \(O(n^2)\)
solve2(1, n)的时间复杂度为?
- A. \(O(\log n)\)
- B. \(O(n)\)
- C. \(O(n \log n)\)
- D. \(O(n^2)\)
- 当输入为
10 -3 2 10 0 -8 9 -4 -5 9 4时,输出的第一行为?
- A. 13
- B. 17
- C. 24
- D. 12
答案
代码分析
这段代码实现了两种分治算法(solve1 和 solve2)来求解同一个问题:最大子段和。
判断题
-
正确。
-
错误。当输入的 \(n\) 小于等于 0 时,第 28 行和第 38 行会被执行到,但最多执行一次。当 \(n\) 大于 0 时,这两行不会被执行到。
-
错误。该数据下最大子段和应该是 11。
单选题
-
B。
-
C。
-
B。\(2+10+0+(-8)+9+(-4)+(-5)+9+4=17\)。

 浙公网安备 33010602011771号