
图论基础
流程图
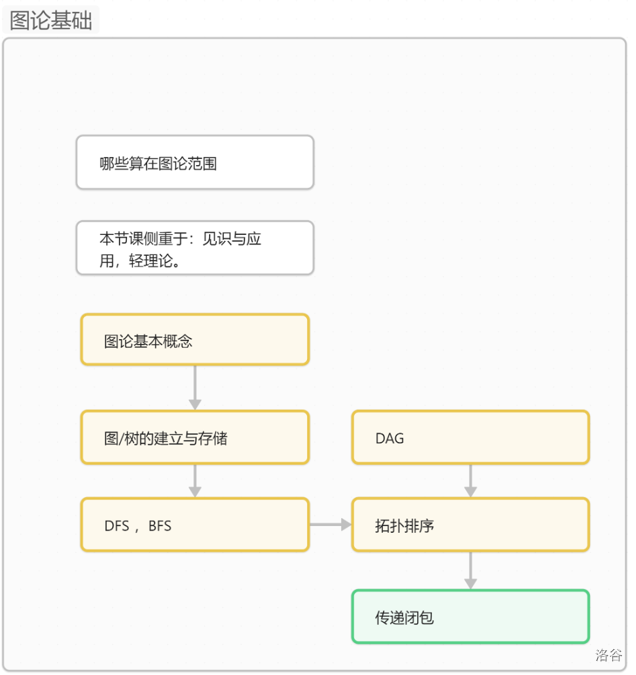
图论基本概念
-
图(graph) 是一个二元组 \(G=(V(G),E(G))\)。其中 \(V(G)\) 是非空集;称为点集(vertex set),对于 \(V\) 中的每个元素,我们称其为顶点;\(E(G)\) 为 \(V(G)\) 各结点之间边的集合,称为边集。
-
常用 \(G=(V,E)\) 表示图。
-
若 \(G\) 为无向图,则 \(E\) 中的每个元素为一个有序二元组 \((u,v)\),称作无向边,建成边,其中 \(u,v \in V\)。设 \(e=(u,v)\),则 \(u\) 和 \(v\) 称为 \(e\) 的端点。
-
若 \(G\) 为无向图,则 \(E\) 中的每一个元素为一个有序二元组 \((u,v)\),称作有向边或弧,在不引起混淆的情况下也可以称作边。
-
若 \(G\) 的每条边 \(e_k =(u_k,v_k)\) 都被赋予一个数作为该边的权,则称 \(G\) 为赋权图。如果这些权都是正实数,就称 \(G\) 为正权图。
拓扑排序
算法实现
拓扑排序是一种基于有向无环图 (DAG)的排序。
它不是对一个数列进行排序,而是对 DAG 上的点进行排序的一种算法。
先来看一下具体实现流程:
-
每次选择入度为 \(0\) 的点,然后删除这个点和它的出边。
-
重复上述过程直到这个 DAG 被删完。
拓扑排序的题目中,会规定点的经过顺序,如果它前面有点得经过,它的入度就大于 \(0\) 了。
拓扑排序的一个性质:拓扑排序的顺序不是唯一的。
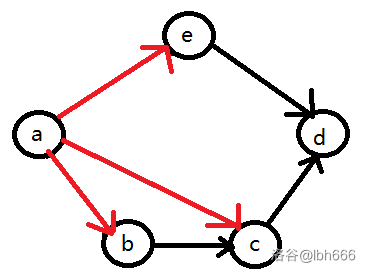
比如说下面这张图,当我们选择入度为 \(0\) 的点 \(a\) 后,删除它本身与它的出边,此时我们有两种方案可选:
-
选择点 \(e\)。
-
选择点 \(b\)。
以此类推......
判断环
如果拓扑排序执行不下去了,说明图中有环。当然也可以用 Tarjan 找环。
DFS、BFS
深度优先搜索(DFS, Depth-First Search)
基本思想:
- 沿着树的深度遍历树的节点,尽可能深的搜索树的分支
- 当节点v的所在边都已被探寻过,搜索将回溯到发现节点v的那条边的起始节点
实现方式:
- 递归实现
- 使用栈的迭代实现
特点:
- 内存消耗相对较小(只需存储当前路径上的节点)
- 不能保证找到最短路径
- 适用于拓扑排序、连通性检测、寻找环路等问题
时间复杂度:
- 邻接表表示:\(O(|V| + |E|)\)。
- 邻接矩阵表示:\(O(|V|²)\)。
广度优先搜索(BFS, Breadth-First Search)
基本思想:
- 从根节点开始,沿着树的宽度遍历树的节点
- 如果所有节点均被访问,则算法中止
实现方式:
- 通常使用队列实现
特点:
- 可以找到从起点到其他所有节点的最短路径(无权图)
- 内存消耗较大(需要存储所有已访问节点)
- 适用于寻找最短路径、社交网络中的"好友推荐"等问题
时间复杂度:
- 邻接表表示:\(O(|V| + |E|)\)。
- 邻接矩阵表示:\(O(|V|²)\)。
对比总结
| 特性 | DFS | BFS |
|---|---|---|
| 数据结构 | 栈 | 队列 |
| 空间复杂度 | \(O(h)\) (\(h\) 为树的高度) | \(O(w)\) (\(w\) 为树的宽度) |
| 最短路径 | 不能保证 | 可以保证(无权图) |
| 适用场景 | 拓扑排序、连通性检测等 | 最短路径、层级遍历等 |
两者都是图遍历的基本算法,选择哪种算法取决于具体问题和需求。
传递闭包
一种用 Floyd 实现的判断任意两点联通性的 \(O(n^3)\) 算法。
具体来说,原本 Floyd 的转移式为 f[i][j]=min(f[i][j],f[i][k]+f[k][j]);,传递闭包的转移式则为 f[i][j]|=(f[i][k]&f[k][j]);,很好理解,把加法换成了位运算而已。
传递闭包还可以用 bitset 优化成 \(O(\frac{n^3}{\omega})\),具体见这篇题解。

 浙公网安备 33010602011771号