
[数据结构/MYSQL] 二叉搜索树(BST) VS 平衡二叉排序树(AVL) VS B树(平衡多路搜索树) VS B+树 VS 红黑树(平衡二叉B树)

1 二叉排序树/二叉查找树/Binary Sort Tree
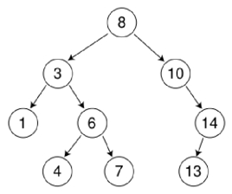
- 1种对排序和查找都很有用的特殊二叉树
- 叉排序树的弊端的解决方案:平衡二叉树
- 二叉排序树必须满足的3条性质(或是具有如下特征的二叉树)
- 若它的左子树不为空,则:左子树上所有结点的值< 它根结点的值
- 若它的右子树不为空,则:右子树上所有结点的值 > 它根结点的值
- 它的左子树、右子树也分别为二叉排序树(递归性)
(按照如上定义,即:
1 无键值相等的结点
2 中序遍历一颗二叉树时,可得一个结点值递增的有序序列)
2 平衡二叉排序树/Balanced Binary Tree/Adelson-Velskii & Landis
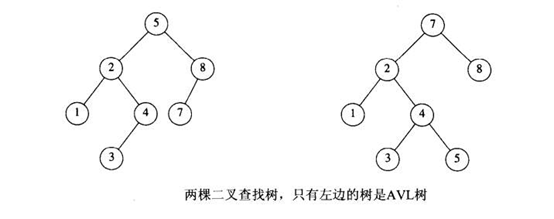
- 1种结构平衡的二叉搜索树(即 叶节点高度差的绝对值不超过1)
- 平衡因子:AVL树中左子树与右子树的深度之差只能为-1、0、1
- AVL树的平衡调整方法:LL、RR、LR、RL(为了保证平衡,需付出一定代价)
- 平衡二叉树的3条性质:(AVL树or空树,或是具有如下特征的二叉排序树(BST))
- 左子树必须为平衡二叉树
- 右子树必须为平衡二叉树
- |左子树深度-右子树深度|≤1
3 B树
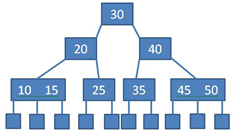
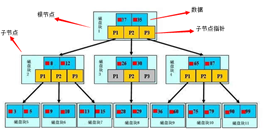
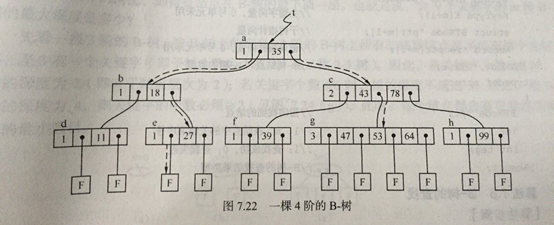
- 1种平衡的多路搜索树,多用于文件系统、数据库的实现
- 缺点
- 在查询单条数据是非常快的。但如果范围查的话,b树每次都要从根节点查询一遍。
- 提出者
- 最早是由德国计算机科学家Rudolf Bayer等人于1972年在论文 《Organization and Maintenance of Large Ordered Indexes》提出的
- 结点的结构图↓

- 1棵m阶的B树,或为空树,或为满足下列特性的m叉树:
- 若根结点不是叶子结点,则:有≥2棵子树
- 树中每个结点有≤m棵子树 (m叉树的性质)
- 所有的非终端结点有≤m-1个关键字。
- 除根结点外的所有非终端结点有≥「m/2」棵子树
- 所有的叶子结点都出现在同一层次上,并且不带信息(即 失败结点)
(实质上,失败结点并不存在,指向此类结点的指针为空,引入失败结点是为便于分析B树的查找性能)
4 B+树
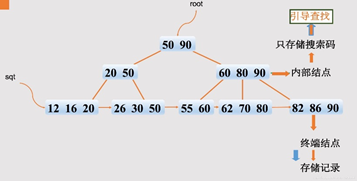
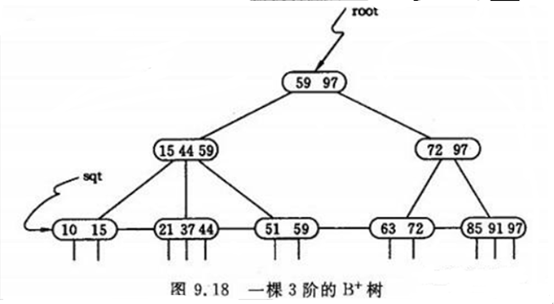
- 1种B树的变形树,更适合用于文件索引系统。
- 实际应用:MySQL的存储引擎InnoDB/MyISAM均利用B+树建立索引。(MYSQL-Console:SHOW INDEX FROM tableName)
- m阶B+树与m阶B树的差异
- 含有n个关键字的结点必含有n棵子树;
- 所有的【非叶子节点/非终端结点】:可看成是索引部分,结点中仅含有其子树(根结点)中的最大(或最小)关键字
- 所有的【叶子结点/终端节点】:包含了全部关键字的信息,以及指向含这些关键字记录的指针,且叶子结点本身依靠关键字的大小自小而大顺序连接;
5 红黑树/平衡二叉B树
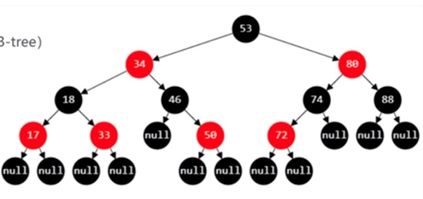
- 别称:平衡二叉B树,1种自平衡的二叉搜索树
- 实际应用:HashMap等Java的JDK源码实现
- 红黑树必须满足的5条性质
- 节点必为Red or Black
- 根节点必为Black
- 叶子节点必为Black
- Red节点的子节点(父节点)必为Black (即 从根节点到叶子节点的所有路径上不能有2个连续的Red节点)
- 从任一节点到叶子节点的所有路径都包含相同数目的Black节点
- 比起AVL树(平衡二叉树),红黑树的特点↓

F 附件
F.1 二叉树的遍历方法:前序遍历、中序遍历、后序遍历
- 二叉树三种遍历(递归定义,根节点访问顺序区分)
记口诀:前根左右,中左根右,后左右根
1. 前序遍历(Pre-order)
根 → 左子树 → 右子树
- 访问当前根节点
- 递归遍历左子树
- 递归遍历右子树
2. 中序遍历(In-order)
左子树 → 根 → 右子树
- 递归遍历左子树
- 访问当前根节点
- 递归遍历右子树
✅ 二叉搜索树:中序遍历结果是升序序列
3. 后序遍历(Post-order)
左子树 → 右子树 → 根
- 递归遍历左子树
- 递归遍历右子树
- 访问当前根节点
✅ 适合删除树、计算子树信息(要先处理完所有子节点)
重要意义:还原二叉树
- 前序 + 中序,可以唯一还原二叉树
- 后序 + 中序,可以唯一还原二叉树
- 只有前序+后序,不能唯一还原(缺少中序,无法区分左右)
简单示例
    A
   / \
  B   C
 /
D
- 前序:A → B → D → C
- 中序:D → B → A → C
- 后序:D → B → C → A
Python 递归模板
# 前序
def pre(root):
    if not root: return
    print(root.val)
    pre(root.left)
    pre(root.right)

# 中序
def ino(root):
    if not root: return
    ino(root.left)
    print(root.val)
    ino(root.right)

# 后序
def post(root):
    if not root: return
    post(root.left)
    post(root.right)
    print(root.val)
非递归(栈)版本: 略
像MYSQL等数据库在做数据恢复时,有使用上这些遍历方法吗?
- 结论
二叉树的前/中/后序遍历本身不会直接用于 MySQL 数据恢复,但 MySQL 底层索引(B+树)的遍历逻辑和这几个遍历思想高度相关;真正做数据恢复靠的是 binlog、redo log、undo log。
1. B+树 和 二叉树遍历的区别
MySQL InnoDB 的主键索引是 B+树(多路平衡查找树,不是二叉树)
- B+树的特点:所有数据都在叶子节点,叶子节点是【双向链表】串联
- 查询、范围扫描:顺着叶子节点链表顺序遍历,等价于【中序遍历】效果(节点值:从小到大)
中序遍历二叉搜索树得到有序序列,B+树叶子链表扫描也是有序,这是【思想同源】。
但是:B+树没有前序、后序遍历的业务场景,B+树几乎只用【叶子节点】做顺序扫描。
2. MySQL 数据恢复到底用什么日志(重点)
redo log(重做日志)
崩溃恢复核心。物理日志,记录「页修改」
宕机重启时:扫描 redo log,把【已提交但没刷到磁盘的数据页】重做,保证数据不丢。
恢复逻辑:按日志产生的时间顺序回放,和树遍历无关。
binlog(二进制日志)
逻辑日志,记录 DML/DDL,用于时间点恢复 PITR、主从复制
数据误删恢复:全量备份 + 按顺序回放 binlog,恢复到指定时间点。
回放:按事务先后顺序执行,和树遍历无关。
undo log(回滚日志)
事务回滚、MVCC,保存数据修改前的旧版本。
rollback 的时候,读取 undo log 把数据改回去。
3. 什么时候会涉及“树遍历”在数据库恢复场景?
只有一种场景:索引损坏,需要重建索引
ALTER TABLE xxx FORCE; 或者重建索引:
引擎会扫描【聚簇索引叶子节点】(B+树顺序遍历),读取全部行,重新构建【二级索引B+树】。
👉 这里的遍历,只是B+树叶子节点顺序扫描,不是二叉树前/中/后序。
4. 重点区分
- ❌ MySQL 数据恢复使用二叉树前/中/后序遍历 → 错误
- ✅ InnoDB B+树范围查询,类似二叉搜索树中序遍历得到有序结果 → 正确
- ✅ 数据误删恢复靠 binlog;宕机崩溃恢复靠 redo log;事务回滚靠 undo log
5. 类比总结
- 二叉树三种遍历:是二叉树的节点访问顺序理论
- B+树叶子链表顺序扫描:是多路树的有序读取,思想借鉴中序,但不是同一个东西
- 数据恢复:是日志回放机制,和树遍历没有直接关系
F.2 B 树 / B + 树 / 二叉搜索树
遍历对比
| 结构 | 树类型 | 数据存放位置 | 常用遍历方式 | 遍历效果 | 备注 |
|---|---|---|---|---|---|
| 二叉搜索树 BST | 二叉树 | 每个节点都存数据 | 中序遍历(左→根→右) | 升序有序序列 | 前/后序很少用于查询;树容易退化成链表 |
| B树(多路平衡查找树) | 多路树 | 所有节点(根、中间、叶子)都存索引+数据 | 中序式遍历:从最左子树开始,依次访问节点内有序key,再访问右子树 | 升序有序 | 没有专门“前/后序”业务场景;查找时自上而下遍历分支 |
| B+树(InnoDB索引) | 多路树 | 仅【叶子节点】存完整数据;【非叶子】只存索引(关键字/key) | 1.单点查找:自上而下从根找到叶子 2.范围查询:叶子节点双向链表顺序扫描 |
升序有序,范围扫描极快 | 不会像BST那样递归中序遍历;直接走叶子链表,是MySQL索引核心 |
小结:BST的中序遍历是递归遍历树节点;B/B+树范围查询虽然结果也是有序,但B+树靠叶子链表,不是递归遍历整棵树。
特点综合对比
| 对比项 | 二叉搜索树(BST) | B树(多路平衡查找树) | B+树 |
|---|---|---|---|
| 节点子节点数 | 最多2个(左、右) | \([⌈m/2⌉, m]\),根节点最少2个 | 内部节点:\([⌈m/2⌉, m]\);叶子节点无孩子 |
| 关键字分布 | 所有节点都存数据+关键字 | 所有节点都存关键字+对应数据 | 内部节点只存索引关键字,叶子节点存全部数据 |
| 查找路径 | 最坏O(n)(退化成链表);平衡BST为O(logn) | 从根到叶子,单次IO链,O(logn) | 一定走到叶子节点;范围查询优势大 |
| 范围查询 | 需要中序遍历,效率低 | 需要来回跨节点,一般 | 叶子节点链表串联,顺序扫描,范围查询最优 |
| 磁盘场景 | 不适合磁盘,树太高IO多 | 适合磁盘,高度低;随机查询不错 | 数据库、索引首选,IO次数稳定,范围查询强 |
| 叶子节点关系 | 无关联 | 叶子节点不相连 | 叶子节点构成有序双向/单向链表 |
| 数据重复 | 一般不允许重复key | B树节点内关键字唯一 | 叶子可存重复索引 |
| 典型应用 | 内存查找、集合(平衡BST:红黑树) | 文件系统索引(部分) | MySQL InnoDB索引 |
- BST:二叉,树高容易失控,多用于内存;
- B树:多路平衡,每个节点都带数据,随机查询好,范围查询一般;
- B+树:B树变种,数据全在叶子,叶子链表串联,范围查询极强,(关系型)数据库索引标准。
优缺点、适用场景对比
- BST、B树、B+树:优缺点、适用场景对比
| 对比项 | 二叉搜索树(BST) | B树(多路平衡查找树) | B+树 |
|---|---|---|---|
| 优点 | 1. 实现简单 2. 中序遍历直接得到有序序列 3. 平衡BST(红黑树、AVL)内存查找性能优秀 | 1. 多路平衡,树高度低,磁盘IO少 2. 查找键命中非叶子节点即可返回数据,随机查询快 3. 插入删除相对均衡 | 1. 所有查询最终落到叶子,IO次数稳定 2. 叶子节点链表相连,范围查询极强 3. 非叶子节点仅存索引,一页能放更多关键字,树更矮 4. 数据都在叶子,数据库分页扫描友好 |
| 缺点 | 1. 普通BST在顺序插入时会退化成链表,查找退化到O(n) 2. 树高随数据量增长快,磁盘场景IO次数多,不适合磁盘存储 3. 范围查询需要中序遍历,效率差 | 1. 范围查询需要多次跨节点跳转,效率弱于B+树 2. 每个节点都存数据,单页存放关键字数量变少,树相对更高 3. 删除非叶子节点比较复杂 | 1. 随机查询通常要走到叶子节点,比B树多一次IO 2. 插入删除需要维护叶子链表,逻辑略复杂 |
| 适合场景 | 内存内的有序查找;平衡BST(红黑树)用于TreeMap、C++ set/map等内存容器 | 文件系统索引(NTFS等);部分数据库的老版本索引 | MySQL InnoDB索引;绝大多数关系型数据库索引,大数据【范围查询】场景 |
补充记忆要点:
- BST:内存用,最怕数据有序插入失衡;
- B树:随机查找强,范围查询弱;
- B+树:范围查询王者,数据库首选。
F.3 哈希表、红黑树、B树、B+树
| 数据结构 | 优点 | 缺点(为什么不用) |
|---|---|---|
| 哈希表 | 等值查询 O(1) | 不支持范围查询,无法排序;有哈希冲突 |
| 红黑树 | 内存中平衡性好 (多用于:内存容器,如: HashMap/TreeMap) |
二叉结构树高过大(千万级数据深度 20+),磁盘 IO 次数多 |
| B 树 | 多路平衡,树矮 (多用于:文件系统,如:NTFS) |
非叶子节点也存数据,单页可容纳的指针更少,树更高;叶子节点无链表,范围查询需中序遍历 |
| B+ 树 | 树矮、IO 少、范围查询快、性能稳定 (多用于:关系型数据库,如:MYSQL/PG) |
非叶子节点不存数据(对「只查非索引列」的场景无优化) |
核心结论:B+ 树以「非叶子节点纯索引化 + 叶子节点链表化」两个设计,同时解决了树高(IO 次数)和范围查询(顺序扫描)两大问题,是最适配磁盘存储的索引结构。这是 MySQL 索引题最高频的深挖点,务必能画出结构图并讲清对比。
F.4 大数据组件是否使用 BST / B 树 / B + 树?
- 推荐文献
- LSM-Tree ≠ B/B + 树;LSM 是日志合并树,RocksDB 底层是 LSM,不是 B + 树;OLAP 库(Doris/ClickHouse)一般不用 B + 树做主索引,用稀疏索引。
Doris / Clickhouse / OpenGemini / InfluxDB / Redis / RocksDB
| 系统 | 是否用BST | 是否用B树 | 是否用B+树 | 底层核心索引结构 | 补充说明 |
|---|---|---|---|---|---|
| Apache Doris | 否 | 否 | ❌ 不做主索引 | 稀疏前缀索引、ZoneMap、BloomFilter、倒排索引、BKD-Tree | OLAP列式存储,没有B+树主键索引;BKD树用于多维/数值范围查询,不是B+树 |
| ClickHouse | 否 | 否 | ❌ 不做主索引 | MergeTree稀疏主键索引、minmax跳数索引、BloomFilter | 稀疏索引(每8192行存一条标记),不是B+树,块粒度定位,不是行级索引 |
| OpenGemini(时序库) | 否 | 否 | ❌ | 倒排索引,底层KV存储复用LSM-Tree | 时序库,标签走倒排;底层存储层是LSM,不使用B+树做主索引,B+树随机写差不适合时序高吞吐写入 |
| InfluxDB | 否 | 否 | ❌ | TSI倒排索引 + TSM文件(块内二分查找) | TSI是LSM风格时序倒排索引;TSM内部块索引只是有序数组二分查找,不是B+树 |
| Redis | ✅(少量场景) | 否 | 否 | 哈希表(主)、跳表(zset) | Redis zset用跳表,不是BST;仅内部少量辅助结构有用二叉树;RDB/AOF持久化本身不使用B/B+树。 ⚠️ Redis on Flash(RocksDB后端)才走LSM |
| RocksDB | 否 | 否 | ❌ | LSM-Tree(MemTable默认跳表 + SSTable) | SSTable内部块索引是有序数组+二分查找,不是B+树;很多人容易把LSM和B+树搞混 |
- B+树:MySQL InnoDB 行存OLTP首选;上面这5个都没有拿B+树做主索引
- LSM-Tree(RocksDB、OpenGemini底层KV、InfluxDB TSI):适合高吞吐写入,牺牲部分读性能,和B+树是两大路线
- Doris/ClickHouse OLAP:稀疏索引 + 块过滤(minmax/zoneMap/BloomFilter),按数据块扫描,不是单行索引
- Redis:核心是哈希、跳表,不用B/B+树
- 补充:容易踩坑知识点
- ❌ 误区:RocksDB = B+树。错。RocksDB是LSM;B+树是原地更新,大量随机IO;LSM顺序写,后台compaction。
- ❌ 误区:时序库用B+树。错,时序写入压力极大,B+树随机写会崩,普遍用LSM/倒排。
- ❌ 误区:ClickHouse主键=B+树。错,是稀疏标记索引,定位数据块,块内仍然扫描。
B+树 vs LSM-Tree 的对比表
- B+树 vs LSM-Tree 对比表
| 对比项 | B+树 | LSM-Tree(日志合并树) |
|---|---|---|
| 核心思想 | 原地更新,在B+树上直接修改节点;数据全部在叶子有序链表 | 不原地修改,新写入先写内存MemTable;满了落盘成有序SSTable;后台异步合并SST |
| 写入方式 | 随机写。更新/插入可能修改磁盘上旧页,产生随机IO | 顺序写为主。写入只追加,极少原地修改,写放大取决于compaction策略 |
| 读路径 | 一次查找,从根走到叶子;IO次数稳定 命中页缓存时读性能极好 | 先查MemTable,再逐层查多层SST;可能多次磁盘IO;存在读放大 |
| 写放大 | 小,修改只影响少量页面 | 大。compaction需要读取、重写旧SST文件,产生写放大 |
| 读放大 | 小,一次查询少量IO | 较大,查询需要遍历多个SSTable,要判断数据版本/墓碑 |
| 空间放大 | 较小,页内填充率可控制 | 较大,旧版本数据、墓碑标记会占用空间,直到compaction清理 |
| 更新/删除 | 原地覆盖;删除标记或直接移除记录 | 追加写入墓碑(tombstone),不立即删旧数据;后台compaction才清理 |
| 随机读 | ⭐⭐⭐⭐⭐ 优秀(OLTP单行查询) | ⭐⭐⭐ 一般,多层SST查找开销高 |
| 批量范围扫描 | ⭐⭐⭐⭐⭐ 优秀,叶子链表连续有序 | ⭐⭐⭐⭐ 较好,但跨SST合并读取,略弱于B+树 |
| 高吞吐写入 | ⭐⭐ 差,大量随机IO瓶颈 | ⭐⭐⭐⭐⭐ 强,适合高并发大量写入场景 |
| 磁盘IO特征 | 大量随机IO | 以顺序IO为主,compaction阶段会有大量读写 |
| 典型数据库/组件 | MySQL InnoDB、PostgreSQL(B+变种) | RocksDB、LevelDB、OpenGemini底层KV、InfluxDB、TiKV |
| 适用场景 | OLTP业务:单行CRUD、事务、低延迟随机查询 | 高吞吐写入场景:时序数据库、分布式KV、大数据存储引擎 |
- 关键要点
- B+树:原地更新,随机读强,随机写弱。更新会修改磁盘旧页,写压力大,适合读多写少OLTP。
- LSM-Tree:追加写,写强随机读弱。牺牲读、空间换取超高写入吞吐量;三大放大:写放大、读放大、空间放大。
- 核心取舍:B+树把代价放在写入时;LSM把代价放到后台compaction。
补充:RocksDB可以配置压缩、compaction策略来降低放大,但无法消除LSM天然存在的三大放大问题。
X 参考文献
- 参考
- 推荐:

本文链接: https://www.cnblogs.com/johnnyzen
关于博文:评论和私信会在第一时间回复,或直接私信我。
版权声明:本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!
日常交流:大数据与软件开发-QQ交流群: 774386015 【入群二维码】参见左下角。您的支持、鼓励是博主技术写作的重要动力!

 浙公网安备 33010602011771号