
三分钟入门DeepONet
从函数逼近到算子逼近
神经网络可以作为通用的函数逼近器。普通神经网络通常学习有限维空间之间的映射,例如
但是很多科学计算问题真正关心的是函数到函数的映射。对于微分方程
我们希望学习给定输入函数 \(u(x)\) 后对应的解函数 \(s(x)\)。这可以表示为算子
对于 \(u\in\mathcal U\),\(G(u)\) 是一个新的函数,而
表示输出函数在位置 \(y\) 处的值。
有一个古老的理论——Universal Approximation Theorem for Operator(Chen et al. 1995)表示,神经网络可以被用来逼近数学算子(比如积分,常微分方程ODEs,偏微分方程PDEs),实现函数到函数/实数的映射。
DeepONet
根据 Approximation Theorem,很自然的,我们可以想到见下图A所表示的神经网络架构,即一股脑将\(u\)和\(y\)传给一个神经网络(比如全连接神经网络FNNs),用它替代算子,然后输出\(G(u)(y)\)。理论上这是可行的,但是这样的神经网络很难训练。为了又快又好的学习\(G\),Lu et al.提出了DeepONet的概念,即图C、D。它的架构很简单,由Branch和Trunk两部分组成。Branch的输入为函数\(u\),Trunk的输入为\(y\),将Branch和Trunk的输入做点乘就得到了\(G(u)(y)\)。

一个连续函数怎么输入神经网络?
本文以最简单 Antiderivative 问题为例来介绍 DeepONet 的基本思路。定义:
因此
假设我们要训练这个神经网络来求解上面不定积分的问题,首先要考虑的就是如何把连续函数传给神经网络。显然,我们无法告诉神经网络这个函数在整个空间各个点处的值。DeepONet的作者提出了"discrete sensor"的概念,很形象。也就是说,想象我们在一些固定的位置放上传感器,它们可以捕捉函数在这个位置的值。将所有传感器捕捉到的值拼成一个向量,作为神经网络的输入。比如🌰,输入的函数 u(x)=x2 ,我们把sensors定在 x1=2,x2=5,x3=6 这三个位置,获得 u=[4,25,36] 作为神经网络的输入向量。相较于以往的研究,DeepONet的一大亮点就是,这些sensors不一定均匀分布,可以放置在定义域的任何位置,只要所有的训练和测试数据都用同样的sensors就行。
知道了如何表示神经网络的输入,那么如何生成大量的inputs呢?这个问题可以拆分为两部分:(1)选取什么函数空间,(2)如何采样。论文中提到了两个函数空间:Gaussian radom field(GRF)和Chebyshev polynomials。这里只以GRF为🌰。我们可以定义这样的核函数
然后通过高斯过程生成\(u\)
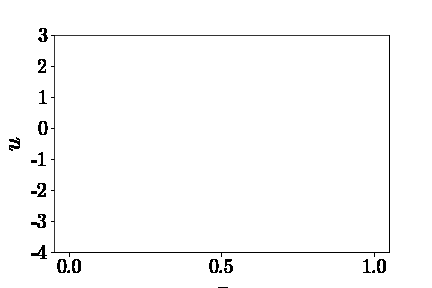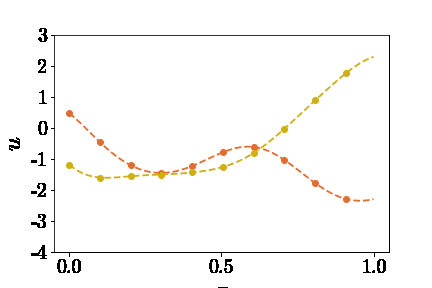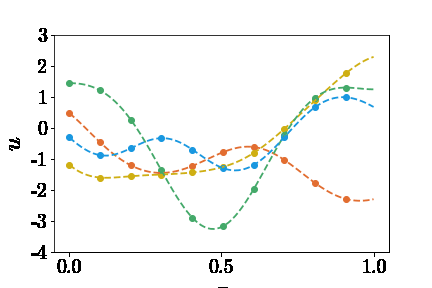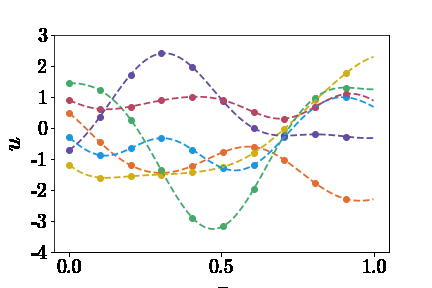
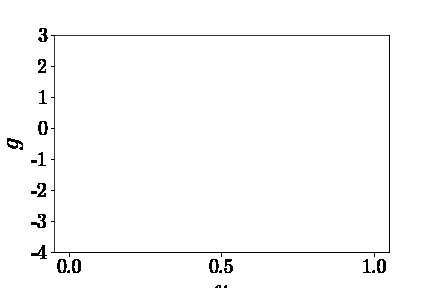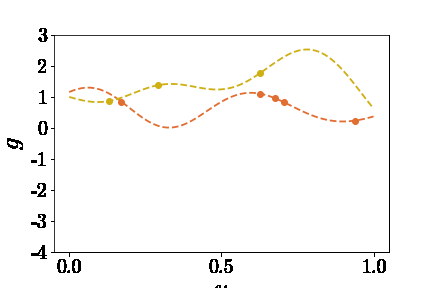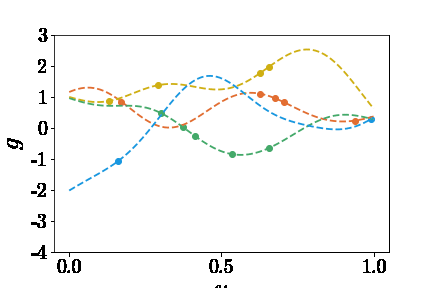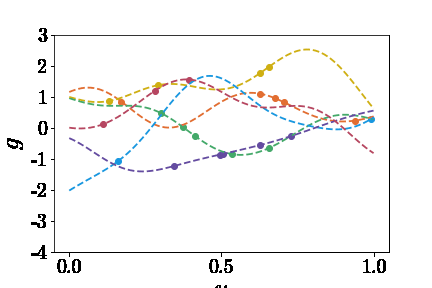
这里就不详述了,感兴趣的读者可以参考Görtler el al.的论文“A Visual Exploration of Gaussian Processes”。这里不理解也没关系,总之就是我们创建了包揽了无限多连续函数的篮子,我们可以从中随机抓取函数(见下图)。然后,获取函数在sensors处的值作为DeepONet Branch的输入。
 |
|---|
| \(u(x)\) |
Trunk部分的输入很简单,就是在定义域内随意取一个或多个坐标\(y\),然后求得\(G(u)(y)\)作为预期输出。
 |
|---|
| \(G(u)(y)\) |
一条 DeepONet 训练数据长什么样?
首先从 GRF 中随机生成一个函数 \(u(x)\)。
在固定的 100 个 sensors 上读取:
作为 Branch input。
然后选择一个查询位置 \(y\) 作为 Trunk input。
对应的监督标签为
因此一条完整训练数据是:
下面从上述 GRF 函数空间中随机采样一个函数 \(u(x)\),以此为例说明 DeepONet 的 Branch 输入、Trunk 输入以及对应的预期输出。

网络与训练
Branch Net 接收
Trunk Net 接收
假设两个网络最终都输出 \(p\) 维特征:
DeepONet 输出:
其核心结构可以写成:
branch_output = branch_net(branch_input)
trunk_output = trunk_net(y)

prediction = np.sum(
    branch_output * trunk_output,
    axis=1,
    keepdims=True
)
本文代码没有自行实现 DeepONet 的 Branch Net、Trunk Net 和最终的输出组合,而是直接使用 DeepXDE 提供的 OpNN:
net = dde.maps.OpNN(
    [m, 40, 40],
    [dim_x, 40, 40],
    activation,
    initializer,
    use_bias=True,
    stacked=False,
)
最简单的 loss 可以采用 MSE:
之后就是常规的 forward、loss、back propagation、optimizer 和参数更新。
model = dde.Model(data, net)

model.compile(
    "adam",
    lr=lr,
    metrics=[mean_squared_error_outlier]
)

checker = dde.callbacks.ModelCheckpoint(
    "model/model.ckpt",
    save_better_only=True,
    period=1000
)

losshistory, train_state = model.train(
    epochs=epochs,
    callbacks=[checker]
)
补充:
- DeepONet只是个框架,里面子神经网络不一定非得是FNN。
参考文献
- Görtler, et al., "A Visual Exploration of Gaussian Processes", Distill, 2019.
- Lu, Lu, Pengzhan Jin, and George Em Karniadakis. ‘DeepONet: Learning Nonlinear Operators for Identifying Differential Equations Based on the Universal Approximation Theorem of Operators’. Nature Machine Intelligence 3, no. 3 (March 2021): 218–29. https://doi.org/10.1038/s42256-021-00302-5.

 浙公网安备 33010602011771号