
Kafka 消费端分区重平衡
什么是分区再均衡
分区的所有权从一个消费者转移到另一个消费者,这样的行为被称为分区再均衡(Rebalance)。Rebalance 实现了消费者群组的高可用性和伸缩性。
Rebalance 本质上是一种协议,规定了一个 Consumer Group 下的所有 Consumer 如何达成一致,来分配订阅 Topic 的每个分区。比如某个 Group 下有 20 个 Consumer 实例,它订阅了一个具有 100 个分区的 Topic。正常情况下,Kafka 平均会为每个 Consumer 分配 5 个分区。这个分配的过程就叫 Rebalance。
当在群组里面 新增/移除消费者 或者 新增/移除 kafka 集群 broker 节点 时,群组协调器 Broker 会触发再均衡,重新为每一个 Partition 分配消费者。Rebalance 期间,消费者无法读取消息,造成整个消费者群组一小段时间的不可用。
何时生分区再均衡
分区再均衡的触发时机有三种:
-
消费者群组成员数发生变更,新 Consumer 加入群组或者离开群组,或者是有 Consumer 实例崩溃被“踢出”群组。
- 新增消费者。Consumer 订阅主题之后,第一次执行 poll 方法
- 移除消费者。执行
consumer.close()操作或者消费客户端宕机,就不再通过 poll 向群组协调器发送心跳了,当群组协调器检测次消费者没有心跳,就会触发再均衡。
-
订阅主题数发生变更。Consumer Group 可以使用正则表达式的方式订阅主题,比如
consumer.subscribe(Pattern.compile(“t.*c”))就表明该 Group 订阅所有以字母 t 开头、字母 c 结尾的主题。在 Consumer Group 的运行过程中,你新创建了一个满足这样条件的主题,那么该 Group 就会发生 Rebalance。 -
订阅主题的分区数发生变更
。Kafka 当前只能允许增加一个主题的分区数。当分区数增加时,就会触发订阅该主题的所有 Group 开启 Rebalance。
- 新增 broker。如重启 broker 节点
- 移除 broker。如 kill 掉 broker 节点。
分区再均衡的过程
Rebalance 是通过消费者群组中的称为“群主”消费者客户端进行的。
(1)选择群主
当消费者要加入群组时,会向群组协调器发送一个 JoinGroup 请求。第一个加入群组的消费者将成为“群主”。群主从协调器那里获取群组的活跃成员列表,并负责给每一个消费者分配分区。
所谓协调者,在 Kafka 中对应的术语是 Coordinator,它专门为 Consumer Group 服务,负责为 Group 执行 Rebalance 以及提供位移管理和组成员管理等。具体来讲,Consumer 端应用程序在提交位移时,其实是向 Coordinator 所在的 Broker 提交位移。同样地,当 Consumer 应用启动时,也是向 Coordinator 所在的 Broker 发送各种请求,然后由 Coordinator 负责执行消费者组的注册、成员管理记录等元数据管理操作。
(2)消费者通过向被指派为群组协调器(Coordinator)的 Broker 定期发送心跳来维持它们和群组的从属关系以及它们对分区的所有权。

(3)群主从群组协调器获取群组成员列表,然后给每一个消费者进行分配分区 Partition。有两种分配策略:Range 和 RoundRobin。
- Range 策略,就是把若干个连续的分区分配给消费者,如存在分区 1-5,假设有 3 个消费者,则消费者 1 负责分区 1-2,消费者 2 负责分区 3-4,消费者 3 负责分区 5。
- RoundRoin 策略,就是把所有分区逐个分给消费者,如存在分区 1-5,假设有 3 个消费者,则分区 1->消费 1,分区 2->消费者 2,分区 3>消费者 3,分区 4>消费者 1,分区 5->消费者 2。
- Sticky Strategy策略
(4)群主分配完成之后,把分配情况发送给群组协调器。
(5)群组协调器再把这些信息发送给消费者。每个消费者只能看到自己的分配信息,只有群主知道所有消费者的分配信息。
如何判定消费者已经死亡
消费者通过向被指定为群组协调器的 Broker 发送心跳来维持它们和群组的从属关系以及它们对分区的所有权关系。只要消费者以正常的时间间隔发送心跳,就被认为是活跃的。消费者会在轮询消息或提交偏移量时发送心跳。如果消费者超时未发送心跳,会话就会过期,群组协调器认定它已经死亡,就会触发一次再均衡。
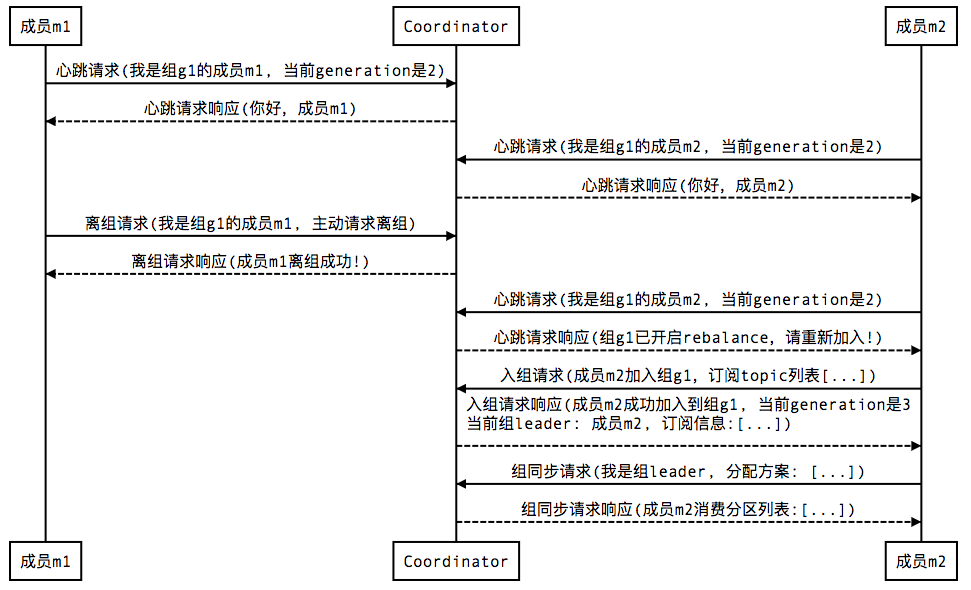
当一个消费者要离开群组时,会通知协调器,协调器会立即触发一次再均衡,尽量降低处理停顿。
查找协调者
所有 Broker 在启动时,都会创建和开启相应的 Coordinator 组件。也就是说,所有 Broker 都有各自的 Coordinator 组件。那么,Consumer Group 如何确定为它服务的 Coordinator 在哪台 Broker 上呢?答案就在我们之前说过的 Kafka 内部位移主题 __consumer_offsets 身上。
目前,Kafka 为某个 Consumer Group 确定 Coordinator 所在的 Broker 的算法有 2 个步骤。
- 第 1 步:确定由位移主题的哪个分区来保存该 Group 数据:
partitionId=Math.abs(groupId.hashCode() % offsetsTopicPartitionCount),即协调者所在分区为消费者组groupID的哈希值 % _consumer_offsets队列分区数量。 - 第 2 步:步骤1确定的分区的leader副本所在broker即为协调者。
分区再均衡的问题
- 首先,Rebalance 过程对 Consumer Group 消费过程有极大的影响。在 Rebalance 过程中,所有 Consumer 实例都会停止消费,等待 Rebalance 完成。
- 其次,目前 Rebalance 的设计是所有 Consumer 实例共同参与,全部重新分配所有分区。其实更高效的做法是尽量减少分配方案的变动。
- 最后,Rebalance 实在是太慢了。
避免分区再均衡
通过前文,我们已经知道了:分区再均衡的代价很高,应该尽量避免不必要的分区再均衡,以整体提高 Consumer 的吞吐量。
分区再均衡发生的时机有三个:
- 组成员数量发生变化
- 订阅主题数量发生变化
- 订阅主题的分区数发生变化
后面两个通常都是运维的主动操作,所以它们引发的 Rebalance 大都是不可避免的。实际上,大部分情况下,导致分区再均衡的原因是:组成员数量发生变化。
有两种情况,消费者并没有宕机,但也被视为消亡:
- 未及时发送心跳
- Consumer 消费时间过长
未及时发送心跳
第一类非必要 Rebalance 是因为未能及时发送心跳,导致 Consumer 被“踢出”Group 而引发的。因此,你需要仔细地设置session.timeout.ms 和 heartbeat.interval.ms的值。我在这里给出一些推荐数值,你可以“无脑”地应用在你的生产环境中。
- 设置
session.timeout.ms= 6s。 - 设置
heartbeat.interval.ms= 2s。 - 要保证 Consumer 实例在被判定为“dead”之前,能够发送至少 3 轮的心跳请求,即
session.timeout.ms>= 3 *heartbeat.interval.ms。
将 session.timeout.ms 设置成 6s 主要是为了让 Coordinator 能够更快地定位已经挂掉的 Consumer。毕竟,我们还是希望能尽快揪出那些“尸位素餐”的 Consumer,早日把它们踢出 Group。希望这份配置能够较好地帮助你规避第一类“不必要”的 Rebalance。
Consumer 消费时间过长
第二类非必要 Rebalance 是 Consumer 消费时间过长导致的。我之前有一个客户,在他们的场景中,Consumer 消费数据时需要将消息处理之后写入到 MongoDB。显然,这是一个很重的消费逻辑。MongoDB 的一丁点不稳定都会导致 Consumer 程序消费时长的增加。此时,max.poll.interval.ms 参数值的设置显得尤为关键。如果要避免非预期的 Rebalance,你最好将该参数值设置得大一点,比你的下游最大处理时间稍长一点。就拿 MongoDB 这个例子来说,如果写 MongoDB 的最长时间是 7 分钟,那么你可以将该参数设置为 8 分钟左右。
GC
如果你按照上面的推荐数值恰当地设置了这几个参数,却发现还是出现了 Rebalance,那么我建议你去排查一下Consumer 端的 GC 表现,比如是否出现了频繁的 Full GC 导致的长时间停顿,从而引发了 Rebalance。为什么特意说 GC?那是因为在实际场景中,我见过太多因为 GC 设置不合理导致程序频发 Full GC 而引发的非预期 Rebalance 了。
协议(protocol)
rebalance本质上是一组协议。group与coordinator共同使用它来完成group的rebalance。
目前kafka提供了5个协议来处理与consumer group coordination相关的问题:
- Heartbeat请求:consumer需要定期给coordinator发送心跳来表明自己还活着
- JoinGroup请求:成员请求加入组
- SyncGroup请求:group leader把分配方案告诉组内所有成员
- LeaveGroup请求:主动告诉coordinator我要离开consumer group
- DescribeGroup请求:显示组的所有信息,包括成员信息,协议名称,分配方案,订阅信息等。通常该请求是给管理员使用
Coordinator在rebalance的时候主要用到了前面4种请求。
消费者存活Liveness
consumer如何向coordinator证明自己还活着? 通过定时向coordinator发送Heartbeat请求。如果超过了设定的超时时间,那么coordinator就认为这个consumer已经挂了。一旦coordinator认为某个consumer挂了,那么它就会开启新一轮rebalance,并且在当前其他consumer的心跳response中添加REBALANCE_IN_PROGRESS,告诉其他consumer:不好意思各位,你们重新申请加入组吧!
Consumer Group状态机
和很多kafka组件一样,group也做了个状态机来表明组状态的流转。coordinator根据这个状态机会对consumer group做不同的处理,如下图所示

- Dead:组内已经没有任何成员的最终状态,组的元数据也已经被coordinator移除了。这种状态响应各种请求都是一个response:
UNKNOWN_MEMBER_ID - Empty:组内无成员,但是位移信息还没有过期。这种状态只能响应JoinGroup请求
- PreparingRebalance:组准备开启新的rebalance,等待成员加入
- AwaitingSync:正在等待leader consumer将分配方案传给各个成员
- Stable:rebalance完成!可以开始消费了
Kafka 图解Rebalance
Rebalance过程
分为2步:Join和Sync
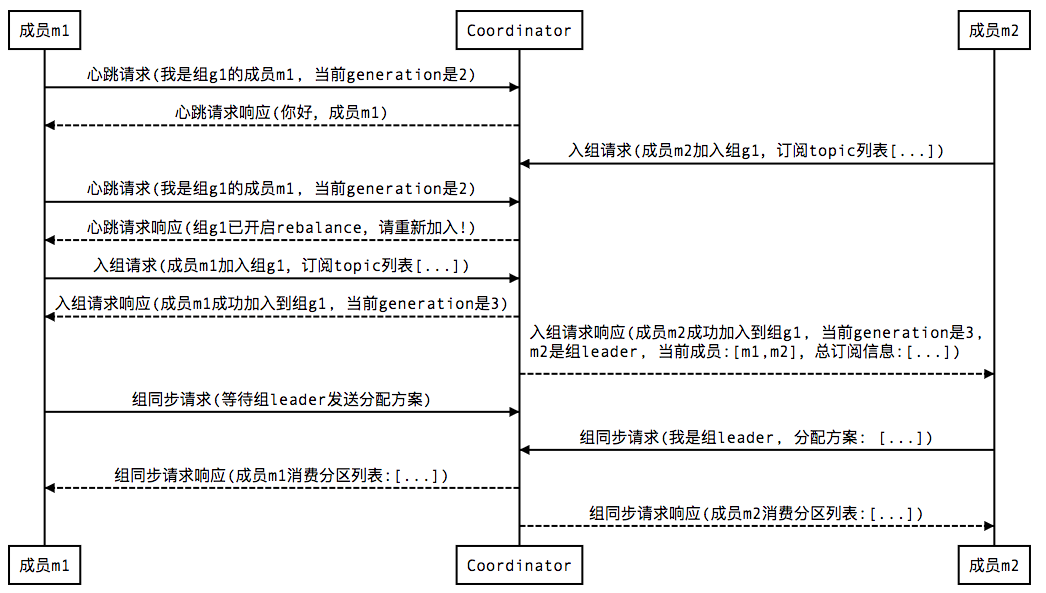
1 Join, 顾名思义就是加入组。这一步中,所有成员都向coordinator发送JoinGroup请求,请求入组。一旦所有成员都发送了JoinGroup请求,coordinator会从中选择一个consumer担任leader的角色,并把组成员信息以及订阅信息发给leader——注意leader和coordinator不是一个概念。leader负责消费分配方案的制定。
2 Sync,这一步leader开始分配消费方案,即哪个consumer负责消费哪些topic的哪些partition。一旦完成分配,leader会将这个方案封装进SyncGroup请求中发给coordinator,非leader也会发SyncGroup请求,只是内容为空。coordinator接收到分配方案之后会把方案塞进SyncGroup的response中发给各个consumer。这样组内的所有成员就都知道自己应该消费哪些分区了。
还是拿几张图来说明吧,首先是加入组的过程:

值得注意的是, 在coordinator收集到所有成员请求前,它会把已收到请求放入一个叫purgatory(炼狱)的地方。
然后是分发分配方案的过程,即SyncGroup请求:

4种Reblance场景
1 新成员加入组(member join)
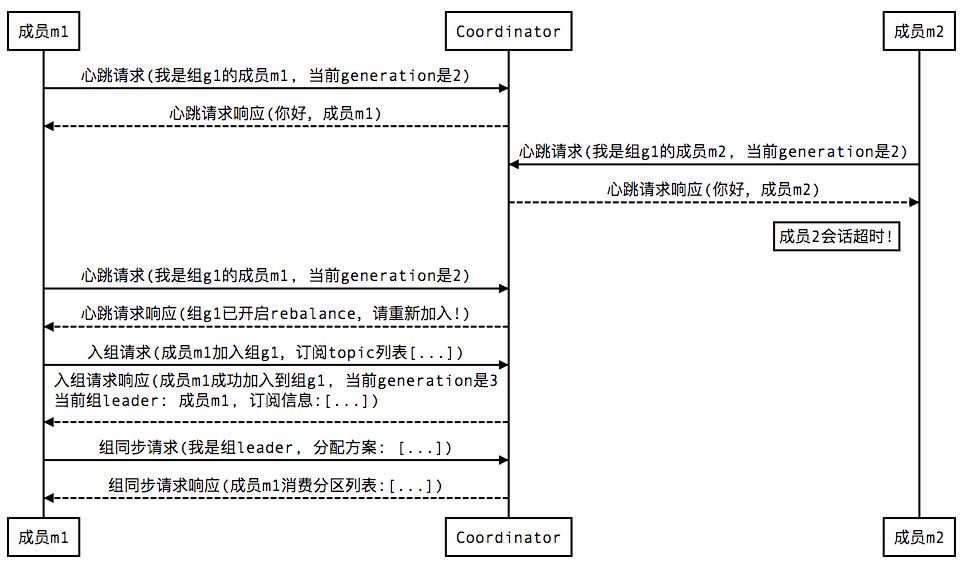
2 组成员崩溃(member failure)
前面说过了,组成员崩溃和组成员主动离开是两个不同的场景。因为在崩溃时成员并不会主动地告知coordinator此事,coordinator有可能需要一个完整的session.timeout周期才能检测到这种崩溃,这必然会造成consumer的滞后。可以说离开组是主动地发起rebalance;而崩溃则是被动地发起rebalance。okay,直接上图:
3 组成员主动离组(member leave group)
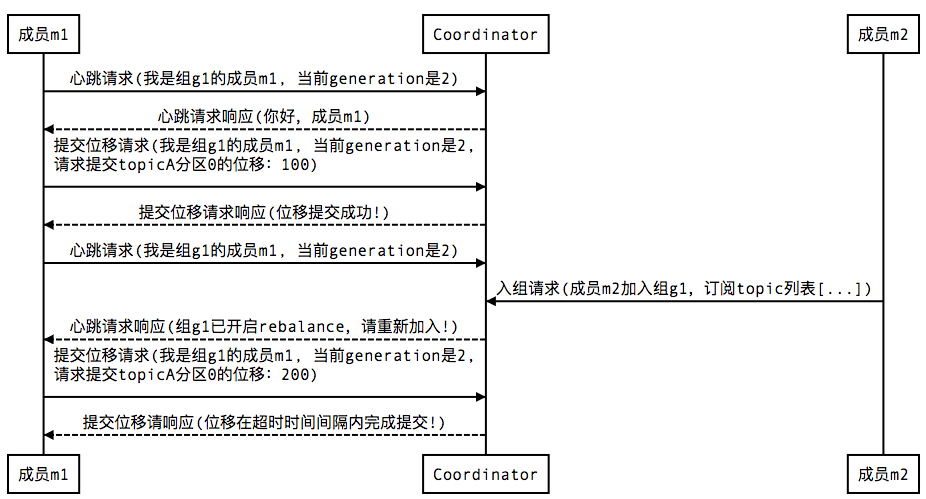
4 提交位移(member commit offset)

 浙公网安备 33010602011771号