
DeepSeek-V4-Flash-Vision-Exp 部署实战:用 GPUStack 搭建多模态 Agent 服务
 DeepSeek-V4-Flash-Vision-Exp 正式开源,多模态 Agent 能力进一步升级。本文基于 4 卡 H20-96G 环境,实测如何通过 GPUStack 完成模型部署,并验证图像理解、工具调用及推理性能,带你快速跑通 DeepSeek V4 首个多模态版本。
DeepSeek-V4-Flash-Vision-Exp 是 DeepSeek V4 系列的第一个多模态版本:2026 年 8 月 21 日先以 deepseek-v4-flash-vision-exp 的 Model ID 上线官方 API,8 月 31 日又在 Hugging Face 完整开源权重。它不是从头训练的多模态模型,而是在纯文本底座 V4-Flash 之上续训出视觉能力——保留了原本就很强的文本 Agent 水准,再叠加“看图做任务”的能力。
官方公布的 Agent 指标中,Agents' Last Exam(27.3)和 ZeroBench Pass@5(35.0)两项超过 Claude Opus-4.8,Chartography 图表理解得分为 64.3,仅差 0.7 分。也就是说,它已经不只是“能识图”,而是能把截图、图表和 UI 界面直接接入 Agent 链路并完成任务。
先来看一下官方的基准测试:
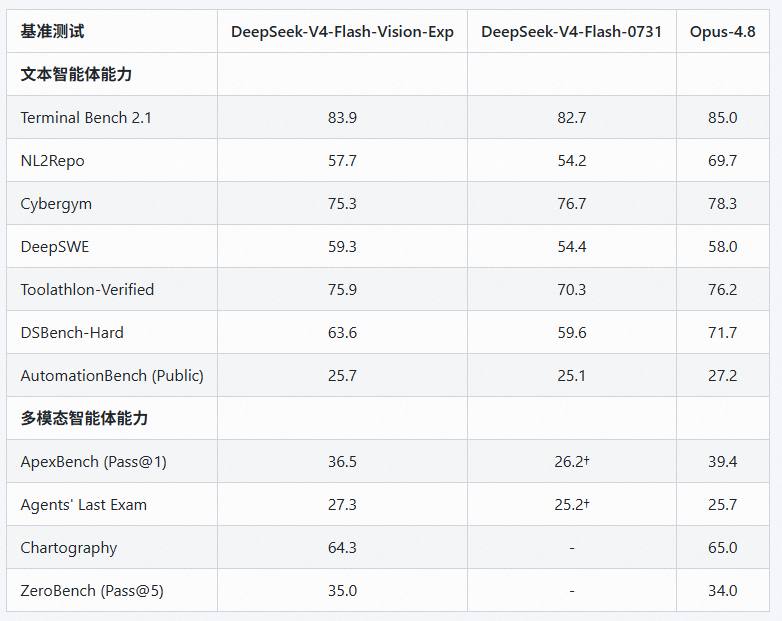
官方强调的重点是“加视觉不掉文本”:Terminal Bench 2.1 从 82.7 提升到 83.9,DeepSWE 59.3、Toolathlon-Verified 75.9 两项甚至小幅反超 Opus-4.8。
一、在 GPUStack 上部署 DeepSeek-V4-Flash-Vision-Exp
Vision-Exp 是 8 月底才开源的实验性模型,涉及 DFlash Attention、Hyper-Connections、DSpark 自投机 等一整套新结构,普通 vLLM 版本跑不起来,必须用 DeepSeek 官方维护的专用镜像 vllm/vllm-openai:deepseekv4-flash-vision。好在这件事在 GPUStack 里只需要在「推理后端」加一个版本,剩下的部署流程仍然是 Web 界面几步完成。
测试环境:4 张 H20-96G 显卡,Driver Version 570.172.08,CUDA Version 12.8。
1. 进入「推理后端」,为 vLLM 添加 deepseekv4-flash-vision 版本
关键顺序:必须先在「推理后端」里加好这个镜像版本,部署页面的「后端版本」下拉框才能选到它。
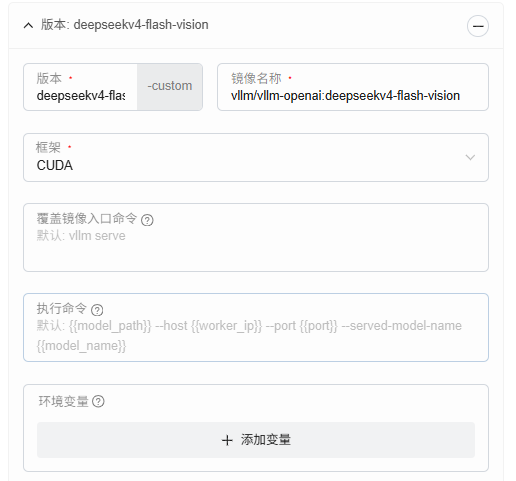
左侧菜单进入 推理后端,找到 vLLM 卡片点「编辑」,在「版本配置」里点「添加版本」。
- 版本号:填
deepseekv4-flash-vision(与镜像 tag 对应,便于识别) - 镜像名称:填写
vllm/vllm-openai:deepseekv4-flash-vision(V4-Flash-Vision 专用版本) - 框架:选择 CUDA
保存后即得到一个可选的 deepseekv4-flash-vision 版本。
2. 新建部署,选择模型与后端
回到 部署 页面,点右上角「部署模型」,按下图填写基本信息:
- 来源:选择 ModelScope(国内下载更稳定),仓库 ID 填写
deepseek-ai/DeepSeek-V4-Flash-Vision-Exp。 - 后端:选择 vLLM。
- 后端版本:选择刚才添加的
deepseekv4-flash-vision版本。
305B 的权重下载耗时较长(FP8 分片在 300GB 量级),建议先确认数据盘空间充足,GPUStack 会显示下载进度,耐心等它拉完再进入下一步。
3. 配置后端参数
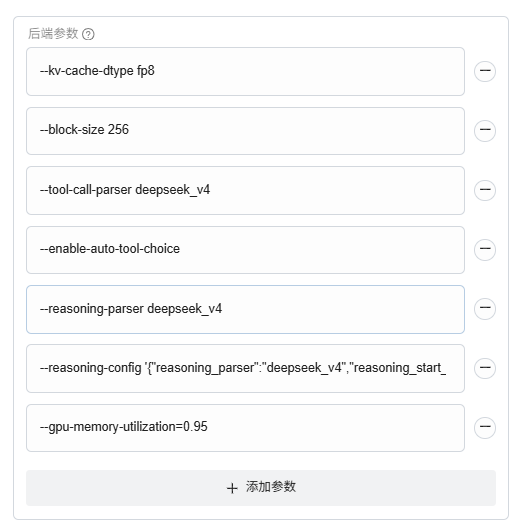
在「高级」里逐项填入后端参数:
--kv-cache-dtype fp8
--block-size 256
--tool-call-parser deepseek_v4
--enable-auto-tool-choice
--reasoning-parser deepseek_v4
--reasoning-config {"reasoning_parser":"deepseek_v4","reasoning_start_str":"","reasoning_end_str":""}
--gpu-memory-utilization=0.95
关键点说明:
--kv-cache-dtype fp8+--block-size 256:KV 缓存以 FP8 存储,相比 BF16 省一半显存;大 block size 是官方 recipe 的推荐搭配,长上下文下的 PagedAttention 开销更小。--tool-call-parser deepseek_v4+--enable-auto-tool-choice+--reasoning-parser deepseek_v4:打开 V4 的工具调用与思考链解析,是它 Agent 能力的核心开关。配套的--reasoning-config把reasoning_start_str/reasoning_end_str置空,交给解析器自动处理。
提交后实例进入 Running 即部署完成。
二、验证与调用
1. 试验场交互
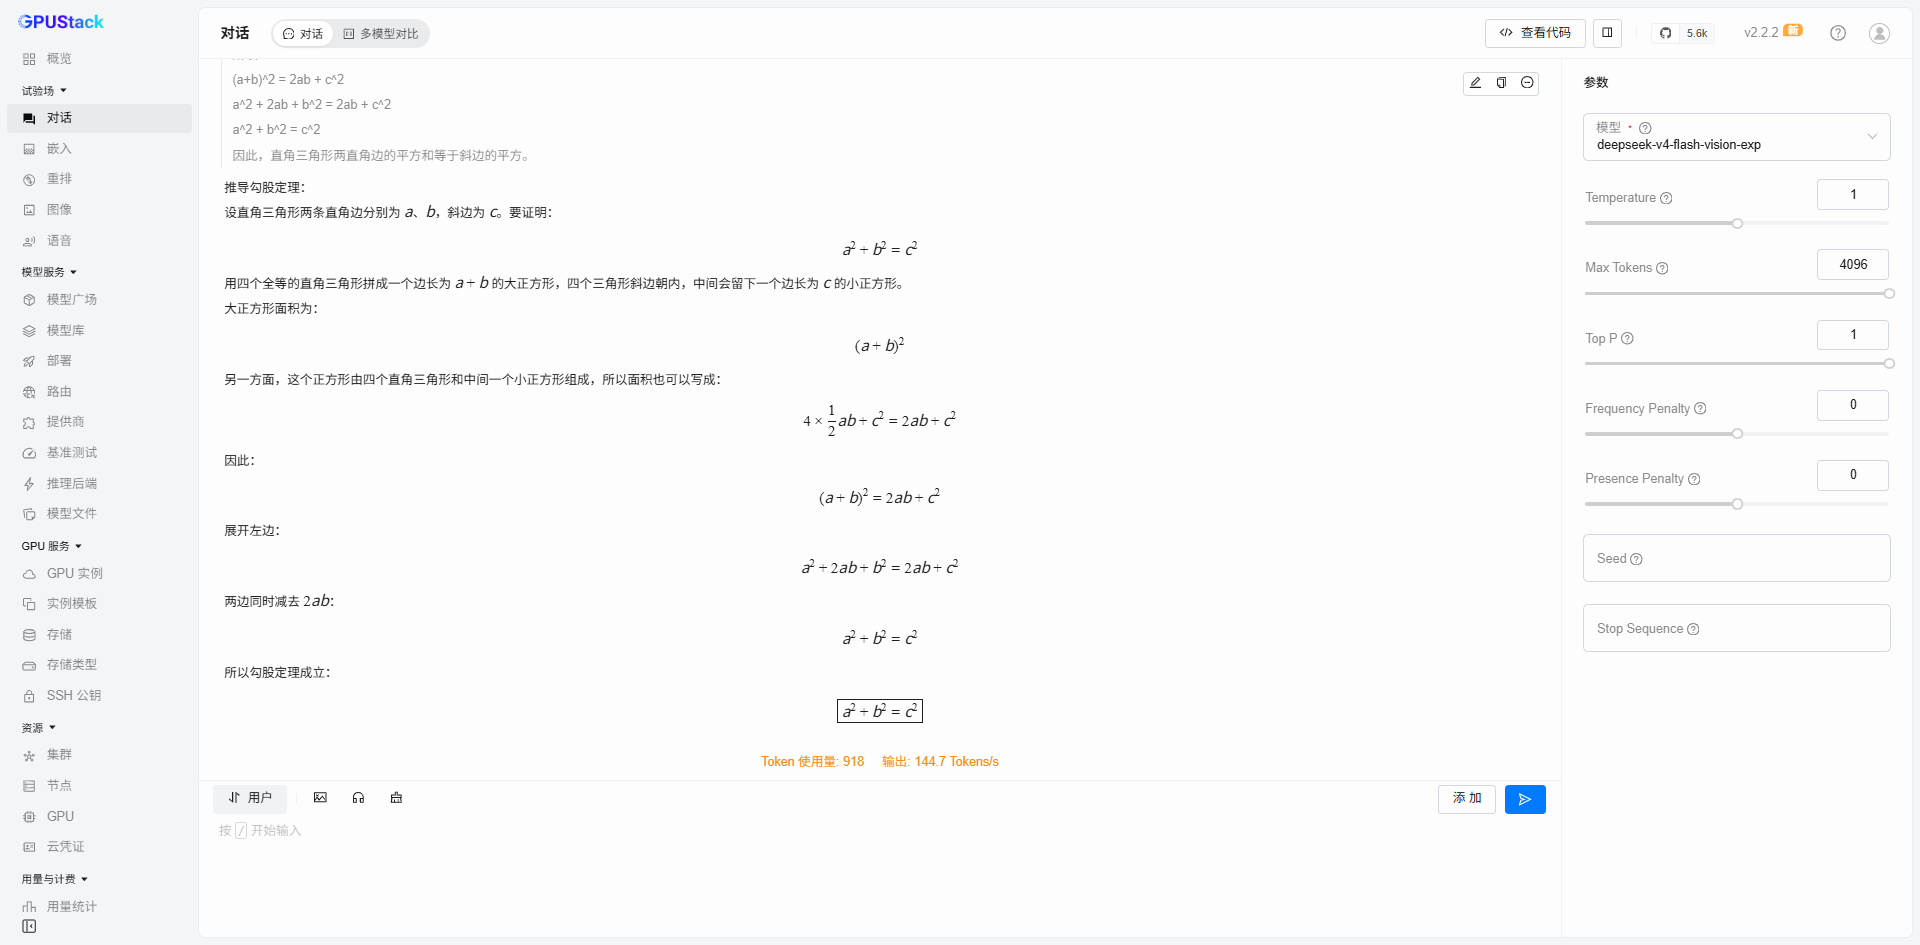
直接在 GPUStack 试验场中对话,观察右下角的实时输出吞吐。
2. 多模态实测:让模型“看图干活”
直接在 GPUStack 试验场中进行对话,测试模型的多模态能力。
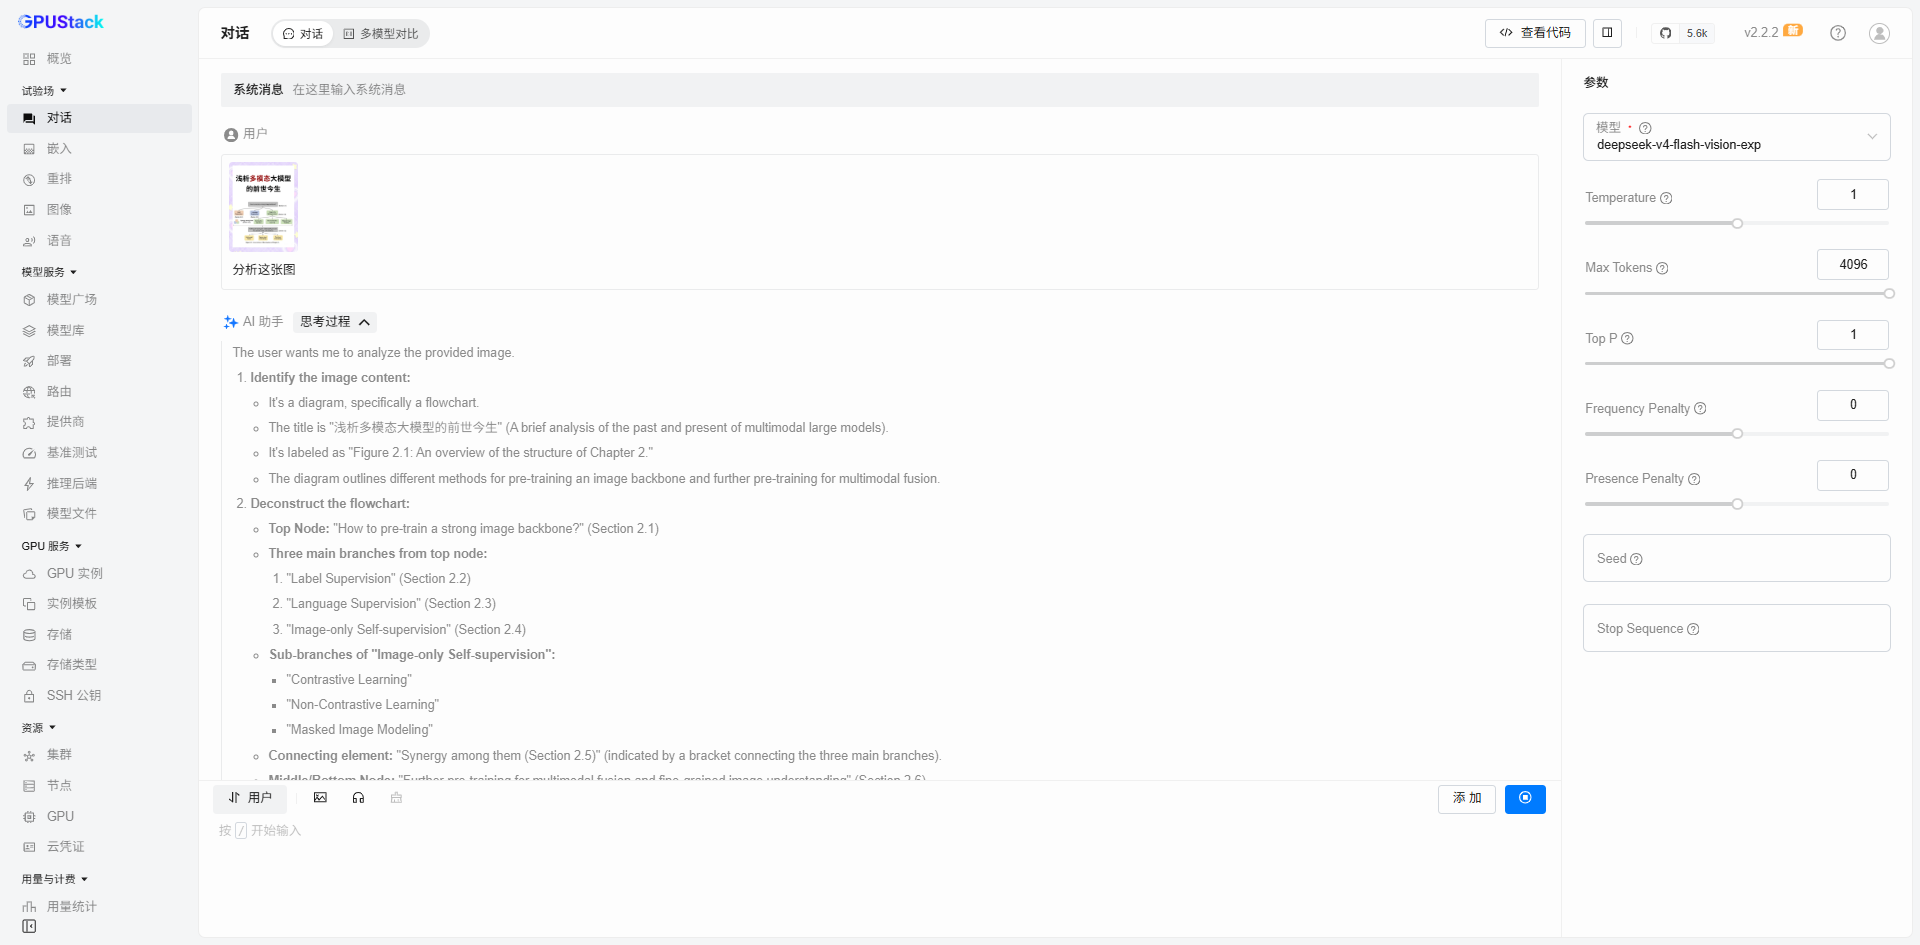
可以看到,此时 DeepSeek 已经能够识别图像并回答相关问题。
3. 基准测试
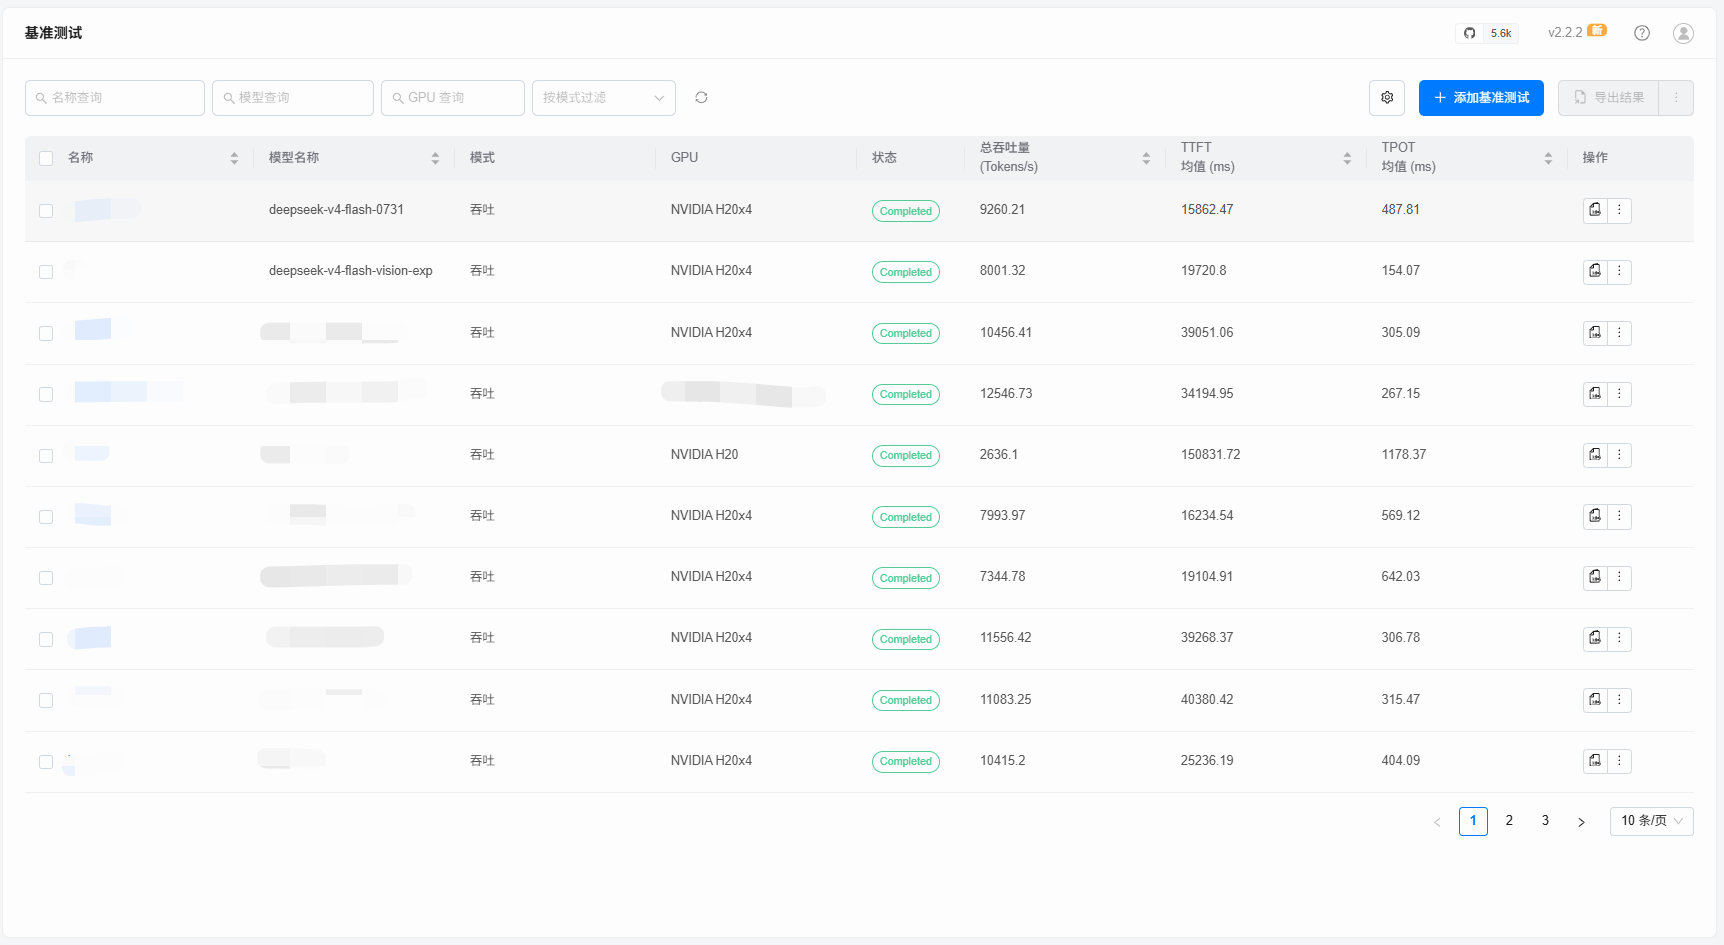
部署进入 Running 状态后,打开 GPUStack 基准测试,在同一台机器上分别测试 deepseek-v4-flash-vision-exp 和 deepseek-v4-flash-0731,整体吞吐表现如下:
总结
DeepSeek-V4-Flash-Vision-Exp 是第一个把“多模态 Agent”能力做到接近顶级闭源模型水平的开源权重模型,并采用 MIT 协议——商用、私有化和微调都没有障碍。
借助 GPUStack 可插拔的 vLLM 后端,这件事被压缩成了三步:添加一个官方专用镜像版本 → 选 ModelScope 仓库 → 填后端参数。把 deepseek_v4 的工具调用 / 推理解析器、FP8 KV 缓存都打开之后,一个支持图文混合输入、带工具调用的 Agent 服务就跑起来了,试验场和 OpenAI 兼容接口都能直接用。
对搭建企业内部 MaaS 平台的团队来说,这是一个很值得 Day 0 就拉起来评测的模型——尤其是那些“要读截图、读图表、读 UI 才能完成任务”的场景。这些场景以前只能调用闭源 API,现在则有了可私有化部署的选项。
实测参考环境:4 卡 H20-96G | Driver Version 570.172.08 | CUDA Version 12.8 | GPUStack v2.2.2 | vLLM 镜像
vllm/vllm-openai:deepseekv4-flash-vision注意:Vision-Exp 仍是 Experimental 版本,权重与接口可能变动,建议先做评测再考虑生产。

 浙公网安备 33010602011771号