
NumPy ndarray 跟原生python列表的区别
NumPy提供了一个N维数组类型 ndarray,它描述了相同类型的“items”的集合。
ndarray 跟原生python列表的区别:
(1)从下图中可以看出ndarray在存储数据的时候,数据与数据的地址都是连续的,这样就使得批量操作数组元素时速度更快。
这是因为ndarray中的所有元素的类型都是相同的,而Python列表中的元素类型是任意的,所以ndarray在存储元素时内存可以连续,而python原生list就只能通过寻址方式找到下一个元素,这虽然也导致了在通用性能方面NumPy的ndarray不及Python原生list,但在科学计算中,NumPy的ndarray就可以省掉很多循环语句,代码使用方面比Python原生list简单得多。
(2)NumPy内置了并行运算功能,当系统有多个核心时,做某种计算时,NumPy会自动做并行计算。
(3)NumPy底层使用C语言编写,数组中直接存储对象,而不是存储对象指针,所以其运算效率远高于纯Python代码。
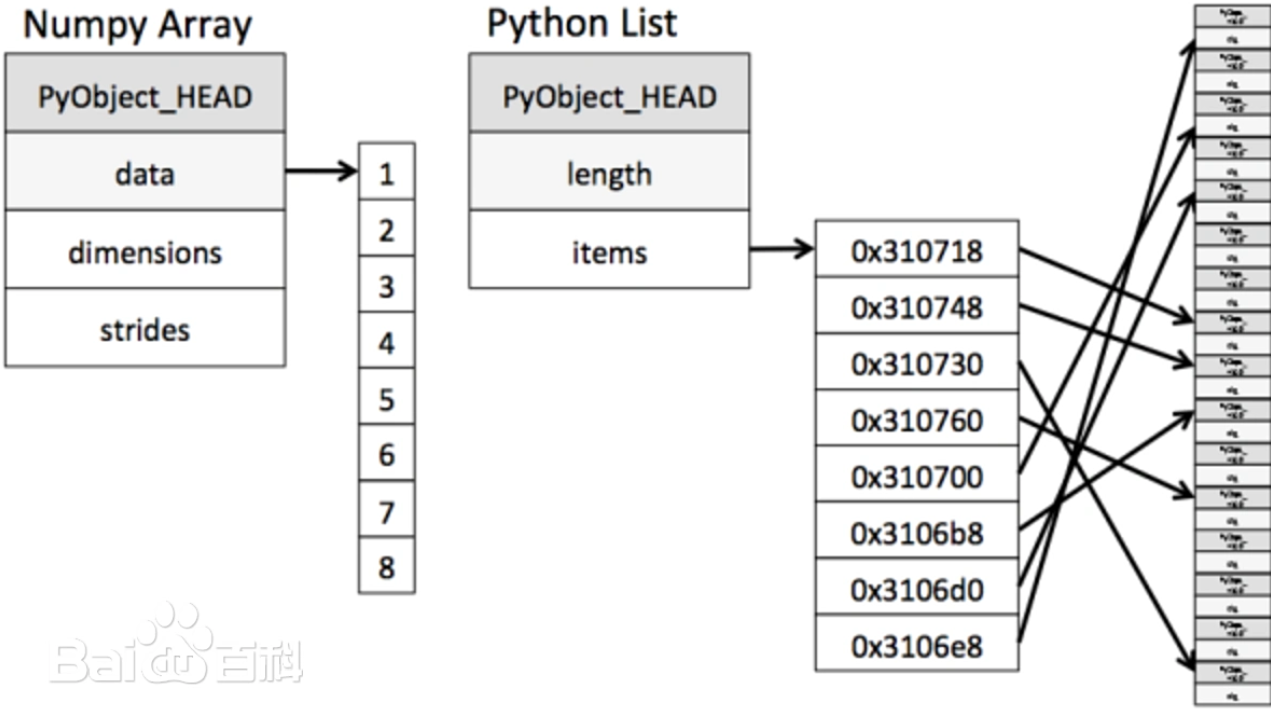
如何查看 np.array ([ 7, 2, 9, 10] ) 中各个元素的地址
numpy 数组里的元素,不是独立 Python 对象!不能直接用
id()拿到每个元素单独的 Python 对象地址;id(arr[i])拿到的是「临时包装出来的 Python 标量」的地址,不是数组内存里的地址。
我们分两种地址:
- ✅ 数组缓冲区里,每个元素在内存中的字节地址(C 层内存地址,这才是 numpy 真正的元素地址)
- ❌
id(arr[i]):取到的是临时新建的 Python 对象 id,每次都变,没有参考意义
方法 :查看每个元素在数组内存中的地址(正确方式)
用 arr.ctypes 接口(ctypes 暴露数组底层内存)
import numpy as np

arr = np.array([7, 2, 9, 10])
print("数组起始地址:", arr.ctypes.data)
print("单个元素字节大小:", arr.itemsize)

for i in range(arr.size):
    elem_addr = arr.ctypes.data + i * arr.itemsize
    val = arr[i]
    print(f"索引{i}, 值={val}, 内存地址={hex(elem_addr)}")
输出示例:
数组起始地址: 140237084472832
单个元素字节大小: 8
索引0, 值=7, 内存地址=0x7f8c84080700
索引1, 值=2, 内存地址=0x7f8c84080708
索引2, 值=9, 内存地址=0x7f8c84080710
索引3, 值=10, 内存地址=0x7f8c84080718
- 地址是连续的,间隔
itemsize(int64 就是 8 字节),符合 C 数组布局。
这个地址是操作系统虚拟内存地址,和 C/C++ 拿到的指针地址一致。
查看python中 list arr=[7, 2, 9, 10] 中各个元素的地址。
Python 的 list 和 numpy array 完全不一样: list 本身存的不是数字本身,而是一堆指针(每个指针指向一个独立的 Python 对象)。 arr = [7, 2, 9, 10] 这个列表里面装的是 4 个指针,分别指向整数对象 7、2、9、10。
id(x) 拿到的就是这个整数对象的内存地址。
arr = [7, 2, 9, 10]
for idx, val in enumerate(arr):
    print(f"list[{idx}] = {val}, id(val) = {hex(id(val))}")
运行结果示例(每次运行地址会变)
list[0] = 7, id(val) = 0x7f123abc1230
list[1] = 2, id(val) = 0x7f123abc11e0
list[2] = 9, id(val) = 0x7f123abc1280
list[3] = 10, id(val) = 0x7f123abc12a0
重要坑点(一定要理解)
- 小整数池:
-5 ~ 256的整数,Python 会提前缓存、复用对象!
a = 7
b = 7
print(id(a) == id(b)) # True,同一个对象
所以如果你在别的地方写 x=7,id(x) 和这里 id(arr[0]) 是一模一样的。
- list 本身的元素(指针)也有自己的内存位置(列表是一块连续空间存指针) 如果你想看 列表内部每个指针本身的地址(很少用到),标准 Python 没有直接 API,因为列表的底层结构体是 C 实现,不直接暴露。日常大家说 “查看 list 元素地址”,都是指
id(元素)。 - 和刚才 numpy 数组对比
- ✅ numpy array:一块连续内存,直接存原始数值;
arr[i]是临时生成的标量包装 - ✅ Python list:一块连续内存存指针,每个指针跳去别的地方找真实对象
list [ 指针0 | 指针1 | 指针2 | 指针3 ]
        ↓       ↓       ↓       ↓
      对象7    对象2    对象9    对象10
拓展对比代码,一眼看清差异
import numpy as np

# Python list
lst = [7,2,9,10]
print("==== Python list ====")
for v in lst:
    print(v, hex(id(v)))

# numpy array
narr = np.array([7,2,9,10])
print("\n==== numpy array ====")
base = narr.ctypes.data
for i in range(narr.size):
    addr = base + i * narr.itemsize
    print(narr[i], hex(addr))
内存示意图
1. Python list:lst = [7, 2, 9, 10]
list 内部存的是指针,指针指向分散在堆上的独立整数对象
列表lst(一块连续内存,存放4个指针)
+------------+------------+------------+------------+
| 指针P0      | 指针P1      | 指针P2      | 指针P3     |
+------------+------------+------------+------------+
     ↓            ↓             ↓            ↓
  +-------+    +-------+    +-------+    +--------+
  | int 7 |    | int 2 |    | int 9 |    | int 10 |
  +-------+    +-------+    +-------+    +--------+
id(7)就是这里对象的地址
👉 7、2、9、10 都是独立Python对象;小整数会被全局缓存复用
2. Numpy array:narr = np.array([7,2,9,10])
一块连续的原生 C 类型内存,直接存数字本身,没有指针跳转
narr 底层缓冲区(连续内存)
+--------+--------+--------+---------+
|   7    |   2    |   9    |   10    |
+--------+--------+--------+---------+
↑首地址base
每个元素紧挨着,间隔 itemsize(int64占8字节)
地址 = base + i * itemsize
👉 这里没有独立Python对象!arr[i]只是临时包装出来的
一句话对比
- list:间接访问,列表里放地址,再跳去找值;元素对象分散
- np.array:直接一块连续内存存原始数值,紧凑、CPU 访问更快,适合数据集、机器人训练

 浙公网安备 33010602011771号