实测Gemini 4 Argon:知识工作强劲但体验糟糕,卡兹克称难撼Claude Opus 5.5与GPT-6 Astra
摘要:Gemini 4 Argon于10月13日全面开放,Pro会员可在Gemini APP使用,Antigravity需100刀Ultra会员。作者实测认为其知识类专业能力强,Vals Index综合第一(68.9)且单次成本仅15.68美元,但CUA-bench仅4.83%排倒数第二;前端效果不及GPT-6 Astra,额度消耗快,中文写作味道重,整体体验糟糕,不建议订阅Ultra。
开篇:跑分与现实之间
Google在9月30日发布Gemini 4 Argon时,把姿态放得很低——先只对Fairwind计划的网络安全防御人员开放,再逐步释放给API付费客户、Ultra订阅用户,最后才轮到普通消费者。这一阶段开放的节奏本身就说明问题:模型还没完全调顺,需要先让一小批高信任度用户踩坑。
10月13日全面开放后,实际用起来才发现跑分和体验之间的鸿沟。Argon在Vals Index拿到68.9%,超过了GPT-6 Astra的63.1%和Claude Opus 5.5的65.8%,排第一。但这是综合得分,真正的细节藏在各个子测试里。
基准测试数据拆解
知识工作领先
Argon的强项集中在法律、金融和长上下文任务。Harvey Legal Agent Benchmark上拿到19.6%,对手GPT-6 Astra只有5.4%,Claude Opus 5.5仅3.8%。AutomationBench上51.3%,领先Astra的41.4%和Opus 5.5的42.5%。
GraphWalks长文本图遍历测试,Argon在25.6万到100万token的材料长度下拿到84.2%,三家对手分别是71.8%、65.0%、66.8%。LVBench长视频理解91.7%,也排第一。
DeepSWE v1.1多步软件工程任务,Argon 77.9%,略超Astra的74.1%和Opus 5.5的74.2%——这个差距小到可以忽略。

长文档分析时,Argon确实能咬住大量材料不丢
终端与编程偏弱
Terminal-bench 4.0命令行操作,Argon 57.4%,四家里最低,Opus 5.5以66.4%领先。FrontierSWE v2真实软件工程任务,Argon 55.0%,Astra以65.5%胜出。PostTrainBench机器学习工程,Opus 5.5的49.3%高于Argon的45.3%。Terminal-Bench Science科学计算,Astra 68.1%对Argon 57.6%。OSWorld-2.0离线子集,Astra 72.6%对Argon 69.2%。
人工分析平台Artificial Analysis的Intelligence Index,Argon 52.6分,Astra 52.7分,Opus 5.5 57.6分。差距不大,但Opus 5.5始终领先约5分。
跑分上的数字差异,落到实际Agent调用时可能完全反转
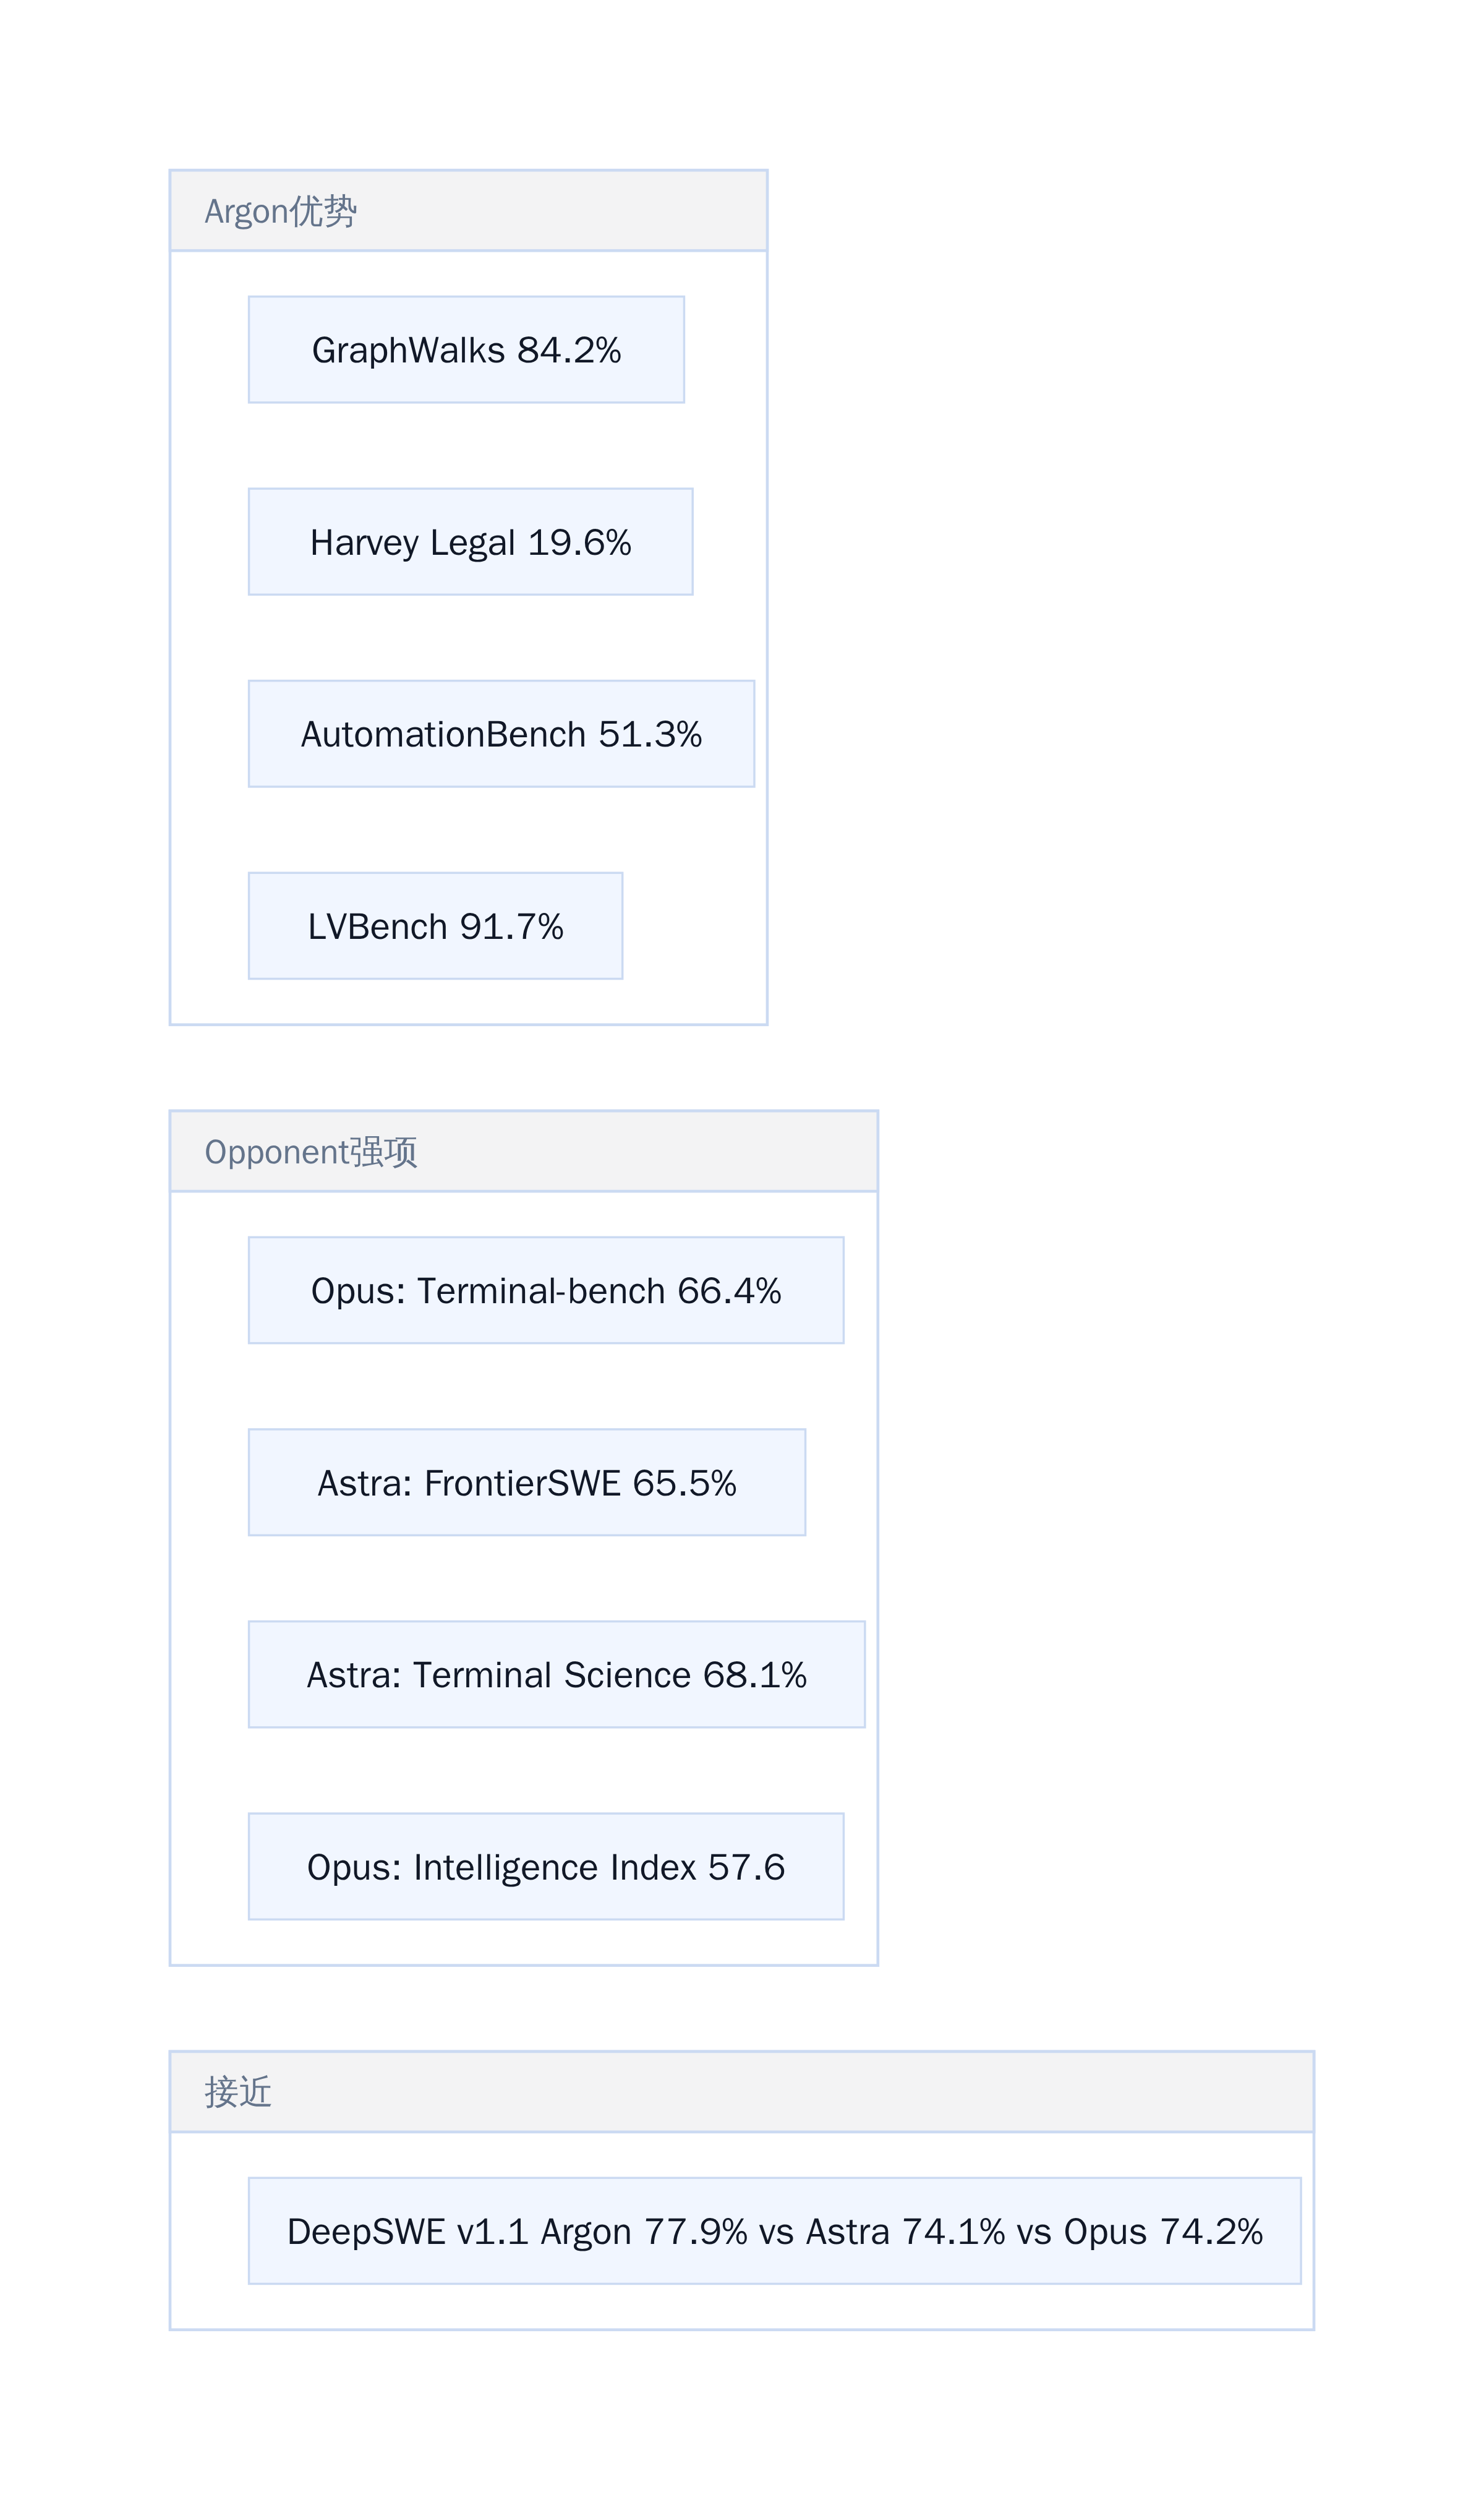
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 基准对比
体验问题:额度、中文味、前端落差
额度消耗是个明显的坑。Argon的输入token消耗速度快于预期,单次任务输出token量也比Astra多出一倍以上。Launch期定价输入每百万token $2、输出$10,约等于Opus 5.5五分之一的价格。但跑完全流程后,实际花费接近翻倍后的价格——输入$4、输出$20。
中文写作风格也是个问题。Argon的输出有明显的训练数据痕迹,句式模板化,读起来不像人写的。同样一段内容换到Astra或Opus上,会自然很多。这不是能力问题,是风格对齐没做好。
前端效果不及GPT-6 Astra。在同样的Prompt下,Astra的前端响应速度和输出质量更稳定,Argon偶尔会出现中断或格式错乱。
前端体验的波动,往往来自后端token消耗的不透明
结论与取舍建议
Argon的定位很清晰:知识密集型工作、长上下文分析、法律金融自动化流程,这是它的舒适区。在这些场景下,单次任务成本约15.68美元,比Astra便宜60%,有价格优势。
但如果是终端操作、实时Agent调用、追求自然中文输出的场景,Astra或Opus 5.5更合适。CUA-bench 4.83%的倒数第二成绩不是偶发,是模型设计取向导致的系统性弱点。
不建议普通用户订阅100刀的Ultra。如果你是安全研究人员或法律金融领域的长期用户,等Launch折扣结束前再决定也不迟。Argon不是替代品,是补充品。
跑分再好看,落到生产环境才是真考验
基准之外的真实差异
跑分好看不等于落地顺手。Argon在DeepSWE v1.1拿到77.9%,领先Opus 5.5的74.2%约3.7个百分点,这条赛道上它确实赢了一小步。但同样的模型在FrontierSWE v2上只有55.0%,落后Astra的65.5%整整10.5分,Terminal-bench 4.0的57.4%也是四家中最低。
问题在于:这两个基准测试的是同一类人吗?DeepSWE侧重多步推理完成的代码任务,FrontierSWE更接近真实复杂工程场景,要求模型在长流程中保持稳定性。Argon的短板不是「不会编程」,而是它在需要反复调试、回退、跨模块协调的场景里容易丢状态。
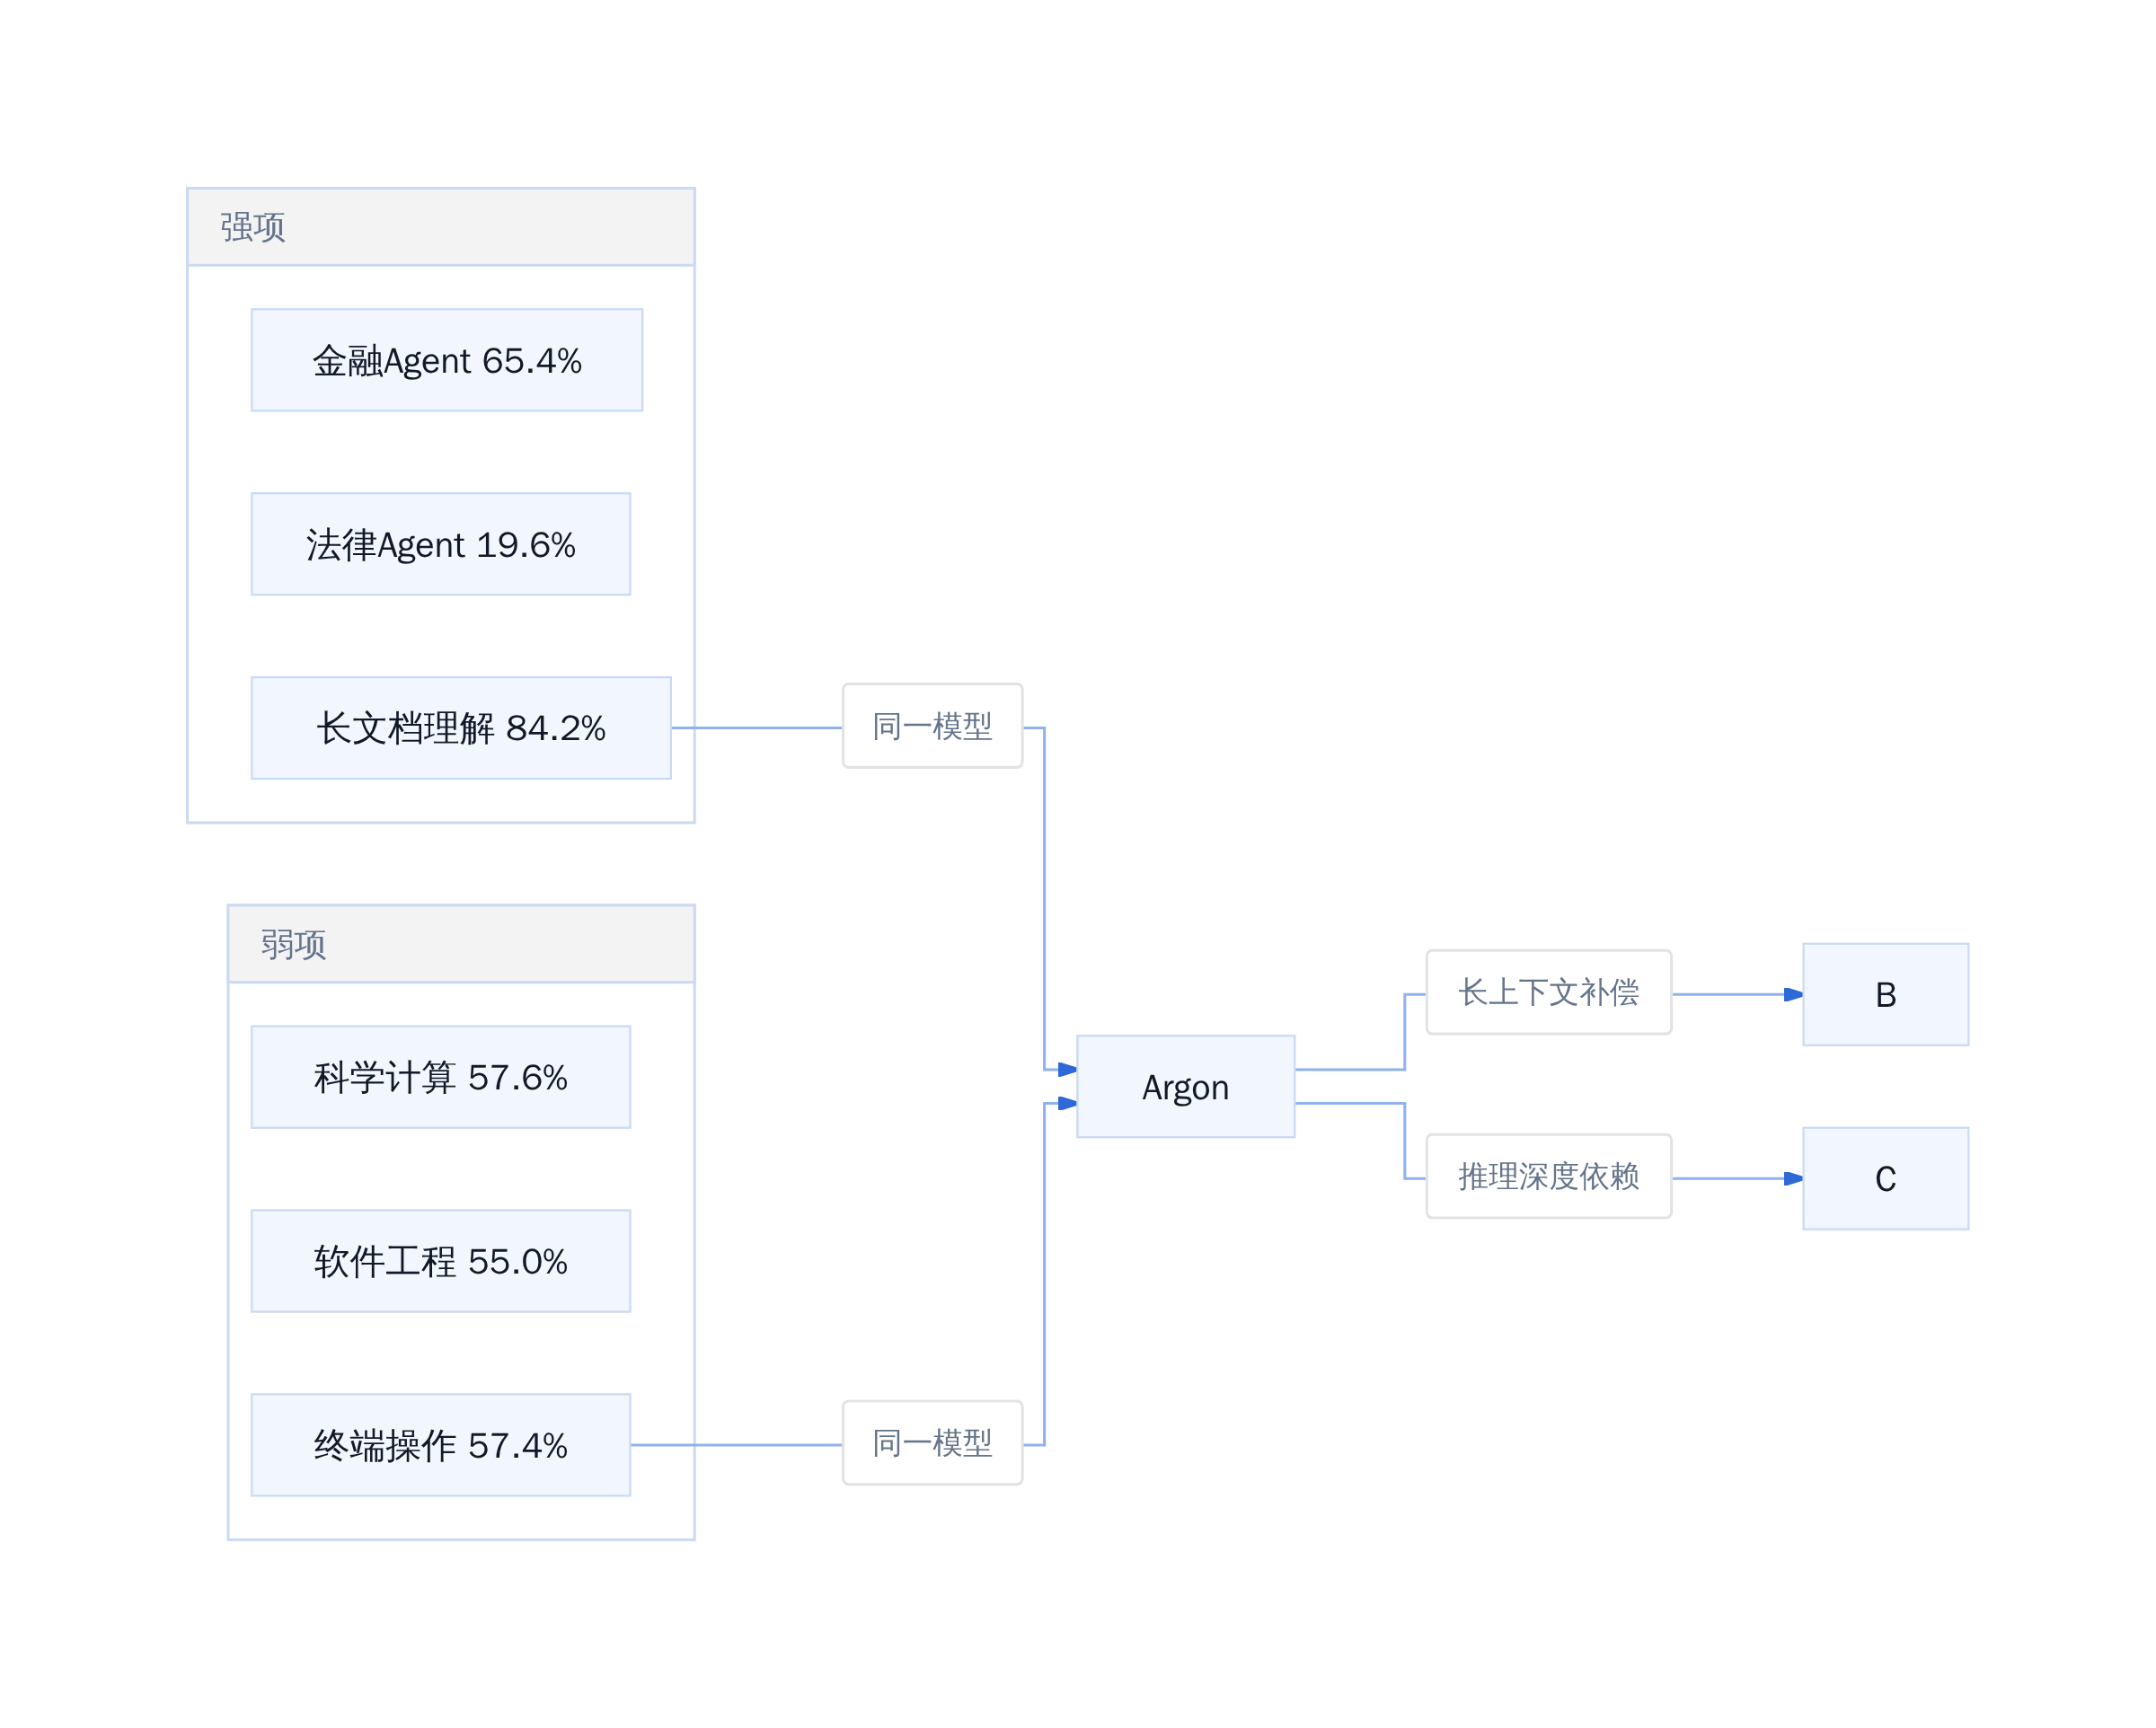
Gemini 4 Argon能力光谱
更准确地说,Argon的优势来自它的两个硬参数:最长1M token输出,以及$2/1M输入、$10/1M输出的定价。这意味着它在「把一堆材料吃进去、再把完整报告吐出来」这个循环里,成本比对手低得多。Kazike在分析中指出,真正的差距不在于绝对能力,而在于输出长度与成本控制形成的性价比窗口。
体验层的摩擦
额度消耗快是第一个现实问题。用户反映,同样一个复杂任务,Argon消耗的token数是GPT-6 Astra的两倍还多。这不是幻觉——它的输出token数确实更高,有时甚至接近输出上限。
中文写作味道重是第二个痛点。模型在处理中文prompt时,输出语句的节奏、连接词的使用频率,都与Claude或GPT系列有明显差异。对需要「读起来像人」的内容生产场景,这种差异会造成明显的违和感。
落地建议:谁该用、怎么用
在长文档分析、法律合同审查、金融数据处理这类知识密集型工作里,Argon的成本优势足以抵消体验上的摩擦。单次任务15.68美元的价格,配合1M输出的能力,对需要反复迭代输出的团队来说是有意义的。
但在终端驱动型工程场景——尤其是需要频繁shell操作、多步调试、跨环境协作的场景——建议保持谨慎。FrontierSWE和Terminal-bench的低分不是偶然,它们是真实工作流的缩影。
最终取舍很明确:知识工作团队可以小规模试点,用它的长输出和低成本换取效率;终端型工程团队别急于切换,等下一版修正或等竞品跟进后再评估。
卡兹克称难撼Claude Opus 5.5与GPT-6 Astra
卡兹克的核心判断是:Argon 在跑分上追平了 Astra,但还没到能撼动 Opus 5.5 的位置。Intelligence Index 上 58 vs 53 的差距,不是小数点后的噪音,而是连续推理能力和多步任务稳定性的综合体现。
更准确地说,Opus 5.5 的优势不在单一基准,而在跨域一致性。Legal Agent、Finance Agent、代码评审、科学推理,Opus 5.5 没有一个明显的短板。Argon 则是典型的偏科生——长文档和法律金融分析是强项,但编程、终端操作、科学计算三项测试均落后。
这背后的机制在于架构取舍。Argon 的 100 万 token 输出上限是真正的卖点,但在终端交互类任务中,模型需要的不是更长记忆,而是更精准的指令理解和工具调用能力。Terminal-bench 和 OSWorld 的得分恰恰暴露了这一点。
参考文献
[1] Gemini 4 Matches GPT-6 Astra but Trails Opus 5.5 | Trending Topics. https://www.trendingtopics.eu/gemini-4-artificial-analysis-en
[2] Gemini 4 Argon matches GPT-6 Astra and hallucinates far.... https://daily.dev/posts/gemini-4-argon-matches-gpt-6-astra-and-hallucinates-far-less-in-early-tests-pxnxyclp2
[3] 宝玉 on X: "谷歌发布新一代旗舰模型 Gemini 4 Argon。 谷歌在跑分表里拿它和 OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Fable 5.1 和 Claude Opus 5.5 对比,价格却定在 GPT-6.1 Sol 和 Opus 5.5 的档位。 普通用户和开发者暂时还用不上,第一批只开放给谷歌 Fairwind 计划里的网络安全防御人员。 谷歌说会分阶段放开,同时参与美国政府的模型发布前自愿审查流程,也就是正式发布前先让政府访问模型。之后先开放给付费 API 客户和 Google AI Ultra 订阅用户,再到普通消费者,… / X. https://x.com/dotey/status/2105396970772942935
[4] Gemini 4 Argon takes on GPT-6 Astra and Claude Opus .... https://www.neowin.net/news/gemini-4-argon-takes-on-gpt-6-astra-and-claude-opus-55-with-aggressive-pricing
[5] Gemini 4 Argon vs GPT-6 Astra, Claude Opus 5.5 [2026]. https://shattered.io/gemini-4-argon-wins-1-of-4-ai-benchmarks-2026
[6] Gemini 4 Argon beats Claude Opus 5.5 and GPT-6 Astra in .... https://www.facebook.com/groups/vibecodinglife/posts/2160502424538283
[7] Google unveils Gemini 4 Argon, retaking benchmark lead over OpenAI and Anthropic — but in limited release | VentureBeat. https://venturebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release
[8] BREAKING: Gemini 4 Argon Beats GPT-6 & Claude on 12 Tests (Half Opus Price). https://www.youtube.com/watch?v=TYD71CSxWzQ
延伸入口
- 原文归档:https://tobemagic.github.io/ai-magician-blog/posts/2026/10/14/实测gemini-4-argon知识工作强劲但体验糟糕卡兹克称难撼claude-opus-55与gpt-6-astra/
- 公众号:计算机魔术师

 浙公网安备 33010602011771号