

python笔记
第 1 章 必备基础知识
计算机组成
硬件
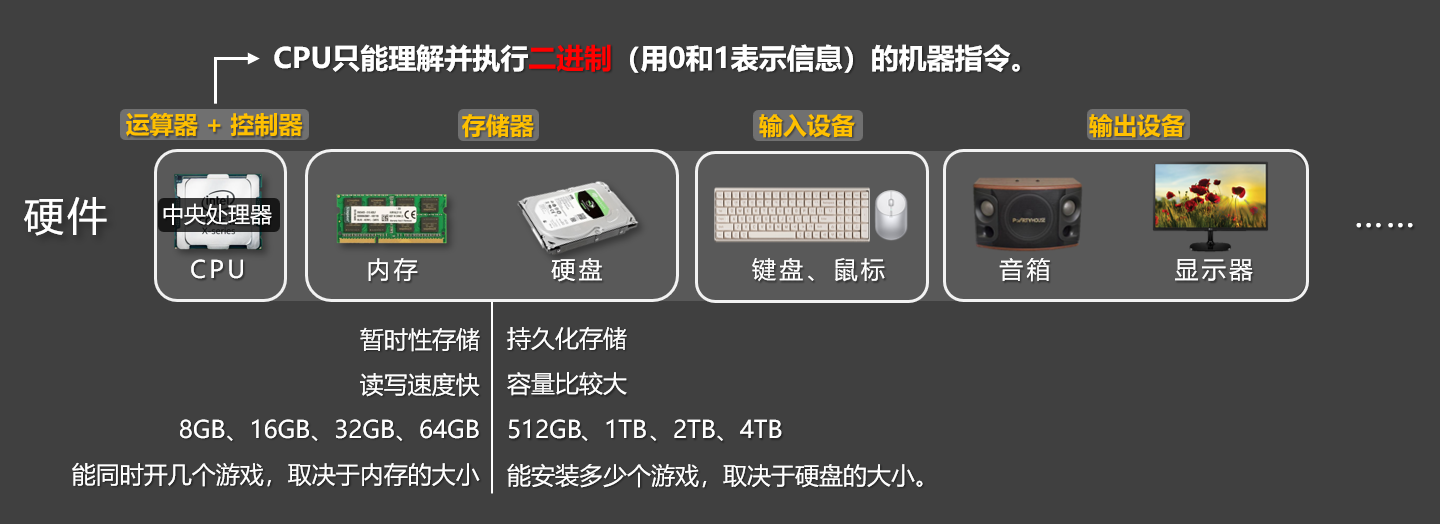
计算机硬件主要由五个部分组成,分别是:运算器、控制器、存储器、输入设备、输出设备。
:::tips
📋备注 :『运算器』和『控制器』一起组成了中央处理器(CPU)。
:::
:::color4
📢注意:计算机的 CPU 只能理解并执行二进制(用 0和1表示信息)的机器指令。
:::
:::info
内存 VS 硬盘:
- 硬盘:持久化存储,读写速度不如内存快,但容量通常比较大(500GB、1TB、2TB 等)。
- 内存:暂时性存储,读写速度快,但容量通常不如硬盘大(8GB、16GB、32GB、64GB 等)。
通俗理解:能安装多少个游戏,取决于硬盘的大小;能同时开几个游戏,取决于内存的大小。
:::
| 运算器 | 运算器(简称:ALU),专门负责执行各种『算术运算』和『逻辑运算』,它需要与控制单元、寄存器等紧密配合。 |
|---|---|
| 控制器 | 计算机的控制中心,它指挥计算机各部分协调地工作,保证计算机按照预先规定的任务,有条不紊地进行操作及处理。 |
| 存储器 | 计算机中的“资料库”,它既保存程序指令,又保存数据,各个硬件在需要访问或更新数据时,都会与它打交道,有了存储器,计算机才有“记忆”。 |
| 输入设备 | 向计算机输入数据和信息的设备,是计算机与外界通信的桥梁。 |
| 输出设备 | 用于输出计算机执行任务的结果,把各种结果数据或信息以:数字、字符、图像、声音等形式表示出来。 |
软件
计算机软件主要分为:系统软件、应用软件。
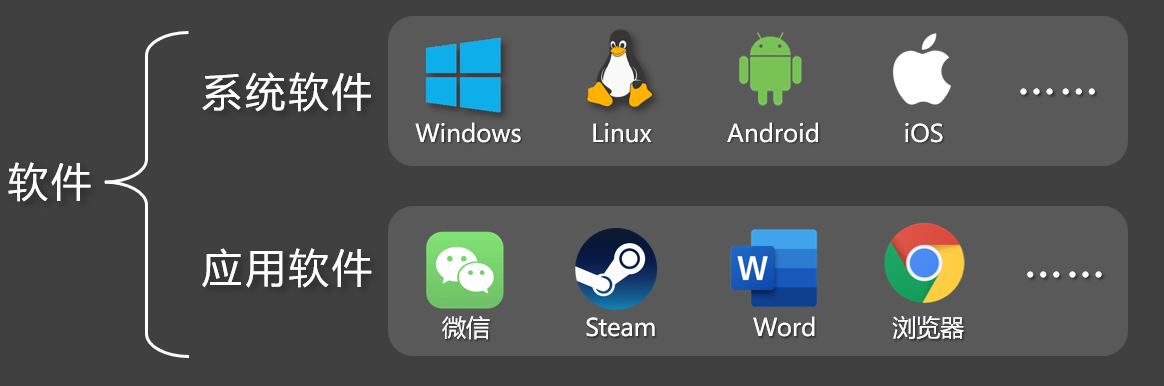
| 系统软件 | 直接管理和控制计算机硬件的软件,为应用软件提供运行平台,它负责协调硬件资源(如内存、处理器)并提供通用服务,例如:文件管理、设备控制、任务调度。 |
|---|---|
| 应用软件 | 用于执行特定任务的软件,满足用户的具体需求,如:文档编辑、数据分析、娱乐等,它依赖系统软件提供的资源和服务。 |
计算机语言、代码、程序
计算机语言
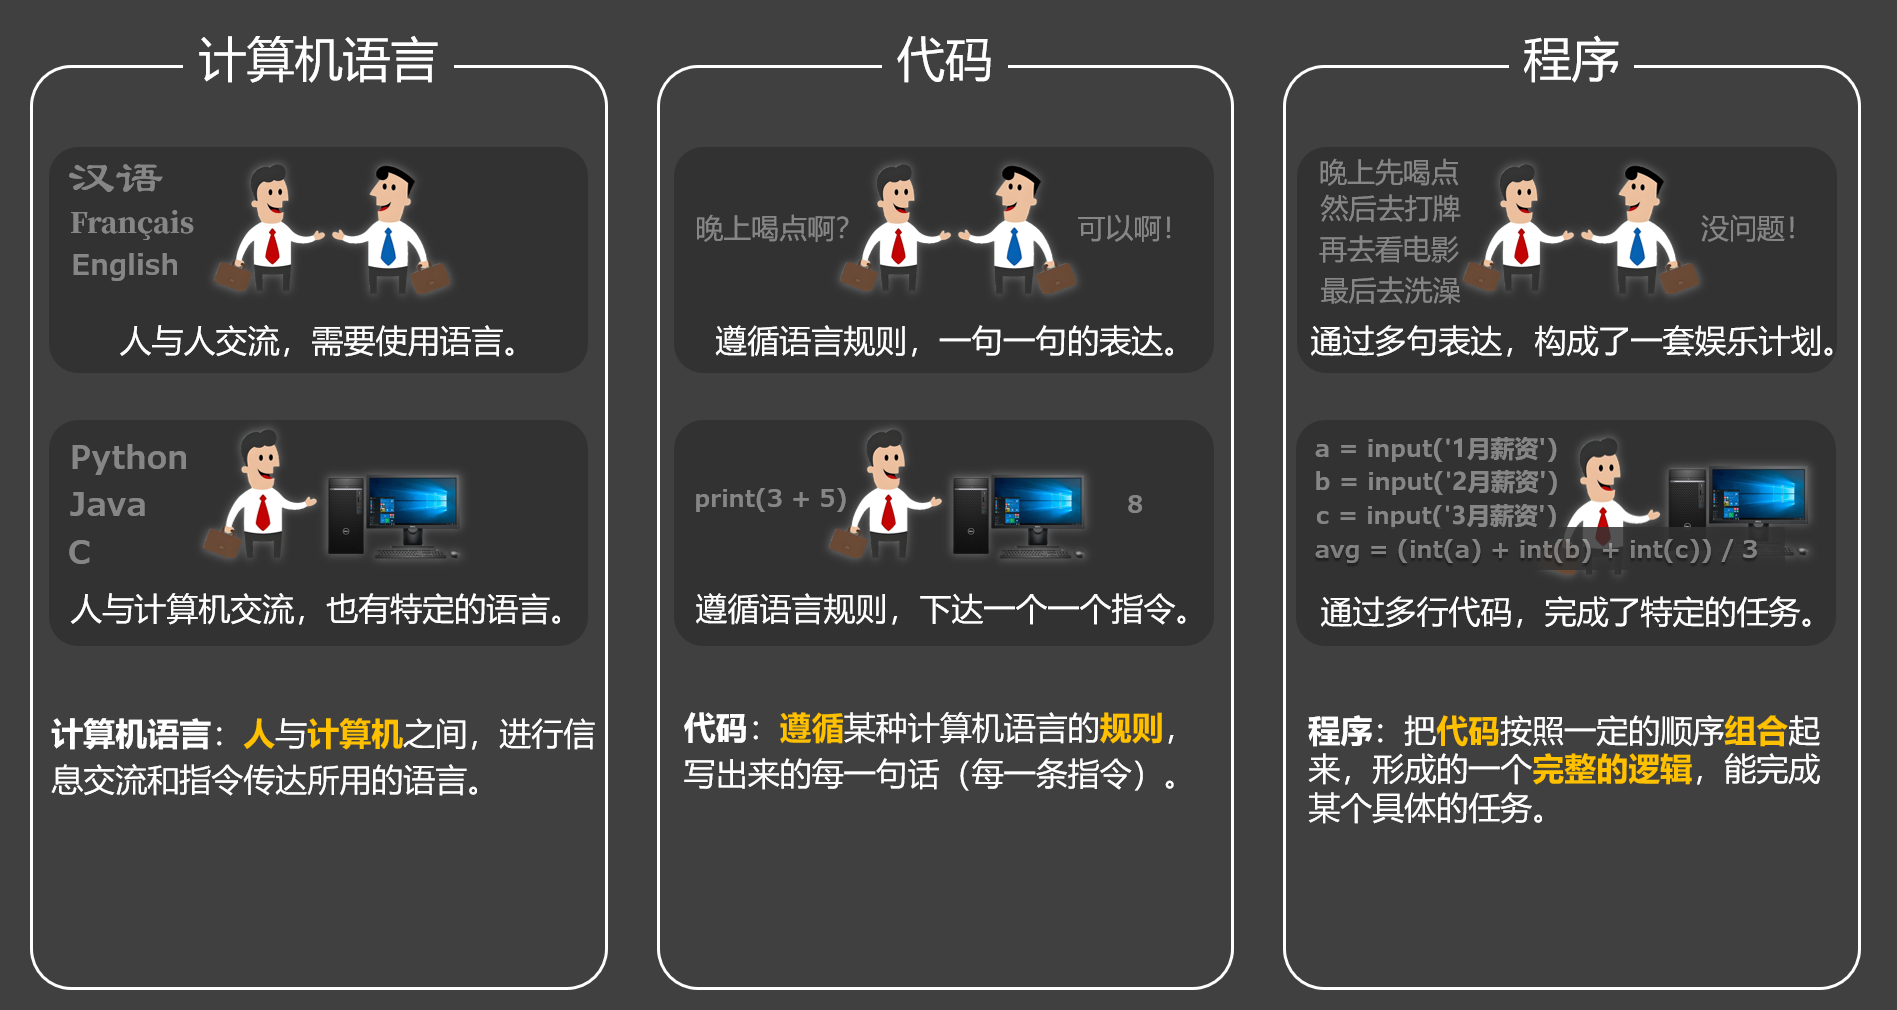
计算机语言是人类与计算机进行『交互』和『指令传达』所使用的一种形式化语言。比如:人与人之间,需要使用各种语言进行交流,那人与计算机之间,同样也需要语言进行沟通。
代码
代码是在计算机语言规则的约束下,编写出来的一组指令,具体描述了要让计算机去执行的操作。简言之就是:计算机语言是规则,代码是基于这些规则,所编写出来的一行一行的指令。
程序
代码按照特定的顺序和逻辑组合后,就是程序;程序通常用于完成某种特定的任务或功能。如果说程序是一道菜,那代码就是做这道菜的某个步骤。
计算机语言简史
第一代语言:机器语言
计算机问世的初期,人们只能通过『机器语言』(又称机器码)来操作计算机,所谓机器语言,就是0和 1组成的二进制内容。而且在当时,录入和修改信息通常都需要:拨动开关、或插拔连线、或使用打孔纸带来输入指令。
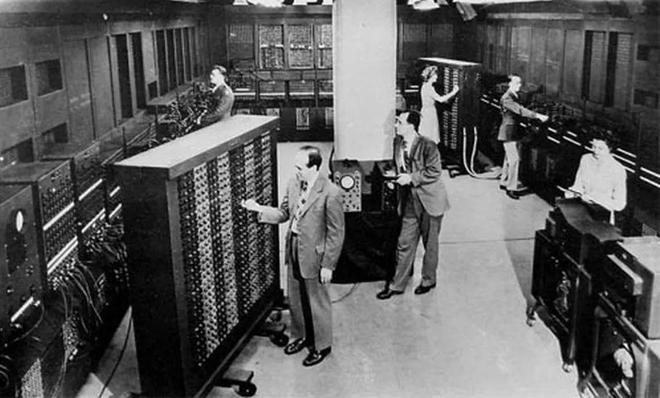
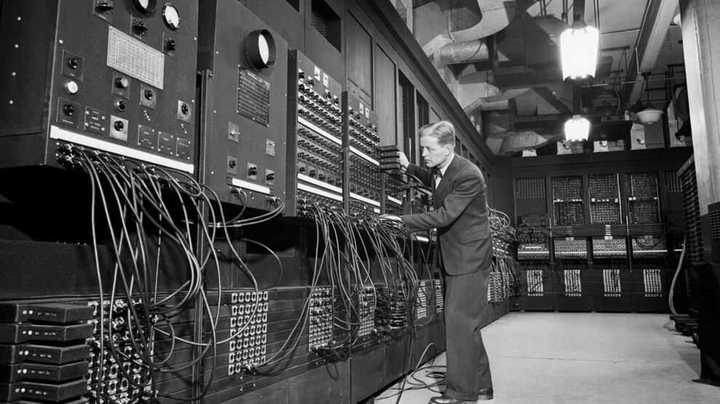
机器语言虽然能充分利用硬件性能,但所有操作都必须通过二进制来完成,所以编程的过程极为繁琐,且容易出错,对程序员的理解能力和耐心,都要求极高。
例如:在
x86的 CPU 架构下,使用机器码编写1 + 1的运算代码如下:
10110000 00000001 00000100 00000001
第二代语言:汇编语言
用机器语言编程,程序员很难理解每一条指令的含义,为了解决这个问题,『汇编语言』应运而生,它将机器语言中的二进制指令,转化为更容易记忆的助记符(如MOV、ADD、LOAD等),从而让程序员能以近似“英文简写”的方式进行编程,简单说就是:『汇编语言』是对『机器语言』的“人性化翻译”,汇编语言显著降低了编程的门槛,也为后续高级语言的诞生,打下了基础。
例如:在
x86的 CPU 架构下,使用『汇编语言』编写1 + 1的运算代码如下:
mov al, 1
add al, 1
:::color4
📢注意:****『汇编语言』需要翻译成『机器码』,才能交给 CPU 执行,因为 CPU 只认二进制指令。
:::
第三代语言:高级语言
相对『机器语言』和『汇编语言』而言,『高级语言』更接近人类的自然语言,它允许程序员使用英语来编写程序,并向程序员屏蔽了大部分的底层细节,语言中的符号和算式,也和日常的数学算式差不多,它更容易被掌握,常见的『高级语言』有:C、C++、Java、PHP、Go、Rust、JavaScript、Python 等。
例如:下面的 Python 代码,可以输出
"Hello, world!"
print("Hello, world!")
例如:下面的 Java 代码,可以输出
"Hello, world!"
public class Main {
    public static void main(String[] args)
System.out.println(1 + 1);
}
}
:::color4
📢注意:计算机不能直接执行『高级语言』,同样需要将其转换为『机器语言』才能被计算机执行。
:::
『编译型语言』与『解释型语言』
对于高级语言来说,我们会根据其转换成二进制指令过程的不同,可将其分为:『编译型』和『解释型』
编译型语言
将程序翻译成计算机能理解的二进制内容,并且通常会生成一个可执行文件,例如在 windows 系统上生成的可执行文件是.exe文件,常见的『编译型』语言有:C、C++、Go、Rust 等。
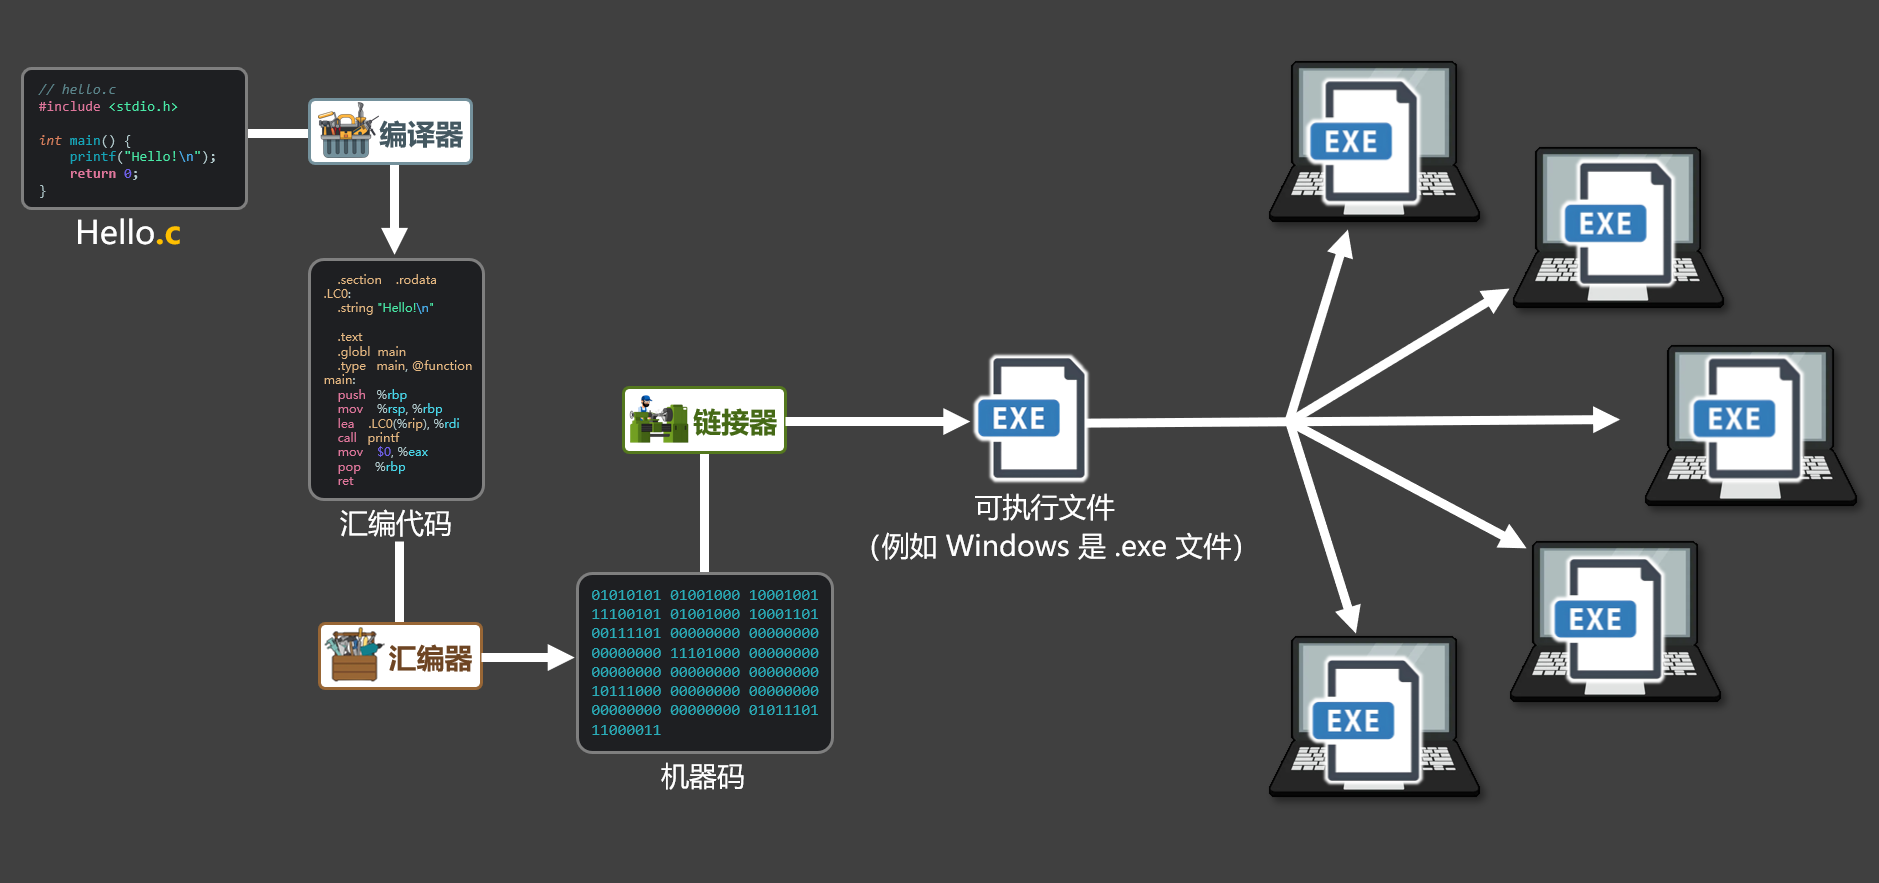
编译型语言的特点:
:::info
- 优势:同一运行平台,代码只需编译一次,且执行效率高。
- 劣势:跨平台性差,大型项目编译时间较长,开发效率略低。
:::
解释型语言
将程序一句一句的翻译为:计算机可以执行的指令,整个过程通常不生成可执行文件,常见的解释型语言有:Python、Php、JavaScript 等。
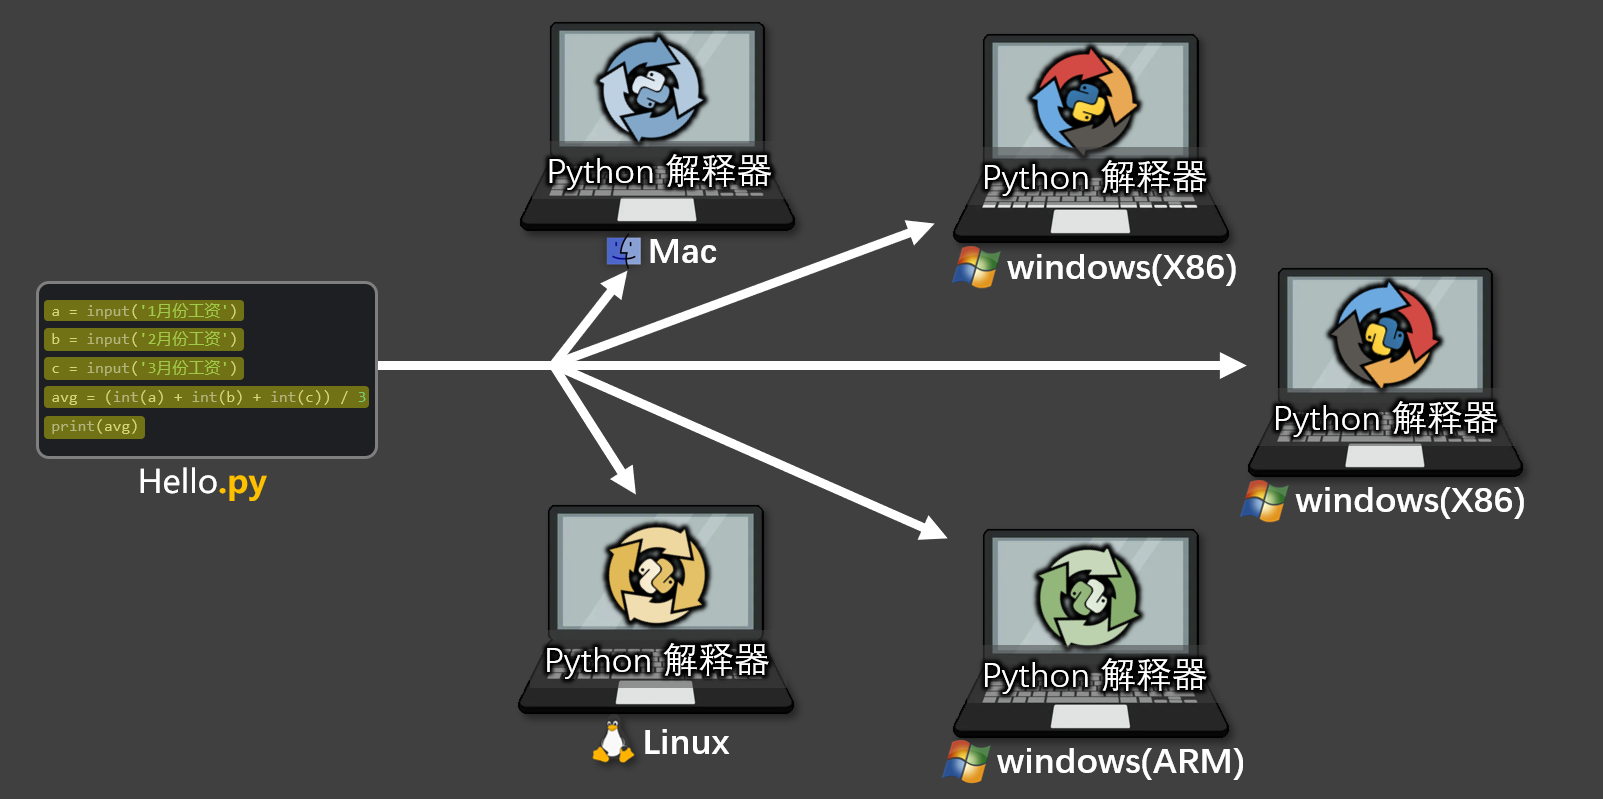
解释型语言的特点:
:::info
- 优势:跨平台性好,无需编译,开发调试灵活高效。
- 劣势:每次运行都需要解释,执行效率较低。
:::
二者对比
| **** | 编译型语言 | 解释型语言 |
|---|---|---|
| 举例 | C、C++、Go、Rust 等 | Python、JavaScript、Ruby 等 |
| 执行流程 | 运行前把所有程序一次性翻译成机器码,并生成可执行文件。 | 运行时靠对应的解释器,把代码一句一句翻译成机器码执行。 |
| 是否生成可执行文件 | 是,一次编译多处运行。 | 否,每次都要靠解释器翻译后再运行。 |
| 运行速度 | 快 | 慢 |
| 是否跨平台 | 否,需要针对平台编译。 | 是,只要该平台下有解释器,就能运行。 |
| 适合场景 | 系统底层、性能要求较高的场景。 | 脚本、数据分析、AI 应用、Web开发等。 |
第 2 章 初识 Python
Python 概述
Python 的起源
:::tips
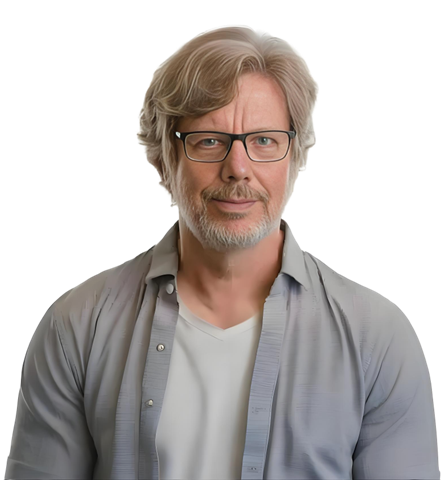
Python 的作者 Guido van Rossum 来自荷兰(国内爱称:龟叔),拥有数学与计算机背景,他发现用: C、Fortran 等语言写程序太费劲,而 Shell 虽然轻松,但功能却很有限。
1989 年圣诞节,龟叔开始动手编写一种既能像 C 那样全面操控系统,又能像 Shell 一样好上手的解释器,并以他喜爱的喜剧《Monty Python’s Flying Circus》为灵感,命名为“Python”。
:::
:::info
Python 的设计哲学是“优雅、明确、简单”,Python 提倡:最好只有一种方法来做一件事,它的第一个公开版本于 1991 年问世,如今已成为全球最受欢迎的编程语言之一。
:::
Python 的特点
Python 的优点:
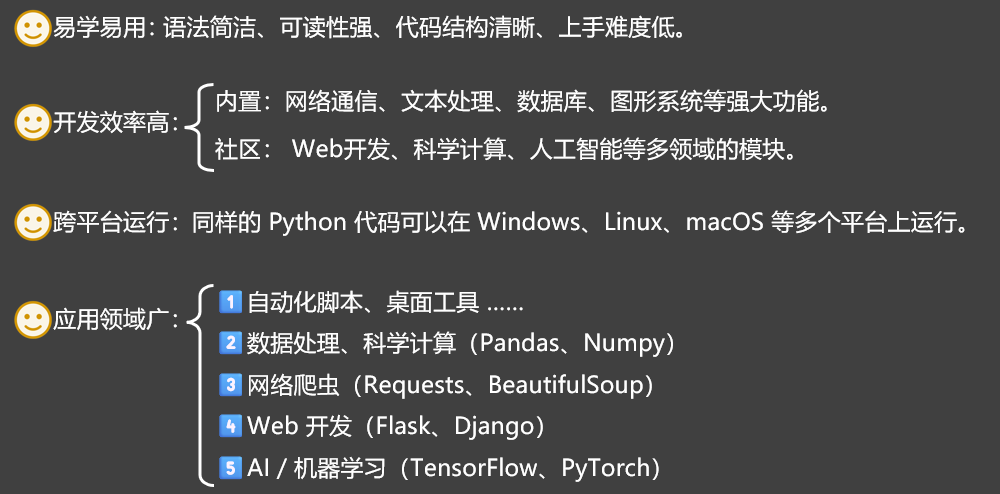
Python 的缺点:
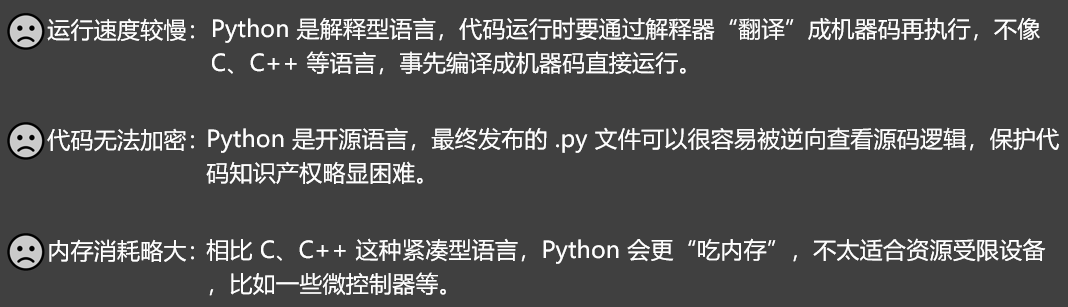
为何 AI 领域广泛使用 Python ?
主要原因是 Python 具备如下的特点:
:::info
- 简洁直观的开发体验。
- 丰富强大的框架生态。
- 与底层语言高效协作。
- 社区活跃且人才充足。
- 业内大厂 + 主流推动。
:::
Python 的版本
- 1991年:
Python 0.9.0发布。 - 1994年:
Python 1.0正式发布(进入正式版阶段)。 - 2000年:
Python 2.0发布。 - 2008年:
**<font style="color:#AD1A2B;">Python 3.0</font>**发布,与**<font style="color:#AD1A2B;">Python 2</font>**不兼容。 - 2010年:
Python 2.7发布,作为Python 2.x的最后主版本,被广泛使用多年。
......
- 2020年:
Python 2官方停止维护,同时Python 3.9发布。 - 2021年:
Python 3.10发布。 - 2022年:
Python 3.11发布,平均性能提升10%-60%。 - 2023年:
Python 3.12发布,进一步优化性能和类型提示。 - 2024年:
Python 3.13发布。 - 2025年:持续迭代。
搭建 Python 开发环境
📢本小节涉及很多设置和操作,建议各位参考视频,来完成配置。
安装 Python 解释器
1️⃣进入官网,点击 Downloads,选择对应的操作系统。
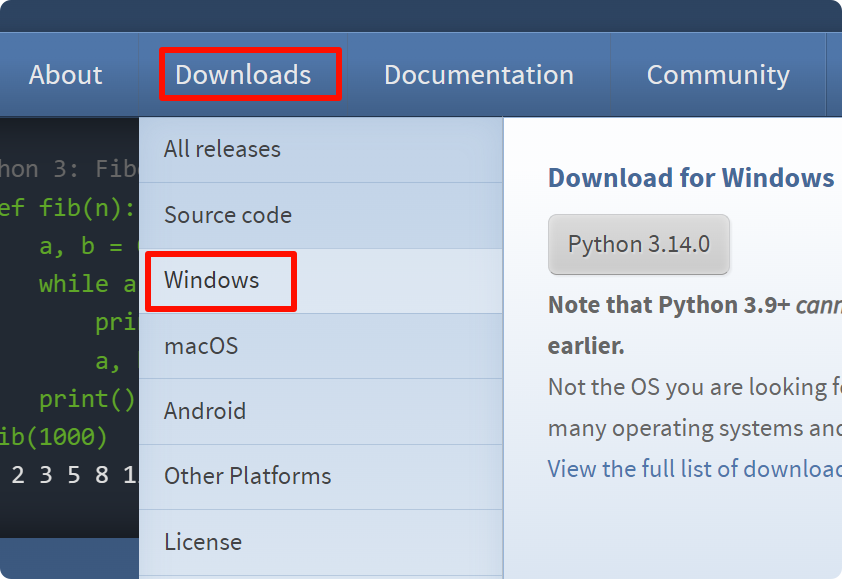
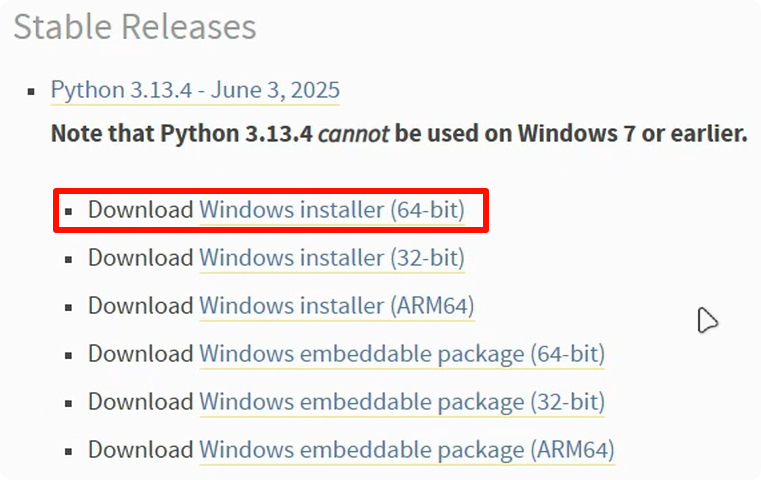
2️⃣选择版本,点击链接下载,我们这里的版本是 3.13.4。
3️⃣双击下载好的文件,开始安装(强烈建议以管理员身份运行)。
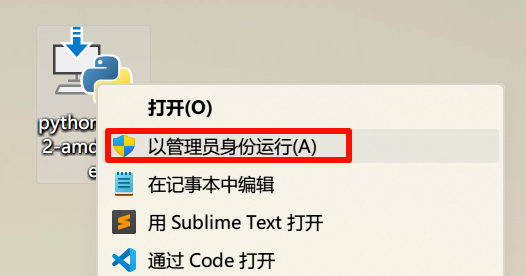
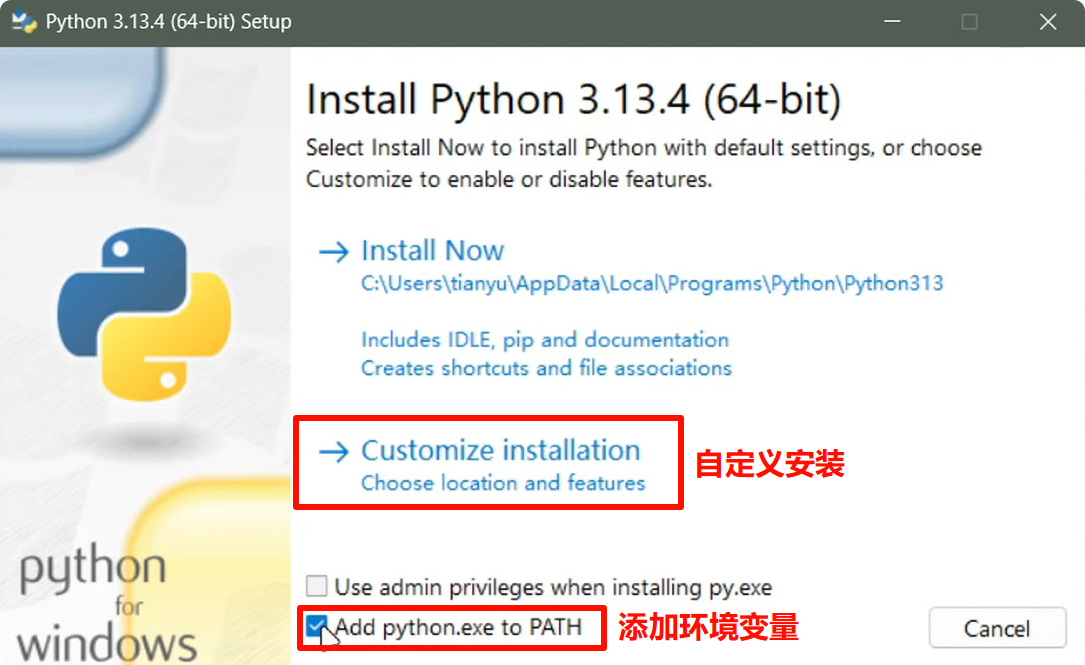
4️⃣保持默认,点击 Next。
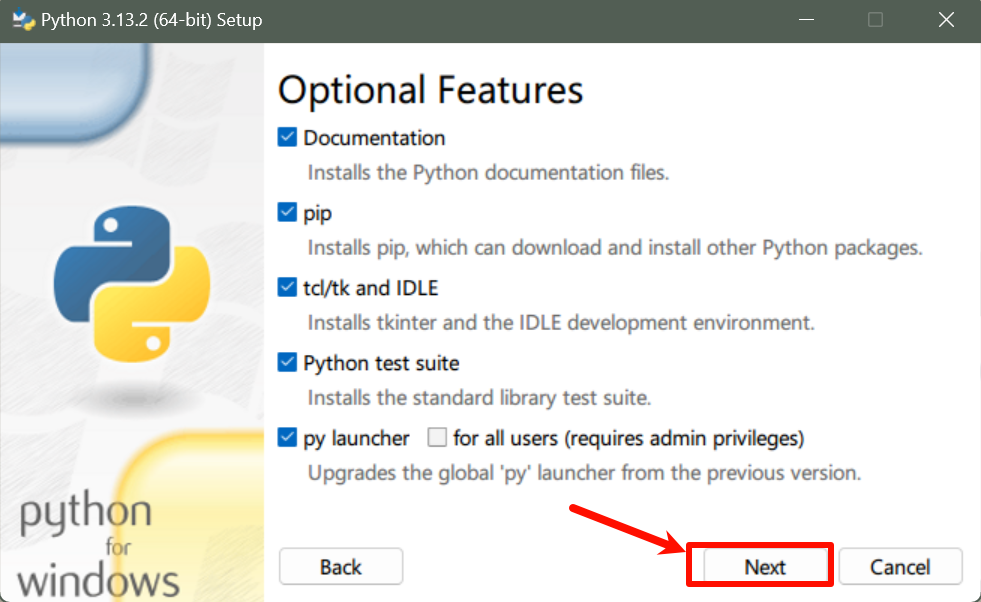
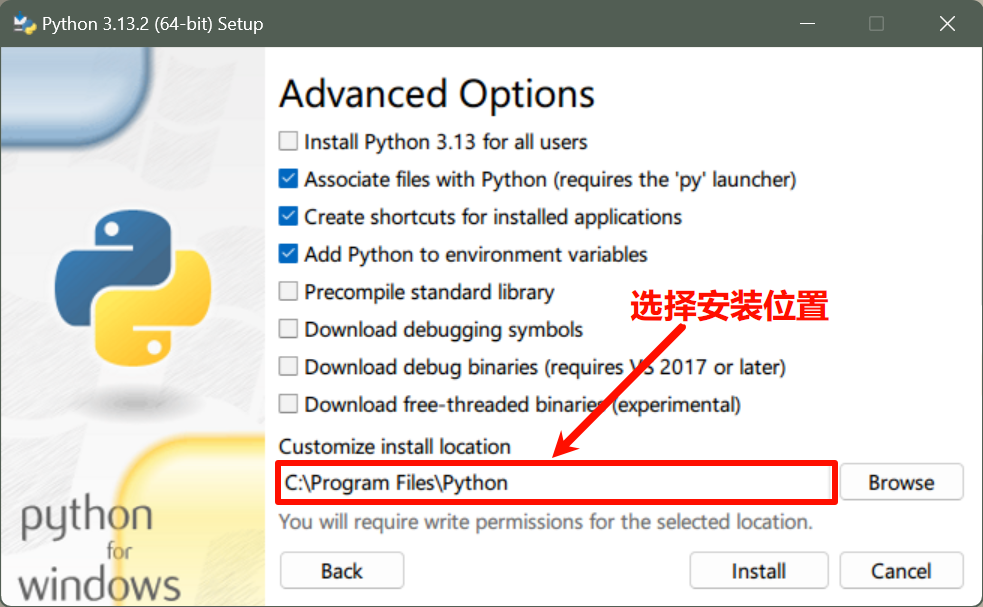
5️⃣修改安装路径,其他保持默认,点击 Install 开始安装。
6️⃣禁用系统路径长度限制
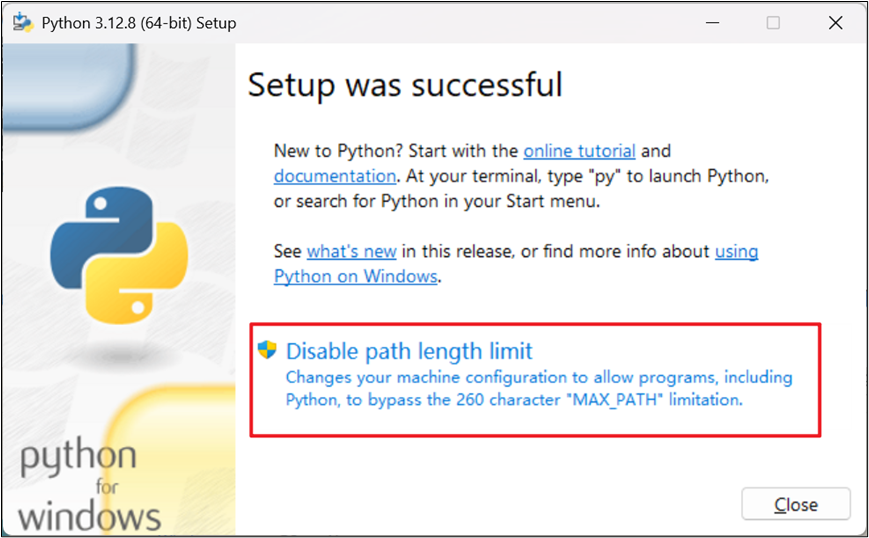
建议点击 Disable path length limit,这样可以禁用系统的路径长度限制,以避免因路径过长而导致的错误,随后点击 Close,完成安装。
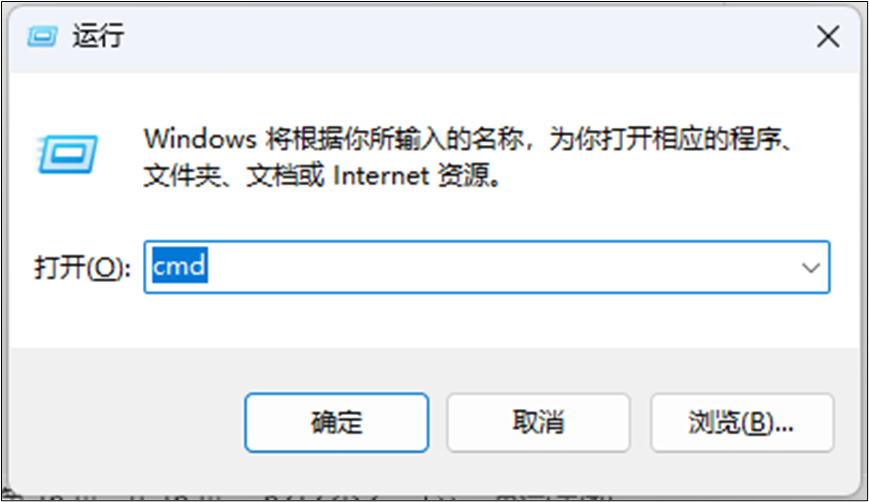
7️⃣检查是否安装成功,同时按下 Win 键和 R ,输入 cmd ,点击确定,进入命令提示符。
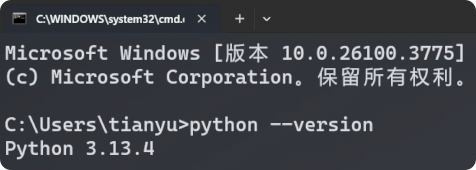
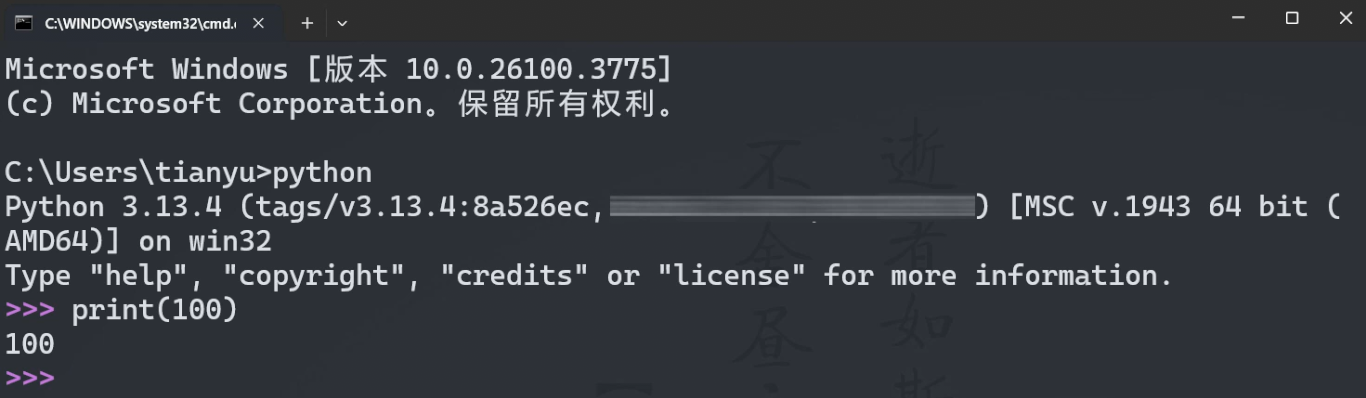
8️⃣输入 python --version,若能打印出 Python 版本,则表示安装成功。
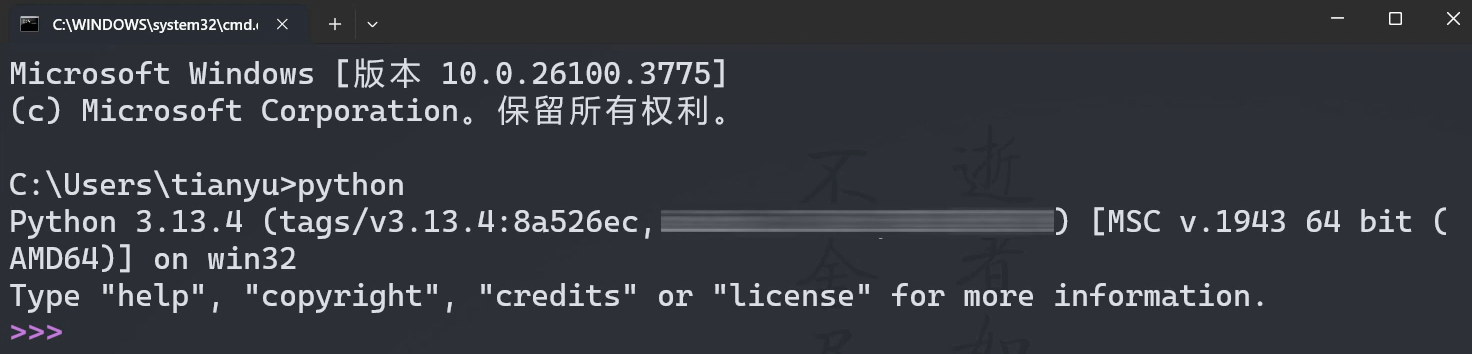
**② **随后输入:print(100),随后回车,终端中呈现100
:::tips
📋****备注:作为初学者,各位暂时不用纠结上述代码的含义,先跟着操作就可以,后面会仔细讲解。
:::
安装 PyCharm
集成开发环境(简称:IDE;英文名:Integrated Development Environment )是用于提供程序开发环境的应用程序,一般包括代码编辑器、编译器、调试器和图形用户界面等工具。集成了代码编写功能、分析功能、编译功能、调试功能等多种功能,本课程中 Python 的 IDE 我们使用主流的工具: PyCharm。
:::info
PyCharm 官方地址:https://www.jetbrains.com/pycharm/download
:::
具体安装步骤如下:
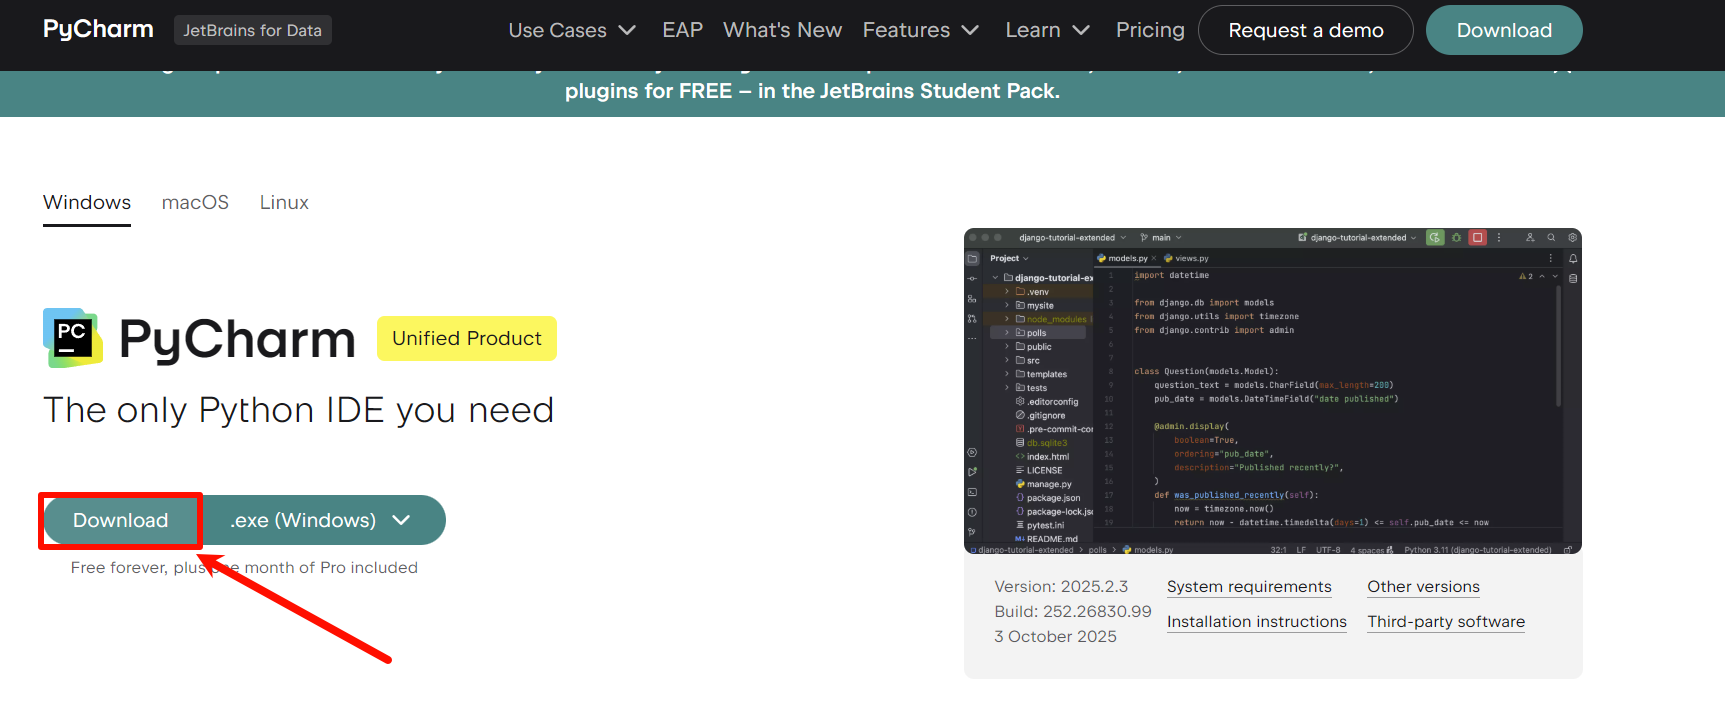
1️⃣进入官网,点击左下角 Download 下载 PyCharm 安装包(此处下载的是完整版安装包)。
:::tips
📋****备注:Pycharm 已经没有专业版了,现在的叫:完整版(也叫:统一版),完整版中包含:付费功能+ 免费功能,付费功能可以免费试用 30 天,到期不付费的话,软件依然可以打开,并且免费的功能也都能正常使用,所以此处推荐各位下载完整版。如果不想使用完整版,也可以下载社区版,具体下载方式,请参考视频教程。
:::
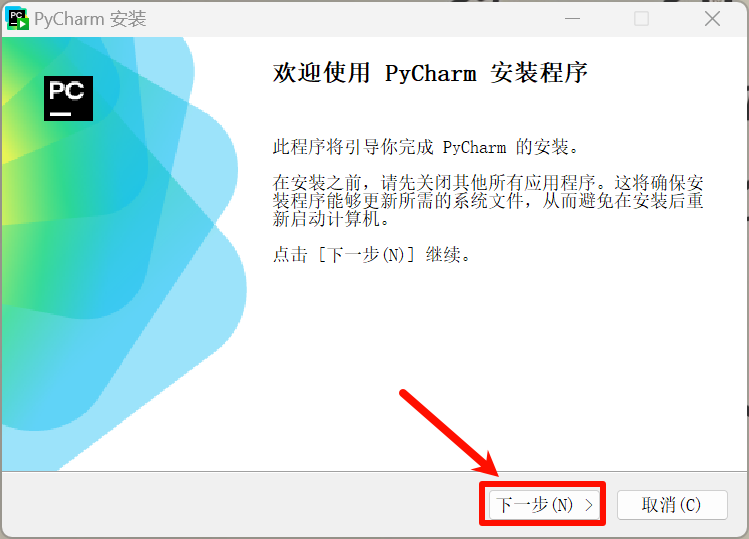
2️⃣以管理员身份运行安装包文件,点击下一步进行安装
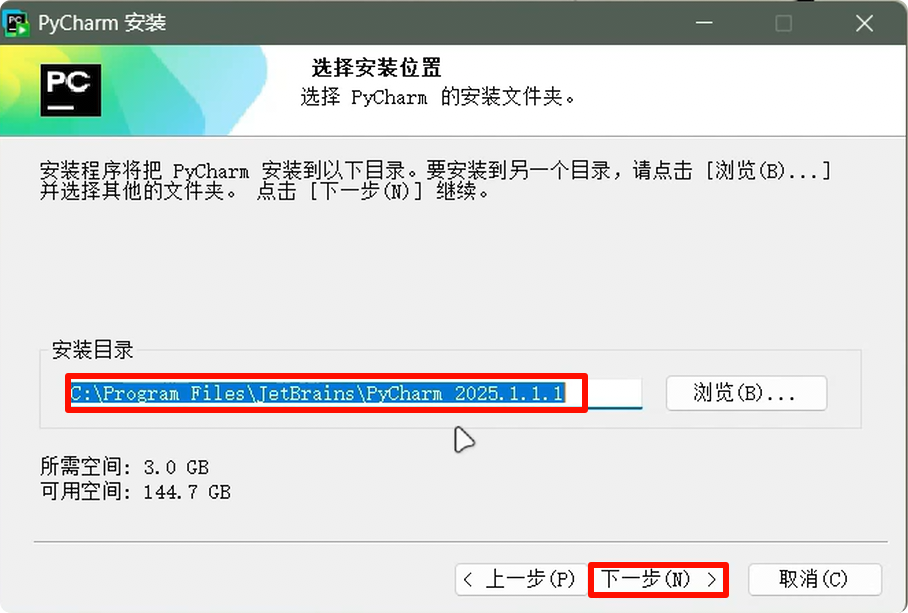
3️⃣修改安装目录,点击下一步。
4️⃣勾选对应的安装选项,之后点击下一步。
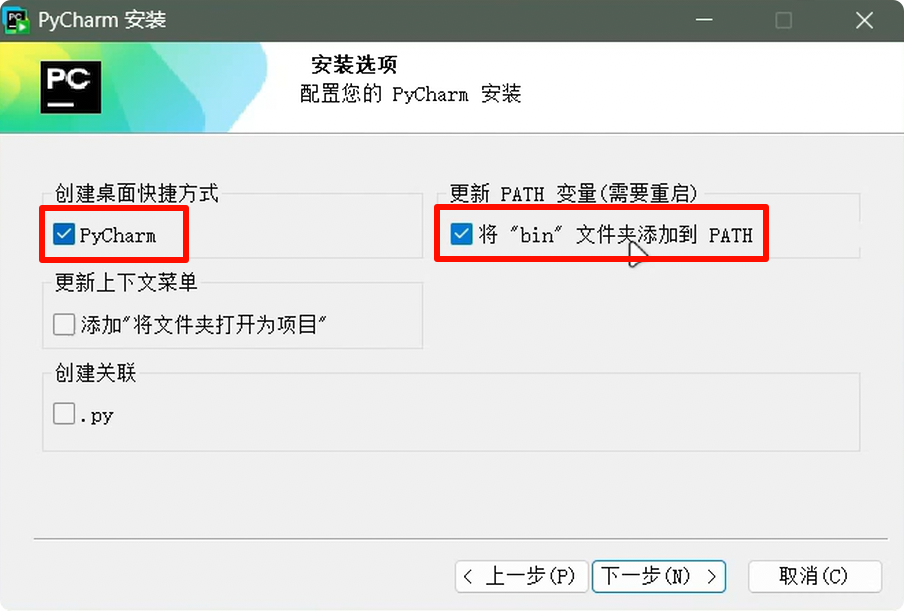
5️⃣点击安装。
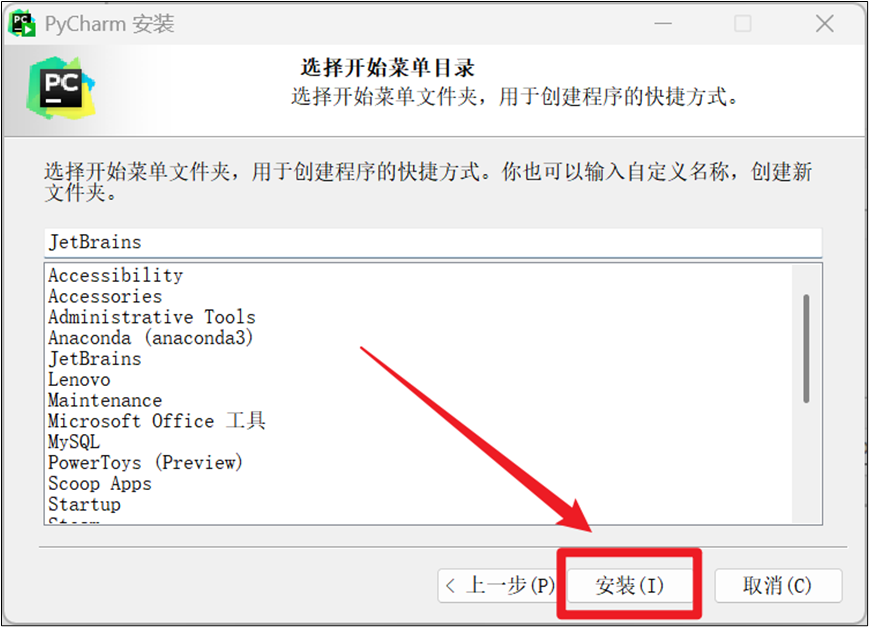
6️⃣安装完成。
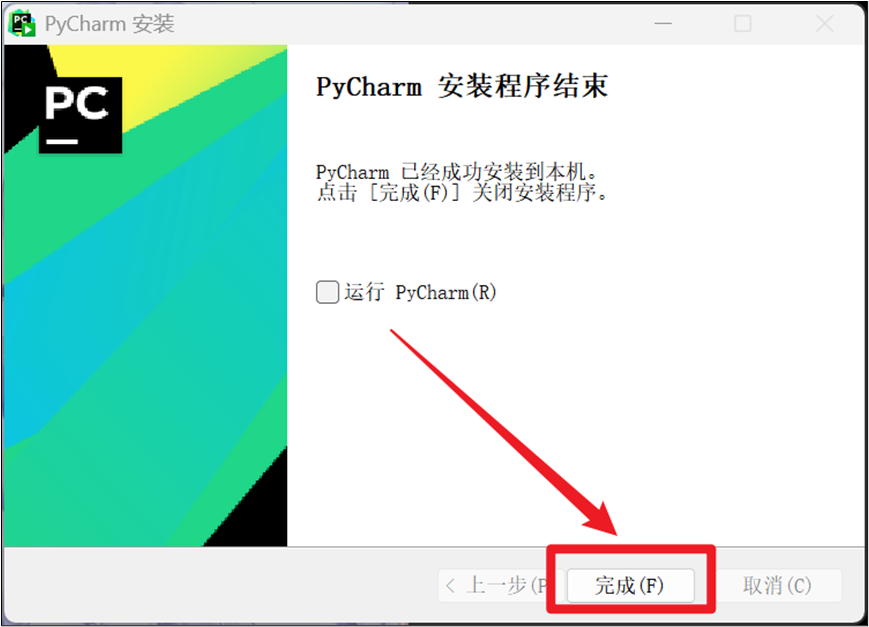
设置 PyCharm
一、设置中文UI
初次运行会弹出语言选择框,选择中文语言包即可
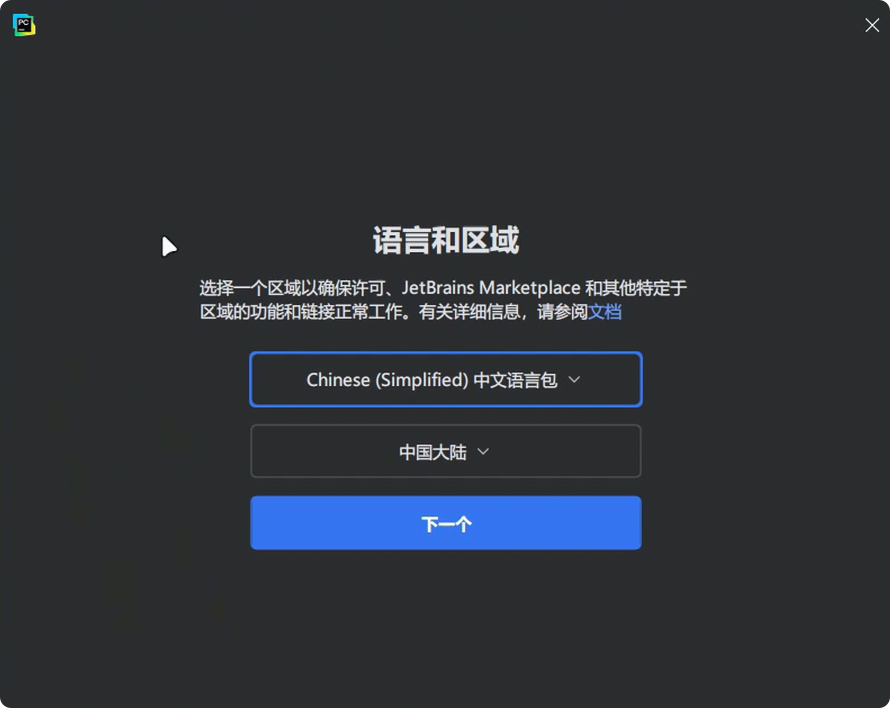
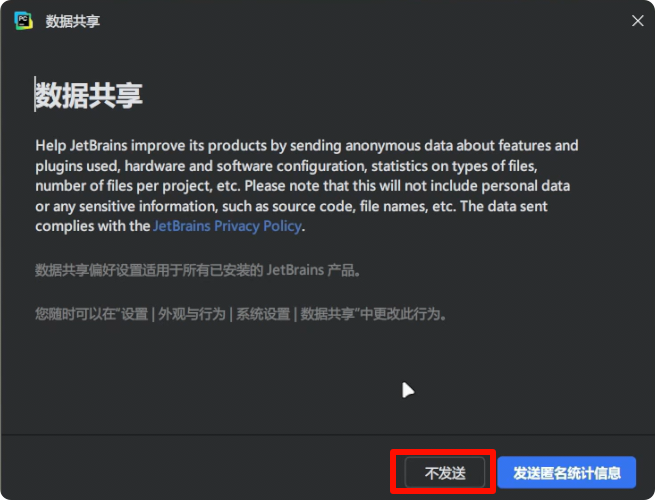
提示是否共享数据,若共享就会将部分使用数据发送给 Jetbrains公司优化产品,我这里选择不共享。
二、创建项目
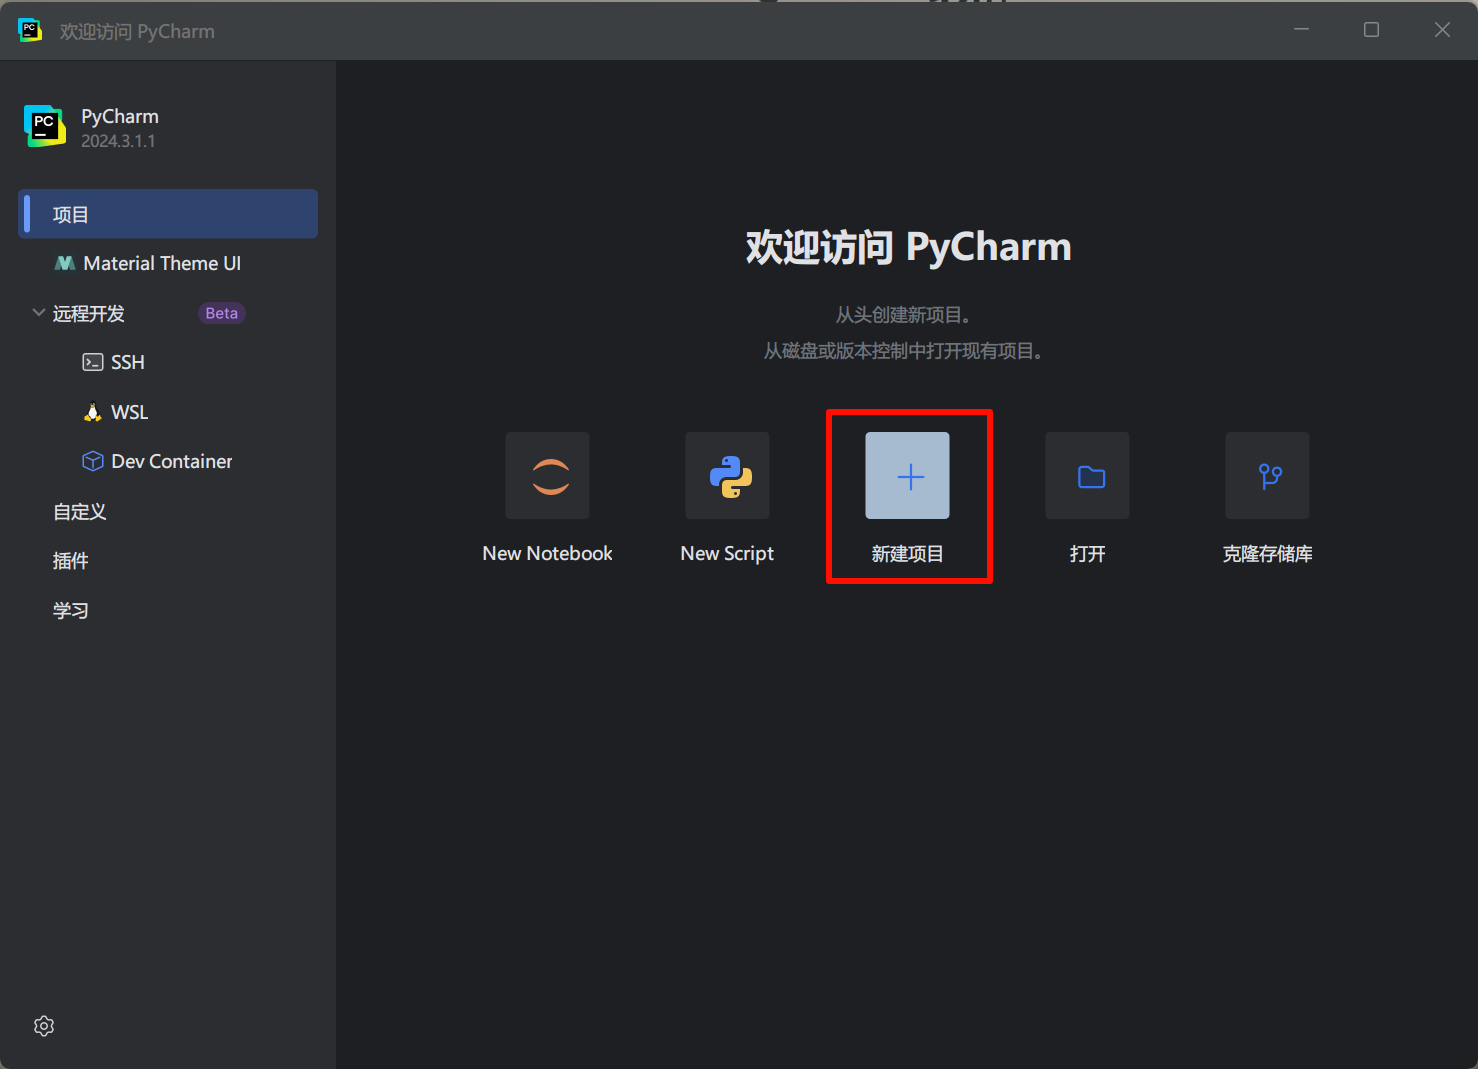
1️⃣点击新建项目
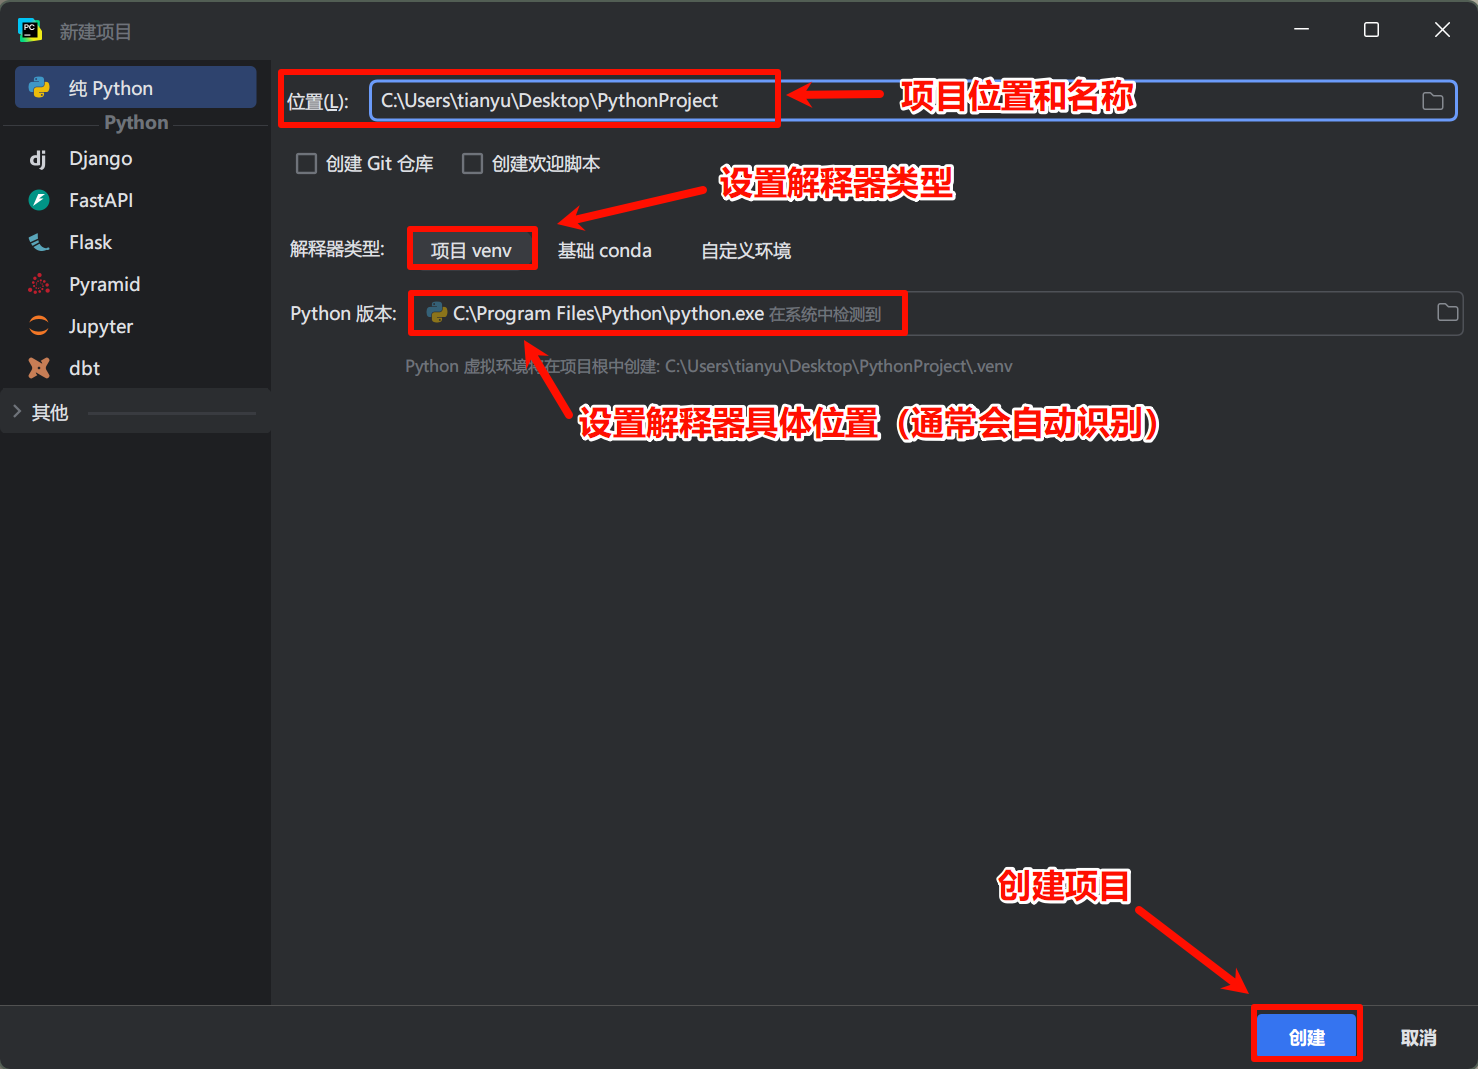
2️⃣设置项目名称,项目路径,解释器类型,Python版本。
:::color4
📢****注意:不同的 pycharm 版本,这里看到的界面可能会略有不同。
:::
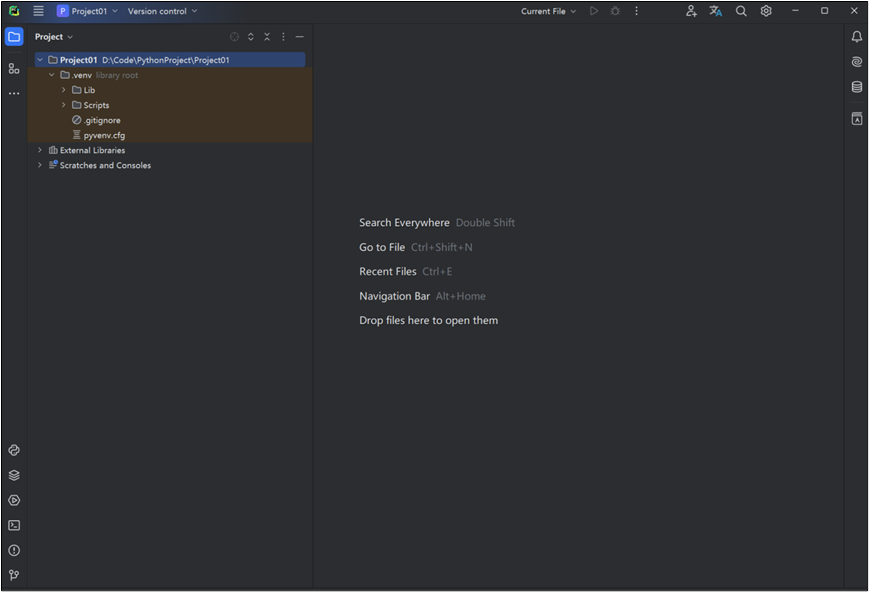
3️⃣一个 Python 项目创建成功。
4️⃣若出现如下提示,点击【排除文件夹】即可
**三、字体设置 **
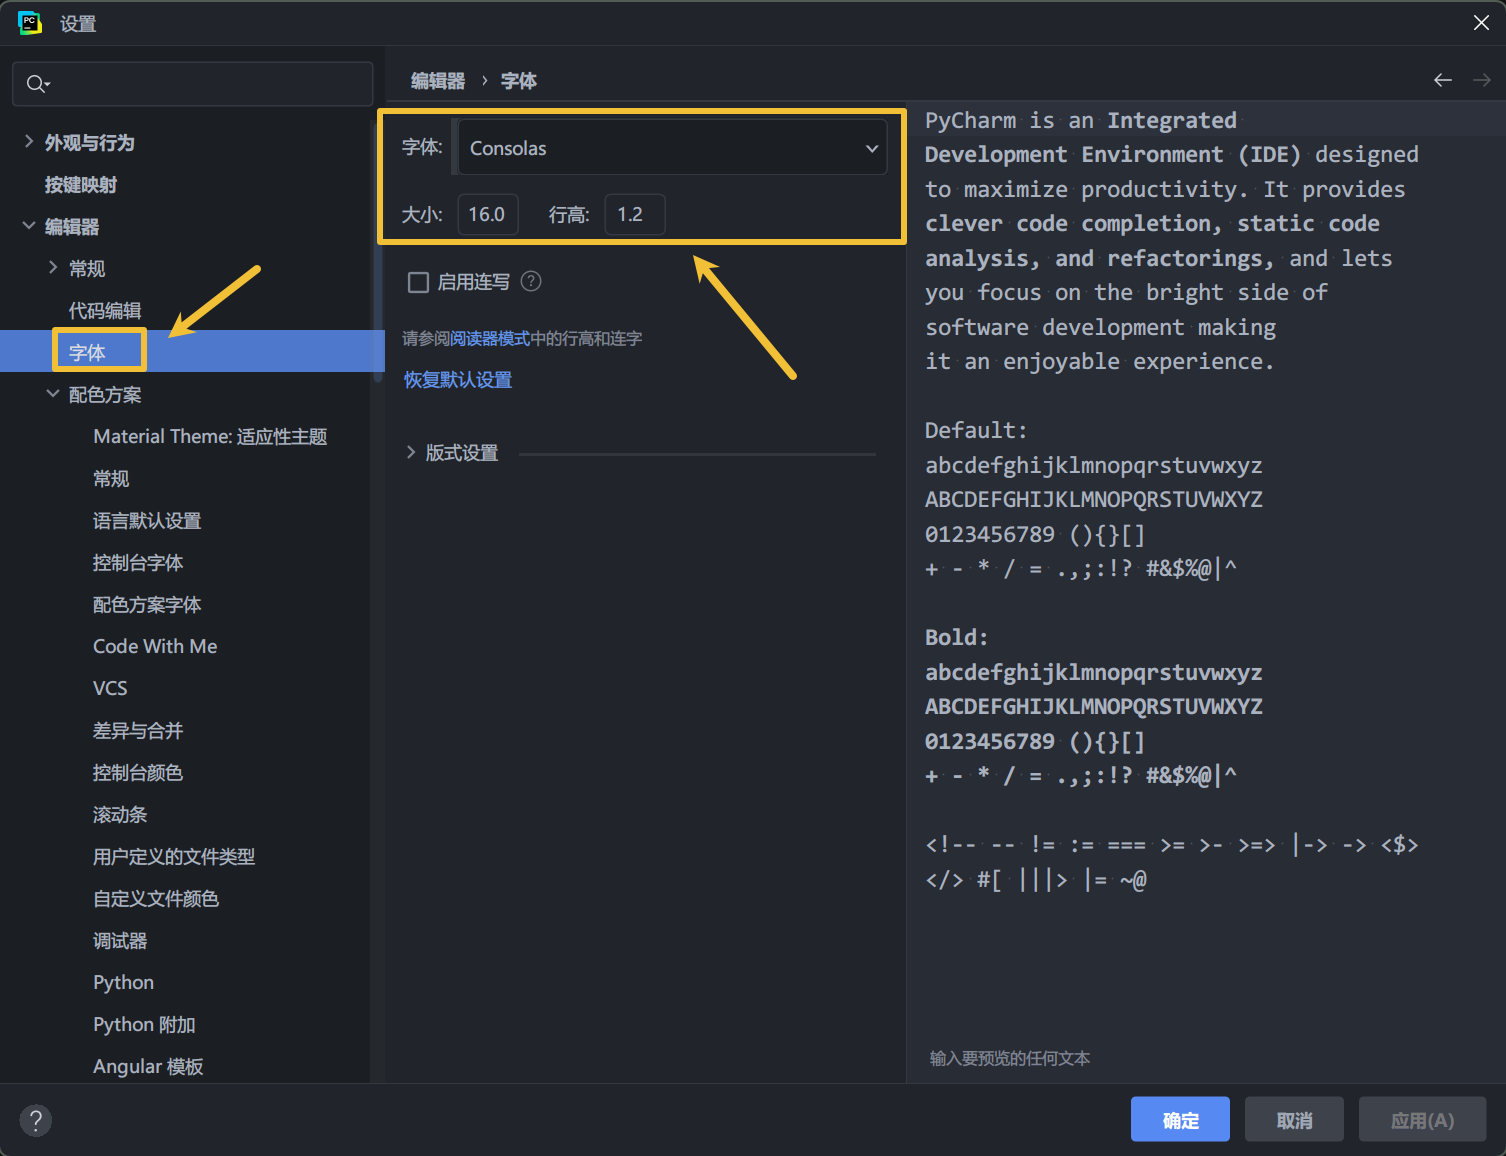
1️⃣参考下图调整编辑器字体
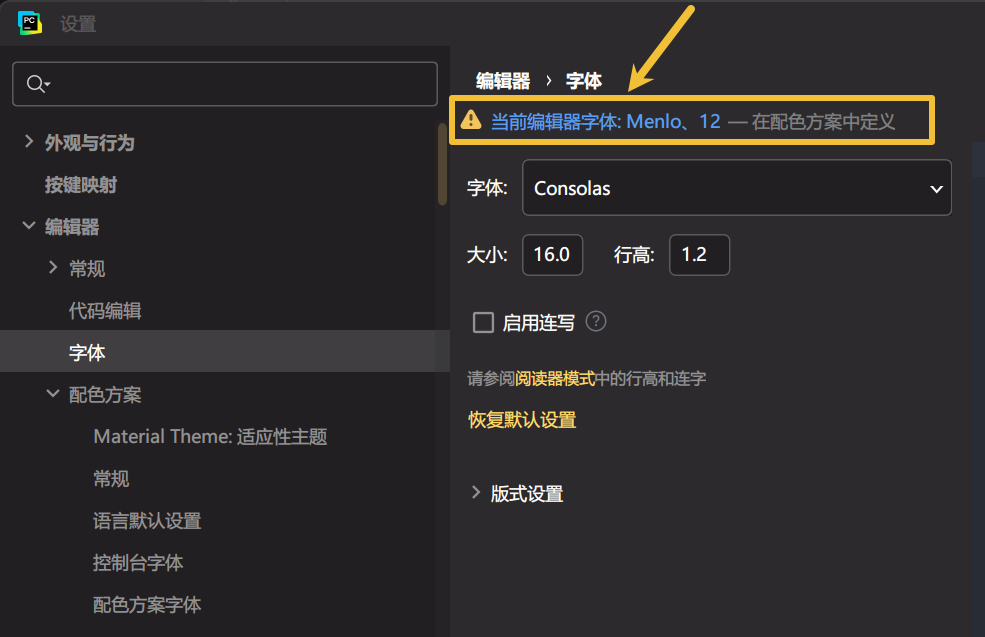
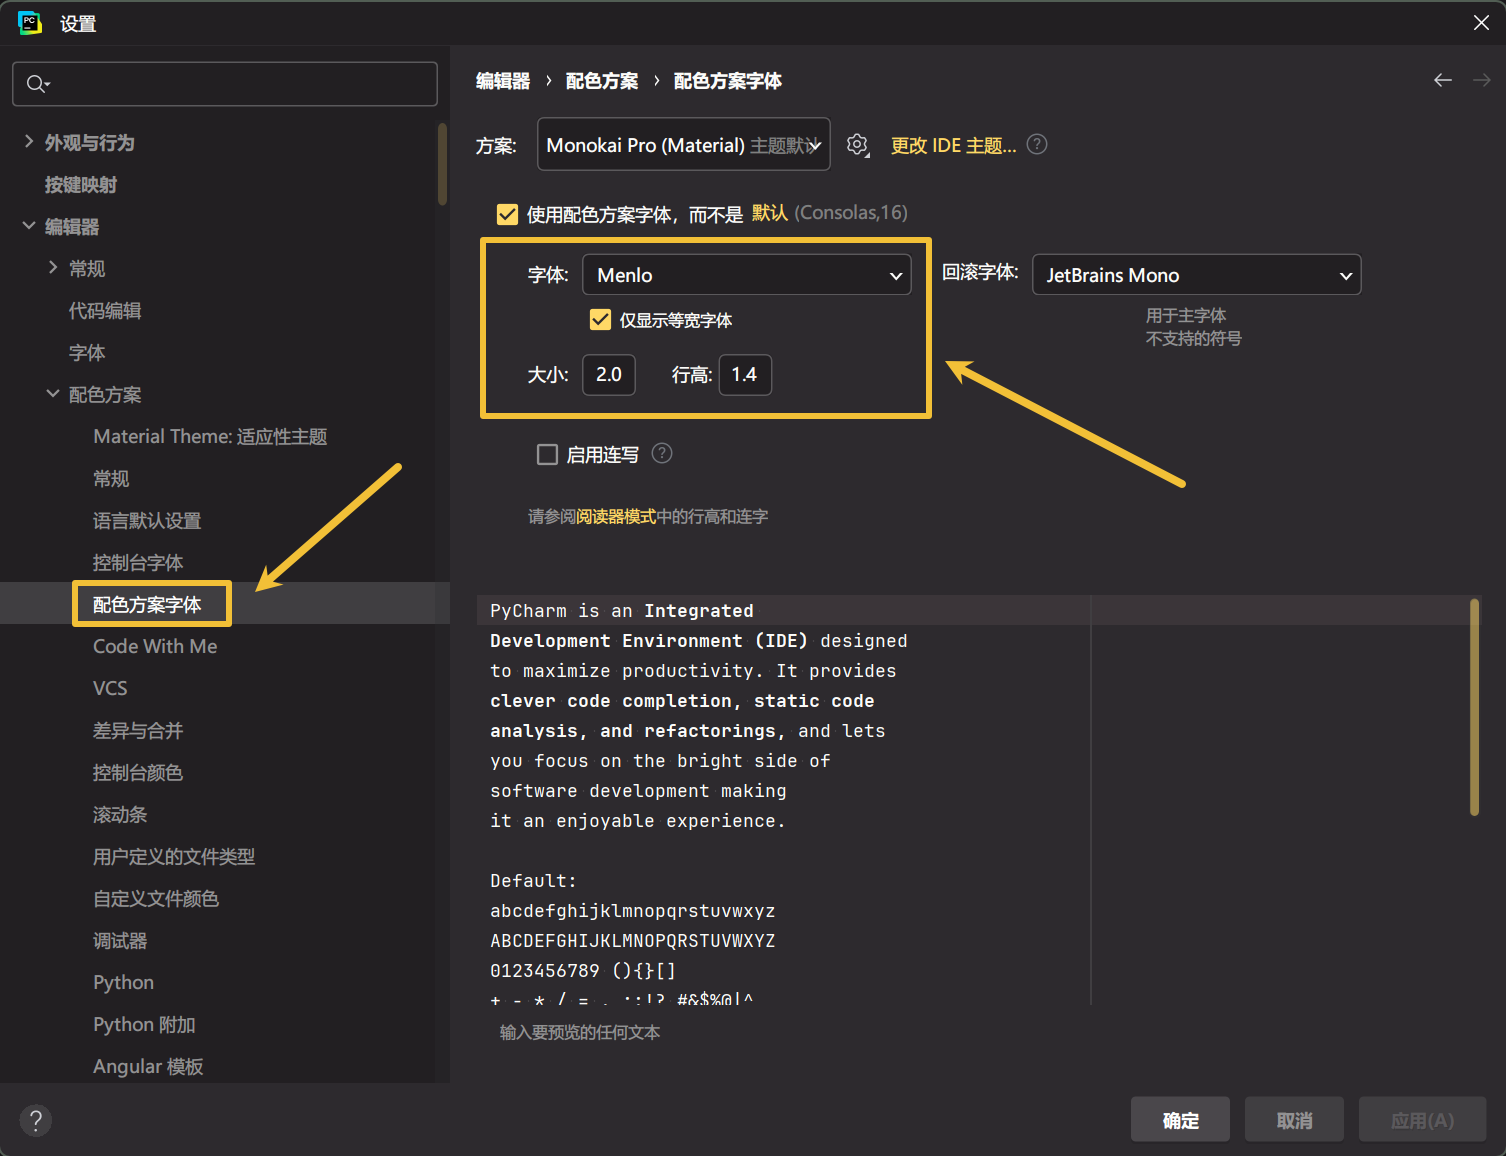
2️⃣若出现如下提示,则表示当前字体遵循主题设置,需要点击蓝色文字,跳转到配色方案中进行调整。
四、主题设置
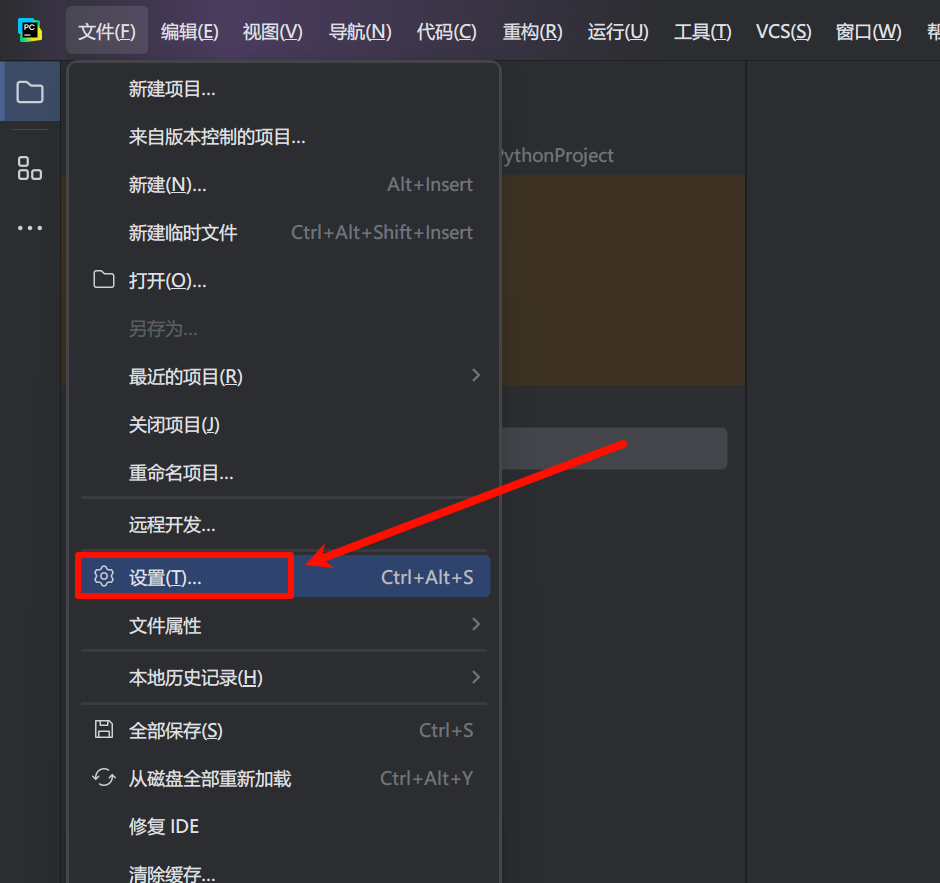
1️⃣打开设置面板。
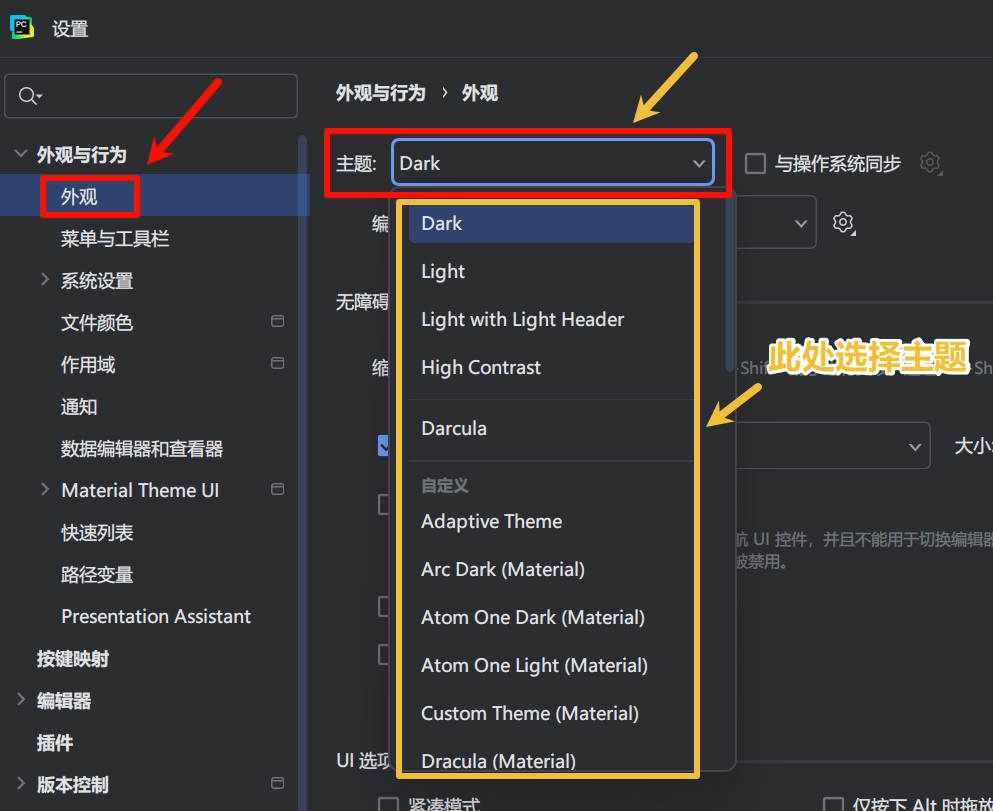
2️⃣依次选择:外观 → 主题。
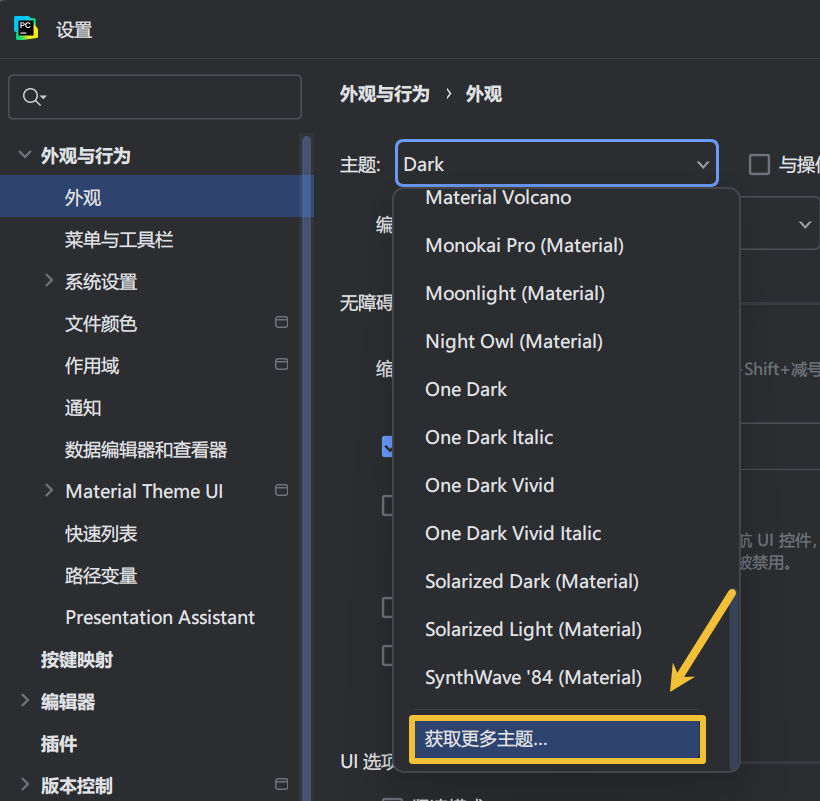
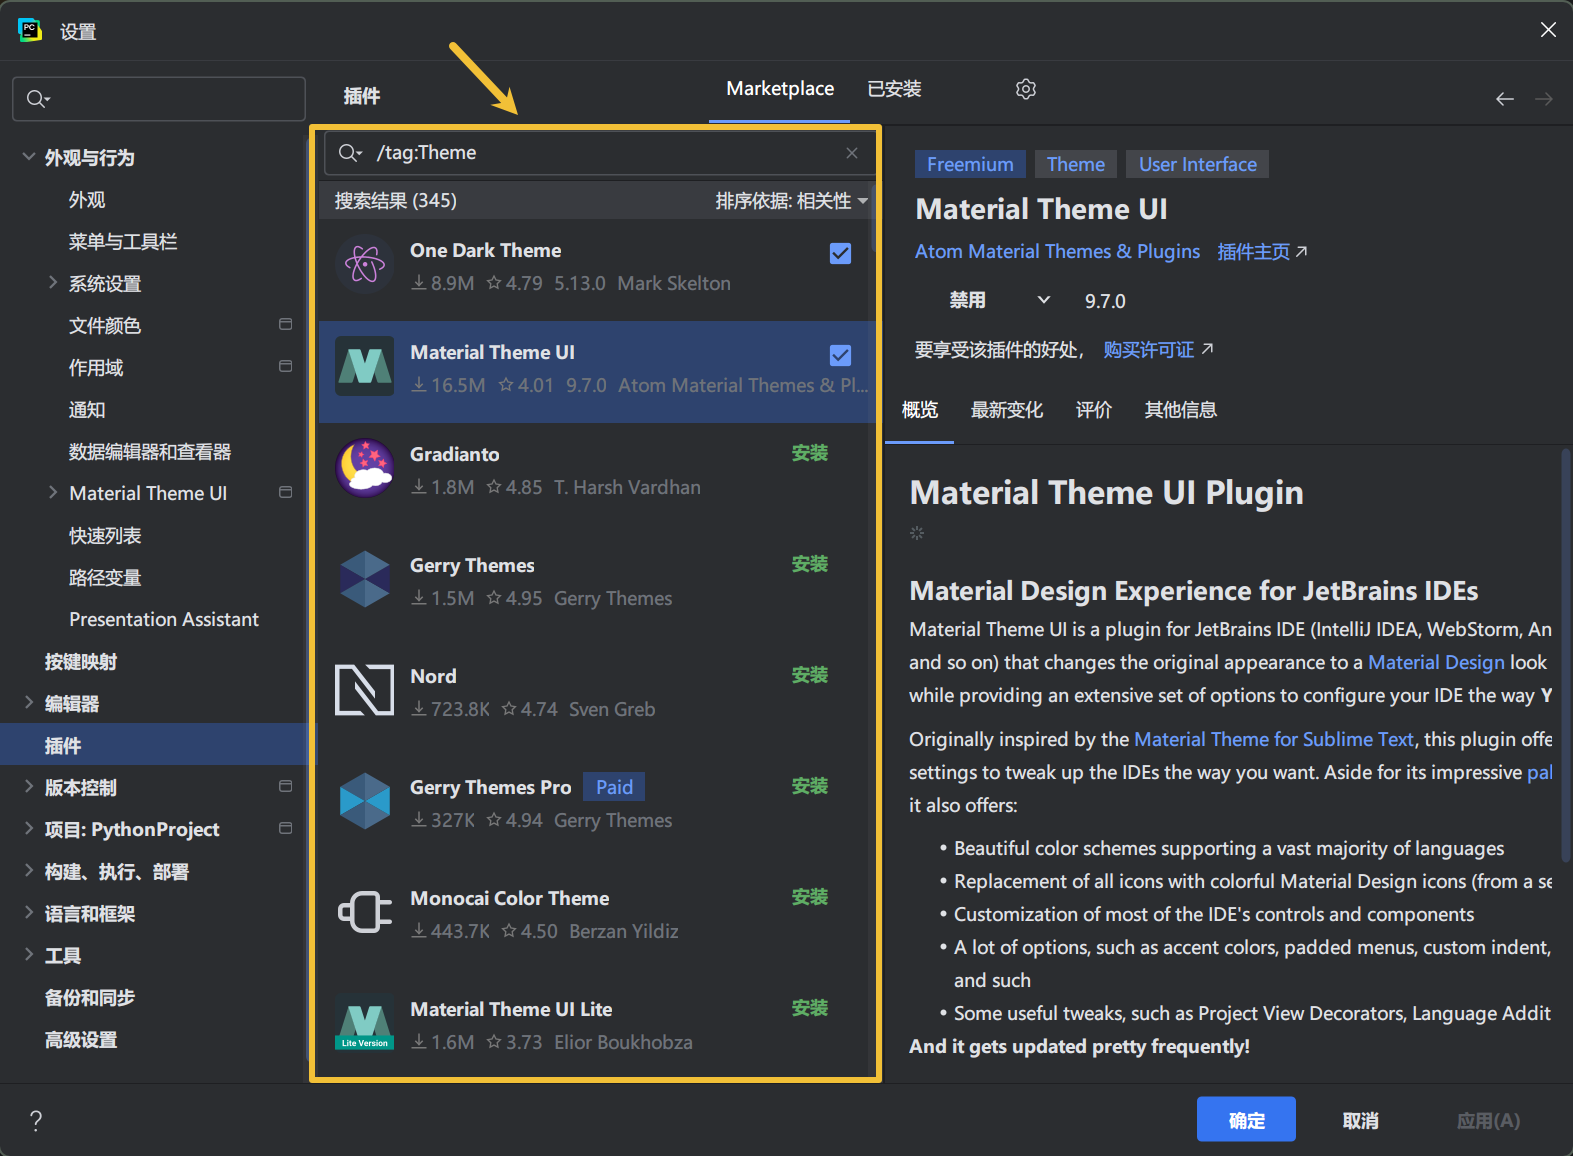
3️⃣滑动到最后,点击获取更多主题,可以从主题商店中安装新主题。
五、默认快捷键
PyCharm 中常用的默认快捷键如下:
| 快捷键 | 对应操作 |
|---|---|
| Ctrl + / | 行注释(可选中多行) |
| Ctrl + Alt + L | 代码格式化 |
| Ctrl + C | 复制当前行 / 复制选定的代码 |
| Ctrl + D | 重复当前行 / 重复选定的代码 |
| Ctrl + Z | 撤销 |
| Ctrl + Y | 删除当前行 / 反撤销(重做) |
| Ctrl + X | 复制当前行 / 剪切选定的代码 |
| Shift + Enter | 换行(光标不在结尾处也可换行) |
六、自定义快捷键
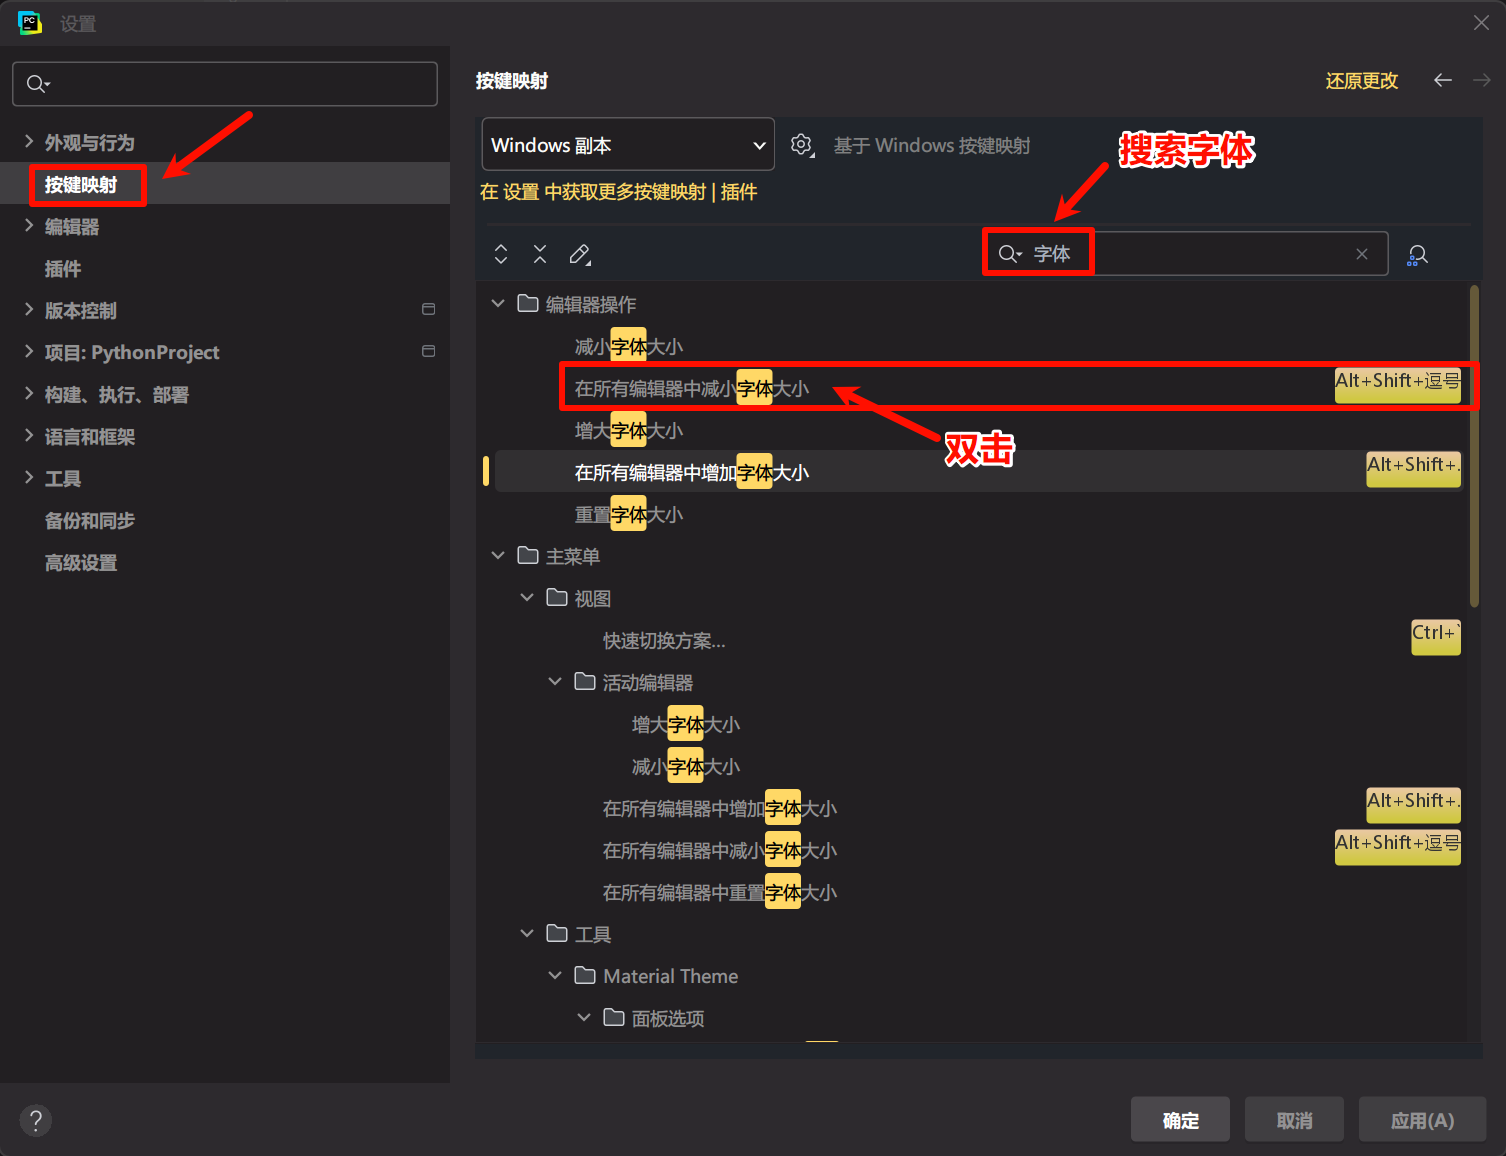
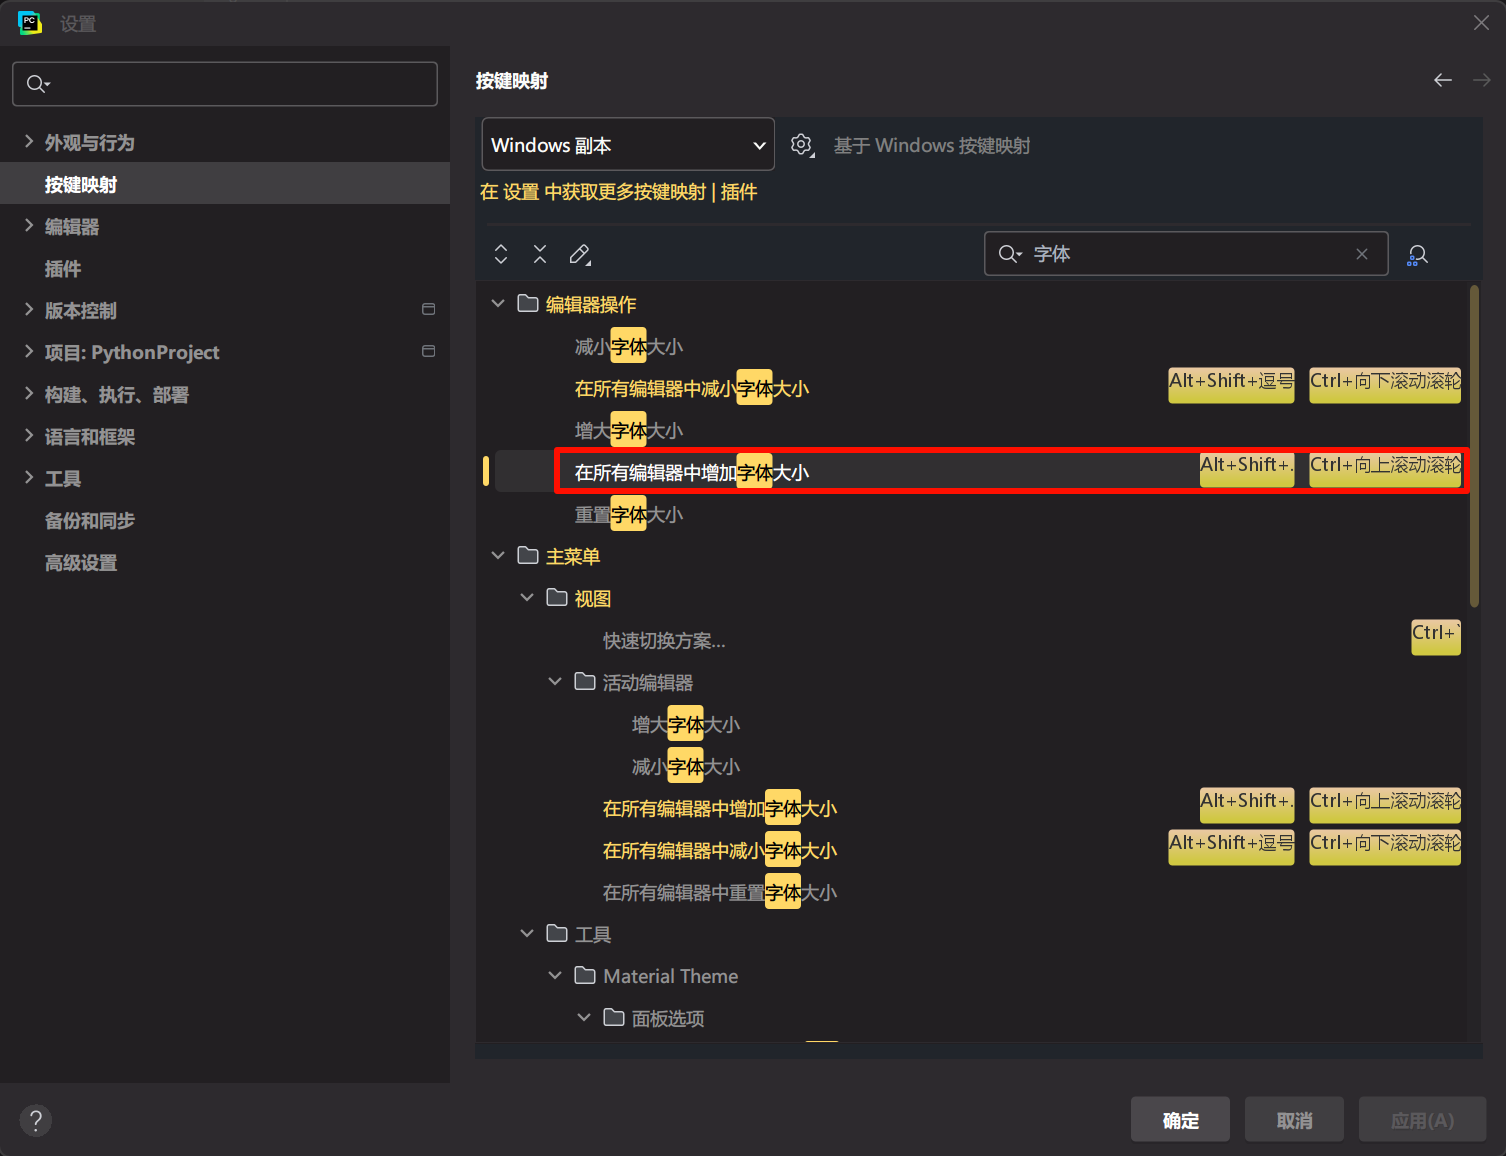
除了默认的快捷键,我们还可以配置自己喜欢的快捷键,例如:我们可以设置ctrl+ 鼠标滚轮,来快速调整字体大小,具体设置步骤如下:
1️⃣按照图示方式,找到对应设置:
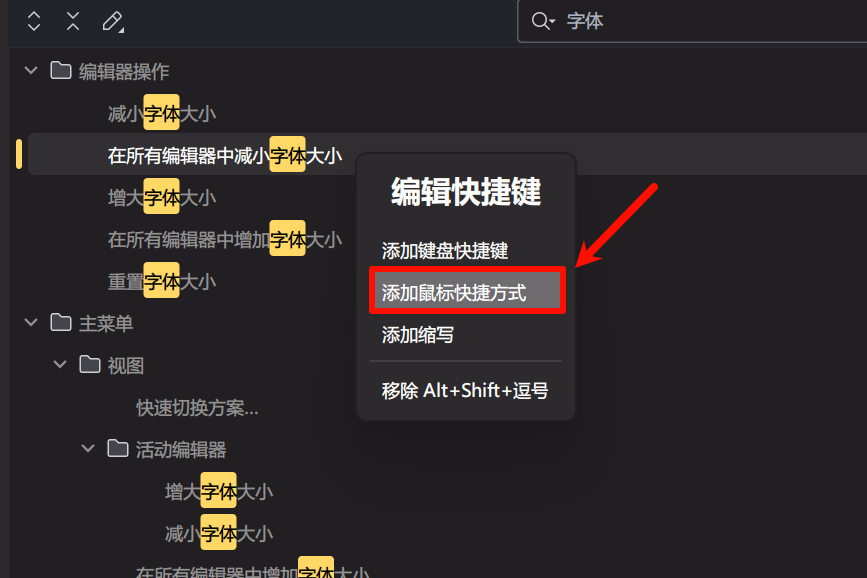
2️⃣选择:添加鼠标快捷方式
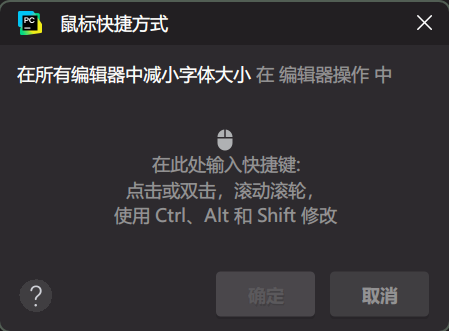
3️⃣弹出如下窗口后,按住ctrl键的同时,将鼠标滚轮向下滚动(当然向上也可以,根据个人习惯来)
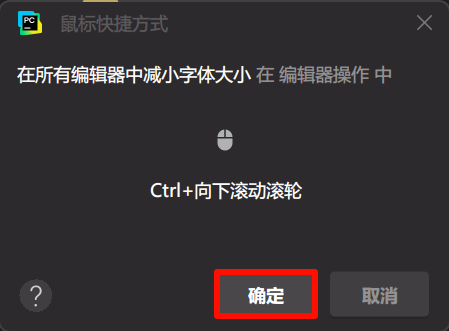
4️⃣随后窗口中会自动识别当前按下的按键和鼠标动作,随后点击确定即可。
5️⃣再以同样的方式,设置让字体变大的快捷键
:::tips
📋****备注:大家可以根据自己的喜好,设置其他功能的快捷键,具体设置方式和注意点,请看视频教程。
:::
运行 Python 程序的几种方式总结
运行 Python 程序,有常见的以下三种方式:
- 第一种方式:命令行(终端)模式
- 第二种方式:脚本模式
- 第三种方式:集成开发环境(IDE)模式
备注:第三种方式,其实是第二种方式的图形化操作,本质上算是一种模式。
命令行模式
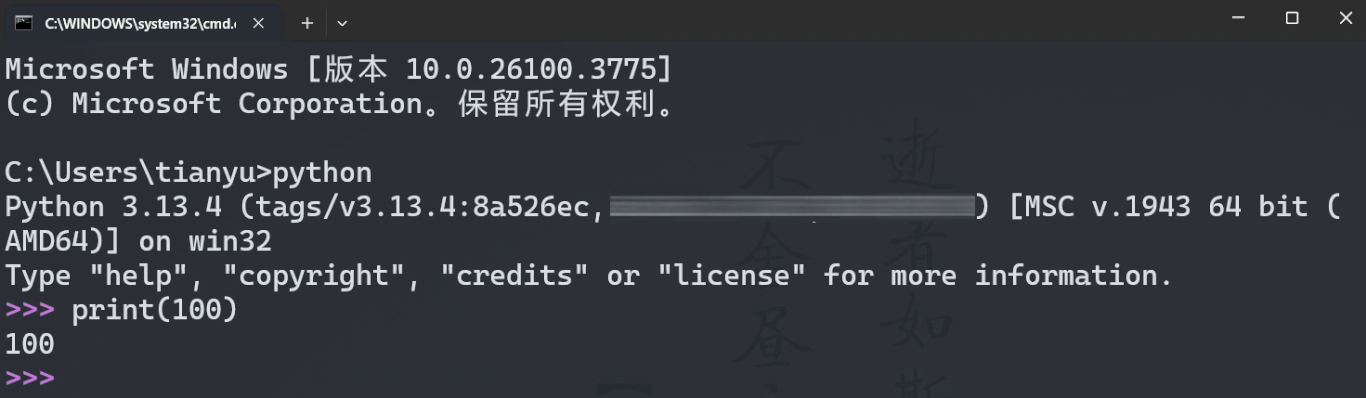
- 同时按下 Win 键和 R ,随后输入
cmd,打开终端(命令行)。 - 在终端(命令行)中输入
python,进入 Python 交互模式。 - 输入
print(100),按下回车,控制台会打印:100。
**脚本模式 **
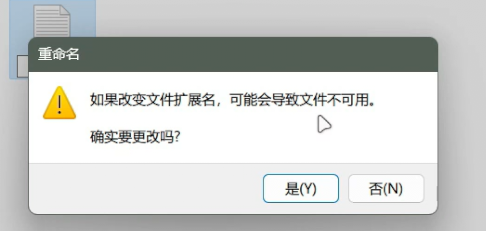
- 在桌面上新建一个
code文件夹,随后新建一个文本档,将其重命名为test.py
- 使用记事本打开
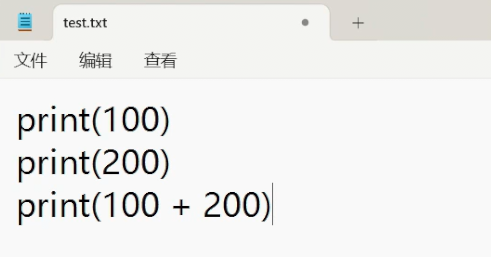
test.py,在其中写好代码并保存。
- 找到
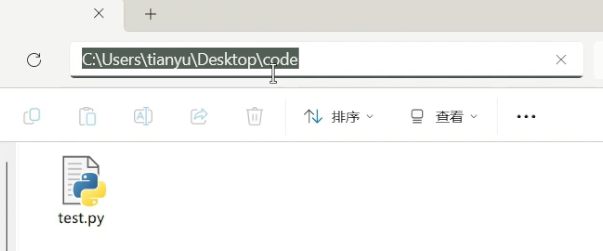
test.py所在的文件夹
- 在资源管理器上方输入
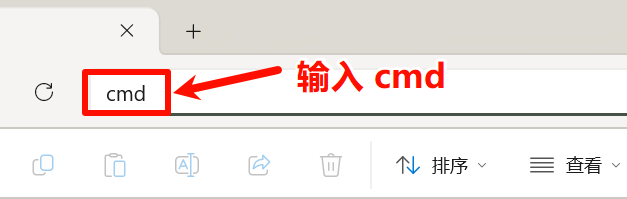
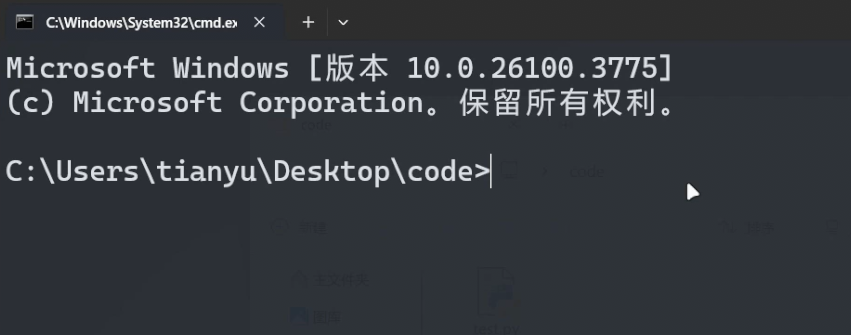
cmd并回车,就会打开命令提示符并进入当前路径。
- 在命令提示符中输入
python test.py执行程序,就会看到打印的内容。
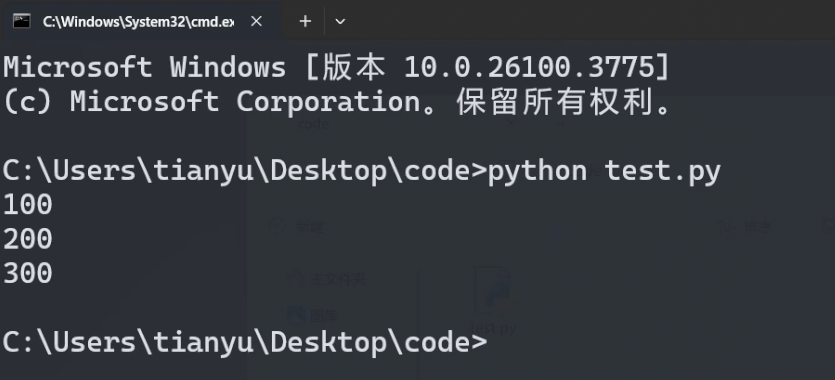
IDE模式
- 鼠标右键工程文件夹,选择新建 python 文件。
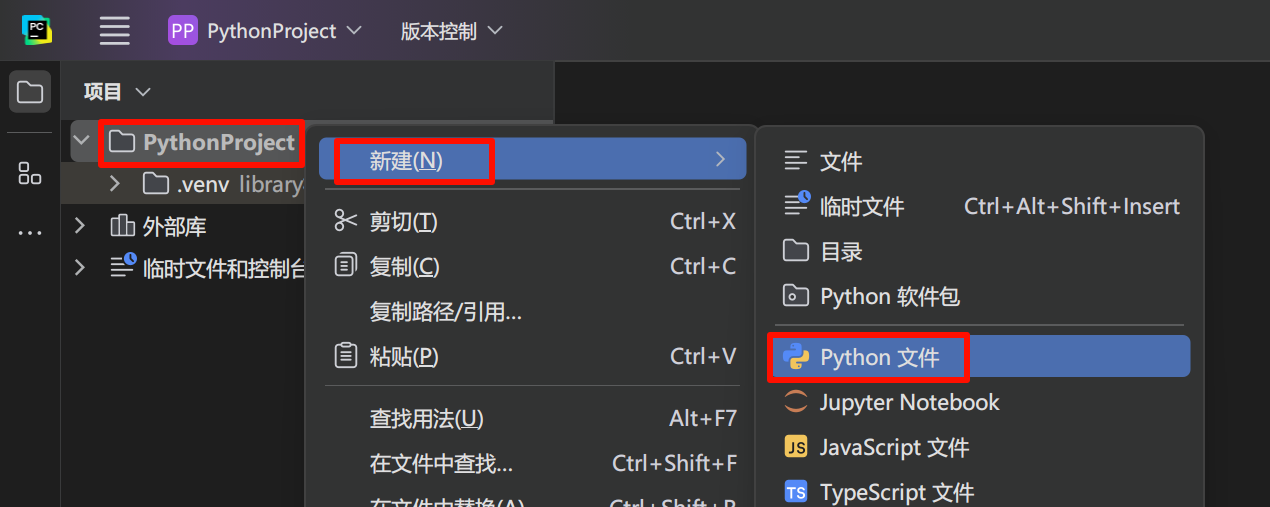
- 输入文件名,确认后按下回车
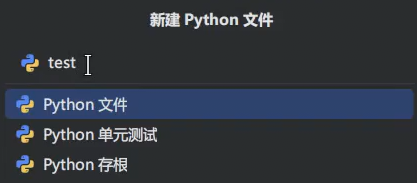
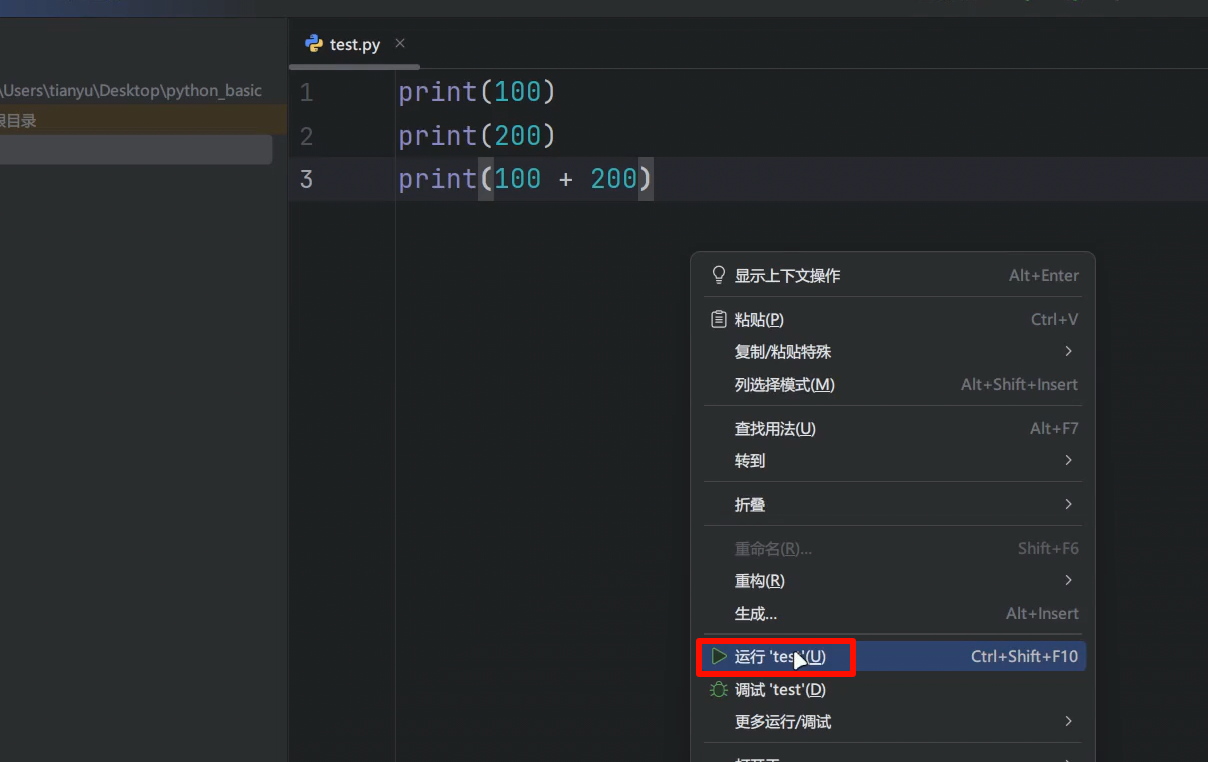
- 输入
print(100),随后在文件空白处点击鼠标右键,选择:运行test。
第 3 章 Python 核心基础
字面量
概述
来看这样一个场景:老师让学生把:姓名、年龄、体重写在纸上,纸上的文字,就是学生想要表达的内容,这些内容不需要计算、也不需要转换,就是字面上的含义,一看就能理解。
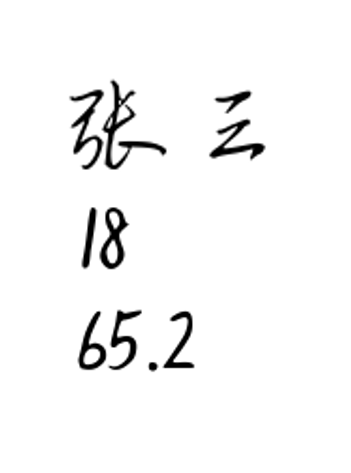
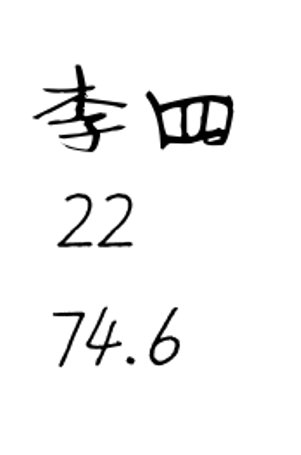
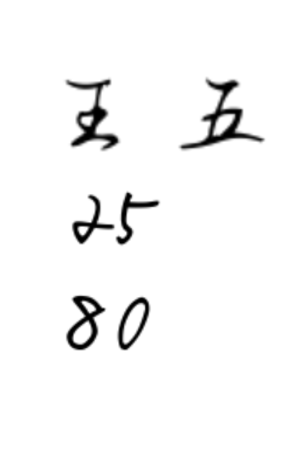
在程序中,也有上述这些“写出来就能被理解”的内容,这些内容在程序中叫做字面量,即:字面量就是直接写在代码中的“具体值”。
写法
下面代码中的内容,都是字面量。
'张三'
18
65.2

'李四'
22
74.6

'王五'
25
80
:::info
以上代码中的 '张三'、'李四'、'王五' 均为字符串。所谓字符串,就是由“字符”组成的“串”。例如,字符串 '张三' 由 '张' 和 '三' 两个字符构成。
从本质上看,字符串属于文本类型,可以由任意数量的字符组成——无论是中文、英文、数字,还是各种符号。此处我们只需对字符串的概念有初步认识,后续课程中将对其进行详细讲解。
:::
:::color4
📢注意:字符串必须要放到引号中,使用:单引号、双引号、三个单引号、三个双引号都可以,但必须是英文的引号。
:::
:::tips
📋****备注:写在 Python 文件头部的字符串,会被自动识别成 docstring(文档字符串),文档字符串的主要作用是:对当前 Python 文件进行说明,且文档字符串必须用三个双引号。
:::
"""这是我写的第一个Python文件"""

'张三'
18
65.2
变量与常量
变量
1️⃣前情回顾
在上一节中,我们通过字面量的形式,记录了张三的体重,例如:
65.2现在需要打印一些体重相关的内容,代码如下:
print('张三的体重是', 65.2)
print('对于', 65.2, '这个体重,张三觉得不满意')
print('张三决定开始减肥,希望体重比', 65.2, '还要小')📌小贴士:
- 使用
print(内容)可以输出内容(也叫:打印内容)这里说的“打印”不是打印在纸上,而是指:把内容呈现在控制台上。 - 使用
print(内容1, 内容2, 内容3)可以输出多个内容,不同内容之间用逗号做分隔,输出的多个内容默认会在同一行,且输出的多个内容之间会有一个空格。
📋备注:print()还有很多使用细节和技巧,后面会逐步介绍。
我们会发现,代码中的65.2被使用了 3 次,当要修改张三的体重为64.2时,就需要手动修改 3 个地方,修改起来会很麻烦,就像下面这样:
print('张三的体重是', 64.2)
print('对于', 64.2, '这个体重,张三觉得不满意')
print('张三决定开始减肥,希望体重比', 64.2, '还要小')2️⃣什么是变量?
变量是数据的“代号”它可以和数据建立绑定关系,通过变量可以使用数据,或更新数据,之所以叫变量,是因为:它和某个值的绑定关系,可以随时改变。
例如:在上述代码中,我们可以把体重值和某个『变量』建立一个『绑定关系』,以后用到体重的时候,直接“呼唤”这个变量就可以了。
3️⃣具体语法
语法为:变量名 = 值,例如下面代码中的:name、age、weight都是变量。
name = '张三'
age = 18
weight = 65.2📢注意:变量名不需要加引号!
4️⃣示例代码
使用weight变量存储体重值,并在后续代码中,多次使用weigth变量。
weight = 65.2
print('张三的体重是', weight)

print('对于', weight, '这个体重,张三觉得不满意')

print('张三决定开始减肥,希望体重比', weight, '还要小')
需要修改体重时,通过weight就可以修改,修改后再去使用weight时,就是修改后的值了。
weight = 65.2

weight = 64.2
print('张三的体重是', weight)

print('对于', weight, '这个体重,张三觉得不满意')

print('张三决定开始减肥,希望体重比', weight, '还要小')
5️⃣几个关键点
- 在数学中,像
1 + 1 = 2这样的等式表示:等号左边的1 + 1是具体的运算过程,等号右边的2是该运算的结果。 - 在代码
age = 18中,等号表示:将等号右侧的值与左侧的变量建立绑定关系。因此,当程序中需要表示年龄18时,可以使用变量age;同样,也可以通过age来修改该数值。 age = 18这一行代码也被称为“赋值语句”,意思是将右侧的18赋给变量age。- 在 Python 中,变量的创建与赋值是同时完成的。也就是说,当程序中出现一个变量时,它必须立即与某个值建立绑定关系。
- 变量名不应过于随意,命名时需要遵守一定的规则(具体命名规则将在下一小节讲解)。
1️⃣什么是标识符?
在程序中我们给: 变量、函数、类.....所起的名字,统称为标识符,即:在程序中所有我们可以自己起的名字,都是标识符。
2️⃣标识符命名规则如下:
- 只能包含:数字、字母、下划线,且不能以数字开头,不能包含空格。
- 区分大小写,即
Name和name是两个不同的标识符。 - 不能使用关键字(关键字的解释在下面⬇️)。
- 标识符尽量不要与内置函数同名。
- 标识符虽然没有长度限制,但应追求:简洁清晰,具有描述性。
3️⃣Python 中的关键字
所谓“关键字”,是指那些:已被 Python 语言预先保留、具有特定含义和功能的标识符。这些关键字被系统征用,因而不能再作为变量名、函数名或其他标识符使用。
False     	None      	True      	and       	as
assert    	async     	await     	break     	class
continue  	def       	del       	elif      	else
except    	finally   	for       	from      	global
if        	import    	in        	is        	lambda
nonlocal  	not       	or        	pass      	raise
return try while with yield📋备注:上述关键字暂不作详细说明。随着课程的推进,我们会在实际讲解中逐步接触并使用这些关键字,届时再进行深入解释。初学者无需在此阶段强行记忆(这也并不现实),随着使用频率的增加,便会在后续学习中自然掌握。
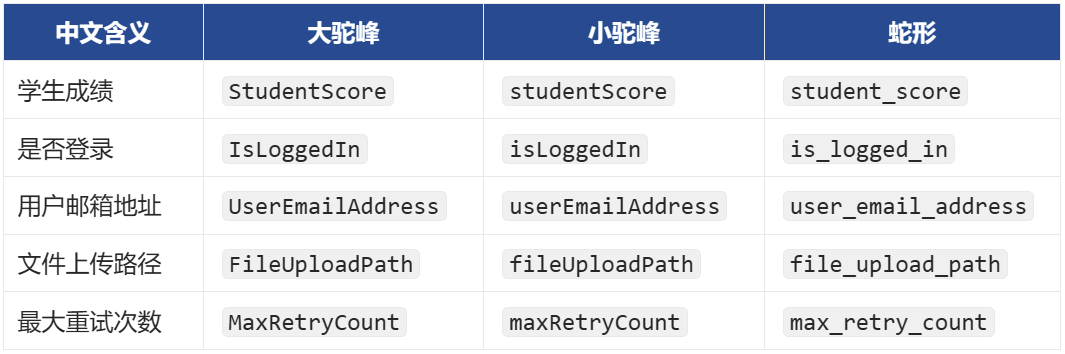
4️⃣常见的三种命名风格
- 大驼峰(UpperCamelCase): 每个单词的首字母大写,例如:
UserName - 小驼峰(lowerCamelCase): 首词的首字母小写,后面单词首字母大写,例如:
userName - 蛇形(snake_case):单词间用下划线连接,例如:
user_name
💡Python 中推荐使用『蛇形(snake_case)』写法。
举几个例子:
1️⃣什么是常量?
在程序中一旦被赋值,就不希望被修改的量(区别于变量)。
2️⃣具体语法
Python 中一般约定使用全大写变量名来表示常量,涉及到多个单词时,用下划线做分隔。
ADULT_AGE = 18
MONTHS_IN_YEAR = 12
MAX_USERS = 1200
PASSING_SCORE = 60
MAX_USERS = 13003️⃣Python 中没有强制的常量机制
当强制对常量进行修改时,最终也能改掉,但要自觉不改,这是 Python 程序员之间的约定。
MONTHS_IN_YEAR = 12
print(MONTHS_IN_YEAR)
MONTHS_IN_YEAR = 13

print(MONTHS_IN_YEAR)
注释
概述
注释是对代码的备注和解释,在代码执行的时,通常不起任何作用。
注释的作用
注释的核心作用如下:
:::info
- 提高代码的可读性,通常用来辅助程序员快速理解代码的逻辑。
- 屏蔽掉暂时不需要的代码。
:::
:::color4
📢注意:在代码中编写清晰易懂的注释,是程序员的基本素养之一!
:::
单行注释
在 Python 中#后的一行内内容,会被视为注释。
# name 是张三的名字
name = '张三'
# age 是张三的年龄
age = 18
# weight 是张三的体重(单位:kg)
weight = 65.2

print(name, age, weight)  # 这是一句打印
关于注释的书写格式:
:::info
- Python官方建议:在
**#**和注释的内容之间加一个空格,在代码和**#**之间加两个空格。 - 上述的规则属于 Python 编码规范,规范的具体内容,我们会在课程中逐渐给各位渗透。
:::
多行注释
多行注释又称“块注释” ,Python 中的多行注释使用的是一组三引号(单引号,双引号都可以)。
1️⃣多行注释可以换行,但不能嵌套。
"""
我是一些注释
我还是一些注释
"""2️⃣多行注释本质是一个多行字符串。
📢注意:Python 中并没有真正的多行注释语法,所谓多行注释的本质其实还是字符串。
print(
    """
    Hello World
    Hello world
    """
)它的作用是:指定当前文件的字符编码。
# coding=utf-8
print('你好啊!')
字符编码
概述
计算机对数据会进行两个常见的操作,分别是:存储数据、读取数据。
- 存储数据时,计算机会进行编码。
- 读取数据时,计算机会进行解码。
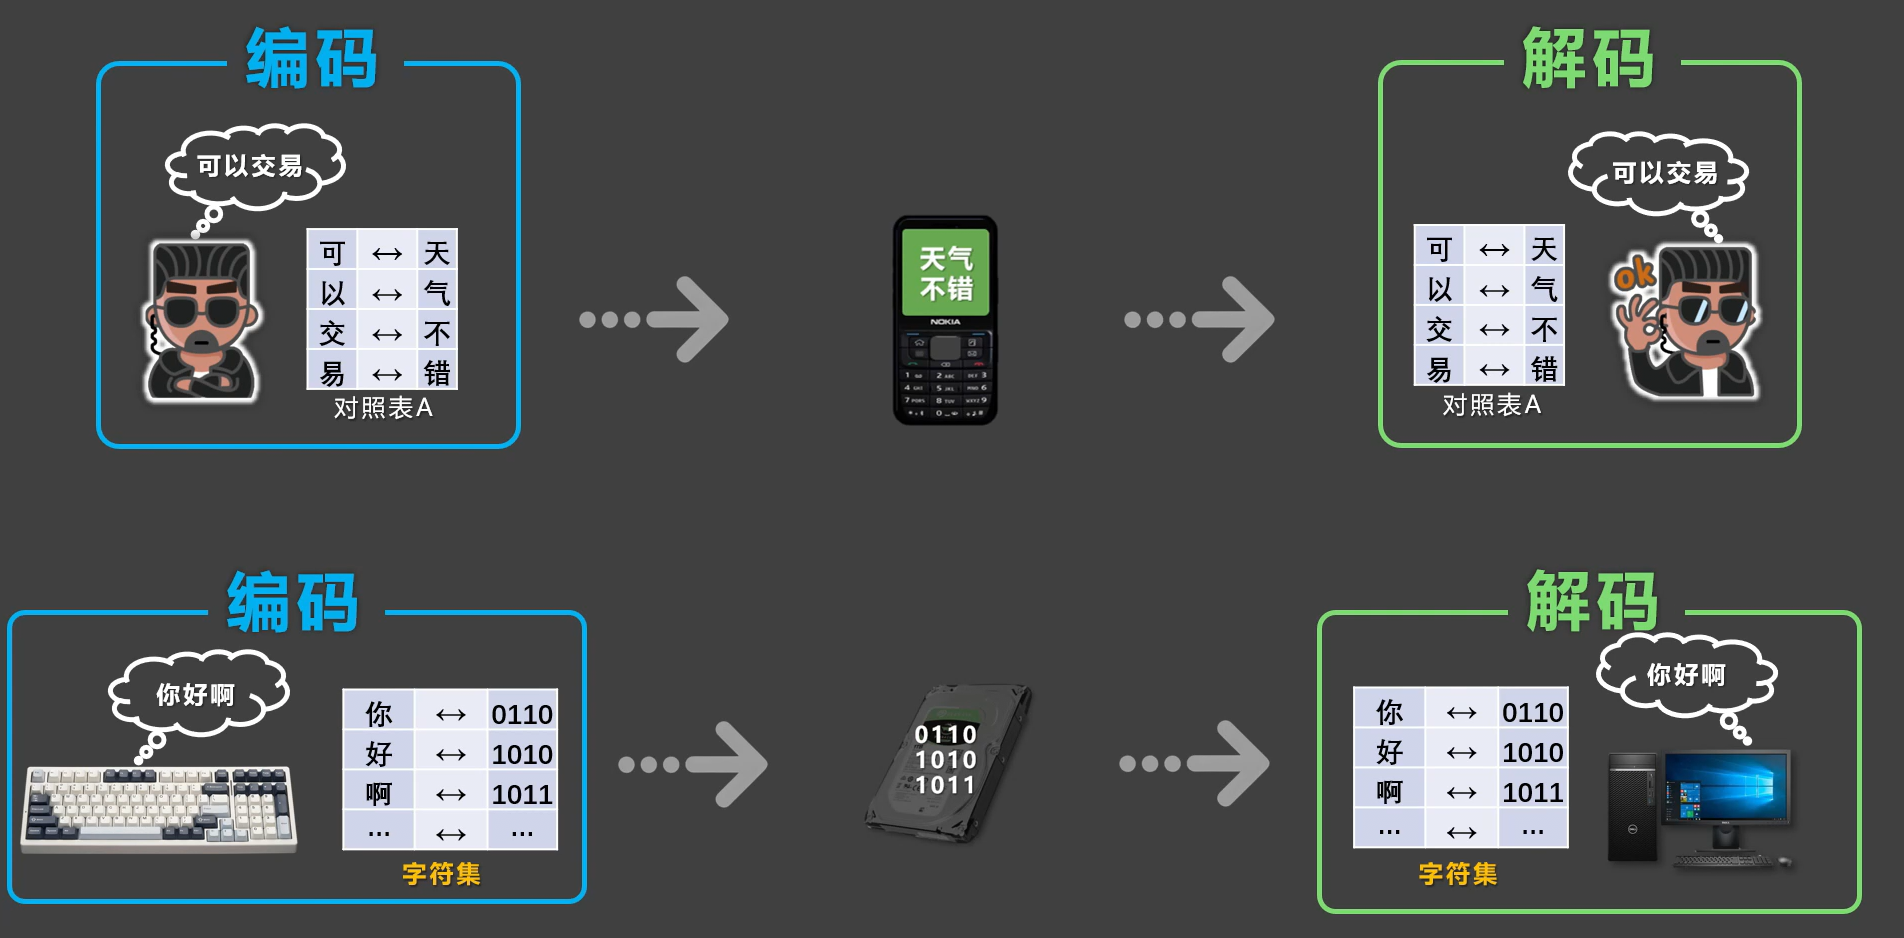
:::tips
编码与解码,会遵循一定的规范,这个规范就是字符编码,并且编码与解码,必须遵循相同的编码规范,若所用的规范不一致,就会出现乱码。
:::
# coding=iso-8859-1
print('你好啊!') # ä½ å¥½åï¼
常见编码方式
:::info
-
ASCII:大写字母、小写字母、数字、一些符号,共计 28个字符。 -
ISO 8859-1:在ASCII基础上扩展,支持西欧语言,共计 256 个字符。 -
GB2312:中国国家编码标准,收录约 6763 个简体中文常用汉字和符号。 -
GBK:兼容GB2312,进一步扩展,支持简繁体中文和其他汉字,共收录 2 万多个字符。 -
**<font style="color:#AD1A2B;">UTF-8</font>**:国际通用的编码格式,也叫“万国码”,支持世界所有语言的字符,包括:中文、英文、阿拉伯文、日文、韩文等,向下兼容ASCII,是现代互联网最常用的编码格式。
:::
:::success
✅最佳实践:实际开发中,几乎都采用UTF-8编码保存文件。
:::
:::tips
📋****备注:在 Python3 中,可以不写文件编码声明,因为 Python3 默认就使用UTF-8编码。
:::
数据类型
概述
就像生活中的物品,都有自己所属的分类一样,数据也有自己所属的『数据类型』。
例如之前写过的这段代码:
'张三'
18
65.2

"李四"
22
74.6
在上述代码中:
:::info
✅'张三'、"李四"这两个字面量,属于『字符串』类型。
✅18、22 这两个字面量,属于『整数****』类型。
✅65.2、74.6这两个字面量,属『浮点数****』类型。
:::
三种最常见的数据类型:
| 类型名称 | 英文名 | 举例 | 说明 |
|---|---|---|---|
| 整型 | int |
5, -3, 0, 2025 |
整数(不带小数点的数) |
| 浮点型 | float |
3.14, -0.01 |
带小数点的数 |
| 字符串 | **<font style="color:#DF2A3F;">str</font>**ing |
"Hello", 'Python' |
文本,要用引号包起来 |
:::tips
📋备注:数据类型不只上述的这三种,还有很多种,我们暂且先知道以上这三种即可,其他数据类型会在后续章节中逐步讲解。
:::
查看数据类型
通过type()可以查看数据类型,type()会返回当前数据的具体类型。
# 使用变量接收 type() 返回的类型
result1 = type('张三')
result2 = type(18)
result3 = type(72.5)

print(result1) # <class 'str'> 注意此处返回的不是string,是 string 的简写:str
print(result2) # <class 'int'>
print(result3) # <class 'float'>
:::color4
📢注意:在 Python 中:变量无类型,数据有类型。
例如a = 10,其中a是没有类型的,但a所关联的数据10是有类型的,10是整型,我们经常说a是整型,其实是一种不太严谨的表述,严谨的表述应该是:a所对应的数据10是整型。
:::
也可以把变量交给type(),最终返回的是:变量所对应的数据的类型。
name = '张三'
age = 18
weight = 72.5

# 使用变量接收type()返回的类型
result1 = type(name)
result2 = type(age)
result3 = type(weight)

# 打印这三个数据类型
print(result1)  # <class 'str'>
print(result2)  # <class 'str'>
print(result3)  # <class 'float'>
当然也可以不使用变量接收,直接打印type()的结果
name = '张三'
age = 18
weight = 72.5

# 打印这三个数据类型
print(type(name))  # <class 'str'>
print(type(age))  # <class 'str'>
print(type(weight))  # <class 'float'>
整型
1️⃣什么是整型?
所谓整型就是没有小数点的数字, Python 中的整型,可以是任意大小的整数,包括负整数。
2️⃣分隔符
当书写很大的数时,可使用下划线将数字分组,使其更清晰易读;Python 自动忽略数字之间的下划线,并且这种写法也适用于浮点数,但要注意:此种写法只有 Python3.6 及以上版本才支持。
num1 = 10_000_000
print(num1)3️⃣整型上限值
Python 中存储整数上限值的大小取决于:计算机的内存和处理能力,我们先来认识一下『幂运算符』,代码如下:
a = 3 ** 2  # 表示3的平方
b = 2 ** 3  # 表示2的3次方
print(a)  # 9

print(b)  # 8
通过幂运算,构建一个很大的数,随后打印它,我们会发现:代码报错了。
a = 9 ** 9999  # 9的9999次方

print(a)  # 打印x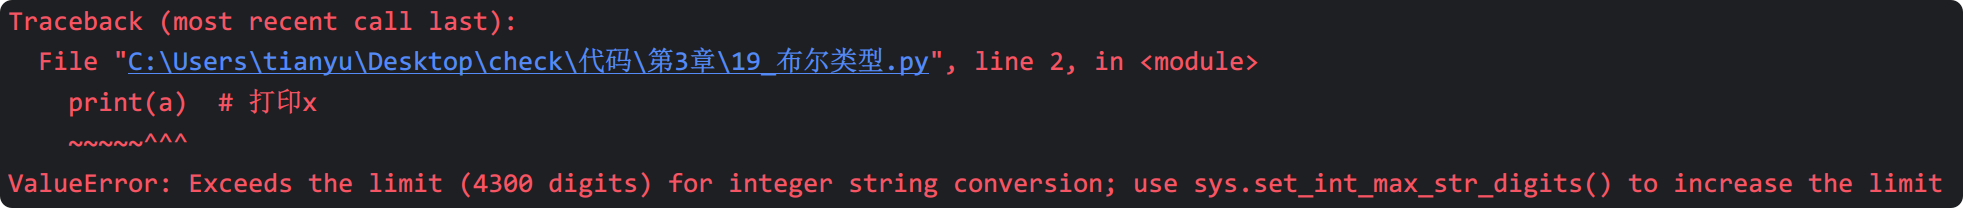
上面报错中提及了"Exceeds the limit (4300 digits)",但这并不代表 Python 最大只能表示4300位的数,比如我们把print删掉,会发现代码正常运行,并且此时的a也是可以正常参与数学运算的。
a = 9 ** 9999  # 9的9999次方

b = a + 100那加上了print(a)为什么报错呢?原因如下:
调用print(a)时,Python 底层会把a的类型转换成『字符串类型』再输出,而从 Python3.11 起,Python 对超大整数转换字符串的长度进行了限制,默认位数是4300位。
💡扩展知识(了解即可):
通过如下代码,可以解除字符串转换时的4300位限制,如下代码中包含模块相关内容,我们还没有讲到,所以不必纠结下面代码的具体含义,只需要先知道:4300位的限制可以修改即可。
import sys

sys.set_int_max_str_digits(0) # 设置为0表示不作任何限制
x = 9 ** 9999  # 9的9999次方

print(x)  # 打印x
浮点型
1️⃣什么是浮点型?
所谓浮点型,就是带小数点的数字,比如:3.14、-0.5、2.0都是浮点数。
2️⃣浮点型的表示方式
- 直接写
# 浮点型就是带有小数点的数字。
weight = 65.2
balance = 1425.58
out_temp = -25.2
price = 120.0- 科学计数法
# 浮点型的科学计数法表示。
speed_of_sound = 3.4e+2  # 3.4乘以10的2次方。
world_population = 7.8e9  # 7.8乘以10的9次方。
distance_sun_earth = 1.496E8  # 1.496乘以10的8次方。
speed_of_light = 2.998E+8  # 2.998乘以10的8次方。
one_ml = 1e-3  # 1乘以10的-3次方。

one_mg = 1E-3  # 1乘以10的-3次方。
字符串
1️⃣字符的四种定义方式
| 写法 | 示例 | 适用场景 |
|---|---|---|
| 单引号 | '你好,尚硅谷' |
单行字符串(不能直接换行,换行需要使用圆括号) |
| 双引号 | "你好,尚硅谷" |
|
| 三个单引号 | '''你好,尚硅谷''' |
多行字符串(可以直接换行) |
| 三个双引号 | """你好,尚硅谷"""" |
下面代码所表示的都是字符串:
# 单引号和双引号的写法是等价的,二者都不能直接换行(要用圆括号才能换行),单引号用的多。
message1 = '尚硅谷,让天下没有难学的技术!'
message2 = "尚硅谷,让天下没有难学的技术!"

# 三个单引号的写法,可以直接换行,并且可以作为多行注释使用。
message3 = '''尚硅谷,让天下没有难学的技术!'''

# 三个双引号的写法,可以直接换行,也可以作为多行注释使用,还能作为文档字符串使用。
message4 = """尚硅谷,让天下没有难学的技术!"""
2️⃣****字符串的格式化输出
写法 1:直接用加号进行拼接,写起来很麻烦,而且只能是字符串之间拼接。
name = '张三'
gender = '男'
weight = 65.2
age = 12
info1 = '我叫' + name + ',我是' + gender + '生'
写法 2:使用占位符。
具体规则:
%s占位字符串%f占位浮点数%i占位整数%d占位十进制的整数%s是万能的(如果我们提供的数据不是字符串,那 Python 就会把数据转成字符串)。
name = '张三'
gender = '男'
weight = 65.2
age = 12
info2 = '我叫%s,我是%s生,我体重是%f,年龄是%d' % (name, gender, weight, age)
写法 3:使用 f-string,这是目前 Python 最推荐的方式。
name = '张三'
gender = '男'
weight = 65.2
age = 12
info3 = f'我叫{name},我是{gender}生,我体重是{weight},年龄是{age}'
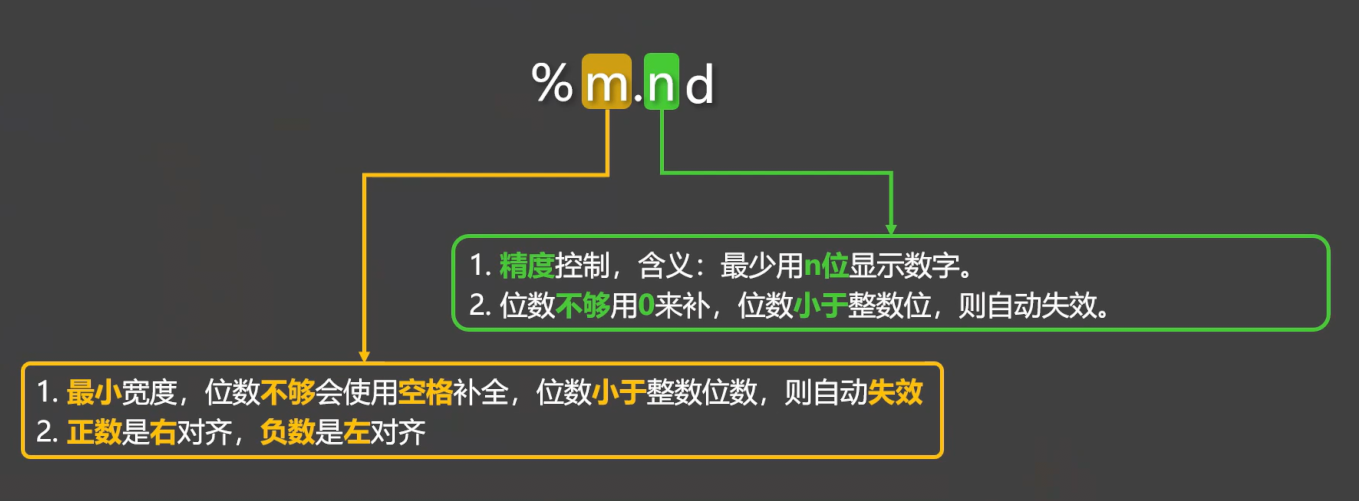
3️⃣占位符精度控
在占位符前方,可以使用m.n的形式来指定精度,具体规则见下图:
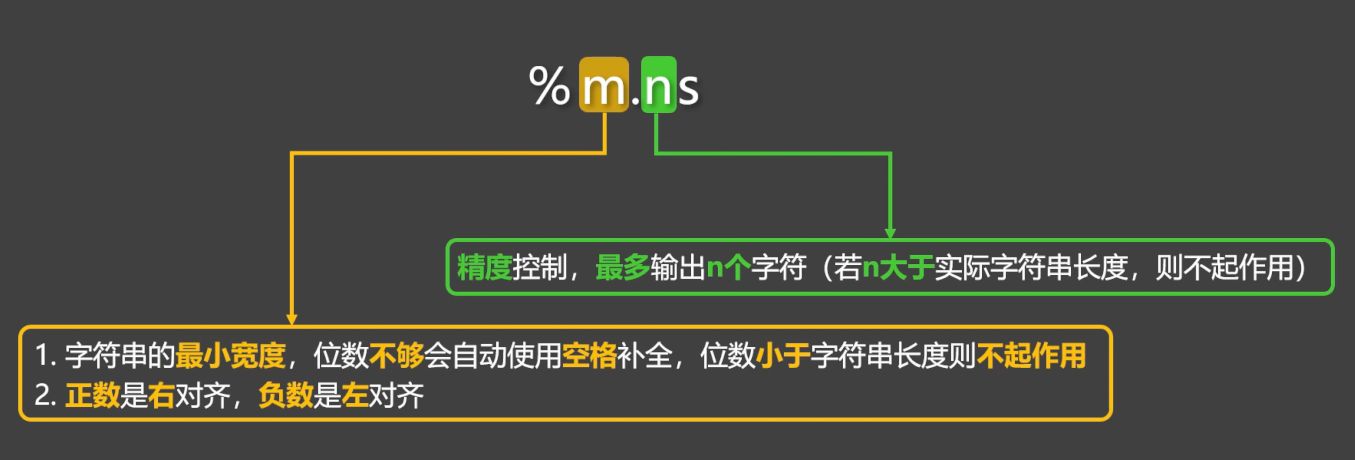
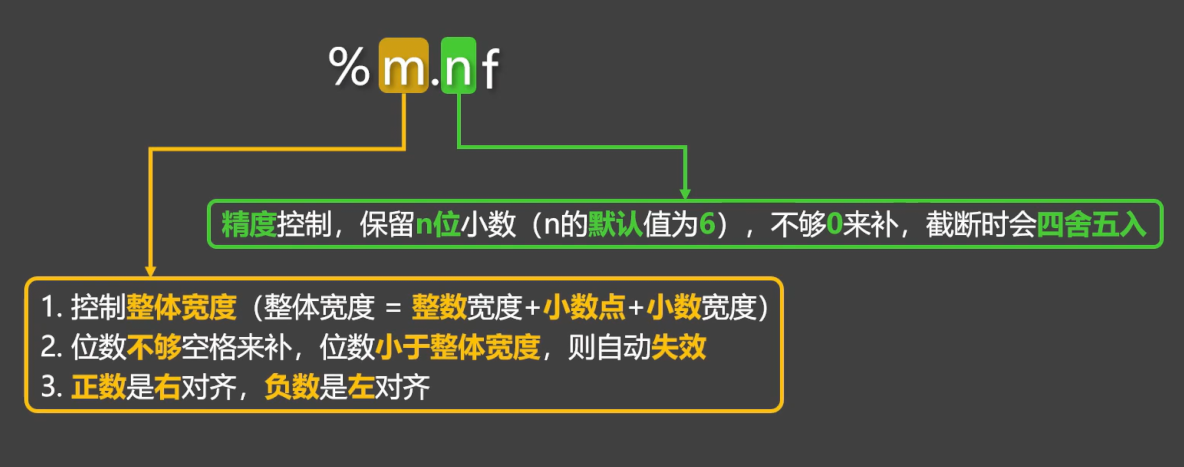
示例代码:
info = '我叫%-4.1s,性别是%3.2s,体重是%-9.3f,年龄是%-6.4d' % (name, gender, weight, age)
4️⃣转义字符
在字符串中,有些字符不能直接写(换行、制表符、引号等)这时就要使用转义字符。
例如下面的message字符串中包含了一个单引号,但如果就这样直接写,就会报错
print('在Python中,可以使用'包裹一个字符串')
使用转义字符后,即可正常输出:
print('在Python中,可以使用\'包裹一个字符串')
常见的转义字符梳理:
| 转义字符 | 表示的含义 |
|---|---|
\' |
' |
\" |
" |
\n |
换行 |
\\ |
\ |
\b |
删除前一个字符 |
\r |
使光标回到本行开头,覆盖输出 |
\t |
表示水平制表符(让光标跳转到下一个制表位) |
测试代码:
# 使用 \' 输出 '
print('在Python中,可以使用\'包裹一个字符串')

# 使用 \" 输出 "
print("在Python中,可以使用\"包裹一个字符串")

# 使用 \n 进行换行
print('注册会员需要以下信息:\n姓名\n年龄\n手机号')

# 使用 \\ 输出 \
print('D:\\nice')

# 使用 \b 删除前一个字符
print('helloo\b')

# 使用 \r 使光标回到本行开头,覆盖输出
print('67%\r68%')

# 使用 \t 表示水平制表符(让光标跳转到下一个制表位)
# 一个制表位到底是几位,是不确定的,但我们可以通过在字符串后面加.expandtabs()来指定位数。
print('1234123412341234')
print('ab\tcd.expandtabs(4)')
print('abc\td.expandtabs(4)')
print('abcd\ta.expandtabs(4)')
print('我是\t中文.expandtabs(4)')

print('12341234123412341234')
print('姓名\t性别\t年龄')
print('张三\t男\t\t18')
print('李四\t女\t\t25')
print('王五\t男\t\t32')
数据类型转换
概述
何为数据类型转换?—— 把一种类型的数据,变成另一种类型。
为什么要数据类型转换
例如下面这些场景中,我们得到的数据类型,和最终要用的数据类型是不一致的,那就需要类型转换:
:::info
- 用户输入的内容是都是字符串,若需要进行数学运算,就必须进行数据类型转换。
- 对文件进行写入操作时,要将其他类型的数据转为字符串。
- 从数据库中读取出的内容都是字符串若需要进行数学运算,也需要数据类型转换
......
:::
具体转换方式
通过以下函数,可以对数据类型进行转换
| 函数 | 说明 | 示例 |
|---|---|---|
| int(x) | 将x转换为一个整数 | 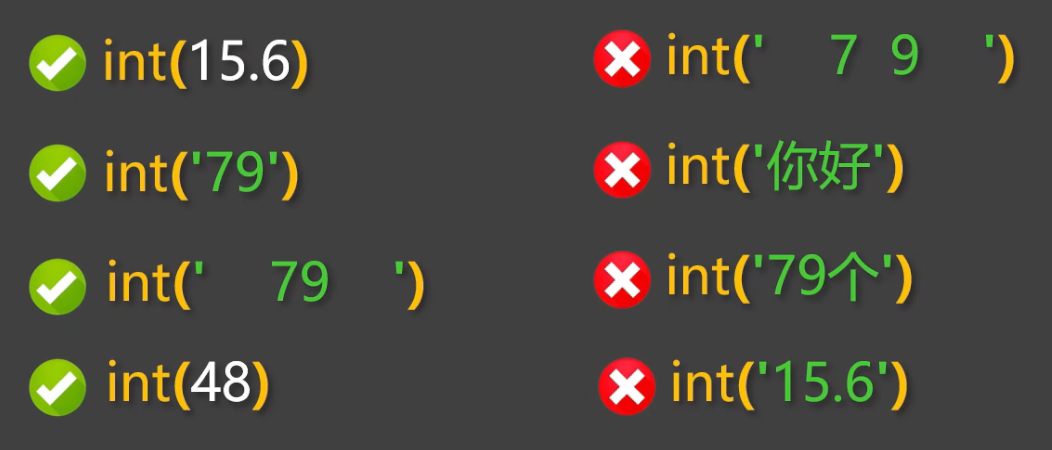 |
| float(x) | 将x转换为一个浮点数 | 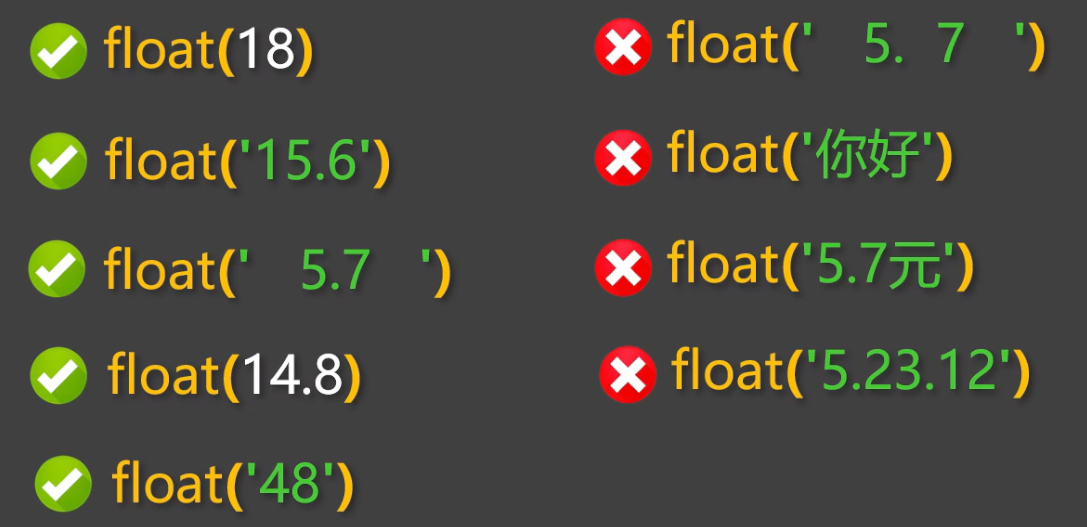 |
| str(x) | 将对象x转换为一个字符串 | 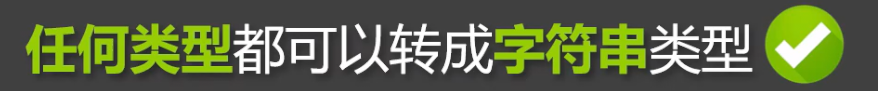 |
运算符
算数运算符
常用的算数运算符如下:
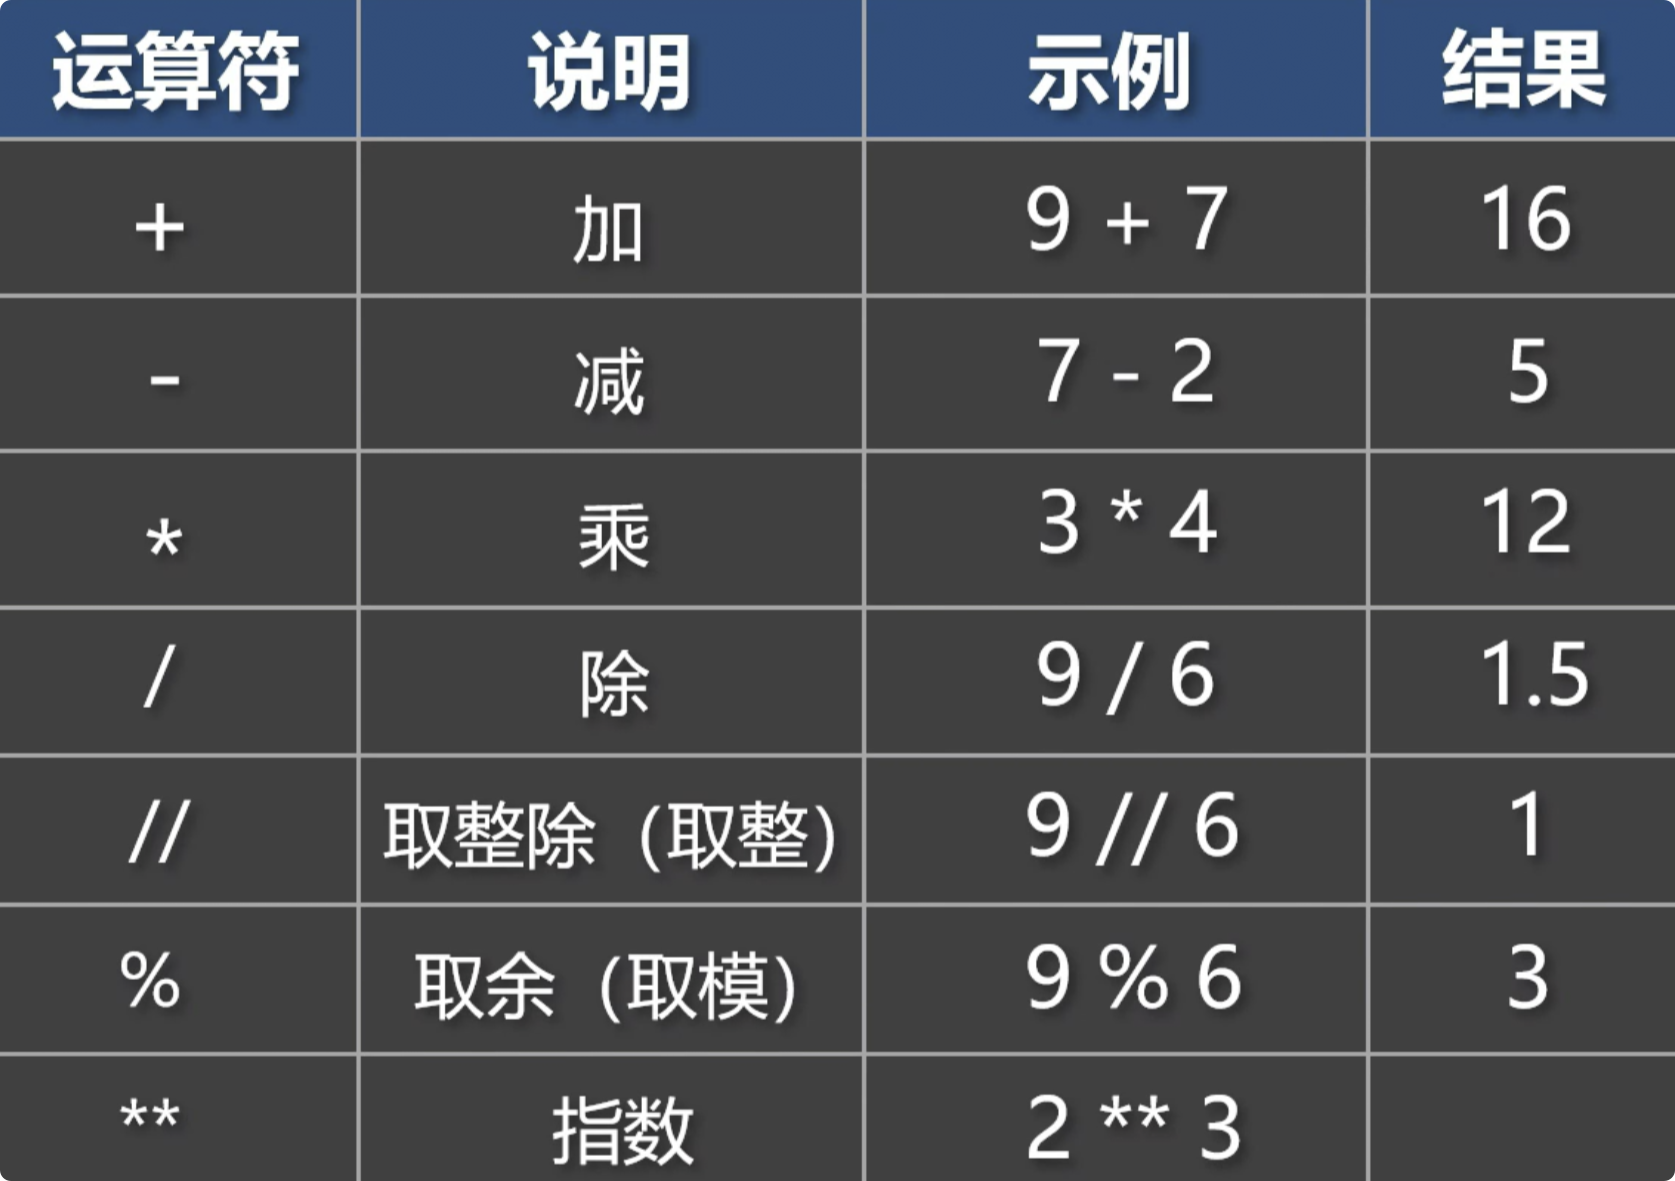
测试代码
# 加
print(9 + 7)
# 减
print(7 - 2)
# 乘
print(3 * 4)
# 除
print(9 / 3)
# 取整
print(9 // 6)
# 取余
print(9 % 6)
# 指数
print(2 ** 3)
赋值运算符
常用的赋值运算符如下:
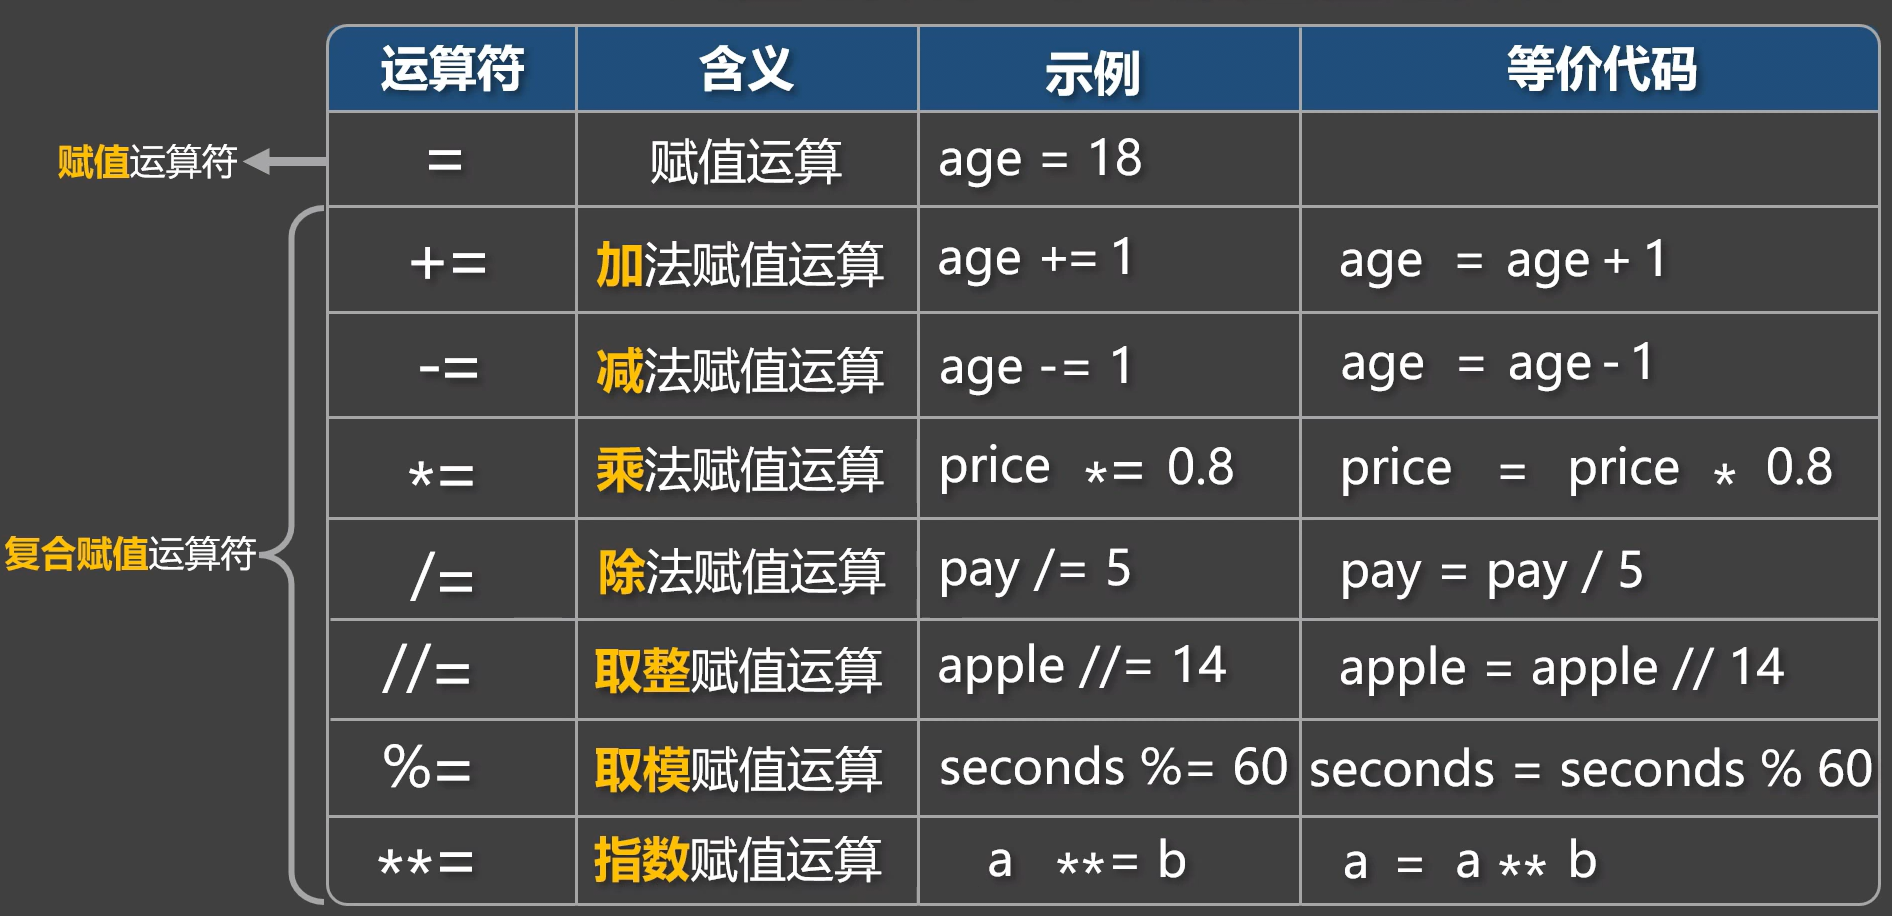
测试代码:
age = 18
print(age)

price = 52
print(price)
age = 18

# 加法复合运算符
age += 1  # 等价于:age = age + 1
print(age)

# 减法复合运算符
age = 18
age -= 1  # 等价于:age = age - 1
print(age)

# 乘法复合运算符
price = 100
discount = 0.8
price *= discount  # 等价于:price = price * discount
print(price)

# 除法复合运算符
pay = 100
num = 5
pay /= 5  # 等价于:pay = pay / num
print(pay)

# 取整赋值运算符
apple = 31
num = 14
apple //= num  # 等价于:apple = apple // num
print(apple)

# 取模赋值运算符
seconds = 386
minutes = 60
seconds %= minutes  # 等价于:seconds = seconds % minutes
print(seconds)

# 指数赋值运算符
a = 2
b = 3
a **= b  # 等价于:a = a ** b
print(a)
比较运算符
常用的比较运算符如下:
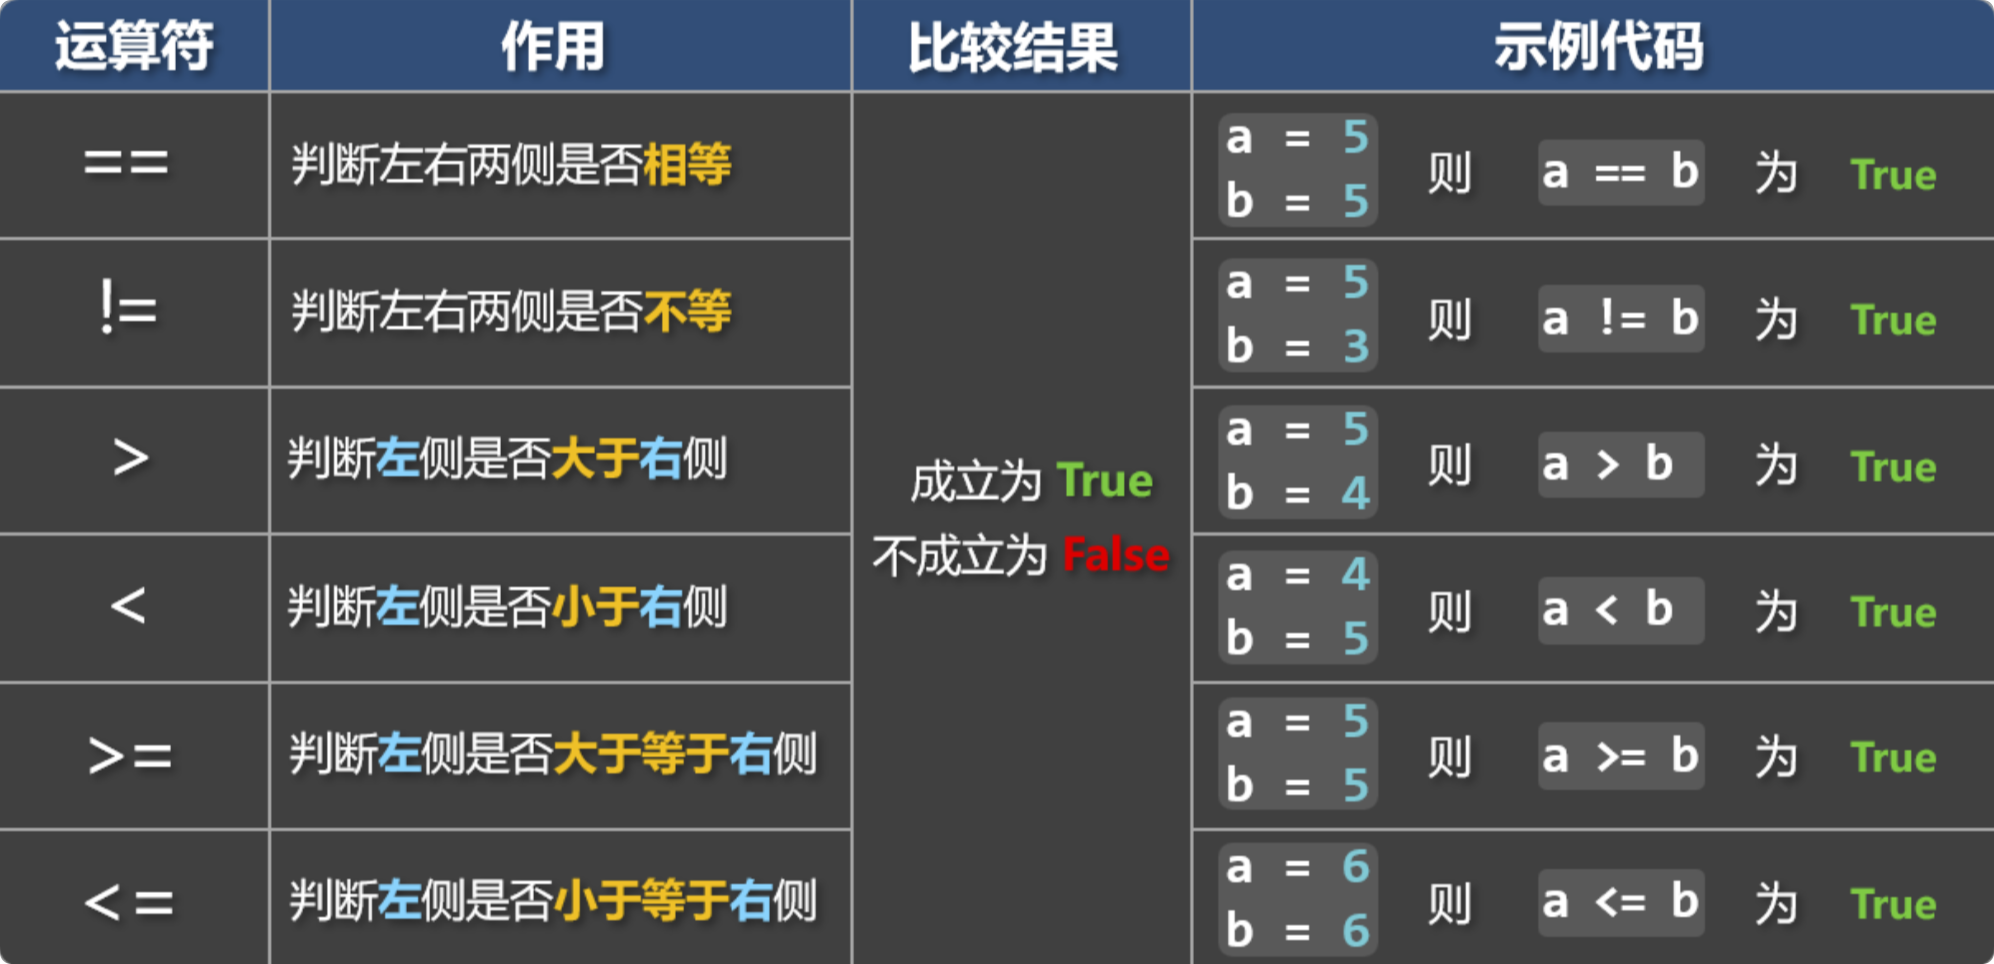
:::tips
📋备注:True 和 False 是布尔类型,会在下一小节讲,暂且先知道:True 表示真,False 表示假。
:::
# 使用==判断左右两侧是否相等
a = 5
b = 7
c = '5'
result = a == c
print(result)

# 使用!=判断左右两侧是否不等
a = 5
b = 7
c = '5'
result = a != c
print(result)

# 使用>判断左侧是否大于右侧
a = 9
b = 7
c = '5'
result = a > b
print(result)

# 使用<判断左侧是否小于右侧
a = 3
b = 7
c = '5'
result = a < b
print(result)

# 使用>=判断左侧是否大于等于右侧
a = 6
b = 7
c = '5'
result = a >= b
print(result)

# 使用<=判断左侧是否小于等于右侧
a = 9
b = 7
c = '5'
result = a <= b
print(result)

# 以上这些比较运算符,同样适用于字符串
msg1 = 'abc'
msg2 = 'abc666'
print(msg1 == msg2)

msg1 = 'abc'
msg2 = 'abc'
print(msg1 != msg2)
:::info
📌****小贴士:
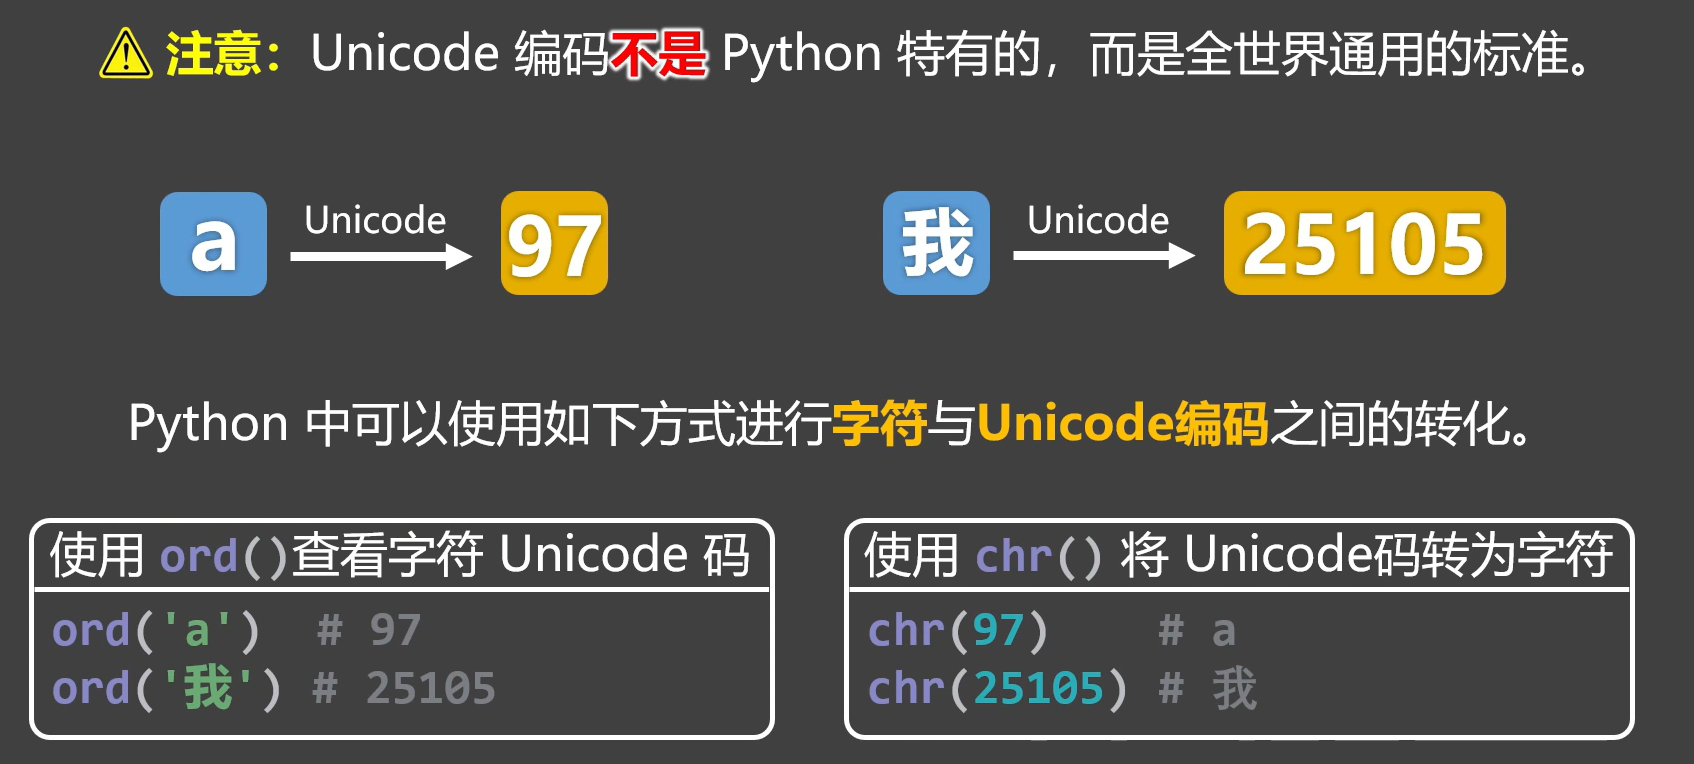
- 字符串进行比较时,是依次比较每个字符的 Unicode 编码。
- Unicode 编码是一种全球通用的字符编码标准,它会给每个字符都分配一个“身份证号”。
:::
具体比较规则是:
:::info
- 从左到右,依次比较两个字符串中的字符。
- 先比较第一个字符:
- 如果两个字符不相等,就直接根据它们的 Unicode 码值比较大小。
- 如果相等,则继续下一步。
- 继续比较下一个字符,依次往后进行,直到遇到不相等的字符为止。
- 当出现不相等的字符时,比较它们的 Unicode 码大小,后续的字符将不再参与比较。
:::
# 使用ord()查看指定字符的Unicode编码
print(ord('a'))
print(ord('我'))

# 使用chr()将Unicode编码转为字符
print(chr(97))
print(chr(25105))

msg1 = 'abc'
msg2 = 'xyz'
msg3 = '我爱你'
msg4 = '中国'
msg5 = 'abc'
msg6 = 'abcdef'
print(msg3 <= msg1)
布尔类型
我们之前讲的这些类型:字符串、整型、浮点型,这些类型中,每一种类型都有无限多的具体值。
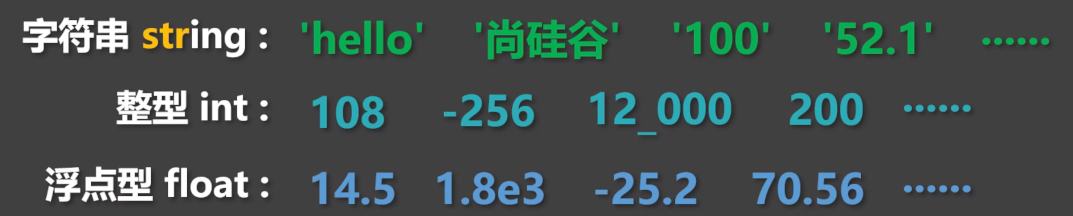
但布尔类型的具体值,只有两个,分别是:True和False,其中:True表示真,False表示假。
布尔值常用于表示:条件是否成立、事件是否发生、操作是否成功、等逻辑状态。
:::color4
📢注意:True 和 False 的首字母必须大写。
:::
# 自己定义的布尔值
a = True
b = False

# 靠程序执行得到的布尔值
c = 5 > 3
d = 7 < 2

print(type(a), a)  # True
print(type(b), b)  # Flase
print(type(c), c)  # True
print(type(d), d)  # Flase
布尔类型是int类型的子类型,底层的本质是用1表示True,用0表示False。
# 布尔类型是int类型的子类型,底层的本质是用1表示True,用0表示False
print(int(True))   # 1
print(int(False))  # 0

print(4 + True)   # 5
print(8 - False)  # 8

print(True + True)   # 2
print(True - False)  # 1

print(7 > True)    # True
print(False <= 0)  # True
Python中除0以外的任何数,转为布尔值后都为 True
# 使用bool()将指定内容转为布尔类型
print(bool(1))  # True
print(bool(0))  # False

print(bool(300))  	# True
print(bool(25.6))  	# True
print(bool(1.8e3))  # True
print(bool(12_000)) # True
print(bool(-10))  	# True
Python中除空字符串以外的任何字符串,转为布尔值都是 True
print(bool('hello')) # True
print(bool('0'))	 # True
print(bool('18.5'))	 # True
print(bool('-9'))	 # True
print(bool(''))	     # False
逻辑运算符
常用的逻辑运算符如下:
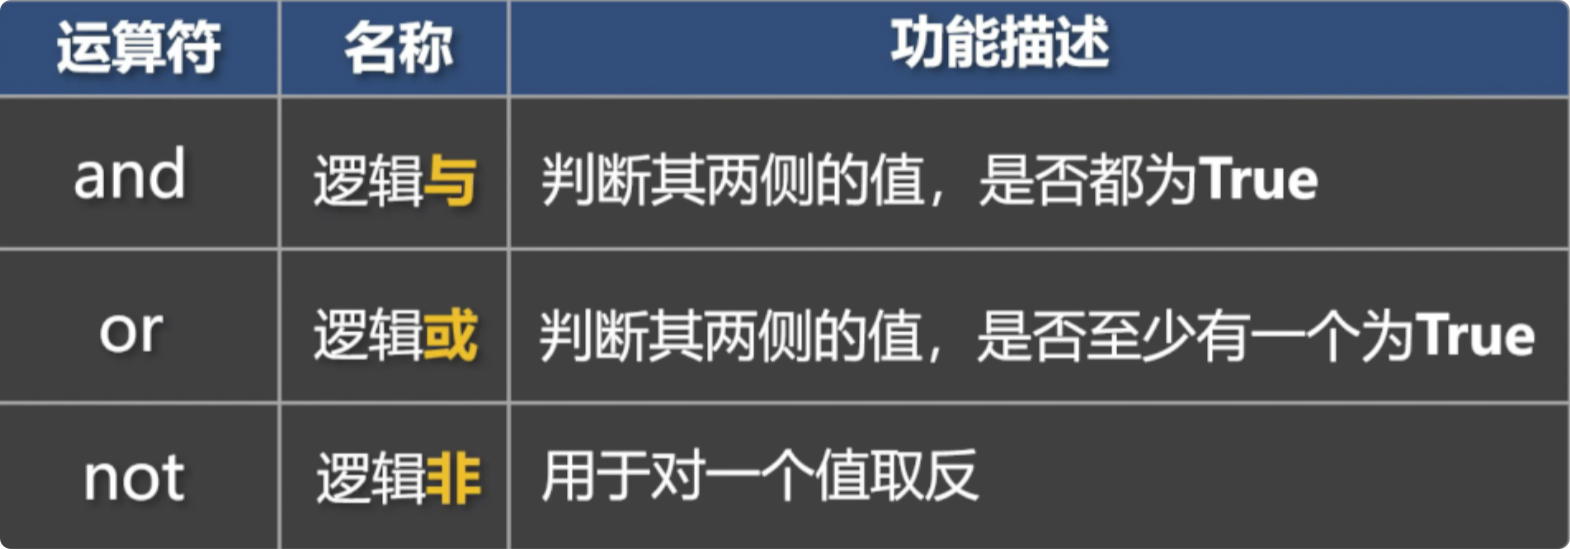
1️⃣and 运算符:用于判断其两侧的值,是否都为True
print(True and True)   # True
print(True and False)  # False
print(False and True)  # False
print(False and False) # False

print(8 > 7 and 8 > 7) # True
print(8 > 7 and 2 > 3) # False
print(2 > 3 and 8 > 7) # False
print(2 > 3 and 2 > 3) # False
and具备“逻辑短路”能力,以下代码中包含3/0这种错误代码,但最终没有报错。
print(False and 3 / 0)  # False
print(3 > 9 and 3 / 0)  # False
and返回的不一定是布尔值,它返回的是某个参与计算的值本身,and会先看左边,如果左边是“假”,就直接返回左边,否则返回右边;若参与and运算的值不是布尔值,那 Python 会自动转为布尔值,然后再进行逻辑操作。
print(2 - 2 and True) # 0
print('' and True)
print(True and 8 / 2)  # 4.0
print(3 + 3 and 3 * 4) # 12
2️⃣or 运算符:用于判断其两侧,是否至少有一个为True(只要有一个是True,那就返回True)
print(True or True)    # True
print(True or False)   # True
print(False or True)   # True
print(False or False)  # False

print(9 > 2 or 9 > 2)  # True
print(9 > 2 or 3 < 1)  # True
print(3 < 1 or 9 > 2)  # True
print(3 < 1 or 3 < 1)  # False
or同样具备“逻辑短路”的能力,以下代码中包含3/0这种错误代码,但最终没有报错。
print(True or 3 / 0) # True
print(9 > 3 or 3 / 0) # True
or返回的也不一定是布尔值,它返回的是参与计算的值本身,or会先看左边,如果左边为“真”,就直接返回左边,否则返回右边;若参与or运算的值不是布尔值,那 Python 会自动转为布尔值,然后再进行逻辑操作。
print(7 - 2 or False)    # 5
print('你好' or '尚硅谷') # 你好
print(False or 8 / 2)	 # 4.0
print(2 - 2 or 3 * 4)    # 12
3️⃣not 运算符:not用于取反,不过要注意:如果参与not运算的值不是布尔值,那 Python 会自动将其转为布尔值,然后再进行逻辑操作。
print(not True)  # False
print(not False) # True
print(not 3 > 2) # False
print(not 3 < 2) # True
not返回的值,一定是布尔值!
print(not 0) 	  # True
print(not 3 > 2)  # False
print(not 9 // 4) # False
print(not 'abc')  # False
进制
概述
进制是指:用多少个符号,来表示数值的一种『记数方式』。比如我们平时使用的『十进制』,就是用0 ~ 9这十个符号来表示所有的数,而计算机中存储和运算的数据,都是二进制,常见的进制与规则如下:
:::info
二进制:0 ~ 1,满2进1。
八进制:0 ~ 7,满8进1。
十进制:0 ~ 9,满10进1。
十六进制:0 ~ 9,A-F,满16进1。
:::
:::tips
📋****备注: 在十六进制中,除了0 ~ 9这十个数字外,还引入了字母,以便表示超过9的值,字母A对应十进制的10,字母B对应十进制的11,同理字母 C、D、E、F 分别对应十进制的:12、13、14、15。
:::
各进制的表示如下图:
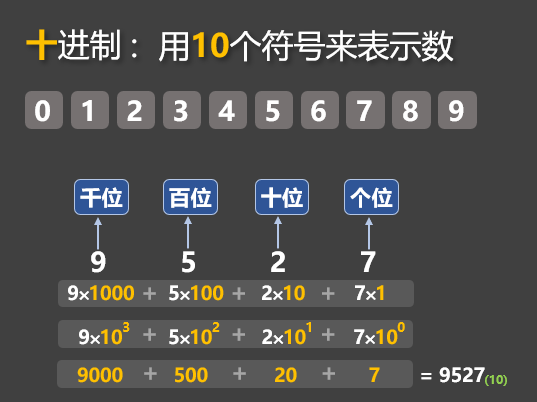
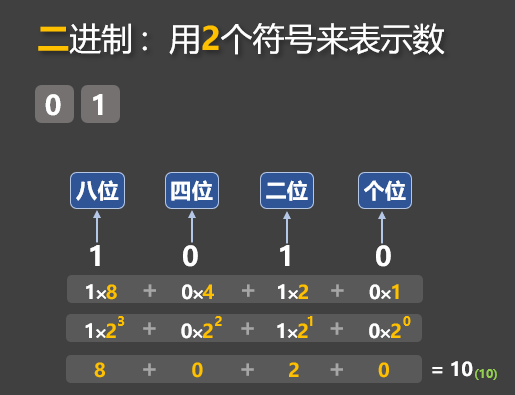
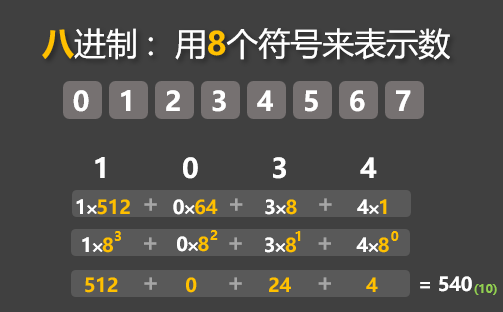
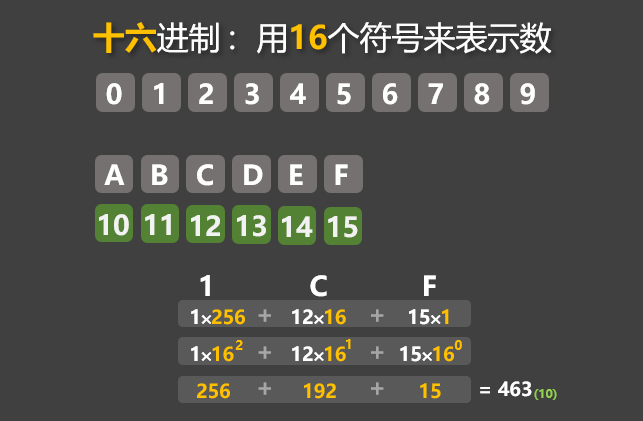
代码中如何表示不同进制
在 Python 中,不同进制的数,有不同的前缀:
:::info
二进制:以0b或0B开头表示。
八进制:以0o开头表示
十进制:无需前缀,正常编写即可。
十六进制:以0x或0X开头表示,此处的A-F不区分大小写。
:::
# 0b开头表示二进制
num1 = 0b11001
# 0o开头表示八进制
num2 = 0o1034
# 0x开头表示十六进制
num3 = 0x1cf
:::tips
📋****备注:Python 中所有的『非十进制』数字,只是代码层面的编写方式,只是给程序员看的,Python 在进行:计算、打印等操作时,会自动将这些『非十进制』数字,转为『十进制』数字。
:::
# 0b开头表示二进制
num1 = 0b11001
# 0o开头表示八进制
num2 = 0o1034
# 0x开头表示十六进制
num3 = 0x1cf

# Python 在对上面的 num1、num2、num3进行计算、打印等操作时,会自动将其转为十进制
print(num1, num2, num3)  # 25  540  463
print(num1 + 1)  # 26
print(str(num2)) # 540
print(num3 > 400) # True
不同进制之间的转换
1️⃣手动转换:使用连除法
:::info
十进制转二进制:不断用 2 去除这个数,直到商为 0,然后把每次的余数倒着写即可。
十进制转八进制:不断用 8 去除这个数,直到商为 0,然后把每次的余数倒着写即可。
十进制转十六进制:不断用 16 去除这个数,直到商为 0,把每次的余数倒着写,若余数 ≥ 10,则依次用 A、B、C、D、E、F 表示 10~15。
:::
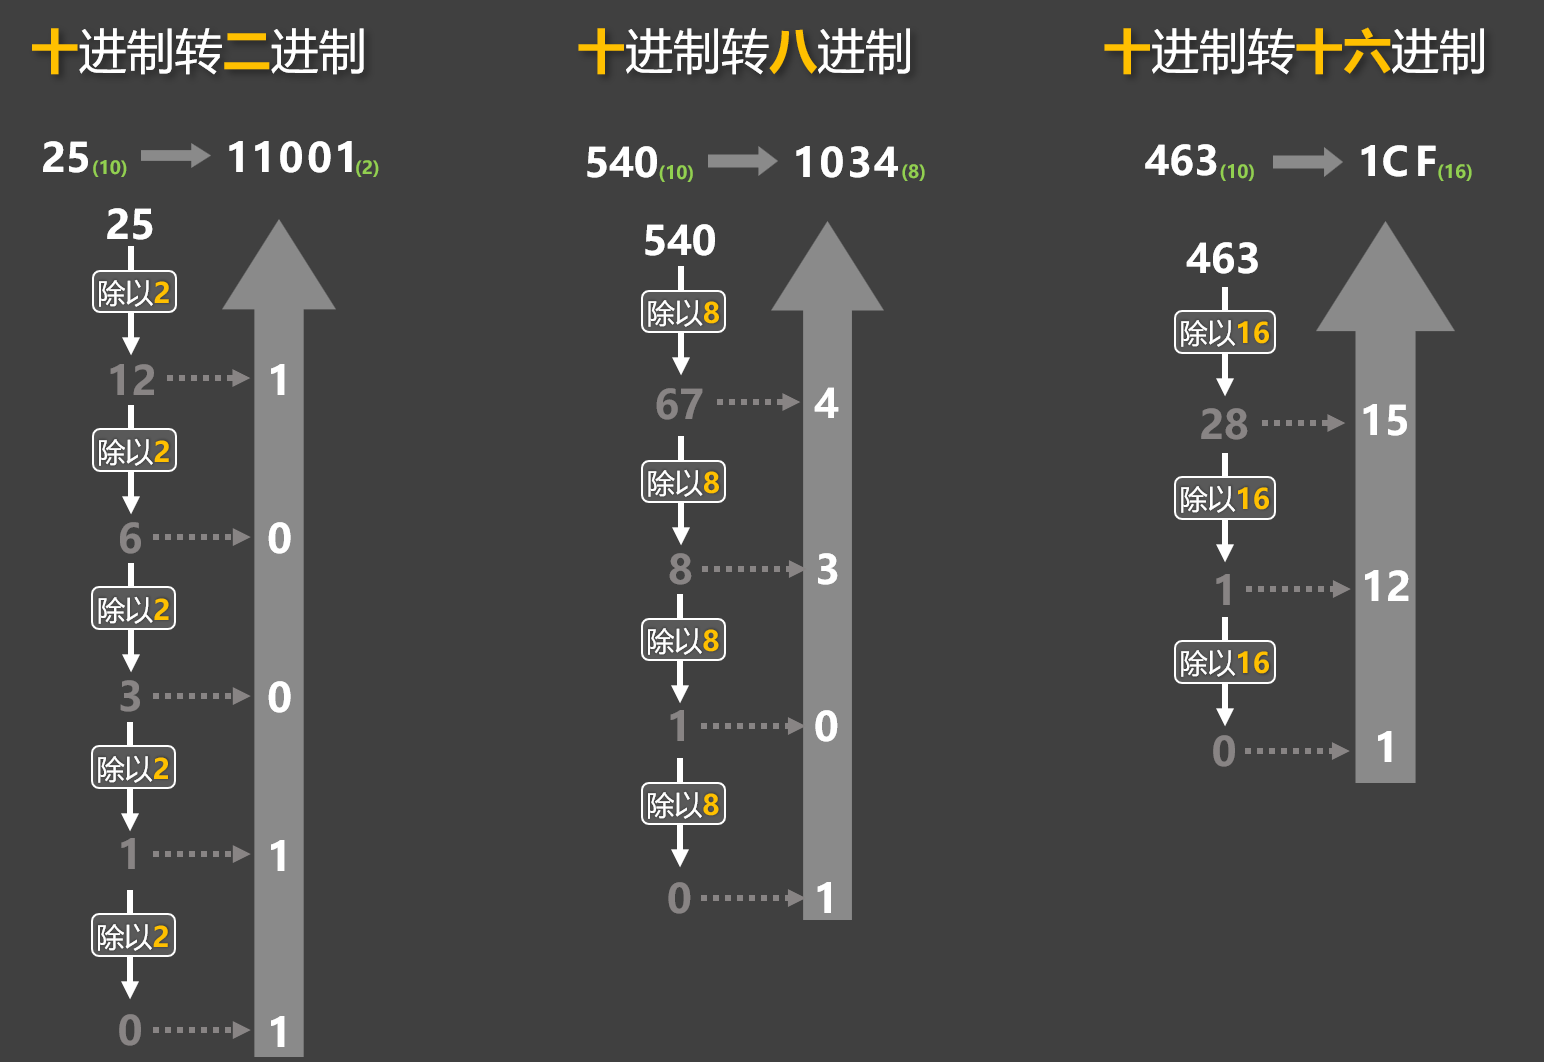
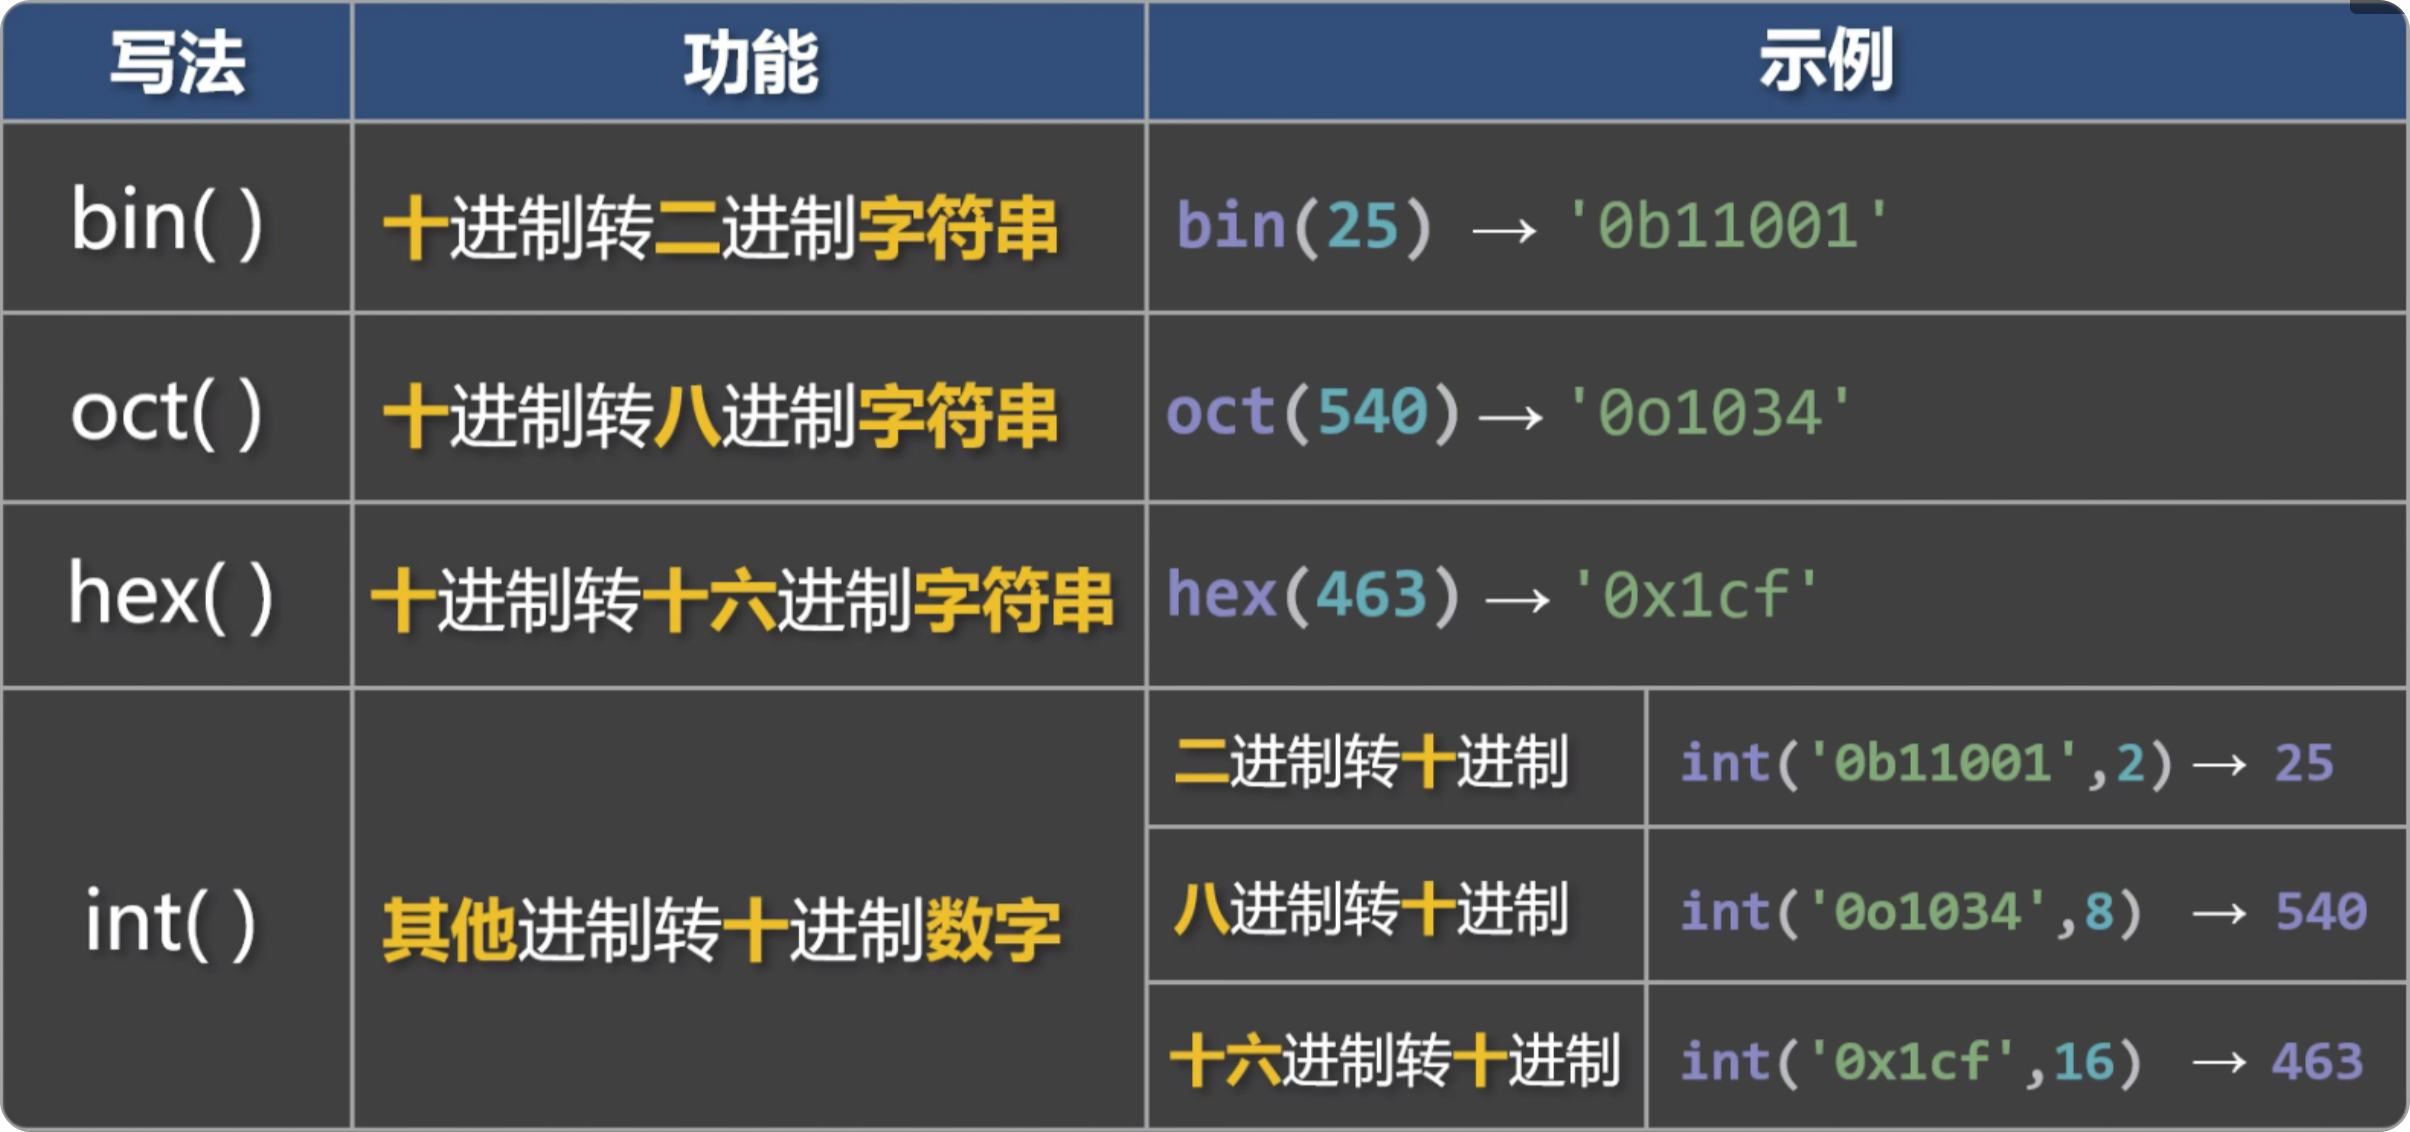
2️⃣借助 Python 提供的内置函数,实现进制转换
输入语句
在 Python 中,输入语句用于:从键盘接收用户输入的内容。
# 使用input()获取用户的输入
name = input('请输入你的姓名:')
age = input('请输入你的年龄:')

# input()获取到的内容全都是字符串类型
print(type(age))
:::tips
📋****备注:程序执行到 input() 时,会暂停等待用户的输入,用户输入后敲下回车,程序继续运行。
:::
input()所获取到的内容全都是字符串类型,不过我们可以手动进行数据类型转换。
age = int(input('请输入你的年龄:'))
第 4 章 流程控制语句
程序并不是简单的“从上到下”执行,很多时候,我们希望程序能根据不同的情况,做出不同的选择,比如:根据情况跳过某些代码,或者重复执行某些代码,那这时就需要用到『流程控制语句』,程序的执行流程大体上可分为三类:顺序、分之、循环。
:::tips
📋****备注:其中顺序执行是最简单的,就是按照程序的编写顺序依次执行,所以我们不再探讨顺序执行。
:::
分之
- 分支有很多其他的称呼,比如:条件控制语句、分支语句、选择语句。
- 分之是通过条件判断,来决定执行哪些代码。
单分支
1️⃣****语法格式:
if 判断条件:
    条件【成立】时执行的代码1
    条件【成立】时执行的代码2
    ......
2️⃣****语法图解:
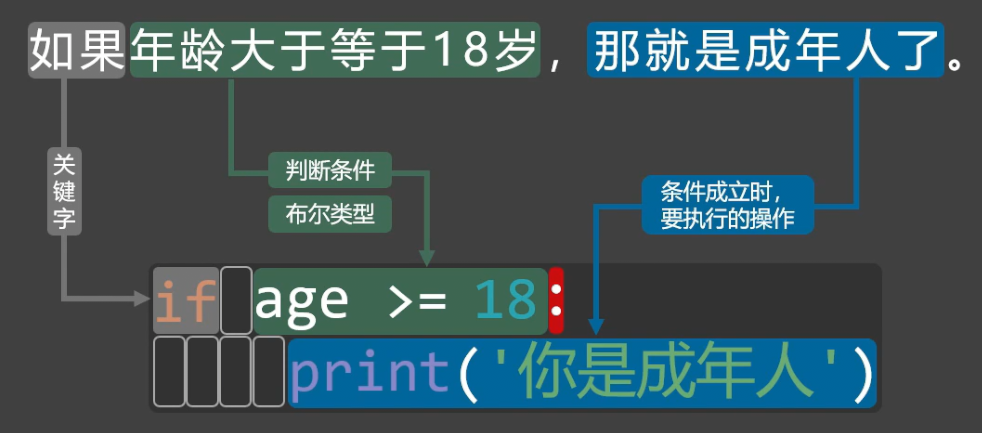
:::color4
⚠️注意:Python 靠代码缩进来识别代码范围,所以条件成立时要执行的代码前,必须加空格。
:::
3️⃣****示例代码:
age = int(input('请输入你的年龄:'))
if age >= 18:
    print('你是成年人')
    print('成年人的世界,虽不容易,但很精彩!')
print('欢迎你来学习Python!')
双分支
1️⃣****语法格式:
if 判断条件:
    条件【成立】时执行的代码1
    条件【成立】时执行的代码2
else:
    条件成【不成立】时执行的代码1
    条件成【不成立】时执行的代码2
2️⃣****语法图解:
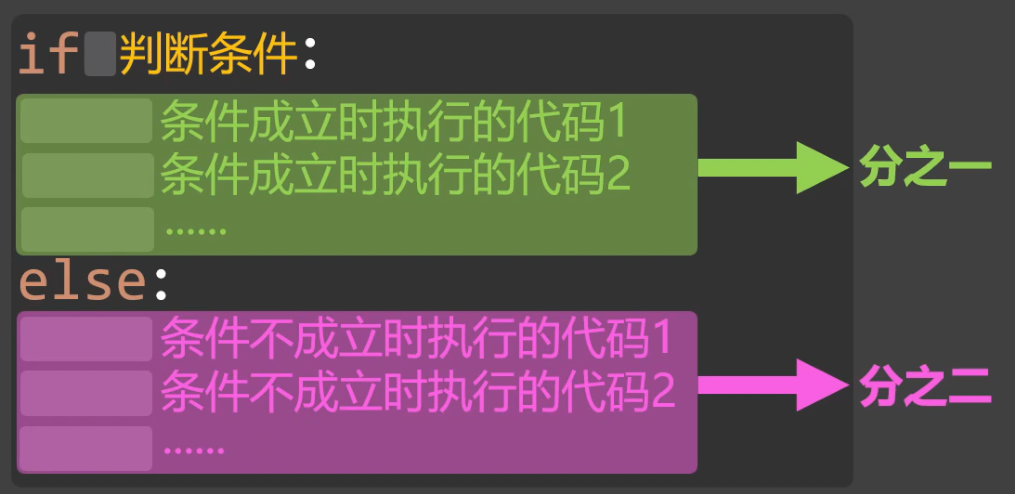
3️⃣****示例代码:
age = int(input('请输入你的年龄:'))
if age >= 18:
    print('你是成年人')
    print('成年人的世界,虽不容易,但很精彩!')
else:
    print('你是未成年人')
    print('好好加油,努力学习,未来可期!')
print('欢迎你来学习Python!')
多分支
1️⃣****语法格式:
if 判断条件1:
    条件1【成立】时执行的代码
elif 判断条件2:
    条件2【成立】时执行的代码
elif 判断条件3:
    条件3【成立】时执行的代码
else:  # else如不需要可以省略
    上述所有条件都不成立时执行的代码
2️⃣****语法图解:
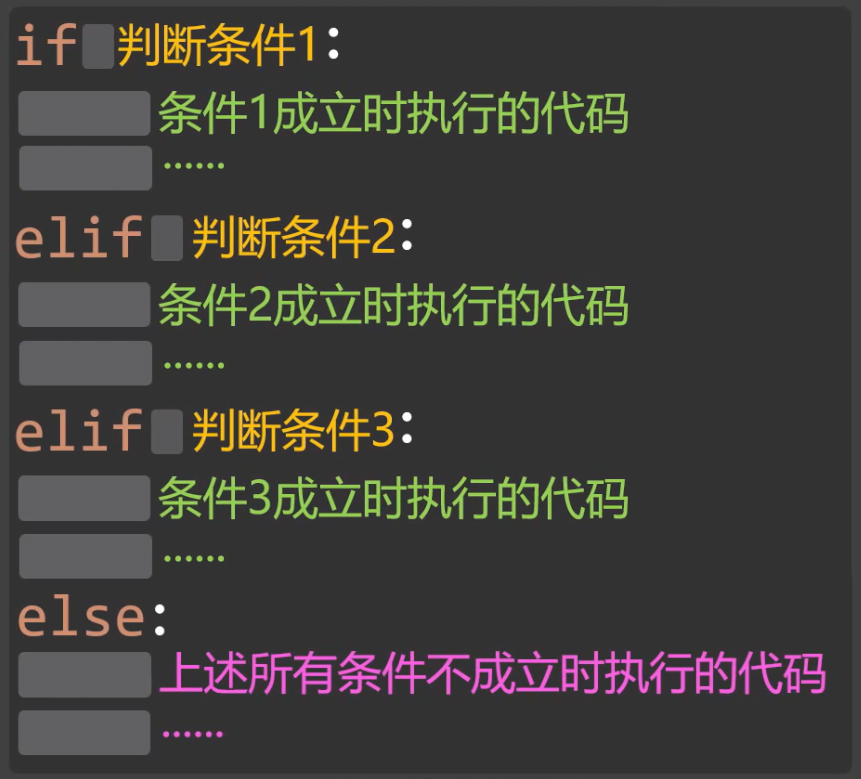
3️⃣****示例代码:
# 根据年龄来判断处于人生哪个阶段。
age = int(input('请输入你的年龄:'))
if age <= 10:
    print('你是幼儿')
elif age <= 18:
    print('你是青少年')
elif age <= 30:
    print('你是青年')
elif age <= 50:
    print('你是中年')
elif age <= 60:
    print('你是中老年')
else:
    print('你是老年')
使用多分支语句时,需要注意下面几点:
:::info
- 一个
if语句只能匹配1个else语句,但可以匹配多个elif语句,并且else语句要在所有的elif语句之后。 - 一旦某个分支语句检测为
true,其他的elif以及else语句都将不再执行。
:::
嵌套分之
1️⃣****语法格式:
if 判断条件1:
    # 条件1 成立时执行的代码1
    # 条件1 成立时执行的代码2
    # ......
    if 判断条件2:
        # 条件2 成立时执行的代码1
        # 条件2 成立时执行的代码2
        # ......
    elif 判断条件3:
        # 条件3 成立时执行的代码
        # ......
    else:
        # 条件2、条件3 都不成立时执行的代码1
        # 条件2、条件3 都不成立时执行的代码2
        # ......
else:
    # 条件1 不成立时执行的代码1
    # 条件1 不成立时执行的代码2
    # ......
    if 判断条件4:
        # 条件4 成立时执行的代码
        # ......
    else:
        # 条件4 不成立时执行的代码
        # ......
2️⃣****语法图解:
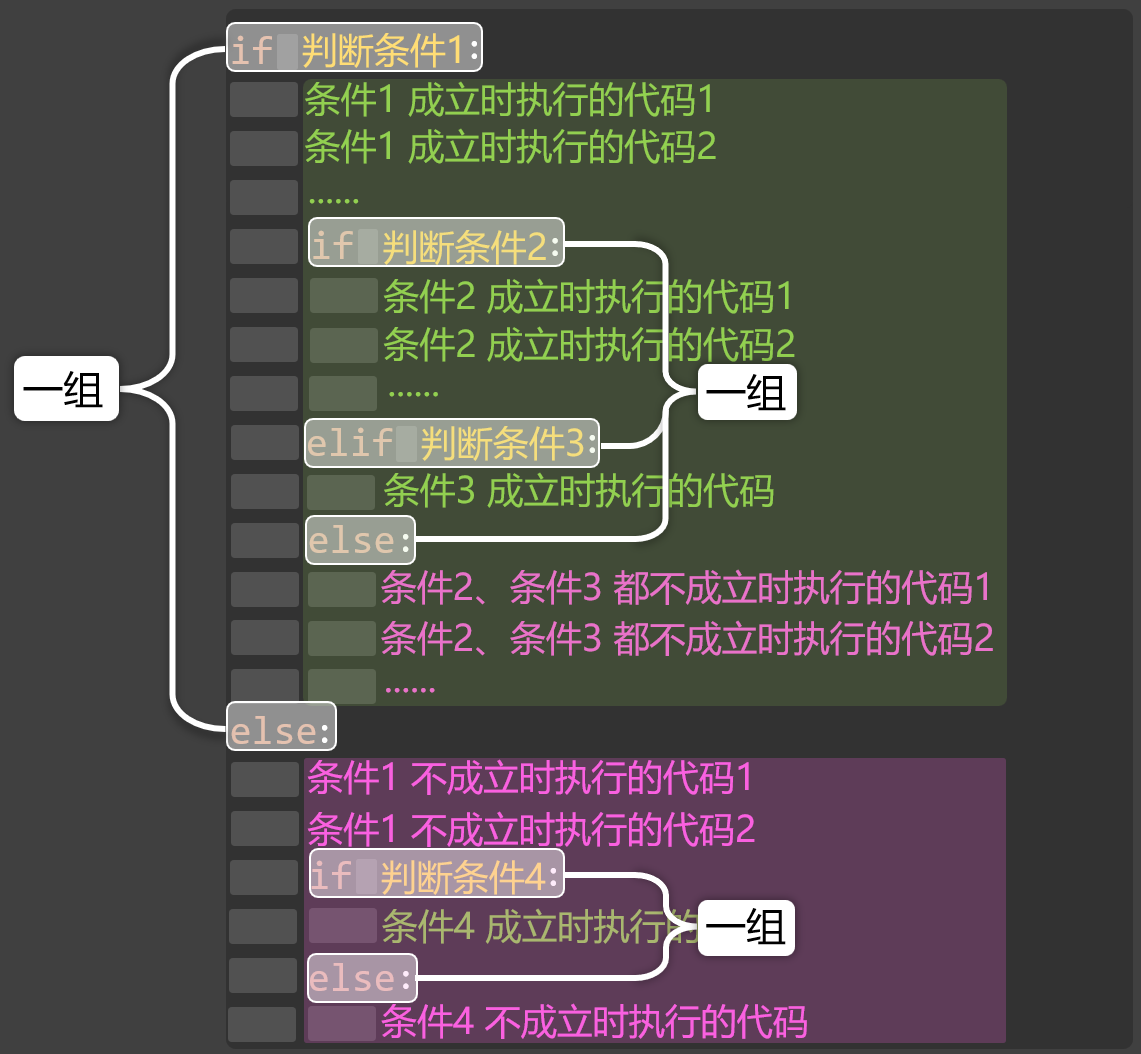
3️⃣****案例:
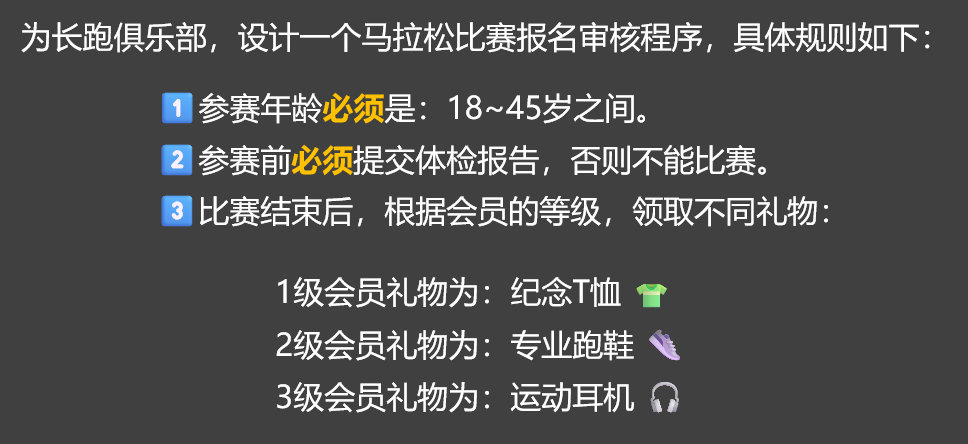
age = int(input('请输入你的年龄:'))
has_report = input('您是否提交了体检报告?(是/否)')
level = int(input('请输入你的会员等级(1/2/3)'))

print('******⬇️程序的识别结果如下⬇️:******')
if 18 <= age <= 45:
    print('✅️您的年龄符合比赛要求!')
    if has_report == '是':
        print('✅️您已提交体检报告!')
        print('✅️您可以参加比赛!')
        if level == 1:
            print(f'😊尊敬的{level}会员,比赛结束后,您可以领取纪念T恤👕一件!')
        elif level == 2:
            print(f'😊尊敬的{level}会员,比赛结束后,您可以领取专业跑鞋👟一双!')
        elif level == 3:
            print(f'😊尊敬的{level}会员,比赛结束后,您可以领取运动耳机🎧️一副!')
        else:
            print('❌您输入的会员等级不正确!')
    elif has_report == '否':
        print('❌您未提交体检报告,不能参加比赛!')
    else:
        print('❌您输入的体检报告有误!')
else:
    print('❌抱歉,参赛年龄需要在18~45之间!')
循环
循环是一种让代码“重复执行”的机制,当某个条件成立时,程序会反复执行一些语句,直到条件不再满足时,再停止运行。
while 循环
1️⃣****语法格式:
while 循环条件:
    条件成立时执行的操作1
    条件成立时执行的操作2
2️⃣****循环逻辑:
:::tips
- 先判断循环条件是否成立(是否为
True) - 如果成立 → 执行循环中的代码
- 执行完循环体 → 再次判断循环条件
- 若仍成立 → 继续执行循环中的代码
- 若不成立 → 循环结束
:::
3️⃣****代码示例:
n = 1
while n <= 10:
    print(f'第{n}次你好啊')
    n += 1
print(f'我是while循环以外的代码,执行到这里时,循环已经结束了,此时的n是:{n}')
:::color4
📢注意:如果条件一直成立,就是无限循环(死循环)。例如上述代码中,如果忘记编写n += 1就会产生死循环。
:::
4️⃣****案例:
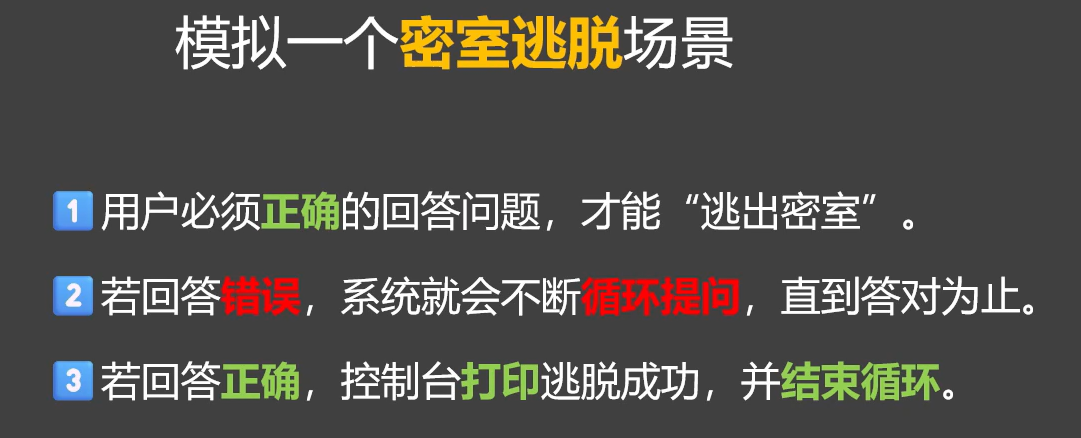
print('😦您现在身处密室,需要正确回答问题之后,才能逃出密室!')
riddle = '你是什么人?'
answer = '你的心上人'
guess = ''

while guess != answer:
    print(f'问题:{riddle}')
    guess = input('请输入答案:')
    if guess == answer:
        print('✅️答案正确,逃脱成功!')
    else:
        print('❌️回答错误,请再想想!')
for 循环
1️⃣****语法格式:
for 临时变量 in 可迭代对象:
    要执行的操作1
    要执行的操作2
:::info
💡****什么叫『可迭代对象』?
比如我们有一个盒子,里面装着:苹果、香蕉、橙子。我们可以一个接一个地把水果取出来,那这个盒子,就相当于 Python 中的可迭代对象。每次 for 循环执行时,其实就是在“取出一个水果”,目前我们还没学到“类”和“对象”,先记住一句话: 能一个个取出来的,就是可迭代的。
:::
2️⃣****循环逻辑:
:::tips
- 从可迭代对象中取出第一个元素 → 赋值给临时变量
- 执行循环中的代码
- 取出下一个元素 → 重复执行
- 当所有元素取完后 → 循环结束
:::
3️⃣****代码示例:
# 使用for循环遍历range()所指定的数字范围
n = 0
for n in range(1, 11):
    print(f'第{n}次你好啊')
print(f'我是for循环以外的代码,执行到这里时,循环已经结束了,此时的n是:{n}')

# 使用for循环遍历字符串
for m in 'abcdef':
    print(m)

# 演示由于误操作造成的死循环(下面代码中,用到了列表,我们后面会讲解)
# 备注:for循环还能遍历很多我们没有讲到的东西,比如:元组、列表、对象......
nums = [1,2,3]
for i in nums:
    # nums.append(4) # 此行代码会造成死循环
    print(i)
:::info
以上代码中的:range(1, 11)、'abcdef'、[1,2,3]这些都是可迭代对象,我们后面还会遇到很多可迭代对象。
:::
4️⃣****案例:实现一个字符串加密程序,大致思路如下图:
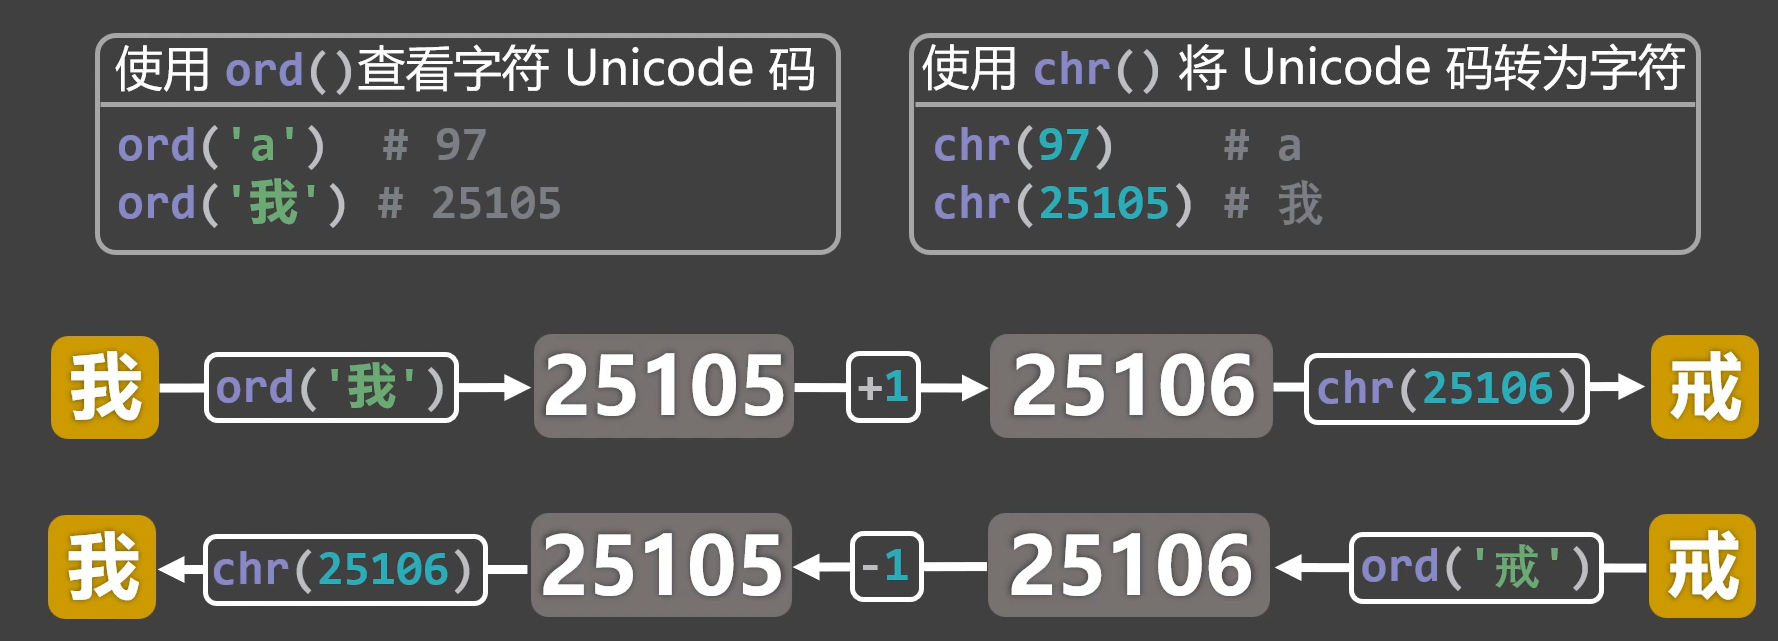
# 加密代码
text = input('📝请输入要加密的文字:')
secret = ''
for t in text:
    secret += chr(ord(t) + 1)
print(f'㊙️经过加密后的内容为:{secret}')

# 解密代码
secret = input('📝请输入要解密的文字:')
text = ''
for s in secret:
    text += chr(ord(s) - 1)
print(f'📃经过解密后的内容为:{text}')
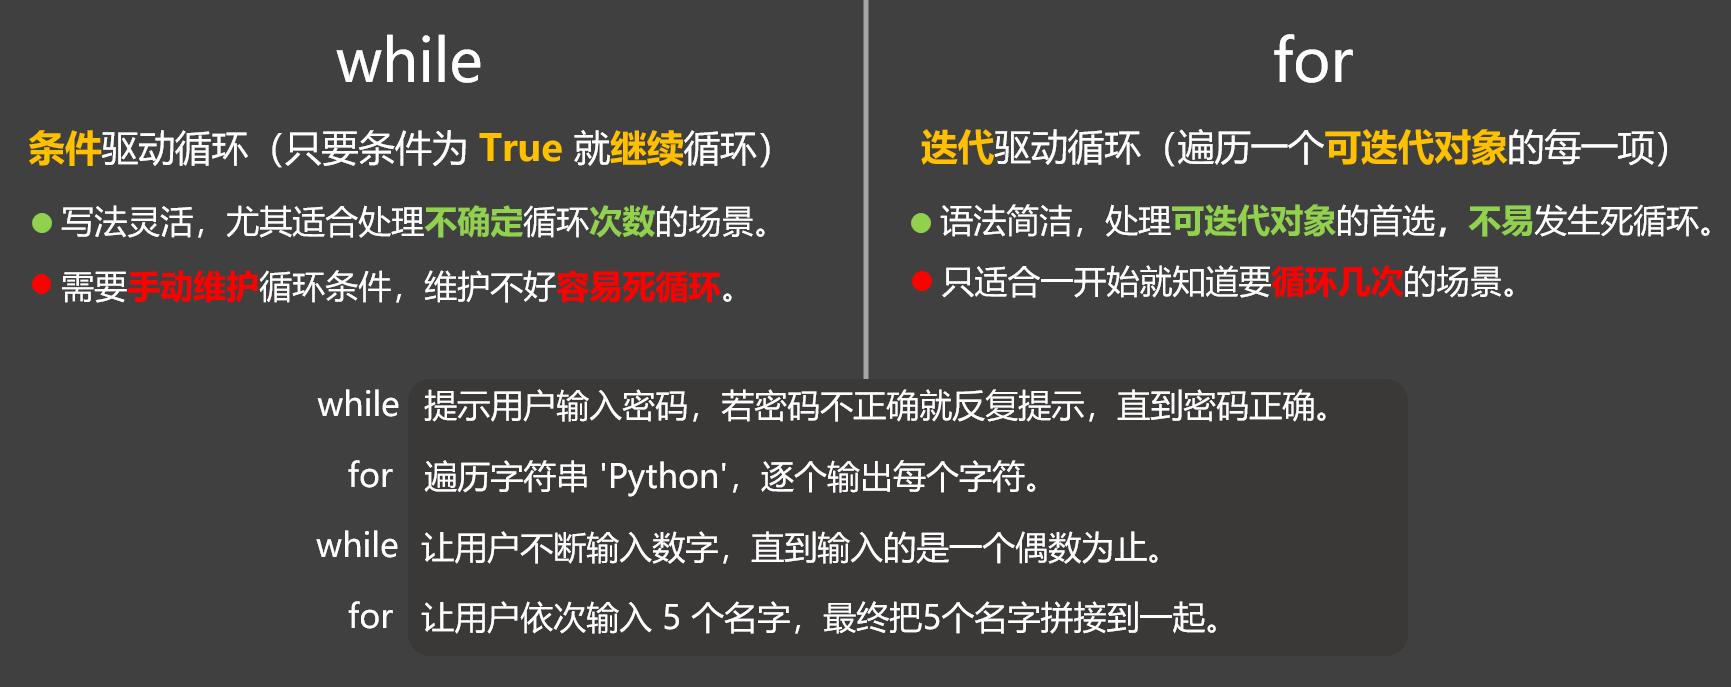
对比 while 与 for
嵌套循环
1️⃣****概念:在一个循环的内部,再写一个或多个循环,就是嵌套循环。
2️⃣****案例:实现一个为期 30 天的健身计划,效果如图:
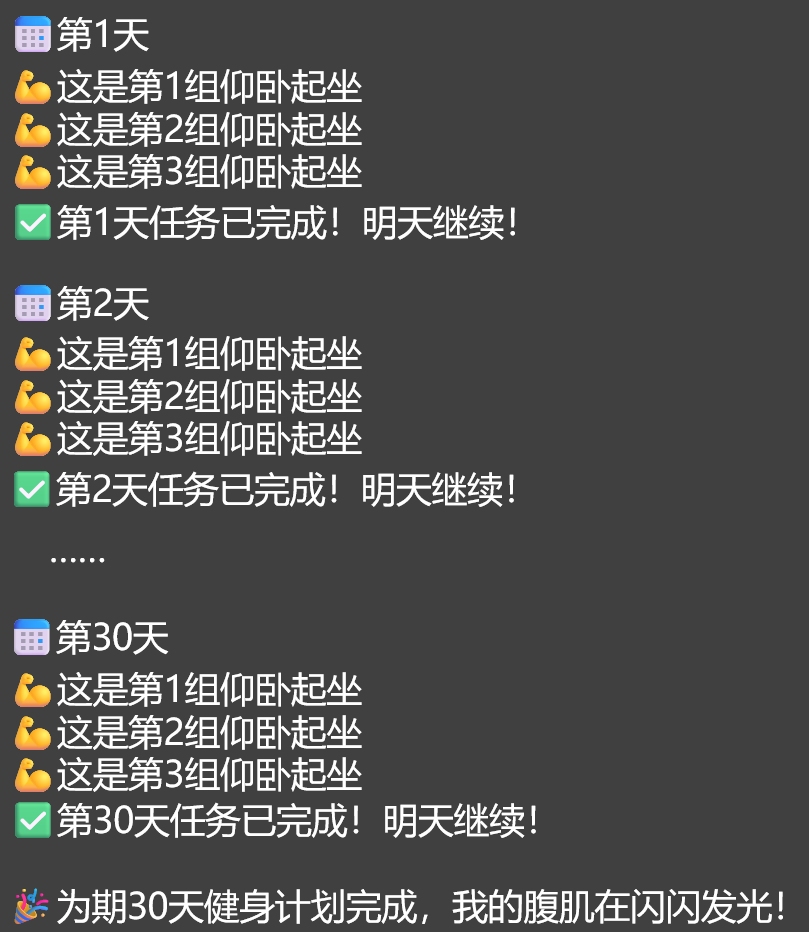
# for循环实现
day = 1
for day in range(1,31):
    print(f'********📅第{day}天********')
    for group in range(1,4):
        print(f'💪这是第{group}组仰卧起坐')
    print(f'✅第{day}天任务已完成!明天继续!\n')
print(f'🎉为期{day}天的健身计划完成,我的腹肌在闪闪发光!')
# while循环实现
day = 1
while day <= 30:
    print(f'********📅第{day}天********')
    group = 1
    while group <= 3:
        print(f'💪这是第{group}组仰卧起坐')
        group += 1
    print(f'✅第{day}天任务已完成!明天继续!\n')
    day += 1
print(f'🎉为期{day - 1}天的健身计划完成,我的腹肌在闪闪发光!')
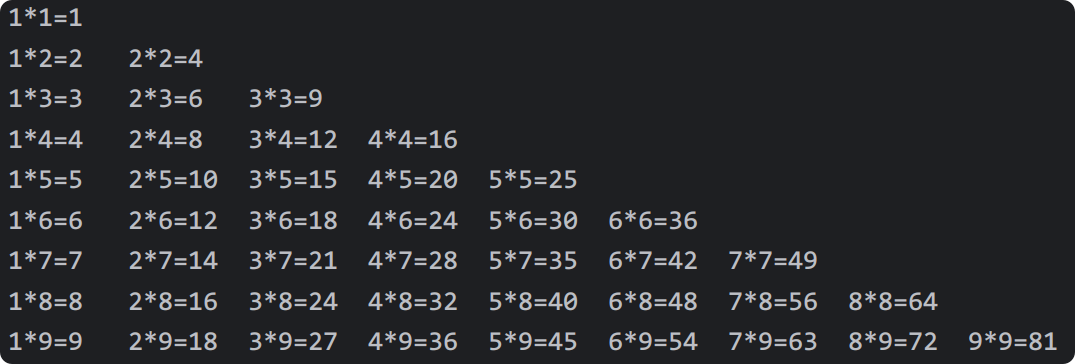
九九乘法表案例
案例效果如图:
:::tips
💡print('你好', end='') 中的end用来控制打印后结尾输出的内容。
:::
# 前序知识
print('你好', end='')
print('尚硅谷', end='')
# for循环实现九九乘法表
for row in range(1, 10):
    for item in range(1, row + 1):
        print(f'{item}*{row}={item * row}', end='\t')
    print()
continue 与 break
continue和break都可用于循环语句中(while循环、for循环都可以)它们的作用分别是:
continue:跳过本次循环剩余语句,直接进入下一次循环判断。break:立即终止循环,不再执行后续循环。
1️⃣测试**continue**
建议参考视频教程中对下方代码的分析与讲解:
# 测试continue
for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    continue
    print('睡觉')

for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    if day == 2:
        continue
    print('睡觉')

for day in range(1, 5):
    if day == 2:
        continue
    print(f'********第{day}天********')
    print('吃饭')
    print('睡觉')

for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    for item in range(1, 3):
        print(f'面包{item}')
        continue
        print(f'牛奶{item}')
    print('睡觉')

for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    for item in range(1, 3):
        print(f'面包{item}')
        if day == 4 and item == 2:
            continue
        print(f'牛奶{item}')
    print('睡觉')
2️⃣****测试**break**
建议参考视频教程中对下方代码的分析与讲解:
for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    break
    print('睡觉')

for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    if day == 2:
        break
    print('睡觉')

for day in range(1, 5):
    if day == 2:
        break
    print(f'********第{day}天********')
    print('吃饭')
    print('睡觉')

for day in range(1, 5):
    print(f'********第{day}天********')
    print('吃饭')
    for item in range(1,3):
        print(f'面包{item}')
        if day == 4 and item == 2:
            break
        print(f'牛奶{item}')
    print('睡觉')
综合案例
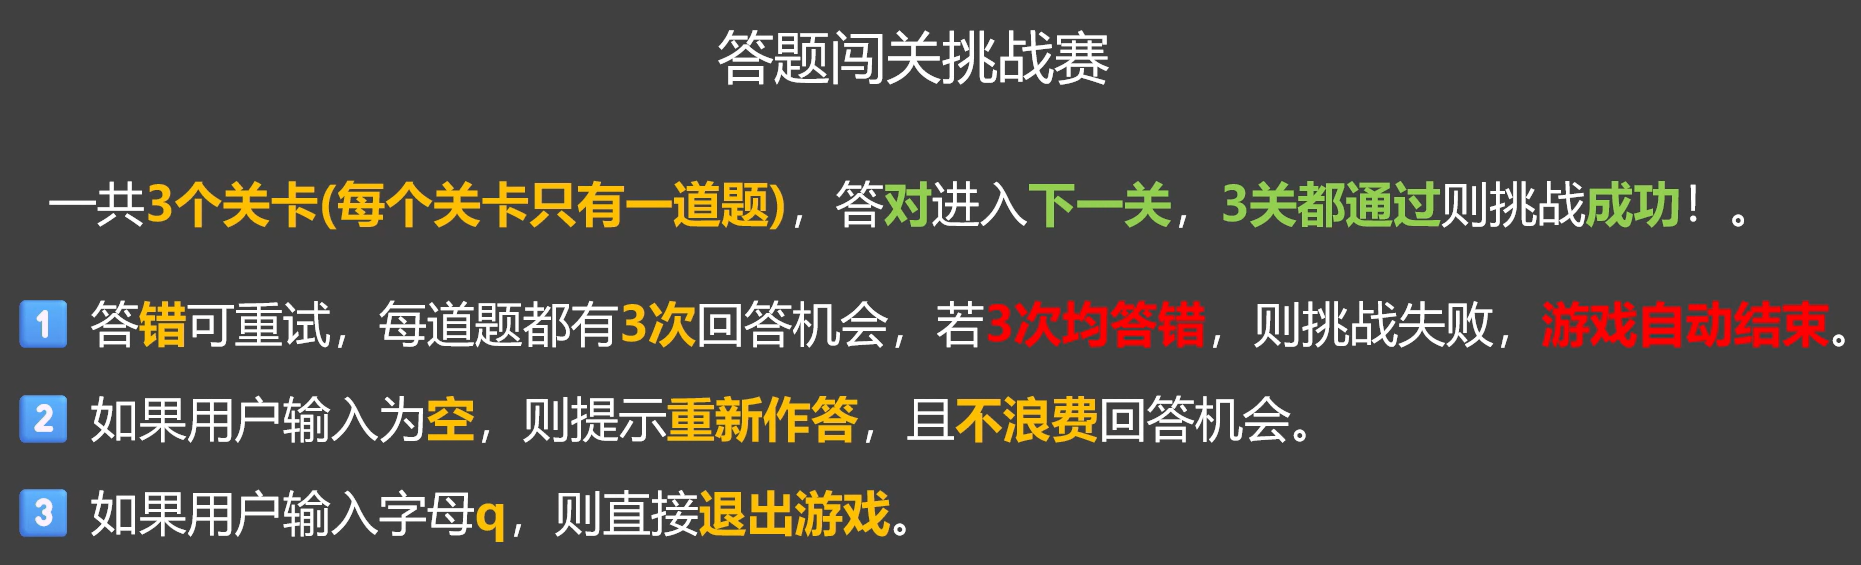
print('🏆欢迎来到:答题闯关挑战赛(输入q可随时退出)\n')

# 题目与答案
ques1, ans1 = 'Python中用于输出的函数是?', 'print'
ques2, ans2 = 'Python中用于表示逻辑“并且”的关键字是?', 'and'
ques3, ans3 = 'Python属于编译型还是解释型?', '解释型'

# 最多可尝试次数
max_tries = 3
# 总关卡数
total_levels = 3
# 是否处于可游戏状态
is_playing = True

# 根据题目数量开始循环
for level in range(1, total_levels + 1):
    # 打印当前是第几关
    print(f'********🎯第{level}关********')
    # 取出当前关卡所对应的题目和答案
    if level == 1:
        question, answer = ques1, ans1
    elif level == 2:
        question, answer = ques2, ans2
    else:
        question, answer = ques3, ans3
    # 记录当前关卡的尝试次数
    tries = 1
    # 若已经尝试的次数,小于等于最大尝试次数,则进入循环
    while tries <= max_tries:
        # 向用户提问
        user_input = input('📢'+question)
        # 根据用户的输入,来决定做什么
        if user_input == answer:
            print('✅回答正确!\n')
            break
        elif user_input == '':
            print('⚠️您的输入为空,请重新作答!\n')
            continue
        elif user_input == 'q':
            print('👋您已退出游戏!\n')
            is_playing = False
            break
        else:
            # 计算剩余次数
            leave = max_tries - tries
            # 判断是否还有剩余次数
            if leave > 0:
                print(f'❌回答错误,您还剩{leave}次机会!\n')
                tries += 1
                continue
            else:
                print(f'😢挑战失败,本题的正确答案是:{answer},游戏结束!')
                is_playing = False
                break
    # 每次进入下一关之前,都要看一下is_playing,如果is_playing为False就要结束游戏!
    if not is_playing:
        break
# 如果到了这里,is_playing的值依然为True,那就意味着用户已经通关了!
if is_playing:
    print('🎉🎉🎉恭喜您!全部通关!🎉🎉🎉')
第 5 章 函数入门
概念及分类
函数的概念
函数(function)是:组织好的、可重复使用的、用于执行特定任务的代码块。
:::info
🌰举个生活中的例子:
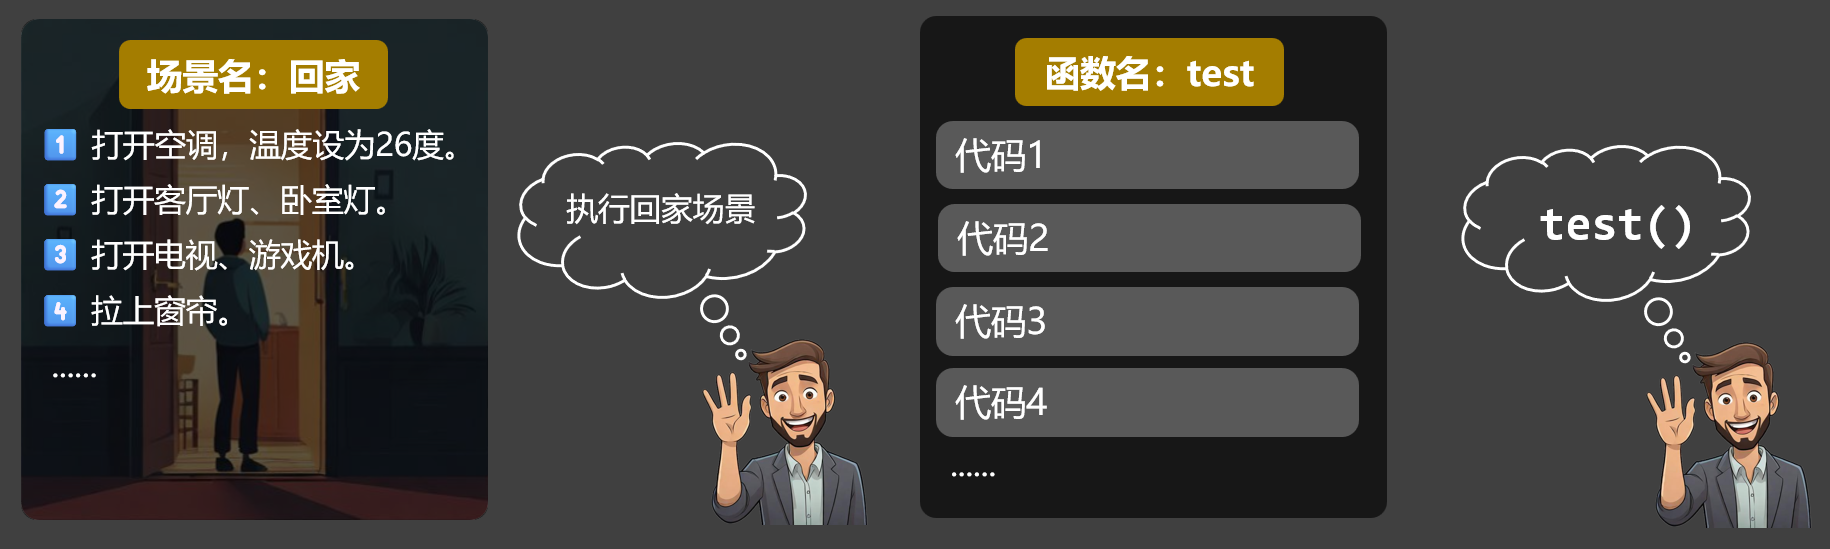
- 函数就像是智能家居中的一个场景,我们提前配置好场景中要执行的操作,等需要时,直接呼唤场景的名字,场景中的操作就会开始执行。
- Python 中的函数是一段有名字的代码块,我们提前编写好函数中要执行的代码,等需要时,调用函数,函数中的代码就会执行。
:::
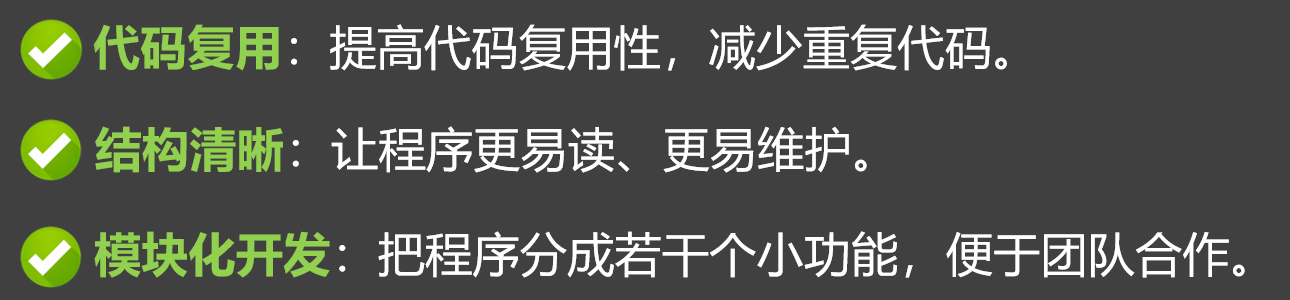
使用函数的主要优势:
Python 中函数的分类
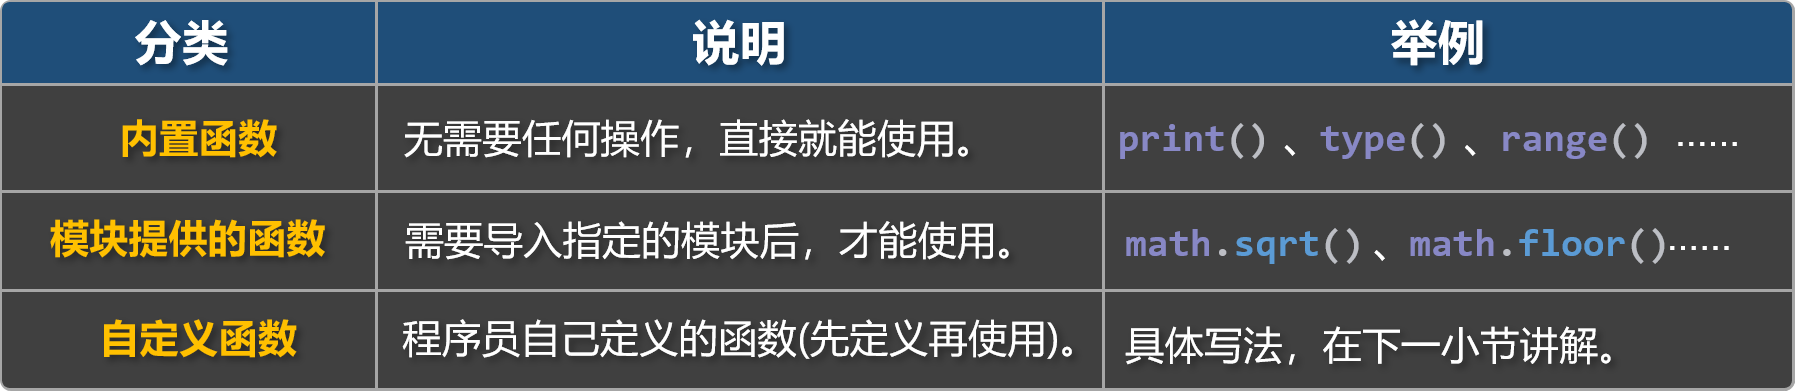
Python 中函数分为三类:①内置函数、②模块提供的函数、③自定义函数。
相关官方文档:
内置函数:https://docs.python.org/zh-cn/3.13/library/functions.html
:::tips
📋****备注:
- 内置函数与模块提供的函数, Python 都已经提前定义完毕,我们只管调用即可。
- 本章主要讲解自定义函数,对于内置函数和模块提供的函数,后面用到哪个讲哪个。
:::
基本使用
定义函数
1️⃣****语法格式:
如下语法格式是函数的基本定义,不涉及:接收参数和返回值。
def 函数名():
    函数体
    函数体
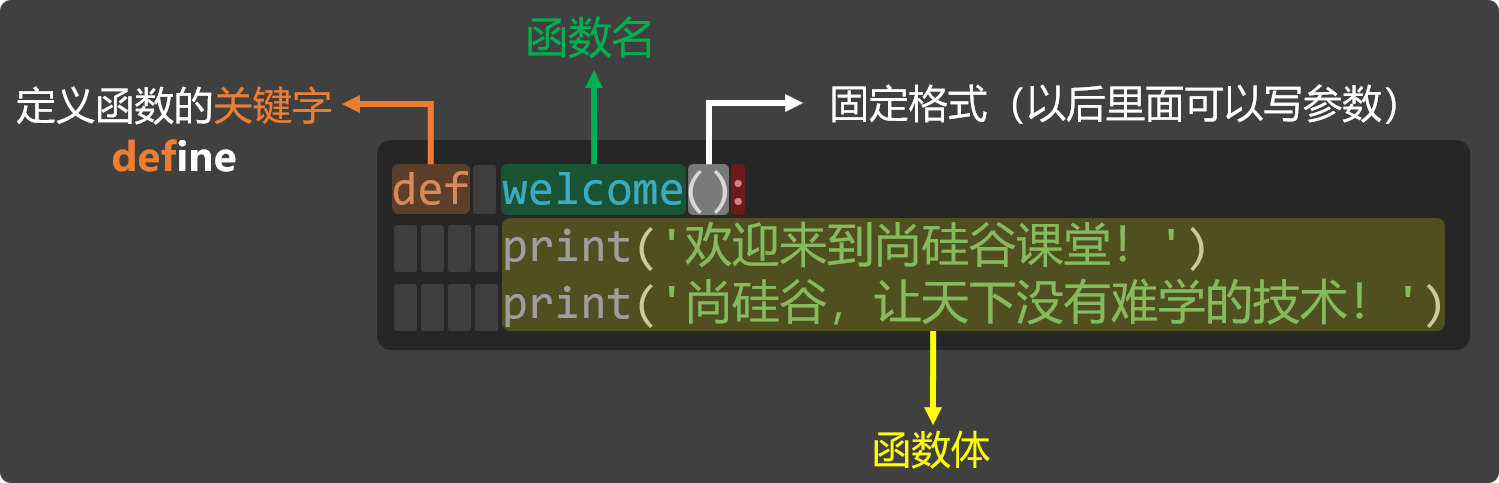
2️⃣****语法图解:
3️⃣说明:
:::info
- 定义函数的关键字是
def,需要将def与函数名用空格隔开,随后紧跟():。 - 函数的命名遵循我们之前讲过的『标识符命名规范』。
- 函数定义完毕后,只是告诉 Python 我们定义了一个函数,可以完成某些功能,但此时函数体还没有执行,需要调用函数后,函数体才会执行!
:::
4️⃣示例代码:定义一个名为 welcome 的函数,函数体中打印两句欢迎语。
# 定义函数
def welcome():
    print('欢迎来到尚硅谷课堂!')
    print('尚硅谷,让天下没有难学的技术!')
调用函数
1️⃣****语法格式:
如下语法格式是基本调用形式,不涉及:传递参数。
函数名()
2️⃣****语法图解:
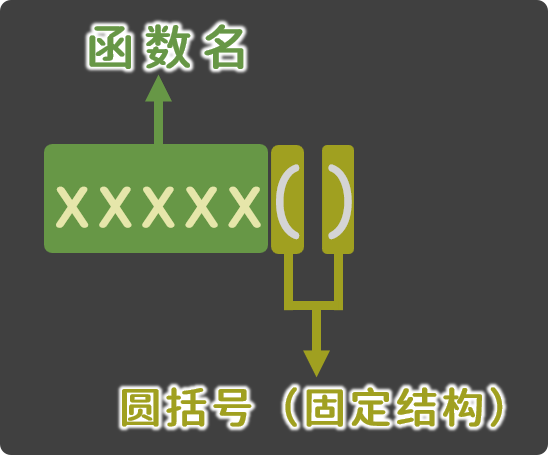
3️⃣****示例代码:编写代码,调用我们刚才定义的welcome函数。
# 定义函数
def welcome():
    print('欢迎来到尚硅谷课堂!')
    print('尚硅谷,让天下没有难学的技术!')

# 调用函数(让函数中的代码运行起来)
welcome()
welcome()
welcome()
:::color4
⚠️****注意:函数必须先定义再调用。
:::
参数
参数的作用
参数可以让函数接收外部传入的数据,能让函数更具通用性和灵活性,比如下面的这个需求:
:::info
📒****需求:定义一个名为order的函数,在函数体中打印用户的点餐信息。
:::
用如下代码实现,就会面临两个问题:① 每次的点餐数量只能是一份。② 每次点的菜品只能是辣椒炒肉。
# 定义函数
def order():
    num = 1
    dish = '辣椒炒肉'
    print(f'您点的是:{num}份 {dish}')

# 调用函数
order()
但如果在上述代码的基础上,使用参数,就可以灵活修改点餐数量和菜品,写法如下:
# 定义函数(定义的同时:声明需要两个参数,分别是:菜品数量 num,和菜品名称 dish)
def order(num, dish):
    print(f'您点的是:{num}份 {dish}')
    print(f'{dish}可是很好吃的!')
    print(f'你只点了{num}份,够吃吗?\n')

# 调用函数(调用的同时:传递了两个值)
order(1, '辣椒炒肉')
order(2, '辣子鸡')
实参与形参
在使用函数时,要注意区分『形参』与『实参』。
- 形参(形式参数):在定义函数时,用来接收数据的变量叫形参,形参是函数定义者设置的。
- 实参(实际参数):在调用函数时,给函数传递的具体值叫实参,实参是函数调用者提供的。
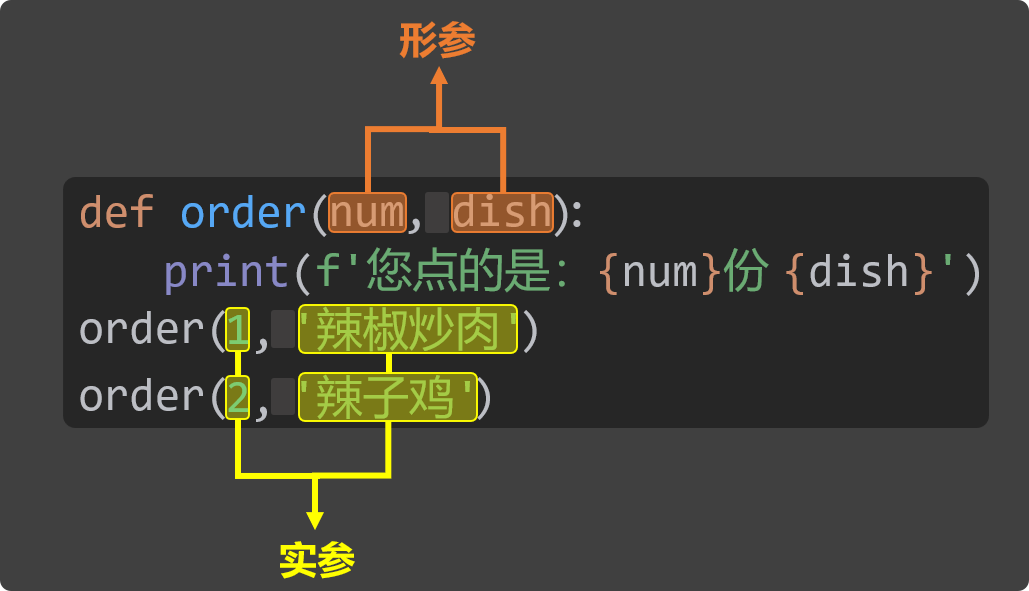
:::tips
📋****备注:形参存储的到底是什么数据,要看调用者传递的实参具体是什么。
:::
:::color4
📢注意:形参的使用范围仅限函数体内。
:::
位置参数
位置参数:调用函数时,根据参数在函数定义时出现的顺序,把实参的值,依次传递给对应的形参。
:::info
例如在上一小节所写的order函数,就是在使用位置参数,其中形参与实参的对应关系如下图:
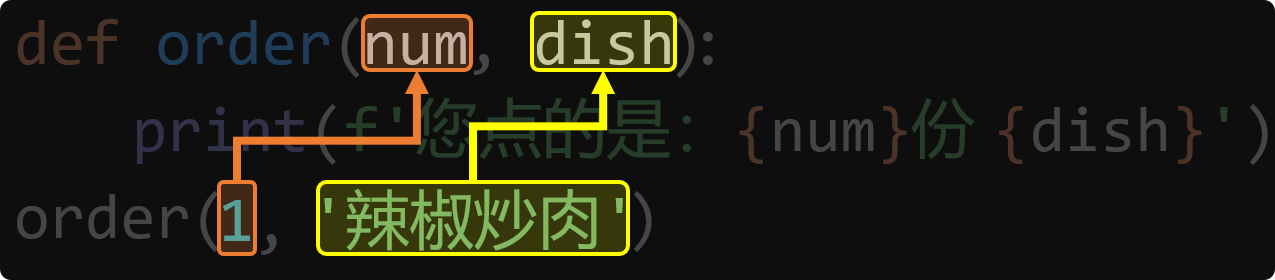
:::
:::color4
📢注意:在使用『位置参数』时,实参的个数与顺序,必须和形参保持一致!
:::
def order(num, dish):
    print(f'您点的是:{num}份 {dish}')
    print(f'{dish}可是很好吃的!')
    print(f'你只点了{num}份,够吃吗?\n')

# 以下是错误示范
order(3)  # 参数少了
order(4, '宫保鸡丁', 7)  # 参数多了
order('宫保鸡丁', 4)  # 实参顺序没有和形参保持一致,不会报错,但会造成数据错乱。
关键字参数
关键字参数:函数调用时通过**形参名 = 值**的形式传递的参数,就是关键字参数。
关键字参数的优势是:不受顺序限制。
# 定义函数
def greet(name, gender, age, height):
    print(f'我叫{name},性别{gender},年龄是{age},身高是{height}cm')

# 调用函数(使用关键字参数)
greet(name='张三', gender='男', age=18, height=172)
greet(height=172, age = 18, gender='男', name='张三')
:::color4
📢注意:『位置参数』和『关键字参数』可以混用,但『位置参数』必须写在『关键字参数』之前!
:::
# 正确使用方式
greet('张三', '男', height=172, age=18)

# 错误示例
greet(height=172, age=18, '张三', '男')
greet(name='张三', '男', 18, 172)
greet(name='张三', '男', age=18, 172)
greet(height=172, age=18, gender='男', name='张三', age=19)
greet(height=172, age=18, gender='男', name='张三', school='尚硅谷')
限制传参方式
具体限制方式:/前面只能用『位置参数』,*后面只能用『关键字参数』。
# 定义函数(使用/和*限制传参方式)
def greet(name, /, gender, *, age, height):
    print(f'我叫{name},性别{gender},年龄是{age},身高是{height}cm')

# 正确示例
greet('张三', '男', age=18, height=172)
greet('张三', gender='男', age=18, height=172)

# 错误示例
greet(name='张三', gender='男', age=18, height=172)
greet('张三', '男', 18, height=172)
参数默认值
在定义函数时,可以通过**<font style="color:rgb(38, 38, 38);">形参名 = 值</font>**的形式,为形参设置一个默认值,这样就可以实现:
- 若调用函数时没有传入该参数的值,就使用默认值。
- 若调用函数时传入了该参数的值,就使用传入的值。
# 定义函数(设置参数默认值)
def greet(name, gender, age, height, msg='你好'):
    print(f'我叫{name},性别{gender},年龄是{age},身高是{height}cm')
    print(f'我想说:{msg}')

# 调用函数
greet('张三', '男', 18, 172)
greet('张三', '男', 18, 172, 'hello')
greet('张三', '男', 18, 172, msg='hello')
:::color4
📢注意:定义函数时,『默认参数』必须放在『必选参数』的后面,或者换一种说法就是:某个形参,一旦设置了默认值,那它后面的所有形参,也必须要写默认值!
:::
例如:下面的代码中,msg='你好'这个默认参数,居然写在了位置参数height前面,所以就会报错。
# 定义函数(设置参数默认值的错误示例)
def greet(name, gender, age,  msg='你好', height):
    print(f'我叫{name},性别{gender},年龄是{age},身高是{height}cm')
    print(f'我想说:{msg}')
可变参数
在定义函数时,如果不确定会传入多少个参数,那就可以使用可变参数,具体写法有两种:
- 使用
*形参名来接收任意数量的『位置参数』,多个位置参数最终会被打包成一个『元组』。 - 使用
**形参名来接收任意数量的『关键字参数』,多个关键字参数最终会被打包成一个『字典』。
:::tips
📋****备注:元组和字典都是新的数据类型,后面才会讲,但没关系,这不耽误大家理解本小节的内容。
:::
# 定义函数(使用*args去接收:可变位置参数,args只是大家习惯这么写,当然也可以换成其他变量)
def test1(*args):
    # 此处args的值,是一种新的数据类型,叫:元组,我们下一章就去讲元组
    print(args)

# 调用函数
test1('张三', '男', 18, 172)
# 定义函数(使用**kwargs去接收:可变关键字参数,kwargs只是大家习惯这么写,当然也可以换成其他变量)
def test2(**kwargs):
    # 此处kwargs的值,是一种新的数据类型,叫:字典,我们下一章就去讲字典
    print(kwargs)

# 调用函数
test2(name='张三', gender='男', age=18, height=172)
💡『可变位置参数』和『可变关键字参数』,可以同时使用,但必须要先写****『可变位置参数』。
# 定义函数(同时使用:可变位置参数、可变关键字参数)
def test3(a, b, *args, c='尚硅谷', **kwargs):
    print(a)
    print(b)
    print(c)
    print(args)
    print(kwargs)
# 调用函数
test3('张三', '男', '抽烟', '喝酒', age=18, height=172)
特殊的字面量 None
None 是一个特殊的字面量,用来表示:空值、无值、无意义。
例如:msg = None 的含义是 —— 我先定义一个变量 msg,但目前还不知道它会存储什么类型的值,那能不能写成 msg = 0 呢?这要看具体情况:
:::info
- 如果确定
msg之后会存放数值类型的数据,那这样写是可以的。 - 但如果还不确定
msg将来会存放什么类型的数据,最好不要写成msg = 0,否则可能会误导别人以为它一定是数值类型。
:::
所以使用 None 更加中立、开放,因为它不暗示变量的类型。
None 的官方文档:https://docs.python.org/zh-cn/3.13/library/constants.html#None
:::info
💡****几个关键点:
None的类型是NoneType。<font style="color:rgb(38, 38, 38);">None</font>出现在布尔判断中(<font style="color:rgb(38, 38, 38);">if</font>判断条件、<font style="color:rgb(38, 38, 38);">while</font>循环条件),会被当作<font style="color:rgb(38, 38, 38);">False</font>来处理。None不能参与任何数学运算,也不能与字符串拼接。- 不给函数设置返回值,那函数默认就会返回
None
:::
None出现最多的两个场景:
:::info
1️⃣函数中没有写return,或写了return但没有返回任何内容 。
2️⃣变量定义时,暂时还不知道要存放什么,可以先赋值为None。
:::
# None是一个特殊的字面量,它表示:空值 / 无值 / 无意义。
msg = None

# None 的类型是 NoneType。
print(type(msg))

# None 转为布尔值是 False。
print(bool(msg))
if not msg:
    print('你好')

# 不能参与数学运算,也不能与字符串拼接。
# result1 = msg + 1
# result1 = msg + 'hello'
返回值
什么是返回值
函数返回值:函数执行完毕后,会把执行结果交给调用者,这个执行结果就是函数的返回值。
我们之前用过的这些内置函数,都有返回值:
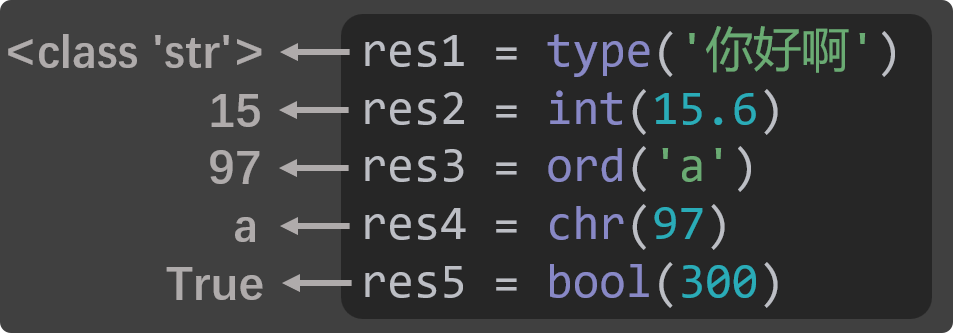
对于自定义的函数,即便我们不去设置返回值,函数也会默认返回None,由于None表示空,所以如果一个函数的返回值是None的话,就也可以说:这个函数“没有”返回值。
# 定义函数
def add(n1, n2):
    print(f'我收到了:{n1}、{n2},二者相加是:{n1 + n2}')
    print('add函数执行完毕了')

# 调用函数
result = add(100, 200)
print(result)  # None
如何设置返回值
使用return关键字可以设置函数的返回值,return的作用有两个,分别是:
- 结束函数的运行。
- 把
return后面的值,作为函数的返回值。
# 定义函数
def add(n1, n2):
    print(f'我收到了:{n1}、{n2},二者相加是:{n1 + n2}')
    print('add函数执行完毕了')
    return n1 + n2

# 调用函数
result = add(100, 200)
print(result)

# print函数是没有返回值的
res = print('hello')
print(res)
全局作用域 VS 局部作用域
什么是作用域?
作用域就是变量能起作用的范围(变量在哪里能用,在哪里不能用),Python 中有多种作用域,我们先来学习:全局作用域、局部作用域。
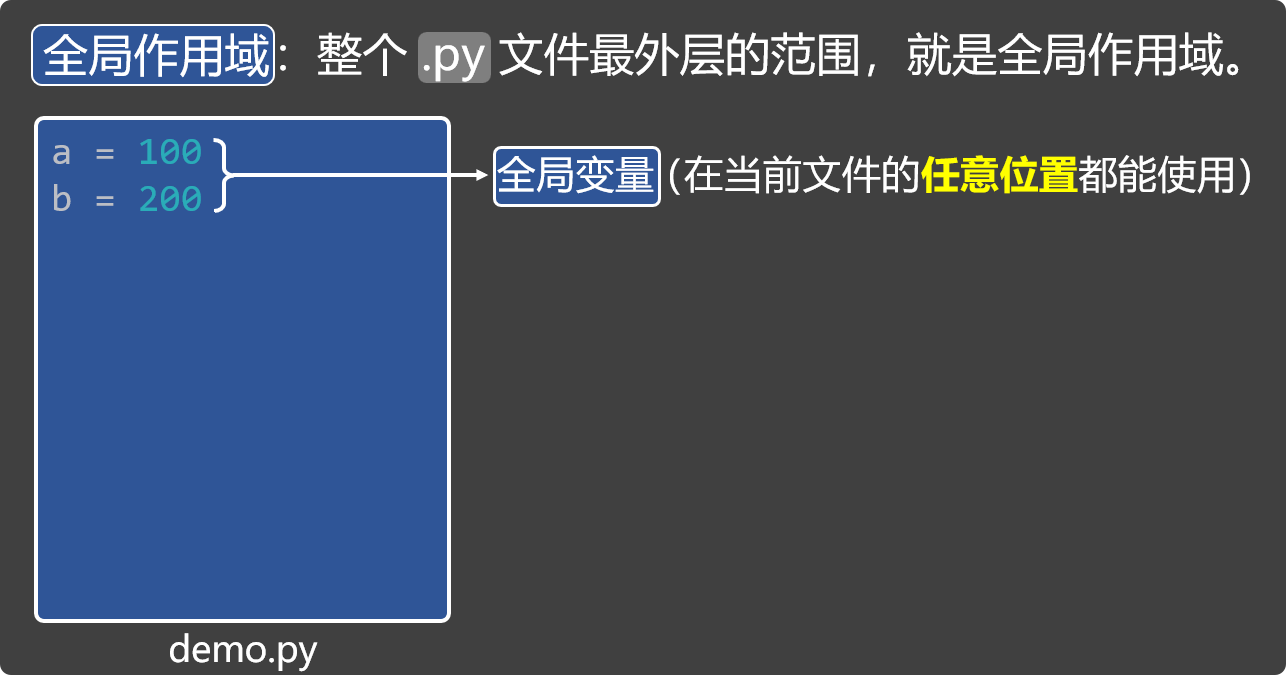
全局作用域 _ 全局变量
- 全局作用域:整个
.py文件最外层的范围,就是全局作用域。 - 全局变量:写在全局作用域中的变量,就叫:全局变量,全局变量在整个程序中都可以访问。
局部作用域 _ 局部变量
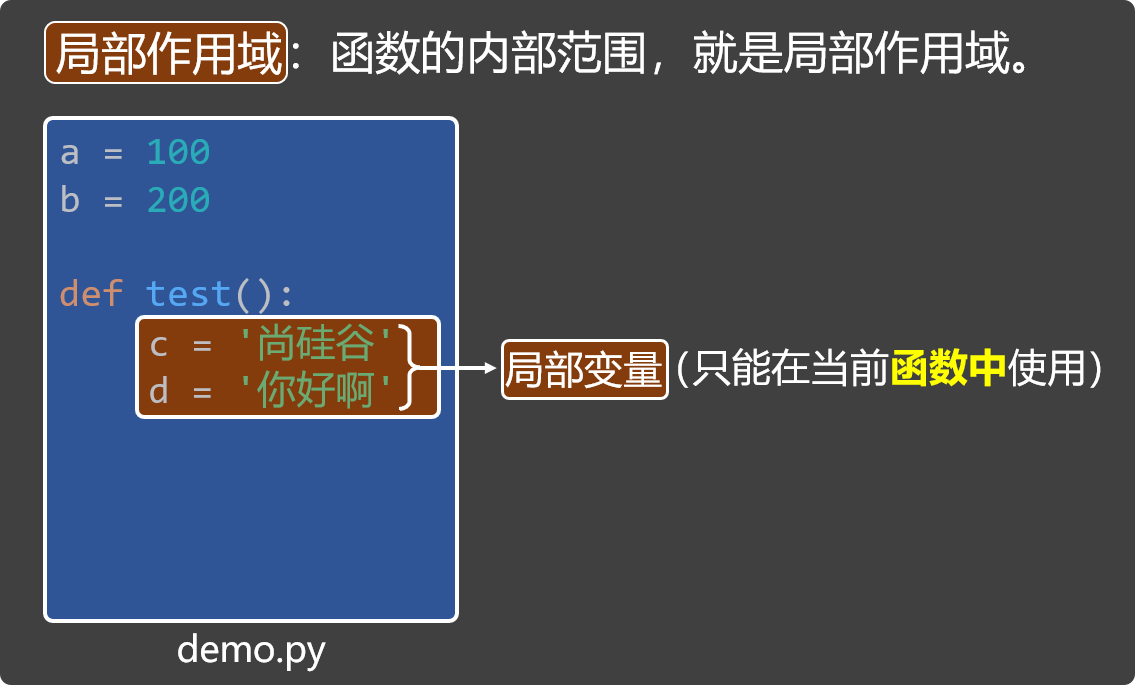
- 局部作用域:函数的内部范围,就是局部作用域。
- 局部变量:写在局部作用域中(函数内部)的变量,叫:局部变量,它只能在当前函数中使用。
global 关键字
在函数内部使用global关键字,可以声明变量为全局变量。
a = 100

def test():
    global a  # 使用 global 关键字,将a声明为全局变量。
    a = 300
    print('函数中的打印(a)', a)
test()
print('全局的打印(a)', a)
小测试
请说出如下代码的输出结果(具体分析请参考视频教程)
# 全局作用域 与 局部作用域,以及global的使用
a = 100
b = 200

def test():
    c = '尚硅谷'
    d = '你好啊'
    global a
    a = 300
    print('函数中的打印(a)', a)
    print('函数中的打印(b)', b)
    print('函数中的打印(c)', c)
    print('函数中的打印(d)', d)
test()
print('***************')
print('全局的打印(a)', a)
print('全局的打印(b)', b)
print(c)
print(d)


# 局部作用域 和 局部变量,会在函数调用时创建,在函数执行结束后自动销毁
def test2():
    m = 100
    m += 1
    print(f'我是test2函数中打印的m:{m}')
test2()
test2()
test2()


# 全局作用域 与 全局变量,会在程序开始时创建,在程序结束后销毁
n = 100
def test3():
    global n
    n += 1
    print(f'我是test3函数中打印的n:{n}')
test3()
test3()
test3()
print(n)
嵌套调用
嵌套调用:在一个函数执行的过程中,调用了另外一个函数,例如下面的代码:
如下代码的具体分析过程,请参考视频教程。
# 函数嵌套调用测试1
def greet(name, msg):
    print(f'我叫{name},我想说的话在下面:')
    speak(msg)
    print('嗯,我想说的结束了')

def speak(msg):
    print('----------')
    print(msg)
    print('----------')

greet('张三', '你好啊')

# 函数嵌套调用测试2
def test1():
    print('进入 test1 函数')
    test2()
    print('退出 test1 函数')

def test2():
    print('进入 test2 函数')
    test3()
    print('退出 test2 函数')

def test3():
    print('进入 test3 函数')
    print('***正在执行 test3 函数')
    print('退出 test3 函数')

test1()
递归调用
1️⃣递归调用:函数自己调用自己的一种操作。
def welcome():
    print("你好啊!")
    welcome() # welcome 函数内部在调用自己

welcome()
:::color4
📢警告:上述代码确实是递归调用,但会出现死循环!
:::
2️⃣递归必须要具备终止条件(不能无限的一直调用,总得有停下来的时候。)
如下代码使用递归调用的方式,输出了 10 次“你好啊!”
# 使用递归打印n次“你好啊”(从大到小)
def welcome(n):
    print(f'你好啊{n}')
    if n > 1:
        welcome(n - 1)
# 调用函数
welcome(5)

# 使用递归打印n次“你好啊”(从小到大)
def welcome(n):
    if n > 1:
        welcome(n - 1)
    print(f'你好啊{n}')
# 调用函数
welcome(5)
3️⃣递归的应用:使用递归完成一个数的阶乘
如下代码的具体分析过程,请参考视频教程。
# 使用递归求阶乘
def factorial(num):
    if num == 0:
        return 1
    else:
        return num * factorial(num - 1)
# 调用函数,求5的阶乘
result = factorial(6)
print(result)
函数说明文档
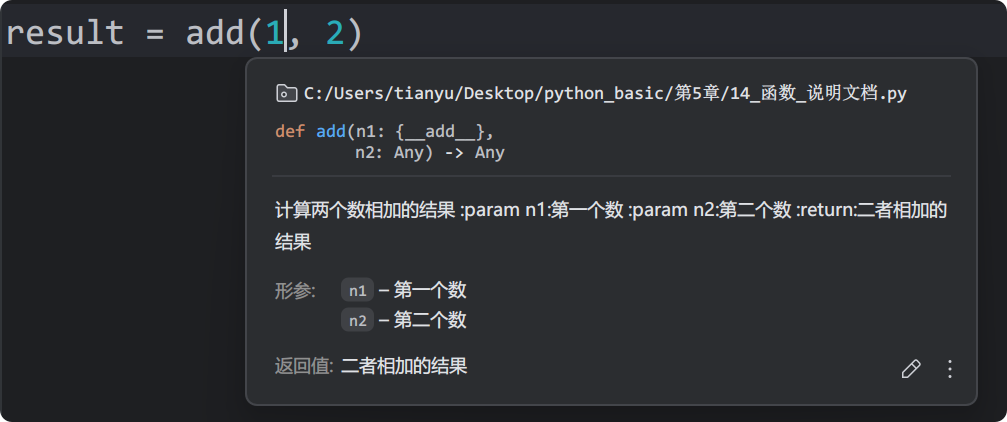
函数说明文档:写在函数里的文字说明,用来描述:函数的功能、需要哪些参数、返回什么结果,它的语法和普通字符串一样,用三引号包裹:
def add(n1, n2):
    """
    计算两个数相加的结果
    :param n1:第一个数
    :param n2:第二个数
    :return:二者相加的结果
    """
    return n1 + n2

result = add(1, 2)
有了函数说明文档之后,可以通过鼠标悬浮的方式,查看函数的具体信息,如下图:
函数综合案例
完成一个健身挑战赛程序,功能演示见下图:
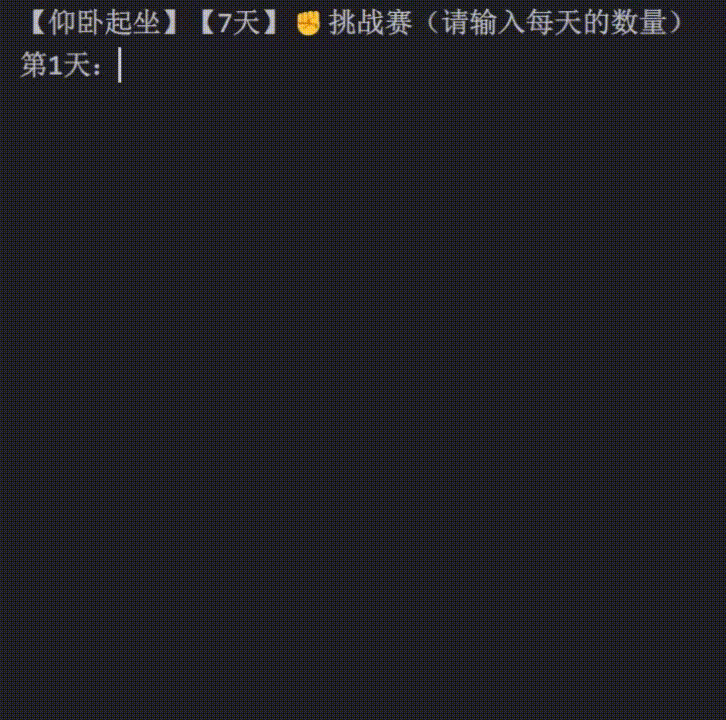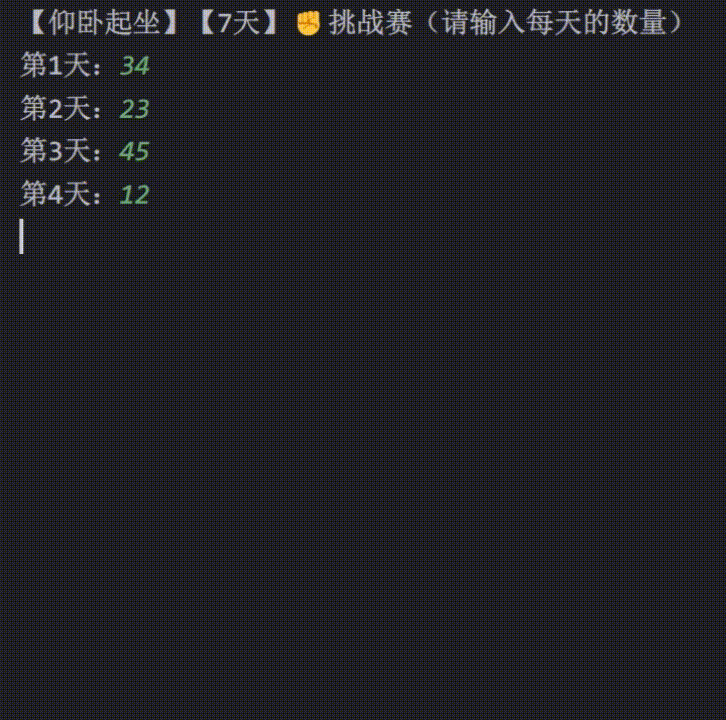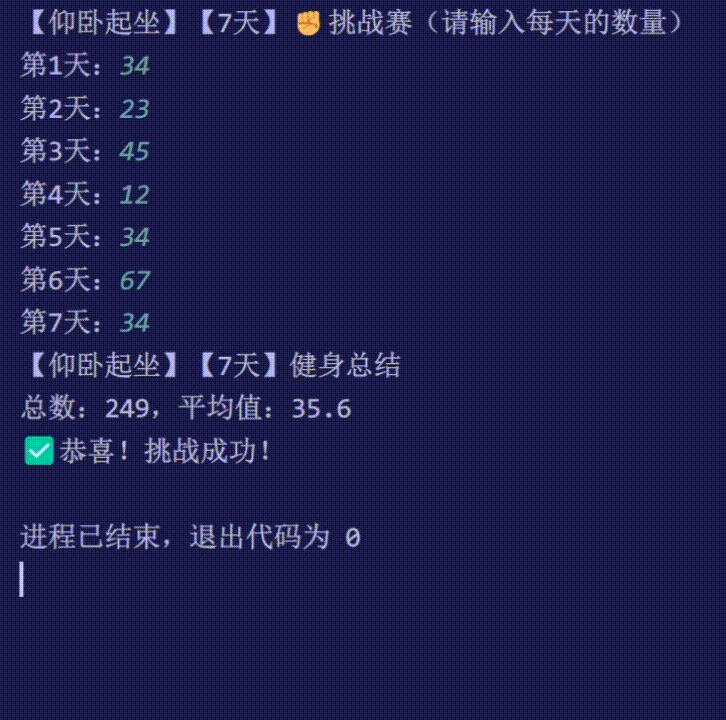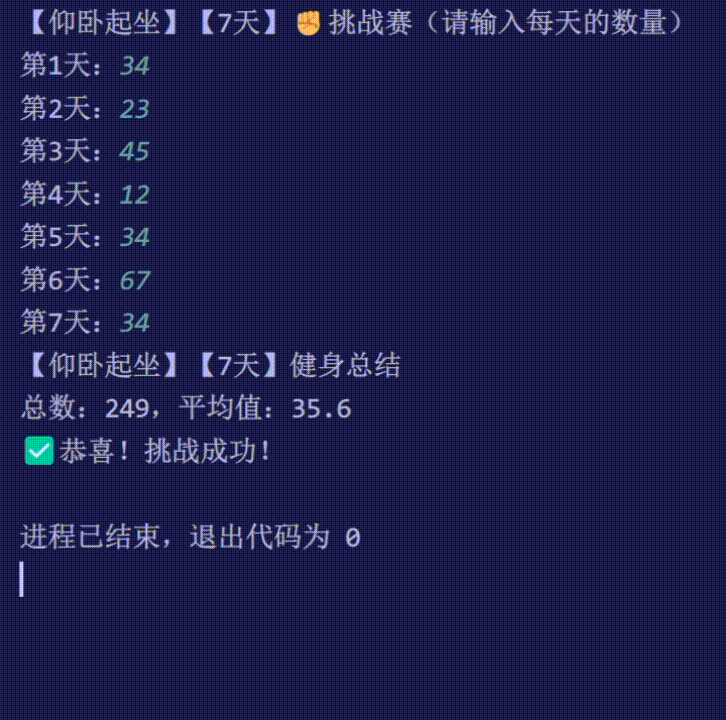
具体实现代码如下:
如下代码的具体分析过程,请参考视频教程。
def calc_total(*nums):
    """
    计算总运动量(个)
    :param nums: 每一天的运动量(可变参数)
    :return: 总运动量(个)
    """
    # 备注:nums的类型是元组(下一章马上就讲了),sum是内置函数,可以对元组中的数据求和
    return sum(nums)

def calc_avg(total, days=7):
    """
    计算平均值
    :param total: 总运动量(个)
    :param days: 天数(默认值是7)
    :return: 平均值
    """
    return total / days

def check_success(total, goal=120):
    """
    判断本次挑战是否成功
    :param total: 总运动量
    :param goal: 成功数量(默认值为120)
    :return: 成功或失败的具体信息
    """
    if total >= goal:
        return '✅恭喜!挑战成功!'
    else:
        return '❌抱歉!挑战失败!'

def main(title, duration, goal):
    """
    主函数,用于开始一场挑战赛
    :param title: 比赛标题
    :param duration: 比赛持续天数
    :param goal: 目标运动量
    :return: None
    """
    print(f'【{title}】【{duration}天】✊️挑战赛(请输入每天的数量)')
    num1 = int(input('第1天:'))
    num2 = int(input('第2天:'))
    num3 = int(input('第3天:'))
    # 计算总数
    total = calc_total(num1, num2, num3)
    # 计算平均值
    avg = calc_avg(total, duration)
    # 判断挑战是否成功
    result = check_success(total, goal)
    # 打印相关信息
    print(f'【{title}】【{duration}天】健身总结')
    print(f'总数:{total},平均值:{avg:.1f}')
    print(result)

main('俯卧撑', 3, 40)
第 6 章 数据容器
概述
在编程中,我们经常需要一次保存多个数据,比如:多个学生的名字、一组商品的价格、或一串测量数据等等,如果把一条数据看作一个“物品”,那这些物品需要被放进“容器”里统一管理,在 Python 中,这种用来存放多个数据的东西,就叫做『数据容器』。
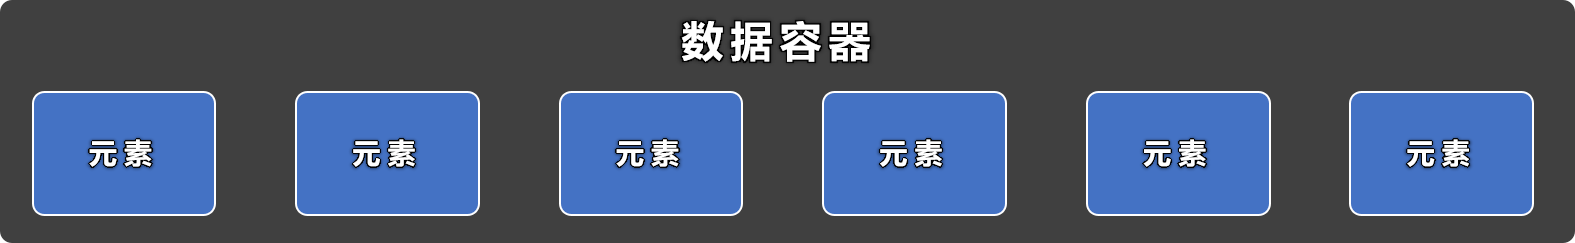
1️⃣数据容器的特点:
:::info
- 数据容器,有时也简称为容器。
- 数据容器可以存放多个数据,每个数据也被称为一个元素。
- 数据容器中的元素可以是任意类型。
- 数据容器会给我们提供多种操作元素的方法。
:::
2️⃣Python 中常用的数据容器:
:::info
- 列表(List)
- 元组(tuple)
- 字符串(str)
- 集合(set)
- 字典(dict)
:::
列表
概述
列表:用来存放一组有序的数据,并且可以对其中的数据进行:增删改查。
:::tips
列表就像一个长度可变的收纳盒,能按顺序装下多个元素,还可以随时添加、拿出、替换里面的元素。
:::
定义列表
使用方括号[]来定义一个列表,不同元素之间用,去分隔。

# 定义有内容的列表
list1 = [34, 56, 21, 56, 11]
list2 = ['北京', '尚硅谷', '你好啊']
list3 = [23, '尚硅谷', True, None]
list4 = [23, '尚硅谷', True, None, [100, 200, 300]] # list4 是一个嵌套列表

# 定义空列表(列表中的数据,后期会通过特定写法填充)
list5 = []
list6 = list()

print(list1, type(list1))  # [34, 56, 21, 56, 11] <class 'list'>
print(list2, type(list2))  # ['北京', '尚硅谷', '你好啊'] <class 'list'>
print(list3, type(list3))  # [23, '尚硅谷', True, None] <class 'list'>
print(list4, type(list4))  # [23, '尚硅谷', True, None, [100, 200, 300]] <class 'list'>
print(list5, type(list5))  # [] <class 'list'>
print(list6, type(list6))  # [] <class 'list'>
下标(索引值)
下标又叫索引值,其实就是元素在列表中的“位置编号”,分为:『正索引』、『负索引』。
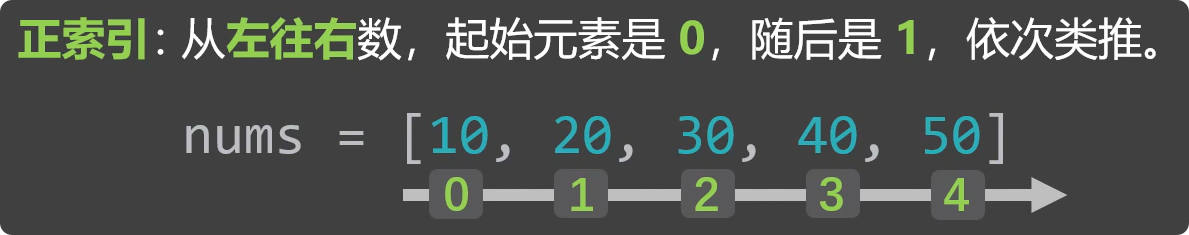
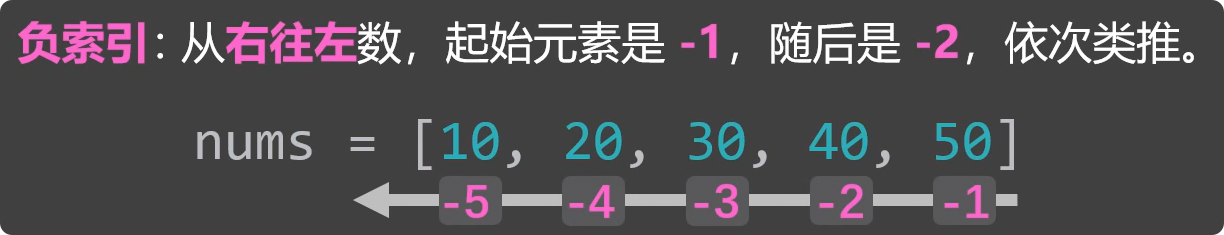
下标最直接的用途就是:从列表中读取元素。
# 定义一个列表
nums = [10, 20, 30, 40, 50]

# 测试正索引
print(nums[0])  # 10
print(nums[1])  # 20
print(nums[2])  # 30
print(nums[3])  # 40
print(nums[4])  # 50

# 测试负索引
print(nums[-1])  # 50
print(nums[-2])  # 40
print(nums[-3])  # 30
print(nums[-4])  # 20
print(nums[-5])  # 10

# 测试错误索引
print(nums[5])

# 定义一个嵌套列表
nums2 = [10, 20, ['你好啊','尚硅谷'], 40, 50]
# 取出“尚硅谷”
print(nums2[2][1])  # 尚硅谷
:::color4
📢注意:通过下标取值时,下标不要超出范围,否则会报错。
:::
列表的增删改查
我们先来认识一个名词 —— 『方法』,先来看如下的这种写法:
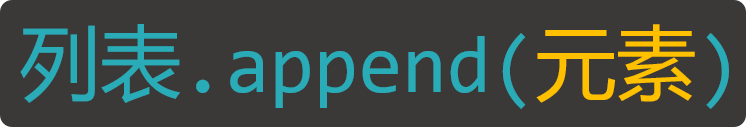
在上述写法中,如果只看append(元素),这就是在调用append函数,但append前面还有列表.这种形式,所以也可以换一个说法,叫:调用列表的append方法。
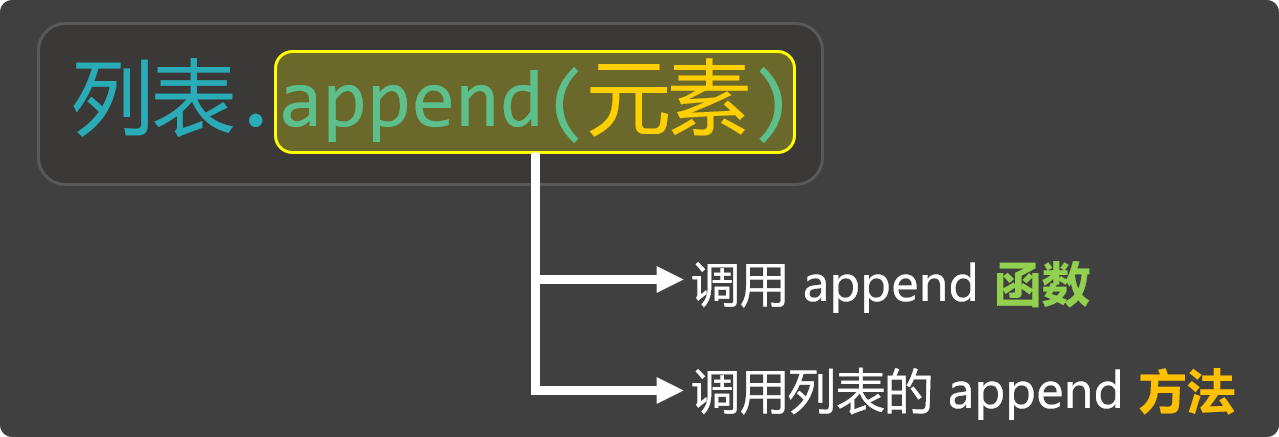
那方法和函数之间是什么关系呢?从更正式的角度来说:当一个函数隶属于某个对象时,这个函数就被称为该对象的方法。不过对于初学者来说,这句话可能一时还不好理解,因为我们尚未学习“类”和“对象”等相关内容。所以这里大家暂时不必纠结方法的严格定义,只要先理解下面这种写法的含义即可:
:::info
b():这叫调用b函数。a.b():这叫调用a的b方法。
:::
:::color4
📢注意:a.b()的形式不是随便写的,a如果是数字100,那就不可以写a.b(),因为这么写的前提是a的身上,得确实有b方法才可以。
:::
列表的增删改查方法概览:
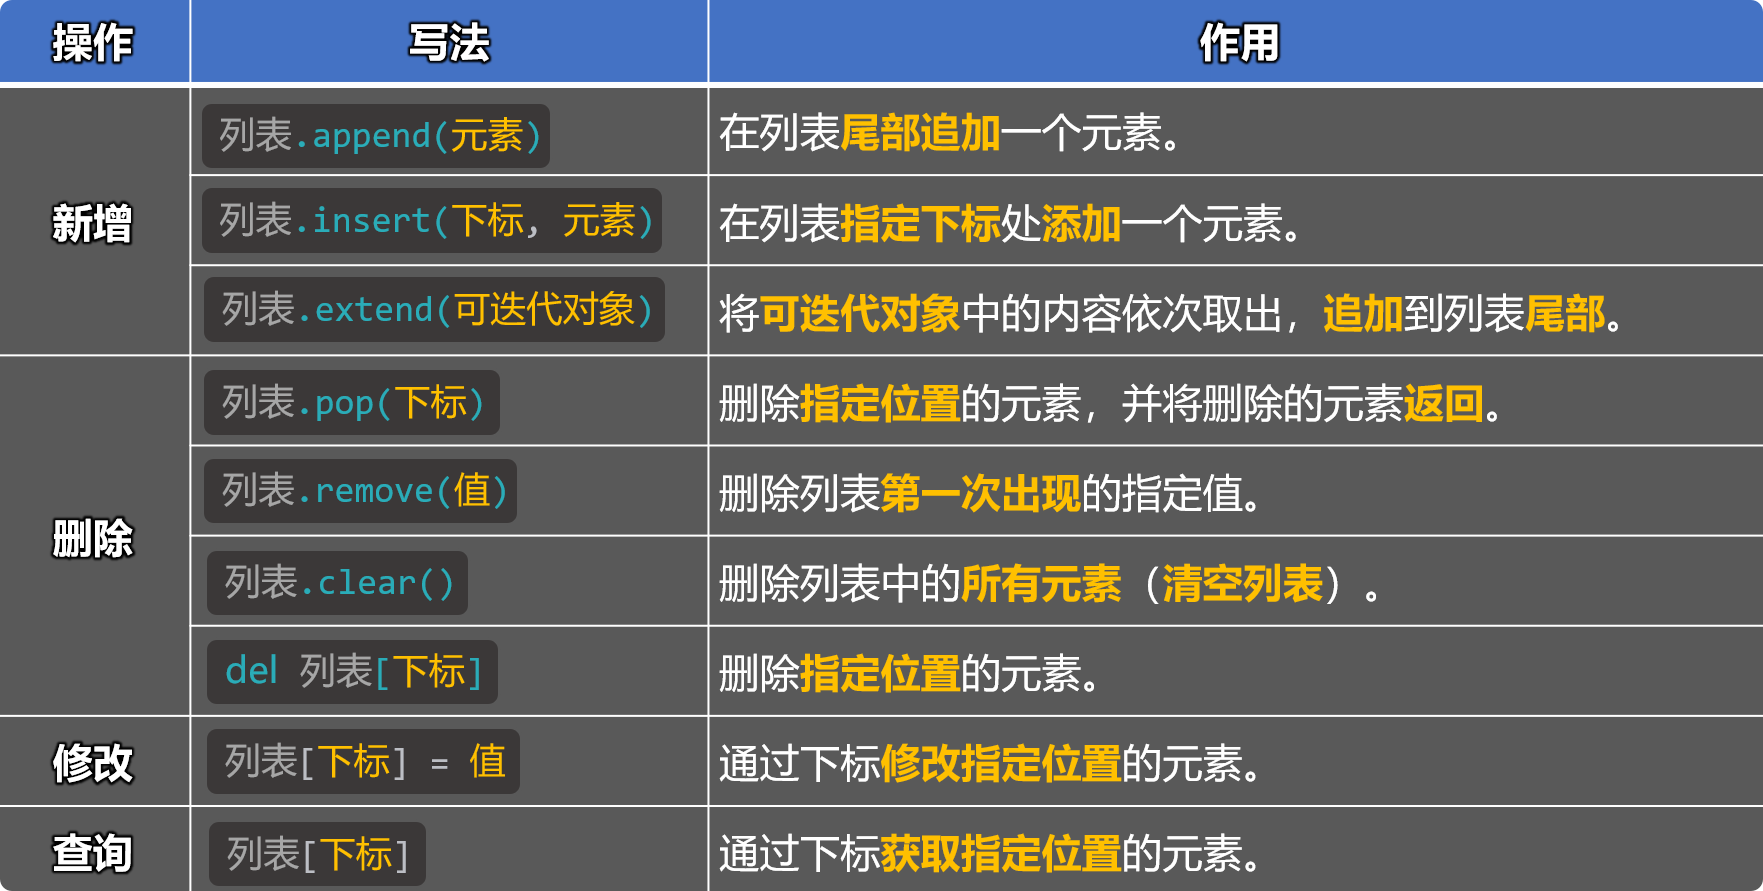
1️⃣新增
列表的新增指的是:向列表中添加元素,主要有如下三种添加方式:
方式1:使用:列表.append(元素),在列表尾部追加一个元素。
# 方式一:通过列表的append方法,在列表尾部追加一个元素
nums = [10, 20, 30, 40]
nums.append(50)
print(nums)  # [10, 20, 30, 40, 50]
方式2:使用:列表.insert(元素),在指定下标处添加一个元素。
# 方式二:通过列表的insert方法,在列表的指定下标处添加一个元素
nums = [10, 20, 30, 40]
nums.insert(2, 666)
print(nums)  # [10, 20, 666, 30, 40]
方式3:使用:列表.extend(可迭代对象),将可迭代对象中的内容依次取出,追加到列表尾部。
# 方式三:通过列表的extend方法,将可迭代对象中的内容依次取出,追加到列表尾部
nums = [10, 20, 30, 40]
nums.extend('尚硅谷')
nums.extend(range(1, 4))
nums.extend([70, 80, 90])
print(nums)  # [10, 20, 30, 40, '尚', '硅', '谷', 1, 2, 3, 70, 80, 90]
2️⃣删除
主要有如下四种删除方式:
方式1:使用:列表.pop(下标),删除指定位置的元素,并将删除的元素返回。
# 方式一:通过列表的pop方法,删除指定位置的元素,并返回该元素
nums = [10, 20, 10, 40, 50]
result = nums.pop(1)
print(nums)   # [10, 10, 40, 50]
print(result) # 20
方式2:使用:列表.remove(值),删除列表中第一次出现的指定值。
# 方式二:通过列表的remove方法,删除列表中第一次出现的指定值
nums = [10, 20, 10, 40, 50]
nums.remove(10)
print(nums)
方式3:使用:列表.clear(),删除列表中所有的元素(变成一个空列表)。
# 方式三:通过列表的clear方法,删除列表中所有的元素(清空列表)
nums = [10, 20, 10, 40, 50]
nums.clear()
print(nums)  # [20, 10, 40, 50]
方式4:使用:del 列表[下标],删除指定位置的元素。
# 方式四:通过del关键字,删除指定元素
nums = [10, 20, 10, 40, 50]
del nums[3]
print(nums)  # [10, 20, 10, 50]
3️⃣修改
修改操作比较简单,主要是通过下标进行修改,语法为:列表[下标] = 值
# 修改操作
nums = [10, 20, 10, 40, 50]
nums[2] = 66
print(nums)  # [10, 20, 66, 40, 50]
4️⃣查询
查询我们之前已经用过了,就是通过下标进行读取元素,语法为:列表[下标]
# 查询操作
nums = [10, 20, 10, 40, 50]
print(nums[3]) # 40
列表的常用方法
除了上述的增删改查方法,列表中还有很多其他常用的方法:
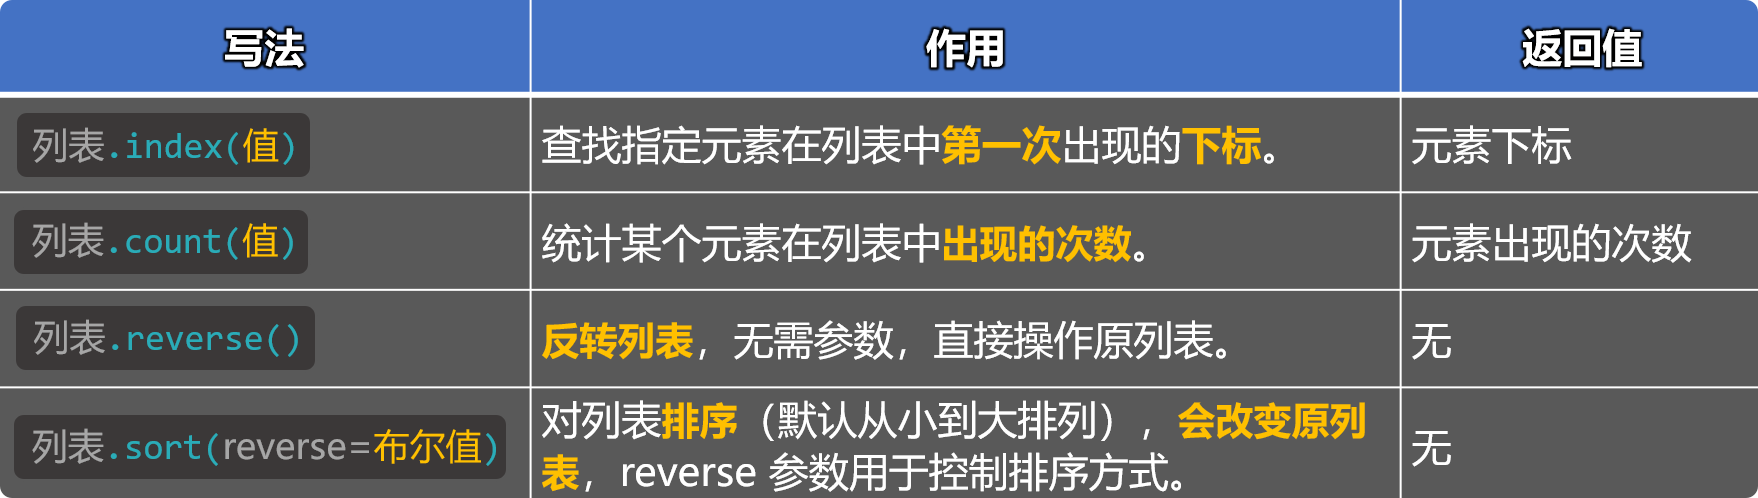
1️⃣使用:列表.index(值),查找指定元素在列表中第一次出现的下标,返回值是元素下标。
fruits = ['香蕉', '苹果', '橙子', '香蕉']
result = fruits.index('香蕉')
print(result)  # 0
2️⃣使用:列表.count(值),统计某个元素在列表中出现的次数,返回值是:元素出现的次数。
nums = [10, 20, 10, 30, 10, 40, [10, 10, 10]]
result = nums.count(10)
print(result)  # 3
3️⃣使用:列表.reverse(),反转列表(会改变原列表),无需参数,无返回值。
nums = [23, 11, 32, 30, 17, [6, 7, 8, 9]]
nums.reverse()
print(nums)  # [[6, 7, 8, 9], 17, 30, 32, 11, 23]
4️⃣使用:列表.sort(reverse=布尔值),对列表排序(从小到大,会改变原列表),reverse 用于控制排序方式,无返回值。
# 4.使用 sort 方法,对列表排序(默认从小到大),若想从大到小,可以将 reverse 参数设为True。
# 4.1 若列表中的元素:都是数字,则按照数字的大小顺序进行排序。
nums = [23, 11, 32, 30, 17]
nums.sort(reverse=True)
print(nums)  # [32, 30, 23, 17, 11]

# 4.2 若列表中的元素:既有数字,又有字符串,那就会报错。
nums = [23, 11, 32, 30, 17, '尚硅谷']
nums.sort()
print(nums) # [23, 11, 32, 30, 17, '尚硅谷']

# 4.3 若列表中的元素:都是字符串,则按照字符串的 Unicode 编码大小进行排序
msg_list = ['北京', '北硅谷', '北好']
msg_list.sort()
print(msg_list)  # ['北京', '北好', '北硅谷']
print(ord('京'), ord('好'), ord('硅'))  # ['北京', '北好', '北硅谷']

# 备注:所有的列表方法,都只作用于“当前层”的元素(浅层操作),不会自动进入嵌套的“里层”结构中。
列表的常用内置函数
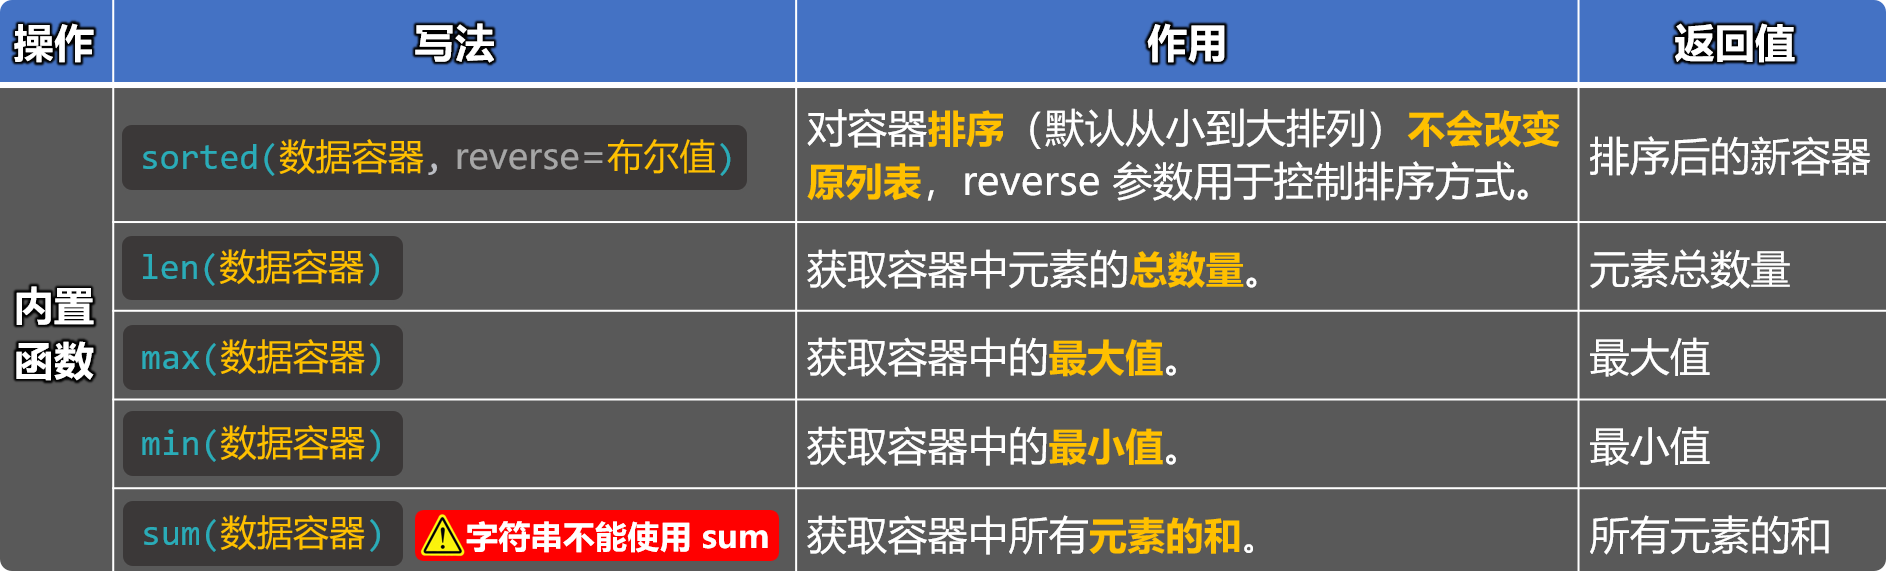
Python 中有一些内置函数,可以用来处理列表,常用的几个如下:
:::color4
📢注意:✅️上述内置函数,不仅适用于列表,而是适用于:所有的数据容器。
:::
1️⃣sorted(数据容器, reverse=布尔值),对容器排序(从小到大,不会改变原容器),返回值:经过排序的新容器。
# 1.使用内置的 sorted 函数,返回一个排序后的新容器(不改变原容器,默认顺序:从小到大)
# 1.1 若列容器中的元素:都是数字,则按照数字的大小顺序进行排序。
nums = [23, 11, 32, 30, 17]
result = sorted(nums, reverse=True)
print(nums)   # [23, 11, 32, 30, 17]
print(result) # [32, 30, 23, 17, 11]

# 1.2 若列容器中的元素:既有数字,又有字符串,那就会报错。
nums = [23, 11, 32, 30, 17, '尚硅谷']
sorted(nums)

# 1.3 若列容器中的元素:都是字符串,则按照字符串的 Unicode 编码大小进行排序。
msg_list = ['北京', '尚硅谷', '你好']
result = sorted(msg_list)
print(msg_list)  # ['北京', '尚硅谷', '你好']
print(result) # ['你好', '北京', '尚硅谷']
2️⃣len(数据容器),获取容器中元素的个数,返回值:元素个数。
# 2.使用内置的 len 函数,获取容器中元素的总数量,返回值是:元素总数量。
nums = [10, 20, 10, 30, 10, 40, [50, 60, 70]]
result = len(nums)
print(result) # 7
3️⃣max(数据容器),返回容器中 或 多个值中的最大值,返回值:容器中的最大值。
# 3.使用内置的 max 函数,获取容器中的最大值,返回值是:最大值。
# 3.1 如果容器中的元素:都是数字,那 max 返回的是最大的数。
nums = [23, 11, 32, 30, 17]
result = max(nums)
print(nums) # [23, 11, 32, 30, 17]
print(result) # 32

# 3.2 如果容器中的元素:既有数字又有字符串,那 max 会报错。
nums = [23, 11, 32, 30, 17, '尚硅谷']
max(nums)

# 3.3 如果容器中的元素:都是字符串,那 max 会返回:Unicode 编码最大的字符。
msg_list = ['北京', '尚硅谷', '你好']
result = max(msg_list)
print(msg_list)  # ['北京', '尚硅谷', '你好']
print(result)  # 尚硅谷

# 3.4 max 函数也可以接收多个值,并筛选出最大值
result = max(33, 45, 12, 78, 99)
print(result) # 99
4️⃣min(数据容器),返回容器中 或 多个值中的最小值,返回值:容器中的最小值。
# 4.使用内置的 min 函数,获取容器中的最小值,返回值是:最小值。
# 备注:min 函数的使用方式与注意点与 max 函数一样,只不过 min 函数返回的是最小值
nums = [23, 11, 32, 30, 17]
result = min(nums)
print(result) # 11
5️⃣sum(数据容器),对容器中所有元素求和(只能是数值类型),返回值:所有元素的和。
# 5.使用内置的 sum 函数,对容器中的数据进行求和(元素只能是数值)。
nums = [10, 20, 30, 40, 50]
result = sum(nums)
print(result) # 150
列表的循环遍历
所谓遍历,就是将列表的每个元素依次取出进行处理,代码如下:
# 定义一个成绩列表
score_list = [62, 50, 60, 48, 80, 20, 95]

# 使用while循环遍历列表
index = 0
while index < len(score_list):
    print(score_list[index])
    index += 1
# 使用for循环遍历列表
for item in score_list:
    print(item)

# 使用for循环遍历列表(通过range函数 和 len函数按照索引遍历)
for index in range(len(score_list)):
    print(score_list[index])
:::info
- 在上述遍历中,
while循环需要结束条件,所以我们定义了index变量,所以打印时,就可以方便的借助index输出当前元素是第几个。 - 而
for循环的遍历,不需要index,那如果也想打印元素是第几个,但又不想去定义index的话,可以借助**enumerate**这个内置函数,它可以在遍历时获取索引和值,代码如下:
:::
# 使用for循环遍历列表(通过enumerate函数,同时获取下标(索引值)和元素)
# enumerate 的 start 参数,可以让计数从指定值开始(改变的是循环时的“编号”,不是真正的索引值)
for index, item in enumerate(score_list, start=5):
    print(index, item, score_list[0])
print('最后的打印', score_list[0])
列表特点总结
- 可存放不同类型的元素。
- 元素是有序存储的(正索引、负索引)。
- 列表中的元素允许重复。
- 元素是允许修改的(增、删、改、查、其他操作)。
- 长度不固定,可以随着操作自动调整大小。
:::info
📍****一句话总结:列表是最常用的数据容器,当遇到要“存储一批数据”的场景时,首选列表。
:::
列表小练习
需求:实现一个成绩统计程序,可以对多名学生的成绩,进行统计和分析。具体统计的项目如下图:
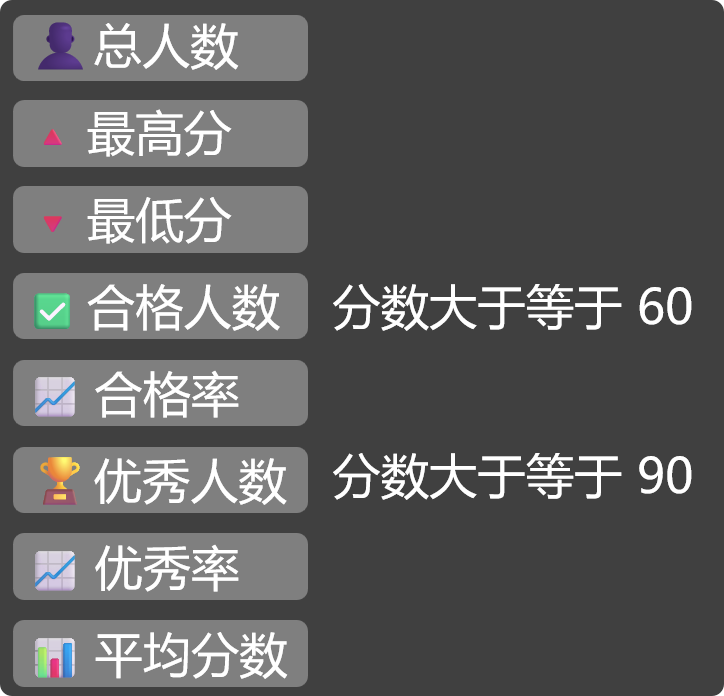
:::tips
📋****备注:用户可以连续输入学生成绩,直到用户输入“结束”字符串。
:::
print('请输入学生成绩,输入“结束”停止录入')
score_list = []
# 持续循环,让用户输入学生成绩
while True:
data = input('📝请输入成绩:')
if data == '结束':
break
else:
score_list.append(int(data))
# 如果score_list中有数据,则开始统计
if score_list:
# 统计平均分
avg = sum(score_list) / len(score_list)
# 合格人数
pass_count = 0
# 优秀人数
excellent_count = 0
# 遍历列表,开始统计
for item in score_list:
if item >= 60:
pass_count += 1
if item >= 90:
excellent_count += 1
# 合格率
pass_rate = pass_count / len(score_list) * 100
# 优秀率
excellent_rate = excellent_count / len(score_list) * 100
# 打印信息
print('********⬇️统计信息如下⬇️********')
print(f'🧑🎓总人数为:{len(score_list)}')
print(f'🔺最高分为:{max(score_list)}')
print(f'🔻最低分为:{min(score_list)}')
print(f'✅合格人数:{pass_count}人')
print(f'📈合格率为:{pass_rate:.1f}%')
print(f'🏆优秀人数:{excellent_count}人')
print(f'📈优秀率为:{excellent_rate:.1f}%')
print(f'📊平均分数:{avg:.1f}')
else:
print('您没有输入任何成绩!')
元组
概述
元组:用来存放一组有序的数据,但其中的内容一旦创建就不可修改(不能增、删、改,只能查)。
:::tips
由于元组不可变,所以元组不能使用<font style="color:#585A5A;">append()</font>、<font style="color:#585A5A;">insert()</font>这些方法,它里面的元素也不能被重新赋值。
:::
定义元组
使用方括号()来定义一个列表,用,去分隔不同的元素:

# 定义有内容的元组
t1 = (28, 67, 21, 67, 11)
t2 = ('北京', '尚硅谷', '你好')
t3 = (100, True, '你好', None)
t4 = (100, True, '你好', None, (50, 60, 70))
print(type(t1), t1)  # <class 'tuple'> (28, 67, 21, 67, 11)
print(type(t2), t2)  # <class 'tuple'> ('北京', '尚硅谷', '你好')
print(type(t3), t3)  # <class 'tuple'> (100, True, '你好', None)
print(type(t4), t4)  # <class 'tuple'> (100, True, '你好', None, (50, 60, 70))

# 定义空元组
t1 = ()
t2 = tuple()
print(type(t1), t1)  # <class 'tuple'> ()
print(type(t2), t2)  # <class 'tuple'> ()
当元组中只有一个元素时,末尾必须写上,
# 定义只有一个元素的元组
t1 = ('你好',)
t2 = (18,)
print(type(t1), t1)  # <class 'tuple'> ('你好',)
print(type(t2), t2)  # <class 'tuple'> (18,)
实际开发中的元组,不一定是我们自己定义的,比如函数的可变参数*args就是一个元组
# 实际开发中的元组,不一定是我们自己定义的,比如函数的可变参数*args就是一个元组
def demo(*args):
    return sum(args)
result = demo(100, 200, 300)
print(result)  # 600
读取数据
元组也支持下标,所以使用元组名[索引值]的方式来读取值。
# 元组的下标
t1 = (28, 67, 21, 67, 11)
print(t1[3])  # 67
print(t1[-1]) # 11
元组不可修改
元组中的元素,不可修改,但元组中如果存放了可变类型(如:列表),那可变类型中的内容仍可修改。
# 元组中的元素,不可修改
t1 = (28, 67, 21, 67, 11)
t1[0] = 100

# 元组中的元素,不可修改,但元组中如果存放了可变类型(列表),那可变类型中的内容仍可修改
t2 = (28, 67, 21, 67, 11, [100, 200, 300, ('你好', '尚硅谷')])
t2[5] = 400
t2[5][2] = 400
t2[5][3][0] = 'hello'
print(t2)
元组的常用方法
由于元组不可修改,所以它的常用方法只有两个:
1️⃣使用元组.index(元素),获取指定元素在元组中第一次出现的下标。
# index 方法:获取指定元素在元组中第一次出现的下标。
t1 = (28, 67, 21, 67, 11)
result = t1.index(67)
print(result)  # 1
2️⃣使用元组.count(元组),统计指定元素在元组中出现的次数。
# count 方法:统计指定元素在元组中出现的次数。
t1 = (28, 67, 21, 67, 11)
result = t1.count(67)
print(result)  # 2
元组的常用内置函数
元组的常用内置函数和列表一样,依然是这几个:max、min、len、sorted、sum。
# 常用内置函数
# max 函数,返回元组中的最大值
t1 = (23, 11, 32, 30, 17)
result = max(t1)
print(result)  # 32

# min 函数,返回元组中的最小值
t1 = (23, 11, 32, 30, 17)
result = min(t1)
print(result)  # 11

# len 函数,返回元组中元素的个数(元组长度)
t1 = (23, 11, 32, 30, 17)
result = len(t1)
print(result)  # 5

# sorted 函数,对元组进行排序(不修改原元组,返回一个新的列表)
t1 = (23, 11, 32, 30, 17)
result = sorted(t1, reverse=True)
print(tuple(result)) # (32, 30, 23, 17, 11)

# sum 函数,统计元组中所有元素的和(元素必须是纯数字)
t1 = (23, 11, 32, 30, 17)
result = sum(t1)
print(result) # 113
元组的循环遍历
元组的遍历与列表一样,可以使用while循环遍历,或for循环遍历。
# 元组的循环遍历
t1 = (23, 11, 32, 30, 17)

# while循环遍历
index = 0
while index < len(t1):
    print(t1[index])
    index += 1
# 元组的循环遍历
t1 = (23, 11, 32, 30, 17)

# for循环遍历
for item in t1:
    print(item)
解包列表或元组传参
解包列表、解包元组传参,就是把其中的元素依次取出,作为多个独立的参数传入函数。
# 定义函数时,使用*args(变量不一定非要用args,比如写:*data也行),将收到的多个参数,打包成一个元组
def test(*args):
    print(f'我是test函数,我收到的参数是:{args},参数类型是:{type(args)}')

list1 = [100, 200, 300, 400]
tuple1 = ('你好', '北京', '尚硅谷')

# 函数调用时,正常传递:列表 或 元组
# test(list1)
# test(tuple1)

# 函数调用时,使用*对:列表 或 元组进行解包后,再传递参数
test(*list1)  # 此种写法相当于:test(100, 200, 300, 400)
test(*tuple1)  # 此种写法相当于:test('你好', '北京', '尚硅谷')
元组特点总结
- 可存放不同类型的元素。
- 元素是有序存储的(正索引、负索引)。
- 元组中的元素允许重复。
- 元素不允许修改文(不能:增、删、改、只能:查)。
- 长度固定定(一旦创建,元素个数不能增减)。
:::info
📍****一句话总结:元组是一种“只读”的数据容器,想保存一批“不会变的数据”时,首选元组。
:::
元组 VS 列表
| 区别点 | 列表(list) | 元组(tuple) |
|---|---|---|
| 是否可变 | 可变 | 不可变 |
| 使用场景 | 可变数据集合 | 不变的结构化数据,安全性更高 |
| 语义 | 表示一组可能变化的数据 | 表示一组固定结构的数据 |
:::info
📢****注意:元组不是用来替代列表的,而是用来在数据不需要修改的情况下,作为列表的补充选择。
:::
字符串
概述
字符串(str):用来存放一组有序的字符数据,但其中的内容不可修改(只能查,不能增删改), 我们之前讲解了一部分字符串的相关知识,如:字符串的定义方式、字符串的格式化输出等,这些内容就不在本小节重复讲解了。
字符串的特点
1️⃣字符串和列表、元组一样,也支持下标
# 字符串的下标
msg = 'welcome to atguigu'
print(msg[3])  # c
print(msg[-1]) # u
2️⃣字符串不可修改,不可嵌套
# 字符串中的字符,不可修改
msg = 'welcome to atguigu'
msg[0] = 'a'

# 字符串不能嵌套
msg = 'welcome to'hello' atguigu'
msg = 'welcome to"hello" atguigu'
msg = 'welcome to\'hello\' atguigu'
字符串常用方法
1️⃣使用字符串.index(字符),获取『指定字符』在字符串中『第一次』出现的下标,返回值:下标。
# index 方法:获取指定字符,在字符串中第一次出现的下标
msg = 'welcome to atguigu'
result = msg.index('t')
print(result)  # 8
2️⃣使用字符串.split(字符),将字符串按照『指定字符』进行分隔,返回值:列表。
# split 方法:将字符串按照指定字符进行分隔,并将分隔后的内容存入一个列表
msg  = '尚硅谷@atguigu@你好'
result = msg.split('@')
print(msg)  # 尚硅谷@atguigu@你好
print(result)  # ['尚硅谷', 'atguigu', '你好']
3️⃣使用字符串.replace(字符串片段),将字符串中的某个字符串片段,替换成目标字符串,不会修改原字符串,返回新字符串。
# replace 方法:将字符串中的某个字符片段,替换成目标字符串(不修改原字符串,返回新字符串)
msg = 'welcome to atguigu'
result = msg.replace('atguigu', '尚硅谷')
print(msg)    # welcome to atguigu
print(result) # welcome to 尚硅谷
4️⃣使用字符串.count(字符),统计『指定字符』在字符串中出现的次数,返回值:下标。
# count 方法:统计指定字符,在字符串中出现的次数
msg = 'welcome to atguigu'
result = msg.count('g')
print(result)  # 2
5️⃣使用字符串.strip(),从某个字符串中删除指定字符串中的任意字符,不会修改原字符串,返回值:新字符串。
# strip 方法:从某个字符串中删除:指定字符串中的任意字符
# 规则:从字符串两端开始删除,直到遇到第一个不在字符串中的字符就停下
msg = '666尚6硅6谷666'
result = msg.strip('6')
print(msg)    # 666尚6硅6谷666
print(result) # 尚6硅6谷

msg = '1234尚12硅34谷4321'
result = msg.strip('1324')
print(msg)     # 1234尚12硅34谷4321
print(result)  # 尚12硅34谷

msg = '34215尚12硅34谷4132'
result = msg.strip('5432')
print(msg)   # 34215尚12硅34谷4132
print(result)# 15尚12硅34谷41

msg = '  尚硅谷  '
result = msg.strip()
print(msg)   #   尚硅谷
print(result)# 尚硅谷
字符串常用内置函数
字符串也可以使用:max、min、len、sorted、sum函数,但实际开发中len函数最常用。
# len 函数:统计字符串中字符的个数(字符串长度)
msg = 'welcome to atguigu'
result = len(msg)
print(result) # 18
遍历字符串
字符串的遍历,与列表一样,可以使用while循环遍历,或for循环遍历。
msg = 'welcome to atguigu'
# while循环遍历
index = 0
while index < len(msg):
    print(msg[index])
    index += 1
msg = 'welcome to atguigu'

# for循环遍历
for item in msg:
    print(item)
序列的切片操作
概述
何为序列?—— 能连续存放元素的数据容器,而且元素有先后顺序,而且可以通过下标访问,所以我们学过的:列表、元组、字符串,都是序列。
何为切片?—— 从序列中按照指定范围,取出一部分元素,形成一个新的序列的操作。
基本语法
语法格式为:**序列[起始索引:结束索引:步长]**
相关注意点如下:
:::info
- 切片操作的区间是左闭右开的,即:截取时包含起始位置,但不包含结束位置。
- 步长是指取出元素时的间隔,例如:
- 步长为 1,就是一个一个取出。
- 步长为 2,就是每次越过 1 个元素取出。
- 步长为 3,就是每次越过 2 个元素取出。
- 步长为 n,就是每次越过 n-1 个元素取出。
- 起始索引默认值为 0,结束索引默认截取到末尾,步长默认值为 1。
- 当起始索引大于结束索引时,步长必须为负数,否则结果是空列表。
:::
测试代码:
# 对列表进行切片
list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[0:5:1]
print(list2)  # [10, 20, 30, 40, 50]

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[1:8:2]
print(list2)  # [20, 40, 60, 80]

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[1:8:3]
print(list2)  # [20, 40, 60, 80]

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[::]  # [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
print(list2)

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[:999:]
print(list2) # [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[3::]
print(list2)  # [40, 50, 60, 70, 80, 90, 100]

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[:5:]
print(list2)  # [10, 20, 30, 40, 50]

list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[::4]
print(list2)  # [10, 50, 90]

# 当起始索引大于结束索引时,步长必须为负数,否则结果是空列表。
list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[7:2:-1]
print(list2)  # [80, 70, 60, 50, 40]

# 一个特殊情况:当同时省略起始索引和结束索引时,如果步长为负数,那Python会自动对调:起始位置和结束位置
list1 = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
list2 = list1[::-1]
print(list2)  # [100, 90, 80, 70, 60, 50, 40, 30, 20, 10]

# 对元组进行切片
tuple1 = (10, 20, 30, 40, 50, 60, 70, 80, 90, 100)
tuple2 = tuple1[0:5:1]
print(tuple2)  # (10, 20, 30, 40, 50)

# 对字符串进行切片
msg1 = 'welcome to atguigu'
msg2 = msg1[2:9:2]
print(msg2)  # (10, 20, 30, 40, 50)
序列的其他操作
1️⃣**序列相加: **把两个序列拼接在一起。
:::color4
📢注意:只有同类型的序列才能相加(字符串+字符串、列表+列表、元组+元组)
:::
# 列表相加
list1 = [10, 20, 30, 40]
list2 = [50, 60, 70, 80]
list3 = list1 + list2
print(list3)  # [10, 20, 30, 40, 50, 60, 70, 80]

# 元组相加
tuple1 = (10, 20, 30, 40)
tuple2 = (50, 60, 70, 80)
tuple3 = tuple1 + tuple2
print(tuple3)  # (10, 20, 30, 40, 50, 60, 70, 80)

# 字符换相加
str1 = 'hello'
str2 = 'atguigu'
str3 = str1 + str2
print(str3) # helloatguigu

# 错误示例
list1 = [10, 20, 30, 40]
str1 = 'hello'
print(list1 + str1) # 报错
2️⃣序列相乘(重复):把序列重复指定的次数。
# 序列相乘(重复)
list1 = [10, 20, 30, 40]
list2 = list1 * 3
print(list2)  # [10, 20, 30, 40, 10, 20, 30, 40, 10, 20, 30, 40]

tuple1 = (10, 20, 30, 40)
tuple2 = tuple1 * 3
print(tuple2)  # (10, 20, 30, 40, 10, 20, 30, 40, 10, 20, 30, 40)

str1 = 'hello'
str2 = str1 * 6
print(str2)  # hellohellohellohellohellohello
集合
概述
集合是一种:无序、元素唯一的容器类型。
:::tips
📋备注:无序是指从集合中取出元素的顺序,与定义集合时存入的顺序不一定一致。
:::
集合分为两种,分别是:
- 可变集合(set):内部的元素无序(不保证顺序)、不能通过下标访问元素、会自动去除重复元素。
- 不可变集合(forzenset):特点和可变集合一样,唯一的区别就是:其中的元素不可修改。
定义集合
1️⃣可变集合的定义方式:使用花括号{}包裹,不同的数据项之间,用,做分隔。
# 定义有内容的【可变集合】
s1 = {10, 20, 20, 30, 40, 40, 50, 60, 60, 70, 80, 90, 100}
s2 = {'你好', 'hello', '你好', 'atguigu', '北京'}
s3 = {10, '你好', True, 1, 12.4}
print(type(s1), s1)  # <class 'set'> {100, 70, 40, 10, 80, 50, 20, 90, 60, 30}
print(type(s2), s2)  # <class 'set'> {'atguigu', 'hello', '你好', '北京'}
print(type(s3), s3)  # <class 'set'> {True, 10, '你好', 12.4}

# 定义空集合(可变集合)
s1 = set()
print(type(s1), s1)  # <class 'set'> set()
:::color4
📢****注意:不能直接写{}来定义空集合,因为直接写{}定义的是:空字典。
:::
# 不能直接写{}来定义空集合,因为直接写{}定义的是:空字典
s2 = {}
print(type(s2), s2)  # <class 'dict'> {}
2️⃣不可变集合的定义方式:借助内置的forzenset函数。
# 定义有内容的【不可变集合】
s1 = frozenset({10, 20, 20, 30, 40, 40, 50, 60, 60, 70, 80, 90, 100})
s2 = frozenset({'你好', 'hello', '你好', 'atguigu', '北京'})
s3 = frozenset({10, '你好', True, 1, 12.4})
print(type(s1), s1)
print(type(s2), s2)
print(type(s3), s3)

# frozenset 接收的参数,可以是任意可迭代对象,但最终返回的一定是【不可变集合】
s1 = frozenset([10, 20, 30, 40, 50])
s2 = frozenset((10, 20, 30, 40, 50))
s3 = frozenset('hello')
print(type(s1), s1)
print(type(s2), s2)
print(type(s3), s3)

# 定义空集合(不可变集合)
s3 = frozenset()
print(type(s3), s3)
3️⃣集合中不能嵌套【可变集合】,但可以嵌套【不可变集合】
为什么会这样?—— 只有“不可变”的东西,才能安全的放进集合里。
# 集合中不能嵌套【可变集合】,但可以嵌套【不可变集合】
# 通俗理解:只有“不可变”的东西,才能安全的放进集合里
s1 = {10, 20, 30, 40, 50}
s2 = frozenset({100, 200, 300, 400, 500})
l1 = [666, 777, 888]
t1 = ('hello', 'atguigu', '北京')

s3 = {11, 22, 33, s1}  # 报错
s3 = {11, 22, 33, s2}  # 没问题
s3 = {11, 22, 33, l1}  # 报错
s3 = {11, 22, 33, t1}  # 没问题
print(s3)
增删改查
1️⃣新增
方式1:使用集合.add(元素),向集合中添加元素,无返回值。
# add方法:向集合中添加元素
s1 = {10, 20, 30, 40, 50}
s1.add(60)
print(s1)
方式2:使用集合.update(元素),向集合中批量添加元素(接收可迭代对象),无返回值。
# update方法:向集合中添加元素(必须传递可迭代对象,例如:列表、元组、集合等)
s1 = {10, 20, 30, 40, 50}
s1.update([60, 70])
s1.update((80, 90))
s1.update({100, 200})
s1.update(range(300, 308))
print(s1)
2️⃣删除
方式1:使用集合.remove(元素),从集合中移除指定元素(若元素不存在,会报错),无返回值。
# remove方法:从集合中移除元素(移除不存在的元素,会报错)
s1 = {10, 20, 30, 40, 50}
s1.remove(20)
print(s1)
方式2:使用集合.discard(元素),从集合中移除指定元素(若元素不存在,不会报错),无返回值。
# discard方法:从集合中移除元素(移除不存在的元素,不会报错)
s1 = {10, 20, 30, 40, 50}
s1.discard(80)
print(s1)
方式3:使用集合.pop(),从集合中移除一个任意元素,返回值:移除的那个元素。
# pop方法:从集合中移除一个任意元素,返回值是移除的那个元素
s1 = {10, 20, 30, 40, 50}
s2 = {'你好', '北京', '尚硅谷', 'hello'}
result = s1.pop()
print(s1)
print(result)
方式4:使用集合.clear(),清空集合,无返回值。
# clear方法:清空集合
s1 = {10, 20, 30, 40, 50}
s1.clear()
print(s1)
3️⃣修改
:::color4
📢****注意:集合没有下标,也不支持replace方法,所以集合没有专门用于“改”的方法,但可以使用:remove+add的组合,来达到“修改”的效果。
:::
# 改
# 使用 add + remove 的组合,来实现修改的效果
s1 = {10, 20, 30, 40, 50}
s1.remove(20)
s1.add(66)
print(s1)
4️⃣查询
:::color4
📢****注意:由于集合没有下标,也不支持切片操作,所以集合不具备按位置访问的能力。虽然不能通过下标读取元素,但可以使用【成员运算符】来判断:某个元素是否在集合中,成员运算符我们会放在后面讲,不过大家可以提前感受一下:
:::
# 查:集合不能通过下标去读取元素,但能通过 【成员运算符】去查看集合中是否包含指定元素
# 由于成员运算符适用于所有数据容器,所以我们会等所有数据容器都讲完以后,再说成员运算符
s1 = {10, 20, 30, 40, 50}
# s1[0] # 此行报错,因为集合不能通过下标访问元素

# 先提前感受一下成员运算符
result = 20 not in s1
print(result)
常用方法
集合常用的方法有如下几个:
1️⃣使用集合A.difference(集合B),找出集合A中,不同于集合B的元素。
# 集合A.difference(集合B):
# 作用:找出集合A中,不同于集合B的元素(集合A 与 集合B 都不变,返回的是一个新的集合)
s1 = {10, 20, 30, 40, 50}
s2 = {30, 40, 50, 60, 70}
result = s1.difference(s2)
print(s1)
print(s2)
print(result)
2️⃣使用集合A.difference_update(集合B),从集合A中,删除集合B中存在的元素。
# 集合A.difference_update(集合B):
# 作用:从集合A中,删除集合B中存在的元素(集合A会被修改,集合B不会)
s1 = {10, 20, 30, 40, 50}
s2 = {30, 40, 50, 60, 70}
s1.difference_update(s2)
print(s1)
print(s2)
3️⃣使用集合A.union(集合B),合并两个集合,集合A 和 集合B 都不变,返回的是一个新的集合。
# 集合A.union(集合B):
# 作用:合并两个集合,集合A 和 集合B 都不变,返回的是一个新的集合
s1 = {10, 20, 30, 40, 50}
s2 = {30, 40, 50, 60, 70}
result = s2.union(s1)
print(s1)
print(s2)
print(result)
4️⃣使用集合A.issubset(集合B),判断集合A是否为集合B的子集,返回值为布尔值。
# 集合A.issubset(集合B):
# 作用:判断集合A是否为集合B的子集
# 如果 集合A的所有元素都在集合B中,那就返回True,否则返回False
s1 = {10, 20, 30, 40, 50}
s2 = {30, 40, 50, 60, 70}
s3 = {30, 40, 50}
result = s3.issubset(s1)
print(result)
5️⃣使用集合A.issuperset(集合B),判断集合A是否是集合B的超集,返回值为布尔值。
# 集合A.issuperset(集合B):
# 作用:判断集合A是否是集合B的超集
# 如果集合A中,包含了集合B中的所有元素,那就返回True,否则返回False
s1 = {10, 20, 30, 40, 50}
s2 = {30, 40, 50, 60, 70}
s3 = {30, 40, 50}
result = s1.issuperset(s3)
print(result)
6️⃣使用集合A.isdisjoint(集合B),判断集合A和集合B是否没有交集,返回值为布尔值。
# 集合A.isdisjoint(集合B):
# 作用:
# 如果没有交集,返回True;只要有一个公共元素,就返回False
s1 = {10, 20, 30, 40, 50}
s2 = {30, 40, 50, 60, 70}
s3 = {80, 90}
result = s1.isdisjoint(s2)
print(result)
集合的数学运算
集合的数学运算如下:
s1 = {10, 20, 30, 40, 50, 60}
s2 = {40, 50, 60, 70, 80, 90}

# 并集
result = s1 | s2
print(result)

# 交集
result = s1 & s2
print(result)

# 差集
result = s1 - s2
print(result)

# 对称差集
result = s1 ^ s2
print(result)
集合的循环遍历
由于集合不支持下标,所以集合不能使用 while 循环遍历。
s1 = {10, 20, 30, 40, 50, 60}

# 集合不能使用while循环遍历(以下是错误示例)
# index = 0
# while index < len(s1):
#     print(s1[index])
#     index += 1

# 集合可以使用for循环遍历
for item in s1:
    print(item)
集合特点总结
- 无序:集合中的元素没有固定顺序,无法通过下标访问。
- 不重复:集合会自动去重,同一个元素只会保留一份。
- 分为两种:可变集合合(set)和不可变集合(forzenset)。
- 集合中的元素必须是不可变类型(如:数字、字符串、元组)。
- 集合支持:并集、交集、差集、对称差集等数学操作。
:::info
📍****一句话总结:集合是可以去重的数据容器,当只关心元素是否存在,而不在乎顺序的时,首选集合。
:::
字典
概述
字典:用来存放一组『键值对』数据,可通过『键(key)』对『值(value)』进行:增、删、改、查操作。
字典就像一个带标签的收纳盒,你贴上标签(键),然后放进东西(值) 。
定义字典
用大括号{}包裹,每个元素之间用逗号,分隔,每个元素的格式为key:value
# 定义有内容的字典
d1 = {'张三': 72, '李四': 60, '王五': 85}
print(type(d1), d1)
字典中的 key 不能重复,若出现重复,则后写的会覆盖之前写的。
# 字典中的key不能重复,若出现重复,则后写的会覆盖之前写的
d1 = {'张三': 72, '李四': 60, '王五': 85, '张三': 99}
print(d1)
定义空字典
# 定义空字典
d1 = {}
d2 = dict()
print(type(d1), d1)
print(type(d2), d2)
字典中的 key 必须是不可变类型,但 value 可以是任意类型。
# 字典中的key必须是不可变类型,但value可以是任意类型
# 通俗理解:只有不可变的东西,才能作为key
d1 = {250: 72, '李四': 60, '王五': 85}
d2 = {('抽烟', '喝酒'): 72, '李四': 60, '王五': 85}
# print(d1)
# print(d2)

# 错误示例:将列表作为key,是不行的
# d2 = {['抽烟', '喝酒']: 72, '李四': 60, '王五': 85}
字典可以嵌套
# 字典可以嵌套
student_dict = {
    2025001: {
        '姓名': '张三',
        '年龄': 18,
        '成绩': 72,
        '爱好': ['抽烟', '喝酒', '烫头']
    },
    2025002: {
        '姓名': '李四',
        '年龄': 19,
        '成绩': 60,
        '爱好': ['唱歌', '跳舞', '打台球']
    },
    2025003: {
        '姓名': '王五',
        '年龄': 20,
        '成绩': 85,
        '爱好': ['学习', '看书', '打太极']
    }
}
print(student_dict)
字典的增删改查
1️⃣新增
新增语法:字典[key] = 值
# 新增
d1 = {'张三': 72, '李四': 60, '王五': 85}
d1['赵六'] = 100
print(d1)
2️⃣****删除
# 删除
d1 = {'张三': 72, '李四': 60, '王五': 85}

# 删除指定key所对应的那组键值对
del d1['张三']
print(d1)

# 删除指定key所对应的那组键值对,并返回这个key所对应的值
result = d1.pop('张三')
print(d1)
print(result)

# pop方法可以设置默认值
# 默认值可以保证:当要删除的key不存在的情况下,程序不会报错,并且返回这个默认值
result = d1.pop('奥特曼', '删除失败!')
print(d1)
print(result)

# 清空字典
d1.clear()
print(d1)
3️⃣****修改
d1 = {'张三': 72, '李四': 60, '王五': 85}

# 修改的写法,与新增的写法一样,若字典中有对应的key,就是修改;若没有,就是新增
d1['张三'] = 97
print(d1)

# 批量修改
d1.update({'李四': 40, '王五': 67})
print(d1)
4️⃣****查询
# 查询
d1 = {'张三': 72, '李四': 60, '王五': 85}

# 直接取值,若键(key)不存在,会报错
result = d1['张三']

# 安全取值,若键(key)不存在,会返回默认值(若没有设置默认值,则会返回None)
result = d1.get('奥特曼', '抱歉,key不存在!')
print(result)
字典的常用方法
1️⃣使用keys方法,获取字典中所有的键。
# keys方法:用于获取字典中所有的键
d1 = {'张三': 72, '李四': 60, '王五': 85}

# keys方法的返回值不是list,而是一种叫做dict_keys的类型
result = d1.keys()
print(result)
print(type(result))

# dict_keys和列表类似,可以被遍历,但要注意的是:它不能通过下标访问元素
for item in result:
    print(item)
print(result[0])

# 借助内置的list函数,可以将dict_keys转换成list
l1 = list(result)
print(l1)
print(type(l1))
2️⃣使用values方法,获取字典中所有的值。
# values方法:获取字典中所有的值
d1 = {'张三': 72, '李四': 60, '王五': 85}
# values方法的返回值类型是:dict_values,它的特点和dict_keys一样
result = d1.values()
print(result)
print(type(result))
3️⃣使用items方法,获取字典中所有的键值对(每组键值对以元组的形式呈现)
# items方法:获取字典中所有的键值对(每组键值对以元组的形式呈现)
d1 = {'张三': 72, '李四': 60, '王五': 85}

# items方法返回的类型是:dict_items,它的特点也和dict_keys一样
result = d1.items()
print(result)
print(type(result))
字典的循环遍历
字典不能使用while循环遍历,但可以使用for循环遍历
# 字典不能使用while循环遍历,但可以使用for循环遍历
d1 = {'张三': 72, '李四': 60, '王五': 85}

for key in d1:
    print(f'{key}的成绩是{d1[key]}')

for key in d1.keys():
    print(f'{key}的成绩是{d1[key]}')
字典总结
- 键值对结构:字典中的数据以
key:value的形式存在,每个键都对应一个值。 - 键唯一:字典中的键(key)不能重复,若重复则后写的会覆盖前写的。
- 键不可变::键必须是不可变类型(如数字、字符串、元组等),而值可以是任意类型。
- 不支持下标:字典中的元素不能通过下标取值。
- 支持增删改查,支持for循环遍历。
:::info
📍****一句话总结:字典是一种以“键”找“值”的映射型容器,当需要唯一标识 → 对应信息的结构时,首选字典。
:::
数据容器_通用操作
我们之前在讲解【列表常用函数时】给大家总结过如下这些函数,这些函数也同样适用于其它数据容器
除了上述这些内置函数以外,数据容器都可以进行如下通用操作
list函数: 1.定义空列表;2.将【可迭代对象】转换为列表。tuple函数:1.定义空元组;2.将【可迭代对象】转换为元组。set函数: 1.定义空集合;2.将【可迭代对象】转换为集合。str函数: 1.定义空字符串;2.将【任意类型】转换为字符串。dict函数: 1.定义空字典;2.将【可迭代对象】转换为字典。- 所有的数据容器,都支持【成员运算符】
in / not in作用:判断某个元素是否在于容器中。
# 以下这五个函数:既能定义对应的【空容器】,又能将【其他类型】转换为对应的数据类型

# 1.list 函数:1.定义空列表。2.将【可迭代对象】转换为列表
res1 = list(range(8))
res2 = list('欢迎来到尚硅谷')
res3 = list({10, 20, 30, 40, 50})
res4 = list({'张三': 75, '李四': 60, '王五':85}.items())
print(type(res1), res1)
print(type(res2), res2)
print(type(res3), res3)
print(type(res4), res4)

# 2.tuple 函数:1.定义空元组。2.将【可迭代对象】转换为元组
res1 = tuple(range(8))
res2 = tuple('欢迎来到尚硅谷')
res3 = tuple({10, 20, 30, 40, 50})
res4 = tuple({'张三': 75, '李四': 60, '王五':85})
print(type(res1), res1)
print(type(res2), res2)
print(type(res3), res3)
print(type(res4), res4)

# 3.set 函数:1.定义空集合。2.将【可迭代对象】转换为集合
res1 = set(range(8))
res2 = set('欢迎来到尚硅谷')
res3 = set({10, 20, 30, 40, 50})
res4 = set({'张三': 75, '李四': 60, '王五':85})
print(type(res1), res1)
print(type(res2), res2)
print(type(res3), res3)
print(type(res4), res4)


# 4.str 函数:1.定义空字符串。2.将【任意类型】转换为字符串
res1 = str(range(8))
res2 = str('欢迎来到尚硅谷')
res3 = str({10, 20, 30, 40, 50})
res4 = str({'张三': 75, '李四': 60, '王五':85})
res5 = str(False)
res6 = str(None)
res7 = str(100)
print(type(res1), res1)
print(type(res2), res2)
print(type(res3), res3)
print(type(res4), res4)
print(type(res5), res5)
print(type(res6), res6)
print(type(res6), res6)
print(type(res7), res7)

# 5.dict 函数:1.定义空字典。2.将【可迭代对象】转换为字典
# 备注:交给dict函数的内容必须是键值对才可以,否则就会报错
res1 = dict({'张三': 75, '李四': 60, '王五':85})
res2 = dict([('张三', 75), ('李四', 60), ('王五', 85)])
res3 = dict((('张三', 75), ('李四', 60), ('王五', 85)))
res4 = dict({('张三', 75), ('李四', 60), ('王五', 85)})
print(type(res1), res1)
print(type(res2), res2)
print(type(res3), res3)
print(type(res4), res4)

# 所有的数据容器,都支持【成员运算符】: in / not in  作用:判断某个“元素”是否在于容器中。
hobby = ['抽烟', '喝酒', '烫头']
nums = (10, 20, 30, 40, 50)
message = 'hello,atgiugu'
citys = {'北京', '天津', '上海', '重庆'}
score = {'张三': 75, '李四': 60, '王五':85}

print('喝酒' not in hobby)
print(20 not in nums)
print('hel' not in message)
print('上海' not in citys)
print('李华' not in score)
数据容器_小练习
数据容器_总结
:::info
有序与无序:
- 有序:列表(list)、元组(tuple)、字符串(str)—— 元素有顺序,可通过下标访问元素。
- 无序:集合(set)、字典(dict) —— 元素没有固定位置,不能用下标访问。
:::
:::info
可修改:
- 可变:列表(list)、集合(set)、字典(dict) —— 可以对内容进行增、删、改操作。
- 不可变:元组(tuple) 、字符串(str) —— 内容固定,创建后无法修改。
:::
:::info
可重复:
- 允许重复:列表(list) 、元组(tuple) 、字符串(str)
- 不允许重复:集合(set) 、字典(dict) 备注:字典的 key 是唯一的,但 value 可重复
:::
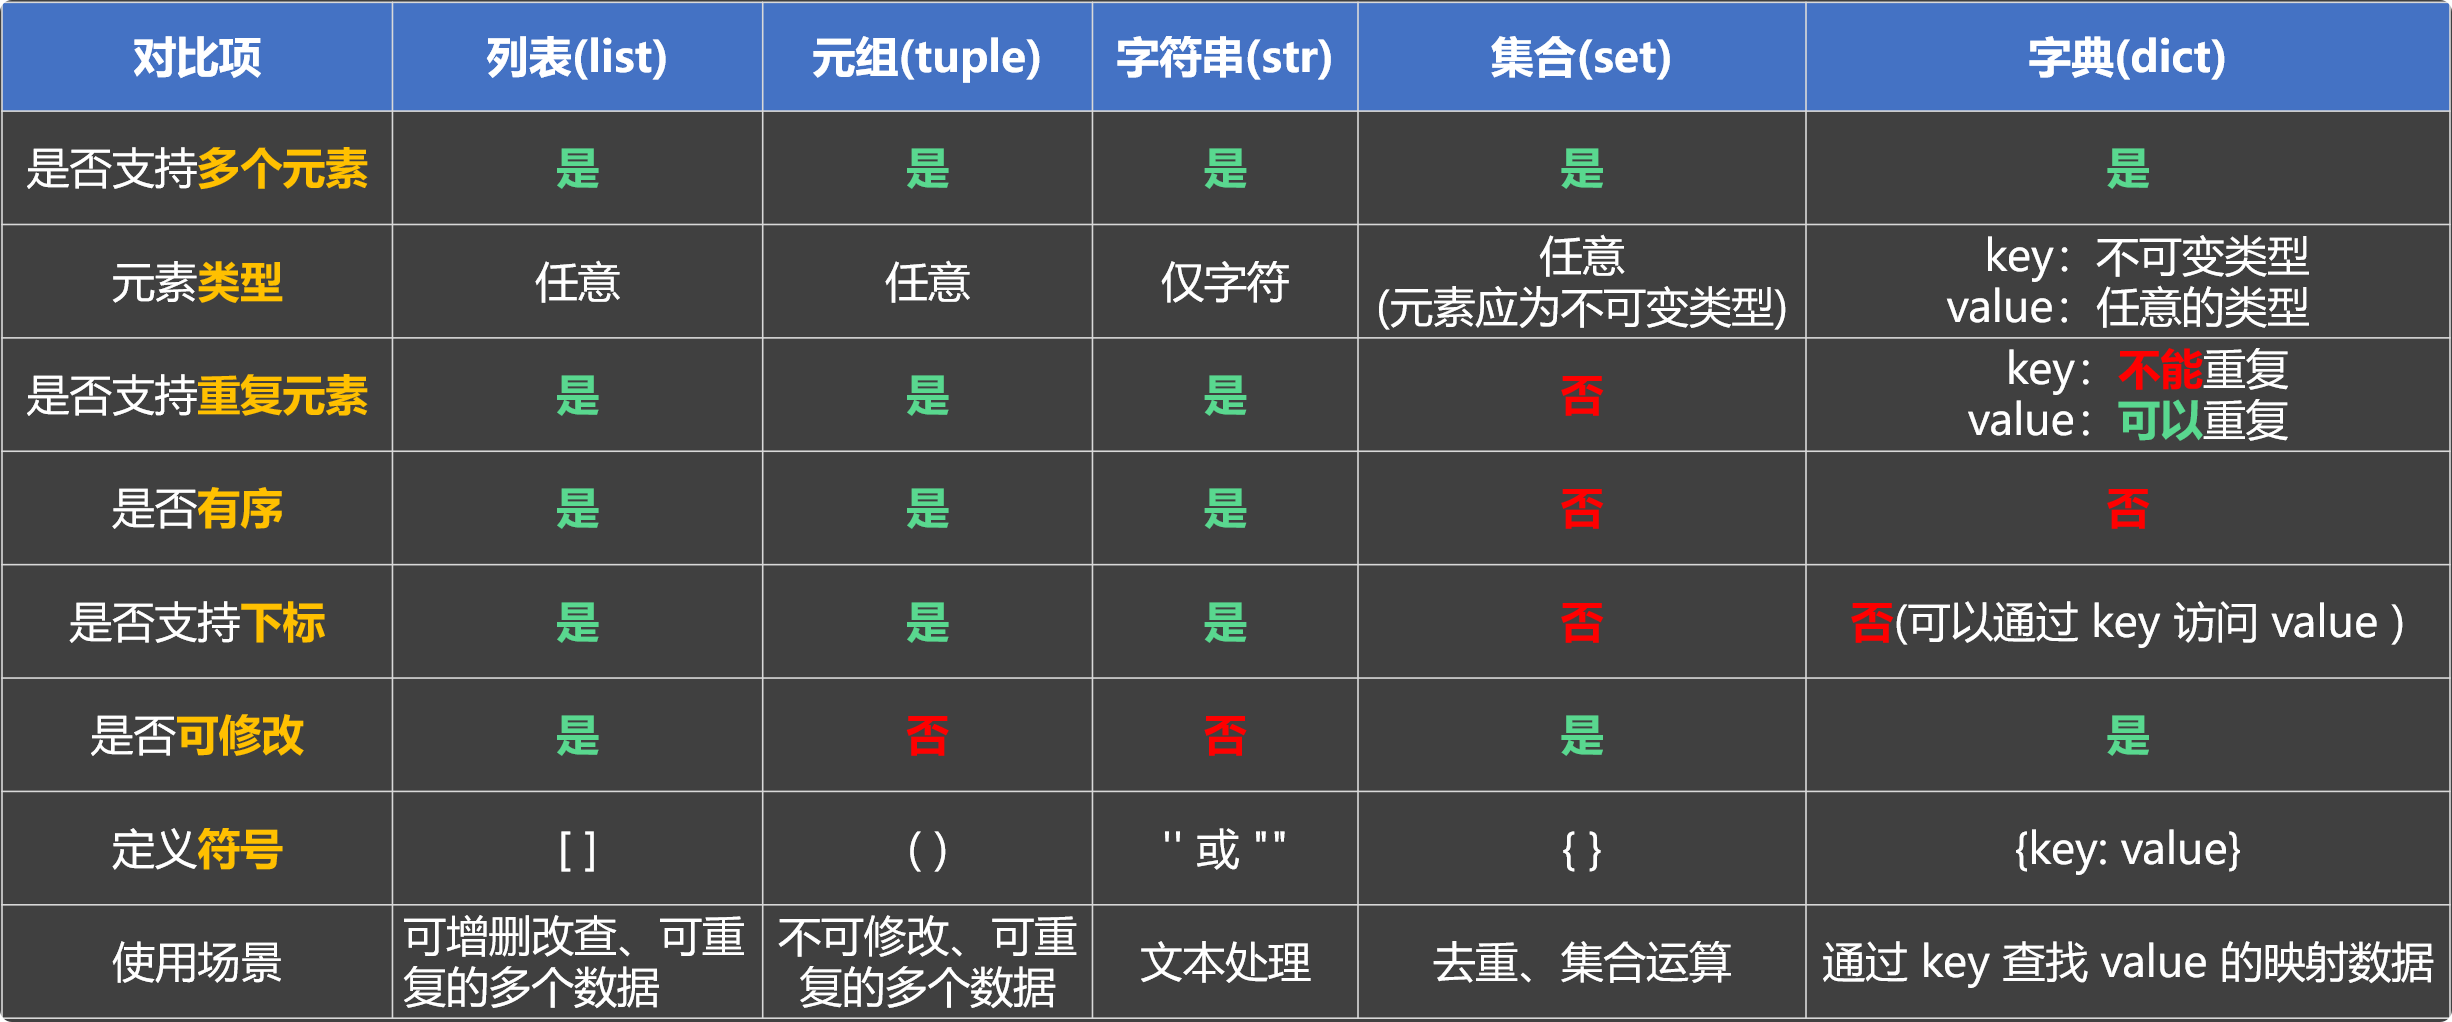
第 7 章 面向对象
概述
对象
『对象』是一个拥有『属性』和『行为』的个体,它是构成现实世界和程序世界的基本单位。编程领域有这么一句话,叫“万物皆对象!”之所以这么说,是因为任何一个具体存在的人或物,都可以看成是一个对象,例如:一个人、 一辆车、一部手机,都是对象,他们的『属性』和『行为』分别是:
:::tips
- 人的属性有:姓名、性别、年龄...... ,人的行为有:吃饭、睡觉、跑步......
- 车的属性有:品牌、颜色、价格...... ,车的行为有:启动、加速、刹车......
- 手机的属性有: 品牌、颜色、电量...... ,手机的行为有: 打电话、播放音乐、拍照......
:::
面向对象
『面向对象』是一种以对象为中心,去思考和组织代码的方式,它更关注:“谁来做这件事”。
以“做饭”这件事为例:
- 传统思想:关注“做饭的步骤”,会依次进行:洗菜 → 切菜 → 炒菜 → 装盘。
- 面向对象思想:关注“谁来做这件事”,会找『切菜员』来洗菜和切菜,找『厨师』来炒菜和装盘。
在上述描述中:『切菜员』和『厨师』就是对象,至于这些对象是我们自己编写的,还是来自外部模块,这并不重要。
:::info
面向对象思想的好处是:可扩展性强,『切菜员』能给我做菜,也能给别人做菜;能做简单的菜,也能做复杂的菜。在程序中也是这个道理:我们定义的“对象”,可以被复用,多个对象之间还可以协作,一起组成更大的系统。
:::
类
『类(class)』是用来描述一类事物的"模板",它规定了一类事物所具有的『属性』和『行为』。
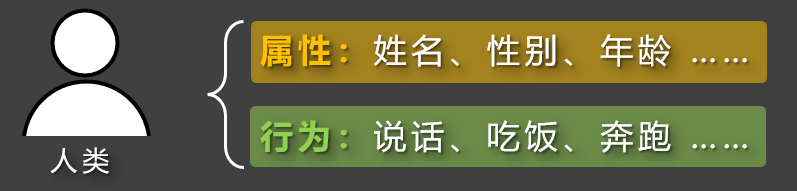
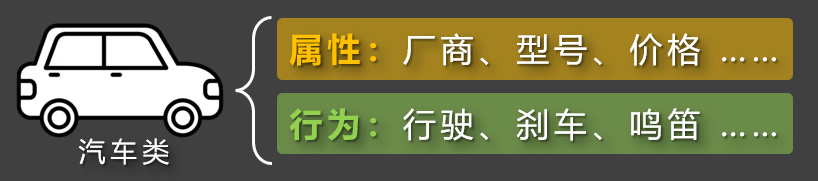
实例 VS 实例化
1️⃣****实例:根据『类』创建出来的一个具体的『对象』又称『实例』,也可称为『实例对象』。
:::tips
对象、实例、实例对象,这三个词在日常使用中是同一个意思。
:::
2️⃣****实例化:所谓『实例化』就是根据类“制造出”一个对象的过程。
:::tips
类是抽象的“模板”,『实例 / 实例对象 / 对象』是具体的个体。
:::
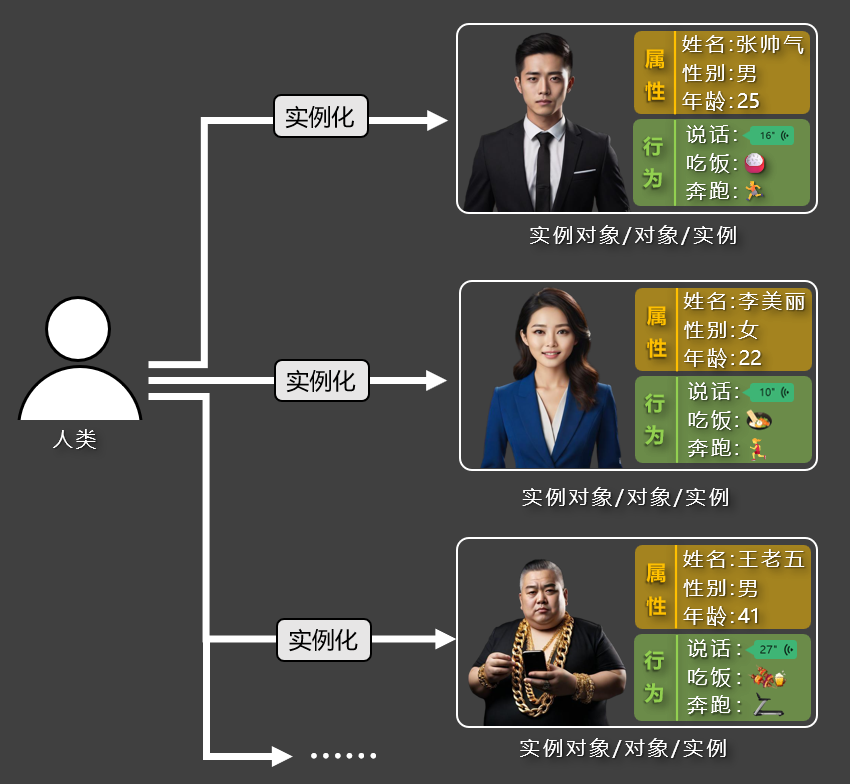
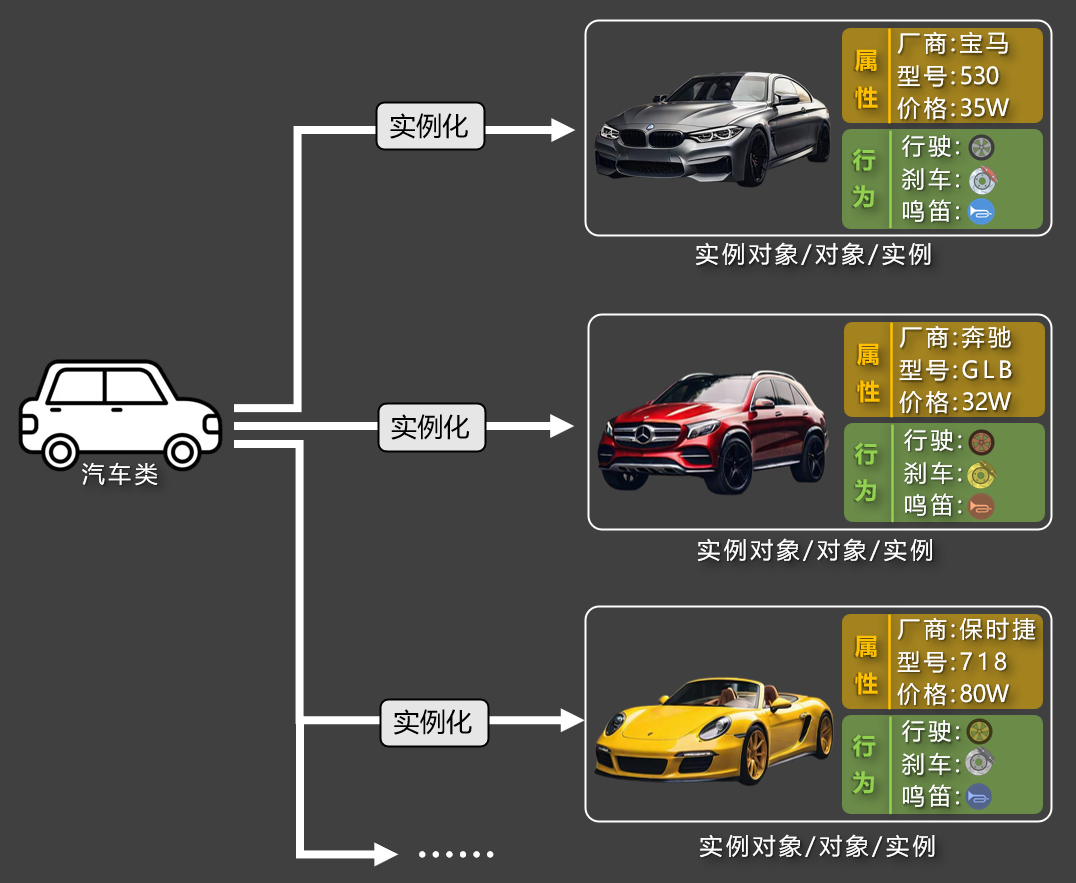
基本使用
类的定义
1️⃣语法格式:
# 定义一个类(类名通常用大驼峰写法)
class 类名:
    # 当一个函数被定义在类中时,它就被称为“方法”。
    # __init__方法又叫:初始化方法,它主要用来给当前实例对象添加属性。
    # __init__方法收到的参数是:当前正在创建的实例对象、其他自定义参数。
    # 当我们后期编写代码,对类进行实例化的时候,Python就会自动调用__init__方法,去完成对实例的初始化。
    def __init__(self, 参数1, 参数2, 参数3):
        # 通过self给当前实例添加属性,语法格式为:self.属性名 = 属性值
        self.属性名 = 参数1
        self.属性名 = 参数2
        self.属性名 = 参数3
2️⃣相关说明:
:::info
- 类名通常采用大驼峰命名法(如:
Person、UserInfo)。 - 类中所定义的函数,通常又称为方法。
__init__方法叫初始化方法,当我们对类进行实例化时,Python会自动调用__init__方法。__init__方法的名字不能更改,否则 Python 无法自动调用。__init__收到的第一个参数是当前正在创建的实例对象,形参通常用self。__init__方法收到的除self以外的参数,通常用来设置实例的属性值,通过“点”语法实现:**<font style="color:#AD1A2B;">self.属性名 = 属性值</font>**
:::
3️⃣代码示例:
# 定义一个Person类(类名通常使用:大驼峰写法)
class Person:
    # 说明:当一个函数被定义在了类中时,那这个函数就被称为:方法。
    # __init__方法:初始化方法,主要作用:给当前正在创建的实例对象添加属性
    # __init__方法收到的参数:当前正在创建的实例对象(self)、其它的自定义参数
    # 当我们以后编写代码去创建Person类实例的时候,Python会自动调用__init__方法
    def __init__(self, name, age, gender):
        # 给实例添加属性(语法为:self.属性名 = 值)
        self.name = name
        self.age = age
        self.gender = gender
创建实例
1️⃣语法格式:
实例名 = 类名(参数1, 参数2, ...)
2️⃣代码示例:
class Person:
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

# 创建Person的实例对象
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')
3️⃣通过实例的“点”语法,可以『访问』或『修改』实例的属性。
# 如果直接打印一个实例的话,我们是看不到实例身上的属性的
print(p1)
print(p2)

# 通过点语法可以访问或修改实例身上的属性
print(p1.name)
print(p1.age)
print(p1.gender)
print('-' * 20)
print(p2.name)
print(p2.age)
print(p2.gender)
p1.name = '阿三'
print(p1.name)
4️⃣通过**实例.__dict__**** **的方式,可以查看实例身上的所有属性。
# 通过 实例.__dict__ 可以查看实例身上的所有属性
print(p1.__dict__)
print(p2.__dict__)
5️⃣在实例创建完毕后,也可以通过**实例.属性名 = 值**的形式,给实例追加属性。
# 实例创建完毕后,依然可以通过 实例.属性名 = 值 去给实例追加属性
p1.address = '北京昌平宏福科技园'
print(p1.__dict__)
6️⃣通过type() 函数,可以查看某个实例对象,是由哪个类创建出来的。
# 通过type函数,可以查看某个实例对象,是由哪个类创建出来的
print(type(p1))
print(type(p2))
自定义方法(行为)
我们之前提到过:类是用来规定一类事物所具有的『属性』和『行为』,在上一小节中,我们已经通过
**self.属性名 = 值**的形式,为实例对象添加了『属性』;接下来,要想让对象具备相应的『行为』,就需要通过『自定义方法』来实现。
:::info
『自定义方法』的第一个参数也是self,是调用该方法的实例对象。
:::
# 定义一个Person类
class Person:
    # 初始化方法(给实例添加属性)
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

    # 自定义方法(给实例添加行为)
    # speak方法收到的参数是:调用speak方法的实例对象(self)、其它参数
    # speak方法只有一份,保存在Person类身上的,所有Person类的实例对象,都可以调用到speak方法
    def speak(self, msg):
        print(f'我叫{self.name}, 年龄是{self.age}, 性别是{self.gender},我想说:{msg}')

# 验证一下:speak方法是存在Person类身上的
# print(Person.__dict__)

# 创建Person类的实例对象
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')

# 验证一下:Person的实例对象身上是没有speak方法的
# print(p1.__dict__)
# print(p2.__dict__)

# 所有Person类的实例对象,都可以调用到speak方法
# 当执行p1.speak()的时候,查找speak方法的过程:1.实例对象自身(p1)  =>  2.实例的“缔造者”的身上(Person)
# p1.speak('好好学习')
# p2.speak('天天向上')

# 验证一下上述的查找过程
def speak():
    print('巴拉巴拉巴拉巴拉巴拉')
p1.speak = speak
print(Person.__dict__)
print(p1.__dict__)
print(p2.__dict__)
p1.speak()
实例属性、类属性
实例属性
1️⃣****定义:通过**实例.属性名 = 值**定义在实例身上的属性,称为:实例属性。
2️⃣****特点:
:::info
- 每个实例都有自己『独立的一份』实例属性,各个实例之间是互不影响的。
- 实例属性只能通过
**实例.xxxx**访问和修改,不能通过『类名』访问或修改。
:::
# 定义一个Person类
class Person:
    # 初始化方法
    def __init__(self, name, age, gender):
        # 通过【实例.属性名 = 值】给实例添加的属性,就叫实例属性
        # 实例属性只能通过实例访问,不能通过类访问
        # 每个实例都有自己【独一份的】实例属性,各个实例之间是互不干扰的
        self.name = name
        self.age = age
        self.gender = gender

# 创建Person类的实例对象
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')

# 实例属性只能通过实例访问,不能通过类访问
print(p1.name)
print(Person.name)
类属性
1️⃣****定义: 在类中直接写赋值语句(例如:a = 100),就会在类身上添加一个a属性,值为 100,此时的a就是『类属性』,它属于类本身,由类所拥有,并且该类创建出来的所有实例对象,都能去访问a属性。
2️⃣特点:
:::info
- 所有实例访问的,都是同一个类属性,所以类属性通常用于:存放公共数据。
- 类属性即可以通过『类』访问,也可以『实例』访问。
:::
# 定义一个Person类
class Person:
    # max_age、planet 他们都是类属性,类属性是保存在类身上的
    # 类属性可以通过类访问,也可以通过实例访问
    # 类属性通常用于保存:公共数据
    max_age = 120
    planet = '地球'

    # 初始化方法
    def __init__(self, name, age, gender):
        # 给实例添加属性
        self.name = name
        self.gender = gender
        # 限制age的最大值
        if age <= Person.max_age:
            self.age = age
        else:
            print(f'年龄超出范围了,已经将年龄设置为最大值:{Person.max_age}')
            self.age = Person.max_age

# 验证一下:类属性是保存在类身上的
# print(Person.__dict__)

# 创建Person类的实例对象
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')

# 验证一下:实例身上是没有类属性的
# print(p1.__dict__)
# print(p2.__dict__)


# 验证一下:类属性可以通过类访问,也可以通过实例访问
# print(Person.max_age)
# print(p1.max_age)  # 查找max_age的过程:1.实例自身(p1)  => 2.实例的“缔造者”(Person)
# print(p2.planet)

# 测试一下年龄超出范围
# p3 = Person('王五', 170, '女')
# print(p3.__dict__)
3️⃣****特别注意:
:::color4
进行**实例.属性名 = xxx**操作时,只会对实例自身的属性起作用(有则修改,无则添加)!
:::
# 注意点:进行【实例.属性名 = 值】操作时,只会对实例自身的属性起作用,不会影响类属性
p1.planet = '火星'
print(Person.__dict__)
print(p1.__dict__)
print(p2.__dict__)
print(p1.planet)
print(p2.planet)
实例方法、类方法、静态方法
实例方法
定义:类中所定义的方法,最终会保存在类身上,并且主要是通过实例调用,所以叫:实例方法。
特点:
:::info
- 实例方法虽然最终会保存在类身上,但它主要是供实例使用的,所以才叫实例方法。
- 因为收到了
self参数,所以其内部可以:访问实例属性,调用实例方法。 - 实例方法的主要作用:定义实例对象的具体行为。
:::
# 定义一个Person类
class Person:
    # 初始化方法(给实例添加属性)
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

    # 下面的speak方法、run方法,都保存在类身上,但他们主要是供实例调用,所以他们都叫:实例方法
    # 自定义方法(给实例添加行为)
    def speak(self, msg):
        print(f'我叫{self.name}, 年龄是{self.age}, 性别是{self.gender},我想说:{msg}')

    # 自定义方法(给实例添加行为)
    def run(self, distance):
        print(f'{self.name}疯狂的奔跑了{distance}米')

# 创建Person类的实例对象
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')

print(Person.__dict__)
print(p1.__dict__)
print(p2.__dict__)

# 通过实例调用实例方法
p1.speak('你好')
p1.run(300)

# 通过类去调用实例方法(能调用,但不推荐)
Person.run(p2, 100)
类方法
定义:使用@classmethod装饰器修饰,第一个参数是类本身,通常用形参cls接收。
特点:
:::info
- 可通过『类名』或『实例名』调用,但强烈推荐****通过类名调用以体现语义。
- 因为收到了
cls参数,所以内部可以访问类属性。 - 一般用于:实现与类相关的逻辑,如:操作类级别的信息、工厂方法等。
:::
from datetime import datetime

# 定义一个Person类
class Person:
    # 类属性
    max_age = 120
    planet = '地球'

    # 初始化方法(给实例添加属性)
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

    # speak方法、run方法,他们都属于:实例方法
    def speak(self, msg):
        print(f'我叫{self.name}, 年龄是{self.age}, 性别是{self.gender},我想说:{msg}')

    def run(self, distance):
        print(f'{self.name}疯狂的奔跑了{distance}米')

    # 使用 @classmethod 装饰过的方法,就叫:类方法,类方法保存在类身上的
    # 类方法收到的参数:当前类本身(cls)、自定义的参数
    # 因为收到了cls参数,所以类方法中是可以访问类属性的
    # 类方法通常用于实现:与类相关的逻辑,例如:操作类级别的信息、一些工厂方法
    @classmethod
    def change_planet(cls, value):
        cls.planet = value

    @classmethod
    def create(cls, info_str):
        # 从info_str中获取到有效信息
        name, year, gender = info_str.split('-')
        # 获取当前年份
        current_year = datetime.now().year
        # 计算年龄
        age = current_year - int(year)
        # 创建并返回一个Person类的实例对象
        return cls(name, age, gender)


# 验证一下:类方法保存在类身上的
# print(Person.__dict__)

# 类方法需要通过类调用
# Person.change_planet('月球')
# print(Person.__dict__)

# 创建Person实例
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')

# 验证一下:类属性planet已经修改了
# print(p1.planet)
# print(p2.planet)

# 测试一下类方法 —— create
# p3 = Person.create('李华-2003-女')
# print(p3.__dict__)

# 注意点:类方法,也能通过实例调用到,但是非常不推荐
p4 = p1.create('李华-2003-女')
print(p4.__dict__)
静态方法
定义:使用@staticmethod装饰器修饰,方法没有self或cls参数,只是单纯的定义在类中。
特点:
:::info
- 可通过『类名』或『实例名』调用,但强烈推荐****通过类名调用以体现语义。
- 由于没有
self或cls参数,所以静态方法中通常:不访问类属性,也不访问实例属性。 - 一般用于:定义与类相关,但可以独立使用的工具方法。
:::
# 定义一个Person类
class Person:
    # *******************************
    # *******************************
    # *******************************

    # 静态方法
    # 使用 @staticmethod 装饰过的方法,就叫:静态方法,静态方法也是保存在类身上的
    # 静态方法只是单纯的定义在类中,它不会收到:self、cls参数,它收到的参数都是自定义参数
    # 由于静态方法没有收到:self、cls参数,所以其内部不会访问任何:类和实例相关的内容
    # 静态方法通常用于定义:与类相关的工具方法
    @staticmethod
    def is_adult(year):
        # 获取当前的年份
        current_year = datetime.now().year
        # 计算年龄
        age = current_year - year
        # 返回结果(成年True,未成年False)
        return age >= 18

    @staticmethod
    def mask_idcard(idcard):
        return idcard[:6] + '********' + idcard[-4:]


# 验证一下:静态方法也是保存在类身上的
# print(Person.__dict__)

# 静态方法需要通过类去调用
# result = Person.is_adult(2015)
# print(result)
# result2 = Person.mask_idcard('212101198802030028')
# print(result2)

# 注意点:通过实例也能调用到静态方法,但非常不推荐
p1 = Person('张三', 18, '男')
res = p1.mask_idcard('212101198802030028')
print(res)
继承
基本语法
概念:是指一个类,可以继承另一个类的属性和方法。
作用:可以实现代码的复用与扩展,避免重复编写相同的代码,让程序结构更简洁、更高效。
举例:就像生活中,孩子可以继承父母的:长相、性格、财产等,程序中的继承与之类似。
代码实例:
如下代码中Person为父类(又称:基类)Student为子类(又称:派生类)
# 定义一个Person类
class Person:
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

    def speak(self, msg):
        print(f'我叫{self.name}, 年龄是{self.age}, 性别是{self.gender},我想说:{msg}')

# 定义一个Student类(子类、派生类), 继承自Person类(父类、超类、基类)
class Student(Person):
    def __init__(self, name, age, gender, stu_id, grade):
        # 在子类中,有两种方式去调用父类的初始化方法,来实现对继承属性:name, age, gender 初始化操作
        # 方式1(更推荐)
        super().__init__(name, age, gender)

        # 方式2
        # Person.__init__(self, name, age, gender)

        # 子类独有的属性,需要自己手动完成初始化
        self.stu_id = stu_id
        self.grade = grade

    def study(self):
        print(f'我叫{self.name},我在努力的学习,争取做到{self.grade}年级的第一名')

# 创建Student类的实例对象
s1 = Student('李华', 16, '男', '2025001', '初二')
# print(s1.__dict__)
# print(type(s1))

# 查找speak方法的过程:1.实例自身(s1) => 2.Student类 => 3.Person类
# s1.speak('你好')

# print(s1.__dict__)

# 查找study方法的过程:1.实例自身(s1) => 2.Student类 => 3.Person类
# s1.study()
几个说明:
:::info
- 定义类时,在类名后写圆括号
(),并填入另一个类名,表示该类继承自另一个类。 - 在子类中,可以直接使用父类中定义的:属性、方法,也可以定义自己独有的内容。
super().__init__()的作用:调用父类的初始化方法。
:::
方法重写
如果子类中定义了与父类同名的方法,则会子类会“覆盖”父类中的方法,又称:“重写”。
# 定义一个Person类
class Person:
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

    def speak(self, msg):
        print(f'我叫{self.name}, 年龄是{self.age}, 性别是{self.gender},我想说:{msg}')


# 定义一个Student类,继承自Person类
class Student(Person):
    def __init__(self, name, age, gender, stu_id, grade):
        super().__init__(name, age, gender)
        self.stu_id = stu_id
        self.grade = grade

    # 方法重写:当子类中定义了一个与父类中相同的方法,那么子类中的方法就会“覆盖”父类的方法
    def speak(self, msg):
        super().speak(msg)
        print(f'我是学生,我的学号是{self.stu_id},我正在读{self.grade},我想说:{msg}')

s1 = Student('李华', 12, '男', '2025001', '初二')
s1.speak('好好学习')
isinstance() 和 issubclass()
两个常用方法:
| 函数 | 作用 |
|---|---|
isinstance(obj, Class) |
判断对象是否为指定类或其子类的实例 |
issubclass(Sub, Super) |
判断一个类是否是另一个类的子类 |
# 定义一个Person类
class Person:
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender

# 定义一个Student类,继承自Person类
class Student(Person):
    def __init__(self, name, age, gender, stu_id, grade):
        super().__init__(name, age, gender)
        self.stu_id = stu_id
        self.grade = grade

p1 = Person('张三', 18, '男')
s1 = Student('李华', 12, '男', '2025001', '初二')

# 方法1:isinstance(instance, Class),作用:判断某个对象是否为指定类或其子类的实例
print(isinstance(s1, Student))
print(isinstance(p1, Person))
print(isinstance(s1, Person))
print(isinstance(p1, Student))

# 方法2:issubclass(Class1, Class2),作用:判断某个类是否是另一个类的子类
print(issubclass(Student, Person))
print(issubclass(Person, Student))
多重继承
概念:多重继承指一个类同时继承多个父类,从而拥有多个父类的属性和方法。
举例:就像孩子不仅继承爸爸的长相,还可能继承妈妈的性格。
class 子类名(父类A, 父类B, ...):
    # 子类可以继承多个父类的属性和方法
    ...
代码示例:如下代码中Student类同时继承Person类和Worker类。
# 所谓多重继承,就是一个类,可以同时继承多个父类
# 定义一个Person类
class Person:
    def __init__(self, name, age, gender):
        self.name = name
        self.age = age
        self.gender = gender
    def speak(self):
        print(f'我叫{self.name}, 年龄是{self.age}, 性别是{self.gender}')

# 定义一个Worker类
class Worker:
    def __init__(self, company):
        self.company = company
    def do_work(self):
        print(f'我在{self.company}做兼职')

# 定义一个Student类,继承自:Person类、Worker类
class Student(Person, Worker):
    def __init__(self, name, age, gender, stu_id, grade, company):
        Person.__init__(self, name, age, gender)
        Worker.__init__(self, company)
        self.stu_id = stu_id
        self.grade = grade
    def study(self):
        print(f'我在很努力的学习,争取做{self.grade}年级的第一名')

# 创建Student实例对象
s1 = Student('张三', 18, '男', '2025001', '初二', '麦当劳')
print(s1.__dict__)
s1.speak()
s1.do_work()
s1.study()

# 类的__mro__属性:用于记录属性和方法的查找顺序
# 通过实例去查找属性或方法时,会现在实例自身上寻找,如果没有,就按照__mro__中所记录的顺序去查找
print(Student.__mro__)
权限控制
三种访问权限
在 Python 中,我们可以给属性赋予三种权限,分别是:公有属性、受保护属性、私有属性。
下面是详细梳理👇
| 权限类型 | 定义方式 | 在当前类内部访问 | 在子类内部访问 | 在类外部访问 |
|---|---|---|---|---|
| 公有属性 | **属性名** |
✅ 能 | ✅ 能 | ✅ 能 |
| 受保护属性 | _**属性名** |
✅ 能 | ✅ 能 | ⚠️ 能(但不推荐) |
| 私有属性 | __**属性名** |
✅ 能 | ❌ 不能 | ❌ 不能 |
测试『类外部』访问:
class Person:
def __init__(self, name, age, idcard):
self.name = name # 公有属性:当前类内部、子类内部、类外部,可都可访问
self._age = age # 受保护属性:当前类内部、子类内部,可以访问
self.__idcard = idcard # 私有属性:仅能在当前类内部访问
def speak(self):
# 类的内部,可以访问任何权限的属性(公有属性、受保护属性、私有属性)。
print(f"我叫:{self.name},年龄:{self._age},身份证:{self.__idcard}")
class Student(Person):
def hello(self):
# 子类的内部可以访问:公有属性、受保护属性
print(f"我是学生,我叫:{self.name},年龄:{self._age}")
p1 = Person('张三', 18, '110101199001011234')
print(p1.name)
# 类的外部,仅能访问公有属性
# 注意:如果在类的外部,强制访问【受保护的属性】,也能访问,但最好别这么做
print(p1._age)
# 强制访问【私有属性】会报错
# print(p1.__idcard)
# 扩展:Python保护【私有属性】的方式,是重命名,例如:__idcard属性,会被重命名为:_Person__idcard
print(p1.__dict__)
print(p1._Person__idcard)
getter 与 setter
在面向对象编程中,我们会把一些内部数据保护起来,但同时还想提供一个“安全的通道”让外部访问。这时候我们就用到:
- getter:读取属性的方法
- setter:修改属性的方法
在 Python 中:通过@property和@xxx.setter语法,把普通方法变成像属性一样使用的方法。
class Person:
def __init__(self, name, age, idcard):
self.name = name # 公有属性:当前类内部、子类内部、类外部,可都可访问
self._age = age # 受保护属性:当前类内部、子类内部,可以访问
self.__idcard = idcard # 私有属性:仅能在当前类内部访问
# 注册 age 属性的 getter 方法:当访问 Person 实例的 age 属性时,age方法会自动调用
@property
def age(self):
return self._age
# 注册 age 属性的 setter 方法:当给 Person 实例的 age 属性赋值时,age方法会自动调用
@age.setter
def age(self, value):
if value <= 120:
self._age = value
else:
print('年龄非法,已将年龄变为最大值120')
self._age = 120
# 注册 idcard 属性的 getter 方法:当访问 Person 实例的 idcard 属性时,会自动调用此方法
@property
def idcard(self):
return self.__idcard[:6] + '********' + self.__idcard[-4:]
# 注册 idcard 属性的 setter 方法,当 idcard 被修改时调用,内部会禁止修改身份证号并给出提示。
@idcard.setter
def idcard(self, value):
print("抱歉,身份证号不允许随意修改,如有特殊需求,请联系管理员!")
p1 = Person('张三', 18, '110101199001011234')
print(p1.age)
print(p1.idcard)
# 测试修改age
p1._age = 19
print(p1.age)
# 测试修改idcard
p1.idcard = 'asd'
魔法方法
:::info
- 概念:以
**__xxx__**命名的特殊方法(双下划线开头和结尾)。 - 特点:不需要手动调,在特定场景由 Python 自动调用。
:::
几个常用的魔法方法:
| 方法 | 调用时机 |
|---|---|
1️⃣**__str__**** ** |
当调用 **print(对象)**或**str(对象)** 时 |
2️⃣**__len__**** ** |
当调用**len(对象)**时 |
3️⃣**__lt__**** ** |
当执行**对象1 < 对象2**时 |
4️⃣**__gt__**** ** |
当执行**对象1 > 对象2**时 |
5️⃣**__eq__**** ** |
当执行**对象1 == 对象2**时 |
6️⃣**__getattr__** |
当访问不存在的属性时 |
# 类中以双下划线开头和结尾的方法,叫魔法方法(魔术方法)。
# 魔法方法不需要手动调用,Python会在特定场景自动调用。
class Person:
def __init__(self, name, age, gender):
self.name = name
self.age = age
self.gender = gender
# __str__ 方法,执行时机:当调用 print(对象)或str(对象) 时
def __str__(self):
return f'姓名:{self.name}, 年龄:{self.age}, 性别:{self.gender}'
# __len__ 方法,执行时机:当调用len(对象)时
def __len__(self):
return len(self.__dict__)
# __lt__方法,执行时机:当执行 对象1 < 对象2 时
def __lt__(self, other):
return self.age < other.age
# __gt__方法,执行时机:当执行 对象1 > 对象2 时
def __gt__(self, other):
return self.age > other.age
# __eq__方法,执行时机:当执行 对象1 == 对象2 时
def __eq__(self, other):
return self.__dict__ == other.__dict__
# __getattr__方法,执行时机:当访问了对象不存在的属性时
def __getattr__(self, item):
print(f'您访问的{item}属性,不存在!')
# 创建Person实例
p1 = Person('张三', 18, '男')
p2 = Person('李四', 22, '女')
# 测试代码
print(p1)
print(str(p1))
print(len(p1))
print(p1 < p2)
print(p1 > p2)
print(p1 == p2)
print(p1.address)
object 类
object是所有类的最终祖先,所有的类,无论写与不写,都继承自object。object提供了所有对象都会有的一组最基本方法,例如:
| 方法名 | 作用简述 |
|---|---|
__init__(self) |
在对实例对象初始化时调用 |
__str__(self) |
print(obj)或 int(obj)时调用 |
__class__ |
返回对象所属的类 |
| ...... |
:::tips
备注:上述这些方法,如果我们不去重写,Python 会自动继承并使用默认版本。
:::
# Python 中,所有的类都继承了 object 类,即:object 类是所有类的顶层父类。
class Person:
def __init__(self, name, age, gender):
self.name = name
self.age = age
self.gender = gender
# 验证一下:所有的类都继承了 object 类
print(issubclass(Person, object))
print(issubclass(int, object))
print(issubclass(str, object))
print(issubclass(list, object))
print(issubclass(tuple, object))
print(issubclass(bool, object))
# 因为 object 是所有类的父类,所以 Python 中的所有对象,都间接是 object 类的实例。
p1 = Person('张三', 18, '男')
print(isinstance(p1, object))
print(isinstance(100, object))
print(isinstance('hello', object))
print(isinstance(True, object))
print(isinstance(None, object))
print(isinstance([10, 20, 30], object))
print(isinstance({'吃饭','睡觉'}, object))
# 所有对象都继承了 object 类所提供的:各种属性和方法,从而保证每个对象都具备统一的基本能力。
for key in object.__dict__:
print(key)
p1 = Person('张三', 18, '男')
print(p1.__dict__) # 打印对象自己身上的东西
print(dir(p1)) # 打印对象能访问到的东西
print(p1.__str__())
print(p1)
多态
何为多态
多态就是“多种形态”,即:不同的对象调使用同一个方法名调用方法时,会表现出不同的行为。
标准多态
:::info
- ****基于继承实现多态,又叫:『传统多态』或『标准多态』。
- 常见于
Java、C++这样的强类型语言中,Python支持『标准多态』。
:::
# 多态是指:同一个方法名,在不同的对象上调用时,能呈现出不同的行为。
# Python中支持:标准多态、鸭子多态
# 标准多态:
class Animal:
def speak(self):
print('动物正在发出声音')
class Dog(Animal):
def speak(self):
print('汪汪汪!')
class Cat(Animal):
def speak(self):
print('喵喵喵!')
# 注意Pig类没有继承Animal类
class Pig:
def speak(self):
print('哼哼哼!')
# make_sound函数要求:传入的对象,必须是 Animal 类型(或其子类型),才能保证可以调用到sepak方法
def make_sound(animal:Animal):
animal.speak()
# 创建实例对象
a1 = Animal()
d1 = Dog()
c1 = Cat()
# 多态的体现:同一函数,不同对象 → 不同行为
make_sound(a1) # 动物正在发出声音
make_sound(d1) # 汪汪汪!
make_sound(c1) # 喵喵喵!
# 按标准多态规则:Pig 没有继承 Animal,类型不匹配(会出现类型警告)
p1 = Pig()
make_sound(p1) # 在其它语言中会报错,虽然 Python 中能运行,但这不属于标准多态
鸭子多态
鸭子类型:如果一个东西看起来像鸭子,叫起来也像鸭子,那它就是鸭子,鸭子类型指一种编程风格,它并不依靠查找对象类型,来确定其是否具有正确的实现,而是直接调用或使用其方法或属性。
官方文档地址:https://docs.python.org/zh-cn/3.13/glossary.html#term-duck-typing
:::info
- 特点:不需要继承,只要传进来的对象,有对应实现就可以。
- Python 中支持“鸭子多态”。
:::
# 核心理念:如果一个东西看起来像鸭子,叫起来也像鸭子,那它就是鸭子。
# 鸭子类型是一种编程风格,它不检查对象的类型,只关注对象能否“做某件事”(是否有对应的方法)。
class Dog:
def speak(self):
print('汪汪汪!')
class Cat:
def speak(self):
print('喵喵喵!')
class Pig:
def speak(self):
print('哼哼哼!')
class Fish:
def speak(self):
print('咕噜噜!')
# 不再对animal的类型做限制,animal可以是任何类型,只要能调用speak方法就可以
def make_sound(animal):
animal.speak()
# 创建实例对象
d1 = Dog()
c1 = Cat()
p1 = Pig()
f1 = Fish()
make_sound(d1)
make_sound(c1)
make_sound(p1)
make_sound(f1)
抽象类
- 概念:抽象类(Abstract Class) 是一种 不能被直接实例化 的类,通常作为“规范”,让子类去继承并实现其中定义的抽象方法,本身只定义规范,不需要提供完整实现。
- 例如:动物会叫、飞行器会飞、支付方式会支付。
from abc import ABC, abstractmethod
#【抽象类】是一种不能直接实例化的类,它通常作为“规范”,让子类去继承,并实现其中定义的【抽象方法】。
# MustRun类一旦继承了ABC类,那MustRun类就是【抽象类】了
class MustRun(ABC):
# run方法一旦被@abstractmethod装饰后,就变成了【抽象方法】
@abstractmethod
def run(self):
pass
class Person(MustRun):
def __init__(self, name, age, gender):
self.name = name
self.age = age
self.gender = gender
def run(self):
print(f'我叫{self.name},我在努力的奔跑!')
p1 = Person('张三', 18, '男')
p1.run()
小练习
完成一个学生成绩管理小案例
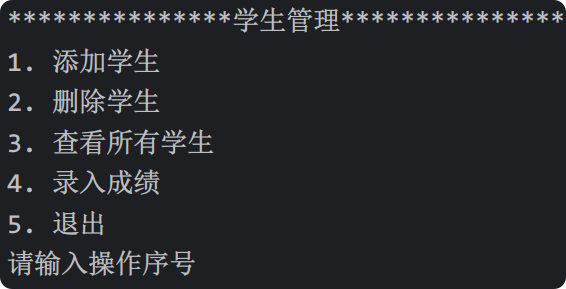
具体代码如下:
from datetime import datetime
# 定义Person类
class Person:
def __init__(self, name, age, gender):
self.name = name
self.age = age
self.gender = gender
class Student(Person):
# 计数器
count = 0
def __init__(self, name, age, gender):
super().__init__(name, age, gender)
Student.count += 1
# 给每个学生添加stu_id属性,格式为:年份-序号,序号靠计数器增长。
self.stu_id = f'{datetime.now().year}{Student.count:03d}'
# 给学生添加成绩,格式为: {'数学':90, '语文':80, '英语':70}
self.scores = {}
# 给当前学生添加成绩
def add_score(self, subject, score):
# 给指定学生添加成绩,subject是学科,score是成绩
self.scores[subject] = score
# 计算平均分
def calcu_avg(self):
if self.scores:
# 计算平均成绩
return sum(self.scores.values()) / len(self.scores)
else:
return 0
# 魔法方法
def __str__(self):
return f'{self.name}({self.age}-{self.gender}),成绩:{self.scores},平均分:{self.calcu_avg():.1f}'
class Manager:
def __init__(self):
self.stu_list = []
# 添加学生
def add_student(self):
name = input('请输入姓名:')
age = int(input('请输入年龄:'))
gender = input('请输入性别:')
# 创建学生实例对象
stu = Student(name, age, gender)
# 将当前学生添加到stu_list列表中
self.stu_list.append(stu)
print(f'添加成功!学号是:{stu.stu_id}')
# 删除学生
def del_student(self):
sid = input('请输入学号:')
# target用于保存要删除的学生
target = None
# 遍历所有学生,找到要删除的学生,并交给target变量
for stu in self.stu_list:
if stu.stu_id == sid:
target = stu
# 如果找到了要删除的学生,就调用remove方法移除该学生
if target:
self.stu_list.remove(target)
print('删除成功!')
# 如果未找到要删除的学生
else:
print('学号有误,删除失败!')
# 展示所有学生
def show_all_student(self):
# 如果当前stu_list中有学生,就遍历展示
if self.stu_list:
for stu in self.stu_list:
print(stu)
# 如果当前stu_list中没有学生,就打印:暂无学生!
else:
print('暂无学生!')
# 给指定学生设置成绩
def set_score(self):
sid = input('请输入学号:')
# 遍历stu_list列表
for stu in self.stu_list:
# 如果当前学生学号,与输入的sid相等
if stu.stu_id == sid:
# 输入成绩字符串,格式为:学科-分数,学科-分数
score_str = input('清输入成绩(学科-分数,学科-分数)')
# 将输入的多个成绩,按照逗号拆分,形成成绩列表
score_list = score_str.replace(',', ',').split(',')
# 循环成绩列表,依次添加成绩
for item in score_list:
# 获取科目与成绩
subject, score = item.split('-')
subject = subject.strip()
score = float(score.strip())
# 调用add_score方法,添加科目,成绩
stu.add_score(subject, score)
print('添加成功!')
# 结束循环,同时结束set_score函数
return
# 若程序能执行到此处,证明在stu_list中没有找到与sid对应的学生
print('学号有误!')
# 提供主菜单
def run(self):
while True:
print('************学生管理************')
print('1. 添加学生')
print('2. 删除学生')
print('3. 查看所有学生')
print('4. 录入成绩')
print('5. 退出')
chocie = input('请输入操作编号:')
if chocie == '1':
self.add_student()
elif chocie == '2':
self.del_student()
elif chocie == '3':
self.show_all_student()
elif chocie == '4':
self.set_score()
elif chocie == '5':
print('再见!')
break
else:
print('输入有误!')
m1 = Manager()
m1.run()
内存分析
内存分为两个部分:栈内存、堆内存;变量在栈内存中,对象在堆内存中。
备注:强烈建议各位参考视频教程学习本小节
1️⃣Python 中变量里保存的不是存数据,而是指向堆中对象的引用(内存地址)。
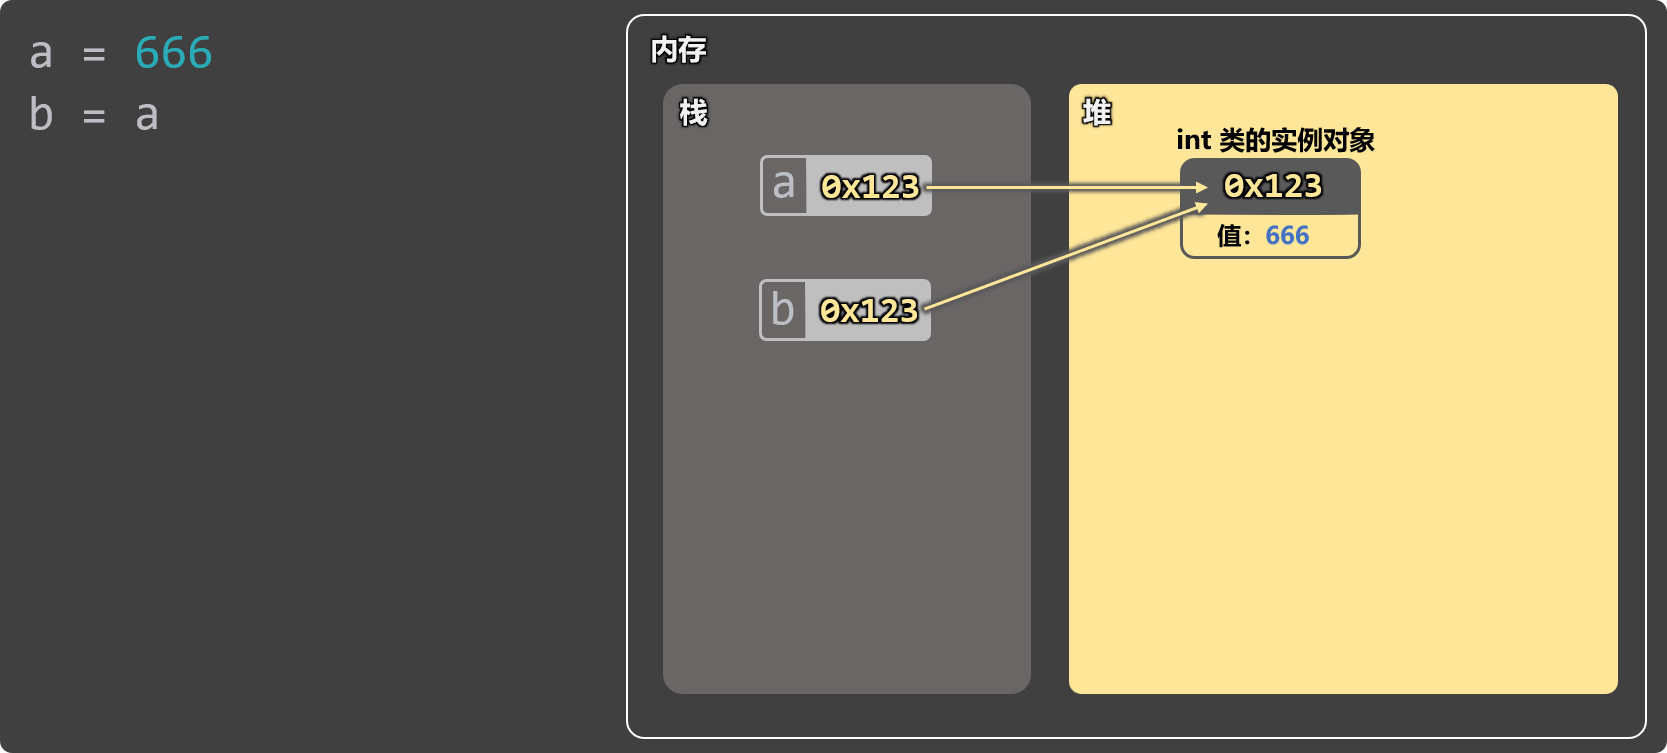
2️⃣不可变对象:重新赋值会创建新对象
int 类的实例对象,是不可变对象,所以修改变量 a 时,会创建新对象,不会影响其他引用(b)
Python 中常见的不可变对象有:int 、float 、bool 、str 、tuple 、frozenset 、None。
Python 中常见的可变对象有:list 、dict 、set 、自定义类的实例对象。
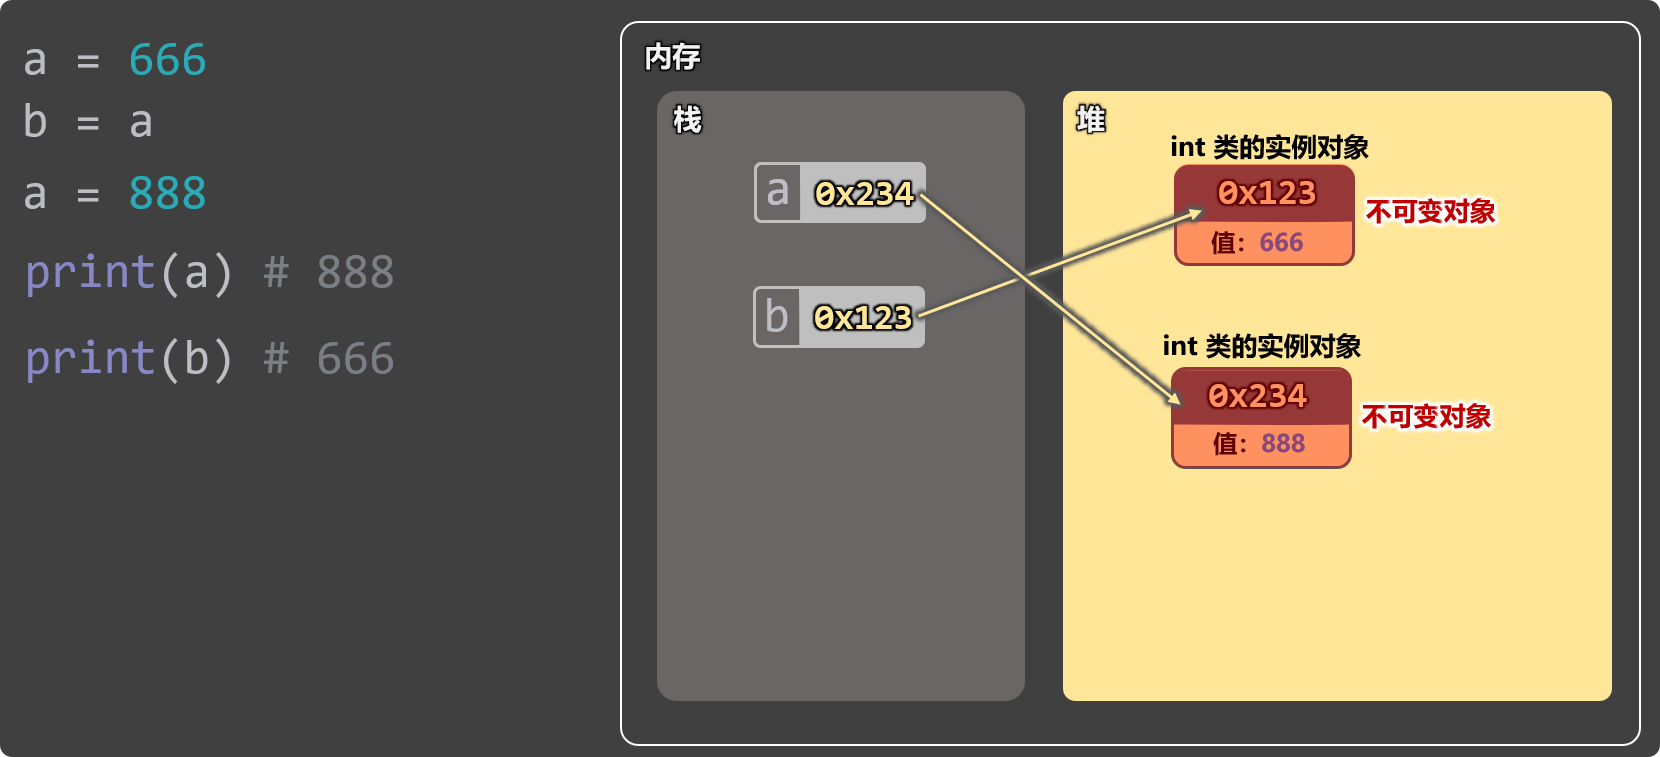
3️⃣ 可变对象:修改内容不改变地址
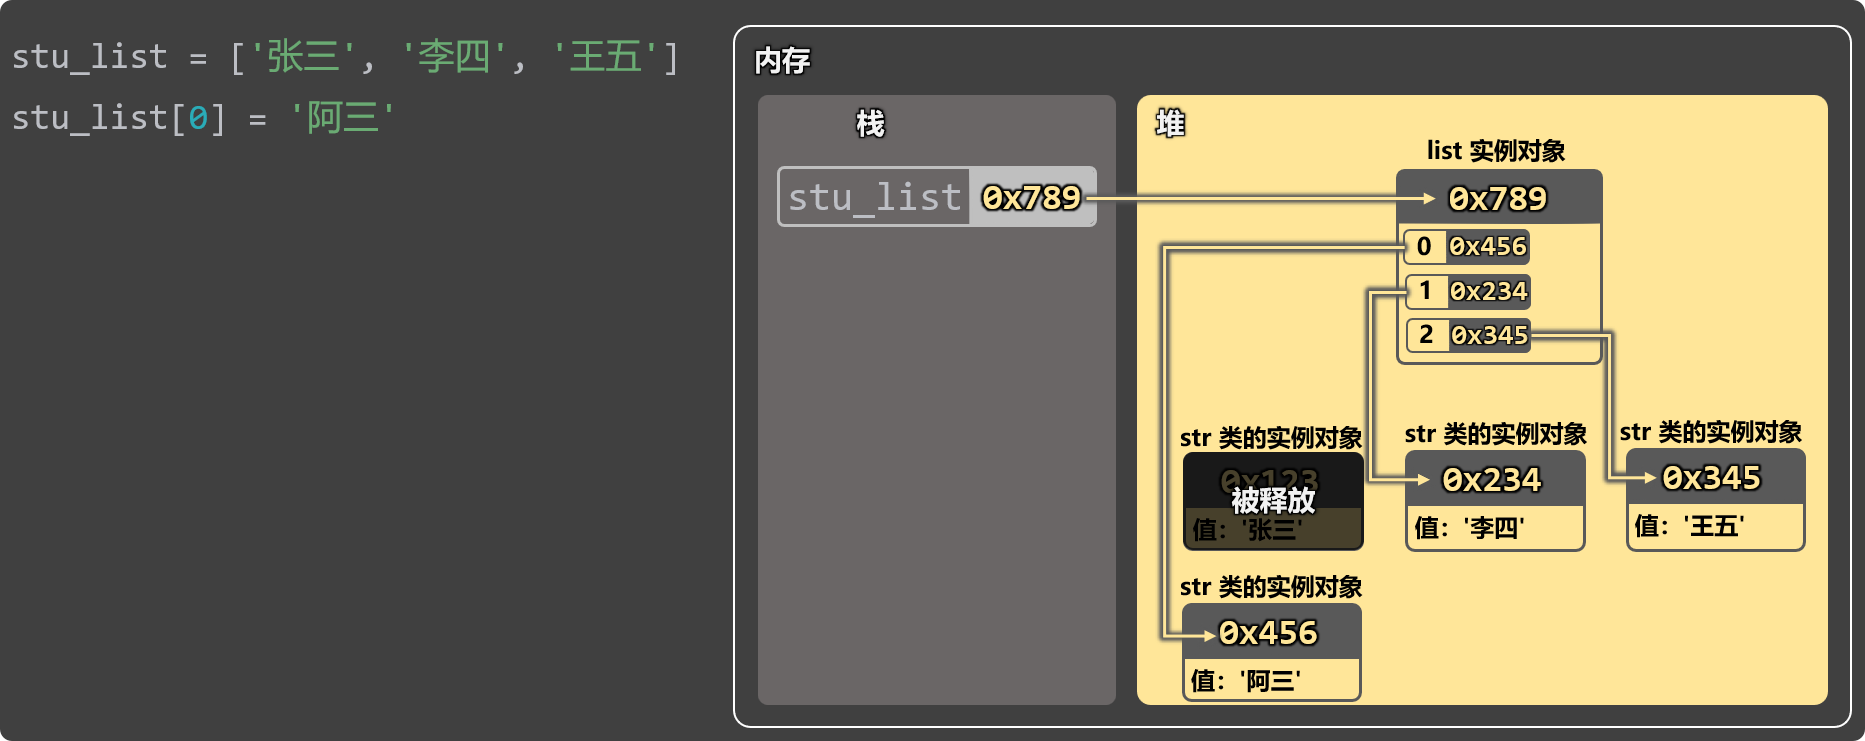
4️⃣自定义类对象的内存表示
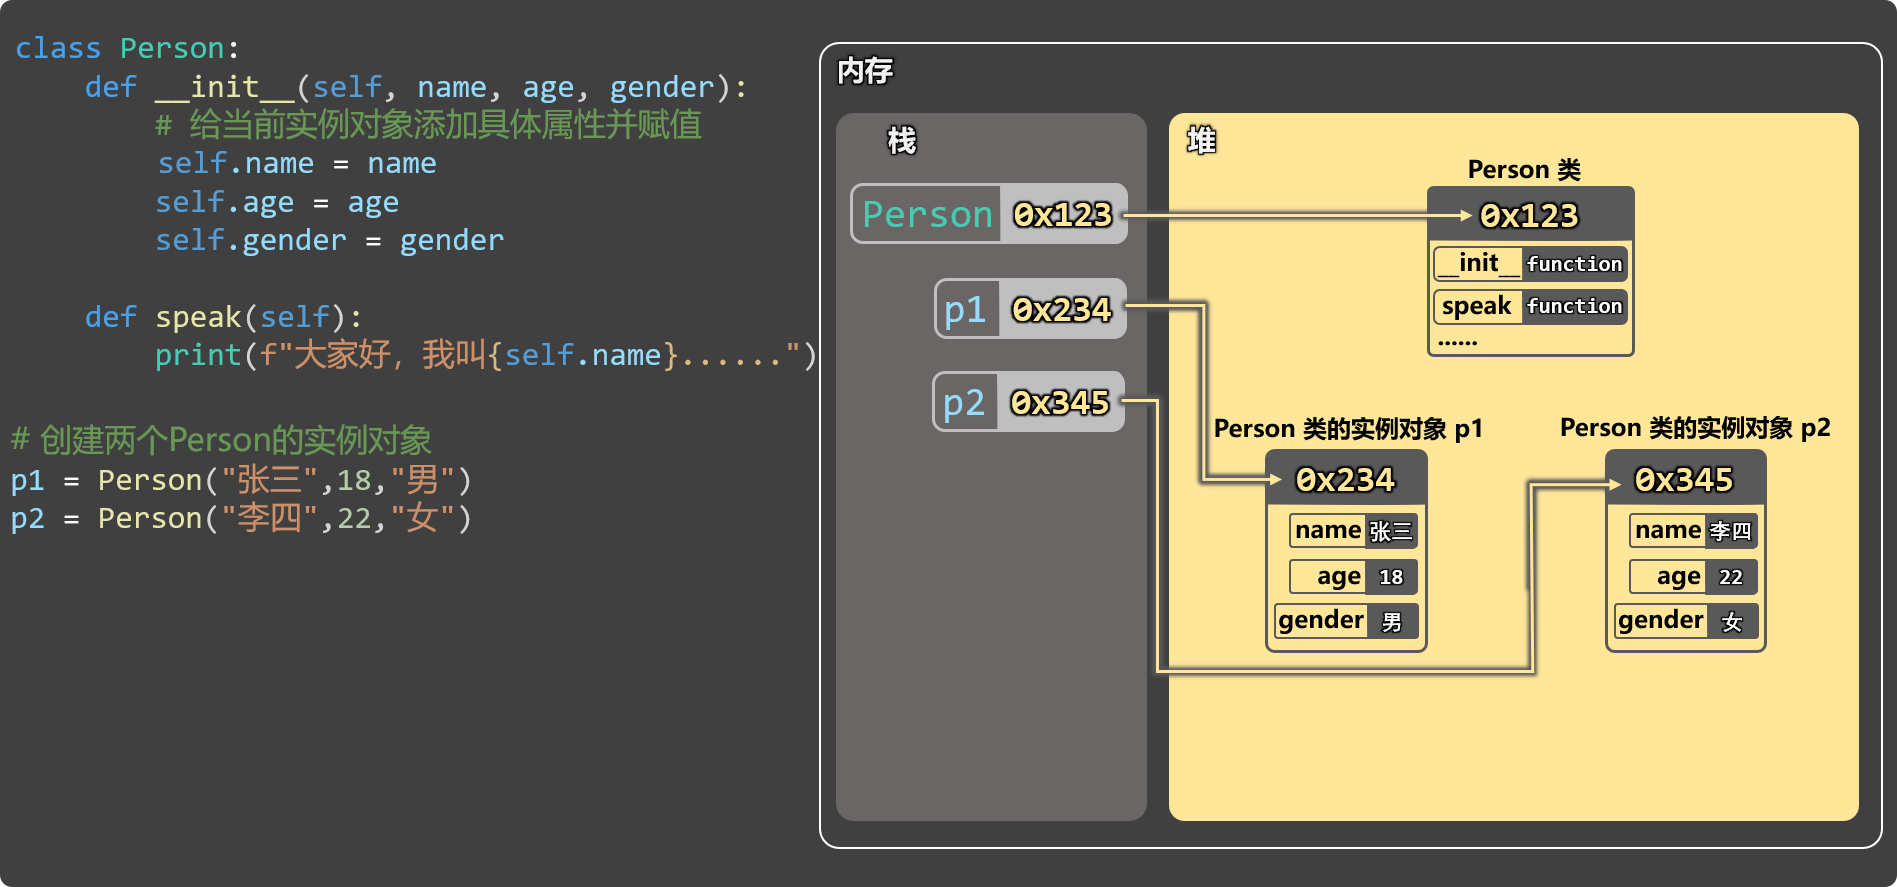
⬇️进阶篇⬇️
第 8 章 函数进阶
重新认识函数
1️⃣函数也是对象。
a1 = 100 # a1是int类的实例对象 a2 = 'hello' # a2是str类的实例对象 a3 = [10, 20, 30] # a3是list类的实例对象welcome函数是function类的实例对象
def welcome():
print('你好啊')
print(type(a1))
print(type(a2))
print(type(a3))
print(type(welcome))
上述代码中welcome函数的内存示意图:
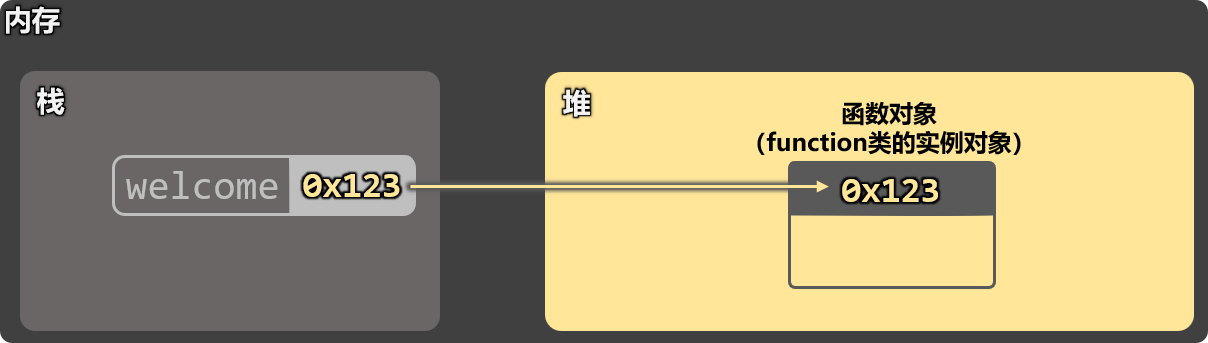
2️⃣函数可以像对象一样,动态添加属性。
def welcome(): print("你好")动态添加属性
welcome.desc = "这是一个用于打招呼的函数"
welcome.version = 1.0
print(welcome.dict)调用函数
welcome()
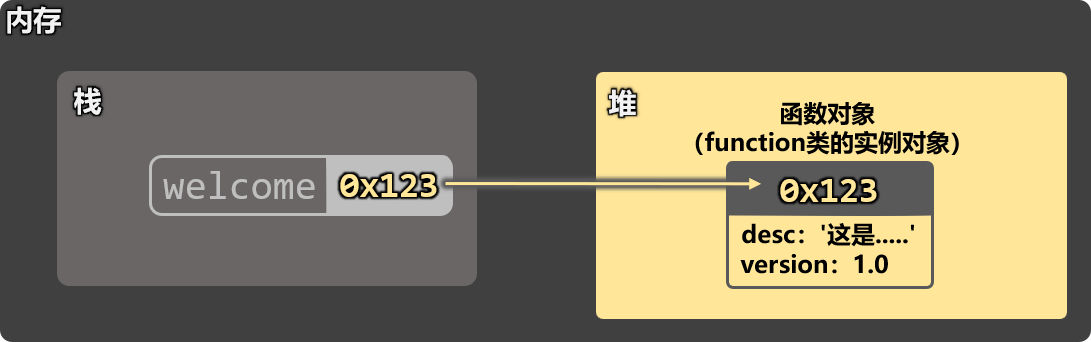
3️⃣函数可以赋值给变量。
def welcome(): print('你好啊!')把函数对象赋值给变量
say_hello = welcome
通过变量调用函数
say_hello()
通过函数名调用函数
welcome()
上述代码的内存结构示意图:
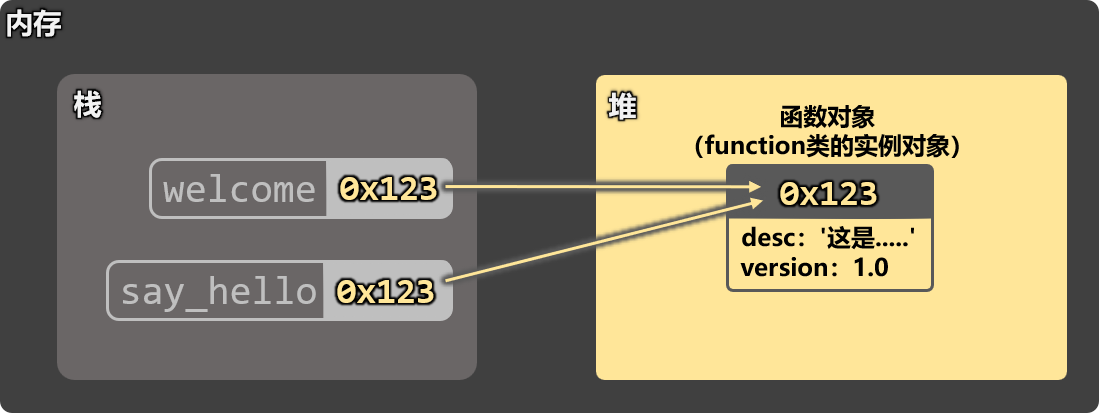
4️⃣可变参数 vs 不可变参数
def welcome(data): print(f'函数收到的data是:{data},地址是:{id(data)}') data = 888 print(f'被修改后的data是:{data},地址是:{id(data)}')
a = 666
print(f'函数外侧a的值是:{a},地址是:{id(a)}')
welcome(a)
print(f'函数调用后a的值是:{a},地址是:{id(a)}')
def welcome(data):
print(f'函数收到的data是:{data},地址是:{id(data)}')
data[2] = 99
print(f'被修改后的data是:{data},地址是:{id(data)}')
a = [10, 20, 30]
print(f'函数外侧a的值是:{a},地址是:{id(a)}')
welcome(a)
print(f'函数调用后a的值是:{a},地址是:{id(a)}')
5️⃣函数也可以作为参数
def welcome(): print('你好啊!')def caller(f):
print('caller函数开始调用')
f()
caller(welcome)
6️⃣函数也可以作为返回值
def welcome(): print('你好啊') def show_msg(msg): print(msg) return show_msgresult = welcome()
result('尚硅谷')
welcome()('尚硅谷')
函数的多返回值
在return关键字后面写多个值,并且多个值之间用逗号隔开,Python 会自动把多个值打包成元组。
def calculate(x, y):
res1 = x + y
res2 = x - y
return res1, res2 # 实际返回的是:(res1, res2)
result = calculate(10, 20)
r1, r2 = calculate(10, 20)
print(result) # (30, -10)
print(r1) # 30
print(r2) # -10
参数的打包与解包
定义函数时,打包接收参数:
*形参名:打包所有的位置参数(会形成一个元组)。**形参名:打包所有的关键字参数(会形成一个字典)。
调用函数时,解包传递参数:
*变量名:将元组拆解成一个一个独立的位置参数。**变量名:将字典拆解一个一个key=value形式的关键字参数。
# 打包接收参数:
# *args :打包所有的位置参数(会形成一个元组)
# **kwargs :打包所有的关键字参数(会形成一个字典)
def show_info(*args, **kwargs):
print(args)
print(kwargs)
nums = (10, 20, 30)
person = {'name': '张三', 'age': 18}
# 解包传递参数:
# *nums :将元组拆解成一个一个独立的位置参数
# **person :将字典拆解一个一个 key=value 形式的关键字参数
show_info(*nums, **person)
高阶函数
当一个函数的『参数是函数』或者『返回值是函数』那该函数就是『高阶函数』。
def welcome():
print('你好啊!')
# caller函数的参数是函数,所以caller是高阶函数
def caller(f):
print('call函数开始调用')
f()
caller(welcome)
# outer函数的返回值是函数,所以outer函数是高阶函数
def outer():
print('我是outer')
def inner():
print('我是inner')
return inner
高阶函数的意义:
:::info
- 代码复用性高:可以把行为“独立出去”,传入不同函数实现不同逻辑。
- 能让函数更灵活,更通用。
- 高阶函数是:装饰器、闭包的基础。(后面会讲)
:::
def info(msg):
return '[提示]' + msg
def warn(msg):
return '[警告]' + msg
def error(msg):
return '[错误]' + msg
def log(fun, text):
print(fun(text))
log(info, '文件保存成功!')
log(warn, '磁盘空间不足!')
log(error, '该用户不存在!')
条件表达式
表达式:执行后最终能得到一个值的代码,就是表达式,例如这些都是表达式:
3 + 5
'abc' * 3
5 > 3
'y' in 'Python'
len('hello')表达式最终会形成一个值,可以写在任何一个需要值的地方。
条件表达式: 根据不同的条件,得到不同的值,又称:三元表达式,也叫:三目运算符。
1️⃣语法格式为:
结果1 if 条件 else 结果2具体规则: 如果条件为真,整个表达式的结果就是“结果1”,否则就是“结果2”。
2️⃣代码示例:
age = 20传统if-else写法
if age >= 18:
text = '成年'
else:
text = '未成年'条件表达式写法
text = '成年' if age >= 18 else '未成年·'
print(text)
3️⃣ 什么时候适合用条件表达式? —— 简单的二选一场景,可以让代码更紧凑。
rain = True
food = '外卖' if rain else '出去吃'is_vip = True
disscount = 0.8 if is_vip else 1.0
is_login = True
msg = '欢迎回来!' if is_login else '请先登录!'
匿名函数
- 概念:所谓『匿名函数』,就是没有名字的函数,它无需使用
def关键字去定义。 - 语法:Python 中使用
lambda关键字来定义『匿名函数』,格式为:**lambda 参数: 表达式** - 使用场景: 当一个函数只用一次、只做一点点小事,使用匿名函数会更简洁。
# 使用普通函数实现计算效果
def add(x, y):
return x + y
def sub(x, y):
return x - y
def calculate(func, a, b):
print(f'计算结果为:{func(a, b)}')
calculate(add, 30, 10)
calculate(sub, 30, 10)
# 使用匿名函数实现计算效果
def calculate(func, a, b):
print(f'计算结果为:{func(a, b)}')
calculate(lambda x, y: x + y, 30, 10)
calculate(lambda x, y: x - y, 30, 10)
- 特点:
:::info
- 只能写一行,不能写多行代码。
- 不能写代码块(if、for、while)
- 冒号右边必须是表达式,且只能写一个表达式。
- 执行结果自动作为返回值。
:::
is_adult = lambda age: '成年' if age >= 18 else '未成年'
print(is_adult(18))
print(is_adult(13))
几个数据处理函数
map 函数
map函数:对一组数据中的每一个元素,统一执行某种操作(加工),并生成一组新数据。- 语法格式:
map(操作函数, 可迭代对象)
# 统一数据处理
nums = [10, 20, 30, 40]
# map函数的返回值是一个迭代器对象,需要我们自己去手动遍历,或者手动类型转换
result = map(lambda x: x * 2, nums)
print(list(result))
print(nums)
# 字符串转换
names = ('python', 'java', 'js')
result = map(lambda x: x.upper(), names)
print(tuple(result))
print(names)
# 类型转换
str_number = {'1', '2', '3'}
result = map(int, str_number)
print(set(result))
print(str_number)
# 注意点:
# 1.延迟执行:map 不会立刻计算,只有在“需要结果”时才执行计算。
# 2.返回的是迭代器对象,且一旦遍历完成,就会被“耗尽”。
# 3.map不会影响元素数量。
nums = [10, 20, 30, 40]
result = list(map(lambda x: x * 2, nums))
print(result)
print(result)
print(result)
print(result)
filter 函数
filter函数:从一组数据中,筛选出符合条件的元素(过滤),并组成一组新数据。- 语法格式:
filter(过滤函数, 可迭代对象)
# 筛选数值
nums = [10, 20, 30, 40, 50]
result = filter(lambda n: n > 30, nums)
print(list(result))
print(nums)
# 筛选成年人
persons = [
{'name':'张三', 'age':15, 'gender':'男'},
{'name':'李四', 'age':16, 'gender':'女'},
{'name':'王五', 'age':17, 'gender':'男'},
{'name':'李华', 'age':18, 'gender':'女'},
{'name':'赵六', 'age':19, 'gender':'女'},
{'name':'孙七', 'age':20, 'gender':'男'}
]
result = filter(lambda p: p['age'] >= 18, persons)
print(list(result))
# 过滤一下非法字符串
names = ['张三', '', '李四', None, '王五']
result = filter(lambda n: n, names)
print(list(result))
# 注意点
# 1.延迟执行:filter不会立刻筛选,只有在“需要结果”时才执行。
# 2.返回的是迭代器对象,且一旦遍历完成就会被“耗尽”。
# 3.filter可能会影响元素数量。
# filter函数的特殊用法:如果不传递过滤函数,那么自动会过滤掉“假值”
data = [0, 1, '', 'hello', [], (), 5]
result = filter(None, data)
print(list(result))
sorted 函数
sorted函数:对一组数据进行排序,返回一组新数据。- 语法格式:
sorted(可迭代对象, key=xxx, reverse=xxx)
# 数字排序
nums = [30, 40, 20, 10]
result = sorted(nums, reverse=True)
print(result)
# 按照字符串的长度去排序
names = ['python', 'sql', 'java']
result = sorted(names, key=len, reverse=True)
print(result)
# 根据字典中的某个字段进行排序
persons = [
{'name':'张三', 'age':15, 'gender':'男'},
{'name':'李四', 'age':17, 'gender':'女'},
{'name':'王五', 'age':19, 'gender':'男'},
{'name':'李华', 'age':20, 'gender':'女'},
{'name':'赵六', 'age':18, 'gender':'女'},
{'name':'孙七', 'age':16, 'gender':'男'}
]
result = sorted(persons, key=lambda p: p['age'], reverse=True)
print(result)
# 我们之前讲的max函数、min函数,也可以传递key参数,用于设置筛选依据
result1 = max(persons, key=lambda p: p['age'])
result2 = min(persons, key=lambda p: p['age'])
print(result1)
print(result2)
reduce 函数
reduce函数:将一组数据不断“合并”,最终归并成一个结果。- 语法格式:
reduce(合并函数, 可迭代对象, 初始值)。
:::tips
备注:<font style="color:#585A5A;">reduce</font>函数需要从<font style="color:#585A5A;">functools</font>模块中引入才能使用。
:::
# 从 functools 模块中引入 reduce
from functools import reduce
# 数值统计
nums = [1, 2, 3, 4, 5]
result = reduce(lambda a, b: a + b, nums, 10)
print(result)
# 字符串拼接
str_list = ['ab', 'cd', 'ef']
result = reduce(lambda a, b: a + b, str_list)
print(result)
列表推导式
- 概念:用一条简洁语句,从可迭代对象中,生成新列表的语法结构。
- 语法格式:
[ 表达式 for 变量 in 可迭代对象 ]
# 需求:让nums列表中所有的元素,都变为原来的2倍
# 方式一:用map函数
nums = [10, 20, 30, 40]
result = list(map(lambda n: n * 2, nums))
print(result)
# 方式二:使用for循环结合append方法
nums = [10, 20, 30, 40]
result = []
for n in nums:
result.append(n * 2)
print(result)
# 方式三:使用列表推导式(列表推导式就是上面 for + append 的简写形式)
nums = [10, 20, 30, 40]
result = [n * 2 for n in nums]
print(result)
# 带条件的列表推导式
nums = [10, 20, 30, 40]
result = [n * 2 for n in nums if n > 20]
print(result)
# 字典推导式
names = ['张三', '李四', '王五']
scores = [60, 70, 80]
result = {names[i]: scores[i] for i in range(len(names))}
print(result)
# 集合推导式
names = ['张三', '李四', '王五']
result = {n + '!' for n in names}
print(result)
names = ['张三', '李四', '王五']
# 注意:Python中没有元组推导式,下面这种写法叫:生成器(后面会仔细讲)
result = (n + '!' for n in names)
print(result)
常用内置函数梳理
以下函数是截至目前,我们需要掌握的一些常用函数,注意:下面这些并不是所有,我们后面还会学习到更多的常用内置函数。(详细讲解请参考视频教程)
输入与输出
| 函数 / 参数 | 功能说明 |
|---|---|
print |
输出指定内容 |
objects |
要输出的内容 |
sep |
输出多个内容时的分隔符 |
end |
结尾追加的内容 |
file |
输出位置(默认控制台) |
flush |
是否立即刷新输出 |
input() |
获取用户输入 |
类型转换
| 函数 | 功能说明 |
|---|---|
int() |
转为整数 |
float() |
转为浮点数 |
str() |
转为字符串 |
bool() |
转为布尔值 |
list() |
转为列表 |
tuple() |
转为元组 |
set() |
转为集合 |
dict() |
转为字典 |
数学相关
| 函数 | 功能说明 |
|---|---|
abs() |
取绝对值 |
round() |
银行家舍入法:小于5舍,大于5入,等于5看奇偶(奇入偶舍) |
pow(a, b) |
计算 a 的 b 次方 |
pow(a, b, c) |
计算 a 的 b 次方后,再对 c 取模 |
divmod(a, b) |
返回 (商, 余数) |
max() |
最大值(支持 key) |
min() |
最小值(支持 key) |
sum() |
求和 |
map() |
加工一组数据 |
filter() |
按条件过滤数据 |
reduce() |
合并计算(需 functools.reduce) |
sorted() |
排序(支持 key) |
数据容器相关
| 函数 | 功能说明 |
|---|---|
len() |
获取容器中元素个数 |
range() |
生成数字序列(常用于循环) |
enumerate() |
为序列添加索引 |
zip() |
将多个序列一一配对 |
类型判断与对象相关
| 函数 | 功能说明 |
|---|---|
type() |
查看对象类型 |
isinstance(obj, type) |
判断对象是否属于某个类型 |
issubclass(A, B) |
判断类 A 是否为类 B 的子类 |
id() |
查看对象的内存地址 |
逻辑判断相关
| 函数 | 功能说明 |
|---|---|
all() |
所有元素为真时返回 True |
any() |
至少一个为真返回 True |
字符串辅助相关
| 函数 | 功能说明 |
|---|---|
ord() |
获取字符的 Unicode 编码值 |
chr() |
将 Unicode 编码值转换为字符 |
浅拷贝 vs 深拷贝
为什么要拷贝?
:::tips
- 赋值语句:
b = a,只是让b指向和a一样的对象。 - 如果
a和b指向的是一个可变对象,那通过b修改后,再通过a访问到的数据也是变化后的。
:::
直接赋值
在如下代码中:nums2 = nums1 不是复制!是两个变量指向同一个列表,并且修改任何一个,都会影响另一个。
nums1 = [10, 20, 30, 40]
nums2 = nums1
nums2[3] = 99
print(nums1[3]) # 99
print(nums2[3]) # 99
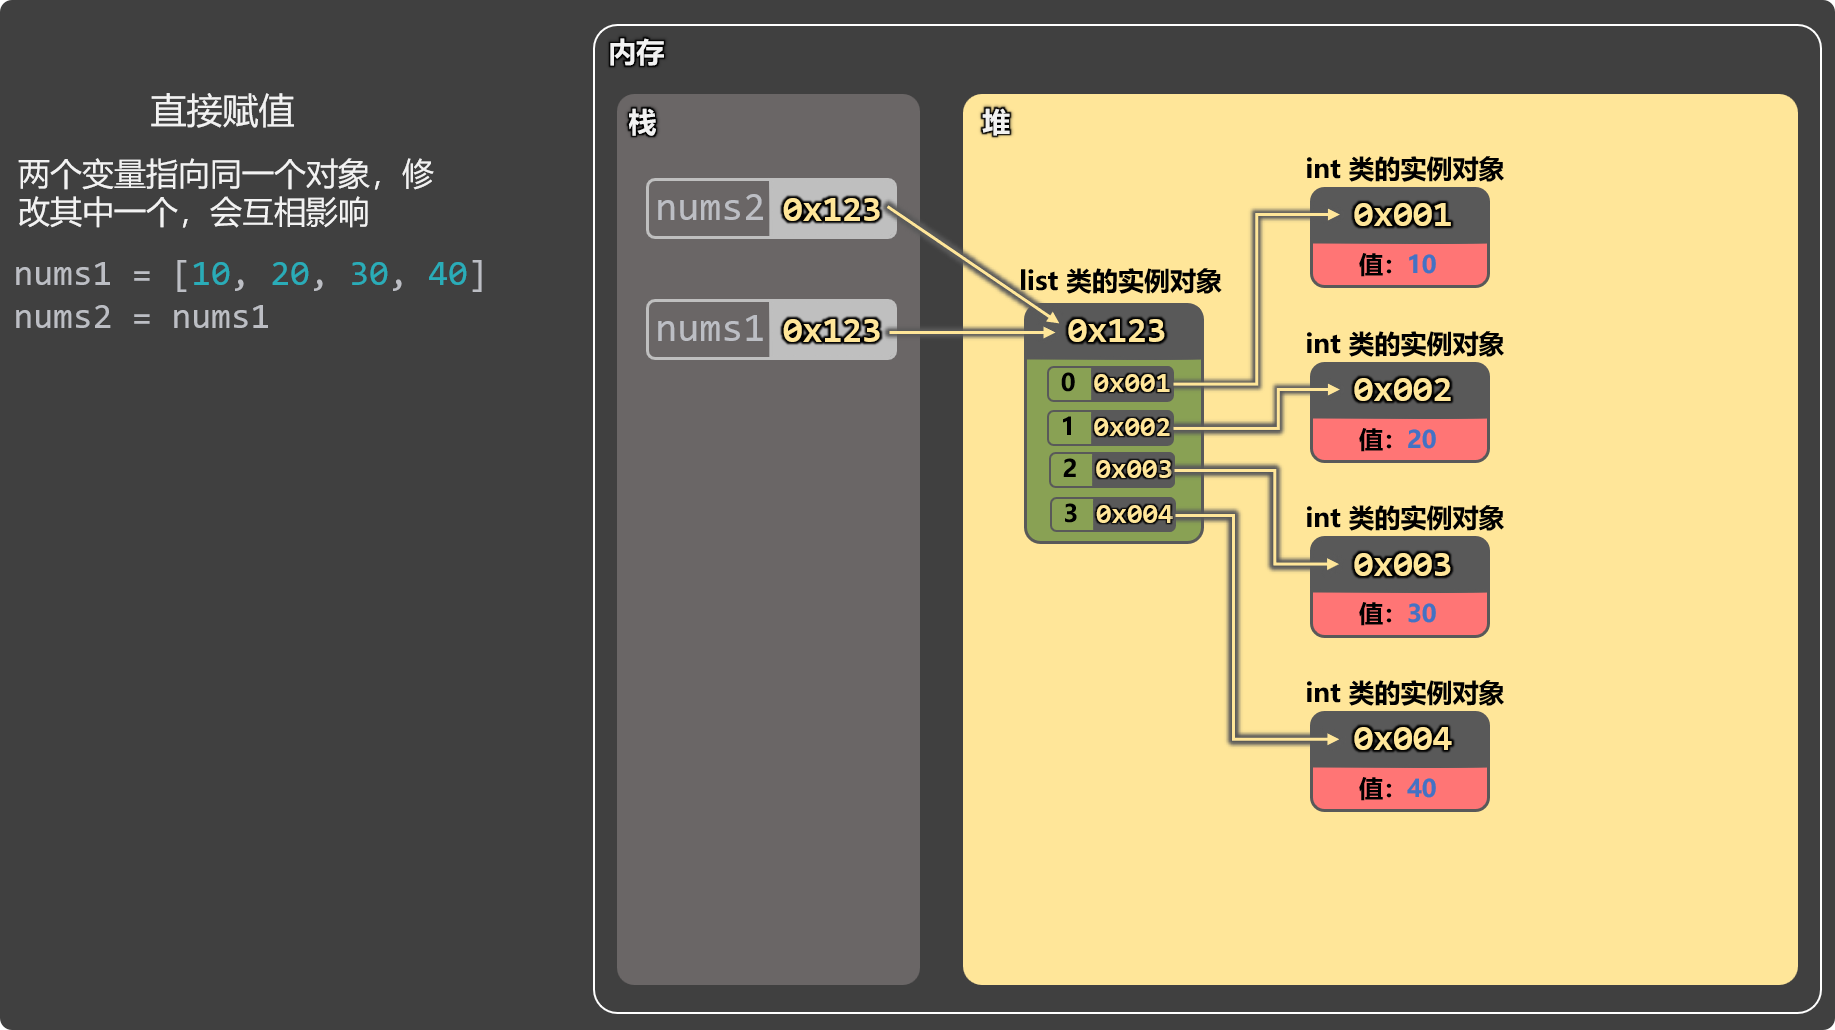
浅拷贝
浅拷贝会创建一个新的外层容器,但内部的元素仍然引用原来的对象。
import copy
nums1 = [10, 20, 30, 40]
nums2 = copy.copy(nums1)
nums2[3] = 99
print(nums1[3]) # 40
print(nums2[3]) # 99
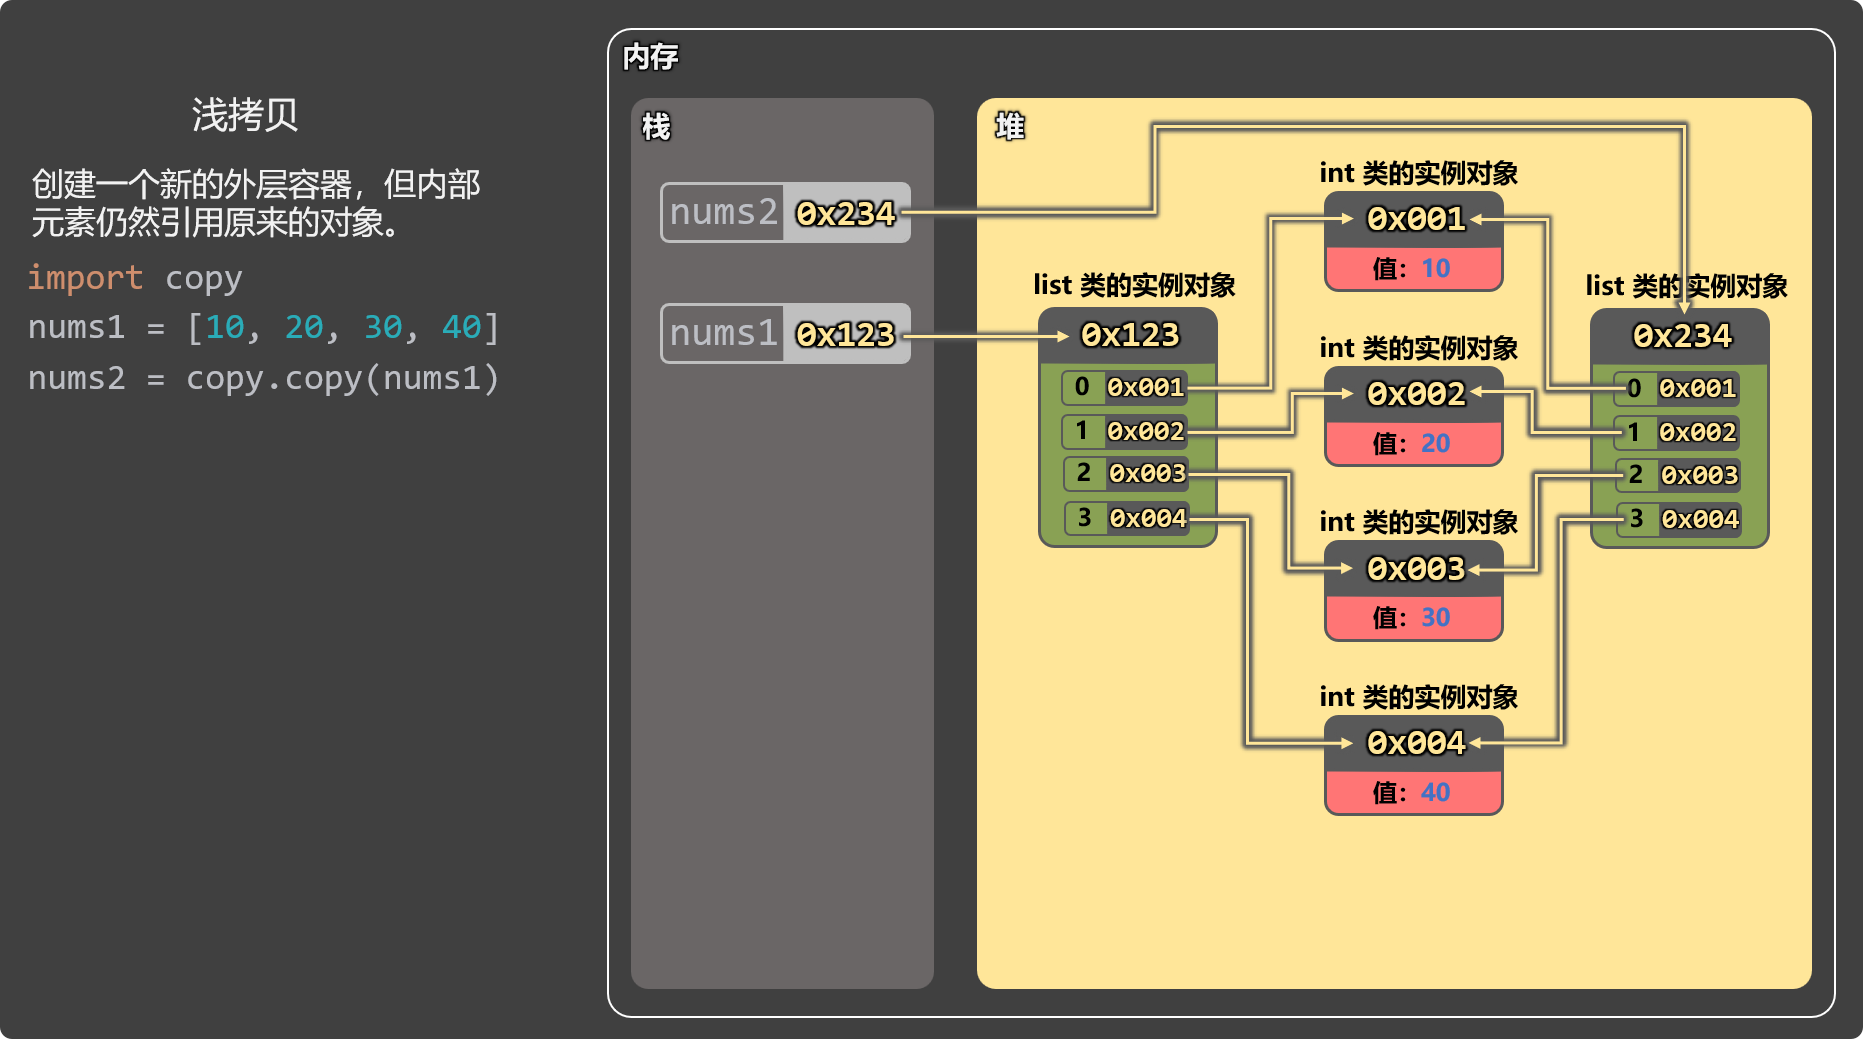
浅拷贝存在的问题:嵌套数据仍然是共享的,修改嵌套数据会互相影响
import copy
nums1 = [10, 20, 30, [40, 50]]
nums2 = copy.copy(nums1)
nums2[3][0] = 99
print(nums1[3][0])
print(nums2[3][0])
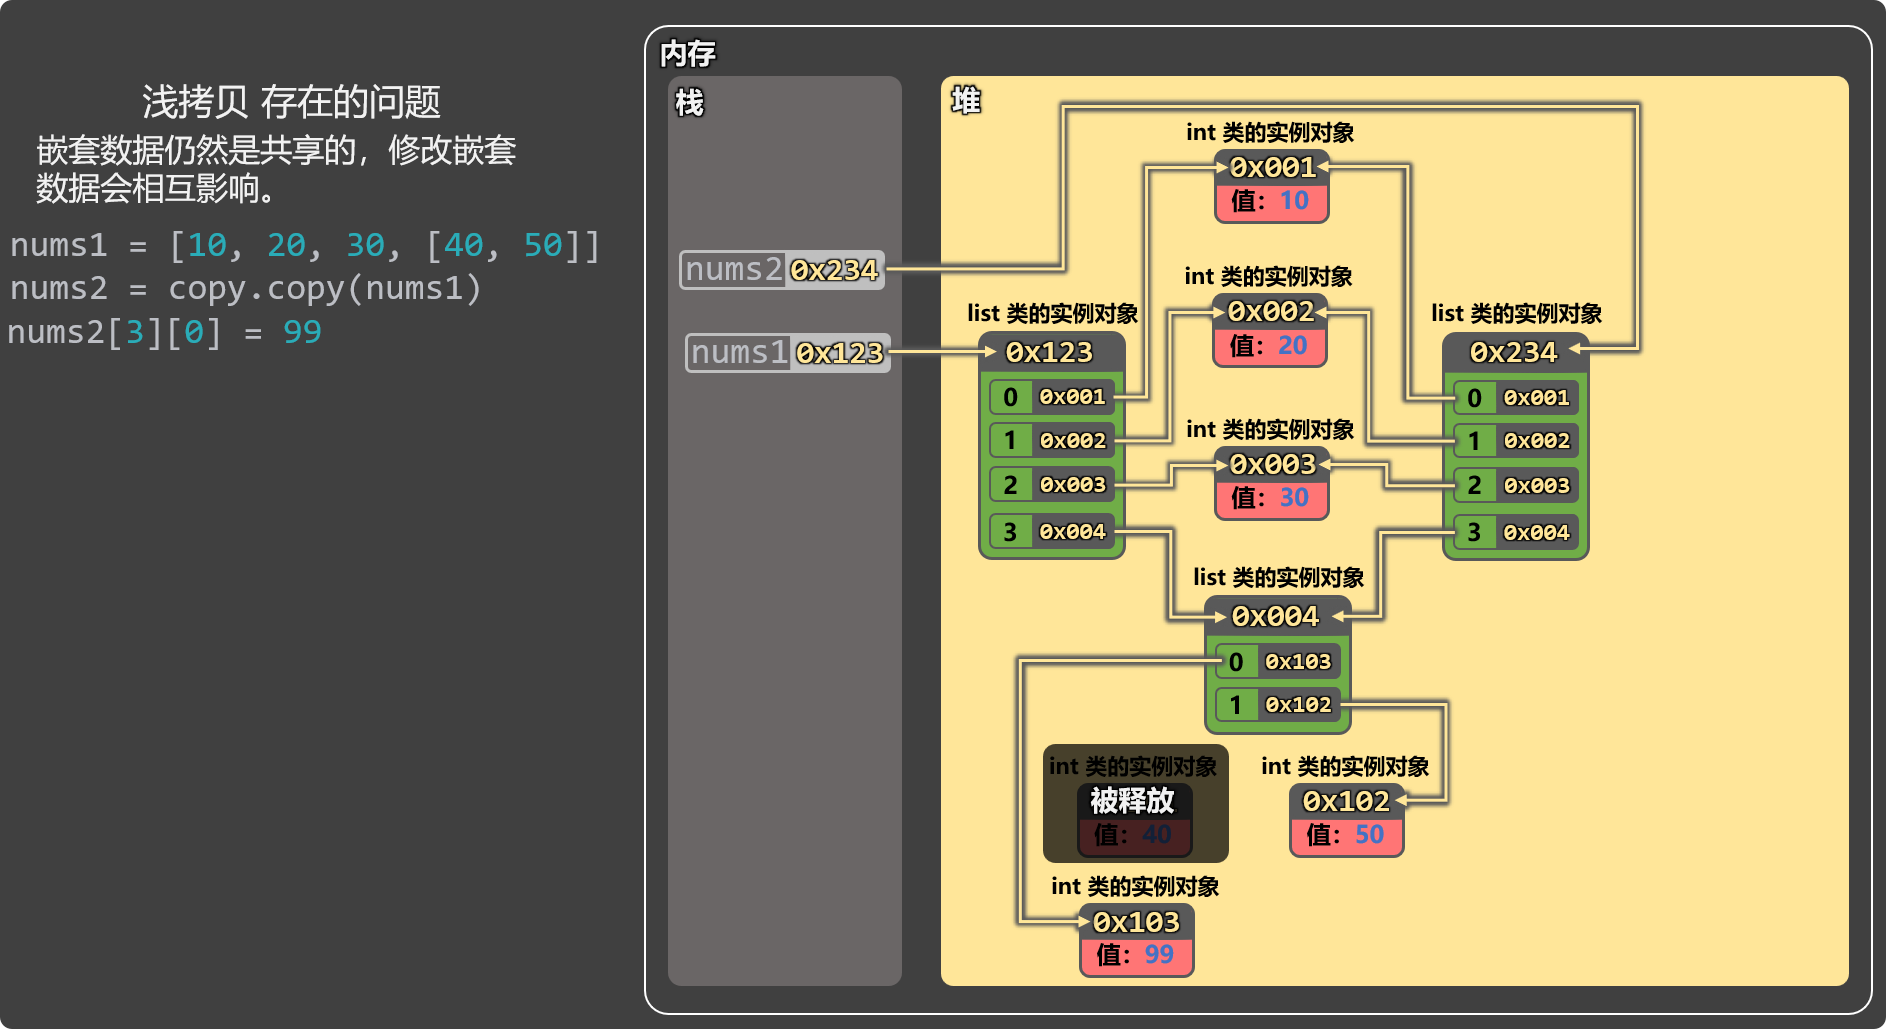
深拷贝
创建一个新的外层容器,同时对内部所有【可变对象】进行递归复制(不可变对象不复制,继续引用)。
import copy
nums1 = [10, 20, 30, [40, 50]]
nums2 = copy.deepcopy(nums1)
nums2[3][0] = 99
print(nums1[3][0])
print(nums2[3][0])
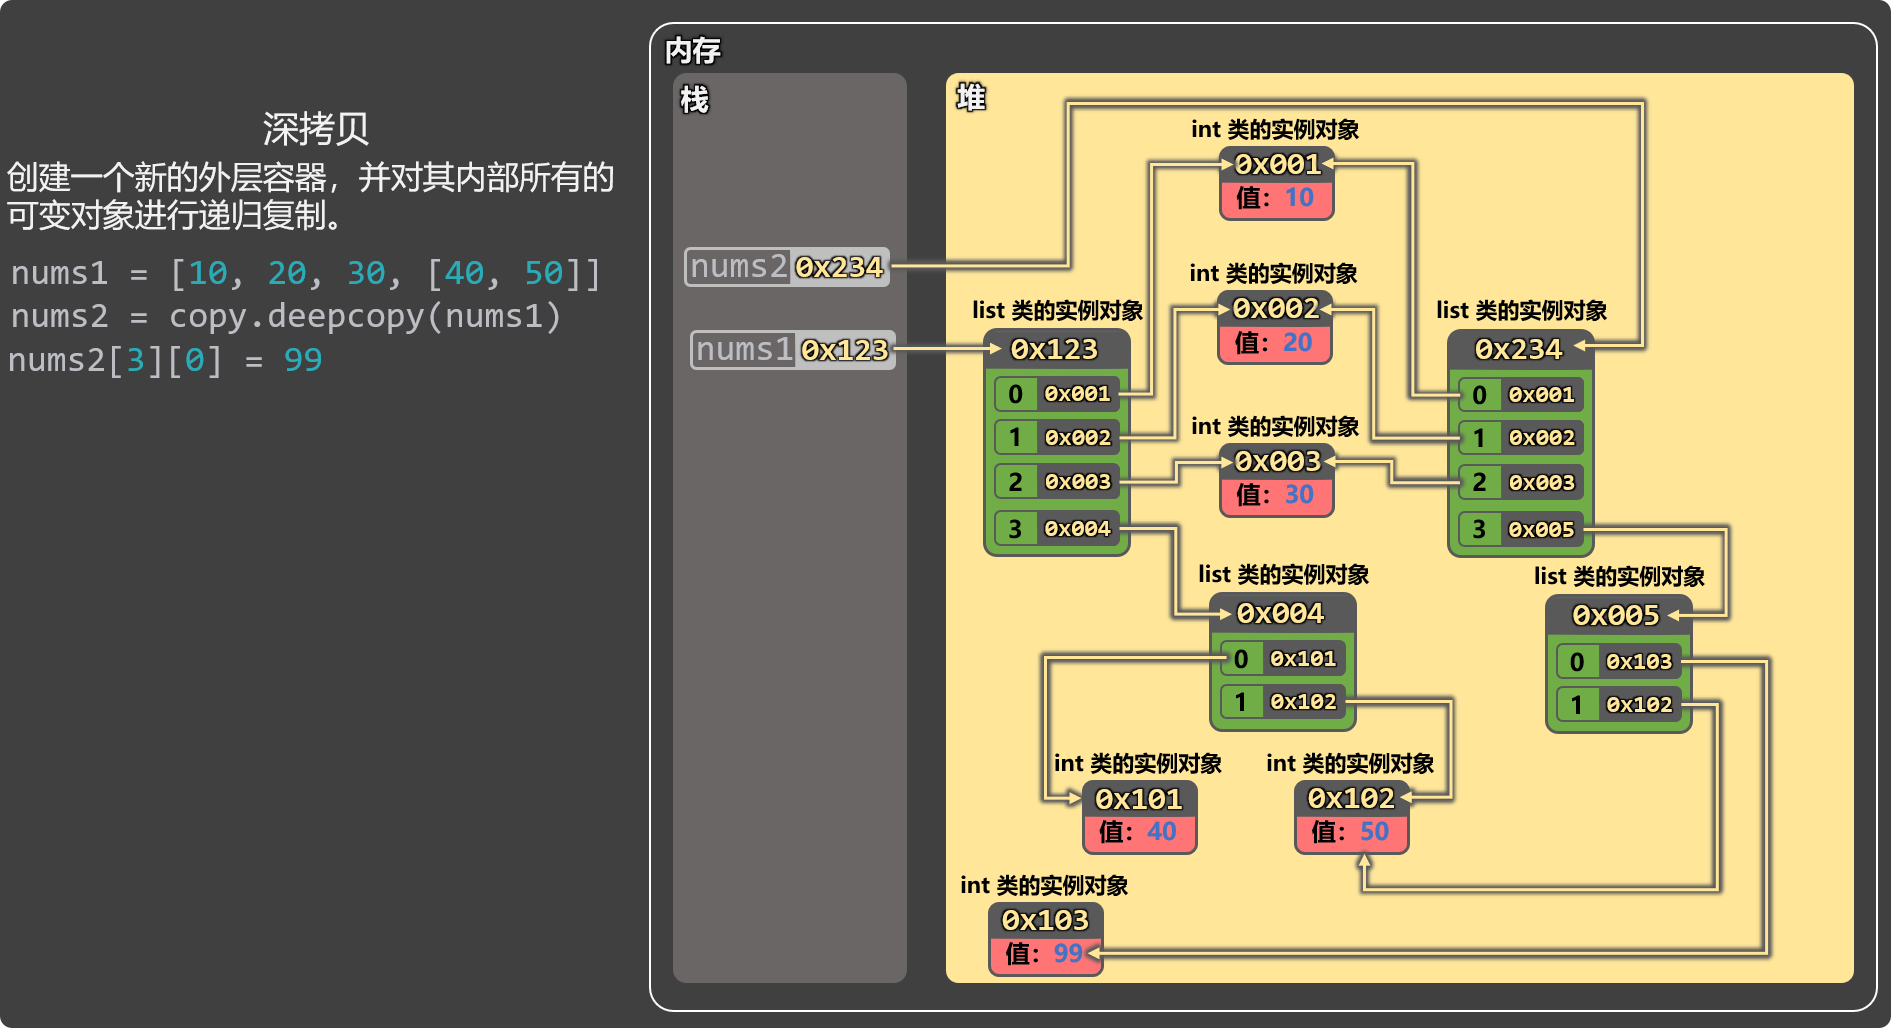
特点:
:::tips
- 深拷贝可以彻底消除数据之间的相互影响。
- 深拷贝遇到【不可变对象】不会复制,会直接引用。
:::
注意点:
:::tips
- 深拷贝只复制可变对象,不可变对象会直接引用。
- 元组中如果只包含不可变对象,则深拷贝没有效果。
:::
import copy
a = 666
# a是不可变对象,即便调用deepcopy也不会深拷贝,会直接引用
b = copy.deepcopy(a)
print(id(a))
print(id(b))
import copy
nums1 = (10, 20, 30, [40, 50])
# nums1元组中只包含不可变对象,即便调用deepcopy也不会深拷贝
nums2 = copy.deepcopy(nums1)
print(id(nums1))
print(id(nums2))
四种作用域
Python 中有四种作用域,分别是:
:::info
- Local(局部作用域)
- Enclosing(外层作用域)
- Global(全局作用域)
- Built-in(内建作用域)
:::
当访问一个变量时,Python 会按以下顺序查找: Local => Enclosing => Global => Built-in
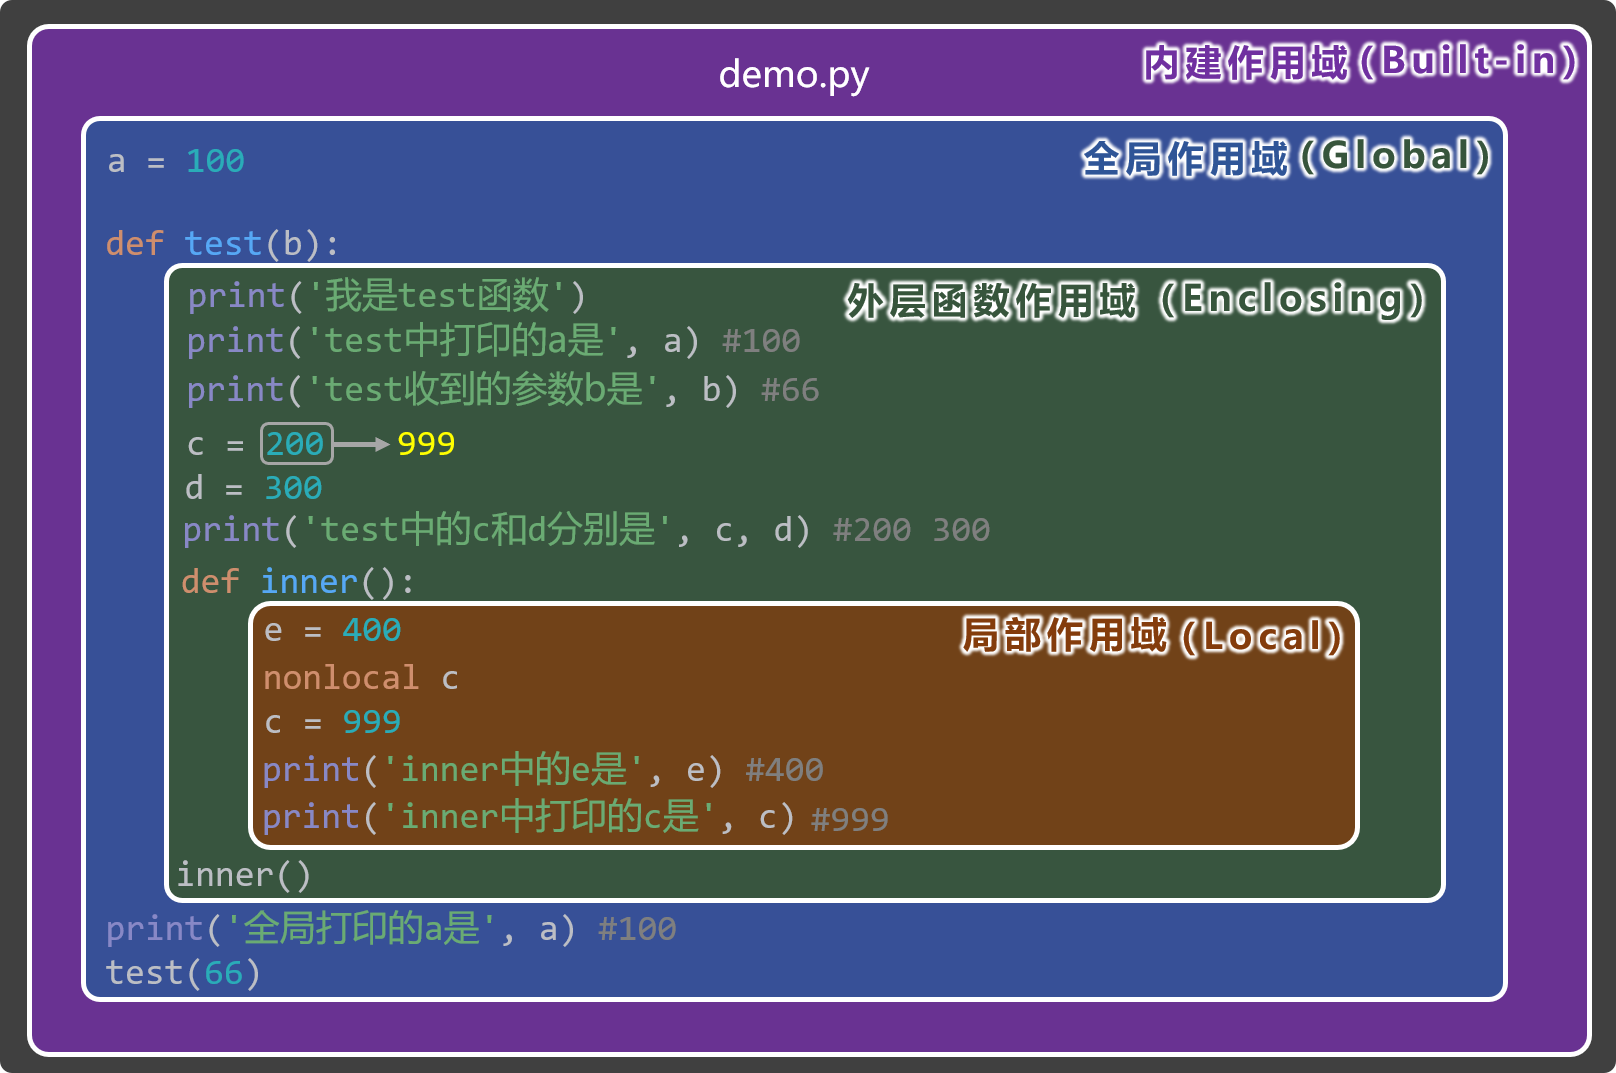
:::color4
上述图示的详细分析,请参考视频教程。
:::
局部作用域(Local)
定义:函数的内部就是局部作用域,局部作用域中的变量,只在该函数内部可见。
特点:
- 每次调用函数都会创建一个新的局部作用域。
- 函数运行结束后,局部作用域会随之销毁。
- 局部作用域优先级最高,即:查找一个变量时,Python 会首先在局部作用域中查找。
举例:
def test():
x = 10 # x 在局部作用域
print(x) # 可以访问
print(x) # ❌ 报错:x 在局部之外不可见
外层作用域(Enclosing)
定义:如果函数中又定义了函数,那么外层函数的作用域,就是内层函数的 Enclosing 作用域。
特点:
- 只有当函数“嵌套定义”时才会出现。
- 内层函数可以读取外层函数变量。
- 想修改外层变量必须使用
nonlocal。
举例:
def outer():
y = 20 # outer 的局部变量 → inner 的 Enclosing 变量
def inner():
print(y) # 内层函数读取外层变量
inner()
修改外层变量:
def outer():
y = 20
def inner():
nonlocal y
y = 99 # 修改外层函数作用域变量
全局作用域(Global)
定义:.py文件就是全局作用域,全局作用域中的变量,在当前.py文件的任何位置都可以访问。
特点:
- 全局变量只在当前
.py文件中可见。 - 函数内部可以使用
global关键字修改全局变量。
例子:
a = 100 # 全局变量
def test():
print(a) # 可以读取
test()
print(a) # 在本文件任何位置都可以访问
如果要修改:
a = 100
def test():
global a
a = 200 # 修改全局变量
内建作用域(Built-in)
定义:Python 预先定义好的东西,会放在内建作用域中,所有.py文件都可以直接使用。
特点:
- 所有
.py文件都能直接使用其中的名称。 - 例如:
print、len、range、sum、max等。 - 查找优先级最低,即:查找一个变量时,内建作用域是“最后一道防线”。
例子:
print('hello')
len([1, 2, 3])
闭包
前置知识
前置知识 1: 局部作用域的生命周期。
- 每次调用函数时,都会创建一个新的局部作用域。
- 函数执行完毕后,该作用域就会被销毁,其中的局部变量,也会随之释放。
def outer():
num = 10
num += 1
print(num)
outer() #11
outer() #11
outer() #11
在上述代码中:每次调用
outer(),num都会重新生成,不会保存上一次的值。
前置知识 2:内层函数访问外层变量。
- 【内层函数】可以访问到【外层函数】作用域中的变量。
- 访问外层变量不用
nonlocal,修改外层变量时要使用nonlocal。
def outer():
num = 10
def inner():
print(num)
inner()
outer()
如下代码验证了:理论上num变量应该在outer函数调用完销毁,但实际并没有。
def outer():
num = 10
def inner():
print(num)
return inner
f = outer()
f()
什么是闭包
- 闭包 = 内层函数 + 被内层函数引用的外层变量。
- 产生闭包的三个条件如下:
:::info
- 必须有函数嵌套
- 内层函数使用了外层函数的变量
- 外层函数返回内层函数
:::
闭包的基本形式
在上述代码的基础上,我们在inner函数中不仅要打印num,还要去修改num(修改时记得加上nonlocal num)。最终发现:num的值居然还可以一直增加,所以截至目前,证明了一件事:本应该随着outer函数调用结束而死去的num,并没有死去,并且inner函数依然可以对num进行读取和修改。所以我们观察如下的代码形式,完全符合上述的闭包产生条件,所以此时就出现了闭包。
def outer():
num = 10
def inner():
nonlocal num
num += 1
print(num)
return inner
f = outer()
f() # 11
f() # 12
f() # 13
闭包是如何保存外层变量的?
外层变量会被保存到 闭包单元(cell)中,例如下面代码中,那些被 inner函数所使用到的outer函数中的局部变量,会被封存在闭包单元(cell) 中,这些cell组成一个 __closure__ 元组,保存在了inner函数上。
def outer():
num = 10
print(id(num)) # 140707460170952
def inner():
nonlocal num
num += 1
print(num)
return inner
f = outer()
print(f.__closure__) # __closure__的值是一个元组,元组中保存着被inner函数所“挽救”下来的数据
print(f.__closure__[0].cell_contents) # 10
print(id(f.__closure__[0].cell_contents)) # 140707460170952
思考:内层函数inner会保存外层函数outer中所有的数据吗? 不会,只会保存inner中所用到的。
def outer():
num = 10
msg = '你好啊!'
print(msg)
def inner():
nonlocal num
num += 1
print(num)
return inner
f = outer()
print(f.__closure__) # 发现__closure__中只有num,没有msg
注意点
- 每次获得一个新闭包,互不影响(闭包之间是互相独立的)。
def outer():
num = 10
def inner():
nonlocal num
num += 1
print(num)
return inner
f1 = outer()
f1()
f1()
f1()
print('*****************')
f2 = outer()
f2()
- 外层变量为可变对象时仍互不影响。
def outer():
nums = []
def inner(value):
nums.append(value)
print(nums)
return inner
# 每次调用 outer() 都创建一个新的 nums
f1 = outer()
f1(10)
f1(20)
f1(30)
print('**********************')
f2 = outer()
f2(666)
闭包的优点
- 可以“记住”状态:不用全局变量,也不用写类,就能在多次调用之间保存数据。
- 可以做“配置过的函数”:先传一部分参数,把环境固定住,得到一个定制版函数。
- 可以实现简单的“数据隐藏”:外层变量对外不可见,只能通过内层函数访问。
- 是装饰器(decorator)等高级用法的基础。
小案例:使用闭包实现对文字的美化效果。
def beauty(char, n):
def show_msg(msg):
print(char * n + msg + char * n)
return show_msg
show1 = beauty('*', 3)
show1('你好啊')
show1('尚硅谷')
show2 = beauty('@', 5)
show2('你好啊')
show2('尚硅谷')
闭包的缺点
- 理解成本较高:对初学者不太友好,滥用会让代码难读。
- 如果闭包里引用了很大的对象,又长期不释放,可能会增加内存占用。
- 很多场景下,其实用【类 + 实例属性】会更清晰,闭包不一定是最优解。
例如将上述的文字美化效果,用类实现:
class Beauty:
def __init__(self, char, n):
self.char = char
self.n = n
def show_msg(self, msg):
print(self.char * self.n + msg + self.char * self.n)
b1 = Beauty('*', 3)
b1.show_msg('你好啊')
b1.show_msg('尚硅谷')
b2 = Beauty('#', 5)
b2.show_msg('你好啊')
b2.show_msg('尚硅谷')
装饰器
- 概述:装饰器是一种在【不修改原函数代码】的前提下,对函数进行【增强】的工具。 它是 Python 中非常强大的语法特性,常用于:日志、校验、计时、缓存、权限控制等。
- 核心语法: 装饰器是一种可调用对象(通常是函数),接收一个函数作为参数,并返回一个新函数。
函数装饰器
需求:在不修改add函数的前提下,给add函数增加一些额外的功能,例如:计算前打印一句欢迎语。
1️⃣定义函数装饰器
def say_hello(func):
def wrapper(*args, **kwargs):
print('你好,我要开始计算了')
return func(*args, **kwargs)
return wrapper
定义装饰器核心规则:
- 接收被装饰的函数、同时返回新函数(wrapper)
- 装饰器“吐出来”的是 wrapper 函数,以后别人调用的也是 wrapper 函数。
- 为了保证参数的兼容性,wrapper 函数要通过 *args 和 **kwargs 接收参数。
- wrapper 函数中主要做的是:调用原函数(被装饰的函数)、执行其它逻辑,但要记得将原函数的返回值 return 出去。
2️⃣使用函数装饰器(手动装饰)
def say_hello(func):
def wrapper(*args, **kwargs):
print('你好,我要开始计算了')
return func(*args, **kwargs)
return wrapper
# 调用say_hello装饰器,对add函数进行装饰,并得到装饰后的新函数
add = say_hello(add)
result = add(10, 20, 30)
print(result)
3️⃣使用函数装饰器(语法糖 @)
def say_hello(func):
def wrapper(*args, **kwargs):
print('你好,我要开始计算了')
return func(*args, **kwargs)
return wrapper
@say_hello
def add(x, y, z):
res = x + y + z
print(f'{x}和{y}和{z}相加的结果是:{res}')
return res
result1 = add(10, 20, 30)
print(result1)
上述代码的执行流程:
@say_hello会自动执行:add = say_hello(add)。- 以后调用
add()时,真正执行的是wrapper()。
4️⃣带参数的函数装饰器(三层嵌套)
需求:装饰不同的函数,打印不同的欢迎语。
核心:带参数的装饰器最终是三层嵌套结构:外层接收配置、中间层接收函数、内层接收具体参数。
def say_hello(msg):
def outer(func):
def wrapper(*args, **kwargs):
print(f'你好,我要开始{msg}计算了')
return func(*args, **kwargs)
return wrapper
return outer
# 装饰加法函数
@say_hello('加法')
def add(x, y, z):
res = x + y + z
print(f'{x}和{y}和{z}相加的结果是:{res}')
return res
# 装饰减法函数
@say_hello('减法')
def sub(x, y):
res = x - y
print(f'{x}和{y}相减的结果是:{res}')
return res
# 测试代码
result1 = add(10, 20, 30)
print(result1)
result2 = sub(20, 10)
print(result2)
5️⃣多个函数装饰器一起使用
核心:注意装饰顺序,距离函数最近的装饰器,会先工作。
例如下面代码:test2先装饰,test1再装饰。
def test1(func):
print('我是test1装饰器')
def wrapper(*args, **kwargs):
res = func(*args, **kwargs)
print('test1追加的逻辑')
return res
return wrapper
def test2(func):
print('我是test2装饰器')
def wrapper(*args, **kwargs):
res = func(*args, **kwargs)
print('test2追加的逻辑')
return res
return wrapper
@test1
@test2
def add(x, y):
res = x + y
print(f'{x}和{y}相加的结果是{res}')
return res
result = add(10, 20)
print(result)
类装饰器
- 包含
__call__方法的类,就是类装饰器。 - 像调用函数一样,去调用类装饰器的实例对象,就会触发
__call__方法的调用。 __call__方法通常接收一个函数作为参数,并且会返回一个新函数。
1️⃣定义类装饰器
需求和之前一样,还是给add函数增加【打印欢迎语】的功能。
class SayHello:
def __call__(self, func):
def wrapper(*args, **kwargs):
print('你好,我要开始计算了')
return func(*args, **kwargs)
return wrapper
2️⃣使用类装饰器(手动装饰)
使用类装饰器的流程:先创建类的实例对象,随后调用实例对象,并传入要装饰的函数
class SayHello:
def __call__(self, func):
def wrapper(*args, **kwargs):
print('你好,我要开始计算了')
return func(*args, **kwargs)
return wrapper
# 使用 SayHello 去装饰 add 函数(手动装饰)
say = SayHello()
add = say(add)
# 调用装饰后的函数
result = add(10, 20)
print(result)
3️⃣使用类装饰器(语法糖 @)
通过语法糖@使用装饰器时,类名后要加圆括号调用
class SayHello:
def __call__(self, func):
def wrapper(*args, **kwargs):
print('你好,我要开始计算了')
return func(*args, **kwargs)
return wrapper
@SayHello()
def add(x, y):
res = x + y
print(f'{x}和{y}相加的结果是{res}')
return res
# 依然按照原本的方式调用,但调用的是被装饰后的新函数
result = add(10, 20)
print(result)
4️⃣带参数的类装饰器
带参数的类装饰器写起来,要比带参数的函数装饰器简单,不需要三层嵌套结构
class SayHello:
def __init__(self, msg):
self.msg = msg
def __call__(self, func):
def wrapper(*args, **kwargs):
print(f'你好,我要开始{self.msg}计算了')
return func(*args, **kwargs)
return wrapper
@SayHello('加法')
def add(x, y):
res = x + y
print(f'{x}和{y}相加的结果是{res}')
return res
result = add(10, 20)
print(result)
5️⃣多个类装饰器一起使用
和之前的函数装饰器一样,离函数近的装饰器,先工作。
# 多个类装饰器的使用
class Test1:
def __call__(self, func):
def wrapper(*args, **kwargs):
print('我是Test1追加的逻辑')
return func(*args, **kwargs)
return wrapper
class Test2:
def __call__(self, func):
def wrapper(*args, **kwargs):
print('我是Test2追加的逻辑')
return func(*args, **kwargs)
return wrapper
@Test1()
@Test2()
def add(x, y):
res = x + y
print(f'{x}和{y}相加的结果是{res}')
return res
result = add(10, 20)
print(result)
类型注解 vs 函数类型注解
类型注解不会影响程序运行,它只是给人和工具看的,它可以提高代码可读性、让 IDE 智能提示更强 。
变量类型注解
语法格式:变量名: 类型 = 值。
num: int = 100
prcie: float = 12.5
message: str = '你好啊'
is_vip: bool = True
result: None = None # 语法上没有问题,但这么写没有意义
注意:可以先写变量的类型注解,以后再赋值。
school: str
print('*******', school)
school = '尚硅谷'
备注:上述代码中,
school: str并不是在定义变量,只是说明:如果未来有school变量,那应该是str类型。Python 执行到school = '尚硅谷'这句代码时,才会真正的定义school变量。
容器类型的注解:
# hobby 是列表,并且列表中的所有元素必须是 str 类型
hobby: list[str] = ['抽烟', '喝酒', '烫头']
# hobby 是列表,并且列表中的元素,可以是:str 或 int 类型
hobby: list[str | int] = ['抽烟', '喝酒', '烫头']
# 上面这行代码的旧写法如下:
from typing import Union
hobby: list[Union[str, int]] = ['抽烟', '喝酒', '烫头']
# citys 是集合,并且集合中所有元素必须是 str 类型
citys: set[str] = {'北京', '上海', '深圳'}
# citys 是集合,并且集合中所有元素可以是:str 或 float 或 bool 类型
citys: set[str | float | bool] = {'北京', '上海', '深圳'}
# persons 是字典,键是 str 类型,值是 int 类型
persons: dict[str, int] = {'张三': 18, '李四': 19, '王五': 20}
# persons 是字典,键是 str 或 int 类型,值是 int 类型
persons: dict[str | int, int] = {'张三': 18, '李四': 19, '王五': 20}
元组的类型注解有些特殊:
# scores 是元组,并且元组中仅包含1个int类型的元素
scores: tuple[int] = (60,)
# scores 是元组,并且元组中包含3个int类型的元素
scores: tuple[int, int, int] = (60, 70, 80)
# scores 是元组,并且元组中包含任意个数的元素,但每个元素的类型必须是int
scores: tuple[int, ...] = (60, 70, 80, 90, 100)
# scores 是元组,并且元组中包含任意个数的元素,每个元素的类型可以是:int 或 str
scores: tuple[int | str, ...] = (60, '70', 80, '90', 100)
Python 中存在类型推导:根据变量初始赋值的实际数据,自动推断变量的类型。
- 对于非容器变量:后续如果改变类型,不会警告。
- 对于容器变量:要求内部元素类型必须与推导出来的一致,否则就会警告。
x = 100
x = '尚硅谷'
y = [10, 20, 30]
y.append('40') # 此行会有警告
函数类型注解
- 函数类型注解:给函数的【参数】和【返回值】添加类型说明。
- 语法格式:
函数名(参数1: 类型, 参数2: 类型) -> 返回值类型:
1️⃣给参数和返回值加类型注解
def add(x: int, y: int) -> int:
return x + y
2️⃣ 带默认值的参数,可以不写注解
def add(x=1, y=1) -> int:
return x + y
3️⃣ 设置多个返回值的类型注解
def show_nums_info(nums: list[int]) -> tuple[int, int, float]:
max_v = max(nums)
min_v = min(nums)
return max_v, min_v, max_v / min_v
4️⃣ 可变参数类型注解
# 设置 *args 的类型注解,要求 args 中的每个参数都必须是 int 类型
def add(*args: int) -> int:
return sum(args)
# 设置 **kwargs 的类型注解,要求 kwargs 中的每组参数的值,必须是 str 或 int 类型
def show_info(**kwargs: str | int):
print(kwargs)
5️⃣获取函数的注解信息
print(add.__annotations__)
第 9 章 错误与异常
错误与异常
错误:代码本身有语法错误,解释器无法执行代码。———— 无法通过异常处理机制解决。
age = 18
if age >= 18
print('成年人')
异常:代码在语法上没问题,但执行过程中出现了问题。———— 可以通过异常处理机制解决。
# 1.ZeroDivisionError:当除数为 0 时触发。
num1 = 100
num2 = 0
result = num1 / num2
# 2.TypeError:当操作的数据类型不正确或不兼容时触发。
result = '10' + 5
# 3.AttributeError: 当对象没有指定的属性或方法时触发。
# 演示1
class Person:
def __init__(self, name, age):
self.name = name
self.age = age
p1 = Person('张三', 18)
print(p1.name)
print(p1.age)
print(p1.gender)
# 演示2
nums = [10, 20, 30]
nums.add(40)
# 4.IndexError:当索引超出范围(索引越界)时触发。
nums = [10, 20, 30, 40]
print(nums[4])
# 5.NameError:当使用了不存在的变量时触发。
print(school)
# 6.KeyError:当访问字典中不存在的 key 时触发。
person = {'name':'张三', 'age':18}
print(person['gender'])
# 7.ValueError:当值不合法,但类型正确时触发。
int('hello')
Python 中异常类的继承关系(层级关系)如下(了解即可):
官方地址:https://docs.python.org/zh-cn/3.13/library/exceptions.html#exception-hierarchy
其中:BaseException是所有异常类的父类,Exception中包含的是开发中常见的业务异常。
BaseException
├── BaseExceptionGroup
├── GeneratorExit
├── KeyboardInterrupt
├── SystemExit
└── Exception
├── ArithmeticError
│ ├── FloatingPointError
│ ├── OverflowError
│ └── ZeroDivisionError
├── AssertionError
├── AttributeError
├── BufferError
├── EOFError
├── ExceptionGroup [BaseExceptionGroup]
├── ImportError
│ └── ModuleNotFoundError
├── LookupError
│ ├── IndexError
│ └── KeyError
├── MemoryError
├── NameErrorburu
│ └── UnboundLocalError
├── OSError
│ ├── BlockingIOError
│ ├── ChildProcessError
│ ├── ConnectionError
│ │ ├── BrokenPipeError
│ │ ├── ConnectionAbortedError
│ │ ├── ConnectionRefusedError
│ │ └── ConnectionResetError
│ ├── FileExistsError
│ ├── FileNotFoundError
│ ├── InterruptedError
│ ├── IsADirectoryError
│ ├── NotADirectoryError
│ ├── PermissionError
│ ├── ProcessLookupError
│ └── TimeoutError
├── ReferenceError
├── RuntimeError
│ ├── NotImplementedError
│ ├── PythonFinalizationError
│ └── RecursionError
├── StopAsyncIteration
├── StopIteration
├── SyntaxError
│ └── IndentationError
│ └── TabError
├── SystemError
├── TypeError
├── ValueError
│ └── UnicodeError
│ ├── UnicodeDecodeError
│ ├── UnicodeEncodeError
│ └── UnicodeTranslateError
└── Warning
├── BytesWarning
├── DeprecationWarning
├── EncodingWarning
├── FutureWarning
├── ImportWarning
├── PendingDeprecationWarning
├── ResourceWarning
├── RuntimeWarning
├── SyntaxWarning
├── UnicodeWarning
└── UserWarning
异常处理
1️⃣为什么要进行异常处理
- 程序运行过程中出现的异常,如果得不到处理,那程序就会立即崩溃,导致后续代码无法执行。
- 异常处理不是让异常消失,而是将异常捕获到,随后根据异常的具体情况,来执行指定的逻辑。
print('欢迎使用本程序')
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
result = a / b
print(f'{a}除以{b}的结果是:{result}')
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
2️⃣异常处理(初级)
核心规则如下:
:::info
- 将可能出现异常的代码放在
try中,出现异常后的处理代码写在except中。 - 如果
try中的代码出现异常,那try中的后续代码不会执行,并自动跳转到except中。 - 如果
try中的代码没有异常,那except中的代码就不会执行。 - 无论是否发生异常,
try-except后面的代码都会继续执行。 - 直接写
except捕获到Python中所有的异常 ———— 实际开发中不推荐这样做。
:::
print('欢迎使用本程序')
try:
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
result = a / b
print(f'{a}除以{b}的结果是:{result}')
except:
print('抱歉,程序出现了异常!')
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
3️⃣捕获指定的类型的异常
print('欢迎使用本程序')
try:
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
result = a / b
print(f'{a}除以{b}的结果是:{result}')
except ZeroDivisionError:
print('程序异常:0不能作为除数!')
except ValueError:
print('程序异常:您输入的必须是数字!')
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
4️⃣验证异常类之间的继承关系
print(issubclass(ZeroDivisionError, ArithmeticError))
print(issubclass(ZeroDivisionError, Exception))
print(issubclass(ValueError, Exception))
print(issubclass(KeyboardInterrupt, Exception))
print(issubclass(KeyboardInterrupt, BaseException))
️5️⃣多个 except
多个except从上往下匹配,匹配成功后不再向下匹配。
print('欢迎使用本程序')
try:
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
print(x)
result = a / b
print(f'{a}除以{b}的结果是:{result}')
except ZeroDivisionError:
print('程序异常:0不能作为除数!')
except ValueError:
print('程序异常:您输入的必须是数字!')
except Exception:
print('程序异常!')
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
6️⃣获取异常的具体信息
备注:通过
e变量,可以获取异常相关的信息,也可以借助traceback去格式化异常信息。
print('欢迎使用本程序')
try:
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
print(x)
result = a / b
print(f'{a}除以{b}的结果是:{result}')
except ZeroDivisionError:
print('程序异常:0不能作为除数!')
except ValueError:
print('程序异常:您输入的必须是数字!')
except Exception as e:
print(f'⚠程序异常,异常信息:{e}')
print(f'⚠程序异常,异常类型:{type(e)}')
print(f'⚠程序异常,异常参数:{e.args}')
print(f'⚠程序异常,异常的文件:{e.__traceback__.tb_frame.f_code.co_filename}')
print(f'⚠程序异常,异常的具体行数:{e.__traceback__.tb_lineno}')
# 通过 traceback 来回溯异常
# import traceback
# print(traceback.format_exc())
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
7️⃣一个 except 捕获不同的异常
print('欢迎使用本程序')
try:
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
print(x)
result = a / b
print(f'{a}除以{b}的结果是:{result}')
except (ZeroDivisionError, ValueError, Exception) as e:
if isinstance(e, ZeroDivisionError):
print('程序异常:0不能作为除数!')
elif isinstance(e, ValueError):
print('程序异常:您输入的必须是数字!')
else:
print(f'程序异常:{e}')
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
8️⃣完整写法
:::info
try:尝试去做可能会出现异常的事情。except:出现异常时的处理(出现异常时怎么补救)。else:如果一切顺利(没有异常出现)要做的事。finall:无论有没有异常,都要做的事。
:::
print('欢迎使用本程序')
try:
a = int(input('请输入第一个数:'))
b = int(input('请输入第二个数:'))
result = a / b
print(f'{a}除以{b}的结果是:{result}')
except (ZeroDivisionError, ValueError, Exception) as e:
if isinstance(e, ZeroDivisionError):
print('程序异常:0不能作为除数!')
elif isinstance(e, ValueError):
print('程序异常:您输入的必须是数字!')
else:
print(f'程序异常:{e}')
else:
print('挺好的,try中的代码没有任何异常!')
finally:
print('无论有没有异常,我的计算都结束了!')
print('*******我是后续的其它逻辑1*******')
print('*******我是后续的其它逻辑2*******')
手动抛出异常
当程序遇到不符合预期情况时,可以使用raise语句手动触发(抛出)异常。
print('欢迎使用年龄判断系统')
try:
age = int(input('请输入你的年龄:'))
if 18 <= age <= 120:
print('成年')
elif 0 <= age < 18:
print('未成年')
else:
# print('输入的年龄有误!(年龄应该为0~120的整数)')
raise ValueError('年龄应该为0~120的整数')
except Exception as e:
print(f'程序异常:{e}')
异常的传递机制
- 如果异常没有被当前代码块所捕获处理,那该异常就会沿着调用链,逐层传递给其调用者。
- 如果所有调用者,都没有捕获该异常,那最终程序将因【未处理异常】而意外终止。
def test1():
print('******test1开始******')
result = '100' + 100
print('******test1结束******')
def test2():
print('******test2开始******')
try:
test1()
except Exception as e:
print(f'程序异常:{e}')
print('******test2结束******')
def test3():
print('******test3开始******')
test2()
print('******test3结束******')
test3()
执行以上代码,控制最终会输出
******test3开始******
******test2开始******
******test1开始******
程序异常:can only concatenate str (not "int") to str
******test2结束******
******test3结束******
自定义异常类
- 由开发人员自己定义一个异常类,用来表示代码中“更具体、更有业务含义”的异常。
- 具体规则:定义一个类(类名通常以
Error结尾),继承Exception类或它的子类。
class SchoolNameError(Exception):
def __init__(self, msg):
super().__init__('【校名异常】' + msg)
def check_school_name(name):
if len(name) > 10:
raise SchoolNameError('学校名过长')
else:
print('学校名是合法的')
try:
check_school_name('atguiguuuuuuuuuuuuuuu')
except SchoolNameError as e:
print(f'程序异常:{e}')
第 10 章 模块与包
模块
概述
- 在 Python 中,一个
.py文件就是一个模块(Module)。 - 模块中可以包含:变量、函数、类、等很多内容。
- 通常把能够实现某一特定功能的代码,集中放在一个模块中(模块就类似于一个工具箱)。
- 模块可以提高代码的可维护性 与 可复用性,还可以避免命名冲突。
模块的分类
Python 中的模块分为三类,分别是:标准库模块、自定义模块、第三方模块。
创建模块
模块命名注意点:
:::info
- 要符合标识符命名规则
- 模块名(
.py文件名)区分大小写 - 不要与标准库模块同名(一旦同名,
Python会优先引入标准库模块)
:::
创建如下文件:
├── order.py # 订单模块
└── pay.py # 支付模块
order模块中包含:创建订单、关闭订单,相关的功能函。
# 订单最大金额
max_order_amount = 1000000
# 创建订单
def create_order():
print('订单创建成功!')
# 关闭订单
def cancel_order():
print('订单关闭成功!')
# 提示函数
def show_info():
print('我是来自【订单】模块的提示!')
pay模块中包含:微信支付、支付宝支付,等相关功能。
# 支付超时时间
timeout = 1800
# 微信支付
def wechat_pay():
print('我是微信支付!')
# 支付宝支付
def ali_pay():
print('我是支付宝支付!')
# 提示函数
def show_info():
print('我是来自【支付】模块的提示!')
导入模块
1️⃣import 模块名
如下写法,会导入order模块,和pay模块的全部内容,又叫全部导入,是最简单的导入方式 。
import order
import pay
print(order.max_order_amount)
order.create_order()
order.cancel_order()
order.show_info()
print('*' * 10)
print(pay.timeout)
pay.wechat_pay()
pay.ali_pay()
pay.show_info()
:::color4
注意:
- Python 中导入模块的时,会执行对应模块中的代码。
- 模块只加载一次,后续再次导入,直接复用缓存。
:::
2️⃣import 模块名 as 别名
import order as dd
import pay as zf
print(dd.max_order_amount)
dd.create_order()
dd.cancel_order()
dd.show_info()
print('*' * 10)
print(zf.timeout)
zf.wechat_pay()
zf.ali_pay()
zf.show_info()
3️⃣from 模块名 import 具体内容1, 具体内容2, ......
from order import max_order_amount, show_info
from pay import wechat_pay, ali_pay
print(max_order_amount)
show_info()
wechat_pay()
ali_pay()
4️⃣from 模块名 import 具体内容 as 别名
from order import max_order_amount as max_amt, show_info as show1
from pay import timeout as tm, show_info as show2
print(max_amt)
print(tm)
show1()
show2()
5️⃣from 模块名 import *
from order import *
from pay import *
max_order_amount = 10
print(max_order_amount)
create_order()
cancel_order()
show_info()
print(timeout)
wechat_pay()
ali_pay()
show_info()
**__all__**** 与 ****__name__**
关于__all__:
:::info
- 在 Python 模块中,可通过
__all__来控制from 模块 import *能导入哪些内容。 __all__的值可以是:列表、元组。
:::
关于__name__:
:::info
__name__是每个 Python 模块(.py文件)都拥有的一个内置变量。- 它的具体值取决于模块的运行方式:
(1). 作为主程序直接运行,__name__ 的值是 __main__
(2). 作为模块被导入到其他程序中运行,__name__的模块的文件名(不带.py)。
:::
标准库模块
- Python 中的模块分为三类,分别是:标准库模块、自定义模块、第三方模块。
- 标准库模块:随着 Python 一起安装在我们电脑上的那些模块。
- 有一些标准库模块是用
C语言实现的,这些用C语言实现的模块,又称:【内置模块】。
标准库模块保存在
Python安装目录中的Lib文件夹中,但内置模块无法在Lib中看到。
import copy # 拷贝对象(浅拷贝、深拷贝)
import os # 操作系统相关操作(文件、文件夹、路径系统层面的操作)
import random # 随机数相关(生成随机数、随机选择、洗牌)
# 上面的copy、os、random是标准库模块中的【非内置模块】,可以通过__file__查看文件位置
# print(copy.__file__)
# print(os.__file__)
# print(random.__file__)
# 如下的这些模块,属于内置模块(无法看到具体实现,也没有__file__属性)
import time # 时间相关操作(获取时间、延时、格式化时间等。)
import math # 数学相关(开平方、取绝对值 等等)
import sys # Python 解释器相关操作
# 创建一个文件夹
os.mkdir('demo')
# 随机选择一个人
names = ['张三', '李四', '王五', '李华']
print(random.choice(names))
# 洗牌
names = ['张三', '李四', '王五', '李华']
random.shuffle(names)
print(names)
# 休眠
time.sleep(2)
print('ok')
# 获取当前时间
print(time.strftime('%H:%M:%S'))
print(time.strftime('%p %I:%M:%S'))
# 开平方
print(math.sqrt(4))
# 取绝对值
print(math.fabs(-11.2))
# 获取Python解释器的版本
print(sys.version)
包
概述
- 包是一种组织模块的方式,包中可以包含:各种模块、子包、其他资源等。
- 在 Python 中,【包含
__init__.py的文件夹】就是一个包(Package)。 - 我们通常会把【某个特定功能相关的所有模块】放入一个包中。
- 使用包可以进一步提升代码的:可维护性、可复用性,便于管理大型项目。
包与模块的关系
- 一个模块就是一个
.py文件 ,包是用来“管理模块”的目录(文件夹)。 - 一个包中可以有多个模块,也可以有多个子包。
包的分类
Python 中的包分为三类,分别是:标准库包、自定义包、第三方包。
创建包
:::info
包命名注意点:
- 要符合标识符命名规范。
- 包名区分大小写(建议全部使用小写字母)
- 不要与标准库包同名。
:::
创建如下文件结构,由于trade文件中包含了__init__.py文件,所以trade就可以称之为『包』。
└── trade/
├── __init__.py
├── order.py
└── pay.py
各文件内容如下:
# 该文件暂时留白,不编写任何代码,后面会对该文件详细讲解
# 订单最大金额
max_order_amount = 1000000
# 创建订单
def create_order():
print('订单创建成功!')
# 关闭订单
def cancel_order():
print('订单关闭成功!')
# 提示函数
def show_info():
print('我是来自【订单】模块的提示!')
# 支付超时时间
timeout = 1800
# 微信支付
def wechat_pay():
print('我是微信支付!')
# 支付宝支付
def ali_pay():
print('我是支付宝支付!')
# 提示函数
def show_info():
print('我是来自【支付】模块的提示!')
导入包
1️⃣import 包名.模块名
import trade.order
import trade.pay
trade.order.create_order()
trade.pay.wechat_pay()
2️⃣import 包名.模块名 as 别名
import trade.order as dd
import trade.pay as zf
dd.create_order()
zf.wechat_pay()
3️⃣from 包名.模块名 import 具体内容1
from trade.order import max_order_amount, create_order
from trade.pay import timeout, wechat_pay
print(max_order_amount)
print(timeout)
create_order()
wechat_pay()
4️⃣from 包名.模块名 import 具体内容 as 别名
from trade.order import max_order_amount as max_amt, create_order
from trade.pay import timeout, wechat_pay as w_pay
print(max_amt)
print(timeout)
create_order()
w_pay()
5️⃣from 包名.模块名 import *
from trade.order import *
from trade.pay import *
# print(max_order_amount)
create_order()
cancel_order()
show_info()
print(timeout)
wechat_pay()
ali_pay()
show_info()
6️⃣from 包名 import 模块名
from trade import order, pay
order.create_order()
pay.wechat_pay()
7️⃣from 包名 import 模块名 as 别名
from trade import order as dd, pay as p
dd.create_order()
p.wechat_pay()
⭐关于 __init__.py 文件
__init__.py是包的初始化文件,在包被导入时,__init__.py会被自动调用__init__.py中可以编写一些包的初始化逻辑__init__.py中所定义的内容,会被from 包名 import *形式全部引入__init__.py中也可以使用__all__来控制包中的哪些模块可以被from 包名 import *引入
8️⃣from 包名 import *
from trade import *
# print(a)
# print(b)
print(order.max_order_amount)
order.create_order()
print(pay.timeout)
pay.wechat_pay()
9️⃣import 包名
注意:想通过import 包名形式进行引入,就必须在__init__.py中定义好具体的内容
import trade
print(trade.a)
print(trade.b)
trade.order.create_order()
trade.pay.wechat_pay()
引入子包
以上引入方式,都可以用于引入子包,只需要在包名的后面跟上子包名即可,
在trade包中创建一个子包hello,其中包含h1模块:
└── trade/
└── hello/
├── __init__.py
└── h1.py
├── __init__.py
├── order.py
└── pay.py
└── demo.py
h1模块内容如下:
def say_hello():
print('你好')
例如:
from trade.hello.h1 import say_hello
say_hello()
第三方包
1️⃣概述
- PyPI 是是 Python 官方推荐、官方维护的包发布与分发平台(https://pypi.org)
pip是Python包管理工具,该工具提供了对Python包的查找、下载、安装、卸载的功能。pip默认的源是 PyPI,其地址为 ,如果下载比较慢,还可以指定其它的源。
备注:以下网址不推荐在浏览器中访问,正确用法是结合命令去使用(后面有讲解)
:::info
- 清华大学: https://pypi.tuna.tsinghua.edu.cn/simple
- 阿里云: https://mirrors.aliyun.com/pypi/simple
- 中国科技大学: https://pypi.mirrors.ustc.edu.cn/simple
:::
2️⃣****pip常用命令
| 命令 | 说明 |
|---|---|
pip install 包名 |
安装指定的包。 |
pip install -i 镜像地址 包名 |
临时使用镜像地址安装指定包。 |
pip config set global.index-url 地址 |
设置 pip 所使用的镜像地址。 |
pip config list |
查看当前环境的 pip 配置。 |
pip config unset global.index-url |
让 pip 恢复使用官方默认的地址。 |
pip list |
列出当前环境中,已安装的所有第三方包。 |
pip uninstall 包名 |
从当前环境中卸载指定的第三方包。 |
3️⃣安装一个第三方包
以安装numpy包为例(注意:请务必使用管理员身份运行 cmd)
💡思考:numpy安装到哪里去了呢? ———— 全局环境
4️⃣全局环境 vs 虚拟环境
- 什么是环境? —— 所谓环境就是指:python 解释器 + 依赖包。
- Python 环境分类两种,分别是全局环境(系统环境)、虚拟环境。
所有项目共用全局环境容易互相影响和干扰,虚拟环境可以解决这个问题,二者结构如下图:
- 图中的 Python 安装目录中的文件,构成了全局环境(系统环境)。
- 图中的
.venv中的文件构成了虚拟环境。- 虚拟环境有自己独立的一套:Python 解释器、pip 命令、第三方依赖包,不和其它项目产生干扰。
- 虚拟环境和全局环境共用的东西,只有标准库。
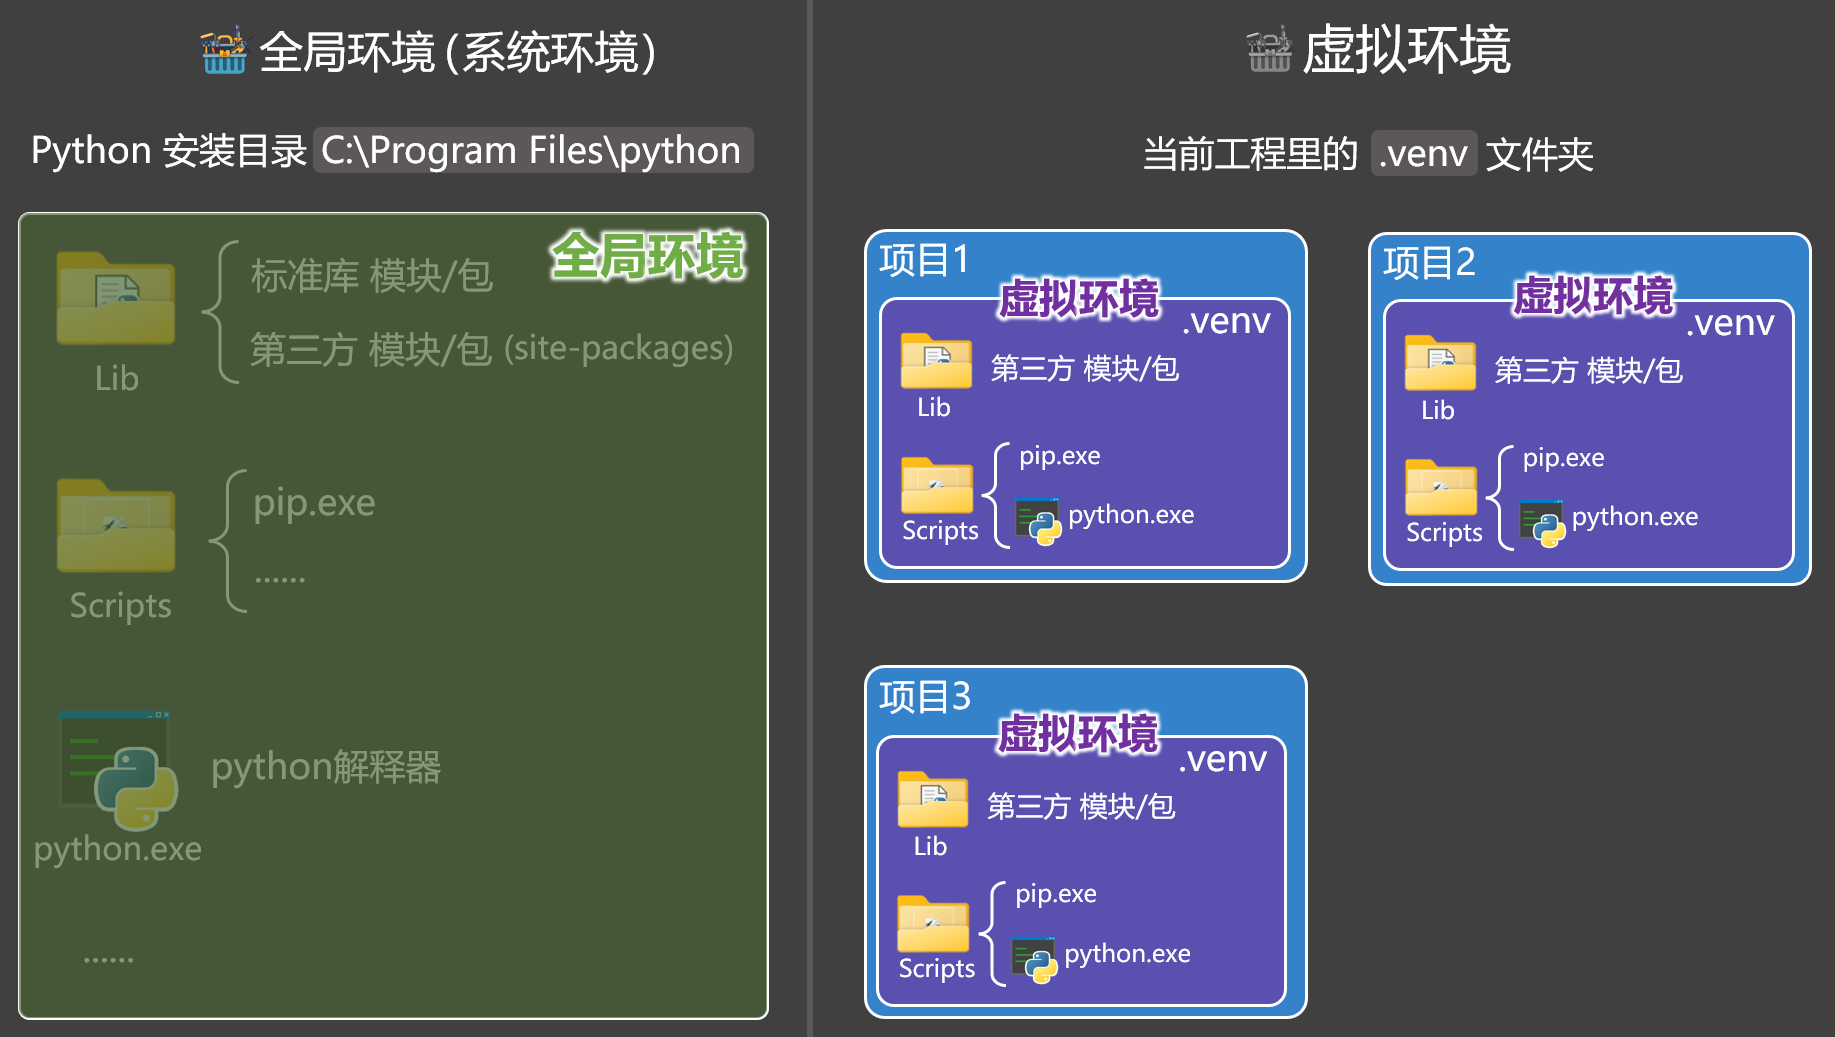
在cmd中不做任何处理,直接通过pip安装的包,都是安装在了全局环境中,如果想在虚拟环境中安装包,需要切到虚拟环境目录后,通过activate命令切换到虚拟环境。
备注:使用
deactivate可以退出虚拟环境。
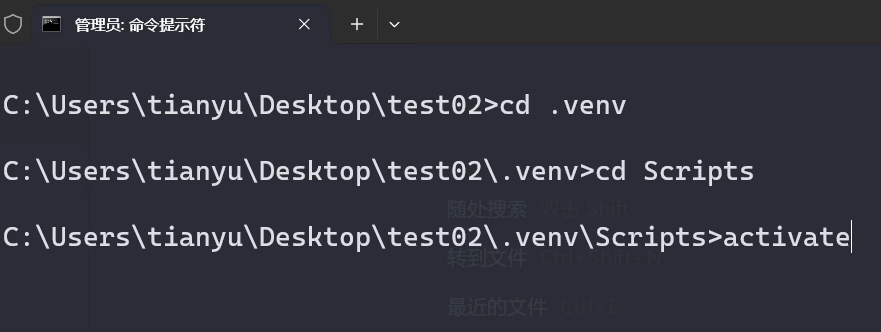
创建全局环境项目
通过 Pycharm 创建项目时,进行如下配置,即可创建全局环境:
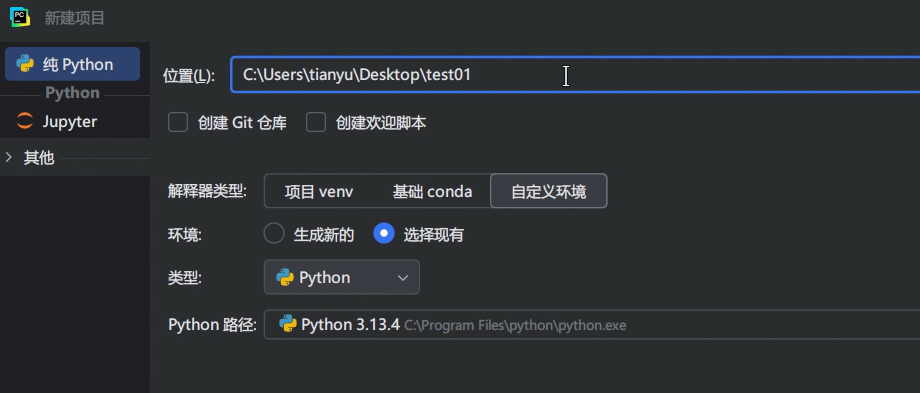
在全局环境中安装好这两个包:numpy、pyfiglet,随后进行测试:
# 使用安装在全局环境中的第三方包numpy
import numpy as np
result = np.random.randint(10, 100, size=10)
print(result)
print(type(result))
print(result.max())
print(result.min())
# 使用安装在全局环境中的第三方包pyfiglet
from pyfiglet import figlet_format
result = figlet_format('hello')
print(result)
# 使用全局的标准库
from collections import Counter
list1 = [10, 20, 30, 40, 20, 30, 20, 30, 10, 10, 10]
res = Counter(list1)
print(res)
结论:基于全局环境的项目,可以使用:全局环境中的第三方包,也可以使用全局的标准库。
创建虚拟环境项目
通过 Pycharm 创建项目时,进行如下配置,即可创建虚拟环境:
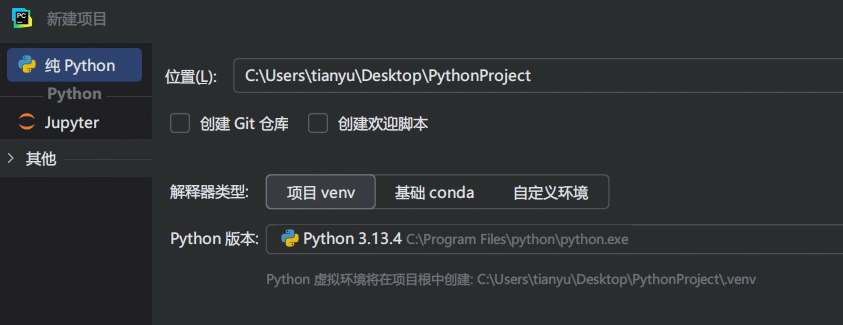
给虚拟环境安装第三方包的方式有三种:
1️⃣通过 cmd 安装
先切换到虚拟环境
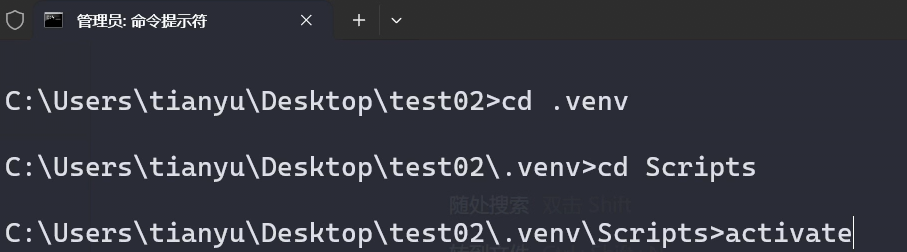
随后会切换到虚拟环境
随后安装自己想要的包(例如:faker)
2️⃣通过 Pycharm 中的命令行窗口安装
在 Pycharm 中打开命令行,会自动激活当前目录的虚拟环境
随后安装自己想要的包(例如:jieba)
3️⃣通过 Pycharm 提供的可视化工具安装
点击 Pycharm 右下角,随后选择解析器设置
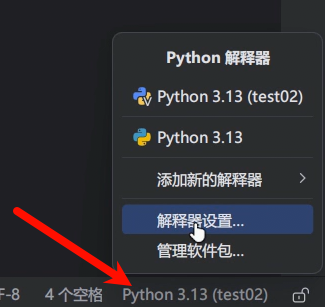
随后点击加号
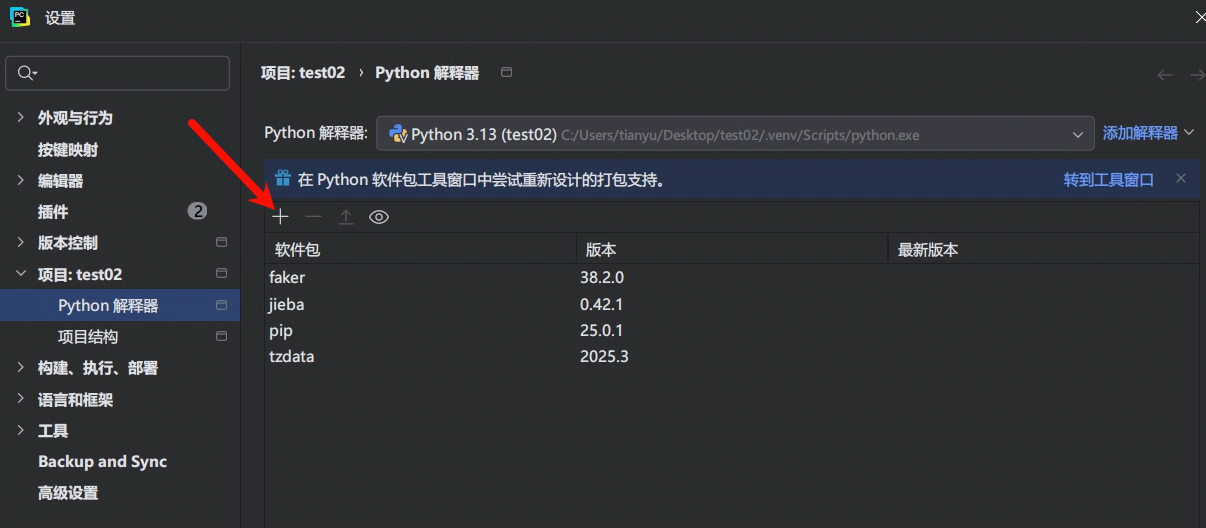
在搜索框里输入自己想安装的包(例如:cn2an),随后点击安装即可
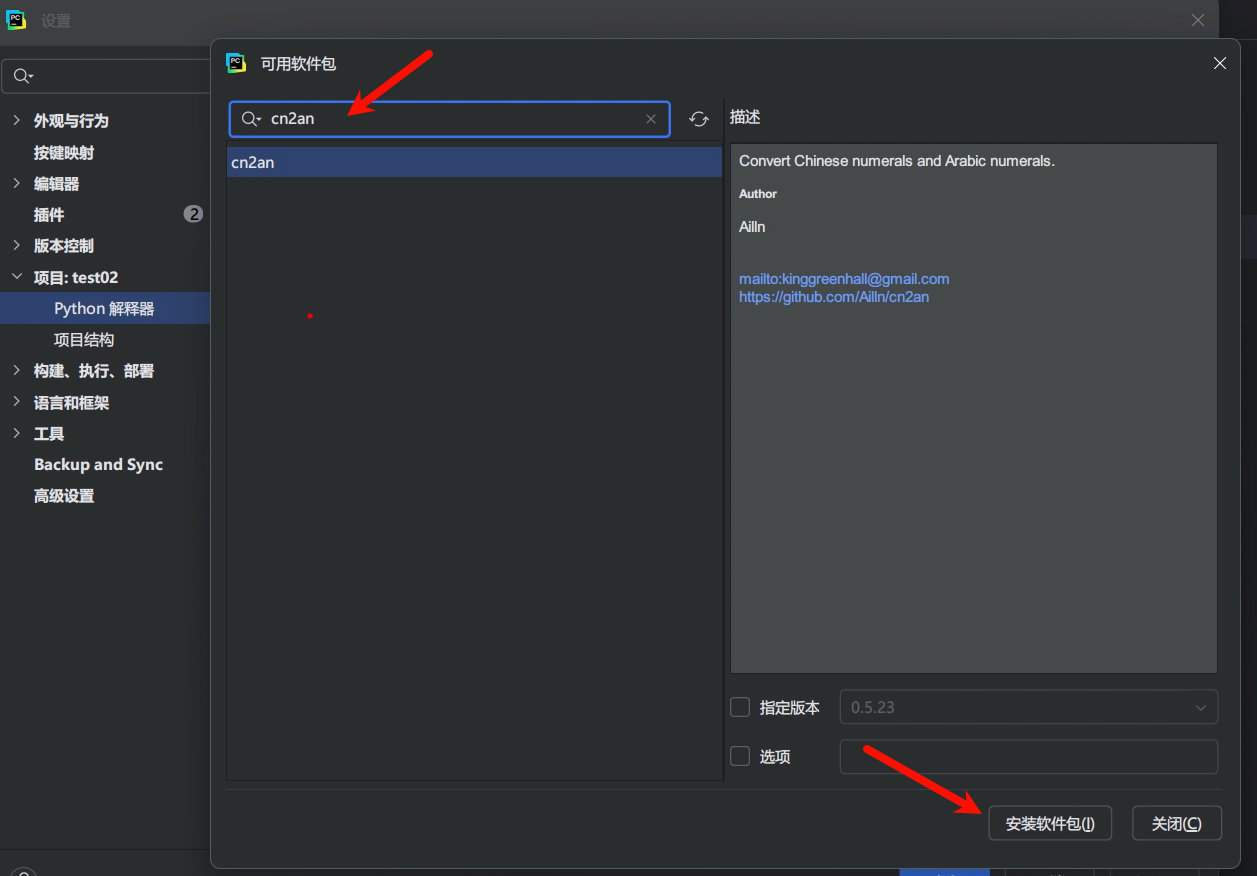
# 使用安装在当前虚拟环境中的第三方包faker
from faker import Faker
f = Faker('zh_CN')
print(f.name())
print(f.address())
print(f.phone_number())
# 使用安装在当前虚拟环境中的第三方包jieba
import jieba
result = jieba.lcut('南京市长江大桥')
print(result)
# 使用安装在当前虚拟环境中的第三方包cn2an
import cn2an
print(cn2an.cn2an('九千七百四十三'))
# 使用全局的标准库
from collections import Counter
list1 = [10, 20, 30, 40, 20, 30, 20, 30, 10, 10, 10]
res = Counter(list1)
print(res)
结论:基于虚拟环境的项目,可以使用:虚拟环境中的第三方包,也可以使用全局的标准库。
第 11 章 迭代器 vs 生成器
迭代器
先区分两个概念:可迭代对象(iterable)、迭代器(iterator)
1️⃣可迭代对象(iterable)
概念:能被 for 循环遍历的对象,就是可迭代对象(iterable)
如下这些都是可迭代对象(iterable):
names = ['张三', '李四', '王五']
citys = ('北京', '上海', '深圳')
msg = 'hello'
for item in names:
print(item)
如下这些不是可迭代对象(iterable):
age = 10
def test():
pass
for item in test:
print(item)
endregion
可迭代对象都拥有__iter__方法。
names = ['张三', '李四', '王五']
citys = ('北京', '上海', '深圳')
msg = 'hello'
age = 10
def test():
pass
names.__iter__()
citys.__iter__()
msg.__iter__()
print(hasattr(names, '__iter__'))
print(hasattr(citys, '__iter__'))
print(hasattr(msg, '__iter__'))
print(hasattr(age, '__iter__'))
print(hasattr(test, '__iter__'))
2️⃣迭代器(iterator)
调用__iter__方法会得到:迭代器(iterator)
- 备注1:
__iter__是一个魔法方法,当调用iter函数时,__iter__会自动调用。 - 备注2:
可迭代对象.__iter__()等价于:iter(可迭代对象)。 - 备注3:如果
iter(obj)能得到一个迭代器(iterator),那obj就是可迭代对象。
names = ['张三', '李四', '王五']
citys = ('北京', '上海', '深圳')
msg = 'hello'
print(names.__iter__())
print(citys.__iter__())
print(msg.__iter__())
print(iter(names))
print(iter(citys))
print(iter(msg))
迭代器(iterator)拥有__next__方法,每次调用都会根据当前的状态,返回下一个元素。
- 备注1:
迭代器.__next__()等价于next(迭代器)。 - 备注2:当所有元素全都取出后,若继续调用
__next__,Python会抛出StopIteration异常。
names = ['张三', '李四', '王五']
it = iter(names)
print(it.__next__())
print(it.__next__())
print(it.__next__())
print(it.__next__())
print(next(it))
print(next(it))
print(next(it))
print(next(it))
编写for循环遍历names列表
names = ['张三', '李四', '王五']
for item in names:
print(item)
for循环背后的逻辑
names = ['张三', '李四', '王五']
# 1️⃣调用【可迭代对象的__iter__方法】获取到一个迭代器(iterator)
it = iter(names)
# 2️⃣开启一个无限循环
while True:
try:
# 3️⃣调用__next__方法,获取下一个元素
item = next(it)
print(item)
except StopIteration:
# 4️⃣捕获 StopIteration 异常,随后结束循环
break
迭代器(iterator)也拥有__iter__方法,并且其返回值是迭代器自身。
这么设计的原因:让 for 循环也能遍历迭代器(即:为了让 iter(迭代器) 不出错)。
names = ['张三', '李四', '王五']
it = iter(names)
print(it)
result = iter(it)
print(result)
x = iter(result)
print(x)
it = iter(names)
for item in it:
print(item)
:::info
迭代器协议:一个对象如果同时满足如下规范,那该对象就是一个迭代器:
- 能被
iter()接受。 - 能被
next()一步一步取值。
:::
迭代器是一次性的,状态只会向前推进,且不会自动重置(迭代器在遍历的过程中会被“消耗”)。
names = ['张三', '李四', '王五']
it1 = iter(names)
it2 = iter(names)
print(it1)
print(it2)
print(next(it1))
print(next(it1))
print(next(it1))
print(next(it1)) # 此行代码会抛出异常,因为此时迭代器已经被耗尽了
# 如想重新依次获取元素,需要使用新的迭代器it2
print(next(it2))
print(next(it2))
print(next(it2))
3️⃣迭代器的应用
需求:让for循环可以遍历Person的实例对象。
实现方式1️⃣:
class Person:
def __init__(self, name, age, gender, address):
self.name = name
self.age = age
self.gender = gender
self.address = address
def __iter__(self):
return PersonIterator(self)
class PersonIterator:
def __init__(self, p):
# 将外部传进来的数据保存好
self.p = p
# 设置迭代器的初始化状态(指针位置)
self.index = 0
# 配置好要遍历的内容
self.attrs = [p.name, p.age, p.gender, p.address]
# 迭代器的__iter__方法会返回迭代器自身
def __iter__(self):
return self
# 每次调用__next__方法,会根据当前的状态,返回下一个元素
def __next__(self):
# 如果指针的位置超出范围,那就抛出StopIteration异常
if self.index >= len(self.attrs):
raise StopIteration
# 获取要返回的内容
value = self.attrs[self.index]
# 更新迭代器状态(指针位置)
self.index += 1
# 返回value
return value
# 目标:
p1 = Person('张三', 18, '男', '北京昌平')
for item in p1:
print(item)
for item in p1:
print(item)
实现方式2️⃣
class Person:
def __init__(self, name, age, gender, address):
self.name = name
self.age = age
self.gender = gender
self.address = address
# 设置迭代器的初始化状态(指针位置)
self.__index = 0
# 配置好要遍历的内容
self.__attrs = [name, age, gender, address]
def __iter__(self):
self.__index = 0
return self
def __next__(self):
# 如果指针的位置超出范围,那就抛出StopIteration异常
if self.__index >= len(self.__attrs):
raise StopIteration
# 获取要返回的内容
value = self.__attrs[self.__index]
# 更新迭代器状态(指针位置)
self.__index += 1
# 返回value
return value
# 目标:
# 下面的p1既是可迭代对象,又是迭代器
p1 = Person('张三', 18, '男', '北京昌平')
for item in p1:
print(item)
for item in p1:
print(item)
进阶:迭代器玩的就是__next__
from cn2an import an2cn
class Person:
def __init__(self, name, age, gender, address):
self.name = name
self.age = age
self.gender = gender
self.address = address
# 设置迭代器的初始化状态(指针位置)
self.__index = 0
# 配置好要遍历的内容
self.__attrs = [name, age, gender, address]
def __iter__(self):
self.__index = 0
return self
def __next__(self):
# 如果指针的位置超出范围,那就抛出StopIteration异常
if self.__index >= len(self.__attrs):
raise StopIteration
# 获取要返回的内容
value = self.__attrs[self.__index]
# 将字符串转为大写
if isinstance(value, str):
value = value.upper()
# 将数字转为汉语形式
if isinstance(value, int):
value = an2cn(value)
# 更新迭代器状态(指针位置)
self.__index += 1
# 返回value
return value
# 目标:
# 下面的p1既是可迭代对象,又是迭代器
p1 = Person('zhangsan', 18, '男', '北京昌平')
for item in p1:
print(item)
4️⃣迭代器的优势
- 迭代器是惰性计算,不会一次性生成所有结果,所以能显著降低内存占用。
- 当数据量很大,不确定要用多少结果时,推荐使用迭代器。
使用迭代器实现【斐波那契数列】:
class Fibo:
def __init__(self, total):
# 要生成多少个数
self.total = total
# 当前生成到第几个了(计数器,指针)
self.index = 0
# 初始的两个值
self.pre = 1
self.cur = 1
def __iter__(self):
return self
def __next__(self):
# 当生成足够数量后,抛出StopIteration异常
if self.index >= self.total:
raise StopIteration
# 前两项都是1
if self.index < 2:
value = 1
else:
# 新的结果等于前两项的和
value = self.pre + self.cur
# 更新一下pre和cur
self.pre = self.cur
self.cur = value
# 计数器+1
self.index += 1
# 返回value
return value
不使用迭代器实现【斐波那契数列】:
def fibo(total):
if total <= 0:
return []
if total == 1:
return [1]
nums = [1, 1]
for i in range(2, total):
nums.append(nums[-1] + nums[-2])
return nums
分析内存占用情况:
分别运行如下两段代码后,会发现迭代器实现明显节约内存。
tracemalloc.start()
f1 = Fibo(0)
m = tracemalloc.get_traced_memory()[1]
print(f'内存占用是:{m / 1024 / 1024}MB')
tracemalloc.start()
f1 = fibo(0)
m = tracemalloc.get_traced_memory()[1]
print(f'内存占用是:{m / 1024 / 1024}MB')
生成器
1️⃣两个概念
- 生成器函数:函数体中如果出现了
yield关键字,那该函数是『生成器函数』。 - 生成器对象:调用『生成器函数』时,其函数体不会立刻执行,而是返回一个『生成器对象』。
备注:不管能否执行到
yield所在的位置,只要函数中有yield,那该函数就是『生成器函数』。
def demo():
print('demo函数开始执行了')
print(100)
yield
a = 200
print(a)
d = demo()
print(d)
2️⃣几个细节
写在『生成器函数』中的代码,需要通过『生成器对象』来执行:
:::info
- 调用『生成器对象』的
__next__方法,会让『生成器函数』中的代码开始执行。 - 当『生成器函数』中的代码开始执行后,遇到
yield会“暂停”,并会记录“暂停”的位置。 - 后续调用
__next__方法时,都会从上一次“暂停”的位置,继续运行,直到再次遇到 yield。 - 遇到
return会抛出StopIteration异常,并将return后面的表达式,作为异常信息。 yield后面所写的表达式,会作为本次__next__方法的返回值。
:::
def demo():
print('demo函数开始执行了')
print(100)
yield '我是第1个yield所返回的数据'
a = 200
print(a)
yield '我是第2个yield所返回的数据'
b = 300
print(b)
return '尚硅谷'
d = demo()
r1 = next(d)
print(r1)
r2 = next(d)
print(r2)
try:
next(d)
except StopIteration as e:
print(e)
生成器对象是一种特殊的迭代器(本质是通过yield自动实现了迭代器协议)
def demo():
print('demo函数开始执行了')
print(100)
yield '我是第1个yield所返回的数据'
a = 200
print(a)
yield '我是第2个yield所返回的数据'
b = 300
print(b)
return '尚硅谷'
d = demo()
# 验证:生成器对象d,和迭代器一样,也拥有:__iter__ 和 __next__ 方法
print(hasattr(d, '__iter__'))
print(hasattr(d, '__next__'))
# 验证:生成器对象的__iter__方法,和迭代器一样,返回的也是自身
result = iter(d)
print(result == d)
# for循环遍历生成器
for item in d:
print(item)
# for循环背后的逻辑
gen = iter(d)
while True:
try:
value = next(gen)
print(value)
except StopIteration:
break
yield也能写在循环里
region
def create_car(total):
for index in range(1, total + 1):
yield f'我是第{index}台车'
# cars是生成器对象
cars = create_car(5)
# 调用一次cars的__next__方法,就会得到一台车
c1 = next(cars)
print(c1)
c2 = next(cars)
print(c2)
c3 = next(cars)
print(c3)
c4 = next(cars)
print(c4)
c5 = next(cars)
print(c5)
for car in cars:
print(car)
endregion
yield from能把一个『可迭代对象』里的东西依次yield出去。(替代:for + yield)
def demo():
nums = [10, 20, 30, 40]
yield from nums
d = demo()
r1 = next(d)
print(r1)
r2 = next(d)
print(r2)
r3 = next(d)
print(r3)
r4 = next(d)
print(r4)
for item in d:
print(item)
使用:生成器.send(值) 可以让生成器继续执行的同时,给上一次yield传值。
备注1:
next只能取值,send既能取值,也能送值。备注2:第一次启动生成器,不能传值!(或者说只能传 None 值)
def demo():
print('demo函数开始执行了')
print(100)
a = yield '我是第1个yield所返回的数据'
print(a)
b = yield '我是第2个yield所返回的数据'
print(b)
return '尚硅谷'
d = demo()
r1 = next(d) # 此处等价于 d.send(None)
print(r1)
r2 = d.send(666)
print(r2)
try:
d.send(888)
except StopIteration as e:
print(e)
3️⃣生成器的应用
用生成器实现遍历Person类的实例对象:
class Person:
def __init__(self, name, age, gender, address):
self.name = name
self.age = age
self.gender = gender
self.address = address
self.__attr = [name, age, gender, address]
def __iter__(self):
# yield self.name
# yield self.age
# yield self.gender
# yield self.address
yield from self.__attr
p1 = Person('张三', 18, '男', '北京昌平')
# 目标:
for attr in p1:
print(attr)
用生成器实现斐波那契数列:
def fibo(total):
pre = 1
cur = 1
for index in range(total):
if index < 2:
yield 1
else:
value = pre + cur
pre = cur
cur = value
yield value
f1 = fibo(10)
for item in f1:
print(item)
无论是迭代器,还是生成器对象,都可以用list、tuple、set等直接拿到其里面的所有内容(注意:如果数据量很大,可能会挤爆内存)
def fibo(total):
pre = 1
cur = 1
for index in range(total):
if index < 2:
yield 1
else:
value = pre + cur
pre = cur
cur = value
yield value
f1 = fibo(10)
result = set(f1)
print(result)
4️⃣生成器表达式
生成器表达式:一种用类似列表推导式的语法,快速创建生成器对象的方式。
语法格式:(表达式 for 变量 in 可迭代对象)。
什么时候适合用生成器表达式?———— 当“每个结果,只依赖当前这一个元素”时。
nums = [10, 20, 30, 40]
# 列表推导式
result1 = [n * 2 for n in nums]
print(result1)
# 生成器表达式(和列表推导式很像,不要搞混)
result2 = (n * 2 for n in nums)
for item in result2:
print(item)
第 12 章 文件操作
文件的分类
1️⃣纯文本文件
:::info
- 读取和存储时,要遵循某种『字符编码』规范(如:UTF-8 等)进行编码和解码,最终以『二进制』的形式存储。
- 『纯文本文件』最终会呈现为:可以直接阅读的文本信息。
- 常见的『纯文本文件』有:
.txt.py.md.html等。
:::
2️⃣二进制文件
:::info
- 读取和存储时,不涉及字符编码,会按照某种『文件格式规范』把内容转为『二进制』进行存储。
- 二进制文件需要由『能够识别其格式的软件』进行解析,最终的呈现形式多种多样(音频、视频、图像、幻灯片等)。
- 常见的二进制文件有:
.mp3.mp4.doc.ppt.jpg.png等。
:::
绝对路径 vs 相对路径
1️⃣绝对路径:
从文件系统的『根目录』开始,完整描述文件或目录所在的位置。
:::tips
举例:D:/demo/test/a.txt
:::
2️⃣****相对路径:
以当前『工作目录』为参照,描述目标文件或目录相对于它的位置。
:::tips
举例:../../a.txt(其中..表示上一级目录)
:::
Python 中操作文件的标准流程
标准流程成如下:
:::info
- 创建『文件对象』
- 操作文件(读取、写入 等)
- 关闭文件
:::
文件操作的核心 —— open函数
:::color3
open函数最常用的三个参数如下:
-
file:要操作的文件路径 -
mode:文件的打开模式r:读取(默认值)w:写入,并先截断文件x:排它性创建,如果文件已存在,则创建失败a:打开文件用于写入,如果文件存在,则在文件末尾追加内容b:二进制模式t:文本模式(默认值)+:打开用于更新(读取与写入) -
encoding:字符编码
:::
读取文件
1️⃣read方法
- 概述:使用『文件对象』的
read方法,读取文件中的内容。 - 方法说明:
:::info
-
read(size)中的size是可选参数。🔸若不传递
size参数,表示:读取文件中所有的内容(注意内存占用!)。🔸若传递了
size参数,表示:读取文件中指定个数的字符,或指定大小的字节。 -
read会从上一次read的位置继续读取,若到达文件末尾后继续读取,将返回空字符串。
:::
- 示例代码:
# 第一步:创建『文件对象』
# 完整写法
# file = open(file='a.txt', mode='rt', encoding='utf-8')
# 简写
file = open('a.txt', 'rt', encoding='utf-8')
# 使用绝对路径读取
# file = open('D:/test/atguigu.txt', 'rt', encoding='utf-8')
# 读取二进制文件
# file = open('D:/test/girl.jpg', 'rb')
# 第二步:操作文件(读取)
# 多次调用read去逐步读取文件
r1 = file.read(2)
r2 = file.read(3)
r3 = file.read(4)
r4 = file.read()
print(r1, end='')
print(r2, end='')
print(r3, end='')
print(r4, end='')
# 用循环配合多次read(对内存友好)
while True:
result = file.read(10)
if result == '':
break
print(result, end='')
# 第三步:关闭文件
file.close()
2️⃣readline方法
- 概述:使用文件对象的
readline方法,读取文件中的一行。 - 方法说明:
:::info
-
readline(size)中的size是可选参数。🔸若不传递
size参数,表示:读取当前这一行所有的内容。🔸若传递了
size参数,表示:表示读取当前行时,最多能读取的字符数,或字节数🔸注意:
size不是行数。 -
readline方法,也是从上一次位置继续读取,若到达文件末尾后继续读取,返回空字符串。
:::
- 示例代码:
# 第一步:创建『文件对象』
file = open('a.txt', 'rt', encoding='utf-8')
# 第二步:操作文件(读取)
# 依次调用readline逐行读取
r1 = file.readline()
r2 = file.readline()
r3 = file.readline()
r4 = file.readline()
print(r1.strip())
print(r2.strip())
print(r3.strip())
print(r4.strip())
# 通过循环配合readline逐行读取
while True:
line = file.readline()
if line == '':
break
# print(line.strip())
print(line, end='')
# 第三步:关闭文件
file.close()
3️⃣for 循环遍历文件对象
- 概述:可以使用
for循环直接遍历文件对象(逐行遍历)。 - 示例代码:
# 第一步:创建『文件对象』
file = open('a.txt', 'rt', encoding='utf-8')
# 第二步:操作文件(读取)
for line in file:
print(line, end='')
# 第三步:关闭文件
file.close()
4️⃣readlines方法
- 概述:使用文件对象的
readlines方法,一次性按“行”读完,返回一个列表。 - 方法说明:
:::info
-
readlines(hint)中的hint是可选参数。🔸若不传递
hint参数,表示:读取当前文件的所有行。🔸若传递了
hint参数,表示:期望读取的【字符个数 或 字节数】(hint不是行数)。 -
注意:由于
readlines是一次性读取文件的所有内容,所以不适合读取体积较大的文件。
:::
- 示例代码:
# 第一步:创建『文件对象』
file = open('a.txt', 'rt', encoding='utf-8')
# 第二步:操作文件(读取)
result = file.readlines()
print(result)
# 第三步:关闭文件
file.close()
⭐️最佳实践
- 概述:更推荐使用
with上下文管理器,结合for循环遍历,逐行读取文件。
with open('a.txt', 'rt', encoding='utf-8') as file:
for line in file:
print(line, end='')
关于with
-
概述:Python 中的
with主要用于管理程序中“需要成对出现的操作”,例如:🔸上锁 / 解锁
🔸打开 / 关闭
🔸借用 / 归还
-
使用
**with**的目标:编码者只管做具体的事,“进入”和“离开”的事,让 Python 自动处理。 -
语法格式:
with 能得到一个上下文管理器的表达式 as 变量:
具体的事1
具体的事2
具体的事3
- 上下文管理器协议:
:::info
__enter__方法:with中的代码执行【之前】调用,其返回值会赋值给as后的变量。__exit__方法:with中的代码执行【结束后】调用(无论是with中否出现异常都会调用)。
:::
- 测试代码:
# 定义一个 Person 类,让其实例对象遵循:上下文管理器协议
class Person:
def __init__(self, name, age):
self.name = name
self.age = age
def speak(self):
print(f'我叫{self.name},年龄是{self.age}')
def __enter__(self):
print('-----我是进入的逻辑-----')
return self
# 当 with 中的代码发生异常时,__exit__ 方法的返回值规则如下:
# 🔸返回“真”:表示异常【已经】被处理,异常【不会】被继续抛出。
# 🔸返回“假”:表示异常【没有】被处理,异常【会】被继续抛出。
def __exit__(self, exc_type, exc_val, exc_tb):
print('-----我是离开的逻辑-----')
# exc_type : 异常类型
# exc_val : 异常对象
# exc_tb : 异常追踪信息
if exc_type:
print(f'异常类型:{exc_type}')
print(f'异常对象:{exc_val}')
print(f'异常追踪信息:{exc_tb}')
return True
# 1.计算 with 后面的表达式,得到一个『上下文管理器』。
# 2.调用『上下文管理器』的 __enter__() 方法,并将其返回值赋给 as 后面的变量。
# 3.执行 with 所管理的代码。
# 4.无论代 with 中的代码,是正常结束,还是发生异常,都会自动调用『上下文管理器』的 __exit__ 方法。
with Person('张三', 18) as p1:
p1.speak()
# p1.study()
print(666)
写入文件
1️⃣w模式
- 概述:
w模式是写入模式,写入前会先截断文件(清空文件)。 - 代码:
with open('b.txt', 'wt', encoding='utf-8') as file:
file.write('你好')
2️⃣x模式
- 概述:
x模式是排它性创建,如果文件已存在,则创建失败。 - 代码:
with open('demo.txt', 'xt', encoding='utf-8') as file:
file.write('你好')
3️⃣a模式
- 概述:打开文件用于写入,如果文件存在,则在文件末尾追加内容。
- 代码:
with open('a.txt', 'at', encoding='utf-8') as file:
file.write('你好')
flush方法
- 概述:Python 写入文件时,并不是每写一次就立刻落盘,而是:先写到“缓冲区”里。
**flush**方法:把缓冲区中的数据,立刻写入到文件中。- 测试代码:
import time
with open('demo.txt', 'at', encoding='utf-8') as file:
file.write('你好1')
file.write('你好2')
file.flush()
time.sleep(10000)
file.write('你好3')
file.write('你好4')
组合模式
1️⃣rt+模式
- 概述:
r模式可以读取,+模式可以更新(读取或写入),所以rt+模式可读可写。 - 注意:
r模式打开文件后,文件指针在起始位置。 - 备注:由于
t是默认值,所以rt+中的t可以省略。 - 代码:
with open('a.txt', 'rt+', encoding='utf-8') as file:
# seek(offset, whence)方法:用于改变文件对象指针的位置,参数说明如下:
# offset:偏移量,要移动多少距离
# whence:参考点,从哪里开始计算偏移,有三种取值:
# 0:从文件开头计算(默认值)
# 1:从当前位置计算
# 2:从文件末尾计算
# 注意:在文本模式下,不要随意去定位中文字符位置,否则可能破坏文件编码。
file.seek(0, 0)
file.write('你好')
2️⃣wt+模式
- 概述:
w模式可以写入,+模式可以用于更新(读取或写入),所以wt+模式可读可写。 - 注意:
w模式打开文件后,文件指针在起始位置,但write方法执行完后,指针在文件结束位置。 - 备注:由于
t是默认值,所以wt+中的t可以省略。 - 代码:
with open('a.txt', 'wt+', encoding='utf-8') as file:
file.write('你好')
file.seek(0, 0)
result = file.read()
print(result)
3️⃣xt+模式
- 概述:
x模式可以写入,+模式可以用于更新(读取或写入),所以xt+模式可读可写。 - 注意:
x模式打开文件后,文件指针在起始位置。 - 备注:由于
t是默认值,所以xt+中的t可以省略。 - 代码:
with open('demo3.txt', 'xt+', encoding='utf-8') as file:
file.write('你好')
file.seek(0, 0)
result = file.read()
print(result)
3️⃣at+模式
- 概述:
a模式可以追加内容,+模式可以用于更新(读取或写入),所以at+模式可读可写。 - 注意:
a模式打开文件后,文件指针在结束位置。 - 备注:由于
t是默认值,所以at+中的t可以省略。 - 代码:
with open('a.txt', 'at+', encoding='utf-8') as file:
file.write('你好')
file.seek(0, 0)
result = file.read()
print(result)
目录操作
Python 中常见的目录操作如下:
import os
import shutil
# 1️⃣os.mkdir(path):创建“单级”目录(如果目录已经存在,则会抛出异常)
os.mkdir('D:/demo')
# 2️⃣os.makedirs(path):创建“多级”目录(如果路径中的所有目录都已经存在,则会抛出异常)
os.makedirs('D:/demo/aa/bb')
# 3️⃣os.rmdir(path):删除空目录(如果目录不存在,或目录非空,都会抛出异常)
os.rmdir('D:/demo/aa/bb')
# 4️⃣os.removedirs(path):递归删除空目录,在成功删除末尾一级目录后,会“向上”尝试把父级目录也删除
# (直到父目录不是空目录)
os.removedirs('D:/demo/aa/bb')
# 5️⃣os.path.exists(path):判断路径是否存在(文件/目录都算)
result = os.path.exists('D:/demo/aa/bb')
print(result)
# 6️⃣os.path.isdir(path):用于判断路径,具体规则如下:
# 1.路径不存在 ==================> 返回 False
# 2.路径存在,但指向的是文件 =====> 返回 False
# 3.路径存在,并且是目录 =======> 返回 True
result = os.path.isdir('D:/demo/aa/bb')
print(result)
# 7️⃣os.path.isfile(path):判断是否为文件
result = os.path.isfile('D:/demo/aa/bb')
print(result)
# 8️⃣os.scandir(path):扫描指定目录
result = os.scandir('D:/demo')
for item in result:
print('目录' if item.is_dir() else '文件', item.name)
# 9️⃣os.walk(path):按层级,递归地遍历指定目录下,所有的子目录和文件
result = os.walk('D:/demo')
for item in result:
print(item)
# ⚠️危险操作:删除有内容的目录
shutil.rmtree('D:/demo')
两个小练习
练习 1:将一个二进制文件复制到指定位置。
import os
# 源文件
source = 'music.mp3'
# 目标目录
target = 'D:/media'
# 如果目标目录不存在,那就去创建
if not os.path.isdir(target):
os.makedirs(target)
with open(source, 'rb') as f1, open(target + '/' + 'my_music.mp3', 'wb') as f2:
while True:
# 每次只读取1KB
data = f1.read(1024)
# 如果文件读取完毕了,就跳出循环
if not data:
break
# 向目标文件中写入数据
f2.write(data)
print('复制完毕')
练习 2:日志记录,需求如下:
:::info
- 用户输入用户名和密码后,程序进行校验:
- 用户名不存在,提示“用户名未注册”,并记录日志。
- 用户名存在,但密码错误,提示“密码错误”,并记录日志。
- 用户名和密码均正确,提示“登录成功”,并记录日志。
:::
import time
# 准备一些用户
users = {
'张三': '123456',
'李四': '888888',
'王五': 'abc123'
}
# 提示输入信息
username = input('请输入用户名:')
password = input('请输入密码:')
# 获取当前的时间
now = time.strftime('%Y-%m-%d %H:%M:%S')
# 如果用户名不在users中
if username not in users:
print('用户名未注册')
with open('log.txt', 'at', encoding='utf-8') as file:
file.write(f'{now} {username} 登录失败(用户未注册)\n')
# 如果密码不正确
elif users[username] != password:
print('密码不正确')
with open('log.txt', 'at', encoding='utf-8') as file:
file.write(f'{now} {username} 密码错误 \n')
# 登录成功
else:
print('登录成功!')
with open('log.txt', 'at', encoding='utf-8') as file:
file.write(f'{now} {username} 登录成功 \n')
第 13 章 进程与线程
一些核心概念
1️⃣并发 vs 并行
- 并发:
🔸概念:在一段时间内,当 CPU 面对多个任务时,会将每个任务交替着执行一段时间。
🔸特点:
(1). 对于某个瞬间,CPU实际上只在执行一个任务。
(2). CPU通过高频切换不同的任务,让每个任务都能得到推进,仿佛多个任务在“同时执行”。
- 并行:
🔸概念:并行依赖于多个CPU,或多核心的CPU,在同一时刻,每个核心都在执行不同的任务
🔸特点:
(1). 对于某个瞬间,每个CPU(或每个核心)都在执行不同的任务。
(2). 通过多个CPU(或多个核心)同时工作的方式,让多个任务真的在同时执行。
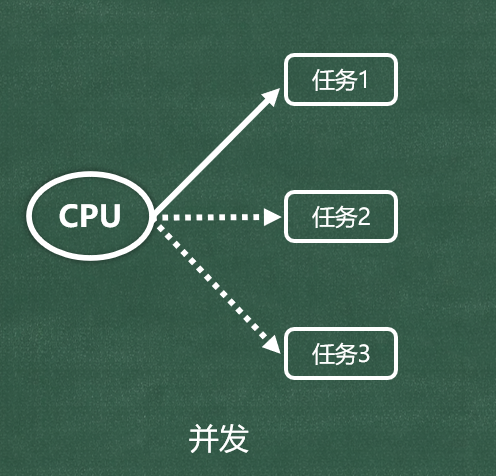
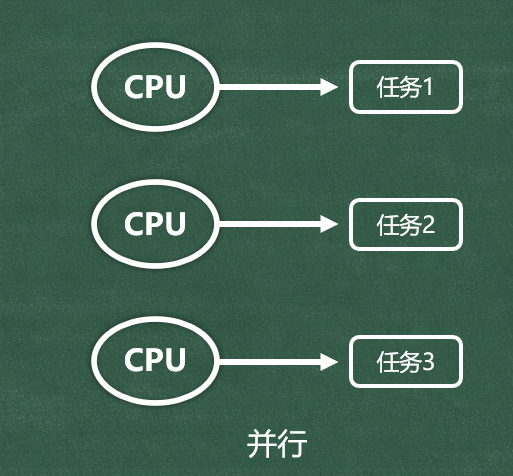
注意:现代操作系统中,并发与并行通常同时存在。
2️⃣ 同步 vs 异步
-
同步(sync):
🔸概念:发起一个任务之后,需要等该任务完成后,才能继续执行后续任务。
🔸表现:当前执行流会被『阻塞』。
-
异步(async):
🔸概念:发起一个任务之后,不必等该任务完成,就可以继续执行其他任务。
🔸备注:虽然不必等待任务完成,但任务完成后,仍然可以通过特定方式获取结果。
🔸表现:当前执行流不会被『阻塞』。
概念对比:
:::info
- 并发 / 并行:描述的是任务如何被执行,即:多个任务在执行时,CPU 要如何处理。
- 同步 / 异步:描述的是任务如何被组织和等待,即:是否等当前任务执行完,再进行下一个任务。
:::
⚠️注意点:
:::color4
CPU 的核心数和执行速度,不会改变任务之间的逻辑依赖关系!例如:一旦任务1、任务2、任务3 之间被设计为同步关系,那么:即便 CPU 切换任务的速度再快,核心数量再多,也不会在【任务1】没完成的情况下去启动【任务2】
:::
3️⃣进程 vs 线程
- 进程:
🔸一个正在运行的程序或软件,背后就对应着一个或多个进程。
🔸进程是操作系统进行资源分配的基本单位。
🔸每个进程都有自己独立的一块内存空间。
- 线程:
🔸线程是进程内部的执行单元(一个进程中可以有多个线程)。
🔸线程是操作系统进行 CPU 调度的基本单位。
🔸同一进程内的线程共享进程资源。
主进程 _ 子进程
在操作系统中,每个进程都会对应一个进程编号(PID),并且主进程与子进程是一个相对的概念,比如 A 进程中创建了 B 进程,B 进程中创建了 C 进程,那此时的 B 进程既是 A 进程的子进程,又是 C 进程的(主)父进程
Python 中查看进程 PID:
os.getpid(): 获取当前进程 ID。os.getppid(): 获取父进程 ID。
Windows 命令查看:进程名、父进程 PID、进程 PID:
wmic process get Name,ParentProcessId,ProcessId。
使用 Process 创建进程
使用multiprocessing.Process类创建进程对象。
import os
import time
from multiprocessing import Process
print(100, __name__, os.getpid())
# 定义一个 speak 函数,功能是:每隔一秒说话一次(一共说话10次)
def speak():
for index in range(10):
print(f'我在说话{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
# 定义一个 study 函数,功能是:每隔一秒学习一次(一共学习15次)
def study():
for index in range(15):
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
# 注意:一定要写 if __name__ == '__main__' 这个判断,原因如下:
# 1.当创建子进程时,Python 并不会把父进程内存里的 speak 函数直接交给子进程。
# 2.Python会启动一个全新的 Python 解释器进程,重新执行当前的 .py 文件(作为模块)。
# 3.在执行过程中,重新定义出一个 speak 函数,交给子进程。
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
# 创建两个 Process 类的实例对象(进程对象),分别是 p1 和 p2。
# 注意点1:p1 和 p2 就对应着以后的两个子进程,在创建它们的时候,就要指定好他们要执行的任务。
# 注意点2:此时的 p1 和 p2 只是代码层面的两个进程对象,操作系统还没有创建 p1 和 p2 两个进程。
p1 = Process(target=speak)
p2 = Process(target=study)
# 调用进程对象的 start 方法,会立刻向操作系统申请一个进程,并且会将该进程交由操作系统进行调度。
p1.start()
p2.start()
print('我是主进程中的【最后一行】打印')
⚠️****注意点:
:::color4
在 Windows 中使用 multiprocessing 必须加上 if __name__ == '__main__':,原因是:创建子进程时,Python 不会直接拷贝内存里的函数给子进程。Python 会启动一个全新的解释器,重新执行当前的.py文件作为模块。如果不加判断,会无限递归创建子进程。
:::
关于 Process 的参数
在实例化 Process 时,可以传递以下参数:
🔸group: 默认值为None(应当始终为None)。
🔸target:子进程要执行的可调用对象,默认值为 None。
🔸name: 进程名称,默认为 None ,如果设置为 None,Python 会自动分配名字。
🔸args: 给 target 传的位置参数(元组)
🔸kwargs:给 target 传的关键字参数(字典)。
🔸daemon:标记进程是否为守护进程,取值为布尔值(默认为 None,表示从创建方继承)。
备注:可以使用
current_process().name获取当前进程的名字。
import os
import time
from multiprocessing import Process, current_process
def speak(a, b, msg):
for index in range(10):
print(f'{msg}--{a}--{b}--{current_process().name}--我在说话{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
def study():
for index in range(15):
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
p1 = Process(target=speak, name='说话进程', args=(666, 888), kwargs={'msg':'尚硅谷'})
p2 = Process(target=study)
# print(p1.name)
# print(p2.name)
p1.start()
p2.start()
print('我是主进程中的【最后一行】打印')
进程控制
1️⃣Lock(进程锁)
为了防止多个进程同时打印或操作同一资源导致数据错乱,可以使用 Lock。
传统用法:
lock.acquire() # 上锁
# ... 临界区代码 ...
lock.release() # 释放锁
上下文管理器用法 (推荐):
with lock:
# 自动上锁,退出块时自动释放
# 好处:即便发生异常也能保证释放锁,避免死锁
示例代码:
import os
import time
from multiprocessing import Process, Lock
def speak(lock):
for index in range(10):
# 上锁:如果锁是空闲的,立刻上锁,继续往下执行;如果锁被别人拿着:当前进程会阻塞等待
lock.acquire()
print('好好', end='')
print('学习', end='')
print('天天', end='')
print('向上')
# 释放锁:acquire 和 release 必须成对出现,否则会永远卡住(死等)
lock.release()
time.sleep(1)
def study(lock):
for index in range(15):
# with lock: 会自动完成两件事:
# (1).进入前:自动执行 lock.acquire() 上锁
# (2).离开后:自动执行 lock.release() 释放锁
# 好处:即便代码块里发生异常,也能保证释放锁,避免“卡死”
with lock:
print('A', end='')
print('B', end='')
print('C', end='')
print('D')
time.sleep(1)
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
lock = Lock()
p1 = Process(target=speak, args=(lock,))
p2 = Process(target=study, args=(lock,))
p1.start()
p2.start()
print('我是主进程中的【最后一行】打印')
传统 Lock 在面对多次上锁时,会产生死锁状态,解决办法是使用 RLock,示例代码:
import os
import time
from multiprocessing import Process, Lock, RLock
def speak(lock):
for index in range(10):
lock.acquire()
lock.acquire()
print('好好', end='')
print('学习', end='')
print('天天', end='')
print('向上')
lock.release()
lock.release()
time.sleep(1)
def study(lock):
for index in range(15):
with lock:
print('A', end='')
print('B', end='')
print('C', end='')
print('D')
time.sleep(1)
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
lock = RLock()
p1 = Process(target=speak, args=(lock,))
p2 = Process(target=study, args=(lock,))
p1.start()
p2.start()
print('我是主进程中的【最后一行】打印')
2️⃣ join 方法
- 作用:阻塞当前进程(通常是主进程),直到调用
join的那个进程执行完毕。 - 参数:
join(timeout),timeout为超时时间(秒)。如果时间到了进程还没结束,主进程就不等了,会继续执行。 - 注意:
join必须在start()之后调用。
# join 方法的作用:阻塞当前进程,等 join 前面的进程执行完,再继续往下执行。
# join(timeout),其中 timeout 是可选参数,表示等多久,单位是秒。
# 注意点:
# 1.p.join() 不是让进程 p 等,而是让“执行这行 join 代码的那个进程”去等,等的是 p 这个进程。
# 2.当达到了 timeout 所指定的时间后,进程并不会终止,只是“不再等”了。
# 3.join 必须在 start 之后
import os
import time
from multiprocessing import Process
def speak():
for index in range(10):
print(f'我在说话{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
def study():
for index in range(15):
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
p1 = Process(target=speak)
p2 = Process(target=study)
p1.start()
# 让主进程等 p1 5秒钟
p1.join(5)
p2.start()
# p1.join() # 让主进程等 p1 进程执行完毕后,主进程再继续执行。
# p2.join() # 让主进程等 p2 进程执行完毕后,主进程再继续执行。
print('我是主进程中的【最后一行】打印')
3️⃣terminate 方法
- 作用:向操作系统申请强制终止进程。
- 注意:使用
terminate终止进程,不会执行**finally**代码块。 - 辅助方法:
is_alive()可用于查看进程是否还“活着”。
import os
import time
from multiprocessing import Process
def speak():
try:
for index in range(10):
print(f'我在说话{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
# 注意:使用 terminate 终止进程,不会引起 finally 执行!
finally:
print('我是finally里的逻辑')
def study():
for index in range(15):
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
p1 = Process(target=speak)
p2 = Process(target=study)
p1.start()
p2.start()
time.sleep(3)
print('我是主进程,我准备强制终止p1进程........')
# 向操作系统申请强制终止p1进程
p1.terminate()
# 等操作系统彻底终止掉了p1进程
p1.join()
# 看一下p1进程是否“活着”
print(p1.is_alive())
print('我是主进程中的【最后一行】打印')
4️⃣ 守护进程 (Daemon)
什么是守护进程?
一种 “依附于主进程存在的子进程”,一旦主进程结束,它就会被自动终止。简言之:主进程一死,守护进程必跟着死。
守护进程的使用场景:
:::info
- 后台监控类任务
- 日志 / 统计 / 采样 类任务
- 辅助型“陪跑任务”
:::
注意点:
:::info
- 守护进程必须是 子进程。
- 主进程结束,守护进程也会随之结束。
- 守护进程中,不允许再创建新的子进程。
- 必须在 start 之前,
start()之后,不能再设置daemon。
:::
import os
import time
from multiprocessing import Process
def monitor():
while True:
try:
with open('log.txt', 'r', encoding='utf-8') as file:
lines = sum(1 for _ in file)
except FileNotFoundError:
lines = 0
print(f'我是【守护进程({os.getpid()})】,log.txt 共有{lines}行')
time.sleep(1)
def test():
for index in range(30):
print(f'我是test({os.getpid()})')
time.sleep(1)
if __name__ == '__main__':
print(f'我是主进程({os.getpid()})中的【第一行】代码')
p1 = Process(target=monitor, daemon=True)
p2 = Process(target=test)
p1.start()
p2.start()
# 向文件中写入数据
with open('log.txt', 'a', encoding='utf-8') as file:
for index in range(10):
file.write(f'尚硅谷{index}\n')
file.flush()
time.sleep(1)
print(f'我是主进程({os.getpid()})中的【最后一行】代码')
进程之间不共享变量
进程之间不共享内存,因此也就不共享任何变量。验证代码如下:
验证代码 1:
# 进程之间不共享内存,因此也就不共享任何变量。
from multiprocessing import Process
num = 100
names = []
def test1():
global num, names
num += 10
names.append('张三')
print(f'我是 test1 进程,操作之后的num是{num},操作之后的names是{names}')
def test2():
global num, names
num -= 10
names.append('李四')
print(f'我是 test2 进程,操作之后的num是{num},操作之后的names是{names}')
if __name__ == "__main__":
print('主进程中的【第一行】代码')
p1 = Process(target=test1)
p2 = Process(target=test2)
p1.start()
p2.start()
p1.join()
p2.join()
print('主进程中的【最后一行】代码', num, names)
验证代码 2:
# 进程之间不共享内存,因此也就不共享任何变量。
from multiprocessing import Process
def test1(num, names):
num += 10
names.append('张三')
print(f'我是 test1 进程,操作之后的num是{num},操作之后的names是{names}')
def test2(num, names):
num -= 10
names.append('李四')
print(f'我是 test2 进程,操作之后的num是{num},操作之后的names是{names}')
if __name__ == "__main__":
num = 100
names = []
print('主进程中的【第一行】代码')
p1 = Process(target=test1, args=(num, names))
p2 = Process(target=test2, args=(num, names))
p1.start()
p2.start()
p1.join()
p2.join()
print('主进程中的【最后一行】代码', num, names)
注意:
:::color4
我们正常编写的变量,在多个进程之间是不共享的,但有些对象是天然被多个进程共享的,比如:我们之前讲过的 Lock 和 RLock,我们后面还会学习到很多天然被多个进程锁共享的对象,例如:multiprocessing.Queue
:::
Queue(队列)
- 我们之前学过
list、tuple、dict,它们的特点是:数据想怎么拿数据,就怎么拿。 - 队列(Queue)是:一种“先进先出”的数据结构(先放进去的数据,一定会先取出来)。
- 队列的常见操作如下:
import time
from multiprocessing import Queue, Process
# 创建一个队列(不限制大小,即:不设置容量上限)
q1 = Queue()
# 创建一个队列(最多能保存3个元素)
q2 = Queue(3)
# 1️⃣put方法:往队列里放数据(入队)
q1.put(10)
q1.put(20)
q1.put(30)
# 2️⃣get方法:从队列里取数据(出队)
value1 = q1.get()
value2 = q1.get()
value3 = q1.get()
print(value1)
print(value2)
print(value3)
# 3️⃣empty方法:判断队列是否为空
result = q1.empty()
print(result)
# 4️⃣full方法:判断队列是否已满
q1.put(10)
q1.put(20)
q1.put(30)
result = q1.full()
print(result)
q2.put(100)
q2.put(200)
q2.put(300)
result = q2.full()
print(result)
# 5️⃣qsize方法:获取队列长度
q1.put(10)
q1.put(20)
q1.put(30)
result = q1.qsize()
print(result)
# 6️⃣队列具备等待模式
q2.put(100)
q2.put(200)
q2.put(300)
# (1).当队列已满,继续 put,就会进入等待模式,等别人调用get方法,取走一个元素
q2.put(400)
print('放入完毕')
# (2).当队列已满,执行:put(元素, timeout=秒数),就会等待指定秒数。
q2.put(400, timeout=3)
print('放入完毕')
# (3).put_nowait 方法,会直接向队列中添加元素,不会进入等待模式,若队列已满,会抛出异常。
# 备注:put_nowait 等价于 put(元素, block=False),block的默认值为 True
q2.put_nowait(400)
q2.put(400, block=False)
# get读多了,也会进入等待模式
q2.get()
q2.get()
q2.get()
# (1).当队列已空,继续 get,就会进入等待模式。x
q2.get()
# (2).当队列已空,执行 get(timeout=秒数),就会等待指定秒数。
q2.get(timeout=3)
# (3).get_nowait 方法,会直接读取队列中的元素,不会进入等待模式,若队列已空,会抛出异常
# 备注:get_nowait 等价于 get(block=False)
q2.get_nowait()
q2.get(block=False)
通过多进程演示:当队列满了以后,再次put会等待,当有人从队列中取出元素后,put会继续。
def test(q):
time.sleep(3)
result = q.get()
print('我从队列中取出了一个元素:',result)
# 通过多进程,演示一下:当队列满了以后,再次put会等待,当有人从队列中取出元素后,put会继续。
if __name__ == '__main__':
# 创建一个队列,让其最多能保存2个元素
q = Queue(2)
# put两次,把队列填满
q.put('尚硅谷')
q.put('atguigu')
print(f'队列是否已满:{q.full()}')
# 创建子进程p1
p1 = Process(target=test, args=(q, ))
# 开启子进程p1,让其3秒钟后,从队列中取出一个元素
p1.start()
print('即将向已满的队列中添加一个元素........')
q.put('hello')
print('目前队列中有的元素是:')
print(q.get())
print(q.get())
使用 Queue 实现进程通信
进程之间是不共享数据的,那如果进程之间如何进行数据沟通(进程通信)呢?手段多种多样,我们本小节给大家说通过Queue 实现进程通信。
核心思想: 一个进程负责生产数据,另一个进程负责消费数据,中间通过 Queue 进行“传话”
import time
from multiprocessing import Process, Queue
# 子进程1:往队列里放数据
def test1(q):
for index in range(5):
print(f'【test1】放入数据:{index}')
q.put(index)
time.sleep(0.5)
# 子进程2:从队列里取数据
def test2(q):
for index in range(5):
data = q.get()
print(f'【test2】取出数据:{data}')
time.sleep(1)
if __name__ == '__main__':
q = Queue()
p1 = Process(target=test1, args=(q,))
p2 = Process(target=test2, args=(q,))
p1.start()
p2.start()
p1.join()
p2.join()
备注:
q是在主进程中创建的,但可以被子进程使用,因为multiprocessing.Queue是跨进程的。
为什么数据不会乱掉? —— 因为队列是先进先出的。
使用 Pipe 实现进程通信
Pipe 就像一根“水管”,一头负责发送,另一头负责接收。
1️⃣ **创建管道 **
# Pipe() 会返回两个连接对象,它们分别代表管道的两端。
# duplex用于控制管道为单向还是双向,True表示双向,False表示单向
con1, con2 = Pipe(duplex=True)
# 单向 Pipe 的规则:con1只能发送,con2只能接收。
2️⃣发送与接收
send方法: 向管道中发送数据。recv方法: 从管道中接收数据。
3️⃣测试代码:
import time
from multiprocessing import Process, Pipe
def test1(con1):
time.sleep(2)
con1.send(100)
print('test1发送了100')
def test2(con2):
data = con2.recv()
print(f'test2接收了{data}')
if __name__ == '__main__':
con1, con2 = Pipe(duplex=False)
p1 = Process(target=test1, args=(con1,))
p2 = Process(target=test2, args=(con2,))
p1.start()
p2.start()
p1.join()
p2.join()
继承 Process 类创建进程
当子进程逻辑比较复杂,或者想把「进程 + 行为」封装成一个整体时,可以使用继承 Process 类的方式去创建进程,这种方式属于“面向对象风格”
1️⃣核心要点:
- 必须继承
Process类 - 把子进程要干的事,写进
run()方法里 - 依然使用
start方法启动进程,不要手动调用run()! - 若子进程不需要参数,可以不写
__init__,若需要参数,则需编写__init__ - 传给的子进程的参数,作为实例属性保存 。
2️⃣示例代码:
from multiprocessing import Process
import os, time
class SpeakProcess(Process):
def __init__(self, a, b, **kwargs):
super().__init__(**kwargs)
self.a = a
self.b = b
def run(self):
for index in range(10):
print(f'{self.a}--{self.b}--我在说话{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
class StudyProcess(Process):
def run(self):
for index in range(15):
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 我的父进程是:{os.getppid()}')
time.sleep(1)
if __name__ == '__main__':
print('我是主进程中的【第一行】打印')
p1 = SpeakProcess(100, 200)
p2 = StudyProcess()
p1.start()
p2.start()
p1.join()
p2.join()
print('我是主进程中的【最后一行】打印')
进程池(ProcessPoolExecutor)
截至目前,我们已经学会了创建多个进程一起工作,但是我们仍然面临一个问题:如果每来一个任务就创建一个进程,会很浪费系统资源,因为进程创建 / 销毁成本很高,当有大量任务时,系统资源浪费严重。
使用进程池的优势:如何使用进程池统一管理多个子进程,避免频繁创建 / 销毁进程带来的开销,因为进程池会提前创建固定数量的进程,反复使用它们来执行任务。
1️⃣创建『进程池执行器』、使用 submit 方法提交任务、使用 shutdown 方法等待任务完成。
def work(n):
print(f'work正在执行任务{n}.........{os.getpid()}')
time.sleep(1)
if __name__ == '__main__':
print('---------start-------------')
# 创建一个进程池执行器
executor = ProcessPoolExecutor(3)
# 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主进程)
executor.submit(work, 1)
executor.submit(work, 2)
executor.submit(work, 3)
executor.submit(work, 4)
executor.submit(work, 5)
executor.submit(work, 6)
executor.submit(work, 7)
# shutdown 的作用:不再接收新的任务。
# wait=True 的作用:阻塞主进程,等待进程池中所有任务执行完毕。
executor.shutdown(wait=True)
print('---------end-------------')
2️⃣获取子进程执行后的返回结果(Future类的实例对象 + result方法)
def work(n):
print(f'work正在执行任务{n}.........{os.getpid()}')
time.sleep(1)
return f'我是任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个进程池执行器
executor = ProcessPoolExecutor(3)
# 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主进程)
# f1 = executor.submit(work, 1)
# f2 = executor.submit(work, 2)
# f3 = executor.submit(work, 3)
# f4 = executor.submit(work, 4)
# f5 = executor.submit(work, 5)
# f6 = executor.submit(work, 6)
# f7 = executor.submit(work, 7)
futures = [executor.submit(work, index) for index in range(1, 8)]
# 阻塞主进程,等待进程池中所有任务执行完毕。
executor.shutdown(wait=True)
# print(f1.result())
# print(f2.result())
# print(f3.result())
# print(f4.result())
# print(f5.result())
# print(f6.result())
# print(f7.result())
for f in futures:
print(f.result())
print('---------end-------------')
3️⃣使用 **as_completed**:按“完成顺序”获取结果
def work(n):
print(f'work正在执行任务{n}.........{os.getpid()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'我是任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个进程池执行器
executor = ProcessPoolExecutor(3)
# 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主进程)
futures = [executor.submit(work, index) for index in range(1, 8)]
# 准备一个 result_list 去收集任务的具体结果
result_list = []
# 收集每个任务的结果
for f in as_completed(futures):
result_list.append(f.result())
# 阻塞主进程,等待进程池中所有任务执行完毕。
executor.shutdown(wait=True)
# 打印最终的结
print(result_list)
print('---------end-------------')
4️⃣使用 **add_done_callback** 方法,为任务添加完成时的回调函数。
def work(n):
print(f'work正在执行任务{n}.........{os.getpid()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'我是任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个进程池执行器
executor = ProcessPoolExecutor(3)
# 准备一个 result_list 列表去收集任务的结果
result_list = []
# 任务完成后的回调函数
def done_func(futrue):
result_list.append(futrue.result())
# 开启7个任务,并指定回调函数
for index in range(1, 8):
f = executor.submit(work, index)
f.add_done_callback(done_func)
# 等所有任务都完成
executor.shutdown(wait=True)
# 打印最终的结果(按“完成的顺序”获取)
print(result_list)
print('---------end-------------')
5️⃣️使用 **map** 方法批量提交任务(注意:**map**方法本身不阻塞,但读取其返回的生成器对象是阻塞的,并且得到结果的顺序,与任务分配的顺序是一致的)
map方法会把这一批任务提交到进程池里执行,它会立刻返回一个生成器,真正的阻塞发生在:生成器取结果时,如 list(result)
def work(n):
print(f'work正在执行任务{n}.........{os.getpid()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'我是任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个进程池执行器
executor = ProcessPoolExecutor(3)
# 通过 map 方法批量提交任务(结果按照提交的顺序来)
results = executor.map(work, [1, 2, 3, 4, 5, 6, 7])
# 获取 results 生成器中的内容
print(list(results))
# 等所有任务都完成
executor.shutdown(wait=True)
print('---------end-------------')
6️⃣**使用 **with**:进程池的“自动回收”写法,离开 **with** 代码块时自动执行 ****shutdown(wait=True)**
def work(n):
print(f'work正在执行任务{n}.........{os.getpid()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'我是任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个进程池执行器
with ProcessPoolExecutor(3) as executor:
# 通过 map 方法批量提交任务(结果按照提交的顺序来)
results = executor.map(work, [1, 2, 3, 4, 5, 6, 7])
# 获取 results 生成器中的内容
print(list(results))
print('---------end-------------')
使用 Thread 创建线程
首先我们要明确一个概念:任何一个正在运行的 Python 程序,至少都有一个线程!
1️⃣回顾一下我们之前的代码:
if __name__ == '__main__':
print('主进程中的代码')
对于上述代码来说:
print('主进程中的代码')确实属于主进程,但更准确地说,是运行在主进程里的主线程中。
2️⃣线程是进程中的执行单位:
- 一个进程里,至少有一个线程(主线程)
- 一个进程里,也可以有多个线程
- 多个线程之间会: 共享进程的内存空间、 但执行顺序由操作系统调度。
3️⃣示例代码:
import os
import time
from threading import get_native_id, Thread, RLock
def speak(lock):
for index in range(5):
with lock:
print(f'我在说话{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
time.sleep(1)
def study(lock):
for index in range(5):
with lock:
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
time.sleep(1)
if __name__ == '__main__':
print(f'-------start------- 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
lock = RLock()
# Thread 的参数:
# 🔸group: 默认值为 None(应当始终为 None)。
# 🔸target: 子线程要执行的可调用对象,默认值为 None。
# 🔸name: 线程名称,默认为 None。如果设置为 None,Python 会自动分配名字
# 🔸args: 给 target 传的位置参数(元组)。
# 🔸kwargs: 给 target 传的关键字参数(字典)。
# 🔸daemon: 标记线程是否为守护线程,取值为布尔值(默认为 None)。
# 使用 Thread 创建线程对象
t1 = Thread(target=speak, args=(lock,))
t2 = Thread(target=study, args=(lock,))
# 调用线程对象的 start 方法,会立刻将该线程交由操作系统进行调度。
t1.start()
t2.start()
# 让主线程等 t1和t2 线程执行完毕后,主线程再继续执行。
t1.join()
t2.join()
print('-------end-------')
继承 Thread 创建线程
和继承Process创建进程一样,我们也可以继承Thread创建线程。
import os
import time
from threading import get_native_id, Thread, RLock
class SpeakThread(Thread):
def __init__(self, lock, **kwargs):
super().__init__(**kwargs)
self.lock = lock
def run(self):
for index in range(5):
with self.lock:
print(f'我在说话{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
time.sleep(1)
class StudyThread(Thread):
def __init__(self, lock, **kwargs):
super().__init__(**kwargs)
self.lock = lock
def run(self):
for index in range(5):
with self.lock:
print(f'我在学习{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
time.sleep(1)
if __name__ == '__main__':
print(f'-------start------- 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
lock = RLock()
# 继承 Thread 类创建线程对象
t1 = SpeakThread(lock)
t2 = StudyThread(lock)
# 调用线程对象的 start 方法,会立刻将该线程交由操作系统进行调度。
t1.start()
t2.start()
# 让主线程等 t1和t2 线程执行完毕后,主线程再继续执行。
t1.join()
t2.join()
print('-------end-------')
线程池
线程池的具体语法,以及各个方法的作用,都和进程池一样
1️⃣创建『线程池执行器』、使用 **submit** 方法提交任务、使用 **shutdown** 方法等待任务完成。
def work(n, lock):
with lock:
print(f'work正在执行任务{n}.........{get_native_id()}')
time.sleep(1)
if __name__ == '__main__':
print('---------start-------------')
# 创建一个线程池执行器
executor = ThreadPoolExecutor(3)
# 创建线程锁
lock = RLock()
# 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主线程)
executor.submit(work, 1, lock)
executor.submit(work, 2, lock)
executor.submit(work, 3, lock)
executor.submit(work, 4, lock)
executor.submit(work, 5, lock)
executor.submit(work, 6, lock)
executor.submit(work, 7, lock)
# shutdown 的作用:不再接收新的任务。
# wait=True 的作用:阻塞主线程,等待线程池中所有任务执行完毕。
executor.shutdown(wait=True)
print('---------end-------------')
2️⃣获取子线程执行后的返回结果(**Future**类的实例对象 + **result**方法)
def work(n, lock):
with lock:
print(f'work正在执行任务{n}.........{get_native_id()}')
time.sleep(1)
return f'任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个线程池执行器
executor = ThreadPoolExecutor(3)
# 创建线程锁
lock = RLock()
# 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主线程)
futures = [executor.submit(work, index, lock) for index in range(1, 8)]
# 阻塞主线程,等待线程池中所有任务执行完毕。
executor.shutdown(wait=True)
# 打印结果
for f in futures:
print(f.result())
print('---------end-------------')
3️⃣使用 **as_completed**:按“完成顺序”获取结果
def work(n, lock):
with lock:
print(f'work正在执行任务{n}.........{get_native_id()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个线程池执行器
executor = ThreadPoolExecutor(3)
# 创建线程锁
lock = RLock()
# 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主线程)
futures = [executor.submit(work, index, lock) for index in range(1, 8)]
# 收集每个线程返回的结果
result_list = []
# 将每个线程返回的结果,存入result_list
for f in as_completed(futures):
result_list.append(f.result())
# 阻塞主线程,等待线程池中所有任务执行完毕。
executor.shutdown(wait=True)
# 打印最终的结果
print(result_list)
print('---------end-------------')
4️⃣使用 **add_done_callback** 方法,为任务添加完成时的回调函数
def work(n, lock):
with lock:
print(f'work正在执行任务{n}.........{get_native_id()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个线程池执行器
executor = ThreadPoolExecutor(3)
# 创建线程锁
lock = RLock()
# 收集每个线程的执行结果
result_list = []
# 定义一个线程执行成功后的回调函数
def done_func(f):
result_list.append(f.result())
# 使用submit提交任务,并指定回调函数
for index in range(1, 8):
f = executor.submit(work, index, lock)
f.add_done_callback(done_func)
# 阻塞主线程,等待线程池中所有任务执行完毕。
executor.shutdown(wait=True)
# 打印最终的结果
print(result_list)
print('---------end-------------')
5️⃣使用 **map** 方法批量提交任务(注意:**map**方法本身不阻塞,但读取其返回的生成器对象是阻塞的,并且得到结果的顺序,与任务分配的顺序是一致的)
map方法会把这一批任务提交到线程池里执行,它会立刻返回一个生成器,真正的阻塞发生在:生成器取结果时,如 list(result)
def work(n, lock):
with lock:
print(f'work正在执行任务{n}.........{get_native_id()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
# 创建一个线程池执行器
executor = ThreadPoolExecutor(3)
# 创建线程锁
lock = RLock()
# 使用map方法批量提交任务
result = executor.map(work, [1, 2, 3, 4, 5, 6, 7], [lock]*7)
# 打印最终的结果
print(list(result))
# 阻塞主线程,等待线程池中所有任务执行完毕。
executor.shutdown(wait=True)
print('---------end-------------')
6️⃣使用 **with**:线程池的“自动回收”写法,离开 **with** 代码块时自动执行** shutdown(wait=True)**
def work(n, lock):
with lock:
print(f'work正在执行任务{n}.........{get_native_id()}')
if n == 1:
time.sleep(15)
elif n == 2:
time.sleep(10)
else:
time.sleep(1)
return f'任务{n}的结果'
if __name__ == '__main__':
print('---------start-------------')
with ThreadPoolExecutor(3) as executor:
# 创建线程锁
lock = RLock()
# 使用map方法批量提交任务
result = executor.map(work, [1, 2, 3, 4, 5, 6, 7], [lock]*7)
# 打印最终的结果
print(list(result))
print('---------end-------------')
GIL 全局解释器锁
概念: GIL锁是 CPython 解释器中的一把互斥锁。
作用:无论 CPU 有多少个核心,在某一时刻,只允许同一个进程中的一个线程去执行 Python 代码。
结论:CPython 解释器中的多线程模型,本质上是并发,而不是并行!(是快速切换,而不是同时进行)
为何要这样设计?———— 为了确保解释器级别的数据安全。
如果没有 GIL 锁,那么 Python 底层就可能会出现引用计数错误,导致内存“爆炸”。
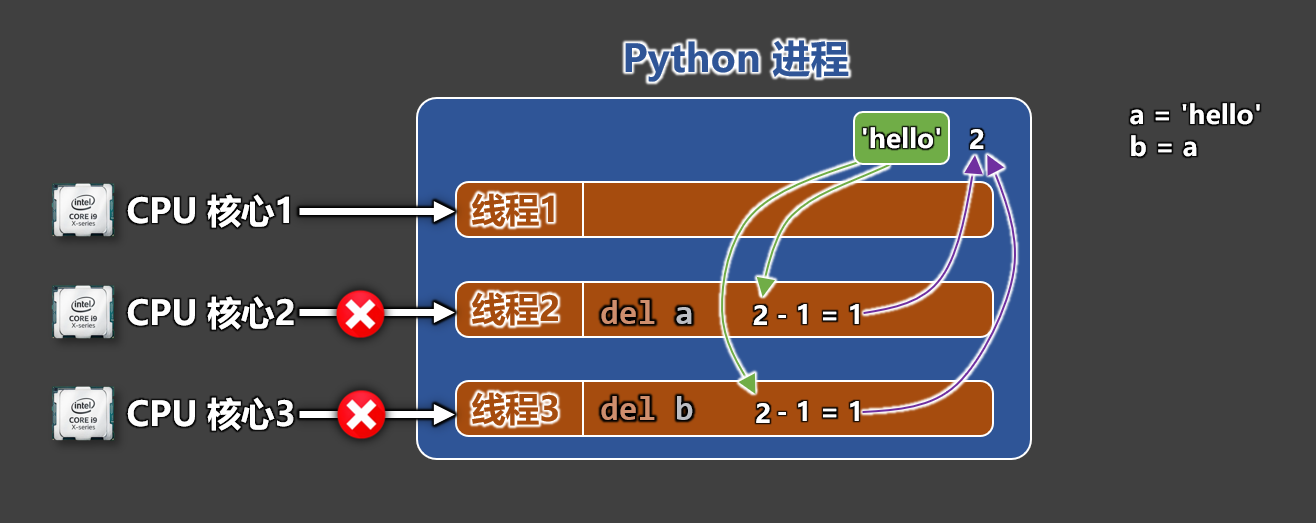
GIl 锁何时会被释放? —— 主动释放(遇到 I/O 操作)、被迫释放(任务超时)
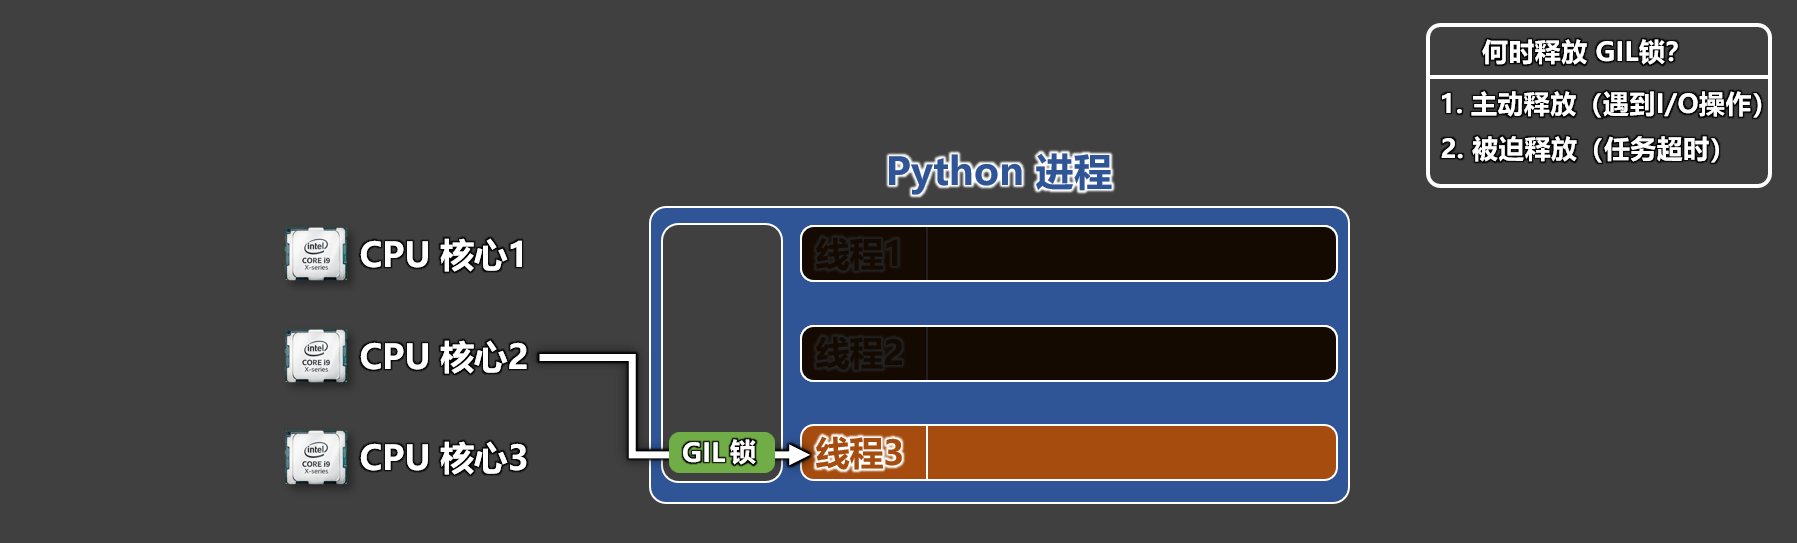
可以使用多进程来发挥多核 CPU 的性能
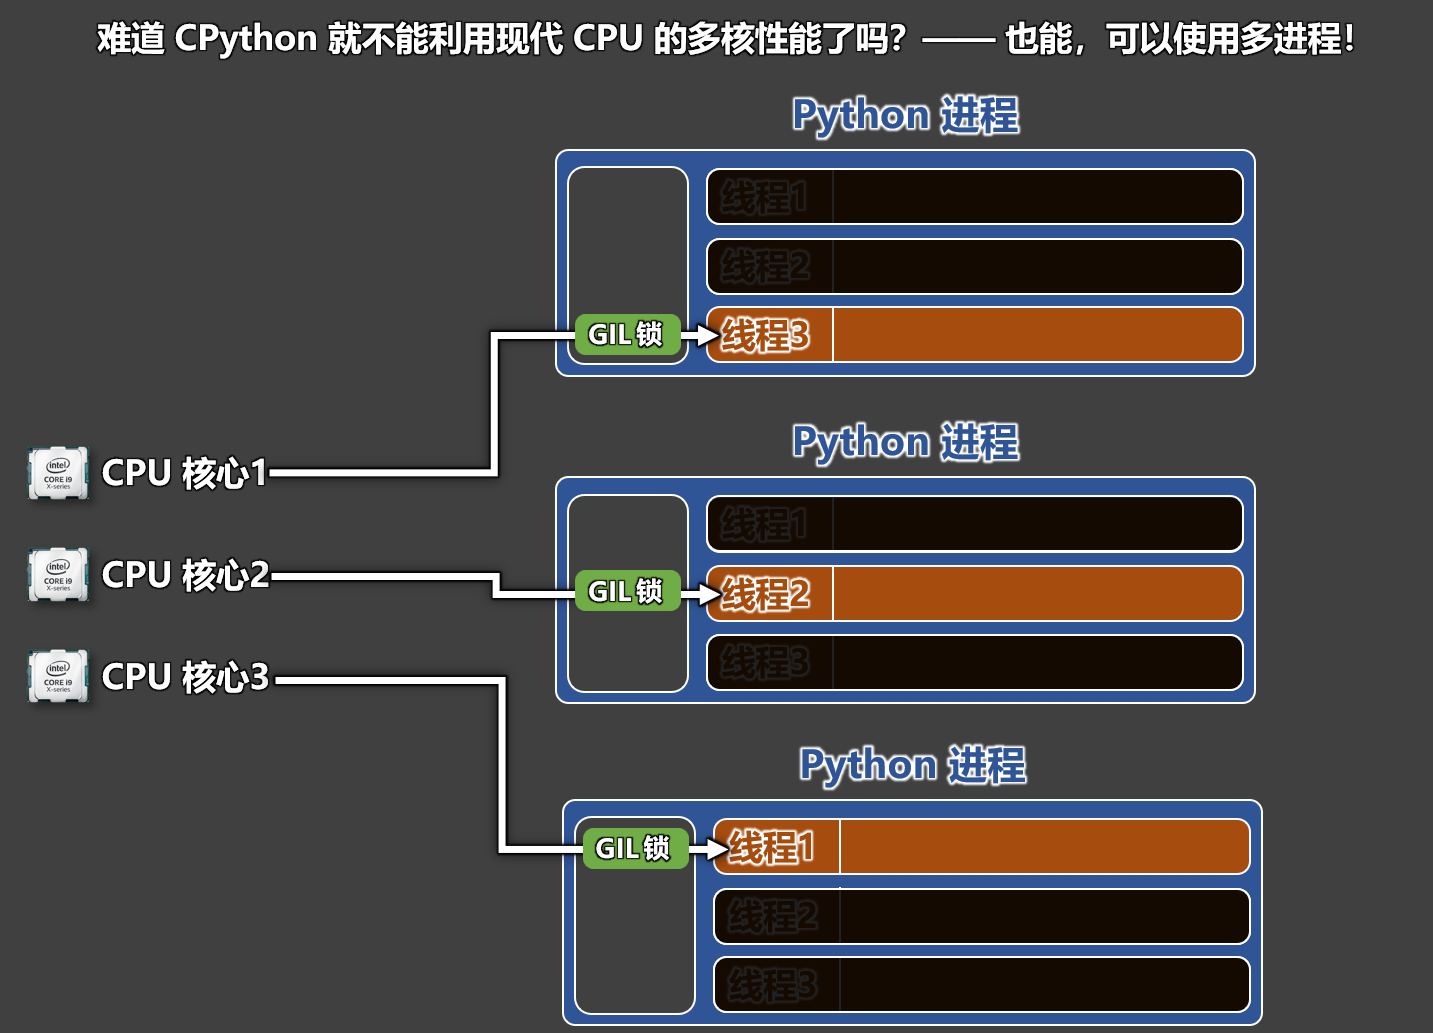
GIL 对比 lock/Rlock:
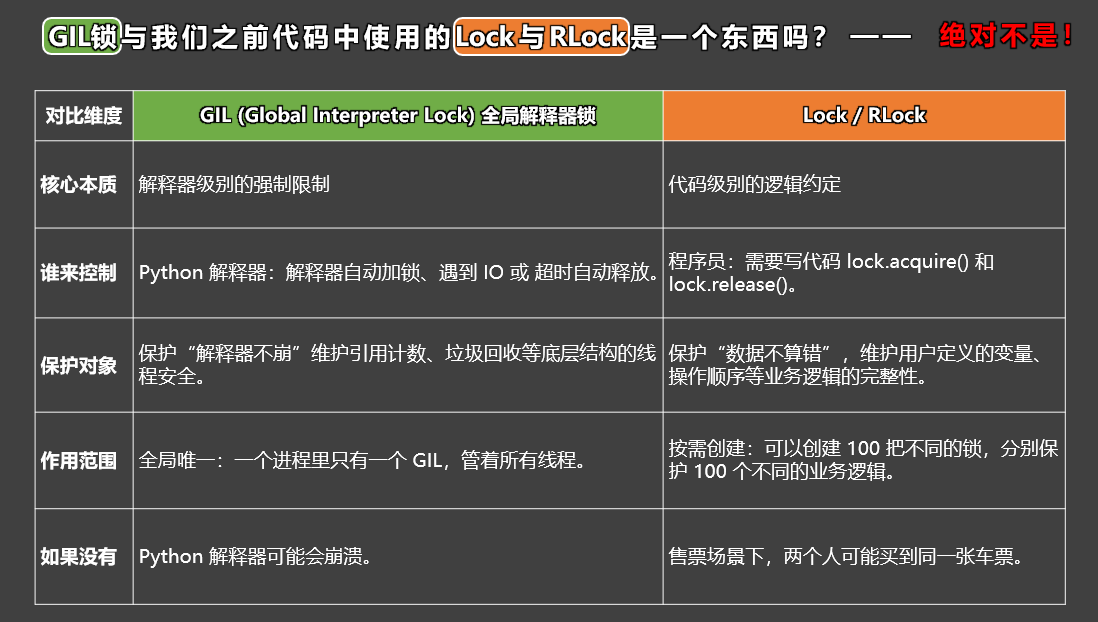
结论:GIL 为了确保 Cpython 解释器级别的数据安全,作为日常编码来说,我们对 GIL 是无感的,但对于 Lock/Rlock 是实际编码中使用较多的,Lock/Rlock是为了确保业务路基的完整,例如:
# GIL锁和编码时使用的 Lock 和 Rlock 不是同一个东西。
# Lock 和 Rlock是业务层面的锁,目标是:让业务逻辑别出错
# Rlock示例1:让打印是完整的
import time
from threading import Thread, RLock,current_thread
def show_info1(lock):
for index in range(10):
with lock:
print('尚', end='')
print('硅', end='')
print('谷')
def show_info2(lock):
for index in range(10):
with lock:
print('at', end='')
print('gui', end='')
print('gu')
if __name__ == '__main__':
lock = RLock()
t1 = Thread(target=show_info1, args=(lock,))
t2 = Thread(target=show_info2, args=(lock,))
t1.start()
t2.start()
# Rlock示例2:不要让两个窗口卖出同一张票
current = 1
def sale(lock):
global current
while True:
with lock:
if current <= 20:
print(f'{current_thread().name}出售了第{current}张票!')
current += 1
else:
print('票已售空')
break
time.sleep(0.3)
if __name__ == '__main__':
lock = RLock()
t1 = Thread(target=sale, name='窗口1', args=(lock,))
t2 = Thread(target=sale, name='窗口2', args=(lock,))
t3 = Thread(target=sale, name='窗口3', args=(lock,))
t1.start()
t2.start()
t3.start()
多进程 vs 多线程,该如何选择?
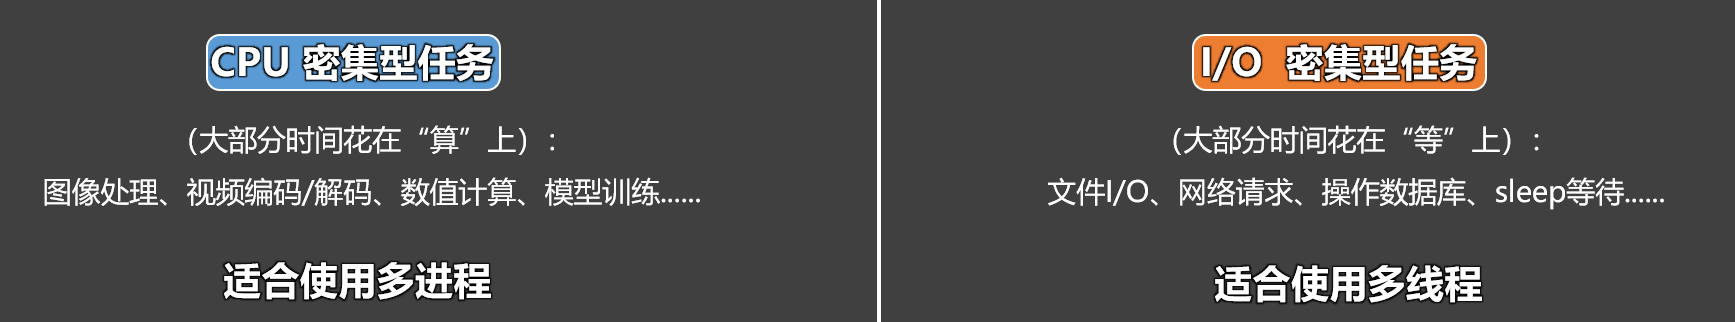
CPU密集型任务,更适合用多进程。
import time
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor
# 准备一个 CPU 密集型任务
def cpu_task(n):
print(f'任务{n}开始了')
total = 0
for i in range(10000000):
total += i * i
return total
if __name__ == '_main_':
print('===== 多进程完成【CPU密集型任务】=====')
start = time.time()
#开启四个进程进行计算
with ProcessPoolExecutor(4) as executor:
list(executor.map(cpu_task, [1, 2, 3, 4]))
end = time.time() - start
print(f'多进程总耗时:{end}秒')
# print('===== 多线程完成【CPU密集型任务】=====')
# start = time.time()
# # 开启四个线程进行计算
# with ThreadPoolExecutor(max_workers=4) as executor:
# results = list(executor.map(cpu_task, [1, 2, 3, 4]))
# end = time.time() - start
# print(f'多线程总耗时:{end}秒')
IO密集型任务,更适合用多线程。
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor
# 拷贝文件
def copy_file(index):
with open('a.zip', 'rb') as src, open(f'a_副本{index}.zip', 'wb') as dst:
while True:
data = src.read(1024 * 1024) # 每次读 1MB
if not data:
break
dst.write(data)
if __name__ == '__main__':
# print('===== 使用多进程完成【IO密集型任务】 =====')
# start = time.time()
# with ProcessPoolExecutor(4) as executor:
# for i in range(4):
# executor.submit(copy_file, i)
# end = time.time() - start
# print(f'多进程耗时:{end} 秒')
print('===== 使用多线程完成【IO密集型任务】 =====')
start = time.time()
with ThreadPoolExecutor(4) as executor:
for i in range(4):
executor.submit(copy_file, i)
end = time.time() - start
print(f'多线程耗时:{end} 秒')
第 14 章 协程
什么是协程
概念:协程(Coroutine),是一种线程内部的任务调度机制,它通过事件循环,在用户态中实现任务的挂起与恢复执行,从而在遇到 IO 操作时,不让 CPU 等待,而是继续执行其它需要 CPU 的任务。
:::info
协程的本质就是:在一个线程里,趁着某些任务在等 IO,把 CPU 交给其它任务去用。
:::
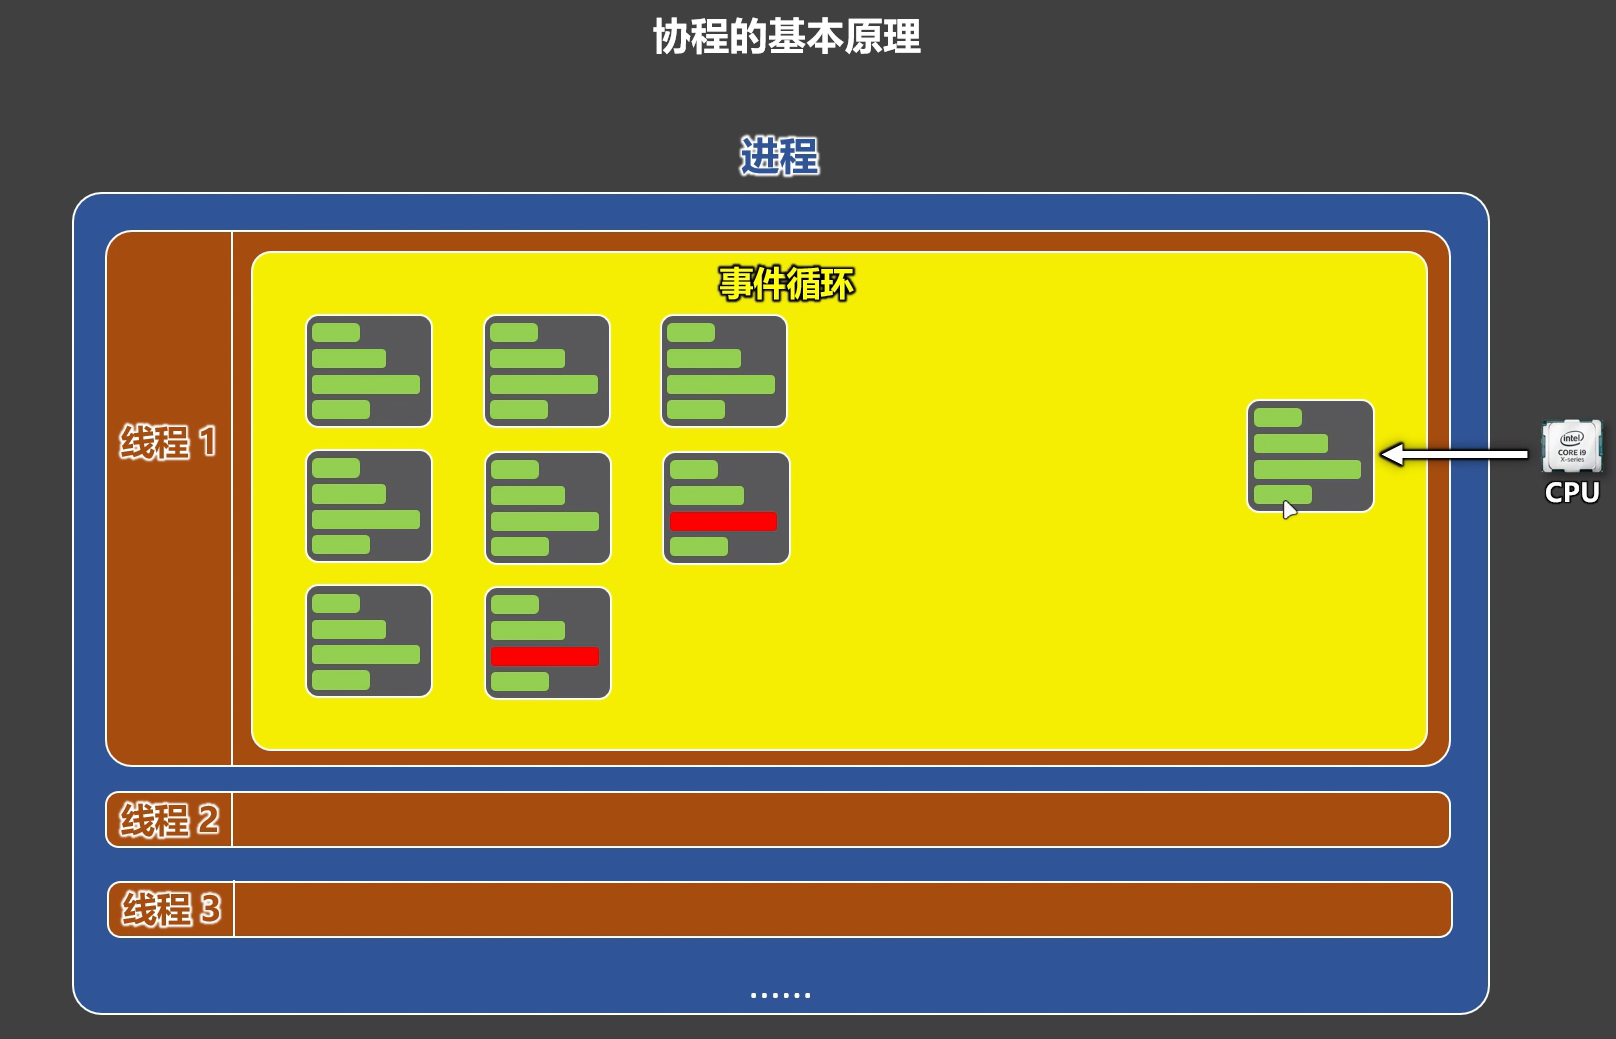
**关键点1️⃣:协程不是线程,也不是进程 **
:::color3
- 协程不是操作系统提供的,并且 CPU 看不见协程。
- 操作系统不知道协程的存在。
- 协程是程序员在用户态,用代码“设计出来”的任务切换机制。
:::
关键点2️⃣:协程发生在一个线程内部
:::color3
- 协程不是线程之间的切换。
- 而是线程内部多个任务之间的切换。
- 本质是一个线程里,写了很多任务,由事件循环统一调度。
:::
关键点3️⃣:协程的核心能力:挂起与恢复
:::color3
- 当任务 遇到 IO 操作 时:任务会被挂起。
- 当 IO 操作完成后:任务会被恢复执行。
:::
关键点4️⃣:协程依赖一个关键角色:事件循环
:::color3
- 事件循环负责:调度任务、判断是否该挂起、决定何时恢复执行,事件循环是协程系统的“大脑”
:::
关键点5️⃣:协程的目标是尽量减少线程切换
:::color3
- 在单线程场景下,最大化 CPU 利用率,特别适合 IO 密集型任务
:::
协程函数 vs 协程对象
- 协程函数(coroutine Function):使用『async关键字』修饰的函数,就是协程函数。
- 协程对象(coroutine Object):调用『协程函数』,就会得到『协程对象』。
注意:调用『协程函数』,并不会执行『协程函数』中的代码。
# 定义一个协程函数
async def work():
print('work开始')
print('work执行中......')
print('work结束')
return '工作结果'
# 调用协程函数,会得到协程对象
coroutine_object = work()
将协程对象交给asyncio.run(),asyncio.run()会将协程对象包装成一个任务交给事件循环。
# asyncio.run 方法做了3件事:
# 1.创建一个事件循环。
# 2.将收到的协程对象,包装成一个任务(task),交给事件循环。
# 3.启动事件循环。
# 注意:asyncio.run 会阻塞当前线程,直到任务执行完毕,并返回该任务 return 的最终结果。
result = asyncio.run(coroutine_object)
print(result)
await 关键字
await 关键有三个作用:
- 挂起:await 会暂停当前协程的执行。
- 等待:遇到 await 关键字,事件循环会立即安排 await 后面的对象去执行,并等待该对象执行完成,并且可以拿到执行结果。
:::info
💡****关键点:在执行 await 后面的对象时,会出现两种情况:
- 情况一:如果在执行该对象中的代码时,遇到了【await I/O操作】(需要等待外部资源返回结果的操作)例如:网络请求、文件读写等,那 CPU 的控制权就会交给事件循环。事件循环会去调度循环中的其他任务(如果有的话)。
- 情况二:如果该对象中的代码,不包含任何【await I/O操作】。例如:print打印、数学计算、逻辑计算等。此时事件循环拿不到 CPU 控制权,无法调度循环中的其他任务,不会发生任务切换。
:::
- 恢复:当 await 后的对象执行完毕,事件循环会恢复之前被挂起的协程,该协程会从当时挂起的位置继续执行,并拿到返回值。
🚨****注意:await 后面只能写『可等待对象』,常见可等待对象有:协程对象、Future对象、Task对象。
import asyncio
async def work():
print('work开始')
print('work执行中......')
# await去等待一个协程对象(靠asyncio.sleep方法,返回一个协程对象)
res = await asyncio.sleep(2)
print(res)
print('work结束')
return '工作结果'
async def main():
print('main开始')
# await去等待一个协程对象(靠自己去编写协程函数,随后调用该函数来得到协程对象)
res = await work()
print(res)
print('main结束')
return 'main的返回值'
result = asyncio.run(main())
print(result)
多个任务同步执行
使用 await 实现多个任务同步执行
import asyncio
import time
# 定义一个协程函数
async def work(n, delay):
print(f'work{n}开始')
print(f'work{n}执行中......')
# 模拟一个IO等待
await asyncio.sleep(delay)
print(f'work{n}结束')
return f'work{n}的返回值'
async def main():
print('main开始')
start = time.time()
# 调用三次work函数,分别得到三个协程对象
coroutine1 = work(1, 2)
coroutine2 = work(2, 2)
coroutine3 = work(3, 2)
# 此处会等待coroutine1执行完成
res1 = await coroutine1
print(res1)
# 等待上面的coroutine1完成后,再等待coroutine2完成
res2 = await coroutine2
print(res2)
# 等待上面的coroutine2完成后,再等待coroutine3完成
res3 = await coroutine3
print(res3)
print('main结束', time.time() - start)
return '我是main的返回值'
# 将协程对象交给事件循环
result = asyncio.run(main())
print(result)
多个任务异步执行
使用asyncio.create_task()方法向事件循环中添加任务,从而实现多个任务异步执行。
import asyncio
import time
# 定义一个协程函数
async def work(n, delay):
print(f'work{n}开始')
print(f'work{n}执行中......')
# 模拟一个IO等待
await asyncio.sleep(delay)
print(f'work{n}结束')
return f'work{n}的返回值'
async def main():
print('main开始')
start = time.time()
# asyncio.create_task 会把一个协程对象包装成一个可被事件循环调度的任务,并注册到事件循环中
task1 = asyncio.create_task(work(1, 2))
task2 = asyncio.create_task(work(2, 2))
task3 = asyncio.create_task(work(3, 2))
# 此处会等待task1执行完成
res1 = await task1
print(res1)
# 等待上面的task1完成后,再等待task2完成
res2 = await task2
print(res2)
# 等待上面的task2完成后,再等待task3完成
res3 = await task3
print(res3)
print('main结束', time.time() - start)
return '我是main的返回值'
# 将协程对象交给事件循环
result = asyncio.run(main())
print(result)
asyncio.gather
asyncio.gather方法可以把多个协程对象丢给事件循环,并在全部执行完后,一次性拿到所有结果。
import asyncio
import time
# 定义一个协程函数
async def work(n, delay):
print(f'work{n}开始')
print(f'work{n}执行中......')
# 模拟一个IO等待
await asyncio.sleep(delay)
print(f'work{n}结束')
return f'work{n}的返回值'
async def main():
print('main开始')
start = time.time()
# 把多个协程对象同时丢给事件循环,并在全部执行完后,一次性拿到所有结果。
result = await asyncio.gather(work(1, 2), work(2, 2), work(3, 2))
print(result)
print('main结束', time.time() - start)
return '我是main的返回值'
# 将协程对象交给事件循环
result = asyncio.run(main())
print(result)
下载图片案例
1️⃣使用传统方式下载图片:
如下代码的特点:图片是一张一张下载的,当前图片没有下载完成,后一张图片的下载就不能开始,这属于典型的同步下载。
import requests
def download_picture(url):
print(f'开始下载:{url}')
# 发送网络请求,获取这张图片
response = requests.get(url)
print('下载完毕')
# 保存图片到本地
with open(url[-10:], 'wb') as file:
file.write(response.content)
def main():
url_list = [
'https://n.sinaimg.cn/spider20260129/217/w600h417/20260129/3e26-917ee55a8a42b8626807c332c24981de.png',
'https://n.sinaimg.cn/finance/transform/97/w630h267/20260129/97c4-b211cc51784830f09ee19e450475c93b.png',
'https://n.sinaimg.cn/spider20260129/539/w1439h700/20260129/e09a-cc2ca319e00f701ccfca3ebc62aa8772.png'
]
for url in url_list:
download_picture(url)
main()
2️⃣使用协程方式下载图:
如下代码的特点:多张图片会几乎同时发起下载请求,当某一张图片在等待网络数据返回时,其它图片的下载任务并不会被阻塞,而是可以继续执行,这属于典型的协程并发下载。
import aiohttp
import asyncio
async def download_picture(session, url):
print(f'开始下载:{url}')
# 发送网络请求,获取这张图片,请求发出去后,要等待服务器把数据返回,等的这段时间就是IO等待
response = await session.get(url)
# 等待数据(图片数据可能分多次传输,需要等待数据全部读完,等的这段时间也是IO等待)
content = await response.read()
print('下载完毕')
# 保存图片到本地
with open(url[-10:], 'wb') as file:
file.write(content)
# 释放连接资源(告诉 aiohttp,这个连接我不用了,你可以回收了)
await response.release()
async def main():
url_list = [
'https://n.sinaimg.cn/spider20260129/217/w600h417/20260129/3e26-917ee55a8a42b8626807c332c24981de.png',
'https://n.sinaimg.cn/finance/transform/97/w630h267/20260129/97c4-b211cc51784830f09ee19e450475c93b.png',
'https://n.sinaimg.cn/spider20260129/539/w1439h700/20260129/e09a-cc2ca319e00f701ccfca3ebc62aa8772.png'
]
# 创建会话对象(发请求的工具)
session = aiohttp.ClientSession()
# 创建多个协程对象
coroutine_list = [download_picture(session, url) for url in url_list]
# 将多个协程对象交给事件循环
await asyncio.gather(*coroutine_list)
# 关闭会话
await session.close()
asyncio.run(main())

 浙公网安备 33010602011771号