
Link Prediction Based on Graph Neural Networks
概
这篇工作 的延续的工作. 依旧是基于目标 link 附件的子图进行预测, 不过本文把这种子图的转换和普通的启发式的指标联系起来, 大概意思就是想要证明, 这些启发式的方法可以看成是在子图上进行转换的一种特例.
符号说明
- \(V\), nodes;
- \(E\), edges;
- \(G = (V, E)\);
- \(A\), 邻接矩阵;
- \(\Gamma(x)\), 1-hop neighbors of \(x\);
- \(d(x, y)\), shortest path distance between \(x\) and \(y\);
Link prediction heuristics
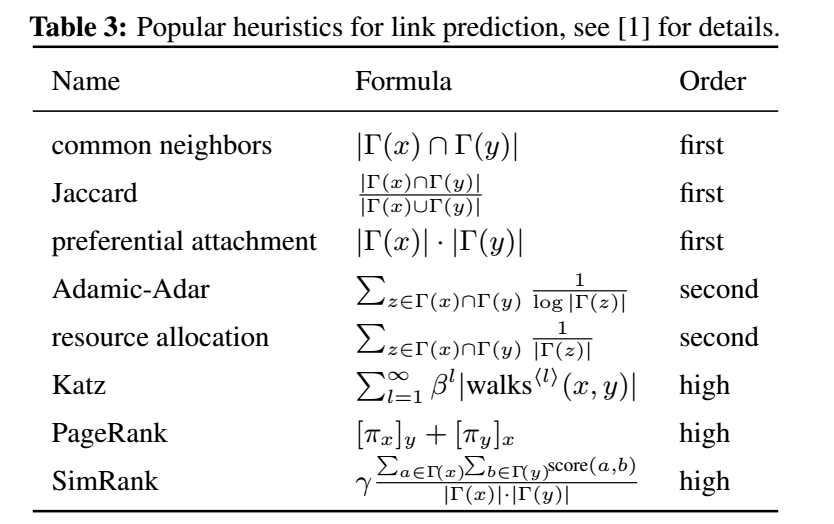
如上图所示, 有很多方法会采样上述启发式的基于图的指标用于 link prediction 任务, 作者在本文证明大部分指标实际上都是 \(\gamma\)-decating heuristic
的一种特例. 而这种指标在满足一定条件下, 可以通过 \((x, y)\) 附件的 \(h\)-order 子图 \(G_{x, y}^h\) 来近似. 于是, 很自然地, 我们寄希望于 GNN 自动地从 \(G_{x, y}^h\) 学到合适指标, 而不是启发式地指定.
注: 证明请看原文, 感觉没有之前那篇那么惊艳.
SEAL

-
如上图所示, 对于所关注的边 (可以是本身是存在的边对应预测标签为 1, 也可以是不存在的边对应预测标签为 0) 提取对应的 \(h\)-order 子图.
-
接下来, 为这些结点进行排序:
- 目标结点 \((x, y)\) 的序为 1;
- 若结点 \(z\) 满足 \(d(x, z) = 1, d(y, z) = 2\), 则序为 3;
- 若结点 \(z\) 满足 \(d(x, z) = 1, d(y, z) = 3\), 则序为 4;
- 若结点 \(z\) 满足 \(d(x, z) = 2, d(y, z) = 2\), 则序为 5;
- 若结点 \(z\) 满足 \(d(x, z) = 1, d(y, z) = 4\), 则序为 6;
- 若结点 \(z\) 满足 \(d(x, z) = 2, d(y, z) = 3\), 则序为 7;
- 以此类推...
-
这一步也可以通过如下的 hash 函数得到:
\[f_l(i) = 1 + \min(d_x, d_y) + (d / 2) [(d / 2) + (d\%2) - 1]. \]注意, 这里 \(d_x := d(x, i), d_y := d(y, i), d := d_x + d_y\), \(d / 2\) 表示integer quotient.
-
这么做主要是为了保证:
- 两个目标结点 \(x, y\) 的标签为 \(1\);
- 若结点 \(i, j\) 有 \(d(x, i) = d(x, j), d(y,i) = d(y, j)\) 则两个结点的序是一致的.
-
有了序之后, 就可以将子图连同它的结点表示 \(X\) 一起喂入 GNN 提取最后特征用于 link prediction. 需要特别说明的是, 当结点表示 \(X\) 为 embeddings 的时候, 如果负样本 \(E_n\) 和 \(E\) 没有交集, 则会导致很容易过拟合. 所以在实际上中, 作者会采用 \(G = (V, E_n \cup E)\) 的图来进行训练 (边包含负样本).

 浙公网安备 33010602011771号