
AC自动机 & 学习笔记
又一神秘字符串匹配算法。
前言
昨天晚上LZY发现自己的对拍有锅,急忙去修,最终成功将其倒退了一个版本。
介绍
AC 自动机是一种多模式串匹配算法,由 Alfred V. Aho 和 Margaret J.Corasick 发明,所以AC自动机的全名是:
有A有C但没有AC
AC自动机的主要作用便是让多个模式串去匹配一个文本串
听起来有点像KMP?
确实用到了KMP的思想,此外也用到的Trie树,所以AC自动机是Trie树上的自动机。
所以不会KMP和Trie树的请掉头。
下面我们详细说明AC自动机的算法过程。
过程
回忆KMP
我们首先回忆一下你kmp是如何匹配的。
假设文本串为abacabababc,模式串为abab,假设预处理已完成,现在进行匹配。
首先我们很顺利的匹配了三个字符:
abacabababc
^^^!
abab
发现下一个字符匹配不上,KMP没有放弃所有已匹配的结果,既然已经匹配上了aba为什么不让a继续进行匹配呢?
abacabababc
  ^!
  ab
发现从a开始匹配还是匹配不上,于是只能从头开始了。
abacabababc
   !
   a
匹配不上,跳过!
abacabababc
    ^
    a
abacabababc
    ^^^^
    abab
成功匹上一个模式串!但模式串后面没有了,所以我们让模式串的公共前后缀ab继续匹配。
abacabababc
      ^^
      ab
abacabababc
      ^^^^
      abab
又成功匹配上一个模式串!后面就没有了,匹配完成。
可以发现KMP的思想就是能不省就不省,最大化利用已经匹配好的串继续向下匹配。
AC自动机上的匹配
AC自动机上的匹配与KMP的匹配大同小异,唯一不同的地方就是失配后的决策。
- KMP在失配后会将当前最长公共前后缀移上来继续尝试匹配。
- AC自动机在失配后会尝试通过去除已经匹配的部分的一段前缀继续尝试匹配。
失配决策不一样的原因就在于AC自动机处理的是多模式串匹配,在其中一个没匹配上的时候,AC自动机会尝试匹配别的串。
这样说好像有点不太对,举个例子就明白了:
有五个模式串:her、she、sheighter、hter、thought,与一个文本串:shersheighthoughter。
shersheighthoughter
^^^
she
sheighter
首先she与sheighter都匹配上了she,she完成了匹配,但sheighter将在下一步失配。
于是考虑去除she的s前缀。
hersheighthoughter
^^
her
取出后sheighter与she由于没有开头的s无法继续匹配,但her可以继续尝试匹配。
hersheighthoughter
^^^
her
her匹配成功,由于无论尝试去除任何her的前缀对无法尝试新的匹配,所以直接去除整串整串也是前缀的一种。
sheighthoughter
^^^
she
sheighter
she再次完成匹配,由于sheighter还可以继续尝试匹配,所以我们先不去除前缀。
sheighthoughter
^^^^^^^!
sheighter
sheighter无法继续匹配,尝试去除前缀sheig。
hthoughter
^^
hter
去除后hter尝试匹配。
hthoughter
^^!
hter
匹配失败尝试去除前缀h。
thoughter
^^
thought
去除后thought,尝试匹配。
thoughter
^^^^^^^
thought
匹配成功,尝试去除前缀thoug继续匹配。
hter
^^
hter
去除后hter尝试匹配。
hter
^^^^
hter
匹配成功,算法结束。
以上就是AC自动机多模式串匹配的步骤,先别说你会不会写,但你肯定大概理解了。
Trie树优化匹配
上面那一堆找了一堆前缀,找前缀这活得找“专业人士”Trie树来干。
我们将上面一堆模式串扔进一颗Trie树里,就会得到这样的东西:

怎么画出来这么一个玩意
我习惯将字符标到节点上。
我们都知道,Trie树上的每一个点都表示一个字符串,那么我们完全可以整一个失配指针(\(fail\))指向每一个节点失配后去除前缀后的后缀部分。
就拿上面这一步举例:
sheighthoughter
^^^^^^^!
sheighter
sheighter无法继续匹配,尝试去除前缀sheig。
我们完全可以将sheight节点的 \(fail\) 指向ht。

这样就可以快速找到下一个要匹配的串。
但说这么多,这个失配指针该这么指呢?
在Trie树中,每一个节点都有一堆指针,表示下一个字符,像sheigh这个节点,只有一个指向下一个节点sheigh的指针,为什么我们不尝试将sheigh指针在指向he与ht呢?
假设sheigh已经指向了he与ht,那么在找sheight的失配指针的时候,直接找它父亲所指向t的节点就找到了。
为什么可以让sheigh指向he与ht呢?
观察一下如果将sheigh的前缀扔掉,剩下h那么h这个字符串在往后接就可以接成he与ht也就是说sheigh的后缀与he、ht的前缀有公共部分,这样如果sheight这个t失配了,sheigh可以通过去除前缀到达ht这个串。
具体过程请看代码实现:
struct node{
	int son[26];                    //子节点指针
	int fail;                       //失配指针
	void init(){                    //初始化
		memset(son,0,sizeof(son));
		ans=fail=id=0;
	}
}T[NUM];
void insert(string s){              //插入一个节点,Trie树操作
	int u=0;
	for(char i:s){
		int &son=T[u].son[i-'a'];
		if(!son) son=++tot,T[son].init();
		u=son;
	}
}
void build(){                        //构建fail指针
	queue<int> q;
	for(int i=0;i<26;++i){
		if(T[0].son[i]) q.push(T[0].son[i]);  //先将跟的子节点入队
	}
	while(!q.empty()){
		int u=q.front();             //取出队首
		q.pop();
		for(int i=0;i<26;++i){
			if(T[u].son[i]){         //如果有这个子节点
				T[T[u].son[i]].fail=T[T[u].fail].son[i];  //子节点的fail就指向当前节点fail的对应节点。
				q.push(T[u].son[i]);
			}else{
				T[u].son[i]=T[T[u].fail].son[i];  //将子节点指向fail的对应子节点
			}
		}
	}
}
另附一张来自oi-wiki的图:
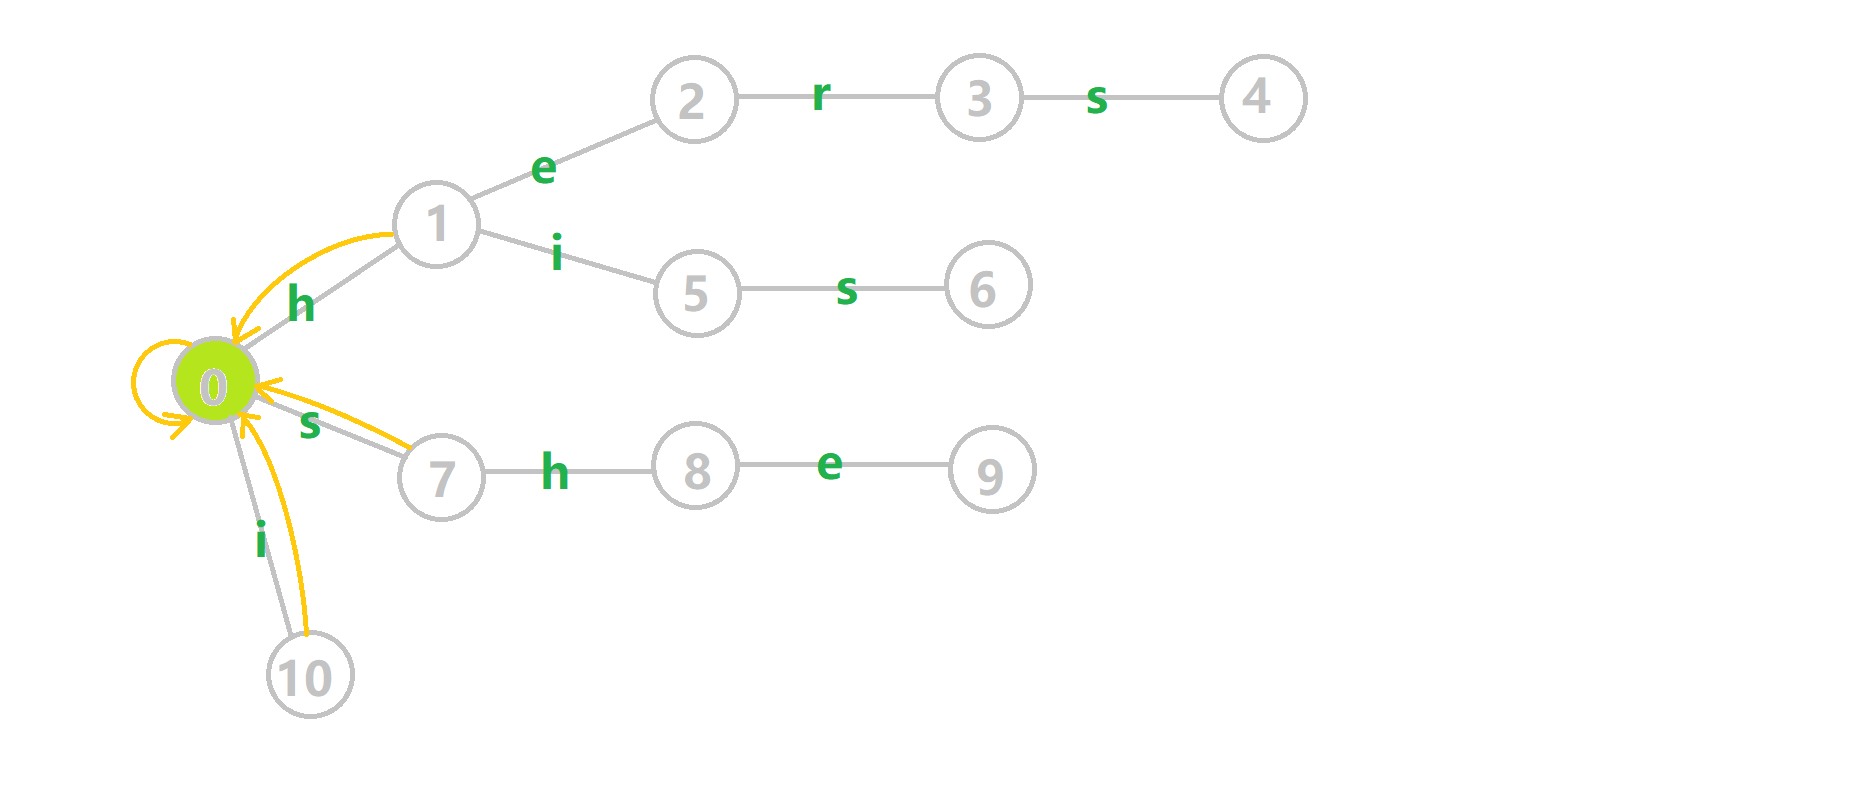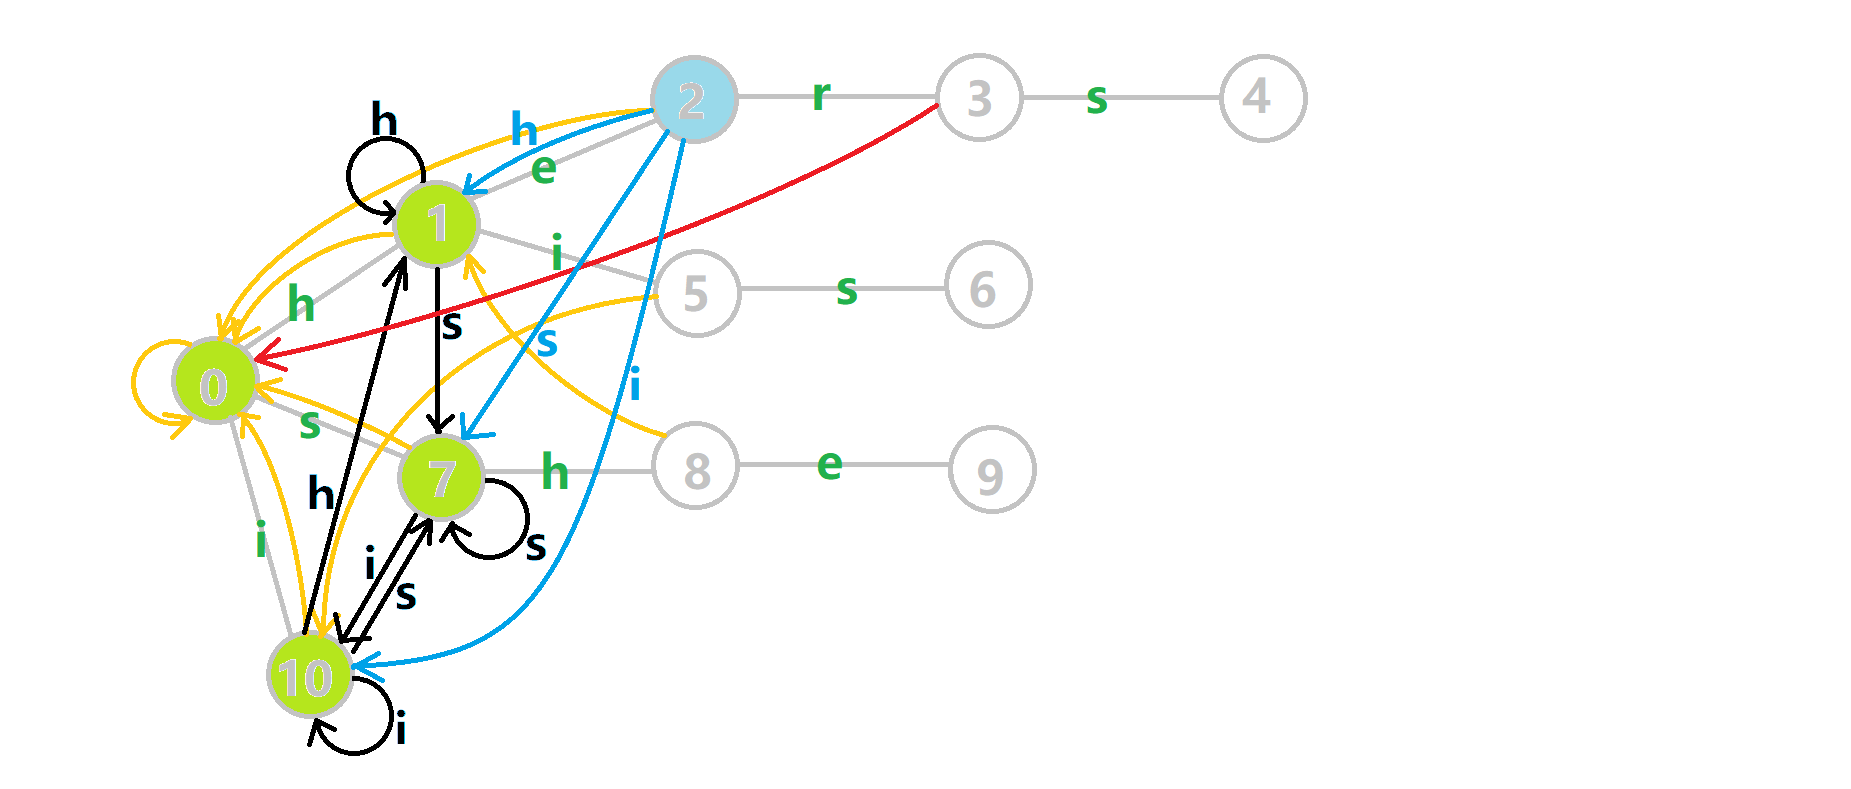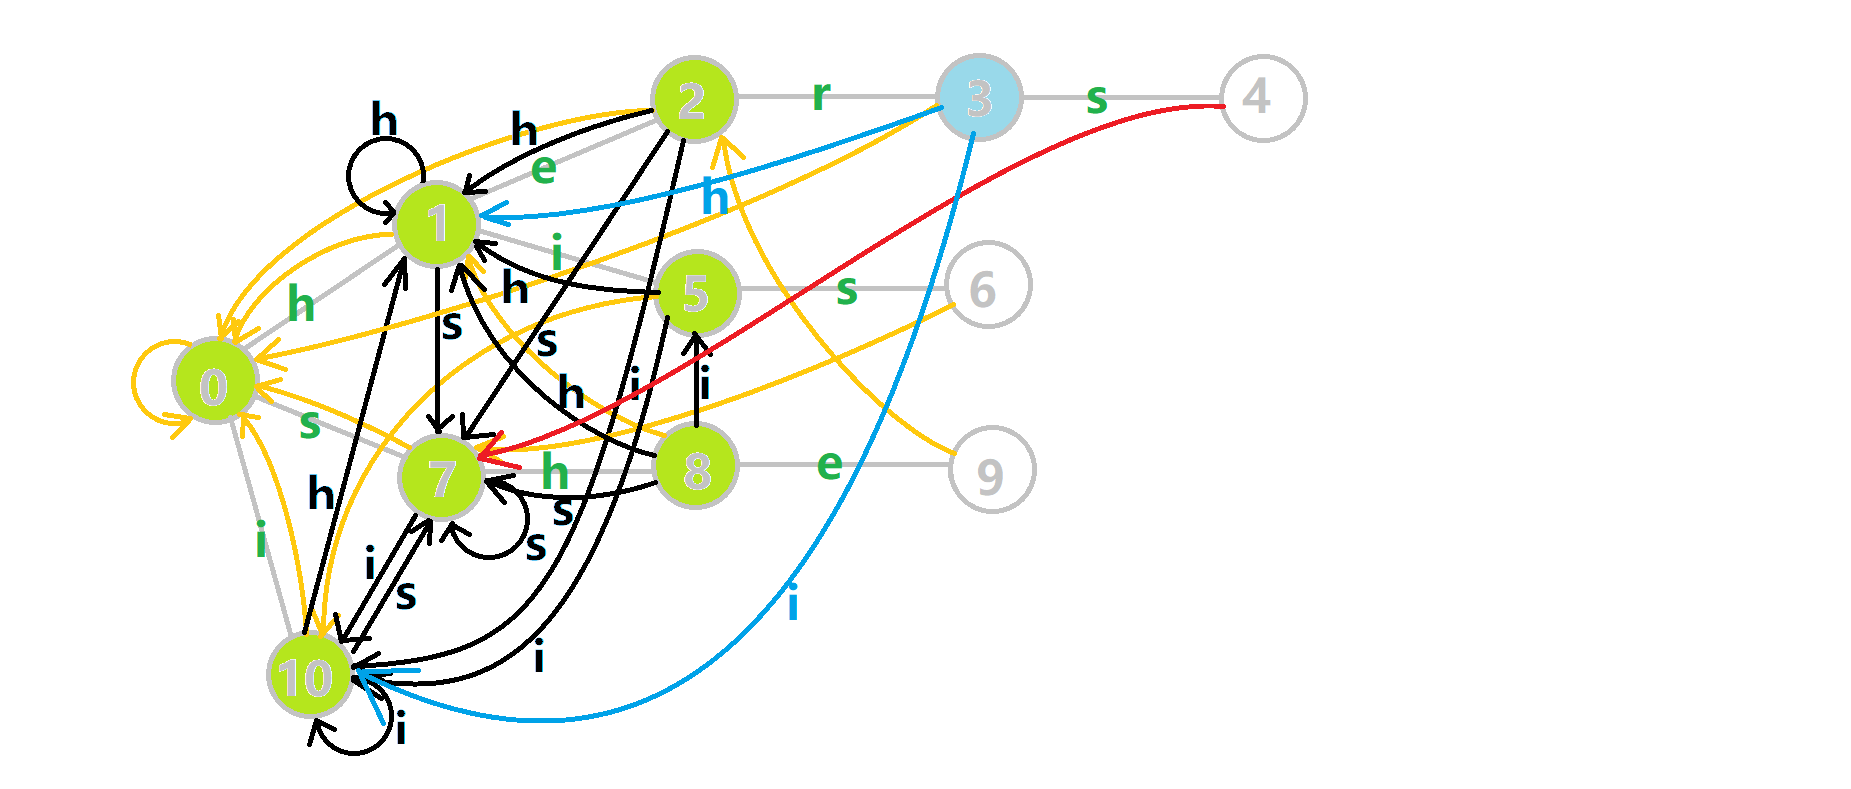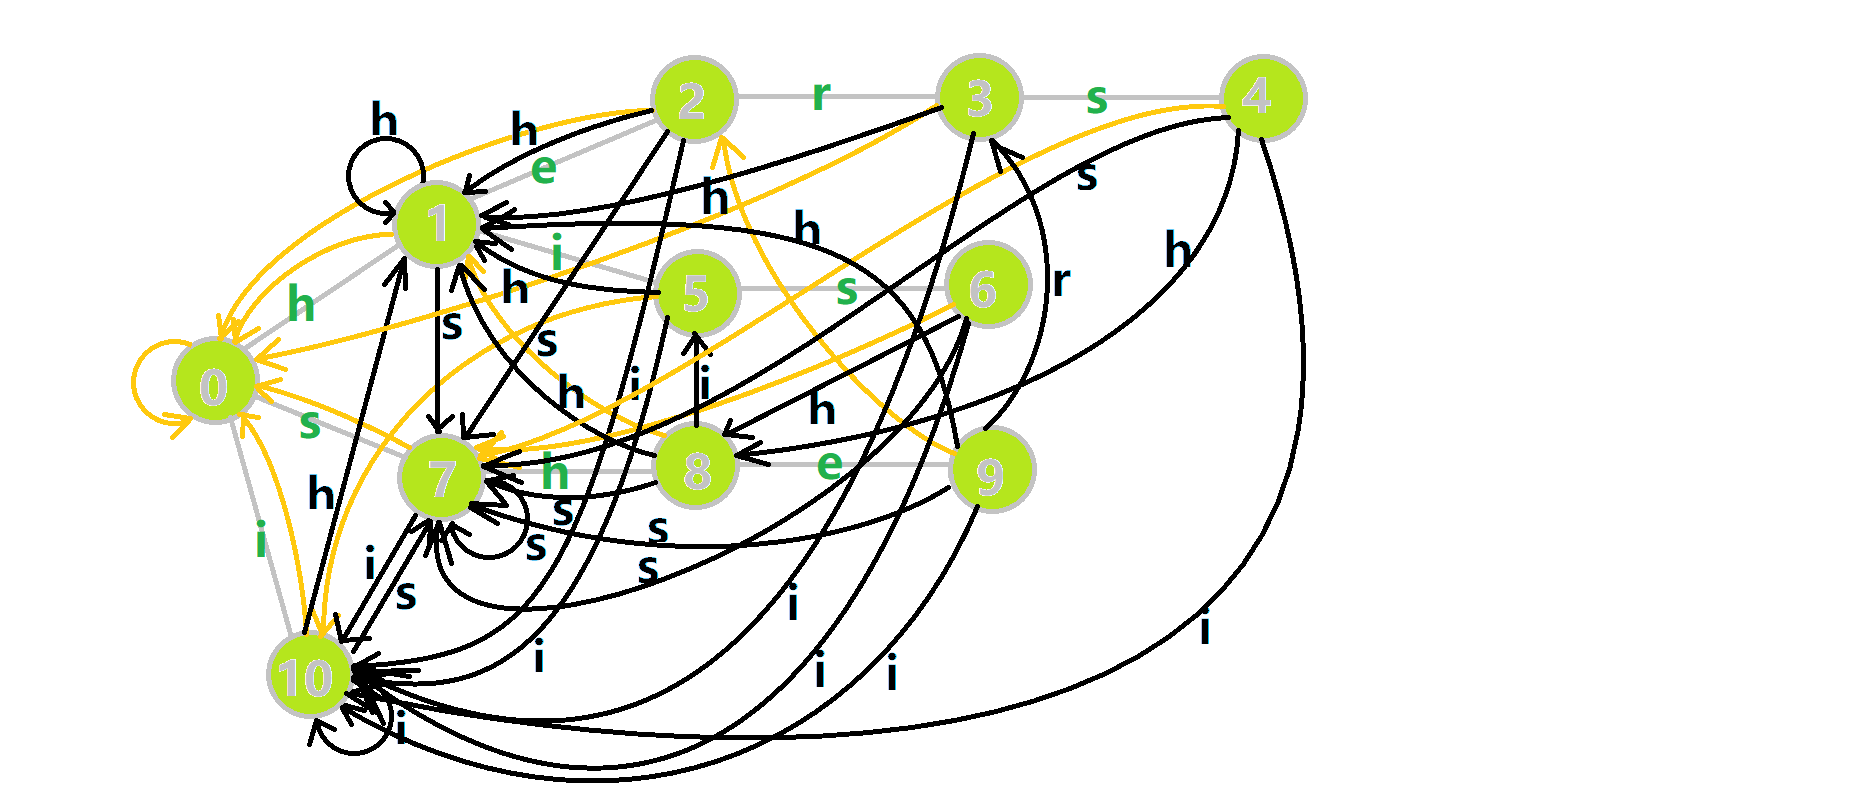
可以手摸一下理解其过程。
统计答案
先附上一张来自oi-wiki的图:
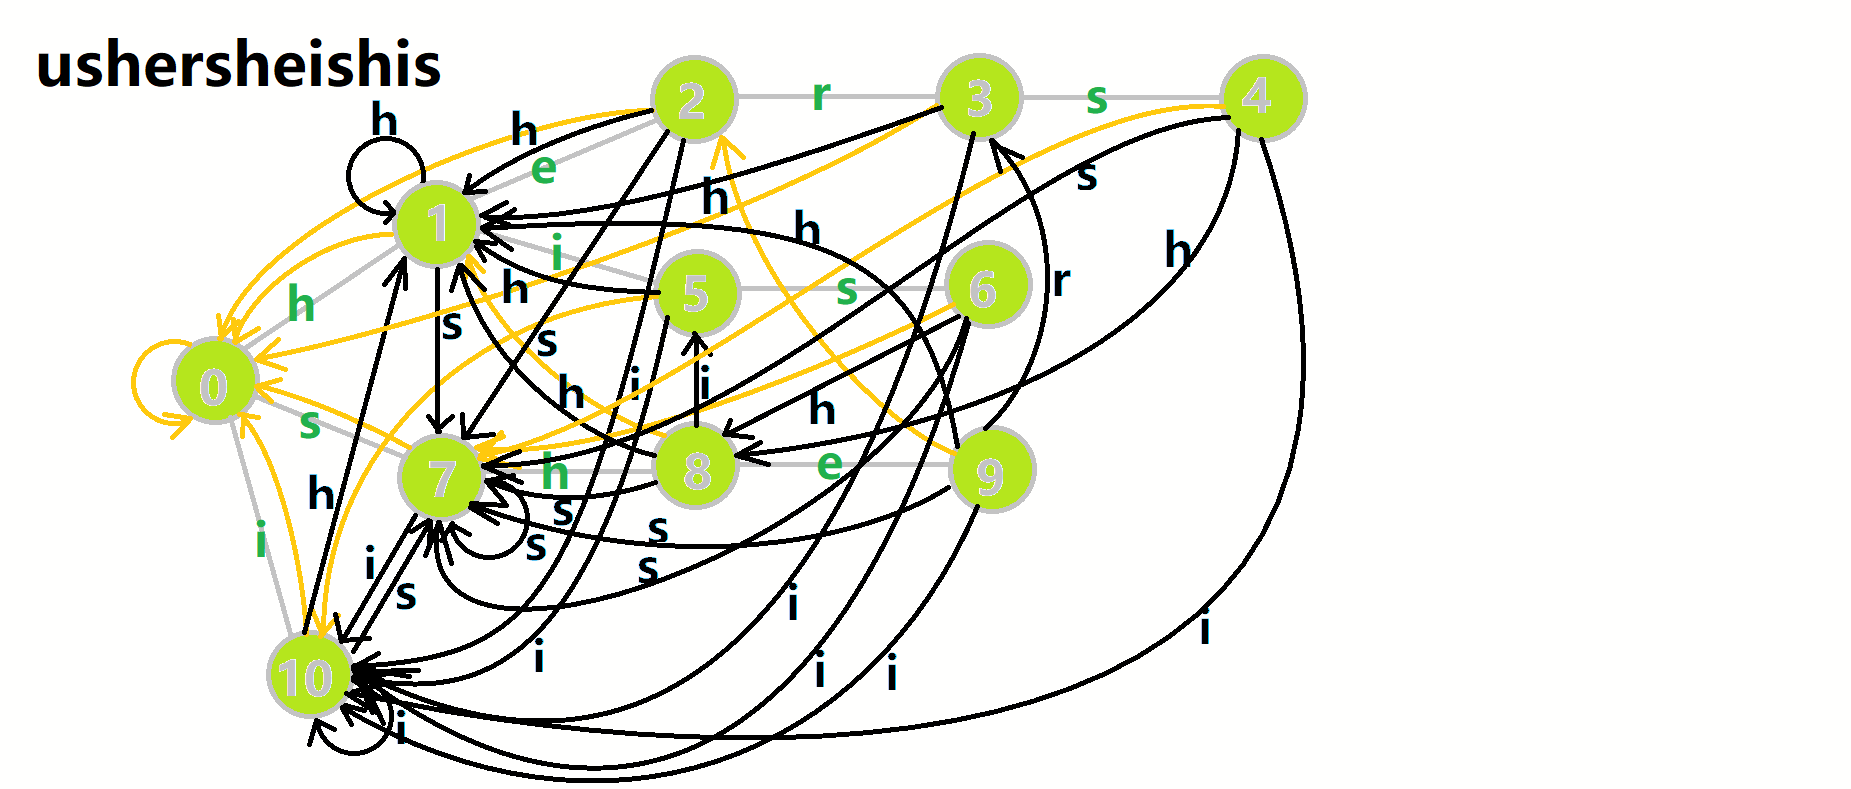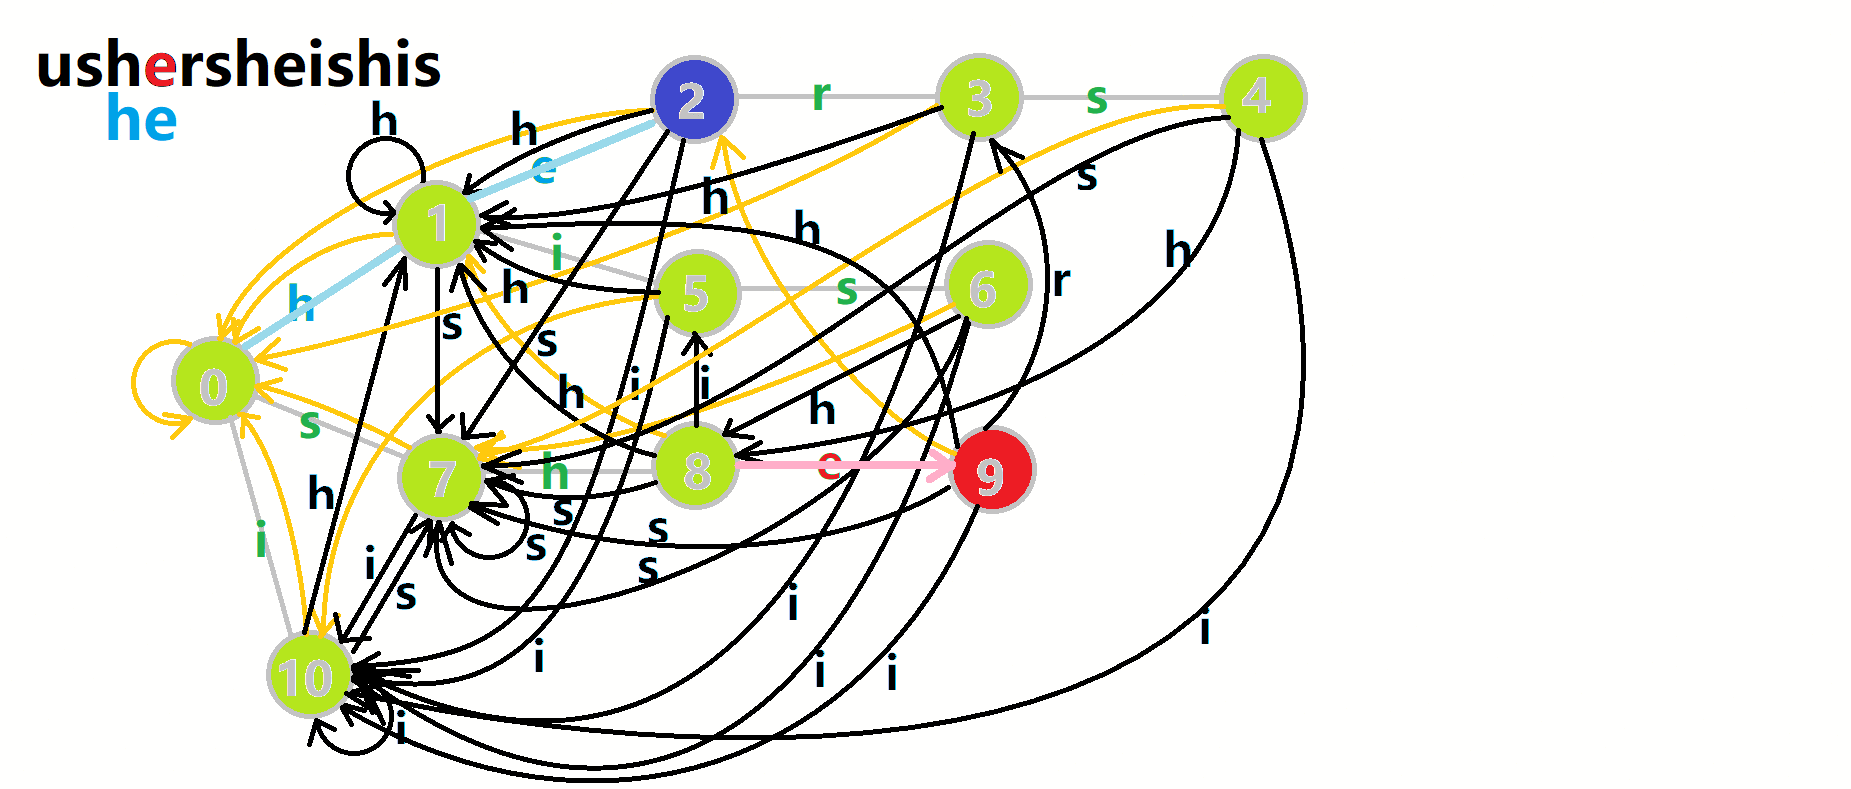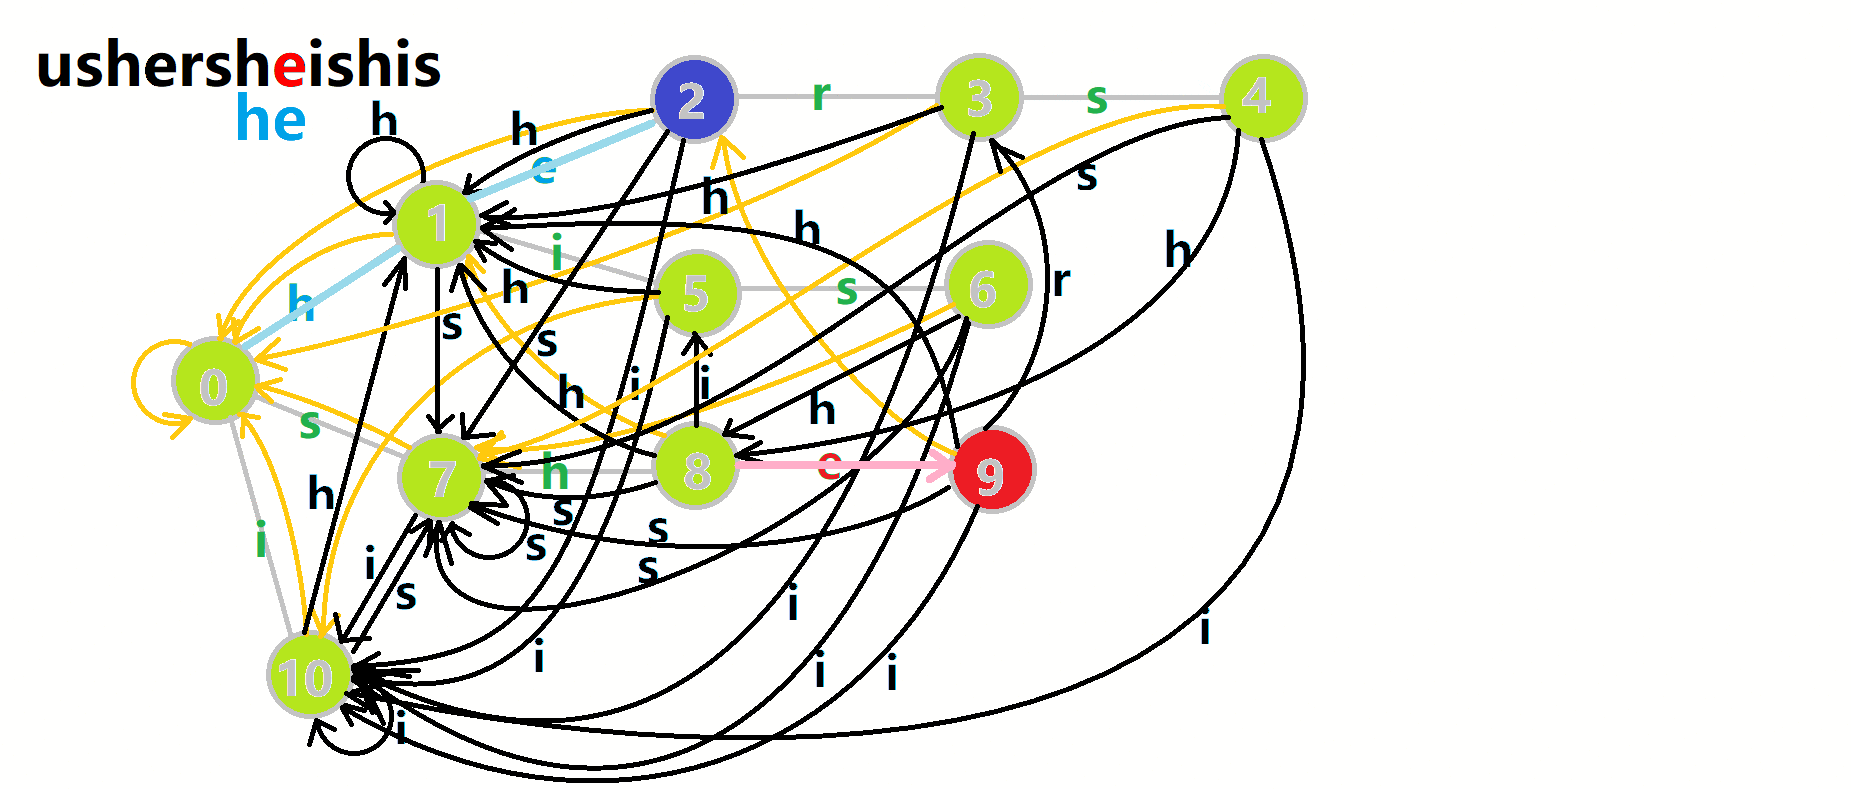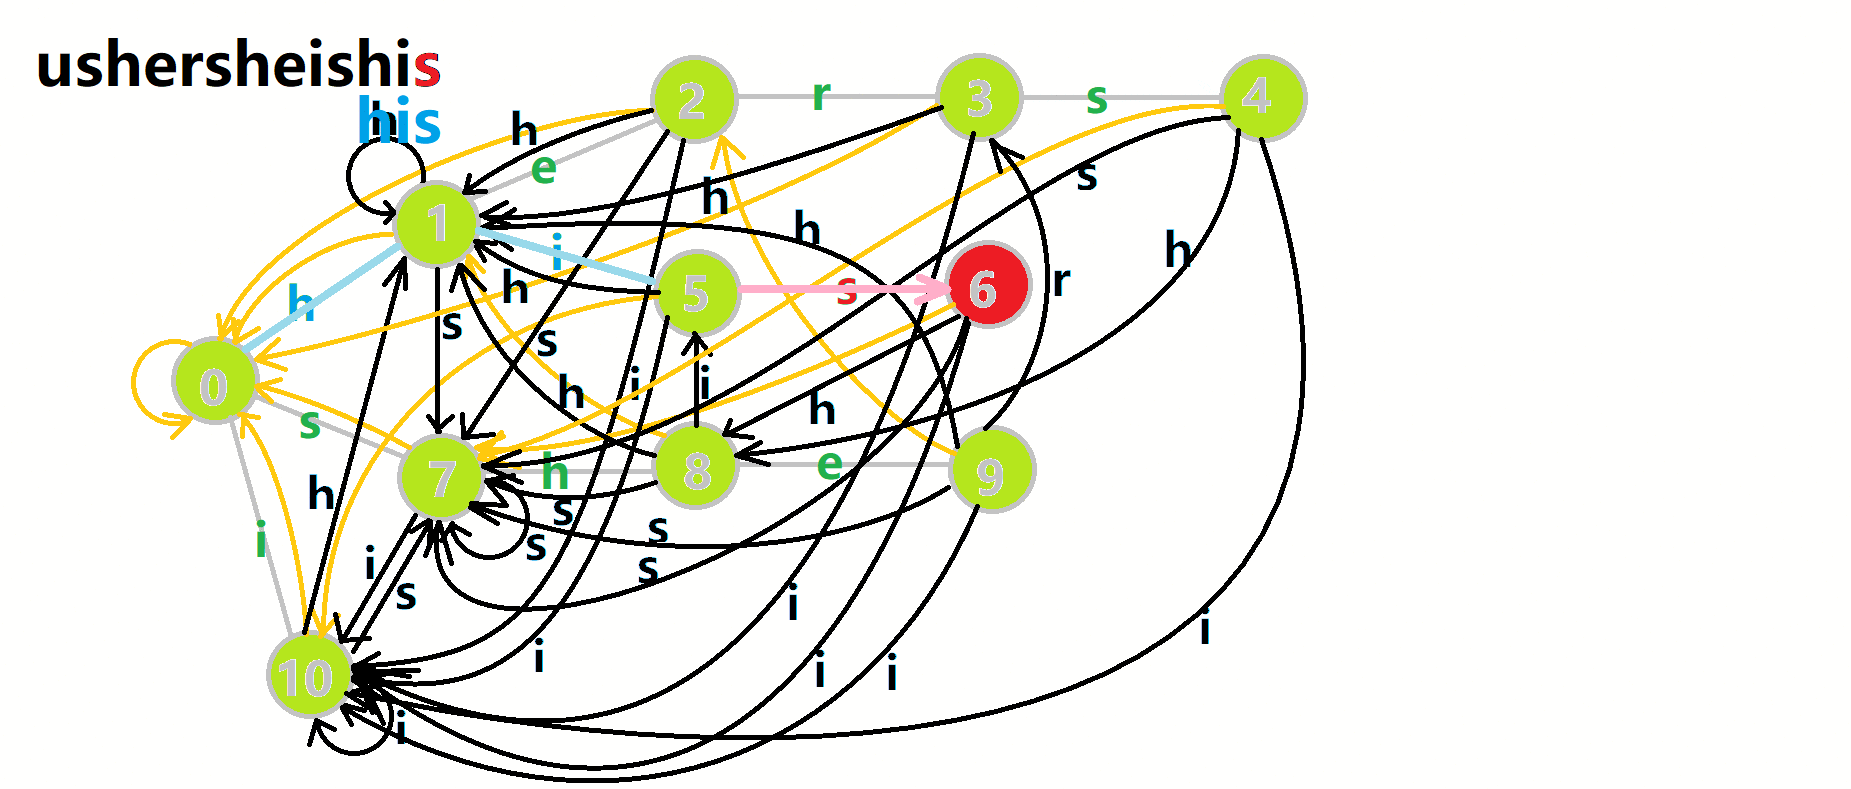
可以结合前面说过的AC自动机上的匹配理解其过程。
我们总不能在这些节点间跳来跳去把,这也太耗时间了。
我们可以发现,若只保留fail指针,那么剩余的图就是一颗树。
这是很显然的,所有节点的fail都指向比自身深度浅的节点,总共有节点数减一个加点,就是一棵树。
这样AC自动机上的问题就可以转移成子树求和的问题。
【模板】AC 自动机\(^{luoguP5357}\)
三倍经验题
子树求和问题可以使用拓扑排序或者树上dp(dfs),拓扑排序需要维护一下每个节点的度数。
下面使用拓扑排序过这道题。
#include<bits/stdc++.h>
using namespace std;
const int NUM=2e5+10;
const int NUMM=2e6+10;

int n;
namespace AC{
	struct node{
		int son[26];
		int ans;
		int fail;
		int deg;
		int id;
		void init(){
			memset(son,0,sizeof(son));
			ans=fail=id=0;
		}
	}T[NUM];
	int tot;
	int ans[NUM],pid;
	void init(){
		tot=pid=0;
		T[0].init();
	}
	void insert(string s,int &idx){
		int u=0;
		for(char i:s){
			int &son=T[u].son[i-'a'];
			if(!son) son=++tot,T[son].init();
			u=son;
		}
		if(!T[u].id) T[u].id=++pid;
		idx=T[u].id;
	}
	void build(){
		queue<int> q;
		for(int i=0;i<26;++i){
			if(T[0].son[i]) q.push(T[0].son[i]);
		}
		while(!q.empty()){
			int u=q.front();
			q.pop();
			for(int i=0;i<26;++i){
				if(T[u].son[i]){
					T[T[u].son[i]].fail=T[T[u].fail].son[i];
					T[T[T[u].fail].son[i]].deg++; //记录度数
					q.push(T[u].son[i]);
				}else{
					T[u].son[i]=T[T[u].fail].son[i];
				}
			}
		}
	}
	void query(string t){
		int u=0;
		for(char i:t){
			u=T[u].son[i-'a'];
			T[u].ans++;
		}
	}
	void topu(){                      //拓扑排序
		queue<int> q;
		for(int i=0;i<=tot;++i){
			if(T[i].deg==0) q.push(i);
		}
		while(!q.empty()){
			int u=q.front();
			q.pop();
			ans[T[u].id]=T[u].ans;
			int v=T[u].fail;
			T[v].ans+=T[u].ans;
			if(!--T[v].deg) q.push(v);
		}
	}
}
using namespace AC;

string s;
int idx[NUM];

int main(){
	init();
	cin>>n;
	for(int i=1;i<=n;++i){
		cin>>s;
		insert(s,idx[i]);
		ans[i]=0;
	}
	build();
	cin>>s;
	query(s);
	topu();
	for(int i=1;i<=n;++i){
		cout<<ans[idx[i]]<<'\n';
	}
	return 0;
}
DFS同理,从 \(0\) 开始跑即可,因为最终所有fail都会指向 \(0\)。
例题
你学了这么多奇奇怪怪的东西,看哪几个不能用来优化DP的?
万恶的出题人怎么可能让你去解决字符串匹配问题?
[JSOI2007] 文本生成器\(^{luoguP4052}\)
题目copy
- 题目描述
JSOI 交给队员 ZYX 一个任务,编制一个称之为“文本生成器”的电脑软件:该软件的使用者是一些低幼人群,他们现在使用的是 GW 文本生成器 v6 版。
该软件可以随机生成一些文章——总是生成一篇长度固定且完全随机的文章。 也就是说,生成的文章中每个字符都是完全随机的大写字母。如果一篇文章中至少包含使用者们了解的一个单词,那么我们说这篇文章是可读的(我们称文章 \(s\) 包含单词 \(t\),当且仅当单词 \(t\) 是文章 \(s\) 的子串)。但是,即使按照这样的标准,使用者现在使用的 GW 文本生成器 v6 版所生成的文章也是几乎完全不可读的。ZYX 需要指出 GW 文本生成器 v6 生成的所有文本中,可读文本的数量,以便能够成功获得 v7 更新版。你能帮助他吗?
答案对 \(10^4 + 7\) 取模。
- 输入格式
第一行有两个整数,分别表示使用者了解的单词总数 \(n\) 和生成的文章长度 \(m\)。
接下来 \(n\) 行,每行一个字符串 \(s_i\),表示一个使用者了解的单词。
- 输出格式
输出一行一个整数表示答案对 \(10^4 + 7\) 取模的结果。
-
输入输出样例 #1
-
输入 #1
2 2
A
B
- 输出 #1
100
-
说明/提示
-
数据规模与约定
对于全部的测试点,保证:
- \(1 \leq n \leq 60\),\(1 \leq m \leq 100\)。
- \(1 \leq |s_i| \leq 100\),其中 \(|s_i|\) 表示字符串 \(s_i\) 的长度。
- \(s_i\) 中只含大写英文字母。
这是一道AC自动机优化DP的经典例题。
因为是AC自动机,所以我们要找到传说中的模板串。然后再找到文本串……等等,发现一个很严重的问题:
再等等,为什么要去找文本串?
回头看看题目让我们求什么?
我来翻译一下:
原来是让我们求问文本串(的数量),可是,怎么求?
正难则反
-------------------by 我也不知道是谁
我们可以求出所有串串数量,再减去不合法串的数量,不就是合法串的数量了吗?
前一个好求,直接就是 \(26^{m}\)。
后面的当然就要用DP求了。
设 \(f_{i,j}\) 表示长度为 \(i\),其后缀是自动机上 \(j\) 位置所代表的字符串时的文本串个数。
那么我们就可以再 \(j\) 后面再接上一个字符 \(k\) 使其长度加一:
但是我们要保证它加上 \(k\) 后后缀不能变为任何一个模式串,想想这个要怎么处理?
我们观察到AC自动机的叶节点肯定不能是,因为那代表一个模式串,换言之,就是不能去代表模式串末尾的节点,但这一定是叶节点,因为还有可能是像 \(\texttt{abc}\) 和 \(\texttt{abcdef}\) 这种,可以画个Trie自己悟一下。
另外,还有一种情况不行,那就是当前节点可以通过连续跳若干次fail到达一个模式串的末尾,可以看一下fail指针指的是什么,是当前节点去除若干前缀后所得到的的字符串,所以说fail指的就是当前节点所包含的,要是fail不行,当前节点也不行。
在实现方面,创建一个 \(bool\) 数组,在建Trie的时候标记串末尾非法,在建AC自动机的时候传递一下fail的非法性,在DP的时候使用:
枚举三层(i,j,k)循环即可。
最后统计答案:
其中 \(tot\) 为AC自动机的节点数。
这样就做完了。
#include<bits/stdc++.h>
using namespace std;

const int NUM=1e6+10;
const int mod=1e4+7;

struct AC_auto{
    struct node{
        int son[26];
        int fail;
    }T[NUM];
    int tot;
    bool illegal[NUM];
    void insert(string s){
        int x=0;
        for(char c:s){
            int &son=T[x].son[c-'A'];
            if(!son) son=++tot;
            x=son;
        }
        illegal[x]=1;
    }
    void build(){
        queue<int> q;
        for(int i=0;i<26;++i) if(T[0].son[i]) q.push(T[0].son[i]);
        while(!q.empty()){
            int x=q.front();q.pop();
            for(int i=0;i<26;++i){
                if(T[x].son[i]){
                    T[T[x].son[i]].fail=T[T[x].fail].son[i];
                    illegal[T[x].son[i]]|=illegal[T[T[x].son[i]].fail];
                    q.push(T[x].son[i]);
                }else{
                    T[x].son[i]=T[T[x].fail].son[i];
                }
            }
        }
    }
}ac;
int ksm(int a,int b,int c){
    int ans=1;
    for(;b;b>>=1,a=a*a%c)
    if(b&1) ans=ans*a%c;
    return ans;
}

int n,m;
int f[110][6010];
string s;

signed main(){
    cin>>n>>m;
    for(int i=1;i<=n;++i){
        cin>>s;
        ac.insert(s);
    }
    ac.build();
    f[0][0]=1;
    for(int i=0;i<m;++i)
    for(int j=0;j<=ac.tot;++j)
    for(int k=0;k<26;++k)
    if(!ac.illegal[ac.T[j].son[k]])
        (f[i+1][ac.T[j].son[k]]+=f[i][j])%=mod;
    int ans=ksm(26,m,mod);
    for(int i=0;i<=ac.tot;++i) ans=(ans-f[m][i])%mod;
    cout<<(ans+mod)%mod;

    return 0;
}
我还记得我当时快速幂打错了查了半天?
[SDOI2014] 数数\(^{luoguP3311}\)
题面copy
- 题目描述
我们称一个正整数 \(x\) 是幸运数,当且仅当它的十进制表示中不包含数字串集合 \(s\) 中任意一个元素作为其子串。例如当 \(s = \{22, 333, 0233\}\) 时,\(233\) 是幸运数,\(2333\)、\(20233\)、\(3223\) 不是幸运数。给定 \(n\) 和 \(s\),计算不大于 \(n\) 的幸运数个数。
答案对 \(10^9 + 7\) 取模。
- 输入格式
第一行有一个整数,表示 \(n\)。
第二行有一个整数,表示 \(s\) 中的元素个数 \(m\)。
接下来 \(m\) 行,每行一个数字串 \(s_i\),表示 \(s\) 中的一个元素。
- 输出格式
输出一行一个整数,表示答案对 \(10^9 + 7\) 取模的结果。
-
输入输出样例 #1
-
输入 #1
20
3
2
3
14
- 输出 #1
14
-
说明/提示
-
样例 1 解释
除了 \(3, 13, 2, 12, 20, 14\) 以外,不大于 \(20\) 的整数都是幸运数字。
- 数据规模与约定
对于全部的测试点,保证:
\(1 \leq n < 10^{1201}\),\(1 \leq m \leq 100\),\(1 \leq \sum_{i = 1}^m |s_i| \leq 1500\),\(\min_{i = 1}^m |s_i| \geq 1\),其中 \(|s_i|\) 表示字符串 \(s_i\) 的长度。\(n\) 没有前导 \(0\),但是 \(s_i\) 可能有前导 \(0\)。
相比于上一题,这道题有了两个限制,一个是上限,另一个是前导零。
这个很简单使用计数DP直接DFS即可,看代码吧,我不想写了qwq。
#include<bits/stdc++.h>
using namespace std;
const int NUM=2e3+10;
const int mod=1e9+7;
#define int long long

struct node{
    int son[10];
    int fail;
}T[NUM];

int tot;
bool illegal[NUM];

void insert(string s){
    int x=0;
    for(char c:s){
        int &son=T[x].son[c-'0'];
        if(!son) son=++tot;
        x=son;
    }
    illegal[x]=true;
}
void build(){
    queue<int> q;
    for(int i=0;i<10;++i) if(T[0].son[i]) q.push(T[0].son[i]);
    while(!q.empty()){
        int x=q.front();q.pop();
        for(int i=0;i<10;++i){
            if(T[x].son[i]){
                T[T[x].son[i]].fail=T[T[x].fail].son[i];
                illegal[T[x].son[i]]|=illegal[T[T[x].son[i]].fail];
                q.push(T[x].son[i]);
            }else{
                T[x].son[i]=T[T[x].fail].son[i];
            }
        }
    }
}

int n,m;
int f[1210][1510][2][2];
string lim,s;

//大家不要学我用i,j做参数。
int dfs(int i,int j,bool l,bool z){
    if(i<=0) return !illegal[j];
    if(illegal[j]) return 0;
    if(f[i][j][l][z]!=-1) return f[i][j][l][z];
    int ans=0;
    for(int x=0;x<=(l?lim[i]-'0':9);++x){
        //我调了半天发现我把x写成i了。
        ans+=dfs(i-1,(z&&(x==0))?0:T[j].son[x],l&&(x==lim[i]-'0'),z&&(x==0));
        ans%=mod;
    }
    return f[i][j][l][z]=ans;
}

signed main(signed argn,char* argv[]){
    if(argn!=1){
        freopen("in.in","r",stdin);
        freopen("out.out","w",stdout);
    }

    memset(f,-1,sizeof(f));
    cin>>lim>>m;
    n=lim.length();
    lim=' '+lim;
    for(int i=1;i<=m;++i){
        cin>>s;
        insert(s);
    }
    build();

    reverse(lim.begin()+1,lim.end());
    cout<<(dfs(n,0,1,1)-1+mod)%mod;
    return 0;
}
[NOI2011] 阿狸的打字机\(^{luoguP2414}\)
题面copy
- 题目描述
阿狸喜欢收藏各种稀奇古怪的东西,最近他淘到一台老式的打字机。打字机上只有 \(28\) 个按键,分别印有 \(26\) 个小写英文字母和 B、P 两个字母。经阿狸研究发现,这个打字机是这样工作的:
- 输入小写字母,打字机的一个凹槽中会加入这个字母(这个字母加在凹槽的最后)。
- 按一下印有
B的按键,打字机凹槽中最后一个字母会消失。 - 按一下印有
P的按键,打字机会在纸上打印出凹槽中现有的所有字母并换行,但凹槽中的字母不会消失。
例如,阿狸输入 aPaPBbP,纸上被打印的字符如下:
a
aa
ab
我们把纸上打印出来的字符串从 \(1\) 开始顺序编号,一直到 \(n\)。打字机有一个非常有趣的功能,在打字机中暗藏一个带数字的小键盘,在小键盘上输入两个数 \((x,y)\)(其中 \(1\leq x,y\leq n\)),打字机会显示第 \(x\) 个打印的字符串在第 \(y\) 个打印的字符串中出现了多少次。
阿狸发现了这个功能以后很兴奋,他想写个程序完成同样的功能,你能帮助他么?
- 输入格式
输入的第一行包含一个字符串,按阿狸的输入顺序给出所有阿狸输入的字符。
第二行包含一个整数 \(m\),表示询问个数。
接下来 \(m\) 行描述所有由小键盘输入的询问。其中第 \(i\) 行包含两个整数 \(x, y\),表示第 \(i\) 个询问为 \((x, y)\)。
- 输出格式
输出 \(m\) 行,其中第 \(i\) 行包含一个整数,表示第 \(i\) 个询问的答案。
-
输入输出样例 #1
-
输入 #1
aPaPBbP
3
1 2
1 3
2 3
- 输出 #1
2
1
0
-
说明/提示
-
数据范围
对于 \(100\%\) 的数据,\(1\leq n\leq 10^5\),\(1\leq m\leq10^5\),第一行总长度 \(\leq 10^5\)。
::cute-table{tuack}
| 测试点 | \(n\) 的规模 | \(m\) 的规模 | 字符串长度 | 第一行长度 |
|---|---|---|---|---|
| \(1,2\) | \(1\leq n\leq 100\) | \(1\leq m\leq 10^3\) | \(—\) | \(\leq 100\) |
| \(3,4\) | \(1\leq n\leq 10^3\) | \(1\leq m\leq 10^4\) | 单个长度 \(\leq 10^3\),总长度 \(\leq 10^5\) | \(\leq 10^5\) |
| \(5\sim 7\) | \(1\leq n\leq 10^4\) | \(1\leq m\leq 10^5\) | 总长度 \(\leq 10^5\) | \(\leq 10^5\) |
| \(8\sim 10\) | \(1\leq n\leq 10^5\) | \(1\leq m\leq 10^5\) | \(—\) | \(\leq 10^5\) |
《真·老式打字机》
一看题面让求一个串在另一个串中出现次数,这不明白着让我们用KMP么,再一看数据范围…… \(1e5\) 额……
于是我们考虑用AC自动机做。
经过我们的观察容易发现,如果一个串(\(A\))的fail指向了另一个串(B), 那么串(B)一定存在于串(A)中。
我们又知道,所有fail指针所构成的就是一颗数,对,是以零为根的树(我直到现在才意识到)
这样我们就可以想到一个暴力做法:
将所有fail指针抽出来,建成一棵树,然后从字符串(x)所对应的节点开始遍历子树,记录遍历到字符串(y)上面的次数即可,在这里,并不一定要到字符串(y)的末尾,只要是字符串(y)上任意一个前缀均可。
既然有了暴力做法我们就开始考虑优化。
我们发现最慢的地方在遍历子树,你遍历子树干什么?求和啊!子树求和怎么整?跑个dfs序记录入栈出栈时间,然后再真个数据结构求和就好了。
具体实现就是先在字符串(y)的DFS序上的值变成1,然后再将所有查询再y上的x区间求和,离线输出即可。
但他还会T,你可以尝试使用DFS优化,进入一个节点时将其dfs序位置加一,离开时减一,到达一个串末尾时将所有关于那个串的查询统计下来即可。
总时间复杂度 \(O(n)\) 并带一个不大不小的常数。
#include<bits/stdc++.h>
using namespace std;
const int NUM=1e5+10;
const int mod=1e9+7;
#define int long long

vector<int> tri[NUM],fil[NUM];

bool flag=0;

void addedge_tri(int x,int y){
    tri[x].push_back(y);
    tri[y].push_back(x);
    //这里其实没必要建双边
}
void addedge_fil(int x,int y){
    fil[x].push_back(y);
}

struct trie{
    int son[26];
    int fail;
}T[NUM];

int tot;
bool vis[NUM];
int id[NUM];
int pos[NUM];

void insert(string s){
    int x=0,idx=0;
    int stk[NUM],top=0;
    stk[++top]=x;
    for(char c:s){
        if(c=='B') x=stk[--top];
        else if(c=='P') vis[++idx]=1,id[x]=idx,pos[idx]=x;
        else{
            int &son=T[x].son[c-'a'];
            if(!son) son=++tot;
            addedge_tri(x,son);
            x=son;
            stk[++top]=x;
        }
    }
}
void build(){
    queue<int> q;
    for(int i=0;i<26;++i) if(T[0].son[i]) q.push(T[0].son[i]);
    while(!q.empty()){
        int x=q.front();q.pop();
        for(int i=0;i<26;++i){
            if(T[x].son[i]){
                T[T[x].son[i]].fail=T[T[x].fail].son[i];
                q.push(T[x].son[i]);
            }else{
                T[x].son[i]=T[T[x].fail].son[i];
            }
        }
    }
}

int ink[NUM],otk[NUM],tim;
void dfs_fail(int x){
    ink[x]=++tim;
    for(int y:fil[x]){
        dfs_fail(y);
    }
    otk[x]=tim;
}

int C[NUM];
void add(int x,int val){
    for(int i=x;i<=tim;i+=(i&-i)) C[i]+=val;
}
int query(int x){
    int res=0;
    for(int i=x;i;i-=(i&-i)) res+=C[i];
    return res;
}

vector<pair<int,int> > q[NUM];
int ans[NUM];

void dfs(int x,int fa){
    add(ink[x],1);
    if(vis[id[x]]){
        for(auto y:q[id[x]]){
            ans[y.second]=query(otk[y.first])-query(ink[y.first]-1);
        }
    }
    for(int y:tri[x]){
        if(y==fa) continue;
        dfs(y,x);
    }
    add(ink[x],-1);
}

signed main(signed argn,char* argv[]){
    if(argn!=1){
        flag=1;
        freopen("in.in","r",stdin);
        freopen("out.out","w",stdout);
    }

    string s;
    cin>>s;
    insert(s);
    build();
    for(int i=1;i<=tot;++i) addedge_fil(T[i].fail,i);
    dfs_fail(0);

    int m;
    cin>>m;
    for(int i=1,x,y;i<=m;++i){
        cin>>x>>y;
        q[y].push_back({pos[x],i});
    }
    dfs(0,-1);
    for(int i=1;i<=m;++i){
        cout<<ans[i]<<'\n';
    }
    return 0;
}
也是浅调1个小时就过了。
后记
AC自动机其实并不是很难,但出题人总是出一些奇奇怪怪的题。
反正就是不能让你好受。
蒟蒻制作不易不喜勿喷,但欢迎指出错误。

 浙公网安备 33010602011771号