
扒透树莓派 Pico 存储底层!ROM/SRAM/Flash 全解析(保姆级教程)
 这里,我们先先充几个核心 “映射” 概念(这是存储器访问的基础),再讲解存储器和 SRAM 的地址映射表,芯片里的资源(内存、寄存器、外设)要被访问,必须先 “编门牌号”,这就是 “映射” 的本质:
- 地址映射:给芯片里的所有资源分配唯一的 “数字门牌号”(即系统地址),比如 SRAM 的门牌号从 0x20000000 开始、ROM 从 0x00000000 开始。内核 / DMA 通过 “门牌号” 就能精准找到要访问的资源,相当于 “资源与门牌号的对应表”;
- 寄存器映射:是地址映射的子集, 给芯片里的寄存器(存配置、状态的小内存)分配门牌号,比如 “0x40008000 对应 UART 的波特率寄存器”,软件写这个地址就能配置 UART,相当于 “寄存器功能与门牌号的对应表”;
- 重映射:是 “重新分配门牌号”—— 比如原本 A 门牌号对应内存,重映射后 A 门牌号可以对应外设,灵活调整资源的访问地址,适配不同场景。
存储器的访问完全基于地址映射,树莓派 Pico 的存储结构由 16kB 固定内容的 ROM 和 264kB 可并行访问的 SRAM 组成,SRAM 通过多物理内存块的设计提升访问效率,并且通过 QSPI 接口访问外部 Flash 存储器(2MB 大小)。
1.ROM
16kB 的只读内存(ROM)地址 0x00000000。ROM 中的内容在芯片被制造后是固定的。它包含:
- 初始化启动引导例程
- 闪存启动顺序
- 闪存编程例程
- 支持 UF2 的大容量存储设备 USB
- 实用程序库,如快速浮点数
ROM 启动程序可在该链接中下载:https://github.com/raspberrypi/pico-bootrom
该 ROM 提供单周期只读总线访问,并且是在一个专用的 AHB-Lite 仲裁器上,因此它可以与其他内存设备同时访问。尝试对 ROM 进行写操作不会产生任何效果,也不会产生总线故障。
2.SRAM
片上 SRAM 共计 264kB。在物理上,这被划分为六个 bank,这可以极大地提高了多个主服务器的内存带宽(即让多个总线主机(比如 Core0、Core1、DMA)能 “同时访问不同 bank”,避免抢资源),但对于软件来说可以将其视为一个 264kB 的内存区域进行读写访问(但物理 bank 的访问是通过地址映射实现的)。
对每个 bank 中存储的内容没有限制:可以放应用程序、数据缓冲区等。
bank 可以分为四个 16kx32 位(每个 64kB)和两个 1kx32 位(每个 4kB)。
每个 SRAM bank 都可以通过一个专用的 AHB-Lite 仲裁器进行访问。这意味着不同的总线主机可以并行访问不同的 SRAM bank,因此每个系统时钟周期最多可以进行 4 个 32 位的 SRAM 访问(每个主机一个)。
在内存映射中,SRAM 的起始地址为 0x20000000,具体每个 bank 的基地址如下:
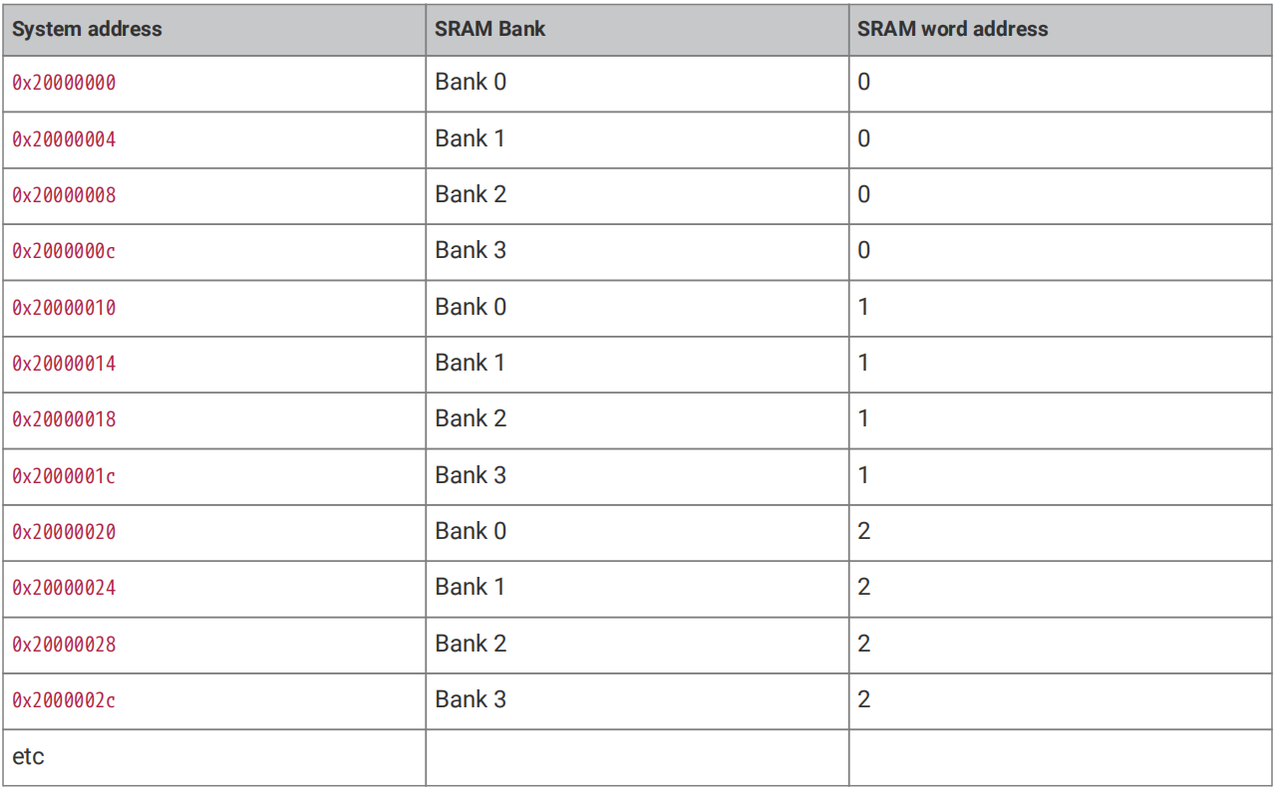
我们可以看到,这个映射表中包含以下信息:
-
System address(系统地址):SRAM 的 “门牌号”,内核 / DMA 通过这个地址访问 SRAM(比如 0x20000000 是 SRAM 的第一个门牌号);
-
SRAM Bank(SRAM 物理分区):SRAM 实际的物理存储块(这里显示了 Bank0~Bank3,另外还有 2 个 4kB 的小 bank);
-
SRAM word address(SRAM 字地址):“字” 是 32 位(对应 4 个字节),这个地址是该 bank 内部的偏移门牌号(比如 “字地址 0” 是 bank 里的第一个 32 位数据)。
这里,RP2040 的 SRAM 内存地址映射使用了条带化(striped)存储机制来提高并行访问性能,内存地址按照字(word)为单位分布在四个内存块之间:系统地址每增加 4(因为 32 位 = 4 字节),会按 “Bank0→Bank1→Bank2→Bank3” 的顺序轮询不同 bank,然后再回到 Bank0 递增 “字地址”—— 比如:
-
0x20000000(门牌号)→ Bank0、字地址 0;
-
0x20000004(+4)→ Bank1、字地址 0;
-
0x20000010(再 + 4)→ 回到 Bank0、字地址 1。
这种映射的好处是:当多个模块同时访问不同的系统地址时,其实是在访问不同的物理 bank—— 比如 Core0 访问 0x20000000(Bank0),DMA 访问 0x20000004(Bank1),两者不会互相干扰,实现 “并行访问”,极大提升了 SRAM 的读写速度。
由于系统地址空间的连续字节被分配到不同的内存块,多个内存访问可以同时进行,从而提高了内存带宽和整体性能,同时可以减少不同内存访问请求之间的冲突,提高了内存访问效率。
此外,位于 0x20040000 和 0x20041000 的两个 4kB 区域直接映射到两个小的 4kB 内存块。这些区域可以专门用于每个核心的操作,例如栈或者频繁执行的代码,确保在访问这些区域时不会出现处理器等待的情况。
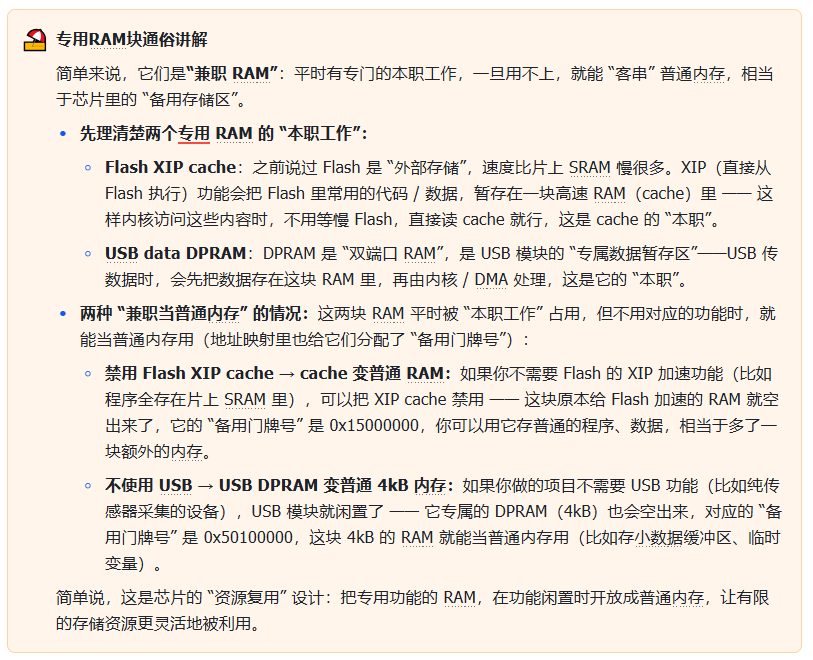
除了片上的 SRAM 外,还有两个专用 RAM 块可在某些情况下使用:
- Flash XIP 缓存:如果禁用 Flash XIP 缓存,该缓存可以作为 16kB 的内存,起始地址为 0x15000000
- USB 数据 DPRAM:如果没有使用 USB,该 4kB 的内存区域也可以作为普通内存使用,起始地址为 0x50100000
3.外置 Flash
这里,我们先引入两个关键概念:
- QSPI 接口:芯片和外部 Flash 之间的 “高速数据线”(比普通 SPI 快),负责芯片和外部 Flash 的通信。
- XIP(Execute In Place):字面是 “在原地执行”—— 不用把外部 Flash 里的程序复制到片上 SRAM,直接访问外部 Flash 就能运行程序,相当于把外部 Flash 当成 “扩展内存” 用,省了 SRAM 空间。
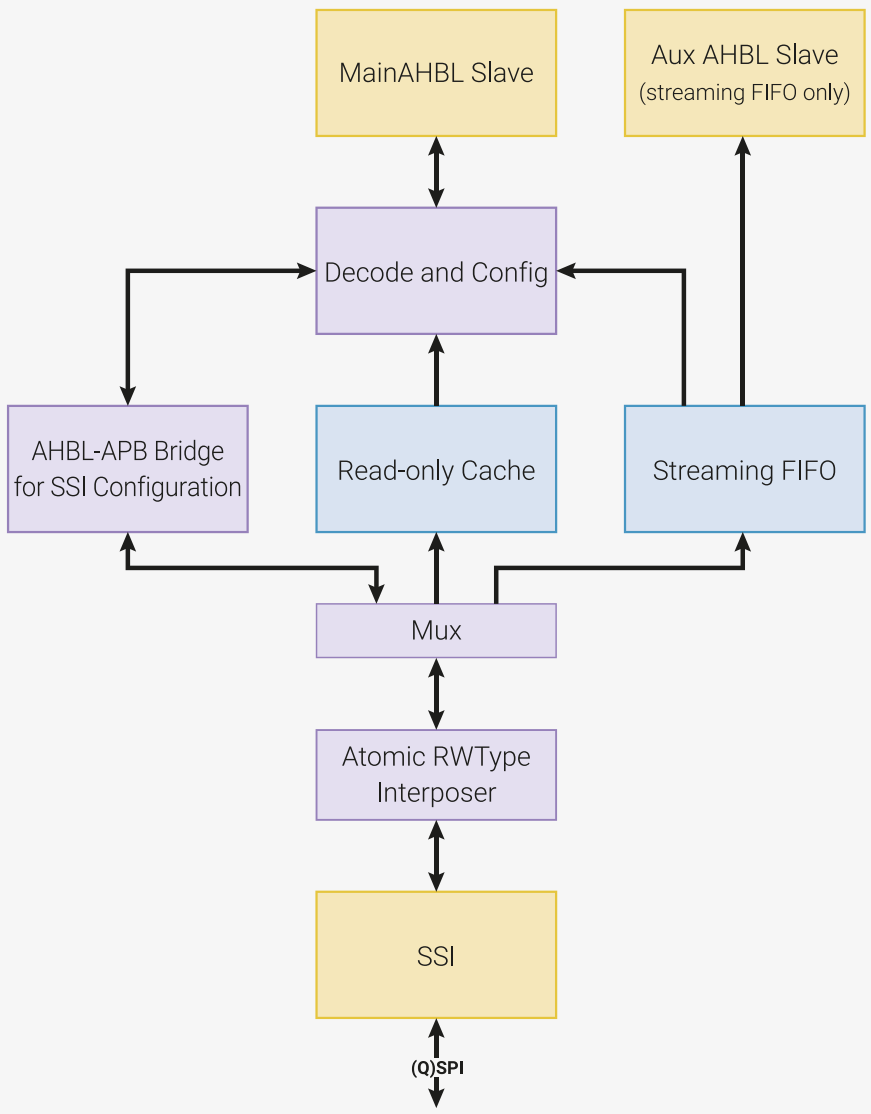
RP2040 微控制器的闪存管理使用了就地执行(Execute-In-Place, XIP)机制,通过四个主要组件实现高效的闪存访问:QSPI 接口、XIP 硬件、XIP 缓存和串行闪存接口(SSI)。
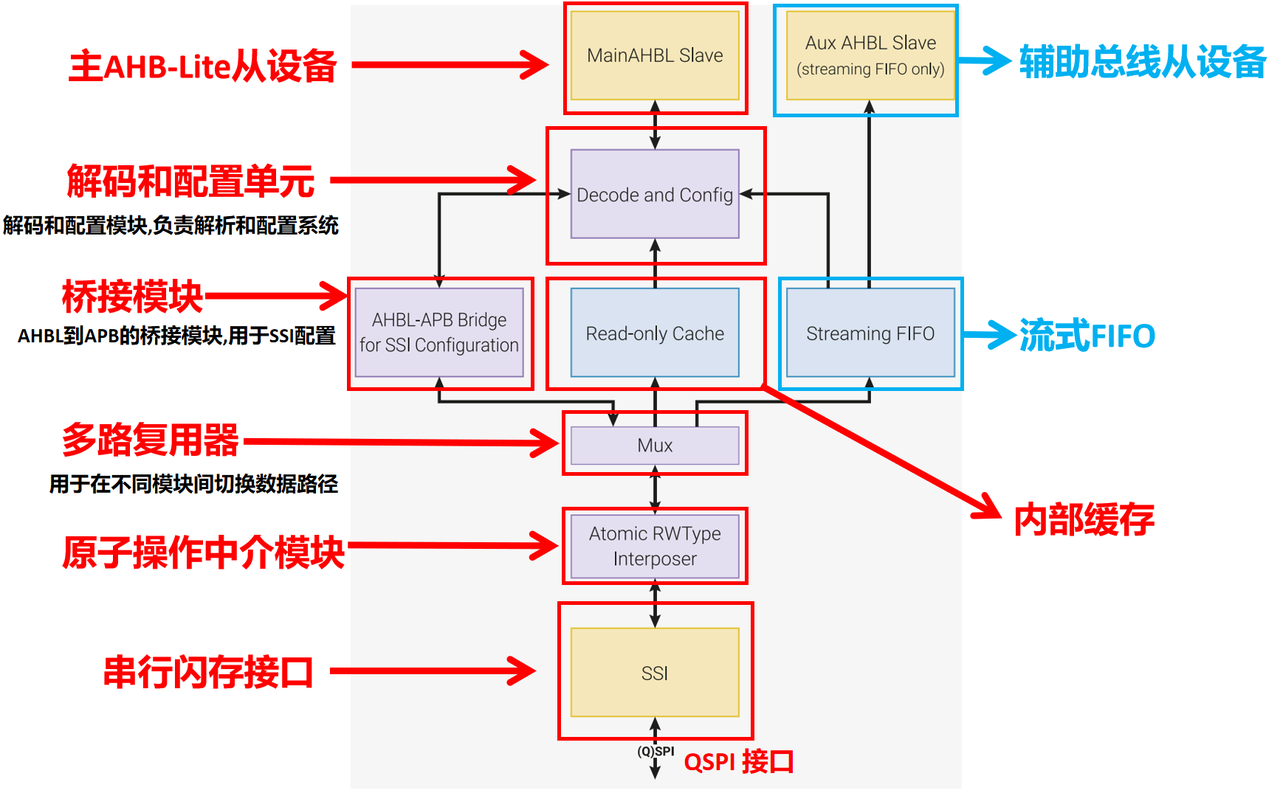
整个结构的核心是让外部 Flash 能像内部内存一样被访问,同时用缓存提速,还要保证通信稳定:
-
SSI 模块:直接连接 QSPI 接口,是和外部 Flash 通信的 “物理层”—— 负责发送 / 接收 QSPI 信号,实际和外部 Flash 传数据的就是它。
-
Atomic RWType Interposer 原子操作保护器:保证对 Flash 的读写操作是“完整不中断” 的(比如读一个 32 位数据时,不会被其他操作打断),避免数据读错 / 写乱。
-
Mux 多路选择器:相当于 “数据路径开关”,选择数据是从 Cache(缓存) 里读,还是直接从 Flash 里读,优先走 Cache(更快)。
-
Read-only Cache 只读缓存:因为外部 Flash 速度比片上 SRAM 慢,Cache 会把 Flash 里常用的内容(比如频繁执行的程序指令)存在这里;内核访问时先查 Cache,有就直接读,不用等慢 Flash,大幅提升 XIP 的速度。
-
Streaming FIFO 连续数据缓冲区:当要从 Flash 读大量连续数据(比如一大段程序、大文件)时,数据会先存在这个 FIFO 里,再传给内核,避免数据传输 “断断续续”,让连续访问更流畅。
-
Decode and Config 地址解析配置单元:
- 解析内核发来的地址:确定这个地址对应的是外部 Flash 的哪个位置;
- 管理整个 XIP 硬件的配置:比如打开 / 关闭 Cache、设置 QSPI 的通信速度、配置 FIFO 的大小等。
-
Main AHBL Slave / Aux AHBL Slave:这个 XIP 硬件连接到系统总线(AHBL)的 “接口”:
- Main 接口:负责常规的 Flash 访问(比如读零散的指令 / 数据);
- Aux 接口:只负责Streaming FIFO 的高速连续数据传输,专门服务大流量场景。
-
AHBL-APB Bridge for SSI Configuration:是 SSI 的配置接口,内核通过 APB 总线给 SSI 模块设置参数(比如 QSPI 的时钟频率、传输模式),让 SSI 能和不同型号的外部 Flash 匹配通信。
外部 Flash(最高支持 16MB)可以通过 QSPI 接口使用本地执行(XIP)硬件进行访问。这允许系统像访问内部内存一样寻址和访问外部闪存,而不需要将代码先复制到内部内存:对地址范围为 0x10000000 起始的 16MB 闪存区域的访问,将被映射为对外部串行闪存的读操作,结果直接返回给发起请求的主设备。
XIP 子系统工作流程如下:
- 系统访问解码:当系统进行内存访问时,这些访问通过主 AHB-Lite 从设备进行,这些访问会被解码,以确定它们是 XIP 访问、对 SSI (串行外设接口) 的直接访问(例如用于配置),还是对 XIP 子系统中的其他硬件和控制寄存器的访问
- XIP 访问处理:
- 缓存查找:对于 XIP 访问,首先会在内部缓存中查找请求的数据,这个缓存用于加速对最近访问过的数据的访问,如果缓存中找到所请求的数据(缓存命中),则直接从缓存返回数据
- 缓存未命中:如果缓存中没有找到所请求的数据(缓存未命中),则会生成一个外部串行访问请求,这种请求通过 SSI 接口发送到外部闪存,以获取所需的数据
- 数据存储和转发:
- 数据存储:从外部闪存获取的数据会被存储在缓存中,以便将来访问时能更快地提供数据
- 数据转发:获取的数据随后会被转发到系统总线,以满足最初的访问请求。这样,XIP 子系统能确保访问的数据在系统总线和处理器中可用
3.1 XIP 缓存机制
XIP 缓存是一个内部缓存,用于加速外部闪存的访问,缓存的大小为 16KB,采用两路组相联(two-way set-associative)结构,每次缓存命中(hit)延迟为 1 个时钟周期;该缓存仅用于 XIP 闪存的访问,软件在大多数情况下无需考虑缓存一致性,除非进行闪存编程操作。
缓存映射到 24 位的闪存地址空间,RP2040 的系统地址中高 8 位用于分段解码,剩余的 24 位用于闪存地址,因此,支持的最大闪存大小为 16MB。闪存地址空间在 RP2040 的地址空间中有多个镜像,每个镜像具有不同的缓存行为。具体镜像地址及其缓存行为如下:
- 0x10…:XIP 访问,缓存可用,分配缓存(cacheable, allocating)。正常的缓存操作,缓存会在缺失时从闪存加载数据并更新
- 0x11…:XIP 访问,缓存可用,不分配缓存(cacheable, non-allocating)。检查缓存是否命中,但在缺失时不更新缓存
- 0x12…:XIP 访问,非缓存(non-cacheable),分配缓存(allocating)。不检查缓存是否命中,始终从闪存读取数据并更新缓存
- 0x13…:XIP 访问,非缓存(non-cacheable),不分配缓存(non-allocating)。完全绕过缓存,直接访问闪存
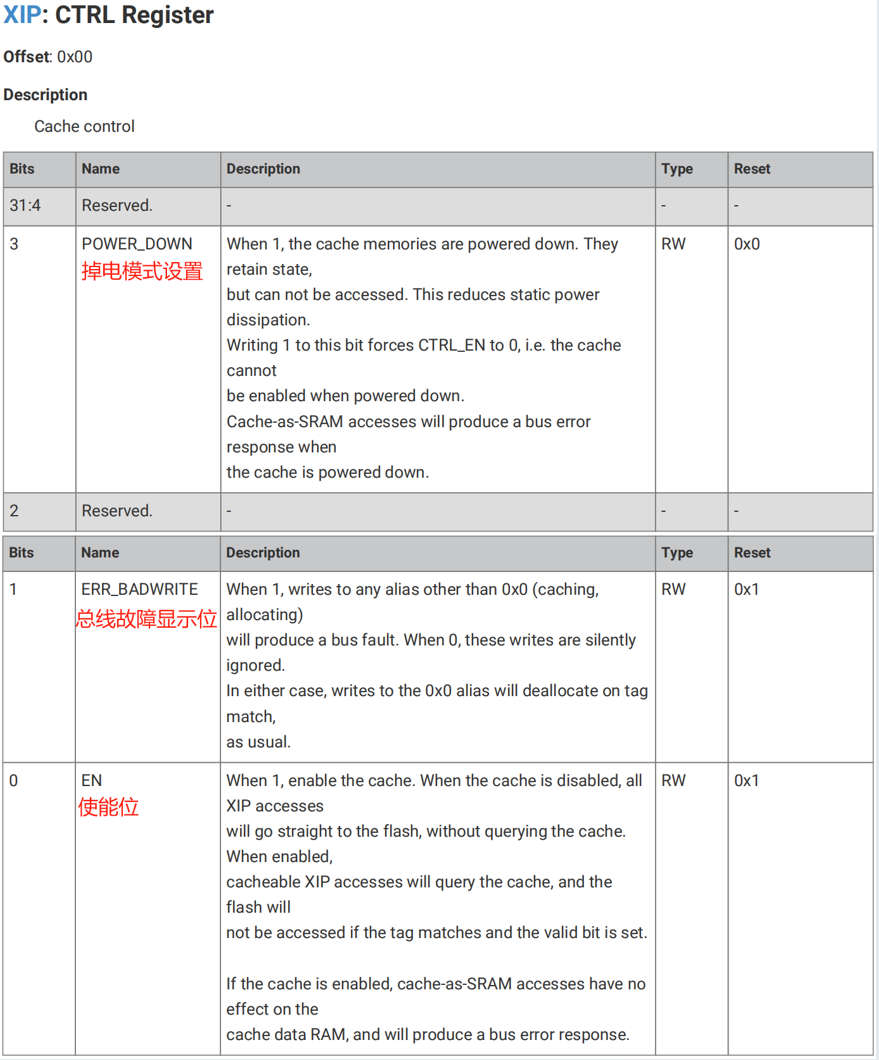
- 0x15…:将 XIP 缓存用作 SRAM 区域,在整个段内镜像。当缓存被禁用时(通过清除 CTRL.EN 寄存器位),这个区域表现为额外的 16KB SRAM 区域,读写操作都是 1 个周期,但连续的写-读序列会有一个等待状态
通过设置 CTRL.EN 寄存器位可以禁用缓存,禁用缓存时,所有 0x10 到 0x13 的 XIP 地址镜像将绕过缓存,直接访问闪存,这会显著影响 XIP 代码执行性能。
3.2 XIP 缓存清除与维护
当软件重新编程了闪存内容时,需要清除缓存中的陈旧数据和代码,以确保系统使用最新的数据,而不必重新启动,此时可以使用 FLUSH 寄存器刷新整个缓存的内容。
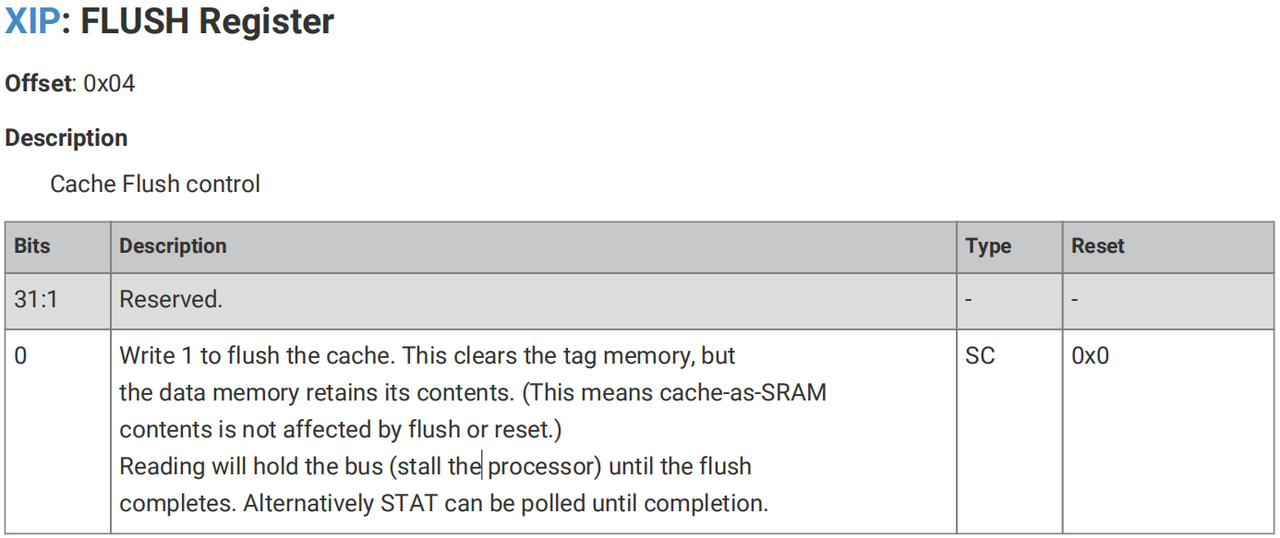
我们可以通过向 FLUSH 寄存器的第 0 数据位写入 1 实现缓存刷新,缓存的刷新是通过将缓存标记存储器(tag memory)清零来实现的。由于缓存的总大小为 16KB,标记存储器每行 8 字节,每组 2 路,因此刷新过程需要大约 1024 个时钟周期。
我们可以通过读取 FLUSH 寄存器的第 0 数据位来等待刷新操作完成,这会阻塞处理器直到刷新完成;也可以通过轮询 STAT 寄存器来检查刷新状态。
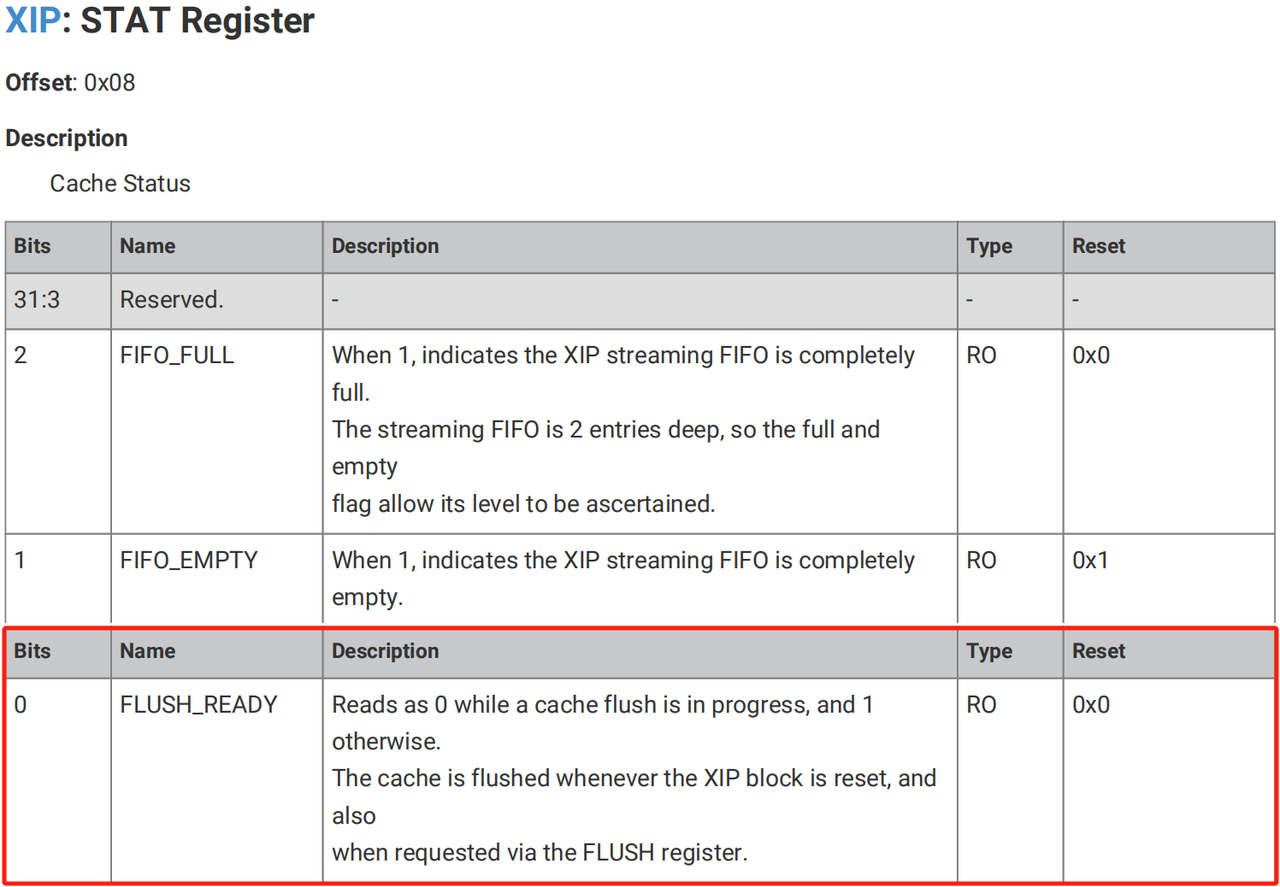
这里,在缓存刷新过程中访问闪存数据是安全的:如果缓存刷新正在进行时有其他主设备访问闪存数据,这些主设备会被阻塞,直到缓存刷新完成,这样可以确保在刷新完成之前不会有不一致的数据访问。
需要注意的是,当使用 XIP 缓存作为一个 16KB 的 SRAM 时(镜像地址为 0x15…),缓存将直接作为内存使用,支持读取和写入操作,如果此时刷新缓存缓存中的数据内容不会被修改,但如果在刷新过程中对缓存作为 SRAM 的地址范围进行写操作,可能会导致数据不一致或损坏。为了避免数据损坏,建议在缓存刷新操作完成后再进行对缓存作为 SRAM 的写操作,这可以通过在执行写操作之前,确认缓存刷新操作已经完全结束来实现。
完成一次完整的缓存刷新会显著降低后续代码执行的速度,直到缓存“重新预热”恢复正常性能。为了避免这种性能损失,可以采取替代方法,即只使特定地址范围的缓存内容失效。例如,当闪存的某个扇区被擦除并重新编程时,只需要确保缓存中的该扇区的陈旧数据被更新,而不是刷新整个缓存,在 RP2040 中,你可以向 0x10…镜像地址写入数据来触发缓存中指定地址范围的失效,这里的 0x10…镜像地址指的是缓存的一个特殊映射,它支持对特定地址范围内的数据进行部分失效:
- 查找缓存条目:当写入 0x10…镜像地址时,缓存会检查这个地址范围的缓存条目
- 删除条目:如果找到匹配的缓存条目,这些条目会被删除,缓存数据会被标记为无效,下次访问这些地址时,数据会从数据源(如闪存)重新加载
3.3 SSI 串行闪存接口
SSI (Synchronous Serial Interface) 是 RP2040 微控制器中的一个重要外设,用于处理序列化的闪存访问。它支持不同的 SPI(串行外围接口)模式,包括标准 SPI、双线 SPI(DSPI)和四线 SPI(QSPI)。SSI 允许通过不同的操作模式进行 XIP(Execute-in-Place)访问,能够兼容几乎所有类型的串行闪存设备。
SSI 的最大 SPI 时钟频率为系统时钟频率的一半,它支持在每次 XIP 访问时插入指令前缀或模式延续位,并且还支持标准的 FIFO(先进先出)SPI 主机模式,同时提供 DMA(直接内存访问)支持,这使得它可以用于快速的数据传输。
3.4 闪存流式传输和辅助总线从属
在嵌入式系统中,闪存(Flash)通常比静态随机存取内存(SRAM)要大得多。因此,在需要将大量数据从闪存传输到内存时,使用流式传输的方式非常有用。这种操作可以让 DMA(直接内存访问)在后台流式传输数据,同时前台的处理器继续执行其他任务。
标准的 XIP(Execute-in-Place)操作与流式传输不太兼容,因为在 SSI(串行外设接口)执行串行传输时,会导致 DMA 出现较长时间的总线延迟。这种延迟对处理器来说可能是可接受的,因为处理器在等待指令获取时一般没有其他有效的操作,而代码执行通常具有较高的缓存命中率。
然而,对于 DMA 来说,这种延迟会阻止其他活跃的 DMA 通道继续工作,从而降低整体 DMA 吞吐量。这就需要一种解决方案来减轻这种影响。
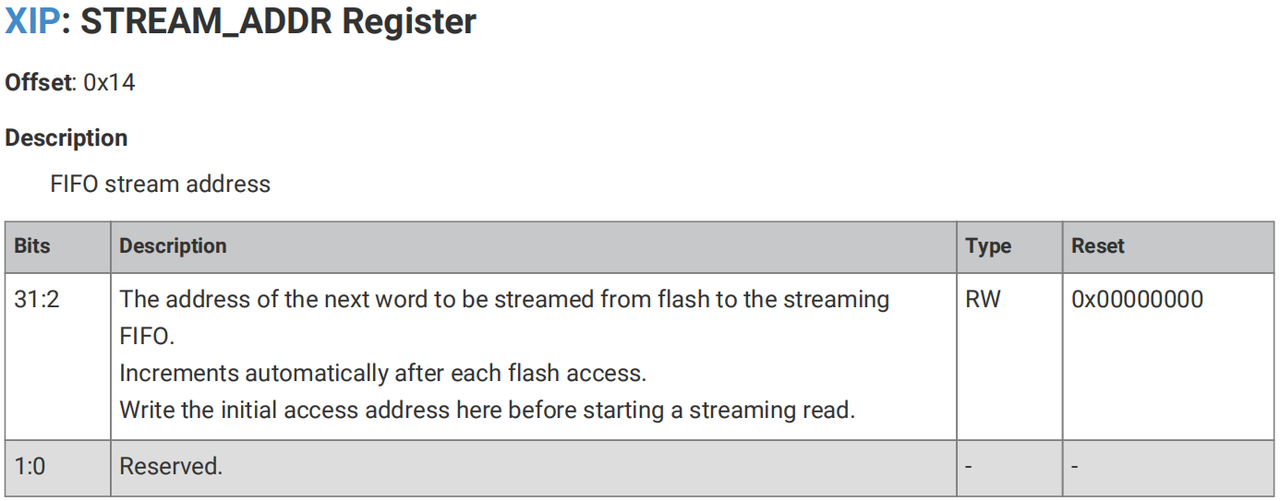
在 RP2040 中,STREAM_ADDR 和 STREAM_CTR 寄存器用于设置如何从闪存中连续读取数据,并将这些数据传输到内存中,这种操作称为流式传输,主要目的是将大量的数据从外部 Flash 闪存中高效地加载到内存 SRAM 中:
- 使用
STREAM_ADDR寄存器,你可以指定要从闪存中读取数据的起始地址:
- 使用
STREAM_CTR寄存器,你可以启动和停止流式传输
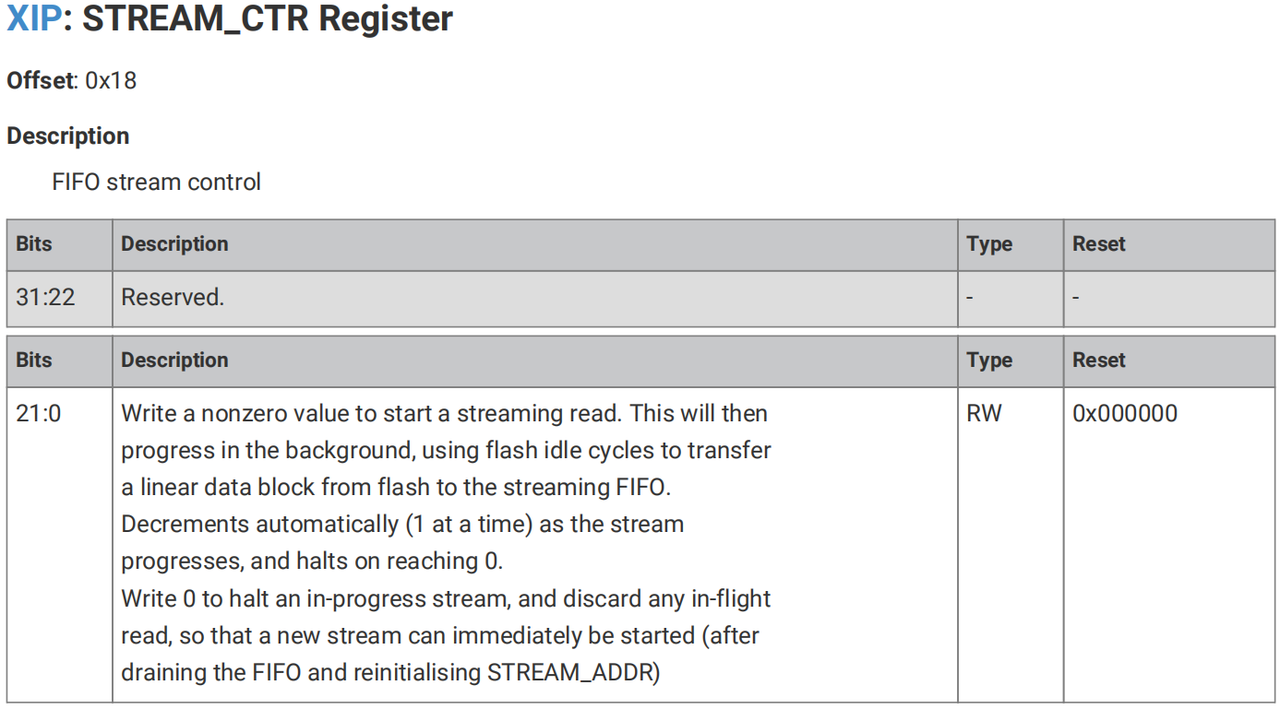
具体操作如下:
- 写入非零值:启动流式传输,将一个非零值写入这个字段时,流式传输操作将开始在后台进行,这会利用闪存的空闲周期,按照指定的线性块从闪存读取数据,并将数据存储到流式传输 FIFO 中;这个值会自动递减,每进行一次数据传输时减 1,当值递减到 0 时,流式传输会自动停止
- 写入零值:停止当前正在进行的流式传输,并丢弃任何正在传输中的数据
一旦配置好流式传输,XIP(Execute-in-Place)子系统会在后台自动处理这些数据读取操作,而无需 CPU 等待,并且在流式传输过程中,XIP 子系统的流式传输硬件会以较低的优先级进行数据读取。这意味着,流式传输的操作不会抢占处理器的执行任务或造成较大的延迟。
当代码从闪存执行时,可能会遇到缓存未命中(即缓存中没有数据,需要从闪存读取),流式传输硬件与常规的 XIP 访问相比,在缓存未命中后会经历一个简短的冷却时间(七个时钟周期),以避免在缓存未命中时引起额外的延迟。
流式传输将数据从闪存中读取并推送到一个小型 FIFO 缓存队列中,当 FIFO 中的数据准备好后,它会生成一个 DREQ(数据请求)信号,该信号通知 DMA 控制器,告知其可以从 FIFO 中读取数据,DMA 控制器负责从 FIFO 中提取数据,并将其传输到目标内存或设备,需要注意的是,DMA 只在数据准备好后才会读取 FIFO,这样不会被闪存读取过程阻塞。
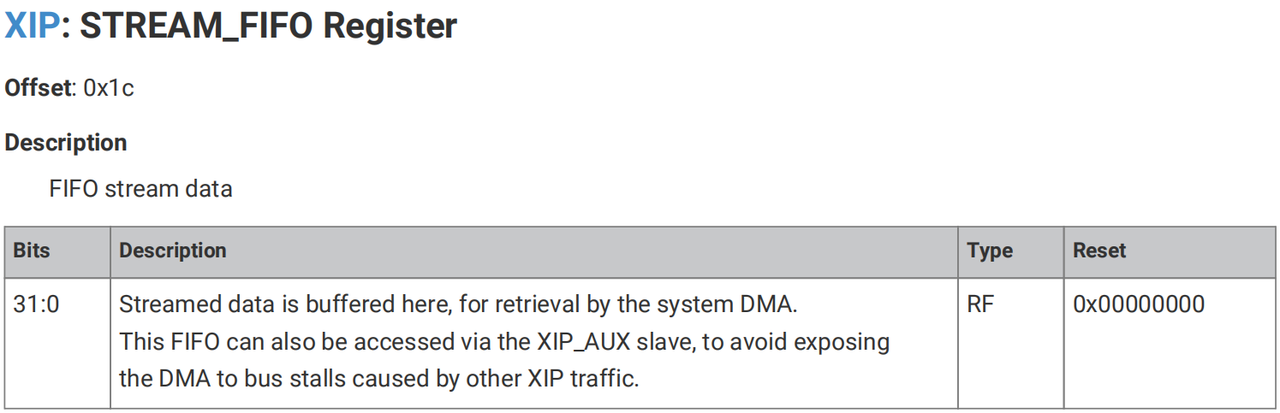
尽管数据已经准备好并在 FIFO 中,但如果其他系统主设备(例如 CPU 或外部设备)正在访问 XIP 闪存并且由于缓存未命中或其他原因而被阻塞,这可能会影响 DMA 的工作。为了解决这个问题,RP2040 使用了一个辅助总线从属设备,个从属设备是一个简单的总线接口,仅用于访问流式传输 FIFO,该设备连接到 FASTPERI 仲裁器,这个仲裁器服务于那些不会产生等待状态的原生 AHB-Lite 外设。这样一来,DMA 在访问 FIFO 时不会遇到额外的等待状态或阻塞,因为辅助总线从属设备的访问不会被其他总线操作干扰。
3.5 性能计数器
RP2040 的 XIP(Execute-In-Place)子系统配备了两个性能计数器,用于监控和分析缓存的性能。这些计数器能够帮助开发者了解缓存的使用情况及其效率,从而优化代码和系统设计。
两个计数器都是 32 位宽,这意味着它们能够计数的最大值为 0xFFFFFFFF(即 4294967295),一旦达到这个值,计数器会回绕(即回到 0),同时计数器的值可以通过写入任意值来清零,通常用于重置计数器以开始新的计数周期。
- 计数器 1-XIP 总访问次数:计数器 1 用于跟踪对 XIP 闪存的所有访问请求的总次数,无论访问是否命中缓存,这个计数器都会增加一次
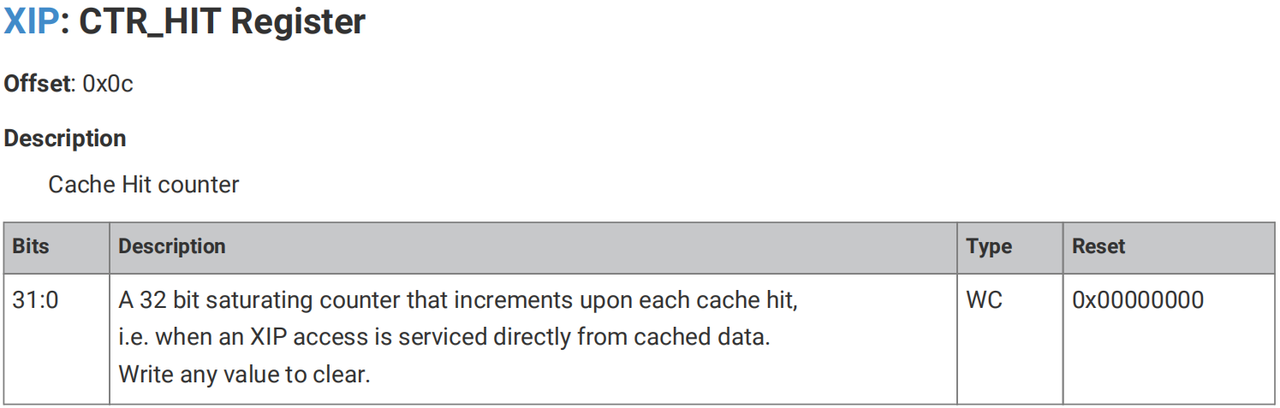
- 计数器 2-XIP 缓存命中次数:计数器 2 用于跟踪所有 XIP 访问中,缓存命中的次数,即,当请求的数据已经存在于缓存中时,这个计数器会增加一次
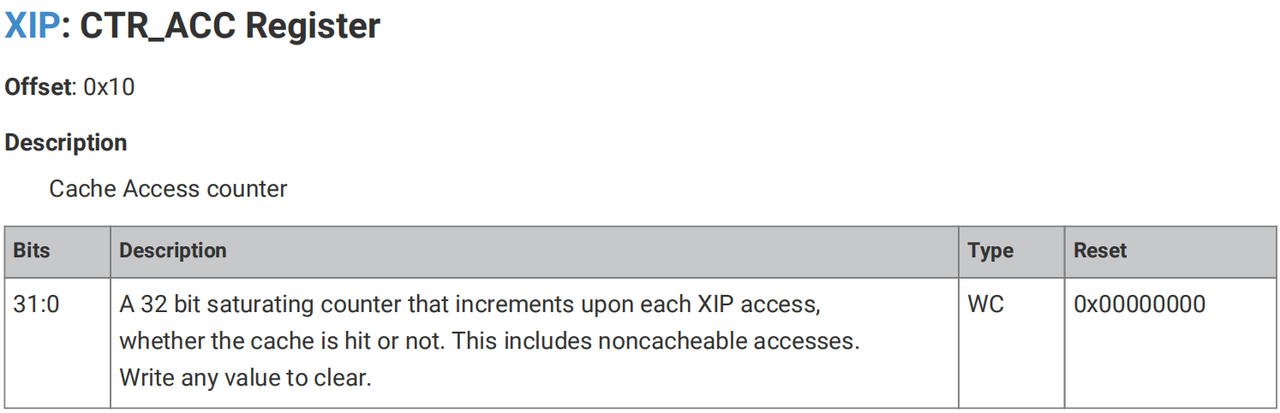
这两个计数器配合使用,可以提供有关 XIP 操作的有用性能数据。例如,通过比较命中次数与总访问次数,可以计算缓存的命中率,从而了解缓存的有效性和优化空间。

 浙公网安备 33010602011771号