
嵌入式进阶:手把手教你用 MicroPython 实现带恢复机制的软件看门狗
 在上一节的示例中,我们使用树莓派 Pico 内置看门狗实现监控系统运行状况并重启设备,但可以在文档中发现,内置看门狗也具有一些问题:
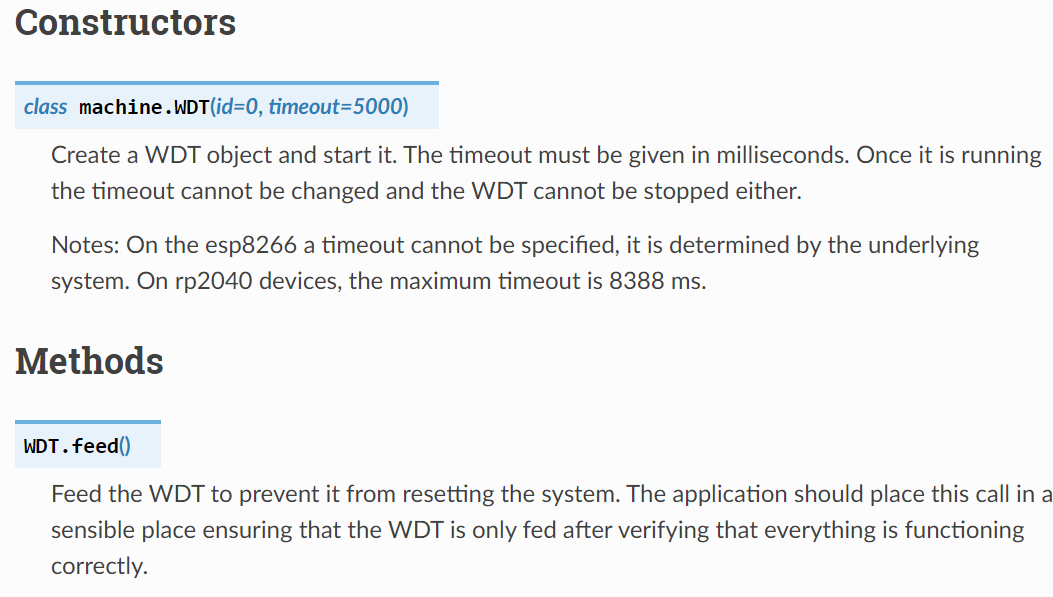
主要集中在以下两个部分:
- 固定超时时间:一旦配置好超时时间,运行期间无法调整;同时一旦超时未喂狗,硬件立即触发复位,无法延迟或者做其他处理。
- 缺乏扩展性:硬件看门狗只负责监控并复位,无法在复位前记录状态、做日志处理或尝试系统恢复。
在实际应用中,当程序出现跑飞或者异常情况时,我们通常会先尝试通过恢复操作来修复问题,例如重新初始化关键模块、重启部分功能或者执行日志记录。软件看门狗正是为此设计的,在单片机系统中,软件看门狗可以通过定时器或计数器来实现。其原理是利用定时器或计数器作为定时触发源,定时器不断倒计时,如果在设定的时间内没有被重新加载或“喂狗”,则认为系统已经陷入死循环或无法响应,触发看门狗功能,如系统复位或执行其他安全操作。
在我们如下的代码中,实现了一个多功能基于定时器实现的软件看门狗,其主要特性包括:
- 灵活的超时设置与复位延迟:软件看门狗基于定时器实现,超时时间可以根据实际需要进行配置和动态修改;同时在触发复位前可设置延迟时间,为系统恢复操作预留时间。
- 可主动停止:可以通过调用
stop()方法停止定时器,方便在系统维护升级等场景下临时关闭看门狗保护。 - 灵活参数设置:可对允许连续未喂狗的次数、调试模式是否开启、触发复位前的延迟时间进行设置。
- 灵活扩展功能:用户可通过传入自定义函数实现状态记录与日志、触发条件判断、恢复操作机制:
- 状态记录与日志:允许注册状态记录回调函数,在发生故障时记录当前状态、时间戳和失败次数,便于后续问题排查。
- 触发条件判断:可以通过自定义触发条件判断函数决定是否允许触发复位。例如,在某些故障场景下可先尝试恢复而非立即复位。
- 恢复操作机制:当检测到程序跑飞时,可以先尝试调用恢复操作(如重连网络、重启部分功能等),仅在恢复失败后才最终触发复位,这样更符合实际需求。
- 调试与性能监控:利用计时装饰器可以统计看门狗回调函数的执行时间,有助于了解系统实时性能并进行优化;并且开启调试模式后,会输出详细的状态信息和执行日志,方便开发者实时监控系统状态和故障响应过程。
具有以下方法和属性:
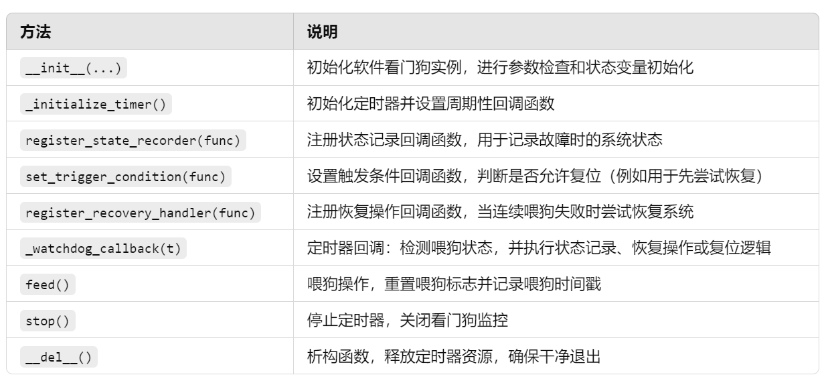
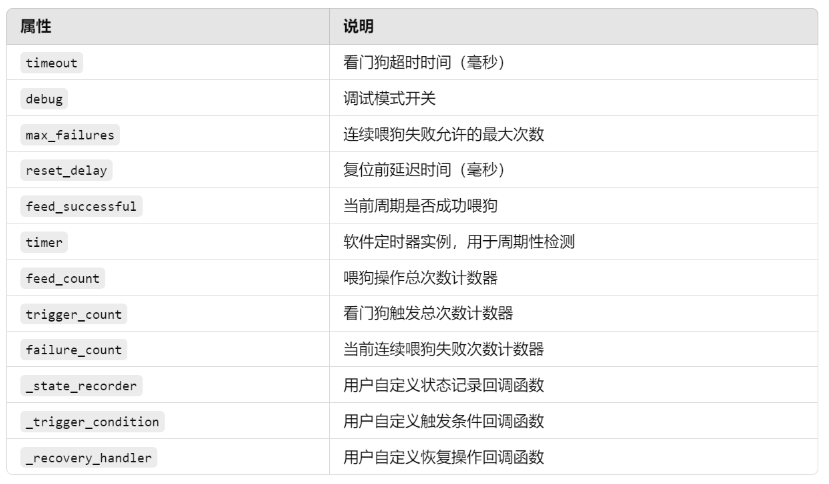
软件看门狗自定义类代码如下:
# 分配紧急异常缓冲区(必须位于所有中断代码之前)
micropython.alloc_emergency_exception_buf(100)
# 软件看门狗类
class SoftwareWatchdog:
"""
软件看门狗类,使用MicroPython的Timer实现看门狗功能。
该类封装了基于定时器的看门狗逻辑,支持超时检测、喂狗操作、状态记录、触发条件判断和恢复操作等功能。
通过注册回调函数,用户可以自定义状态记录、触发条件和恢复操作逻辑。
Attributes:
timeout (int): 看门狗超时时间,单位为毫秒(默认4000ms)。
debug (bool): 是否开启调试模式(默认开启)。
max_failures (int): 连续喂狗失败的最大次数(默认1次)。
reset_delay (int): 触发复位前的延迟时间,单位为毫秒(默认3000ms)。
feed_successful (bool): 喂狗标志,表示是否成功喂狗。
timer (Timer): 软件定时器实例,用于周期性检测喂狗状态。
feed_count (int): 喂狗次数计数器。
trigger_count (int): 看门狗触发次数计数器。
failure_count (int): 连续喂狗失败次数计数器。
_state_recorder (callable): 用户自定义状态记录回调函数。
_trigger_condition (callable): 用户自定义触发条件回调函数。
_recovery_handler (callable): 用户自定义恢复操作回调函数。
Methods:
__init__(self, timeout: int = 4000, debug: bool = True, max_failures: int = 1, reset_delay: int = 3000) -> None:
初始化软件看门狗实例。
_initialize_timer(self) -> None:
初始化定时器并设置回调函数。
register_state_recorder(self, recorder: callable[[], None]) -> None:
注册状态记录回调函数。
set_trigger_condition(self, condition: callable[[], bool]) -> None:
设置触发条件回调函数。
register_recovery_handler(self, handler: callable[[], bool]) -> None:
注册恢复操作回调函数。
_watchdog_callback(self, t: Timer) -> None:
定时器回调函数,判断是否及时喂狗,同时具有状态记录和条件判断是否触发复位功能。
feed(self) -> None:
喂狗操作,重置喂狗标志。
stop(self) -> None:
停止看门狗定时器。
__del__(self) -> None:
析构函数,确保定时器资源释放。
"""
def __init__(self, timeout: int = 4000, debug: bool = True, max_failures: int = 1, reset_delay: int = 3000) -> None:
"""
初始化软件看门狗。
Args:
timeout (int): 看门狗超时时间,单位为毫秒(默认4000ms)。
debug (bool): 是否开启调试模式(默认开启)。
max_failures (int): 连续喂狗失败的最大次数(默认1次)。
reset_delay (int): 触发复位前的延迟时间,单位为毫秒(默认3000ms)。
Returns:
None
Raises:
ValueError: 如果参数timeout、max_failures、reset_delay不是正整数或debug不是布尔值。
"""
# 入口参数检查
if not isinstance(reset_delay, int) or reset_delay <= 0:
raise ValueError("reset_delay must be a positive integer")
if not isinstance(timeout, int) or timeout <= 0:
raise ValueError("timeout must be a positive integer")
if not isinstance(max_failures, int) or max_failures <= 0:
raise ValueError("max_failures must be a positive integer")
if not isinstance(debug, bool):
raise TypeError("debug must be a boolean value")
# 设置超时时间
self.timeout = timeout
# 设置调试模式
self.debug = debug
# 设置最大失败次数
self.max_failures = max_failures
# 设置复位延迟时间
self.reset_delay = reset_delay
# 初始化喂狗标志为False
self.feed_successful = False
# 初始化软件定时器
self.timer = Timer(-1)
# 初始化喂狗次数
self.feed_count = 0
# 初始化看门狗触发次数
self.trigger_count = 0
# 初始化连续喂狗失败次数
self.failure_count = 0
# 初始化用户自定义状态记录函数为None
self._state_recorder = None
# 初始化用户自定义触发条件函数为None
self._trigger_condition = None
# 初始化恢复操作回调函数为None
self._recovery_handler = None
# 初始化定时器
self._initialize_timer()
def _initialize_timer(self) -> None:
"""
初始化定时器并设置回调函数。
Args:
None
Returns:
None
"""
# 初始化定时器,设置周期和回调函数
self.timer.init(period=self.timeout, mode=Timer.PERIODIC, callback=lambda t: schedule(self._watchdog_callback, t))
def register_state_recorder(self, recorder: callable[[], None]) -> None:
"""
注册状态记录回调函数。
Args:
recorder (callable): 无参数无返回值的回调函数,用于记录状态
Returns:
None
Raises:
TypeError: 如果参数recorder不是callable类型。
"""
# 检查recorder是否为可调用对象
if not callable(recorder):
raise TypeError("State recorder must be callable")
# 设置状态记录回调函数
self._state_recorder = recorder
def set_trigger_condition(self, condition: callable[[], bool]) -> None:
"""
设置触发条件回调函数。
Args:
condition (callable): 无参数返回bool的回调函数,返回为True表示允许触发重启。
Returns:
None
Raises:
TypeError: 如果参数condition不是callable类型。
"""
# 检查condition是否为可调用对象
if not callable(condition):
raise TypeError("Trigger condition must be callable")
# 设置触发条件回调函数
self._trigger_condition = condition
def register_recovery_handler(self, handler: callable[[], bool]) -> None:
"""
注册恢复操作回调函数。
Args:
handler (callable): 无参数有返回值的回调函数,用于执行恢复操作,返回值为True表示恢复操作成功,False表示恢复操作失败。
Returns:
None
Raises:
TypeError: 如果参数handler不是callable类型。
"""
# 检查handler是否为可调用对象
if not callable(handler):
raise TypeError("Recovery handler must be callable")
# 设置恢复操作回调函数
self._recovery_handler = handler
# 使用@timed_function装饰器,SoftwareWatchdog._watchdog_callback方法运行时间
@timed_function
def _watchdog_callback(self, t: Timer) -> None:
"""
定时器回调函数,判断是否及时喂狗,同时具有状态记录和条件判断是否触发复位功能。
Args:
t (Timer): 定时器对象(由Timer自动传入)。
Returns:
None
Raises:
Exception: 如果状态记录回调函数执行时发生错误。
Exception: 如果恢复操作回调函数执行时发生错误。
TypeError: 如果恢复操作回调函数的返回值不是布尔类型。
Exception: 如果触发条件回调函数执行时发生错误。
"""
# 原子读取喂狗标志
irq_state = disable_irq()
feed_flag = self.feed_successful
enable_irq(irq_state)
# 检查是否及时喂狗
if not feed_flag:
# 增加连续失败次数
self.failure_count += 1
# 增加触发次数
self.trigger_count += 1
# 如果调试模式开启,打印触发信息
if self.debug:
print("[Watchdog] Triggered ({} failures, {} total triggers)".format(
self.failure_count, self.trigger_count))
# 执行状态记录(如果已注册)
if self._state_recorder:
try:
self._state_recorder()
except Exception as e:
if self.debug:
print("[Error] Failed to record state:", str(e))
# 检查连续失败次数是否达到最大值
if self.failure_count >= self.max_failures:
# 恢复操作是否成功的标志
recovery_successful = False
# 尝试恢复操作
if self._recovery_handler:
try:
if self.debug:
print("[Watchdog] Attempting recovery...")
# 尝试恢复操作
recovery_successful = self._recovery_handler()
# 判断recovery_successful是否为bool变量
if not isinstance(recovery_successful, bool):
raise TypeError("Recovery handler must return a boolean value")
except Exception as e:
if self.debug:
print("[Error] Recovery handler failed:", str(e))
# 检查恢复操作是否成功
if recovery_successful:
# 重置连续失败次数
self.failure_count = 0
# 重置应该触发标注位
self.should_trigger = False
if self.debug:
print("[Watchdog] Recovery successful, resetting failure count...")
else:
# 如果恢复失败,检查触发条件
# 默认触发
should_trigger = True
# 检查触发条件是否已注册
if self._trigger_condition:
try:
# 执行触发条件检查
should_trigger = self._trigger_condition()
except Exception as e:
if self.debug:
print("[Error] Trigger condition check failed:", str(e))
# 默认触发
should_trigger = True
# 如果满足触发条件,触发复位
if should_trigger:
if self.debug:
print("[Watchdog] Max failures reached, resetting system after %d ms..." %(self.reset_delay))
# 创建单次定时器,延迟指定时间后执行复位
self.reset_timer = Timer(-1)
self.reset_timer.init(period=self.reset_delay, mode=Timer.ONE_SHOT, callback=lambda t: reset())
else:
# 重置连续失败次数
self.failure_count = 0
# 原子重置
irq_state = disable_irq()
# 复位喂狗标志
self.feed_successful = False
enable_irq(irq_state)
def feed(self) -> None:
"""
喂狗操作,重置喂狗标志。
Args:
None
Returns:
None
"""
irq_state = disable_irq()
self.feed_successful = True
# 增加喂狗次数
self.feed_count += 1
enable_irq(irq_state)
# 如果调试模式开启,打印喂狗时间
if self.debug:
print("Watchdog fed at:", time.ticks_ms())
def stop(self) -> None:
"""
停止看门狗定时器。
Args:
None
Returns:
None
"""
# 停止定时器
self.timer.deinit()
if self.debug:
print("Watchdog stopped.")
def __del__(self):
"""
析构函数:确保定时器资源释放。
Args:
None
Returns:
None
"""
self.timer.deinit()
if self.debug:
print("Watchdog resources released.")
可以看到,在定义类之前,我们先分配了一块紧急异常内存缓冲区,用于存储在中断上下文中发生异常时的异常信息,确保即使在中断中发生异常,也能捕获并记录异常信息,从而便于后续调试和排查问题。
该类的基本原理如上文所说,即利用 MicroPython 的 Timer 模块在 _initialize_timer() 方法中创建周期性定时器,定时调用 _watchdog_callback 回调函数检查喂狗标志,从而实现看门狗机制,类似于硬件看门狗;在检测到连续未喂狗(即系统未正常响应)的情况时,通过触发恢复操作或系统复位来防止系统长时间处于异常状态。
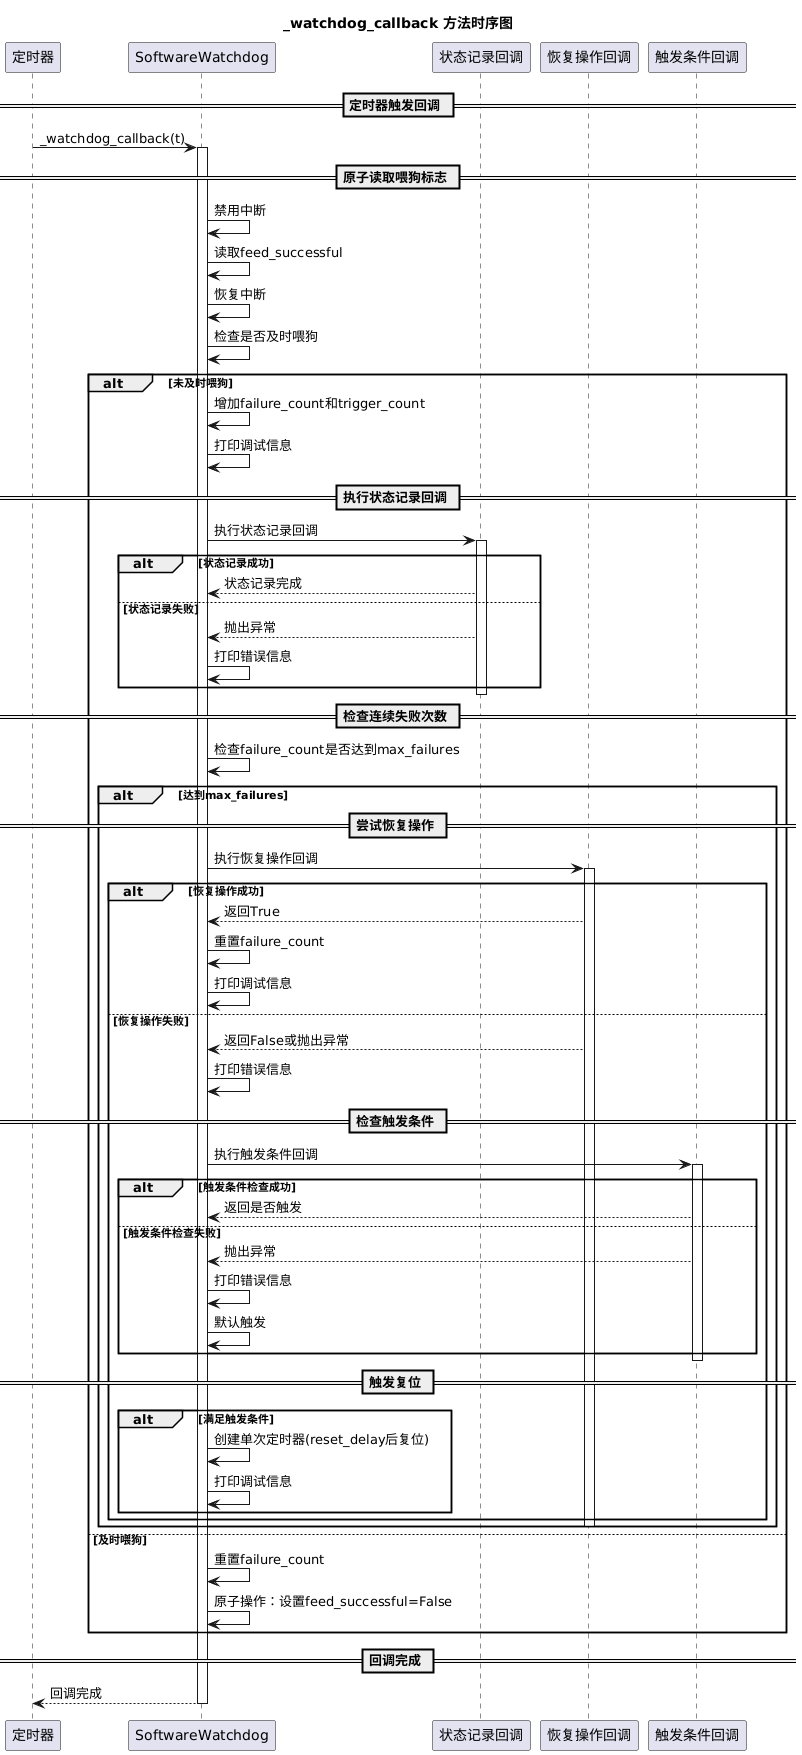
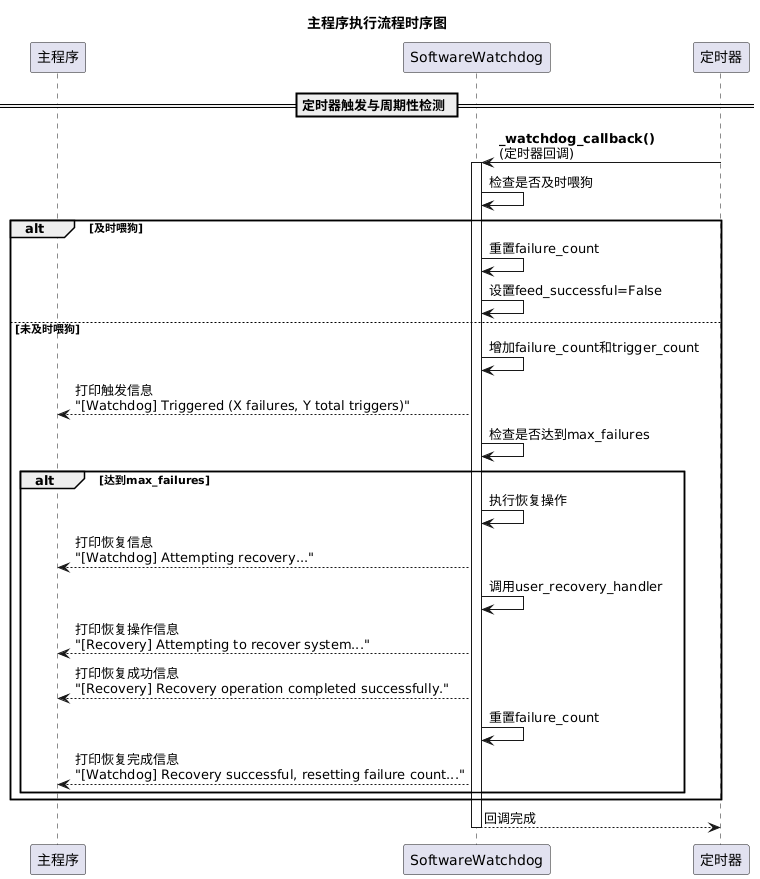
实现扩展功能的核心方法为定时器回调函数 _watchdog_callback:
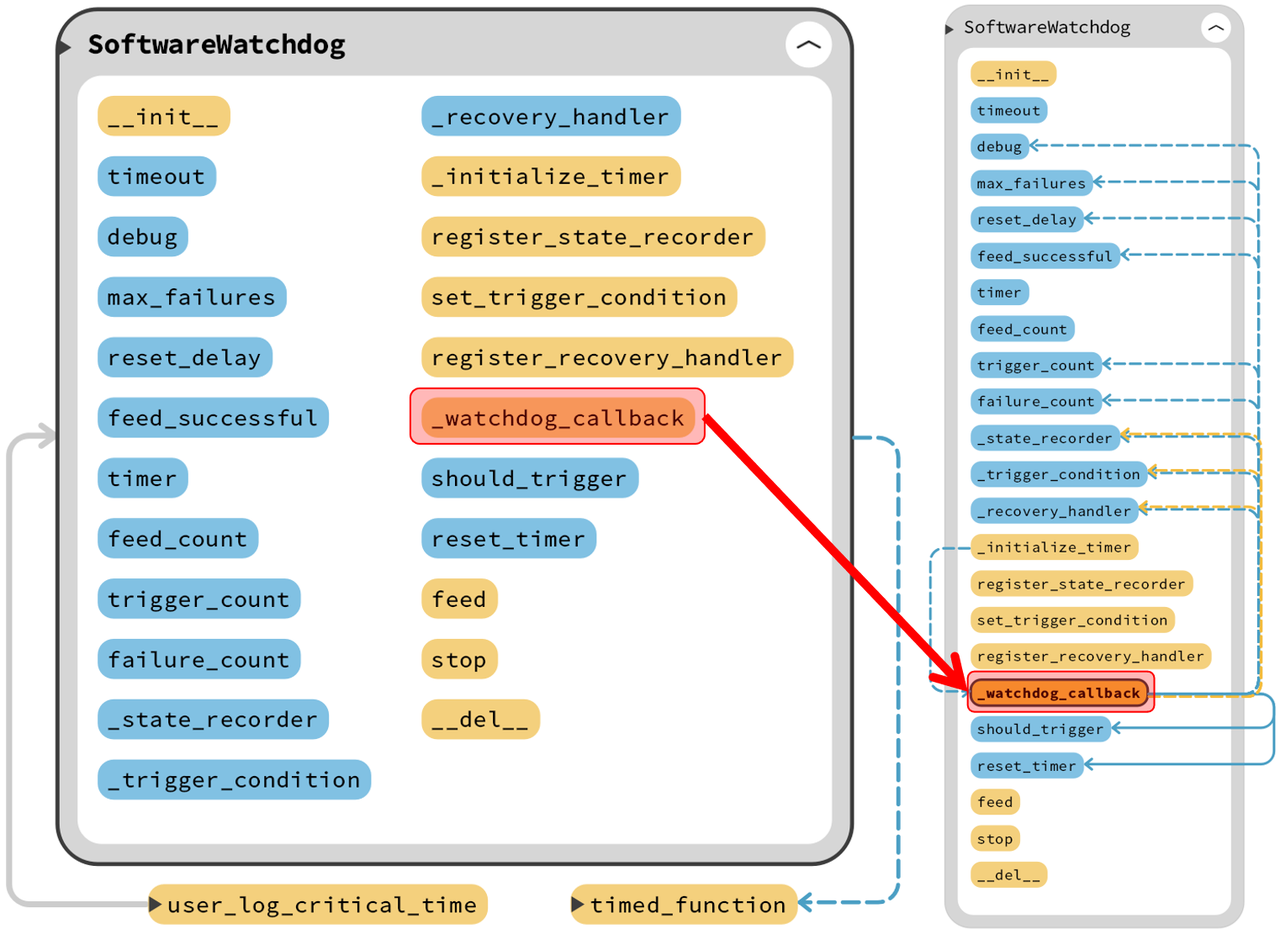
其流程可以概括为:
- 喂狗检测:首先读取
feed_successful标志检测是否有喂狗操作,如果在当前周期内没有收到喂狗信号(feed_successful为False),则增加连续失败计数和总触发次数,并输出调试信息。 - 状态记录:如果用户注册了状态记录函数,则在未喂狗时调用该函数记录当前状态。
- 恢复与复位决策:
- 当连续失败次数达到允许连续未喂狗的次数
max_failures时,首先尝试调用恢复操作。 - 如果恢复操作成功,重置连续失败计数;若恢复失败,再通过触发条件判断(如果注册了条件函数)决定是否启动系统复位。
- 系统复位通过创建一个一次性定时器实现,延迟
reset_delay毫秒后调用reset()进行复位。
- 当连续失败次数达到允许连续未喂狗的次数
具体时序如下图所示:
用户可以通过下面三个方法来实现自定义回调函数注册:
- 状态记录函数:用户可以通过
register_state_recorder方法注册一个状态记录回调函数,该函数可用于记录当前系统状态、日志信息等,便于故障排查。 - 触发条件判断函数:通过
set_trigger_condition方法设置一个返回布尔值的回调函数,用于判断是否在恢复失败后满足触发系统复位的条件。用户可以根据系统具体需求进行自定义。 - 恢复操作函数:利用
register_recovery_handler方法注册恢复操作回调函数,当连续喂狗失败达到上限时,该函数被调用以尝试恢复系统。如果恢复成功,则失败计数重置;否则,根据触发条件可能进入复位流程。
接下来,我们定义几个自定义回调函数对该类进行测试:
# Python env : MicroPython v1.23.0
# -*- coding: utf-8 -*-
# @Time : 2024/8/16 上午10:51
# @Author : 李清水
# @File : main.py
# @Description : WDT看门狗定时器类实验,使用Pico软件定时器实现
# ======================================== 导入相关模块 ========================================
# 导入硬件相关模块
from machine import Timer, reset, disable_irq, enable_irq
# 导入时间相关模块
import time
# 导入scheduler方法
from micropython import schedule
# 导入micropython相关模块
import micropython
# ======================================== 全局变量 ============================================
# 设置触发条件的阈值
threshold = 10
# 假设当前的值是0
current_value = 12
# 声明看门狗对象
watchdog = None
# ======================================== 功能函数 ============================================
# 用户自定义状态记录函数
def user_log_critical_time() -> None:
"""
用户自定义状态记录函数,用于将当前时间戳、当前值、看门狗触发次数、连续喂狗失败次数写入日志文件。
当日志文件行数超过 50 条时,自动创建新的日志文件。
Args:
None
Returns:
None
Raises:
Exception: 如果写入日志文件时发生错误。
"""
# 声明全局变量
global watchdog, current_value
# 获取当前时间戳
timestamp = time.ticks_ms()
# 日志文件的基础名称
log_base_name = "/log"
log_extension = ".txt"
log_index = 0
log_file = f"{log_base_name}{log_index}{log_extension}"
# 查找最新的日志文件
while True:
try:
# 尝试打开文件以检查是否存在
with open(log_file, "r") as f:
lines = f.readlines()
# 如果文件行数小于 10,继续使用当前文件
if len(lines) < 10:
break
except OSError:
# 如果文件不存在,使用当前文件
break
# 如果文件行数超过 10,递增索引,尝试下一个文件
log_index += 1
log_file = f"{log_base_name}{log_index}{log_extension}"
# 将时间戳、当前值、看门狗触发次数、连续喂狗失败次数写入日志文件
try:
with open(log_file, "a") as f:
# 使用 % 格式化字符串
log_entry = "Timestamp: %d ms, Current Value: %d, Triggers: %d, Failures: %d\n" % (
timestamp, current_value, watchdog.trigger_count, watchdog.failure_count
)
f.write(log_entry)
# 确保数据写入存储设备
f.flush()
except Exception as e:
print("[Error] Failed to write log:", str(e))
# 用户自定义触发条件函数
@micropython.native
def user_check_threshold() -> bool:
"""
用户自定义触发条件函数,用于判断是否达到阈值。
Args:
None
Returns:
bool: True表示达到阈值,False表示未达到阈值
Raises:
None
"""
# 声明全局变量
global current_value, threshold
# 检查是否达到阈值
if current_value >= threshold:
# 到达触发阈值,返回True并打印信息
print("[Trigger] Threshold reached, triggering watchdog...")
return True
# 没有达到阈值,返回False并打印信息
print("[Info] Current value is below threshold, no need to trigger watchdog...")
return False
# 自定义恢复操作函数
@micropython.native
def user_recovery_handler() -> bool:
"""
用户自定义恢复操作函数,用于执行恢复操作。
Args:
None
Returns:
bool: True表示恢复操作成功,False表示恢复操作失败
Raises:
Exception: 如果恢复操作执行过程中发生错误。
"""
# 声明全局变量
global watchdog
# 打印恢复操作信息
print("[Recovery] Attempting to recover system...")
# 模拟恢复操作
try:
# 用户可以在这里执行恢复操作,例如重启系统、重新连接网络等。
pass
except Exception as e:
print("[Error] Failed to recover system:", str(e))
# 返回False表示恢复操作失败
return False
# 打印恢复操作成功信息
print("[Recovery] Recovery operation completed successfully.")
# 返回True表示恢复操作成功
return True
接下来我们对其函数进行讲解:
- 状态记录
user_log_critical_time()函数:我们记录系统的关键状态信息,包括当前时间戳、当前值、看门狗触发次数以及连续喂狗失败次数,并创建了记录日志文件将其关键信息写入到 log 文件中:- 日志文件管理:通过构造日志文件名(如
/log0.txt、/log1.txt等),依次检测当前日志文件是否存在,以及文件行数是否低于阈值;如果当前文件行数达到或超过阈值,就递增日志文件索引,使用新文件记录,从而避免单个文件过大。 - 状态记录:获取当前系统时间(毫秒级别),并利用设置的全局变量构造日志记录内容;使用
%格式化字符串拼接日志条目,再以追加模式写入文件。 - 异常处理:使用
try/except捕捉文件操作中的异常,确保在写入日志时遇到错误能够输出提示,避免程序中断。
- 日志文件管理:通过构造日志文件名(如
- 触发条件判断
user_check_threshold()函数:检查系统当前状态值是否达到预设的阈值,如果current_value大于或等于阈值,则认为触发条件满足,并返回True,同时输出提示信息;否则返回False,该函数仅是用于测试软件定时器类的触发条件判断功能,为方便讲解将系统当前状态值设定为固定值。 - 恢复操作
user_recovery_handler()函数:这里,我们模拟执行系统恢复操作,当系统连续喂狗失败达到一定次数后,调用此函数尝试进行恢复;如果恢复操作成功(在此例中始终模拟成功),则返回True;若遇到异常或操作失败则返回False,为方便讲解这里我们假定恢复操作成功。
这里,在触发条件判断 user_check_threshold() 函数和恢复操作 user_recovery_handler() 函数中,我们使用了函数装饰器 @micropython.native 来启用本地代码发射器,生成的本地代码运行速度更快,性能提升显著(大约是字节码的两倍),但代价是本地代码体积更大,占用更多的存储空间。
同时,再导入一个计时装饰器,用于计算并打印函数/方法运行时间:
# 计时装饰器,用于计算函数运行时间
@micropython.native
def timed_function(f: callable, *args: tuple, **kwargs: dict) -> callable:
"""
计时装饰器,用于计算并打印函数/方法运行时间。
Args:
f (callable): 需要传入的函数/方法
args (tuple): 函数/方法 f 传入的任意数量的位置参数
kwargs (dict): 函数/方法 f 传入的任意数量的关键字参数
Returns:
callable: 返回计时后的函数
"""
myname = str(f).split(' ')[1]
def new_func(*args: tuple, **kwargs: dict) -> any:
t: int = time.ticks_us()
result = f(*args, **kwargs)
delta: int = time.ticks_diff(time.ticks_us(), t)
print('Function {} Time = {:6.3f}ms'.format(myname, delta / 1000))
return result
return new_func
初始化软件看门狗实例之后,可以通过 register_state_recorder() 方法、set_trigger_condition() 方法、register_recovery_handler() 方法来注册相关函数,其实现原理就是通过传入并存储函数的引用来实现的,以下面 register_recovery_handler() 方法为例:
def register_state_recorder(self, recorder: callable[[], None]) -> None:
"""
注册状态记录回调函数。
Args:
recorder (callable): 无参数无返回值的回调函数,用于记录状态
Returns:
None
Raises:
TypeError: 如果参数recorder不是callable类型。
"""
# 检查recorder是否为可调用对象
if not callable(recorder):
raise TypeError("State recorder must be callable")
# 设置状态记录回调函数
self._state_recorder = recorder
这里,recorder 只是一个函数引用,它指向用户传入的函数,之后,当 self._state_recorder() 被调用时,它会执行原始函数的代码。
我们可以通过下面的语句来注册相关函数:
# 初始化软件看门狗,设置超时时间为4秒,最大连续失败次数为3次,复位延迟时间为1秒
watchdog = SoftwareWatchdog(timeout=4000, debug=True, max_failures=3, reset_delay=1000)
# 注册状态记录回调函数
watchdog.register_state_recorder(user_log_critical_time)
# 设置触发条件回调函数
watchdog.set_trigger_condition(user_check_threshold)
# 注册恢复操作回调函数
watchdog.register_recovery_handler(user_recovery_handler)
以下代码可以在我们提供的资料包中 elegance-devkit v1\Demo\53 WDG_Timer 文件夹找到。
在下面的示例中,我们将会使用上面实现的 SoftwareWatchdog 软件定时器类监控系统的运行状态,并在系统出现异常时执行恢复操作,完整代码如下所示:
# Python env : MicroPython v1.23.0
# -*- coding: utf-8 -*-
# @Time : 2024/8/16 上午10:51
# @Author : 李清水
# @File : main.py
# @Description : WDT看门狗定时器类实验,使用Pico软件定时器实现
# ======================================== 导入相关模块 ========================================
# 导入硬件相关模块
from machine import Timer, reset, disable_irq, enable_irq
# 导入时间相关模块
import time
# 导入scheduler方法
from micropython import schedule
# 导入micropython相关模块
import micropython
# ======================================== 全局变量 ============================================
# 设置触发条件的阈值
threshold = 10
# 假设当前的值是0
current_value = 12
# 声明看门狗对象
watchdog = None
# ======================================== 功能函数 ============================================
# 用户自定义状态记录函数
def user_log_critical_time() -> None:
"""
用户自定义状态记录函数,用于将当前时间戳、当前值、看门狗触发次数、连续喂狗失败次数写入日志文件。
当日志文件行数超过 50 条时,自动创建新的日志文件。
Args:
None
Returns:
None
Raises:
Exception: 如果写入日志文件时发生错误。
"""
# 声明全局变量
global watchdog, current_value
# 获取当前时间戳
timestamp = time.ticks_ms()
# 日志文件的基础名称
log_base_name = "/log"
log_extension = ".txt"
log_index = 0
log_file = f"{log_base_name}{log_index}{log_extension}"
# 查找最新的日志文件
while True:
try:
# 尝试打开文件以检查是否存在
with open(log_file, "r") as f:
lines = f.readlines()
# 如果文件行数小于 10,继续使用当前文件
if len(lines) < 10:
break
except OSError:
# 如果文件不存在,使用当前文件
break
# 如果文件行数超过 10,递增索引,尝试下一个文件
log_index += 1
log_file = f"{log_base_name}{log_index}{log_extension}"
# 将时间戳、当前值、看门狗触发次数、连续喂狗失败次数写入日志文件
try:
with open(log_file, "a") as f:
# 使用 % 格式化字符串
log_entry = "Timestamp: %d ms, Current Value: %d, Triggers: %d, Failures: %d\n" % (
timestamp, current_value, watchdog.trigger_count, watchdog.failure_count
)
f.write(log_entry)
# 确保数据写入存储设备
f.flush()
except Exception as e:
print("[Error] Failed to write log:", str(e))
# 用户自定义触发条件函数
@micropython.native
def user_check_threshold() -> bool:
"""
用户自定义触发条件函数,用于判断是否达到阈值。
Args:
None
Returns:
bool: True表示达到阈值,False表示未达到阈值
Raises:
None
"""
# 声明全局变量
global current_value, threshold
# 检查是否达到阈值
if current_value >= threshold:
# 到达触发阈值,返回True并打印信息
print("[Trigger] Threshold reached, triggering watchdog...")
return True
# 没有达到阈值,返回False并打印信息
print("[Info] Current value is below threshold, no need to trigger watchdog...")
return False
# 自定义恢复操作函数
@micropython.native
def user_recovery_handler() -> bool:
"""
用户自定义恢复操作函数,用于执行恢复操作。
Args:
None
Returns:
bool: True表示恢复操作成功,False表示恢复操作失败
Raises:
Exception: 如果恢复操作执行过程中发生错误。
"""
# 声明全局变量
global watchdog
# 打印恢复操作信息
print("[Recovery] Attempting to recover system...")
# 模拟恢复操作
try:
# 用户可以在这里执行恢复操作,例如重启系统、重新连接网络等。
pass
except Exception as e:
print("[Error] Failed to recover system:", str(e))
# 返回False表示恢复操作失败
return False
# 打印恢复操作成功信息
print("[Recovery] Recovery operation completed successfully.")
# 返回True表示恢复操作成功
return True
# 计时装饰器,用于计算函数运行时间
@micropython.native
def timed_function(f: callable, *args: tuple, **kwargs: dict) -> callable:
"""
计时装饰器,用于计算并打印函数/方法运行时间。
Args:
f (callable): 需要传入的函数/方法
args (tuple): 函数/方法 f 传入的任意数量的位置参数
kwargs (dict): 函数/方法 f 传入的任意数量的关键字参数
Returns:
callable: 返回计时后的函数
"""
myname = str(f).split(' ')[1]
def new_func(*args: tuple, **kwargs: dict) -> any:
t: int = time.ticks_us()
result = f(*args, **kwargs)
delta: int = time.ticks_diff(time.ticks_us(), t)
print('Function {} Time = {:6.3f}ms'.format(myname, delta / 1000))
return result
return new_func
# ======================================== 自定义类 ============================================
# 分配紧急异常缓冲区(必须位于所有中断代码之前)
micropython.alloc_emergency_exception_buf(100)
# 软件看门狗类
class SoftwareWatchdog:
"""
软件看门狗类,使用MicroPython的Timer实现看门狗功能。
该类封装了基于定时器的看门狗逻辑,支持超时检测、喂狗操作、状态记录、触发条件判断和恢复操作等功能。
通过注册回调函数,用户可以自定义状态记录、触发条件和恢复操作逻辑。
Attributes:
timeout (int): 看门狗超时时间,单位为毫秒(默认4000ms)。
debug (bool): 是否开启调试模式(默认开启)。
max_failures (int): 连续喂狗失败的最大次数(默认1次)。
reset_delay (int): 触发复位前的延迟时间,单位为毫秒(默认3000ms)。
feed_successful (bool): 喂狗标志,表示是否成功喂狗。
timer (Timer): 软件定时器实例,用于周期性检测喂狗状态。
feed_count (int): 喂狗次数计数器。
trigger_count (int): 看门狗触发次数计数器。
failure_count (int): 连续喂狗失败次数计数器。
_state_recorder (callable): 用户自定义状态记录回调函数。
_trigger_condition (callable): 用户自定义触发条件回调函数。
_recovery_handler (callable): 用户自定义恢复操作回调函数。
Methods:
__init__(self, timeout: int = 4000, debug: bool = True, max_failures: int = 1, reset_delay: int = 3000) -> None:
初始化软件看门狗实例。
_initialize_timer(self) -> None:
初始化定时器并设置回调函数。
register_state_recorder(self, recorder: callable[[], None]) -> None:
注册状态记录回调函数。
set_trigger_condition(self, condition: callable[[], bool]) -> None:
设置触发条件回调函数。
register_recovery_handler(self, handler: callable[[], bool]) -> None:
注册恢复操作回调函数。
_watchdog_callback(self, t: Timer) -> None:
定时器回调函数,判断是否及时喂狗,同时具有状态记录和条件判断是否触发复位功能。
feed(self) -> None:
喂狗操作,重置喂狗标志。
stop(self) -> None:
停止看门狗定时器。
__del__(self) -> None:
析构函数,确保定时器资源释放。
"""
def __init__(self, timeout: int = 4000, debug: bool = True, max_failures: int = 1, reset_delay: int = 3000) -> None:
"""
初始化软件看门狗。
Args:
timeout (int): 看门狗超时时间,单位为毫秒(默认4000ms)。
debug (bool): 是否开启调试模式(默认开启)。
max_failures (int): 连续喂狗失败的最大次数(默认1次)。
reset_delay (int): 触发复位前的延迟时间,单位为毫秒(默认3000ms)。
Returns:
None
Raises:
ValueError: 如果参数timeout、max_failures、reset_delay不是正整数或debug不是布尔值。
"""
# 入口参数检查
if not isinstance(reset_delay, int) or reset_delay <= 0:
raise ValueError("reset_delay must be a positive integer")
if not isinstance(timeout, int) or timeout <= 0:
raise ValueError("timeout must be a positive integer")
if not isinstance(max_failures, int) or max_failures <= 0:
raise ValueError("max_failures must be a positive integer")
if not isinstance(debug, bool):
raise TypeError("debug must be a boolean value")
# 设置超时时间
self.timeout = timeout
# 设置调试模式
self.debug = debug
# 设置最大失败次数
self.max_failures = max_failures
# 设置复位延迟时间
self.reset_delay = reset_delay
# 初始化喂狗标志为False
self.feed_successful = False
# 初始化软件定时器
self.timer = Timer(-1)
# 初始化喂狗次数
self.feed_count = 0
# 初始化看门狗触发次数
self.trigger_count = 0
# 初始化连续喂狗失败次数
self.failure_count = 0
# 初始化用户自定义状态记录函数为None
self._state_recorder = None
# 初始化用户自定义触发条件函数为None
self._trigger_condition = None
# 初始化恢复操作回调函数为None
self._recovery_handler = None
# 初始化定时器
self._initialize_timer()
def _initialize_timer(self) -> None:
"""
初始化定时器并设置回调函数。
Args:
None
Returns:
None
"""
# 初始化定时器,设置周期和回调函数
self.timer.init(period=self.timeout, mode=Timer.PERIODIC, callback=lambda t: schedule(self._watchdog_callback, t))
def register_state_recorder(self, recorder: callable[[], None]) -> None:
"""
注册状态记录回调函数。
Args:
recorder (callable): 无参数无返回值的回调函数,用于记录状态
Returns:
None
Raises:
TypeError: 如果参数recorder不是callable类型。
"""
# 检查recorder是否为可调用对象
if not callable(recorder):
raise TypeError("State recorder must be callable")
# 设置状态记录回调函数
self._state_recorder = recorder
def set_trigger_condition(self, condition: callable[[], bool]) -> None:
"""
设置触发条件回调函数。
Args:
condition (callable): 无参数返回bool的回调函数,返回为True表示允许触发重启。
Returns:
None
Raises:
TypeError: 如果参数condition不是callable类型。
"""
# 检查condition是否为可调用对象
if not callable(condition):
raise TypeError("Trigger condition must be callable")
# 设置触发条件回调函数
self._trigger_condition = condition
def register_recovery_handler(self, handler: callable[[], bool]) -> None:
"""
注册恢复操作回调函数。
Args:
handler (callable): 无参数有返回值的回调函数,用于执行恢复操作,返回值为True表示恢复操作成功,False表示恢复操作失败。
Returns:
None
Raises:
TypeError: 如果参数handler不是callable类型。
"""
# 检查handler是否为可调用对象
if not callable(handler):
raise TypeError("Recovery handler must be callable")
# 设置恢复操作回调函数
self._recovery_handler = handler
# 使用@timed_function装饰器,SoftwareWatchdog._watchdog_callback方法运行时间
@timed_function
def _watchdog_callback(self, t: Timer) -> None:
"""
定时器回调函数,判断是否及时喂狗,同时具有状态记录和条件判断是否触发复位功能。
Args:
t (Timer): 定时器对象(由Timer自动传入)。
Returns:
None
Raises:
Exception: 如果状态记录回调函数执行时发生错误。
Exception: 如果恢复操作回调函数执行时发生错误。
TypeError: 如果恢复操作回调函数的返回值不是布尔类型。
Exception: 如果触发条件回调函数执行时发生错误。
"""
# 原子读取喂狗标志
irq_state = disable_irq()
feed_flag = self.feed_successful
enable_irq(irq_state)
# 检查是否及时喂狗
if not feed_flag:
# 增加连续失败次数
self.failure_count += 1
# 增加触发次数
self.trigger_count += 1
# 如果调试模式开启,打印触发信息
if self.debug:
print("[Watchdog] Triggered ({} failures, {} total triggers)".format(
self.failure_count, self.trigger_count))
# 执行状态记录(如果已注册)
if self._state_recorder:
try:
self._state_recorder()
except Exception as e:
if self.debug:
print("[Error] Failed to record state:", str(e))
# 检查连续失败次数是否达到最大值
if self.failure_count >= self.max_failures:
# 恢复操作是否成功的标志
recovery_successful = False
# 尝试恢复操作
if self._recovery_handler:
try:
if self.debug:
print("[Watchdog] Attempting recovery...")
# 尝试恢复操作
recovery_successful = self._recovery_handler()
# 判断recovery_successful是否为bool变量
if not isinstance(recovery_successful, bool):
raise TypeError("Recovery handler must return a boolean value")
except Exception as e:
if self.debug:
print("[Error] Recovery handler failed:", str(e))
# 检查恢复操作是否成功
if recovery_successful:
# 重置连续失败次数
self.failure_count = 0
# 重置应该触发标注位
self.should_trigger = False
if self.debug:
print("[Watchdog] Recovery successful, resetting failure count...")
else:
# 如果恢复失败,检查触发条件
# 默认触发
should_trigger = True
# 检查触发条件是否已注册
if self._trigger_condition:
try:
# 执行触发条件检查
should_trigger = self._trigger_condition()
except Exception as e:
if self.debug:
print("[Error] Trigger condition check failed:", str(e))
# 默认触发
should_trigger = True
# 如果满足触发条件,触发复位
if should_trigger:
if self.debug:
print("[Watchdog] Max failures reached, resetting system after %d ms..." %(self.reset_delay))
# 创建单次定时器,延迟指定时间后执行复位
self.reset_timer = Timer(-1)
self.reset_timer.init(period=self.reset_delay, mode=Timer.ONE_SHOT, callback=lambda t: reset())
else:
# 重置连续失败次数
self.failure_count = 0
# 原子重置
irq_state = disable_irq()
# 复位喂狗标志
self.feed_successful = False
enable_irq(irq_state)
def feed(self) -> None:
"""
喂狗操作,重置喂狗标志。
Args:
None
Returns:
None
"""
irq_state = disable_irq()
self.feed_successful = True
# 增加喂狗次数
self.feed_count += 1
enable_irq(irq_state)
# 如果调试模式开启,打印喂狗时间
if self.debug:
print("Watchdog fed at:", time.ticks_ms())
def stop(self) -> None:
"""
停止看门狗定时器。
Args:
None
Returns:
None
"""
# 停止定时器
self.timer.deinit()
if self.debug:
print("Watchdog stopped.")
def __del__(self):
"""
析构函数:确保定时器资源释放。
Args:
None
Returns:
None
"""
self.timer.deinit()
if self.debug:
print("Watchdog resources released.")
# ======================================== 初始化配置 ==========================================
# 上电延时3s
time.sleep(3)
# 打印调试信息
print("FreakStudio : Implement Watchdog Timer using a software timer Test")
# 初始化软件看门狗,设置超时时间为4秒,最大连续失败次数为3次,复位延迟时间为1秒
watchdog = SoftwareWatchdog(timeout=4000, debug=True, max_failures=3, reset_delay=1000)
# 注册状态记录回调函数
watchdog.register_state_recorder(user_log_critical_time)
# 设置触发条件回调函数
watchdog.set_trigger_condition(user_check_threshold)
# 注册恢复操作回调函数
watchdog.register_recovery_handler(user_recovery_handler)
# ======================================== 主程序 ===========================================
# 在超时时间内喂狗十次,看门狗定时器不触发复位
for i in range(2):
# 喂狗
watchdog.feed()
# 延时2秒
time.sleep(2)
烧录程序,连接树莓派 Pico,终端输出如下:
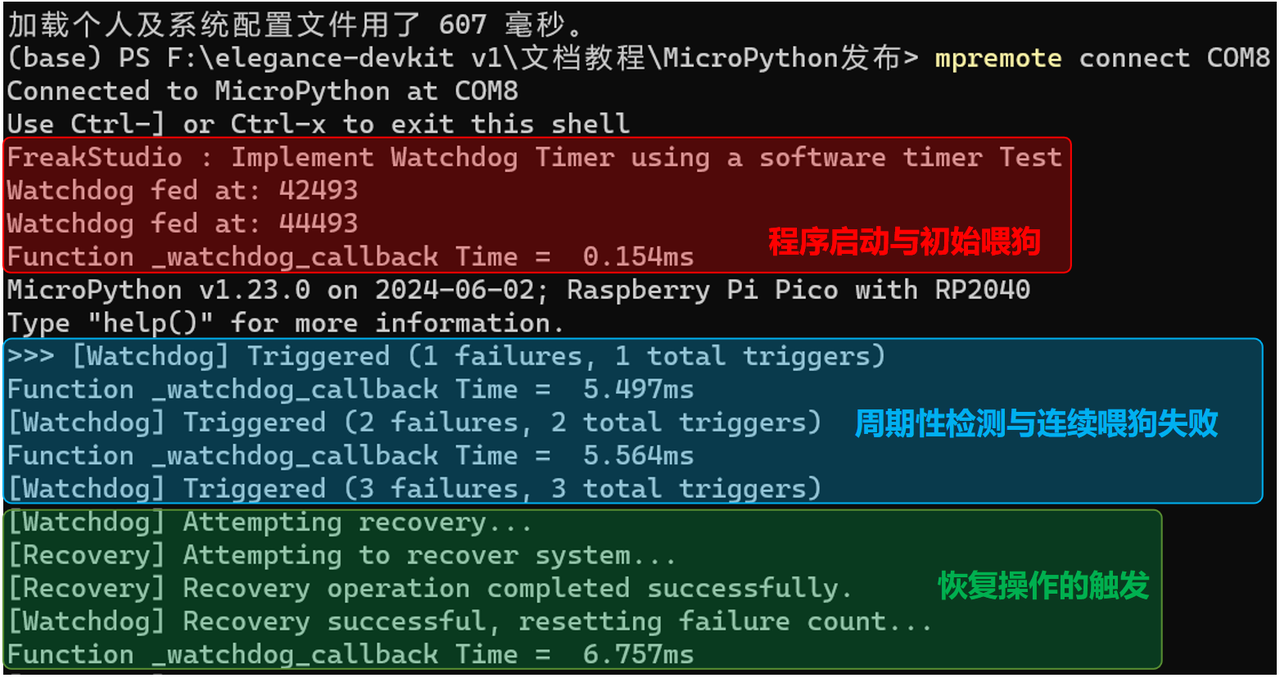
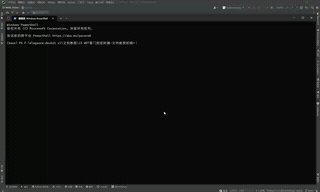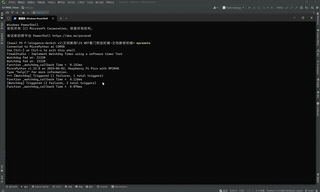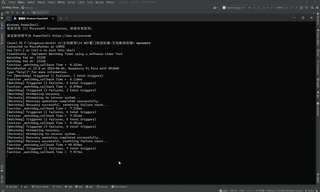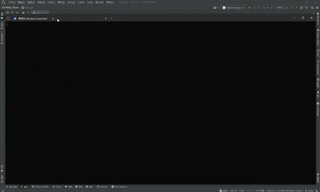
可以看到程序运行的基本流程为:
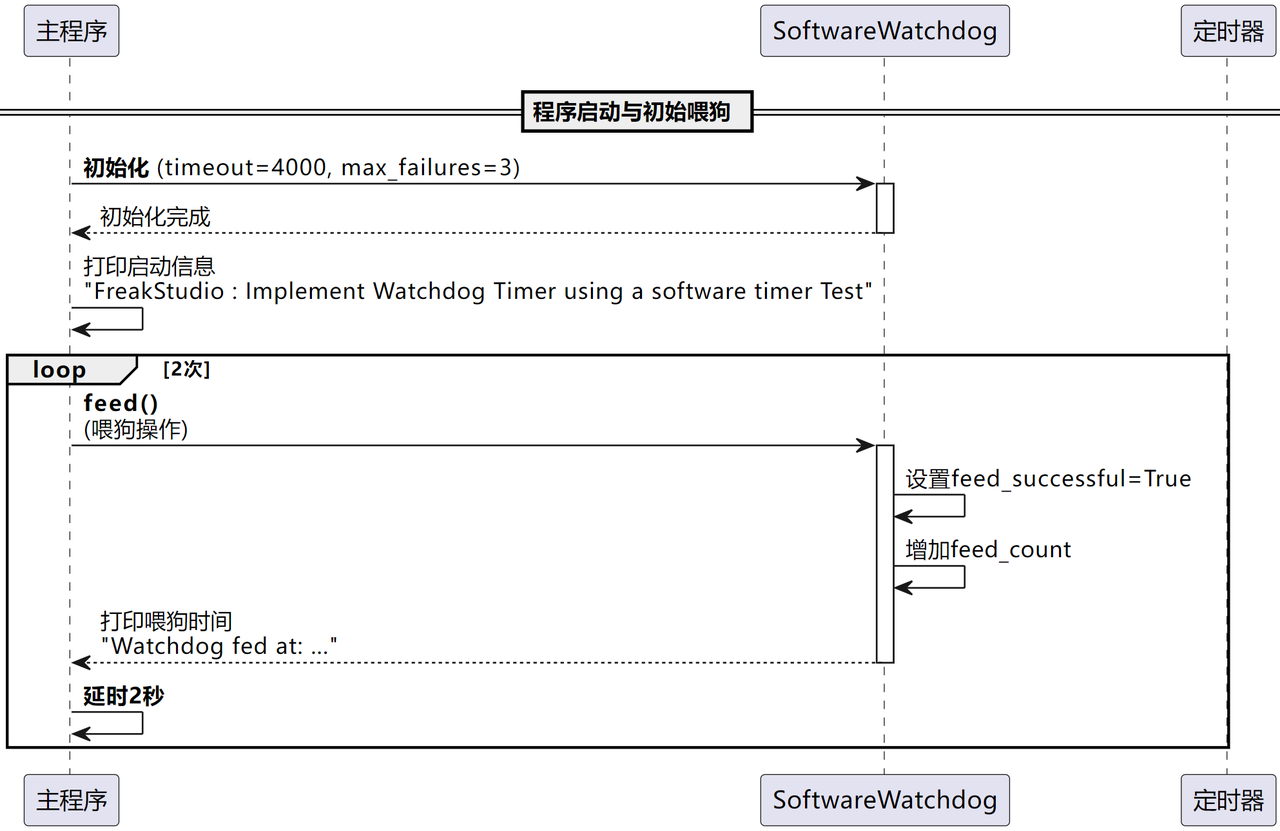
- 程序启动与初始喂狗:首先进行程序启动,终端首先显示
“FreakStudio : Implement Watchdog Timer using a software timer Test”,随后打印出两次“Watchdog fed at: …”消息,表明在主程序中调用了两次watchdog.feed(),这两次调用成功地将喂狗标志设为 True,同时记录了喂狗时刻;同时在第一次调用看门狗回调函数时(输出“Function _watchdog_callback Time = … ms”),说明定时器已经启动并进入周期性检测阶段。
-
周期性检测与连续喂狗失败:由于主程序循环结束(没有继续调用
feed()),后续每个周期内看门狗回调函数检测到 feed_successful 为 False,从而进入“未及时喂狗”状态,在每个未喂狗的周期,程序按以下步骤工作:- 增加连续失败计数(
failure_count)和总触发计数(trigger_count); - 第一次未喂狗时,输出
“[Watchdog] Triggered (1 failures, 1 total triggers)”; - 第二次检测时,
“[Watchdog] Triggered (2 failures, 2 total triggers)”; - 当连续失败达到 3 次时(比如第一次达到
“(3 failures, 3 total triggers)”),系统进入恢复阶段。
- 增加连续失败计数(
-
恢复操作的触发:当连续喂狗失败次数达到预设的最大值(本例中为 3 次)时,输出
“[Watchdog] Attempting recovery...”开始恢复操作:![9.png]()
- 调用用户定义的恢复操作函数
user_recovery_handler,依次输出:“[Recovery] Attempting to recover system...”;“[Recovery] Recovery operation completed successfully.”;“[Watchdog] Recovery successful, resetting failure count...”。
表示恢复操作成功,并且连续失败计数被重置为 0。
- 恢复成功后,看门狗继续工作。此时虽然连续失败计数归零,但总触发次数依然累加(例如第一次循环后总触发数为 3,然后下一个周期的第一次触发显示 “(1 failures, 4 total triggers)”);这种模式在后续周期中不断重复,每到连续 3 次未喂狗便进行一次恢复操作。
- 调用用户定义的恢复操作函数
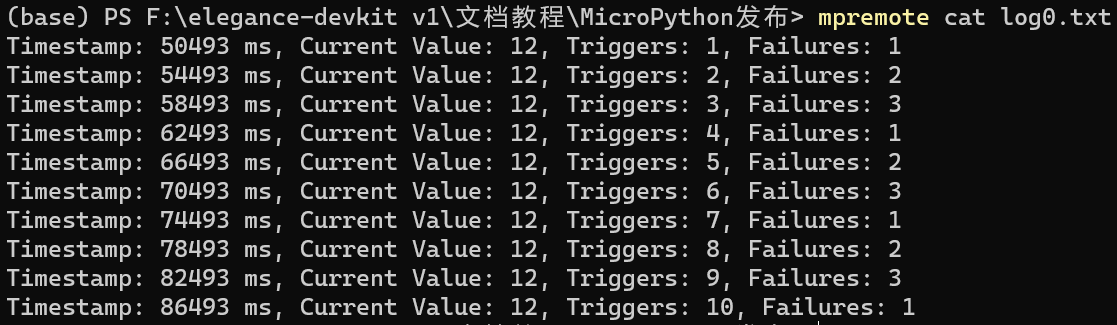
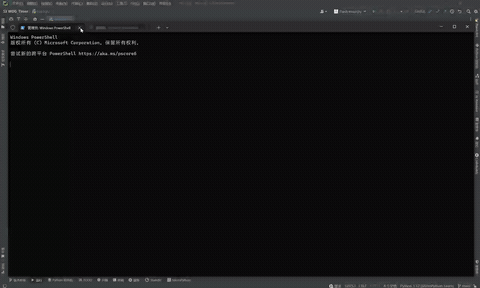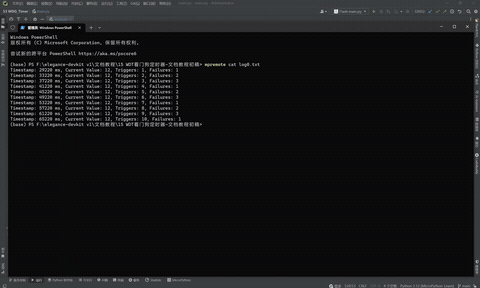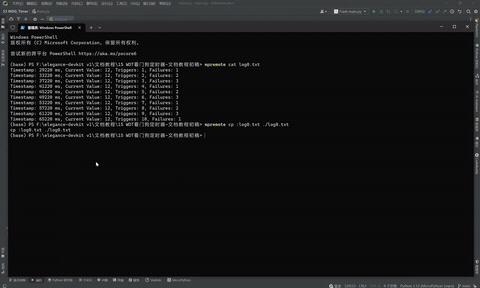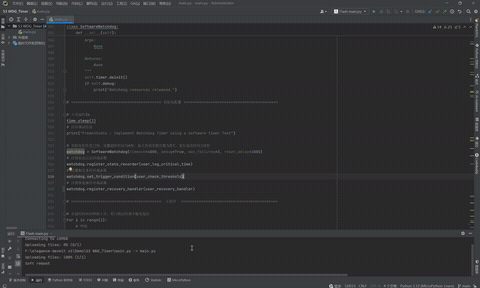
我们可以使用 mpremote 工具查看日志文件,使用如下命令即可:
mpremote cat log0.txt
可以看到日志文件中详细记录了当前时间戳、系统当前状态值、看门狗触发次数以及连续喂狗失败次数:
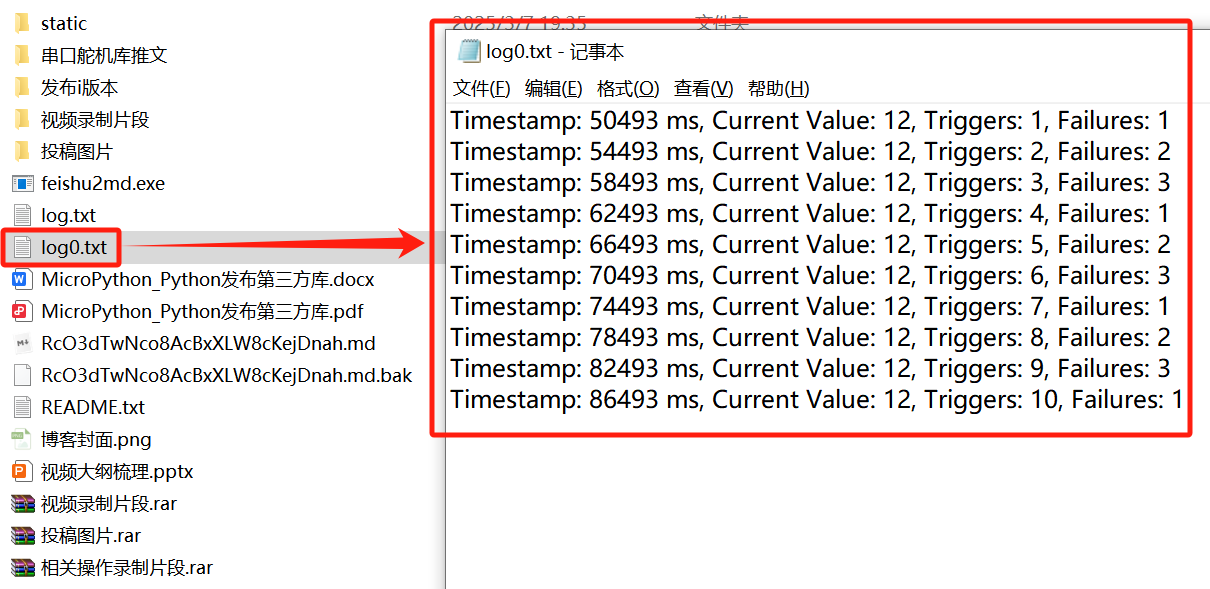
我们也可以使用 mpremote cp :log0.txt ./log0.txt 命令将该日志文件复制到指定路径下:
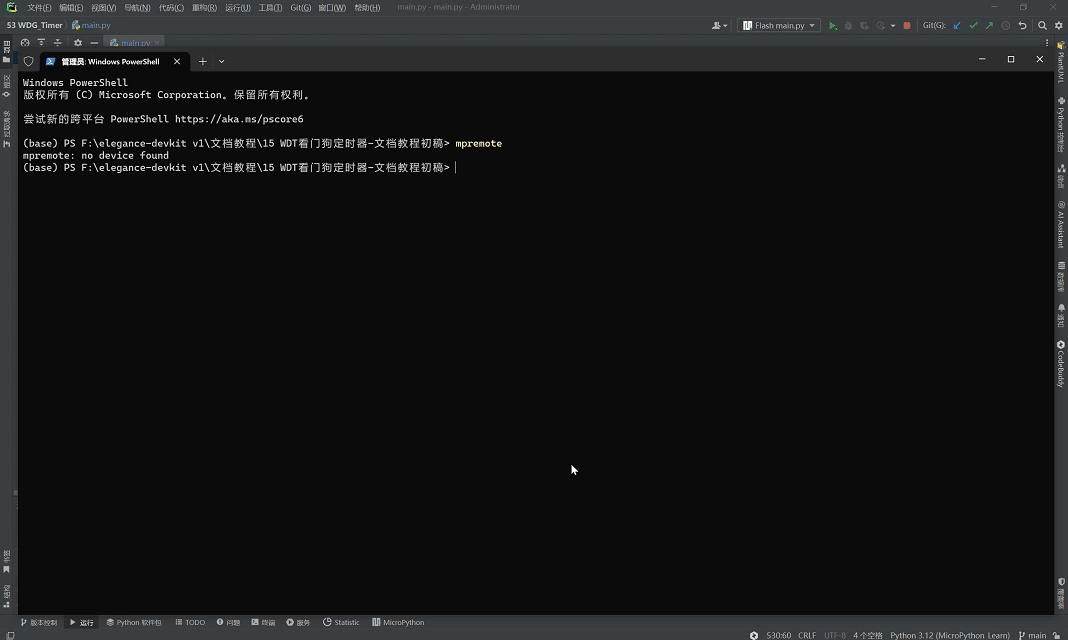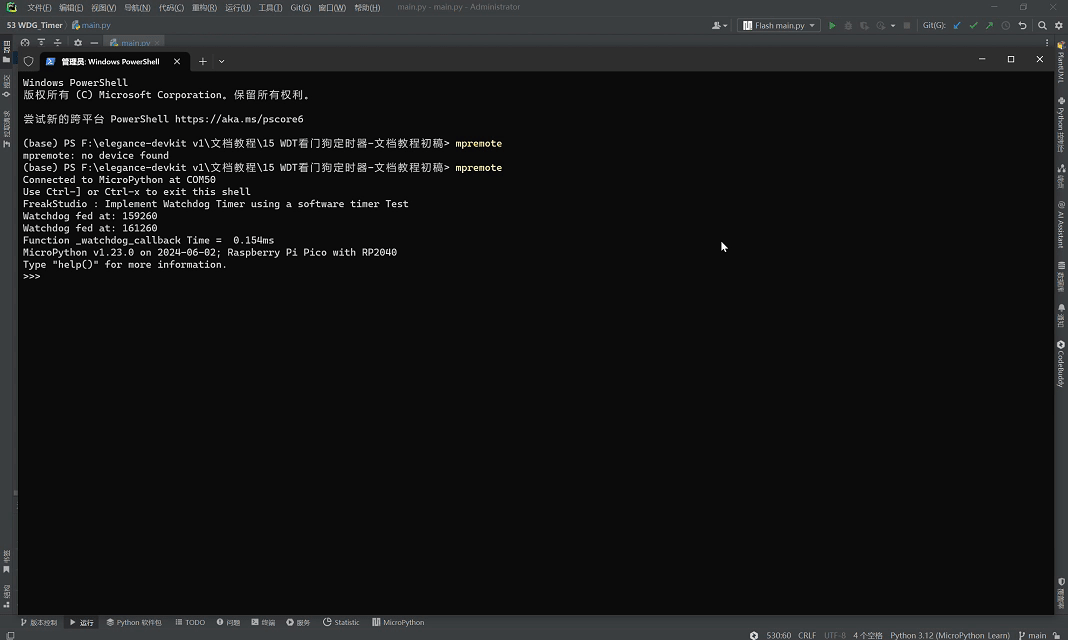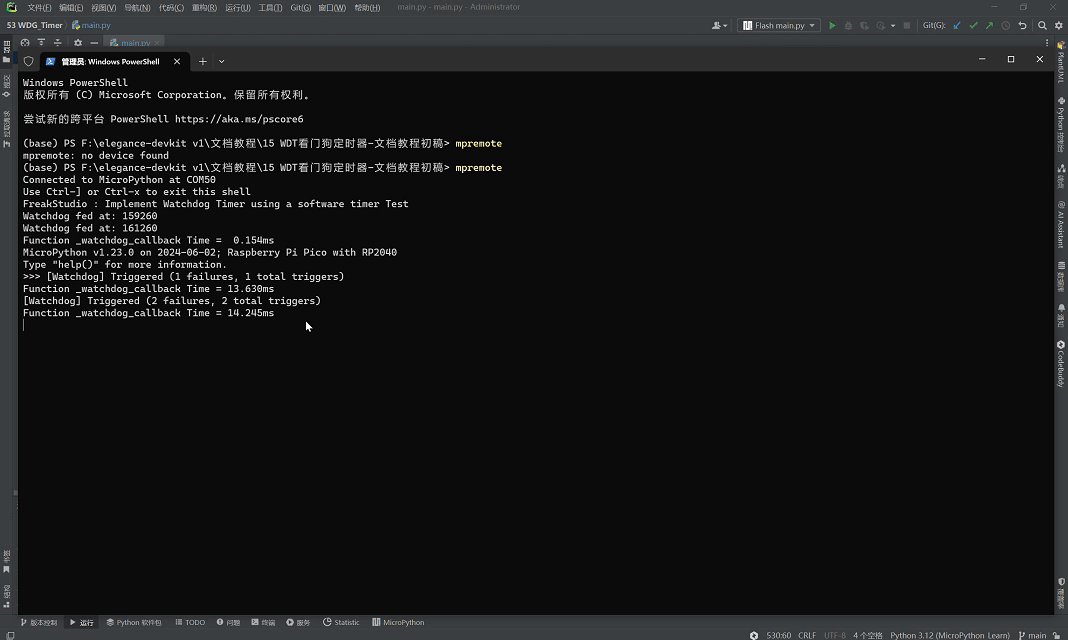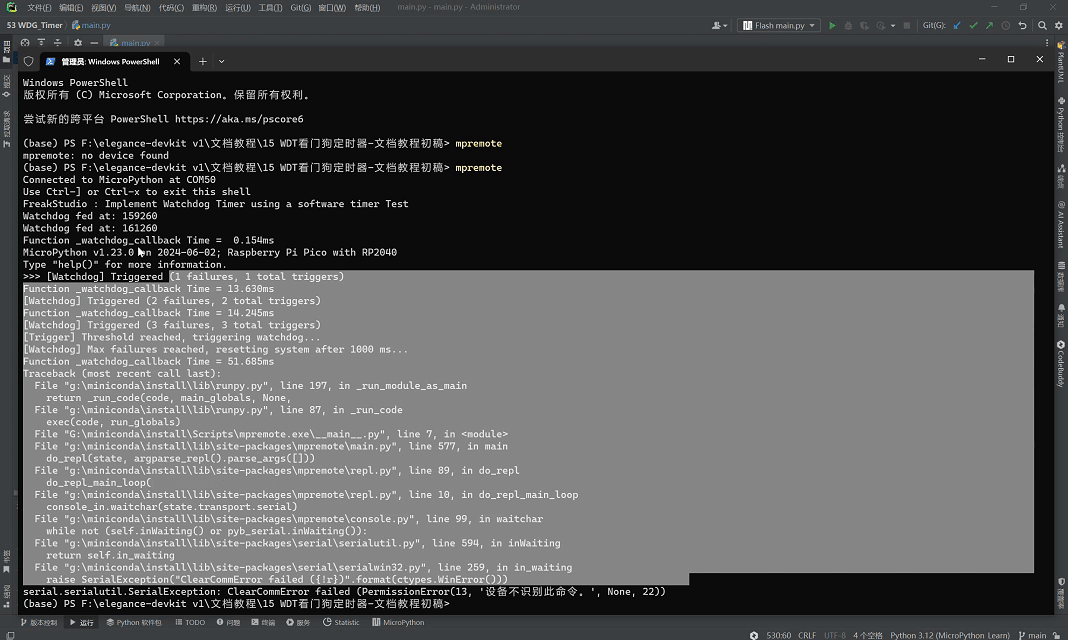
接下来,我们尝试不进行恢复操作,将注册恢复操作回调函数的语句注释掉,再次运行:
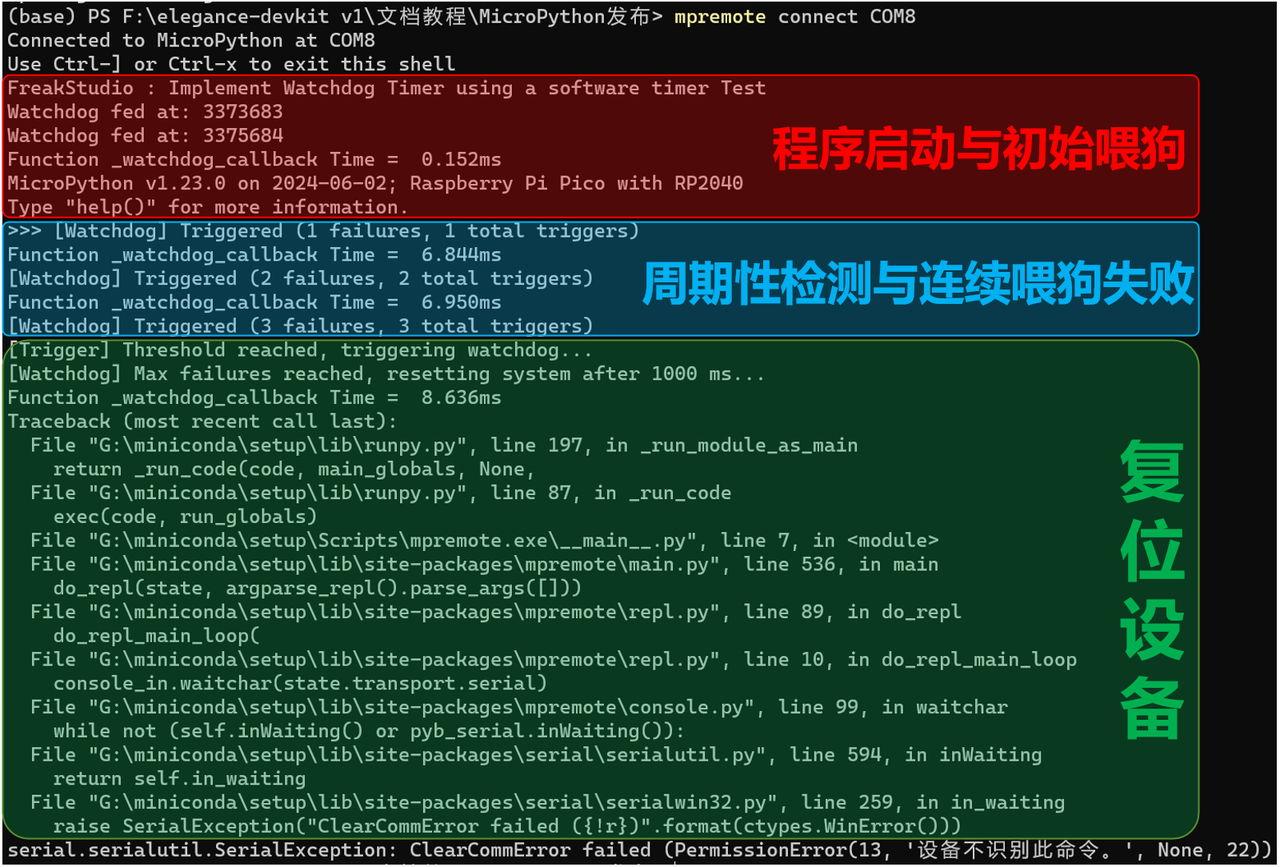
# 注册恢复操作回调函数
# watchdog.register_recovery_handler(user_recovery_handler)
可以看到,在 3 次喂狗失败后,设备复位。
实际上,软件看门狗也存在一定的局限性。由于其运行依赖于系统本身的软硬件资源,当系统发生严重错误时,软件看门狗可能会失效。例如,如果系统中的中断服务例程(ISR)出现问题,导致系统整体陷入瘫痪状态,软件看门狗可能无法及时执行复位操作,因为它本身也是通过系统的资源运行的。这种情况下,系统可能会无法自我恢复,从而导致更严重的后果。

 浙公网安备 33010602011771号