
声纹鉴定/识别 概念简单了解 & 在线体验
在线体验
声音识别(声纹识别)与语音识别:技术边界与应用场景的深度解析
一、技术本质的差异:生物特征识别 vs 内容语义解析
声纹识别(Voiceprint Recognition)本质上是生物特征识别技术,其核心在于通过分析声带振动、声道结构等生理特征形成的独特声波模式,提取如基频、共振峰、频谱包络等参数,构建个体唯一的声纹模型。其技术流程可分为特征提取(如MFCC、LPC)、模型训练(如GMM-UBM、i-vector、PLDA)和匹配验证三个阶段。例如,某银行声纹支付系统要求用户重复特定短语,系统通过比对实时声纹与注册模板的相似度(通常采用EER等指标)完成身份核验。
语音识别(Automatic Speech Recognition, ASR)则属于自然语言处理范畴,其目标是将声波信号转换为文本或命令。技术路径涉及声学模型(如CNN、RNN、Transformer)、语言模型(如N-gram、RNN-LM)和解码器(如WFST)的协同。以智能家居场景为例,用户说出”打开空调,26度”,ASR系统需先通过声学特征提取识别音素序列,再结合语言模型预测最可能的词序列,最终输出结构化指令。
关键差异点:声纹识别关注”谁在说”,依赖生理特征;语音识别关注”说了什么”,依赖语言内容。两者在特征空间上存在本质区别——声纹特征具有跨语言稳定性(如中文和英文的同一说话人声纹相似度高),而语音识别需针对不同语言训练独立模型。
二、应用场景的分化:安全认证 vs 交互控制
声纹识别的核心场景集中在高安全要求的身份认证领域:
- 金融支付:某国际银行采用动态声纹密码技术,用户需随机生成3位数字并朗读,系统通过声纹验证+内容校验双重机制,将欺诈风险降低至0.001%以下。
- 司法取证:公安部门利用声纹比对系统,在电话诈骗案件中通过嫌疑人通话录音与数据库比对,破案效率提升40%。
- 门禁系统:企业园区部署声纹门禁,员工无需携带卡片,仅需说出预设口令即可通过,误识率控制在0.1%以内。
语音识别的主流应用则聚焦于人机交互效率提升:
- 智能客服:某电商平台ASR系统支持中英文混合识别,实时转写用户咨询并自动分类,客服响应时间从平均120秒缩短至30秒。
- 车载系统:特斯拉Model S的语音控制模块采用端到端ASR架构,在80km/h时速下仍保持95%以上的识别准确率,支持导航、音乐控制等20余项功能。
- 医疗转录:科大讯飞智能语音系统可将医生口述病历实时转为结构化文本,转写效率达160字/分钟,错误率低于2%。
协同应用案例:在智能会议系统中,声纹识别用于参会者身份标注(如”张经理:关于预算…”),语音识别完成内容转写,两者结合实现会议纪要的自动生成与权限管理。
三、技术实现的关键挑战
声纹识别的核心难题:
- 跨信道问题:手机通话(8kHz采样)与高清录音(16kHz采样)的频谱差异可能导致性能下降。解决方案包括信道补偿算法(如FFTN)和对抗训练。
- 短时语音挑战:1秒以内的语音片段特征不足,需采用深度嵌入(Deep Embedding)技术提取更鲁棒的特征表示。
- 活体检测:防止录音重放攻击,需结合文本相关验证(如随机数字)和生理信号分析(如呼吸节奏)。
语音识别的技术瓶颈:
- 口音与方言适应:中文八大方言区的识别需构建大规模方言语料库,某团队通过迁移学习将粤语识别准确率从68%提升至89%。
- 噪声鲁棒性:工厂环境(SNR<5dB)下,可采用波束形成(Beamforming)和深度学习增强的谱减法(DSS)提升信噪比。
- 实时性要求:流式ASR需在100ms内输出首个结果,Facebook的Emformer架构通过记忆压缩技术将延迟降低至320ms。
四、开发者实践建议
-
场景适配选择:
- 身份认证场景优先选择声纹识别,推荐使用GMM-UBM算法(适合小样本)或ResNet34声纹编码器(适合大规模应用)。
- 交互控制场景选择语音识别,开源工具推荐Kaldi(传统模型)或WeNet(端到端模型)。
-
性能优化策略:
- 声纹系统:采用数据增强(如速度扰动、添加噪声)提升模型泛化能力,某团队通过此方法将跨信道性能提升15%。
- 语音系统:使用语言模型自适应(如插值法)优化垂直领域术语识别,医疗场景下专业术语识别率可提升20%。
-
隐私保护方案:
- 声纹数据建议采用局部差分隐私(LDP)处理,在特征提取阶段添加噪声,平衡可用性与隐私性。
- 语音数据推荐使用联邦学习框架,某银行通过此方式在保护用户数据的同时完成声纹模型更新。
五、未来技术融合趋势
随着多模态技术的发展,声纹与语音识别的融合呈现三大方向:
- 情感识别增强:结合声纹的基频变化和语音的语义内容,可更准确判断用户情绪(如愤怒、焦虑),某客服系统通过此技术将客户满意度提升18%。
- 抗攻击能力提升:联合声纹活体检测和语音内容验证,可有效防御AI合成语音攻击,最新研究显示联合系统的防伪能力达99.7%。
- 低资源场景突破:通过迁移学习将高资源语言(如中文)的声纹特征迁移至低资源语言,非洲某语种的声纹识别准确率从52%提升至76%。
结语:声纹识别与语音识别如同生物特征认证与自然语言处理的”双生子”,前者构建安全信任的基石,后者搭建高效交互的桥梁。开发者需深刻理解两者在技术本质、应用场景、实现难点上的差异,方能在智能语音的浪潮中精准布局,创造真正符合用户需求的价值。
AI老司机带你认识声音黑科技:声纹识别
同属于生物识别技术,与火爆的人脸识别相比,声纹识别表现得很低调,然而这并不影响这一黑科技魅力的散发,本文将带你认识一下声音黑科技-声纹识别,让你了解真正的“闻声识人”。
本文将从如下方面为你一一解读:
- 什么是声纹?
- 声纹识别的原理
- 声纹识别算法的技术指标
- 影响声纹识别水平的因素
- 声纹识别的应用流程
- 声纹识别的应用场景
一、什么是声纹?
声纹(Voiceprint),是用电声学仪器显示的携带言语信息的声波频谱,是由波长、频率以及强度等百余种特征维度组成的生物特征,具有稳定性、可测量性、唯一性等特点。
- 人类语言的产生是人体语言中枢与发音器官之间一个复杂的生理物理过程,发声器官--舌、牙齿、喉头、肺、鼻腔在尺寸和形态方面每个人的差异很大,所以任何两个人的声纹图谱都有差异。
- 每个人的语音声学特征既有相对稳定性,又有变异性,不是一成不变的。这种变异可来自生理、病理、心理、模拟、伪装,也与环境干扰有关。
- 尽管如此,由于每个人的发音器官都不尽相同,因此在一般情况下,人们仍能区别不同的人的声音或判断是否是同一人的声音。
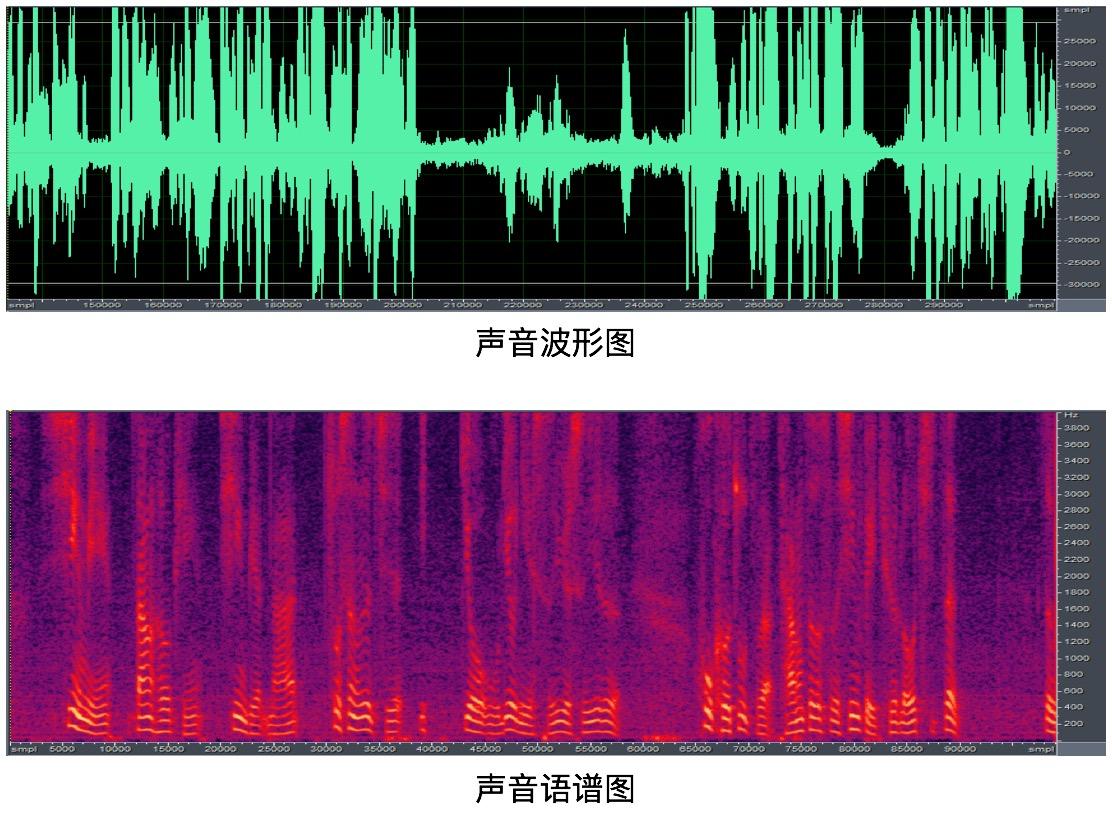
声纹不如图像那样直观展现,在实际分析中,可通过波形图和语谱图进行展现,如下所示:
二、声纹识别的原理
人在讲话时使用的发声器官在尺寸和形态方面每个人的差异很大,所以任何两个人的声纹图谱都有差异,主要体现在如下方面:
- 共鸣方式特征:咽腔共鸣、鼻腔共鸣和口腔共鸣
- 嗓音纯度特征:不同人的嗓音,纯度一般是不一样的,粗略地可分为高纯度(明亮)、低纯度(沙哑)和中等纯度三个等级
- 平均音高特征:平均音高的高低就是一般所说的嗓音是高亢还是低沉
- 音域特征:音域的高低就是通常所说的声音饱满还是干瘪
不同人的声音在语谱图中共振峰的分布情况不同,
声纹识别正是通过比对两段语音的说话人在相同音素上的发声来判断是否为同一个人,从而实现“闻声识人”的功能。

三、声纹识别算法的技术指标
声纹识别在算法层面可通过如下基本的技术指标来判断其性能,除此之外还有其它的一些指标,如:信道鲁棒性、时变鲁棒性、假冒攻击鲁棒性、群体普适性等指标,这部分后续于详细展开讲解。
- 错误拒绝率(False Rejection Rate, FRR) :分类问题中,若两个样本为同类(同一个人),却被系统误认为异类(非同一个人),则为错误拒绝案例。错误拒绝率为错误拒绝案例在所有同类匹配案例的比例。
- 错误接受率(False Acceptance Rate, FAR) :分类问题中,若两个样本为异类(非同一个人),却被系统误认为同类(同一个人),则为错误接受案例。错误接受率为错误接受案例在所有异类匹配案例的比例。
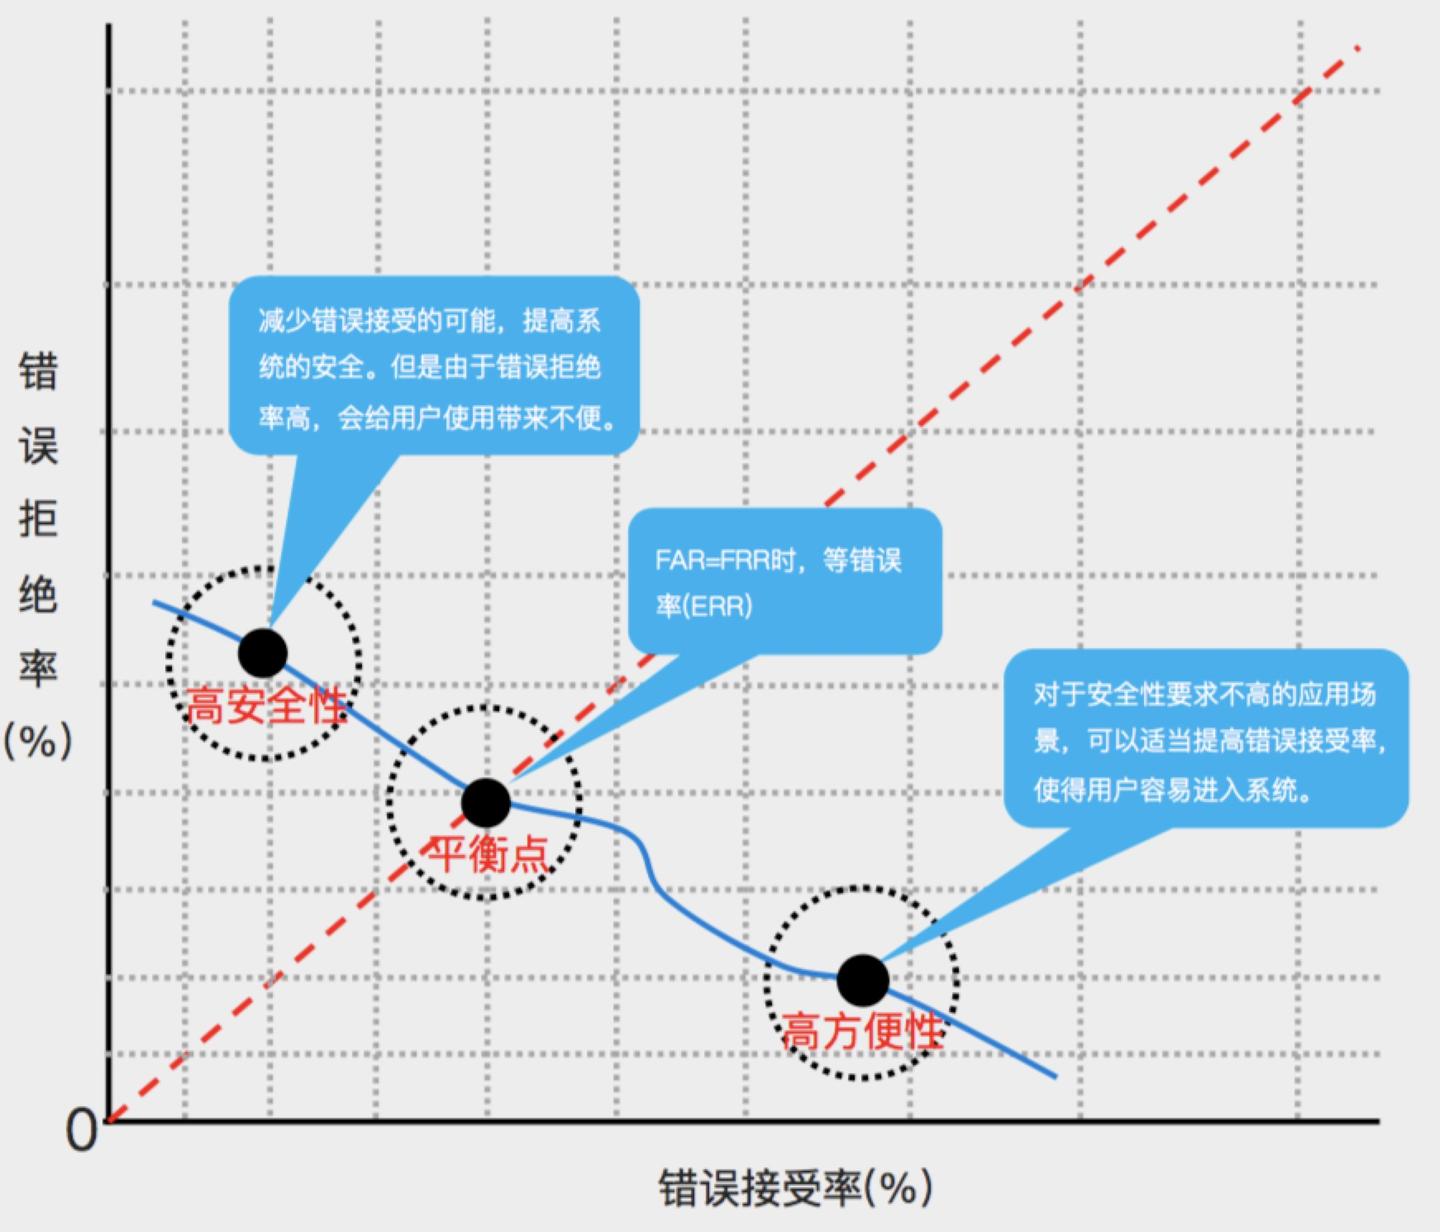
- 等错误率(Equal Error Rate,EER):调整阈值,使得误拒绝率(False Rejection Rate,FRR)等于误接受率 (False Acceptance Rate,FAR),此时的FAR与FRR的值称为等错误率。
- 准确率(Accuracy,ACC):调整阈值,使得FAR+FRR最小,1减去这个值即为识别准确率,即ACC=1 - min(FAR+FRR)
- 速度:(提取速度:提取声纹速度与音频时长有关、验证比对速度):Real Time Factor 实时比(衡量提取时间跟音频时长的关系,比如:1秒能够处理80s的音频,那么实时比就是1:80)。验证比对速度是指平均每秒钟能进行的声纹比对次数。
- ROC曲线:描述FAR与FRR之间相互变化关系的曲线,X轴为FAR的值,Y轴为FRR的值。从左到右,当阈值增长期间,每一个时刻都有一对FAR和FRR的值,将这些值在图上描点连成一条曲线,就是ROC曲线。
- 阈值:在接受/拒绝二元分类系统中,通常会设定一个阈值,分数超过该值时才做出接受决定。调节阈值可以根据业务需求平衡FAR与FRR。 当设定高阈值时,系统做出接受决定的得分要求较为严格,FAR降低,FRR升高;当设定低阈值时,系统做出接受决定的得分要求较为宽松,FAR升高,FRR降低。在不同应用场景下,调整不同的阈值,则可在安全性和方便性间平平衡,如下图所示:
四、影响声纹识别水平的因素
训练数据和算法是影响声纹识别水平的两个重要因素,在应用落地过程中,还会受很多因素的影响。
声源采样率
- 人类语音的频段集中于50Hz ~ 8KHz之间,尤其在4KHz以下频段
- 离散信号覆盖频段为信号采样率的一半(奈奎斯特采样定理)
- 采样率越高,信息量越大
- 常用采样率:8KHz (即0 ~ 4KHz频段),16KHz(即0 ~ 8KHz频段)
信噪比(SNR)
- 信噪比衡量一段音频中语音信号与噪声的能量比,即语音的干净程度
- 15dB以上(基本干净),6dB(嘈杂),0dB(非常吵)
信道
- 不同的采集设备,以及通信过程会引入不同的失真
- 声纹识别算法与模型需要覆盖尽可能多的信道
- 手机麦克风、桌面麦克风、固话、移动通信(CDMA, TD-LTE等)、微信……
语音时长
- 语音时长(包括注册语音条数)会影响声纹识别的精度
- 有效语音时长越长,算法得到的数据越多,精度也会越高
- 短语音(1~3s)
- 长语音(20s+)
文本内容
- 通俗地说,声纹识别系统通过比对两段语音的说话人在相同音素上的发声来判断是否为同一个人
- 固定文本:注册与验证内容相同
- 半固定文本:内容一样但顺序不同;文本属于固定集合
- 自由文本
五、声纹识别的应用流程
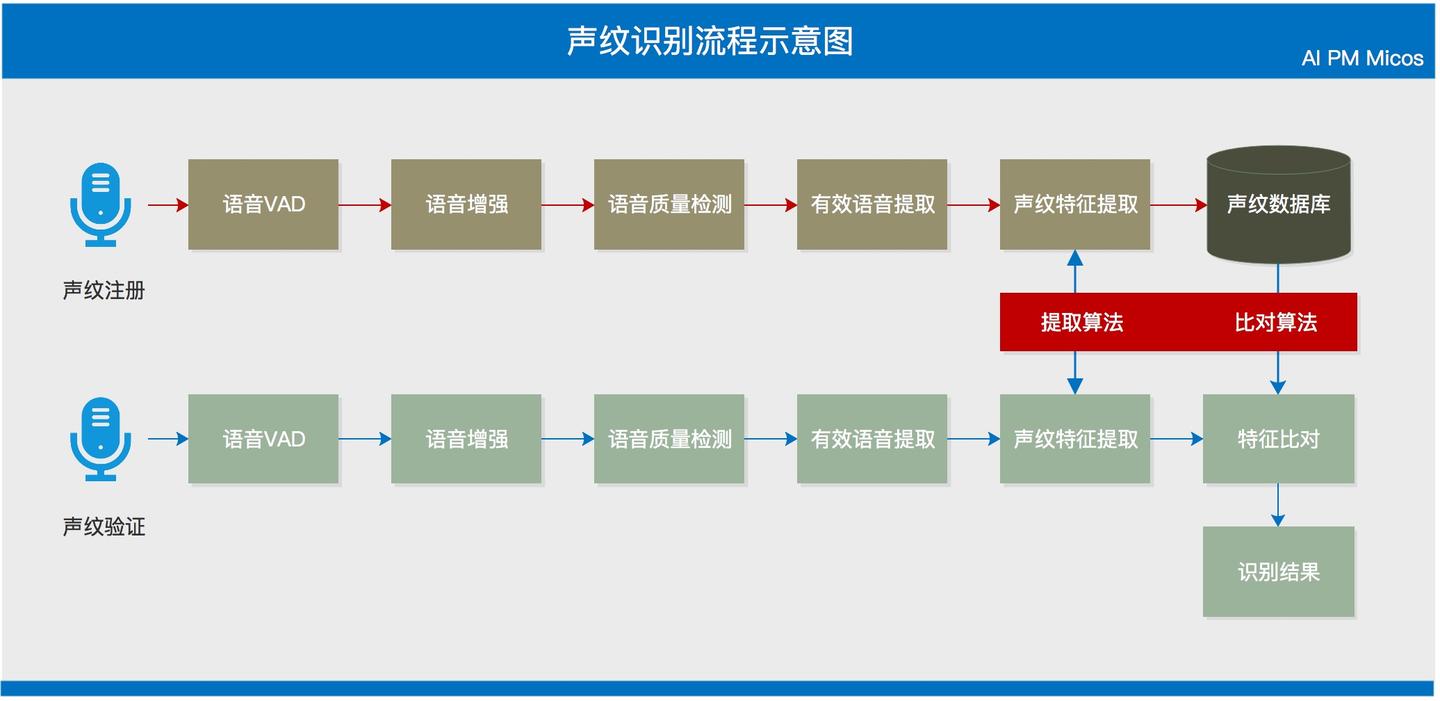
声纹识别(VPR) ,生物识别技术的一种,也称为说话人识别 ,是从说话人发出的语音信号中提取声纹信息,从应用上看,可分为:
- 说话人辨认(Speaker Identification):用以判断某段语音是若干人中的哪一个所说的,是“多选一”问题;
- 说话人确认(Speaker Verification):用以确认某段语音是否是指定的某个人所说的,是“一对一判别”问题。
声纹识别在应用中分注册和验证两个主流程,根据不同的应用中,部分处理流程会存在差异,一般的声纹识别应用流程如下图所示:
3大核心技术构建企业级声纹识别系统:从原理到落地实践
项目地址:https://gitcode.com/gh_mirrors/vo/VoiceprintRecognition-Pytorch/
在线试用
声纹识别技术正快速渗透到金融安全、智能家居、公共安全等关键领域,成为身份认证的重要手段。
本文基于 VoiceprintRecognition-Pytorch 开源项目,系统解析声纹识别的技术原理、场景化应用方案及工程化实践技巧,帮助技术团队快速构建高准确率、低延迟的声纹认证系统。
🔍 声纹识别技术底层架构解析
核心技术原理与数据流程
声纹识别系统本质是通过提取音频中的生物特征进行身份验证的智能系统,其核心流程包括音频预处理、特征提取、模型推理三大环节。系统首先将原始音频转换为梅尔频谱图等视觉化特征,再通过深度神经网络提取高维度声纹向量,最后通过相似度计算完成身份匹配。
📌 技术小贴士:声纹特征具有短时稳定性与长期可变性,建议采用3-5秒的语音片段进行特征提取,同时定期更新用户声纹模型以适应声纹变化。
主流模型架构对比分析
VoiceprintRecognition-Pytorch项目集成了当前最先进的声纹识别模型,各模型在性能与资源消耗上呈现显著差异:
| 模型类型 | 核心优势 | 适用场景 | 推理速度 | 模型大小 |
|---|---|---|---|---|
| CAM++ | 平衡精度与效率 | 移动端应用 | 快 | 中等 |
| EcapaTDNN | 高识别准确率 | 金融级认证 | 中 | 较大 |
| ERes2Net | 噪声鲁棒性强 | 电话语音场景 | 较慢 | 大 |
| ResNetSE | 特征提取能力强 | 安静环境 | 中 | 中等 |
模型配置文件路径:configs/cam++.yml、configs/ecapa_tdnn.yml
📊 多场景声纹应用解决方案
会议场景说话人分割系统
在多人会议场景中,声纹识别技术能够自动区分不同说话人并按时间轴分割语音。系统通过实时分析音频流,将语音片段分配给对应说话人,生成结构化的会议记录。

应用案例:某智能会议系统集成该技术后,会议纪要生成效率提升40%, speaker diarization准确率达92%。关键实现代码位于mvector/infer_utils/speaker_diarization.py。
声纹门禁身份认证方案
声纹门禁系统通过"说出指定口令+声纹特征验证"的双重机制实现高安全性认证。系统支持离线部署,响应时间低于500ms,误识率(FAR)控制在0.001%以下。
📌 技术小贴士:为提升安全性,建议采用动态口令机制,每次认证随机生成不同的挑战语句,防止录音回放攻击。
⚙️ 声纹系统工程化实践指南
环境搭建与优化配置
推荐环境配置:
- Python 3.11+
- PyTorch 2.4.0+
- CUDA 11.8+(GPU加速)
基础环境搭建命令:
conda create --name voiceprint python=3.11
conda activate voiceprint
conda install pytorch==2.4.0 torchvision==0.19.0 torchaudio==2.4.0 pytorch-cuda=11.8 -c pytorch -c nvidia
git clone https://gitcode.com/gh_mirrors/vo/VoiceprintRecognition-Pytorch
cd VoiceprintRecognition-Pytorch
pip install -r requirements.txt
图形化工具与快速部署
项目提供直观的GUI工具,支持声纹注册、识别和分割等功能,非技术人员也能快速上手操作。

部署建议:对于资源受限环境,可采用模型量化技术将模型体积压缩40%以上,同时保持95%以上的识别准确率。
🔮 声纹识别技术发展趋势
随着深度学习技术的进步,声纹识别正朝着以下方向发展:
跨模态融合:结合面部特征、行为习惯等多模态信息提升认证安全性
端侧智能:轻量级模型在手机等终端设备上实现实时声纹识别
抗干扰技术:基于自监督学习的噪声鲁棒性提升方法
隐私保护:联邦学习框架下的声纹特征学习技术
这些技术发展将进一步拓展声纹识别的应用边界,推动其在智能汽车、远程医疗等新场景的落地应用。
ChipIntelli 声纹识别 Voice Print Recogition(VPR) 技术应用方案
声纹注册算法当前推荐最多注册4个人,人数越多会影响注册效果,如需注册更多人数,需确认效果达到使用要求;同时注册过的声纹支持单个删除或全部删除。
1.算法功能配置步骤如下:
打开CI13XX_SDK_ALG_PRO_Vx.x.x\project_file\makefile文件,将CI_ALG_TYPE修改为CI_ALG_TYPE := $(USE_VPR)
CI_ALG_TYPE变量和算法功能对应说明请参考:算法功能使用说明
2. 该算法参数宏说明在projects\CI13XX_SDK_ALG_PRO_Vx.x.x\app\app_main\user_config.h文件中, 可调整的参数如下(如无特殊需求,建议都使用sdk中的默认宏配置):
//声纹计算的窗长,单位为ms, 建议范围1200-1500,值越大消耗内存越多(每增加100,内存增加8KB)
#define VP_USE_FRM_LEN                  1200
//声纹阈值-建议范围(0.48-0.68),值越大,灵敏度越低,误识越低,识别率下降,需要更严格的匹配注册的模版
#define VP_THR_FOR_MATCH                (0.52f)
//声纹注册时重复录入次数 -注册时的次数
#define VP_REC_TIMES                    3
//声纹识别功能允许的最大模版(用户)数,最大4个 重要说明:每个模版单次约占0.8KB NV空间,三次2.4KB
#define MAX_VP_TEMPLATE_NUM             3
//注册声纹时最大超时等待时间(秒)
#define MAX_VP_REG_TIME                 10
3. 声纹注册算法请把external\model\vpr(声纹注册)中[60001]VPR_model_v00xx.bin算法模型,复制到projects\CI13XX_SDK_ALG_PRO_Vx.x.x\firmware\dnn文件夹中
注意
- 声纹注册算法,涉及收费,需烧录license,具备license的芯片正常运行,无license的芯片每五分钟会进行复位,如有量产需求,请联系启英泰伦商务。
- 固件打包时,如果NV data分区空间过小,影响模板数据存储,导致无法正常识别已注册的声纹。
- 声纹注册需搭配该算法的前端算法模型使用。
4. 声纹注册结果说明:
声纹注册和注册以后的识别结果在vpr_callback回调函数中,该函数位于CI-SDK-ASR-ALG_Vx.x.x\projects\components\VPR\voice_print_recognition.c中,如下图:
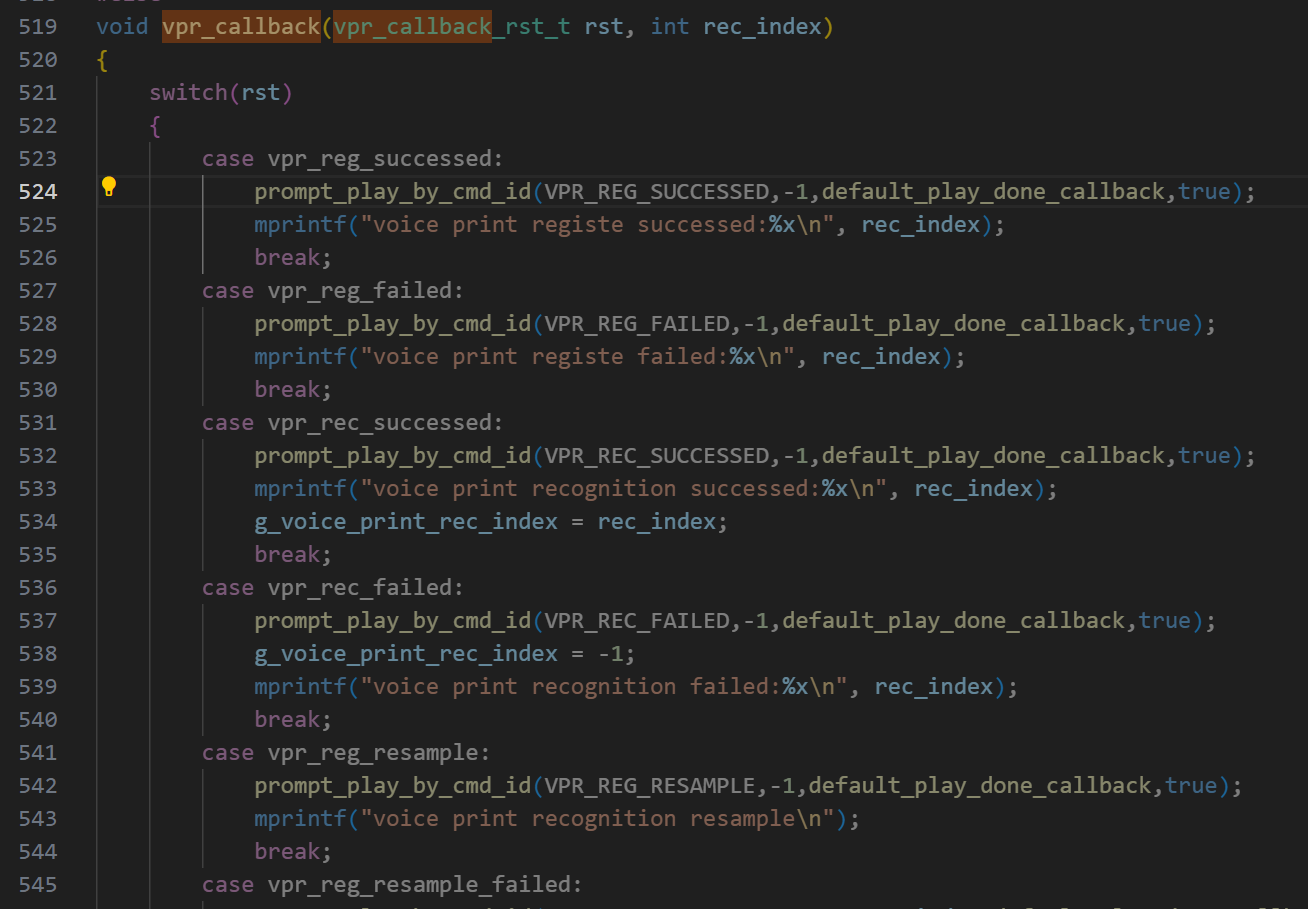
vpr_callback函数参数rst:表示返回当前注册状态,reg_index:表示当前注册到第几个模版
rst注册状态有如下几类:
    typedef enum
    {
        vpr_reg_successed,          // 注册成功
        vpr_reg_failed,             // 注册失败
        vpr_rec_successed,          // 识别成功
        vpr_rec_failed,             // 识别失败
        vpr_reg_resample,           //继续重复录入声纹
        vpr_reg_resample_failed     //重复录入失败(注册一个模板可能需要录入多次)。
    }vpr_callback_rst_t;
用户可以根据rst状态在对应的case添加后续对应需要执行的逻辑代码,示例中只对当前注册和识别状态做了对应的结果进行了播报。
男女声纹检测算法
男女声纹检测算法基于声纹特征检测目标人声是男声还是女声
1.算法功能配置步骤如下:
打开CI13XX_SDK_ALG_PRO_Vx.x.x\project_file\makefile文件,将CI_ALG_TYPE修改为CI_ALG_TYPE := $(USE_WMAN_VPR)
CI_ALG_TYPE变量和算法功能对应说明请参考:算法功能使用说明
2. 该算法参数宏说明在projects\CI13XX_SDK_ALG_PRO_Vx.x.x\app\app_main\user_config.h文件中,可调整的参数如下(如无特殊需求,建议都使用sdk中的默认宏配置):
//VP_USE_FRM_LEN:声纹计算的窗长,单位为ms,建议范围1200-1500,值越大消耗内存越多(每增加100,内存增加8KB)
#define VP_USE_FRM_LEN                  1200
//WMAN_PLAY_EN:是否开启男女声纹识别播报,默认开启
#define WMAN_PLAY_EN                    1
3. 男女声纹检测算法请把external\model\wman_vpr(男女声纹)中[60008]VGR_model_xxxx_vx算法模型,复制到projects\CI13XX_SDK_ALG_PRO_Vx.x.x\firmware\dnn文件夹中
注意
- 男女声纹检测算法,涉及收费,需烧录license,具备license的芯片正常运行,无license的芯片每五分钟会进行复位,如有量产需求,请联系启英泰伦商务。
- 男女声纹检测需搭配该算法的前端算法模型使用。
4. 男女声纹识别结果在vpr_run_one_recognition函数中,该函数位于CI-SDK-ASR-ALG_Vx.x.x\projects\components\VPR\voice_print_recognition.c中,如下图:


当前SDK示例会打印对应的结果和播报对应的播报音,用户可在识别结果处添加对应的应用逻辑。
参考资料:
1.声音识别(声纹识别)与语音识别:技术边界与应用场景的深度解析
https://developer.baidu.com/article/detail.html?id=3694515
2.
《3大核心技术构建企业级声纹识别系统:从原理到落地实践》
版权声明:本文为CSDN博主「毛彤影」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/gitblog_00094/article/details/159377626
3.
讯飞平台声纹识别方案:
https://www.xfyun.cn/services/voiceprint-recognition
4. 启英泰伦声纹识别方案:男女声纹检测算法
https://document.chipintelli.com/%E8%BD%AF%E4%BB%B6%E5%BC%80%E5%8F%91/SDK/CI13XX%E8%8A%AF%E7%89%87SDK/CI-SDK-ALG/CI13XX_SDK_ASR_ALG_V2.6.3/API%E6%8C%87%E5%8D%97/%E7%AE%97%E6%B3%95%E4%BD%BF%E7%94%A8%E8%AF%B4%E6%98%8E/%E7%94%B7%E5%A5%B3%E5%A3%B0%E7%BA%B9%E6%A3%80%E6%B5%8B%E7%AE%97%E6%B3%95/

 浙公网安备 33010602011771号