
学习心得 - 数据结构 - 浅谈树链剖分
前言
何为树剖?
树链剖分,就是通过特定的方式,把树分为多条链,以维护特定的答案。
一般的树链剖分,是钦定一个儿子为重儿子,即重链剖分。
前置芝士
建议先浅浅食用一下。
- 倍增法求 LCA(毕竟都是树上操作)
- 树上差分
- 线段树(要会 lazytag)
- (选)树形 dp(更好理解两个 dfs)
- 树上 dfs
操作
我们通过对树按照重儿子分成不相交的重链,把树上问题转成线段问题,可以把效率优化到 \(\mathcal O(\log n)\)。
为什么复杂度这么优呢?我们以 LCA 为例。
通过巧妙的剖分,我们从根节点到子节点只需要跳 \(\mathcal O(\log n)\) 条链,就可以跳到节点。
让链的数量尽可能少,就要请出重链剖分了。
这里给出一个图,看看什么是重链剖分。
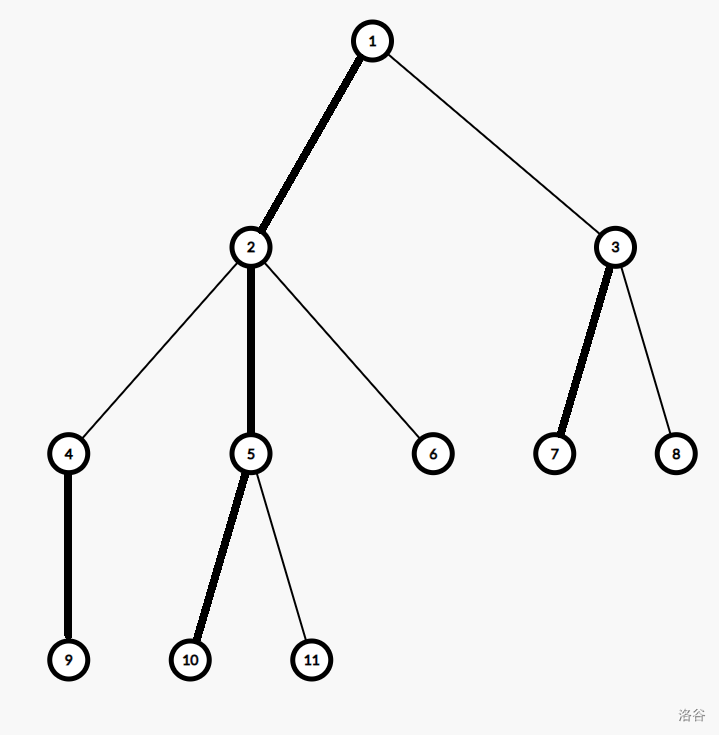
我们使用一个 \(sz\) 数组记录一个点的子节点,这个东西会 dfs 的都会。
这样,我们再用 \(son\) 记录一个节点的重儿子。
我们就可以把链连接到重儿子了。
比如,\(2\) 的重儿子是 \(5\),因为 \(5\) 的儿子有 \(2\) 个,分别是 \(10\) 和 \(11\),所以 \(5\) 这颗子树大小为 \(3\),而 \(2\) 的其他儿子显然没那么大,所以 \(a_2.son=5\)。
我们按照这样链接好的链,就有经过重链不超过 \(\log_2 n\) 条的性质,同理,经过轻边不超过 \(\log_2 n\) 条。
证明
证:经过轻边不超过 \(\log_2 n\) 条。
\(p\) 的一个轻儿子 \(v\),因为是轻儿子,\(v\) 的子树不超过 \(\frac{1}{2}t_{p}.sz\)。那么,我们每过一条轻边,当前子树大小 \(sz\) 就 \(\leq \frac{1}{2}sz\),因此,次数 \(\leq\log_2 n\)。
同理,易证:经过重链不超过 \(\log_2 n\) 条。
读者自证不难。
因为两条重链之间是轻边,那么因为经过轻边不超过 \(\log_2 n\) 条,所以经过重链不超过 \(\log_2 n\) 条。
具体操作
接下来的部分将讲解树剖的各种操作。
求各种基本信息
我们一般通过两个 dfs 求解。
void dfs(int p,int fa){
	t[p].dep=t[fa].dep+1;
	t[p].fa=fa;
	t[p].sz=1;
	for(auto v:e[p])if(v!=fa){
		t[v].fa=p;
		dfs(v,p);
		t[p].sz+=t[v].sz;
		if(!t[p].son||t[t[p].son].sz<t[v].sz)t[p].son=v; // Heavy
	}
}
void dfs2(int p,int tp){
	t[p].id=++num;
	nw[num]=va[p];
	t[p].top=tp;
	t[p].son=0;
	if(!t[p].son)return;
	dfs2(t[p].son,tp);
	for(auto v:e[p])if(v!=t[p].fa&&v!=t[p].son)dfs2(v,v);
}
先是各种信息的定义。
- \(dep\),顾名思义,节点深度。
- \(fa\),记录父亲节点。
- \(sz\),子树大小。
- \(\bf son\),重儿子。
- \(id\),\(\operatorname{dfn}\) 序,用于把树上问题转化成区间问题。
- \(top\),链头。
基本就没什么特殊了。
第一个 dfs 用于求 \(dep\)、\(fa\)、\(sz\)、\(son\) 等一次就能完成的信息,跟树上 dp 很想。
注意这里 \(\bf son\) 在一些多测题目中要赋初值,要不然就不会以重儿子剖分了,直接被卡成乱链剖分,虽然可以通过部分数据点,但是会 TLE 而非 WA。
第二个 dfs 用于连接链,当然,我们要考虑点权转换成区间初值,这里的 \(nw\) 就是把原点权 \(va\) 转化。
部分题目可能有边权,或者对边权查询,这种情况需要将边权转点权,后面会介绍。
更新链头 \(top\) 直接跳即可。然后我们发现那些非重儿子的节点也要访问,这些点将成为新的链头,继续搜索即可。
完成了这些处理,我们就可以把树上问题转化了。
线段树维护树上问题
要是边都断了,那么就成为了森林,这样 dfn 连续也物理回天,得 splay 维护,要上 LCT。
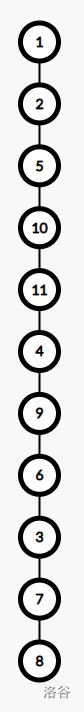
我们发现,这里的 dfs2 是先搜重儿子,再搜轻儿子,可以转化成区间问题。
线段树先放着,可以维护题目所需 max/min/sum/mul/xor 即可,建议带 tag,马蜂不要乱改,要不然调不出来。
// segment tree.
struct snode{
	int tg,val;
}a[N<<2];
void tag(int p,int l,int r,int val){
	a[p].tg+=val;
	(a[p].val+=val*(r-l+1))%=P;
}
void pushup(int p){
	a[p].val=(a[2*p].val+a[2*p+1].val)%P;
}
void pushdown(int p,int l,int r){
	if(a[p].tg){
		int mid=(l+r)>>1;
		tag(2*p,l,mid,a[p].tg),tag(2*p+1,mid+1,r,a[p].tg);
		a[p].tg=0;
	}
}
void build(int p,int l,int r){
	if(l==r){a[p].val=nw[l]%P;return;} // build: nw
	int mid=(l+r)>>1;
	build(2*p,l,mid),build(2*p+1,mid+1,r);
	pushup(p);
}
void update(int p,int l,int r,int nl,int nr,int val){
	if(l<=nl&&nr<=r)return tag(p,nl,nr,val),void(0);
	pushdown(p,nl,nr);
	int mid=(nl+nr)/2;
	if(l<=mid)update(2*p,l,r,nl,mid,val);
	if(mid<r)update(2*p+1,l,r,mid+1,nr,val);
	pushup(p);
}
int query(int p,int l,int r,int nl,int nr){
	if(l<=nl&&nr<=r)return a[p].val%P;
	pushdown(p,nl,nr);
	int mid=(nl+nr)/2;
	int res=0;
	if(l<=mid)res=(res+query(2*p,l,r,nl,mid))%P;
	if(mid<r)res=(res+query(2*p+1,l,r,mid+1,nr))%P;
	return res;
}
这个是区间加 / 区间求和的模板,有需要的取用。
先给上图编上 dfn。
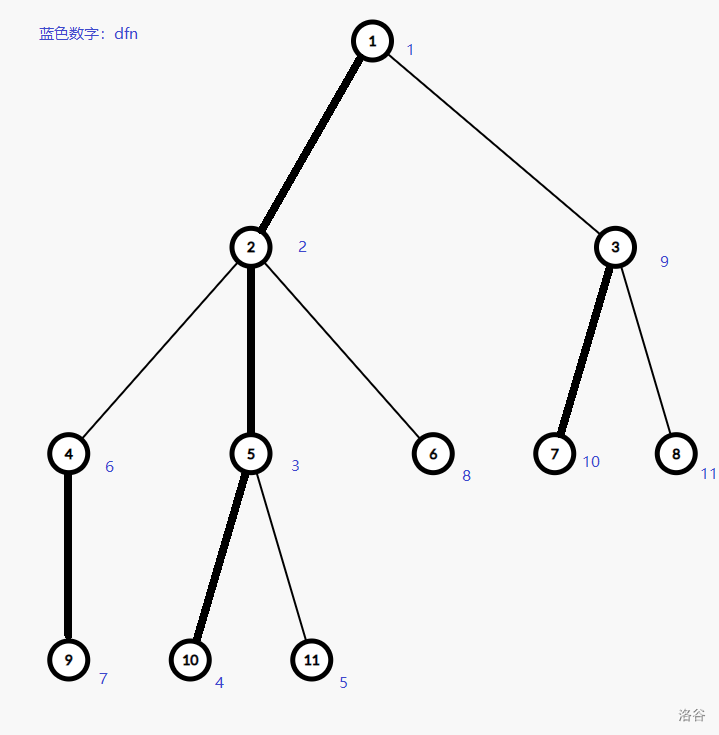
按照 dfn 展开。
子树修改
注意到当我们需要在子树内修改时,只需要把连续的一段修改即可。
比如说 \(2\) 的子树为 \(dfn=[2,8]\) 的一段。
我们以此类推,\(p\) 的子树为 \(dfn=[p,p+t_p.sz-1]\) 的一段。
那么,子树修改就会变的很方便。
代码很简单。
void update_t(int p,int val){
	update(1,t[p].id,t[p].id+t[p].sz-1,1,n,val);
}
int query_t(int p){
	return query(1,t[p].id,t[p].id+t[p].sz-1,1,n);
}
这里就是对 \(p\) 节点的查询与修改。
路径修改
但是,我们的区间呢?比如说在 \(u\) 到 \(v\) 的路径上修改。
在之前的树上差分中,我们知道,一条 \(u-v\) 的路径可以被拆分成 \(u-\operatorname{LCA}(u,v)\) 和 \(\operatorname{LCA}(u,v)-v\) 两条路径。
我们发现,这些路径都是由链组成,而一条重链在 dfn 里肯定连续,那没事了。
直接跳 \(\operatorname{LCA}\),具体看底下的 \(\operatorname{LCA}\),每一条链都是 \([t_p.top,p]\) 连续的,把这些链的答案加上即可。
代码简单易懂。
void update_r(int u,int v,int w){
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		update(1,t[t[u].top].id,t[u].id,1,n,w);
		u=t[t[u].top].fa;
	}
	if(t[u].dep>t[v].dep)swap(u,v);
	update(1,t[u].id,t[v].id,1,n,w);
}
int query_r(int u,int v){
	int ans=0;
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		(ans+=query(1,t[t[u].top].id,t[u].id,1,n))%=P;
		u=t[t[u].top].fa;
	}
	if(t[u].dep>t[v].dep)swap(u,v);
	ans+=query(1,t[u].id,t[v].id,1,n);
	return ans%P;
}
跟底下 \(\operatorname{LCA}\) 没什么区别,就是多维护了个答案。
总代码
题目就是【模板】重链剖分/树链剖分。
#include<bits/stdc++.h>
#define debug
using namespace std;
const int N=1e5+10;
int n,m,op,r,P,opt,U,V,W,va[N],nw[N];

vector<int>e[N];

// segment tree.
struct snode{
	int tg,val;
}a[N<<2];
void tag(int p,int l,int r,int val){
	a[p].tg+=val;
	(a[p].val+=val*(r-l+1))%=P;
}
void pushup(int p){
	a[p].val=(a[2*p].val+a[2*p+1].val)%P;
}
void pushdown(int p,int l,int r){
	if(a[p].tg){
		int mid=(l+r)>>1;
		tag(2*p,l,mid,a[p].tg),tag(2*p+1,mid+1,r,a[p].tg);
		a[p].tg=0;
	}
}
void build(int p,int l,int r){
	if(l==r){a[p].val=nw[l]%P;return;} // build: nw
	int mid=(l+r)>>1;
	build(2*p,l,mid),build(2*p+1,mid+1,r);
	pushup(p);
}
void update(int p,int l,int r,int nl,int nr,int val){
	if(l<=nl&&nr<=r)return tag(p,nl,nr,val),void(0);
	pushdown(p,nl,nr);
	int mid=(nl+nr)/2;
	if(l<=mid)update(2*p,l,r,nl,mid,val);
	if(mid<r)update(2*p+1,l,r,mid+1,nr,val);
	pushup(p);
}
int query(int p,int l,int r,int nl,int nr){
	if(l<=nl&&nr<=r)return a[p].val%P;
	pushdown(p,nl,nr);
	int mid=(nl+nr)/2;
	int res=0;
	if(l<=mid)res=(res+query(2*p,l,r,nl,mid))%P;
	if(mid<r)res=(res+query(2*p+1,l,r,mid+1,nr))%P;
	return res;
}

// Tree Partition.
struct tnode{
	int son,id,fa,dep,sz,top;
}t[N];
int num;
void dfs(int p,int fa){
	t[p].dep=t[fa].dep+1;
	t[p].fa=fa;
	t[p].sz=1;
	for(auto v:e[p])if(v!=fa){
		t[v].fa=p;
		dfs(v,p);
		t[p].sz+=t[v].sz;
		if(!t[p].son||t[t[p].son].sz<t[v].sz)t[p].son=v; // Hard
	}
}
void dfs2(int p,int tp){
	t[p].id=++num;
	nw[num]=va[p];
	t[p].top=tp;
	if(!t[p].son)return;
	dfs2(t[p].son,tp);
	for(auto v:e[p])if(v!=t[p].fa&&v!=t[p].son)dfs2(v,v);
}
void update_r(int u,int v,int w){
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		update(1,t[t[u].top].id,t[u].id,1,n,w);
		u=t[t[u].top].fa;
	}
	if(t[u].dep>t[v].dep)swap(u,v);
	update(1,t[u].id,t[v].id,1,n,w);
}
int query_r(int u,int v){
	int ans=0;
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		(ans+=query(1,t[t[u].top].id,t[u].id,1,n))%=P;
		u=t[t[u].top].fa;
	}
	if(t[u].dep>t[v].dep)swap(u,v);
	ans+=query(1,t[u].id,t[v].id,1,n);
	return ans%P;
}
void update_t(int p,int val){
	update(1,t[p].id,t[p].id+t[p].sz-1,1,n,val);
}
int query_t(int p){
	return query(1,t[p].id,t[p].id+t[p].sz-1,1,n);
}
int main(){
	cin>>n>>m>>r>>P;
	for(int i=1;i<=n;i++)cin>>va[i];
	for(int i=1;i<n;i++){
		cin>>U>>V;
		e[U].push_back(V);
		e[V].push_back(U);
	}
	dfs(r,0),dfs2(r,r);
	build(1,1,n);
	while(m--){
		cin>>op;
		if(op==1)cin>>U>>V>>W,update_r(U,V,W);
		else if(op==2)cin>>U>>V,cout<<query_r(U,V)<<"\n";
		else if(op==3)cin>>U>>W,update_t(U,W);
		else cin>>U,cout<<query_t(U)<<"\n";
	}
	return 0;
}
如果你认认真真打完了的话,那么恭喜你,你又学会了一个好用的数据结构。
应用
我们证明了树剖的优秀复杂度后,考虑应用。
求 \(\operatorname{LCA}\)
我们发现这个东西跟倍增一样,都是以 \(\log_2 n\) 的方法跳,而这里变成了跳重链。
熟悉 \(\operatorname{LCA}\) 的选手可以以倍增法类推。
- 当 \(u\) 与 \(v\) 在一条重链上,因为是祖先关系,那么 \(\operatorname{LCA}(u,v)=u\)(\(t_u.dep<t_v.dep\))
- 否则,我们跳重链。
给出代码。
int get_lca(int u,int v){
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		u=fa[t[u].top];
	}
	return(t[u].dep<t[v].dep?u:v);
}
这里的 \(top\) 表示重链链头。
然后,我们让更深的 \(u\) 跳。(当然要是不够深就对调)
最后处于同一个链时,为答案。
边权转点权
什么?你说既有边权又有点权?那么分开维护即可。
我们考虑边权转点权。
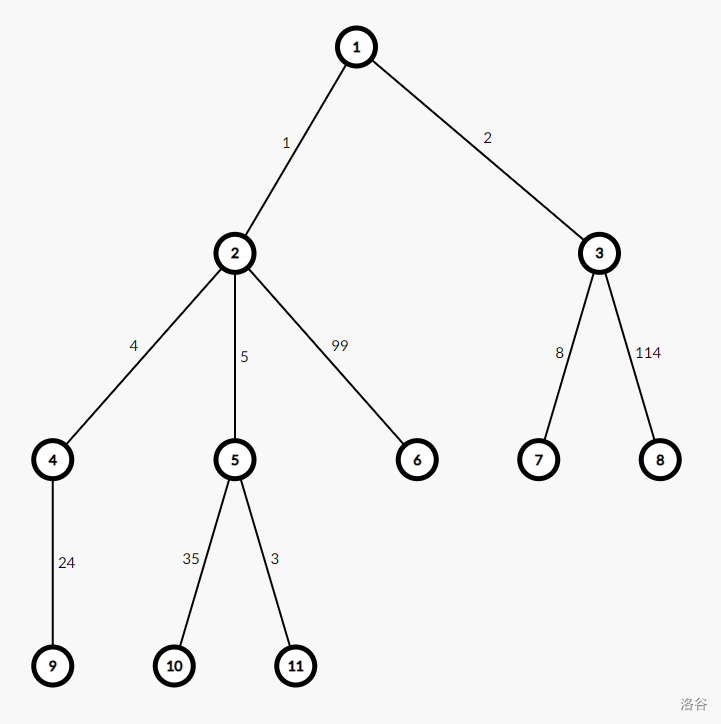
我们发现,一个点的父亲是唯一的。
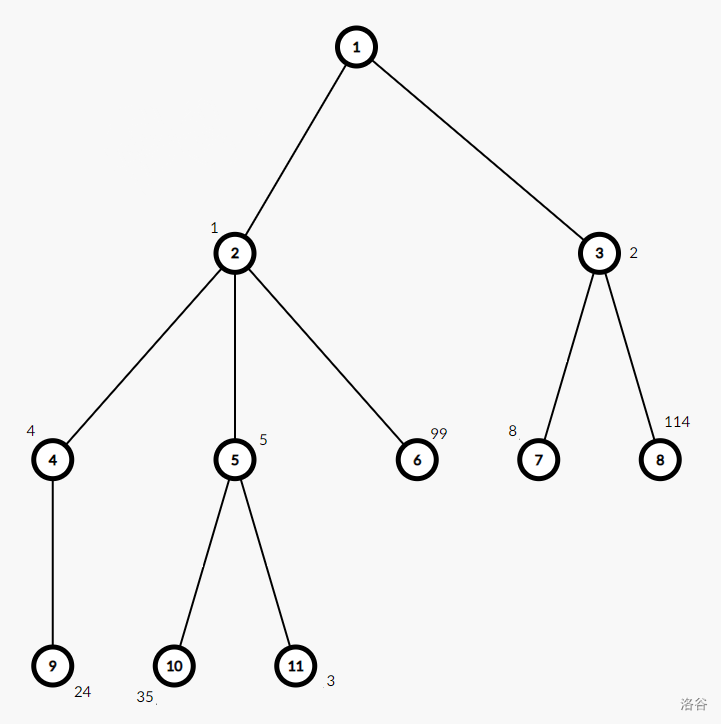
那么我们把这个点的边权移动到所属子节点即可。
比如 \(u\) 是 \(v\) 的父亲,那么 \(w\) 就存在 \(v\) 上。
这样就可以很好地移动边权了。
注意到我们要是在区间修改时,要注意不要把 \(\operatorname{LCA}\) 的权值改了,那不属于这个路径。
还有就是子树修改同理不要改 \(u\) 的权值。
移动后的图如下。
代码:
void update_r(int u,int v,int w){
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		update(1,t[t[u].top].id,t[u].id,1,n,w);
		u=t[t[u].top].fa;
	}
	if(t[u].dep>t[v].dep)swap(u,v);
	update(1,t[u].id+1,t[v].id,1,n,w);
}
int query_r(int u,int v){
	int ans=0;
	while(t[u].top!=t[v].top){
		if(t[t[u].top].dep<t[t[v].top].dep)swap(u,v);
		ans+=query(1,t[t[u].top].id,t[u].id,1,n);
		u=t[t[u].top].fa;
	}
	if(t[u].dep>t[v].dep)swap(u,v);
	ans+=query(1,t[u].id+1,t[v].id,1,n);
	return ans;
}
练习题:P3038 [USACO11DEC] Grass Planting G
换根树剖
例题:P3979 遥远的国度。
我们考虑分类讨论求子树答案,因为只有这个是受影响的。
首先是查询点 \(p=rt\) 的情况,答案就是 \(a_1.val\)。
然后是答案不受影响的情况。
读者自己可以通过分析搜索序求出答案不受影响的情况。
答案:$t_{rt}.id\leq t_{rt}.id\ \vee\ t_{rt}.id>t_{p}.id+t_{p}.sz-1 $,即点 \(rt\) 不在 \(p\) 子树范围内。
这种情况与普通的查询是一样的。
最后一种情况就是点 \(rt\) 在子树范围内。
重点是:不能更新 \(p\) 到 \(rt\) 链答案。
直接去掉即可。
int typ;
int query_t(int p){
	typ=(rt==p?1:(t[rt].id<=t[p].id||t[rt].id>t[p].id+t[p].sz-1)?2:3);
	if(typ==1)return a[1].val;
	if(typ==2)return query(1,t[p].id,t[p].id+t[p].sz-1,1,n);
	int ans,u=rt,gt=t[p].son;
	while(t[u].top!=t[p].top){
		if(t[t[u].top].fa==p){
			gt=t[u].top;
			break;
		}
		u=t[t[u].top].fa;
	}
	u=gt;
	ans=query(1,1,t[u].id-1,1,n);
	if(t[u].id+t[u].sz<=n)ans=min(ans,query(1,t[u].id+t[u].sz,n,1,n));
	return ans;
}
课后练习
这里有一些题:卷卷 · 树链剖分 / LCT · 卷卷。
然后建议想练习代码能力的同学看:P1505 [国家集训队] 旅游。关底 boss。

 浙公网安备 33010602011771号