
【LLM扫盲系列·2】大语言模型核心原理
一、大语言模型 vs 传统的机器学习:主要差异
在人工智能的发展历程中,传统机器学习和大语言模型(LLM)代表了两种不同的范式。理解它们的差异,有助于我们把握大模型的独特价值。
| 对比维度 | 传统机器学习 | 大语言模型(LLM) |
|---|---|---|
| 特征处理 | 需要人工设计特征(feature engineering),比如提取关键词、统计频率 | 模型自动学习特征表示,工程师主要负责数据清洗、分词、token化和训练流程 |
| 数据需求 | 使用监督学习,依赖标注数据 | 使用自监督学习,不需要人工标注 |
| 模型规模 | 参数量较小(通常百万级以下),任务专一,单机可训练 | 参数量巨大(亿级到万亿级),具备跨任务的通用性,需要分布式训练、并行计算和高性能硬件 |
| 泛化能力 | 换任务需重新设计特征和模型 | 通过 Prompt 工程、微调或外挂知识库即可迁移到新任务 |
| 应用场景 | 结构化数据(表格、数值),如金融风控、推荐系统 | 非结构化数据(文本、图像、语音),如对话、写作、翻译、编程 |
| 优势 | 高效、稳定、可解释性强 | 通用性强、跨领域能力突出 |
| 局限 | 灵活性差,迁移性弱 | 成本高,可能出现“幻觉” |
🌱 PS:关键词解释
- 特征工程(Feature Engineering):把原始数据(比如一段文字)转化成模型能理解的数字特征。传统方法需要人工挑选哪些信息重要。
- Token 化(Tokenization):把文本切分成模型能理解的最小单元(可能是字、词或子词)。
- 监督学习(Supervised Learning):模型学习时需要“标准答案”,比如给猫狗图片打上“猫/狗”的标签。
- 自监督学习(Self-Supervised Learning):模型自己从数据中找规律,比如通过预测句子里的下一个词来学习语言。
- 分布式训练(Distributed Training):由于单台机器算力和内存不够,把一个超大模型的训练任务拆分到多台机器上一起完成。
- 并行计算(Parallel Computing):在同一时间同时处理多个计算任务,而不是一个接一个顺序执行。
- 提示词工程(Prompt Engineering):工程师通过设计输入指令,引导模型输出更符合需求的结果。
- 幻觉(Hallucination):模型一本正经地生成错误内容,就像“自信地胡说”。
二、Transformer架构
大语言模型背后,最核心的技术是 Transformer。它的出现几乎改变了整个自然语言处理(NLP)的格局。要理解 Transformer,我们需要先看看为什么它会被提出,以及它和之前传统的 RNN 有什么不同。
1. 背景介绍:为什么需要 Transformer?
在 Transformer 出现之前,主流的序列建模方法是 RNN(循环神经网络) 和它的改进版 LSTM/GRU。它们的思路是:一句话从左到右逐字读入,前面的信息通过“隐藏状态”传递给后面。但问题是:
- 长依赖问题:句子很长时,前面的信息容易在传递过程中“遗忘”。
- 计算效率低:必须顺序处理,无法并行。
- 训练难度大:梯度容易消失或爆炸。(PS:通俗解释来说,就是模型参数更新的力度容易太弱或太猛,导致模型学不到东西或学得不稳定)
于是研究者提出了一个问题:能不能有一种方法,不用逐字传递信息,而是让模型直接“看到”整句话的所有部分,并决定哪些词彼此相关? 这就是 Transformer 的出发点。
2. 什么是Transformer
Transformer 是一种基于注意力机制(Attention) 的神经网络架构。它的核心思想是:
- 在处理一句话时,模型不是顺序传递信息,而是”关注“句子里其他所有词。
- 通过计算“注意力权重”,模型能判断哪些词对当前词的理解最重要。
👉 举个例子: 句子 “The cat sat on the mat.” 当模型处理 “cat” 时,它会自动关注 “sat” 和 “mat”,因为它们和 “cat” 的关系更紧密,而不会过度关注 “the”。
3. RNN vs Transformer:主要差异
| 特点 | RNN(循环神经网络) | Transformer |
|---|---|---|
| 信息传递方式 | 顺序传递,前一个词的状态传给下一个 | 所有词之间直接建立联系 |
| 并行计算 | 不支持,必须逐步处理 | 支持,所有词可同时计算 |
| 长依赖问题 | 容易遗忘远处的信息 | 注意力机制能直接捕捉远距离关系 |
| 训练效率 | 慢,梯度消失/爆炸问题严重 | 快,训练稳定 |
| 代表模型 | LSTM、GRU | BERT、GPT、T5 等 |
PS:代表模型简介
(1)RNN 家族:早期的代表
| 模型 | 全称 | 介绍 | 应用 |
|---|---|---|---|
| RNN | Recurrent Neural Network,循环神经网络 | 一边读输入,一边把前面读到的信息“记下来”,再传给后面的步骤 | 早期常用于语音识别、机器翻译、文本生成等 |
| LSTM | Long Short-Term Memory,长短期记忆网络 | 是 RNN(循环神经网络)的改进版,解决了普通 RNN 容易“忘记长距离信息”的问题 | 适合处理序列数据,比如语音识别、早期的机器翻译 |
| GRU | Gated Recurrent Unit,门控循环单元 | 和 LSTM 类似,但结构更简单,计算更快 | 也用于语音、文本等序列任务 |
👉 可以把 LSTM/GRU 想象成“老一代的语言模型引擎”,擅长短文本,但处理长句子时还是吃力。
(2)Transformer 时代的代表
| 模型 | 全称 | 介绍 | 应用 |
|---|---|---|---|
| BERT | Bidirectional Encoder Representations from Transformers,谷歌提出,双向编码器 | 它是第一个大规模成功的 Transformer 模型,能同时从左到右、从右到左理解句子 | 主要用于理解类任务:搜索、问答、情感分析 |
| GPT | Generative Pre-trained Transformer,OpenAI 的代表作 | GPT 专注于“生成”,比如写文章、写代码、续写故事 | 代表了“生成式 AI”的浪潮 |
| T5 | Text-to-Text Transfer Transformer,谷歌提出 | 把所有 NLP 任务都转化为“文本到文本”(“输入一段文字 → 输出一段文字”)的形式 | 可执行翻译、分类、问答、摘要任务,用一个模型解决所有问题 |
4. Transofrmer架构概览
(1)架构图
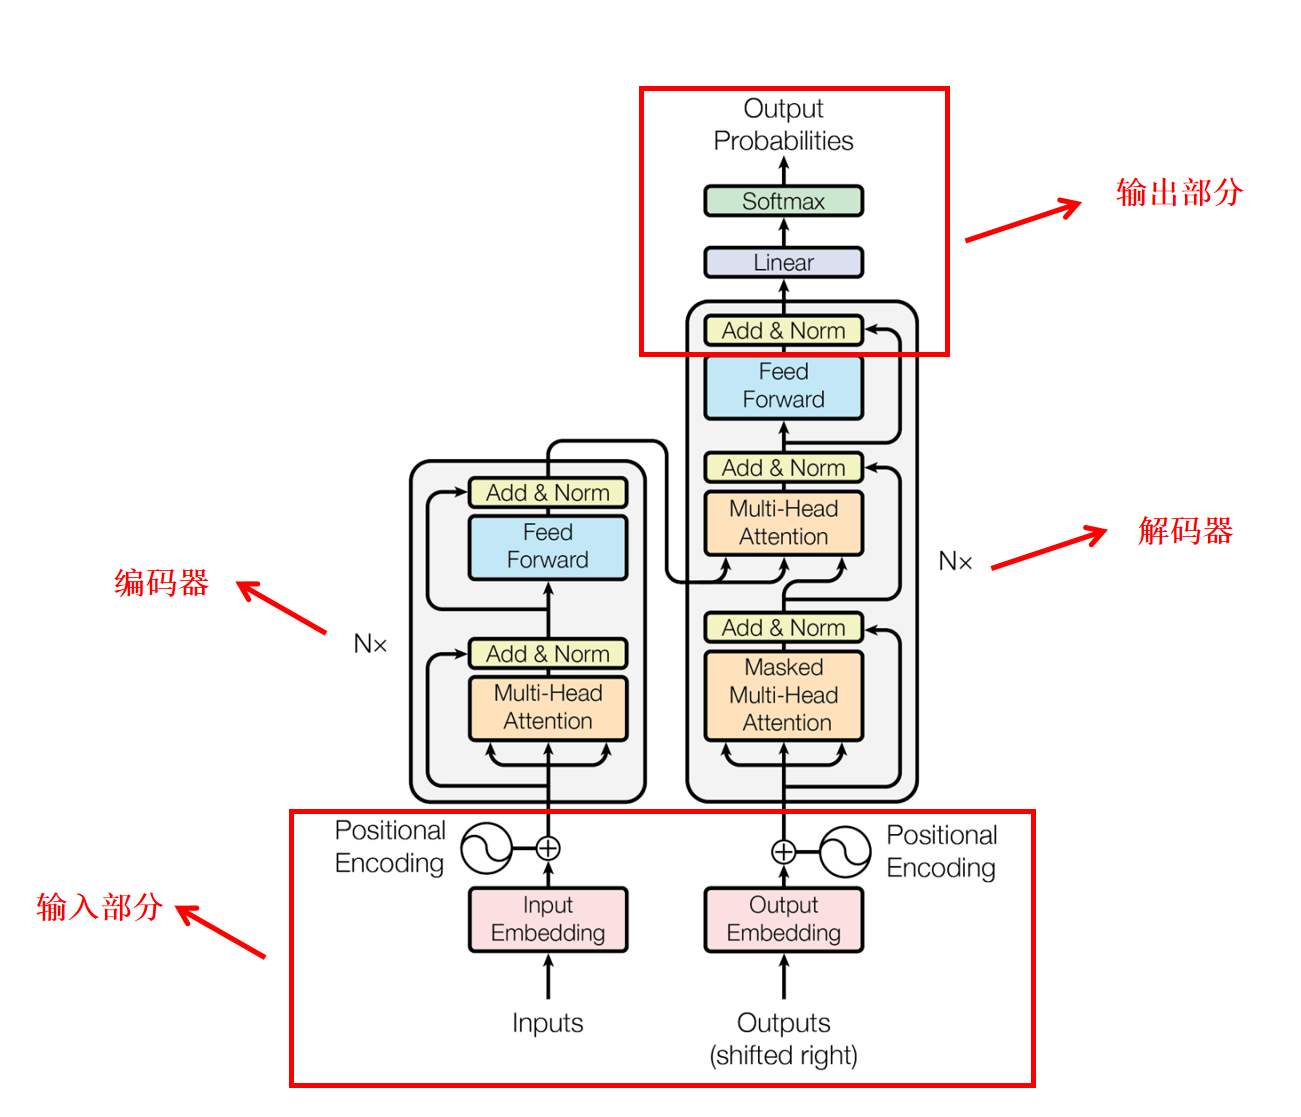
- Transformer架构图,来自经典文章 Attention is all you need
![Transformer架构图]()
(2)主要架构
Transformer 模型主要由输入层 → 编码器(Encoder)→ 解码器(Decoder)→ 输出层组成,我们将在后文详细解释该架构如何运行。
| 结构 | 功能 |
|---|---|
| 输入层 | 把文本切分成 Token,并转化为向量(这个转化成向量的过程叫做Embedding),再加上位置编码(Positional Encoding) |
| 编码器(Encoder) | 由多个相同的层堆叠而成,每层包含自注意力机制(Self-Attention)+ 前馈神经网络(Feed-Forward Neural Network) 两个主要子层,它的任务是将输入序列转换为一组包含词语本义和上下文信息的向量 (例:bank 在 “river bank” 和 “bank account” 中的含义不同,向量表示也不一样,编码器在把词转化成向量时,要根据上下文判断此处bank的含义) |
| 解码器(Decoder) | 同样由多个相同的层堆叠而成,每层包含自注意力机制+ 编码器-解码器注意力机制(Encoder-Decoder Attention)+ 前馈神经网络 三个主要子层,它的任务是将编码器的输出转换为目标序列,输出一组高维向量,代表“下一个词的语义可能性” |
| 输出层 | 通常是一个 Softmax 层,把解码器的结果向量映射到词表大小的维度,得到每个词的概率,把输出转化为具体的词 |
三、大模型运行基本机制
1. 大模型如何理解和表示单词
(1)大模型处理单元 - Token
计算机不能直接理解自然语言里的“词”,所以大模型会先把文本切分成更小的单元,叫做 Token。
- 一个 Token 可能是一个完整的词(如cat),也可能是一个词的一部分(如 ca + t),甚至是一个标点符号。
- 模型处理的所有输入和输出,都是由 Token 组成的序列。
(2)单元之间的远近关系
每个 Token 会被转化成一个向量(这个过程叫Embedding),这个向量就像是单词的“坐标”。
- 向量就是词义的载体。它不仅包含词本身的含义,还会随着上下文而变化。 比如 “bank” 在 “river bank” 和 “bank account” 中,向量表示会不同,因为上下文不同。
- 在这个空间里,语义相近的词会靠得更近。例如,“猫”和“狗”的向量距离很近,而“猫”和“汽车”的距离就很远。
- 这种“远近”关系帮助模型理解词语之间的语义联系
2. 大模型如何理解并预测输入的内容
(1)注意力机制(Attention)
注意力机制让模型在处理一句话时,不会平均对待所有词,而是学会“重点关注”与当前任务最相关的部分。
(2)自注意力机制(Self-Attention)
自注意力是注意力机制的一种特殊形式:
- 在自注意力机制下,每个词会生成三个向量:Query、Key、Value。 Query 向量, Key 向量和Value向量都是通过 与不同的矩阵相乘 得到的,因此并不相同。类比来看,Query 表示“提问”,Key 表示举手表明“我能回答”,Value 表示“真正的回答内容”。
- 通过计算 Query 和 Key 的相似度,得到注意力权重,再加权求和 Value。
- 举例:在句子 I love you 中,当前Query是“love”,key分别是“I”,“love”,“you”。模型发现“love”与“I”的key的相似度是0.2,与 “love” 的 key 相似度是0.7,与 “you” 的 key 相似度是0.1,则概率分布可能是[0.2, 0.7, 0.1],则用这个相似度和每个词的Value分别相乘求和得到“love”的新表示。
这样,每个词的表示就会融合上下文信息。 例如,在 “I love you” 中,模型会让 “love” 同时关注 “I” 和 “you”,从而理解“爱”的对象是谁。
(3)基于语义理解的内容生成
当模型理解了输入后,它会在解码阶段一步步生成输出。首先输入 <BOS>(句子开头符号),预测第一个词。然后把已生成的词作为输入,再预测下一个词。每一步的输出都是一个向量,经过 Softmax 转换成概率分布,选出概率最高的词。重复这个过程,直到生成完整的句子。我们将在后文详细展开。
3. Transformer架构运行流程
Step 1:输入处理
- 文本进入模型后,首先被切分成Token(如单词或子词);
- Embedding:每个 Token 转换成多维向量(多维可以表达更丰富的含义);
- 加上 位置编码(Positional Encoding) ,让模型知道词语的顺序 (由于 Transformer 不像 RNN 那样有顺序感,所以需要额外来告诉模型词语的先后顺序。位置编码通常使用正弦和余弦函数生成,能够为每个位置提供唯一的表示)。
Step 2:编码器处理
- 每个 Token 的向量进入编码器;
- 编码器的核心是自注意力机制允许模型在处理输入序列的每个元素时,考虑到序列中所有其他元素的影响,模型会计算某个词与其他所有词的关系;
- 此处会使用多头注意力机制(1)进行并行计算;
- 最后经过前馈神经网络(1)和残差连接(1),得到更抽象的表示,此时向量不再只是“词的表面含义”,而是逐渐编码了更复杂的语义和语法特征。
Step 3:解码器生成
- 解码器先用 掩码自注意力机制(Masked Self-Attention),保证生成时只能看到前面的词,避免“偷看答案”。因为我们在训练模型时,会同时告诉模型输入和输出答案来比对模型输出结果和答案是否一致,因此为了避免模型直接读取答案,我们需要遮住未来的词,只允许模型看到当前位置之前的词,模拟真实生成过程。
- 再通过 Encoder-Decoder Attention 利用编码器的输出,理解输入和输出之间的对应关系。
- 此处同样会使用多头注意力机制(1)进行并行计算;
- 最后经过前馈神经网络,得到对下一个词的预测。
Step 4:输出层
- 解码器的结果通过 Softmax (1)转换为概率分布。
- 选出概率最高的词作为输出。
- 重复 Step 3 和 Step 4,直到生成完整的句子。
(1) 关键词解释
- 多头注意力(Multi-Head Attention):在 编码器的自注意力层 和 解码器的自注意力层、编码器-解码器注意力层 都会使用,它的作用是:并行计算多组注意力,每个“头”关注不同的关系(比如语法、语义、长距离依赖)。
- 前馈神经网络(Feed Forward Network):一个小型的全连接网络,它对每个词的向量做非线性变换,从而让模型能捕捉复杂的模式 (如果只有线性变换,模型整体仍然是线性的,表达能力有限)。
- 残差连接(Residual Connection):公式为y = x + F(x) ,其中x是输入,F(x) 是子层变换;这使得输入和输出叠加,即使 F(x) 学得不好,至少能保留原始输入x,避免信息完全丢失。
- Softmax:把一组数值转化为概率分布,方便选择输出词,表达式为 $\text{Softmax}(z_i) = \frac{e{z_i}}{\sum_{j=1} e^{z_j}}$ ,其中$z_i$是第$i$个词的得分,$K$是词表大小。Softmax 可以把任意实数转化为 0–1 之间的概率,并且所有概率之和为 1。
(2)举例:英译中
输入:I love you
目标输出:我 爱 你
-
Step 1 输入处理: I love you → Token → 向量 + 位置编码
-
Step 2 编码器: 通过自注意力,模型理解 I 是主语,love 是动词,you 是宾语 → 得到上下文相关的表示
-
Step 3 解码器 + Softmax:
- 每一步的输出都通过 Softmax 转成概率分布,选出概率最高的词
- 预测第一个词:Masked Self-Attention 确保它只能看到
(句子开头符号) - 输入 <BOS>(句子开头符号)
- 解码器输出一个向量,例如 [2.3, 0.5, -1.2, …](对应词表里的所有词)
- Softmax 转换成概率分布:[ “我”:0.72, “你”:0.15, “爱”:0.08, 其他词:更小]
- 选出概率最高的“我”
- 再预测第二个词:
- 输入<BOS> 我,输出“爱”
- 输出向量 → Softmax 概率:[“你”:0.10, “爱”:0.80, 其他词:更小]
- 选出“爱”
- 再预测第三个词:
- 同上,选出“你”
-
Step 4 输出层: 最终得到完整的目标序列:我 爱 你
四、大模型是如何一步步变聪明的:预训练 → SFT → RLHF
当我们说“大语言模型很强”,其实它不是一蹴而就的,而是经历了三个关键阶段:预训练 → 监督微调(SFT) → 人类反馈强化学习(RLHF)。
| 阶段 | 输入数据 | 训练方式 | 类比 | 结果 |
|---|---|---|---|---|
| 预训练 (Pre-training) | 海量的无标注文本(网页、书籍、对话等) | 自监督学习:预测下一个词、填空 | 通识教育:像小孩读各种书,先学语言规律和常识 | 得到一个“通用大脑”,懂语法、词义和常识,但不够精细 |
| 监督微调 (SFT) | 人工标注的高质量数据(问答对、任务数据) | 监督学习:给模型一堆“问题 → 标准答案”的数据,让它学会如何回答问题 | 专业训练:像学生上专业课,老师手把手教 | 模型能在特定任务上表现更好,但回答可能比较“机械” |
| 人类反馈强化学习 (RLHF) | 人类对模型回答的偏好反馈(好/不好) | 强化学习:先训练“奖励模型”(Reward Model)学会预测人类的偏好,再用这个偏好来调整模型,让它生成更合人意的回答(如PPO算法) | 社会化训练:像学生在社会中学会礼貌、合群 | 模型不仅能答对,还能更自然、更符合人类价值观 |

 浙公网安备 33010602011771号