
为什么越来越多人用 AI Gateway?
前言
大家好,我是苏三。
前阵子有球友反馈说,他们做了一个 AI 客服系统,光是“调模型”这个动作,他们在业务层写了三个适配器:一个 OpenAI 的,一个 Anthropic 的,一个通义千问的。
每个适配器里都有自己的一套重试逻辑、自己的一套错误码映射、自己的一套 Token 统计。
我问他:“如果明天老板说 DeepSeek 便宜,全量切过去,你要改多少地方?”
他苦笑了一下:“三个适配器都得动,业务代码里还有一堆 if provider == 'openai'的判断。”
这就是 AI Gateway 要解决的问题。
它不是“又一个中间件”,而是把“调模型”这件事从业务代码里抽出来,变成一层统一的基础设施。
你对着一个地址说话,剩下的路由、翻译、兜底、记账,交给网关。
今天这篇文章,我就把 AI Gateway 到底解决了什么、它的核心原理、以及怎么用,从头到尾给你拆解一遍。
希望对你会有所帮助。
一、为什么“直接调模型”会变成灾难?
有些小伙伴可能会说:“我直接调 OpenAI 的 API 不就行了?加个 try-catch 不就完了?”
单模型、单供应商的时候,确实没问题。但一旦你的系统开始“长大”,问题就藏不住了。
第一个问题,协议不统一。
OpenAI 用 tool_calls 字段,Anthropic 用 tool_use content block,Gemini 用 functionCall part。
你每接一个供应商,就要写一套入参转换、出参转换、流式事件转换。三套适配器,加起来就是几百行胶水代码。
第二个问题,故障处理零散。
某个供应商突然 5xx 了,你希望自动切到备用模型。
但如果你在每个业务方法里都写 try-catch 加 fallback,代码会变得极其难看。而且“什么时候该重试、什么时候该降级、429 限流该怎么处理”,每个地方写的逻辑可能还不一样。
第三个问题,成本不可见。
你的应用同时调了 OpenAI 和 DeepSeek,月底账单来了,你想知道“哪个业务线花了多少钱”,结果发现两个供应商的账单格式不一样,对不上。
第四个问题,安全管控分散。
你想给每个部门设置不同的 Token 限额,想对用户输入做 PII 脱敏,想审计每一次模型调用。
如果每个应用各管各的,这些事根本做不统一。
AI Gateway 的本质,就是把这些问题从业务代码里“抽出来”,放在一个统一的地方解决。
二、一张图看懂 AI Gateway 的位置
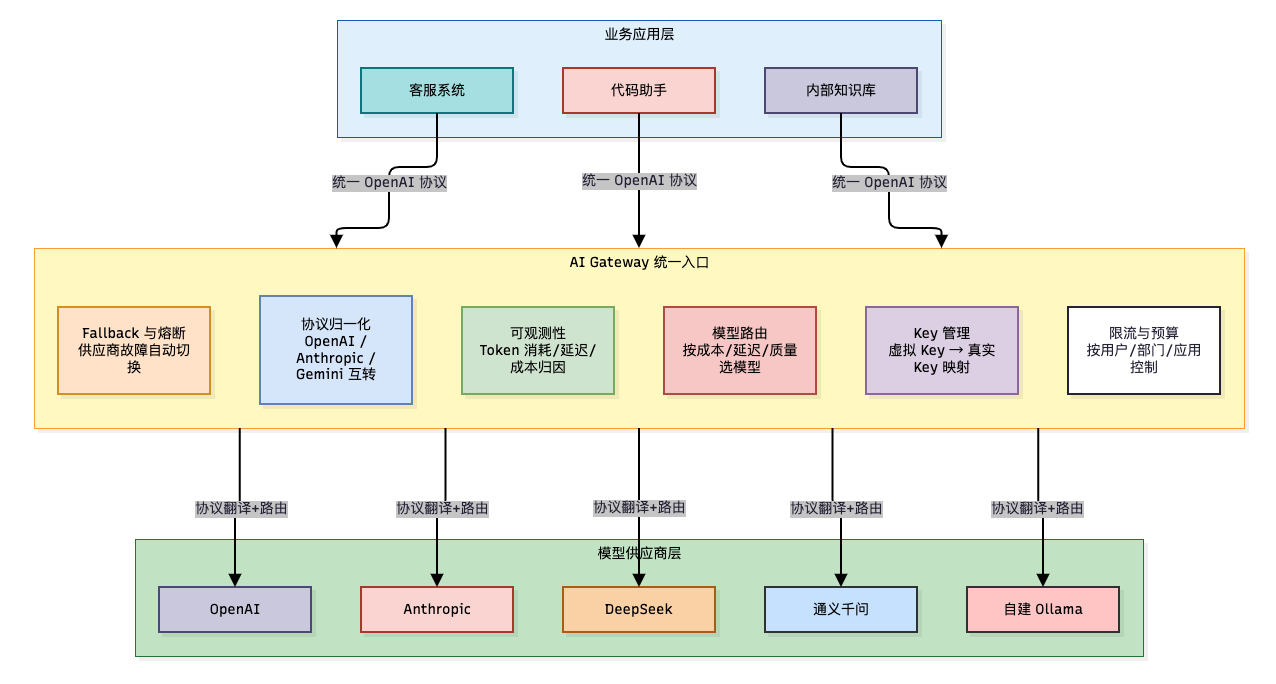
业务应用只对着 Gateway 说一种“语言”(通常是 OpenAI Chat Completions 格式),Gateway 负责把它翻译成各个供应商能听懂的话,然后根据你的策略,决定把请求发给谁。
这个设计的核心价值是:业务代码和供应商解耦了。 你今天用 OpenAI,明天换 DeepSeek,后天加一个自建的 Ollama,业务代码一行都不用改。你只需要改 Gateway 的配置。
三、AI Gateway 到底在做什么?
3.1 协议归一化:让所有供应商“说普通话”
这是 AI Gateway 最基础、也最繁琐的工作。
各家 API 的差异比看起来深。
以工具调用为例:OpenAI 用 tool_calls 字段,Anthropic 用 tool_use content block,Gemini 用 functionCall part。
系统提示的位置也不一样。
流式响应的增量结构更是各不相同。
Gateway 在中间做翻译。
你发一个标准的 OpenAI 格式请求进来,Gateway 根据路由规则,把它翻译成目标供应商的格式,发出去;收到响应后,再翻译回标准格式,返回给你。
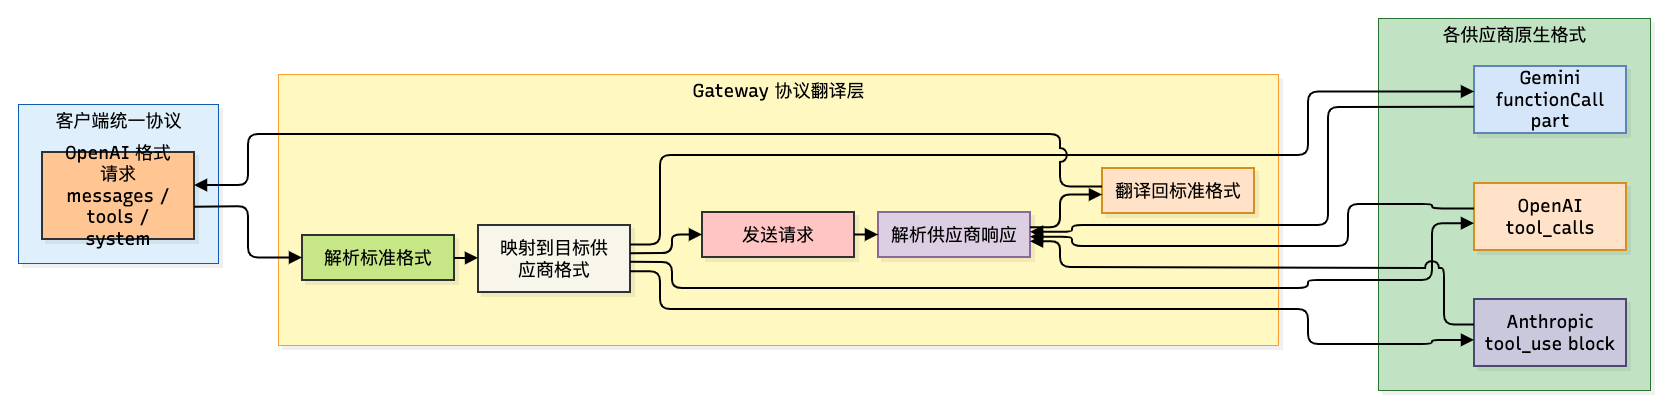
这意味着你的代码只需要认一种协议。
换供应商的时候,你不需要重写任何请求构造逻辑。
LiteLLM 的文档把这件事说得很清楚:litellm.completion() 负责的就是“Translation and parameter mapping”。
3.2 模型路由:按策略选“谁来回答”
这是 AI Gateway 最有技术含量的部分。路由策略从简单到复杂,大概有这几个层次:
固定模型:写死,手动改。最简单,也最不灵活。
规则路由:按场景、租户、风险等级映射模型。比如“内部测试用便宜模型,生产环境用旗舰模型”。
成本路由:小模型先试,不够用再升级强模型。比如先用 DeepSeek 回答,如果它返回的置信度低,再转给 GPT-4o 重答。
Fallback 与熔断:不是所有错误都该 Fallback。网络瞬断、5xx 服务端错误适合切换;429 限流要谨慎,需要读 Retry-After;认证错误切了也没用。
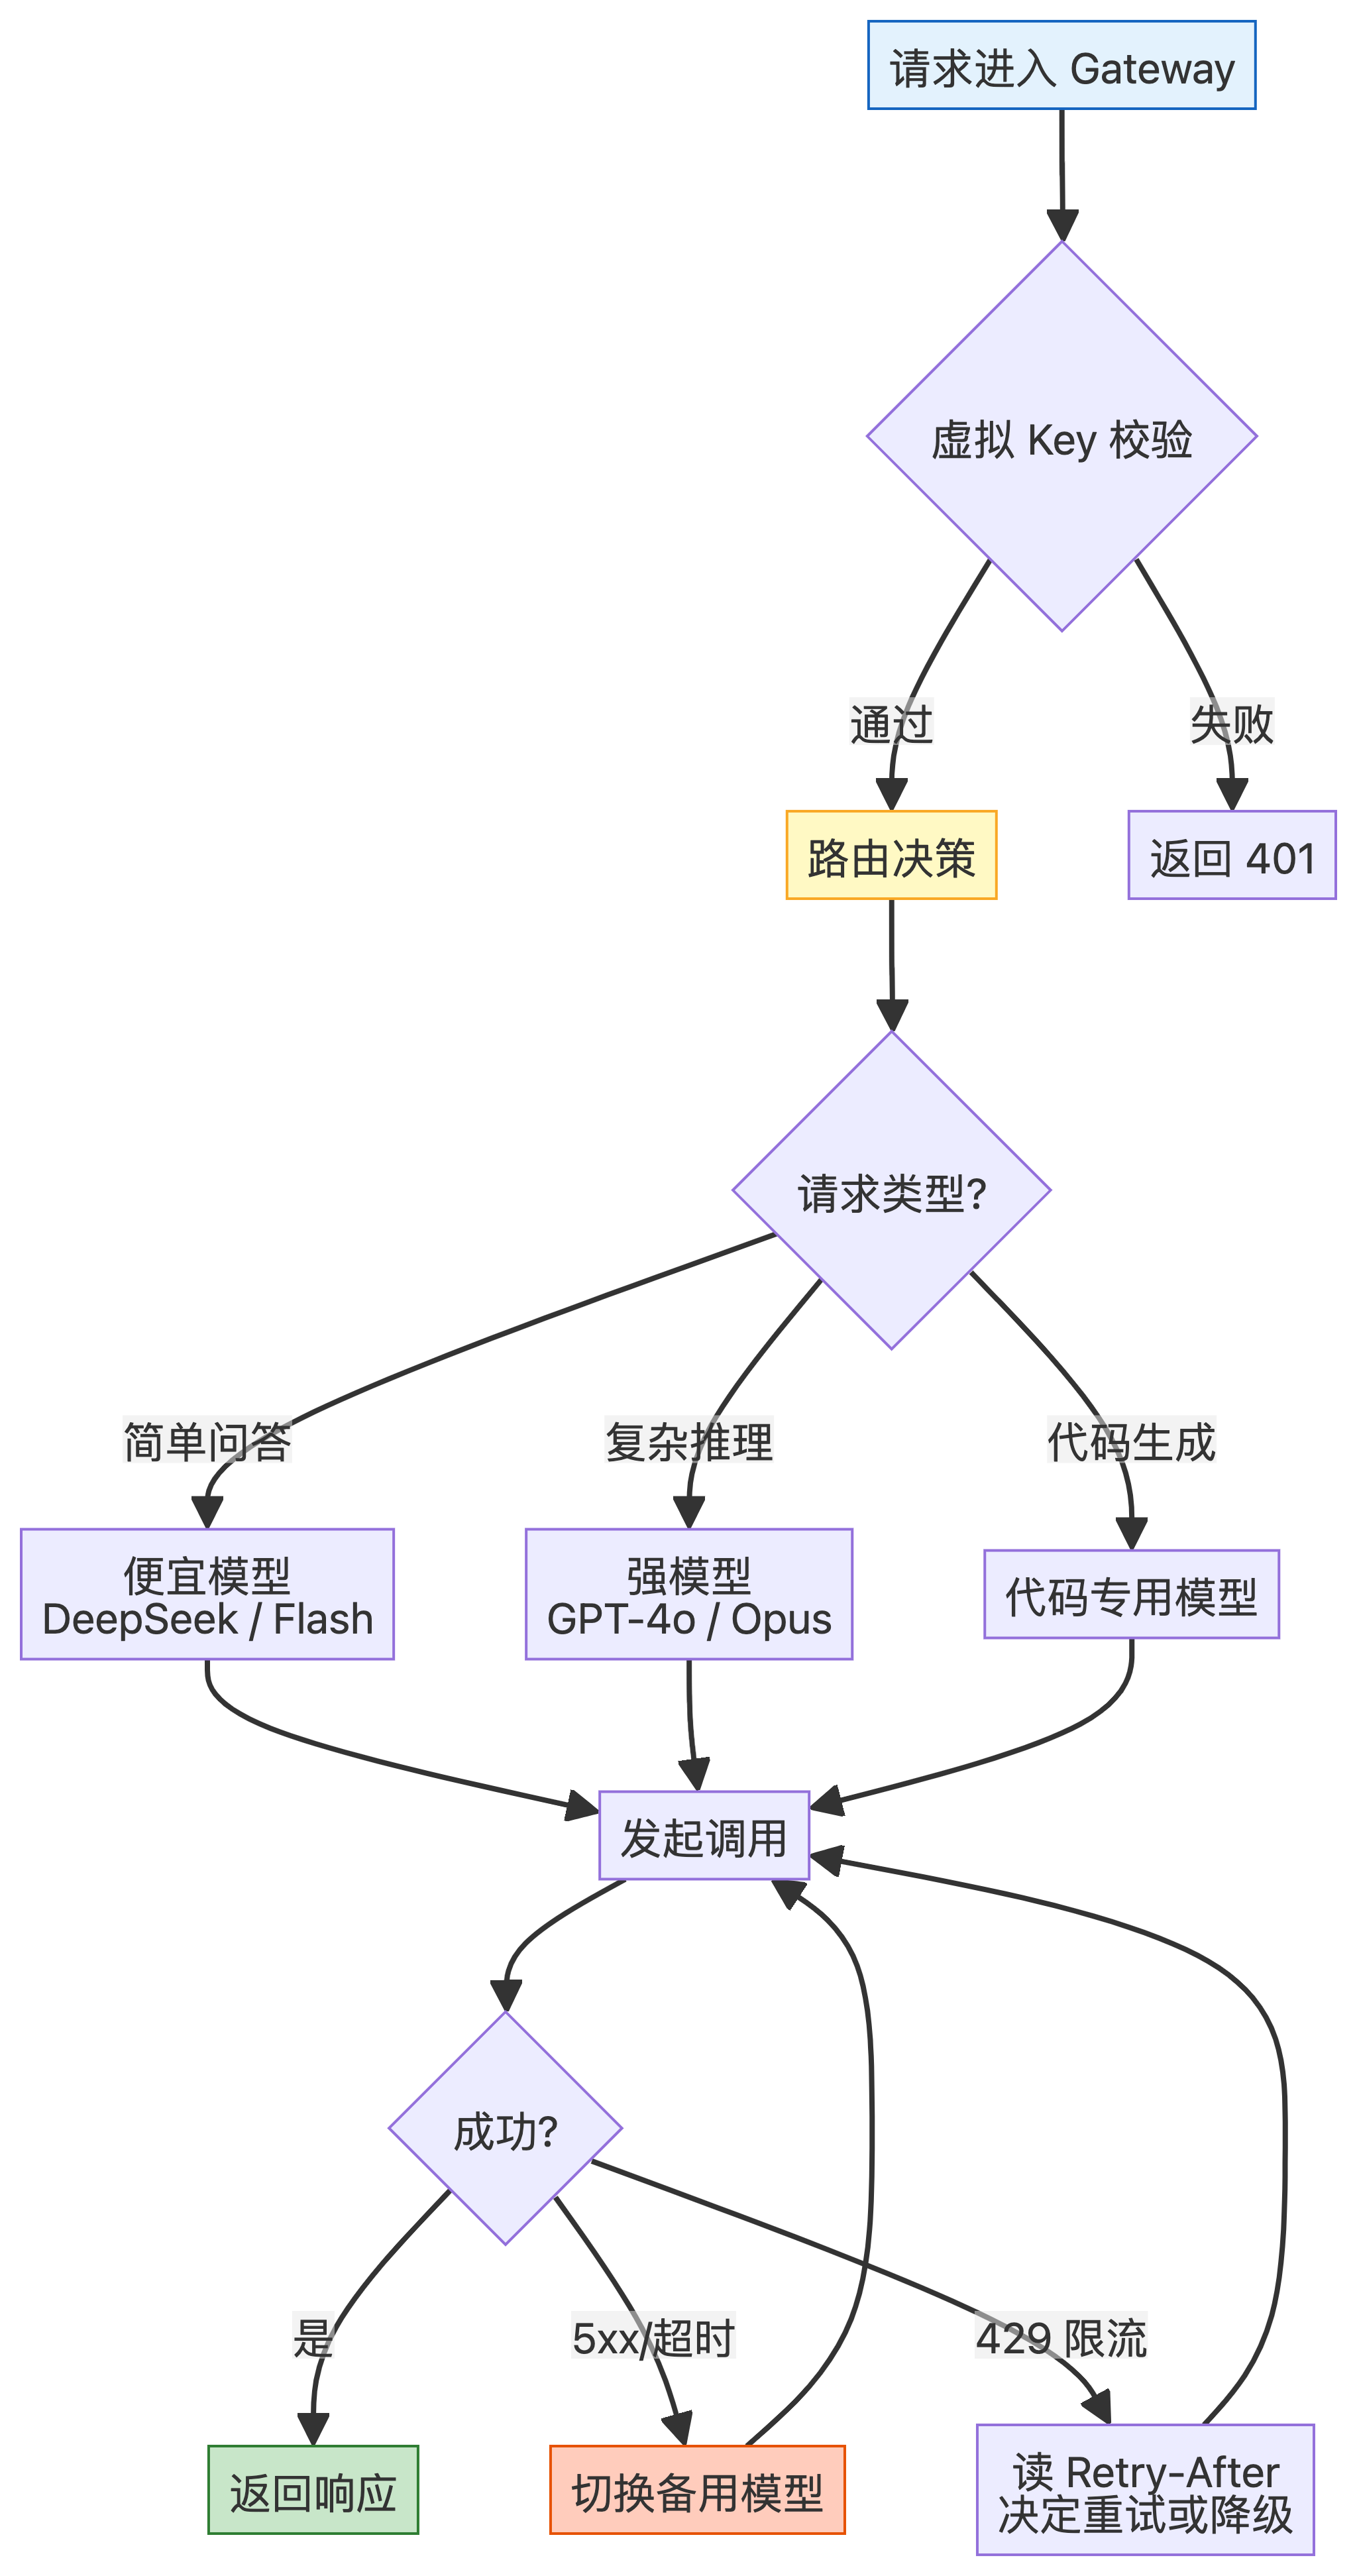
LiteLLM 的 Router 把 Load balancing、Fallbacks、Retries 都收在这一层处理。
3.3 Key 管理:虚拟 Key 到真实 Key 的映射
这是企业级场景的刚需。
你的应用不应该直接持有 OpenAI 的 Key。
正确的做法是:Gateway 给每个应用或每个用户发一个“虚拟 Key”,应用拿着虚拟 Key 来调 Gateway,Gateway 根据虚拟 Key 找到对应的真实供应商 Key,再转发出去。
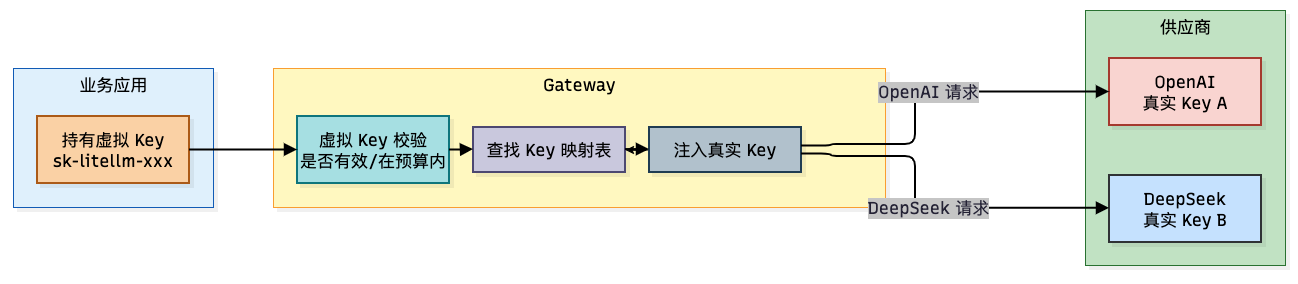
LiteLLM 的请求流程里,第一步就是检查 Bearer token 对应的 Virtual Key 是否有效、是否在预算内。你可以随时吊销某个虚拟 Key 而不影响其他人;你可以追踪“哪个应用调了多少次、花了多少钱”;你可以给不同部门设置不同的预算上限。
3.4 可观测性:Token 和成本是新的 QPS
传统 API 网关看的是 QPS、延迟、错误率。
AI Gateway 看的是 Token 消耗、成本归因、首 Token 延迟。
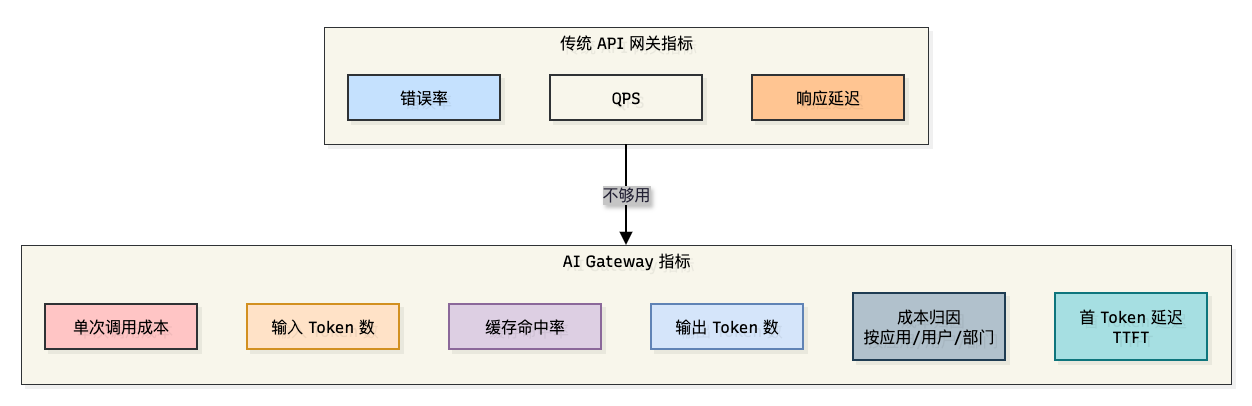
这些指标的意义完全不同。
两个请求的 QPS 可能一样,但一个请求消耗 100 个 Token,另一个消耗 10 万个 Token,成本差一千倍。传统按 QPS 限流在这里几乎无效。
AI Gateway 按 Token 限流、按成本预算控制,这才是 AI 场景下正确的治理方式。
阿里云 AI 网关的文档里,Token 计量计费和语义缓存是并列的两个核心能力。
四、用 LiteLLM 跑通一个 AI Gateway
有些小伙伴可能会说:“说了这么多,到底怎么用?”
LiteLLM 是目前最广泛使用的开源 AI Gateway。
Thoughtworks 的技术雷达把它从“语言与框架”移到了“平台”类别,理由是“我们更多把它看作基础设施,而不是一个库”。
4.1 安装与启动
pip install 'litellm[proxy]'
litellm --config /path/to/config.yaml
4.2 配置文件:定义模型路由
model_list:
  - model_name: "gpt-4o"
    litellm_params:
      model: "openai/gpt-4o"
      api_key: os.environ/OPENAI_API_KEY

  - model_name: "deepseek-chat"
    litellm_params:
      model: "deepseek/deepseek-chat"
      api_key: os.environ/DEEPSEEK_API_KEY

  - model_name: "qwen-max"
    litellm_params:
      model: "dashscope/qwen-max"
      api_key: os.environ/DASHSCOPE_API_KEY
4.3 客户端调用:完全不用改代码
from openai import OpenAI

client = OpenAI(
    api_key="sk-litellm-virtual-key",
    base_url="http://localhost:4000"
)

response = client.chat.completions.create(
    model="gpt-4o",  # 或者 "deepseek-chat"、"qwen-max"
    messages=[{"role": "user", "content": "解释一下什么是 AI Gateway"}]
)
你的业务代码只认 base_url 和 model 两个东西。 背后是 OpenAI 还是 DeepSeek,业务代码完全不知道。
五、用 AI 帮你排查网关配置问题
AI Gateway 本身是一个“中间层”,出问题时,排查链路比直连长。但正因为它是网关,它的日志是集中的、结构化的,AI 可以帮你快速定位。
假设你的应用突然报错,说某个模型不可用。你怎么快速判断是网关配置问题还是供应商问题?
传统方式:看应用日志、看网关日志、看供应商状态页,三方对比,十分钟过去了。
AI 辅助方式:你把网关的请求日志和错误日志喂给 AI,说:
“这是我的 LiteLLM 网关日志。应用调用
gpt-4o时返回 500,但调用deepseek-chat正常。帮我分析一下是网关配置问题还是 OpenAI 侧问题。”
AI 会扫描日志,发现 gpt-4o 的请求在网关侧就失败了,错误信息是 AuthenticationError: Incorrect API key。
它会告诉你:“网关到 OpenAI 的 Key 配置有问题,不是 OpenAI 服务本身挂了。检查 OPENAI_API_KEY 环境变量是否正确加载。”
AI 不能替你做的事:判断“这个 Key 为什么失效了”——是过期了、被吊销了、还是环境变量没注入?这个需要你去看供应商控制台、看部署配置。
AI 帮你缩小范围,你来做最终判断。
六、优缺点
优点
1. 业务与供应商解耦
业务代码只认一种协议、一个地址。换供应商、加模型,改网关配置就行,业务代码不动。
2. 故障处理集中化
Fallback、重试、熔断、限流,全部在网关层统一配置。不需要每个应用自己写一套。
3. 成本可观测、可控制
Token 消耗、成本归因、预算上限,网关层统一管理。知道钱花在哪、花给谁。
4. Key 管理更安全
虚拟 Key 映射真实 Key,应用不直接持有供应商密钥。轮换、吊销、权限控制都在网关层完成。
5. 协议翻译自动化
OpenAI、Anthropic、Gemini 之间的格式差异,网关帮你翻译。你不需要写三套适配器。
缺点
1. 多了一层,就多了一个故障点
网关本身挂了,所有应用都调不了模型。所以网关的高可用是必须的,不能单点。
2. 供应商特有功能可能被“抹平”
LiteLLM 的 drop_params 模式会静默丢弃不支持的参数。如果你依赖某个供应商的特有能力,可能需要绕过网关直连,或者接受“跨供应商时功能降级”。
3. 自托管有运维成本
开源网关(如 LiteLLM)需要自己部署、自己保证可用性、自己跟安全补丁。Thoughtworks 指出 LiteLLM 在 2026 年已经报告了超过 25 个 CVE,需要及时打补丁。
4. 不是所有场景都需要
只接一个模型、只有一个调用方、不在乎成本细节的系统,加网关是过度设计。
七、适用场景
| 场景 | 推荐程度 | 理由 |
|---|---|---|
| 多模型/多供应商切换 | ✅✅✅ 强烈推荐 | 协议翻译+路由,业务代码零改动 |
| 需要成本管控和归因 | ✅✅✅ 强烈推荐 | Token 级限流、预算控制、成本归因 |
| 企业级 Key 管理和审计 | ✅✅✅ 强烈推荐 | 虚拟 Key、审计日志、权限控制 |
| 供应商故障自动兜底 | ✅✅✅ 强烈推荐 | Fallback、熔断、重试集中配置 |
| 单模型简单应用 | ❌ 不推荐 | 加网关是过度设计 |
| 依赖供应商特有功能 | ⚠️ 需评估 | 网关可能抹平差异,需确认支持范围 |
八、写在最后
回到最初的问题:为什么越来越多人用 AI Gateway?
因为“调模型”这件事,正在从“写一行代码”变成“管一套基础设施”。
当你的系统只接一个模型的时候,直接调 API 没问题。
但当你的系统接了三个供应商、五个模型、十几个应用、几十个用户的时候,“怎么调”就变成了一件需要统一治理的事。
协议不统一、故障处理零散、成本看不见、Key 管不住——这些问题,每一个单独解决都不难,但加在一起,就是几千行胶水代码和无数个深夜的应急电话。
AI Gateway 的价值,就是把这些“横切关注点”从业务代码里抽出来,放在一个统一的地方解决。 业务代码只管“我要什么”,网关负责“怎么拿到”。
当然,它不是银弹。
多一层就多一个故障点,自托管有运维成本,供应商特有功能可能被抹平。
但对于多模型、多供应商、需要成本管控和审计的团队来说,它已经从一个“可选项”变成了“基础设施”。
相关推荐:

 浙公网安备 33010602011771号