
聊聊Redisson最常见的8个坑
前言
不知道你有没有遇到过这种场景:项目里明明用了 Redisson,代码里也老老实实写了 lock 和 unlock,结果偶尔还是会出现重复扣库存、同一笔订单被处理两次,或者两个线程同时修改同一份数据。
有些小伙伴第一反应是:Redisson 是不是有 bug?
我一般情况下不会先怀疑 Redisson。咱们得先看锁到底加在了什么地方、什么时候释放、保护的是不是同一个资源,以及锁失效以后业务能不能自己兜底。
Redisson 帮我们封装了可重入、自动续期和持有者校验,这些都是好东西。但它管不了咱们的业务边界,也不知道锁里面的那段代码执行完以后,事务有没有提交,更不会替业务保证幂等。
所以锁能加成功,不等于业务就一定互斥。
今天这篇文章就专门跟大家一起聊聊 Redisson 里最常见的 8 个坑,希望对你会有所帮助。
先看一张整体图,这 8 个坑分别会出现在加锁、执行业务和释放锁的哪个阶段:

图 1:Redisson 加锁之后,8 个问题分别落在资源与加锁、执行、释放与续期、组合与故障四个部分。
从图里也能看出来,大部分问题都不是“锁命令写错了”,而是锁和业务之间的边界没有设计好。
下面咱们一个一个聊。
1 传了 leaseTime,看门狗其实已经下班了
先问小伙伴们一个问题:看到下面这段代码,你觉得它的锁会一直自动续期吗?
RLock lock = redissonClient.getLock("order:lock:" + orderNo);
boolean locked = lock.tryLock(2, 30, TimeUnit.SECONDS);
有不少人会说会,因为用的是 Redisson。
但这里传了 30 秒的 leaseTime。锁到期就是到期,Redisson 不会再让看门狗给它续命。
我对着 Redisson 3.35 的源码看了一下,RedissonLock 只有在 leaseTime <= 0 时才会启动续期。像 tryLock(waitTime, leaseTime, unit) 这种传了正数租期的重载,走的是固定过期时间。
如果业务执行超过 30 秒,锁就会先失效。后面那个线程根本不用等你 unlock,它已经可以拿到同一把锁了。
整个过程大概是这样:
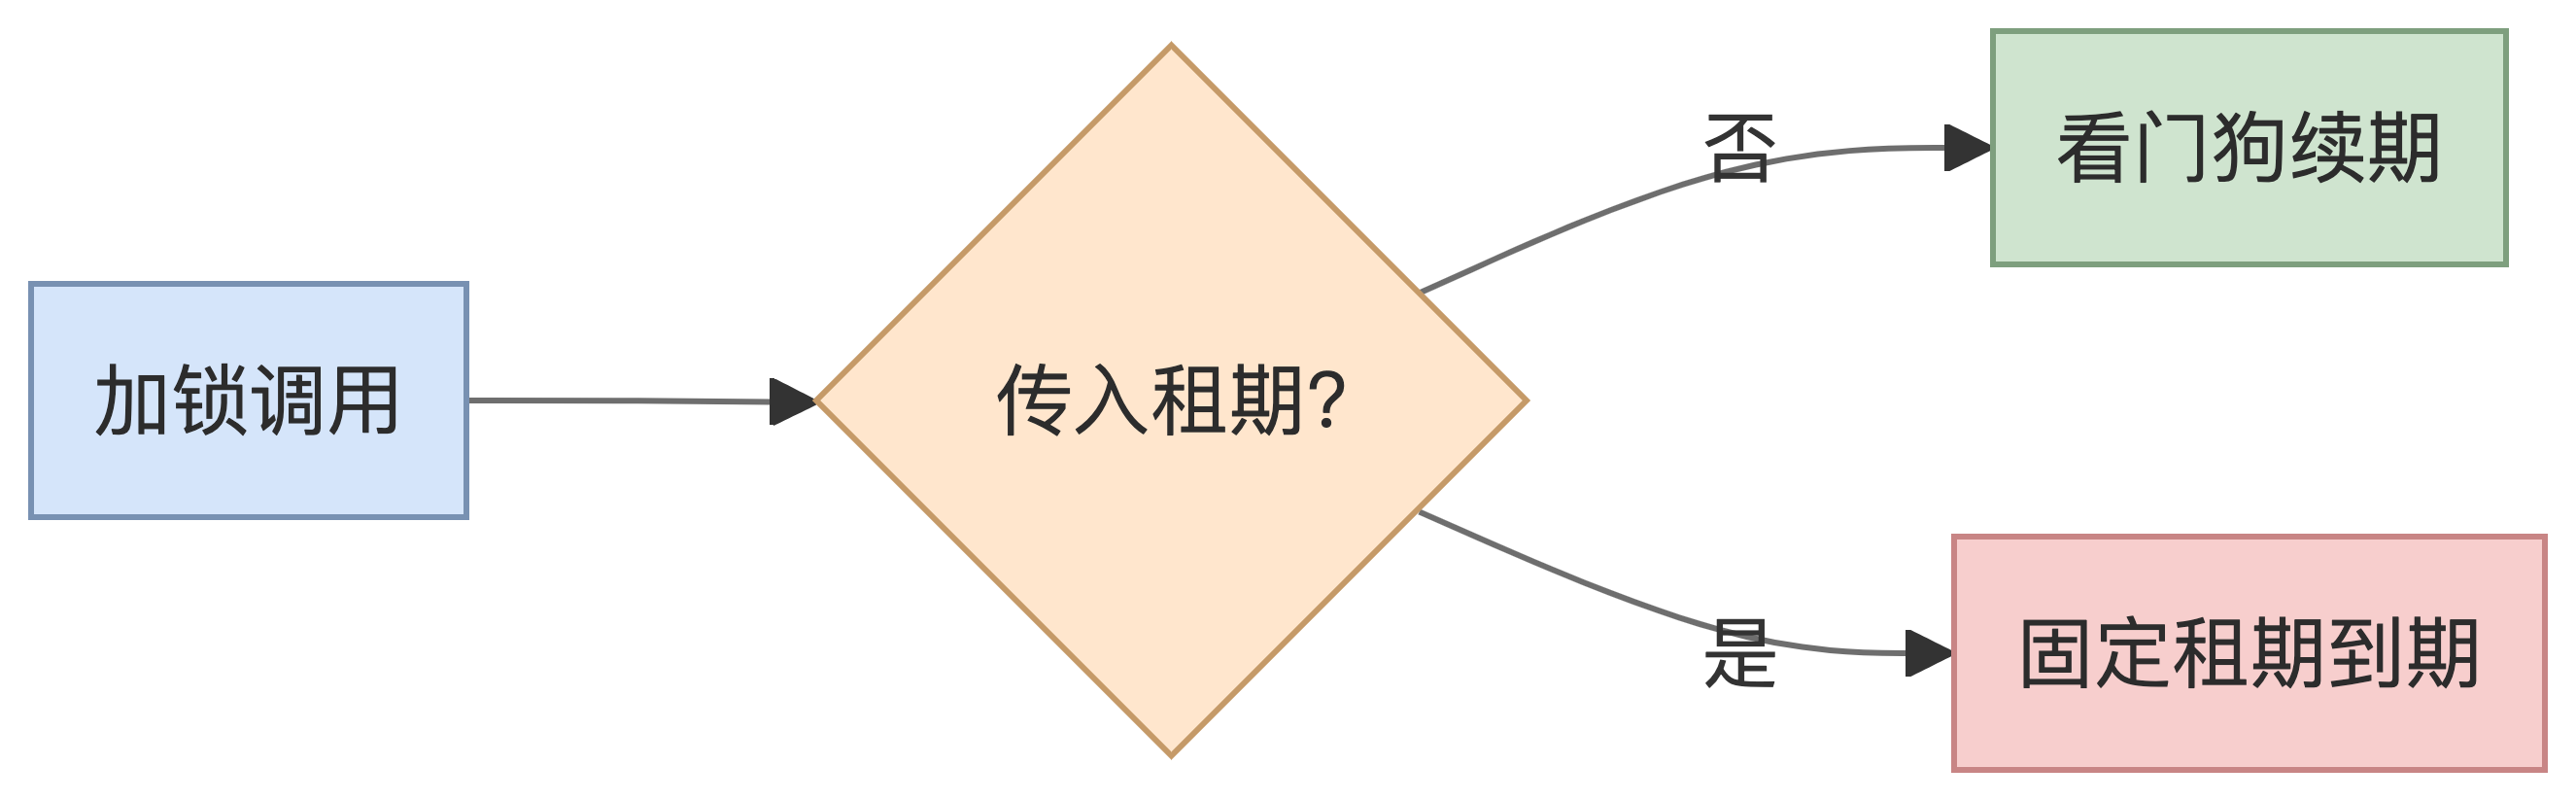
图 2:固定 leaseTime 和看门狗的路径不同,不要把两者混在一起。
常见重载的语义可以先记成下面这张表:
| 写法 | 最长等待时间 | 锁的初始租期 | 看门狗 |
|---|---|---|---|
lock() |
一直等待 | 默认 30 秒 | 开启 |
lock(30, SECONDS) |
一直等待 | 30 秒 | 关闭 |
tryLock(2, SECONDS) |
2 秒 | 默认 30 秒 | 开启 |
tryLock(2, 30, SECONDS) |
2 秒 | 30 秒 | 关闭 |
Redisson 3.35 里,tryLock(waitTime, unit) 实际上会转成 tryLock(waitTime, -1, unit),所以它不传固定租期,仍然可以续期。
那咱们应该怎么选?
如果你的临界区耗时不可预测,例如需要等待一次比较慢的数据库操作,通常用不带 leaseTime 的写法更合适,再配合业务超时和监控,防止死循环一直续期。
如果临界区有明确的上限,例如一段固定大小的数据同步,你可以传一个明显大于最长执行时间的租期。关键是这个上限得有依据,不能拍脑袋写个 30 秒。
最怕的是代码里随手传了 leaseTime,心里却默认“Redisson 会帮我续期”。这种错觉很危险。
2 事务提交前就把锁放了
这个问题在 Spring 项目里特别常见,我一般会先盯着 @Transactional 的方法看一遍。
假设咱们有一个支付完成的方法:
@Service
public class PaymentService {
    private final RLock lock;
    private final PaymentRepository repository;

    @Transactional
    public void complete(String orderNo) {
        boolean locked = false;
        try {
            locked = lock.tryLock(200, TimeUnit.MILLISECONDS);
            if (!locked) {
                throw new IllegalStateException("订单正在处理");
            }
            repository.markPaid(orderNo);
        } catch (InterruptedException exception) {
            Thread.currentThread().interrupt();
            throw new IllegalStateException("等待订单锁被中断", exception);
        } finally {
            if (locked && lock.isHeldByCurrentThread()) {
                lock.unlock();
            }
        }
    }
}
有些小伙伴看到 try/finally 就觉得稳了:异常也会释放锁,能有什么问题?
问题不在 finally,而在 Spring 事务的提交时机。
@Transactional 的提交发生在方法返回之后。finally 却在方法返回之前执行,于是实际顺序变成了:
加锁 -> 更新数据库 -> 解锁 -> 事务提交
解锁和提交之间出现了一个很短的窗口。另一个线程如果在这个窗口拿到锁,就可能读到数据库的旧状态,接着再改一次。
这个时候你去看代码,锁确实加了,finally 也确实执行了,但临界区已经被切开了。
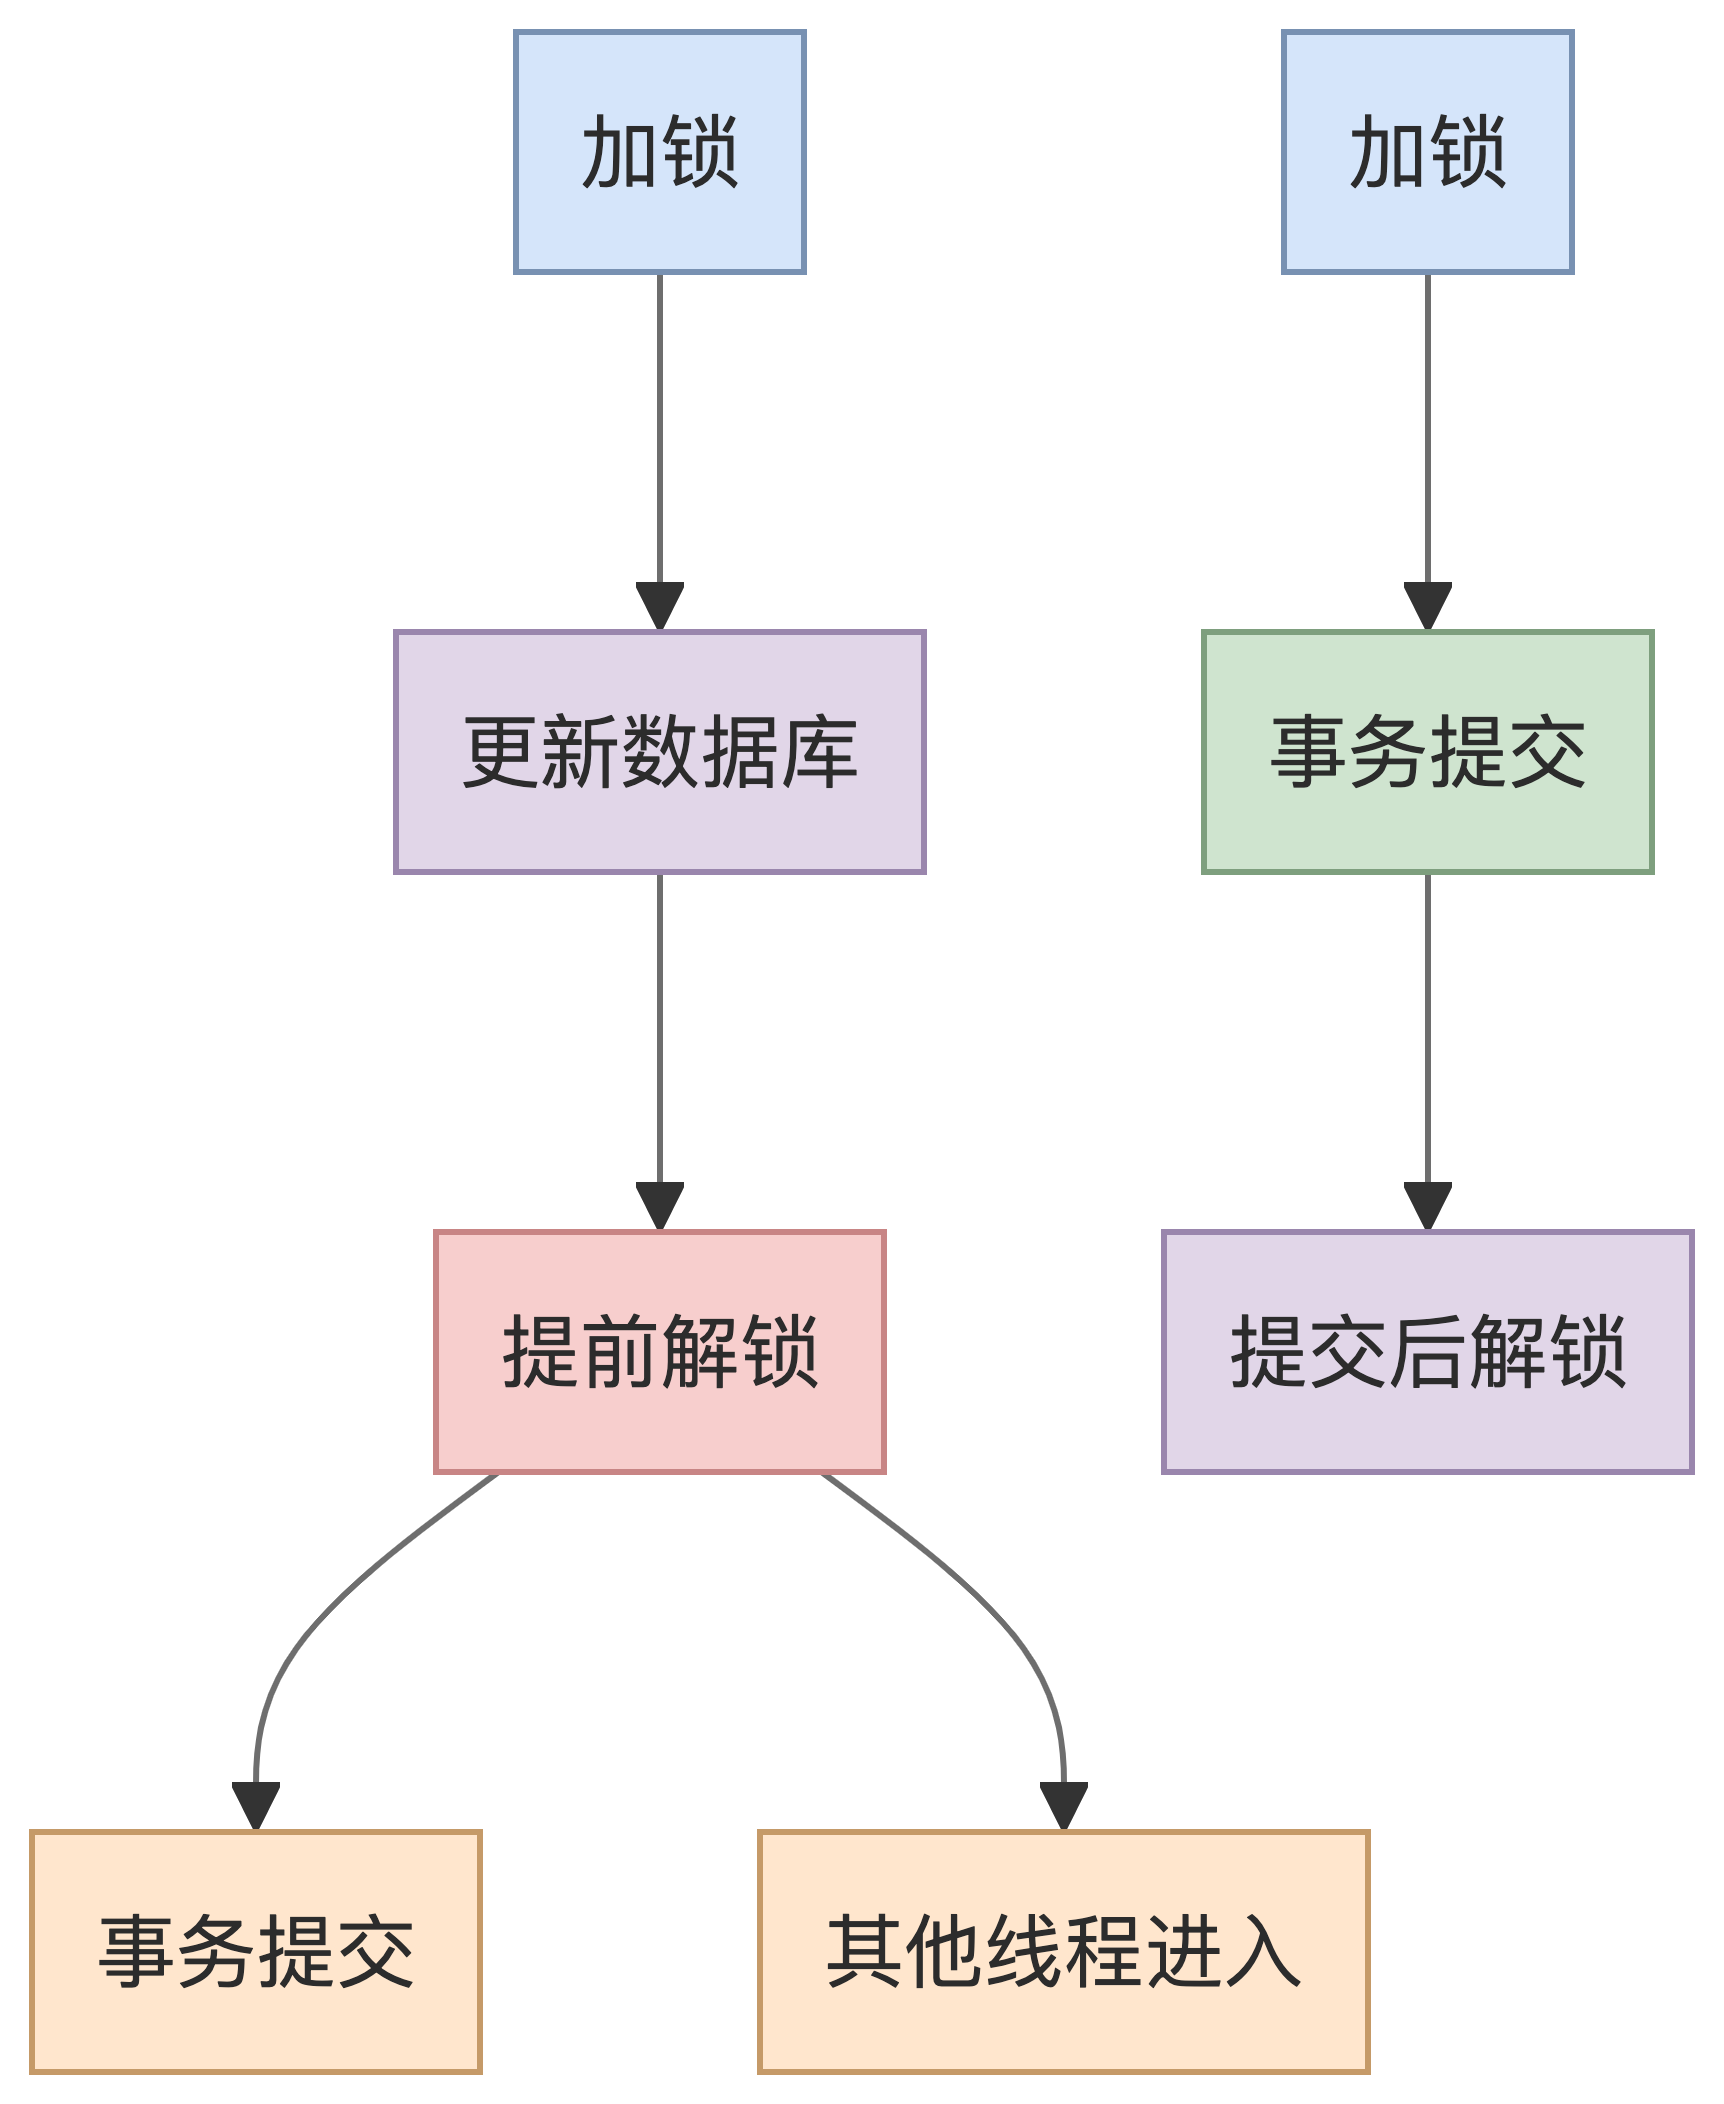
图 3:锁应该包住事务提交,不能只包住事务方法里面的一段代码。
看到这里,有些小伙伴会问:那我把事务方法单独抽出去,不就行了吗?
思路是对的,但还要注意 Spring AOP 的代理边界。同类内部方法直接调用,事务注解可能不会生效。
更稳妥的做法是让锁控制事务外层,用 TransactionTemplate 明确事务从哪里开始、在哪里提交:
下面为了聚焦锁和事务的顺序,示例省略了仓储实现、异常映射和事务配置。
@Service
public class PaymentService {
    private final RedissonClient redissonClient;
    private final TransactionTemplate transactionTemplate;

    public PaymentService(
            RedissonClient redissonClient,
            TransactionTemplate transactionTemplate
    ) {
        this.redissonClient = redissonClient;
        this.transactionTemplate = transactionTemplate;
    }

    public void complete(String tenantId, String orderNo) {
        RLock lock = redissonClient.getLock(
                "order:lock:" + tenantId + ":" + orderNo
        );
        boolean locked = false;
        try {
            locked = lock.tryLock(200, TimeUnit.MILLISECONDS);
            if (!locked) {
                throw new IllegalStateException("订单正在处理,请稍后重试");
            }

            // transactionTemplate 返回时,事务已经提交。
            transactionTemplate.executeWithoutResult(status ->
                    markPaid(orderNo)
            );
        } catch (InterruptedException exception) {
            Thread.currentThread().interrupt();
            throw new IllegalStateException("等待订单锁被中断", exception);
        } finally {
            if (locked && lock.isHeldByCurrentThread()) {
                lock.unlock();
            }
        }
    }
}
这样事务提交完,才轮到 finally 释放锁。
代价是锁的持有时间会变长。所以锁里面只放必须串行化的数据库操作,不要在锁里发短信、调远程接口或者做大批量导出。
3 一把大锁,把整个系统串成了单线程
有些小伙伴为了保险,喜欢直接来一把大锁:
RLock lock = redissonClient.getLock("stock:lock");
所有 SKU、所有仓库、所有租户都抢同一把锁。
从正确性看,超卖确实不容易发生了。但从性能看,系统也被咱们自己串成了单线程。
请求 A 只想扣 SKU-1,请求 B 只想扣 SKU-2,两个商品八竿子打不着,却要排在同一队列里。
锁的粒度至少得和真正需要互斥的资源对齐:
RLock lock = redissonClient.getLock(
        "stock:lock:" + tenantId + ":" + warehouseId + ":" + skuId
);
这样同一个仓库里的同一个 SKU 会互斥,不同 SKU 之间还能并行处理。
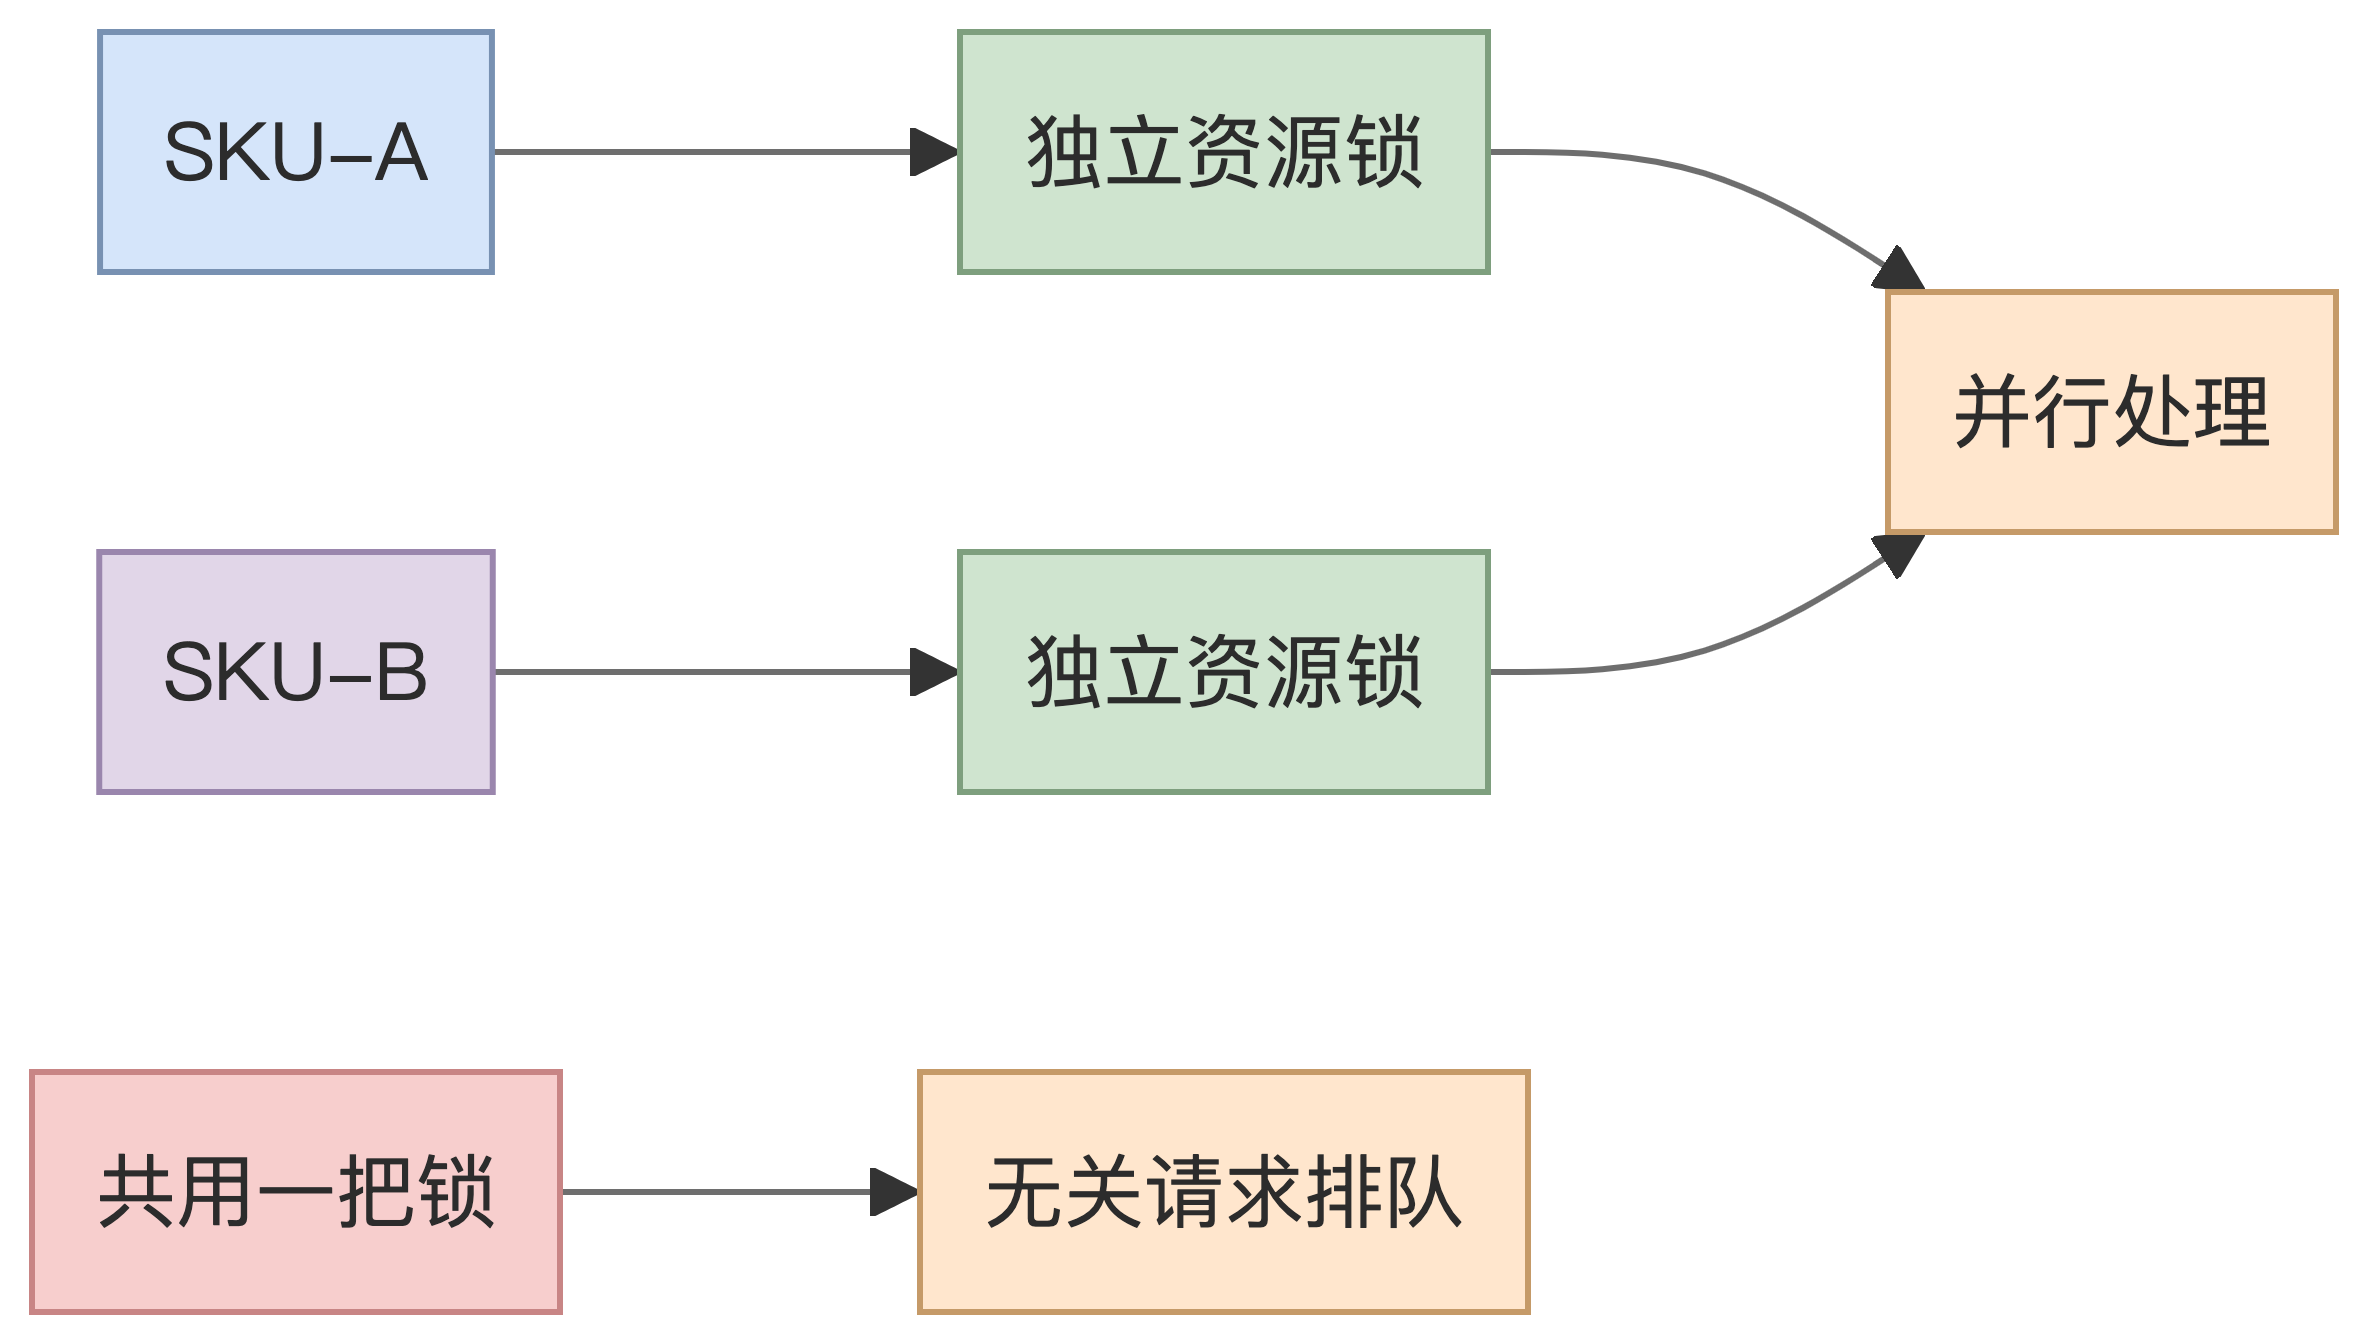
图 4:锁 key 要围绕资源设计,不能围绕一个模糊的“大业务”设计。
不过锁也不是越细越好。
如果每次请求都生成一个随机 key,那就等于没加锁。key 里如果放了请求 ID,也很容易制造出一堆只用一次、谁也拦不住的锁。
我判断 key 是否合理,通常就看一句话:两个请求到底因为什么资源发生冲突?
同一个租户、同一个仓库、同一个 SKU,这是明确的资源。它们对应的请求才应该互相等待。
4 在 A 线程加锁,让 B 线程去解锁
有些小伙伴喜欢在请求线程里加锁,然后把释放动作丢给线程池:
RLock lock = redissonClient.getLock(lockKey);
lock.lock();

executor.submit(() -> {
    lock.unlock();
});
这段代码看着像是在“异步优化”,实际上是不行的。
Redisson 的 RLock 不是一把普通的跨线程信号量。它的持有者标识里包含客户端实例和线程信息,同一个线程重复获取同一把锁,才会被当作重入。
换一个线程过来,它就不是原来的持有者了。
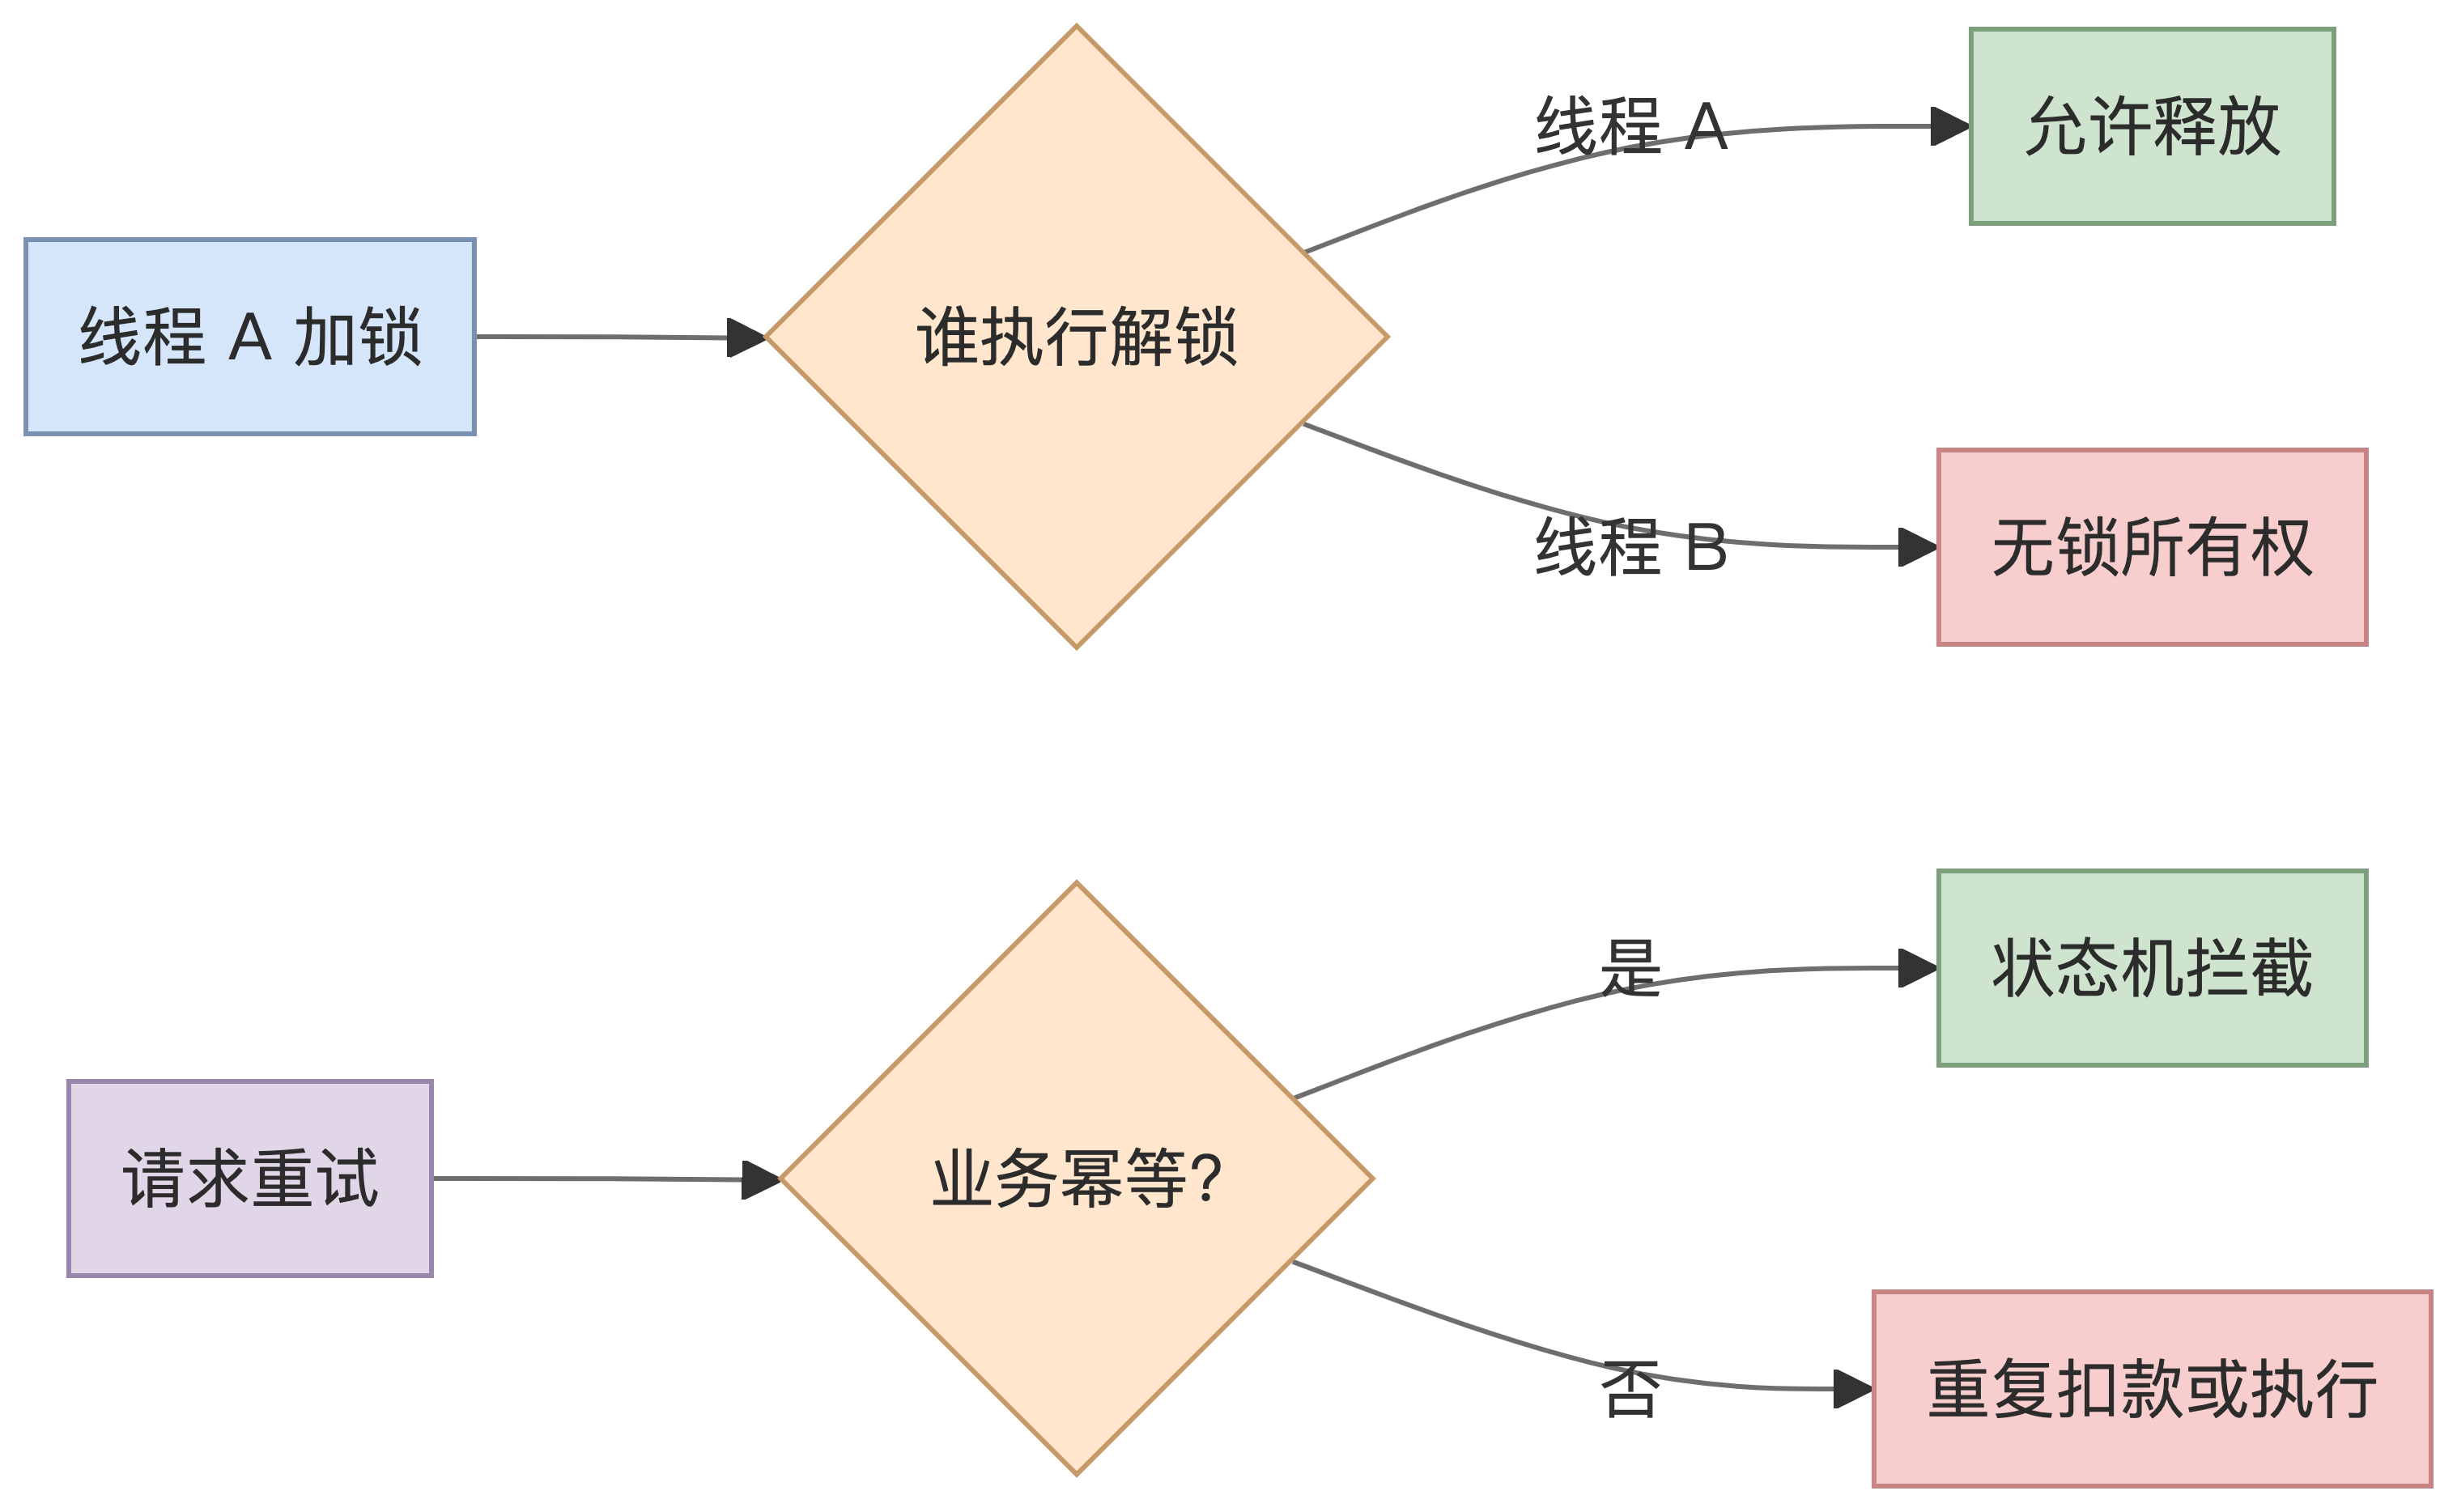
图 5:锁的所有权和幂等是两个问题,跨线程传递 RLock 对象不代表传递了锁的所有权。
还有一种更常见的错误,是 finally 里面无条件解锁:
RLock lock = redissonClient.getLock(lockKey);

try {
    lock.tryLock(200, TimeUnit.MILLISECONDS);
    doBusiness();
} finally {
    lock.unlock();
}
这里连 tryLock 的返回值都没判断。万一没拿到锁,finally 还是去解锁,轻则抛 IllegalMonitorStateException,重则把真正的业务异常盖掉。
老老实实把状态记下来:
boolean locked = false;
try {
    locked = lock.tryLock(200, TimeUnit.MILLISECONDS);
    if (!locked) {
        return;
    }
    doBusiness();
} catch (InterruptedException exception) {
    Thread.currentThread().interrupt();
    throw new IllegalStateException("等待锁被中断", exception);
} finally {
    if (locked && lock.isHeldByCurrentThread()) {
        lock.unlock();
    }
}
如果项目里用的是异步线程、响应式编程或者自定义线程池,锁的生命周期尽量限制在同一个同步调用栈里。
千万不要把“把对象传给另一个线程”理解成“把锁也交给另一个线程了”。
5 以为加了锁,就不会重复处理
这个问题也经常有小伙伴问:“我明明加了分布式锁,为什么支付回调还是处理了两次?”
因为锁解决的是同时执行,幂等解决的是重复执行。
这两件事差得很远。
假设支付回调第一次已经更新成功,但在返回结果给第三方时网络超时了。对方没有收到成功响应,于是过一会儿又发了一次。
这个时候,第一次请求早就释放了锁,第二次请求当然能重新拿到锁。
锁不会记得上一次已经处理过,也不应该替业务记这个事。
订单支付这种场景,不能只写一句“先加锁,再更新”。
UPDATE orders
SET status = 'PAID',
    paid_at = CURRENT_TIMESTAMP
WHERE order_no = ?
  AND status = 'PENDING';
只有影响行数为 1,才继续后面的发货、通知等操作。如果影响行数为 0,就按订单当前状态返回,别再扣一次钱。
更完整的重复请求处理,可以对照高并发下如何保证接口幂等性这篇文章。
有些小伙伴可能会说:数据库加锁不就行了?
数据库锁当然也能解决一部分问题,但它的粒度和吞吐量得结合业务看。对于支付、余额、库存这种不能错的场景,数据库唯一约束、状态 CAS、版本号和审计补偿,通常比“相信 Redis 锁永远有效”更可靠。
锁是并发控制工具,不是数据正确性的最后一道防线。
这句话咱们得多念两遍。
6 把看门狗当成了永不过期的保险
看门狗很好用,但它有一个前提:客户端还活着,续期任务还能正常执行,Redis 也还能收到命令。
有些小伙伴看到自动续期,就放心地把长任务塞进锁里。短时间看没事,遇到故障时就容易出问题。

图 6:看门狗只能处理“客户端正常但业务还没跑完”的续期,不能保证 JVM、网络和 Redis 永远正常。
如果进程长时间 Full GC,续期线程可能来不及执行。
如果客户端和 Redis 之间的网络断了,续期命令发不过去。
如果 Redis 主从切换,异步复制还没把锁数据同步过去,新的主节点上就可能看不到这把锁。
还有一种情况,业务代码进入了死循环。看门狗一直续期,其他请求就一直排队。这虽然不是锁丢失,但同样能把系统拖垮。
所以长任务最好拆成状态阶段,不要指望一把锁从头抱到尾:
检查状态 -> 写入处理中 -> 获取短锁 -> 提交事务 -> 释放锁 -> 异步继续处理
异步处理阶段再通过任务表、消息队列或者状态机推进。进程被杀以后,业务还能根据“处理中”状态继续恢复。
看门狗能解决续期,解决不了业务状态应该怎么设计。
7 拿着读锁,还想原地升级成写锁
读写锁很适合读多写少的场景。读读可以共享,读写互斥,写写也互斥。
但有些小伙伴会写出这样的代码:
RReadWriteLock rwLock = redissonClient.getReadWriteLock("config:lock");
RLock readLock = rwLock.readLock();
RLock writeLock = rwLock.writeLock();

readLock.lock();
try {
    Config config = loadConfig();
    if (needRefresh(config)) {
        writeLock.lock(); // 危险:当前线程还持有读锁
    }
} finally {
    readLock.unlock();
}
这段代码的风险在于,当前线程还持有读锁,却又要申请写锁。
Redisson 的读锁和写锁共用同一个读写锁名称,但它们的获取条件不一样。读锁没有释放时,写锁会在 Redis 里看到当前还有读模式,然后继续等待。
申请写锁的线程,恰好就是持有读锁的线程。如果它一直等下去,读锁又永远没有机会释放。
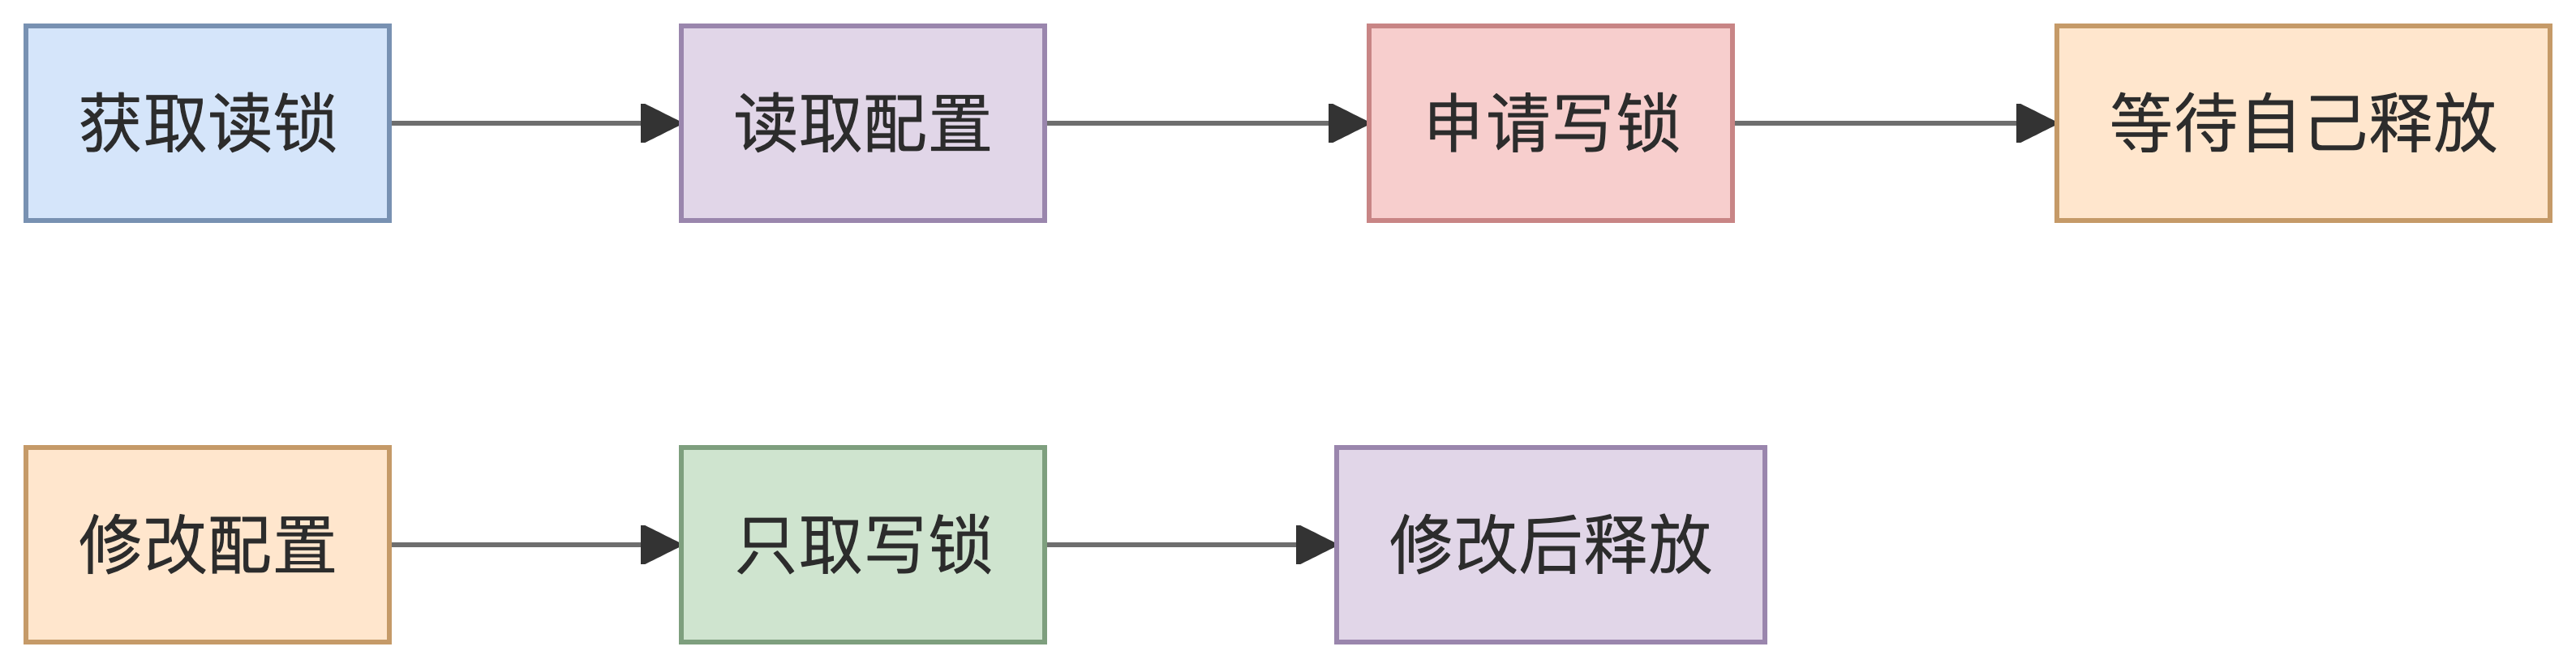
图 7:需要修改数据时,一开始就走写锁路径,不要在读锁里面临时升级。
正确的姿势是把读和写的入口拆开。
需要刷新配置时,直接申请写锁,在写锁里面重新读取并修改:
public void refreshConfig() {
    RLock writeLock = rwLock.writeLock();
    writeLock.lock();
    try {
        Config current = loadConfig();
        if (needRefresh(current)) {
            updateConfig(current);
        }
    } finally {
        writeLock.unlock();
    }
}
这样逻辑会直白很多,也不会出现“自己等自己释放锁”的尴尬。
另外,读锁不等于免费。拿着读锁做一次慢远程调用,所有写线程照样会被挡住。锁里面只放必须保护的共享状态,别把整个业务流程都塞进去。
8 把 RedLock 和 MultiLock 当成一个东西
有些小伙伴看到 Redisson 提供了 RedissonMultiLock 和 RedissonRedLock,会觉得后者是前者的升级版,节点越多越安全。
这里得掰开说。
RedissonMultiLock 是把多个独立 RLock 当成一把组合锁来操作。Redisson 3.35 里,它的 failedLocksLimit() 默认返回 0,也就是所有子锁都成功,这次组合加锁才算成功。
RedissonRedLock 继承自 RedissonMultiLock,但它改了失败容忍数,采用的是多数派判断。比如 5 个节点里成功 3 个,就可以认为加锁成功。
不过 RedissonRedLock 在 Redisson 3.35 里已经标记为 @Deprecated。这说明这个方案存在适用边界和复杂度问题,不建议咱们看到旧博客就直接搬到生产环境。
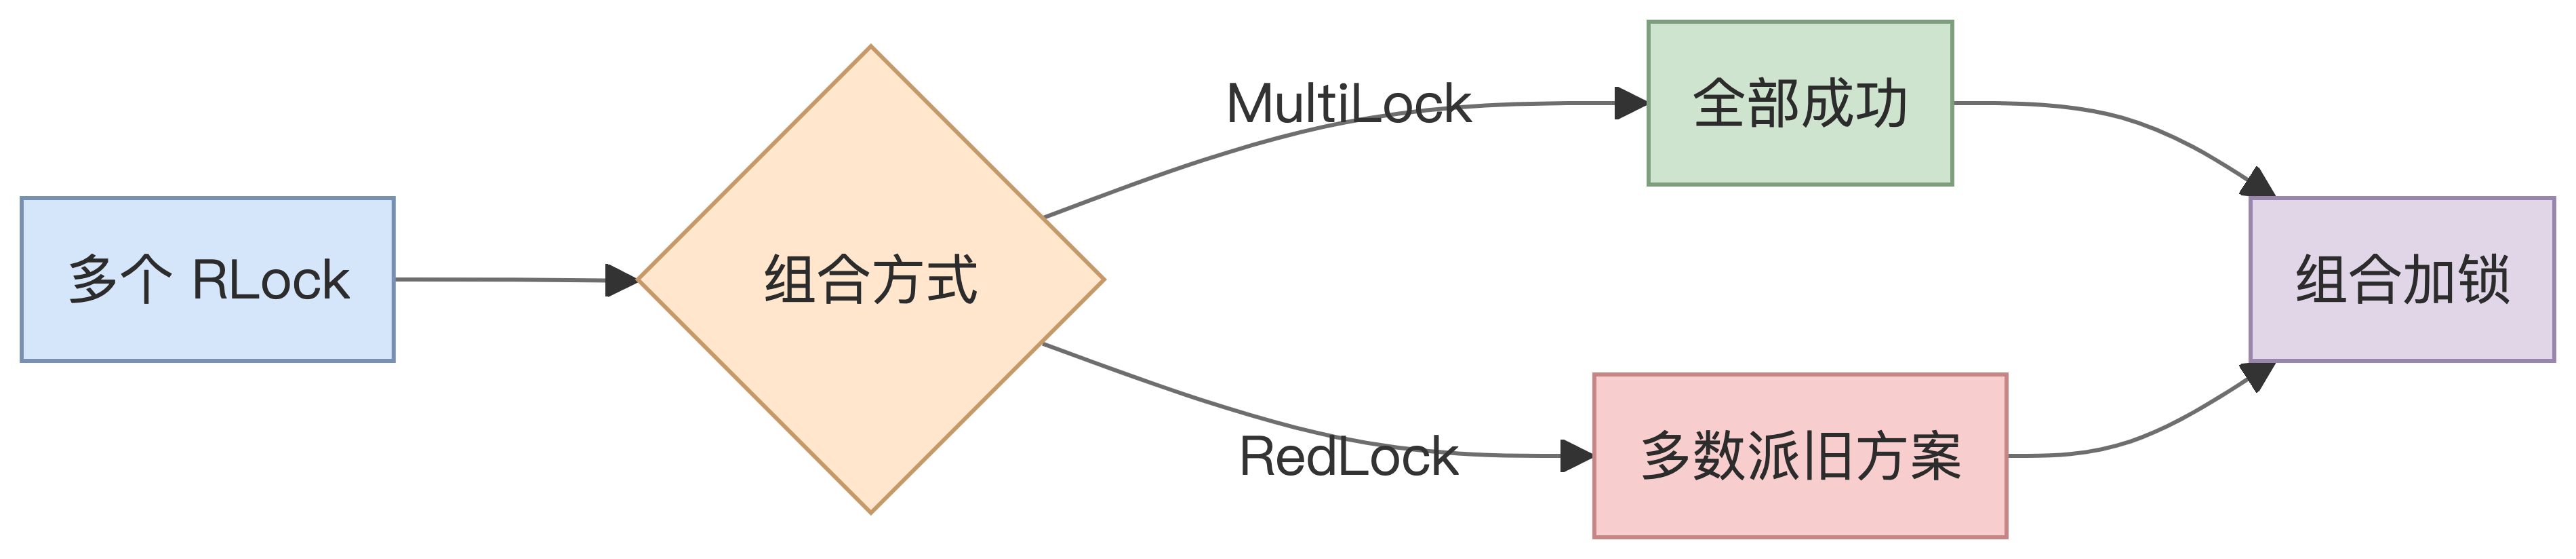
图 8:RedissonMultiLock 默认要求全部成功,RedissonRedLock 才是多数派判断,不能混为一谈。
有些小伙伴紧接着会问:那用了 RedLock,是不是就能保证跨集群强一致了?
也不能这么理解。
多个 Redis 节点可以降低单节点故障带来的影响,但网络分区、客户端停顿和锁过期以后继续执行的问题,仍然存在。
对于商品库存、支付、余额这种强一致场景,我更建议把数据库约束、状态 CAS、版本号或者 fencing token 放在资源侧。哪怕锁曾经成功过,也要让真正写数据的地方拒绝过期持有者。
Redis 锁更适合任务防重、短时间互斥、缓存刷新这类可以容忍少量重复的场景。
选什么锁,得先问业务能不能接受一次锁失效。
把一次请求从头走到尾
聊完 8 个坑,咱们再用一条完整的请求链路把它们串起来。
上线之前,我一般会拿一笔真实请求,顺着时间线走几遍。先看正常路径,再看异常路径,最后看 Redis 和网络出故障时业务还能不能自保。
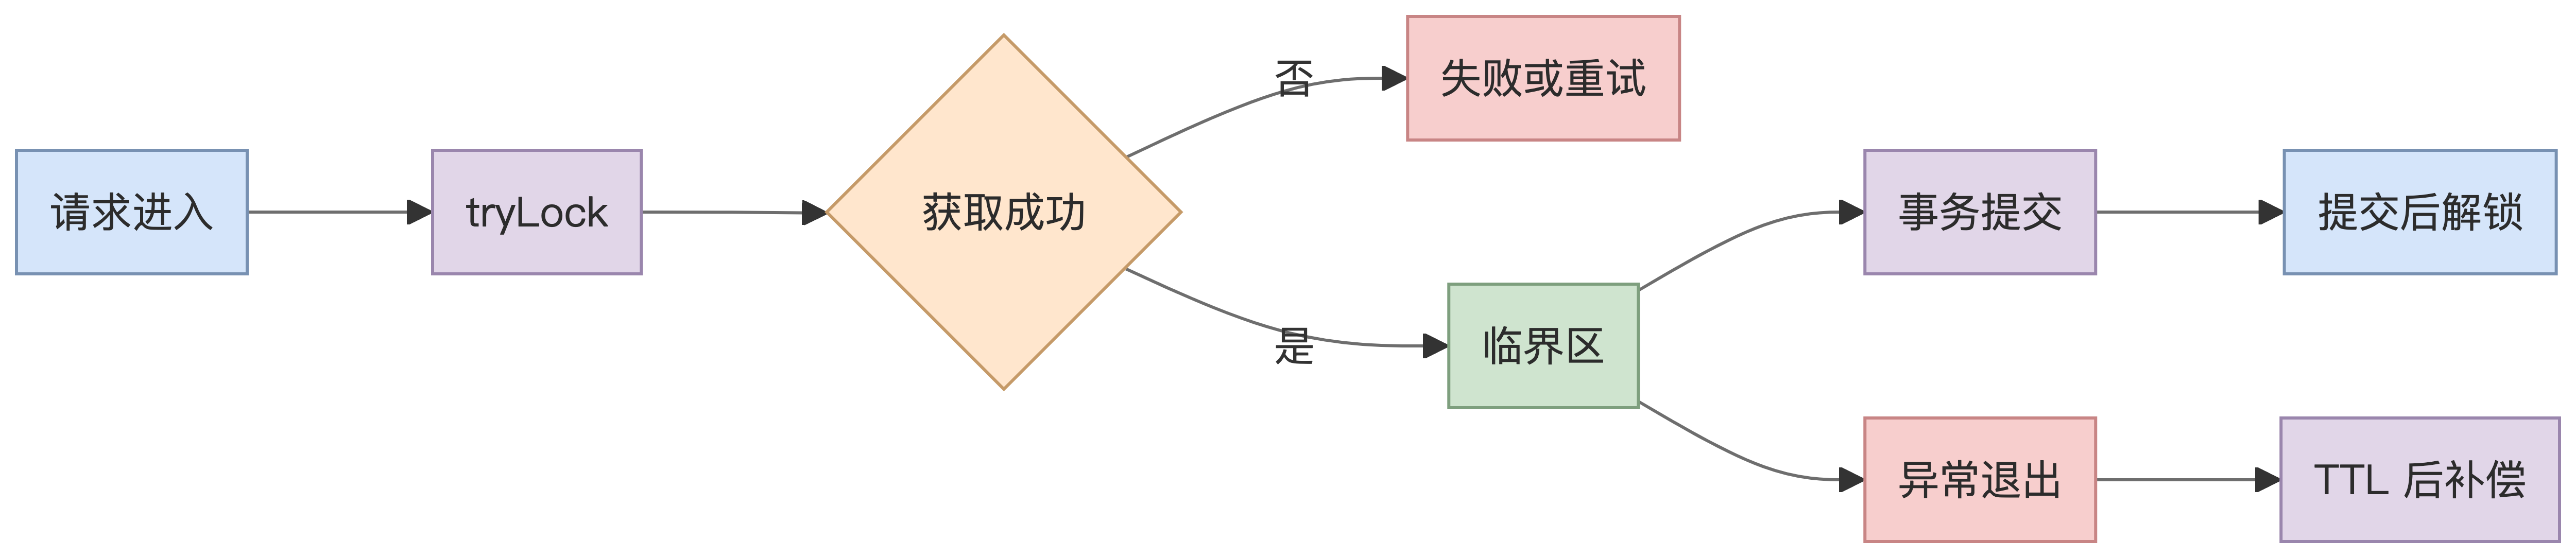
图 9:一次 Redisson 加锁请求的正常路径、失败路径和超时恢复路径。
第一遍看正常流程。
请求进来以后,锁 key 是不是落到了真正冲突的资源上?等待时间有没有上限?拿到锁以后,数据库更新和事务提交是不是都在锁里面?提交完成以后,是不是由同一个线程检查持有者再释放?
这一遍看的是代码顺序。
第二遍看失败流程。
tryLock 返回 false 的时候,业务是快速失败、有限重试,还是返回缓存里的旧值?有没有可能没拿到锁,却继续执行后面的更新?线程被中断时,中断标记有没有恢复?
这一遍看的是失败分支有没有写完整。
第三遍看故障流程。
如果进程被杀、Full GC、Redis 主从切换,锁丢了以后业务能不能靠唯一键、状态机、任务表或者补偿任务继续保证正确?等待时间、持锁时间、续期失败和 tryLock 失败次数,有没有可观测的数据?
这一遍看的是锁失效以后,系统还能不能自己站起来。
把这三遍走完,很多看似偶发的问题,其实在上线前就能暴露出来。
总结
Redisson 是个好工具,可重入、自动续期和持有者校验,确实帮咱们省了不少事。
但它解决的是“怎么安全地操作一把 Redis 锁”,解决不了“业务应该在哪加锁、锁什么时候能释放、锁失效以后怎么办”。
我的建议很朴素:
用不用 leaseTime,先看业务最长执行时间和能否预测;事务必须在锁内提交,不能让 finally 跑在提交前面;锁 key 要围绕租户、业务类型和资源 ID 设计,但不要细到一个请求一把锁;跨线程不要传递锁的所有权;锁外面还要有数据库唯一约束、状态 CAS 和幂等机制兜底。
看门狗、读写锁、MultiLock 和 RedLock 也都有自己的边界。别把它们当成“更高级所以更安全”的开关。
把锁当成并发控制,把数据库状态当成事实来源,把幂等和监控当成收尾。这三样一起用,Redisson 才算真正落到业务里。
希望这篇文章能让你少踩一点坑,也欢迎小伙伴们在评论区聊聊:你们项目里的 Redisson 锁,最长会在锁里面停留多久?

 浙公网安备 33010602011771号