
网络编程就是编写程序使两台联网的计算机相互交换数据。这就是全部内容了吗?是的!网络编程要比想象中的简单许多。
那么,这两台计算机之间用什么传输数据呢?首先需要物理连接。如今大部分计算机都已经连接到互联网,因此不用担心这一点。
在此基础上,只需要考虑如何编写数据传输程序。但实际上这点也不用愁,因为操作系统已经提供了 socket。即使对网络数据传输的原理不太熟悉,我们也能通过 socket 来编程。
什么是 socket?
socket 的原意是“插座”,在计算机通信领域,socket 被翻译为“套接字”,它是计算机之间进行通信的一种约定或一种方式。通过 socket 这种约定,一台计算机可以接收其他计算机的数据,也可以向其他计算机发送数据。
我们把插头插到插座上就能从电网获得电力供应,同样,为了与远程计算机进行数据传输,需要连接到因特网,而 socket 就是用来连接到因特网的工具。
socket 的典型应用就是 Web 服务器和浏览器:浏览器获取用户输入的 URL,向服务器发起请求,服务器分析接收到的 URL,将对应的网页内容返回给浏览器,浏览器再经过解析和渲染,就将文字、图片、视频等元素呈现给用户。
学习 socket,也就是学习计算机之间如何通信,并编写出实用的程序。
UNIX/Linux 中的 socket 是什么?
在 UNIX/Linux 系统中,为了统一对各种硬件的操作,简化接口,不同的硬件设备也都被看成一个文件。对这些文件的操作,等同于对磁盘上普通文件的操作。
你也许听很多高手说过,UNIX/Linux 中的一切都是文件!那个家伙说的没错。
为了表示和区分已经打开的文件,UNIX/Linux 会给每个文件分配一个 ID,这个 ID 就是一个整数,被称为文件描述符(File Descriptor)。例如:
- 通常用 0 来表示标准输入文件(stdin),它对应的硬件设备就是键盘;
- 通常用 1 来表示标准输出文件(stdout),它对应的硬件设备就是显示器。
UNIX/Linux 程序在执行任何形式的 I/O 操作时,都是在读取或者写入一个文件描述符。一个文件描述符只是一个和打开的文件相关联的整数,它的背后可能是一个硬盘上的普通文件、FIFO、管道、终端、键盘、显示器,甚至是一个网络连接。
请注意,网络连接也是一个文件,它也有文件描述符!你必须理解这句话。
我们可以通过 socket() 函数来创建一个网络连接,或者说打开一个网络文件,socket() 的返回值就是文件描述符。有了文件描述符,我们就可以使用普通的文件操作函数来传输数据了,例如:
- 用 read() 读取从远程计算机传来的数据;
- 用 write() 向远程计算机写入数据。
你看,只要用 socket() 创建了连接,剩下的就是文件操作了,网络编程原来就是如此简单!
Window 系统中的 socket 是什么?
Windows 也有类似“文件描述符”的概念,但通常被称为“文件句柄”。因此,本教程如果涉及 Windows 平台将使用“句柄”,如果涉及 Linux 平台则使用“描述符”。
与 UNIX/Linux 不同的是,Windows 会区分 socket 和文件,Windows 就把 socket 当做一个网络连接来对待,因此需要调用专门针对 socket 而设计的数据传输函数,针对普通文件的输入输出函数就无效了。
套接字有哪些类型?socket有哪些类型?
这个世界上有很多种套接字(socket),比如 DARPA Internet 地址(Internet 套接字)、本地节点的路径名(Unix套接字)、CCITT X.25地址(X.25 套接字)等。但本教程只讲第一种套接字——Internet 套接字,它是最具代表性的,也是最经典最常用的。以后我们提及套接字,指的都是 Internet 套接字。
根据数据的传输方式,可以将 Internet 套接字分成两种类型。通过 socket() 函数创建连接时,必须告诉它使用哪种数据传输方式。
Internet 套接字其实还有很多其它数据传输方式,但是我可不想吓到你,本教程只讲常用的两种。
流格式套接字(SOCK_STREAM)
流格式套接字(Stream Sockets)也叫“面向连接的套接字”,在代码中使用 SOCK_STREAM 表示。
SOCK_STREAM 是一种可靠的、双向的通信数据流,数据可以准确无误地到达另一台计算机,如果损坏或丢失,可以重新发送。
流格式套接字有自己的纠错机制,在此我们就不讨论了。
SOCK_STREAM 有以下几个特征:
- 数据在传输过程中不会消失;
- 数据是按照顺序传输的;
- 数据的发送和接收不是同步的(有的教程也称“不存在数据边界”)。
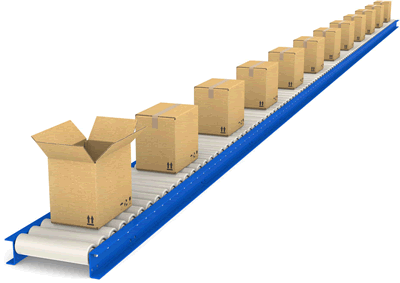
可以将 SOCK_STREAM 比喻成一条传送带,只要传送带本身没有问题(不会断网),就能保证数据不丢失;同时,较晚传送的数据不会先到达,较早传送的数据不会晚到达,这就保证了数据是按照顺序传递的。
为什么流格式套接字可以达到高质量的数据传输呢?这是因为它使用了 TCP 协议(The Transmission Control Protocol,传输控制协议),TCP 协议会控制你的数据按照顺序到达并且没有错误。
你也许见过 TCP,是因为你经常听说“TCP/IP”。TCP 用来确保数据的正确性,IP(Internet Protocol,网络协议)用来控制数据如何从源头到达目的地,也就是常说的“路由”。
那么,“数据的发送和接收不同步”该如何理解呢?
假设传送带传送的是水果,接收者需要凑齐 100 个后才能装袋,但是传送带可能把这 100 个水果分批传送,比如第一批传送 20 个,第二批传送
50 个,第三批传送 30
个。接收者不需要和传送带保持同步,只要根据自己的节奏来装袋即可,不用管传送带传送了几批,也不用每到一批就装袋一次,可以等到凑够了 100
个水果再装袋。
流格式套接字的内部有一个缓冲区(也就是字符数组),通过 socket 传输的数据将保存到这个缓冲区。接收端在收到数据后并不一定立即读取,只要数据不超过缓冲区的容量,接收端有可能在缓冲区被填满以后一次性地读取,也可能分成好几次读取。
也就是说,不管数据分几次传送过来,接收端只需要根据自己的要求读取,不用非得在数据到达时立即读取。传送端有自己的节奏,接收端也有自己的节奏,它们是不一致的。
流格式套接字有什么实际的应用场景吗?浏览器所使用的 http 协议就基于面向连接的套接字,因为必须要确保数据准确无误,否则加载的 HTML 将无法解析。
数据报格式套接字(SOCK_DGRAM)
数据报格式套接字(Datagram Sockets)也叫“无连接的套接字”,在代码中使用 SOCK_DGRAM 表示。
计算机只管传输数据,不作数据校验,如果数据在传输中损坏,或者没有到达另一台计算机,是没有办法补救的。也就是说,数据错了就错了,无法重传。
因为数据报套接字所做的校验工作少,所以在传输效率方面比流格式套接字要高。
可以将 SOCK_DGRAM 比喻成高速移动的摩托车快递,它有以下特征:
- 强调快速传输而非传输顺序;
- 传输的数据可能丢失也可能损毁;
- 限制每次传输的数据大小;
- 数据的发送和接收是同步的(有的教程也称“存在数据边界”)。
众所周知,速度是快递行业的生命。用摩托车发往同一地点的两件包裹无需保证顺序,只要以最快的速度交给客户就行。这种方式存在损坏或丢失的风险,而且包裹大小有一定限制。因此,想要传递大量包裹,就得分配发送。
另外,用两辆摩托车分别发送两件包裹,那么接收者也需要分两次接收,所以“数据的发送和接收是同步的”;换句话说,接收次数应该和发送次数相同。
总之,数据报套接字是一种不可靠的、不按顺序传递的、以追求速度为目的的套接字。
数据报套接字也使用 IP 协议作路由,但是它不使用 TCP 协议,而是使用 UDP 协议(User Datagram Protocol,用户数据报协议)。
QQ 视频聊天和语音聊天就使用 SOCK_DGRAM 来传输数据,因为首先要保证通信的效率,尽量减小延迟,而数据的正确性是次要的,即使丢失很小的一部分数据,视频和音频也可以正常解析,最多出现噪点或杂音,不会对通信质量有实质的影响。
注意:SOCK_DGRAM 没有想象中的糟糕,不会频繁的丢失数据,数据错误只是小概率事件。
面向连接和无连接的套接字到底有什么区别
OSI网络七层模型简明教程
如果你读过计算机专业,或者学习过网络通信,那你一定听说过 OSI 模型,它曾无数次让你头大。OSI 是 Open System Interconnection 的缩写,译为“开放式系统互联”。
OSI 模型把网络通信的工作分为 7 层,从下到上分别是物理层、数据链路层、网络层、传输层、会话层、表示层和应用层。
OSI 只是存在于概念和理论上的一种模型,它的缺点是分层太多,增加了网络工作的复杂性,所以没有大规模应用。后来人们对 OSI
进行了简化,合并了一些层,最终只保留了 4 层,从下到上分别是接口层、网络层、传输层和应用层,这就是大名鼎鼎的 TCP/IP 模型。

图1:OSI 七层网络模型和 TCP/IP 四层网络模型的对比
这个网络模型究竟是干什么呢?简而言之就是进行数据封装的。
我们平常使用的程序(或者说软件)一般都是通过应用层来访问网络的,程序产生的数据会一层一层地往下传输,直到最后的网络接口层,就通过网线发送到互联网上去了。数据每往下走一层,就会被这一层的协议增加一层包装,等到发送到互联网上时,已经比原始数据多了四层包装。整个数据封装的过程就像俄罗斯套娃。
当另一台计算机接收到数据包时,会从网络接口层再一层一层往上传输,每传输一层就拆开一层包装,直到最后的应用层,就得到了最原始的数据,这才是程序要使用的数据。
给数据加包装的过程,实际上就是在数据的头部增加一个标志(一个数据块),表示数据经过了这一层,我已经处理过了。给数据拆包装的过程正好相反,就是去掉数据头部的标志,让它逐渐现出原形。
你看,在互联网上传输一份数据是多么地复杂啊,而我们却感受不到,这就是网络模型的厉害之处。我们只需要在代码中调用一个函数,就能让下面的所有网络层为我们工作。
我们所说的 socket 编程,是站在传输层的基础上,所以可以使用 TCP/UDP 协议,但是不能干「访问网页」这样的事情,因为访问网页所需要的 http 协议位于应用层。
两台计算机进行通信时,必须遵守以下原则:
- 必须是同一层次进行通信,比如,A 计算机的应用层和 B 计算机的传输层就不能通信,因为它们不在一个层次,数据的拆包会遇到问题。
- 每一层的功能都必须相同,也就是拥有完全相同的网络模型。如果网络模型都不同,那不就乱套了,谁都不认识谁。
- 数据只能逐层传输,不能跃层。
- 每一层可以使用下层提供的服务,并向上层提供服务。
TCP/IP协议族
上节《OSI网络七层模型简明教程》中讲到,目前实际使用的网络模型是 TCP/IP 模型,它对 OSI 模型进行了简化,只包含了四层,从上到下分别是应用层、传输层、网络层和链路层(网络接口层),每一层都包含了若干协议。
协议(Protocol)就是网络通信过程中的约定或者合同,通信的双方必须都遵守才能正常收发数据。协议有很多种,例如 TCP、UDP、IP
等,通信的双方必须使用同一协议才能通信。协议是一种规范,由计算机组织制定,规定了很多细节,例如,如何建立连接,如何相互识别等。
协议仅仅是一种规范,必须由计算机软件来实现。例如 IP 协议规定了如何找到目标计算机,那么各个开发商在开发自己的软件时就必须遵守该协议,不能另起炉灶。
TCP/IP 模型包含了 TCP、IP、UDP、Telnet、FTP、SMTP 等上百个互为关联的协议,其中 TCP 和 IP 是最常用的两种底层协议,所以把它们统称为“TCP/IP 协议族”。
也就是说,“TCP/IP模型”中所涉及到的协议称为“TCP/IP协议族”,你可以区分这两个概念,也可以认为它们是等价的,随便你怎么想。
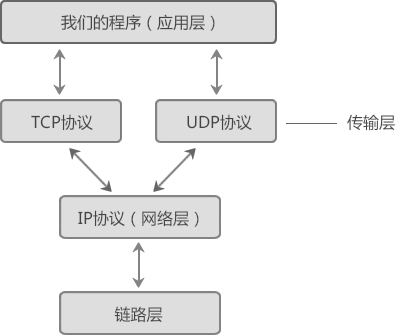
本教程所讲的 socket 编程是基于 TCP 和 UDP 协议的,它们的层级关系如下图所示:
【扩展阅读】开放式系统(Open System)
把协议分成多个层次有哪些优点?协议设计更容易?当然这也足以成为优点之一。但是还有更重要的原因,就是为了通过标准化操作设计成开放式系统。
标准本身就是对外公开的,会引导更多的人遵守规范。以多个标准为依据设计的系统称为开放式系统(Open System),我们现在学习的 TCP/IP 协议族也属于其中之一。
接下来了解一下开放式系统具有哪些优点。
路由器用来完成 IP 层的交互任务。某个网络原来使用 A 公司的路由器,现要将其替换成 B 公司的,是否可行?这并非难事,并不一定要换成同一公司的同一型号路由器,因为所有生产商都会按照 IP 层标准制造。
再举个例子。大家的计算机是否装有网络接口卡,也就是所谓的网卡?尚未安装也无妨,其实很容易买到,因为所有网卡制造商都会遵守链路层的协议标准。这就是开放式系统的优点。
标准的存在意味着高速的技术发展,这也是开放式系统设计最大的原因所在。实际上,软件工程中的“面向对象(Object Oriented)”的诞生背景中也有标准化的影子。也就是说,标准对于技术发展起着举足轻重的作用。
IP、MAC和端口号——网络通信中确认身份信息的三要素
在茫茫的互联网海洋中,要找到一台计算机非常不容易,有三个要素必须具备,它们分别是 IP 地址、MAC 地址和端口号。
IP地址
IP地址是 Internet Protocol Address 的缩写,译为“网际协议地址”。
目前大部分软件使用 IPv4 地址,但 IPv6 也正在被人们接受,尤其是在教育网中,已经大量使用。
一台计算机可以拥有一个独立的 IP 地址,一个局域网也可以拥有一个独立的 IP 地址(对外就好像只有一台计算机)。对于目前广泛使用 IPv4 地址,它的资源是非常有限的,一台计算机一个 IP 地址是不现实的,往往是一个局域网才拥有一个 IP 地址。
在因特网上进行通信时,必须要知道对方的 IP 地址。实际上数据包中已经附带了 IP 地址,把数据包发送给路由器以后,路由器会根据 IP 地址找到对方的地里位置,完成一次数据的传递。路由器有非常高效和智能的算法,很快就会找到目标计算机。
MAC地址
现实的情况是,一个局域网往往才能拥有一个独立的 IP;换句话说,IP 地址只能定位到一个局域网,无法定位到具体的一台计算机。这可怎么办呀?这样也没法通信啊。
其实,真正能唯一标识一台计算机的是 MAC 地址,每个网卡的 MAC 地址在全世界都是独一无二的。计算机出厂时,MAC 地址已经被写死到网卡里面了(当然通过某些“奇巧淫技”也是可以修改的)。局域网中的路由器/交换机会记录每台计算机的 MAC 地址。
MAC 地址是 Media Access Control Address 的缩写,直译为“媒体访问控制地址”,也称为局域网地址(LAN Address),以太网地址(Ethernet Address)或物理地址(Physical Address)。
数据包中除了会附带对方的 IP 地址,还会附带对方的 MAC 地址,当数据包达到局域网以后,路由器/交换机会根据数据包中的 MAC 地址找到对应的计算机,然后把数据包转交给它,这样就完成了数据的传递。
端口号
有了 IP 地址和 MAC 地址,虽然可以找到目标计算机,但仍然不能进行通信。一台计算机可以同时提供多种网络服务,例如 Web
服务(网站)、FTP 服务(文件传输服务)、SMTP 服务(邮箱服务)等,仅有 IP 地址和 MAC
地址,计算机虽然可以正确接收到数据包,但是却不知道要将数据包交给哪个网络程序来处理,所以通信失败。
为了区分不同的网络程序,计算机会为每个网络程序分配一个独一无二的端口号(Port Number),例如,Web 服务的端口号是 80,FTP 服务的端口号是 21,SMTP 服务的端口号是 25。
端口(Port)是一个虚拟的、逻辑上的概念。可以将端口理解为一道门,数据通过这道门流入流出,每道门有不同的编号,就是端口号。如下图所示:

socket缓冲区以及阻塞模式详解
在《socket数据的接收和发送》一节中讲到,可以使用 write()/send() 函数发送数据,使用 read()/recv() 函数接收数据,本节就来看看数据是如何传递的。
socket缓冲区
每个 socket 被创建后,都会分配两个缓冲区,输入缓冲区和输出缓冲区。
write()/send() 并不立即向网络中传输数据,而是先将数据写入缓冲区中,再由TCP协议将数据从缓冲区发送到目标机器。一旦将数据写入到缓冲区,函数就可以成功返回,不管它们有没有到达目标机器,也不管它们何时被发送到网络,这些都是TCP协议负责的事情。
TCP协议独立于 write()/send() 函数,数据有可能刚被写入缓冲区就发送到网络,也可能在缓冲区中不断积压,多次写入的数据被一次性发送到网络,这取决于当时的网络情况、当前线程是否空闲等诸多因素,不由程序员控制。
read()/recv() 函数也是如此,也从输入缓冲区中读取数据,而不是直接从网络中读取。
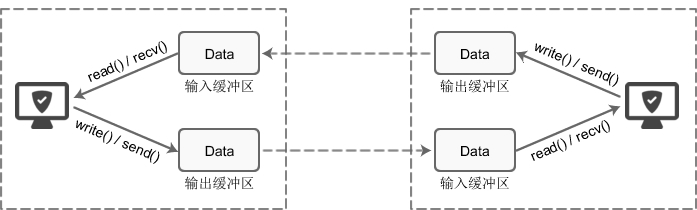
图:TCP套接字的I/O缓冲区示意图
这些I/O缓冲区特性可整理如下:
- I/O缓冲区在每个TCP套接字中单独存在;
- I/O缓冲区在创建套接字时自动生成;
- 即使关闭套接字也会继续传送输出缓冲区中遗留的数据;
- 关闭套接字将丢失输入缓冲区中的数据。
输入输出缓冲区的默认大小一般都是 8K,可以通过 getsockopt() 函数获取:
- unsigned optVal;
- int optLen = sizeof(int);
- getsockopt(servSock, SOL_SOCKET, SO_SNDBUF, (char*)&optVal, &optLen);
- printf("Buffer length: %d\n", optVal);
运行结果:
Buffer length: 8192
这里仅给出示例,后面会详细讲解。
阻塞模式
对于TCP套接字(默认情况下),当使用 write()/send() 发送数据时:
1) 首先会检查缓冲区,如果缓冲区的可用空间长度小于要发送的数据,那么 write()/send() 会被阻塞(暂停执行),直到缓冲区中的数据被发送到目标机器,腾出足够的空间,才唤醒 write()/send() 函数继续写入数据。
2) 如果TCP协议正在向网络发送数据,那么输出缓冲区会被锁定,不允许写入,write()/send() 也会被阻塞,直到数据发送完毕缓冲区解锁,write()/send() 才会被唤醒。
3) 如果要写入的数据大于缓冲区的最大长度,那么将分批写入。
4) 直到所有数据被写入缓冲区 write()/send() 才能返回。
当使用 read()/recv() 读取数据时:
1) 首先会检查缓冲区,如果缓冲区中有数据,那么就读取,否则函数会被阻塞,直到网络上有数据到来。
2) 如果要读取的数据长度小于缓冲区中的数据长度,那么就不能一次性将缓冲区中的所有数据读出,剩余数据将不断积压,直到有 read()/recv() 函数再次读取。
3) 直到读取到数据后 read()/recv() 函数才会返回,否则就一直被阻塞。
这就是TCP套接字的阻塞模式。所谓阻塞,就是上一步动作没有完成,下一步动作将暂停,直到上一步动作完成后才能继续,以保持同步性。
TCP套接字默认情况下是阻塞模式,也是最常用的。当然你也可以更改为非阻塞模式,后续我们会讲解。
TCP协议的粘包问题(数据的无边界性)
上节我们讲到了socket缓冲区和数据的传递过程,可以看到数据的接收和发送是无关的,read()/recv() 函数不管数据发送了多少次,都会尽可能多的接收数据。也就是说,read()/recv() 和 write()/send() 的执行次数可能不同。
例如,write()/send() 重复执行三次,每次都发送字符串"abc",那么目标机器上的 read()/recv()
可能分三次接收,每次都接收"abc";也可能分两次接收,第一次接收"abcab",第二次接收"cabc";也可能一次就接收到字符串"abcabcabc"。
假设我们希望客户端每次发送一位学生的学号,让服务器端返回该学生的姓名、住址、成绩等信息,这时候可能就会出现问题,服务器端不能区分学生的学号。例如第一次发送 1,第二次发送 3,服务器可能当成 13 来处理,返回的信息显然是错误的。
这就是数据的“粘包”问题,客户端发送的多个数据包被当做一个数据包接收。也称数据的无边界性,read()/recv() 函数不知道数据包的开始或结束标志(实际上也没有任何开始或结束标志),只把它们当做连续的数据流来处理。
下面的代码演示了粘包问题,客户端连续三次向服务器端发送数据,服务器端却一次性接收到所有数据。
图解TCP数据报结构以及三次握手(非常详细)
TCP(Transmission Control Protocol,传输控制协议)是一种面向连接的、可靠的、基于字节流的通信协议,数据在传输前要建立连接,传输完毕后还要断开连接。
客户端在收发数据前要使用 connect() 函数和服务器建立连接。建立连接的目的是保证IP地址、端口、物理链路等正确无误,为数据的传输开辟通道。
TCP建立连接时要传输三个数据包,俗称三次握手(Three-way Handshaking)。可以形象的比喻为下面的对话:
- [Shake 1] 套接字A:“你好,套接字B,我这里有数据要传送给你,建立连接吧。”
- [Shake 2] 套接字B:“好的,我这边已准备就绪。”
- [Shake 3] 套接字A:“谢谢你受理我的请求。”
TCP数据报结构
我们先来看一下TCP数据报的结构:

带阴影的几个字段需要重点说明一下:
1) 序号:Seq(Sequence Number)序号占32位,用来标识从计算机A发送到计算机B的数据包的序号,计算机发送数据时对此进行标记。
2) 确认号:Ack(Acknowledge Number)确认号占32位,客户端和服务器端都可以发送,Ack = Seq + 1。
3) 标志位:每个标志位占用1Bit,共有6个,分别为 URG、ACK、PSH、RST、SYN、FIN,具体含义如下:
- URG:紧急指针(urgent pointer)有效。
- ACK:确认序号有效。
- PSH:接收方应该尽快将这个报文交给应用层。
- RST:重置连接。
- SYN:建立一个新连接。
- FIN:断开一个连接。
对英文字母缩写的总结:Seq 是 Sequence 的缩写,表示序列;Ack(ACK) 是 Acknowledge 的缩写,表示确认;SYN 是 Synchronous 的缩写,愿意是“同步的”,这里表示建立同步连接;FIN 是 Finish 的缩写,表示完成。
连接的建立(三次握手)
使用 connect() 建立连接时,客户端和服务器端会相互发送三个数据包,请看下图:

客户端调用 socket() 函数创建套接字后,因为没有建立连接,所以套接字处于CLOSED状态;服务器端调用 listen() 函数后,套接字进入LISTEN状态,开始监听客户端请求。
这个时候,客户端开始发起请求:
1) 当客户端调用 connect() 函数后,TCP协议会组建一个数据包,并设置 SYN
标志位,表示该数据包是用来建立同步连接的。同时生成一个随机数字
1000,填充“序号(Seq)”字段,表示该数据包的序号。完成这些工作,开始向服务器端发送数据包,客户端就进入了SYN-SEND状态。
2) 服务器端收到数据包,检测到已经设置了 SYN 标志位,就知道这是客户端发来的建立连接的“请求包”。服务器端也会组建一个数据包,并设置 SYN 和 ACK 标志位,SYN 表示该数据包用来建立连接,ACK 用来确认收到了刚才客户端发送的数据包。
服务器生成一个随机数 2000,填充“序号(Seq)”字段。2000 和客户端数据包没有关系。
服务器将客户端数据包序号(1000)加1,得到1001,并用这个数字填充“确认号(Ack)”字段。
服务器将数据包发出,进入SYN-RECV状态。
3) 客户端收到数据包,检测到已经设置了 SYN 和 ACK 标志位,就知道这是服务器发来的“确认包”。客户端会检测“确认号(Ack)”字段,看它的值是否为 1000+1,如果是就说明连接建立成功。
接下来,客户端会继续组建数据包,并设置 ACK 标志位,表示客户端正确接收了服务器发来的“确认包”。同时,将刚才服务器发来的数据包序号(2000)加1,得到 2001,并用这个数字来填充“确认号(Ack)”字段。
客户端将数据包发出,进入ESTABLISED状态,表示连接已经成功建立。
4) 服务器端收到数据包,检测到已经设置了 ACK 标志位,就知道这是客户端发来的“确认包”。服务器会检测“确认号(Ack)”字段,看它的值是否为 2000+1,如果是就说明连接建立成功,服务器进入ESTABLISED状态。
至此,客户端和服务器都进入了ESTABLISED状态,连接建立成功,接下来就可以收发数据了。
最后的说明
三次握手的关键是要确认对方收到了自己的数据包,这个目标就是通过“确认号(Ack)”字段实现的。计算机会记录下自己发送的数据包序号 Seq,待收到对方的数据包后,检测“确认号(Ack)”字段,看Ack = Seq + 1是否成立,如果成立说明对方正确收到了自己的数据包。
详细分析TCP数据的传输过程
建立连接后,两台主机就可以相互传输数据了。如下图所示:
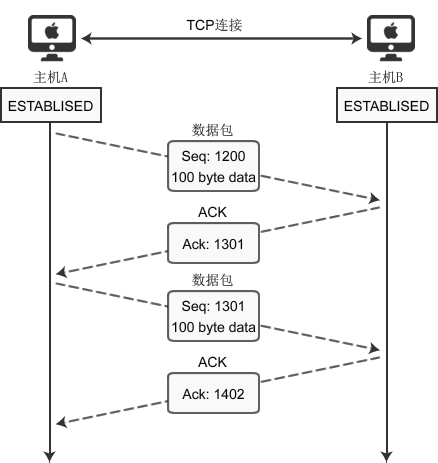
图1:TCP 套接字的数据交换过程
上图给出了主机A分2次(分2个数据包)向主机B传递200字节的过程。首先,主机A通过1个数据包发送100个字节的数据,数据包的 Seq 号设置为 1200。主机B为了确认这一点,向主机A发送 ACK 包,并将 Ack 号设置为 1301。
为了保证数据准确到达,目标机器在收到数据包(包括SYN包、FIN包、普通数据包等)包后必须立即回传ACK包,这样发送方才能确认数据传输成功。
此时 Ack 号为 1301 而不是 1201,原因在于 Ack 号的增量为传输的数据字节数。假设每次 Ack 号不加传输的字节数,这样虽然可以确认数据包的传输,但无法明确100字节全部正确传递还是丢失了一部分,比如只传递了80字节。因此按如下的公式确认 Ack 号:
Ack号 = Seq号 + 传递的字节数 + 1
与三次握手协议相同,最后加 1 是为了告诉对方要传递的 Seq 号。
下面分析传输过程中数据包丢失的情况,如下图所示:
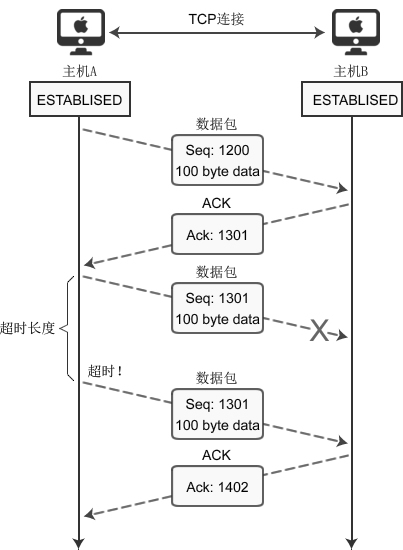
图2:TCP套接字数据传输过程中发生错误
上图表示通过 Seq 1301 数据包向主机B传递100字节的数据,但中间发生了错误,主机B未收到。经过一段时间后,主机A仍未收到对于 Seq 1301 的ACK确认,因此尝试重传数据。
为了完成数据包的重传,TCP套接字每次发送数据包时都会启动定时器,如果在一定时间内没有收到目标机器传回的 ACK 包,那么定时器超时,数据包会重传。
上图演示的是数据包丢失的情况,也会有 ACK 包丢失的情况,一样会重传。
重传超时时间(RTO, Retransmission Time Out)
这个值太大了会导致不必要的等待,太小会导致不必要的重传,理论上最好是网络 RTT 时间,但又受制于网络距离与瞬态时延变化,所以实际上使用自适应的动态算法(例如 Jacobson 算法和 Karn 算法等)来确定超时时间。
往返时间(RTT,Round-Trip Time)表示从发送端发送数据开始,到发送端收到来自接收端的 ACK 确认包(接收端收到数据后便立即确认),总共经历的时延。
重传次数
TCP数据包重传次数根据系统设置的不同而有所区别。有些系统,一个数据包只会被重传3次,如果重传3次后还未收到该数据包的 ACK 确认,就不再尝试重传。但有些要求很高的业务系统,会不断地重传丢失的数据包,以尽最大可能保证业务数据的正常交互。
最后需要说明的是,发送端只有在收到对方的 ACK 确认包后,才会清空输出缓冲区中的数据。
图解TCP四次握手断开连接
建立连接非常重要,它是数据正确传输的前提;断开连接同样重要,它让计算机释放不再使用的资源。如果连接不能正常断开,不仅会造成数据传输错误,还会导致套接字不能关闭,持续占用资源,如果并发量高,服务器压力堪忧。
建立连接需要三次握手,断开连接需要四次握手,可以形象的比喻为下面的对话:
- [Shake 1] 套接字A:“任务处理完毕,我希望断开连接。”
- [Shake 2] 套接字B:“哦,是吗?请稍等,我准备一下。”
- 等待片刻后……
- [Shake 3] 套接字B:“我准备好了,可以断开连接了。”
- [Shake 4] 套接字A:“好的,谢谢合作。”
下图演示了客户端主动断开连接的场景:

建立连接后,客户端和服务器都处于ESTABLISED状态。这时,客户端发起断开连接的请求:
1) 客户端调用 close() 函数后,向服务器发送 FIN 数据包,进入FIN_WAIT_1状态。FIN 是 Finish 的缩写,表示完成任务需要断开连接。
2) 服务器收到数据包后,检测到设置了 FIN 标志位,知道要断开连接,于是向客户端发送“确认包”,进入CLOSE_WAIT状态。
注意:服务器收到请求后并不是立即断开连接,而是先向客户端发送“确认包”,告诉它我知道了,我需要准备一下才能断开连接。
3) 客户端收到“确认包”后进入FIN_WAIT_2状态,等待服务器准备完毕后再次发送数据包。
4) 等待片刻后,服务器准备完毕,可以断开连接,于是再主动向客户端发送 FIN 包,告诉它我准备好了,断开连接吧。然后进入LAST_ACK状态。
5) 客户端收到服务器的 FIN 包后,再向服务器发送 ACK 包,告诉它你断开连接吧。然后进入TIME_WAIT状态。
6) 服务器收到客户端的 ACK 包后,就断开连接,关闭套接字,进入CLOSED状态。
关于 TIME_WAIT 状态的说明
客户端最后一次发送 ACK包后进入 TIME_WAIT 状态,而不是直接进入 CLOSED 状态关闭连接,这是为什么呢?
TCP
是面向连接的传输方式,必须保证数据能够正确到达目标机器,不能丢失或出错,而网络是不稳定的,随时可能会毁坏数据,所以机器A每次向机器B发送数据包后,都要求机器B”确认“,回传ACK包,告诉机器A我收到了,这样机器A才能知道数据传送成功了。如果机器B没有回传ACK包,机器A会重新发送,直到机器B回传ACK包。
客户端最后一次向服务器回传ACK包时,有可能会因为网络问题导致服务器收不到,服务器会再次发送 FIN
包,如果这时客户端完全关闭了连接,那么服务器无论如何也收不到ACK包了,所以客户端需要等待片刻、确认对方收到ACK包后才能进入CLOSED状态。那么,要等待多久呢?
数据包在网络中是有生存时间的,超过这个时间还未到达目标主机就会被丢弃,并通知源主机。这称为报文最大生存时间(MSL,Maximum Segment Lifetime)。TIME_WAIT
要等待 2MSL 才会进入 CLOSED 状态。ACK 包到达服务器需要 MSL 时间,服务器重传 FIN 包也需要 MSL 时间,2MSL
是数据包往返的最大时间,如果 2MSL 后还未收到服务器重传的 FIN 包,就说明服务器已经收到了 ACK 包。
再谈UDP和TCP
TCP 是面向连接的传输协议,建立连接时要经过三次握手,断开连接时要经过四次握手,中间传输数据时也要回复 ACK 包确认,多种机制保证了数据能够正确到达,不会丢失或出错。
UDP 是非连接的传输协议,没有建立连接和断开连接的过程,它只是简单地把数据丢到网络中,也不需要 ACK 包确认。
UDP
传输数据就好像我们邮寄包裹,邮寄前需要填好寄件人和收件人地址,之后送到快递公司即可,但包裹是否正确送达、是否损坏我们无法得知,也无法保证。UDP
协议也是如此,它只管把数据包发送到网络,然后就不管了,如果数据丢失或损坏,发送端是无法知道的,当然也不会重发。
既然如此,TCP 应该是更加优质的传输协议吧?
如果只考虑可靠性,TCP 的确比 UDP 好。但 UDP 在结构上比 TCP 更加简洁,不会发送 ACK 的应答消息,也不会给数据包分配 Seq 序号,所以 UDP 的传输效率有时会比 TCP 高出很多,编程中实现 UDP 也比 TCP 简单。
UDP 的可靠性虽然比不上TCP,但也不会像想象中那么频繁地发生数据损毁,在更加重视传输效率而非可靠性的情况下,UDP
是一种很好的选择。比如视频通信或音频通信,就非常适合采用 UDP
协议;通信时数据必须高效传输才不会产生“卡顿”现象,用户体验才更加流畅,如果丢失几个数据包,视频画面可能会出现“雪花”,音频可能会夹带一些杂音,这些都是无妨的。
与 UDP 相比,TCP 的生命在于流控制,这保证了数据传输的正确性。
最后需要说明的是:TCP 的速度无法超越 UDP,但在收发某些类型的数据时有可能接近 UDP。例如,每次交换的数据量越大,TCP 的传输速率就越接近于 UDP。
基于UDP的服务器端和客户端
前面的文章中我们给出了几个 TCP 的例子,对于 UDP 而言,只要能理解前面的内容,实现并非难事。
UDP中的服务器端和客户端没有连接
UDP 不像 TCP,无需在连接状态下交换数据,因此基于 UDP 的服务器端和客户端也无需经过连接过程。也就是说,不必调用 listen() 和 accept() 函数。UDP 中只有创建套接字的过程和数据交换的过程。
UDP服务器端和客户端均只需1个套接字
TCP 中,套接字是一对一的关系。如要向 10 个客户端提供服务,那么除了负责监听的套接字外,还需要创建 10 套接字。但在 UDP 中,不管是服务器端还是客户端都只需要 1 个套接字。之前解释 UDP 原理的时候举了邮寄包裹的例子,负责邮寄包裹的快递公司可以比喻为 UDP 套接字,只要有 1 个快递公司,就可以通过它向任意地址邮寄包裹。同样,只需 1 个 UDP 套接字就可以向任意主机传送数据。
基于UDP的接收和发送函数
创建好 TCP 套接字后,传输数据时无需再添加地址信息,因为 TCP 套接字将保持与对方套接字的连接。换言之,TCP 套接字知道目标地址信息。但 UDP 套接字不会保持连接状态,每次传输数据都要添加目标地址信息,这相当于在邮寄包裹前填写收件人地址。
发送数据使用 sendto() 函数:
- ssize_t sendto(int sock, void *buf, size_t nbytes, int flags, struct sockaddr *to, socklen_t addrlen); //Linux
- int sendto(SOCKET sock, const char *buf, int nbytes, int flags, const struct sockadr *to, int addrlen); //Windows
Linux 和 Windows 下的 sendto() 函数类似,下面是详细参数说明:
- sock:用于传输 UDP 数据的套接字;
- buf:保存待传输数据的缓冲区地址;
- nbytes:带传输数据的长度(以字节计);
- flags:可选项参数,若没有可传递 0;
- to:存有目标地址信息的 sockaddr 结构体变量的地址;
- addrlen:传递给参数 to 的地址值结构体变量的长度。
UDP 发送函数 sendto() 与TCP发送函数 write()/send() 的最大区别在于,sendto() 函数需要向他传递目标地址信息。
接收数据使用 recvfrom() 函数:
- ssize_t recvfrom(int sock, void *buf, size_t nbytes, int flags, struct sockadr *from, socklen_t *addrlen); //Linux
- int recvfrom(SOCKET sock, char *buf, int nbytes, int flags, const struct sockaddr *from, int *addrlen); //Windows
由于 UDP 数据的发送端不定,所以 recvfrom() 函数定义为可接收发送端信息的形式,具体参数如下:
- sock:用于接收 UDP 数据的套接字;
- buf:保存接收数据的缓冲区地址;
- nbytes:可接收的最大字节数(不能超过 buf 缓冲区的大小);
- flags:可选项参数,若没有可传递 0;
- from:存有发送端地址信息的 sockaddr 结构体变量的地址;
- addrlen:保存参数 from 的结构体变量长度的变量地址值。
基于UDP的回声服务器端/客户端
下面结合之前的内容实现回声客户端。需要注意的是,UDP 不同于 TCP,不存在请求连接和受理过程,因此在某种意义上无法明确区分服务器端和客户端,只是因为其提供服务而称为服务器端,希望各位读者不要误解。
下面给出 Windows 下的代码,Linux 与此类似,不再赘述。
服务器端 server.cpp:
- #include <stdio.h>
- #include <winsock2.h>
- #pragma comment (lib, "ws2_32.lib") //加载 ws2_32.dll
- #define BUF_SIZE 100
- int main(){
- WSADATA wsaData;
- WSAStartup( MAKEWORD(2, 2), &wsaData);
- //创建套接字
- SOCKET sock = socket(AF_INET, SOCK_DGRAM, 0);
- //绑定套接字
- sockaddr_in servAddr;
- memset(&servAddr, 0, sizeof(servAddr)); //每个字节都用0填充
- servAddr.sin_family = PF_INET; //使用IPv4地址
- servAddr.sin_addr.s_addr = htonl(INADDR_ANY); //自动获取IP地址
- servAddr.sin_port = htons(1234); //端口
- bind(sock, (SOCKADDR*)&servAddr, sizeof(SOCKADDR));
- //接收客户端请求
- SOCKADDR clntAddr; //客户端地址信息
- int nSize = sizeof(SOCKADDR);
- char buffer[BUF_SIZE]; //缓冲区
- while(1){
- int strLen = recvfrom(sock, buffer, BUF_SIZE, 0, &clntAddr, &nSize);
- sendto(sock, buffer, strLen, 0, &clntAddr, nSize);
- }
- closesocket(sock);
- WSACleanup();
- return 0;
- }
代码说明:
1) 第 12 行代码在创建套接字时,向 socket() 第二个参数传递 SOCK_DGRAM,以指明使用 UDP 协议。
2) 第 18 行代码中使用htonl(INADDR_ANY)来自动获取 IP 地址。
利用常数 INADDR_ANY 自动获取 IP 地址有一个明显的好处,就是当软件安装到其他服务器或者服务器 IP
地址改变时,不用再更改源码重新编译,也不用在启动软件时手动输入。而且,如果一台计算机中已分配多个 IP
地址(例如路由器),那么只要端口号一致,就可以从不同的 IP 地址接收数据。所以,服务器中优先考虑使用
INADDR_ANY;而客户端中除非带有一部分服务器功能,否则不会采用。
客户端 client.cpp:
- #include <stdio.h>
- #include <WinSock2.h>
- #pragma comment(lib, "ws2_32.lib") //加载 ws2_32.dll
- #define BUF_SIZE 100
- int main(){
- //初始化DLL
- WSADATA wsaData;
- WSAStartup(MAKEWORD(2, 2), &wsaData);
- //创建套接字
- SOCKET sock = socket(PF_INET, SOCK_DGRAM, 0);
- //服务器地址信息
- sockaddr_in servAddr;
- memset(&servAddr, 0, sizeof(servAddr)); //每个字节都用0填充
- servAddr.sin_family = PF_INET;
- servAddr.sin_addr.s_addr = inet_addr("127.0.0.1");
- servAddr.sin_port = htons(1234);
- //不断获取用户输入并发送给服务器,然后接受服务器数据
- sockaddr fromAddr;
- int addrLen = sizeof(fromAddr);
- while(1){
- char buffer[BUF_SIZE] = {0};
- printf("Input a string: ");
- gets(buffer);
- sendto(sock, buffer, strlen(buffer), 0, (struct sockaddr*)&servAddr, sizeof(servAddr));
- int strLen = recvfrom(sock, buffer, BUF_SIZE, 0, &fromAddr, &addrLen);
- buffer[strLen] = 0;
- printf("Message form server: %s\n", buffer);
- }
- closesocket(sock);
- WSACleanup();
- return 0;
- }
先运行 server,再运行 client,client 输出结果为:
Input a string: C语言中文网
Message form server: C语言中文网
Input a string: c.biancheng.net Founded in 2012
Message form server: c.biancheng.net Founded in 2012
Input a string:
从代码中可以看出,server.cpp 中没有使用 listen() 函数,client.cpp 中也没有使用 connect() 函数,因为 UDP 不需要连接。
