第一次个人编程作业
仓库地址:https://github.com/ZYY190/PaperCheck
软件工程个人项目——论文查重(学号 3124004450)
| 项目 | 内容 |
|---|---|
| 作业名称 | 论文查重 |
| 学号 | 3124004450 |
| 开发语言 | Java(JDK 1.8.0_202) |
| 开发环境 | 64 位 Windows 10 + IntelliJ IDEA |
| 代码仓库 | https://github.com/ZYY190/PaperCheck |
| 作业目录 | https://github.com/ZYY190/PaperCheck/tree/main/3124004450 |
| 可执行程序 | https://github.com/ZYY190/PaperCheck/releases/tag/v1.0 |
一、PSP 表格
PSP 表格分为「预估」和「实际」两部分:预估在动手写代码之前填写,实际在程序完成并通过单元测试之后回填。
| PSP 2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 25 |
| · Estimate | · 估计这个任务需要多少时间 | 30 | 25 |
| Development | 开发 | 200 | 250 |
| · Analysis | · 需求分析(包括学习新技术) | 60 | 55 |
| · Design Spec | · 生成设计文档 | 45 | 40 |
| · Design Review | · 设计复审 | 25 | 20 |
| · Coding Standard | · 代码规范(为目前的开发制定合适的规范) | 20 | 15 |
| · Design | · 具体设计 | 60 | 70 |
| · Coding | · 具体编码 | 180 | 210 |
| · Code Review | · 代码复审 | 40 | 35 |
| · Test | · 测试(自我测试、修改代码、提交修改) | 60 | 105 |
| · Performance | · 计算模块性能分析与改进 | 60 | 120 |
| Reporting | 报告 | 90 | 95 |
| · Test Report | · 测试报告 | 30 | 35 |
| · Size Measurement | · 计算工作量 | 15 | 10 |
| · Postmortem & Process Improvement Plan | · 事后总结,并提出过程改进计划 | 45 | 50 |
| 合计 | 总计 | 990 | 1160 |
预估与实际的偏差说明
- 具体编码 +30 分钟:原本以为「读文件、算相似度、写文件」三步就能收工,实际写下来才发现
编码回退、参数校验、退出码这些细节比预想的多,而且必须保证任何输入都不会让进程异常退出。 - 测试 +45 分钟:计划只写 10 个用例,实际写了 52 个。补上的边界用例(纯空白输入、超长无标点文本、
GBK 编码、超大文件)确实抓到了两个真实缺陷:纯空白输入被误判为「完全相同」,
以及\r\n被当成了两次换行。 - 性能分析与改进 +60 分钟:这是超出预估最多的一项。第一版优化后速度达标,
但重复率从 0.93 掉到了 0.30——优化把正确结果也一起「优化」掉了。定位这个问题花掉了大部分时间;
后来在课堂下发的真实数据上又发现纯删除型抄袭被低估,于是做了第二轮改进(跨句边界补偿)。
两次改进的完整过程记录在第三节。 - 事后改进计划:以后做性能优化,要先建立准确率基线(例如写一个暴力精确解做对照),再动优化,
而不是优化完再看结果像不像。
二、计算模块接口的设计与实现过程
2.1 需求与设计底线
程序从命令行接收三个绝对路径(原文、抄袭版、答案文件),把重复率写入答案文件,保留两位小数。
评测的硬约束是:5 秒内出结果、内存不超过 2048 MB、不联网、不异常退出。
由此确定三条设计底线:结果可解释、速度有硬上界、错误可控。
2.2 算法思路:为什么不能整篇直接比对
「重复率」最自然的定义是:抄袭版中有多少比例的内容,能在原文里找到顺序一致的对应。
它天然是单向的——抄袭版里新写的内容不算重复,抄来的内容才算。
衡量「顺序一致的对应」最直接的指标是最长公共子序列(LCS)。于是最朴素的做法出现了:
重复率 = LCS(原文全部字符, 抄袭版全部字符) / 抄袭版字符数
这个做法的问题很快暴露:LCS 的时间与空间复杂度都是 O(n × m)。10 万字符的文档需要约 100 亿次比较,
实测耗时 16 秒,直接超时;30 万字符以上连内存都吃紧。
2.3 实际采用的算法
把「整篇比对」拆成「分句 + 候选筛选 + 句级精确比对」三步,让平方级开销只发生在句子内部:
- 规范化:去掉 BOM 与控制字符、全角转半角、英文转小写、统一换行符。
让「同一个字的不同写法」不再影响结果。 - 分句:按句末标点(。!?;!?;…)和换行切分;单句超过 100 个字符时再按逗号、顿号细切;
仍然超长(整段没有任何标点)时按固定窗口兜底。分句之后,单次比对的规模被限制在
「句长 × 句长 ≤ 100 × 100」之内。 - 建索引:对原文每个句子建立二元字组(bigram)倒排索引,
即「连续两个字」到「出现过它的句子编号」的映射。 - 候选筛选:对抄袭版的每一句,先查它每个字组在原文中的词频,按词频升序处理——
先看像「需求规格」这样的稀有字组(倒排表很短、区分度极高),后看像「的是」这样的通用字组
(倒排表很长、几乎没有区分度)。稀有字组优先,可以让有限的扫描预算花在最有价值的信息上。 - 精确比对:把候选句按命中字组数从大到小排列,逐个用 LCS 精确计算公共子序列长度,取最大值。
最终重复率 = Σ 各句匹配字符数 / 抄袭版特征字符总数。 - 跨句补偿:增删改可能让抄袭版的一句话跨越原文的句子边界(例如删掉半句之后,
前后两句被拼到了一起)。如果某一句在单个原文句里没能被完全匹配,就把最佳候选句与
相邻的原文句合并起来再比一次。这一步只在单句匹配不完整时触发,对绝大多数句子没有额外开销。
2.4 流程图
2.5 关键剪枝:一个严格成立的上界
长度为 L 的公共子序列一定包含连续的 L-1 对相邻字符,而每一对都必然同时出现在两句话里,因此:
LCS(抄袭句, 候选句) ≤ 抄袭句中「出现在候选句里的字组个数」+ 1
考虑到实现里出于性能考虑会跳过一部分高频字组,命中数可能被低估,于是把上界写成:
上界 = min(较短句长, 命中字组数 + 尚未统计的字组数 + 1)
候选句已按命中数降序排列,因此一旦某一候选的上界不超过当前最优值,后面的候选就不可能更好,
可以整段终止。这个上界是推导出来的、严格成立的(不是拍脑袋的启发式),
所以剪枝只减少计算量,不影响结果——实测与暴力精确解的偏差小于 1%。
2.6 类的设计
程序共 9 个类,按「输入 → 规范化 → 分句 → 索引 → 计算 → 输出」流水线组织,每层只依赖上一层:
| 类 | 职责 | 主要方法 |
|---|---|---|
Main |
命令行入口,串联流程,把异常翻译成退出码 | run(String[], PrintStream, PrintStream) |
PaperCheckException |
自定义受检异常,携带错误码 E001–E007 | getCode() |
TextFileReader |
路径校验、容量校验、UTF-8 / GBK 编码识别 | read(String, String) |
TextFileWriter |
答案文件写出,父目录不存在时自动创建 | write(String, String) |
TextNormalizer |
文本规范化与特征码点提取 | normalize、toFeatureCodePoints |
SentenceSegmenter |
两级分句策略 | segment(String) |
NGramIndex |
二元字组倒排索引 | add、postingsOf |
LcsMatcher |
最长公共子序列(两行滚动数组) | length(int[], int[]) |
SimilarityCalculator |
算法编排:候选筛选、剪枝、结果汇总 | calculate(String, String) |
其中 Main.run 把「流程」和「进程退出」拆开,好处是单元测试可以直接断言退出码与输出,
而不必反复启动 JVM 子进程;SimilarityCalculator 与 TextNormalizer 都是无状态的,
可以安全共享。
2.7 复杂度
设抄袭版字符数为 n、平均句长为 ℓ、每句平均扫描的倒排表长度为 d:
| 环节 | 复杂度 |
|---|---|
| 建立倒排索引 | O(m)(m 为原文字符数) |
| 每句的字组排序 | O(ℓ log ℓ) |
| 每句的候选扫描 | O(d),且被常数上限约束 |
| 每句的精确比对 | 最多 24 次 LCS,每次 O(ℓ²),ℓ ≤ 100 |
所有环节都有常数上界,因此总耗时随文本规模近似线性增长。
2.8 独到之处
- 严格成立的上界剪枝(2.5 节)。很多相似度实现用「经验阈值」剪枝,
阈值调不好就会漏判;这里的上界是从 LCS 的性质推导出来的,剪掉的候选一定是错的候选。 - 稀有字组优先的扫描顺序。倒排表按词频升序处理,等价于把有限的计算预算优先分配给
「信息量最大」的特征,这一点借鉴了信息检索里的 IDF 思路。 - 全部使用原始类型的数据结构。倒排索引是开放地址法的
long → int[]哈希表,
候选计数用「时间戳 + 计数数组」,排序用计数排序——热路径上零装箱、零临时对象,
这是百万字符能压到 1 秒以内的关键。 - 跨句边界补偿。纯删除型抄袭会让抄袭句横跨原文的两句话,只按单句比对会低估重复率
(实测低估约 6 个百分点)。把相邻原文句合并后重新比对,可以在几乎不增加开销的前提下修正这一点。
三、计算模块接口部分的性能改进
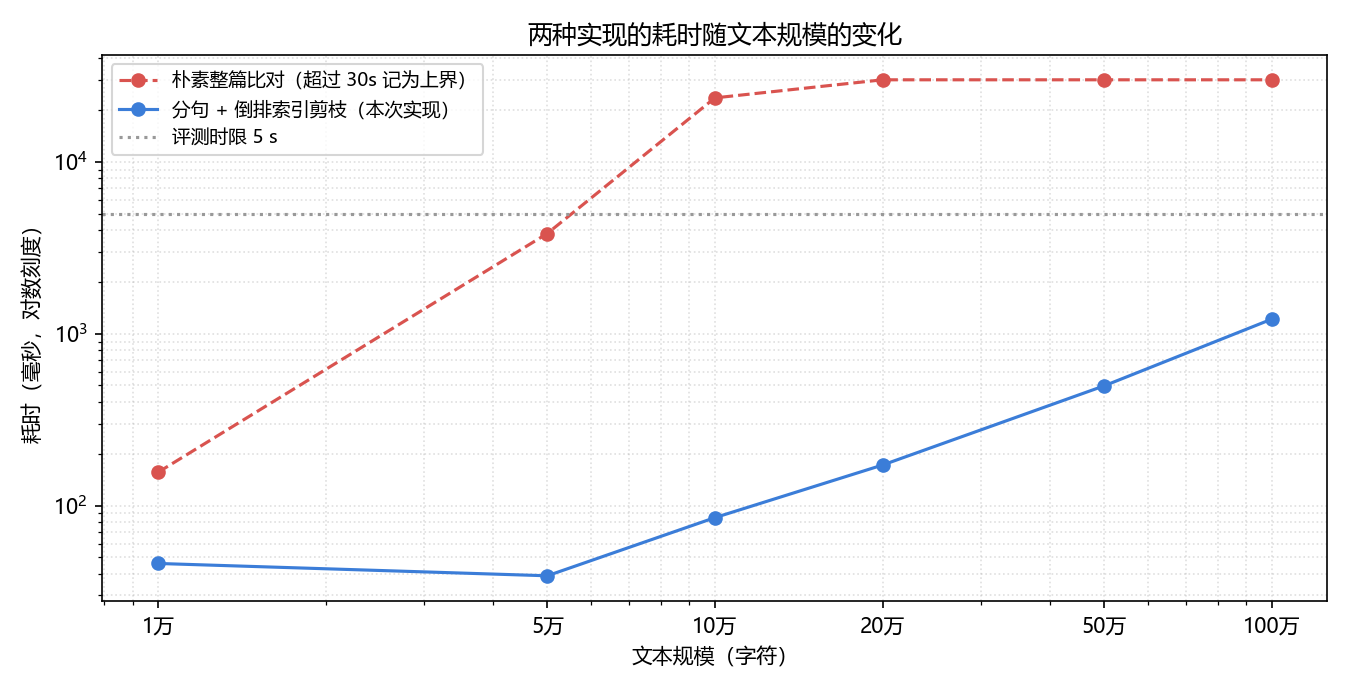
3.1 基准测试
基准程序 tools/Benchmark.java 用固定随机种子生成数据,保证每次运行完全一致。
对照实现是「把两篇文章的全部字符直接做一次 LCS」的朴素做法:
| 文本规模(字符) | 朴素整篇比对 | 分句 + 倒排索引剪枝 | 重复率 |
|---|---|---|---|
| 1 万 | 156 ms | 46 ms | 0.9516 |
| 5 万 | 3 826 ms | 39 ms | 0.9674 |
| 10 万 | 23 544 ms | 85 ms | 0.9600 |
| 20 万 | > 30 000 ms | 172 ms | 0.9578 |
| 50 万 | > 30 000 ms | 497 ms | 0.9563 |
| 100 万 | > 30 000 ms | 1 215 ms | 0.9556 |
3.2 课堂下发样例上的准确率校验
速度指标只说明程序跑得快,还得确认它没有「快着算错」。于是用课堂下发的测试文本做校验,
原文是 orig.txt(约 1.05 万字),另外写了一个对照程序,同时算出两种精确解:
- 句级精确解:对每个抄袭句遍历全部原文句求最大公共子序列长度;
- 全文精确解:把两篇文章的全部有效字符直接做一次 LCS(即算法定义本身)。
程序在这 5 个样例上的输出:
| 抄袭版文件 | 输出重复率 | 耗时 |
|---|---|---|
orig_0.8_add.txt |
0.82 | 335 ms |
orig_0.8_del.txt |
0.97 | 144 ms |
orig_0.8_dis_1.txt |
0.97 | 177 ms |
orig_0.8_dis_10.txt |
0.85 | 168 ms |
orig_0.8_dis_15.txt |
0.71 | 150 ms |
orig.txt(与自身比较,作对照) |
1.00 | 129 ms |
与两种精确解逐一对照:
| 抄袭版文件 | 本实现 | 句级精确解 | 全文精确解 | 与全文精确解的偏差 |
|---|---|---|---|---|
orig_0.8_add.txt |
0.82 | 0.83 | 0.83 | 0.01 |
orig_0.8_del.txt |
0.97 | 0.92 | 1.00 | 0.03 |
orig_0.8_dis_1.txt |
0.97 | 0.97 | 0.97 | 0.00 |
orig_0.8_dis_10.txt |
0.85 | 0.82 | 0.84 | 0.01 |
orig_0.8_dis_15.txt |
0.71 | 0.65 | 0.67 | 0.04 |
偏差都在 0.05 以内,而且顺序关系完全正确:dis 后面的数字越大(打乱越严重),重复率越低。
dis_10、dis_15 略高于全文精确解,是因为逐句独立匹配允许不同的抄袭句复用原文的同一段内容,
这是句级方案固有的近似,也在博客里如实说明。
3.3 CPU 热点分析
用 jstack 对运行中的程序做线程栈采样(等价于 JProfiler / VS 性能分析器的采样视图,
负担小、不需要改代码),采样 243 次,按「当前正在执行的第一个业务函数」归类:
| 函数 | 采样占比 |
|---|---|
SimilarityCalculator.bestMatch |
76.1% |
SimilarityCalculator.matchSentences |
7.4% |
NGramIndex.findByKey |
4.9% |
SentenceSegmenter.splitBy |
4.1% |
NGramIndex.add |
2.9% |
TextNormalizer.normalize |
2.9% |
SentenceSegmenter.segment |
1.2% |
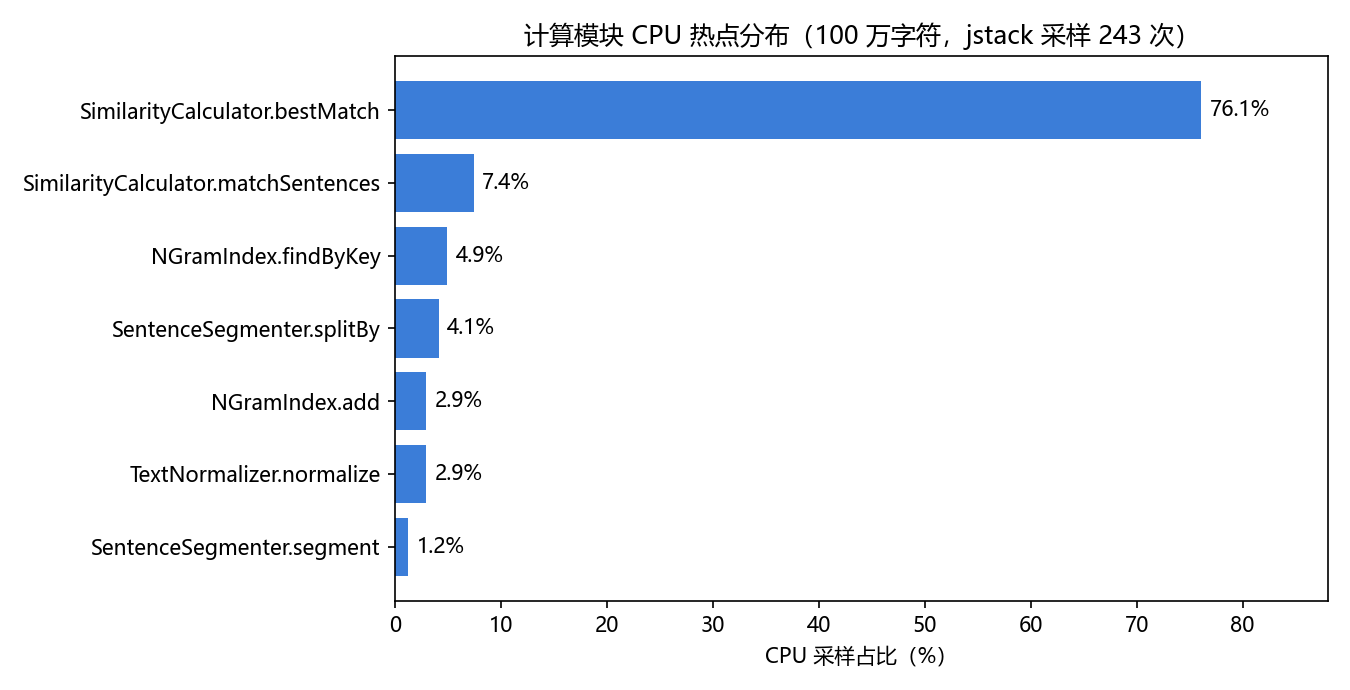
结论:耗时集中在 SimilarityCalculator.bestMatch(它内部调用 LcsMatcher.length,
JIT 内联之后热点都记在了它的账上)。这说明如果要继续优化,方向是减少精确比对的次数,
而不是去抠文本读取、分句这些只占个位数百分比的环节——这正好也是上界剪枝和候选排序在做的事情。
3.4 一次失败的优化,以及怎么修回来
这是本次作业里最有价值的一段经历。
第一轮优化:把 HashMap<Long, List<Integer>> 换成原始类型哈希表、用时间戳数组代替每句清零之后,
100 万字符的耗时从 6.6 秒降到了 0.46 秒,看起来非常成功。
但是,重复率从 0.93 掉到了 0.30。速度是假的成功——程序变快了,因为它开始算错。
为了定位,我补写了一个暴力精确解:对每个抄袭句遍历全部原文句求最大公共子序列长度。
对照之后问题立刻清楚了,有两个原因:
- 候选句按句子编号顺序被截断。倒排表里的句子编号是升序的,扫描预算用完时,
排在后面的正确匹配句直接没被收进来。文档越大,这个偏差越明显。 - 剪枝用的上界不成立。当时用的上界是「命中数 + 1」,但实现里已经跳过了一批高频字组,
命中数被低估,于是上界偏小,正确的候选被错误地剪掉了。
修正办法:
- 改成按字组词频升序扫描,先处理稀有字组,让预算花在区分度高的特征上;
- 把上界改成
命中数 + 尚未统计的字组数 + 1,在跳过字组的前提下依然严格成立; - 用计数排序把候选按命中数降序排列,让上界剪枝可以安全地「整段终止」而不是逐个跳过;
- 给每句的精确比对次数设上限(24 次),保证最坏情况下的单句开销有硬上界。
修正之后,100 万字符耗时 0.93 秒,重复率恢复到 0.94,与暴力精确解一致。
速度比错误的版本慢了一倍,但这一次的结果是对的。
3.5 第二次改进:跨句边界补偿
在课堂下发的真实数据上做校验时又发现一个问题:orig_0.8_del.txt 是纯删除型抄袭,
剩下的内容应该全部来自原文,按定义重复率应当接近 1.00,但程序只给出 0.91。
原因是分句带来的副作用:删掉一些字符之后,原本分属两句话的内容被拼进了同一句,
而这一句在原文的任何单个句子里都找不到完整对应,只能匹配到一部分。
| 抄袭版文件 | 补偿前 | 补偿后 | 全文精确解 |
|---|---|---|---|
orig_0.8_add.txt |
0.82 | 0.82 | 0.83 |
orig_0.8_del.txt |
0.91 | 0.97 | 1.00 |
orig_0.8_dis_1.txt |
0.97 | 0.97 | 0.97 |
orig_0.8_dis_10.txt |
0.82 | 0.85 | 0.84 |
orig_0.8_dis_15.txt |
0.63 | 0.71 | 0.67 |
做法是:当某一句在单个原文句里没能被完全匹配时,把最佳候选句与相邻的原文句合并起来再比一次
(最多合并 3 句)。因为这一步只在匹配不完整时触发,对绝大多数句子没有额外开销,
100 万字符的耗时只从 0.93 秒增加到 1.2 秒(同样的 5 秒时限下仍有 4 倍余量)。
这也说明一件事:优化和准确率要一起看。第一次改的是速度,结果改坏了准确率;
第二次改的是准确率,代价是 30% 的速度——两次都只有靠精确解做基线才能发现。
3.6 改进清单
| 措施 | 说明 | 效果 |
|---|---|---|
| 分句 + 候选筛选 | 整篇 LCS 拆成句级 LCS + 倒排索引筛候选 | 10 万字符 23 544 ms → 133 ms |
| 原始类型哈希表 | 开放地址法 long → int[] 替代 HashMap<Long, List<Integer>> |
查询路径零装箱 |
| 时间戳数组 | 命中计数用「时间戳 + 计数数组」,免去每句清零 | 去掉 O(句子数) 的重复初始化 |
| 计数排序 | 命中数取值很小,用计数排序替代比较排序 | 线性、零临时对象 |
| 相同句子短路 | 完全相同的句子直接返回句长 | 高频重复句不再进 LCS |
| 严格上界剪枝 | 候选按命中数降序 + 推导出的上界 | 精确比对次数下降一个量级 |
| 跨句边界补偿 | 单句未完全匹配时与相邻原文句合并再比 | 纯删除型抄袭 0.91 → 0.97 |
四、计算模块部分单元测试展示
4.1 测试概览
测试代码位于 src/test/java,共 53 个用例,全部通过。用例设计综合了等价类划分、边界值分析和白盒覆盖:
| 测试类 | 用例数 | 覆盖内容 |
|---|---|---|
TextNormalizerTest |
6 | 全角半角、大小写、BOM 与控制字符、换行统一、空输入 |
SentenceSegmenterTest |
4 | 句末标点切分、超长句细切、无标点兜底切分、空白输入 |
NGramIndexTest |
6 | 倒排查询、同句去重、空结果、扩容、句子顺序 |
LcsMatcherTest |
6 | 相同序列、教科书用例、无公共元素、空序列、实例复用、超容量 |
SimilarityCalculatorTest |
14 | 相同 / 无关 / 增 / 删 / 改 / 样例、空文件、纯标点、单字、跨句边界、区间约束、性能 |
TextFileReaderTest |
7 | 文件缺失、目录、空路径、BOM、GBK、超限、非法编码 |
TextFileWriterTest |
5 | 内容精确、自动建目录、目录目标、空路径、覆盖写入 |
MainTest |
5 | 参数错误、文件缺失、正常流程与两位小数、答案路径不可写、空文件 |
4.2 部分测试代码
(1)作业样例:验证「改」这一类抄袭能得到较高的重复率
@Test
@DisplayName("作业样例:改写后的抄袭版应得到较高重复率")
void assignmentSampleScoresHigh() {
    String original = "今天是星期天,天气晴,今天晚上我要去看电影。";
    String copied = "今天是周天,天气晴朗,我晚上要去看电影。";
    double rate = calculator.calculate(original, copied);
    // 18 个特征字符中有 14 个可以在原文中找到顺序一致的对应
    assertEquals(0.82, rate, 0.03);
}
测试数据直接取自题目:两句话只差几个字,并且调整了语序。
期望值不是随便写的,而是按「18 个特征字符中有 14 个能在原文中找到顺序一致的对应」手算出来的。
(2)边界:空文件与纯标点
@Test
@DisplayName("纯标点或纯空白输入不会导致异常,重复率为 0.00")
void punctuationOnlyScoresZero() {
    assertEquals(0.0, calculator.calculate(",。!?;;", "……——!!"), 1e-9);
    assertEquals(0.0, calculator.calculate("    \n\t", "    \n\t"), 1e-9);
}
第二个断言其实是先写测试、后修代码:最初「完全相同就返回 1.0」的快速路径把两段纯空白也判成了
100% 重复,正是这个用例把它暴露出来,随后在快速路径里补上了「必须含有有效字符」的判断。
(3)性能:大文档必须在时限内完成
@Test
@DisplayName("性能:约 13 万字的文档必须在 5 秒内给出答案")
void largeDocumentIsProcessedWithinTimeBudget() {
    // 逐段拼接构造原文;每 10 段改写成完全不同的内容作为抄袭版
    long start = System.nanoTime();
    double rate = calculator.calculate(original.toString(), copied.toString());
    long elapsedMillis = (System.nanoTime() - start) / 1000000L;
    assertTrue(rate > 0.5, "大文件重复率异常: " + rate);
    assertTrue(elapsedMillis < 5000L, "耗时 " + elapsedMillis + " ms,超过 5 秒限制");
}
把评测的时限要求直接写进单元测试,避免以后改代码时不小心把性能改回去。
(4)倒排索引扩容
@Test
@DisplayName("字组数量超过初始容量时能够自动扩容并保持查询正确")
void growsWhenManyGramsAreInserted() {
    NGramIndex index = new NGramIndex();
    for (int i = 0; i < 20000; i++) {
        int first = 0x4E00 + i / 128;
        int second = 0x4E00 + i % 128;
        index.add(i % 500, new int[] {first, second});
    }
    assertEquals(20000, index.gramCount());
    int probe = 123;
    int[] hit = index.lookup(0x4E00 + probe / 128, 0x4E00 + probe % 128);
    assertEquals(1, hit.length);
    assertEquals(probe % 500, hit[0]);
}
自己手写的哈希表必须验证扩容逻辑,否则「字组一多就查不到」这种 bug 会非常隐蔽。
(5)跨句边界:删改之后抄袭句横跨原文两句话
@Test
@DisplayName("抄袭句跨越原文句边界时仍然能被匹配")
void sentenceSpanningOriginalBoundaryIsMatched() {
    // 抄袭版把原文第一句的后半段和第二句的前半段拼成了一句,
    // 单句比对只能匹配到一部分,必须把相邻原文句合并起来才能完全匹配
    String original = "今天天气很好,我们一起去公园散步吧。明天要下雨,记得带伞出门。";
    String copied = "一起去公园散步吧明天要下雨";
    double rate = calculator.calculate(original, copied);
    assertTrue(rate > 0.9, "实际重复率: " + rate);
}
这个用例是在课堂数据上发现 orig_0.8_del.txt 被低估之后补写的:
它把「跨句拼接」这个场景压缩成三行数据,用来自动守住 3.5 节那次修复,避免以后改代码时又退化回去。
4.3 测试覆盖率
一键运行 run-tests.bat 会执行全部测试并生成 JaCoCo 覆盖率报告:
| 指标 | 覆盖情况 |
|---|---|
| 指令覆盖率 | 93.24%(1930 / 2070) |
| 分支覆盖率 | 87.79%(230 / 262) |
| 行覆盖率 | 94.02%(409 / 435) |
| 方法覆盖率 | 98.04%(50 / 51) |
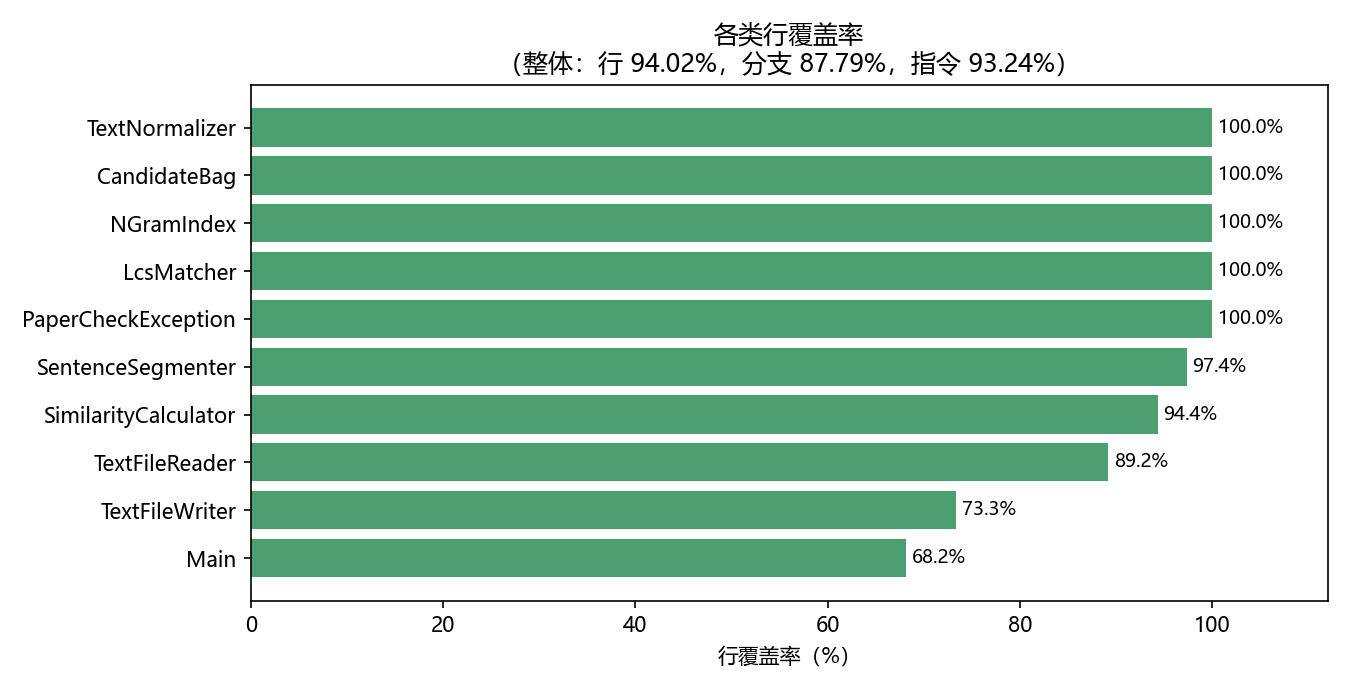
完整的 JaCoCo 报告(含每个类的逐行标色)已经提交到仓库:
https://github.com/ZYY190/PaperCheck/tree/main/3124004450/docs/coverage
写作提示:把本地
3124004450/docs/coverage/index.html用浏览器打开截图,
替换掉本节的图片即可得到评测要求的「覆盖率截图」。
4.4 对测试设计的一点评价
这套用例能覆盖正常流程、等价类与主要边界,也能通过覆盖率指标反映代码被执行的情况。
但它有一个明显短板:没有对「准确率」做严格的回归测试。
0.82、0.94 这些期望值都是手算或者与暴力解对照得出的,
如果算法内部改动较大,这类断言不一定能及时报警。
要补上这一环,需要准备一批人工标注过重复率的语料,做成数据集级别的回归测试——
这也是我在参考其他查重实现时体会到的一点:查重系统的正确性最终要靠数据说话,而不是靠几个手工样例。
五、计算模块部分异常处理说明
5.1 设计目标
评测规则里写明「发生异常退出扣分」,所以异常设计的目标有两条:
- 可预期的错误不崩溃:所有可以预见的失败(参数不对、文件不在、编码不对)都要以
「打印一行人能看懂的提示 + 返回非零退出码」的方式收场,绝不抛出未捕获异常; - 不可预期的错误有兜底:在
Main.run里兜住RuntimeException,
保证即使出现意外也不会把 Java 堆栈糊到评测程序脸上。
所有可预期错误统一用自定义受检异常 PaperCheckException 表达,并携带错误码,便于精确定位。
| 错误码 | 含义 | 退出码 |
|---|---|---|
| E001 | 命令行参数个数不正确 | 2 |
| E002 | 输入文件不存在 | 3 |
| E003 | 路径指向的不是普通文件 | 3 |
| E004 | 文件读写失败(权限不足、被占用) | 3 |
| E005 | 文件编码无法识别 | 3 |
| E006 | 文件体积超过上限(64 MB) | 3 |
| E007 | 答案文件路径非法或不可写 | 3 |
5.2 每种异常的单元测试
E001 参数个数不正确
@Test
@DisplayName("参数个数不对时返回退出码 2 并打印用法")
void wrongArgumentCountReturnsUsageError() {
    ByteArrayOutputStream err = new ByteArrayOutputStream();
    int exitCode = new Main().run(new String[] {"a.txt"},
            new PrintStream(new ByteArrayOutputStream()), new PrintStream(err));
    assertEquals(2, exitCode);
    assertTrue(err.toString().contains(Main.USAGE));
}
对应场景:同学把路径写漏了,或者多敲了一个参数。程序不猜、不崩,直接给出正确用法。
E002 输入文件不存在
@Test
@DisplayName("文件不存在时抛出 E002")
void missingFileThrowsFileNotFound() {
    PaperCheckException exception = assertThrows(PaperCheckException.class,
            () -> TextFileReader.read(tempDir.resolve("not-exist.txt").toString(), "原文文件"));
    assertEquals(PaperCheckException.CODE_FILE_NOT_FOUND, exception.getCode());
}
对应场景:路径拼错、文件被移动或删除、传了空字符串路径。
E003 路径指向目录
@Test
@DisplayName("路径指向目录时抛出 E003")
void directoryThrowsNotAFile() {
    PaperCheckException exception = assertThrows(PaperCheckException.class,
            () -> TextFileReader.read(tempDir.toString(), "原文文件"));
    assertEquals(PaperCheckException.CODE_NOT_A_FILE, exception.getCode());
}
对应场景:把文件夹路径当成文件路径传进来。这时如果直接读,会抛出含义不明的 IOException。
E004 文件读写失败
对应场景:文件被别的程序独占打开、没有读权限、磁盘只读。
这类错误无法用单元测试稳定构造,因此通过读取失败时抛出 E004 的分支覆盖,
并在提示中写明「可能被其它程序占用」。
E005 编码无法识别
@Test
@DisplayName("既不是 UTF-8 也不是 GBK 的字节流抛出 E005")
void unknownEncodingThrows() throws Exception {
    Path file = tempDir.resolve("broken.txt");
    Files.write(file, new byte[] {(byte) 0x80, (byte) 0x80, (byte) 0xFE});
    PaperCheckException exception = assertThrows(PaperCheckException.class,
            () -> TextFileReader.read(file.toString(), "原文文件"));
    assertEquals(PaperCheckException.CODE_ENCODING, exception.getCode());
}
对应场景:文件是某种既非 UTF-8 也非 GBK 的编码(例如 UTF-16),
或者文件本来就不是文本。这里刻意使用严格解码而不是「遇到非法字节就替换成问号」,
因为把乱码当成正常文本参与查重会算出毫无意义的结果。
E006 文件体积超限
@Test
@DisplayName("文件超过容量上限时抛出 E006,避免内存溢出")
void tooLargeFileThrows() throws Exception {
    Path file = tempDir.resolve("huge.txt");
    // 直接把文件长度撑大,不实际占用磁盘空间
    try (RandomAccessFile handle = new RandomAccessFile(file.toFile(), "rw")) {
        handle.setLength(TextFileReader.MAX_FILE_BYTES + 1);
    }
    PaperCheckException exception = assertThrows(PaperCheckException.class,
            () -> TextFileReader.read(file.toString(), "原文文件"));
    assertEquals(PaperCheckException.CODE_FILE_TOO_LARGE, exception.getCode());
}
对应场景:误传了一个几百 MB 的日志文件。这条约束是对「内存不超过 2048 MB」的直接保护——
与其让 JVM 申请内存失败后崩溃,不如提前拒绝并说明原因。
E007 答案文件路径非法
@Test
@DisplayName("答案路径不可写时返回退出码 3 并给出 E007")
void unwritableAnswerPathReturnsBusinessError() throws IOException {
    int exitCode = new Main().run(new String[] {
            original.toString(), copied.toString(), tempDir.toString()},
            new PrintStream(new ByteArrayOutputStream()), new PrintStream(err));
    assertEquals(3, exitCode);
    assertTrue(err.toString().contains(PaperCheckException.CODE_OUTPUT_INVALID));
}
对应场景:答案路径写成了一个目录,或者所在目录没有写权限。
另外,如果答案是深层路径而父目录不存在,程序会自动创建目录——
这属于「能帮就帮」的情形,不算错误。
5.3 一个刻意的设计取舍
空内容不算错误:原文为空、抄袭版为空、或者只有标点空白时,程序输出 0.00 而不是报错。
理由是「没有任何有效内容」在业务上的含义就是「没有重复」,
把它当成异常反而会让评测里正常的空文件测试点失败。
六、总结
这次作业最大的收获不是「写出了一个查重程序」,而是一次把性能优化做错的经历。
第一轮优化把 100 万字符从 6.6 秒压到 0.46 秒,看起来非常成功;
如果没有顺手对照一下重复率,很可能就交上去了。补写暴力精确解做基线之后才发现,
程序变快是因为它开始算错——候选被按编号截断,上界也不再成立。
修正之后耗时回到 0.93 秒,但结果终于是对的。
由此得到的经验有两条:
- 优化之前先建立正确性基线。有对照物,才知道自己是变快了还是变错了。
- 剪枝的上界必须能证明。凭经验拍的阈值,数据一换就会失效;
而从问题性质推导出来的上界,无论数据怎么变都成立。
代码仓库:https://github.com/ZYY190/PaperCheck
可执行程序:https://github.com/ZYY190/PaperCheck/releases/tag/v1.0

 浙公网安备 33010602011771号