mysql 之索引、视图、触发器、存储过程、函数、事物、数据库锁
索引
http://www.cnblogs.com/zy0517/articles/8066477.html
索引相当于图书的目录,可以帮助用户快速的找到需要的内容.
数据库利用各种各样的快速定位技术,能够大大提高查询效率。特别是当数据量非常大,查询涉及多个表时,使用索引往往能使查询速度加快成千上万倍.
索引好处:可以提高查询效率,而且是数据量越大效果越明显.
索引缺点:添加数据和删除数据效率低
索引类型:
1.HASH :hash就是一种(key=>value)形式的键值对,允许多个key对应相同的value,但不允许一个key对应多个value,为某一列或几列建立hash索引,就会利用这一列或几列的值通过一定的算法计算出一个hash值,对应一行或几行数据. hash索引可以一次定位,不需要像树形索引那样逐层查找,因此具有极高的效率.
假设创建如下一个表:
CREATE TABLE testhash (
fname VARCHAR(50) NOT NULL,
lname VARCHAR(50) NOT NULL,
KEY USING HASH(fname)
) ENGINE=MEMORY;
包含的数据如下:
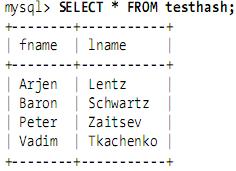
假设索引使用hash函数f( ),如下:
|
f('Arjen') = 2323 f('Baron') = 7437 f('Peter') = 8784 f('Vadim') = 2458 |
此时,索引的结构大概如下:
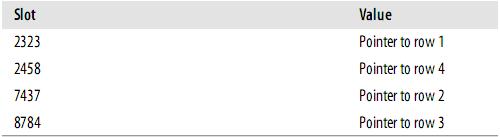
Slots是有序的,但是记录不是有序的。当你执行
mysql> SELECT lname FROM testhash WHERE fname='Peter';
MySQL会计算’Peter’的hash值,然后通过它来查询索引的行指针。因为f('Peter') = 8784,MySQL会在索引中查找8784,得到指向记录3的指针。
因为索引自己仅仅存储很短的值,所以,索引非常紧凑。Hash值不取决于列的数据类型,一个TINYINT列的索引与一个长字符串列的索引一样大。
2.BTREE: 就是一种将索引值按一定的算法,存入一个树形的数据结构中. 如二叉树一样

索引分类:
1. 普通索引
2.唯一索引
3.主键索引
4.组合索引
5. FULLTEXT:全文索引
目前只有MyISAM引擎支持。而且只有 CHAR、VARCHAR ,TEXT 列上可以创建全文索引.
FULLTEXT索引是按照分词原理建立索引的。西文中,大部分为字母文字,分词可以很方便的按照空格进行分割。但很明显,中文不能按照这种方式进行分词。那又怎么办呢?这个向大家介绍一个Mysql的中文分词插件Mysqlcft,有了它,就可以对中文进行分词,想了解的同学请移步Mysqlcft,当然还有其他的分词插件可以使用。
创建 普通索引
1 CREATE index aaa on ren(p_name)
2 添加普通索引
3 注意:index :表示索引 aaa:表示索引的别名, on:表示给哪个表添加索引  ren:表名称,(添加索引的字段,多个字段以","间隔)
创建 唯一索引
1 CREATE UNIQUE index age on ren(p_age)
2 添加唯一索引
3 注意:unique index :表示唯一索引 aaa:表示索引的别名, on:表示给哪个表添加索引  ren:表名称,(添加索引的字段,多个字段以","间隔)
创建 主键索引
1 alter table 表名 add primary key(id);
2 添加之间索引
3 注意:主键索引只能有一个
创建 组合索引
1 create index id_name on ren (id,name)
2 添加组合索引
3 注意: 如上创建组合索引之后,查询:
4 id and name-- 使用索引
5 id                -- 使用索引
6 name           -- 不使用索引
视图
视图是一个虚拟表,其内容由查询定义。同真实的表一样,视图包含一系列带有名称的列和行数据。但是,视图并不在数据库中以存储的数据值集形式存在。行和列数据来自定义视图的查询所引用的表,并且在引用视图时动态生成。
视图好处:
a、简化表之间的联结(把联结写在select中);
b、适当的利用视图可以更清晰地表达查询
c、过滤不想要的数据(select部分)视图能够对机密数据提供安全保护
d、使用视图计算字段值,如汇总这样的值。


#两张有关系的表
mysql> select * from course;
+-----+--------+------------+
| cid | cname  | teacher_id |
+-----+--------+------------+
|   1 | 生物   |          1 |
|   2 | 物理   |          2 |
|   3 | 体育   |          3 |
|   4 | 美术   |          2 |
+-----+--------+------------+
4 rows in set (0.00 sec)

mysql> select * from teacher;
+-----+-----------------+
| tid | tname           |
+-----+-----------------+
|   1 | 张磊老师        |
|   2 | 李平老师        |
|   3 | 刘海燕老师      |
|   4 | 朱云海老师      |
|   5 | 李杰老师        |
+-----+-----------------+
5 rows in set (0.00 sec)

#查询李平老师教授的课程名
mysql> select cname from course where teacher_id = (select tid from teacher where tname='李平老师');
+--------+
| cname  |
+--------+
| 物理   |
| 美术   |
+--------+
2 rows in set (0.00 sec)

#子查询出临时表,作为teacher_id等判断依据
select tid from teacher where tname='李平老师'
创建视图
#语法:CREATE VIEW 视图名称 AS  SQL语句
create view teacher_view as select tid from teacher where tname='李平老师';

#于是查询李平老师教授的课程名的sql可以改写为
mysql> select cname from course where teacher_id = (select tid from teacher_view);
+--------+
| cname  |
+--------+
| 物理   |
| 美术   |
+--------+
2 rows in set (0.00 sec)

#!!!注意注意注意:
#1. 使用视图以后就无需每次都重写子查询的sql,但是这么效率并不高,还不如我们写子查询的效率高

#2. 而且有一个致命的问题:视图是存放到数据库里的,如果我们程序中的sql过分依赖于数据库中存放的视图,那么意味着,一旦sql需要修改且涉及到视图的部分,则必须去数据库中进行修改,而通常在公司中数据库有专门的DBA负责,你要想完成修改,必须付出大量的沟通成本DBA可能才会帮你完成修改,极其地不方便
使用视图
#修改视图,原始表也跟着改
mysql> select * from course;
+-----+--------+------------+
| cid | cname  | teacher_id |
+-----+--------+------------+
|   1 | 生物   |          1 |
|   2 | 物理   |          2 |
|   3 | 体育   |          3 |
|   4 | 美术   |          2 |
+-----+--------+------------+
4 rows in set (0.00 sec)

mysql> create view course_view as select * from course; #创建表course的视图
Query OK, 0 rows affected (0.52 sec)

mysql> select * from course_view;
+-----+--------+------------+
| cid | cname  | teacher_id |
+-----+--------+------------+
|   1 | 生物   |          1 |
|   2 | 物理   |          2 |
|   3 | 体育   |          3 |
|   4 | 美术   |          2 |
+-----+--------+------------+
4 rows in set (0.00 sec)

mysql> update course_view set cname='xxx'; #更新视图中的数据
Query OK, 4 rows affected (0.04 sec)
Rows matched: 4  Changed: 4  Warnings: 0

mysql> insert into course_view values(5,'yyy',2); #往视图中插入数据
Query OK, 1 row affected (0.03 sec)

mysql> select * from course; #发现原始表的记录也跟着修改了
+-----+-------+------------+
| cid | cname | teacher_id |
+-----+-------+------------+
|   1 | xxx   |          1 |
|   2 | xxx   |          2 |
|   3 | xxx   |          3 |
|   4 | xxx   |          2 |
|   5 | yyy   |          2 |
+-----+-------+------------+
5 rows in set (0.00 sec)
我们不应该修改视图中的记录,而且在涉及多个表的情况下是根本无法修改视图中的记录的,如下图

修改视图
语法:ALTER VIEW 视图名称 AS SQL语句
mysql> alter view teacher_view as select * from course where cid>3;
Query OK, 0 rows affected (0.04 sec)

mysql> select * from teacher_view;
+-----+-------+------------+
| cid | cname | teacher_id |
+-----+-------+------------+
|   4 | xxx   |          2 |
|   5 | yyy   |          2 |
+-----+-------+------------+
2 rows in set (0.00 sec)
删除视图
语法:DROP VIEW 视图名称

DROP VIEW teacher_view
触发器--trigger
使用触发器可以定制用户对表进行增 、删、改操作是前后的行为,注意:没有查询
触发器(trigger):监视某种情况,并触发某种操作。
触发器创建语法四要素:1.监视地点(table)
2.监视事件(insert/update/delete)
3.触发时间(after/before)
4.触发事件(insert/update/delete)
1.创建触发器语法
 1 create trigger triggerName  after/before  insert/update/delete
 2     on 表名 for each row #这句话是固定的
 3
 4 begin
 5
 6     #需要执行的sql语句
 7
 8 end
 9
10 注意1:after/before: 只能选一个 ,after 表示 后置触发, before 表示前置触发
11 注意2:insert/update/delete:只能选一个
创建两张表
|
#商品表 create table goods( id int primary key auto_increment, name varchar(20), num int ); |
#订单表 create table order_table( oid int primary key auto_increment, gid int, much int
); |
添加3条商品数据
1 insert into g(name,num) values('商品1',10),('商品2',10),('商品3',10);
如果我们在没使用触发器之前:假设我们现在卖了3个商品1,我们需要做两件事
1.往订单表插入一条记录
1 insert into o(gid,much) values(1,3);
2.更新商品表商品1的剩余数量
update g set num=num-3 where id=1;
现在,我们来创建一个触发器:
1 create trigger tg1 after insert on  order_table for each row
2
3 begin
4
5     update goods set num = num -3 where id = 1;
6
7 end
这时候我们只要执行:
1 insert into order_table(gid,much) values(1,3);
会发现商品1的数量变为7了,说明在我们插入一条订单的时候,
触发器自动帮我们做了更新操作。
但现在会有一个问题,因为我们触发器里面num和id都是写死的,所以不管我们买哪个商品,最终更新的都是商品1的数量。比如:我们往订单表再插入一条记录:
insert into o(gid,much) values(2,3);
执行完后会发现商品1的数量变4了,而商品2的数量没变,这样显然不是我们想要的结果。我们需要改改我们之前创建的触发器。
我们如何在触发器引用行的值,也就是说我们要得到我们新插入的订单记录中的gid或much的值。
对于insert而言,新插入的行用new来表示,行中的每一列的值用new.列名来表示。
所以现在我们可以这样来改我们的触发器:
create trigger tg2 afert insert on order_table for each row
begin

 update goods set num = num-new.much  where id = new.gid;

end
第二个触发器创建完毕,我们先把第一个触发器删掉
1 drop trigger tg1;再来测试一下,插入一条订单记录:
1 insert into order_table(gid,much) values(2,3)执行完发现商品2的数量变为7了,现在就对了。
现在还存在两种情况:
1.当用户撤销一个订单的时候,我们这边直接删除一个订单,我们是不是需要把对应的商品数量再加回去呢?
对于delete而言:原本有一行,后来被删除,想引用被删除的这一行,用old来表示,old.列名可以引用被删除的行的值。
那我们的触发器就该这样写:
create trigger tg3 afert delete  on order_table for each row
bigen

    update goods set num = num + old.much where id = old.gid;(注意这边的变化)
end
4.存储过程
MySQL数据库在5.0版本后开始支持存储过程,那么什么是存储过程呢?怎么创建、查看和删除存储过程呢?存储过程有什么优点?
什么是存储过程:类似于函数(方法),简单的说存储过程是为了完成某个数据库中的特定功能而编写的语句集合,该语句集包括SQL语句(对数据的增删改查)、条件语句和循环语句等。
存储过程包含了一系列可执行的sql语句,存储过程存放于MySQL中,通过调用它的名字可以执行其内部的一堆sql
使用存储过程的优点:
1.用于替代程序写的SQL语句,实现程序与sql解耦
2.基于网络传输,传别名的数据量小,而直接传SQL数据量大
使用 存储过程的缺点:
1.程序员扩展功能不方便
补充:程序与数据库结合使用的三种方式
#方式一:
    MySQL:存储过程
    程序:调用存储过程

#方式二:
    MySQL:
    程序:纯SQL语句

#方式三:
    MySQL:
    程序:类和对象,即ORM(本质还是纯SQL语句)
查看现有的存储过程
show procedure status;
创建简单存储过程(无参)
delimiter //
create procedure p1()
BEGIN
    select * from blog;
    INSERT into blog(name,sub_time) values("xxx",now());
END //
delimiter ;

#在mysql中调用
call p1()

#在python中基于pymysql调用
cursor.callproc('p1')
print(cursor.fetchall())
创建存储过程(有参)
对于存储过程,可以接收参数,其参数有三类:

in          仅用于传入参数用
out        仅用于返回值用
inout     既可以传入又可以当作返回值
delimiter //
create procedure p2(
    in n1 int,
    in n2 int
)
BEGIN

    select * from blog where id > n1;
END //
delimiter ;

#在mysql中调用
call p2(3,2)

#在python中基于pymysql调用
cursor.callproc('p2',(3,2))
print(cursor.fetchall())
delimiter //
create procedure p3(
    in n1 int,
    out res int
)
BEGIN
    select * from blog where id > n1;
    set res = 1;
END //
delimiter ;

#在mysql中调用
set @res=0; #0代表假(执行失败),1代表真(执行成功)
call p3(3,@res);
select @res;

#在python中基于pymysql调用
cursor.callproc('p3',(3,0)) #0相当于set @res=0
print(cursor.fetchall()) #查询select的查询结果

cursor.execute('select @_p3_0,@_p3_1;') #@p3_0代表第一个参数,@p3_1代表第二个参数,即返回值
print(cursor.fetchall())
delimiter //
create procedure p4(
    inout n1 int
)
BEGIN
    select * from blog where id > n1;
    set n1 = 1;
END //
delimiter ;

#在mysql中调用
set @x=3;
call p4(@x);
select @x;


#在python中基于pymysql调用
cursor.callproc('p4',(3,))
print(cursor.fetchall()) #查询select的查询结果

cursor.execute('select @_p4_0;')
print(cursor.fetchall())
1 1#体会封装
2 create procedure p1 ()
3 begin
4    select * from account;
5
6 end
1 2#SQL 体会参数
2 create procedure p2(in m int)
3 begin
4   select * from account where money > m;
5 end
 1 #SQL 体会控制
 2 create procedure p3(in x int,in c char(1))
 3
 4 begin
 5
 6     if c ='d' then
 7
 8         select * from account where money >x;
 9
10    else
11
12          select * from account  where money <x;
13   end if;
14 end
#体会循环:计算1-100累加的和,并且返回计算结果.
create procedure p4(inout n int)
    begin
      DECLARE sum int default 0; -- 设置总和变量,并且指定初始值0
      declare i int; -- 声明变量
      set i = 0;    -- 通过set为变量设置值
      while i<=n DO  -- 开始循环
            set sum = sum +i;
            set i = i+1;
          end while; -- 结束循环

      select sum; -- 提供结果

          set n = sum;--将计算结果提供给 输出变量 n;

      end;

  -- 调用:
       set @n = 100;
       call p4(@n);
       select @n;
执行存储过程
-- 无参数
call proc_name()

-- 有参数,全in
call proc_name(1,2)

-- 有参数,有in,out,inout
set @t1=0;
set @t2=3;
call proc_name(1,2,@t1,@t2)

执行存储过程
#!/usr/bin/env python
# -*- coding:utf-8 -*-
import pymysql

conn = pymysql.connect(host='127.0.0.1', port=3306, user='root', passwd='123', db='t1')
cursor = conn.cursor(cursor=pymysql.cursors.DictCursor)
# 执行存储过程
cursor.callproc('p1', args=(1, 22, 3, 4))
# 获取执行完存储的参数
cursor.execute("select @_p1_0,@_p1_1,@_p1_2,@_p1_3")
result = cursor.fetchall()

conn.commit()
cursor.close()
conn.close()


print(result)
删除存储过程
drop procedure 存储过程名称;
调用存储过程
call 存储过程名称(参数1 参数1类型,参数2 参数2类型);
函数
MySQL中提供的内置函数
CHAR_LENGTH(str)
        返回值为字符串str 的长度,长度的单位为字符。一个多字节字符算作一个单字符。
        对于一个包含五个二字节字符集, LENGTH()返回值为 10, 而CHAR_LENGTH()的返回值为5。

    CONCAT(str1,str2,...)
        字符串拼接
        如有任何一个参数为NULL ,则返回值为 NULL。
    CONCAT_WS(separator,str1,str2,...)
        字符串拼接(自定义连接符)
        CONCAT_WS()不会忽略任何空字符串。 (然而会忽略所有的 NULL)。

    CONV(N,from_base,to_base)
        进制转换
        例如:
            SELECT CONV('a',16,2); 表示将 a 由16进制转换为2进制字符串表示

    FORMAT(X,D)
        将数字X 的格式写为'#,###,###.##',以四舍五入的方式保留小数点后 D 位, 并将结果以字符串的形式返回。若  D 为 0, 则返回结果不带有小数点,或不含小数部分。
        例如:
            SELECT FORMAT(12332.1,4); 结果为: '12,332.1000'
    INSERT(str,pos,len,newstr)
        在str的指定位置插入字符串
            pos:要替换位置其实位置
            len:替换的长度
            newstr:新字符串
        特别的:
            如果pos超过原字符串长度,则返回原字符串
            如果len超过原字符串长度,则由新字符串完全替换
    INSTR(str,substr)
        返回字符串 str 中子字符串的第一个出现位置。

    LEFT(str,len)
        返回字符串str 从开始的len位置的子序列字符。

    LOWER(str)
        变小写

    UPPER(str)
        变大写

    LTRIM(str)
        返回字符串 str ,其引导空格字符被删除。
    RTRIM(str)
        返回字符串 str ,结尾空格字符被删去。
    SUBSTRING(str,pos,len)
        获取字符串子序列

    LOCATE(substr,str,pos)
        获取子序列索引位置

    REPEAT(str,count)
        返回一个由重复的字符串str 组成的字符串,字符串str的数目等于count 。
        若 count <= 0,则返回一个空字符串。
        若str 或 count 为 NULL,则返回 NULL 。
    REPLACE(str,from_str,to_str)
        返回字符串str 以及所有被字符串to_str替代的字符串from_str 。
    REVERSE(str)
        返回字符串 str ,顺序和字符顺序相反。
    RIGHT(str,len)
        从字符串str 开始,返回从后边开始len个字符组成的子序列

    SPACE(N)
        返回一个由N空格组成的字符串。

    SUBSTRING(str,pos) , SUBSTRING(str FROM pos) SUBSTRING(str,pos,len) , SUBSTRING(str FROM pos FOR len)
        不带有len 参数的格式从字符串str返回一个子字符串,起始于位置 pos。带有len参数的格式从字符串str返回一个长度同len字符相同的子字符串,起始于位置 pos。 使用 FROM的格式为标准 SQL 语法。也可能对pos使用一个负值。假若这样,则子字符串的位置起始于字符串结尾的pos 字符,而不是字符串的开头位置。在以下格式的函数中可以对pos 使用一个负值。

        mysql> SELECT SUBSTRING('Quadratically',5);
            -> 'ratically'

        mysql> SELECT SUBSTRING('foobarbar' FROM 4);
            -> 'barbar'

        mysql> SELECT SUBSTRING('Quadratically',5,6);
            -> 'ratica'

        mysql> SELECT SUBSTRING('Sakila', -3);
            -> 'ila'

        mysql> SELECT SUBSTRING('Sakila', -5, 3);
            -> 'aki'

        mysql> SELECT SUBSTRING('Sakila' FROM -4 FOR 2);
            -> 'ki'

    TRIM([{BOTH | LEADING | TRAILING} [remstr] FROM] str) TRIM(remstr FROM] str)
        返回字符串 str , 其中所有remstr 前缀和/或后缀都已被删除。若分类符BOTH、LEADIN或TRAILING中没有一个是给定的,则假设为BOTH 。 remstr 为可选项,在未指定情况下,可删除空格。

        mysql> SELECT TRIM('  bar   ');
                -> 'bar'

        mysql> SELECT TRIM(LEADING 'x' FROM 'xxxbarxxx');
                -> 'barxxx'

        mysql> SELECT TRIM(BOTH 'x' FROM 'xxxbarxxx');
                -> 'bar'

        mysql> SELECT TRIM(TRAILING 'xyz' FROM 'barxxyz');
                -> 'barx'

部分内置函数
#1 基本使用
mysql> SELECT DATE_FORMAT('2009-10-04 22:23:00', '%W %M %Y');
        -> 'Sunday October 2009'
mysql> SELECT DATE_FORMAT('2007-10-04 22:23:00', '%H:%i:%s');
        -> '22:23:00'
mysql> SELECT DATE_FORMAT('1900-10-04 22:23:00',
    ->                 '%D %y %a %d %m %b %j');
        -> '4th 00 Thu 04 10 Oct 277'
mysql> SELECT DATE_FORMAT('1997-10-04 22:23:00',
    ->                 '%H %k %I %r %T %S %w');
        -> '22 22 10 10:23:00 PM 22:23:00 00 6'
mysql> SELECT DATE_FORMAT('1999-01-01', '%X %V');
        -> '1998 52'
mysql> SELECT DATE_FORMAT('2006-06-00', '%d');
        -> '00'


#2 准备表和记录
CREATE TABLE blog (
    id INT PRIMARY KEY auto_increment,
    NAME CHAR (32),
    sub_time datetime
);

INSERT INTO blog (NAME, sub_time)
VALUES
    ('第1篇','2015-03-01 11:31:21'),
    ('第2篇','2015-03-11 16:31:21'),
    ('第3篇','2016-07-01 10:21:31'),
    ('第4篇','2016-07-22 09:23:21'),
    ('第5篇','2016-07-23 10:11:11'),
    ('第6篇','2016-07-25 11:21:31'),
    ('第7篇','2017-03-01 15:33:21'),
    ('第8篇','2017-03-01 17:32:21'),
    ('第9篇','2017-03-01 18:31:21');

#3. 提取sub_time字段的值,按照格式后的结果即"年月"来分组
SELECT DATE_FORMAT(sub_time,'%Y-%m'),COUNT(1) FROM blog GROUP BY DATE_FORMAT(sub_time,'%Y-%m');

#结果
+-------------------------------+----------+
| DATE_FORMAT(sub_time,'%Y-%m') | COUNT(1) |
+-------------------------------+----------+
| 2015-03                       |        2 |
| 2016-07                       |        4 |
| 2017-03                       |        3 |
+-------------------------------+----------+
3 rows in set (0.00 sec)
自定义函数
注意:函数中不要写SQL语句(否则会报错),函数仅仅只是一个功能,是一个在sql中被应用的功能
若是要在begin.....end.....中写sql,请用储存过程
delimiter //
create function f1(
    i1 int,
    i2 int)
returns int
BEGIN
    declare num int;
    set num = i1 + i2;
    return(num);
END //
delimiter ;
delimiter //
create function f5(
    i int
)
returns int
begin
    declare res int default 0;
    if i = 10 then
        set res=100;
    elseif i = 20 then
        set res=200;
    elseif i = 30 then
        set res=300;
    else
        set res=400;
    end if;
    return res;
end //
delimiter ;
删除函数
drop function func_name;
执行函数
-- 获取返回值
select upper('egon') into @res;
select @res


-- 在查询中使用
select f1(11,nid) ,name from tb2;
事物
1. 什么是事务
事务是应用程序中一系列严密的操作,所有操作必须成功完成,否则在每个操作中所作的所有更改都会被撤消。也就是事务具有原子性,一个事务中的一系列的操作要么全部成功,要么一个都不做。
事务的结束有两种,当事务中的所以步骤全部成功执行时,事务提交。如果其中一个步骤失败,将发生回滚操作,撤消撤消之前到事务开始时的所以操作。
总结:事物就是一组操作,要么全部完成,要么全部失败!
2.事物特性 ACID
事务具有四个特征:原子性( Atomicity )、一致性( Consistency )、隔离性( Isolation )和持续性( Durability )。这四个特性简称为 ACID 特性。
1 、原子性 (事物内的操作,要么全部成功,要么全部失败)
事务是数据库的逻辑工作单位,事务中包含的各操作要么都做,要么都不做
2 、一致性 (事物之前之后,前后数据的一致性)
事务执行的结果必须是使数据库从一个一致性状态变到另一个一致性状态。因此当数据库只包含成功事务提交的结果时,就说数据库处于一致性状态 如果数据库系统 运行中发生故障,有些事务尚未完成就被迫中断,这些未完成事务对数据库所做的修改有一部分已写入物理数据库,这时数据库就处于一种不正确的状态,或者说是 不一致的状态。
3 、隔离性(多个事物时,相互不能干扰)
一个事务的执行不能被其它事务干扰。即一个事务内部的操作及使用的数据对其它并发事务是隔离的,并发执行的各个事务之间不能互相干扰。
4 、持续性(一旦事物提交(commit)之后,是不可回滚的)
也称永久性,指一个事务一旦提交,它对数据库中的数据的改变就应该是永久性的。接下来的其它操作或故障不应该对其执行结果有任何影响。
3.例子: 现实中的转账操作:
- 开启事物 start transaction
- 提交事物 commit
- 回滚事物 rollback
创建表
create table account(
    id int(50) not null auto_increment primary key,
  a_name VARCHAR(50) not null,
    money DOUBLE(5,2) not NULL
);
插入数据
insert into account (a_name,money) values('鲁班',159.11),('后羿',333);
执行转账
start transaction; -- 开启事物
 --  执行sql语句操作
 update account set money = money - 500 where id ='1';
 update account set money = money+500 where id = '2';

commit;  -- 手动提交事物

rollback; -- 回滚事物

--  查看结果
select * from account;
数据库锁
锁的基本概念
当并发事务同时访问一个资源时,有可能导致数据不一致,因此需要一种机制来将数据访问顺序化,以保证数据库数据的一致性。
锁的基本类型
数据库上的操作可以归纳为两种:读和写。
多个事务同时读取一个对象的时候,是不会有冲突的。同时读和写,或者同时写才会产生冲突。因此为了提高数据库的并发性能,通常会定义两种锁:共享锁和排它锁。
1 共享锁(Shared Lock,也叫S锁)
共享锁(S)表示对数据进行读操作。因此多个事务可以同时为一个对象加共享锁。(如果试衣间的门还没被锁上,顾客都能够同时进去参观)
2 排他锁(Exclusive Lock,也叫X锁)
排他锁也叫写锁。
排他锁表示对数据进行写操作。如果一个事务对对象加了排他锁,其他事务就不能再给它加任何锁了。(某个顾客把试衣间从里面反锁了,其他顾客想要使用这个试衣间,就只有等待锁从里面给打开了)
开发中常见的两种锁:
1悲观锁(Pessimistic Lock), 顾名思义,就是很悲观,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会block(阻塞)直到它拿到锁。传统的关系型数据库里边就用到了很多这种锁机制.
注:要使用悲观锁,我们必须关闭mysql数据库的自动提交属性,因为MySQL默认使用autocommit模式,也就是说,当你执行一个更新操作后,MySQL会立刻将结果进行提交。关闭自动提交命令为:set autocommit=0;
设置完autocommit后,我们就可以执行我们的正常业务了。具体如下:
//0.开始事务
start transaction;

//1.查询出数据信息
select * from ren where p_id='p001' for update;

//2.修改当前人员信息
 update ren set p_name='张1丰' where p_id='p001';

//3. 提交事务
commit;
在另外的查询页面执行:
select * from ren where p_id='p001' for update;
会发现当前查询会进入到等待状态,不会显示出数据,当上面的sql执行完毕提交事物后,当前sql才会显示结果.
上面的第一步我们执行了一次查询操作:select * from ren where p_id='p001' for update;
与普通查询不一样的是,我们使用了select…for update的方式,这样就通过数据库实现了悲观锁。此时在ren表中,id为p001的 那条数据就被我们锁定了,其它的事务必须等本注:需要注意的是,在事务中,只有SELECT ... FOR UPDATE 或LOCK IN SHARE MODE(共享锁) 同一笔数据时会等待其它事务结束后才执行,一般SELECT ... 则不受此影响。拿上面的实例来说,当我执行select * from ren where p_id='p001' for update;后。我在另外的事务中如果再次执行select * from ren where p_id='p001' for update;则第二个事务会一直等待第一个事务的提交,此时第二个查询处于阻塞的状态,但是如果我是在第二个事务中执行select * from ren where p_id='p001';则能正常查询出数据,不会受第一个事务的影响。
补充:MySQL select…for update的Row Lock与Table Lock
上面我们提到,使用select…for update会把数据给锁住,不过我们需要注意一些锁的级别,MySQL InnoDB默认Row-Level Lock,所以只有「明确」地指定主键,MySQL 才会执行Row lock (只锁住被选取的数据) ,否则MySQL 将会执行Table Lock (将整个数据表单给锁住)。
注意: 悲观锁的确保了数据的安全性,在数据被操作的时候锁定数据不被访问,但是这样会带来很大的性能问题。因此悲观锁在实际开发中使用是相对比较少的。
2 乐观锁(Optimistic Lock), 顾名思义,就是很乐观,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库如果提供类似于write_condition机制的其实都是提供的乐观锁。
使用乐观锁的两种方式:
1.使用数据版本(Version)记录机制实现,这是乐观锁最常用的一种实现 方式。何谓数据版本?即为数据增加一个版本标识,一般是通过为数据库表增加一个数字类型的 “version” 字段来实现。当读取数据时,将version字段的值一同读出,数据每更新一次,对此version值加一。当我们提交更新的时候,判断数据库表对应记录 的当前版本信息与第一次取出来的version值进行比对,如果数据库表当前版本号与第一次取出来的version值相等,则予以更新,否则认为是过期数 据。
2.乐观锁定的第二种实现方式和第一种差不多,同样是在需要乐观锁控制的table中增加一个字段,名称无所谓,字段类型使用时间戳 (datatime), 和上面的version类似,也是在更新提交的时候检查当前数据库中数据的时间戳和自己更新前取到的时间戳进行对比,如果一致则OK,否则就是版本冲突。
代码实例:
update account set name='ygz' , version = version+1 where id = '1' and version = 1;
两种锁各有优缺点:不可认为一种好于另一种,像乐观锁适用于写入比较少的情况下,即冲突真的很少发生的时候,这样可以省去了锁的开销,加大了系统的整个吞吐量。但如果经常产生冲突,上层应用会不断的进行retry(重试),这样反倒是降低了性能,所以这种情况下用悲观锁就比较合适.
数据类型介绍
       bit[(M)]
           二进制位(101001),m表示二进制位的长度(1-64),默认m=1

       tinyint[(m)] [unsigned] [zerofill]

           小整数,数据类型用于保存一些范围的整数数值范围:
           有符号:
               -128 ~ 127.
           无符号:
           ~ 255

       int[(m)][unsigned][zerofill]

           整数,数据类型用于保存一些范围的整数数值范围:
               有符号:
                   -2147483648 ~ 2147483647
               无符号:
            ~ 4294967295

           特别的:整数类型中的m仅用于显示,对存储范围无限制。例如: int(5),当插入数据2时,select 时数据显示为: 00002

       bigint[(m)][unsigned][zerofill]
           大整数,数据类型用于保存一些范围的整数数值范围:
               有符号:
                   -9223372036854775808 ~ 9223372036854775807
               无符号:
~  18446744073709551615

       decimal[(m[,d])] [unsigned] [zerofill]
           准确的小数值,m是数字总个数(负号不算),d是小数点后个数。 m最大值为65,d最大值为30。

           特别的:对于精确数值计算时需要用此类型
                  decaimal能够存储精确值的原因在于其内部按照字符串存储。

       FLOAT[(M,D)] [UNSIGNED] [ZEROFILL]
           单精度浮点数(非准确小数值),m是数字总个数,d是小数点后个数。
               无符号:
                   -3.402823466E+38 to -1.175494351E-38,
                   1.175494351E-38 to 3.402823466E+38
               有符号:
                   1.175494351E-38 to 3.402823466E+38

           **** 数值越大,越不准确 ****

       DOUBLE[(M,D)] [UNSIGNED] [ZEROFILL]
           双精度浮点数(非准确小数值),m是数字总个数,d是小数点后个数。

               无符号:
                   -1.7976931348623157E+308 to -2.2250738585072014E-308
                   2.2250738585072014E-308 to 1.7976931348623157E+308
               有符号:
                   2.2250738585072014E-308 to 1.7976931348623157E+308
           **** 数值越大,越不准确 ****


       char (m)
           char数据类型用于表示固定长度的字符串,可以包含最多达255个字符。其中m代表字符串的长度。
           PS: 即使数据小于m长度,也会占用m长度
       varchar(m)
           varchar数据类型用于变长的字符串,可以包含最多达255个字符。其中m代表该数据类型所允许保存的字符串的最大长度,只要长度小于该最大值的字符串都可以被保存在该数据类型中。

           注:虽然varchar使用起来较为灵活,但是从整个系统的性能角度来说,char数据类型的处理速度更快,有时甚至可以超出varchar处理速度的50%。因此,用户在设计数据库时应当综合考虑各方面的因素,以求达到最佳的平衡

       text
           text数据类型用于保存变长的大字符串,可以组多到65535 (2**16 − 1)个字符。

       mediumtext
           A TEXT column with a maximum length of 16,777,215 (2**24 − 1) characters.

       longtext
           A TEXT column with a maximum length of 4,294,967,295 or 4GB (2**32 − 1) characters.


       enum
           枚举类型,
           An ENUM column can have a maximum of 65,535 distinct elements. (The practical limit is less than 3000.)
           示例:
               CREATE TABLE shirts (
                   name VARCHAR(40),
                   size ENUM('x-small', 'small', 'medium', 'large', 'x-large')
               );
               INSERT INTO shirts (name, size) VALUES ('dress shirt','large'), ('t-shirt','medium'),('polo shirt','small');

       set
           集合类型
           A SET column can have a maximum of 64 distinct members.
           示例:
               CREATE TABLE myset (col SET('a', 'b', 'c', 'd'));
               INSERT INTO myset (col) VALUES ('a,d'), ('d,a'), ('a,d,a'), ('a,d,d'), ('d,a,d');

       DATE
           YYYY-MM-DD(1000-01-01/9999-12-31)

       TIME
           HH:MM:SS('-838:59:59'/'838:59:59')

       YEAR
           YYYY(1901/2155)

       DATETIME

           YYYY-MM-DD HH:MM:SS(1000-01-01 00:00:00/9999-12-31 23:59:59    Y)

       TIMESTAMP

           YYYYMMDD HHMMSS(1970-01-01 00:00:00/2037 年某时)

 浙公网安备 33010602011771号