【Python高级应用课程设计 】大数据分析——中国时尚购物的动机
选题背景:
时尚购物在中国的消费市场中占据了重要地位,并且受到越来越多消费者的追捧。中国消费者在时尚购物方面的动机是什么,了解其背后的原因和驱动力对于了解中国市场、时尚行业的发展趋势以及消费者行为具有重要意义。本选题旨在探讨中国时尚购物的动机。
时尚购物在中国的兴盛背后有多重因素。首先,中国的经济发展和中产阶级的崛起为时尚购物提供了广阔的市场。随着经济发展,越来越多的中国消费者有了更高的收入和消费能力,他们渴望通过购买时尚商品来展示自己的生活品味和社会地位。
社交媒体的普及也对时尚购物的推动起了积极作用。中国的年轻消费者越来越重视自己的形象和时尚感,他们通过社交媒体平台分享自己的时尚品味,并且关注时尚博主和名人的穿着。这种社交媒体的影响力促使他们购买流行的时尚商品以展现自己的个性和时尚意识。,这一选题想从中了解享乐的动机和各个数据在数据集中的占比进行分析处理
数据学习案例设计方案:
从网站中下载相关的数据集,对数据集进行整理,在python的环境中,给数据集中的文件打上标签,对数据进行预处理,利用所学的python知识分析出需要的图片以及要展示的数据
该数据集包含了403名中国消费者的回答,代表了更广泛的人群。该调查的重点是了解实体店和电子商务环境下时尚服装购物背后的动机。它旨在深入了解中国消费者在时尚零售领域的独特动机。
| ID | User ID |
|---|---|
| Gender | Gender |
| Age | Age of Respondent |
| Edu | Education Level |
| Inc | Income Level |
| Emp | Employment Status |
| Monthly_Spend | Expenditure on Clothing |
| Retail_Platform | High Street or eCommerce Shopping |
| Adv | Hedonic: Adventure Shopping |
| Soc | Hedonic: Social Shopping |
| Grat | Hedonic: Gratification Shopping |
| Ide | Hedonic: Idea Shopping |
| Rol | Hedonic: Role Shopping |
| Val | Hedonic: Value Shopping |
| Eff | Utilitarian: Efficiency Shopping |
| Ach | Utilitarian: Achievement Shopping |
| MAH_1 | Mahalanobis Distance |
| filter_$ | MAH_1 < 26.13 (FILTER) |
| Spend | Expenditure on Clothing |
| Occupation | Occupation |
1 数据源:
这是选自kaggle中的数据集,链接:https://www.kaggle.com/datasets/elanderos/motivations-for-fashion-shopping-in-china?select=shopping_motivations_in_china.csv
该数据集包含了403名中国消费者的回答,代表了更广泛的人群。该调查的重点是了解实体店和电子商务环境下时尚服装购物背后的动机。它旨在深入了解中国消费者在时尚零售领域的独特动机。
2 导入数据
点击查看代码
# 导入模块
1. import inline
2. import matplotlib
3. import pandas as pd
4. import numpy as np
5. import matplotlib.pyplot as plt
6. import seaborn as sns

8. # 显示所有列
9. pd.set_option('display.max_columns', None)
10. # 显示所有行
11. pd.set_option('display.max_rows', None)

13.  # 读取数据集
14. df = pd.read_csv("shopping_motivations_in_china.csv")
15. print(df.head())

17. #查看数据基本信息
18. df.info()


3、Pandas数据处理
Pandas是一个强大的数据处理和分析工具,它提供了丰富的功能和方法来处理和操作数据。下面是一些常见的Pandas数据处理操作
点击查看代码
1. # 检查缺失值
2. print("\nCheck for missing values:")
3. missing_values = df.isnull().sum()
4. print(missing_values)

6. # 快速统计汇总
7. print(df.describe())

9. # 分类列中的唯一值
10. print("\nUnique Values:")
11. for column in df.select_dtypes(include='object').columns:
12.     print(f"{column}: {df[column].unique()}")

14. #数据形状
15. print("\nData Shape:")
16. print(df.shape)


4数据可视化
各项数据在数据中的分布
性别分布
点击查看代码
1. 各项数据在数据中的分布
2. #性别分布
3. gender_distribution = df['Gender'].value_counts()

5. #绘制分布
6. plt.figure(figsize=(8, 6))
7. sns.countplot(x='Gender', data=df)
8. plt.title('Distribution of Genders')
9. plt.xlabel('Gender')
10. plt.ylabel('Count')
11. plt.show()

13. # 将分布显示为百分比
14. print("Gender Distribution:")
15. print(gender_distribution)


收入水平分配
点击查看代码
#收入水平分配
income_distribution = df['Inc'].value_counts()

# 绘制分布
1. plt.figure(figsize=(10, 6))
2. sns.countplot(x='Inc', data=df, order=df['Inc'].value_counts().index)
3. plt.title('Distribution of Income Levels')
4. plt.xlabel('Income Level')
5. plt.ylabel('Count')
6. plt.show()

8. # 将分布显示为百分比
9. print("Income Level Distribution:")
10. print(income_distribution)


年龄分布
点击查看代码
1. #年龄分布
2. age_distribution = df['Age'].value_counts()

4. #绘制分布
5. plt.figure(figsize=(8, 6))
6. sns.countplot(x='Age', data=df)
7. plt.title('Distribution of age')
8. plt.xlabel('age')
9. plt.ylabel('Count')
10. plt.show()

就业状况分布
点击查看代码
1. # 就业状况分布
2. employment_distribution = df['Emp'].value_counts()

4. # 绘制分布
5. plt.figure(figsize=(10, 6))
6. sns.countplot(x='Emp', data=df, order=df['Emp'].value_counts().index)
7. plt.title('Distribution of Employment Status')
8. plt.xlabel('Employment Status')
9. plt.ylabel('Count')
10. plt.show()

12. # 以百分比显示分布
13. print("Employment Status Distribution:")
14. print(employment_distribution)

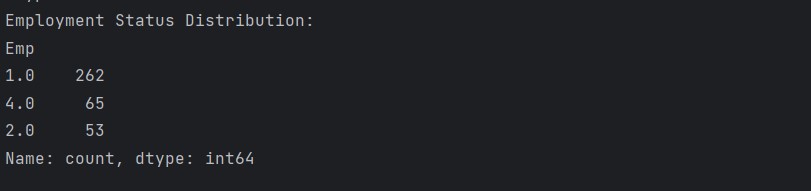
就业状况饼图
点击查看代码
1. # 就业状况饼图
2. employment_distribution = df['Emp'].value_counts()

4. # 绘制分布
5. plt.figure(figsize=(8,6))
6. # 添加颜色和标签
7. plt.pie(employment_distribution, labels=employment_distribution.index, autopct='%1.1f%%')
8.  # 格式化标题
9. plt.title('Distribution of Employment Status', fontsize=20)
10. # 格式化x轴标签
11. plt.xlabel('Employment Status', fontsize=14)
12.  # 格式化y轴标签
13. plt.ylabel('Count', fontsize=14)
14. plt.show()

每月支出分布
点击查看代码
1. # 每月支出分布
2. plt.figure(figsize=(8, 6))
3. sns.histplot(df['Monthly_Spend'], bins=20, kde=True)
4. plt.title('Distribution of Monthly Spending on Clothing')
5. plt.xlabel('Monthly Spending (in Currency)')
6. plt.ylabel('Count')
7. plt.show()

被调查者的马氏距离(MAH_1)如何变化,有多少低于指定阈值?
点击查看代码
1. #被调查者的马氏距离(MAH_1)如何变化,有多少低于指定阈值?
2. # 距离分布
3. plt.figure(figsize=(8, 6))
4. sns.histplot(df['MAH_1'], bins=20, kde=True)
5. plt.title('Distribution of Mahalanobis Distance (MAH_1)')
6. plt.xlabel('Mahalanobis Distance')
7. plt.ylabel('Count')
8. plt.show()

10. # 低于指定阈值的应答者数量
11. threshold_count = df[df['MAH_1'] < 26.13].shape[0]
12. print(f"Number of respondents with MAH_1 < 26.13: {threshold_count}"


功利动机分配
点击查看代码
1. #功利动机分配
2. utilitarian_cols = ['Eff', 'Ach']
3. utilitarian_distribution = df[utilitarian_cols].sum()

5. #绘制分布
6. plt.figure(figsize=(8, 6))
7. sns.barplot(x=utilitarian_distribution.index, y=utilitarian_distribution.values)
8. plt.title('Distribution of Utilitarian Motivations for Shopping')
9. plt.xlabel('Utilitarian Motivation')
10. plt.ylabel('Count')
11. plt.show()

13. #显示每个功利动机的分布
14. print("Utilitarian Motivations Distribution:")
15. print(utilitarian_distribution)


享乐动机分布
点击查看代码
1. # 享乐动机分布
2. hedonic_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val']
3. hedonic_distribution = df[hedonic_cols].sum()

5. # 绘制分布
6. plt.figure(figsize=(10, 6))
7. labels = hedonic_distribution.index
8. sizes = hedonic_distribution.values

10. # 绘制饼图
11. plt.pie(sizes, labels=labels, autopct='%1.1f%%', startangle=90)
12. plt.title('Distribution of Hedonic Motivations for Shopping')
13. # 确保饼图是正圆形
14. plt.axis('equal')
15. plt.show()

17. #显示每个享乐动机的分布
18. print("Hedonic Motivations Distribution:")
19. print(hedonic_distribution)
20.


散点图可视化关系
点击查看代码
#散点图可视化关系
1. plt. figure(figsize=(8, 6))
2. sns. scatterplot(x='Age', y='Monthly_Spend', data=df)
3. plt. title('Relationship between Age and Monthly Spending')
4. plt.xlabel('Age')
5. plt. ylabel('Monthly Spending (in Currency)')
6. plt.show()

8. # 相关性分析
9. correlation_age_spending = df['Age'].corr(df['Monthly_Spend'])
10. print(f"Correlation between Age and Monthly Spending: {correlation_age_spending}")


零售平台每月消费的箱线图
点击查看代码
1. # 零售平台每月消费的箱线图
2. plt. figure(figsize=(10, 8))
3. sns. boxplot(x='Retail_Platform', y='Monthly_Spend', data=df)
4. plt. title('Monthly Spending Distribution by Retail Platform')
5. plt. xlabel('Retail Platform')
6. plt. ylabel('Monthly Spending (in Currency)')
7. plt.show()

马氏距离(按职业)的箱线图
点击查看代码
1. # 马氏距离(按职业)的箱线图
2. plt. figure(figsize=(10, 8))
3. sns. boxplot(x='Occupation', y='MAH_1', data=df)
4. plt. title('Mahalanobis Distance Distribution by Occupation')
5. plt.xlabel('Occupation')
6. plt. ylabel('Mahalanobis Distance')
7. plt.show()

动机列的成对相关矩阵
点击查看代码
1. #动机列的成对相关矩阵
2. motivations_corr = df[['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val', 'Eff', 'Ach']].corr()

4. #热图可视化
5. plt.figure(figsize=(10, 8))
6. sns.heatmap(motivations_corr, annot=True, cmap='coolwarm', fmt=".2f")
7. plt.title('Pairwise Correlation among Motivational Columns')
8. plt.show()

按年龄组划分的每月消费小提琴图
点击查看代码
1. #按年龄组划分的每月消费小提琴图
2. plt.figure(figsize=(8, 6))
3. sns.violinplot(x='Age', y='Monthly_Spend', data=df)
4. plt.title('Monthly Spending Distribution by Age Group')
5. plt.xlabel('Age Group')
6. plt.ylabel('Monthly Spending (in Currency)')
7. plt.show()

每个享乐动机按收入水平的箱线图
点击查看代码
1. # 每个享乐动机按收入水平的箱线图
2. hedonic_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val']
3. plt.figure(figsize=(14, 8))
4. for col in hedonic_cols:
5.     plt.subplot(2, 3, hedonic_cols.index(col) + 1)
6.     sns.boxplot(x='Inc', y=col, data=df)
7.     plt.title(f'{col} by Income Level')
8. plt.tight_layout()
9. plt.show()

零售平台的马氏距离箱线图
点击查看代码
1. #零售平台的马氏距离箱线图
2. plt. figure(figsize=(8, 6))
3. sns. boxplot(x='Retail_Platform', y='MAH_1', data=df)
4. plt. title('Mahalanobis Distance Distribution by Retail Platform')
5. plt. xlabel('Retail Platform')
6. plt. ylabel('Mahalanobis Distance')
7. plt.show()

马哈拉诺比斯距离与综合享乐动机的散点图
点击查看代码
1. # 创建一个新的列为合并的享乐动机
2. df['Combined_Hedonic'] = df[['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val']].sum(axis=1)

4. #马哈拉诺比斯距离与综合享乐动机的散点图
5. plt. figure(figsize=(8, 6))
6. sns. scatterplot(x='Combined_Hedonic', y='MAH_1', data=df)
7. plt. title('Mahalanobis Distance vs. Combined Hedonic Motivations')
8. plt. xlabel('Combined Hedonic Motivations')
9. plt. ylabel('Mahalanobis Distance')
10. plt.show()

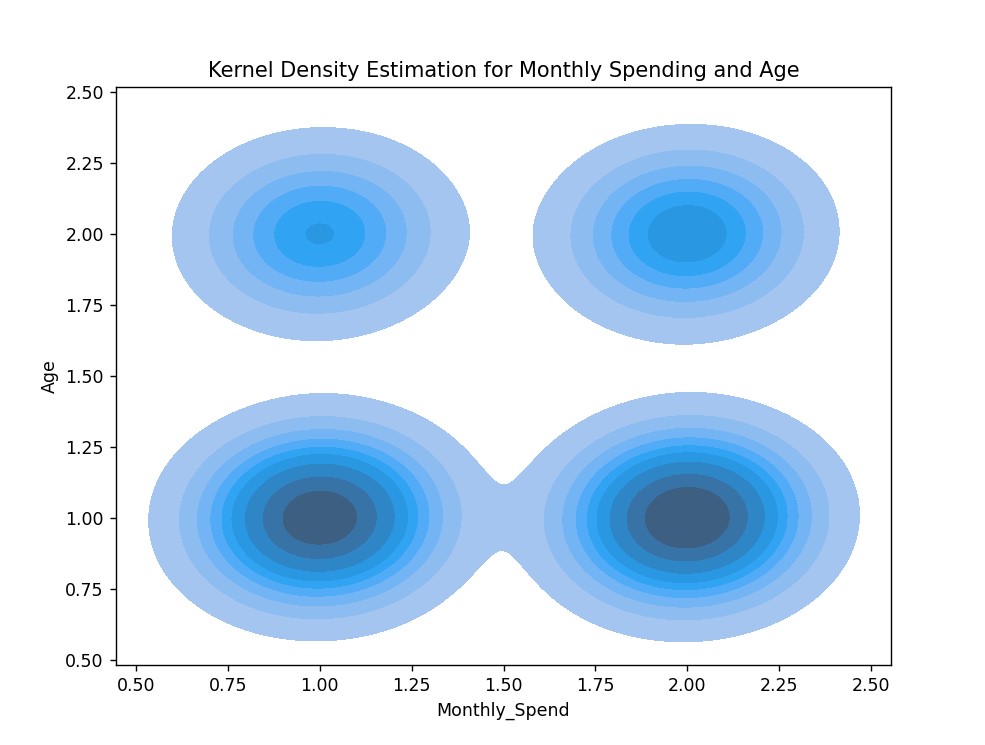
KDE每月消费和年龄图
点击查看代码
1. # KDE每月消费和年龄图
2. plt.figure(figsize=(8, 6))
3. sns.kdeplot(data=df, x='Monthly_Spend', y='Age', fill=True)
4. plt.title('Kernel Density Estimation for Monthly Spending and Age')
5. plt.show()
所有数值列的关联矩阵
点击查看代码
1. #所有数值列的关联矩阵
2. all_numeric_corr = df.corr()
3. # 热图可视化
4. plt.figure(figsize=(16, 12))
5. sns.heatmap(all_numeric_corr, annot=True, cmap='coolwarm', fmt=".2f")
6. plt.title('Correlation Matrix for All Numerical Columns')
7. plt.show()

动机雷达图
点击查看代码
1. #动机雷达图
2. from math import pi
3. motivation_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val', 'Eff', 'Ach']
4. motivation_data = df[motivation_cols].mean()
5. #绘制雷达图
6. angles = [n / float(len(motivation_cols)) * 2 * pi for n in range(len(motivation_cols))]
7. angles += angles[:1]
8. values = motivation_data.tolist() + motivation_data.tolist()[:1]
9. plt.figure(figsize=(8, 8))
10. plt.polar(angles, values, marker='.')
11. plt.fill(angles, values, alpha=0.25)
12. plt.title('Radar Chart for Shopping Motivations')
13. plt.show()

NMDS对于购物动机的差异
点击查看代码
1. # NMDS对于购物动机的差异
2. from sklearn.manifold import MDS
3. from sklearn.metrics import euclidean_distances

5. motivation_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val', 'Eff', 'Ach']
6. motivations_data = df[motivation_cols]
7. distances = euclidean_distances(motivations_data)
8. mds = MDS(n_components=2, dissimilarity='precomputed', random_state=42)
9. mds_result = mds.fit_transform(distances)

11. #NMDS结果轨迹图
12. plt.figure(figsize=(8, 6))
13. for i in range(mds_result.shape[0]):
14.     plt.plot(mds_result[i, 0], mds_result[i, 1], marker='o')
15. plt.title('Trajectory Plot of NMDS Results for Shopping Motivations')
16. plt.xlabel('NMDS Dimension 1')
17. plt.ylabel('NMDS Dimension 2')
18. plt.show()

方差分析测试每月支出按教育水平
点击查看代码
1. #方差分析测试每月支出按教育水平
2. import statsmodels.api as sm
3. from statsmodels.formula.api import ols

5. #拟合方差分析模型
6. model = ols('Monthly_Spend ~ Edu', data=df).fit()
7. anova_table = sm.stats.anova_lm(model, typ=2)

9. # 显示ANOVA表
10. print("ANOVA Table for Monthly Spending by Education Level:")
11. print(anova_table)

卡方检验的列联表
点击查看代码
1. #计算交叉表
2. gender_retail_crosstab = df.groupby(['Gender', 'Retail_Platform']).size().unstack()

4. # 卡方检验
5. from scipy.stats import chi2_contingency

7. chi2, p_value, _, _ = chi2_contingency(gender_retail_crosstab)

9. # 输出结果
10. print(f"卡方统计量: {chi2}")
11. print(f"P值: {p_value}")

四、总结
本次数据分析揭示了许多有关时尚购物行为的有趣洞见。首先,在男女比例中,女性对时尚的需求明显高于男性,这可能与女性更注重外表和时尚感有关。其次,价格和性价比对消费者购物动机的影响不容忽视,尤其是对于年轻消费者而言,他们更倾向于选择价格适中且性价比较高的时尚商品。此外,通过大数据分析,我们可以深入了解时尚购物行为的复杂性,看到它受到多种因素的共同影响,而不仅仅是单一的驱动因素。
通过这次分析,我不仅提高了自己的数据分析和技术实现能力,还掌握了大数据分析的基本方法和技巧。我学会了如何从海量数据中提取有价值的信息和特征,以及如何解释和分析结果。这些技能将对我未来的学习和工作产生积极的影响。
总之,这次数据分析是一次非常有意义的经历,让我对时尚购物行为有了更深入的了解。我相信这些洞见能为相关行业的决策者提供有价值的参考,促进更明智的商业决策。
总结代码
点击查看代码
1. #各项数据在数据中的分布
2. #性别分布
3. gender_distribution = df['Gender'].value_counts()

5. #绘制分布
6. plt.figure(figsize=(8, 6))
7. sns.countplot(x='Gender', data=df)
8. plt.title('Distribution of Genders')
9. plt.xlabel('Gender')
10. plt.ylabel('Count')
11. plt.show()

13. # 将分布显示为百分比
14. print("Gender Distribution:")
15. print(gender_distribution)

17. #收入水平分配
18. income_distribution = df['Inc'].value_counts()

20. # 绘制分布
21. plt.figure(figsize=(10, 6))
22. sns.countplot(x='Inc', data=df, order=df['Inc'].value_counts().index)
23. plt.title('Distribution of Income Levels')
24. plt.xlabel('Income Level')
25. plt.ylabel('Count')
26. plt.show()

28. # 将分布显示为百分比
29. print("Income Level Distribution:")
30. print(income_distribution)

32. #年龄分布
33. age_distribution = df['Age'].value_counts()

35. #绘制分布
36. plt.figure(figsize=(8, 6))
37. sns.countplot(x='Age', data=df)
38. plt.title('Distribution of age')
39. plt.xlabel('age')
40. plt.ylabel('Count')
41. plt.show()

43. # 就业状况分布
44. employment_distribution = df['Emp'].value_counts()

46. # 绘制分布
47. plt.figure(figsize=(10, 6))
48. sns.countplot(x='Emp', data=df, order=df['Emp'].value_counts().index)
49. plt.title('Distribution of Employment Status')
50. plt.xlabel('Employment Status')
51. plt.ylabel('Count')
52. plt.show()

54. # 以百分比显示分布
55. print("Employment Status Distribution:")
56. print(employment_distribution)

58. # 就业状况饼图
59. employment_distribution = df['Emp'].value_counts()

61. # 绘制分布
62. plt.figure(figsize=(8,6))
63. # 添加颜色和标签
64. plt.pie(employment_distribution, labels=employment_distribution.index, autopct='%1.1f%%')
65.  # 格式化标题
66. plt.title('Distribution of Employment Status', fontsize=20)
67. # 格式化x轴标签
68. plt.xlabel('Employment Status', fontsize=14)
69.  # 格式化y轴标签
70. plt.ylabel('Count', fontsize=14)
71. plt.show()


75. # 每月支出分布
76. plt.figure(figsize=(8, 6))
77. sns.histplot(df['Monthly_Spend'], bins=20, kde=True)
78. plt.title('Distribution of Monthly Spending on Clothing')
79. plt.xlabel('Monthly Spending (in Currency)')
80. plt.ylabel('Count')
81. plt.show()

83. #被调查者的马氏距离(MAH_1)如何变化,有多少低于指定阈值?
84. # 距离分布
85. plt.figure(figsize=(8, 6))
86. sns.histplot(df['MAH_1'], bins=20, kde=True)
87. plt.title('Distribution of Mahalanobis Distance (MAH_1)')
88. plt.xlabel('Mahalanobis Distance')
89. plt.ylabel('Count')
90. plt.show()

92. # 低于指定阈值的应答者数量
93. threshold_count = df[df['MAH_1'] < 26.13].shape[0]
94. print(f"Number of respondents with MAH_1 < 26.13: {threshold_count}")

96. #功利动机分配
97. utilitarian_cols = ['Eff', 'Ach']
98. utilitarian_distribution = df[utilitarian_cols].sum()

100. #绘制分布
101. plt.figure(figsize=(8, 6))
102. sns.barplot(x=utilitarian_distribution.index, y=utilitarian_distribution.values)
103. plt.title('Distribution of Utilitarian Motivations for Shopping')
104. plt.xlabel('Utilitarian Motivation')
105. plt.ylabel('Count')
106. plt.show()

108. #显示每个功利动机的分布
109. print("Utilitarian Motivations Distribution:")
110. print(utilitarian_distribution)

112. # 享乐动机分布
113. hedonic_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val']
114. hedonic_distribution = df[hedonic_cols].sum()

116. # 绘制分布
117. plt.figure(figsize=(10, 6))
118. labels = hedonic_distribution.index
119. sizes = hedonic_distribution.values

121. # 绘制饼图
122. plt.pie(sizes, labels=labels, autopct='%1.1f%%', startangle=90)
123. plt.title('Distribution of Hedonic Motivations for Shopping')
124. # 确保饼图是正圆形
125. plt.axis('equal')
126. plt.show()

128. #显示每个享乐动机的分布
129. print("Hedonic Motivations Distribution:")
130. print(hedonic_distribution)

132. #散点图可视化关系
133. plt. figure(figsize=(8, 6))
134. sns. scatterplot(x='Age', y='Monthly_Spend', data=df)
135. plt. title('Relationship between Age and Monthly Spending')
136. plt.xlabel('Age')
137. plt. ylabel('Monthly Spending (in Currency)')
138. plt.show()

140. # 相关性分析
141. correlation_age_spending = df['Age'].corr(df['Monthly_Spend'])
142. print(f"Correlation between Age and Monthly Spending: {correlation_age_spending}")

144. # 零售平台每月消费的箱线图
145. plt. figure(figsize=(10, 8))
146. sns. boxplot(x='Retail_Platform', y='Monthly_Spend', data=df)
147. plt. title('Monthly Spending Distribution by Retail Platform')
148. plt. xlabel('Retail Platform')
149. plt. ylabel('Monthly Spending (in Currency)')
150. plt.show()

152. # 马氏距离(按职业)的箱线图
153. plt. figure(figsize=(10, 8))
154. sns. boxplot(x='Occupation', y='MAH_1', data=df)
155. plt. title('Mahalanobis Distance Distribution by Occupation')
156. plt.xlabel('Occupation')
157. plt. ylabel('Mahalanobis Distance')
158. plt.show()

160. #动机列的成对相关矩阵
161. motivations_corr = df[['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val', 'Eff', 'Ach']].corr()

163. #热图可视化
164. plt.figure(figsize=(10, 8))
165. sns.heatmap(motivations_corr, annot=True, cmap='coolwarm', fmt=".2f")
166. plt.title('Pairwise Correlation among Motivational Columns')
167. plt.show()

169. #按年龄组划分的每月消费小提琴图
170. plt.figure(figsize=(8, 6))
171. sns.violinplot(x='Age', y='Monthly_Spend', data=df)
172. plt.title('Monthly Spending Distribution by Age Group')
173. plt.xlabel('Age Group')
174. plt.ylabel('Monthly Spending (in Currency)')
175. plt.show()

177. # 每个享乐动机按收入水平的箱线图
178. hedonic_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val']
179. plt.figure(figsize=(14, 8))
180. for col in hedonic_cols:
181.     plt.subplot(2, 3, hedonic_cols.index(col) + 1)
182.     sns.boxplot(x='Inc', y=col, data=df)
183.     plt.title(f'{col} by Income Level')
184. plt.tight_layout()
185. plt.show()

187. #零售平台的马氏距离箱线图
188. plt. figure(figsize=(8, 6))
189. sns. boxplot(x='Retail_Platform', y='MAH_1', data=df)
190. plt. title('Mahalanobis Distance Distribution by Retail Platform')
191. plt. xlabel('Retail Platform')
192. plt. ylabel('Mahalanobis Distance')
193. plt.show()

195. # 创建一个新的列为合并的享乐动机
196. df['Combined_Hedonic'] = df[['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val']].sum(axis=1)

198. #马哈拉诺比斯距离与综合享乐动机的散点图
199. plt. figure(figsize=(8, 6))
200. sns. scatterplot(x='Combined_Hedonic', y='MAH_1', data=df)
201. plt. title('Mahalanobis Distance vs. Combined Hedonic Motivations')
202. plt. xlabel('Combined Hedonic Motivations')
203. plt. ylabel('Mahalanobis Distance')
204. plt.show()

206. # KDE每月消费和年龄图
207. plt.figure(figsize=(8, 6))
208. sns.kdeplot(data=df, x='Monthly_Spend', y='Age', fill=True)
209. plt.title('Kernel Density Estimation for Monthly Spending and Age')
210. plt.show()

212. #所有数值列的关联矩阵
213. all_numeric_corr = df.corr()
214. # 热图可视化
215. plt.figure(figsize=(16, 12))
216. sns.heatmap(all_numeric_corr, annot=True, cmap='coolwarm', fmt=".2f")
217. plt.title('Correlation Matrix for All Numerical Columns')
218. plt.show()

220. #动机雷达图
221. from math import pi
222. motivation_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val', 'Eff', 'Ach']
223. motivation_data = df[motivation_cols].mean()
224. #绘制雷达图
225. angles = [n / float(len(motivation_cols)) * 2 * pi for n in range(len(motivation_cols))]
226. angles += angles[:1]
227. values = motivation_data.tolist() + motivation_data.tolist()[:1]
228. plt.figure(figsize=(8, 8))
229. plt.polar(angles, values, marker='.')
230. plt.fill(angles, values, alpha=0.25)
231. plt.title('Radar Chart for Shopping Motivations')
232. plt.show()

234. # NMDS对于购物动机的差异
235. from sklearn.manifold import MDS
236. from sklearn.metrics import euclidean_distances

238. motivation_cols = ['Adv', 'Soc', 'Grat', 'Ide', 'Rol', 'Val', 'Eff', 'Ach']
239. motivations_data = df[motivation_cols]
240. distances = euclidean_distances(motivations_data)
241. mds = MDS(n_components=2, dissimilarity='precomputed', random_state=42)
242. mds_result = mds.fit_transform(distances)

244. #NMDS结果轨迹图
245. plt.figure(figsize=(8, 6))
246. for i in range(mds_result.shape[0]):
247.     plt.plot(mds_result[i, 0], mds_result[i, 1], marker='o')
248. plt.title('Trajectory Plot of NMDS Results for Shopping Motivations')
249. plt.xlabel('NMDS Dimension 1')
250. plt.ylabel('NMDS Dimension 2')
251. plt.show()


254. #方差分析测试每月支出按教育水平
255. import statsmodels.api as sm
256. from statsmodels.formula.api import ols

258. #拟合方差分析模型
259. model = ols('Monthly_Spend ~ Edu', data=df).fit()
260. anova_table = sm.stats.anova_lm(model, typ=2)

262. # 显示ANOVA表
263. print("ANOVA Table for Monthly Spending by Education Level:")
264. print(anova_table)

266. #计算交叉表
267. gender_retail_crosstab = df.groupby(['Gender', 'Retail_Platform']).size().unstack()

269. # 卡方检验
270. from scipy.stats import chi2_contingency

272. chi2, p_value, _, _ = chi2_contingency(gender_retail_crosstab)

274. # 输出结果
275. print(f"卡方统计量: {chi2}")
276. print(f"P值: {p_value}")

 浙公网安备 33010602011771号