
倍增与LCA 学习笔记
倍增与LCA 学习笔记
前言
\(\quad\)首先回忆一下二分答案是什么,二分答案是每一次取中间值,判断合法,只适用于具有单调性的序列,那么什么是倍增呢?顾名思义,成倍增长呗,如果直接对数组进行递推无法满足时间复杂度的话,就要用到倍增,具体是啥呢,举个栗子,看一下以下这个序列:
\(\overbrace{\overbrace{\overbrace{\overbrace{4}^{\text{1}} \quad 5}^{\text{2}} \quad 6 \quad 8}^{\text{4}} \quad 1 \quad 4 \quad 6 \quad 10}^{\text{8}}\)
以第一个数4为例,每次呈指数增长(\(2^0,2^1,2^2,...,2^k\)),以2的整数次幂上位置的值作为代表,因为我们都知道每个数都可以被表示为若干个2的次幂项的和这一性质,所以查询区间长度为2的次幂,直接查询,如果查询区间长度非2的次幂,那么可以将其拆开为若干2的次幂项和,最后合并即可
RMQ问题
\(\quad\)那么RMQ(Range Maximum/Minimum Query的英文缩写)问题,表示为区间的最大值或最小值,通常解决RMQ问题的算法有 单调栈/队列 ST表 线段树,这里着重讲ST表
ST表
\(\quad\)通过倍增法,解决可重复贡献问题的数据结构,不能修改数据,这时你就要问了:明明线段树可以解决RMQ问题,那还要ST表有什么用, 好像确实没用 首先ST表码量比线段树小的多得多,对于没有修改的RMQ还是ST表的时间复杂度更好,那么什么是 可重复贡献问题呢 比如\(max(x, x) = x\),那么相对应的区间求max就是一个可重复贡献问题,对于查询区间重叠部分对解没有影响
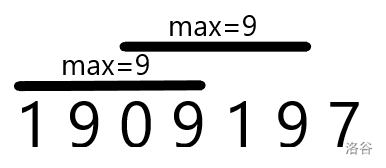
\(\quad\)ST表可以做到\(O(nlogn)\)复杂度的预处理,并做到\(O(1)\)取得答案,具体步骤如下:
-
我们令 \(f(i, j)\) 表示区间 \([i, i+2^j-1]\) 的最大值,那么很显然 \(f(i, 0) = a_i\)
-
那么我们倍增的时候就相当于向上 跳了\(2^j-1\) 那么我们可以写出倍增的转移方程:
预处理 【参考代码】
void init(){

    lg[1] = 0;
    for(int i = 2 ; i <= n ; i ++){
        lg[i] = lg[i >> 1] + 1;
    }

	for(int j = 0 ; j < M ; j ++){
		for(int i = 1 ; i + (1 << j) - 1 <= n ; i ++){
			if(!j) f[i][j] = a[i];
			else{
				f[i][j] = max(f[i][j - 1], f[i + (1 << j - 1)][j - 1]);
			}
		}
	}
}
- 那么对于每一个查询 \([l,r]\) 我们可以将其分开成两个区间:\([l,l+2^k-1]\) 和 \([r-2^k+1,r]\) 两个部分,其中 \(k=\lfloor log_2(r-l+1) \rfloor\)
查询 【参考代码】
int qman(int l, int r){
	int k = lg[r - l + 1];
	return max(f[l][k], f[r - (1 << k) + 1][k]);
}
P3865 【模板】ST 表 & RMQ 问题
根据上述讲解写出代码即可
P3865 【参考代码】
#include<bits/stdc++.h>
using namespace std;
typedef long long LL;
const int M = 17, N = 100010;
int a[N];
int n, m;
int f[N][M];

inline int read()
{
	int x=0,f=1;char ch=getchar();
	while (ch<'0'||ch>'9'){if (ch=='-') f=-1;ch=getchar();}
	while (ch>='0'&&ch<='9'){x=x*10+ch-48;ch=getchar();}
	return x*f;
}

void init(){
	for(int j = 0 ; j < M ; j ++){
		for(int i = 1 ; i + (1 << j) - 1 <= n ; i ++){
			if(!j) f[i][j] = a[i];
			else{
				f[i][j] = max(f[i][j - 1], f[i + (1 << j - 1)][j - 1]);
			}
		}
	}
}

int qman(int l, int r){
	int k = log2(r - l + 1);
	return max(f[l][k], f[r - (1 << k) + 1][k]);
}

int main(){
	n = read();
	m = read();
	for(int i = 1 ; i <= n ; i ++){
		a[i] = read();
	}
	init();
	while(m --){
		int l = read(), r = read();
		cout<<qman(l, r)<<'\n';
	}
	return 0;
}
LCA最近公共祖先
\(\quad\)首先最近公共祖先就是两个节点所有公共祖先中,距离两个节点距离最近的,具体可以看下面这个图:
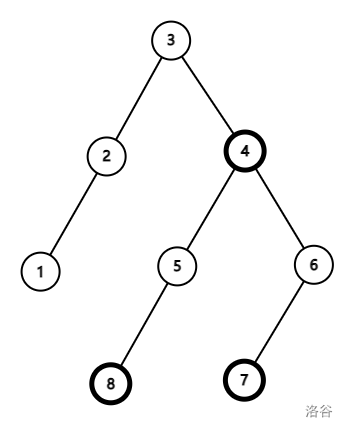
如图,7号节点和8号节点的最近公共祖先就是4号节点
那么具体怎么求解lca呢,我们用到的思路是每次找到深度较大的节点,然后让深度较大的节点向上跳,不难发现,跳到最后两个节点到了同一个节点上,这个节点就是他们的LCA,暴力肯定过不了,本文章着重介绍 倍增法LCA tarjan求LCA 树链剖分LCA
倍增LCA
\(\quad\)倍增lca属于市面上比较流行的lca求解方式了,属于暴力思路的进阶版,具体过程是通过预处理出 \(fa\) 数组(\(fa_{u,j}\)表示u号节点的第 \(2^j\) 个祖先),这个数组可以帮助减少跳转次数,可以通过dfs遍历预处理出来
具体如何优化跳转次数?
-
根据暴力思路,我们要先取得两个节点中较大的节点,然后让深度较大的节点跳到两个节点深度相同,设这两个节点为\(u,v\),我们可以通过枚举深度较大的点跳跃的步数,从大到小(设深度较大的点为\(u\),则枚举一个\(k\),使得\(dep_{fa[u][k]} <= dep_v\)),向上跳转直到最后一个满足 \(dep_{fa[u][k]} <= dep_v\) 的\(u\)
-
到这里,我们需要判断一下如果此时\(u,v\)已经是同一个节点了,那么可以直接return,如果不是同一个节点,再枚举跳跃步数,从大到小,如果 \(fa_{u,k} \not = fa_{v,k}\) 则 \(u \leftarrow fa_{u,k},v \leftarrow fa_{v,k}\) 最后LCA就是 \(fa_{u,0}\)
倍增【参考代码】
inline void dfs(int u){
	for(int k = 1 ; k < 20 ; k ++)
		f[u][k] = f[f[u][k - 1]][k - 1];
	for(int j : e[u]){
		if(j == f[u][0]) continue;
		f[j][0] = u;
		dep[j] = dep[u] + 1;
		dfs(j);
	}
}

inline int lca(int a, int b){
	if(dep[a] < dep[b]) swap(a, b);
	for(int i = 19 ; i >= 0 ; i --) if(dep[f[a][i]] >= dep[b]) a = f[a][i];
	if(a == b) return a;
	for(int i = 19 ; i >= 0 ; i --) if(f[a][i] != f[b][i]) a = f[a][i], b = f[b][i];
	return f[a][0];
}
tarjan求LCA
未制作
tarjan求LCA 【参考代码】
int ans[N];

int p[N];
int find(int x){
	if(p[x] != x) return p[x] = find(p[x]);
	return x;
}
void merge(int a, int b){
	a = find(a), b = find(b);
	p[a] = b;
}

bool vis[N];

void tarjan(int u){
	vis[u] = true;
	for(int j : e[u]){
		if(!vis[j]){
			tarjan(j);
			merge(j, u);
		}
	}

	for(auto &it : t[u]){
		int j = it.first, id = it.second;
		if(vis[j]) ans[id] = find(j);
	}
}
树链剖分lca
未制作
树链剖分lca 【参考代码】
int f[N], dep[N], sz[N], hson[N], dfn[N], rnk[N], top[N], tot;

void dfs1(int u, int fa){
	f[u] = fa;
	dep[u] = dep[fa] + 1;
	sz[u] = 1;
	hson[u] = -1;

	for(int j : e[u]){
		if(j == fa) continue;
		dfs1(j, u);
		sz[u] += sz[j];
		if(hson[u] == -1 || sz[hson[u]] < sz[j]){
			hson[u] = j;
		}
	}
}

void dfs2(int u, int tp){
	top[u] = tp;
	dfn[u] = ++ tot;
	rnk[tot] = u;

	if(hson[u] == -1) return ;
	dfs2(hson[u], tp);
	for(int j : e[u]){
		if(j != hson[u] && j != f[u]){
			dfs2(j, j);
		}
	}
}

int lca(int a, int b){
	while(top[a] != top[b]){
		if(dep[top[a]] < dep[top[b]]) swap(a, b);
		a = f[top[a]];
	}
	if(dep[a] > dep[b]) swap(a, b);
	return a;
}

 浙公网安备 33010602011771号