
KL 散度统一视角下的LLM后训练:SFT 、RL 与 OPD
本篇文章将围绕近期受到广泛关注的 On-Policy Distillation(OPD)展开。为了建立统一的分析视角,笔者将首先从熵与交叉熵出发,自然引出 KL 散度,并重点讨论 Forward KL 与 Reverse KL 在采样方向、mode-covering 与 mode-seeking 等方面的差异。在此基础上,本文进一步从 KL 散度与数据分布的统一视角重新审视一系列经典后训练方法,包括 SFT、传统知识蒸馏、RL、OPD 以及 Self-Distillation,重点分析它们在“数据由谁产生、模型在哪些状态上学习、Teacher 与 Student 如何进行分布匹配”等问题上的本质区别。
从熵到KL散度
熵与交叉熵
我们先从熵的定义出发。对于一个离散随机变量 \(X\),设事件 \(x\) 发生的概率为 \(p(x)\),其熵定义为
这里可以把 \(\log \frac{1}{p(x)}\) 理解为事件 \(x\) 发生后带来的信息量。当 \(p(x)=1\) 时,这件事是确定发生的,因此它的发生没有提供任何额外信息;反过来,一个原本概率很低的事件真的发生时,会带来更大的信息量。因此,熵可以理解为:当我们按照分布 \(p\) 不断观察随机事件时,平均能够获得多少信息。一个分布越集中、越确定,熵越小;一个分布越分散、越难预测,熵通常越大。
沿着这个视角,可以自然引出交叉熵。设随机变量 \(X\) 的真实分布为 \(p(x)\),而我们使用另一个分布 \(q(x)\) 去预测它,那么按照真实分布 \(p\) 观察事件,同时使用 \(q\) 衡量这些事件的信息量时,得到的平均信息量为
什么时候交叉熵会很大?一种典型情况是:某个事件在真实世界中经常发生,即 \(p(x)\) 很大,但模型却认为它几乎不可能发生,即 \(q(x)\) 很小。此时 \(-\log q(x)\) 会非常大,从而显著拉高交叉熵。因此,在机器学习中使用交叉熵作为损失,本质上就是要求模型的预测分布逐渐逼近数据的真实分布。
KL 散度 - Forward和Reverse KL
通常我们把真实数据分布记为 \(p(x)\),把参数为 \(\theta\) 的模型分布记为 \(q_\theta(x)\)。此时,KL 散度可以进一步刻画两个分布之间的差异。首先考虑 Forward KL:
由于 \(H(p)\) 与模型参数 \(\theta\) 无关,因此在优化 \(q_\theta\) 时,
也就是说,最小化 Forward KL 与最小化交叉熵、最大化数据似然在优化意义上是等价的。它的操作含义非常直接:从目标分布 \(p\) 中采样样本 \(x\),然后要求模型 \(q_\theta\) 尽可能提高这些样本的概率。
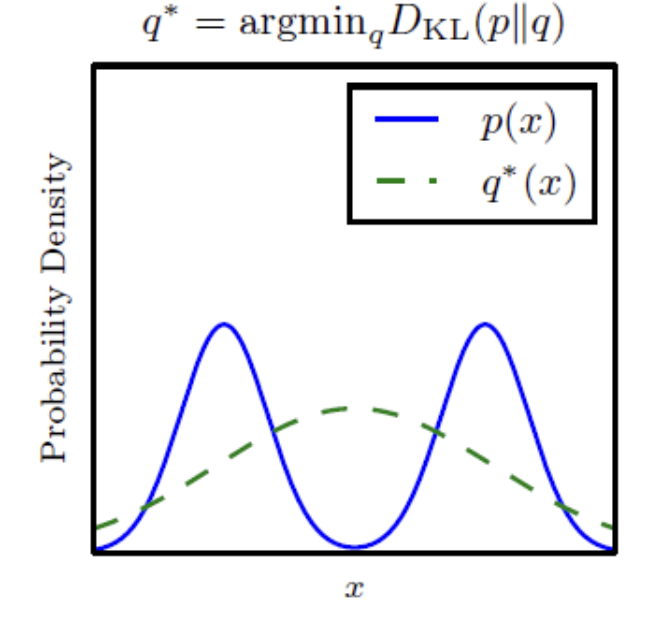
这一采样方向决定了 Forward KL 的一个重要性质。由于样本来自 \(p\),因此只要某个区域在 \(p\) 中具有较高概率,它就会不断出现在训练数据中。如果 \(q_\theta\) 恰好在这个区域给出了极低概率,那么对应的 \(-\log q_\theta(x)\) 就会非常大,产生很强的惩罚。因此,Forward KL 会迫使 \(q_\theta\) 尽可能覆盖 \(p\) 的所有主要高概率区域。
反过来,如果某个区域 \(q_\theta\) 给了较高概率,但 \(p\) 几乎不会在那里采样,那么这个错误并不会受到同样强烈的惩罚。正因为如此,Forward KL 通常表现出一种典型的 mode-covering 倾向:宁可把概率质量铺得更开一些,也尽量不要漏掉目标分布中的某个重要 mode。如下图所示:
再来看 Reverse KL:
这里的采样方向反了过来:样本不是来自目标分布 \(p\),而是来自正在训练的模型 \(q_\theta\)。第一项要求模型自己生成出来的样本,在目标分布 \(p\) 下也应该拥有较高概率;第二项 \(-H(q_\theta)\) 则意味着,在其他条件相同的情况下,提高模型自身的熵可以降低 Reverse KL。
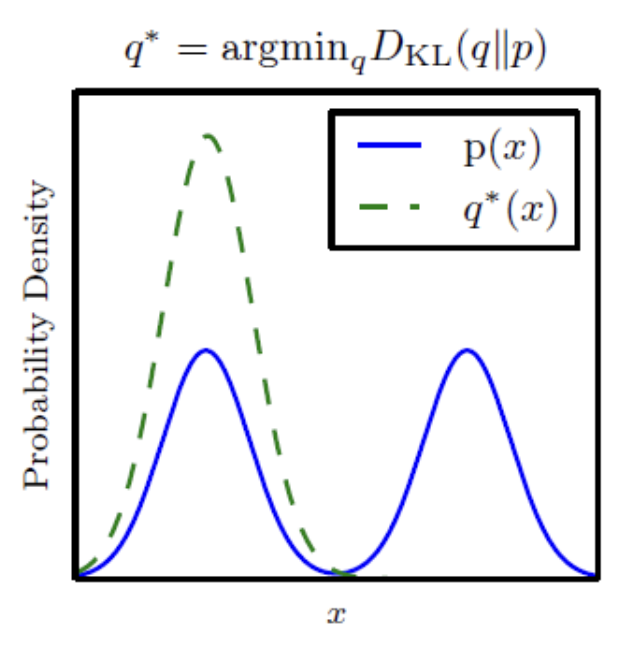
Reverse KL 与 Forward KL 最核心的区别就在采样方向。由于训练样本来自 \(q_\theta\),模型只需要对“自己经常访问到的区域”负责。如果 \(p\) 中存在多个高概率 mode,而 \(q_\theta\) 几乎不给其中某个 mode 分配概率,那么模型也就几乎不会从那里采样,自然不会因为遗漏这个 mode 而受到直接惩罚。
另一方面,一旦 \(q_\theta\) 把概率质量放到了一个 \(p(x)\) 很低的区域,那么这些样本会被频繁采出,同时 \(-\log p(x)\) 会变得很大,于是受到强烈惩罚。因此,Reverse KL 更倾向于寻找目标分布中的高概率区域,并把自己的概率质量集中在那里,这就是常说的 mode-seeking 行为。如下图所示:
- Forward KL :目标分布产生的样本,当前模型能否都解释好?
- Reverse KL :模型自己产生的样本,在目标分布看来是否合理?
什么时候用FKL,什么时候用RKL呢?
对于普通监督学习,我们几乎天然使用 Forward KL(等价于优化交叉熵)。因为我们在监督学习中,通常只能从真实数据分布 \(p_{\text{data}}\) 中采样,而无法直接计算出每个样本在该分布中的概率。例如,我们可以从真实世界中收集大量自然语言、图片和视频,相当于获得了 \(x\sim p_{\text{data}}\) 的样本;但给定一句具体文本或一张具体图片,我们通常无法回答“它在真实世界数据分布中的概率 \(p_{\text{data}}(x)\) 到底是多少”。
因此,我们能够计算
却无法直接计算
对于知识蒸馏领域,FKL和RKL第一次成了可选的问题。知识蒸馏是一个非常特殊的场景。假设我们有一个强大的 Teacher 模型 \(p_T\),希望训练一个较小的 Student 模型 \(q_\theta\) 尽可能贴近教师分布。与真实世界的数据分布不同,Teacher 本身就是一个显式的概率模型:我们既可以从 Teacher 中采样 \(x\sim p_T\),也可以对给定序列计算它在 Teacher 下的 log probability。因此,在 LLM 蒸馏中,Forward KL 和 Reverse KL 第一次真正同时成为了可选项。
如果采用 Forward KL,
那么训练过程可以理解为:先让 Teacher 生成回答,再要求 Student 最大化输出这些 Teacher 回答的概率。如果只保留 Teacher 最终采样出来的 token,而不使用其完整概率分布,那么这种训练实际上就非常接近我们熟悉的 response distillation,或者基于 Teacher-generated data 的 SFT。Teacher 生成什么,Student 就学习什么。
经典的实现为: 考虑Teacher生成response的全过程,利用在每一个 token 上的完整概率分布,可以进一步进行 token-level Forward KL。对于某个上下文 \(s_t\),Teacher 给出 \(p_T(a_t\mid s_t)\),Student 给出 \(q_\theta(a_t\mid s_t)\),然后直接优化
使用Forward KL时:训练状态主要由 Teacher 的分布决定。Teacher 经常访问哪些回答、哪些 reasoning trajectory,Student 就必须在那里分配足够的概率质量。因此,它天然倾向于较完整地覆盖 Teacher 的行为分布。
Reverse KL 则对应另一种完全不同的蒸馏逻辑:
现在 trajectory 来自 Student 自己。Student 先生成回答,再考察这些回答在 Teacher 分布下的概率。
这种区别在 LLM 中尤其重要,因为语言模型的输出空间极其庞大。同一个问题可能存在大量语义正确、风格不同、推理路径不同的回答。Forward KL 会尝试覆盖 Teacher 赋予较高概率的各种输出;Reverse KL 则允许 Student 忽略部分 Teacher mode,只要自己选择的那部分行为始终落在 Teacher 的高概率区域即可。
因此,RKL 往往具有更强的 mode-seeking 特征:Student 可以集中学习 Teacher 最偏好的某一类回答,而不必完整复现 Teacher 的全部行为模式。相应地,它也更容易牺牲输出多样性,甚至集中到少数几个 mode 上。
这两个方向为后面很多后训练方法埋下了伏笔。SFT 可以看成一种以数据分布为目标的 Forward-KL-style 学习;经典 Teacher-to-Student 蒸馏同样天然对应 FKL;而当训练过程开始从 Student 自己的 policy 中采样,再利用 Teacher、Reward Model 或其他外部信号评价这些样本时,整个学习过程就逐渐转向了RL/On Policy Distillation视角
SFT - Supervised Fine-Tuning(监督微调)
SFT 的设定非常直接:我们首先拥有一个已经标注好的数据集,其中的回答可能由人工编写,也可能由更强的 Teacher 模型生成。但无论数据从哪里来,有一个共同点——在训练开始之前,这批监督数据就已经固定下来。随后,我们在初始模型上进行标准的交叉熵训练。用分布的语言来说:
- 定义输入给LLM的上下文为 \(x\),模型的输出为 \(y\),则训练数据定义了一个经验分布 \(p_{\mathcal D}(y\mid x)\);
- 当前模型定义了一个条件分布 \(\pi_\theta(y\mid x)\);
SFT 所做的事情,本质上就是不断把模型分布拉向这个数据分布。
给定一条训练样本 \((x,y^*)\sim\mathcal D\),其中 \(y^*=(y_1^*,\ldots,y_T^*)\) 是标注好的目标回答(共计 \(T\) 个token),自回归语言模型的 SFT 损失可以写成
也就是说,对于数据集中的每一个 token,我们都要求模型提高目标 token 的条件概率。由于交叉熵满足
而数据分布 \(p_{\mathcal D}\) 本身不依赖模型参数 \(\theta\),因此最小化 SFT 的交叉熵,在优化意义上就等价于最小化
因此,从上一章的 KL 视角来看,SFT 本质上就是一种 Forward KL 学习:样本来自固定的数据分布 \(p_{\mathcal D}\),这个视角也解释了 SFT 为什么具有很强的“纠偏”倾向。对于某个监督 token \(y_t^*\),它对应的损失为
其中 \(s_t=(x,y_{<t}^*)\) (prompt+已经生成的前缀)。如果模型本来就认为这个 token 很合理,例如 \(\pi_\theta(y_t^*\mid s_t)=0.8\),那么损失很小;但如果数据要求模型输出一个自己原本极不认可的 token,例如其概率只有 \(10^{-4}\),那么对应的负对数似然就会很大。换句话说,模型与监督数据分歧越大的位置,在 SFT 目标带来的梯度越大。这正是 Forward KL 的典型特征:数据分布出现在哪里,模型就必须设法覆盖哪里,哪怕这些区域在当前模型中原本概率很低。
许多工作暗示,这种较为激进的优化行为,可能是导致了SFT灾难性遗忘问题的元凶。不过笔者认为,SFT优化算法本身并不算太激进,因为对于 softmax 的 logit,标准交叉熵梯度本身仍然是有界的。梯度不会出现爆炸
设模型对一个 token 的词表 logits 为 \(z=(z_1,\dots,z_V)\),经过 softmax 得到
\[p_i=\frac{e^{z_i}}{\sum_{j=1}^{V}e^{z_j}}. \]
假设正确 token 是第 \(k\) 个,也就是 one-hot 标签满足 \(y_k=1\),其余 \(y_i=0\)。于是根据链式法则,
\[\frac{\partial \mathcal L}{\partial z_k} = \frac{\partial \mathcal L}{\partial p_k} \frac{\partial p_k}{\partial z_k} = -\frac{1}{p_k}\cdot p_k(1-p_k). \]
前面的 \(1/p_k\) 与 softmax 导数中的 \(p_k\) 正好抵消,因此
\[\frac{\partial \mathcal L}{\partial z_k} = p_k-1. \]
由于 \(p_k\in[0,1]\),所以
\[-1\le \frac{\partial \mathcal L}{\partial z_k} \le 0. \]
即使模型把正确 token 的概率压到了 \(10^{-10}\)、\(10^{-100}\),甚至趋近于 0,对正确 token logit 的梯度也只是趋近于
而不是趋向负无穷。
一个有意思的解释来自 Dynamic Fine-Tuning(DFT)这项工作(On the Generalization of SFT: A Reinforcement Learning Perspective with Reward Rectification):作者把 SFT 的梯度重新改写成了 policy gradient 的形式,从而发现标准 SFT 可以解释为一种非常特殊的 reward。
为了看清这一点,先忽略序列结构,只考虑某个状态 \(s\) 下的目标 token \(a^*\)。标准 SFT 的梯度为
我们可以人为地在当前模型 \(\pi_\theta\) 下进行采样,并把它等价地改写成
如果把它和标准 policy gradient
放在一起看,就会发现 SFT 隐含的 reward 实际上是
这个 reward 有两个非常特殊的性质。首先,它极其稀疏:只有当采样 token 恰好等于监督 token \(a^*\) 时才非零。其次,更关键的是,它与模型给监督 token 的概率成反比。模型越不相信数据中的 token,\(\pi_\theta(a^*\mid s)\) 越小,对应的隐式 reward \(1/\pi_\theta(a^*\mid s)\) 就越大。
因此,从这个 policy-gradient 视角来看,标准 SFT 会特别强调那些当前模型与监督数据分歧最大的 token。一个本来就被模型认为合理的 token 不需要太多修正,而一个模型原本认为极不合理的 token 会得到非常强的纠偏信号。DFT 的作者认为,这种逆概率加权会促使模型过度贴合训练样本,从而限制 SFT 的泛化能力。这篇工作的直接论点主要是 generalization 和 overfitting,;不过笔者认为,从直觉上说,过度修改模型原本低概率区域,确实也与后训练中常见的预训练能力覆盖和遗忘问题密切相关。
DFT 的改动因此非常直接。对于每一个监督 token,它不再单纯使用
而是使用
其中 \(\operatorname{sg}(\cdot)\) 表示 stop-gradient,也就是说前面的概率只作为权重使用,不参与反向传播。实现上几乎只需要在普通 SFT loss 前乘上当前模型对目标 token 的概率,并对这个概率 detach。
这样做的意义在 policy-gradient 视角下非常清楚:前面额外乘上的 \(\pi_\theta(a^*\mid s)\),恰好抵消了标准 SFT 中隐含的 \(1/\pi_\theta(a^*\mid s)\)。于是原来的
被校正成了近似统一的
这样一来,一个模型原本极不相信的监督 token,不再因为 \(1/\pi_\theta\) 而获得额外夸张的权重,训练会更加平滑。DFT 在 ICLR 2026 的实验中也报告了相比标准 SFT 更好的数学、代码和多模态任务泛化表现。
KL 散度视角看 RL
前面讨论 SFT 时,我们把训练理解成了一个分布拟合问题:数据来自目标分布 \(p_{\mathcal D}\),模型 \(\pi_\theta\) 去提高这些数据的概率,因此 SFT 对应于最小化 Forward KL。到了 RL,视角会发生一个关键变化:训练数据不再必须预先存在,而是由当前模型自己生成。
对于语言模型,可以把一个 prompt \(x\) 看成初始状态,把完整回答 \(y=(y_1,\ldots,y_T)\) 看成一条 trajectory。最简单的强化学习目标就是让模型生成高奖励的回答:
这里与 SFT 最大的区别已经出现了:期望是在当前模型自己的分布 \(\pi_\theta\) 上计算。利用 log-derivative trick,
实际算法中通常不会直接使用原始 reward,而是使用减去 baseline 后的 advantage \(A\),从而得到我们熟悉的 Policy Gradient:
因此,Policy Gradient 的直觉其实非常简单:先让模型按照自己的分布生成答案,然后增加高 advantage 轨迹的概率,降低低 advantage 轨迹的概率。
有趣的是,一旦给 RL 引入 KL regularization,它就可以和前面讨论的 FKL/RKL 非常漂亮地统一起来。考虑现代 LLM 后训练中常见的 KL-regularized RL objective:
其中 \(\pi_{\mathrm{ref}}\) 通常是 RL 开始之前的模型。reward 希望 policy 往高奖励区域移动,而 KL 项则不希望它离原始模型太远。
定义一个 reward-induced target distribution
也就是说,我们首先以 \(\pi_{\mathrm{ref}}\) 为基础,再根据 reward 对不同回答的概率重新加权:reward 越高,对应概率就越大。将其代入 Reverse KL,
稍作整理就得到
其中 \(Z\) 与待优化的 policy 无关,因此
于是,KL-regularized RL 可以被理解为被理解为 Reverse KL :当前 policy \(\pi\) 正在逼近一个由 reference model 和 reward 共同定义出来的目标分布 \(p^*\)。
这与 SFT 构成了一个非常漂亮的对照。SFT 是
也就是从目标数据分布采样,让模型去覆盖目标分布;KL-regularized RL 则是
也就是从模型自己的分布采样,让这些样本逐渐集中到目标分布的高概率区域。
不过现代 PPO、GRPO 已经变成了更加工程化的 probability-ratio clipping。可以参见本系列之前的博客:https://zhuanlan.zhihu.com/p/2077541116409393747 .
我们引入另一个比 FKL/RKL 更基础的概念:on-policy 和 off-policy。
所谓 on-policy,就是:训练模型的数据来自这个模型自己当前的 policy。 当前模型是 \(\pi_{\mathrm{old}}\),就让 \(\pi_{\mathrm{old}}\) rollout 出一批 trajectory,然后利用这些 trajectory 更新 policy。PPO、GRPO 虽然会对同一批 rollout 做若干次 gradient update,使得正在训练的 \(\pi_\theta\) 与生成数据时的 \(\pi_{\mathrm{old}}\) 出现轻微偏离,但整体训练循环仍然是“当前模型 rollout → 更新 → 重新 rollout”,因此通常被归为 on-policy 方法。
off-policy 则意味着训练数据来自另一个 behavior distribution。比如一个 Teacher 已经提前生成了十万条 reasoning trajectory,Student 此后一直在这些固定数据上训练。那么无论 Student 在训练过程中发生了什么变化,它看到的仍然是 Teacher 当时产生的轨迹。
严格来说,SFT 并不是一个 RL 算法,因此把 SFT 直接称作“off-policy”并不规范。但如果我们只讨论训练数据由哪个分布产生,那么传统SFT 或 offline distillation 显然具有非常典型的 off-policy 特征:
而 RL 则是
这时候就可以发现,on/off-policy 和 FKL/RKL 虽然不是同一组概念,却存在非常深的结构联系。
FKL
要求从目标分布 \(p\) 中采样,再训练 \(q\)。因此它天然呈现出off policy风格。
RKL
则要求从正在优化的 \(q\) 中采样,再利用目标分布 \(p\) 去评价这些样本。因此它天然呈现出on policy风格。
于是从采样视角来看,
而
on/off-policy 描述的是数据究竟由哪个 behavior policy 生成,FKL/RKL 描述的是 KL 两侧分布的方向。二者不能混为一谈。但对于 SFT、distillation 和 LLM RL 这些我们最关心的场景,这种对应关系非常有解释力。
这一视角还可以帮助我们理解一个近几年越来越受到关注的现象:为什么在完成相同新任务的情况下,RL 往往比 SFT 更不容易遗忘模型原有能力?
传统 SFT 中,Student 被要求学习一批固定的 Teacher trajectory。问题在于,Teacher 的行为分布并不一定符合 Student 自己原有的概率结构。一个对于 Teacher 十分自然的 reasoning step,对于 Student 来说可能恰好是一个极低概率 token;一条对 Teacher 很自然的思维轨迹,也可能经过大量 Student 自己几乎不会访问的状态。
Teacher forcing 进一步放大了这种 mismatch。在训练第 \(t\) 个 token 时,模型看到的 prefix 是 Teacher 的真实前缀 \(y_{<t}^{T},\) 而不是 Student 自己生成到第 \(t\) 步时真正可能到达的 \(y_{<t}^{S}.\)
于是 Student 被不断拉向一条外部提供的轨迹,而这条轨迹可能并不位于 Student 原本的高概率区域。随着训练继续,这种外部轨迹对模型参数和内部表征施加持续作用,因此更容易覆盖或者干扰 base model 原有的能力。
RL 的情况则不同。无论 reward 来自 Reward Model 还是 verifier,只要我们进行的是 on-policy rollout,训练首先从 Student 自己会产生的 trajectory 开始:
模型已经认为某条 trajectory 几乎不可能,就基本不会访问那里;模型当前习惯使用怎样的 reasoning pattern,训练就主要在这些 pattern 附近发生。reward 所做的事情更像是在 Student 已有行为流形内部进行筛选:好的 trajectory 被加强,坏的 trajectory 被压低,而不是强行把一个外部轨迹塞进模型。
因此,即使完全拿掉显式的 KL regularization,只剩下最基本的
它已经无法再被简单地写成前面那个带有限 \(\beta\) 的标准 Reverse KL ,但它仍然保留了一个极为重要的性质:它是 on-policy 的。 越来越多的研究正在说明,on policy 本身可能是 RL 更抗遗忘的重要来源。
On Policy Distillation (OPD)
所谓 On-Policy Distillation(OPD),核心并不复杂:在蒸馏过程中,不再让 Student 模仿 Teacher 预先生成好的轨迹,而是让 Student 按照自己的 policy 进行 rollout,再让 Teacher 在 Student 真正访问到的状态上提供监督信号。 因此,它与传统 SFT / offline distillation 最本质的区别,而在于训练数据来自谁。
具体来说,Student 首先按照自己的 policy 生成回答:
于是,在第 \(t\) 个位置,Student 实际访问到的 prefix 为 \(s_t=(x,y_{<t})\)。rollout 完成之后,我们把这些 prefix 当作固定的训练条件。Teacher 和 Student 随后在同一个 Student prefix 上分别给出 next-token distribution。为了兼容后面讨论的 Self-Distillation,这里允许 Teacher 额外获得 privileged context \(c\),例如 demonstration、答案或其他特权信息。因此 Student 和 Teacher 的分布分别为
如果选择 Reverse KL 作为局部蒸馏目标,那么在第 \(t\) 个位置有
把 KL 在整个词表 \(\mathcal V\) 上展开:
为了简化符号,暂时记
由于 Teacher 是固定的,因此 \(p_t\) 与待优化参数 \(\theta\) 无关。直接对当前位置的 Reverse KL 求梯度:
再利用恒等式
可以得到
因为
因此,第 \(t\) 个位置上的 Reverse KL 梯度最终可以写成
最后,对 Student rollout 中的所有 token 位置求和,并对 Student 产生的 trajectory 取期望,就得到整个 OPD 的梯度形式:
这里特别注意:外层的 \(y\sim\pi_\theta\) 描述的是 Student 如何产生训练 prefix。在实际训练时,rollout 完成以后这些 prefix 会被视为固定数据。因此这里的 on-policy,首先是一个数据分布层面的概念:Student 在自己真正会访问的状态上接受 Teacher 的指导。
这也引出了理解 OPD 最重要的第一个问题:on-policy 到底体现在哪里? 答案是
传统 SFT 或 offline distillation 中,训练 trajectory 通常来自固定数据或者 Teacher:
Student 被要求在“别人走过的轨迹”上学习。而 OPD 中,trajectory 来自 Student 自己:
Student 会怎么思考、会走进哪些 prefix、会在哪些地方产生偏差,Teacher 就去这些 Student 真正访问到的状态上进行指导。因此 OPD 所解决的核心问题之一,就是 Teacher trajectory 与 Student 自身行为分布之间的 mismatch。
OPD 是否等价于 Reverse KL?
并不是。Reverse KL 只是上面推导中选择的一种 local distillation objective:
我们完全可以在同样的 Student rollout 上改用 Forward KL:
也可以采用 Jensen–Shannon Divergence(JSD)或者其他 divergence。换句话说,“谁产生 prefix”和“Teacher、Student 用什么散度进行匹配”是两个彼此独立的设计维度。 事实上,即使使用 token-level Forward KL,只要训练 trajectory 来自 Student 自己,它依然保留了 on-policy distillation 的核心性质。
这也呼应了前文关于灾难性遗忘的讨论。相比在这个局部问题上纠结究竟使用 FKL、RKL 还是 JSD,笔者更倾向于认为,SDFT 等方法减轻遗忘的关键因素之一,是 Student 不再被强迫拟合一条与自身行为分布可能严重不匹配的外部 trajectory,而是在自己真正会访问的状态上接受监督。
参考文献
[1] 卢明冬. 机器学习中的各种熵. 卢明冬的博客, 2019. https://lumingdong.cn/various-entropies-in-machine-learning.html
[2] Rishabh Agarwal, Nino Vieillard, Yongchao Zhou, Piotr Stanczyk, Sabela Ramos Garea, Matthieu Geist, Olivier Bachem. On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes. ICLR 2024.
[3] Idan Shenfeld, Mehul Damani, Jonas Hübotter, Pulkit Agrawal. Self-Distillation Enables Continual Learning. 2026.
[4] wh. SFT, RL, and On-Policy Distillation Through a Distributional Lens. Blog. https://nrehiew.github.io/blog/sft_rl_opd/
[5] Yuxin Gu, Li Dong, Furu Wei, Minlie Huang. MiniLLM: Knowledge Distillation of Large Language Models. ICLR 2024.

 浙公网安备 33010602011771号