OO第三单元博客作业
OO第三单元博客作业
一 总结分析自己实现规格所采取的设计策略
这一单元的作业整体来说是比较清楚明白的。在设计的时候主要是以下策略。
1)从简单的下手,先保证正确性
在设计时,先从简单的class下手,最后设计JML复杂的class,因为我们的程序中各个类之间的交互比较复杂,这是我们在刚开始写的时候无法很快领会的。而从JML简短的class下手更能降低这种复杂交互的可能性。这样写到最后面对复杂交互的时候会发现交互的其他class都已经实现,这样自然会理解复杂类型用到的方法。在我们的作业中就是先写Person等类,最后再写交互关系最复杂的Network。
2)结合方法名的基础上整体理解JML编写代码,在写完后进行充分的测试,保证正确性。
这一点在后面会讲,不再赘述。
3)最后进行性能的优化,优化的主要策略为字段缓存,使用复杂度更低的算法等。
二 结合课程内容,整理基于JML规格来设计测试的方法和策略
1.使用Junit测试
Junit测试是针对Java程序的最小功能单元测试的方法,也即针对单个Java方法的测试。
JUnit是一个开源的Java语言的单元测试框架,我们可以非常简单地组织测试代码,并随时运行它们,Junit就会给出成功的测试和失败的测试,还可以生成测试报告。
在测试的时候需要根据JML中声明(signal)的多种情况全面的覆盖输入数据,并且在每一种情况下的边界情况下尽量考虑。
优势:
-
Junit编写及其简单,集成在IDEA中,可以在写完一个方法后随时进行测试。
-
对于较为简单的方法,Junit手写测试可以确保所写代码基本覆盖JML中声明的所有情况,主要可以避免一些基本的逻辑错误。
-
JML是针对方法的测试,而且在出错后会生成错误报告,可以快速确定bug,方便debug。
劣势:
-
在我的测试中,Junit的输入数据都是靠手动构造,这样的话数据肯定不够强,只能把基本的情况测一下,测试的强度无法保证。
-
Junit的输出也是根据输入手动计算的,这样的话如果对JML的理解本身就有问题的话,很容易导致手写的标准输出也是错的,强度很低。
2.使用JML语言的应用工具链
这一块我做作业的时候没有使用,昨晚才听人说在blog上看见,感觉很厉害,这些工具可以根据JML给的规格自动生成各种数据并进行正确性检查。这样就保证了测试的强度,解决了我手写Junit的问题。由于我也没用过,这里就放出链接大伙可以试试
https://blog.csdn.net/denglili2090/article/details/101237257
3.使用数据生成器+对拍器
我主要使用的是这种方法,在完成了所有的类和方法并用Junit简单做了测试之后,就可以使用一个数据生成器生成大批量数据,在检验正确性的时候这个数据可以很大,由于这个单元指令都很整齐,构造随机生成器并不复杂。我这里使用C++来构造的,用python会更加方便。
一个简单的例子
#include<iostream>
#include<stdlib.h>
#include<time.h>
using namespace std;
int person_id[123456];
int Group_id[10];
int getPersonid(){
	return rand()%10000;
}
int getValue(){
	return rand()%1000;
}
int getAge(){
	return rand()%200;
}
char *randstr(char *str, const int len)
{
    int i;
    for (i = 0; i < len; ++i)
    {
        switch ((rand() % 3))
        {
        case 1:
            str[i] = 'A' + rand() % 26;
            break;
        case 2:
            str[i] = 'a' + rand() % 26;
            break;
        default:
            str[i] = '0' + rand() % 10;
            break;
        }
    }
    str[++i] = '\0';
    return str;
}
char name[20];
int main(){
	srand((unsigned)time(NULL));
	int num_ap = 1000;
	int cnt_id = 0;
	for(int i=0;i<num_ap;i++){
		int newid = getPersonid();
		person_id[cnt_id++] = newid;
		cout<<"ap "<<newid<<" "<<randstr(name,10)<<" "<<getAge()<<"\n";
	}
	cnt_id = 0;
	for(int i=0;i<9;i++){
		int newid = getPersonid();
		Group_id[cnt_id++] = newid;
		cout<<"ag "<<newid<<"\n";
	}

	for(int i=0;i<1000;i++){
		int index_personid = rand()%num_ap;
		int index_groupid = rand()%9;
		cout<<"atg "<<person_id[index_personid]<<" "<<Group_id[index_groupid]<<"\n";

	}
	for(int i=0;i<1100;i++){
		int index_personid1 = rand()%num_ap;
		int index_personid2 = rand()%num_ap;
		cout<<"ar "<<person_id[index_personid1]<<" "<<person_id[index_personid2]<<" "<<getValue()<<"\n";

	}
	for(int i=0;i<1500;i++){
		cout<<"qbs"<<"\n";
	}
	for(int i=0;i<333;i++){
			int index_personid1 = rand()%num_ap;
		int index_personid2 = rand()%num_ap;
		cout<<"qci "<<person_id[index_personid1]<<" "<<person_id[index_personid2]<<"\n";
	}
}
生成之后就可拉上几个小伙伴进行对拍了,这样的话找的人不是特别拉胯的话都是可以找出bug的。
优势:
- 这样测试,测试强度比较强。
劣势:
- 需要找同学来对拍,没有标准输出,只能比较,理论上是不能保证正确性的。
- 无法自己测试,需要找人,而且在多个人出问题时不好判断谁是对的。
改进:
使用python的一个图论库NetworkX,将此作为标准输出。
三 总结分析容器选择和使用的经验
Java内置了很多容器,选择合适的容器可以极大的改善程序的性能。
ArrayList
- 优点:遍历元素和随机访问元素的效率比较高
- 缺点:添加和删除需大量移动元素效率低,按照内容查询效率低
ArrayList性能不是很优秀,选择的优先级比较低,我整个程序没有使用。
LinkedList
- 采用双向链表存储方式。
- 缺点:遍历和随机访问元素效率低下
- 优点:插入、删除元素效率比较高(但是前提也是必须先低效率查询才可。如果插入删除发 生在头尾可以减少查询次数)
LinkedList在头节点插入的高效性让我用在了Person类型的messages中。
主要由于sendMessage有将信息插到messages容器的开头的操作。
HashMap
- 维护了key-value的映射,可以一次存放两个信息,并且由容器自动维护对应性。
- 查询性能O(1),十分优秀。
HashMap这单元作业中大量应用在我的代码中,主要是因为这单元社交网络中大量采用独一无二的ID来标记对象,这和Map的结构不谋而合,而且大量的查询操作HashMap的优势很明显。
而且HahsMap维护的是key-value两个信息,可以对应到JML的两个容器,一举两得。
例如:
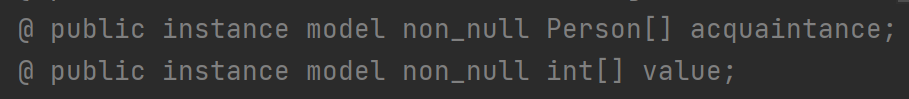
由于personId可以唯一标记一个person,我们可以直接使用id-value一个HashMap来记录Person之间的关系。
private final HashMap<Integer, Integer> value;
四 性能提高
缓存策略
面对quary方法每次都要将图遍历进行计算,我们可以把要查询的内容当作图本身的属性,从而只需要在某些操作后对这些属性进行修改。
例如:qbs在JML中是遍历产生的,但是JML只是规定了结果符合的规则,并不要求我们一定要遍历实现。因此我将blocknum作为一个字段存放在图中,在ap,ar的时候对blocknum进行相应的修改即可。
与此类似的例子有很多,例如第二次作业中的ageMean,ageVar等,这种方法重点是理解图的工作过程,找到什么时候这些字段需要改变,否则会漏写,答案肯定是错误的。
并查集
并查集是处理是一种简洁的数据结构,主要用于解决一些元素分组的问题,它管理了一系列不相交的集合,并支持合并与查询。
并查集与离散二中学过的分割是类似的,将某些具有相同性质的元素划分成一个集合,这与划分连通分量相匹配。因此,使用并查集来管理连通分量的查询(isCircle)可以使查询直接到O(logn)。
堆优化的Dijkstra
一般的Dijkstra算法使O(n2)的复杂度,主要是因为每次操作后需要找到当前dist最短的元素作为下一个确定最短路径的节点。而如果要用数组存放的话找最短需要O(n)的遍历。但是使用Java内置的PriorityQueue可以降低这个操作的复杂度。Java内置的PriorityQueue内部采用堆来维护节点之间的大小关系,可以O(logn)的复杂度直接找到最小,将O(n2)的Dijkstra优化成为了O(nlogn).有效降低了复杂度。
五 作业架构设计
作业并没有使用传统的邻接矩阵或者邻接表的方法,对于一个图,在MyNetwork层只需要记录所有的人,群和消息,而不关注人与人之间的关系,群的内部结构。
关系由person层下的HashMap value维护关系。这样的好处是在维护图的时候加减关系是在Person层完成的,Network层只需要负责管理加减人就可以。Network作为比Group,Person,Message更高的层,只需要管理这些类型元素的个数增减即可,底层的变化由下层封装好再由Network上层调用。
例如:addRelation作为一个Network的方法
MyPerson person1 = (MyPerson) people.get(id1);
MyPerson person2 = (MyPerson) people.get(id2);
person1.addRelation(person2.getId(), value);
person2.addRelation(person1.getId(), value);
调用person的addRealtion方法:
public void addRelation(Integer id, Integer value1) {
    value.put(id, value1);
    return;
}
将层次划分清楚有利于整个程序的理解和维护。
六.单元感想
这单元整体来说是比较轻松的,得益于这个单元指令比较固定,相互之间没有什么限制,因此我第一次搭了一个比较简易的评测机,并用数据生成器随机生成的数据刀了一些同学,还是挺有收获的。
这个单元主要要搞清楚JML的基本语法,和离散一的内容很多差不太多。然后在写的时候在保证正确性的前提下再去优化复杂度,将正确性和性能进行解耦,万万不可丢失正确性。
这单元我认为收获最大的还是亲身体验了规格-基于规格测试-基于规格编写代码的流程,这样先设计出每一个类的功能规格给编写和测试都带来了极大的方便,将设计和实现和测试再次进行解耦,降低了复杂软件系统的复杂度,这对于我以后开发大规模软件来说是一个宝贵的经验。
OO课快要结束了,随着难度的降低,我现在也越来越从容了,希望能继续加油!!

 浙公网安备 33010602011771号