PyTorch模型调优实战:从64%到91%,手机价格分类的优化全记录
在深度学习项目中,构建一个能运行的模型只是第一步,而将其性能优化到可用的商业级别,才是真正的挑战。本文将以一个经典的手机价格区间预测项目为例,完整展示如何通过系统性的调优策略,将一个基础的PyTorch模型准确率从64%提升至91%。我们将深入探讨数据预处理、网络结构设计、优化器选择等核心环节,为你提供一份可复现的模型优化指南。
一、项目背景:一个典型的多分类问题
设想你正在为一家手机零售商开发智能定价系统。你需要根据手机的20项硬件配置特征(如运行内存RAM、电池容量、摄像头像素等),自动将其归类到4个预设的价格区间中:0、1、2和3。这正是一个典型的多分类任务,非常适合使用神经网络来解决。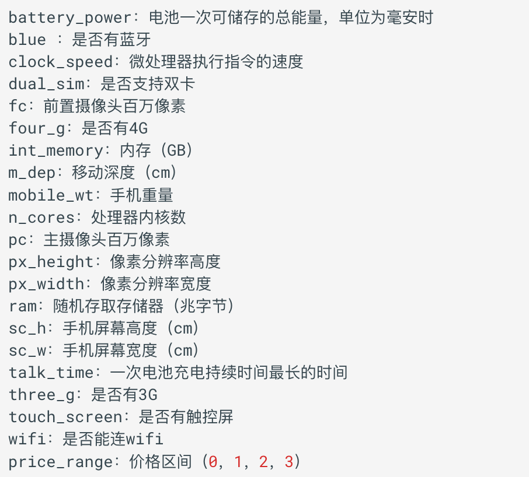 理解问题本质是成功的第一步,这与使用Python进行数据分析、用Go构建微服务API,或是用TypeScript编写前端交互的逻辑是相通的——清晰的定义是高效开发的基础。
二、构建基线模型:我们的起点
在优化之前,我们必须建立一个性能基准。这个基线模型将揭示模型的初始能力,并帮助我们定位后续的优化方向。
1. 环境与数据准备
首先,我们导入必要的库。PyTorch提供了灵活的深度学习框架,而pandas和scikit-learn则在数据处理和评估方面不可或缺。
# 核心框架
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import TensorDataset, DataLoader
# 数据处理与划分
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
# 辅助工具
import timedef create_dataset_base():
"""基础版数据加载函数"""
data = pd.read_csv('./data/手机价格预测.csv')
x, y = data.iloc[:, :-1], data.iloc[:, -1]
x = x.astype(np.float32)
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=3, stratify=y)
train_dataset = TensorDataset(torch.tensor(x_train.values), torch.tensor(y_train.values))
test_dataset = TensorDataset(torch.tensor(x_test.values), torch.tensor(y_test.values))
return train_dataset, test_dataset, x_train.shape[1], len(np.unique(y))2. 定义网络结构与训练流程
我们构建一个简单的三层全连接网络作为起点。这个结构虽然基础,但足以学习数据中的一些初步模式。
class PhonePriceModelBase(nn.Module):
"""基础版神经网络模型"""
def __init__(self, input_dim, output_dim):
super().__init__()
self.linear1 = nn.Linear(input_dim, 128)
self.linear2 = nn.Linear(128, 256)
self.output = nn.Linear(256, output_dim)
def forward(self, x):
x = torch.relu(self.linear1(x))
x = torch.relu(self.linear2(x))
x = self.output(x) # 输出层不加激活,CrossEntropyLoss内部包含了Softmax
return x# 训练函数
def train_base(train_dataset, input_dim, output_dim):
train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True)
model = PhonePriceModelBase(input_dim, output_dim)
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.001) # 使用SGD优化器
epochs = 50
print("--- 开始基础模型训练 ---")
for epoch in range(epochs):
model.train()
for x, y in train_loader:
y_pred = model(x)
loss = criterion(y_pred, y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
torch.save(model.state_dict(), './model/phone_base.pth')
print("--- ✅ 基础模型训练完成 ---")
# 评估函数
def evaluate_base(test_dataset, input_dim, output_dim):
model = PhonePriceModelBase(input_dim, output_dim)
model.load_state_dict(torch.load('./model/phone_base.pth'))
test_loader = DataLoader(test_dataset, batch_size=8, shuffle=False)
correct = 0
model.eval()
with torch.no_grad():
for x, y in test_loader:
y_pred = torch.argmax(model(x), dim=1)
correct += (y_pred == y).sum().item()
accuracy = correct / len(test_dataset)
return accuracy3. 基线结果分析
运行基线模型后,我们在测试集上获得了约64.25%的准确率。这个结果优于随机猜测(25%),证明模型确实学到了一些特征与价格的关系。然而,对于实际的商业应用场景,这个精度远远不够。它为我们指明了明确的优化方向。
三、性能优化四部曲:从理论到实践
模型的低性能通常源于多个因素的共同作用。下面,我们将从四个关键维度实施系统性的优化。这种分步验证、逐个击破的思路,在优化C++程序性能或调试复杂的JavaScript应用时同样有效。
优化一:数据标准化——为模型训练铺平道路
为什么需要标准化? 原始数据中,不同特征的量纲和数值范围差异巨大(例如,电池容量可能以千为单位,而CPU核心数是个位数)。这种差异会导致梯度下降过程震荡,难以收敛。标准化将所有特征缩放到均值为0、方差为1的分布,相当于为模型提供了一个公平的“起跑线”。
from sklearn.preprocessing import StandardScaler
def create_dataset_optimized():
data = pd.read_csv('./data/手机价格预测.csv')
x, y = data.iloc[:, :-1], data.iloc[:, -1]
x = x.astype(np.float32)
y = y.astype(np.int64) # CrossEntropyLoss需要LongTensor类型的标签
x_train, x_valid, y_train, y_valid = train_test_split(x, y, train_size=0.8, random_state=88, stratify=y)
# === ✨ 优化点 ①:数据标准化 ===
transfer = StandardScaler()
x_train = transfer.fit_transform(x_train)
x_valid = transfer.transform(x_valid)
train_dataset = TensorDataset(torch.from_numpy(x_train), torch.tensor(y_train.values))
valid_dataset = TensorDataset(torch.from_numpy(x_valid), torch.tensor(y_valid.values))
return train_dataset, valid_dataset, x_train.shape[1], len(np.unique(y))优化二:深化网络结构——增强模型表达能力
为什么加深网络? 更深的网络拥有更强的非线性拟合能力,可以学习更复杂、更抽象的数据模式。这类似于为一个简单函数库(如基础JavaScript)引入更强大的框架(如React或Vue),以处理更复杂的交互逻辑。我们通过增加网络层数和每层的神经元数量来提升模型的“脑容量”。
class PhonePriceModelOptimized(nn.Module):
def __init__(self, input_dim, output_dim):
super().__init__()
# === ✨ 优化点 ②:使用nn.Sequential构建更深的网络 ===
self.layers = nn.Sequential(
nn.Linear(input_dim, 128), nn.ReLU(),
nn.Linear(128, 256), nn.ReLU(),
nn.Linear(256, 512), nn.ReLU(),
nn.Linear(512, 128), nn.ReLU(),
nn.Linear(128, output_dim)
)
def forward(self, x):
return self.layers(x)
优化三与四:更换优化器与调整超参数
优化器的选择至关重要。 我们将基础的随机梯度下降(SGD)优化器更换为Adam。Adam优化器自适应地调整每个参数的学习率,结合了动量法和RMSProp的优点,在大多数深度学习任务中收敛更快、更稳定。
学习率的精细调整。 配合Adam,我们采用一个更小的初始学习率。这允许模型在训练后期更精细地接近最优解,避免在最优值附近震荡。
def train_optimized(train_dataset, input_dim, class_num):
dataloader = DataLoader(train_dataset, shuffle=True, batch_size=8)
model = PhonePriceModelOptimized(input_dim, class_num)
criterion = nn.CrossEntropyLoss()
# === ✨ 优化点 ③ & ④:使用Adam和更小的学习率 ===
optimizer = optim.Adam(model.parameters(), lr=1e-4)
# ... (训练循环与之前类似) ...
torch.save(model.state_dict(), './model/phone-price-model2.pth')
# 评估函数逻辑不变,只需加载新模型即可
def test_optimized(valid_dataset, input_dim, class_num):
# ... (加载PhonePriceModelOptimized模型并评估) ...
# 此处省略重复代码,与 evaluate_base 类似
四、优化成果与深度对比
经过上述四项优化策略的联合作用,我们重新训练并评估模型。最终,模型在测试集上的准确率跃升至令人瞩目的91.25%!这意味着对于每100台新手机,模型能正确预测其中超过91台的价格区间,具备了很高的实用价值。
| 模型版本 | 核心配置 | 准确率 | 提升幅度 |
|---|---|---|---|
| 基础版 | 3层网络 / SGD | 64.25% | - |
| 优化版 | 5层网络 / 数据标准化 / Adam | 91.25% | +27% |
五、核心总结与进阶思考
通过这个完整的实战案例,我们验证了模型优化中几个颠扑不破的真理:
- 数据质量是基石: 无论模型多复杂,糟糕的输入数据(未标准化)都会严重限制其性能上限。这好比用TypeScript开发项目,严谨的类型定义是后续高效开发的基础。
- 结构决定潜力: 合适的网络深度和宽度为模型提供了强大的学习能力。但需注意,过深的网络也可能导致过拟合,需要配合正则化等技术。
- 优化器是引擎: 选择合适的优化器(如Adam)并搭配恰当的学习率策略,能极大提升训练效率和最终性能。
- 迭代是方法论: 模型开发是一个“构建-评估-分析-优化”的循环过程,需要耐心和系统的实验。
为了让你能够亲手复现并进一步探索,我们提供了完整的项目源码和手机价格预测.csv数据集。你可以尝试调整网络层数、激活函数、加入Dropout层防止过拟合,甚至尝试不同的优化器(如RMSProp),看看能否将准确率提升到新的高度。[AFFILIATE_SLOT_2]
深度学习模型的调优,融合了工程实践与科学实验的艺术。希望本次从64%到91%的旅程,能为你未来的PyTorch项目提供一套清晰、可操作的优化框架。记住,优秀的模型不是一蹴而就的,而是通过持续的分析与精心的调整锻造出来的。

 浙公网安备 33010602011771号