

UFA在团伙检测中的实践
背景介绍
(风控场景下)
壮阳团伙早期通过强介质关联就能较为准确的识别,随着对抗加深,团伙间的关系逐渐由强中关联转移到弱关联,如x月的壮阳case,团伙间都仅在操作IP、注册设备等弱介质上有相关性,而强介质各不相同。在我们的视角,如果某个IP被大量用户使用,则认为该IP异常的可能性比较大,而如果某个操作系统版本被多个用户使用则不属于异常,我们需要找能彰显用户异常的弱介质。
基于弱介质的团伙挖掘和扩散容易导致超大团伙,团伙中可能包含成千上万个主体/账户,导致挖掘结果不可用。此外,以往的弱介质权重根据先验知识人为制定,为固定权重。
为了充分利用弱边信息、自动学习和更新弱边的权重,调研了无监督检测算法UFA。

图1 自助户壮阳,仅能通过操作IP等弱介质关联
图2 强/弱介质扩散结果对比
算法原理
论文原文:Unveiling Fake Accounts at the Time of Registration: An Unsupervised Approach
UFA算法旨在以无监督的方式在微信注册时检测出虚假账号。算法整体流程分为特征提取、无监督权重学习、注册图构建、虚假账号检测四部分。
图3 UFA算法整体流程
论文使用真实世界的微信数据集评估UFA,在召回率为80%的情况下达到了94%的精度,而监督变体需要600K手动标签才能获得可比较的性能。
2.1 特征提取
为了有效提取虚假账户检测的特征,首先对微信的注册数据进行了分析。每条注册数据都包含多个特征属性,如IP、手机号、设备号和系统版本。
数据分析显示,与良性账号相比,虚假账号倾向于形成离群/异常值注册模式。例如虚假账号可能使用相同的IP,使用相同地区的相同电话号码,在夜间活跃或者使用旧版本的微信或者系统。原因猜测可能是攻击者受制于资源有限(比如ip、手机号和设备),只能通过脚本自动化注册。论文剔除的特征提取就是将每个属性转化为“FeaturePrefix_value”的格式,如手机号+861301111xxxx对应的特征为PN_+861301111xxxx。
图4 注册特征和特征前缀
2.2 无监督权重学习
2.2.1 账号-特征异构图构建
构造账号/用户-特征的二部图,捕获账号、特征之间的相关性(这里的账号=用户)。通过将注册用户的特征属性转化为节点,从而将单个用户节点分裂为以用户节点为中心的用户-属性的二部图。用户节点和特征节点间存在边,代表用户在注册时使用了该特征。
图5 “注册账号节点-特征节点”二部图
2.2.2 节点权重初始化
特征节点权重初始化
将特征节点分类为A和B类,针对不同类别的特征节点进行特征权重的初始化。
-
B类特征:B类特征某个值的占比越大,越异常,即这个特征关联多个异常账户。B类特征如IP地址、手机号、设备号、MAC等
-
A类特征:与B类相反,某个值存在大量账户共享的问题,则我们认为这种情况并不异常。A类特征如微信版本、操作系统版本等
考虑到对于A类特征,特征节点共享的账户越多,越正常,节点权重越小;对于B类特征,特征节点共享的账户越多,越不正常,节点权重越大。对于任意的特征节点x,初始权重W_x计算如下:
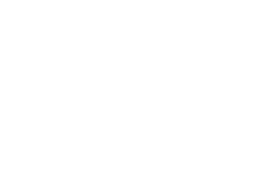
Pre_A、Pre_B分别表示A类特征和B类特征,ratio(x)表示该特征节点值的特征占比,pre(x)表示该特征节点值所属的特征。
然而上述表达式有一个严重问题:不能用于直接比较不同特征下的不同特征节点的节点权重。比如 手机系统版本和手机号 这两个特征的分布,系统版本特征比分布是比较集中的(大部分用户都是集中使用比较新的几个版本),而手机号的特征比分布则比较均匀(用户均匀的分配到不同的手机号段上),这个时候算出来的ratio肯定差别很大的。因此要进行标准化,优化后的初始权重W_x计算如下:
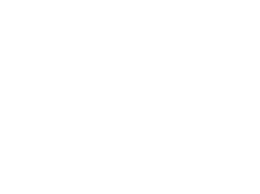
其中:
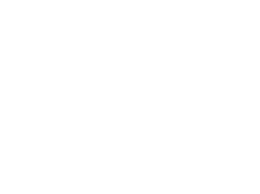
dev(x)考虑了特征节点的异常,base(x)考虑了特征的异常。dev、base、w_x取值都在0~1之间。
mode(pre(x))表示该特征节点所属特征中频率最高的特征节点,ratio(mode(pre(x))指特征类型中占比最大的特征的占比。
我们有一个特征 手机号(属于 B类特征),其下有 1000 个样本,分布如下:
PN_+861582222xxxx:500 个(占比 50%)
PN_+861301111xxxx:300 个(占比 30%)
其他 200 个(占比 20%)

已知:
mode(pre(x)) = 频率最高的特征节点 = PN_+861582222xxxx
ratio(mode(pre(x))) = 最大占比 = 0.5

1. 计算 base
base = ratio(mode(pre(手机号))) = 0.5

2. 计算 dev
ratio(PN_+861582222xxxx) = 0.5     dev = ratio(x) / ratio(mode(pre(x))) = 0.5 / 0.5 = 1.0

ratio(PN_+861301111xxxx) = 0.3     dev = 0.3 / 0.5 = 0.6

3. 计算 weight
weight 是 base 和 dev 的平均值:

对于 PN_+861582222xxxx:weight = (base + dev) / 2 = (0.5 + 1.0) / 2 = 0.75

对于 PN_+861301111xxxx:weight = (0.5 + 0.6) / 2 = 0.55
|
(B类)特征节点 |
ratio(x) |
base |
dev |
weight |
|
PN_+861582222xxxx |
0.5 |
0.5 |
1.0 |
0.75 |
|
PN_+861301111xxxx |
0.3 |
0.5 |
0.6 |
0.55 |
账号节点权重初始化
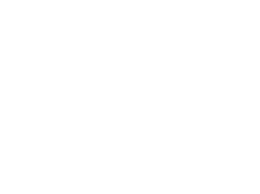
注册账号的初始权重为与账号相连的所有特征节点权重的平均值。下式中\Gamma(r)表示 2.2.1 中账号节点-特征节点二部图中账号节点的所有邻居。
2.2.3 节点权重更新
对所有节点的权重通过线性信念传播进行迭代更新,每一次权重的迭代是上一次节点权重的结果加上各邻居节点权重的平均影响,并且每次的权重仍保持在0-1之间。迭代公式如下:
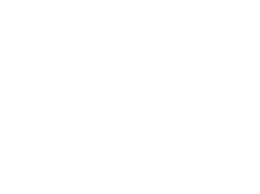
邻居节点即为有边连接的节点,每个注册账号节点和特征节点互为邻居。其中,P_u^{(0)}为节点u的初始权重,P_u^{(t)}表示节点u第t次迭代的权重,\Gamma(u)表示u的所有邻居节点的集合,|\Gamma(u)|表示u的邻居节点数量。
注意:如果某个特征只有一个注册账号节点,则设置特征节点的权重为0.5,不进行迭代更新。
2.3 注册图构建
2.3.1 账号节点相似度计算
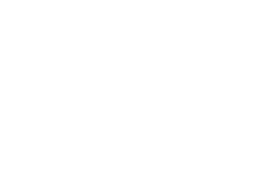
论文的分析关键点在注册账号上,而2.2.1构建的图是异构二部图,转化为同构图的步骤为计算节点之间的相似度,且将相似度作为注册用户之间边的权重。两个注册账号节点u v之间的相似度,为其共有特征节点的权重之和:
2.3.2 账号-账号同构图构建
自然而然想到,若账号间的相似度大于设定阈值,则可认为两个账号节点连上一条边。只考虑账号节点之间的边,就可构建同构图。
当相似度阈值设置为0时,所有的用户都互相连接,随着阈值的不断增大,用户和用户的边逐渐减少,当阈值足够大时,不存在任何边。通过数据分析,发现能使得异常用户相连接的阈值会存在一个小范围的稳定区间,因此阈值设置的逻辑为使得账号-账号同构图的边关系稳定(小区间内保持边关系不改变)的最小阈值。
方式:先将阈值设置成一个较小的值α,此时几乎所有的用户都互相连接,再将阈值每次增加δ,观察最大连通子图下的节点数量,若在连续n次的阈值增加的过程中最大连通图的节点数量几乎保持不变,则第n次的阈值α+nδ设置为当前模型的相似度阈值。
2.4 虚假账号检测
2.4.1 社团发现
基于上述相似度阈值用社区发现、连通图等算法找出所有的连通子图/团伙,当连通子图下的用户节点数大于设定阈值时,则该连通子图的所有账号/用户为异常聚集。聚集用户数的阈值是根据模型的效果来确定的,可以通过不同值的模型效果来确定最佳值。
图6 异常社团和正常社团对比
2.4.2 新账号检测
对于一个新注册用户,获取到其特征后,计算该用户与当前最新模型中的坏用户节点的相似度(即与坏用户特征节点的公共节点权重之和),若与任意一个坏用户节点的相似度大于模型的相似度阈值,则输出为异常聚集,否则认为是正常用户。每注册一个新用户也会触发模型的更新。
图7 用户注册实时策略图
实验步骤
3.1 主体维度实验
数据选择:24年x月xx主体,排除7日消耗过高
特征选择:上述提到过往我们对关系网络中强关联信息使用较多,而对弱关联信息的利用不够充分,且壮阳团伙存在弱关联关系,因此这里选择利用弱介质来进行实验。
-
选择能彰显用户异常模式的弱介质进行实验:如多个账号使用同一个IP注册则被我们认为异常;但若是像时间、操作系统版本如“android 13.0”存在大量账号共享的问题,则我们认为这种情况并不异常,因为操作系统版本号本身就趋向于被大量账号共享。
-
数据分析后我选择将注册设备ID、最后一次操作城市拼接代理商作为训练特征,且为B类特征。
-
最开始选择操作IP而不是城市,但由于IP粒度过细,IP值很分散,导致实验效果不好,考虑到城市粒度可能偏大所以用城市拼接代理商作为特征。
-
最开始选择的登录设备ID,同样因为登录设备IP很分散导致实验效果次优。
-
这里为了训练快捷没有使用A类特征,即操作系统版本,某个版本被大量用户使用也不认为是异常的特征。加入A类特征训练可能得到的信息更充分
数据量级:主体量级6.7w+、边量级10.7w+
实验结果:
-
对挖掘结果进行团伙定性,头部社团均有壮阳风险。且编号0的最大团伙中87%的主体实锤为壮阳黑主体。
图8 主体挖掘结果示意
|
团伙中主体数 |
实锤壮阳黑种子主体 |
社团标签 |
|
97 |
85 |
0 |
|
11 |
7 |
1 |
3.2 账户维度实验
数据选择:
-
回溯25年x月自助户近30天有进审账户
-
排除7日消耗过高的账户
特征选择:(与主体实验类似)将注册设备ID、最后一次操作城市作为训练特征,且为B类特征。这里为了训练快捷没有使用A类特征。加入A类特征训练可能得到的信息更充分
数据量级:账户量级4k、边量级5k
实验结果:
-
准确率:
-
最大社团中账户已实锤为壮阳账户的比例为82%+;
-
人工抽样看多个账户的素材均为壮阳黑五类风险。
-
召回率:
-
回扫xx日大盘漏放的壮阳case:9个case中有8个能被UFA算法召回。
-
人工抽样看不在黑名单的账户大部分为壮阳风险,因此UFA能提高召回率;
算法对比
UFA无监督挖掘算法的核心思想和技术路径与传统的社团挖掘算法(如Louvain)和图神经网络算法(如graphsage)存在本质差异,后两类方法是要基于已有的拓扑图结构和节点属性进行挖掘,而UFA算法的核心思路是特征选择和权重计算,在此基础上构图并捕捉账号之间的关联性。
|
方法 |
核心思想 |
关键差异 |
|
Louvain |
基于模块度(Modularity)最大化,通过贪心算法迭代合并节点,发现紧密连接的社区结构。 |
依赖现有图结构,仅利用拓扑信息,不涉及节点特征或动态权重计算。 |
|
GraphSAGE |
通过邻居采样和聚合(如均值、LSTM)生成节点嵌入,保留局部和全局图结构信息。 |
依赖现有图结构和节点属性,需要预定义的拓扑关系,无法处理孤立节点或动态构图。 |
|
UFA |
无监督特征提取、权重更新 + 动态构图: |
不依赖初始图结构,而是通过特征权重计算节点关联性,再构建图并挖掘团伙 |
不足与思考
每更新一次模型,初始权重都会基于2.2.2中公式重新进行计算,即当前模型节点的初始权重只和当前模型有关,没有去学习历史的权重结果。实际上,对于历史模型认为异常的用户,其特征节点在当前模型中出现时被赋予更高的初始权重可能是更优的方案。
参考文献
[1] https://freewechat.com/a/MzA4OTAwMjY2Nw==/2650194385/1
[2] https://pan.baidu.com/link/zhihu/7Eh3zQuTh5iGVFhj1iVzoMtEMhT4MHSQQoF2==

 浙公网安备 33010602011771号