从树到堆:一文搞懂堆排序与TopK问题的底层逻辑
数据结构是编程的基石,而堆(Heap)作为其中一种高效且应用广泛的非线性结构,在机器学习、深度学习以及AI算法中扮演着关键角色——无论是优先队列调度还是TopK问题求解,都离不开它。本文将从树的概念出发,带你逐步深入二叉树的顺序存储,最终彻底掌握堆的实现、堆排序以及TopK问题的解法。全文配图丰富,适合初学者和进阶者阅读。
1. 树的概念与结构
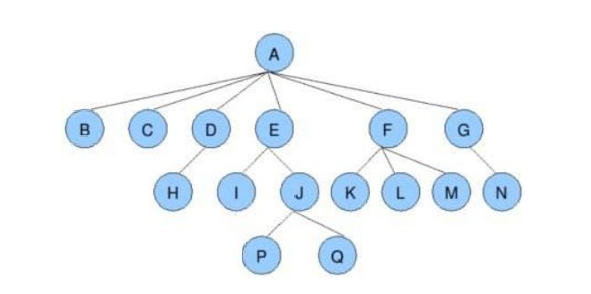
树是一种非线性的数据结构,由 n(n≥0)个有限结点组成,具有层次关系。之所以称为“树”,是因为它的形态像一棵倒挂的树——根朝上,叶朝下。树有一个特殊的根结点,它没有前驱;其余结点被分成 M 个互不相交的集合,每个集合本身又是一棵子树。这种定义方式使得树具有天然的递归特性。
以下是树中常用的相关概念:
- 结点的度:结点拥有的子树数
- 树的度:树内各结点度的最大值
- 叶子结点:度为 0 的结点
- 父结点与子结点:若 A 是 B 的父结点,则 B 是 A 的子结点
- 层次与深度:根为第 1 层,深度为最大层数
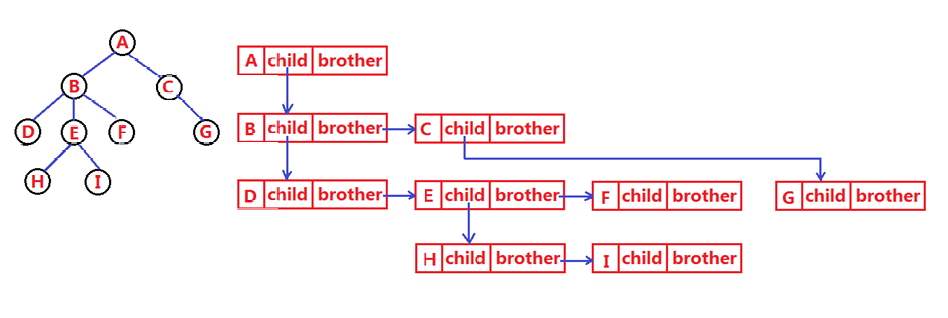
树的存储方式有多种,最常用的是孩子兄弟表示法,每个结点包含数据域、指向第一个孩子的指针和指向下一个兄弟的指针。这种表示法既节省空间,又便于遍历。
typedef int DataType;
struct Node
{
struct Node* firstChild; // 第一个孩子结点
struct Node* pNextBrother; // 指向其下一个兄弟结点
DataType data; // 结点中的数据域
};
2. 二叉树的概念与性质
二叉树是每个结点最多有两个子树的树结构,分为左子树和右子树。二叉树可以是空集,也可以由根结点加上左右子树构成。它的两个重要特征是:每个结点度数不超过 2,且子树有左右之分,不能颠倒。
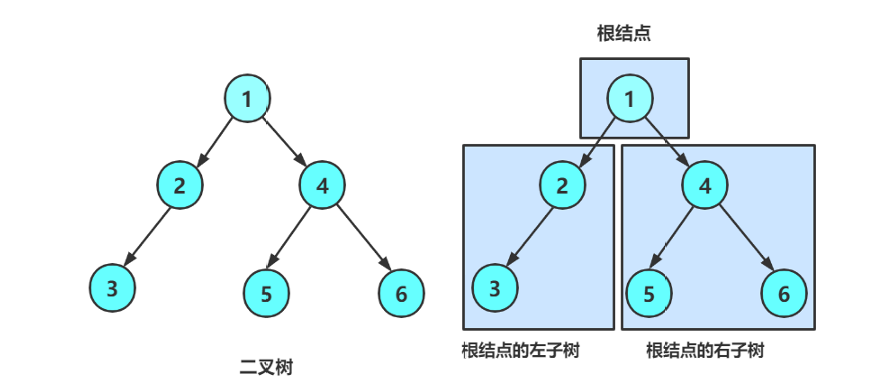
任意二叉树都由以下几种基本形态组合而成:
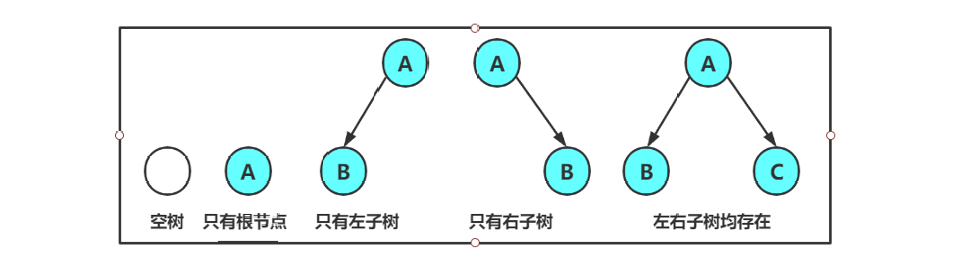
2.1 特殊二叉树
有两种特殊的二叉树值得关注:
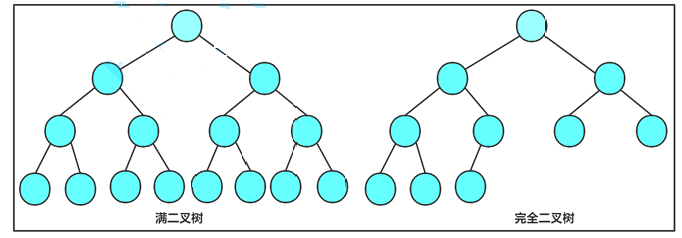
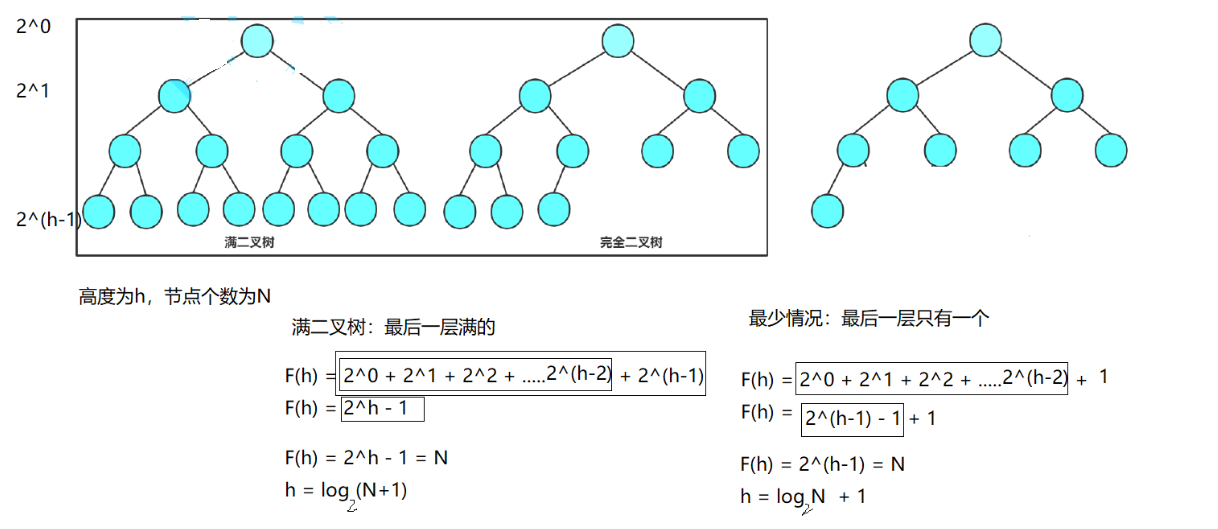
- 满二叉树:每一层的结点数都达到最大值。若层数为 K,则总结点数为 2^K - 1。
- 完全二叉树:除最后一层外,其他层结点数均达到最大,且最后一层的结点从左到右连续排列。满二叉树是特殊的完全二叉树。
2.2 二叉树的性质
以下是二叉树的一些重要性质:
- 第 i 层最多有 2^(i-1) 个结点(根为第 1 层)
- 深度为 h 的二叉树最多有 2^h - 1 个结点
- 叶子结点数 n0 与度为 2 的结点数 n2 满足:n0 = n2 + 1
- 具有 n 个结点的完全二叉树深度为 ⌊log₂n⌋ + 1
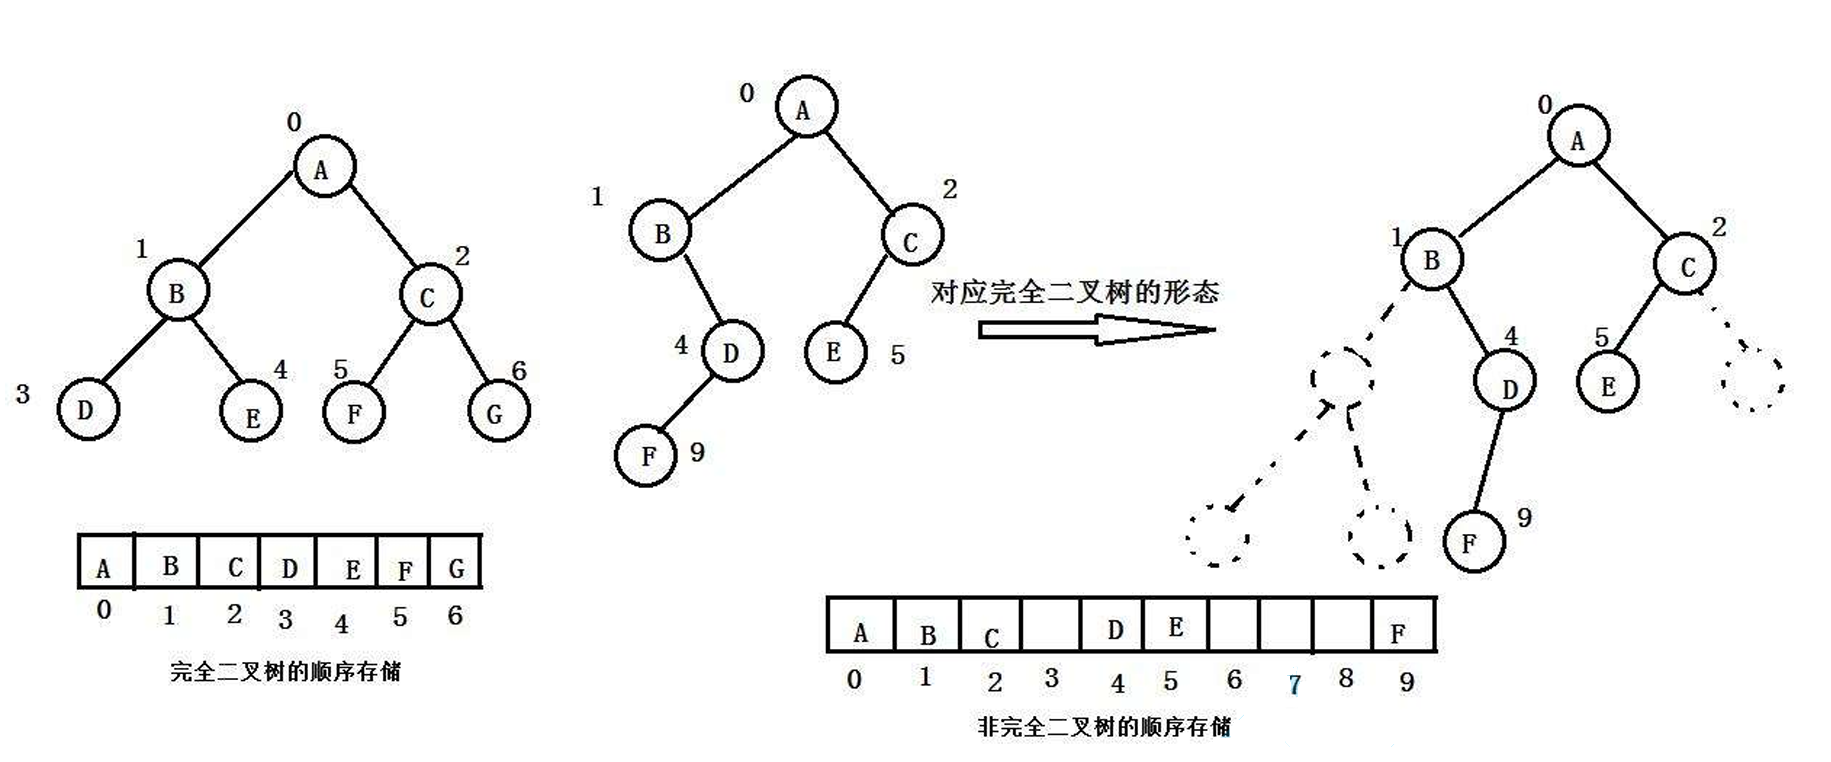
• 若i>0,i位置结点的双亲序号:(i-1)/2;i=0,i为根结点编号,无双亲结点
• 若2i+1<n,左孩子序号:2i+1,2i+1>=n,否则无左孩子
• 若2i+2<n,右孩子序号:2i+2,2i+2>=n,否则无右孩子
3. 二叉树的顺序存储与堆的实现
二叉树的存储方式主要有两种:顺序存储(数组)和链式存储(链表)。顺序存储只适合完全二叉树,因为非完全二叉树会导致数组空间浪费。现实中,只有堆这种数据结构使用数组存储。
3.1 堆的概念
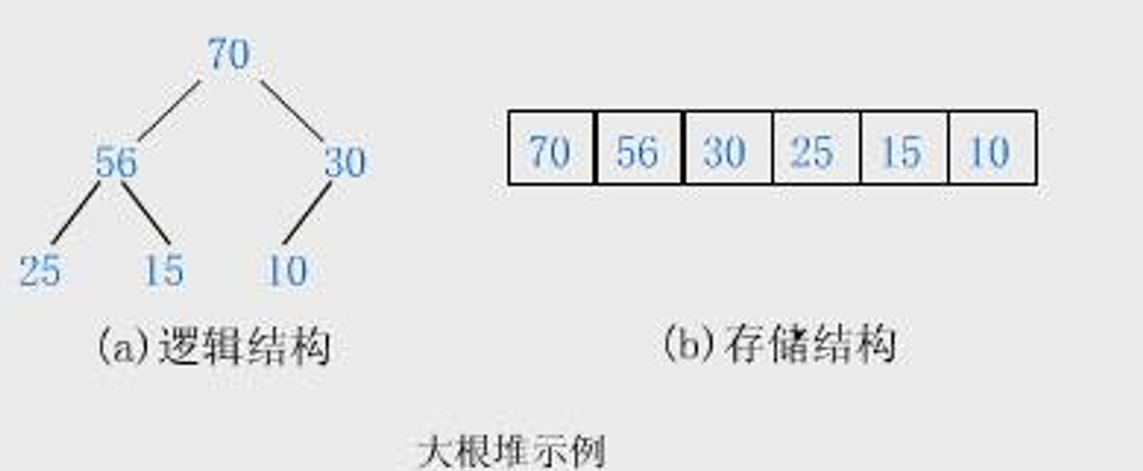
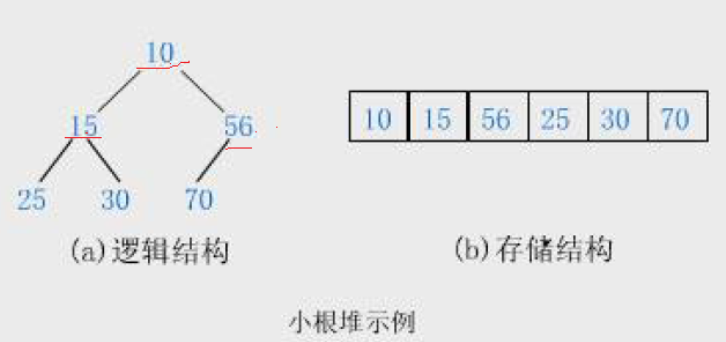
堆是一种完全二叉树,且满足以下条件:
- 大堆:每个父结点的值 ≥ 子结点的值,根结点是最大值
- 小堆:每个父结点的值 ≤ 子结点的值,根结点是最小值
⚠️ 注意:这里的堆与操作系统中的“堆内存”是完全不同的概念,一个是数据结构,一个是内存管理区域。
3.2 堆的基本操作
堆的核心操作包括:
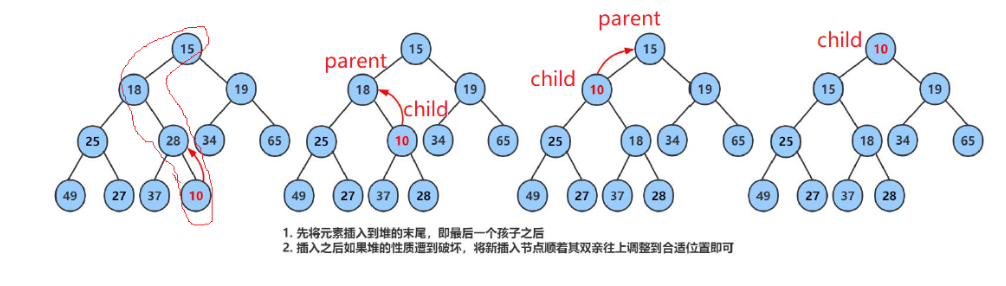
- 向上调整算法:从最后一个结点开始,与父结点比较并交换,直到满足堆性质
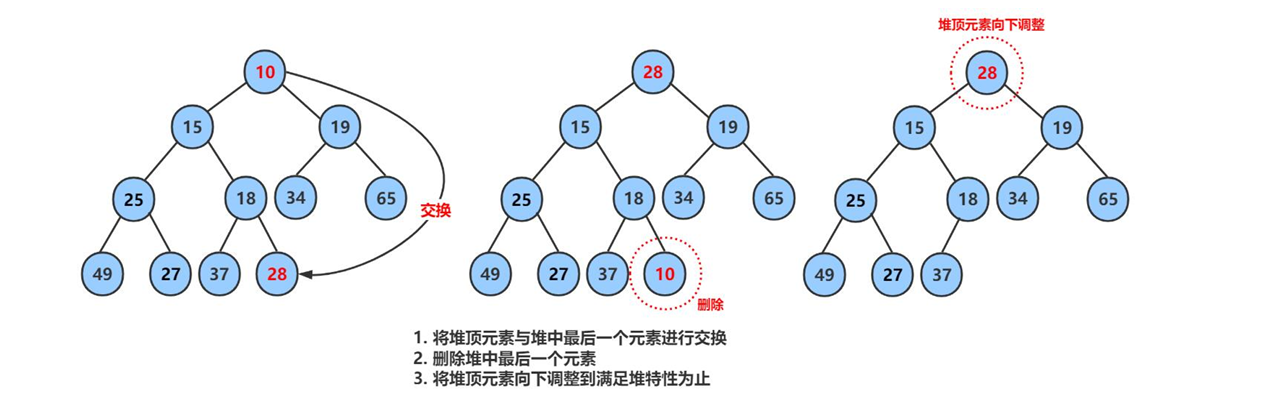
- 向下调整算法:从根结点开始,与较大的子结点比较并交换,直到满足堆性质
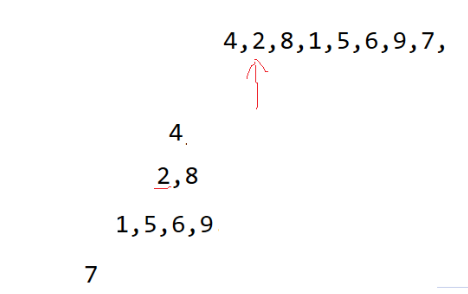
向上调整算法的代码实现如下:
void Swap(HPDataType* p1, HPDataType* p2)
{
	HPDataType tmp = *p1;
	*p1 = *p2;
	*p2 = tmp;
}
void AdjustUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)
	{
		if (a[child] < a[parent])
		{
			Swap(&a[child], &a[parent]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
		{
			break;
		}
	}
}
向下调整算法则从第一个非叶子结点开始,逐步向下调整:
void AdjustDown(HPDataType* a, int n, int parent)
{
	int child = parent * 2 + 1;
	while (child < n)
	{
		if (child + 1 < n && a[child + 1] > a[child])
		{
			child++;
		}
		if (a[child] > a[parent])
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else
		{
			break;
		}
	}
}
3.3 堆的插入与删除
插入:将新元素放到数组末尾,然后执行向上调整算法。
删除:将堆顶元素与最后一个元素交换,删除最后一个元素,然后对堆顶执行向下调整算法。
3.4 堆排序
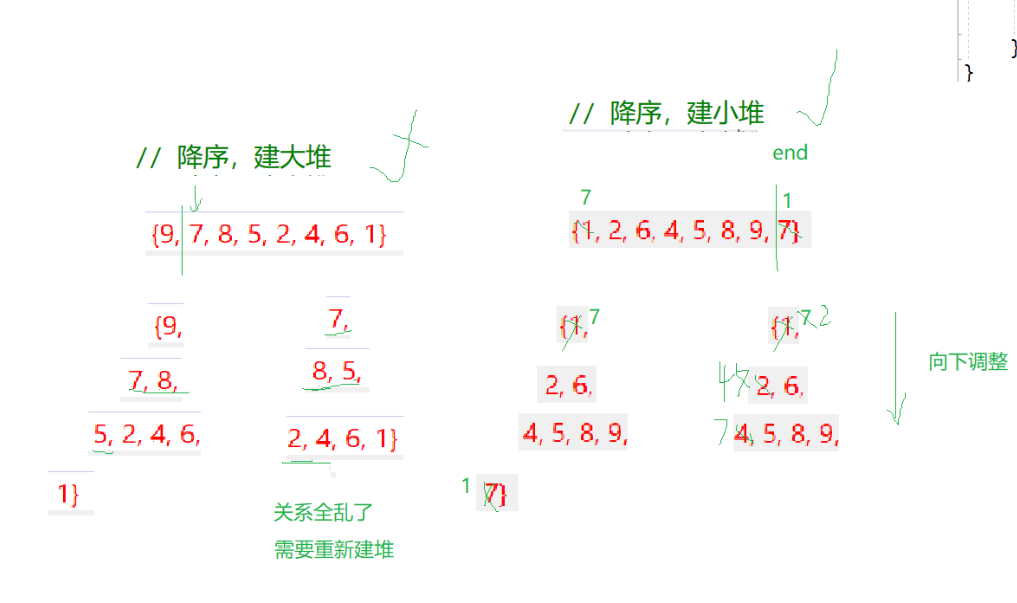
堆排序的核心思路是:升序建大堆,降序建小堆。这个结论看似反直觉,但实际很巧妙——通过堆顶与末尾元素交换,逐步确定最大或最小值。
结论:
降序建小堆,升序建大堆
因为在堆里面有效的数据其实就只有堆顶,当堆是小堆时,栈顶就是最小的数据,这时我们把栈顶的数据交换,再让新的栈顶数据向下排序,,这样就能确定最小数据的位置。新的栈顶是第二小的数据,重复上述操作,就又能确定第二小的位置,直到所有数据都完成排序。
堆排序的完整代码实现:
void HeapSort(int* a, int n)
{
	// 降序,建小堆
	// 升序,建大堆
	for (int i = 1; i < n; i++)
	{
		AdjustUp(a, i);
	}
	/*for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDown(a, n, i);
	}*/
	int end = n - 1;
	while (end > 0)
	{
		Swap(&a[0], &a[end]);
		AdjustDown(a, end, 0);
		--end;
	}
}
3.5 时间复杂度分析
两种建堆算法的时间复杂度对比:
- 向上调整算法:O(N log N)
- 向下调整算法:O(N)
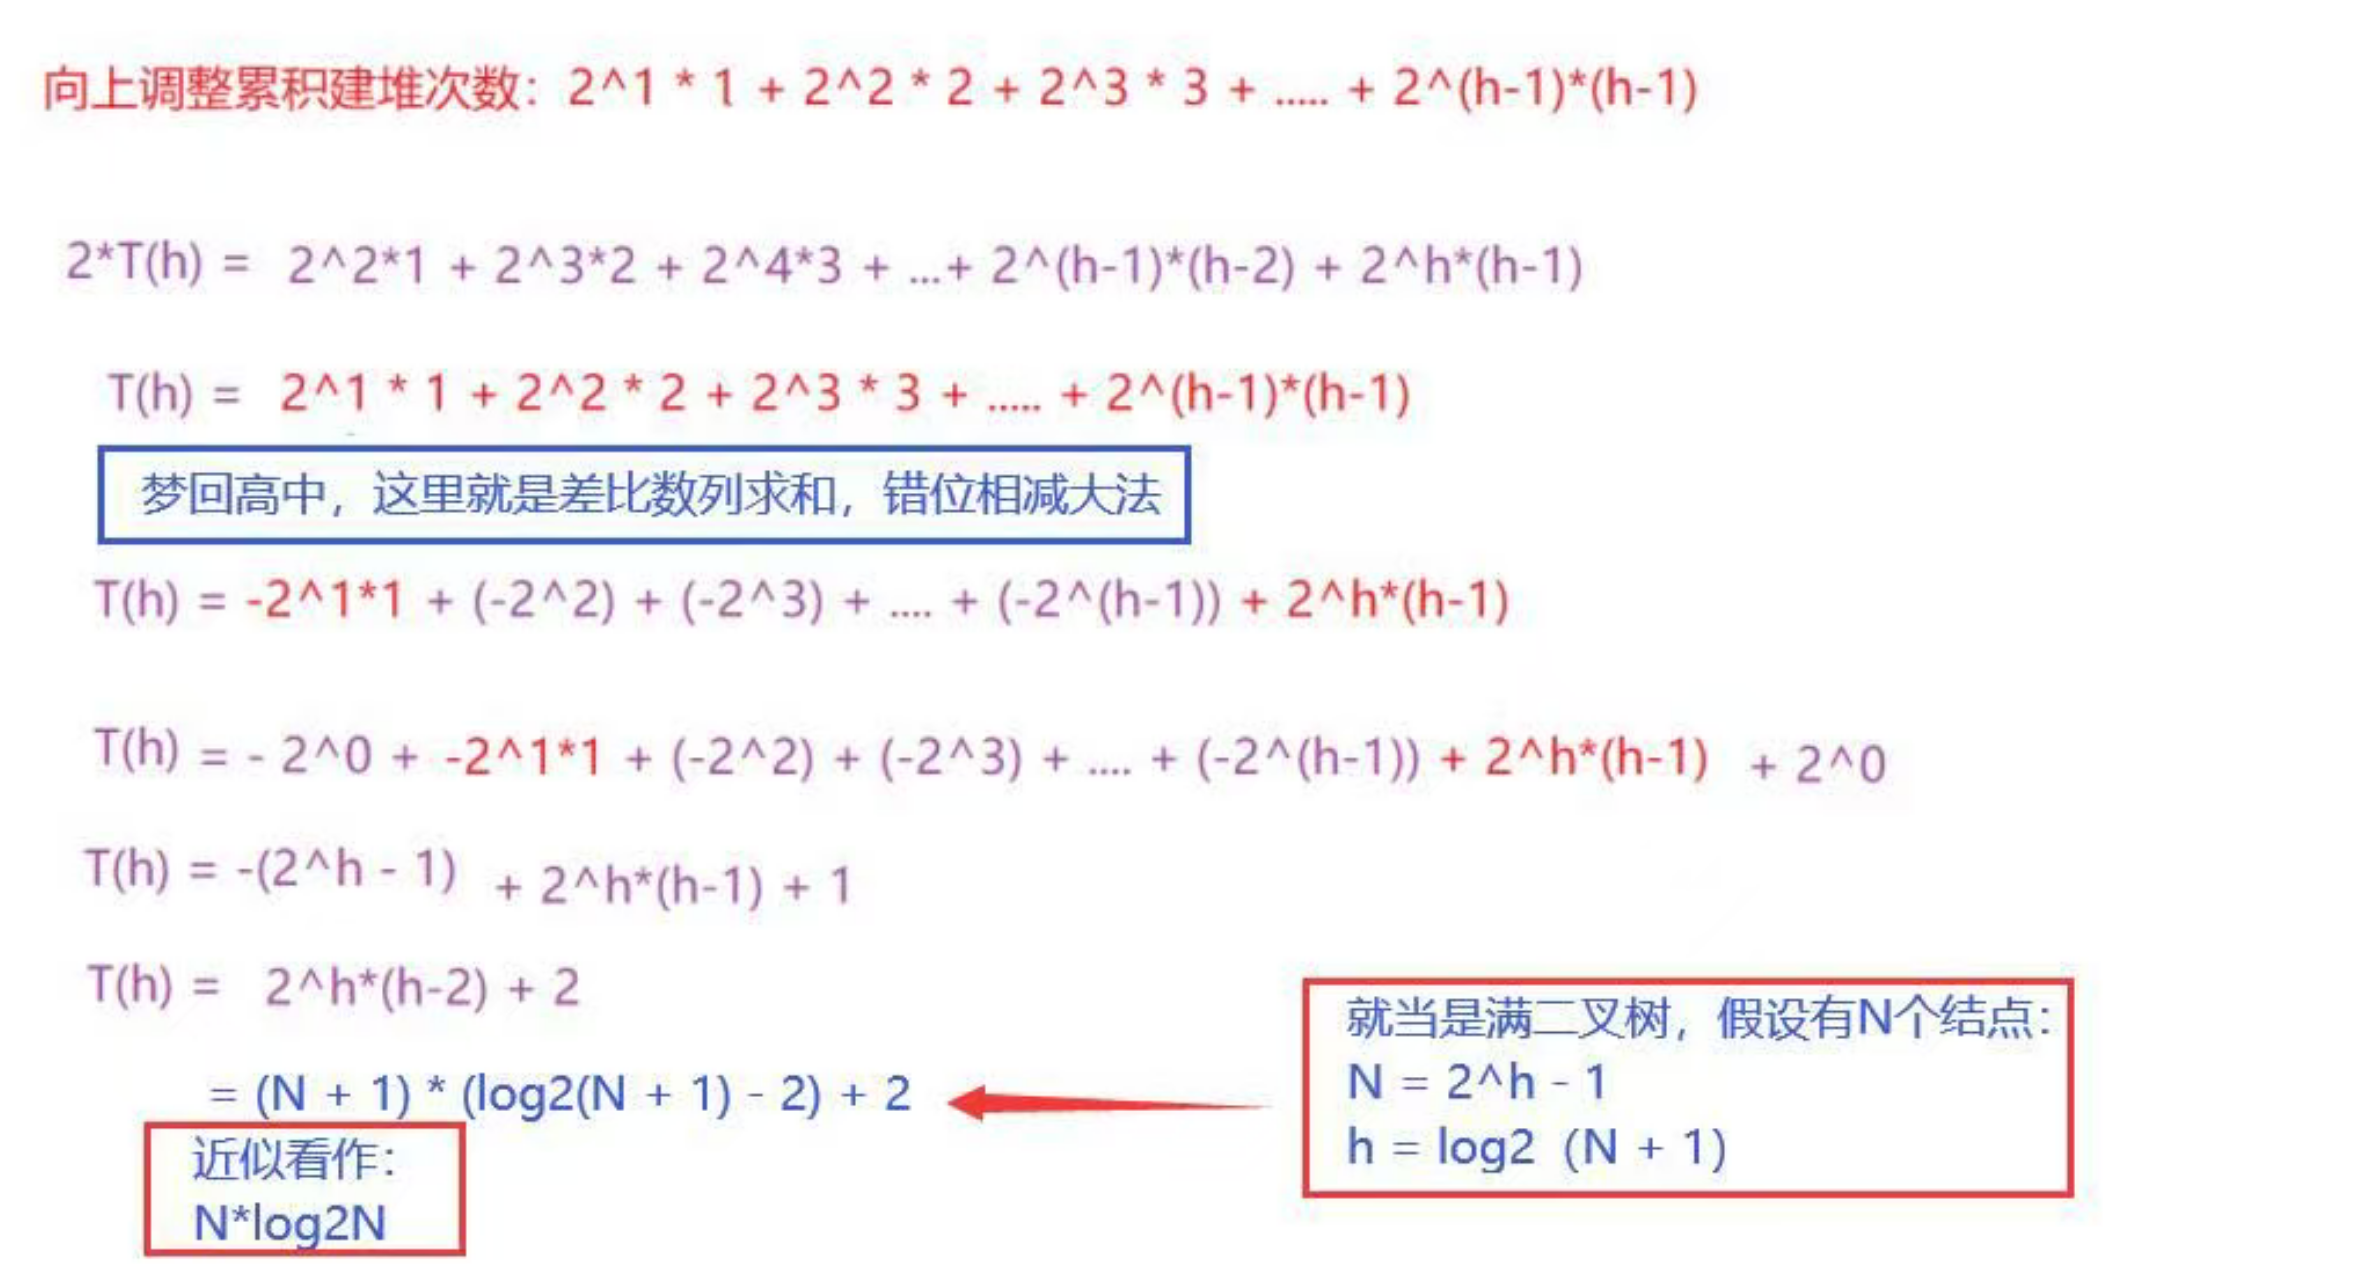
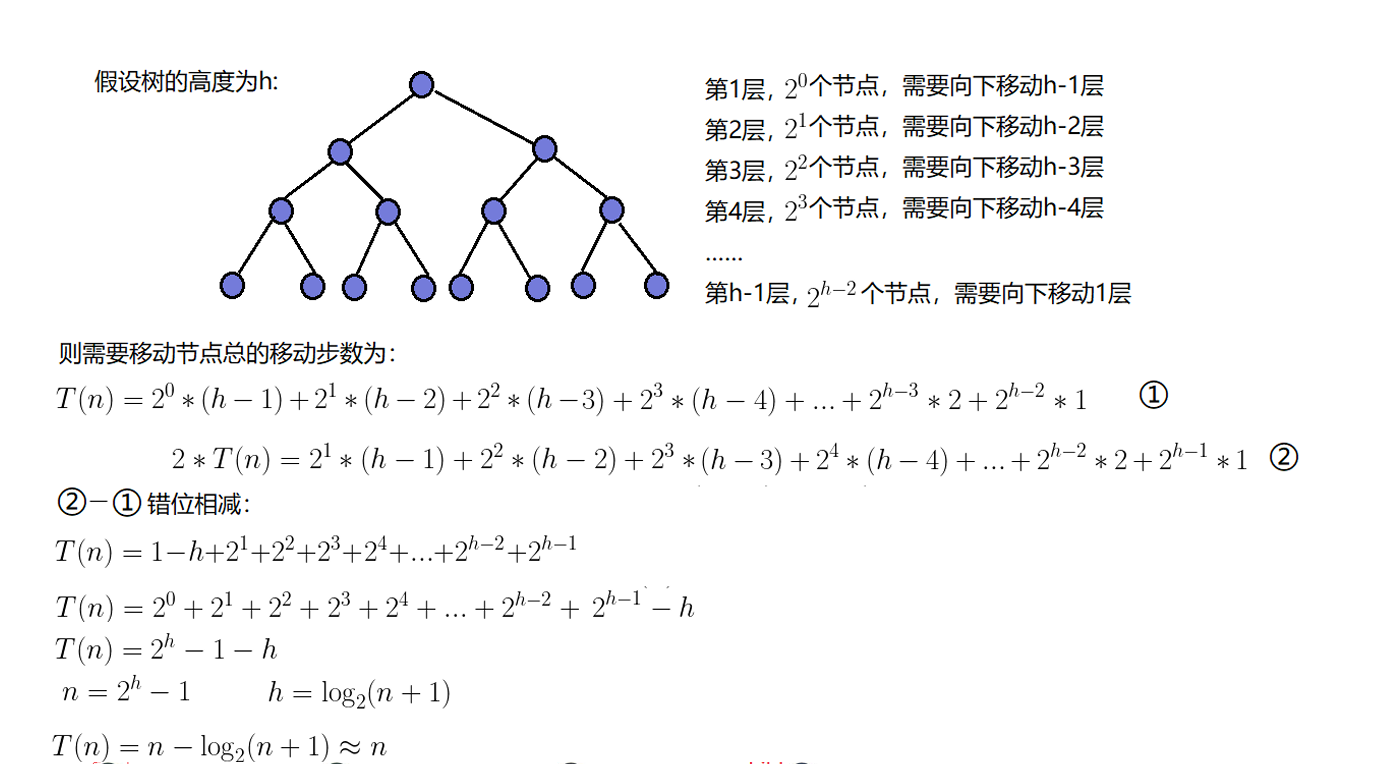
显然,向下调整算法更优,在实际应用中应优先选择。
3.6 堆的完整代码实现
typedef int HPDataType;
typedef struct Heap
{
	HPDataType* a;
	int capacity;
	int size;
}HP;
void Swap(HPDataType* p1, HPDataType* p2);
void AdjustUp(HPDataType* a, int child);
void AdjustDown(HPDataType* a, int n, int parent);
void HPInit(HP* php);
void HPDestroy(HP* php);
void HPPush(HP* php, HPDataType x);
void HPPop(HP* php);
HPDataType HPTop(HP* php);
bool HPEmpty(HP* php);
void HPInit(HP* php)
{
	assert(php);
	php->a = NULL;
	php->capacity = php->size = 0;
}
void HPDestroy(HP* php)
{
	assert(php);
	free(php->a);
	php->a = NULL;
	php->capacity = php->size = 0;
}
void Swap(HPDataType* p1, HPDataType* p2)
{
	HPDataType tmp = *p1;
	*p1 = *p2;
	*p2 = tmp;
}
void AdjustUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)
	{
		if (a[child] < a[parent])
		{
			Swap(&a[child], &a[parent]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
		{
			break;
		}
	}
}
void HPPush(HP* php, HPDataType x)
{
	assert(php);
	if (php->capacity == php->size)
	{
		int newcapacity = php->capacity == 0 ? 4 : 2 * php->capacity;
		HPDataType* tmp = (HPDataType*)realloc(php->a,newcapacity * sizeof(HPDataType));
		if (tmp == NULL)
		{
			perror("malloc");
			return;
		}
		php->a = tmp;
		php->capacity = newcapacity;
	}
	php->a[php->size] = x;
	php->size++;
	AdjustUp(php->a, php->size - 1);
}
void AdjustDown(HPDataType* a, int n, int parent)
{
	int child = parent * 2 + 1;
	while (child < n)
	{
		if (child + 1 < n && a[child + 1] > a[child])
		{
			child++;
		}
		if (a[child] > a[parent])
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else
		{
			break;
		}
	}
}
void HPPop(HP* php)
{
	assert(php);
	assert(php->size > 0);
	Swap(&php->a[0], &php->a[php->size - 1]);
	php->size--;
	AdjustDown(php->a, php->size, 0);
}
HPDataType HPTop(HP* php)
{
	assert(php);
	assert(php->size > 0);
	return php->a[0];
}
bool HPEmpty(HP* php)
{
	assert(php);
	return php->size == 0;
}
void HeapSort(int* a, int n)
{
	// 降序,建小堆
	// 升序,建大堆
	for (int i = 1; i < n; i++)
	{
		AdjustUp(a, i);
	}
	/*for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDown(a, n, i);
	}*/
	int end = n - 1;
	while (end > 0)
	{
		Swap(&a[0], &a[end]);
		AdjustDown(a, end, 0);
		--end;
	}
}4. TopK问题:在 N 个数中找最大的前 K 个
TopK问题是面试和工程中的常客。例如,在推荐系统中需要从海量用户中找出活跃度最高的前 100 名。解决思路如下:
- 用前 K 个元素建一个小堆
- 遍历剩余元素,如果比堆顶大,则替换堆顶并执行向下调整
- 遍历结束后,堆中的 K 个元素就是最大的 K 个
方法:用前K个数建一个小堆,剩下的数据跟栈顶数据比较,如果比栈顶的数据大,就替代堆顶进堆,然后向下调整
这个小堆的K个数,就是最大的前K个数
这种方法的时间复杂度为 O(N log K),空间复杂度为 O(K),非常适合处理海量数据。
[AFFILIATE_SLOT_2]5. 总结
本文从树的概念出发,系统讲解了二叉树的性质、顺序存储结构以及堆的实现。重点介绍了堆排序和TopK问题的核心思路与代码实现。掌握这些知识,不仅能帮助你应对面试题,还能在实际工程中高效处理优先级队列、数据筛选等问题。如果你对数据结构和算法感兴趣,建议动手实现一遍堆的代码,理解会更深刻。
觉得不错的话,别忘了点赞、收藏、关注哦~我们下期再见!

 浙公网安备 33010602011771号