MySQL索引优化实战:从B+树原理到性能调优全攻略
在数据库优化领域,索引优化是提升查询性能最直接、最有效的手段之一。无论是MySQL、PostgreSQL还是MongoDB,理解索引的底层数据结构都是成为数据库专家的必修课。本文将从B+树原理出发,深入剖析MySQL索引的工作机制,并分享实用的优化策略,帮助你快速掌握索引优化的核心技巧。
一、B+树:MySQL索引的基石
要理解MySQL索引,首先要理解B+树这种数据结构。为什么MySQL InnoDB引擎选择B+树而不是二叉树或B树?这背后是对查询性能和存储效率的极致追求。
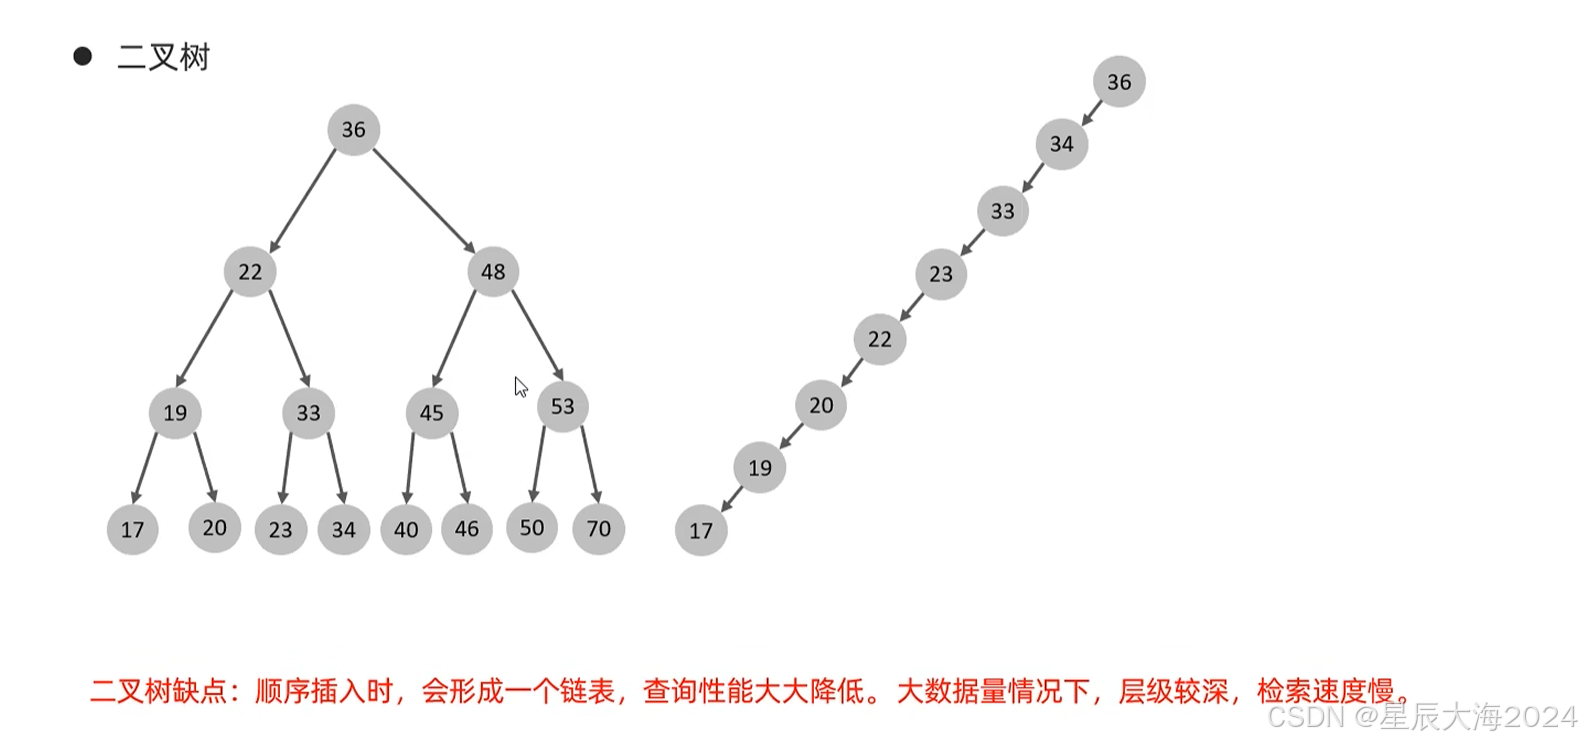
从二叉树到B树的演进:二叉树通过二分查找减少查询次数,但存在两个致命问题——插入顺序不当时会退化为链表,时间复杂度从O(log n)恶化为O(n);大数据量下树高度过高,查询性能急剧下降。B树通过自动平衡机制解决了退化问题:当节点键值对数不足时触发合并或重新分配操作(页合并和借键),始终保持树的平衡性。
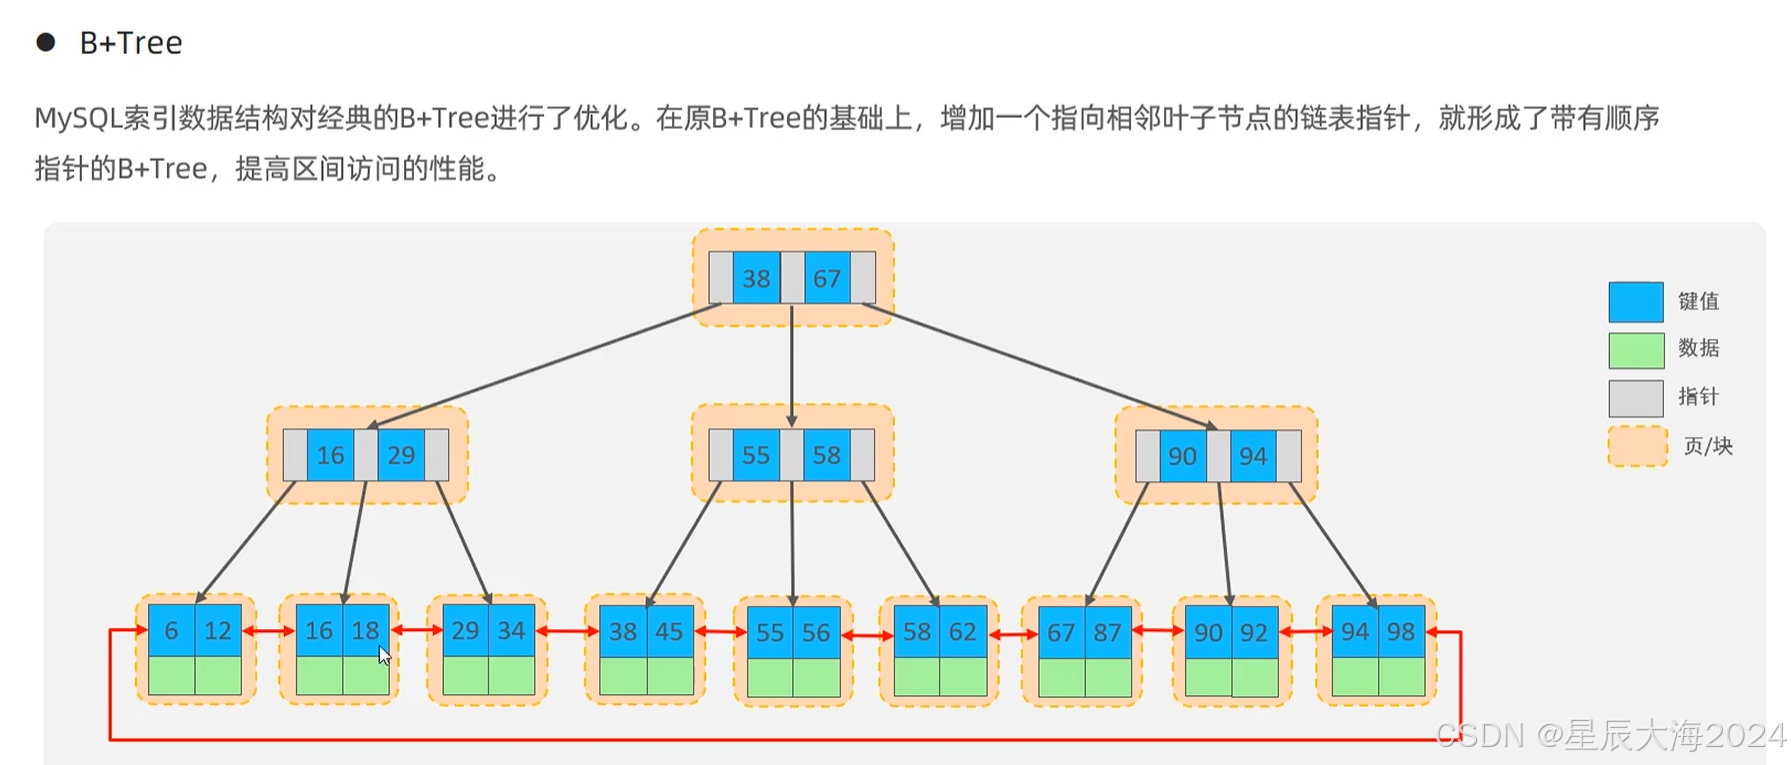
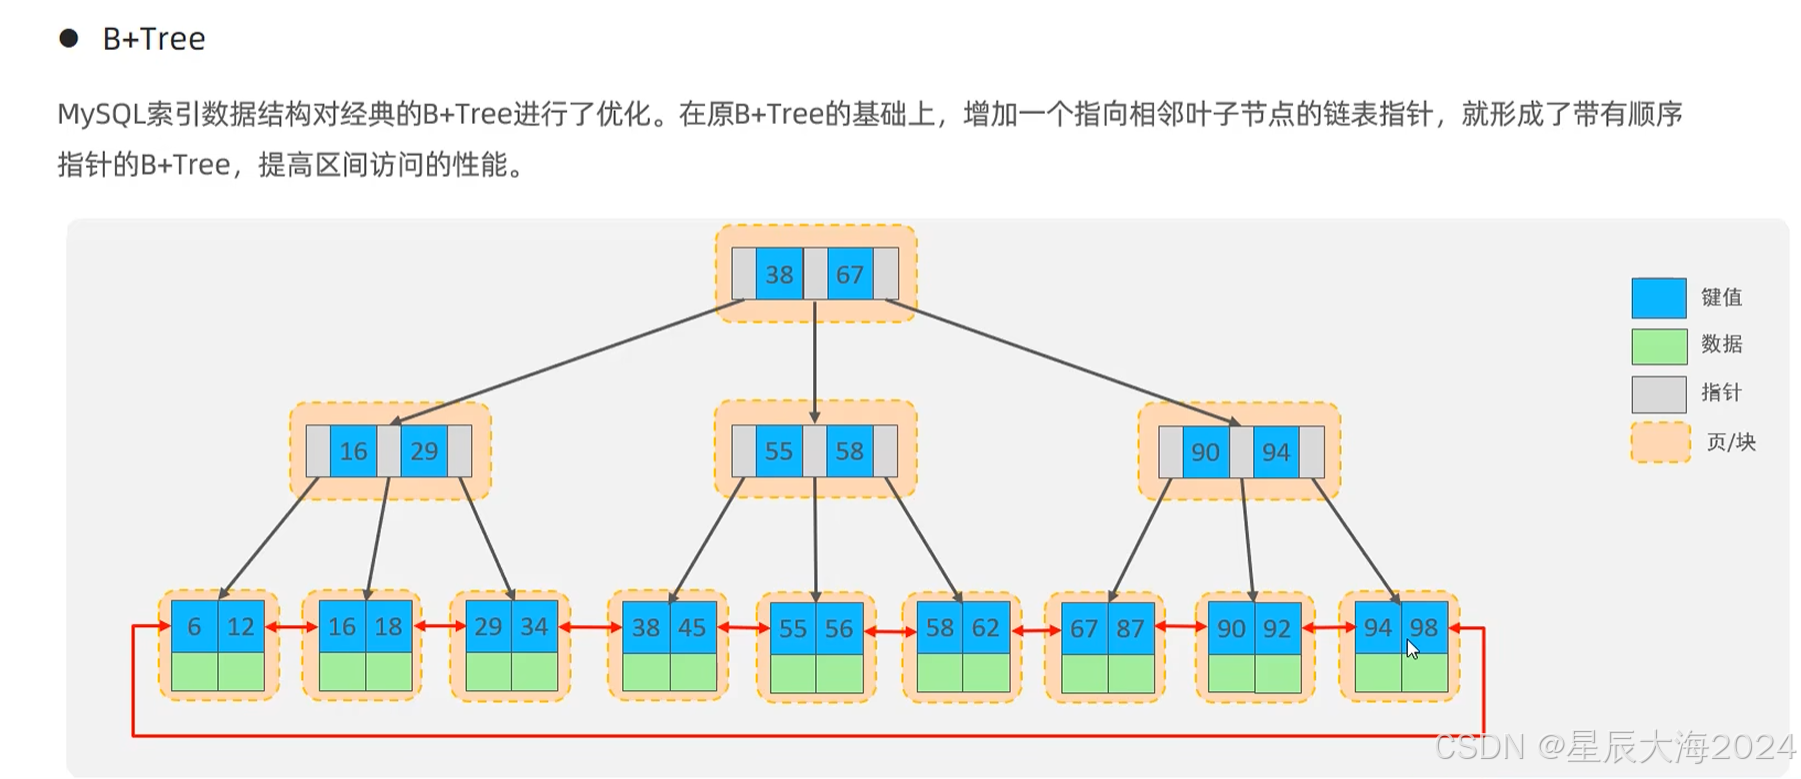
B+树的独特优势:MySQL InnoDB最终选择B+树,是因为它在B树基础上做了两项关键改进:
- 叶子节点双向链表连接:所有叶子节点通过双向指针串联,形成有序序列。这使得范围查询(如
WHERE age BETWEEN 20 AND 30)只需遍历链表即可,无需反复回溯父节点。 - 非叶子节点仅存键值:非叶子节点不存储实际数据,只存放用于区分路径的键。这使单个节点(InnoDB中默认16KB的页)能容纳更多键,显著降低树的高度。在千万级数据量下,B+树通常只需3-4层。
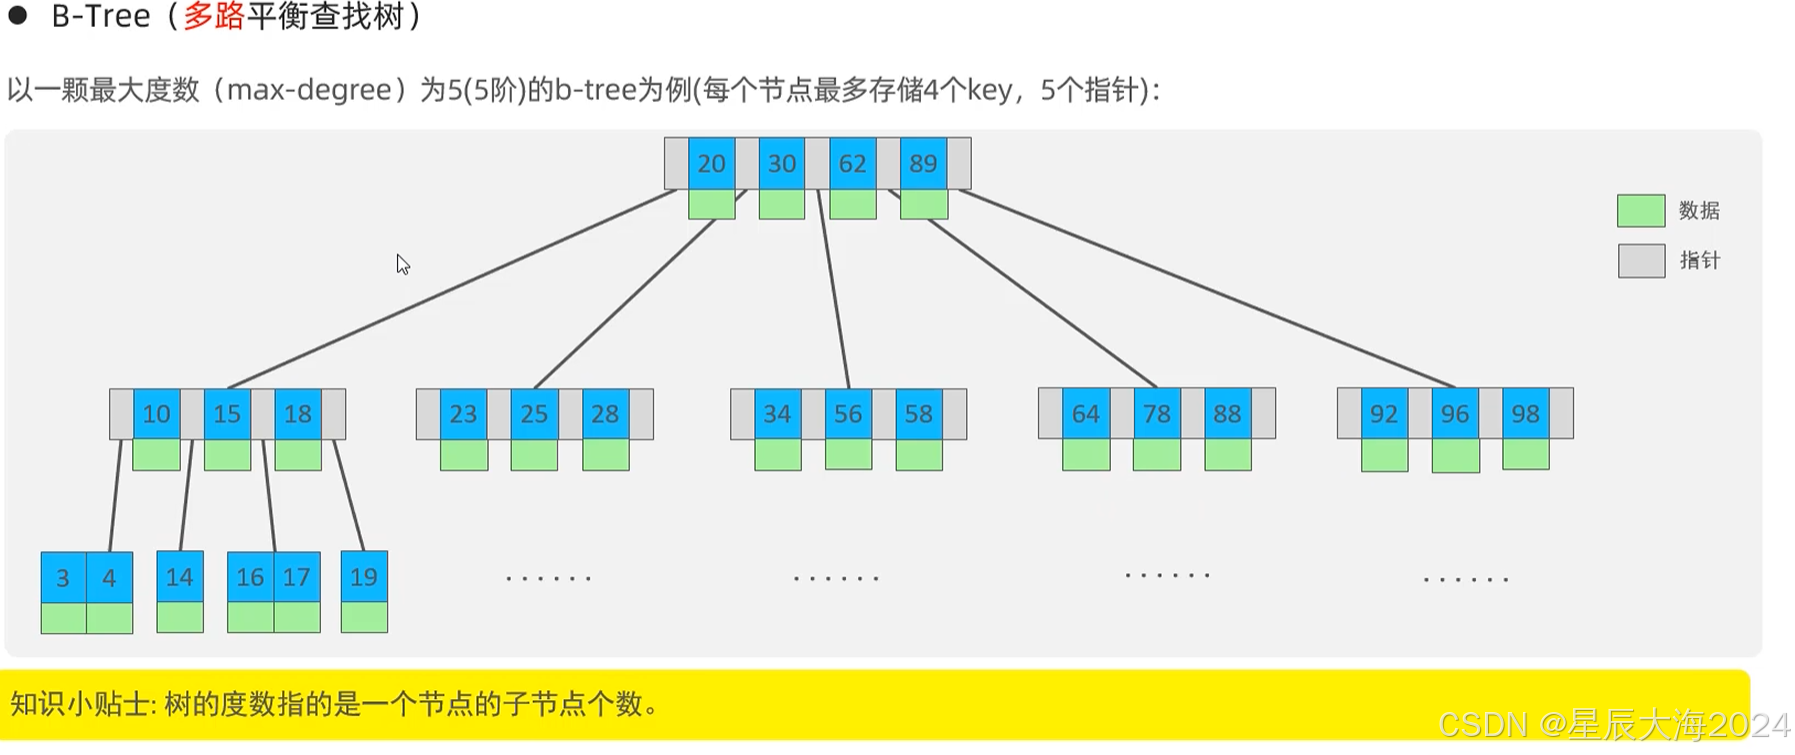
延伸思考:与Redis的跳表(Skip List)或MongoDB的B树实现相比,MySQL的B+树更擅长范围查询和磁盘I/O优化,这也是关系型数据库的核心需求。
二、索引结构详解:聚簇索引与非聚簇索引
在MySQL中,索引不仅仅是查询加速器,更是数据组织方式。理解聚簇索引和非聚簇索引的区别,是掌握索引优化的第一步。
索引的核心定义:索引是MySQL在存储引擎层为字段构建的B+树数据结构,用于快速定位符合条件的数据行,减少磁盘I/O。InnoDB引擎中,数据本身也是按照聚簇索引组织的。
基础索引类型:
索引类型 | 核心特点 | 适用场景 |
主键索引 | 唯一、非空,一张表仅1个,聚簇索引 | 主键查询(WHERE id=1) |
唯一索引 | 字段值唯一(允许NULL),一张表可多个 | 唯一字段查询(如手机号phone) |
普通索引 | 无唯一性约束,最常用 | 普通查询字段(如age、name) |
联合索引 | 多个字段组合的索引 | 多字段查询(如age+name) |
覆盖索引 | 索引包含查询所需所有字段 | 避免回表(如SELECT id,age FROM user WHERE age=20,(age,id)索引覆盖) |
什么是回表? 这是面试高频考点。聚簇索引直接存储行数据,而非聚簇索引(二级索引)存储的是主键值。查询时,先通过二级索引找到主键,再到聚簇索引中查找完整行数据,这个过程就是回表。
示例:回表场景
select * from tb_user where age=20;示例:不回表(覆盖索引)
select id,age from tb_user where age=20;⚠️ 优化技巧:尽量使用覆盖索引,即索引包含查询所需的所有字段,避免回表操作。这在PostgreSQL和MySQL中都是通用的优化策略。
三、最左前缀法则与索引失效场景
联合索引是MySQL索引优化的核心工具,但使用不当会导致索引失效。最左前缀法则是必须牢记的基本原则。
最左前缀法则:查询条件必须从联合索引的最左侧列开始,且不能跳过任何字段,否则索引部分失效,最坏情况完全失效。
假设联合索引为 (name, age, city)
- ✅ 索引生效:
SELECT * FROM tb_user WHERE name='Alice' AND age=25; - ⚠️ 索引部分失效(
citySELECT * FROM tb_user WHERE name='Alice' AND city='Beijing' - ❌ 索引完全失效(全表扫描):
SELECT * FROM tb_user WHERE age=13
SELECT * FROM tb_user WHERE city="北京"
六大索引失效核心场景:
- 索引列做运算或函数:如
age+1=20、YEAR(create_time)=2024,会导致索引失效。select id,age from tb_user where age+1=20; - 隐式类型转换:如
WHERE phone=13800138000(phone为varchar类型),MySQL会隐式转换,破坏索引。select id,phone from tb_user where phone=12334567; - 联合索引不满足最左前缀:如
(age,name)索引,仅查name='张三'则完全失效。select id,name from tb_user where name="张三"; - LIKE后置模糊匹配:
name LIKE '%张'会导致索引失效,而'张%'则生效。select id,name from tb_user where name like "%张"; - OR条件含非索引列:如
age=20 OR address='北京'(address无索引),整个查询走全表扫描。select id,age,address from tb_user where age=20 OR address='北京'; - 数据分布不均:当优化器认为全表扫描比索引查找更快时(如查询超过30%的数据),会主动放弃索引。
四、索引设计基本原则与索引下推
设计索引不是越多越好,而是要为高频查询场景量身定制。以下是经过实践验证的索引设计原则。
第一步:分析查询模式
通过以下命令查看当前数据库各语句的访问频次:
SHOW GLOBAL STATUS LIKE 'Com_______';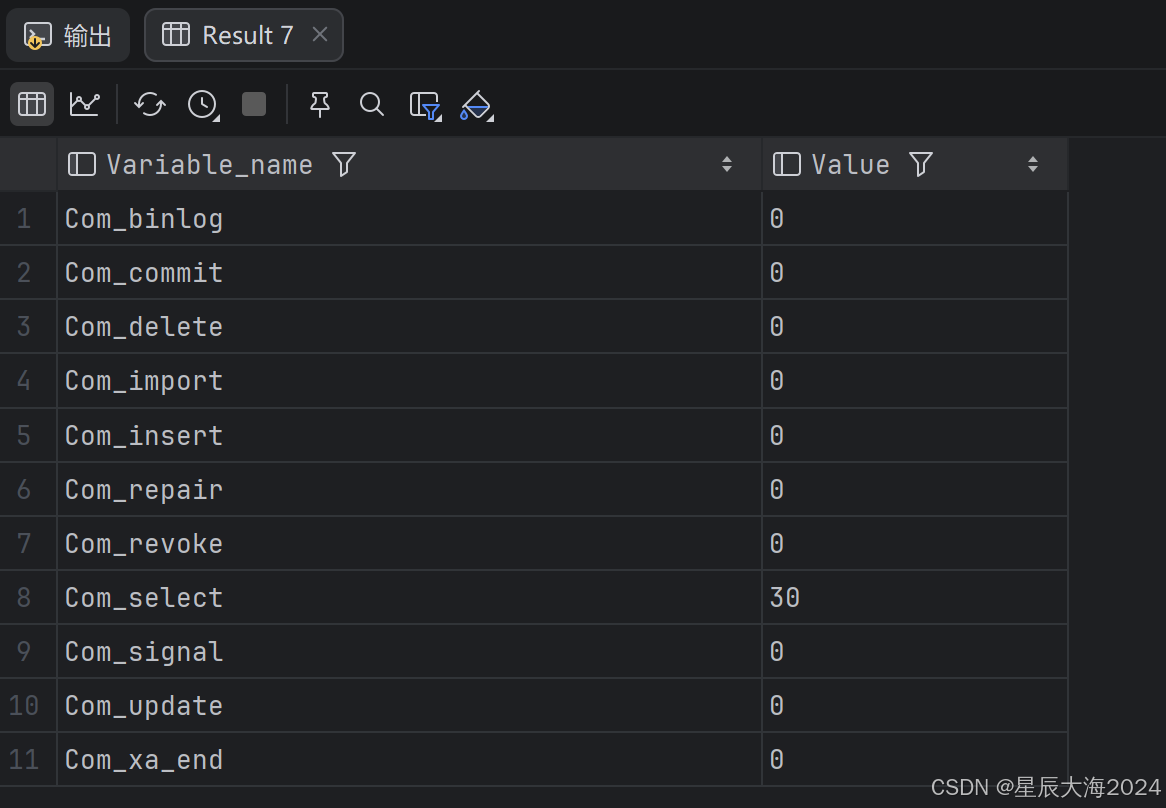
核心原则:
- 只为高频查询字段建索引(WHERE/ORDER BY/GROUP BY字段)
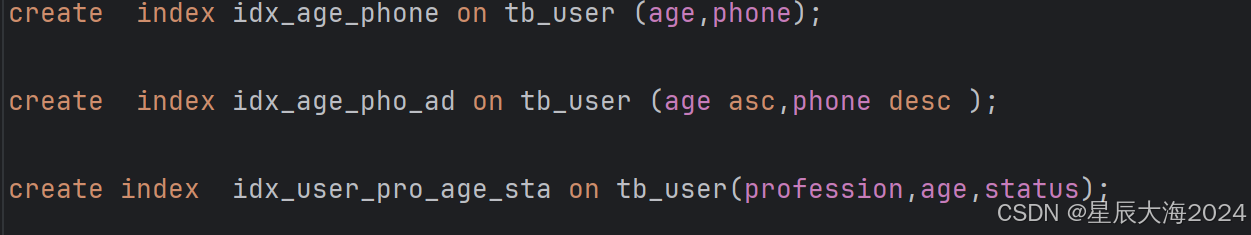
- 联合索引设计:高频字段放左、区分度高的字段放左(如 phone > age)
- 避免冗余索引:如已有
(age,name),无需再建age索引
索引下推(ICP) 是MySQL 5.6引入的重要优化机制,能显著减少回表次数。
示例语句:
select * from tb_user where age>20 and reward=200;当使用联合索引 (age,reward) 进行范围查询时,reward 部分会失效,从B+树二分查找退化为叶子节点双向链表顺序扫描 + ICP过滤。ICP的核心作用是将索引字段的过滤逻辑下推到存储引擎层,减少回表I/O。
ICP关键特征:
- ✅ 适用场景:仅针对非主键的联合索引,且过滤条件是索引中包含的字段(如上面的
reward - ✅ 识别方式:
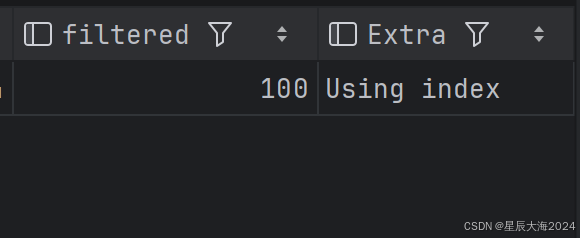
EXPLAINExtraUsing index condition - ✅ 与覆盖索引的区别:覆盖索引是「完全不回表」(索引包含所有查询字段),ICP是「减少回表行数」(仍需回表,但数据量更少)
 [AFFILIATE_SLOT_1]
五、实战优化建议与延伸思考
掌握了理论,还需要在实践中灵活运用。以下是一些经过验证的优化建议。
优化清单:
- 使用
EXPLAIN分析查询计划,重点关注type(至少要达到range级别)、key(是否使用索引)、rows(扫描行数) - 对于高并发写入场景,索引数量不宜过多(建议不超过5个),维护索引有开销
- 字符串字段建立前缀索引,减少索引大小:
ALTER TABLE users ADD INDEX idx_email(email(10)); - 定期使用
OPTIMIZE TABLE重建索引,减少碎片 - 考虑使用 覆盖索引 避免回表,这是MySQL中最高效的查询方式
跨数据库对比:
- PostgreSQL:支持B-tree、Hash、GiST、GIN等多种索引类型,其B-tree实现与MySQL类似,但支持更丰富的索引表达式和部分索引。
- Redis:作为内存数据库,其索引主要通过跳表(Sorted Set)和哈希表实现,适合低延迟、高吞吐的场景,但不适合复杂范围查询。
- MongoDB:使用B树作为默认索引结构(WiredTiger引擎),支持单字段、复合、文本和地理空间索引。与MySQL的B+树相比,MongoDB的B树在等值查询上稍快,但范围查询稍慢。
学习建议:
- 动手创建测试表,插入10万+数据,用
EXPLAIN验证各种索引失效场景 - 阅读MySQL官方文档中关于索引优化的章节
- 关注慢查询日志(Slow Query Log),定期分析优化
总结
MySQL索引优化的核心在于理解B+树的数据结构特性,掌握最左前缀法则,识别索引失效场景,并合理利用索引下推和覆盖索引等高级特性。从二叉树到B+树的演进,本质是对查询性能和存储效率的不断追求。在数据库优化这条路上,没有银弹,只有对原理的深刻理解和对实践的持续总结。希望本文能帮助你在MySQL索引优化的道路上少走弯路。

 浙公网安备 33010602011771号