从零到一:手把手教你搭建与配置 Elasticsearch 8.x 本地开发环境
Elasticsearch 作为一款强大的分布式搜索和分析引擎,已成为现代应用开发中处理海量非结构化数据的首选。无论是构建电商搜索、日志分析平台,还是实现复杂的业务指标聚合,它都扮演着核心角色。对于开发者而言,在本地搭建一个可用的 Elasticsearch 环境是学习和项目开发的第一步。本文将为你提供一份详尽的 Windows 平台安装、配置与基础使用指南,涵盖核心组件 Elasticsearch、可视化工具 Kibana 以及中文分词器 IK 的集成,助你快速构建起本地的搜索与数据分析沙箱。
一、环境准备与组件下载
在开始安装之前,我们需要明确 Elasticsearch 的运行依赖。它基于 Java 开发,但好消息是,自 7.x 版本以后,官方发行版已内置了适配的 JDK(通常是 OpenJDK),这意味着你无需在本地预先安装特定版本的 Java 环境,大大简化了部署流程。我们将下载三个核心组件:Elasticsearch 服务器、Kibana 管理界面以及 IK 中文分词器插件。
核心组件下载指引:
- Elasticsearch:访问官方下载页面
https://www.elastic.co/downloads。页面默认提供最新版本的 Windows ZIP 包。如果你需要特定版本(例如为了与项目中的 Java 或 Python 客户端库版本兼容),可以通过官方文档的历史版本页面进行选择。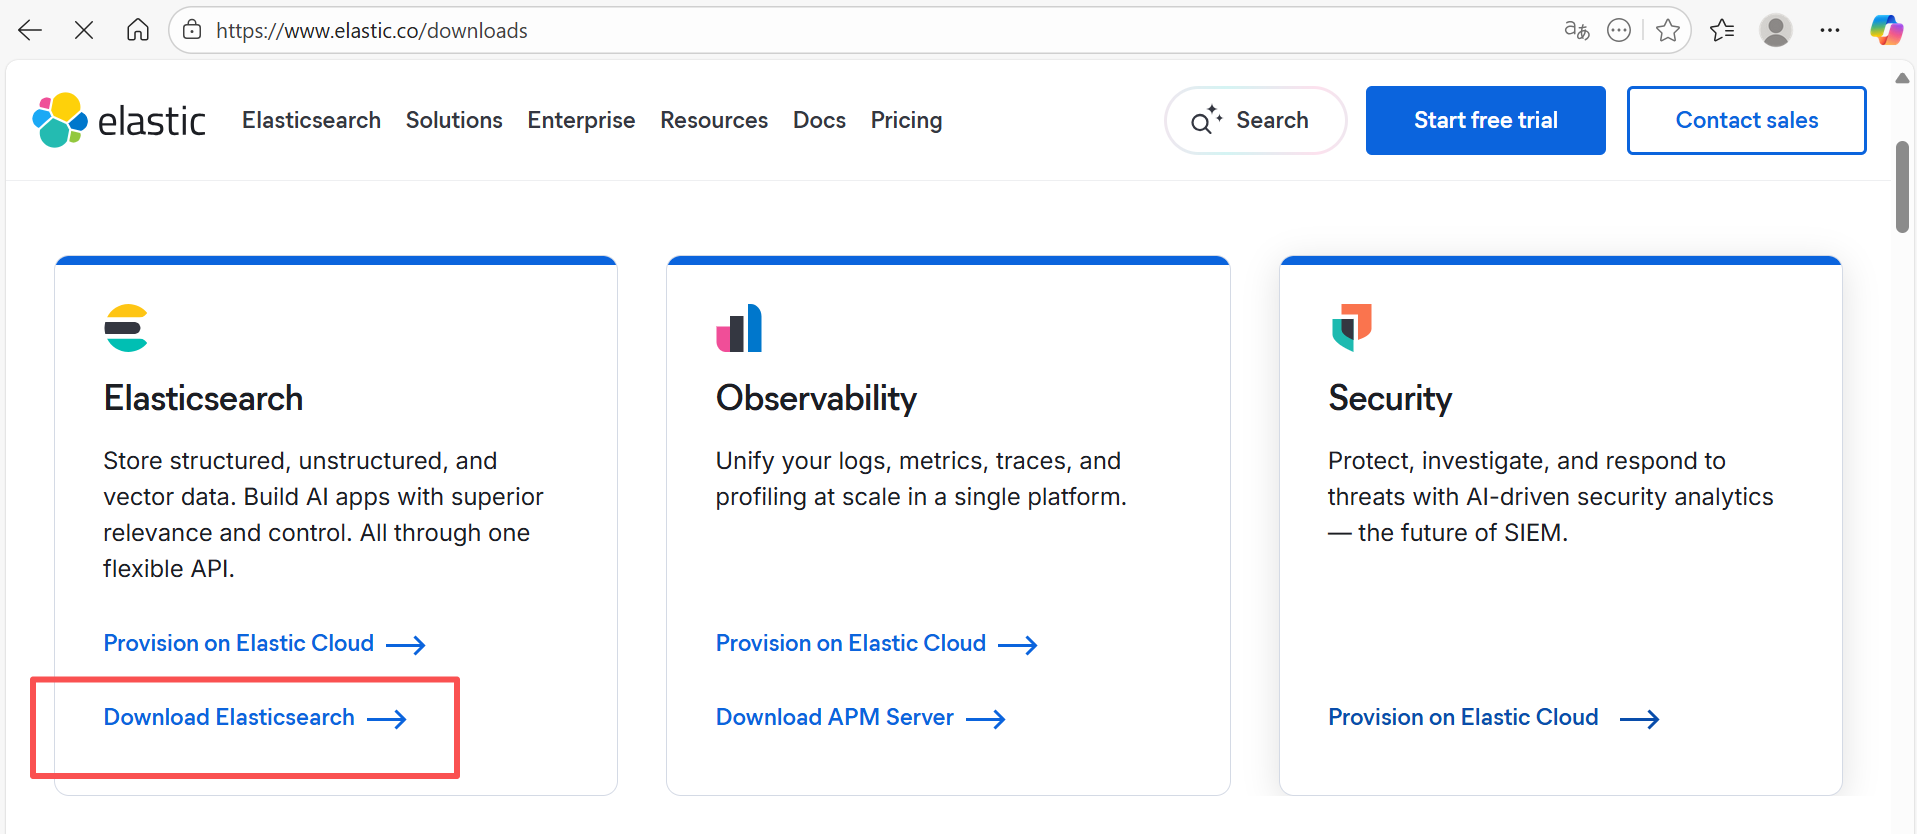
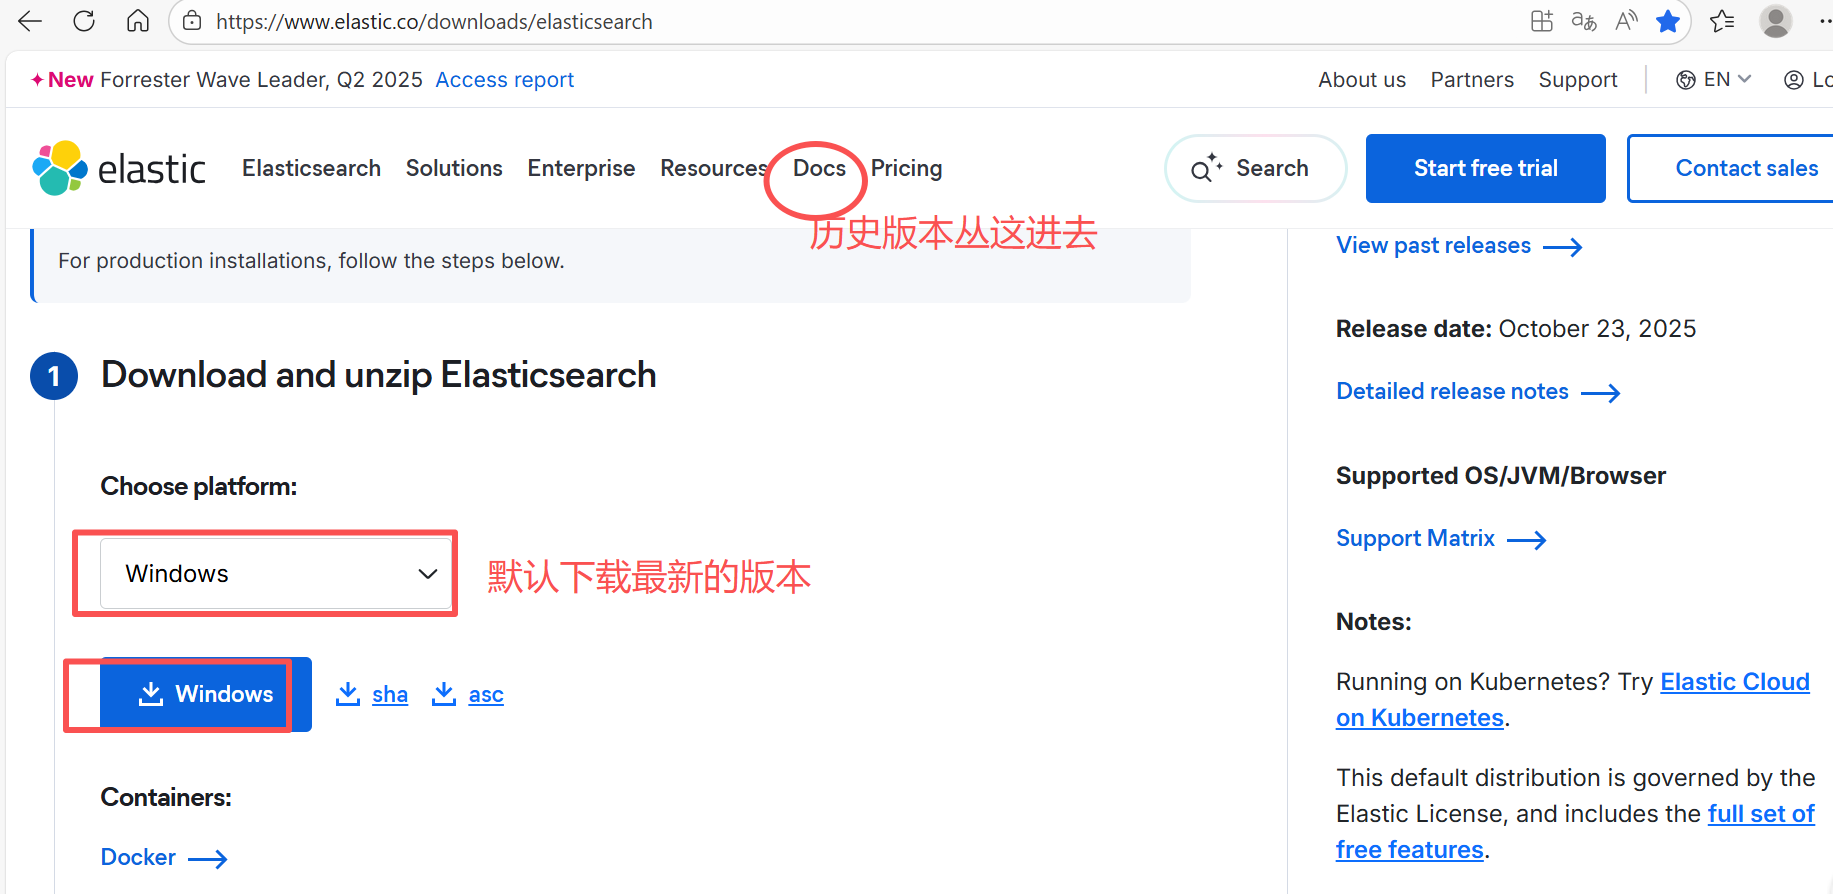 点击页面上方的“Docs”进入文档中心,然后查找“View other versions”链接即可浏览所有历史版本。
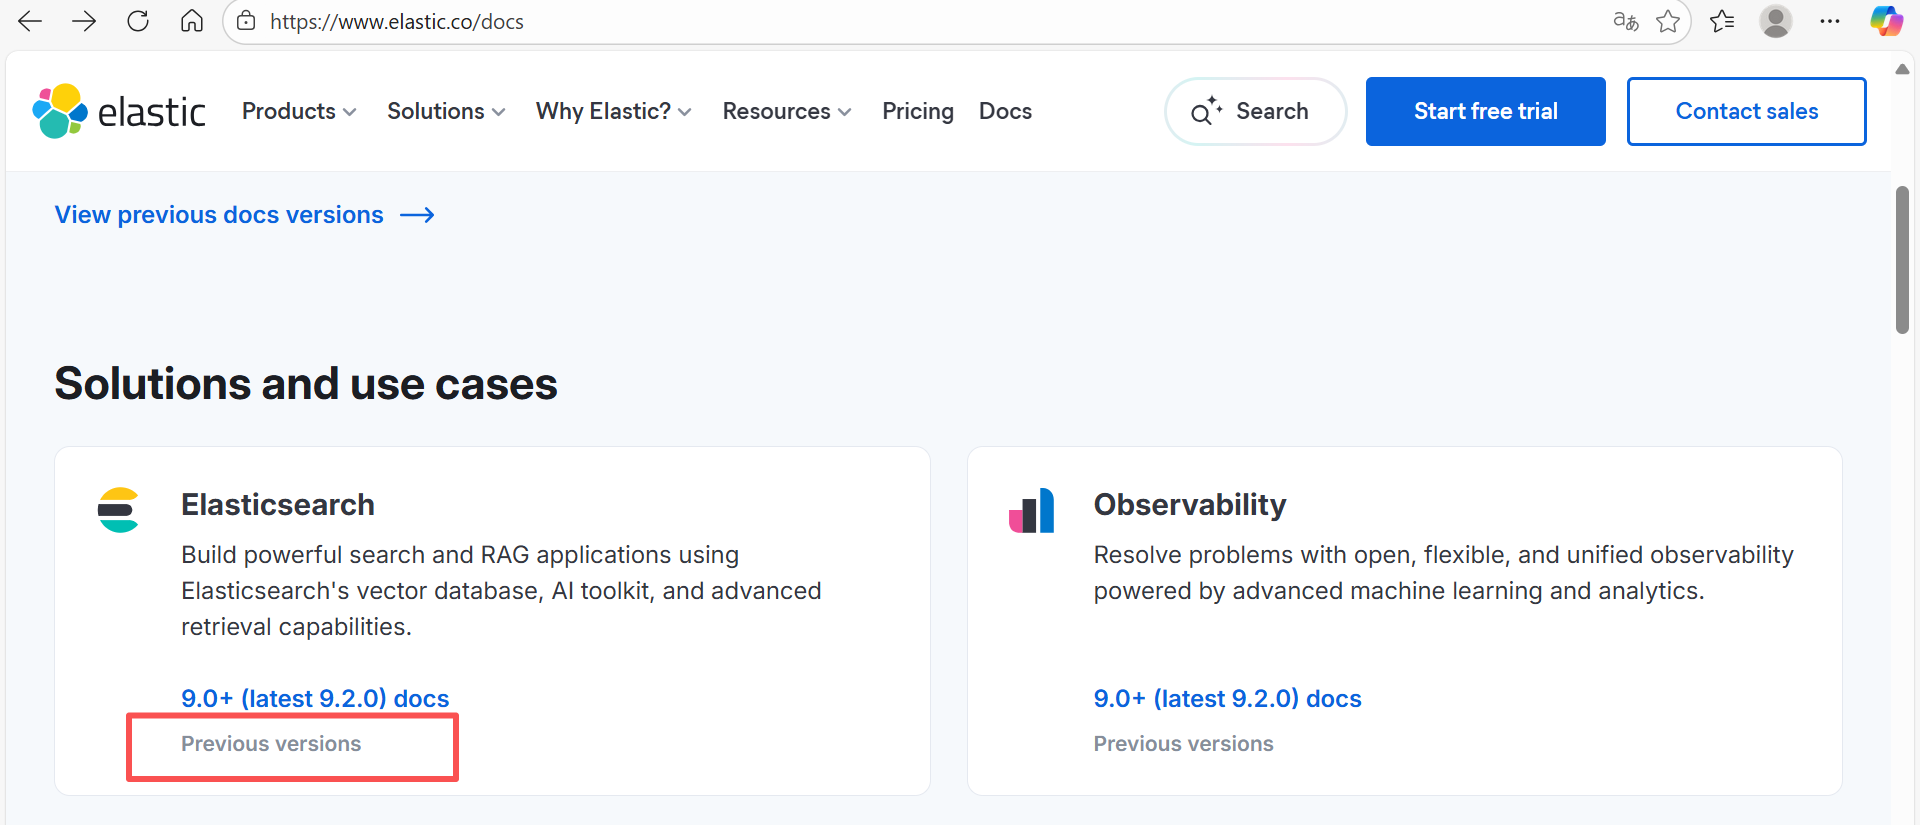
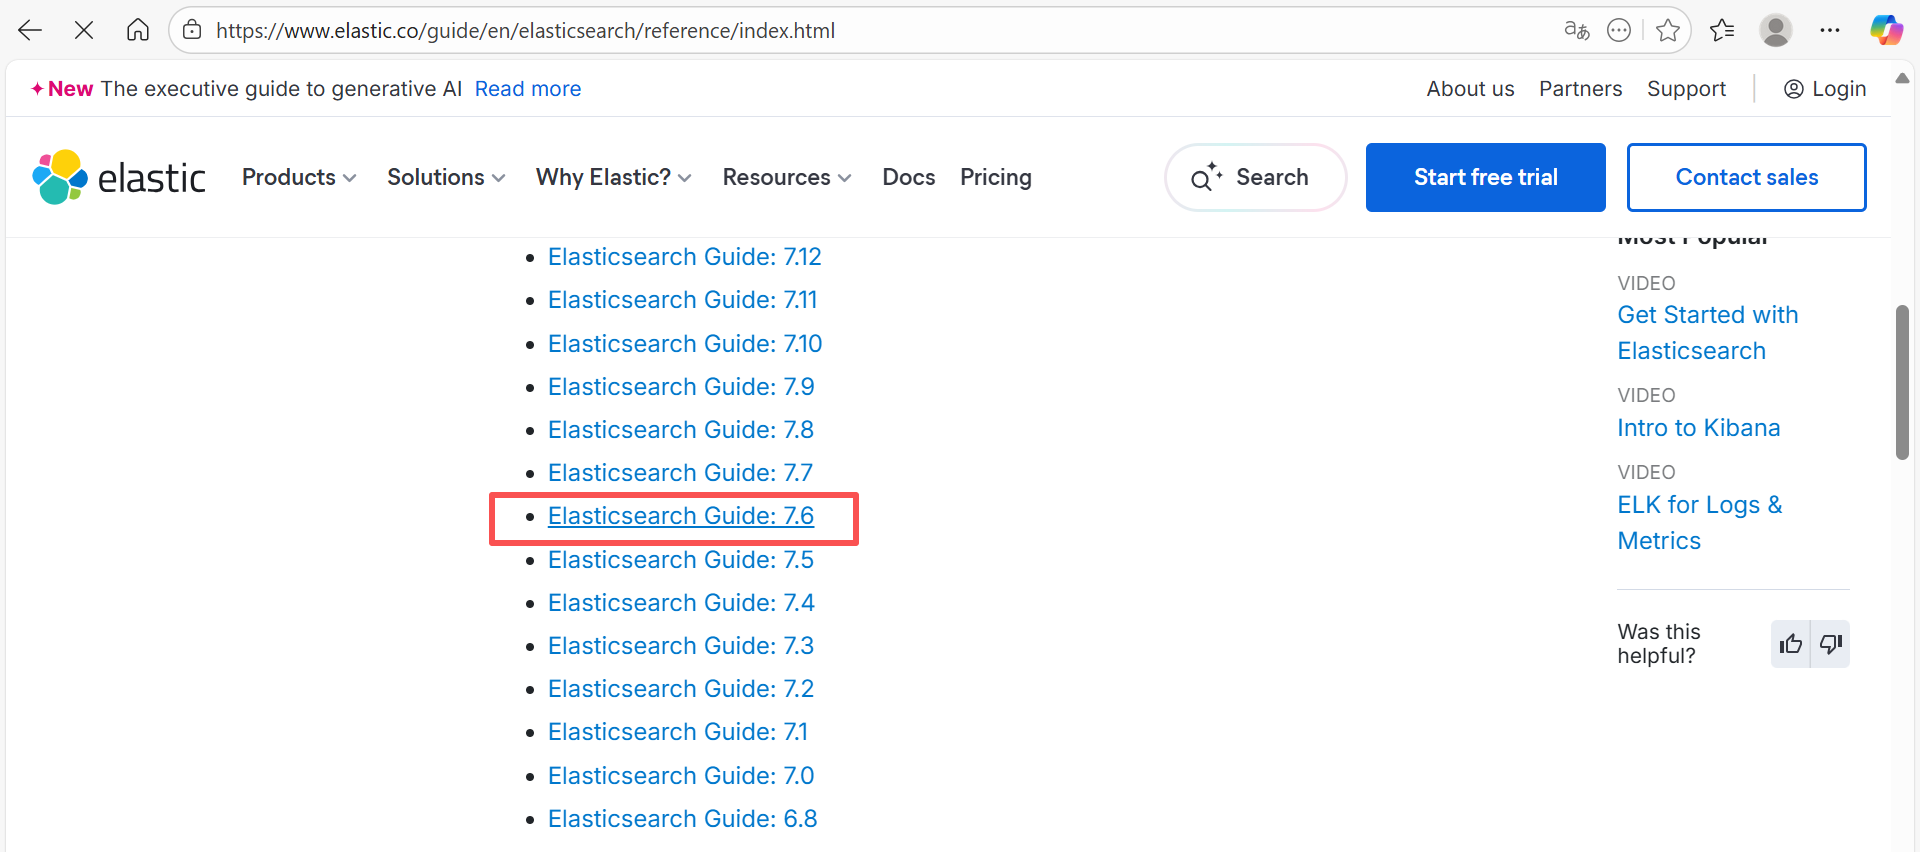
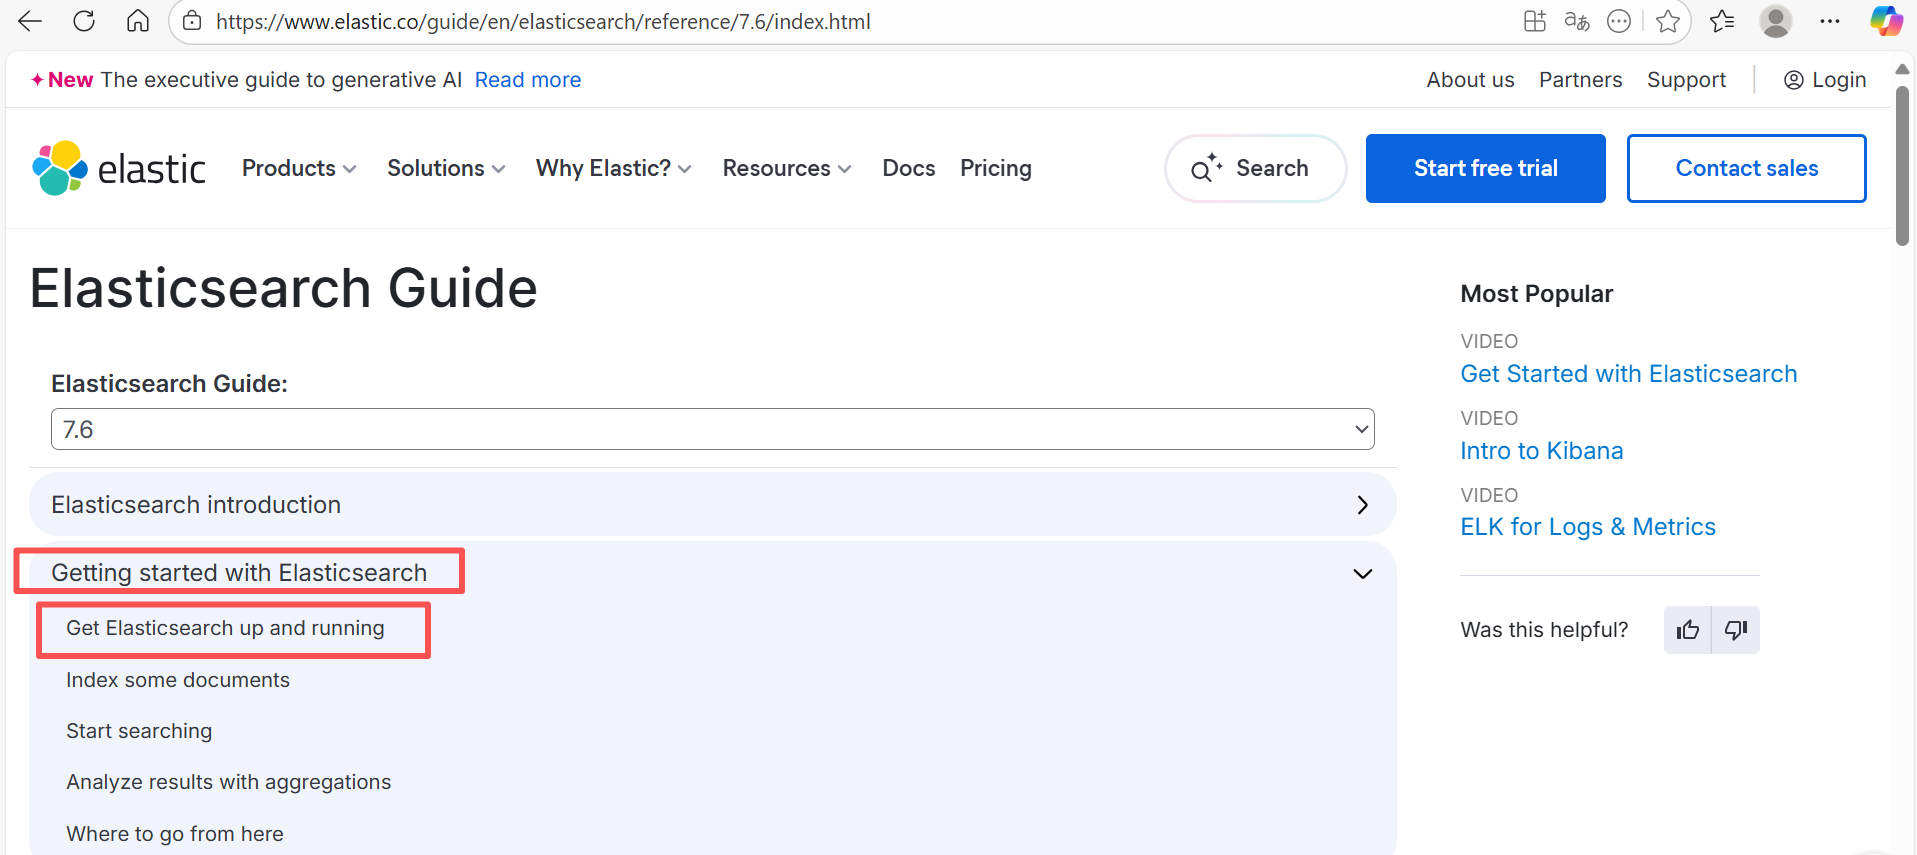 在目标版本的文档中,找到“Get Elasticsearch up and running”部分,下载对应的 Windows ZIP 包。
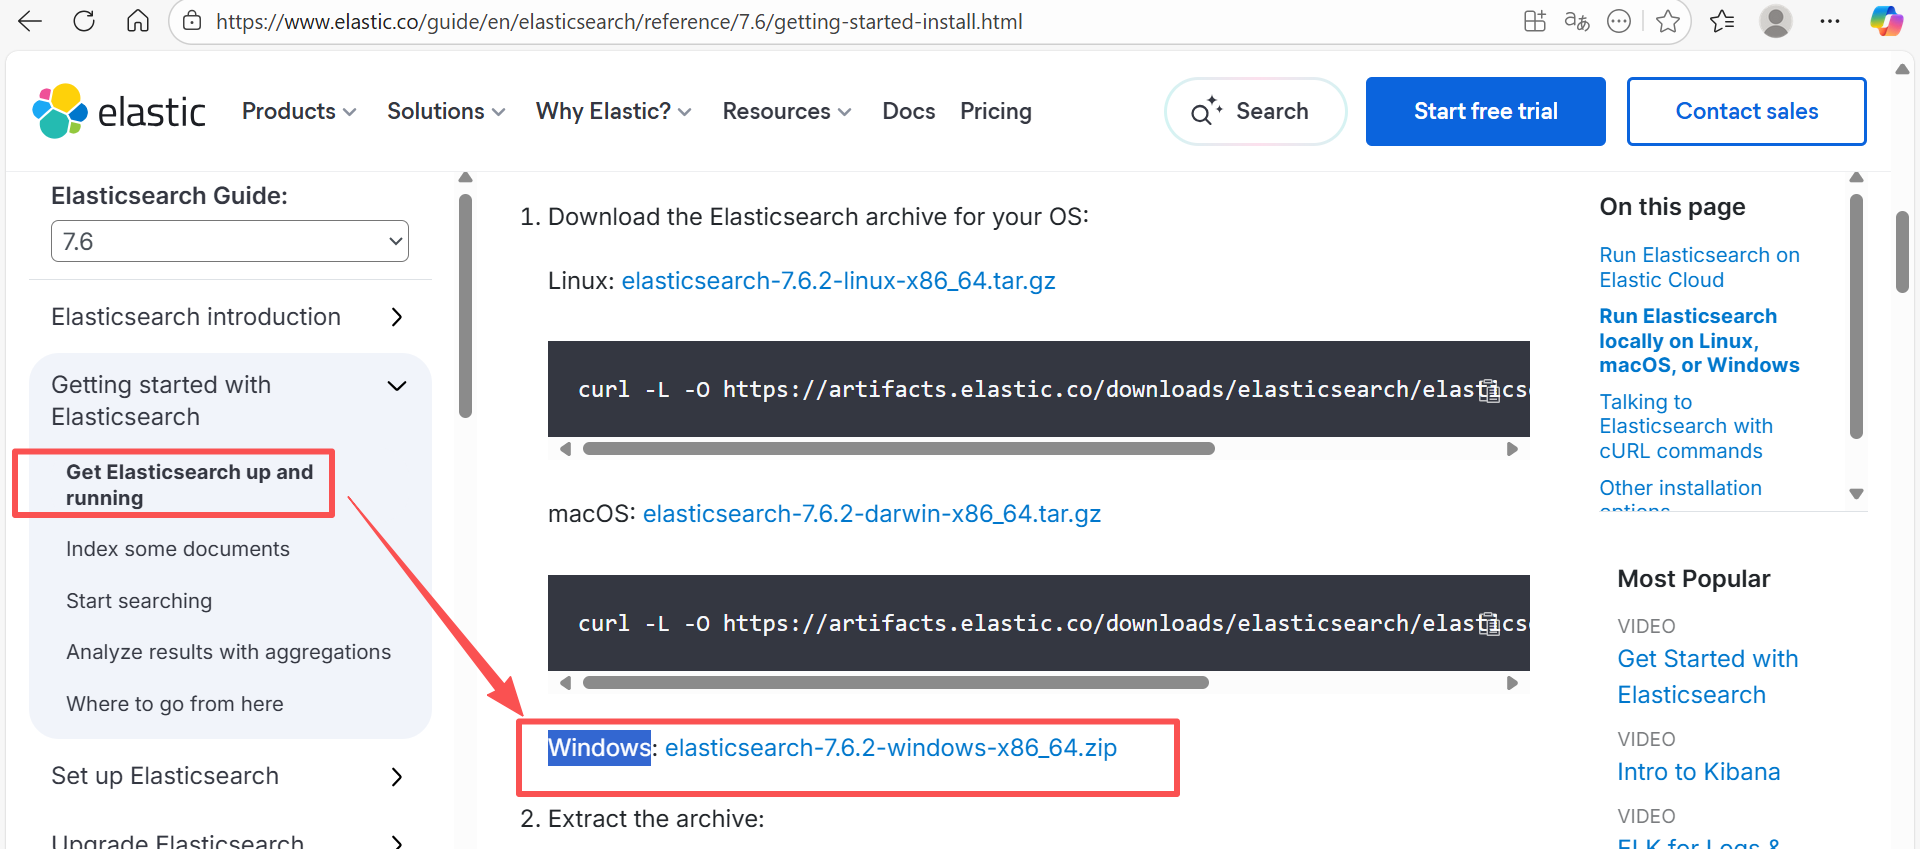
- IK 分词器:对于中文搜索场景,IK 分词器是必备插件。其发布地址为
https://release.infinilabs.com/analysis-ik/stable/。请务必下载与你的 Elasticsearch 主版本号完全一致的 IK 分词器版本,以避免兼容性问题。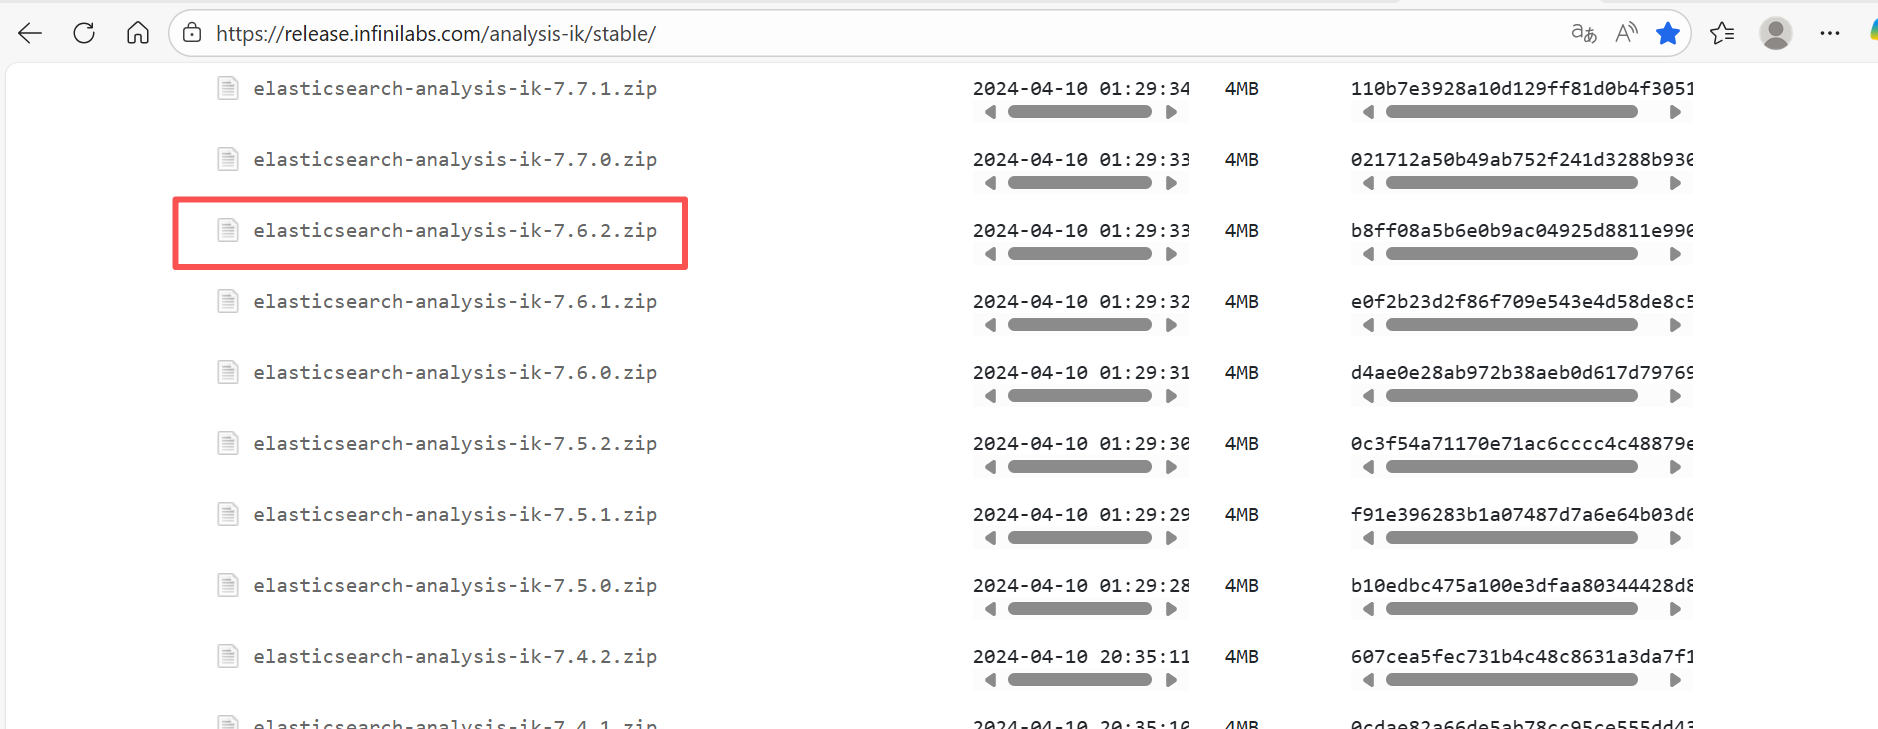
- Kibana:这是 Elasticsearch 的数据可视化和管理利器。你可以通过修改以下 URL 中的版本号来下载特定版本:
https://artifacts.elastic.co/downloads/kibana/kibana-7.6.2-windows-x86_64.zip。通常建议与 Elasticsearch 版本保持一致。
二、安装、启动与基础验证
下载完成后,我们进入实际的安装和配置环节。这个过程就像搭建一个微型的本地数据服务中心。
1. 安装 Elasticsearch 与 IK 分词器
首先,解压下载的 Elasticsearch ZIP 包(例如 elasticsearch-8.12.0-windows-x86_64.zip)。接着,解压 IK 分词器 ZIP 包,并将其整个文件夹(如 elasticsearch-analysis-ik-8.12.0)复制或移动到 Elasticsearch 目录下的 plugins 文件夹中。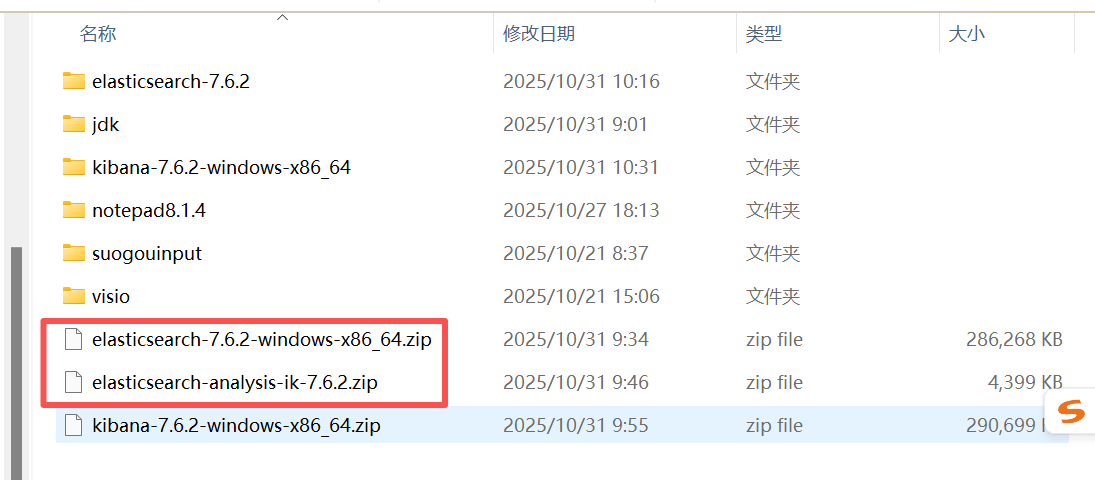
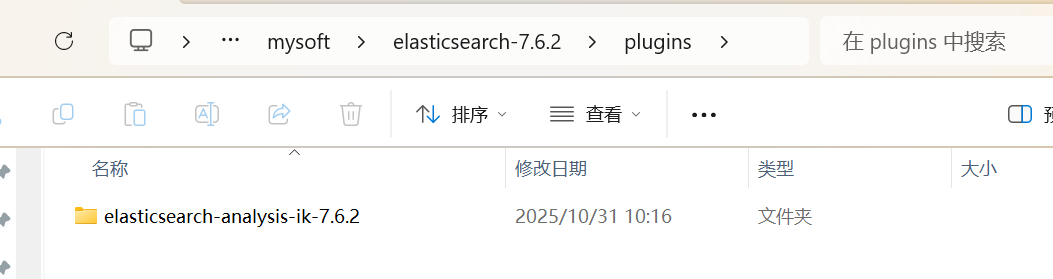 这个操作相当于为 Elasticsearch 安装了一个功能扩展模块。
2. 启动与验证 Elasticsearch
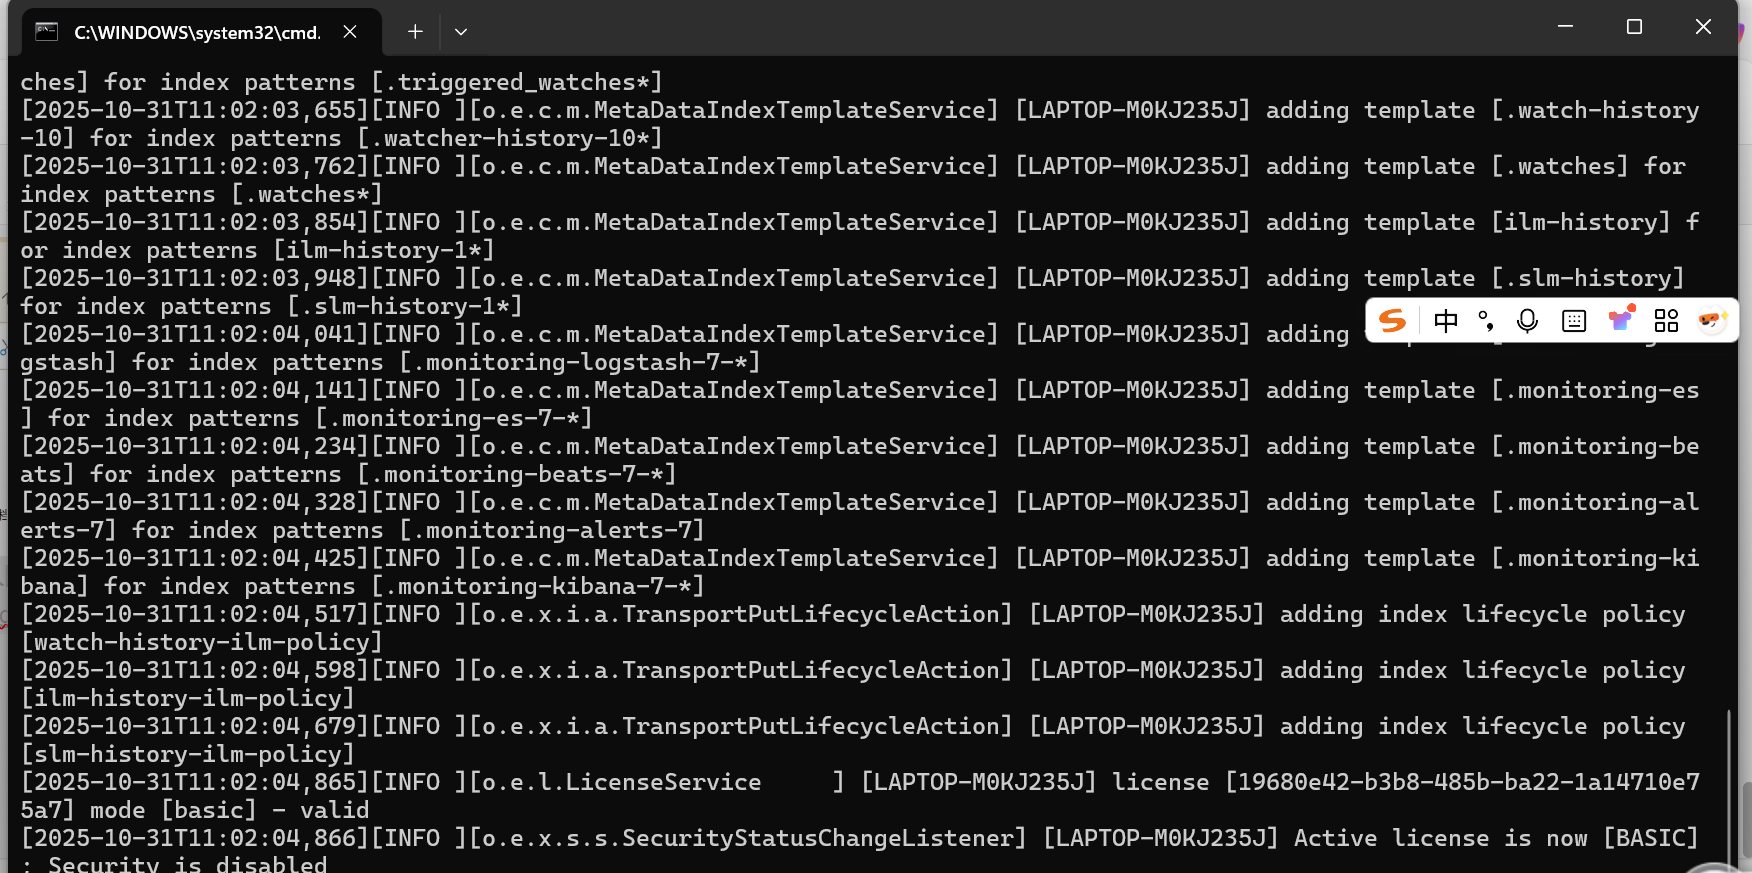
进入 Elasticsearch 解压目录的 bin 文件夹,双击 elasticsearch.bat 文件启动服务。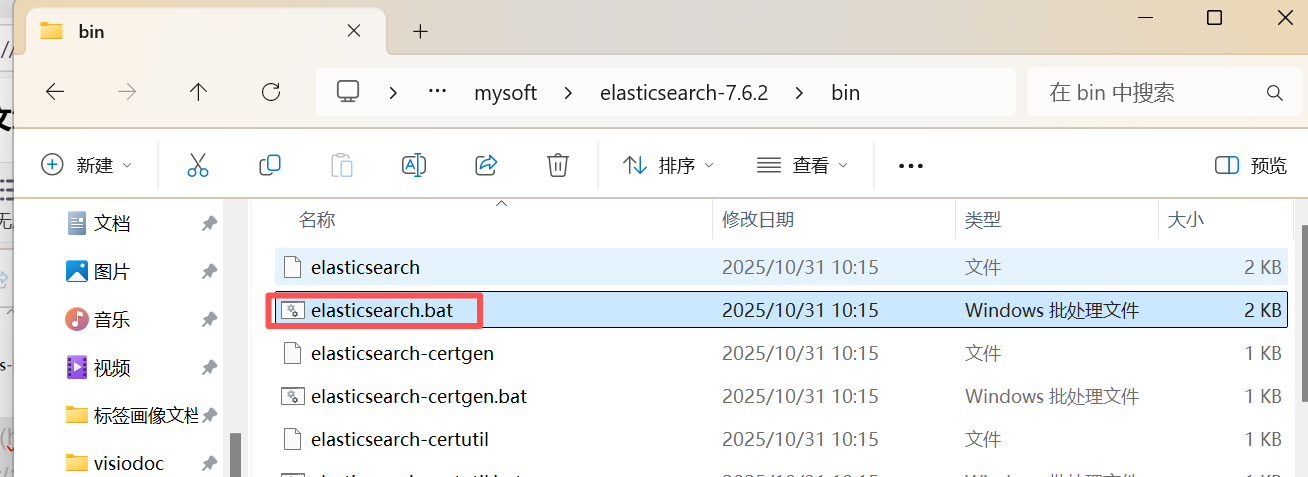 你会看到一个命令行窗口,显示启动日志。当看到类似“started”的日志信息时,表示启动成功。
 此时,打开浏览器,访问
http://localhost:9200。如果看到返回一个包含集群名称、版本等信息的 JSON 对象,则证明 Elasticsearch 服务已正常运行。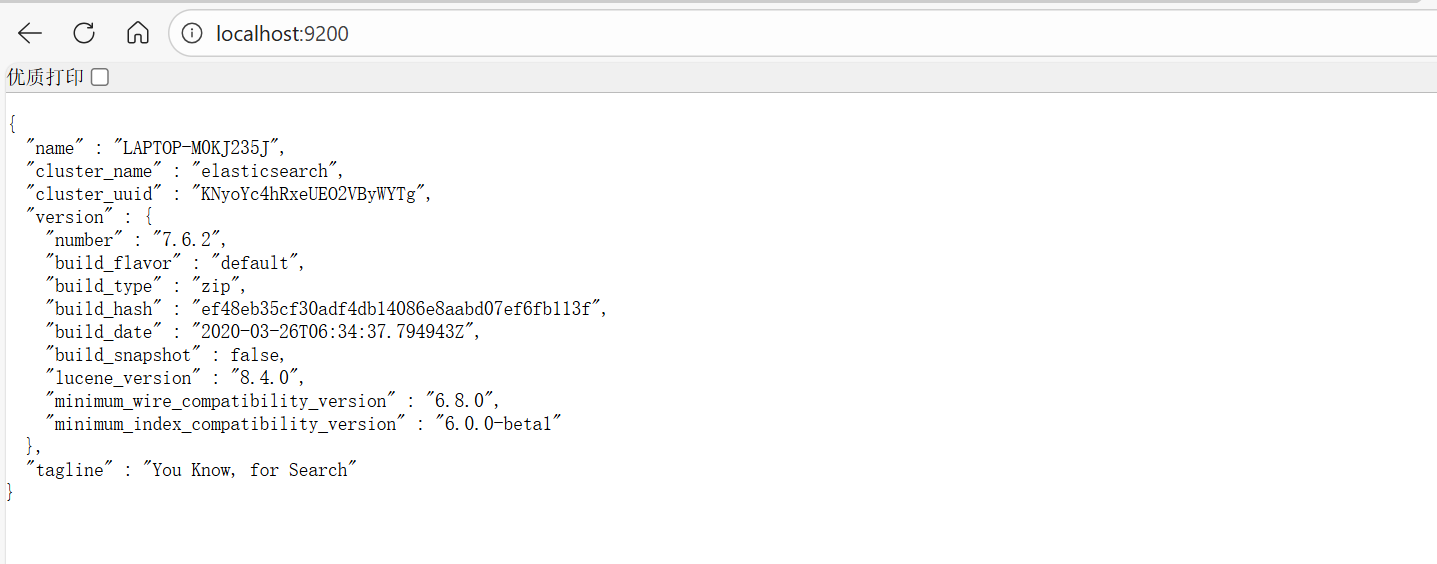
3. 常见启动问题排查
如果启动窗口闪退或无法访问 9200 端口,说明启动失败。此时应查看 Elasticsearch 目录下 logs 文件夹中的日志文件(如 elasticsearch.log)来定位问题。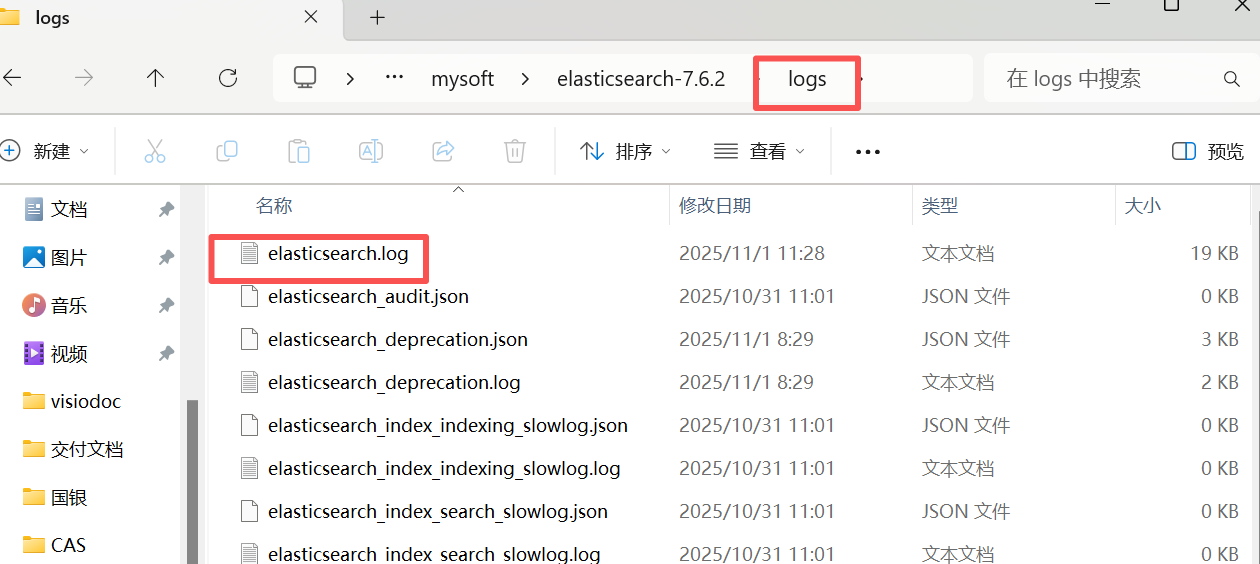
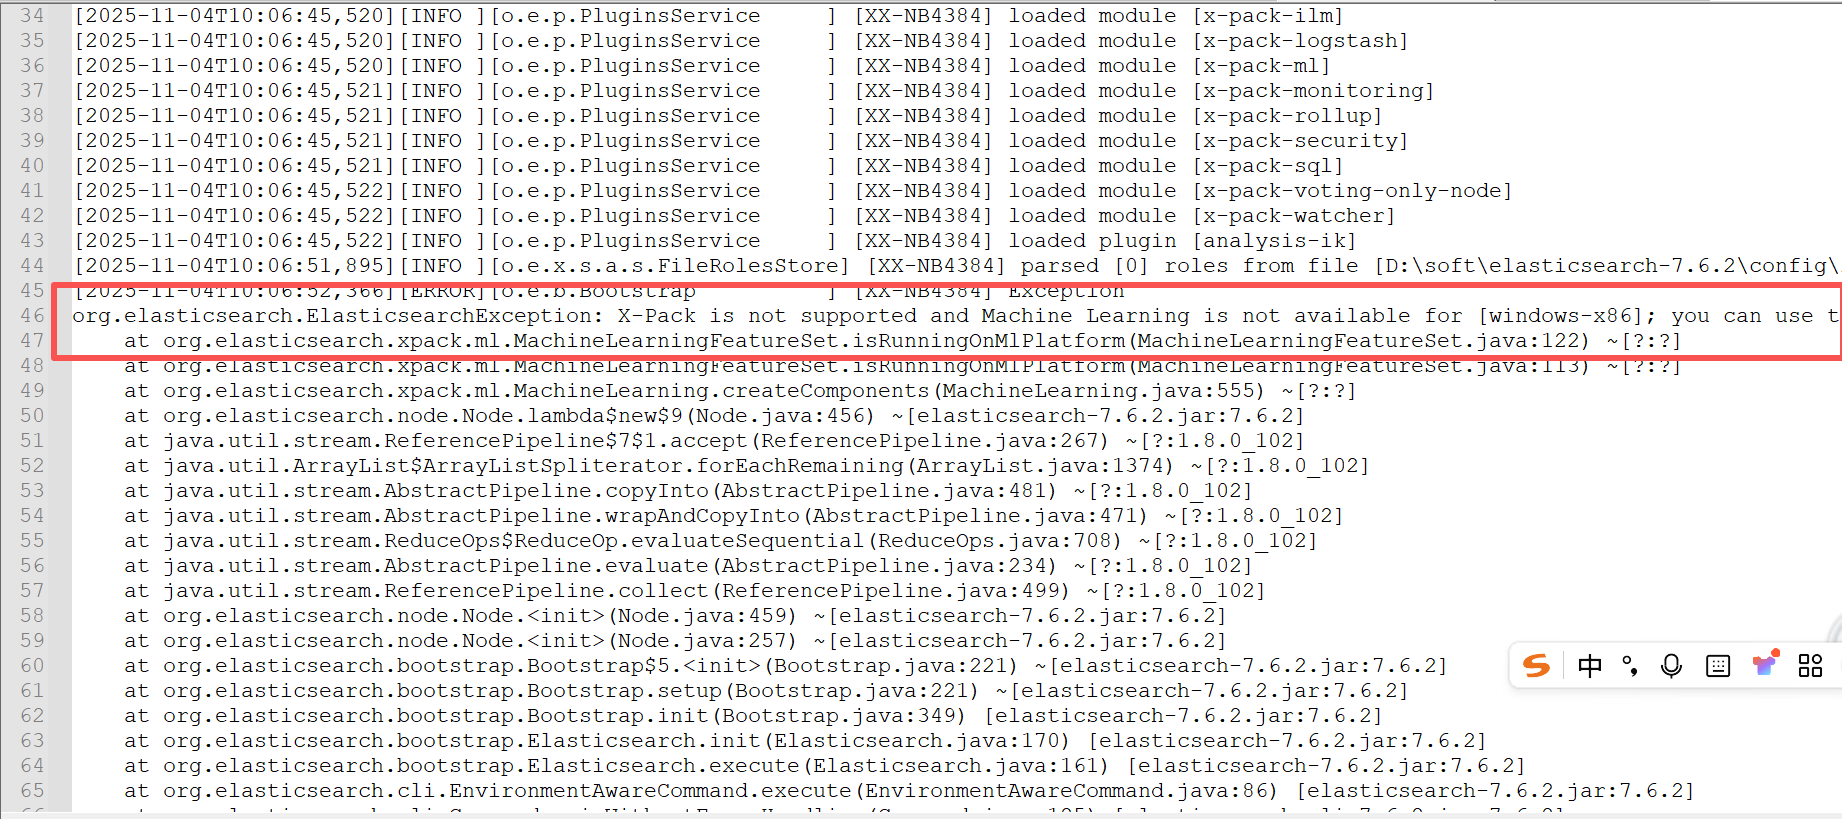 一个常见问题是高版本 Elasticsearch 默认启用了安全功能(X-Pack),如果未配置证书可能导致启动失败。日志中通常会给出明确的错误信息和解决建议。
org.elasticsearch.ElasticsearchException: X-Pack is not supported and Machine Learning is not available for [windows-x86]; you can use the other X-Pack features (unsupported) by setting xpack.ml.enabled: false in elasticsearch.ymlconfig/elasticsearch.yml 文件,添加以下配置行:xpack.ml.enabled: falseelasticsearch.bat 即可。三、配置与启动 Kibana 可视化界面
Kibana 为我们提供了图形化的方式来与 Elasticsearch 交互,极大地提升了开发和管理效率。
解压 Kibana 的 ZIP 包。进入其 config 目录,编辑 kibana.yml 配置文件。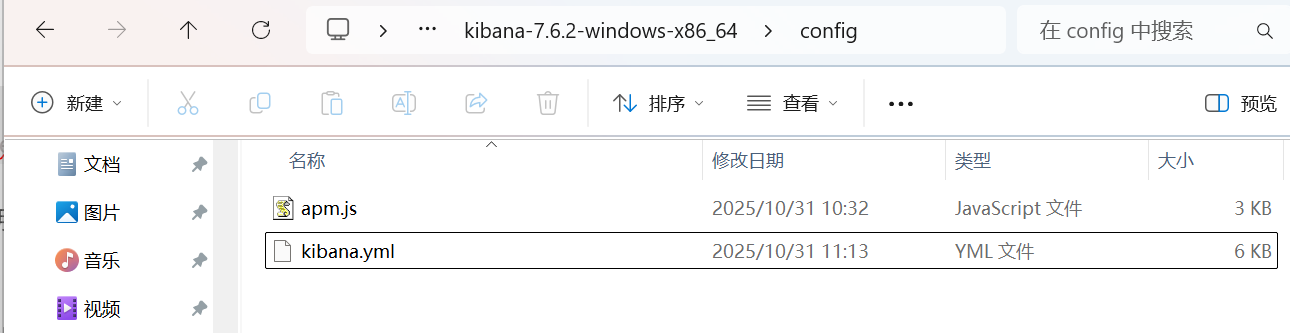 该文件包含了大量注释说明。对于基础开发环境,我们只需启用最关键的几项配置:
server.port: 5601  # 访问端口
server.host: "localhost"  # 访问地址
server.name: "es-sever" # 服务名, 可以自行定义
elasticsearch.hosts: ["http://localhost:9200"] # elasticsearch服务器的地址
i18n.locale: "zh-CN" # 可视化页面使用中文0.0.0.0 允许外部访问),以及它要连接的 Elasticsearch 实例地址。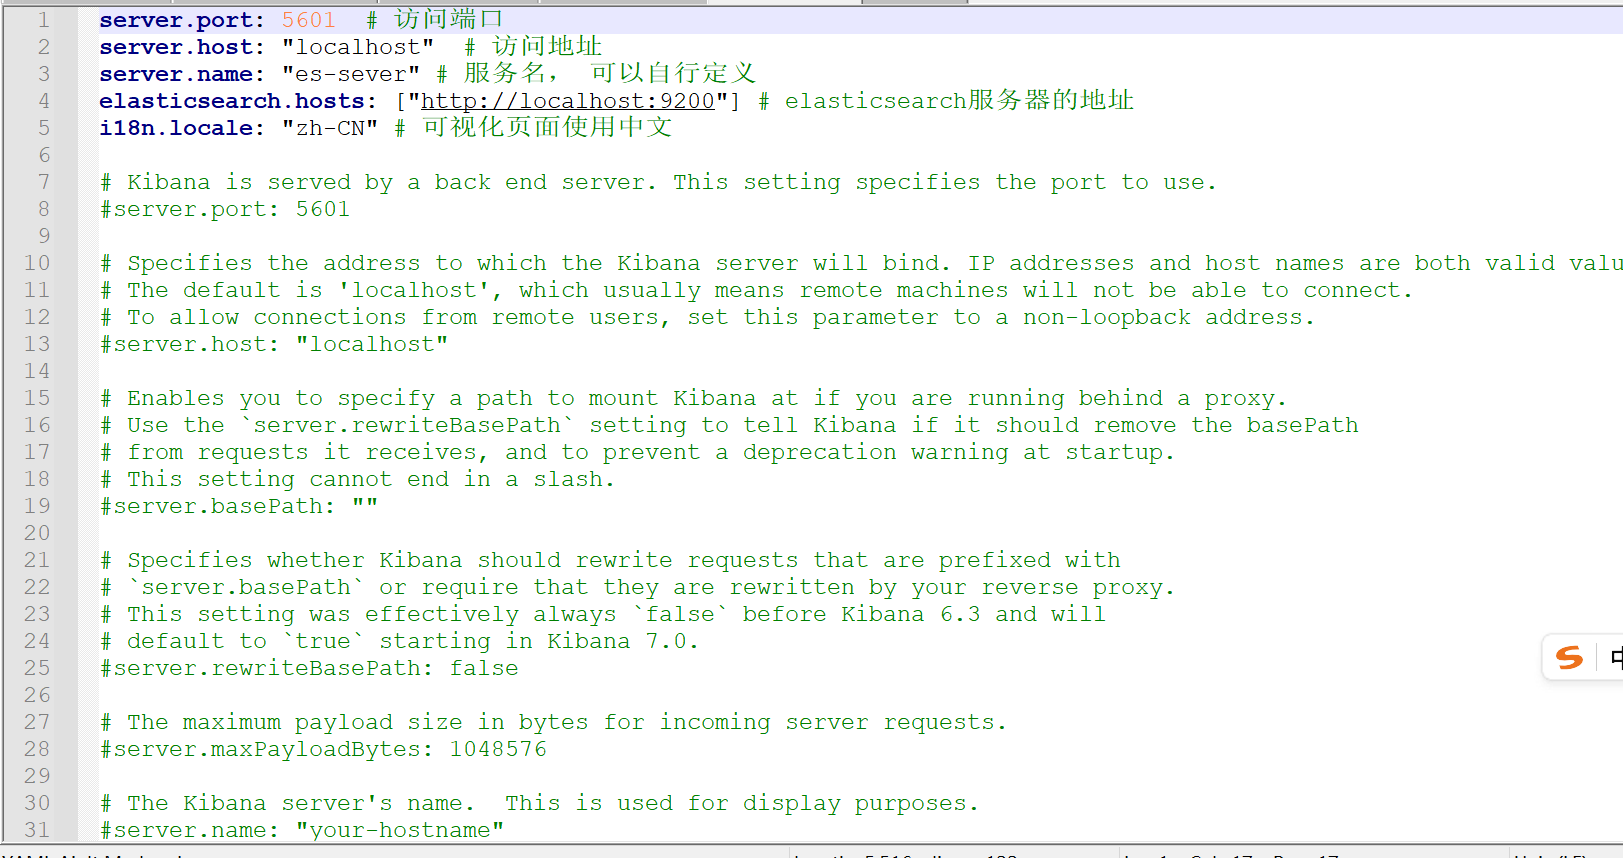
配置完成后,进入 Kibana 的 bin 目录,双击 kibana.bat 启动。启动过程可能需要一两分钟。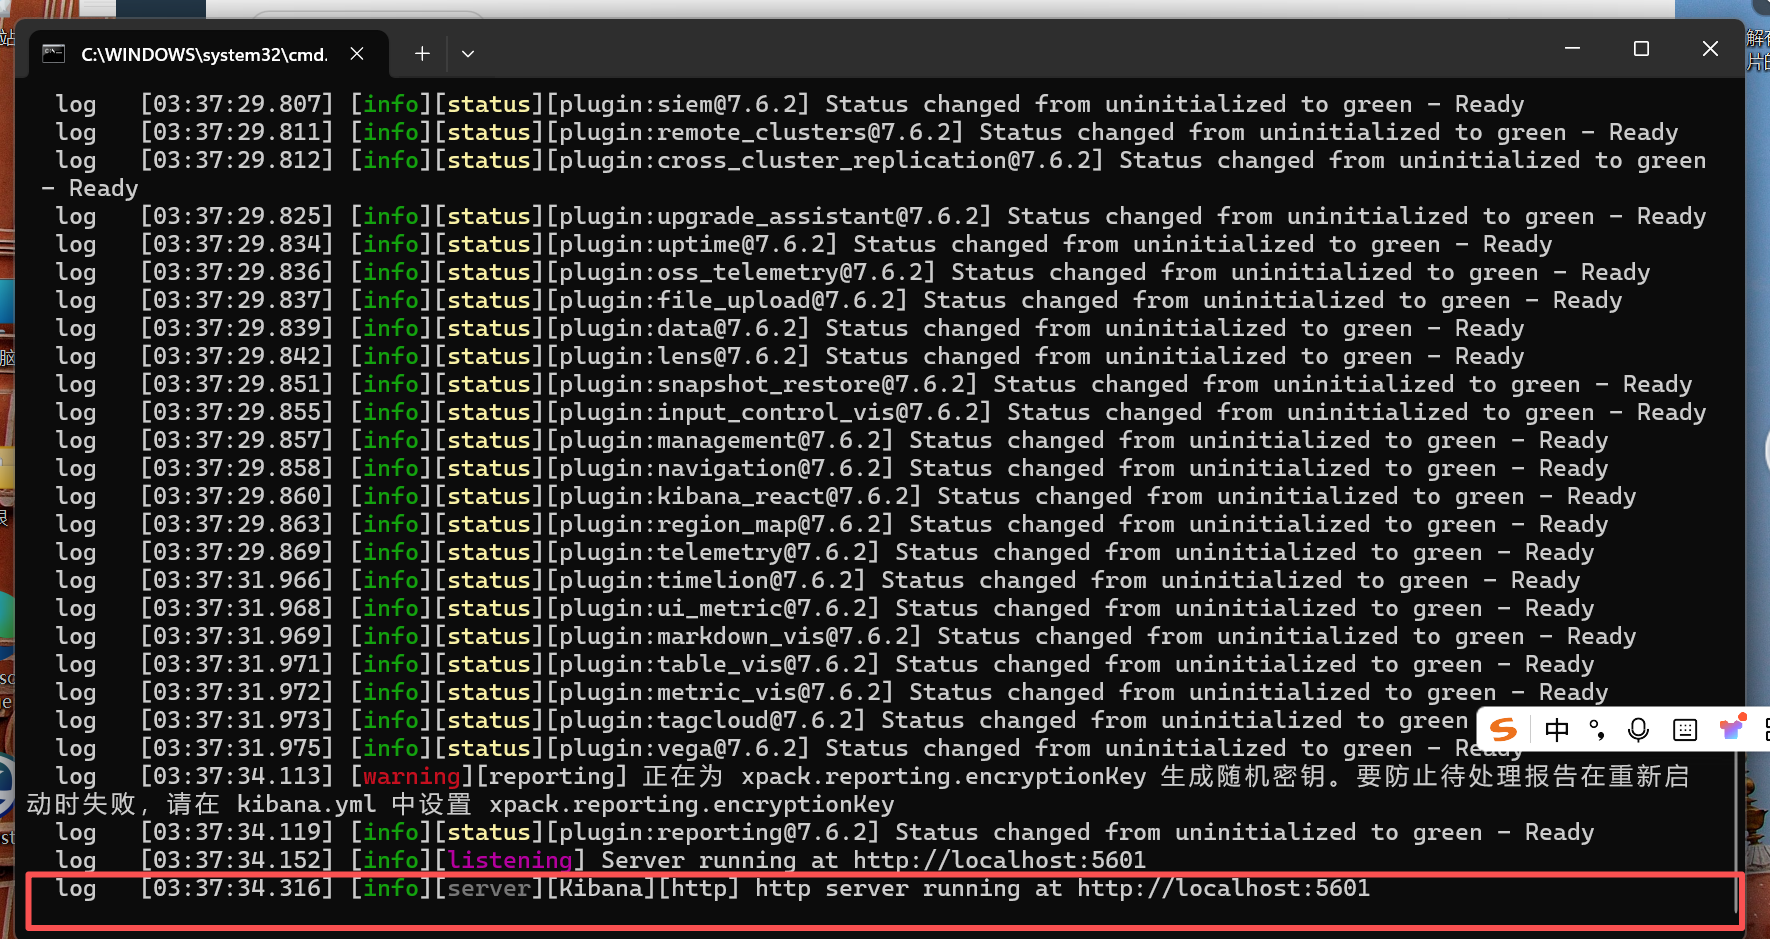 成功后,在浏览器访问
http://localhost:5601,即可进入 Kibana 的欢迎界面。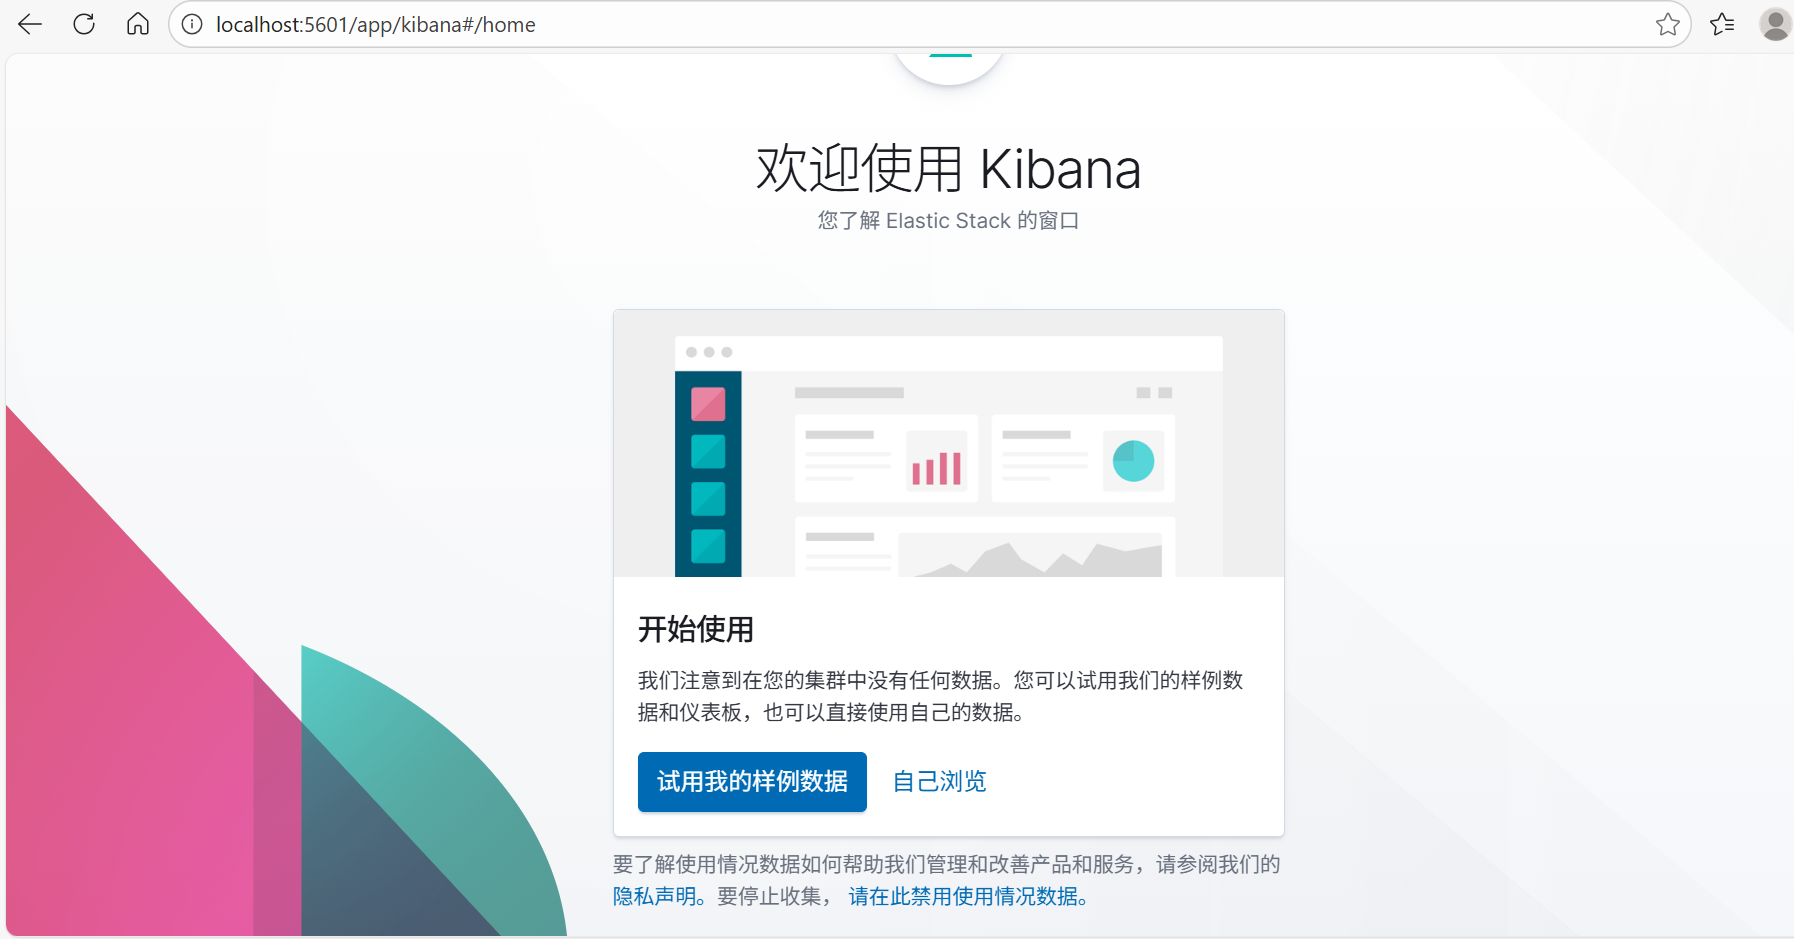
四、初探 Kibana Dev Tools:执行你的第一个查询
Kibana 的 Dev Tools 控制台是与 Elasticsearch 进行 API 交互的绝佳场所,其体验类似于你在 JavaScript 或 Python 中使用 REPL 环境。
在 Kibana 左侧导航栏找到并点击“Dev Tools”图标。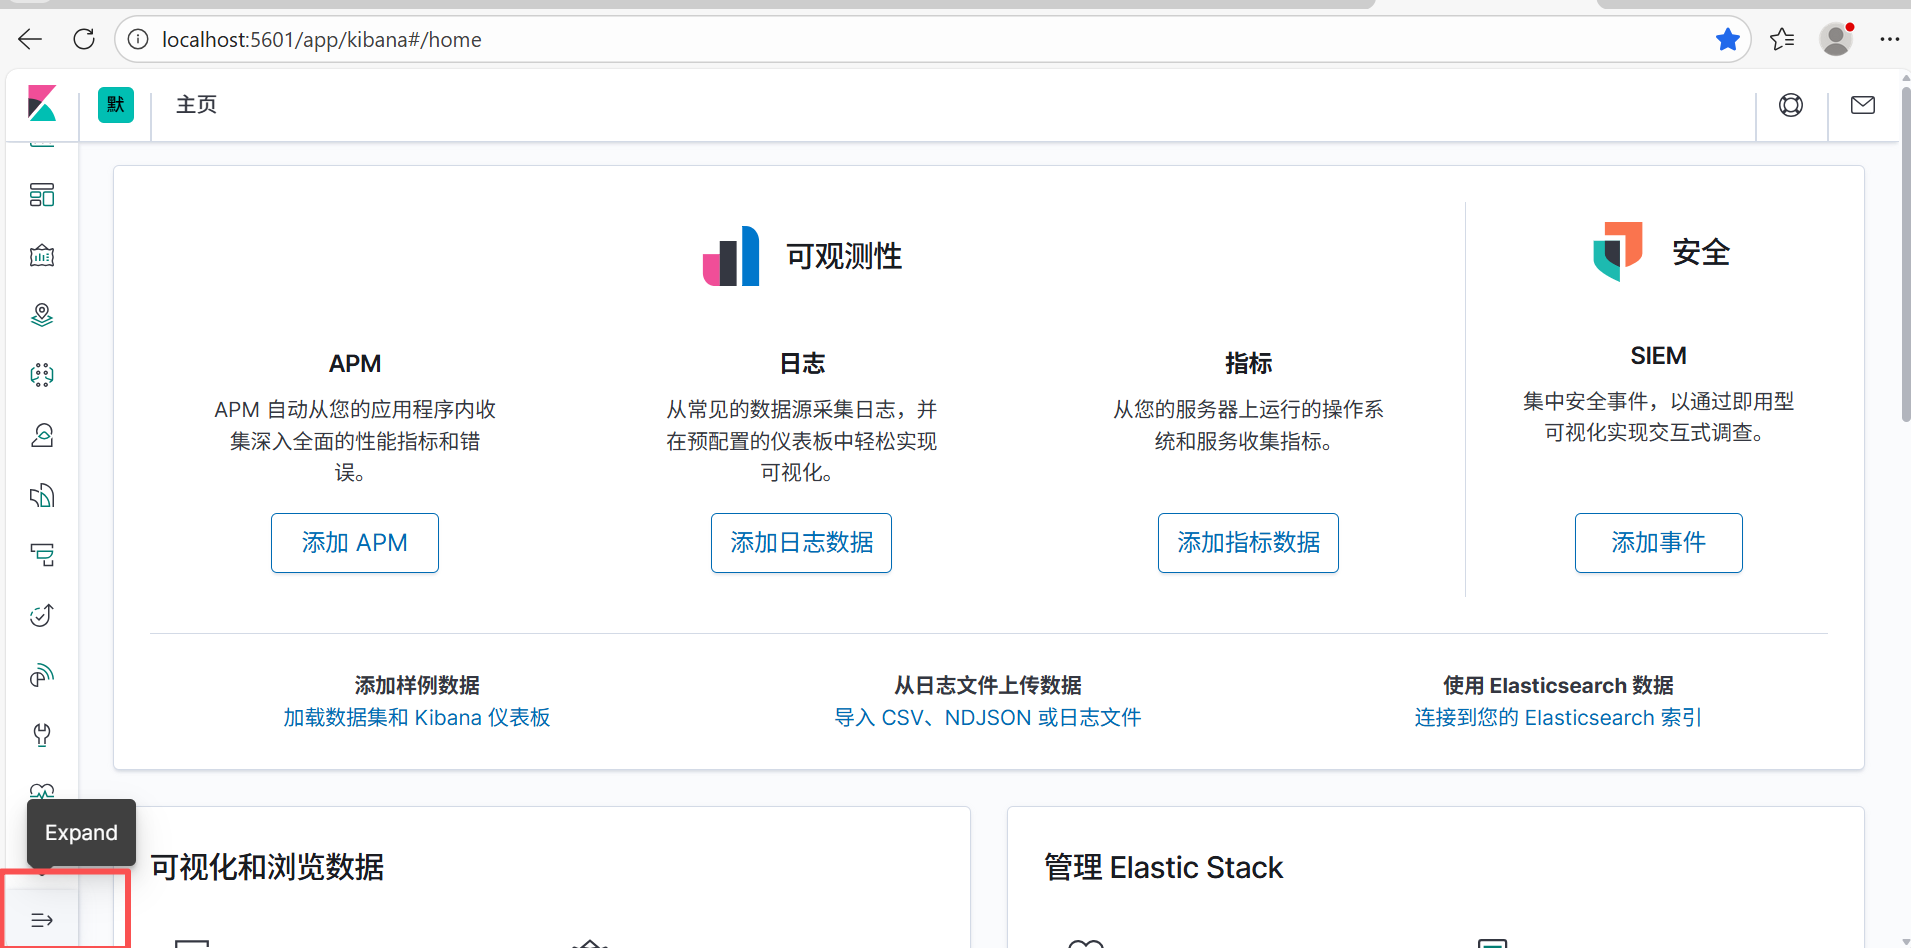
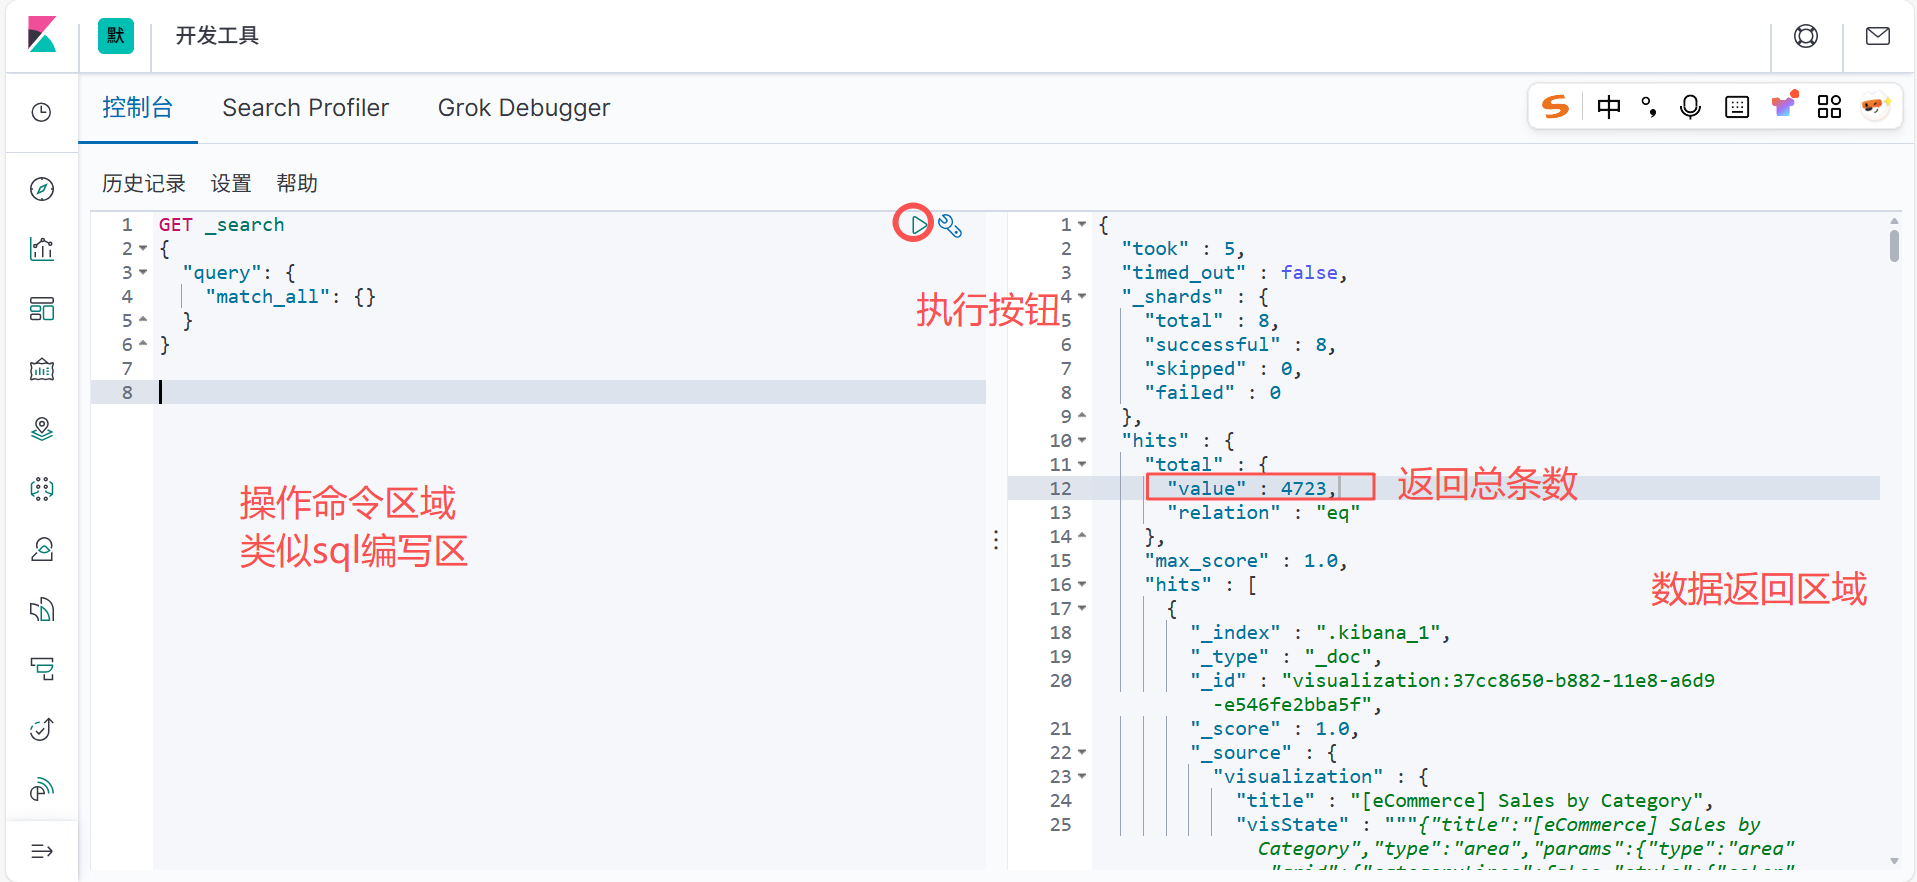 左侧面板用于编写请求,右侧面板展示响应结果。它支持语法高亮和智能提示,例如输入
GET / 时会自动补全选项。match_ match_all 你可以一次性编写多条语句,但执行后只会显示最后一条语句的结果。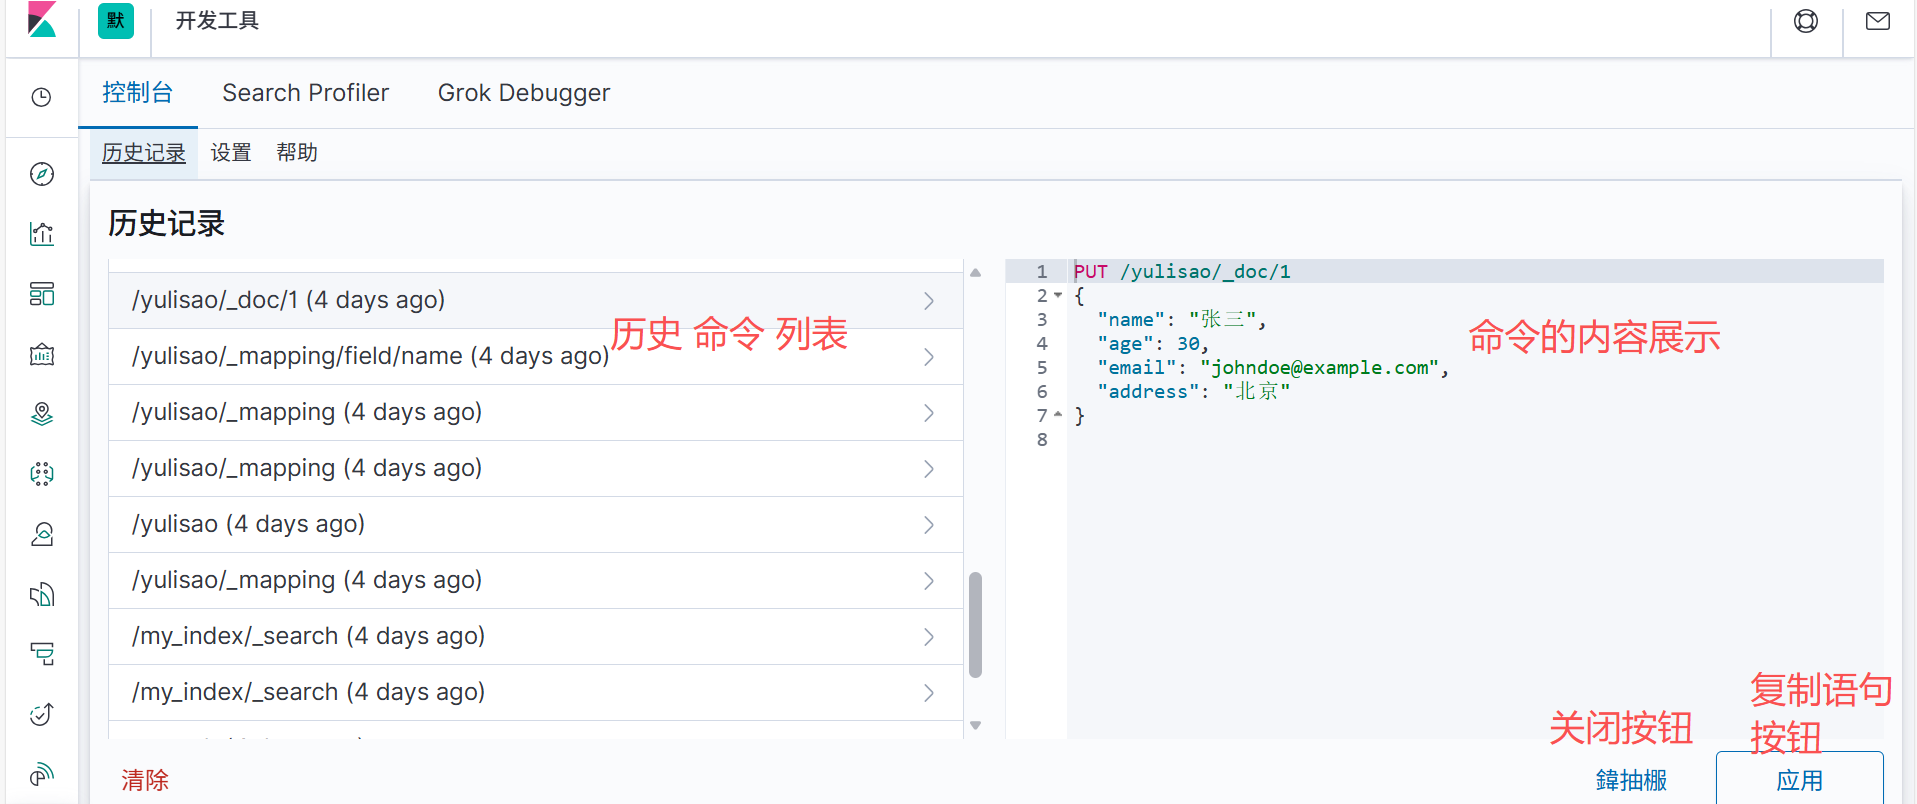
让我们通过一个简单的例子来理解 Elasticsearch 的核心概念。它与传统关系型数据库(如 MySQL)的类比关系如下:
- 索引 (Index) ≈ 数据库中的表 (Table)
- 映射 (Mapping) ≈ 表结构 (Schema),定义字段类型
- 文档 (Document) ≈ 表中的一行数据 (Row)
以下是一组基础的增删改查操作示例,你可以直接在 Dev Tools 中执行:
1. 创建索引并定义映射: 这相当于创建一张名为“users”的表,并规定字段类型。
PUT /yulisao      # 创建yulisao这个索引并同时添加映射
{
	"mappings": {
		"properties": {
			"name": {  # 字段名
			  "type": "text"   # 数据类型
			},
			"age": {
			  "type": "integer"
			},
			"barth": {
			  "type": "date",
			  "format": "yyyy-MM-dd HH:mm:ss||epoch_millis"  # 数据格式
			}
		}
	}
}
2. 插入文档: 向“users”索引中添加一条数据。
# 添加一条数据
POST /yulisao/_doc/1    # 1 是文档ID,可以省略则自动生成一个长字符串
{
  "name": "张三",
  "age": 30,
  "barth": "2025-01-01 12:12:12"
}
3. 查询文档: 搜索名为“小王”的用户。
# 查询  {}里面的注释要删除掉在执行,不然报错
GET /yulisao/_search
{
  "query": {
    "match": {
		"name": "小王"
	} # 查询条件
  },
  "size": 5,  # 查询多少条,可省略则返回全部
  "_source": ["name", "age"] # 查哪几个字段返回, 可省略则返回全部字段
}
4. 删除文档: 根据文档ID删除数据。
DELETE /yulisao/_doc/1掌握这些基础操作后,你已经可以开始用 Elasticsearch 存储和查询数据了。对于希望深入集成搜索功能的开发者,无论是使用 Node.js (JavaScript/TypeScript)、Java 的 Spring Boot,还是 Python 的 Django/Flask,都有成熟的官方客户端库可供使用 [AFFILIATE_SLOT_1]。
五、进阶配置:安全加固与 IK 分词器深度定制
在完成基础搭建后,为了满足更接近生产环境的需求或优化中文搜索体验,可以进行以下进阶配置。
1. 启用 Elasticsearch 与 Kibana 的安全认证
默认安装下,你的 Elasticsearch 和 Kibana 是对外开放且无需密码的,这在开发后期或团队协作中存在安全风险。Elasticsearch 内置了安全模块,可以轻松启用。
首先,编辑 elasticsearch.yml,启用安全特性并配置密码:
xpack.security.enabled: true
xpack.license.self_generated.type: basic
xpack.security.transport.ssl.enabled: true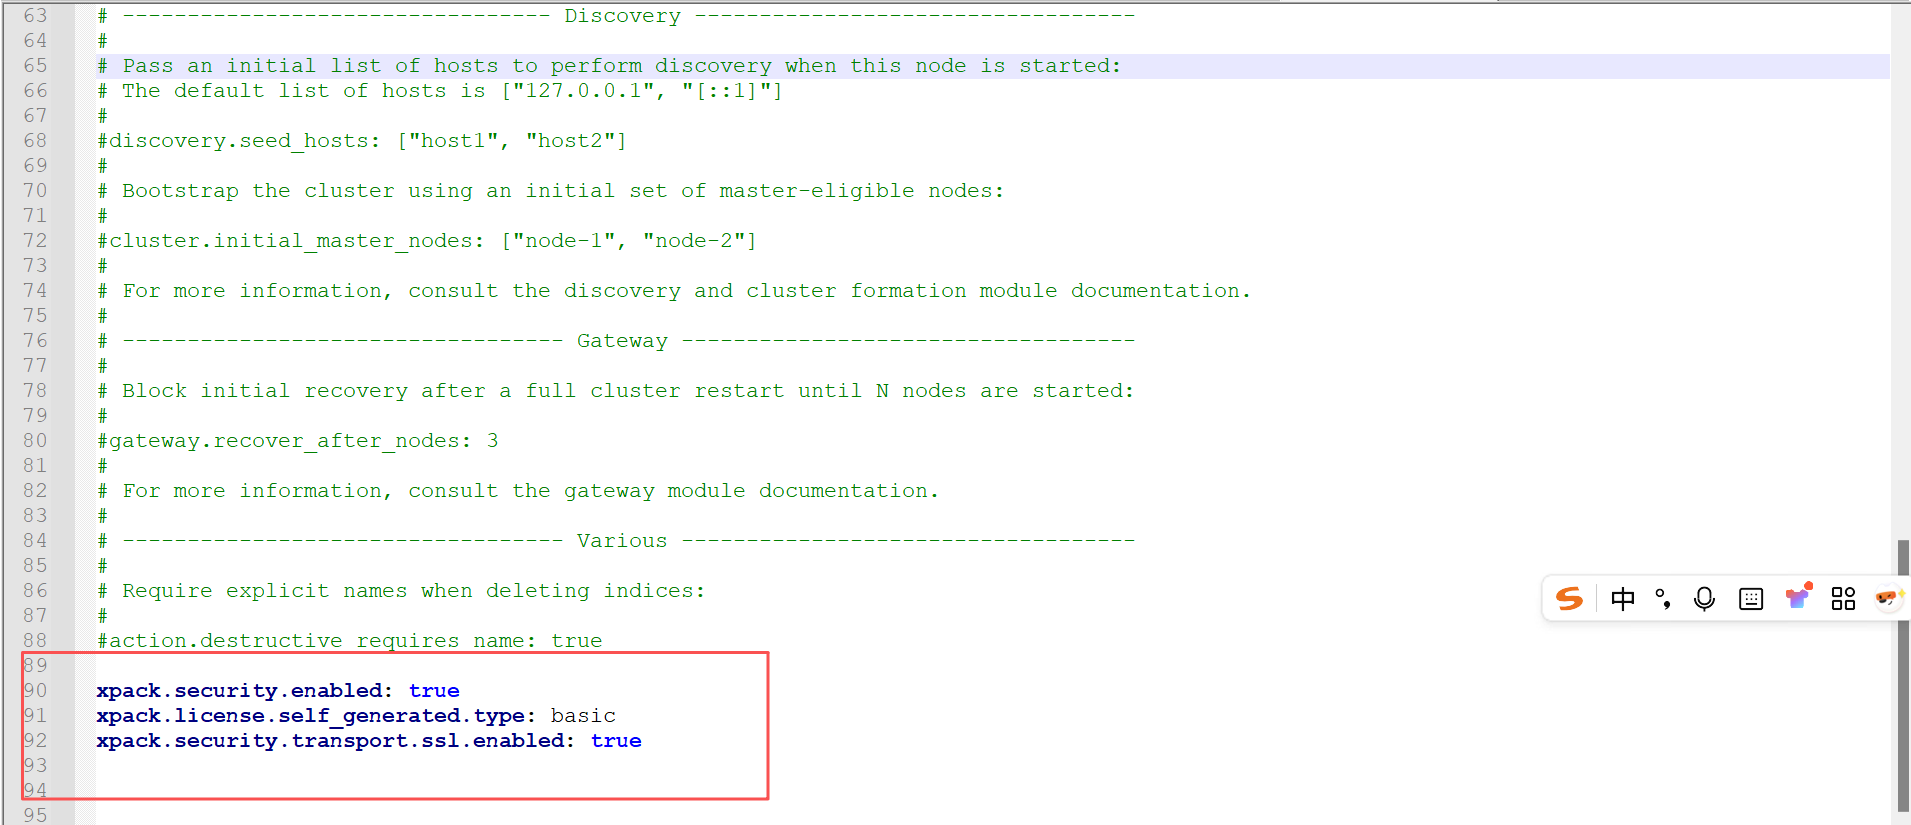
保存并重启 Elasticsearch。然后,在 Elasticsearch 的 bin 目录下打开 PowerShell,执行以下命令来为内置用户(如超级用户 elastic)设置密码:
./elasticsearch-setup-passwords interactive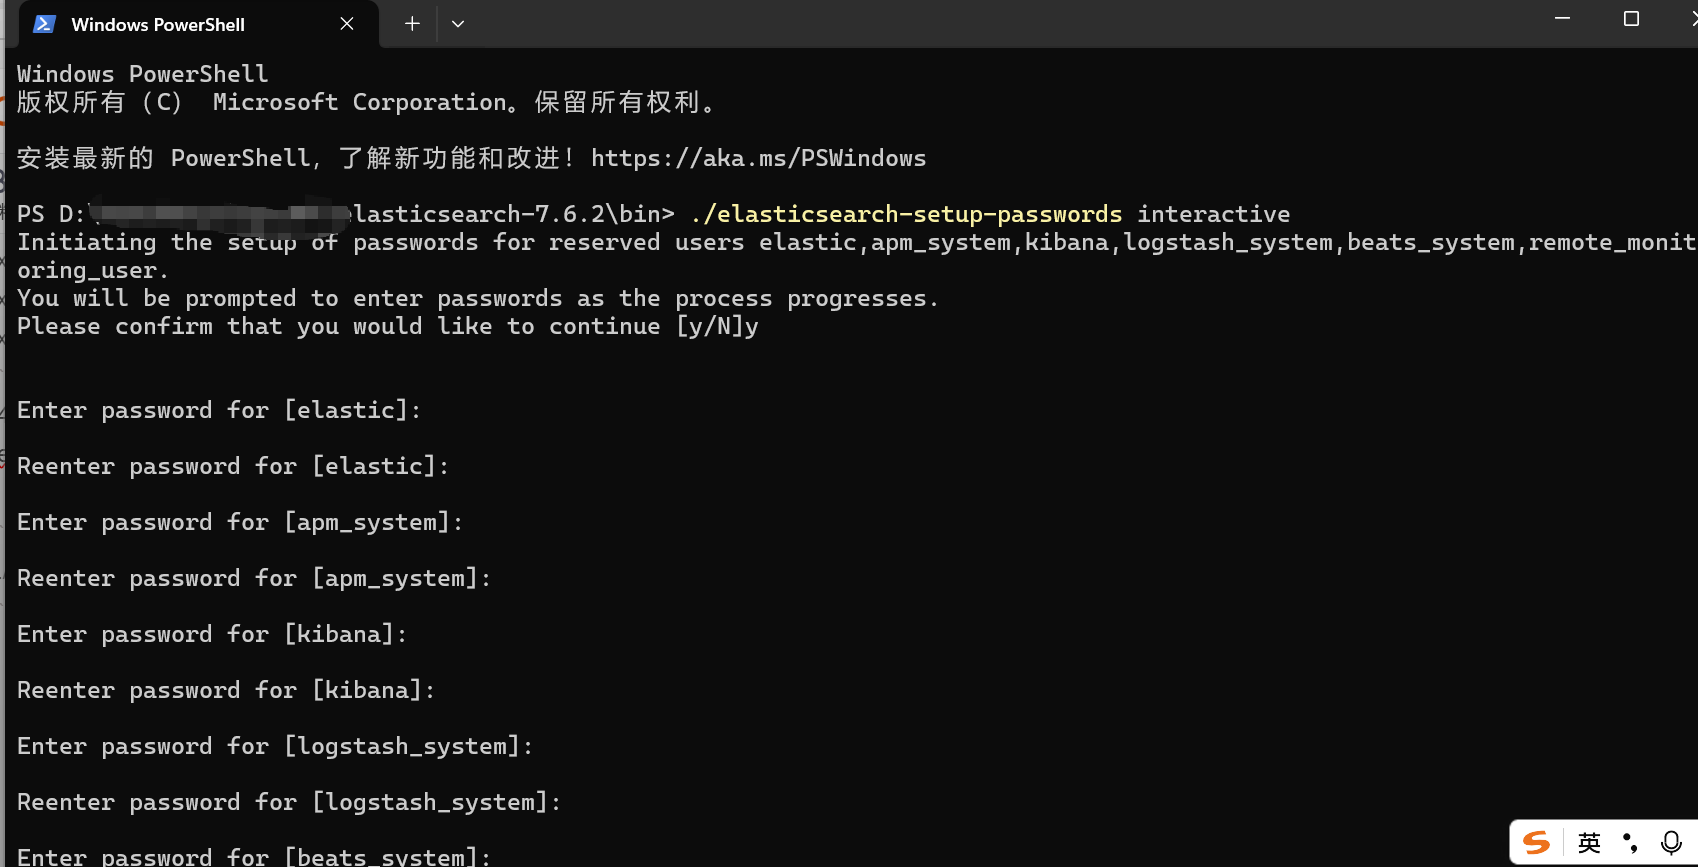
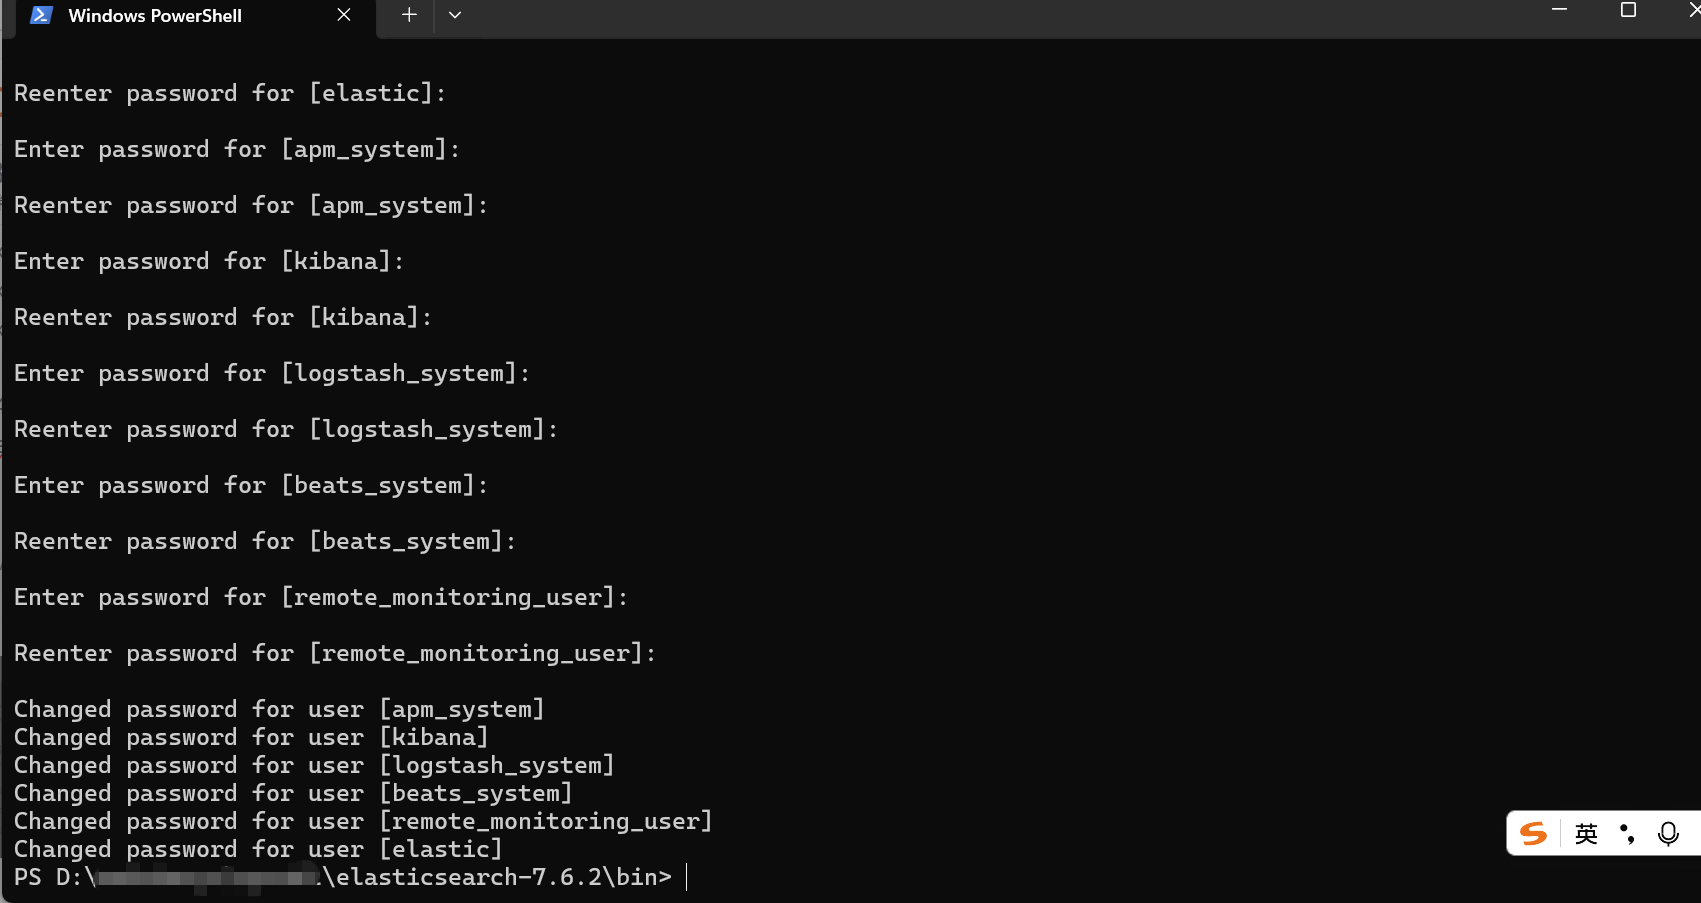 按照提示为各个系统用户设置强密码。完成后,再次访问
http://localhost:9200 就会弹出登录框。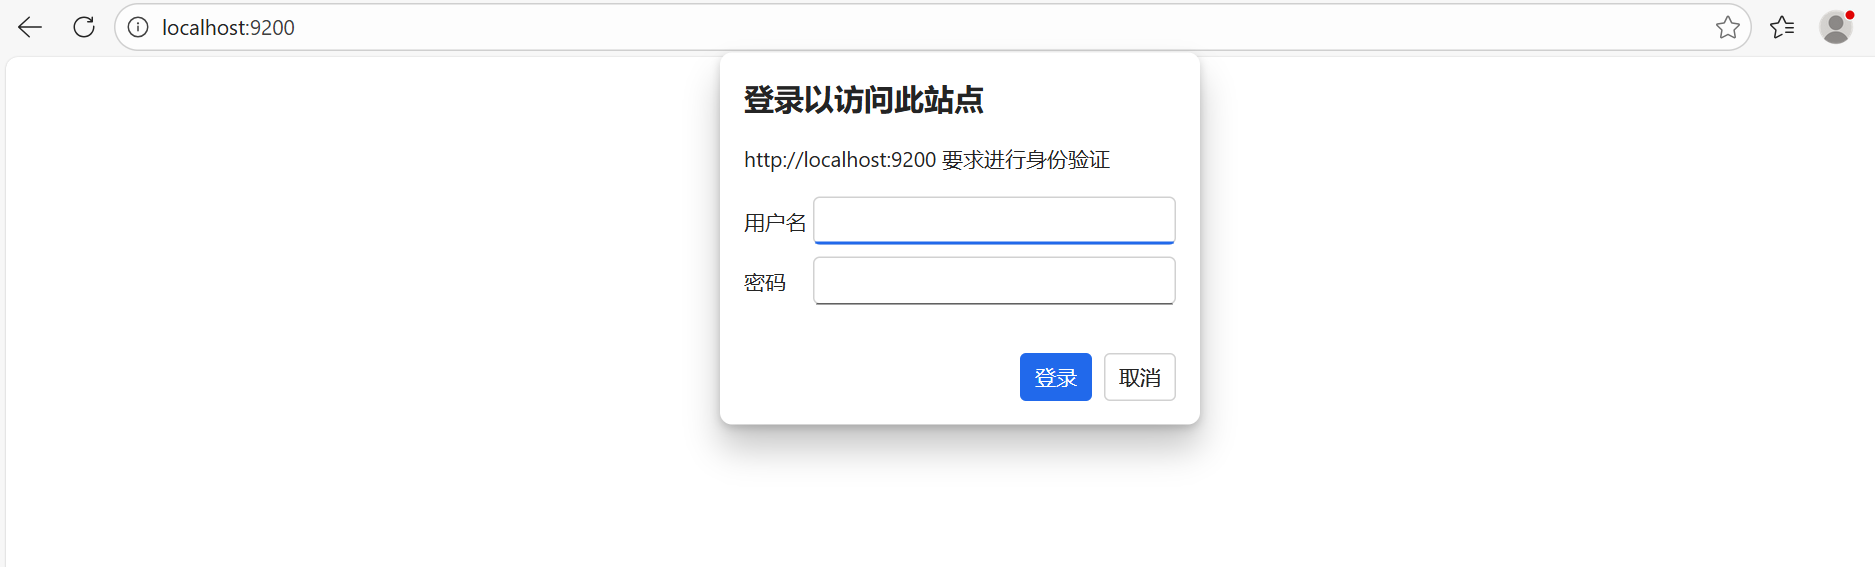
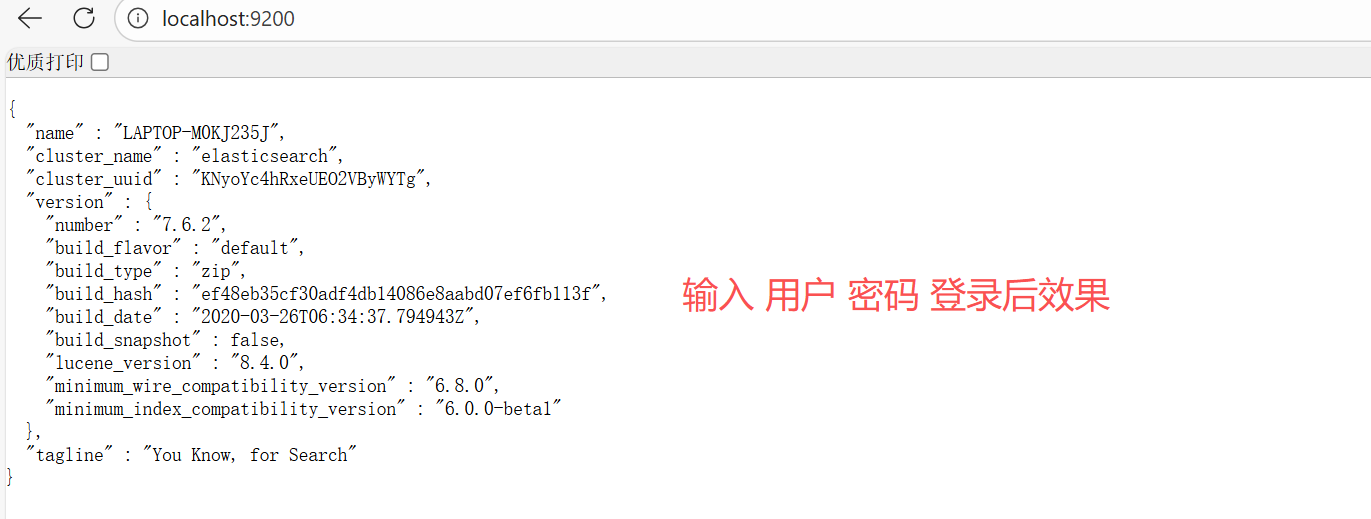
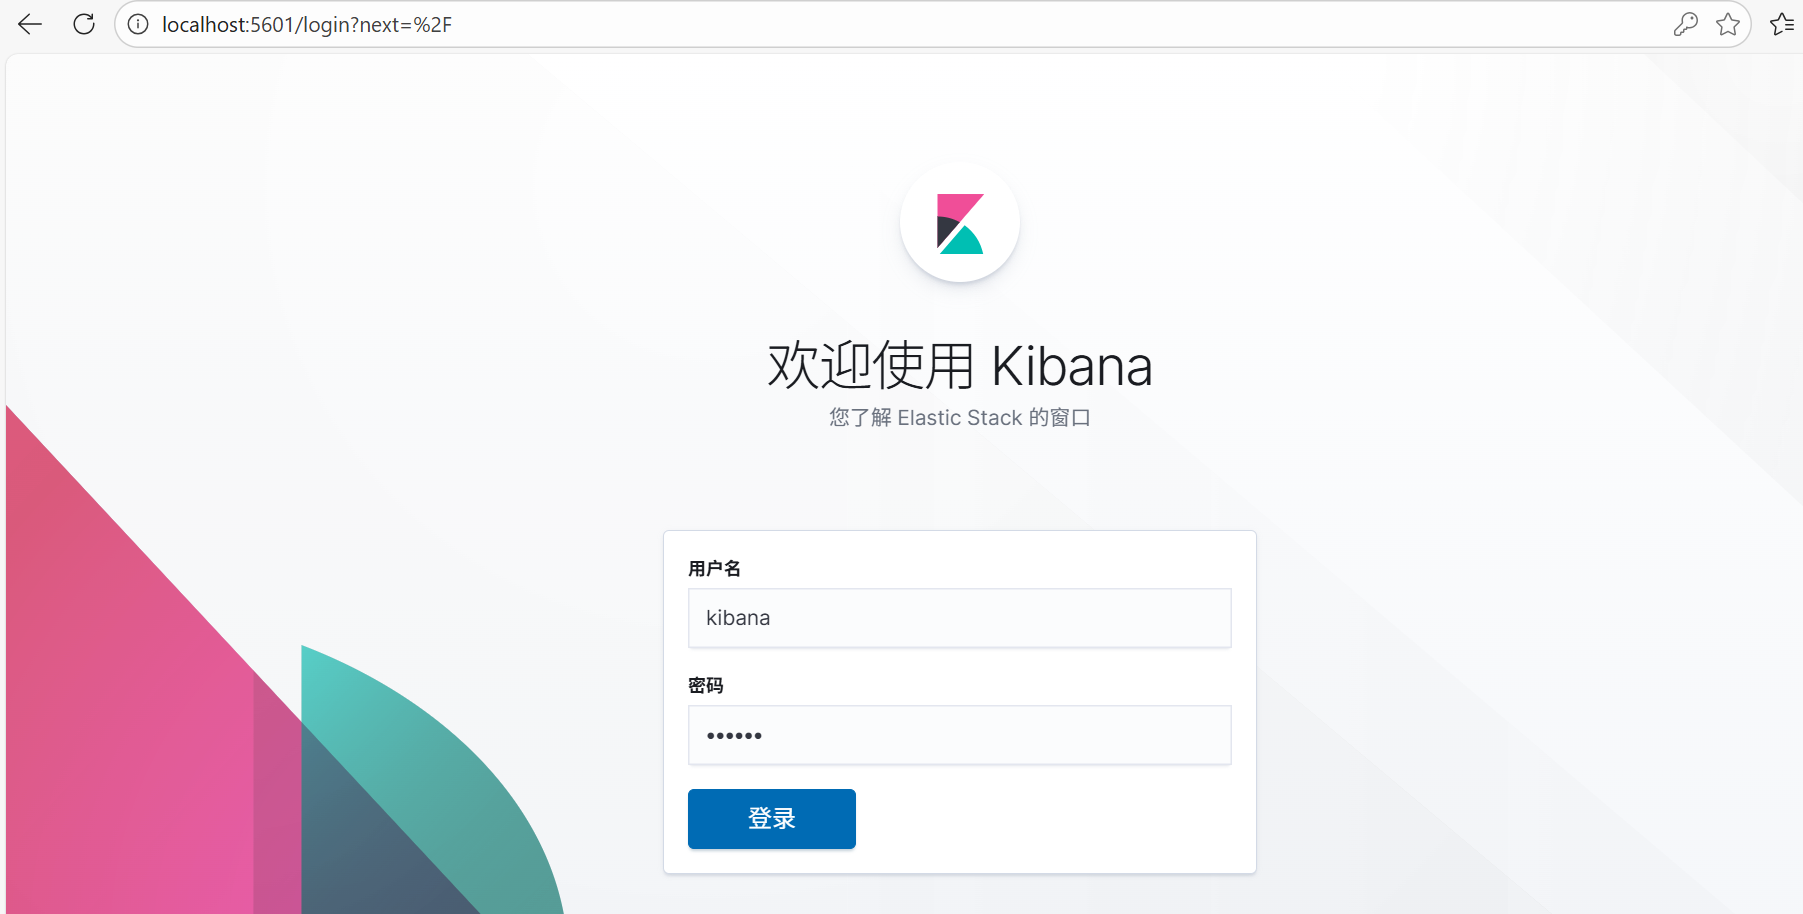
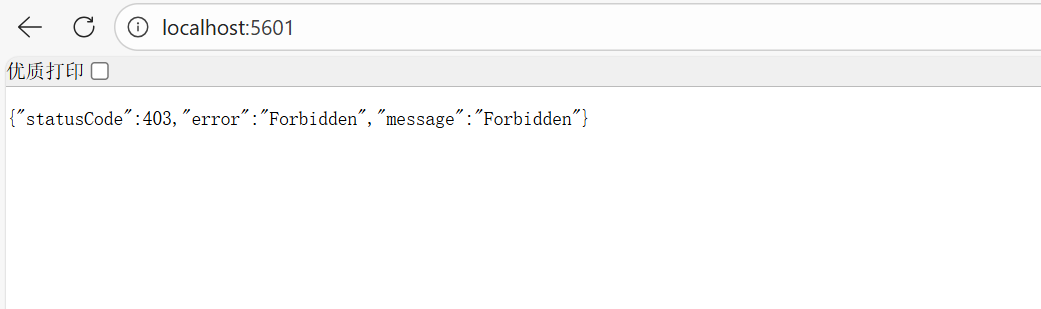
接着,需要配置 Kibana 使用密码连接 Elasticsearch。编辑 kibana.yml,添加认证信息:
elasticsearch.username: "kibana"
elasticsearch.password: "123456" # 你在elasticsearch设置的密码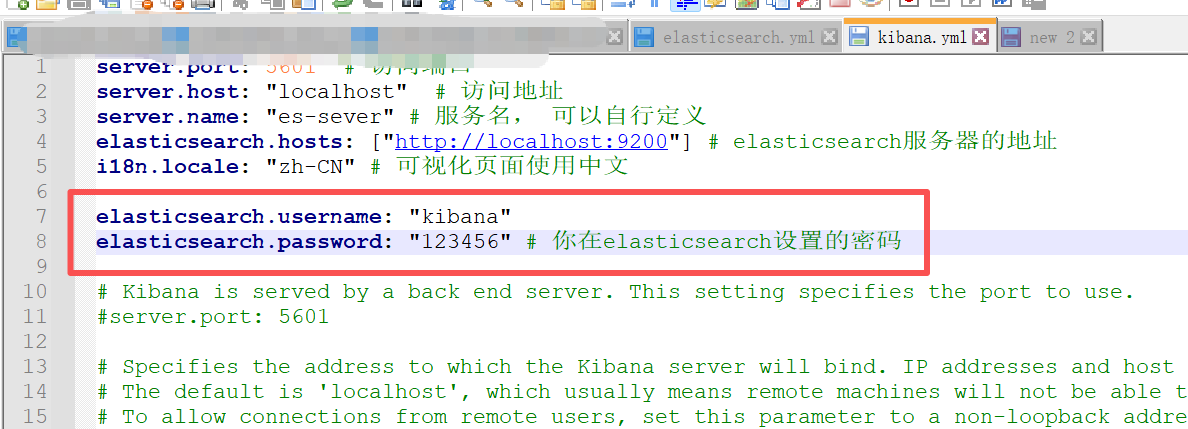 重启 Kibana 后,访问其界面也需要进行登录。
2. 深入理解与配置 IK 分词器
Elasticsearch 的搜索性能优势很大程度上源于其“倒排索引”机制,而分词器是构建和查询倒排索引的关键。与 MySQL 的“全表扫描”式模糊匹配不同,Elasticsearch 会在写入时对文本进行分析分词,并建立“词条 -> 文档ID”的映射表;在查询时,同样对查询词进行分词,然后直接在映射表中查找,效率极高。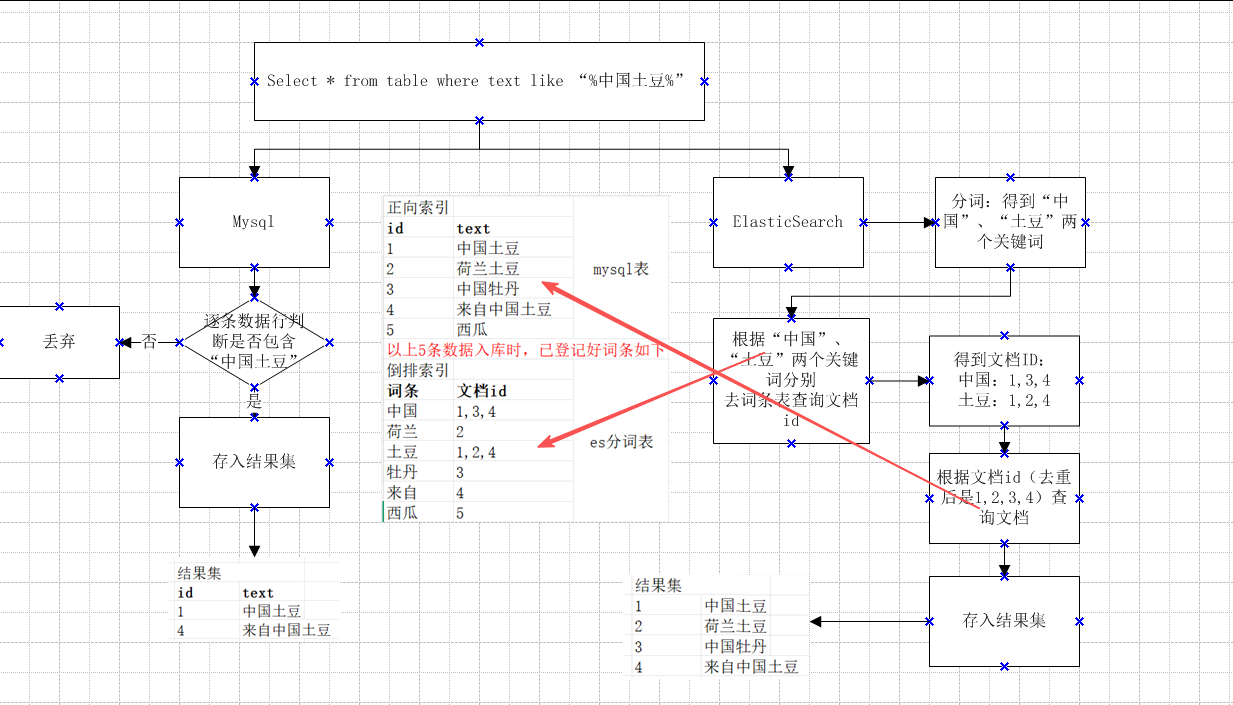
IK 分词器提供两种分词模式,适用于不同场景:
你可以通过以下 API 来直观感受不同模式的分词效果:ik_smart:智能切分,粗粒度。比如“中国人”,就分割为“中国人”
ik_max_word:最细切分,细粒度。比如“中国人”,分割为“中国”,“国人”
GET /_analyze
{
  "analyzer": "ik_max_word",  # 分词模式
  "text": "中国人"  # 你的关键词
}
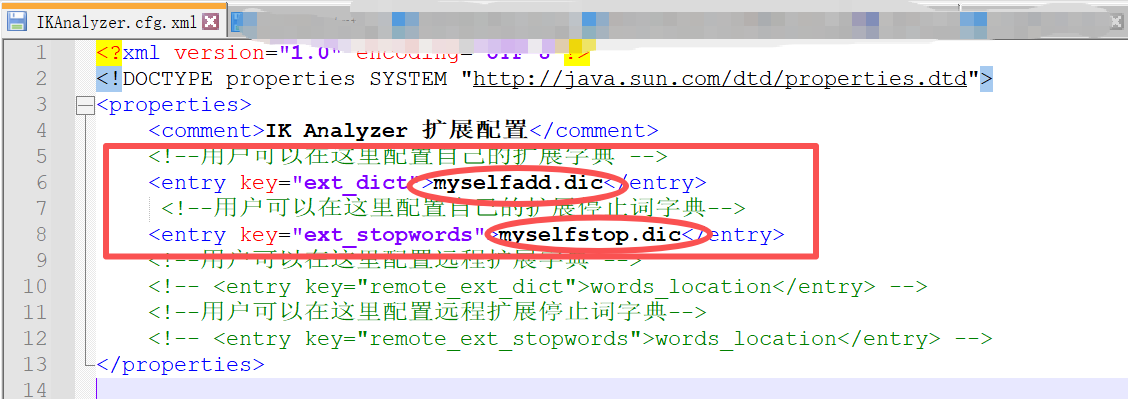
为了应对网络新词(如“提灯定损”)或屏蔽敏感词,我们需要自定义词典。进入 IK 分词器插件目录 plugins/elasticsearch-analysis-ik-*/config,编辑 IKAnalyzer.cfg.xml 文件。\elasticsearch-7.6.2\plugins\elasticsearch-analysis-ik-7.6.2\config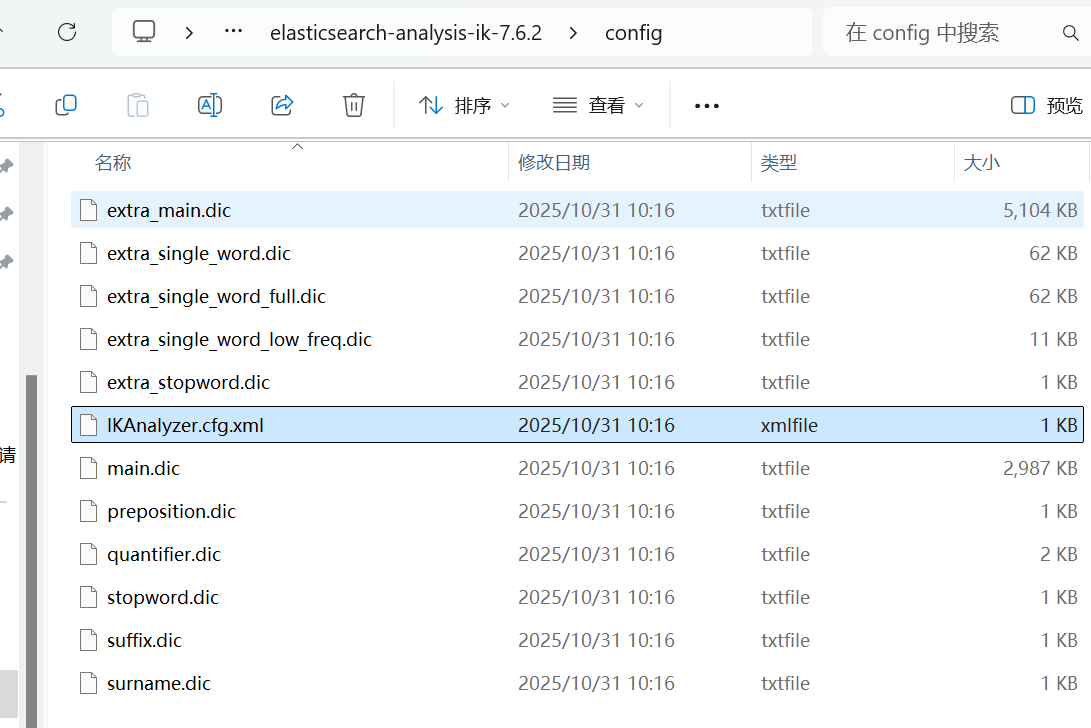
 在
<entry key="ext_dict"> 标签内添加自定义词典文件(如 custom_word.dic),在 <entry key="ext_stopwords"> 标签内添加停用词典文件。然后在同一目录下创建这些 .dic 文件,每行写入一个词条即可。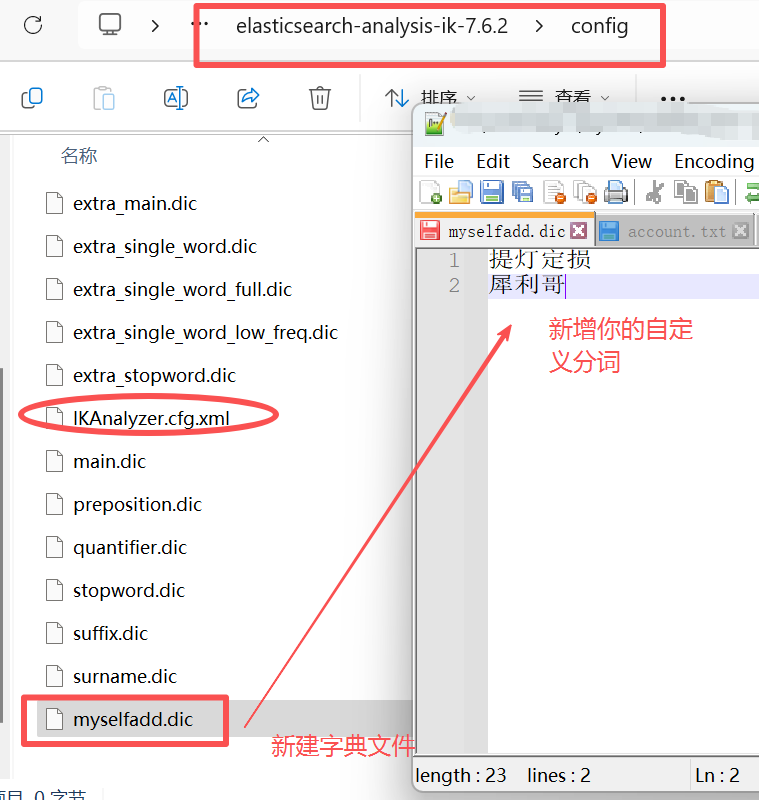 修改后重启 Elasticsearch,自定义词典即可生效。
六、总结与后续学习路径
至此,你已经成功在本地 Windows 环境上搭建起了一个功能相对完整的 Elasticsearch 开发栈,包括核心搜索引擎、可视化管理和中文分词支持。这个环境足以支撑你进行个人项目开发、功能验证和 API 学习。
回顾核心步骤:从组件下载、解压安装、服务启动验证,到 Kibana 的配置连接,再到通过 Dev Tools 进行基础数据操作,最后触及安全认证和分词器定制这两个进阶主题。整个过程体现了现代基础设施软件“开箱即用”与“深度可配置”的特点。
为了将 Elasticsearch 的强大能力融入你的实际项目,下一步可以探索其官方客户端在主流语言中的使用,例如 Java 的 High Level REST Client、Python 的 elasticsearch-py,或者 JavaScript/TypeScript 的 @elastic/elasticsearch 库。同时,深入理解聚合(Aggregation)、全文搜索查询(如 match、term)、索引生命周期管理(ILM)等核心概念,将帮助你解锁更复杂的应用场景 [AFFILIATE_SLOT_2]。记住,实践是最好的老师,尝试用这个本地环境为你的下一个应用添加搜索功能吧!
---
 浙公网安备 33010602011771号