重塑驾驶之眼:多模态大模型如何革新自动驾驶感知系统
自动驾驶技术正从传统的模块化架构,迈向以端到端学习为核心的新范式。在这一变革中,多模态大语言模型凭借其卓越的跨模态理解与推理能力,正在成为重塑自动驾驶感知系统的关键力量。本文将深入探讨其技术原理、核心应用与未来挑战。
从单模态到多模态:技术范式的跃迁
传统的自动驾驶感知系统依赖于精心设计的模块化流水线,分别处理来自摄像头、激光雷达等传感器的数据,完成目标检测、分割等任务。这种模式常面临信息孤岛和长尾场景处理困难的挑战。多模态大模型的出现,为解决这些问题提供了全新路径。它通过统一的深度学习架构,将视觉、语言乃至点云信息深度融合,实现对驾驶场景的“理解”而非仅仅是“识别”。其核心在于利用Transformer架构和注意力机制,建立不同模态数据间的语义关联,从而完成更复杂的推理任务。
早期的多模态学习多采用后期特征融合,但难以捕捉深层关联。随着视觉-语言预训练模型的崛起,如CLIP通过对比学习对齐图像与文本表示,为模型带来了零样本泛化能力。后续的BLIP、LLaVA等模型进一步优化了架构与训练策略。这些进展为AI理解复杂的驾驶环境奠定了理论基础。
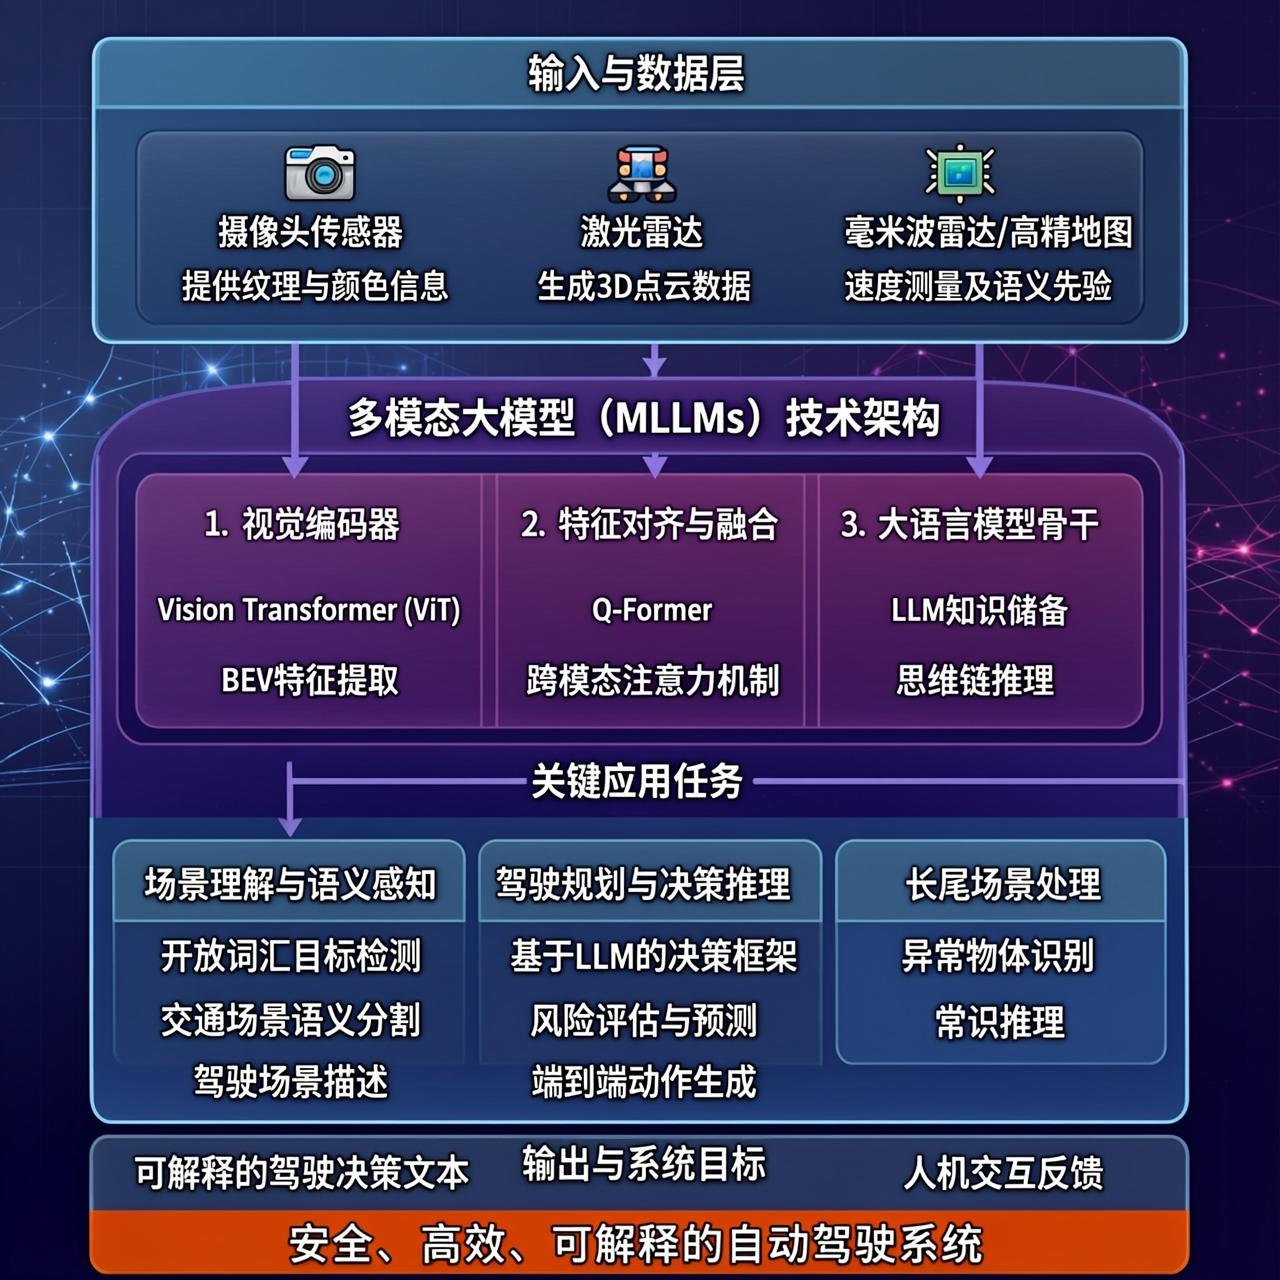
核心架构:感知、语义与决策的统一
将多模态大模型应用于自动驾驶,需要设计满足实时性、安全性的专用架构。其核心思想是构建感知-语义-决策统一框架,打破传统模块间的壁垒。
- 统一表示空间:利用视觉编码器提取特征,并通过适配器映射到大语言模型的语义空间中,实现感知与语义的自然衔接。
- BEV(鸟瞰图)融合:将多传感器(摄像头、激光雷达)数据统一转换到BEV空间进行特征融合与处理,已成为主流范式。
- 语义引导的融合:不同于传统的几何融合,多模态大模型能利用其语义理解能力,智能地加权和选择不同传感器的信息。
其中,视觉与语言特征的精细对齐是关键。Q-Former等架构通过可学习的查询向量,从视觉特征中提取与任务强相关的信息,有效桥接了视觉与语言模态。
[AFFILIATE_SLOT_1]场景理解:从“识别”到“认知”的飞跃
多模态大模型极大地增强了自动驾驶系统的场景理解能力,使其不再局限于预定义的类别。
1. 开放词汇目标检测:传统检测器无法识别未知物体。借助CLIP等模型的对齐能力,系统可以通过自然语言描述(如“路上的大型障碍物”)来定位从未见过的物体,这对处理道路突发情况至关重要。
2. 通用语义分割:像SAM这样的模型,可根据点、框或文本提示分割任意物体。结合CLIP的语义知识,可以实现对驾驶场景中可行驶区域、异常障碍物的零样本或弱监督分割。
3. 驾驶场景描述与理解:模型能生成对当前环境的自然语言描述,包括交通参与者、其相互关系及潜在风险。这大幅提升了系统的可解释性。专用模型如DriveGPT4,在此任务上表现优于通用模型。
| 模型名称 | 发布机构 | 视觉编码器 | 语言模型骨干 | 预训练数据规模 | 核心技术特点 |
|---|---|---|---|---|---|
| CLIP | OpenAI | ViT-L/14 | Transformer | 4亿图像-文本对 | 对比学习范式,零样本迁移能力强 |
| BLIP-2 | Salesforce | ViT-G | FlanT5/OPT | 1.29亿样本 | Q-Former架构,高效桥接视觉与语言 |
| LLaVA | 威斯康星大学 | CLIP ViT | Vicuna | 15.8万指令数据 | 视觉指令微调,对话能力强 |
| GPT-4V | OpenAI | 未公开 | GPT-4 | 未公开 | 最强多模态理解能力,推理能力强 |
| Gemini | 未公开 | 未公开 | 多模态数据 | 原生多模态设计,多任务能力强 | |
| MiniCPM-V | 清华大学 | SigLIP | MiniCPM | 多源数据 | 边缘端部署优化,效率高 |
⚙️ 规划与决策:引入推理能力的驾驶大脑
多模态大模型的真正威力在于将其推理能力注入驾驶决策系统。
- 基于大语言模型的决策框架:将场景编码为语义描述,利用大语言模型的世界知识和常识进行推理,生成驾驶决策并解释原因,融合了规则方法的可解释性与学习方法的泛化能力。
- 思维链推理的应用:模型可以像人类一样进行逐步推理(例如:“前方有行人→需减速;右侧车辆变道→需留意”),这使得决策过程更加透明、可信。
- 端到端驾驶的新路径:通过预训练获得通用知识与推理能力,再针对驾驶任务微调,为构建更简洁、强大的端到端驾驶系统提供了可能。
研究表明,即使未经过专门驾驶数据训练的大语言模型,也能通过提示工程展现出合理的驾驶决策能力,这证明了其强大的知识迁移性。
⚠️ 现实挑战与未来展望
尽管前景广阔,但多模态大模型在自动驾驶中的应用仍面临严峻挑战:
- 实时性瓶颈:模型参数量大,推理速度难以满足高速驾驶的毫秒级响应需求。
- 安全性与可靠性:模型的“幻觉”问题可能产生错误理解,如何确保决策绝对安全是首要难题。
- 数据与算力需求:需要大规模、高质量的多模态驾驶数据进行训练,成本极高。
- 长尾场景与泛化:如何应对极端、罕见的“角案例”场景,仍是巨大考验。
未来,我们可能会看到更高效的模型架构、仿真与真实数据结合的训练范式,以及具身智能与自动驾驶的进一步融合。
| 感知任务 | 传统方法局限性 | 多模态大模型优势 | 代表性方法 | 性能提升 |
|---|---|---|---|---|
| 目标检测 | 固定类别,难以泛化 | 开放词汇检测,零样本迁移 | Grounding DINO, GLIP | 新类别检测准确率提升30%+ |
| 语义分割 | 类别受限,标注成本高 | 文本引导分割,弱监督学习 | SAM, DyFuse | 减少标注需求90%+ |
| 场景分类 | 场景类型有限 | 自然语言描述,灵活定义 | CLIP-based方法 | 零样本准确率达85%+ |
| 深度估计 | 需大量标注数据 | 语言引导几何推理 | VL-Depth | 无监督性能接近监督方法 |
| 车道检测 | 泛化能力弱 | 语义理解增强 | LaneCLIP | 跨数据集泛化提升20%+ |
总结
多模态大模型正在将自动驾驶的感知系统从“特征识别”时代推向“语义理解”时代。它通过统一架构融合多传感器信息,并利用强大的自然语言处理与推理能力,实现了开放场景理解与可解释决策。尽管在实时性、安全性等方面挑战重重,但它无疑代表了自动驾驶感知技术最具潜力的演进方向。随着机器学习与神经网络技术的持续突破,一个更智能、更可靠的自动驾驶未来正加速到来。

 浙公网安备 33010602011771号