生产级向量数据库Milvus深度解析:架构设计、多租户隔离与核心节点流程全攻略
在AI工程化浪潮中,向量数据库已成为构建智能应用的核心基础设施。作为一款开源的、生产级别的向量数据库,Milvus以其卓越的性能和灵活的架构设计,在众多场景中脱颖而出。本文将深入剖析Milvus 2.x版本的核心架构、多租户隔离方案以及关键节点的工作流程,为后端架构师和开发者提供一份全面的部署与优化指南。
一、Milvus 2.x 核心架构全景解析
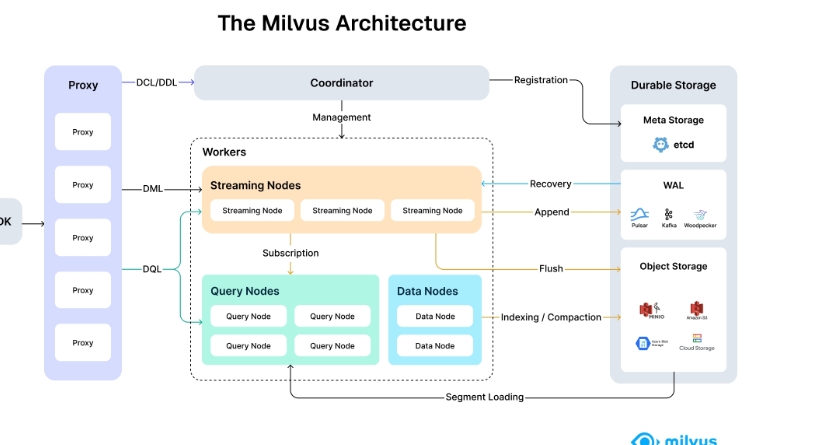
Milvus 2.0采用了云原生、存储计算分离的架构设计,使其具备了极佳的弹性和可扩展性。其核心思想是将系统职责清晰地划分给不同的微服务组件,每个组件都可以独立伸缩,这极大地提升了整个后端架构的健壮性。
整个系统主要分为四大协调器(Coordinator)和三种工作节点(Worker Node)。协调器负责元数据管理、集群调度与任务协调,是系统的“大脑”;而工作节点则负责具体的数据处理任务,是系统的“四肢”。这种设计使得Milvus能够轻松应对从中小规模到超大规模的各种向量检索需求。
下图清晰地展示了Milvus 2.x的官方标准架构,它体现了各组件间的交互关系:
在实际的场内部署中,架构可能会根据具体的网络环境、资源情况和性能要求进行调整。例如,为了更高的可用性,我们可能会部署多个Proxy实例,并通过负载均衡器进行分发。下面的场内架构图展示了一种典型的生产环境部署模式:
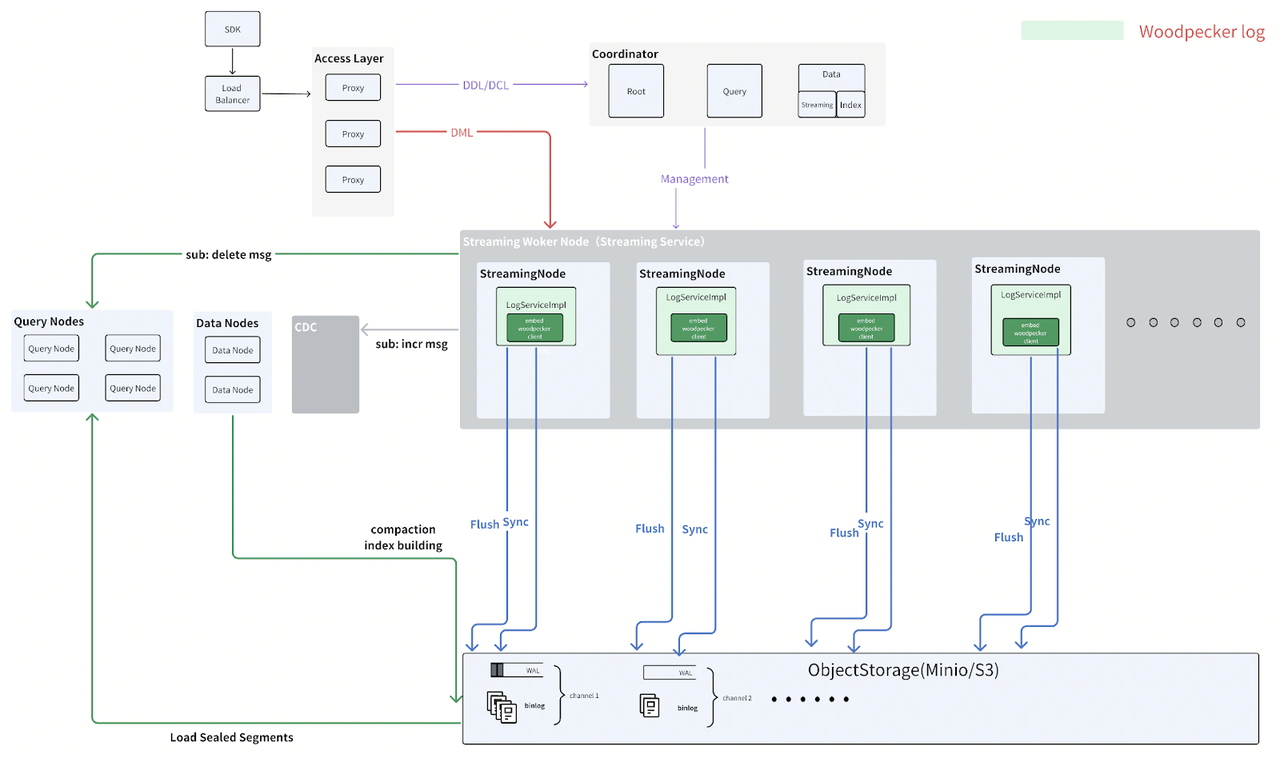
理解这一架构是进行高效运维和性能调优的基础。每个组件都扮演着独特的角色,共同协作以完成从数据写入到高性能检索的完整链路。[AFFILIATE_SLOT_1]
二、多租户隔离方案设计与选型
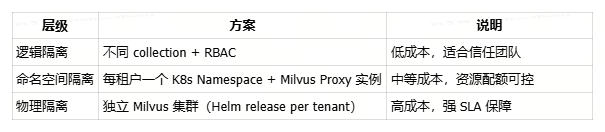
在企业级应用中,多租户隔离是必须考虑的关键特性。Milvus通过在逻辑层面将数据组织成“集合”(Collection)和“分区”(Partition),并在物理层面提供灵活的部署方案,来实现不同级别的租户隔离。
常见的多租户方案主要有两种,其核心区别在于Proxy层的隔离程度:
- 方案一:共享Proxy,逻辑隔离 - 所有租户共享同一个Milvus集群和Proxy服务。隔离完全依赖于Milvus内部的租户、数据库、集合等逻辑概念。这种方式部署简单,资源利用率高,适合租户间信任度较高、QPS压力不大的场景。
- 方案二:独立Proxy,物理+逻辑隔离 - 为不同租户或业务线部署独立的Proxy实例,甚至独立的Milvus集群。这种方式能提供更强的资源隔离性和安全性,避免“吵闹邻居”问题,适合对性能隔离和安全性要求极高的场景。
下图对比了这两种方案的核心差异:
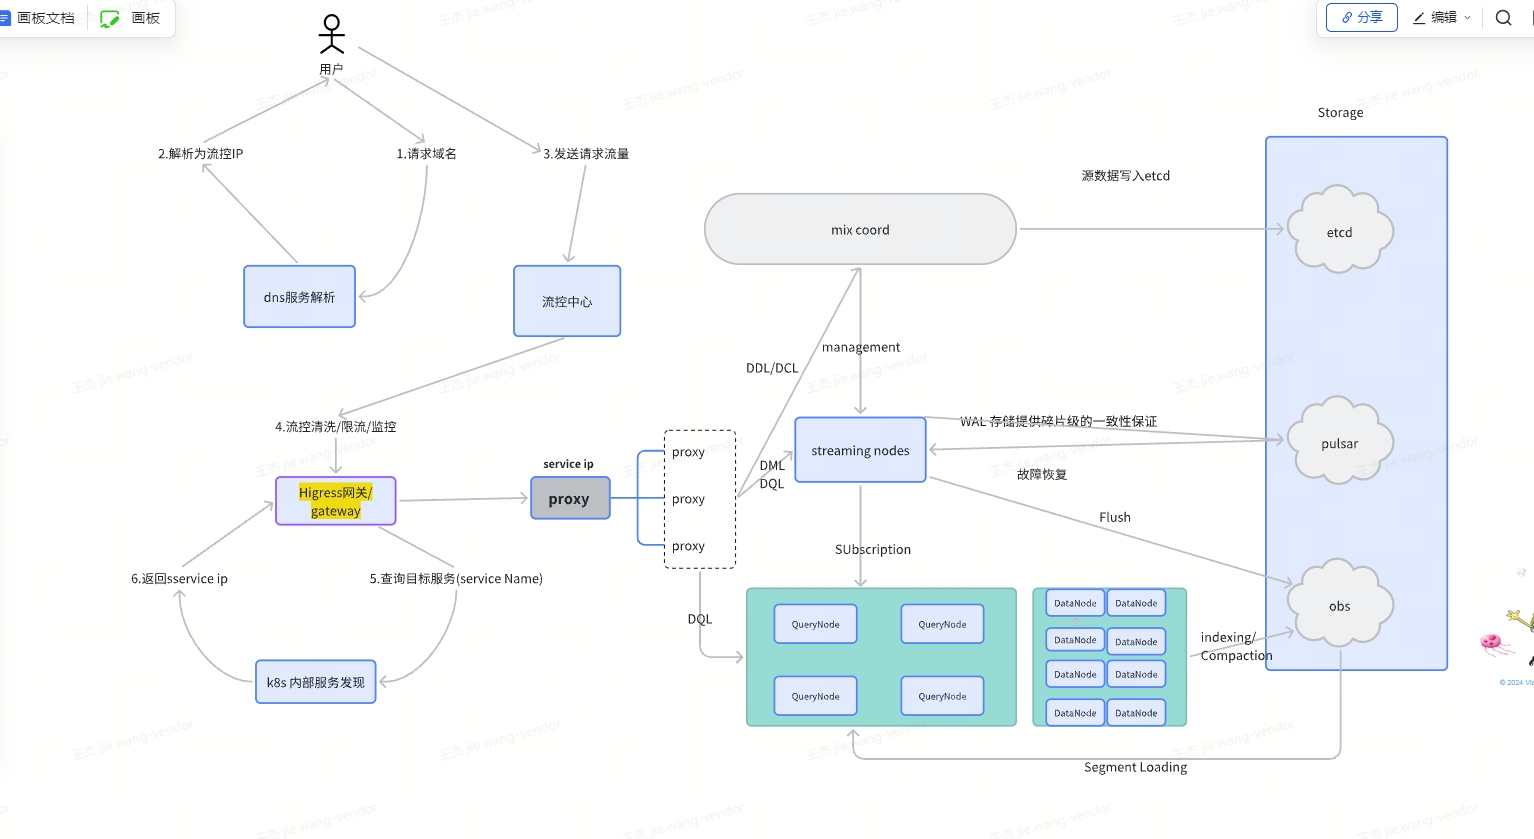
在实际选型中,我们还可以采用混合模式。例如,通过Higress等网关将流量路由到不同的Proxy。普通用户使用共享的Proxy,而对QPS要求高、数据量大的核心业务或VIP客户,则导向其专属的Proxy实例。这种架构既保证了通用性,又满足了高性能场景的定制化需求。
以下是一个配置示例,展示了如何通过不同的连接参数来区分租户:
Kubernetes Cluster
│
├── Namespace: milvus-system          ← 共享核心组件(RootCoord, QueryNode, S3...)
│   ├── pod/rootcoord-0
│   ├── pod/querynode-0~2
│   ├── pod/datanode-0~1
│   └── service/milvus-rootcoord
│
├── Namespace: milvus-team-a          ← 租户 A
│   └── pod/proxy-team-a              ← 专属 Proxy
│       └── 连接到 milvus-system 中的核心服务
│
└── Namespace: milvus-team-b          ← 租户 B
└── pod/proxy-team-b              ← 专属 Proxy
└── 同样连接到 milvus-system 的核心服务
三、核心工作节点流程深度剖析
Milvus的高性能源于其精细化的节点职责划分。理解Streaming Node、Data Node和Query Node的工作流程,是进行故障排查和性能优化的关键。
1. Streaming Node:实时写入的流量入口
Streaming Node是写入路径(Write Path)的核心,专门处理流式数据操作(DML)。它的主要职责包括:
- 接收来自Proxy的插入(Insert)、删除(Delete)等数据变更请求。
- 将数据以流的形式持久化到WAL(预写日志)中,确保数据的持久性和一致性。
- 将数据同步到对象存储(如S3、MinIO),实现存储计算分离。
- 对接Kafka、Pulsar等消息队列,支持实时数据流的无缝接入。
关键点:Streaming Node只负责数据的接收和初步落盘,不参与索引构建和压缩。它将未构建索引的增量数据(Growing Segment)暂存在内存中,为后续的查询提供近实时能力。
2. Data Node:索引构建与压缩的引擎
Data Node是后台的“数据处理工厂”,负责将原始向量转化为可高效检索的结构。其核心工作是索引构建(Indexing)和段合并压缩(Compaction)。
数据通过Flush操作从Streaming Node传递到Data Node。DataCoord(数据协调器)负责调度这些任务,它采用混合工作模式:
- 轮询(Polling):主动检查是否有Segment满足Flush或Compaction条件,保障系统自主运行。
- 事件驱动(Event-Driven):监听DataNode的心跳和任务完成报告,快速响应状态变化。
你可以把DataCoord想象成一个智能调度中心:轮询就像定时巡检生产线库存,事件监听就像接收车间完工报告,从而高效安排全流程。
3. Query Node:检索查询的执行终端
Query Node是读取路径(Query Path)的终点,直接面向用户查询请求(DQL)。它需要加载两部分数据:
- 已索引的静态数据:来自Data Node处理好的、已构建索引的持久化Segment。
- 未索引的增量数据:来自Streaming Node的、尚未完成索引构建的Growing Segment。
这就引出一个关键问题:为什么查询需要同时访问Streaming Node和Query Node?
Client → Proxy (DQL)
↓
Query Node ← Subscription ← Streaming Node
↓
[查询已建索引的数据 + 增量未索引数据]
↓
返回结果
下表清晰地展示了DQL查询的完整路径:
| 组件 | 状态 | 存储/计算方式 | 查询方式 |
|---|---|---|---|
| Data Node | 已索引 | 持久化存储 (Object Storage) | 高效索引算法 (IVF_PQ, HNSW) |
| Query Node (Loaded Segment) | 已索引 | 内存缓存 | 高效索引算法 (IVF_PQ, HNSW) |
| Query Node (Growing Segment) | 未索引 | 内存缓冲区 (Raw Vectors) | 暴力搜索 (Flat Search) |
设计权衡分析:这种设计的优点是实现了近实时查询,数据写入后几乎立即可查,用户体验好。缺点是对Growing Segment的查询效率较低(O(N)复杂度),且占用Query Node内存。因此,系统会严格控制Growing Segment的大小,并尽快触发Flush和Compaction,让Data Node构建高效索引。
四、关键问题:Compaction期间的查询一致性
一个常见的疑问是:当Data Node正在对某个Segment进行Compaction或索引重建时,如果Query Node收到对该Segment的查询请求,系统如何处理?
✅ 核心机制:Milvus保证了查询的连续性和一致性。在Compaction/Index Building期间,Query Node仍然使用旧的、已存在的索引版本来服务查询。只有当新的索引完全构建成功并被加载到Query Node后,系统才会平滑地切换到新索引,旧索引随之释放。这个过程对用户是无感知的。
另一个关键点是索引的加载方式。Query Node将Segment的索引加载到内存中以提供高速检索。内存管理策略直接影响系统的性能和稳定性。下表总结了Query Node加载数据的关键信息:
| 数据类型 | 来源 | 查询方式 | 存储位置 | 加载目标 |
|---|---|---|---|---|
| Growing Segment (未索引) | Streaming Node | 暴力搜索 (Flat Search) | QueryNode 内存 (Raw Vector Array) | 内存 |
| Sealed Segment (已索引) | Object Storage | 索引加速搜索 (IVF_PQ, HNSW…) | 下载到本地 disk -> 加载到内存 | 内存 |
⚠️ 实践建议:在规划生产集群时,需要根据数据总量和索引类型,仔细计算Query Node所需的内存容量,并预留足够的缓冲,避免因内存不足导致节点崩溃或查询失败。[AFFILIATE_SLOT_2]
五、总结与最佳实践
Milvus通过其精巧的微服务化架构,为生产级向量检索提供了强大支撑。总结要点如下:
- 架构选择:根据隔离性需求选择合适的多租户方案,混合模式往往能平衡灵活性与性能。
- 节点理解:深刻理解Streaming、Data、Query三大节点的职责与协作流程,是性能调优的基石。
- 内存规划:Query Node的内存配置至关重要,需结合数据量、索引类型和并发查询量进行精细规划。
- 监控告警:建立对节点状态、资源使用率、查询延迟等关键指标的监控体系,确保系统稳定运行。
掌握Milvus的内部原理,不仅能帮助我们在部署时做出更合理的决策,也能在出现问题时快速定位根因,从而构建出更高效、更稳定的AI应用后端基础设施。
---
 浙公网安备 33010602011771号