
Tips 1
1、请简述async函数的编译方式
async/await是C# 5.0推出的异步代码编程模型,其本质是编译为状态机。只要函数前带上async,就会将函数转换为状态机。
2、请简述Task状态机的实现和工作机制
CPS全称是Continuation Passing Style,在.NET中,它会自动编译为:
1. 将所有引用的局部变量做成闭包,放到一个隐藏的状态机的类中;
2. 将所有的await展开成一个状态号,有几个await就有几个状态号;
3. 每次执行完一个状态,都重复回调状态机的MoveNext方法,同时指定下一个状态号;
4. MoveNext方法还需处理线程和异常等问题。
3、请简述await的作用和原理,并说明和GetResult()有什么区别
从状态机的角度出发,await的本质是调用Task.GetAwaiter()的UnsafeOnCompleted(Action)回调,并指定下一个状态号。
从多线程的角度出发,如果await的Task需要在新的线程上执行,该状态机的MoveNext()方法会立即返回,此时,主线程被释放出来了,然后在UnsafeOnCompleted回调的action指定的线程上下文中继续MoveNext()和下一个状态的代码。
而相比之下,GetResult()就是在当前线程上立即等待Task的完成,在Task完成前,当前线程不会释放。(注意:Task也可能不一定在新的线程上执行,此时用GetResult()或者await就只有会不会创建状态机的区别了。)
4、Task和Thread有区别吗?如果有请简述区别
Task和Thread都能创建用多线程的方式执行代码,但它们有较大的区别。
Task较新,发布于.NET 4.5,能结合新的async/await代码模型写代码,它不止能创建新线程,还能使用线程池(默认)、单线程等方式编程,在UI编程领域,Task还能自动返回UI线程上下文,还提供了许多便利API以管理多个Task,用表格总结如下:
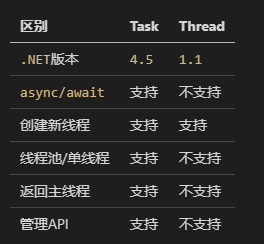
TL;DR就是,用Task就对了。
5、简述yield的作用
yield需配合IEnumerable<T>一起使用,能在一个函数中支持多次(不是多个)返回,其本质和async/await一样,也是状态机。
如果不使用yield,需实现IEnumerable<T>,它只暴露了GetEnumerator<T>,这样确保yield是可重入的,比较符合人的习惯。
注意,其它的语言,如C++/Java/ES6实现的yield,都叫generator(生成器),这相当于.NET中的IEnumerator<T>(而不是IEnumerable<T>)。这种设计导致yield不可重入,只要其迭代过一次,就无法重新迭代了,需要注意。
6、利用IEnumerable实现斐波那契数列生成
IEnumerable<int> GenerateFibonacci(int n)
{
    if (n >= 1) yield return 1;

    int a = 1, b = 0;
    for (int i = 2; i <= n; ++i)
    {
        int t = b;
        b = a;
        a += t;

        yield return a;
    }
}
7、简述stackless coroutine和stackful coroutine的区别,并指出C#的coroutine是哪一种
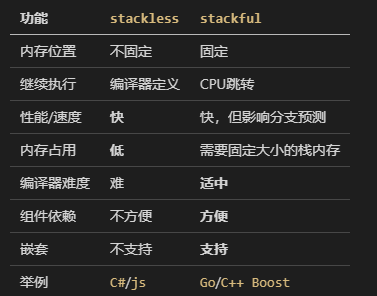
stackless和stackful对应的是协程中栈的内存,stackless表示栈内存位置不固定,而stackful则需要分配一个固定的栈内存。
在继续执行(Continuation/MoveNext())时,stackless需要编译器生成代码,如闭包,来自定义继续执行逻辑;而stackful则直接从原栈的位置继续执行。
性能方面,stackful的中断返回需要依赖控制CPU的跳转位置来实现,属于骚操作,会略微影响CPU的分支预测,从而影响性能(但影响不算大),这方面stackless无影响。
内存方面,stackful需要分配一个固定大小的栈内存(如4kb),而stackless只需创建带一个状态号变量的状态机,stackful占用的内存更大。
骚操作方面,stackful可以轻松实现完全一致的递归/异常处理等,没有任何影响,但stackless需要编译器作者高超的技艺才能实现(如C#的作者),注意最初的C# 5.0在try-catch块中是不能写await的。
和已有组件结合/框架依赖方面,stackless需要定义一个状态机类型,如Task<T>/IEnumerable<T>/IAsyncEnumerable<T>等,而stackful不需要,因此这方面stackless较麻烦。
Go属于stackful,因此每个goroutine需要分配一个固定大小的内存。
C#属于stackless,它会创建一个闭包和状态机,需要编译器生成代码来指定继续执行逻辑。
总结如下:
8、请简述SelectMany的作用
相当于js中数组的flatMap,意思是将序列中的每一条数据,转换为0到多条数据。
SelectMany可以实现过滤/.Where,方法如下:
public static IEnumerable<T> MyWhere<T>(this IEnumerable<T> seq, Func<T, bool> predicate)
{
    return seq.SelectMany(x => predicate(x) ?
        new[] { x } :
        Enumerable.Empty<T>());
}
SelectMany是LINQ中from关键字的组成部分,这一点将在第10题作演示。
9、请实现一个函数Compose用于将多个函数复合
public static Func<T1, T3> Compose<T1, T2, T3>(this Func<T1, T2> f1, Func<T2, T3> f2)
{
    return x => f2(f1(x));
}
然后使用方式:
Func<int, double> log2 = x => Math.Log2(x);
Func<double, string> toString = x => x.ToString();

var log2ToString = log2.Compose(toString);

Console.WriteLine(log2ToString(16)); // 4
10、实现Maybemonad,并利用LINQ实现对Nothing(空值)和Just(有值)的求和
void Main()
{
    Maybe<int> a = Maybe.Just(5);
    Maybe<int> b = Maybe.Nothing<int>();
    Maybe<int> c = Maybe.Just(10);

    (from a0 in a from b0 in b select a0 + b0).Dump(); // Nothing
    (from a0 in a from c0 in c select a0 + c0).Dump(); // Just 15
}
按照我猴子进化来的大脑的理解,应该很自然地能写出如下代码:
public class Maybe<T> : IEnumerable<T>
{
    public bool HasValue { get; set; }
    public T Value { get; set;}

    IEnumerable<T> ToValue()
    {
        if (HasValue) yield return Value;
    }

    public IEnumerator<T> GetEnumerator()
    {
        return ToValue().GetEnumerator();
    }

    IEnumerator IEnumerable.GetEnumerator()
    {
        return ToValue().GetEnumerator();
    }
}

public class Maybe
{
    public static Maybe<T> Just<T>(T value)
    {
        return new Maybe<T> { Value = value, HasValue = true};
    }

    public static Maybe<T> Nothing<T>()
    {
        return new Maybe<T>();
    }
}
这种很自然,通过继承IEnumerable<T>来实现LINQ to Objects的基本功能,但却是错误答案。
正确答案:
public struct Maybe<T>
{
    public readonly bool HasValue;
    public readonly T Value;

    public Maybe(bool hasValue, T value)
    {
        HasValue = hasValue;
        Value = value;
    }

    public Maybe<B> SelectMany<TCollection, B>(Func<T, Maybe<TCollection>> collectionSelector, Func<T, TCollection, B> f)
    {
        if (!HasValue) return Maybe.Nothing<B>();

        Maybe<TCollection> collection = collectionSelector(Value);
        if (!collection.HasValue) return Maybe.Nothing<B>();

        return Maybe.Just(f(Value, collection.Value));
    }

    public override string ToString() => HasValue ? $"Just {Value}" : "Nothing";
}

public class Maybe
{
    public static Maybe<T> Just<T>(T value)
    {
        return new Maybe<T>(true, value);
    }

    public static Maybe<T> Nothing<T>()
    {
        return new Maybe<T>();
    }
}
注意: 首先这是一个函数式编程的应用场景,它应该使用struct——值类型。
其次,不是所有的LINQ都要走IEnumerable<T>,可以用手撸的LINQ表达式——SelectMany来表示。(关于这一点,其实特别重要,我稍后有空会深入聊聊这一点。)
11、简述LINQ的lazy computation机制
Lazy computation是指延迟计算,它可能体现在解析阶段的表达式树和求值阶段的状态机两方面。首先是解析阶段的表达式树,C#编译器在编译时,它会将这些语句以表达式树的形式保存起来,在求值时,C#编译器会将所有的表达式树翻译成求值方法(如在数据库中执行sQL语句)。
其次是求值阶段的状态机, LN to Objects可以使用像EnumemrablecTs接口,它本身不一定保存数据,只有在求值时,它返回一个迭代器—— lEnumerator<T>,它才会根据MoveNext() / value来求值。这两种机制可以确保LINQ是可以延迟计算的。
12、利用SelectMany实现两个数组中元素的两两相加
int[] a1 = { 1, 2, 3, 4, 5 };
int[] a2 = { 5, 4, 3, 2, 1 };
a1
.SelectMany(v => a2, (v1, v2) => $"{v1}+{v2}={v1 + v2}")
.Dump();
解析与说明:⼤多数⼈可能只了解
做⼀转多的场景(两参数重载,类似于
),但它还提供了这个三参数的重载,可以允许
SelectMany
flatMap
你做多对多——笛卡尔集。因此这些代码实际上可以⽤如下
表⽰:
LINQ
from v1 in a1
from v2 in a2
select $"{v1}+{v2}={v1 + v2}"
13、请为三元函数实现柯里化
Func<int, int, int, int> op3 = (a, b, c) => (a - b) * c;
Func<int, Func<int, Func<int, int>>> op11 = a => b => c => (a - b) * c;
op3(4, 2, 3).Dump(); // 6
op11(4)(2)(3).Dump(); // 6
通过实现⼀个泛型⽅法,实现通⽤的三元函数柯⾥化:
Func<T1, Func<T2, Func<T3, TR>>> Currylize3<T1, T2, T3, TR>(Func<T1, T2, T3, TR> op)
{
return a => b => c => op(a, b, c);
}
// 测试代码:
var op12 = Currylize3(op3);
op12(4)(2)(3).Dump(); // (4-2)x3=6
现在了解为啥
签名也能不⽤写参数了吧,因为参数确实太长了
14、请简述ref struct的作用
ref struct是C#7.2发布的新功能,主要是为了配合Span<T>,防止Span<T>被误用。
为什么会被误用呢?因为SpancTs表示一段连续、固定的内存,可供托管代码和非托管代码访问〈不需要额外的 fixed)这些内存可以
从 stacalc中来,也能从 fived 中获取托管的位置,也能通过MashalAllncHGloba()等方式直接分配。这些内存应该是固定的、不能被托管堆移动。但之前的代码并不能很好地确保这一点,因此添加了ref struct来确保。
基于不被托管堆管理这一点,我们可以总结出以下结论:
1.不能对ref struct装箱(因为装箱就变成引用类型了)——包括不能转换为object 、dynamic2.禁止实现任何接口(因为接口是引用类型)
3.禁止在class和struct中使用ref stouct做成员或自动属性(因为禁止随意移动,因此不能放到托管堆中。而引用类型、stuct 成员和自动属性都可能是在托管内存中)
4.禁止在迭代器( yield)中使用ref struct(因为迭代器本质是状态机,状态机是一个引用类型)
5.在Lambda或本地函数中使用(因为Lambda/本地函数都是闭包,而闭包会生成一个引用类型的类)
以前常有一个疑问,我们常常说值类型在栈中,引用类型在堆中,那放在引用类型中的值类型成员,内存在哪?(在堆中,但必须要拷到栈上使用)
加入了ref struct ,就再也没这个问题了。
15、请简述ref return的使用方法
16、请利用foreach和ref为一个数组中的每个元素加1
int[]arr = { 1,2,3,4,5};
Console.WriteLine(string.Join("," , arr)); I/ 1,2,3,4,5
foreach (ref int v in arr.AsSpan())
{
V++;}
Console.WriteLine(string.Join(",", arr)); II 2,3,4,5,6
注意 foreach不能用var,也不能直接用int,需要ref int,注意arr要转换为Span<T>。
17、请简述ref、out和in在用作函数参数修饰符时的区别
ref参数可同时用于输入或输出(变量使用前必须初始化); out参数只用于输出(使用前无需初始化);
in参数只用于输入,它按引用传递,它能确保在使用过程中不被修改(变量使用前必须初始化);
18、请简述非sealed类的IDisposable实现方法
IDisposable 接口需要实现单个无参数的方法 Dispose。 此外,任何非密封类都应具有附加 Dispose(bool) 重载方法。
方法签名为:
public非虚拟的(Visual Basic 中的NotOverridable)(IDisposable.Dispose 实现)。protected virtual(在 Visual Basic 中为Overridable)Dispose(bool)。
Dispose() 方法
由于 public、非虚拟(Visual Basic 中为 NotOverridable)、无参数的 Dispose 方法在不再需要时(由该类型的使用者)调用,因此其用途是释放非托管资源,执行常规清理,以及指示终结器(如果存在)不必运行。 释放与托管对象关联的实际内存始终是垃圾回收器的域。 因此,它具有标准实现:
public void Dispose()
{
    // Dispose of unmanaged resources.
    Dispose(true);
    // Suppress finalization.
    GC.SuppressFinalize(this);
}
Dispose 方法执行所有对象清理,使垃圾回收器不再需要调用对象的 Object.Finalize 重写。 因此,调用 SuppressFinalize 方法会阻止垃圾回收器运行终结器。 如果类型没有终结器,则对 GC.SuppressFinalize 的调用不起作用。 请注意,实际清除由 Dispose(bool) 方法重载执行。
19、delegate和event本质是什么?请简述他们的实现机制
event是特殊的delegate。
如果不基于EventHandler实现的event,跟delegate主要区别是event语法上多了一些限制。
1.event事件只能使用"+=“或”-=“进行订阅和取消订阅操作。不能进行“=”赋值操作。也即是说订阅了一个事件只能在通过”-="进行取消订阅,除此之外无其他方式。
2.event事件触发只能通过事件所在对象内部触发。对象外部无法触发事件。而delegate能从对象外部对委托invoke。
声明了delegate的属性都会继承自Delegate类。
使用单播委托类似C和C++的函数指针,但委托是面向对象和类型安全的(封装成delegate对象)。
使用多播委托类似观察者模式(发布/订阅模式)。实际上源码使用得最多的也是多播模式。但委托的通知实现方法绑定是基于函数签名(duck type)而非接口。相比传统的观察者模式实现更加灵活,有点像guava的Eventbus,而且实现更加优雅。
delegate不仅可以绑定外部方法,内部方法,静态方法。还能绑定匿名委托和lambda函数。可以使用 “=” 赋值委托方法,也可以使用“+=”和“-=”添加和去除委托方法。使用非常灵活方

 浙公网安备 33010602011771号