
MobileNet
MobileNetV1
MobileNetV1提出将原始卷积操作分为两步即深度可分离卷积:特征提取(逐通道卷积)和特征融合(1x1逐点卷积)。大大降低计算量:
假设标准卷积核大小\(D_k, D_k\),输入通道\(M\),输出通道\(N\),每个卷积核进行\(D_W \times D_H\)次计算
参数量为\(D_k \times D_k \times M \times N\)
计算量为\(D_k \times D_k \times M \times N \times D_W \times D_H\)
使用深度可分离卷积进行操作
参数量: 逐通道卷积\(D_k \times D_k \times M\),逐点卷积\(M\times N\)
计算量: 逐通道卷积\(D_k \times D_k \times M \times D_W \times D_H\),逐点卷积\(M\times N \times D_W \times D_H\)
进行对比可以得到:
我们通常所使用的时3x3的卷积核,参数量和计算量会下降到原来的九分之一到八分之一。
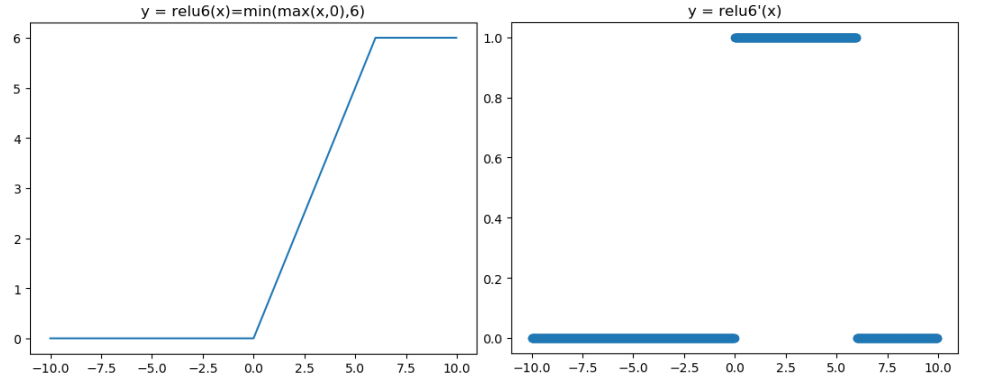
同时用 ReLU6 替换 ReLU,目的是为了保证在移动端低精度的 float16 时也能保有很好的数值分辨率。如果对 ReLU 的输出值不加限制,那么输出范围就是 0 到正无穷,而低精度的 float16 无法精确描述其数值,这将带来精度损失。
ReLU6函数与其导函数如下:
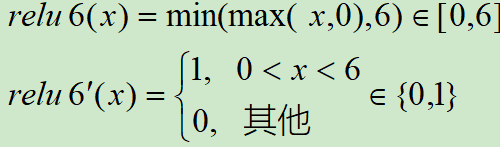
对应的图像分别如下:
MobileNetV2
MobileNet V1 的结构较为简单,另外,主要的问题还是在Depthwise Convolution 之中,Depthwise Convolution 确实降低了计算量,但是Depthwise部分的 Kernel 训练容易废掉,即卷积核大部分为零,作者认为最终再经过 ReLU 出现输出为 0的情况。
V2 传递的思想只有一个,即ReLU 会对 channel 数较低的张量造成较大的信息损耗,简单来说,就是当低维信息映射到高维,经过ReLU后再映射回低维时,若映射到的维度相对较高,则信息变换回去的损失较小;若映射到的维度相对较低,则信息变换回去后损失很大,如下图所示:
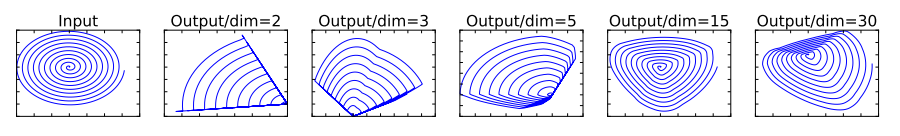
当原始输入维度数增加到 15 以后再加 ReLU,基本不会丢失太多的信息;但如果只把原始输入维度增加到 2~5维度后再加 ReLU,则会出现较为严重的信息丢失。因此,认为对低维度做ReLU运算,很容易造成信息的丢失。而在高维度进行ReLU运算的话,信息的丢失则会很少。另外一种解释是,高维信息变换回低维度信息时,相当于做了一次特征压缩,会损失一部分信息,而再进行过ReLU后,损失的部分就更大了。作者为了这个问题,就将ReLU替换成线性激活函数。
对比
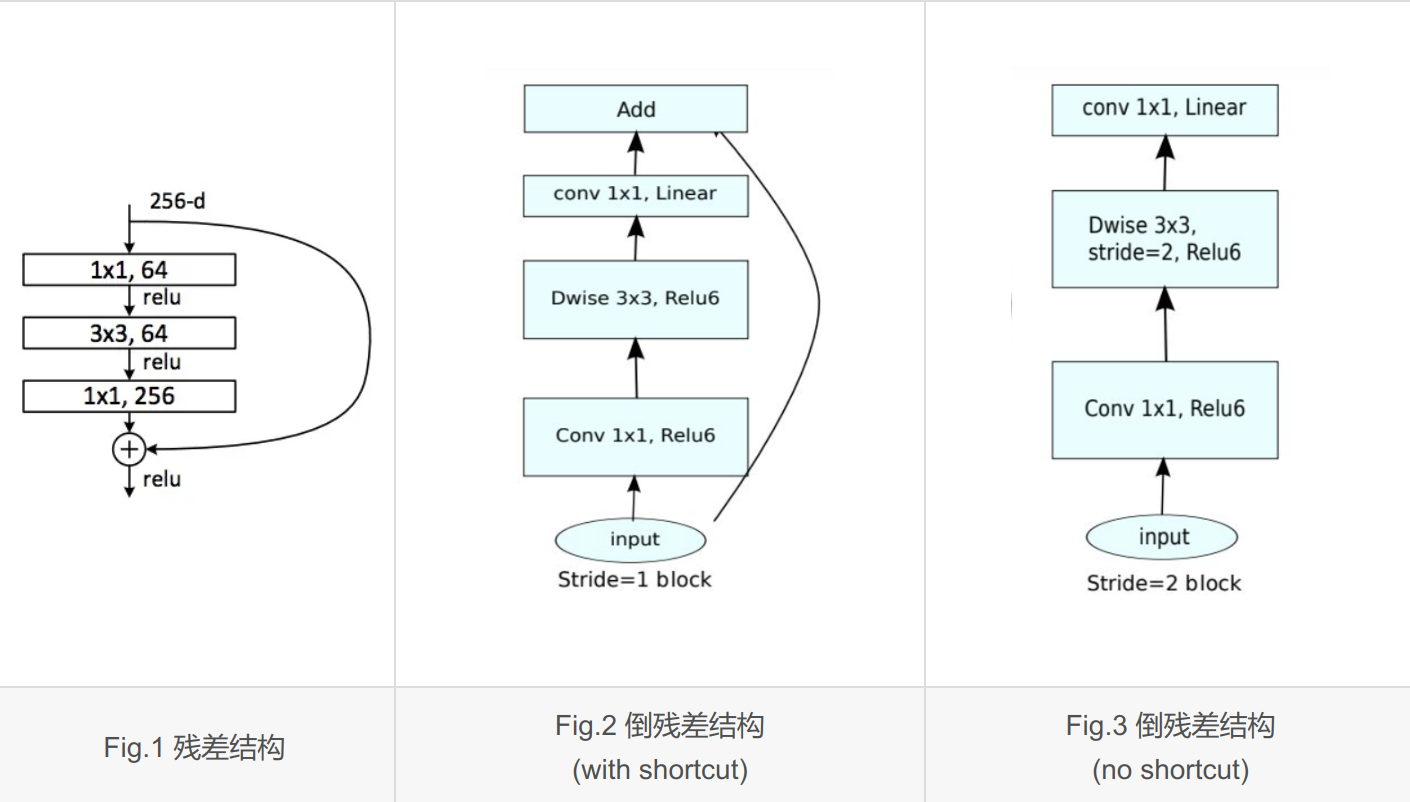
注意,当 stride=2 时,input 和 output 的的尺寸不一致,无法使用 shortcut。但 stride 参数并不直接控制跳跃连接,而是通过影响输出特征图的尺寸间接决定 shortcut 的使用。
Inverted Residuals
通道数变化
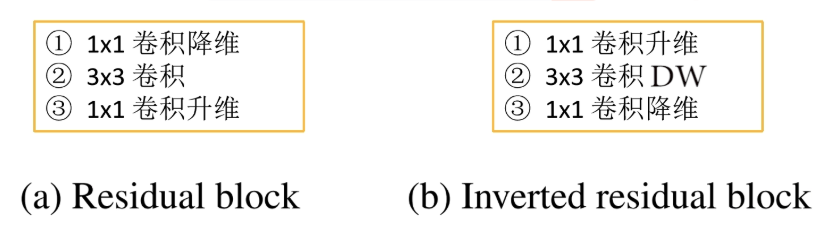
残差结构中,先使用1x1卷积降维,再通过3x3卷积提取特征,最后使用1x1卷积实现升维。可以看成一个两头大、中间小的沙漏结构。
倒残差结构中,先使用1x1卷积升维,再通过3x3DW卷积(dw_wise conv)提取特征,最后使用1x1卷积实现降维。可以看成一个两头小、中间大的梭形结构。
卷积操作变化
在倒残差结构中,用 DW 卷积将标准卷积替换。
激活函数变化
残差结构中统一采用 ReLU 激活函数,而在倒残差结构中,前两个所用的为 ReLU6 激活函数,最后一个卷积使用的是线性激活函数。用 ReLU6 替换 ReLU,目的是为了保证在移动端低精度的 float16 时也能保有很好的数值分辨率。如果对 ReLU 的输出值不加限制,那么输出范围就是 0 到正无穷,而低精度的 float16 无法精确描述其数值,这将带来精度损失。最后一个卷积使用线性激活。
Linear Bottleneck
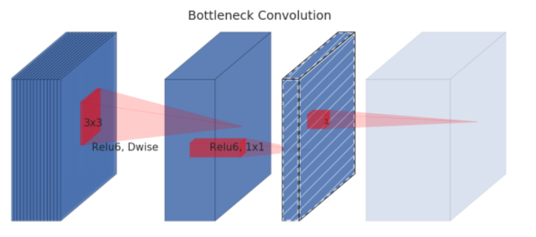
这个模块是为了解决一开始提出的那个低维-高维-低维的问题,即将最后一层的ReLU替换成线性激活函数,而其它层的激活函数依然是ReLU6。这么做的渊源,是因为作者认为激活函数在高维空间能够有效的增加非线性,而在低维空间时则会破坏特征,不如线性的效果好。由于第二个PW(point-wise)的主要功能就是降维,因此按照上面的理论,降维之后就不宜再使用ReLU6了。
倒残差结构代码实现
# _*_coding:utf-8_*_
import torch
import torch.nn as nn


class InvertedResidualsBlock(nn.Module):
    def __init__(self, in_channels, out_channels, expansion, stride):
        super(InvertedResidualsBlock, self).__init__()
        channels = expansion * in_channels
        self.stride = stride

        self.basic_block = nn.Sequential(
            nn.Conv2d(in_channels, channels, kernel_size=1, stride=1, bias=False),
            nn.BatchNorm2d(channels),
            nn.ReLU6(inplace=True),
            nn.Conv2d(channels, channels, kernel_size=3, stride=stride, padding=1, groups=channels, bias=False),
            nn.BatchNorm2d(channels),
            nn.ReLU6(inplace=True),
            nn.Conv2d(channels, out_channels, kernel_size=1, stride=1, bias=False),
            nn.BatchNorm2d(out_channels)
        )
        # The shortcut operation does not affect the number of channels
        self.shortcut = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=1, bias=False),
            nn.BatchNorm2d(out_channels)
        )

    def forward(self, x):
        out = self.basic_block(x)
        if self.stride == 1:
            print("With shortcut!")
            out = out + self.shortcut(x)
        else:
            print("No shortcut!")
        print(out.size())

        return out


if __name__ == "__main__":
    x = torch.randn(16, 3, 32, 32)
    # no shortcut
    net1 = InvertedResidualsBlock(3, 6, 6, 2)
    # with shortcut
    net2 = InvertedResidualsBlock(3, 6, 6, 1)
    y1, y2 = net1(x), net2(x)
MobileNetV3
修改尾部结构
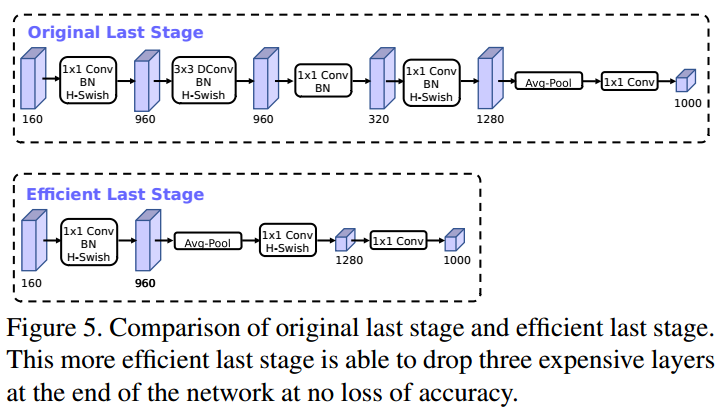
在MobileNetV2中,在Avg Pooling之前,存在一个 1*1 的卷积层,目的是提高特征图的维度,更有利于结构的预测,但是这其实带来了一定的计算量了。所以这里作者做了修改,将其放在 avg Pooling 的后面,首先利于 avg Pooling 将特征图的大小由 7*7 降到了 1*1,降到 1*1 后,然后再利用1*1提高维度,这样就减少了 7*7 =49 倍的计算量。并且为了进一步的降低计算量,作者直接去掉了前面纺锤型卷积的 3*3 以及 1*1 卷积,进一步减少了计算量,就变成了如下图第二行所示的结构,作者将其中的 3*3 以及1*1去掉后,精度并没有得到损失,这里降低了大约 10ms的延迟,提高了15%的运算速度,且几乎没有任何精度损失。其次,对于v2的输入层,通过3*3卷积将输入扩张成32维。作者发现使用ReLU或者switch激活函数,能将通道数缩减到16维,且准确率保持不变。这又能节省3ms的延时。
非线性变换改变
由于嵌入式设备计算sigmoid是会耗费相当大的计算资源的,特别是在移动端,因此作者提出了h-switch作为激活函数。且随着网络的加深,非线性激活函数的成本也会随之减少。所以只有在较深的层使用h-switch才能获得更大的优势。
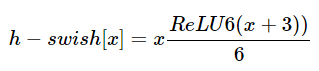
观察上图可以发现,其实相差不大(不过swish是谷歌自家的研究成果,h-swish 是在其基础上,为速度进行了优化)。
引入SE模块
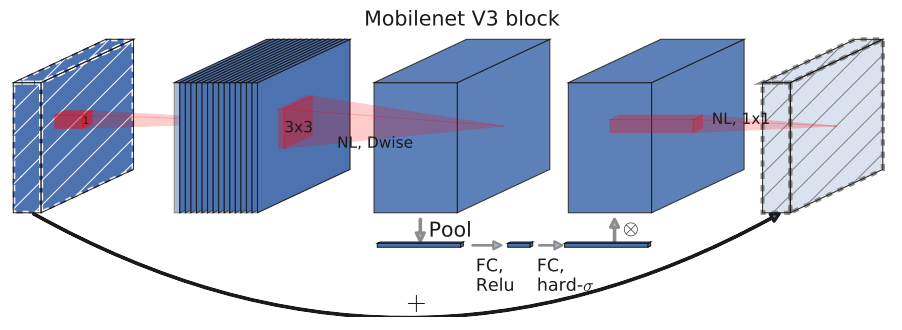
在v2的 bottleneck 结构中引入SE模块,并且放在了 depthwise filter 之后,SE模块是一种轻量级的通道注意力模块,因为SE结构会消耗一定的时间,所以在depthwise之后,经过池化层,然后第一个fc层,通道数缩小4倍,再经过第二个fc层,通道数变换回去(扩大4倍),然后与depthwise进行按位相加,这样作者发现,即提高了精度,同时还没有增加时间消耗。

 浙公网安备 33010602011771号