
 下-Transformer与大模型全景
Transformer 用"注意力机制"替代了 RNN 的循环,从而既能并行计算,又能一眼看到整句话的上下文。这正是它能支撑千亿参数大模型的根本原因。本文先走完 Transformer 的原理,再用一张"概念地图"把大模型相关的核心术语串起来。
一、为什么需要 Transformer
回顾 RNN 的两个顽疾:① 长期依赖难捕捉(信息在循环里衰减);② 必须逐词串行(无法并行,浪费 GPU)。
Transformer(2017 年《Attention Is All You Need》)的思路很彻底:不要循环了,整句话同时喂进去,用纯矩阵运算让每个词直接"看到"所有其他词。这就是注意力机制(Attention)。
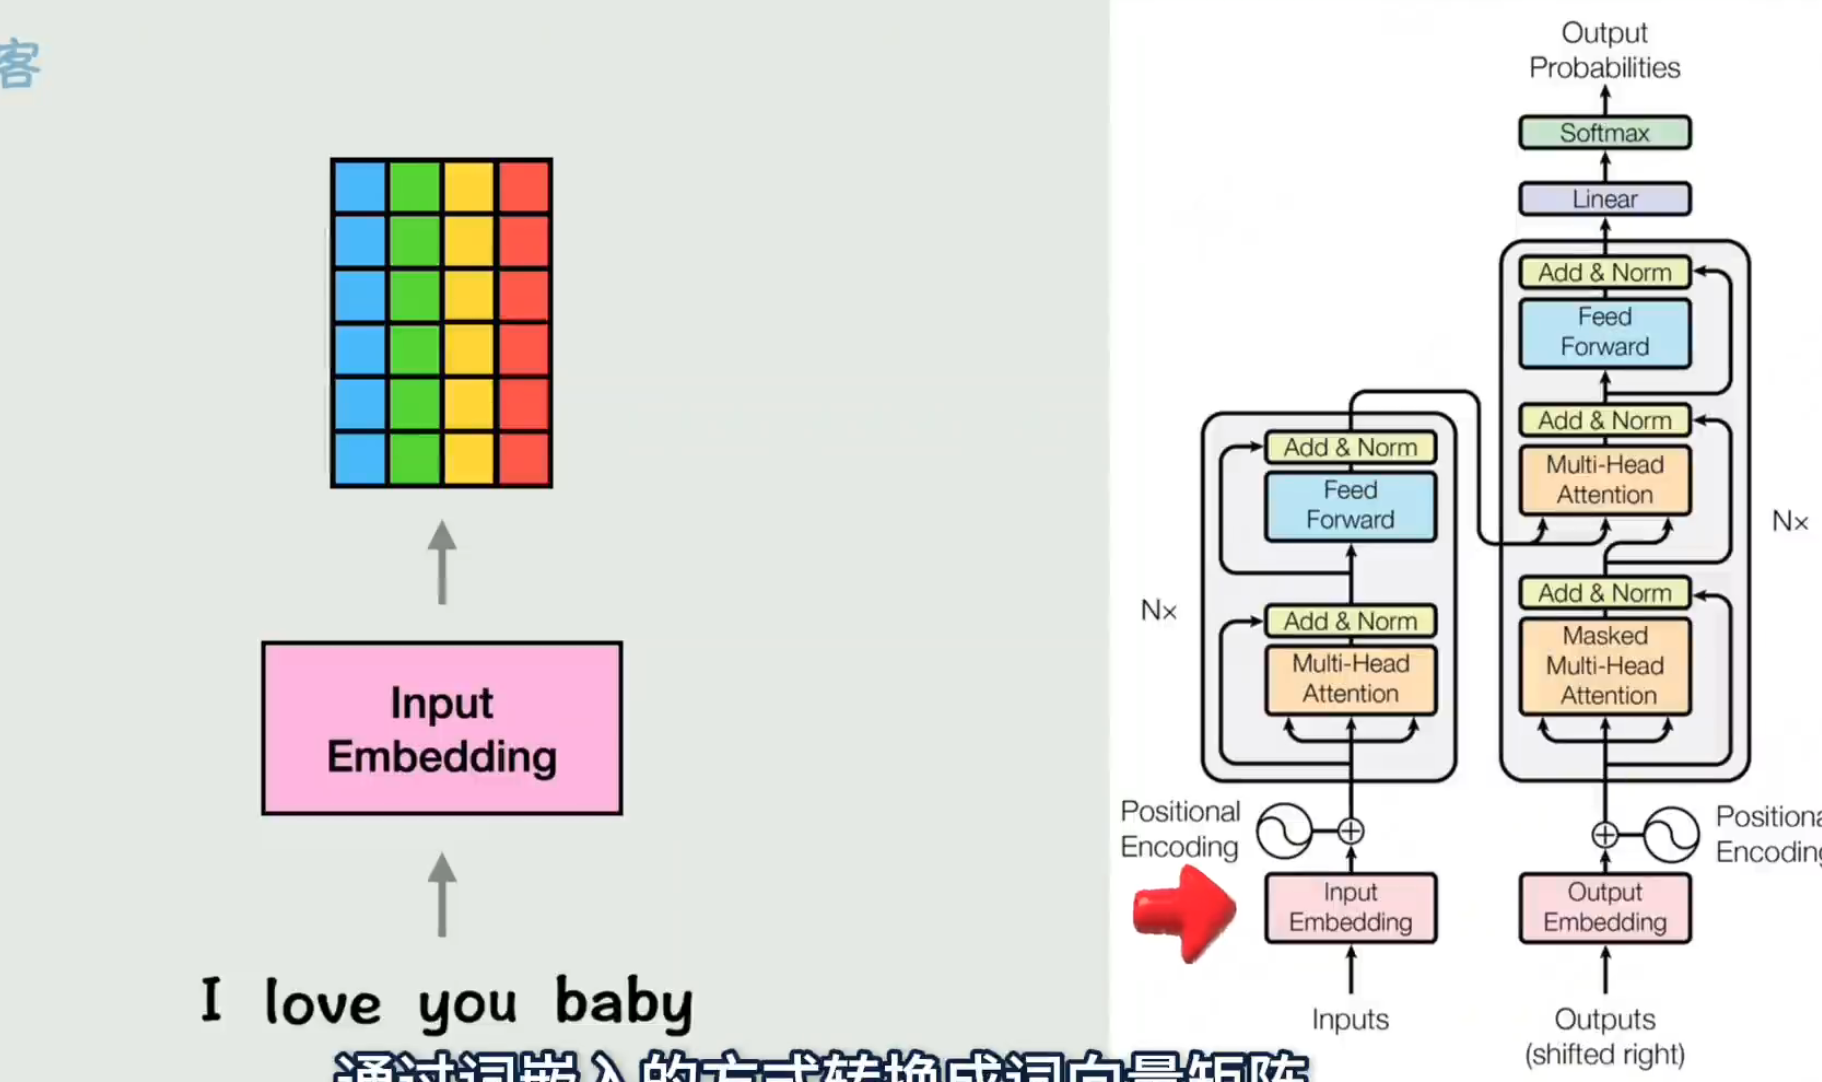
二、输入:词嵌入 + 位置编码
与 RNN 相同,先经词嵌入把词变成向量。但有个新问题:RNN 靠"先后输入"天然知道顺序,而 Transformer 是并行处理的——"I love AI"和"AI love I"的词集合会完全一样,模型分不清前后。
解决办法是位置编码(Positional Encoding, PE):设计一组向量,直接加到词向量上:
x̃ᵢ = xᵢ + PE(i)
论文用 sin/cos 公式生成 PE。其数学性质让绝对位置里蕴含了相对位置信息——模型既能分清"谁在前",又能理解"隔多远"。
三、注意力的核心:Q / K / V 与自注意力
这是 Transformer 最关键的设定。每个词的向量会分别乘以三个权重矩阵 W_Q / W_K / W_V,得到三个向量:
- Query(Q,查询):当前词需要检索的信息。
- Key(K,键):当前词可供匹配的特征。
- Value(V,值):当前词实际携带的内容。
每个词拿着自己的 Q 去和全场每个词的 K 比对"相关度",越相关,就越从对方那里取走 V 的份额。
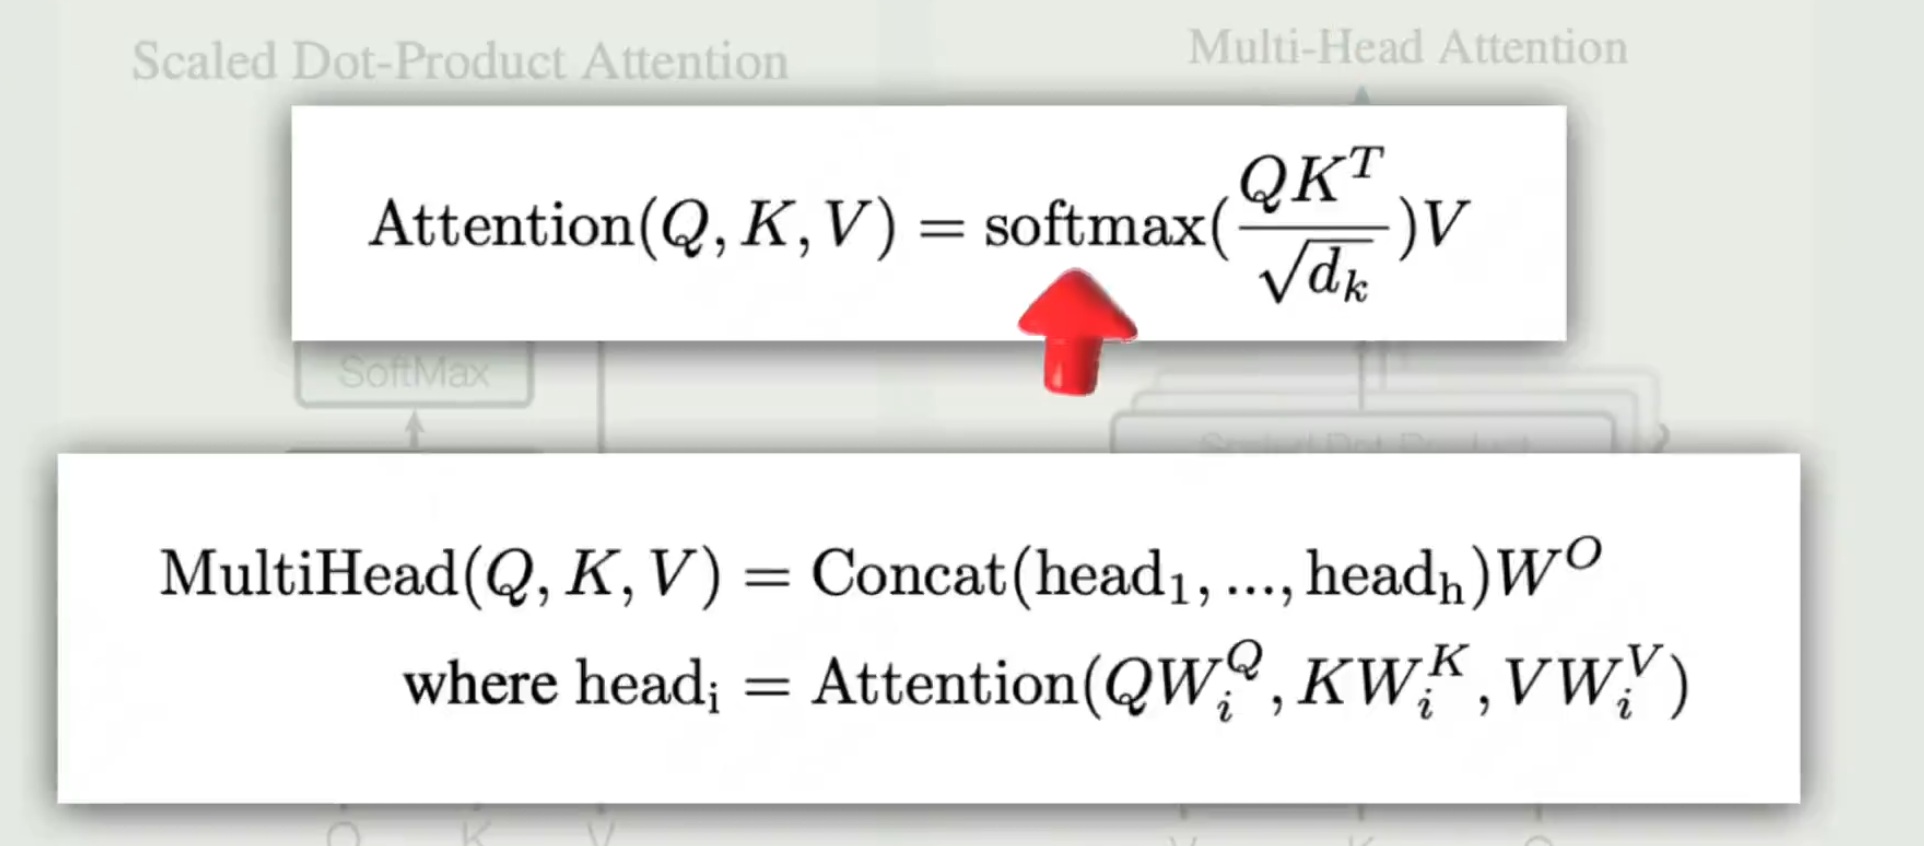
缩放点积注意力(Scaled Dot-Product Attention):
Attention(Q, K, V) = softmax( QKᵀ / √d_k ) · V
逐步拆解:
QKᵀ:算每个词和其他所有词的"相关分数"(内积越大越相关);- 除以
√d_k:把分数缩到合适范围,保持梯度稳定; softmax:把分数变成 0~1 的权重(同一行加和为 1);- 用权重对 V 做加权求和 → 得到新的词向量,它已融合了"自己 + 全场上下文 + 位置"的信息。
一句话:每个词都向整句话"收集"了一遍信息,然后带着全局理解重新表达自己。
四、多头、残差、归一化与前馈网络
单个注意力只能捕捉一种关系,太单薄。多头注意力(Multi-Head Attention) 用多组 W_Q/W_K/W_V 并行算多套注意力,各自关注不同角度(例如一个头看主语、一个头看时态),最后把结果拼接。这样模型对句子的理解更立体、全面。
一个 Transformer 子层的标准套路是 Add & Norm + FFN:
-
残差连接(Add):把子层输入直接加到输出上
输出 = F(x) + x。作用极大——保证梯度能一路回流,深层网络才不会梯度消失,模型才"堆得深"。 -
层归一化(Layer Norm):对同一句话的不同特征做归一化(区别于 BatchNorm 的"跨样本"),训练更稳,更适合 NLP。
-
前馈网络(FFN):两层线性变换 + ReLU,给模型再补一层非线性拟合能力:
FFN(x) = max(0, xW₁ + b₁) W₂ + b₂
五、编码器–解码器:原论文的骨架
论文里的完整结构是 Encoder-Decoder 各堆叠 6 层(层数 N 可自定义):
- Encoder(编码器):自注意力 + FFN,把输入句子压缩成富含上下文的表示。
- Decoder(解码器):
- Masked 掩码 自注意力:预测第 t 个词时,故意看不到 t 之后的词(保持训练和生成时行为一致,自回归);
- 编码–解码注意力:Q 来自解码器,K/V 来自编码器输出,让生成时"回头看"输入;
- FFN。
- 最后经 Linear + Softmax 输出下一个词的概率分布。
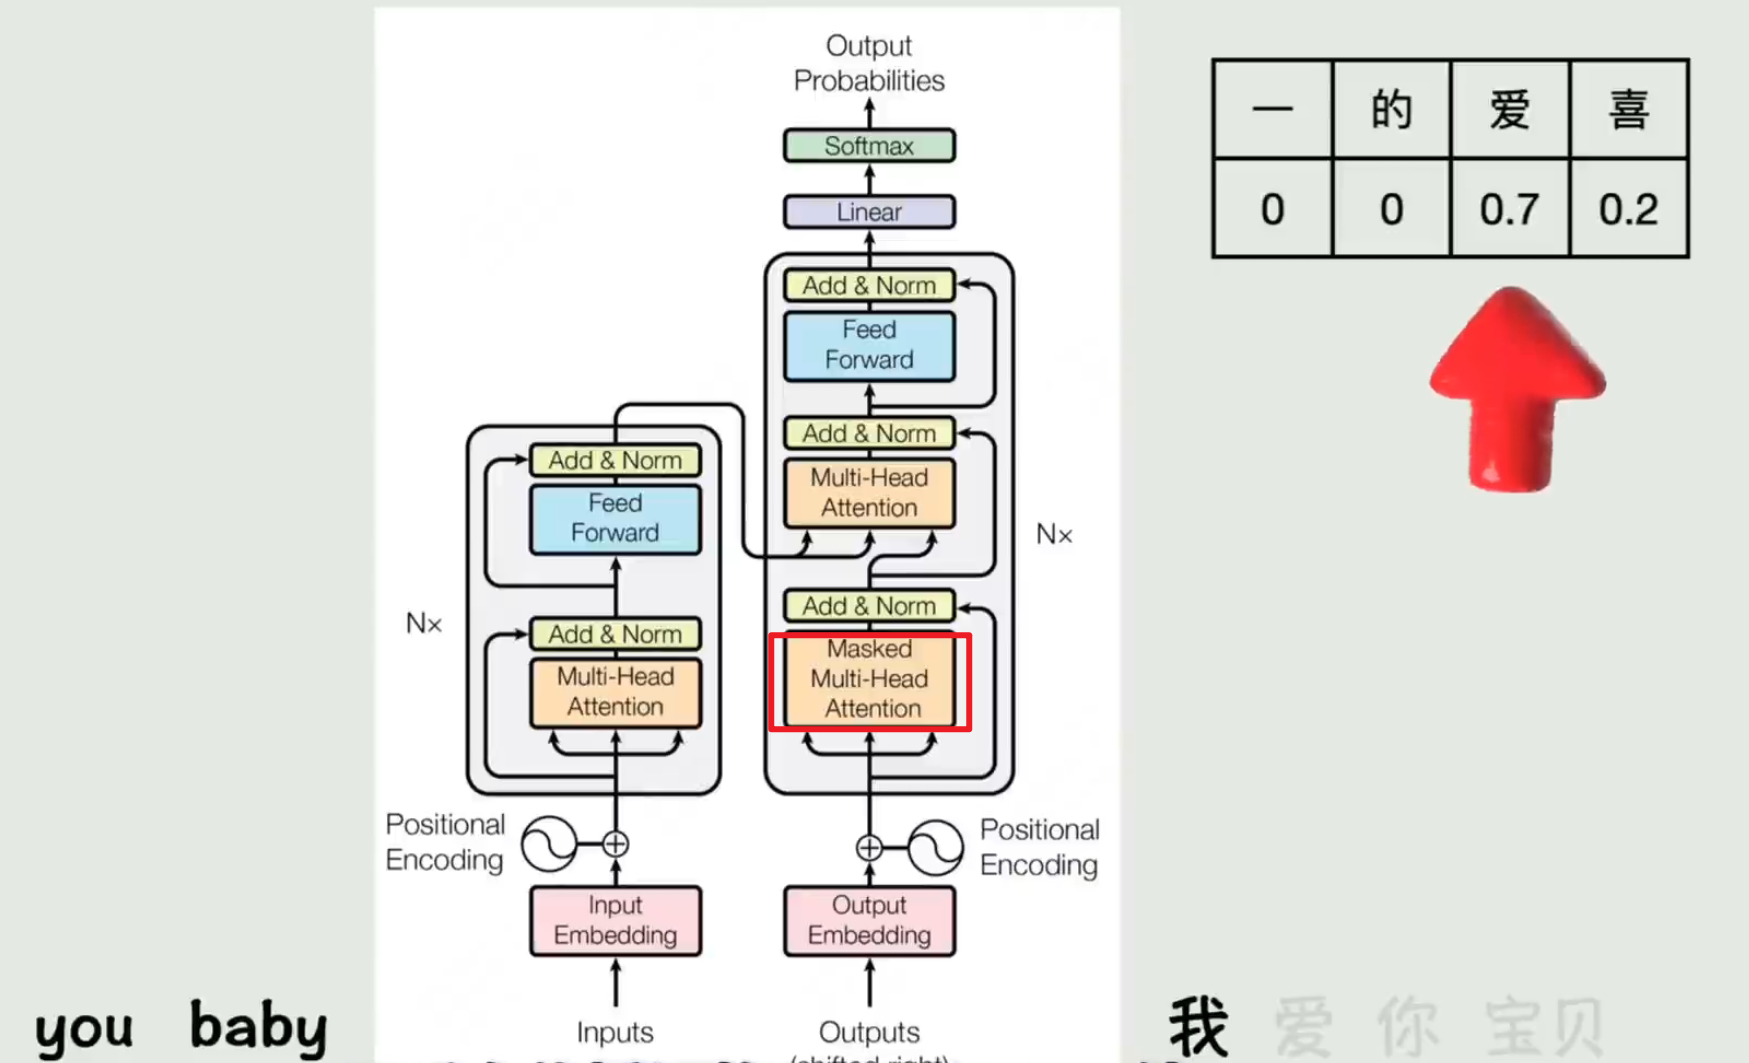
注意力在三个地方出现:编码器自注意力、解码器(掩码)自注意力、编码–解码注意力。
Transformer 之所以重要:① 并行 + 可扩展,不再受串行限制,能在海量数据上训练超大模型 → 直接催生 BERT、GPT;② 通用性,语言是序列,DNA(碱基)、蛋白质(氨基酸)、图像/音频也都能转成序列 → Transformer 跨界到生物、多模态(如 DALL·E 文生图)。其设计哲学可概括为:把复杂问题拆成简单模块,让每个模块专注做好一件事。
六、大模型全景:一张概念地图
原理走完之后,用一张"地图"把大模型相关的核心概念串起来,方便回看。
地基概念(前文已述):函数/线性变换 y=wx+b、激活函数、神经网络/前向/反向传播、损失/梯度下降/学习率、过拟合/正则化/Dropout、CNN/卷积核/池化、词嵌入/嵌入矩阵、RNN/隐藏状态,以及本篇详述的 Transformer/注意力/QKV/多头/位置编码/残差/LayerNorm/FFN/Encoder-Decoder。
大模型专属名词(按主题分块,越靠前越基础):
1. 基础与表示
- LLM(Large Language Model,大语言模型):以 Transformer 为底座、在海量文本上训练出的语言模型,代表有 GPT、Claude、Gemini、文心、通义、DeepSeek 等。其核心能力是"接龙式"预测下一个 token,并由此完成问答、写作、翻译、编程等任务。
- 基座模型 / Foundation Model(基础模型):在大规模无标注数据上预训练出的通用模型,是后续微调、对齐的"起点"。ChatGPT 背后的 GPT-3.5/4,就是从基座模型经对齐得到的。
- Token(词元):模型处理文本的最小单位,不严格等于"字"或"词"。英文常把一个单词拆成若干子词(如 "playing" → "play"+"ing"),中文常按字或词切分。同一句话在不同 tokenizer 下 token 数不同;计费与上下文窗口都以 token 计。
- Tokenizer(分词器):把原始文本切成 token 序列的工具,常见算法有 BPE、WordPiece、SentencePiece。分词方式决定了"同样一段话要花多少 token",直接影响成本与效率。
- 词表(Vocabulary):模型认识的"全部 token 集合",规模常见数万到二十余万。生成时模型从词表挑一个 token,循环往复,直到输出结束符。
- Embedding(嵌入):把 token 映射成低维稠密向量的过程(与前述"词嵌入"一脉相承)。模型内部一切运算都建立在向量之上,语义相近者自然靠近。
- 上下文窗口 / Context Window:模型单次能"一眼看到"的最大 token 数。超出窗口的历史会被截断或压缩。窗口越长,能处理的文档、对话越完整,但计算量与成本也越高(自注意力开销大致随长度平方增长)。
- 多模态 / Multi-modal:模型同时处理文本、图像、音频、视频等多种信号。例如 GPT-4V 看图说话、DALL·E / Stable Diffusion 文生图、Whisper 语音转写。本质是先把不同模态都"编码成向量",再喂给同一套 Transformer。
2. 训练范式
- 预训练 / Pre-training:在海量无标注文本上做"下一 token 预测",让模型通读语料、学到通用语言规律与世界知识。这是最贵的一步,往往需数千张 GPU 训练数月。
- 自监督学习 / Self-supervised:预训练不需要人工标注——文本自身就能提供"答案"(下一个词)。用数据自身的结构造出监督信号,故称"自监督"。
- 微调 / Fine-tuning:在预训练模型上,用特定领域或任务的数据继续训练,使其"定向适配",好比通才再进修专科。
- 指令微调 / Instruction Tuning(常称 SFT,监督微调):用"指令—回答"配对数据训练,让模型学会"听懂人话、按格式作答",是模型从"接龙机器"变为"助手"的关键一步。
- 迁移学习 / Transfer Learning:把在大数据上习得的通用能力,迁移到小数据的新任务。微调即迁移学习的一种典型应用。
- 上下文学习 / In-context Learning:模型不更新参数,仅靠你在提示里给的几个示例(few-shot)或零示例(zero-shot)就能完成新任务。这是大模型特有的"现学现卖"能力。
- 参数高效微调 / PEFT(如 LoRA、QLoRA):不改动原模型全部参数,只训练一小撮"适配器"参数,即可获得接近全量微调的效果,显存与成本大幅下降。LoRA 把权重更新拆成低秩矩阵;QLoRA 再叠加量化,让大模型能在消费级显卡上微调。
- RLHF(基于人类反馈的强化学习):收集人对模型回答的偏好(哪个更好),训练一个"奖励模型",再用强化学习让模型去最大化奖励,从而对齐人类价值观——说人话、不胡来、更安全。
- RLAIF / DPO / Constitutional AI:RLHF 的替代或简化路线。DPO 直接用偏好数据优化策略、免去单独训练奖励模型;Constitutional AI 用一套"宪法"原则让模型自我批评,以减少人工标注。目标都是更可控、更便宜地实现对齐。
- 对齐 / Alignment:让模型行为符合人类意图与伦理的持续性目标,而非一次性步骤;前述 SFT、RLHF、DPO 都是对齐的手段。
3. 推理与生成控制
- 推理 / Inference:训练完成后,用模型生成回答的过程(区别于"训练")。日常和 ChatGPT 对话,每一次回复都是一次推理。
- 采样参数 Temperature(温度):控制输出的"随机度"。低温(接近 0)更确定、保守、偏好高频词;高温更发散、有创意但易失实。写代码常调低,写诗常调高。
- Top-k / Top-p(核采样,Nucleus):限制每一步只从"概率最高的 k 个"或"累计概率达 p 的候选"里挑词,避免选中概率极低的怪词,兼顾质量与多样性。
- 贪心 / Beam Search:确定性解码策略(每步取概率最大 / 保留若干最优序列),常用于翻译、摘要等对"准确"要求高于"创意"的场景。
- 思维链 / Chain-of-Thought(CoT):让模型"先一步步推理、再给答案",而非直接蹦结果。例如提示"让我们一步步思考……"能显著提升数学、逻辑题表现,是大模型"会思考"的重要体现。
- KV Cache(键值缓存):推理时为避免重复计算已生成 token 的 K、V 而将其缓存复用。它极大加速自回归生成,但会随上下文变长而占用显存。
- 流式生成 / Streaming:模型边算边把 token 吐出(像打字机),而非算完整段才显示,显著提升交互体验。
4. 能力现象与评测
- 涌现能力 / Emergent Abilities:当模型规模(参数、数据、算力)跨过某阈值,会"突然"表现出小模型没有的能力(如复杂推理、代码生成)。这种"量变引起质变"是大模型最迷人的特性之一。
- 规模定律 / Scaling Law:经验规律显示,模型性能随参数、数据、算力增长而可预测地提升(通常呈幂律)。它指导着"堆多少资源换多少性能"的投入决策。
- 幻觉 / Hallucination:模型看似自信地编造不存在的事实、引用、URL 或数据。根源在于它本质是"概率接龙",并不真正"知道"外部世界的真假。RAG、引用标注、人工核验是主要缓解手段。
- 灾难性遗忘 / Catastrophic Forgetting:模型学新任务时把旧知识忘掉的现象。微调与持续学习时需用回放、正则等办法平衡。
- 基准测试 / Benchmark(如 MMLU、GSM8K、HumanEval):用标准化题库评测模型在知识、推理、代码等维度的水平。便于横向比较,但也可能被"刷榜",未必完全反映真实体验。
- 困惑度 / Perplexity:衡量语言模型"预测准确性"的指标,越低表示模型对文本越"不意外"、越懂。多用于预训练阶段监控,而非最终体验评价。
5. 应用形态
- Prompt / 提示词:你给模型的指令与上下文。Prompt Engineering(提示工程)研究"怎么问模型才答得好",包括角色设定、示例、格式约束等。
- 系统提示 / System Prompt:对话开始时设定模型"身份与规矩"的隐藏指令(如"你是乐于助人的助手")。用户通常不直接看到,却深刻影响回答风格。
- RAG(检索增强生成 / Retrieval-Augmented Generation):回答前先去外部知识库(文档、网页、数据库)检索相关资料,再把资料拼进提示一起生成。它能缓解幻觉、注入私有/最新知识,是企业落地的主流方案。
- Function Calling / 工具调用(Tool Use):模型输出"我要调用某函数、参数是……"的结构化指令,由外部程序执行(查天气、算数、发邮件),再把结果喂回模型。它让模型突破"纯文本"边界,连接真实世界。
- Agent(智能体):能自主规划、调用工具、多步迭代完成目标的模型应用。它不止"答一句",而是像助手一样"想—做—看结果—再想",典型如自动订票、写代码跑测试、研究调研。
- 多轮对话 / 记忆:模型在一段会话里记住前文(受上下文窗口限制),实现连贯交互;超出窗口则需摘要或外挂记忆。
6. 压缩与部署
- 蒸馏 / Distillation:用大模型(教师)的输出去训练小模型(学生),把"大模型的本领"压缩进小体积,推理更快更便宜,常用于端侧(手机、浏览器)。
- 量化 / Quantization:用更低精度(如 INT8、INT4,甚至 INT2)表示权重,替代默认的 FP16/FP32。显存与带宽大幅下降、速度提升,精度损失通常可控。QLoRA 即"量化 + LoRA"的组合。
- 剪枝 / Pruning:删掉模型中"贡献小"的连接或通道,减小体积、加速推理。
- MoE(混合专家 / Miety of Experts):模型内含多个"专家"子网络,每个 token 只激活其中少数几个。这样总参数量很大、单次计算量却不大,是用"参数量换能力、用稀疏激活控成本"的主流大模型架构(如 Mixtral、GLM-4、DeepSeek)。
- 推理加速 / 推理框架(如 vLLM、TensorRT-LLM):通过连续批处理、PagedAttention、算子融合等手段,把"每秒生成 token 数"和并发拉满,降低单位成本。
- Token 计费 / 推理成本:商用 API 按输入输出 token 数收费;本地部署则主要花电费与硬件折旧。上下文越长、模型越大,单次成本越高。
一张极简关系图:
原始文本 → Tokenizer → Embedding(+位置编码)
        → [Transformer 层 × N:自注意力 + FFN + 残差/LayerNorm]
        → 输出向量 → Linear + Softmax → 预测下一个 Token
                                  ↑
                    预训练(通读) → 微调(定向) → RLHF(对齐人类)
小结
- Transformer 用注意力替代 RNN 循环:位置编码注入顺序(
x̃ = x + PE),自注意力softmax(QKᵀ/√d_k)·V让每个词融合全局上下文,多头捕捉多维关系,残差 + LayerNorm + FFN 构成稳定可深的子层,Encoder-Decoder 自回归生成催生 BERT/GPT 与多模态。 - 大模型 = Transformer 底座 + 预训练/微调/RLHF 训练范式 + Token/Embedding 接口;常见痛点(幻觉)与解法(RAG、蒸馏、量化)都有对应术语。
- 整季回顾:函数 → 神经网络 → 训练 → CNN → 词嵌入/RNN → Transformer → 大模型全景。从
y=wx+b一路搭到了今天的大模型。
参考:B 站 BV1NCgVzoEG9《【闪客】一小时从函数到 Transformer》。本文根据该系列第 6–7 节内容整理,配图来自原视频笔记。

 浙公网安备 33010602011771号