
 上-从函数到训练神经网络
神经网络本质上是一系列函数的嵌套组合。再复杂的模型,也建立在最朴素的线性变换 y = wx + b 之上。本文梳理人工智能入门最基础的三部分内容:神经网络的结构、参数如何通过学习得到,以及训练过程中需要应对的典型问题。
一、神经网络是什么:从函数说起
理解神经网络,通常从两条研究路线入手:
- 符号主义:认为世界万物都能用精确公式描述。例如输入直角两边长,用勾股定理得到斜边长;输入质量和加速度,用牛顿第二定律得到力。这一类方法依赖人为找到正确的公式。
- 联结主义:认为许多问题无法写出精确公式,例如"识别一张猫的图片""听懂一段语音",只能通过学习给出一个"足够接近"的答案。神经网络属于这一派。
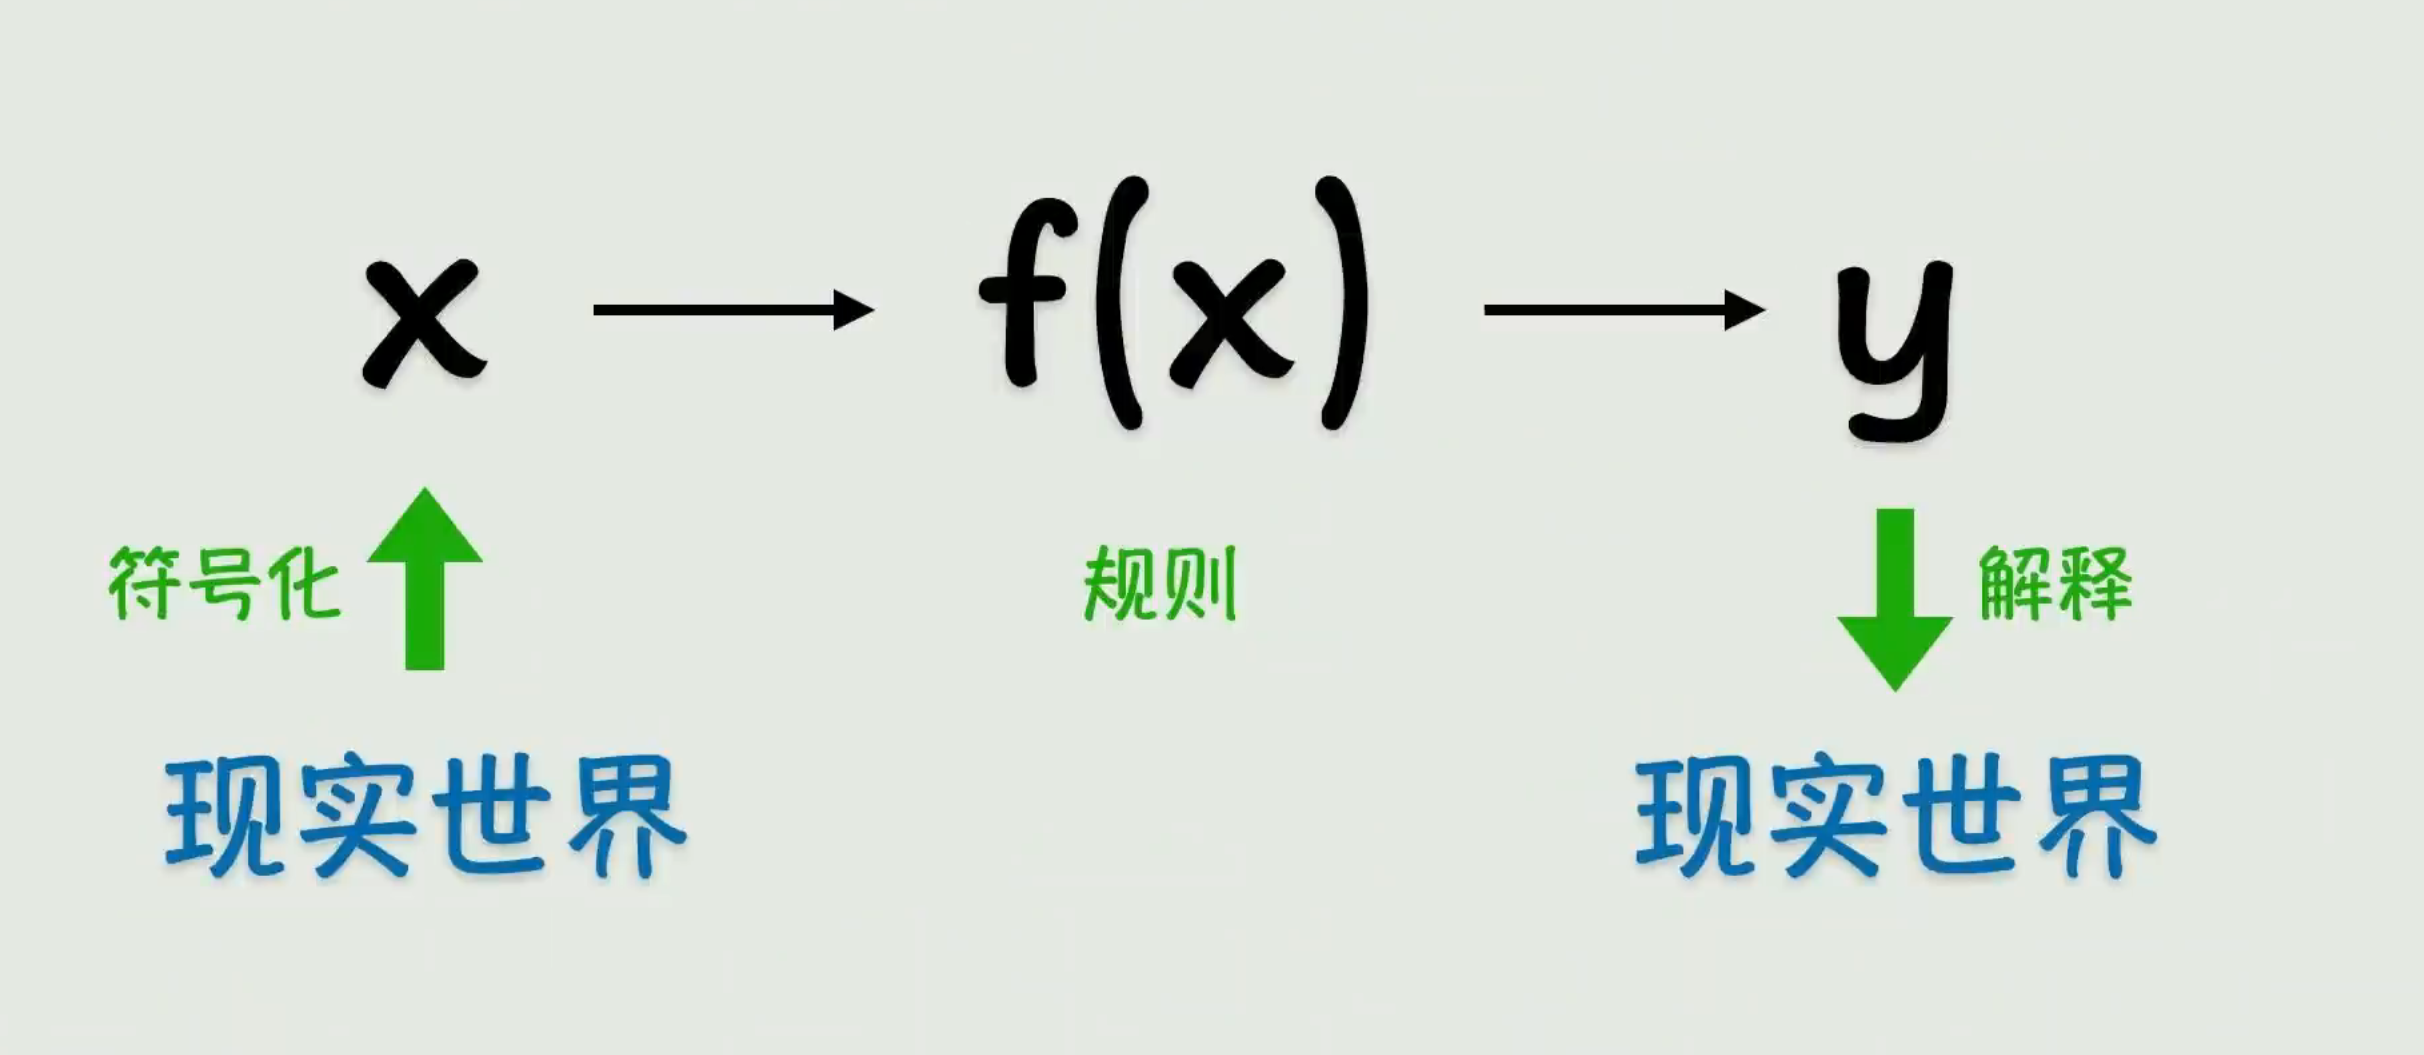
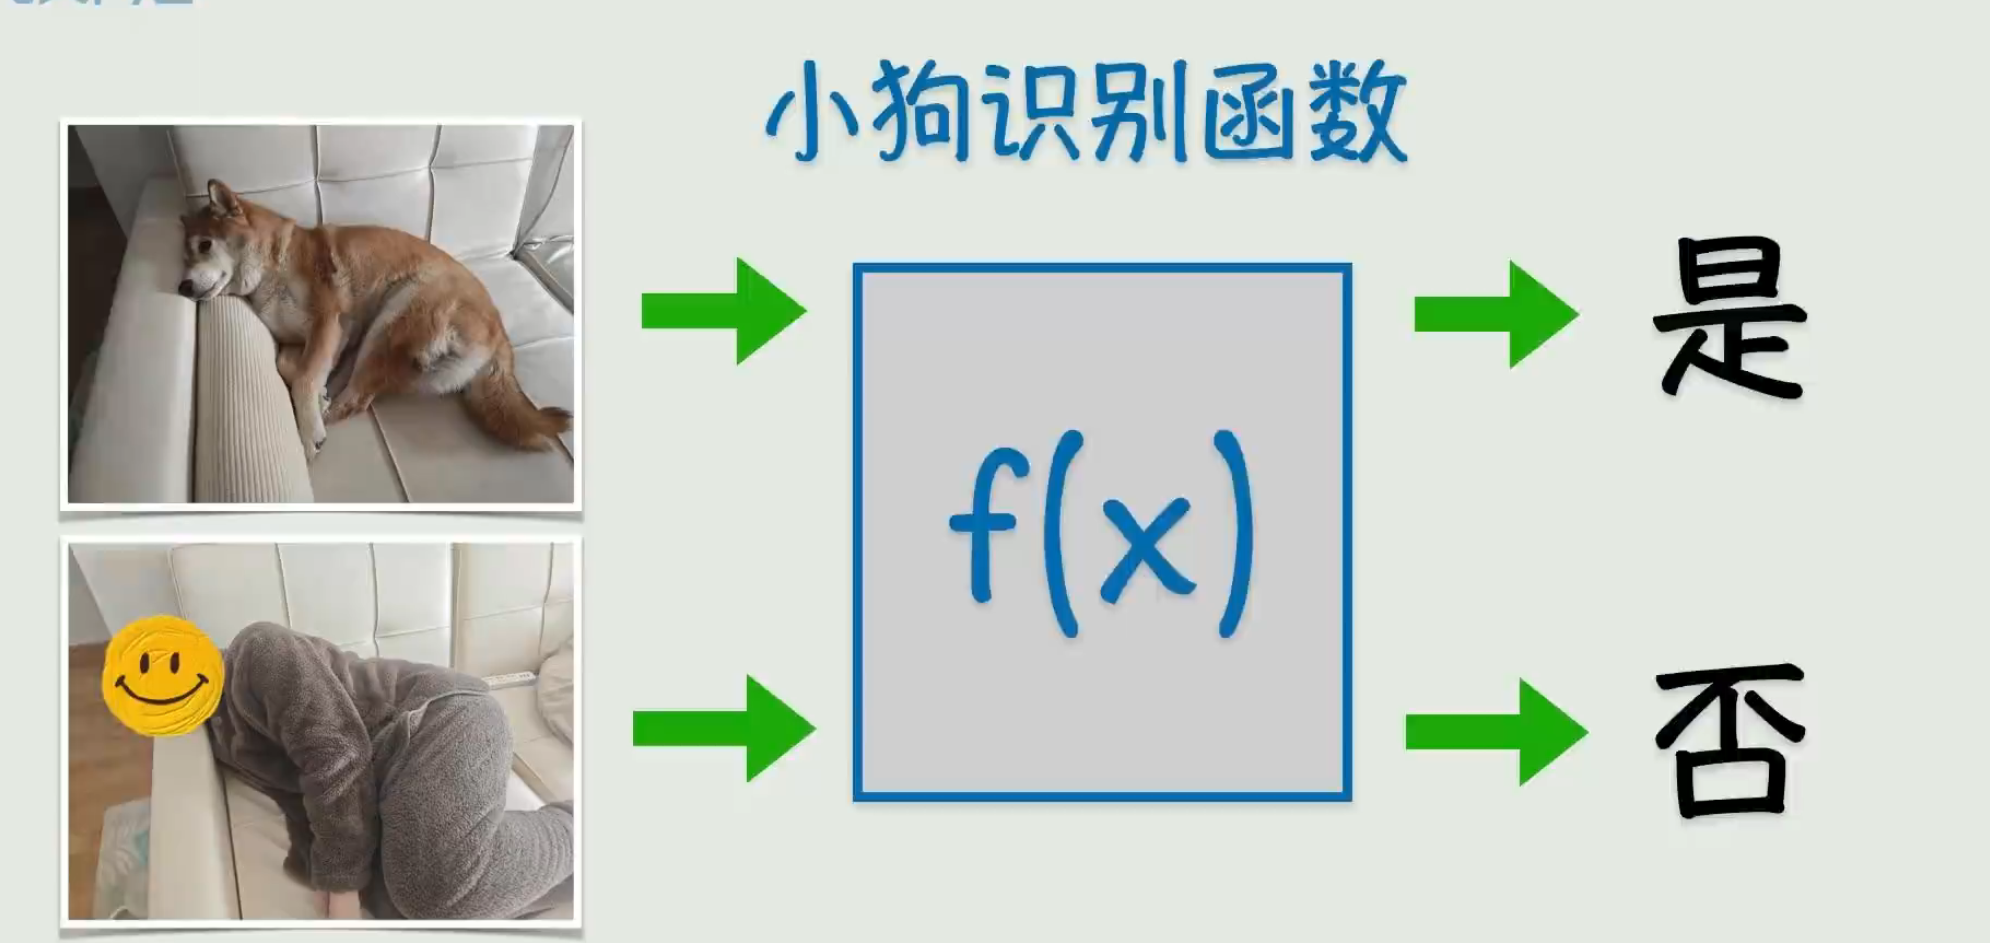
神经网络的核心任务往往不是严格的符号推理,而是从样本中拟合出一个足够逼近真实规律的函数。
一切都从这条最朴素的直线开始:
x是输入,w是权重(weight),控制输入对输出的影响程度;b是偏置(bias),提供一个基准输出;y是预测结果。
给定一堆真实数据点,任务是找出一组 w 和 b,让这条直线尽量贴合数据。
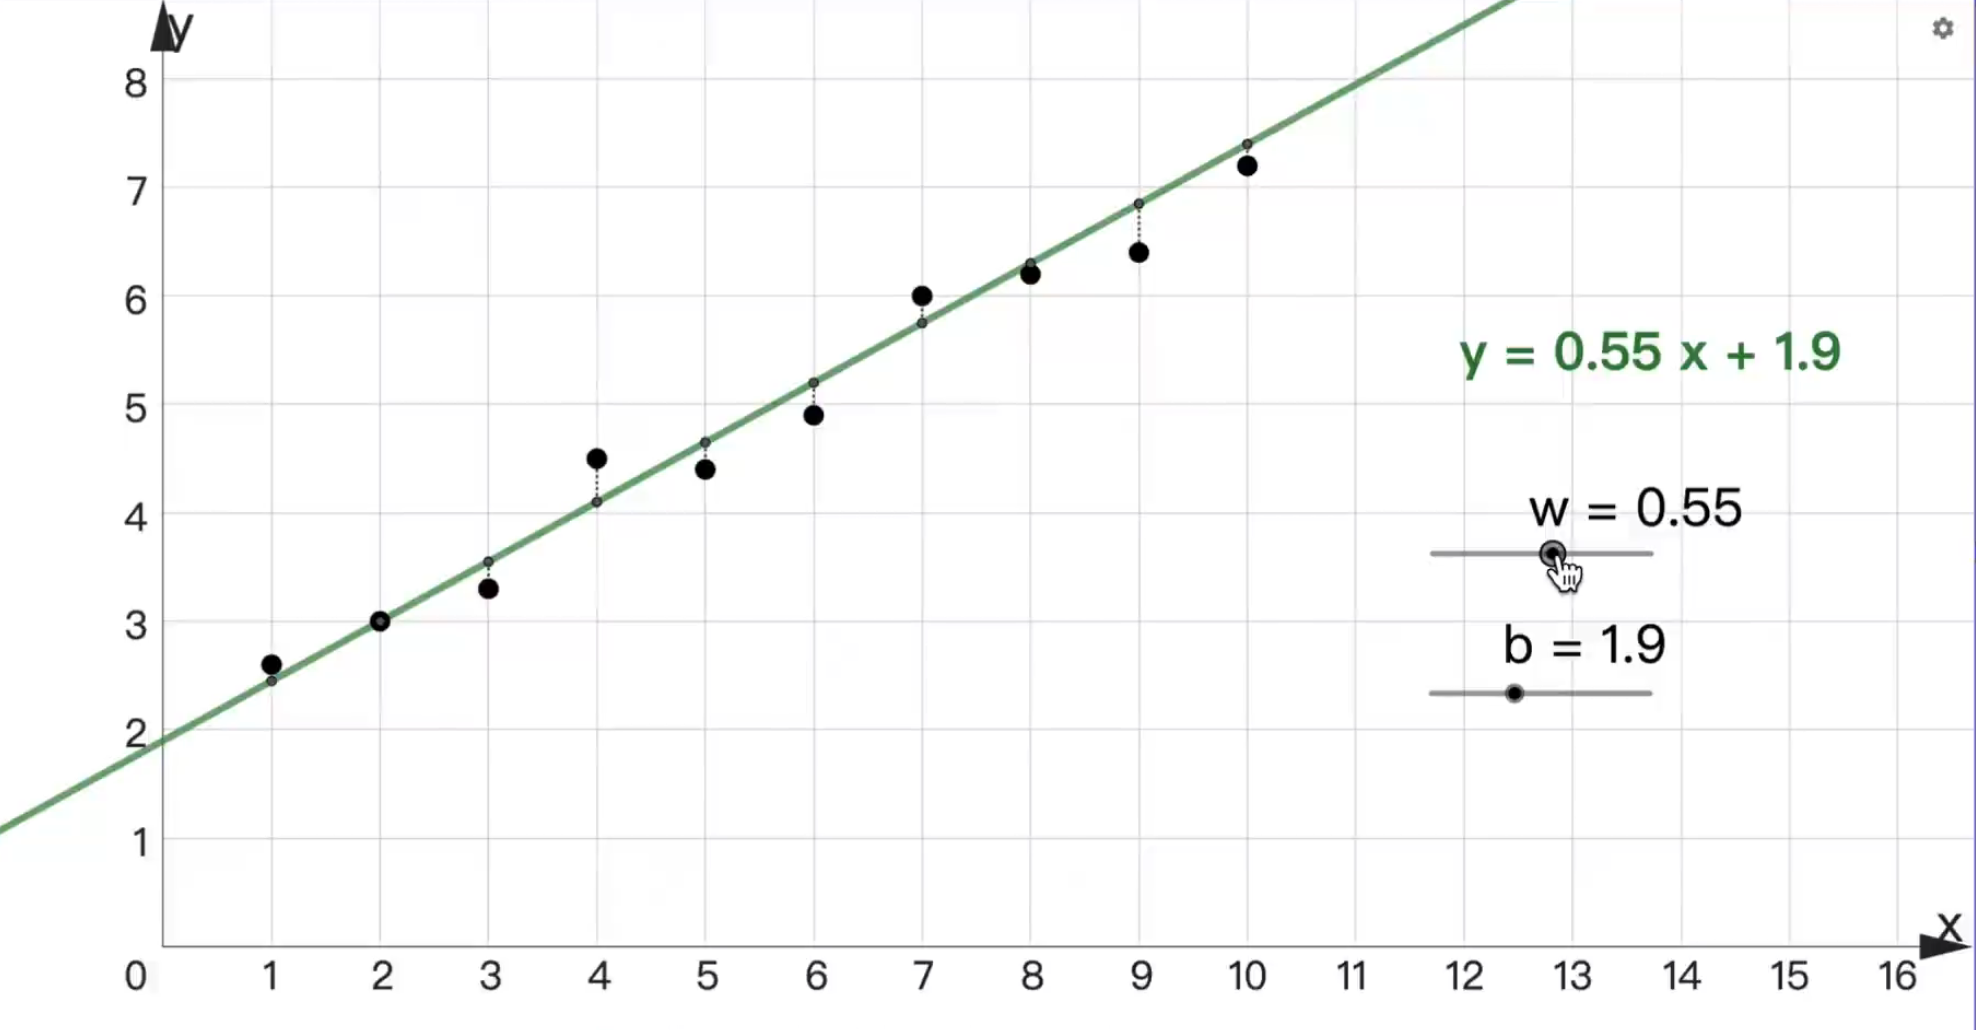
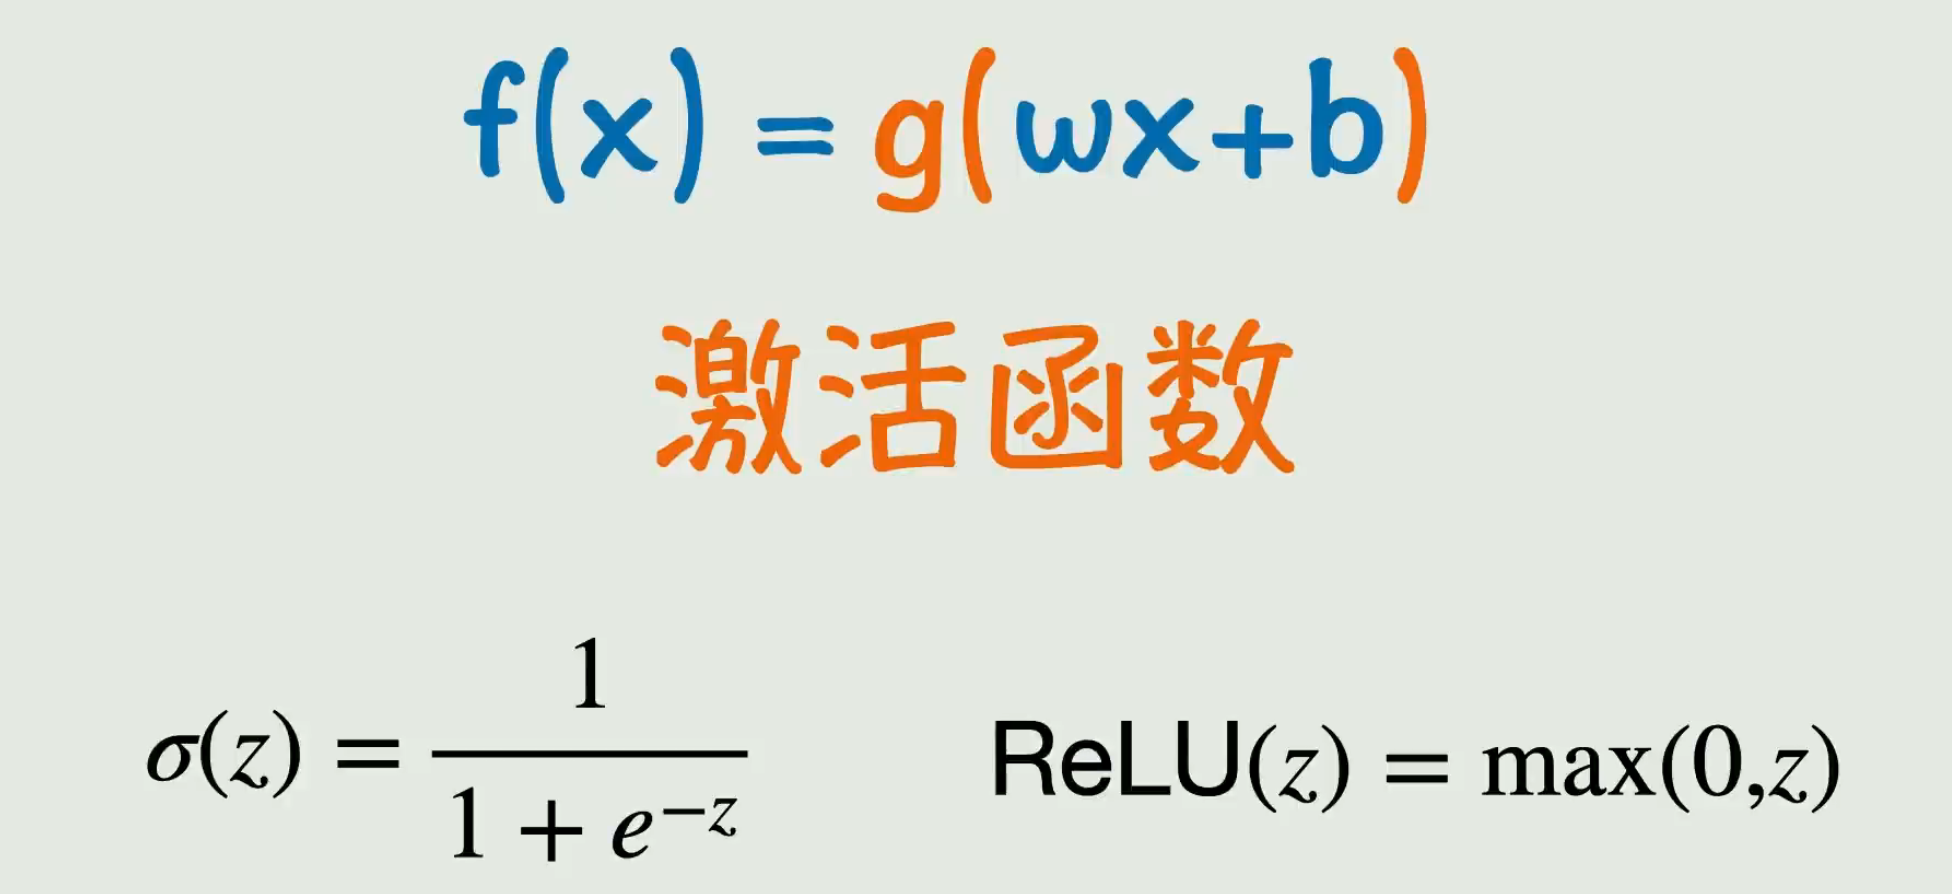
但真实世界的数据很少是笔直的,例如成绩与努力程度的关系往往是非线性的。为此在线性函数外再套一层激活函数 g(·):
f(x) = g(wx + b)
这一下,线性函数变成表达能力更强的非线性函数。常见的激活函数有 ReLU、Sigmoid 等,它们给模型提供"掰弯"的能力,使其能贴近不规则的真实分布。
输入变多时:
f(x) = g(w₁x₁ + w₂x₂ + b)
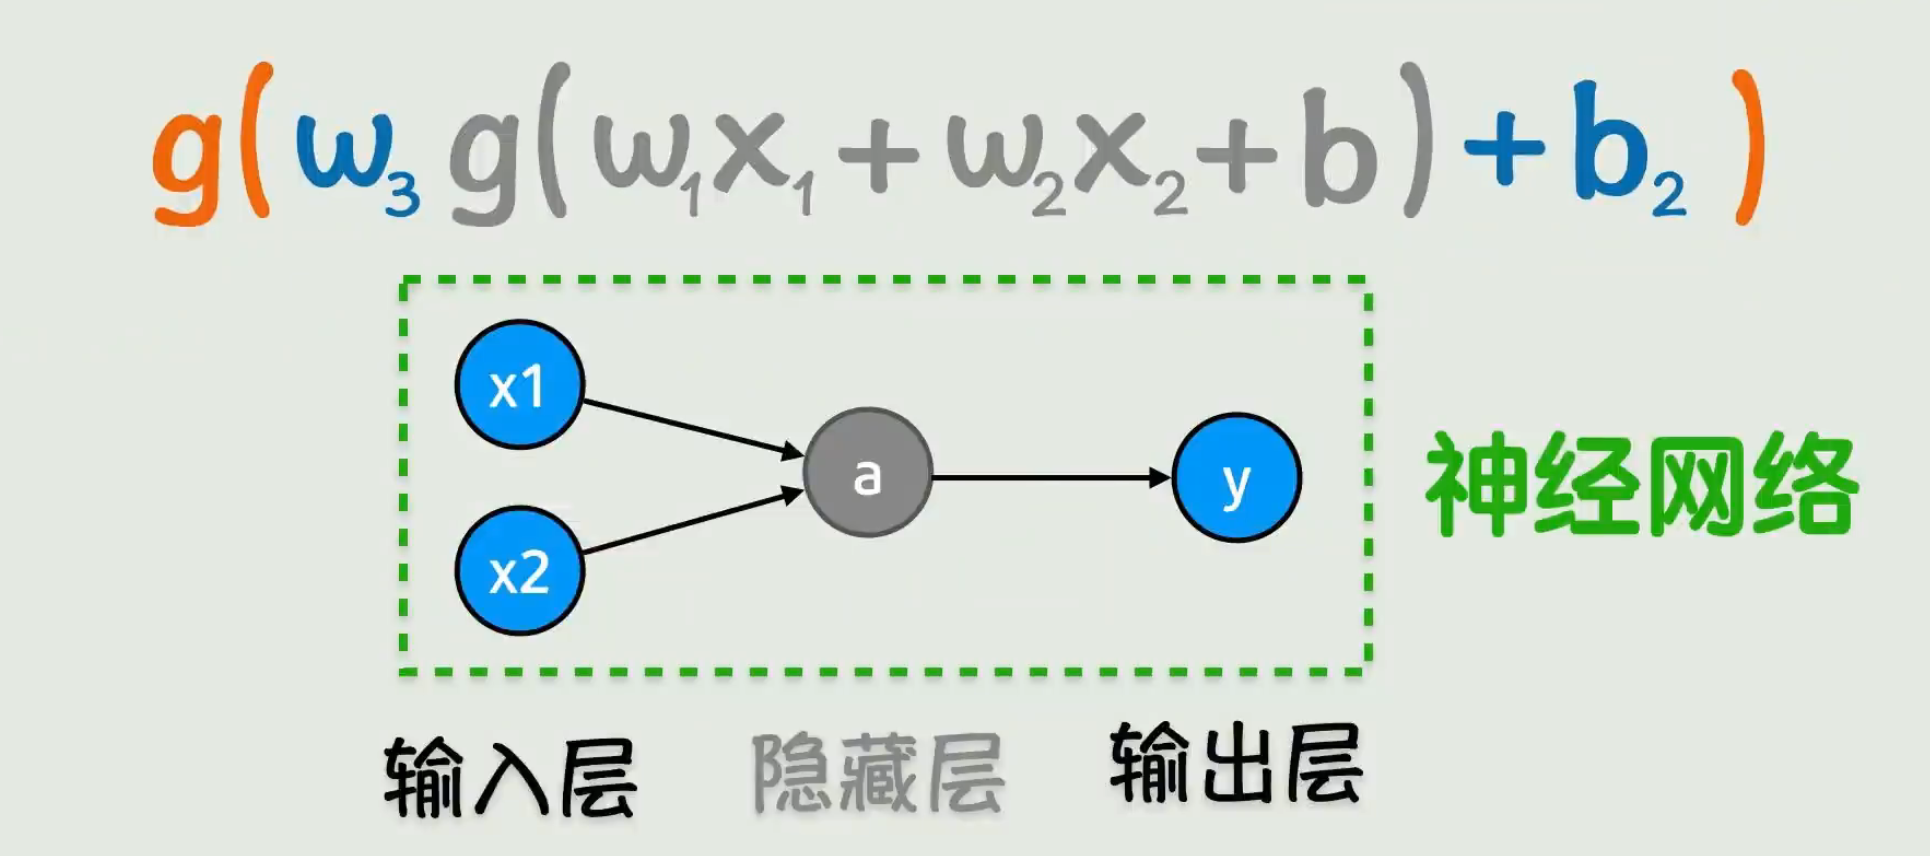
若再套一层激活函数,中间那层就成为隐藏层(hidden layer):
f(x) = g( w₃ · g(w₁x₁ + w₂x₂ + b) + b )
将无数个这样的"神经元"按层连接,便构成了神经网络,包含:
- 输入层:接收原始数据
- 隐藏层:真正进行特征变换的地方(可以有很多层)
- 输出层:给出最终结果
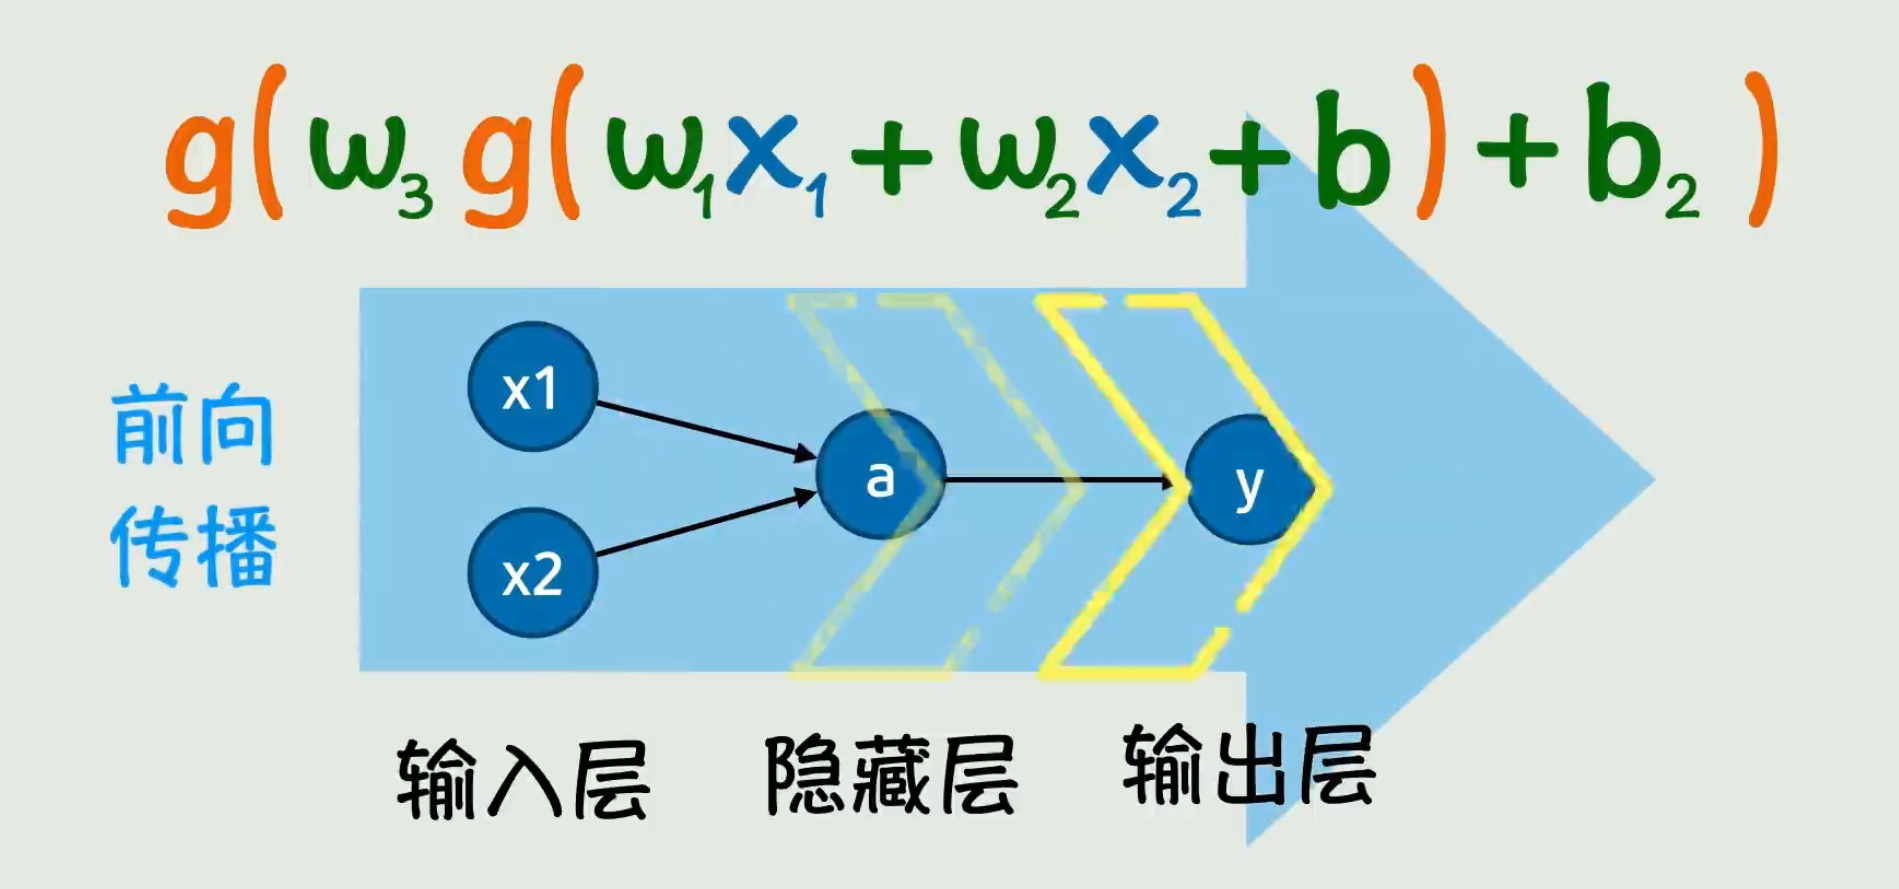
所谓前向传播(Forward Propagation),即数据从输入层逐层向右计算,直到算出输出 y。整个过程相当于把嵌套函数从内到外求值一遍。训练网络的核心目标,就是依据已有数据求出未知的 w 和 b,让函数更好地拟合真实世界。
二、参数从哪来:损失、梯度与反向传播
什么样的 w、b 才算好?答案是与真实数据"拟合"得好。但"好"需要量化指标,机器也需要一套可执行的步骤去逼近它。
假设有一堆真实数据点,每个点都有真实值 y 与模型预测值 ŷ = wx + b。量化"差多远"的直观做法是:在每个数据点画一条竖直线连接预测值与真实值,线长即误差。
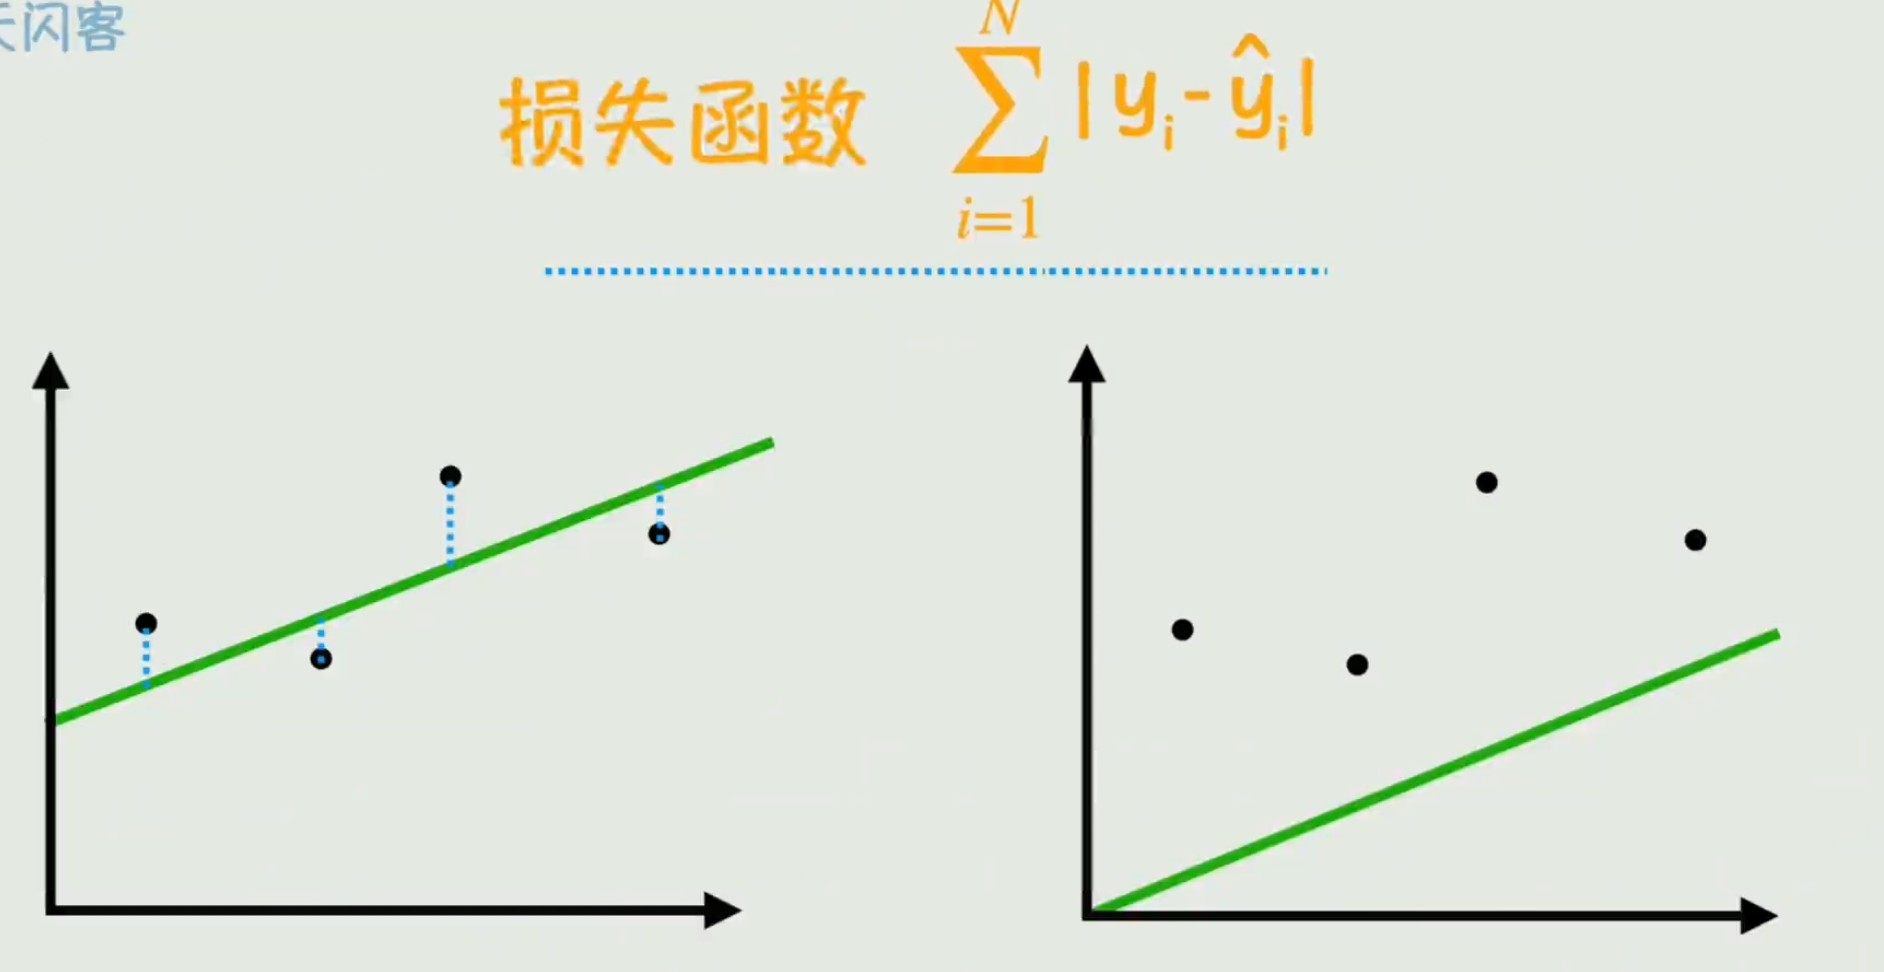
绝对值不便优化(不平滑),因此改用平方,既能放大较大误差的影响,又可按样本数平均,得到均方误差(MSE):
MSE = (1/N) × Σ (yᵢ − ŷᵢ)²
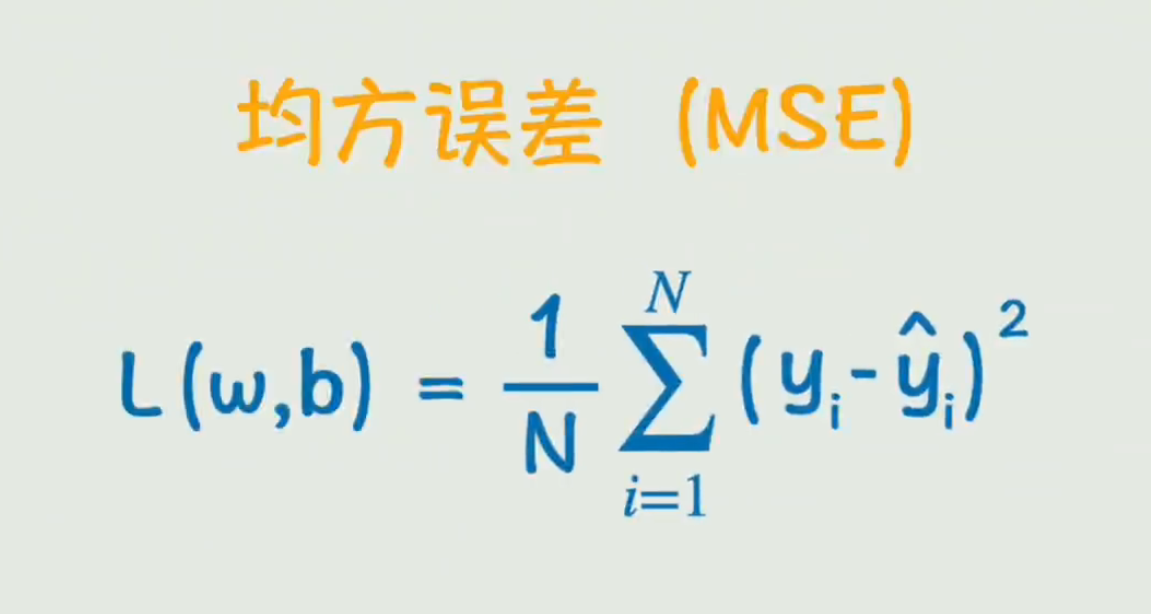
这个衡量"预测与真实差距"的函数称为损失函数(Loss Function)。损失越小,w、b 越好。
目标明确:让损失函数尽量小。损失函数形如一个"山坡",要找的是谷底。数学上,梯度(Gradient) 是损失函数对每个参数的偏导数,指向"损失上升最快"的方向——只要反方向走,就能最快下山。每次更新参数的方式:
w = w − 学习率 × ∂Loss/∂w
b = b − 学习率 × ∂Loss/∂b
学习率(Learning Rate) 控制每步迈多大:太大容易冲过谷底来回震荡,太小则收敛缓慢,是需要经验调节的"超参数"。
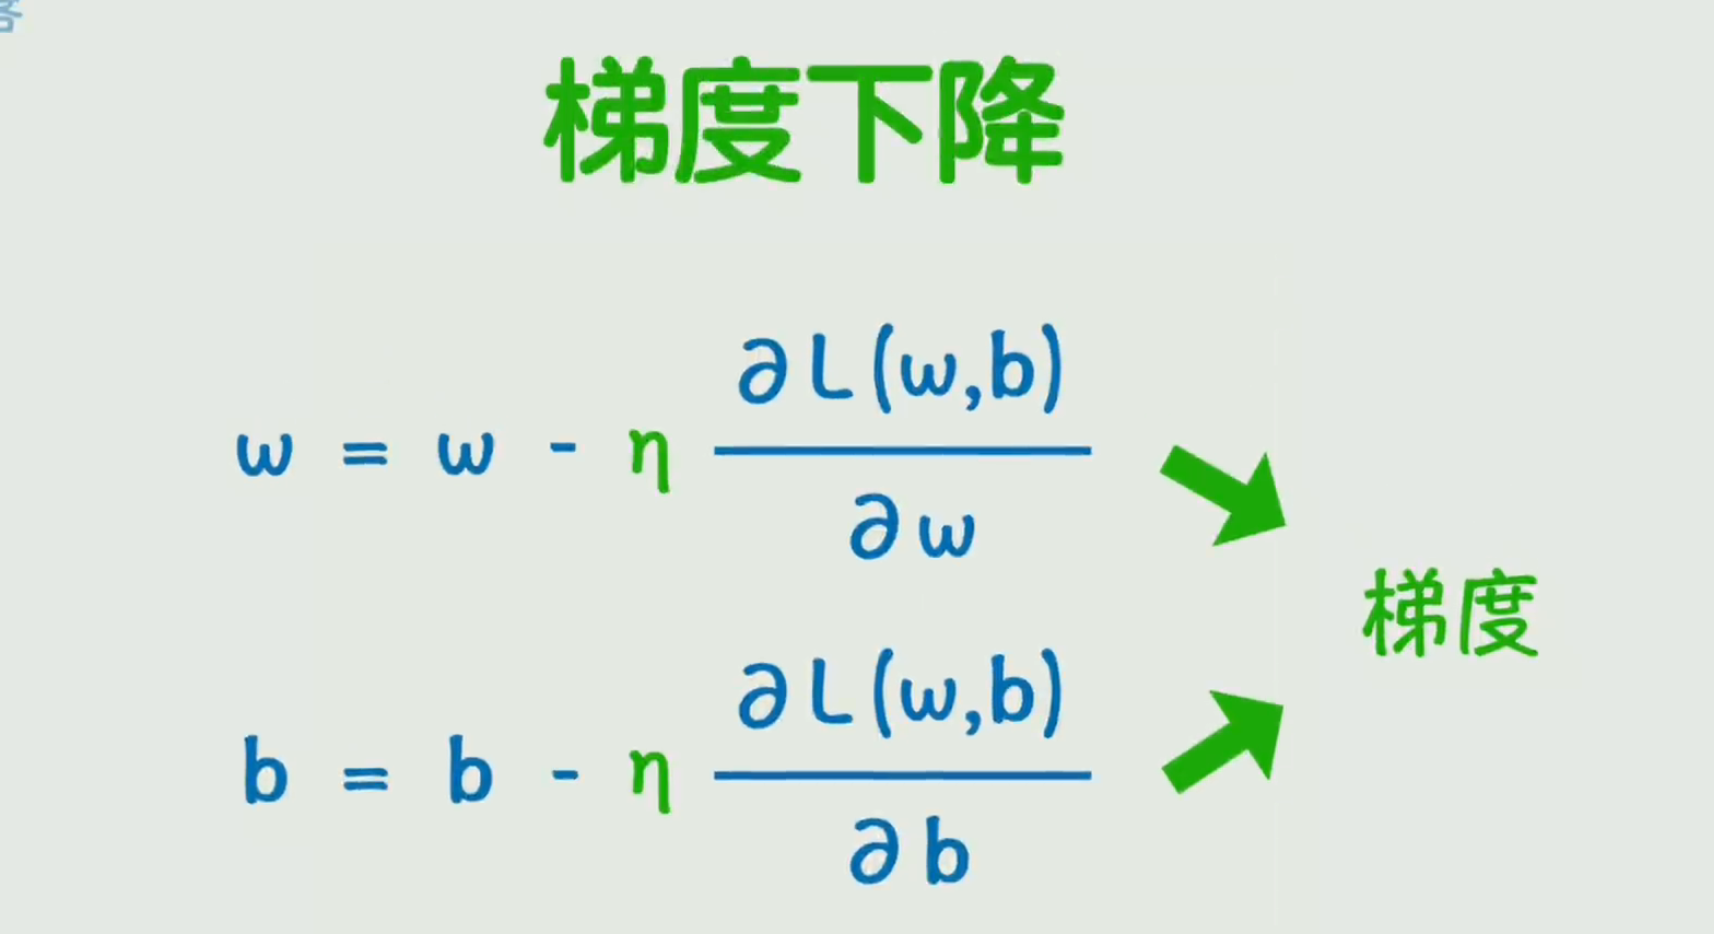
深层网络参数众多,逐个手动求偏导不现实。反向传播(Backpropagation) 借助链式法则,从输出层往回逐层计算,高效得到"损失对每个参数的梯度"。
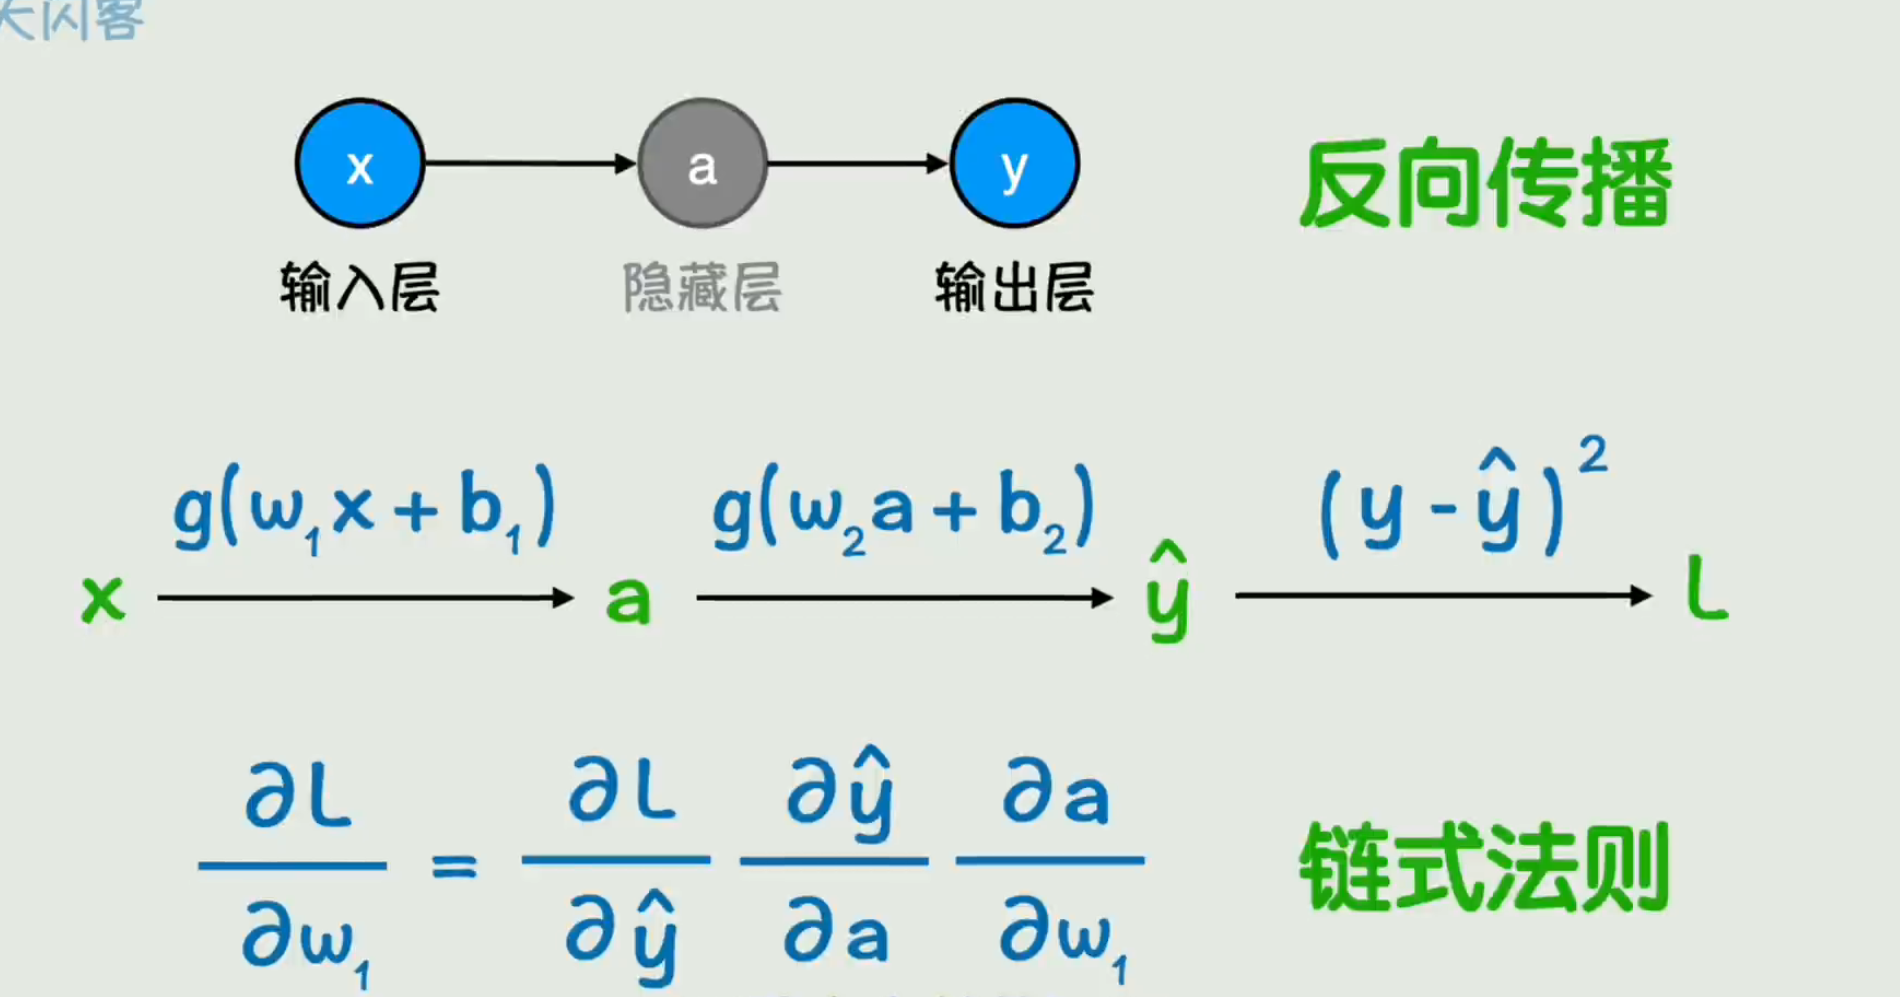
前向传播把数据从输入算到输出(算预测),反向传播把"误差"从输出传回每一层(算责任归属),告诉每个参数"该往哪调、调多少"。
三、怎么训练得"好":过拟合与训练优化
上一节说明了机器如何"学"(梯度下降 + 反向传播),但"学"不等于"学好"。这一节讨论训练中的典型问题及常用优化手段。
- 过拟合(Overfitting):模型在训练数据上表现极好,在未见数据上却很差。本质是它把训练数据中的噪声与随机波动也一并记住,而非学到真正规律。
- 泛化能力(Generalization):在未见数据上的表现,这才是模型真正的价值所在。
例如:考前把往年真题和标准答案全部背下(包括印刷错误),考原题能拿满分,但题目稍变就不会——这正是过拟合。
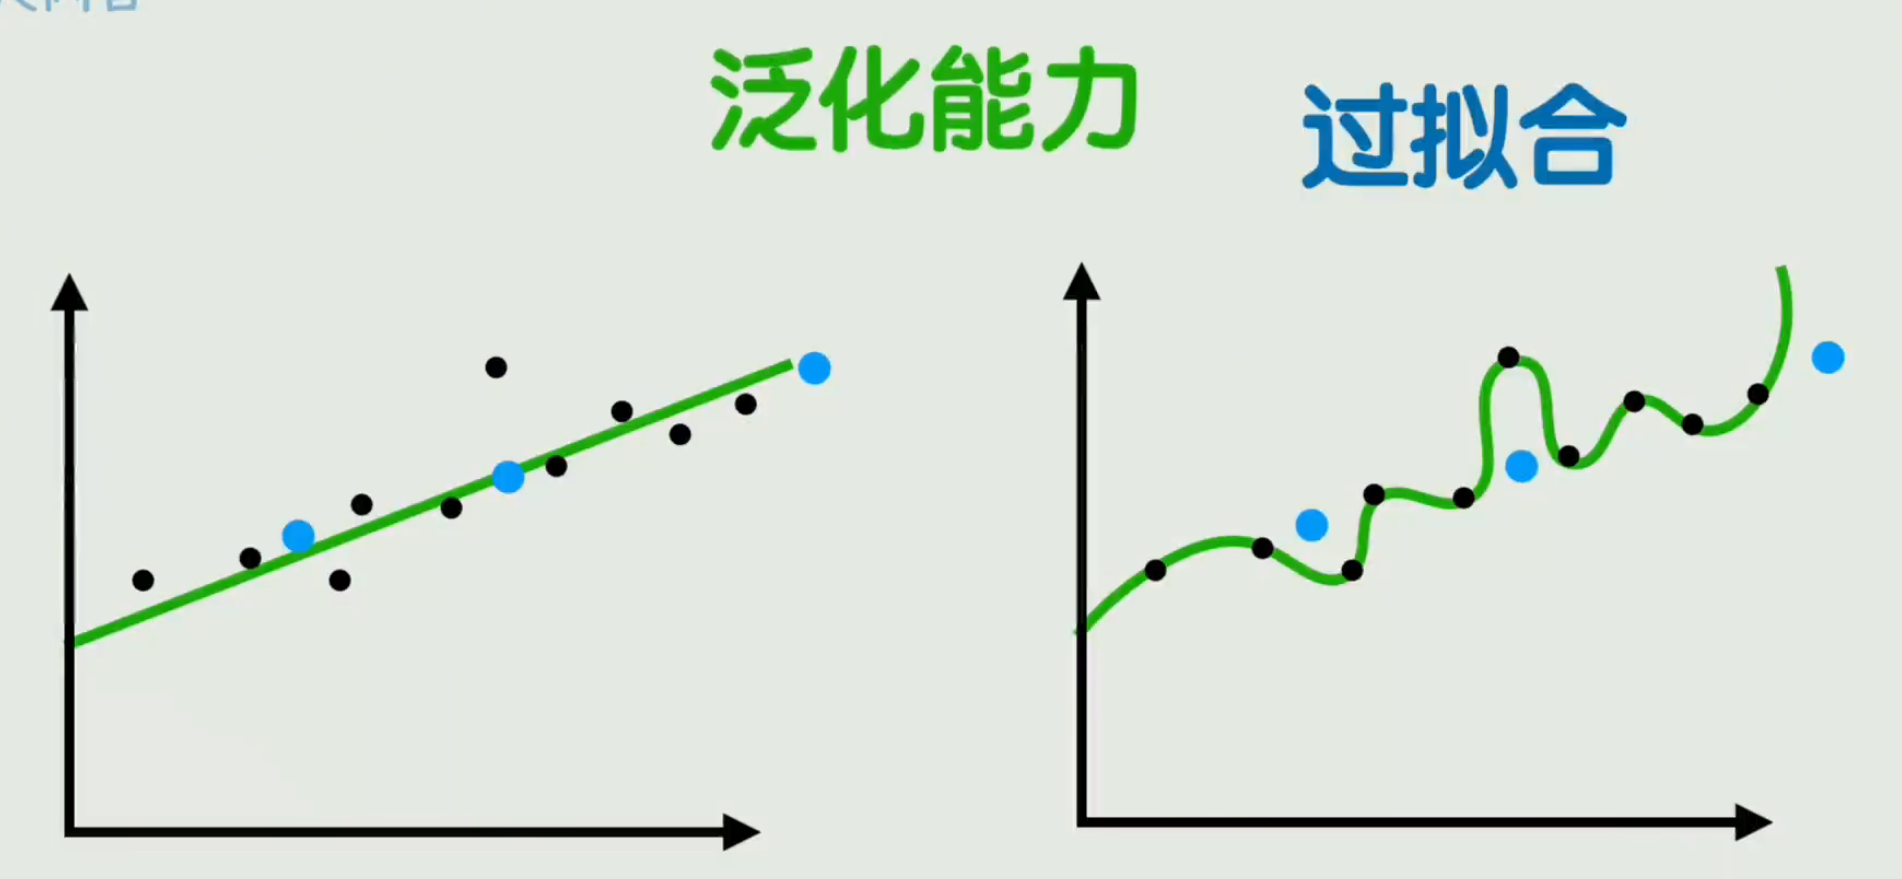
应对过拟合的常用办法:
| 方法 | 思路 |
|---|---|
| 数据增强 | 旋转、翻转、加噪,造出更多训练样本 |
| 简化模型 | 降低复杂度,减少记忆容量 |
| 提前终止 | 训练到一定程度即停止(较粗糙) |
| Dropout | 训练时随机"掐掉"一部分神经元,防止某些参数一家独大 |
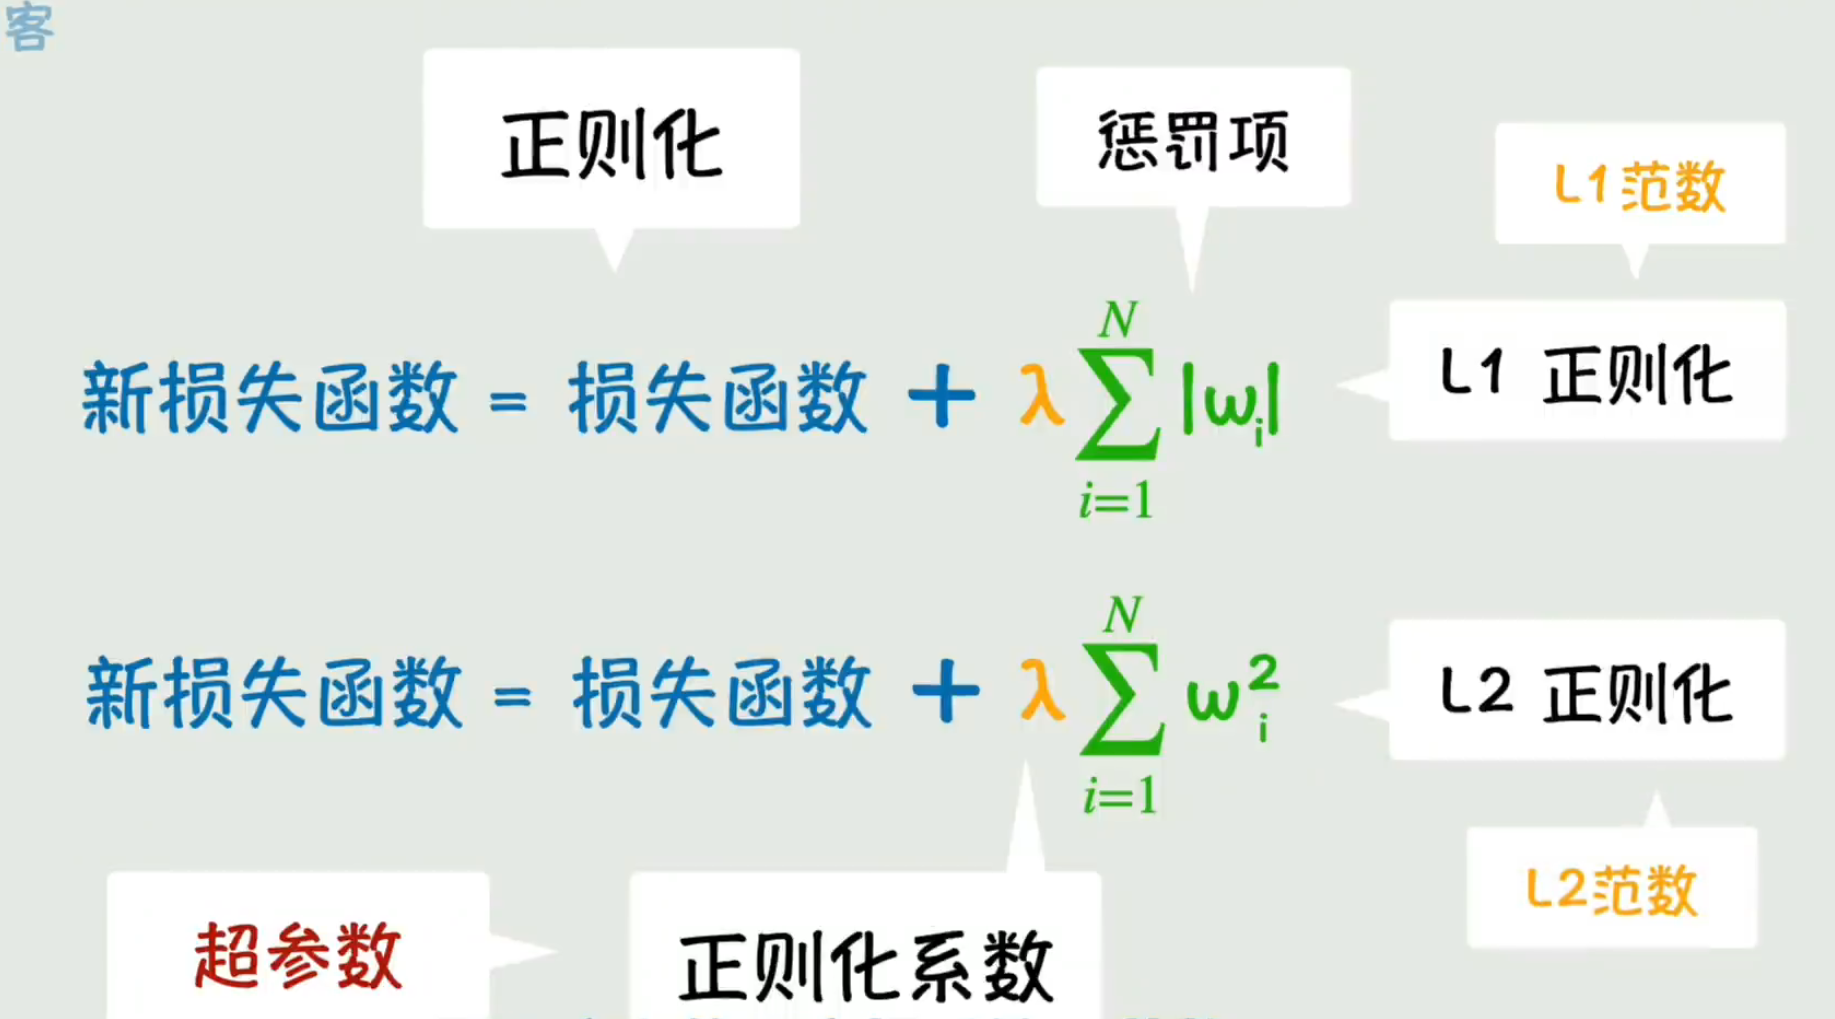
| 正则化 | 在损失中加"参数大小"惩罚项,抑制参数野蛮生长 |
正则化分两种:
- L1 正则:新损失 = 旧损失 +
λΣ|w|(用绝对值) - L2 正则:新损失 = 旧损失 +
λΣw²(用平方)
λ 是正则化系数,控制惩罚力度。加入惩罚后,参数越大代价越高,模型便不会"用力过猛"去死记训练集。
除了过拟合,还有几个经典难题:
- 梯度消失:网络越深,梯度往回传时越小,深层参数几乎不更新。
- 梯度爆炸:梯度越来越大,参数调整失控,训练发散。
- 收敛慢:陷入局部最优,或在谷底来回震荡。
- 计算开销大:数据海量,前向 + 反向均耗时。
对应的工程对策:
- 梯度裁剪:给梯度设上限,防止更新过大(对付爆炸)。
- 残差网络(ResNet):加"短路连接",让梯度能直接回流,解决深层梯度消失,网络才能堆得很深。
- 权重初始化 + 输入归一化:让梯度分布更平缓,训练更稳。
- 自适应优化器:动量法、RMSprop、Adam 等,加速收敛、减少震荡。
- Mini-batch:将海量数据切成小批次训练,显存与时间都更可控。
- 调节这些"参数的参数"的旋钮统称超参数(Hyperparameter),如学习率、层数、
λ。
小结
- 神经网络 = 线性变换
wx+b+ 激活函数(掰弯) + 多层堆叠;前向传播即从输入算到输出。 - 训练的本质:用损失函数(如 MSE)量化偏差,靠梯度下降沿反方向更新参数,反向传播高效回溯每个参数的梯度。
- 过拟合 = 过度贴合训练分布、泛化不足;缓解靠数据增强 / Dropout / 正则化(L1、L2)。
- 梯度消失、爆炸、收敛慢、开销大等难题,对应有梯度裁剪、残差、归一化、Adam、Mini-batch 等对策。
- 至此搭好了"通用神经网络"的地基,后续将进入具体结构:让网络看懂图、读懂话。
参考:B 站 BV1NCgVzoEG9《【闪客】一小时从函数到 Transformer》。本文根据该系列前 3 节内容整理,配图来自原视频笔记。

 浙公网安备 33010602011771号